3줄 요약
- MOSI.AI(OpenMOSS 팀)가 2026년 10월 16일 50억 파라미터 이미지 생성 모델 MOSS-Image-Base와 MOSS-Image-SFT를 Apache-2.0으로 공개했고, 사흘 뒤 기술 보고서를 arXiv에 올렸다.
- 한 페이지 분량의 글을 그림 안에 그리는 LLTB에서 96.3점으로 오픈 웨이트 모델 가운데 1위였고, 지정한 상자대로 물체를 그리는 7Bench에서는 mIoU 0.88로 비교한 모델 전부보다 높았다. 사람이 디자인 결과를 고르는 RLA에서는 GPT Image 2 다음인 2위였다.
- 연구진은 복잡한 그래픽을 만들려면 글을 정확히 그리는 생성기와, 무엇을 어디에 둘지 정한 명세가 함께 있어야 한다고 결론 내렸다. 지금 공개된 모델은 텍스트만 입력받으며, 참조 이미지 입력과 편집은 다음 과제로 남겼다.
그럴듯하지만 읽히지 않는 그림
GPT Image 2, Seedream 5.0 Pro, Qwen Image 3.0 Pro, Nano Banana Pro 같은 상용 모델은 인포그래픽과 UI 시안, 지식 카드처럼 글이 많은 실무용 그림까지 만든다. 반면 Stable Diffusion, SDXL, FLUX, Qwen-Image, Z-Image, ERNIE-Image 같은 오픈 웨이트 모델은 글이 빽빽하거나 요소가 많아지면 결과가 무너진다. 멀리서 보면 색감과 구도는 그럴듯한데, 가까이 읽어 보면 글자가 깨져 있고 요청한 내용이 빠져 있으며 배치가 흩어져 있다.
보고서는 오픈 웨이트 모델에 모자란 것을 렌더링과 명세로 꼽는다. 렌더링은 긴 글을 틀리지 않고 그리면서 공간 제약까지 지키는 생성기의 능력을 말한다. 명세는 “코알라 인포그래픽을 만들어 줘” 같은 짧은 요청을 실제 문구와 정보의 위계, 요소별 배치로 풀어 쓰는 일을 말한다. 자세한 명세를 받아도 생성기가 따라 그리지 못하면 글자가 뭉개지고, 정밀한 생성기도 한 줄짜리 요청만 받으면 무엇을 어디에 그릴지 스스로 정할 수 없다. 연구진이 두 능력을 한 시스템에 묶은 까닭이 여기에 있다.
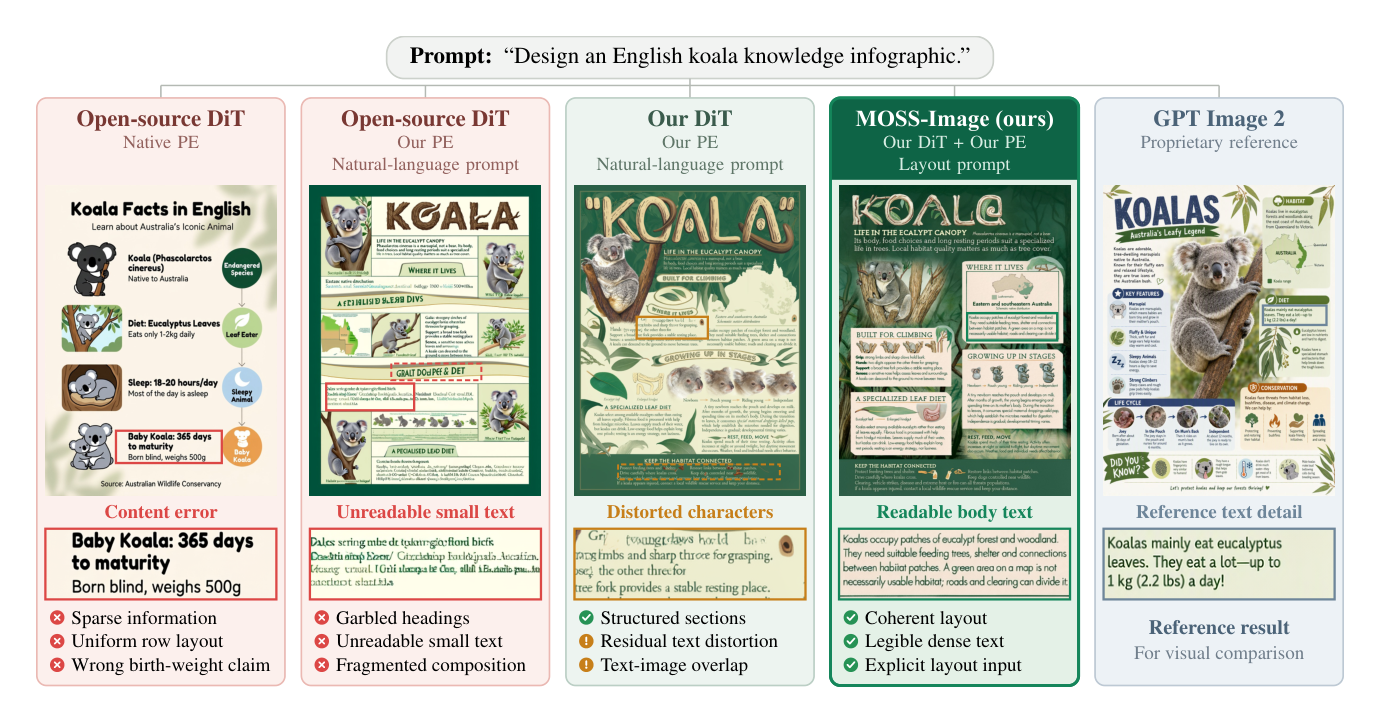 그림 1. 같은 짧은 요청을 다섯 구성으로 그린 결과. 왼쪽부터 오픈소스 DiT와 그 모델의 기본 인핸서, 오픈소스 DiT와 MOSS 인핸서(자연어), MOSS DiT와 MOSS 인핸서(자연어), MOSS DiT와 MOSS 인핸서(레이아웃 JSON), 마지막은 참고용 상용 모델 GPT Image 2다. 출처: MOSS-Image Technical Report 그림 1
그림 1은 “Design an English koala knowledge infographic.“라는 한 줄 요청을 다섯 구성으로 처리한 결과다. 오픈소스 생성기에 그 모델의 기본 인핸서를 붙인 첫 결과는 정보가 적고 행 배치가 단조로우며, 새끼 코알라의 체중에 대한 설명이 틀렸다. 같은 생성기에 MOSS의 인핸서를 붙이자 정보는 늘었지만 작은 본문 글씨가 깨져 읽을 수 없게 됐다. 생성기를 MOSS DiT로 바꾸자 섹션 구조는 잡혔지만 글자 왜곡이 일부 남았고 글과 그림이 겹쳤다. 인핸서의 출력을 자연어 대신 레이아웃 JSON으로 바꾼 네 번째 구성에 와서야 본문이 읽혔고 카드 배치가 정돈됐다.
50억 파라미터 단일 스트림 DiT
MOSS-Image의 생성기는 처음부터 새로 사전학습한 50억 파라미터 디퓨전 트랜스포머(DiT)다.1 텍스트 인코더와 VAE는 다른 팀이 공개한 모델을 가져와 가중치를 고정한 채 썼다.2
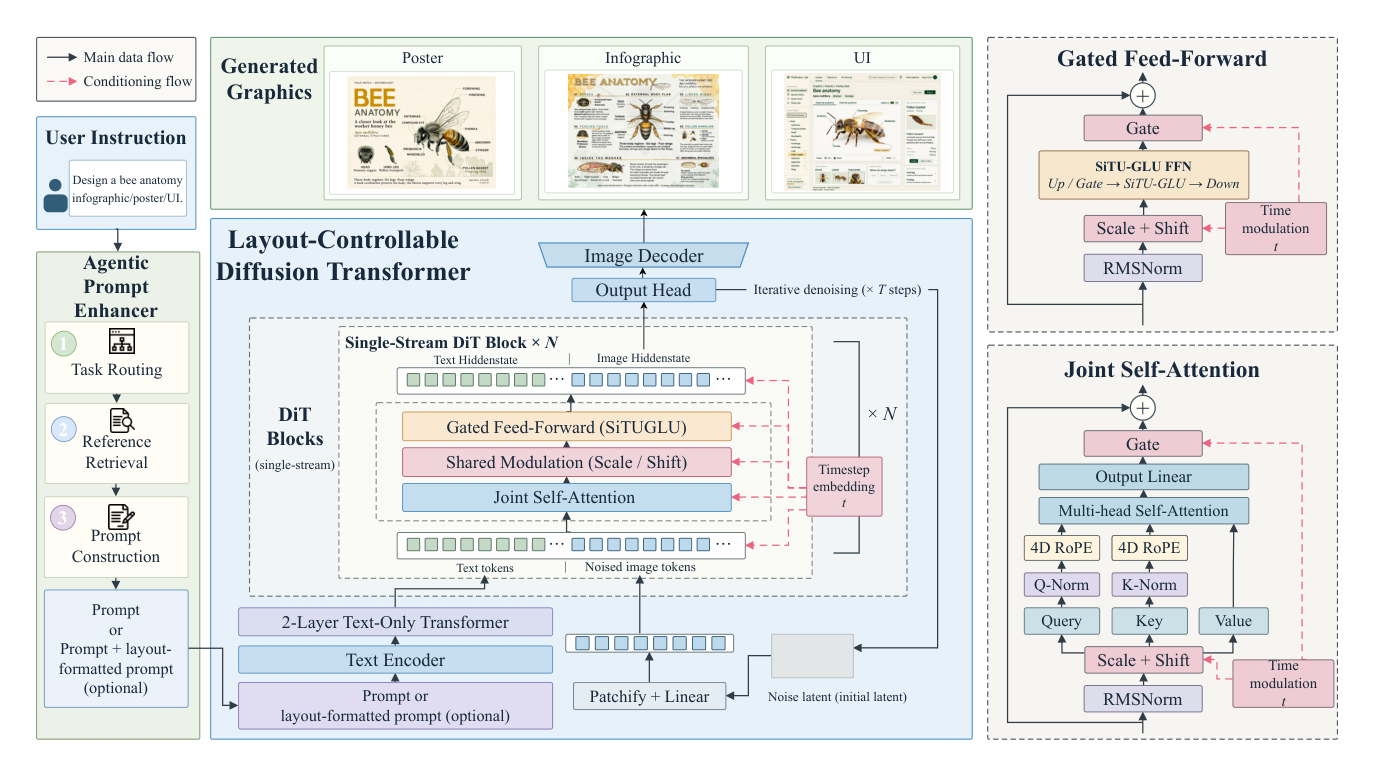 그림 2. 시스템 개요. 왼쪽의 에이전트형 인핸서가 요청을 라우팅하고 참고 자료를 찾아 프롬프트나 레이아웃 프롬프트를 만들고, 오른쪽의 단일 스트림 DiT가 이를 받아 이미지를 그린다. 출처: MOSS-Image Technical Report 그림 2
| 구성 요소 | 사양 |
|---|---|
| 생성기 | 단일 스트림 트랜스포머 42블록. 은닉 차원 3072, 어텐션 헤드 24개(헤드당 128차원), FFN 8192 |
| 텍스트 인코더 | Qwen3.5-9B(동결). 마지막 층 출력 4096차원을 3072차원으로 투영한 뒤 텍스트 전용 블록 2개를 거친다 |
| VAE | FLUX.2 VAE(동결). 잠재 32채널, 가로세로 8배 축소. 잠재 2×2를 토큰 하나로 묶어 16픽셀마다 토큰 1개 |
| 위치 인코딩 | 4D RoPE(참조 이미지 번호, 시퀀스 위치, 너비, 높이) |
단일 스트림이라는 말은 텍스트 토큰과 이미지 토큰을 따로 처리하지 않고, 둘을 한 줄로 이어 붙여 모든 블록에서 함께 어텐션을 계산한다는 뜻이다. 확산 단계 정보를 넣는 모듈레이션 파라미터도 블록끼리 공유한다. 1024×1024 이미지는 이미지 토큰 4,096개가 되고, 텍스트는 마지막 학습 단계에서 4,096토큰까지 받으므로 한 샘플은 최대 8,192토큰이다. FFN으로는 게이트형 구조인 SiTU-GLU를 썼는데, tanh로 값의 상한을 부드럽게 제한해 활성값이 지나치게 커지는 것을 막는다.
이 구조에는 레이아웃 전용 인코더가 없다. 바운딩 박스 좌표를 담은 JSON도 자연어 프롬프트와 똑같이 Qwen3.5-9B를 거쳐 텍스트 토큰이 된다. 모델은 같은 통로로 두 형식을 함께 배웠기 때문에 자연어와 JSON, 둘을 섞은 입력까지 모두 처리한다.
RoPE는 토큰의 위치를 벡터의 회전 각도로 표현하는 위치 인코딩이다. MOSS-Image는 이 위치를 참조 이미지 번호, 시퀀스 위치, 너비, 높이의 네 성분으로 구분했다. 지금은 참조 이미지를 입력받지 않으므로 모든 토큰의 참조 번호가 0이고, 헤드 128차원 가운데 이 성분에 배정된 앞 32차원은 회전하지 않는다. 연구진에 따르면 이 성분은 확장에 대비한 것이다. 나중에 참조 이미지를 조건으로 받게 되면, 위치 인코딩을 바꾸지 않고도 참조 이미지 수를 늘릴 수 있다.
학습 레시피: 거르지 말고 설명하라
사전학습 데이터는 ReLAION, OmniCorpus, DataComp 등 16개 공개 데이터셋의 약 55억 장에서 시작했다. 연구진은 SSCD로 중복을 지우고 자체 탐지기로 AI 생성 이미지를 빼서 약 32억 장을 남겼다. 그 뒤로는 품질 필터링을 더 하지 않았다.3
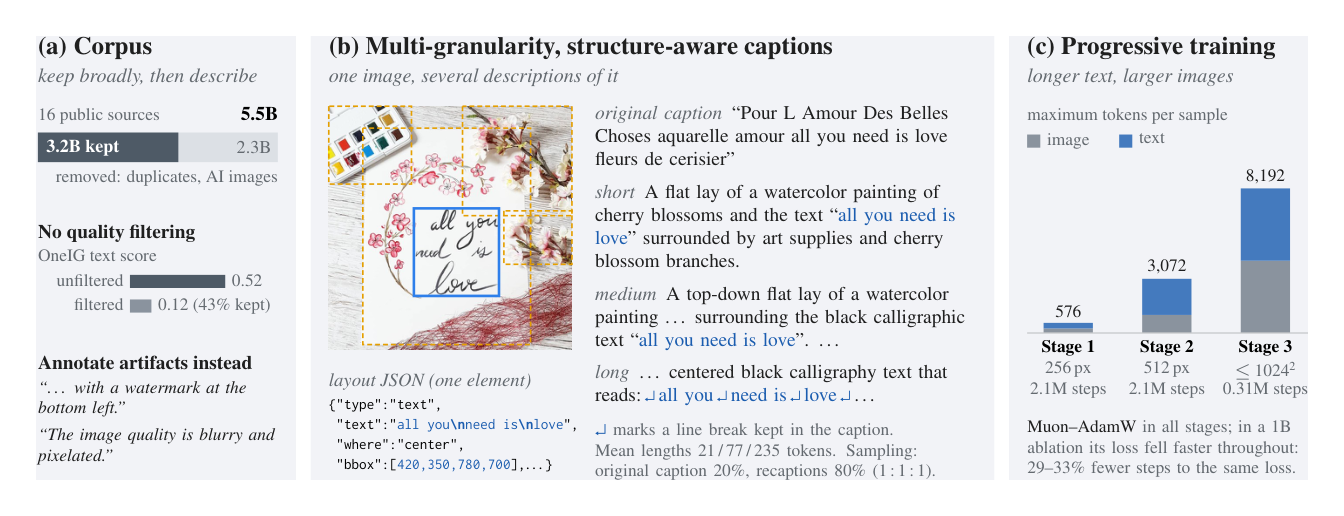 그림 3. 사전학습 레시피. (a) 중복과 AI 생성 이미지만 빼고 모두 남기며, 결함은 이미지를 버리는 대신 캡션에 적는다. 품질 필터를 건 예비 실험에서는 OneIG 텍스트 점수가 0.52에서 0.12로 떨어졌다. (b) 이미지 한 장에 원래 캡션과 짧은 캡션, 중간 캡션, 긴 캡션, 레이아웃 JSON을 함께 단다. (c) 단계마다 해상도와 샘플당 토큰 수를 늘린다. 출처: MOSS-Image Technical Report 그림 3
연구진이 내건 원칙은 “Annotate rather than filter”, 곧 거르지 말고 주석을 달라는 것이다. 워터마크가 있거나 얼굴이 흐리거나 압축 손상이 보이는 이미지도 지우지 않았다. 대신 캡션에 “왼쪽 아래에 워터마크가 있다”, “화질이 흐리고 픽셀이 깨져 있다” 같은 문장을 적어 결함을 학습 조건의 일부로 만들었다. 연구진은 이렇게 해서 현실의 데이터 분포를 되도록 그대로 보존하려 했다. 근거로 든 예비 실험에서, 품질 필터로 데이터의 43%만 남겨 학습한 모델은 OneIG 텍스트 점수가 0.12였고 필터링하지 않은 데이터로 학습한 모델은 0.52였다.4
캡션은 Gemma 4로 다시 달았다. 한 장마다 짧은 한 문장(평균 21토큰), 한 문단(평균 77토큰), 구도와 피사체, 이미지에 보이는 글까지 옮긴 긴 설명(평균 235토큰)을 만들었다. 학습할 때는 원래 웹 캡션을 20%, 새 캡션을 80% 비율로 뽑고, 새 캡션 세 종류는 1:1:1로 고른다. 일부 고품질 이미지에는 레이아웃 JSON도 달았다. 여기에는 장면 전체 설명, 요소별 바운딩 박스와 종류, 이미지 속 글의 원문, 글꼴 속성이 담겨 있다. 학습 중에는 JSON의 선택 필드를 무작위로 빼서, 일부 필드만 주어져도 모델이 그릴 수 있게 했다. 보고서는 이 설계의 취지를 “자세한 주석은 성능의 상한을 높이고, 다양한 주석은 일반화를 지킨다"고 정리해 두었다.
이미지 속 글을 캡션과 JSON에 옮길 때는 줄바꿈까지 그대로 적었다. 글을 받아 적기만 하면 모델은 어떤 단어가 나오는지만 알 수 있다. 줄바꿈을 함께 적으면 그 단어들이 몇 번째 줄에 어떻게 놓이는지도 모델에 알려 줄 수 있다. 보고서의 표현으로는 “Text line breaks are also a form of layout”, 곧 줄바꿈도 레이아웃의 한 형태라는 말이다.
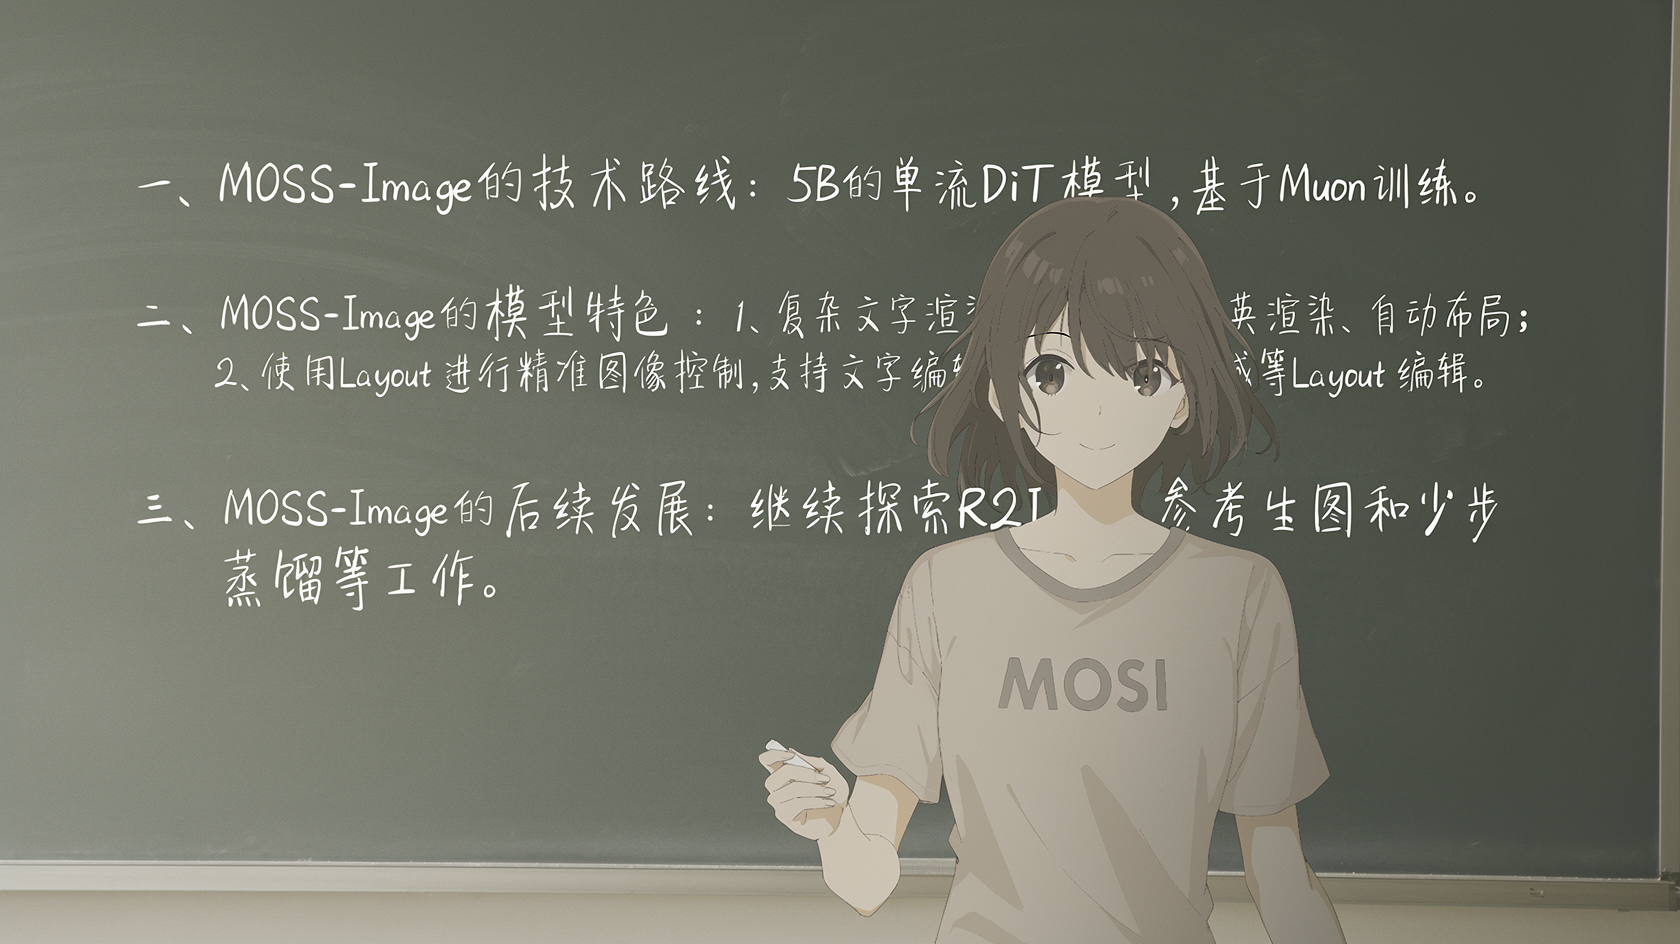 칠판에 쓸 중국어 문장 전체를 프롬프트에 넣어 손글씨로 그리게 한 예시. 출처: OpenMOSS/MOSS-Image README
연구진은 학습하는 동안 해상도와 텍스트 길이를 단계적으로 늘렸다. 그림 3 기준으로 1단계는 256픽셀, 샘플당 최대 576토큰으로 210만 스텝을 학습했다. 2단계는 512픽셀, 3,072토큰으로 역시 210만 스텝이다. 3단계는 최대 1024×1024, 8,192토큰으로 31만 스텝이다.5 옵티마이저는 Muon과 AdamW를 함께 썼다. Muon을 적용할 수 있는 행렬 파라미터에는 Muon을, 나머지에는 AdamW를 썼다. 10억 파라미터 모델로 비교했을 때, 디노이징 손실 0.41에 도달하는 데 필요한 스텝은 AdamW만 쓴 경우보다 33.2% 적었고 0.403에 도달하는 데는 28.6% 적었다.6
에이전트형 프롬프트 인핸서: 짧은 요청을 명세로
“코알라 인포그래픽을 만들어 줘” 같은 요청에는 제목과 본문 문구, 소제목 개수, 상자 크기와 좌표가 하나도 정해져 있지 않다. MOSS-Image는 그리기 전에 이 빈칸을 채우는 에이전트형 프롬프트 인핸서를 둔다. 보고서의 인핸서는 GPT-6에 작업별 지침 모듈을 붙인 구성이고, 세 단계로 동작한다.
첫째, 요청한 매체에 맞춰 지침 모듈을 고른다. 포스터, 인포그래픽, UI마다 내용과 디자인 지침이 다르고, 제약 조건과 JSON 형식, 검증 규칙 같은 핵심 부분은 모든 모듈이 공유한다. 덕분에 모듈을 더하거나 고쳐도 출력 형식과 생성기는 그대로 둘 수 있다.
둘째, 필요하면 관련 지식을 찾고 참고 이미지를 살펴 내용과 구도를 정한다. 참고 이미지는 인핸서가 계획을 세울 때만 쓰이고, 생성기에는 전달되지 않는다.
셋째, 화면에 들어갈 글의 원문과 요소별 설명, 바운딩 박스, 글꼴, 요소 사이의 관계를 JSON으로 쓴다. 생성기에 전달하기 전에 사용자의 제약이 반영됐는지, 빠진 내용은 없는지, 배치가 일관적인지, 글이 상자 크기에 맞는지를 확인한다.
어떤 생성기에나 붙일 수 있는 기존 프롬프트 확장 에이전트는 자연어 프롬프트로만 생성기에 지시를 전달할 수 있다. MOSS-Image의 인핸서는 생성기가 사전학습에서 배운 레이아웃 형식 그대로 명세를 전달하므로, 계획한 배치가 생성 단계까지 유지된다. 연구진은 GitHub 저장소에 이 인핸서를 GPT-6 계열 에이전트용 스킬(MOSS-Image Prompt Enhancer)로 공개했다. 스킬에 포함된 스크립트는 픽셀 좌표로 쓴 초안을 캔버스 중심을 원점으로 하는 정수 좌표 JSON으로 바꿔 줄 뿐, 이미지 생성 서비스를 호출하지는 않는다. 오픈소스 LLM을 미세조정한 레이아웃 인핸서는 아직 공개 전이다.
레이아웃 JSON으로 요소 좌표를 지정한다
레이아웃 제어를 쓸 때는 프롬프트 칸에 자연어 대신 JSON을 넣는다. JSON은 장면 전체를 설명하는 summary와 요소 목록인 items로 구성된다.
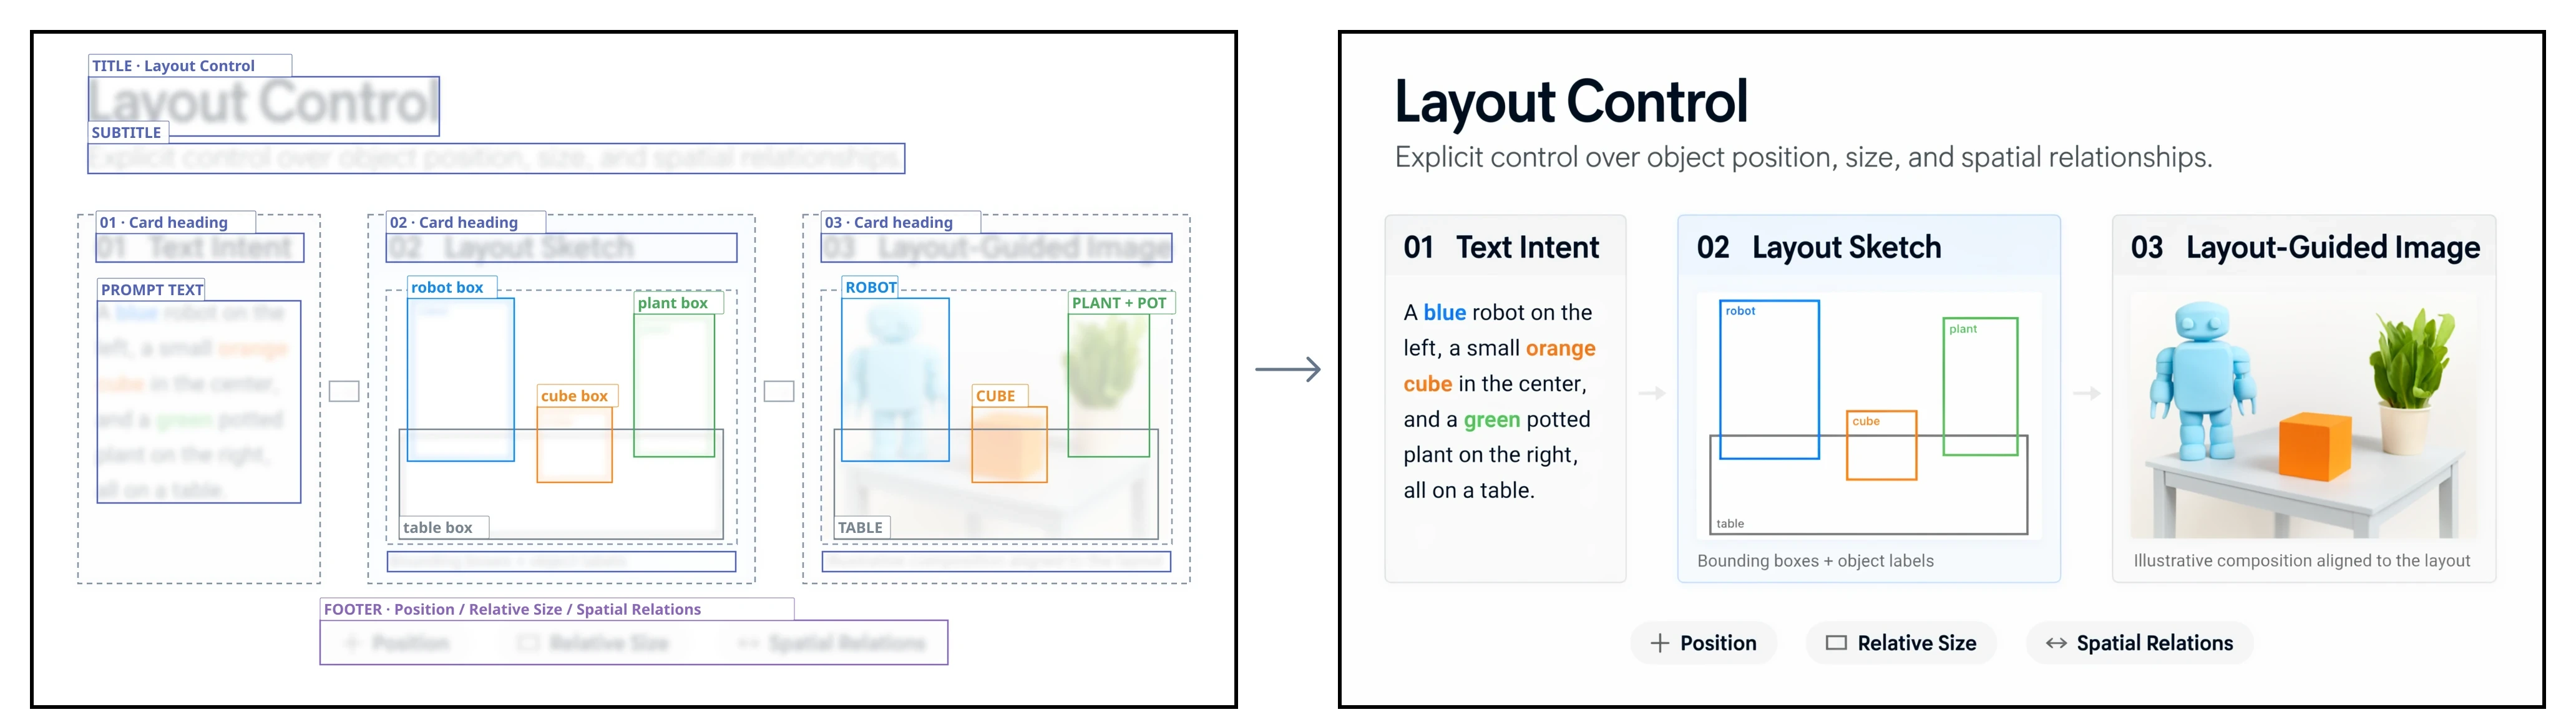 레이아웃 상자 스케치(왼쪽)와 그 레이아웃으로 생성한 이미지(오른쪽). 제목, 카드 세 장, 로봇과 큐브와 화분이 지정한 상자에 맞춰 그려졌다. 출처: OpenMOSS/MOSS-Image README
README가 예로 든 1024×1024 여행 포스터 JSON은 다음과 같다.
{
  "summary": {
    "meta": ["poster"],
    "canvas": "single",
    "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."
  },
  "items": [
    {
      "label": "text",
      "caption": "Large dark-blue uppercase title centered at the top.",
      "text": "EXPLORE",
      "bbox": [-416, -384, -288, 384]
    },
    {
      "label": "object",
      "caption": "A flat blue mountain illustration in the lower center.",
      "bbox": [-192, -288, 384, 288]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
| 필드 | 뜻 |
|---|---|
summary.caption | 장면 전체의 주제, 배경, 색감, 화풍 |
items[].label | 요소 종류(text 또는 object) |
items[].caption | 요소의 모양, 색, 글꼴 |
items[].text | 글 요소일 때 그릴 문자열 |
bbox_format: "yxyx" | 상자 좌표를 [y_min, x_min, y_max, x_max] 순서로 적는다 |
bbox_coord_space: "abs_centralized" | 캔버스 정중앙을 원점으로 삼는 픽셀 좌표. x는 오른쪽, y는 아래쪽으로 커진다 |
abs_centralized 좌표는 흔히 쓰는 왼쪽 위 기준 픽셀 좌표에서 x는 폭의 절반, y는 높이의 절반을 뺀 값이다. 1024×1024 캔버스라면 두 축 모두 -512에서 +512다. 예시에서 제목 EXPLORE의 상자는 캔버스 위쪽의 가로로 긴 띠다([-416, -384, -288, 384]). 산 그림의 상자는 가운데에서 아래쪽까지 이어지는 영역이다([-192, -288, 384, 288]).
최근 연구 가운데는 0에서 1000으로 정규화한 상대 좌표를 쓰는 사례가 있다. MOSS-Image는 캔버스 중심을 원점으로 하는 절대 픽셀 좌표를 택했고, 보고서의 사례 비교에서 이 방식이 학습 때 보지 못한 해상도에서 상대 좌표보다 잘 일반화했다.
평가: 긴 글, 배치, 사람의 선호
연구진은 생성기의 기본기를 재는 세 벤치마크(LongTextBench, LLTB, 7Bench)에서는 인핸서 없이 생성기만 평가했다. 인핸서를 포함한 시스템 전체는 사람이 결과를 고르는 RLA로 비교했다. LongTextBench의 비교 모델 점수는 공개된 보고에서 가져왔고, 나머지 세 평가는 연구진이 직접 돌렸다.
LLTB: 한 페이지 분량의 글
기존 벤치마크인 LongTextBench에서는 강한 모델들의 점수가 모두 96.05점에서 98.85점이다(MOSS-Image는 영어 98.08, 중국어 97.17). 목표 글이 평균 120.3자로 짧아서, 긴 글을 이어서 그리는 능력은 이 점수로 구분하기 어렵다. 그래서 연구진은 LLTB(LongLongTextBench)를 새로 만들었다. 영어와 중국어 각 120개, 모두 240개의 문학 텍스트를 그리게 하고 길이를 세 구간으로 구분했다. 목표 글은 평균 1,339.8자로 LongTextBench의 약 11.1배이고, 가장 짧은 과제(444자)도 LongTextBench의 가장 긴 과제(482자)와 비슷하다. 채점할 때는 생성한 이미지를 OCR로 읽어 목표 글의 단어나 글자가 얼마나 재현됐는지 잰다. 언어와 길이를 조합한 여섯 묶음의 평균이 Mean-6이다.
| 모델 | 구분 | Mean-6 | 영어 장문 | 중국어 장문 |
|---|---|---|---|---|
| GPT Image 2 | 상용 | 99.0 | 97.3 | 98.2 |
| Nano Banana Pro | 상용 | 96.6 | 97.4 | 91.4 |
| Qwen Image 3.0 Pro | 상용 | 94.3 | 96.2 | 88.5 |
| Seedream 5.0 Pro | 상용 | 55.3 | 41.7 | 13.3 |
| MOSS-Image | 오픈 | 96.3 | 97.1 | 92.4 |
| Qwen Image 2512 | 오픈 | 64.9 | 48.1 | 31.3 |
| Ideogram 4.0 | 오픈7 | 63.5 | 97.5 | 31.8 |
| ERNIE Image | 오픈 | 55.7 | 48.1 | 30.2 |
| SenseNova U1 | 오픈 | 43.9 | 22.8 | 18.7 |
| Z-Image Base | 오픈 | 40.8 | 24.9 | 24.3 |
| Krea 2 Raw | 오픈 | 31.8 | 21.6 | 13.7 |
| FLUX.2 | 오픈 | 11.8 | 4.8 | 2.9 |
MOSS-Image의 Mean-6은 96.3으로, 오픈 웨이트 2위인 Qwen Image 2512(64.9)보다 31.4점 높다. 상용 모델과 견주면 Nano Banana Pro(96.6)와 비슷하고 Qwen Image 3.0 Pro(94.3)보다 높으며, GPT Image 2(99.0)보다는 낮다. 다른 오픈 웨이트 모델은 대부분 가장 긴 구간에서 50점에 못 미쳤다. Ideogram 4.0은 영어 장문에서 97.5점을 냈지만 중국어 장문은 31.8점이었다. 연구진은 MOSS-Image도 가장 긴 중국어 구간(92.4)에서는 재현율이 낮아진다고 적었다.
7Bench: 상자대로 그리기
7Bench는 지정한 바운딩 박스에 물체가 실제로 그려졌는지 잰다. MOSS-Image는 검출된 물체의 평균 IoU(mIoU) 0.88, Layout AUC 0.70을 기록했다.8 두 번째로 높은 Ideogram 4.0은 mIoU 0.44, Layout AUC 0.20이었고, GPT Image 2는 0.30과 0.16, Nano Banana Pro는 0.33과 0.16이었다. 상용 모델은 위치를 자연어 설명으로만 전달받으므로, 이 차이에는 좌표를 직접 입력받는 구조의 덕도 있다고 볼 수 있다.
RLA: 사람이 고른 디자인
RLA(RealLayoutArena)는 시스템 전체를 비교하려고 연구진이 새로 만든 평가다. 실제 디자인 자료에서 고른 짧은 요청 61개(포스터 20, 인포그래픽 20, UI 21)를 쓴다. 한 요청에도 좋은 디자인은 여러 개일 수 있다. 그래서 정답과 대조하는 대신, 평가자가 모델 이름을 가린 두 결과를 나란히 보고 더 나은 쪽을 고른다. 기준은 지시 이행, 내용 완결성, 글 가독성, 시각적 정돈이다. 무승부와 “둘 다 나쁨"은 0.5승으로 센다. 이 승패 기록에 Bradley-Terry 모델을 맞춰 Elo 척도의 점수와 95% 신뢰구간을 낸다.9
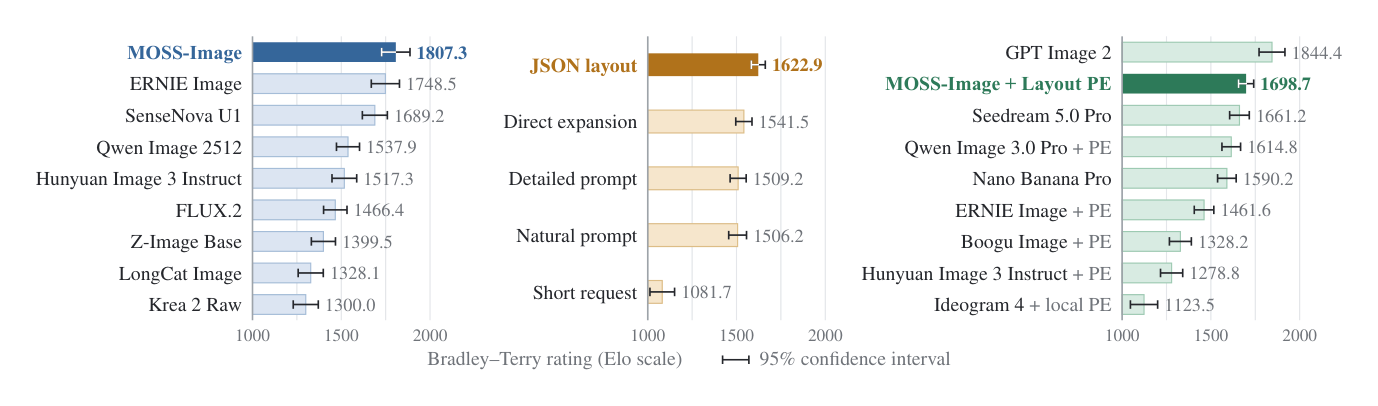 그림 4. RLA 결과. 왼쪽은 인핸서를 거친 같은 프롬프트를 받은 생성기 9개, 가운데는 MOSS-Image 하나에 넣은 프롬프트 전략 5가지, 오른쪽은 상용 모델을 포함한 시스템 9개의 비교다. 막대 끝의 선은 95% 신뢰구간이다. 출처: MOSS-Image Technical Report 그림 4
- 생성기 비교(왼쪽): 인핸서의 명세를 자연어로 다시 쓴 같은 프롬프트를 생성기 9개에 넣었다. MOSS-Image가 1,807.3점(95% 신뢰구간 1,727.44~1,887.24)으로 가장 높았고, ERNIE Image 1,748.5점, SenseNova U1 1,689.2점이 그다음이었다. 가장 낮은 Krea 2 Raw는 1,300.0점이다.
- 프롬프트 전략 비교(가운데): 생성기를 MOSS-Image로 고정하고 입력만 바꿨다. 짧은 요청을 그대로 넣었을 때는 1,081.7점에 그쳤다. 인핸서 계획을 자연어로 풀어 넣으면 1,506.2점, 사람이 쓴 자세한 설명을 넣으면 1,509.2점, 라우팅과 검색 없이 요청만 확장해 넣으면 1,541.5점, 인핸서 계획을 JSON 레이아웃으로 넣으면 1,622.9점이었다.
- 시스템 비교(오른쪽): 각 시스템이 짧은 요청을 받아 끝까지 그린 결과를 비교했다. GPT Image 2가 1,844.4점으로 1위, MOSS-Image와 레이아웃 인핸서 조합이 1,698.7점(95% 신뢰구간 1,655.96~1,741.43)으로 2위였다. 이어서 Seedream 5.0 Pro(1,661.2점), 인핸서를 붙인 Qwen Image 3.0 Pro(1,614.8점), Nano Banana Pro(1,590.2점) 순이었다.10
레이아웃만 고쳐 다시 그리기
MOSS-Image에는 기존 이미지를 입력받아 고치는 편집 기능이 없다. 대신 레이아웃 JSON의 일부만 고쳐 처음부터 다시 생성하면, 원래 디자인을 유지한 채 내용과 배치를 바꿀 수 있었다. 원본 이미지를 조건으로 넣지 않았고 추가 학습도 하지 않았다.
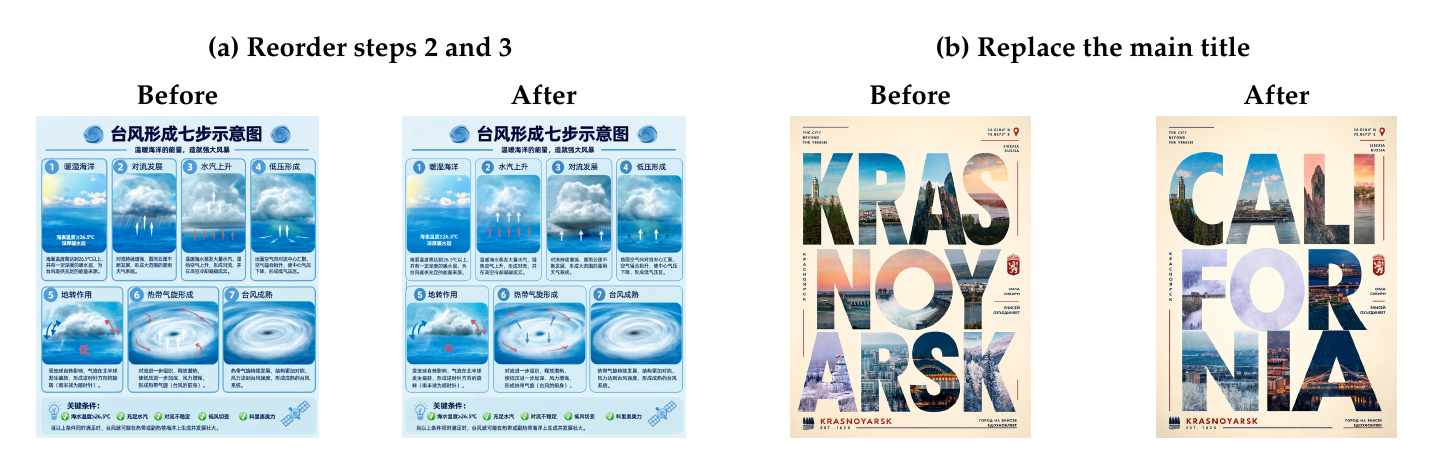 그림 8. 레이아웃만 고쳐 다시 생성한 사례. (a) 태풍 형성 7단계 인포그래픽에서 2단계와 3단계를 맞바꿨다. (b) 글자 안을 사진으로 채운 포스터의 제목을 KRASNOYARSK에서 CALIFORNIA로 바꿨다. 각 쌍의 왼쪽이 수정 전, 오른쪽이 수정 후다. 출처: MOSS-Image Technical Report 그림 8
태풍 인포그래픽에서는 2단계와 3단계의 순서를 바꾸자 두 칸의 제목과 설명, 그림이 함께 새 순서를 따랐다. 일곱 칸 구성과 파란 색조, 제목 띠, 아래쪽 요약은 그대로 남았다. 도시 포스터에서는 세 줄로 된 큰 제목을 KRASNOYARSK에서 CALIFORNIA로 바꿨다. 밝은 배경과 붉은 포인트, 주변의 작은 주석은 유지됐고, 글자 모양과 글자 안을 채운 사진이 새 단어에 맞게 달라졌다. 다시 생성하는 방식이라 세부 묘사는 매번 조금씩 다르다.
보고서는 줄바꿈의 효과도 사례로 보여 준다. 프롬프트에 줄바꿈을 명시하자, 명시하지 않았을 때보다 디노이징의 이른 단계에서 각 줄의 글자가 정해졌고 최종 이미지의 글자도 더 정확했다.
써 보려면
공개된 체크포인트는 MOSS-Image-Base와 MOSS-Image-SFT 두 가지이고, 구조와 샘플링 방식은 같다. Base는 사후학습을 하지 않았고 CFG 같은 추론 파라미터도 증류하지 않은 기본형이다. 연구진은 학습 정보를 그대로 보존해 커뮤니티가 LoRA를 학습하기 쉽게 하려고 이렇게 공개했다고 밝혔다. SFT는 Base를 선별한 데이터로 미세조정한 모델이다. README의 비교 예시에서 SFT가 그린 화이트보드는 글의 묶음과 배치가 Base보다 정돈돼 있다.
| 설정 | 권장값 | 설명 |
|---|---|---|
| 해상도 | 총 1M, 1.5M, 2M 픽셀 | 0.25M(512×512)부터 4M(2K)까지 외삽 가능. 가로와 세로는 16의 배수 |
| 스텝 | 50 이상 | 증류하지 않은 모델이라 스텝이 충분해야 한다 |
| CFG | 3.0(3.0~6.0) | 긴 프롬프트는 3.0이면 충분하고, 짧은 프롬프트는 필요한 만큼 높인다 |
| Shift | 5.0 | 플로 매칭 노이즈 스케줄의 이동값 |
| 샘플러 | Euler | 플로 매칭 Euler |
| SLG | 부정 분기에서 22번 블록 건너뛰기 | 부정 분기를 계산할 때만 22번 블록(0부터 셈)을 건너뛴다. 스텝마다 순전파가 두 번이다11 |
프롬프트는 자연어 문장, 태그 나열, 레이아웃 JSON의 세 형식을 받고, 자연어와 JSON을 섞을 수도 있다. 태그 나열은 애니메이션 화풍에 쓰는 형식이며, 권장 순서는 Quality, Score, Meta, Year, Character, Series, Artist, General이다. 사용자 가이드는 이미지 속 글의 줄바꿈을 정확히 지키고 싶으면 프롬프트에 \n이나 실제 줄바꿈을 넣으라고 권한다.
| 도구 | 지원 현황 |
|---|---|
| Diffusers | Python 3.10, PyTorch 2.9, diffusers 0.38 이상. 커스텀 파이프라인 pipeline_moss_image를 trust_remote_code=True로 불러온다. 트랜스포머와 텍스트 인코더는 bfloat16, VAE는 float32 |
| Gradio | 저장소에 포함. 모델 전체를 GPU에 올리는 모드, 구성 요소를 필요할 때만 옮기는 모드, 메모리를 가장 적게 쓰는 순차 모드 가운데 고른다 |
| ComfyUI | 10월 16일 본체에 지원이 병합됐다(커밋 e087d8f6 이후 master와 nightly). 10월 19일 기준 정식 릴리스 v0.41.3에는 아직 없다. Comfy-Org 형식 가중치를 기본 로더로 불러오고, 내장 MOSS-Image Layout Prompt 노드를 쓴다 |
| SGLang, vLLM-Omni | 공개 당일부터 지원 |
| KohakuMossTrainer | 10월 18일 공개된 커뮤니티 학습 도구. 전체 미세조정과 LoRA를 포함한 LyCORIS 학습을 지원하며, 어댑터 학습은 VRAM 6GB부터 가능하다고 소개한다 |
| DiffSynth-Studio | 전체 미세조정과 LoRA 학습 지원 |
사용자 가이드는 직접 사후학습할 때 텍스트 인코더를 학습하지 말고 동결해 두라고 안내한다.
한계
보고서는 8장에서 한계를 직접 적었다. 먼저 지금 모델은 참조 이미지를 조건으로 받지 못하고 이미지 편집 기능도 없다. 연구진은 현재 연산 예산 때문에 이 기능을 다음 과제로 남겼다. 사용자 가이드는 간단한 SFT만으로 GIF 생성과 참조 기반 생성을 끌어냈다고 밝혔지만, 공개된 체크포인트에는 아직 그 기능이 없다. 또 인핸서가 외부 LLM(GPT-6)에 기대고 있다. LLM이 미적 판단을 그르치거나 참고 자료를 잘못 읽거나 사실을 틀리면, 생성기는 그 틀린 명세를 충실하게 그릴 뿐이다. 사용자 가이드도 레이아웃 프롬프트에 실험적 기능이라는 표시를 달았다. 레이아웃까지 받게 되면서 모델을 다루기가 어려워졌고, 그 부담을 덜려고 인핸서를 붙였다는 것이 가이드의 설명이다.
보고서 밖에서 확인한 사정도 있다. LLTB와 RLA 데이터셋, 학습 레시피, 평가 프레임워크는 아직 공개 예정 상태이고, GitHub 이슈 13번에서 사용자들이 데이터셋 공개를 요청하고 있다. 공개 열흘 사이 커뮤니티가 보완 작업을 여러 개 내놓았다. SFT 모델의 세로 색 띠를 줄이는 LoRA, FP16에서 값이 넘치지 않도록 잔차 스트림을 재조정한 가중치, 50스텝 대신 8스텝으로 그리는 DMD 증류판, ComfyUI 샘플링 가속 노드다. 공식 체크포인트는 bfloat16과 50스텝 이상의 샘플링을 전제로 한 무거운 기본형이라고 보는 편이 맞다.
가장 흥미로운 지점
내가 곱씹은 것은 프롬프트만 바꿨을 때 같은 모델의 점수가 달라지는 폭이다. RLA 가운데 패널에서 MOSS-Image에 한 줄 요청을 넣었을 때와 JSON 레이아웃을 넣었을 때의 차이는 541.2점이다. 왼쪽 패널에서 같은 명세를 받은 생성기 1위(1,807.3)와 9위(1,300.0)의 차이는 507.3점이다.12 정보가 많은 그래픽에서는 어느 생성기를 고르느냐만큼이나, 무엇을 어디에 어떤 줄바꿈으로 둘지 정하는 단계가 결과를 좌우한다는 뜻으로 읽힌다.
학습 데이터를 다룬 방식도 같은 생각에서 나온 것으로 보인다. 연구진은 결함 있는 이미지를 걸러 버리는 대신, 결함과 줄바꿈까지 캡션에 적어 넣었다. 학습할 때는 이미지마다 자세한 설명을 주고, 추론할 때는 요청마다 자세한 명세를 준다. 이미지를 고르는 일보다 설명하는 일에 공을 들인 설계다. 50억 파라미터로 크지 않은 생성기가 상용 모델과 비슷한 긴 글 렌더링 점수를 낸 데에도 이 설계가 작용했을 가능성이 있다.
출처
- 기술 보고서: MOSI.AI(MOSI Intelligence, SII, 푸단대, 상하이교통대), “MOSS-Image Technical Report”, arXiv:2610.23374, 2026-10-19. https://arxiv.org/abs/2610.23374 (PDF: https://openmoss.ai/MOSS-Image/paper/MOSS_Image_Technical_Report.pdf)
- GitHub 저장소: OpenMOSS/MOSS-Image, README와 사용자 가이드, ComfyUI 문서 (https://github.com/OpenMOSS/MOSS-Image)
- Hugging Face 모델 카드: OpenMOSS-Team/MOSS-Image-Base (https://huggingface.co/OpenMOSS-Team/MOSS-Image-Base), OpenMOSS-Team/MOSS-Image-SFT (https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT)
- 프로젝트 페이지: https://openmoss.ai/MOSS-Image/
치비 서소영 삽화 2장은 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
디퓨전 트랜스포머(DiT)는 노이즈를 조금씩 제거하며(디노이징) 이미지를 복원하는 확산 모델의 신경망으로, 예전에 많이 쓰던 U-Net 대신 트랜스포머를 쓴다. ↩︎
텍스트 인코더는 프롬프트를 모델이 계산할 수 있는 벡터로 바꾸는 언어 모델이다. VAE는 픽셀 이미지를 작은 잠재 표현으로 압축했다가 생성이 끝나면 다시 픽셀로 복원한다. 동결은 사전학습된 가중치를 고정하고 생성기만 학습했다는 뜻이며, 50억 파라미터에는 텍스트 인코더와 VAE가 포함되지 않는다. ↩︎
각 출처가 데이터셋을 만들 때 이미 적용한 필터(ReLAION의 NSFW와 워터마크 검사 등)는 그대로 남아 있다. ↩︎
보고서는 이 차이의 원인을 따로 분석하지 않았다. 품질 필터가 글이 많은 이미지(문서, 간판, 화면 캡처)를 함께 걸러, 글을 그리는 법을 배울 예시가 줄었을 가능성이 있다. ↩︎
보고서 안에서도 단계 수와 스텝 수가 서로 맞지 않는다. 그림 3과 부록 A.2는 세 단계, 마지막 체크포인트 31만 스텝으로 적는다. 본문 표 1은 네 단계로 적는다(256px 210만 스텝, 512px와 256, 512 혼합 210만 스텝, 면적 1024² 이하 혼합 37만 스텝, 약 2×1024²까지 52만 스텝). ↩︎
README는 대체 GPU 플랫폼에서 학습했다고만 밝히고 기종과 규모는 적지 않았다. ↩︎
보고서 표 4는 Ideogram 4.0을 오픈소스 모델 묶음에 넣었다. 이 글의 오픈 웨이트 순위도 표의 분류를 따랐다. ↩︎
IoU는 실제로 그린 물체 영역과 지정한 상자가 겹친 부분의 면적을, 두 영역을 합친 면적으로 나눈 값이다. 1에 가까울수록 상자대로 그렸다는 뜻이다. ↩︎
그림 4의 세 패널은 비교 대상마다 따로 맞춘 점수라서, 패널이 다르면 점수를 직접 비교할 수 없다. 왼쪽 패널에는 상용 모델이 없다. ↩︎
보고서 부록 H에는 사람 대신 GPT-6에 채점 기준표를 건네 평가하게 한 보조 결과도 실려 있다. ↩︎
SLG(Skip Layer Guidance)는 CFG의 부정 분기를 계산할 때 특정 블록을 건너뛰어 세부 묘사를 또렷하게 하는 기법이다. 22번 외에 24번, 26번 블록도 화질에 도움이 된다고 한다. SLG를 끄면 사진처럼 사실적으로 나오지만 세부가 무너질 수 있다. ↩︎
두 차이는 서로 다른 패널에서 따로 맞춘 점수로 계산했으므로 대략적인 비교다. ↩︎