3줄 요약
- 밀집(dense) 트랜스포머를 학습해 본 엔지니어가 전문가 혼합(MoE) 모델의 설계부터 분산 학습, 서빙, 강화학습(RL) 사후학습까지 실무 전 과정을 익힐 수 있도록 Hugging Face의 Nouamane Tazi, Leandro von Werra, Thomas Wolf가 대규모 핸드북을 펴냈다.
- Artificial Analysis 상위 20개 오픈웨이트 모델 중 18개가 채택한 MoE에서는 라우터 점수 계산, 전문가 간 부하 균형(보조 손실, 무손실 편향, 분위수 균형), GPU 간 All-to-All 토큰 교환이 핵심 난제로 꼽힌다. 저자들은 이를 Megatron-LM과 AWS P5(H100 80GB) 클러스터의 실험 수치로 검증했다.
- 사전학습 이후 단계의 실전 구성도 제시한다. 서빙에서 활성 전문가 수(k)를 줄일 때의 재정규화 분모 보정, 라우팅 전문가의 4비트 양자화(MXFP4, NVFP4), 프리필과 디코딩에 서로 다르게 적용하는 전문가 병렬화(EP), 롤아웃 엔진과 트레이너의 라우팅 불일치를 해소하는 라우팅 리플레이(R3)가 그 내용이다.
1. 왜 지금 MoE인가: 희소 모델이 된 프론티어와 진단 지도
2026년 11월 기준 Artificial Analysis 오픈웨이트 모델 리더보드 상위 20개 모델 가운데 18개가 전문가 혼합(Mixture of Experts, MoE) 구조를 사용한다.1 상위 5개 연구소의 대표 모델인 DeepSeek V4.1 Flash 1017, GLM-5.3, MiMo-V2.6-Pro, Ling 3.1 Flash 1019, MiniMax-M3.1-Flash가 모두 MoE다.
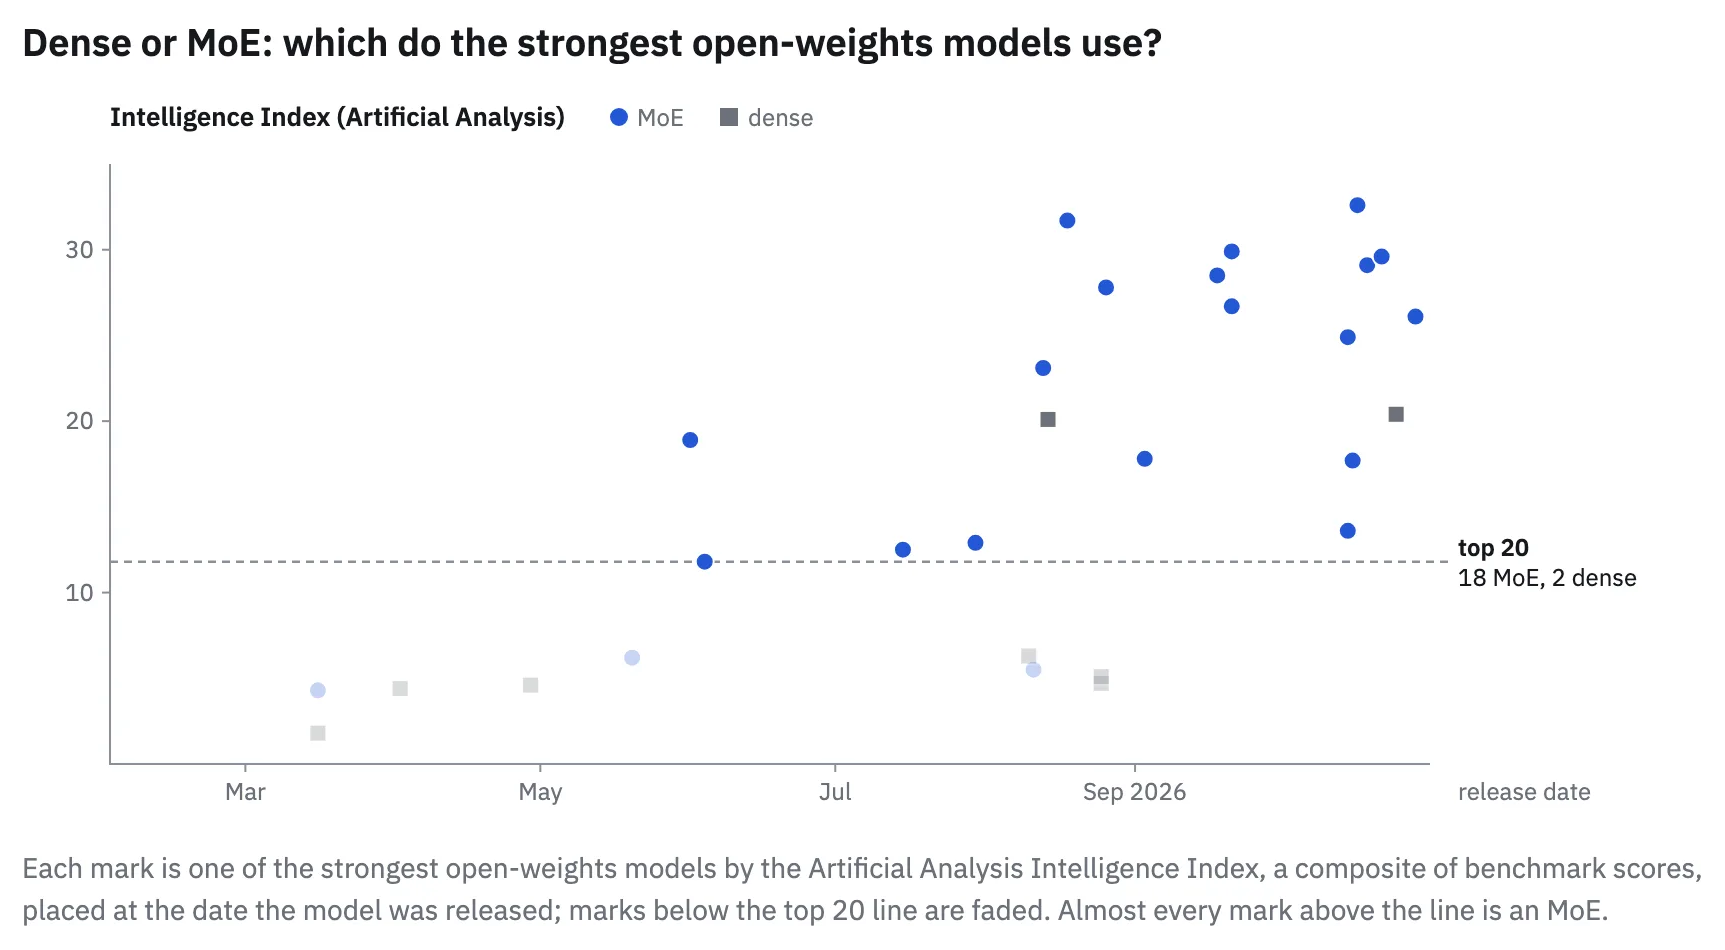 Figure 1.1: 출시 시점에 따른 오픈웨이트 모델의 총 파라미터와 토큰당 활성 파라미터 추이 (출처: Hugging Face)
MoE를 쓰는 가장 큰 이유는 토큰당 추론 연산량을 크게 줄일 수 있기 때문이다. 각 토큰은 전체 전문가(expert) 중 일부만 통과한다. 이 덕분에 모델은 토큰 하나를 처리할 때 쓰는 파라미터보다 훨씬 많은 파라미터를 보유할 수 있다. 예를 들어 2장에서 구축하는 소형 MoE는 총 파라미터가 68.6억 개(6.86B)이지만 토큰당 활성 파라미터는 12.2억 개(1.22B)다.
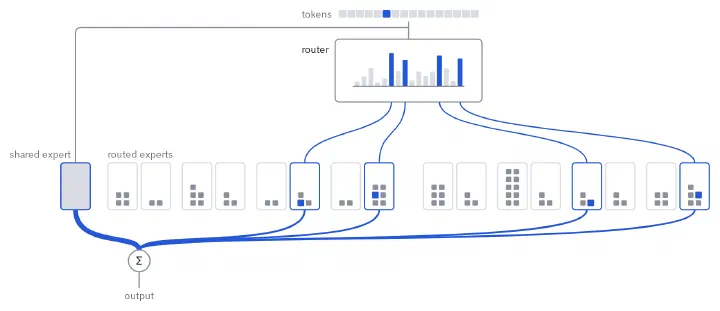
그러나 추론할 때 효율적이라고 해서 학습까지 저절로 빠르고 안정적이지는 않다. 밀집 모델에서 MoE로 전환하면 새로운 과제 세 가지가 생긴다. 첫째로 각 토큰을 어느 전문가로 보낼지 결정하는 라우터(router)를 설계해야 한다. 둘째로 전문가들의 토큰 작업량을 고르게 유지하는 부하 분산(load balancing)이 필요하다. 셋째는 GPU 간 토큰 교환(All-to-All 통신)이다. 전문가들을 여러 GPU에 분산 배치하는 전문가 병렬화(Expert Parallelism, EP) 환경에서는 이 교환이 레이어마다 일어난다. 저자들은 진단 지도도 함께 제시한다. 학습 도중 이상 징후가 나타나면 증상(slow, OOM, blows up, learns badly, won't start)과 최초 이상 신호를 기준으로 원인을 설명한 절을 찾도록 구성한 지도다.
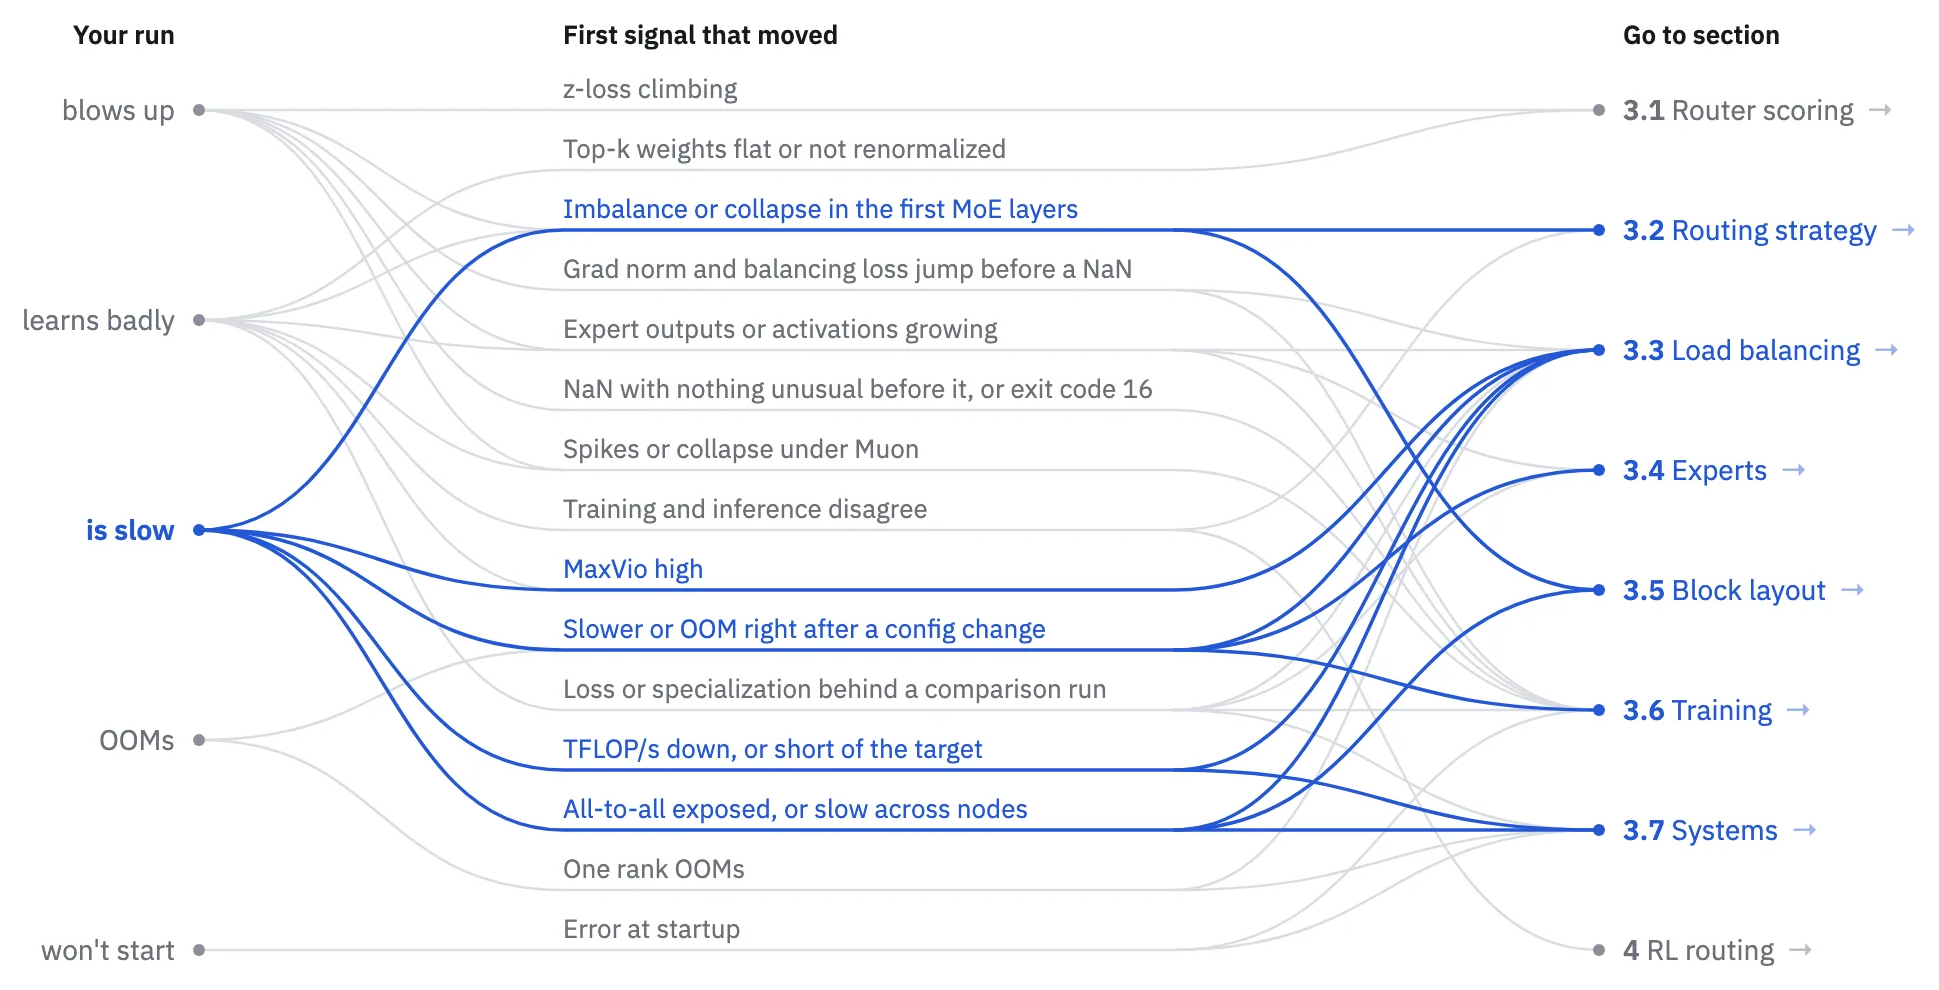 Figure 1.2: 학습 이상 증상에서 관찰 지표와 원인 분석 절로 이어지는 진단 지도 (출처: Hugging Face)
2. 클러스터 검증과 첫 6.86B MoE 학습
하드웨어와 All-to-All 네트워크 검증
MoE 레이어는 All-to-All 통신을 두 번 수행한다. 토큰을 담당 전문가가 있는 GPU로 보낼 때(dispatch)와 계산된 출력을 원래 GPU로 회수할 때(combine)다. 밀집 모델에서 흔히 확인하는 All-Reduce 대역폭이 정상이어도 All-to-All 대역폭은 심각하게 낮을 수 있다. 저자들이 2노드(H100 16대)에서 측정한 별도 할당 환경은 NCCL 튜닝 변수가 설정되어 있었다. All-Reduce 대역폭은 398.52 GB/s였지만, 8 GiB 버퍼 기준 All-to-All 버스 대역폭(busbw)은 39.84 GB/s로 정상 기준치 77.14 GB/s의 절반에 그쳤다.
노드 수가 늘어날수록 노드 간 패브릭(AWS EFA 또는 InfiniBand)을 통과하는 트래픽 비율이 높아진다. 저자들의 클러스터 실측에서 All-to-All 대역폭은 2노드 77.14 GB/s, 4노드 39.25 GB/s, 8노드 30.91 GB/s로 감소했다. 따라서 노드 수별로 정상 기준치를 따로 측정하고 그 값의 90% 이상을 통과 조건으로 삼아야 한다. 또한 컨테이너 실행 시 LD_LIBRARY_PATH에 호스트 RDMA와 EFA 라이브러리 경로를 우선 지정하고 NCCL_DEBUG=INFO 로그에서 Using network Libfabric(또는 InfiniBand의 경우 IB)이 출력되는지 확인해야 한다. 만약 Using network Socket으로 폴백되면 2노드 EP16 학습 속도가 42.0 TFLOP/s에서 1.7 TFLOP/s로 약 25배 느려진다.
1.22B 밀집 기준선을 6.86B MoE로 전환하기
핸드북은 모델 변경의 효과를 데이터나 인프라 문제와 구분하기 위해 기준선(baseline)부터 만든다. 16레이어, 은닉 차원 2,048, FFN 폭 8,192인 1.22B 밀집 모델을 FineWeb-Edu 데이터셋(Llama 3.2 토크나이저, 문서 경계 토큰 128001)으로 단일 노드(H100 8대)에서 120 스텝 학습한다.2
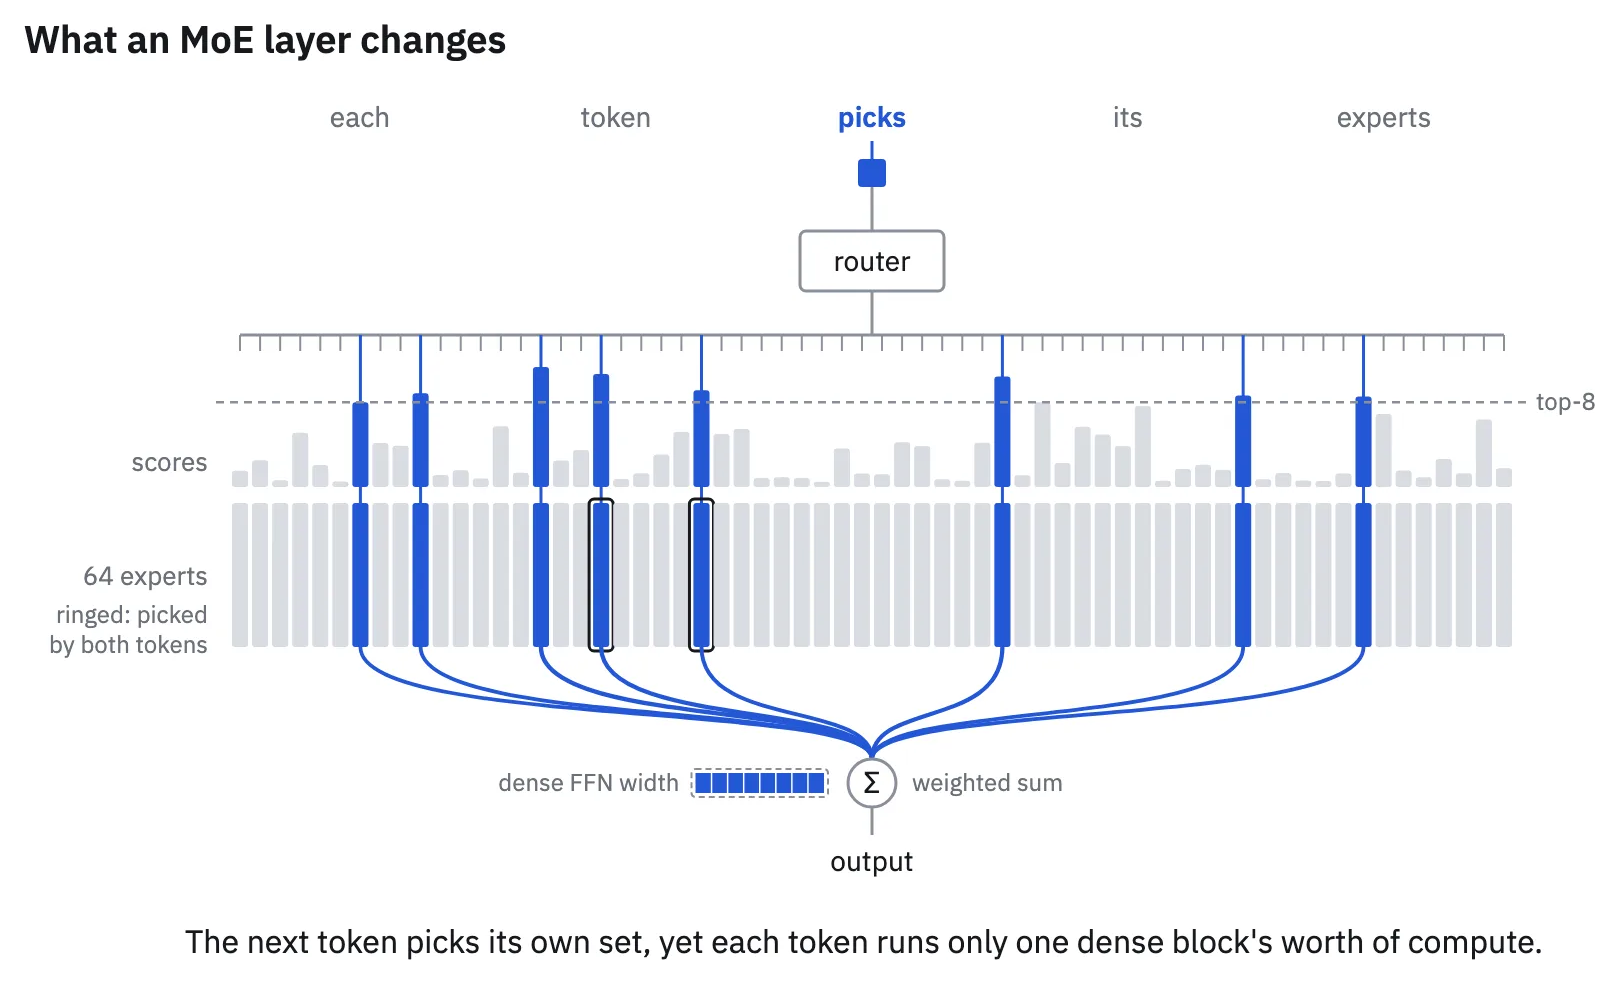 Figure 2.5.1: 1.22B 밀집 모델을 활성 파라미터가 같은 6.86B MoE(64개 전문가 중 Top-8 선택)로 확장하는 구성 (출처: Hugging Face)
이후 각 레이어의 폭 8,192짜리 밀집 SwiGLU FFN(3 × 2,048 × 8,192 = 50,331,648 파라미터)을 폭 1,024짜리 라우팅 전문가 64개(--num-experts 64 --moe-ffn-hidden-size 1024)로 교체한다. 각 토큰이 전문가 64개 중 8개(--moe-router-topk 8)를 선택하면 토큰당 활성 FFN 파라미터는 8 × 3 × 2,048 × 1,024 = 50,331,648개로 밀집 모델과 정확히 일치한다. 반면 레이어당 저장하는 FFN 파라미터는 8배인 4억 270만 개로 늘어난다. 어텐션과 임베딩을 합친 전체 모델 크기는 밀집 기준선의 약 5.6배인 6.86B가 되고, 활성 파라미터는 1.221B다. --expert-model-parallel-size 8로 전문가 64개를 GPU 8대에 8개씩 분산 배치한다.
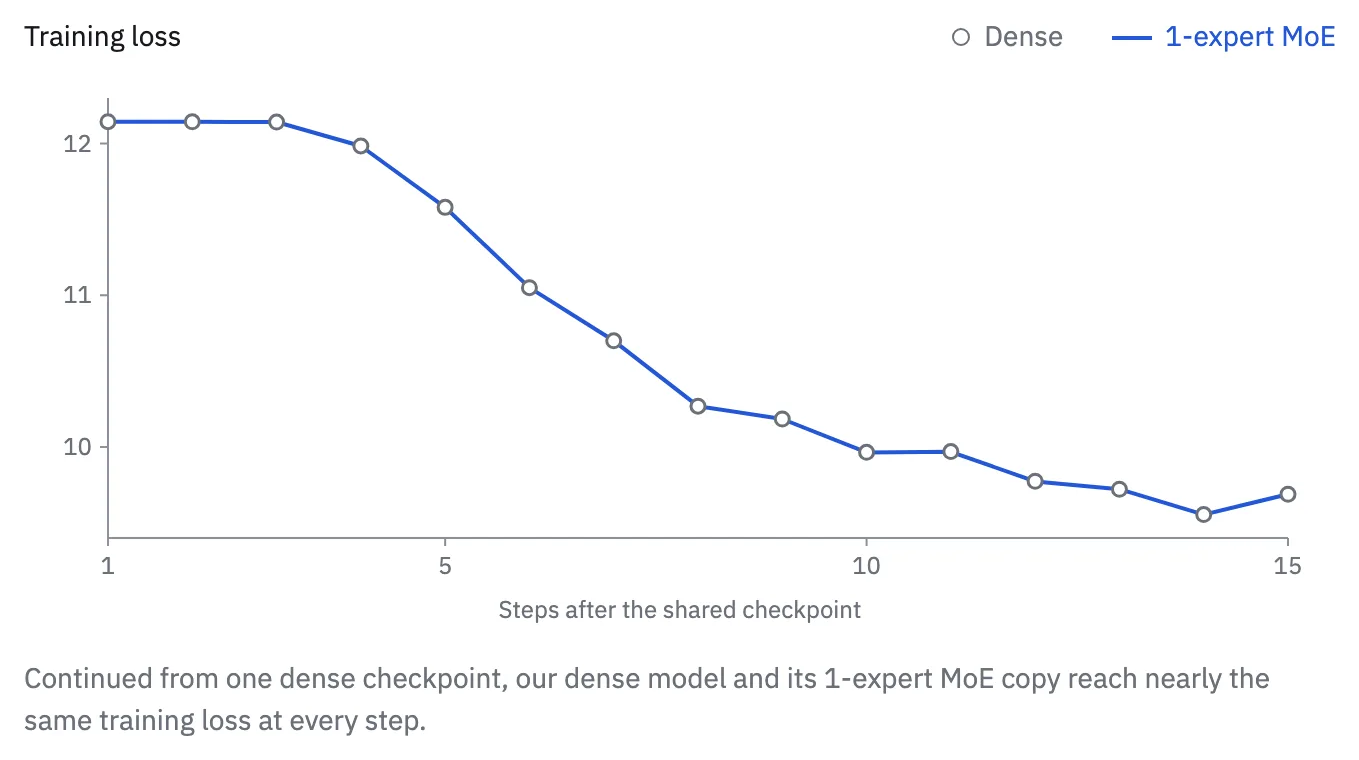 Figure 2.5.3: 밀집 체크포인트를 업사이클링한 전문가 1개짜리 MoE의 궤적 일치와 결정론적 모드 검증 (출처: Hugging Face)
본격적인 실험에 앞서 핸드북은 건전성 검증(sanity check) 두 가지를 권한다. 첫째, 밀집 체크포인트를 전문가 1개, Top-1인 MoE로 업사이클링해 밀집 모델과 같은 손실 곡선(15 스텝 동안 차이 0.00087 이내)을 그리는지 확인한다. 둘째, 두 실행을 비교하거나 NaN을 추적할 때는 --deterministic-mode를 켜고 NVTE_ALLOW_NONDETERMINISTIC_ALGO=0으로 설정한 뒤 비결정론적 커널(--cross-entropy-loss-fusion 등)을 끈다. 그런 다음 반복 실행에서 매 스텝 손실과 기울기 노름이 똑같이 나오는지 검증한다.
3. MoE 학습 해부: 라우터부터 시스템 최적화까지
3.1 라우터 점수 계산: 게이팅 함수, 출력 스케일, 정밀도
라우터는 각 토큰의 은닉 상태를 전문가 수만큼의 로짓(logit)으로 변환한 뒤 상위 $k$개 전문가를 고르고 가중합에 쓸 가중치를 산출한다. 이 과정에서 정할 것은 네 가지다. 게이팅 함수, 출력 스케일(재정규화와 스케일링 계수), 분포의 뾰족함(sharpness), 연산 정밀도다.
| 모델 | 게이팅 함수 | 활성 / 전체 전문가 | 재정규화 후 배수 | 뾰족함 제어 | 추론 코드 정밀도 |
|---|---|---|---|---|---|
| DeepSeek‑V4.1‑Flash | $\sqrt{\text{softplus}}$ | 6/384 | 1.5배 | 온도 1.0 | FP32 |
| Gemma 4 26B‑A4B | Softmax | 8/128 | 학습 스케일 | RMSNorm, $1/\sqrt{d}$ | BF16 |
| GLM‑5.3 | Sigmoid | 8/256 | 2.5배 | 없음 | FP32 |
| Kimi K3 | Sigmoid | 16/896 | 1.0배 | 없음 | FP32 |
| MiMo‑V2.6‑Pro‑RL | Sigmoid | 8/384 | 1.0배 | 없음 | FP32 |
| Qwen3.8‑Flash‑Next | Softmax | 10/- | 1.0배 | 없음 | BF16 |
| Step‑5‑Preview | Sigmoid | 8/352 | 3.0배 | 없음 | FP32 |
게이팅 함수인 Softmax, Sigmoid, $\sqrt{\text{softplus}}$는 모두 단조 증가 함수다. 따라서 편향 항이 없을 때 전문가 순위는 바꾸지 않지만, 선택된 전문가들 사이의 가중치 비율은 달라진다. 로짓 크기가 커질수록 Softmax는 1위 전문가에 가중치를 집중시킨다. Sigmoid에서는 상위 전문가들의 점수가 모두 1에 수렴해, 재정규화 후 $1/k$씩 같은 가중치를 갖는다. DeepSeek-V4가 채택한 $\sqrt{\text{softplus}}$는 Softmax처럼 한 전문가에 쏠리지도 않고 Sigmoid처럼 완전히 평평해지지도 않는 완만한 곡선을 그린다. Megatron에서 무손실 전문가 편향(3.3절)을 쓸 때는 Softmax를 허용하지 않으므로 Sigmoid나 $\sqrt{\text{softplus}}$를 선택해야 한다.
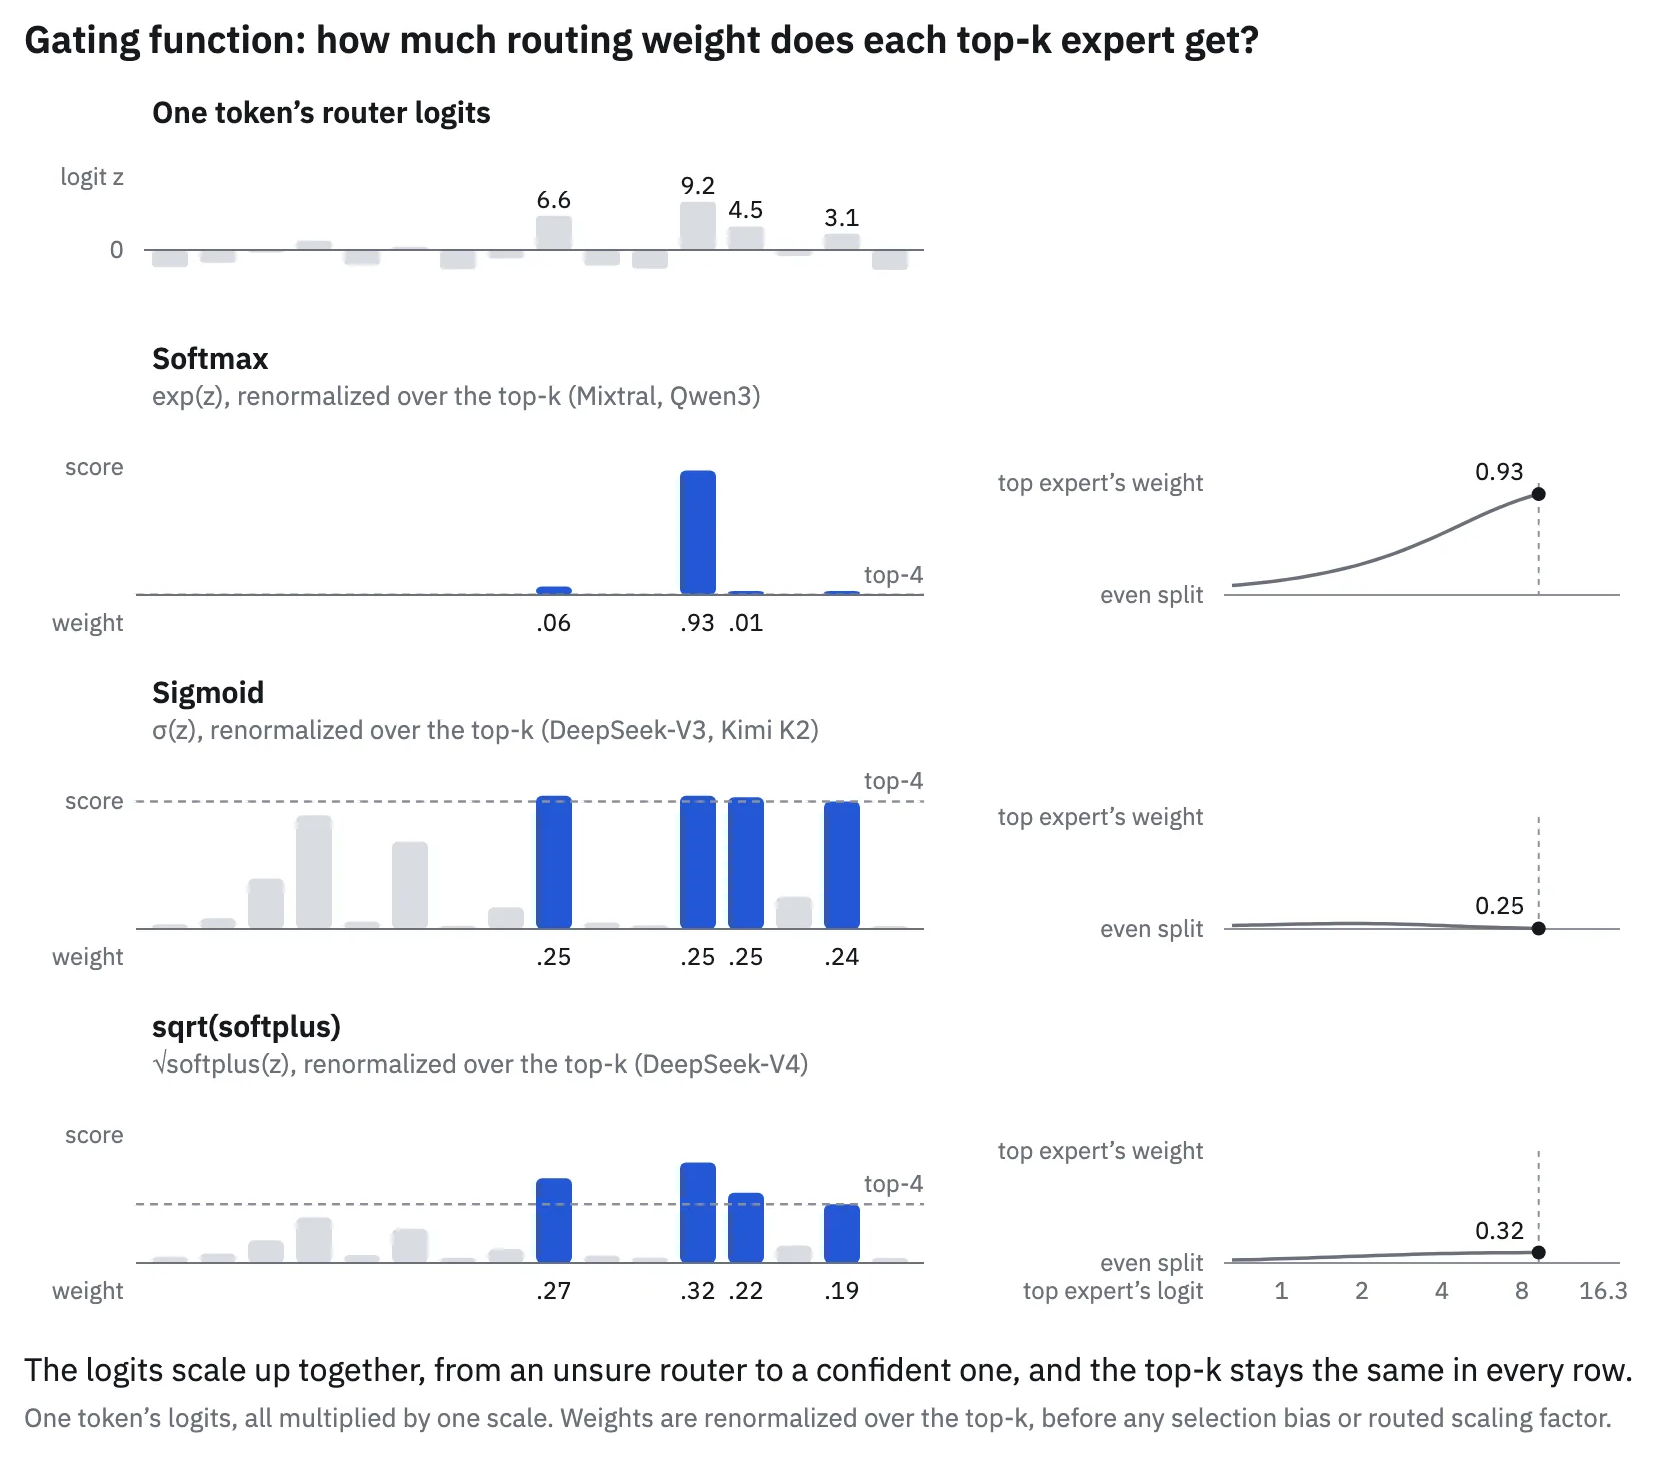 Figure 3.1.1: 라우터 확신도(로짓 스케일)가 커질 때 Softmax, Sigmoid, sqrt(softplus)의 상위 전문가 가중치 분포 변화 (출처: Hugging Face)
재정규화(renormalization)는 선택된 $k$개 전문가의 가중치 합을 1로 맞춘다. 이렇게 하면 출력 크기가 토큰별 상위 $k$개 확률 질량에 따라 달라지지 않는다. Krajewski 등의 실험에서는 세분성 8 조건에 재정규화를 적용하자 검증 손실이 2.219에서 2.183으로 낮아졌다.3 한편 서로 상관이 없는 전문가 $k$개를 같은 가중치($1/k$)로 합산하면 출력의 제곱평균제곱근(RMS)이 단일 전문가의 $1/\sqrt{k}$로 줄어든다. 이를 보정하려고 DeepSeek-V3와 GLM-5.3은 2.5, Step-5-Preview는 3.0처럼 $\sqrt{k}$와 비슷한 라우팅 스케일링 계수를 곱한다. 또한 라우터 가중치가 평탄해져 1위와 2위 가중치 비율(Max1/Max2)이 1로 수렴하면 학습 품질이 저하되는데, Skywork-MoE는 게이팅 로짓 정규화로 이를 해결했다.
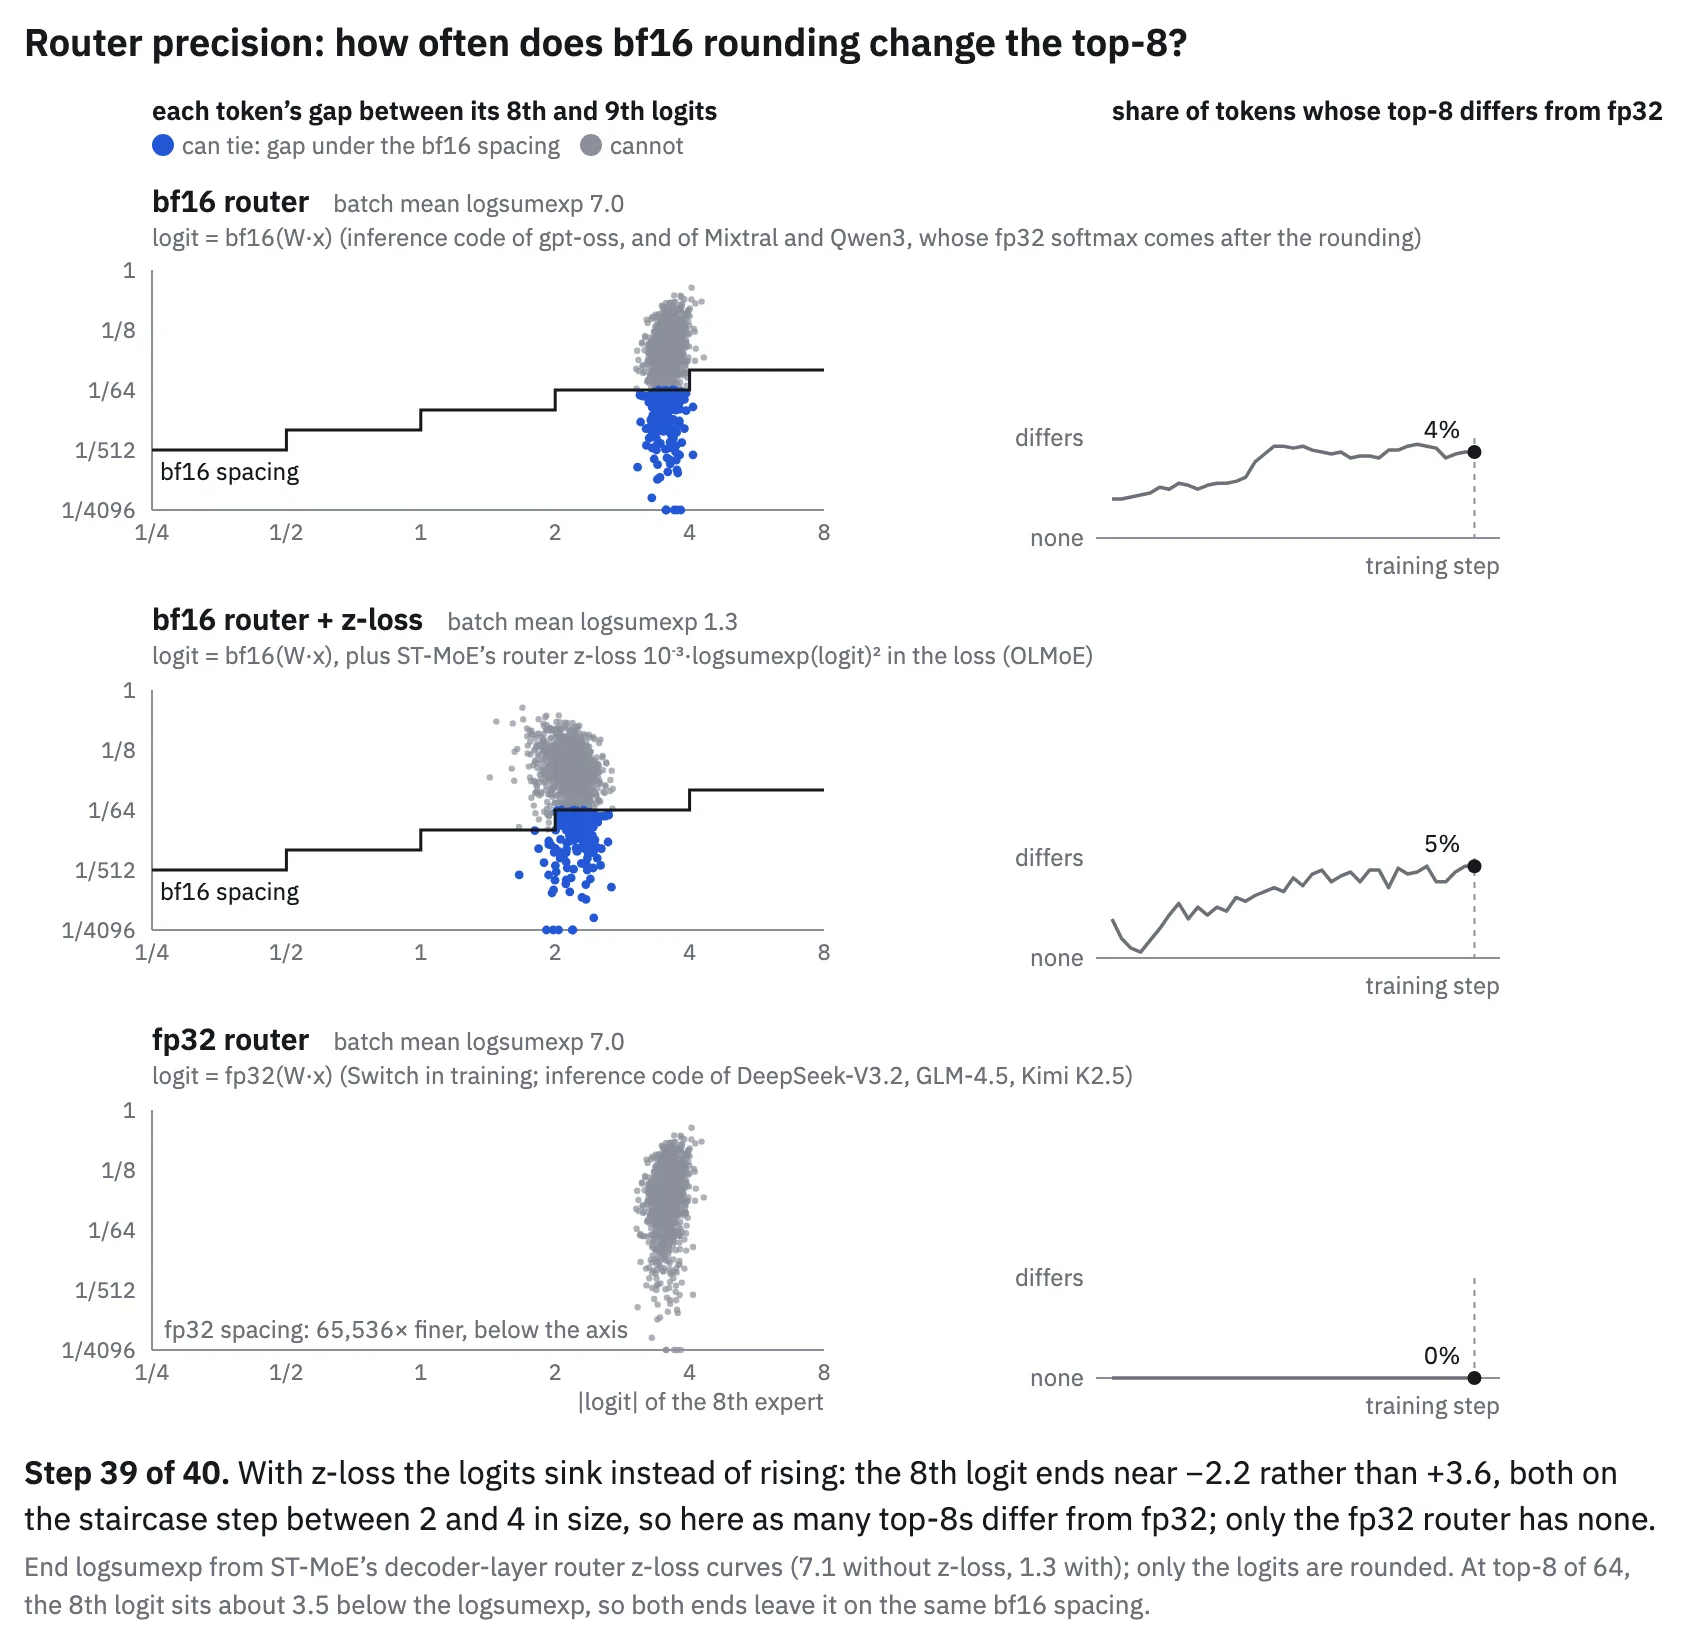 Figure 3.1.4: 로짓 오프셋 상승 시 BF16 라우터에서 FP32보다 선택 전문가가 달라지는 토큰 비율과 z-loss의 영향 (출처: Hugging Face)
연산 정밀도는 앞의 세 요소와 달리 토큰마다 선택되는 전문가 자체를 직접 바꾼다. BF16은 정밀도가 낮아, 값이 비슷한 두 로짓이 같은 값으로 반올림되면서 동점(tie)이 생긴다. 이 때문에 FP32 라우터와 다른 전문가를 고르는 뒤집힘(flip)이 일어난다. 표에서 추론 코드 정밀도가 BF16인 Gemma 4와 Qwen3.8-Flash-Next도 Softmax 계산은 FP32로 수행하며, Kimi K3는 사후학습 QAT 중 MXFP4 초과 정밀도로 라우터를 보호한다. Switch Transformers에서도 BF16 라우터는 발산했지만 FP32 라우터는 BF16과 같은 속도로 안정적으로 학습됐다. 따라서 --moe-router-dtype fp32는 모든 실행에서 기본으로 켜야 하며, Softmax 라우터에서 로짓이 계속 커질 때는 ST-MoE와 같게 --moe-z-loss-coeff 1e-3을 추가한다.
3.2 라우팅 전략: 누가 어떻게 선택하는가
기본 방식인 토큰 선택(Token Choice) Top-$k$에서는 각 토큰이 전문가를 고르므로 인기 있는 전문가에 토큰이 몰릴 수 있다. 이와 달리 각 전문가가 상위 토큰을 정해진 용량만큼 고르는 전문가 선택(Expert Choice) 방식은 부하를 완벽하게 균등화하지만, 미래 토큰 누수(future token leakage)가 생긴다. 현재 토큰의 라우팅 여부가 미래 토큰들의 점수에 좌우되므로, 자기회귀 추론에서는 학습 때와 다르게 동작한다. Sun 등이 제안한 전문가 임계값(Expert Threshold) 라우팅은 이전 배치의 점수 분포에서 구한 임계값을 써서 미래 토큰 참조 없이 부하를 고르게 유지하지만 토큰마다 선택되는 전문가 수가 달라진다.
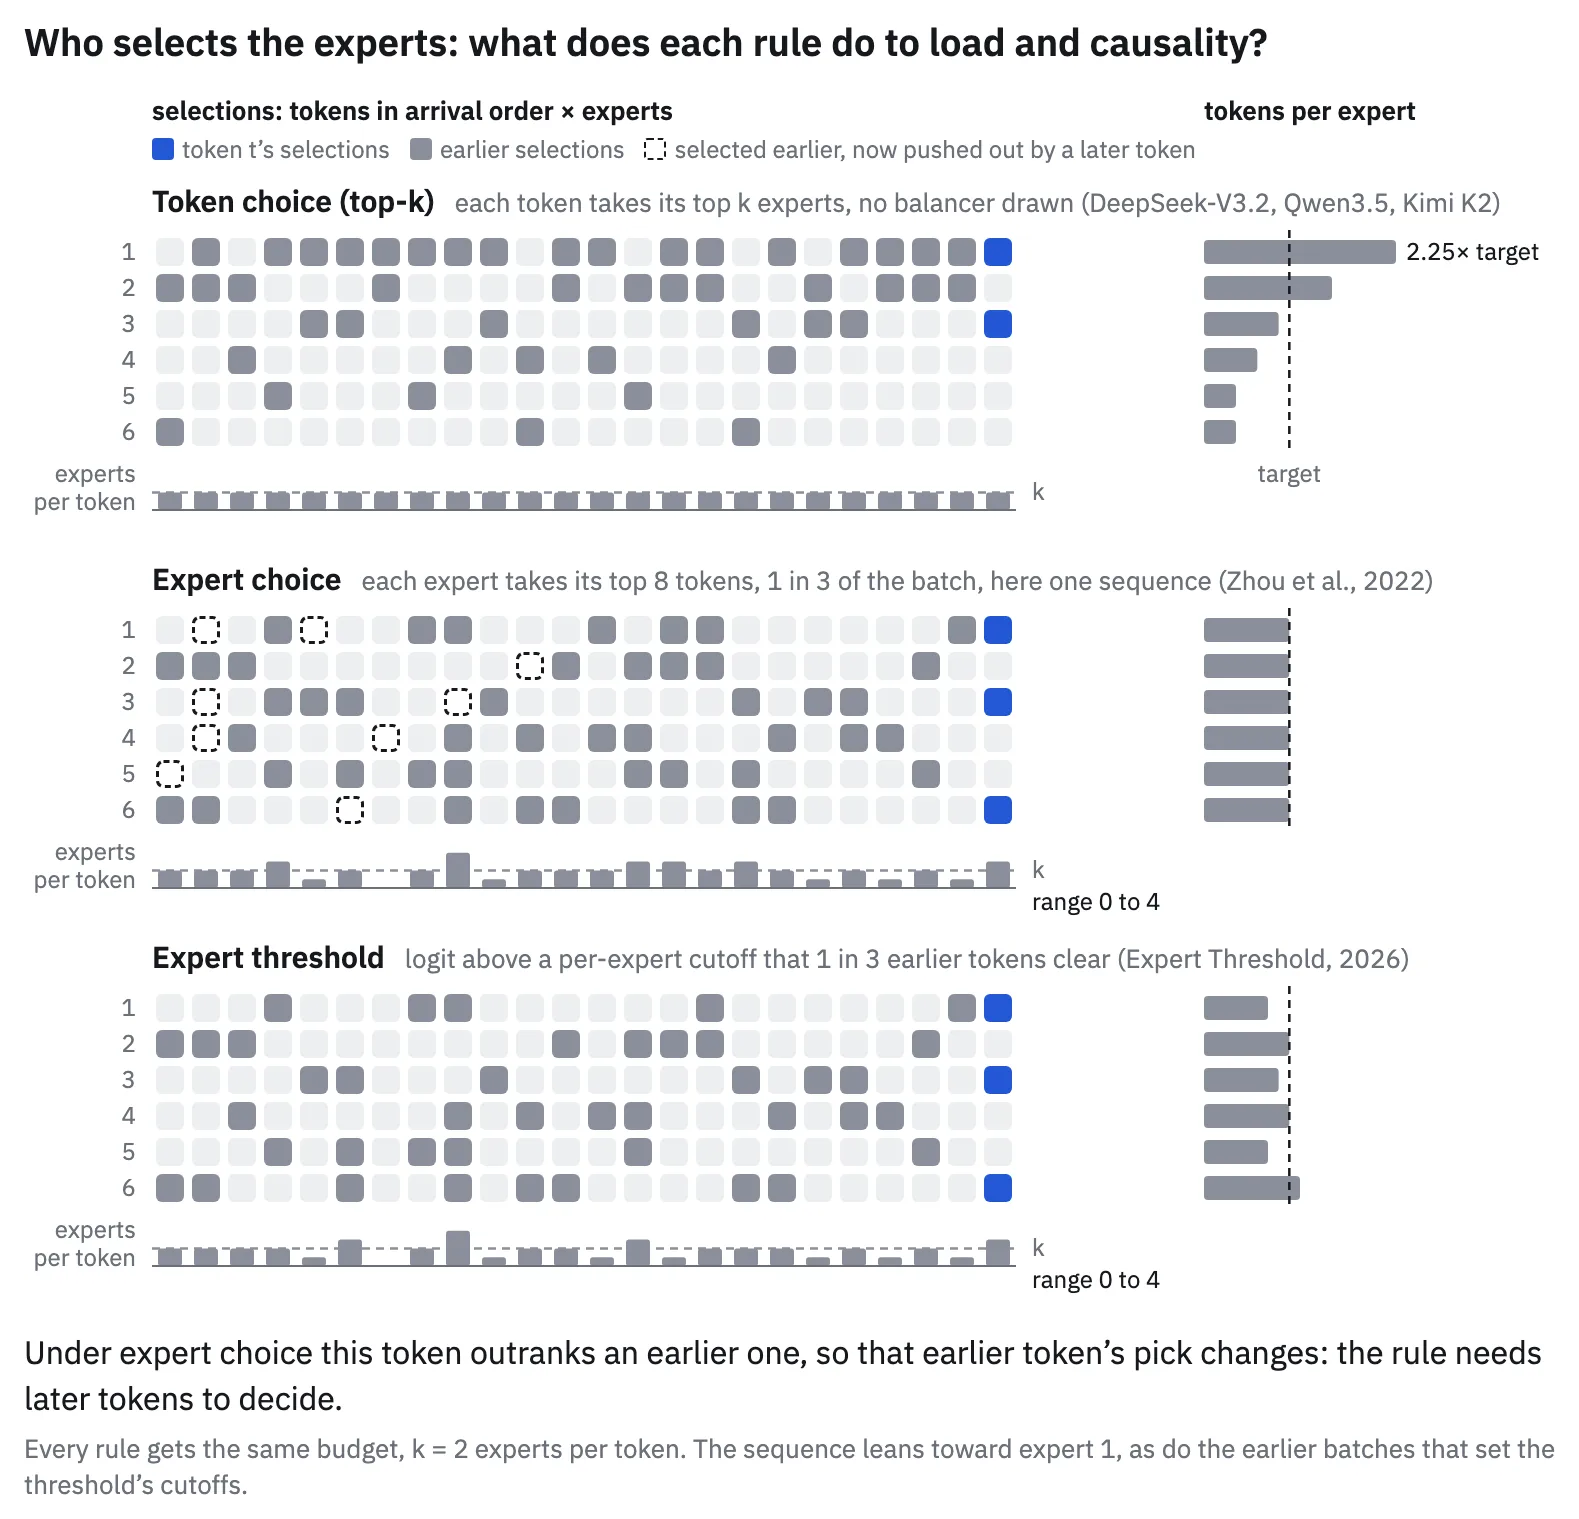 Figure 3.2.1: 특정 전문가 선호가 있을 때 Token Choice, Expert Choice, Expert Threshold의 토큰 배정 비교 (출처: Hugging Face)
해시 레이어(Hash layers)는 학습된 라우터 대신 토큰 ID의 고정 해시 테이블로 전문가를 정한다. DeepSeek-V4가 처음 3개 MoE 레이어에 도입했다. 그러나 해시 레이어는 문맥과 상관없이 같은 단어(예: "the")를 항상 같은 전문가들로 보낸다. MoE 레이어 수가 늘어날수록 학습된 라우터에 비해 손실 개선도 정체된다. 게다가 빈출 토큰 때문에 특정 전문가에 부하가 몰려도 편향으로 재조정할 방법이 없다. 후속 모델인 DeepSeek-V4.1-Flash는 해시 라우팅을 폐기하고 모든 레이어의 전문가 선택을 학습된 라우터에 맡겼다. 1번과 14번 레이어에는 2-gram에서 4-gram까지의 임베딩을 조회하는 모듈 Engram만 남겼다.
3.3 부하 분산: 보조 손실, 무손실 편향, 분위수 균형
토큰이 소수 전문가에 몰리면 두 가지 손해가 생긴다. 첫째, 가장 바쁜 전문가를 보유한 GPU가 끝날 때까지 나머지 GPU가 대기하므로 스텝 시간이 길어진다. 둘째, 선택받지 못한 전문가들의 파라미터가 낭비된다. 부하 불균형 정도를 나타내는 핵심 지표는 MaxVio(최대 위반도)다. 가장 바쁜 전문가의 토큰 수가 평균 부하를 초과한 비율로, 완전 균등이면 0, 평균의 2배면 1이다.
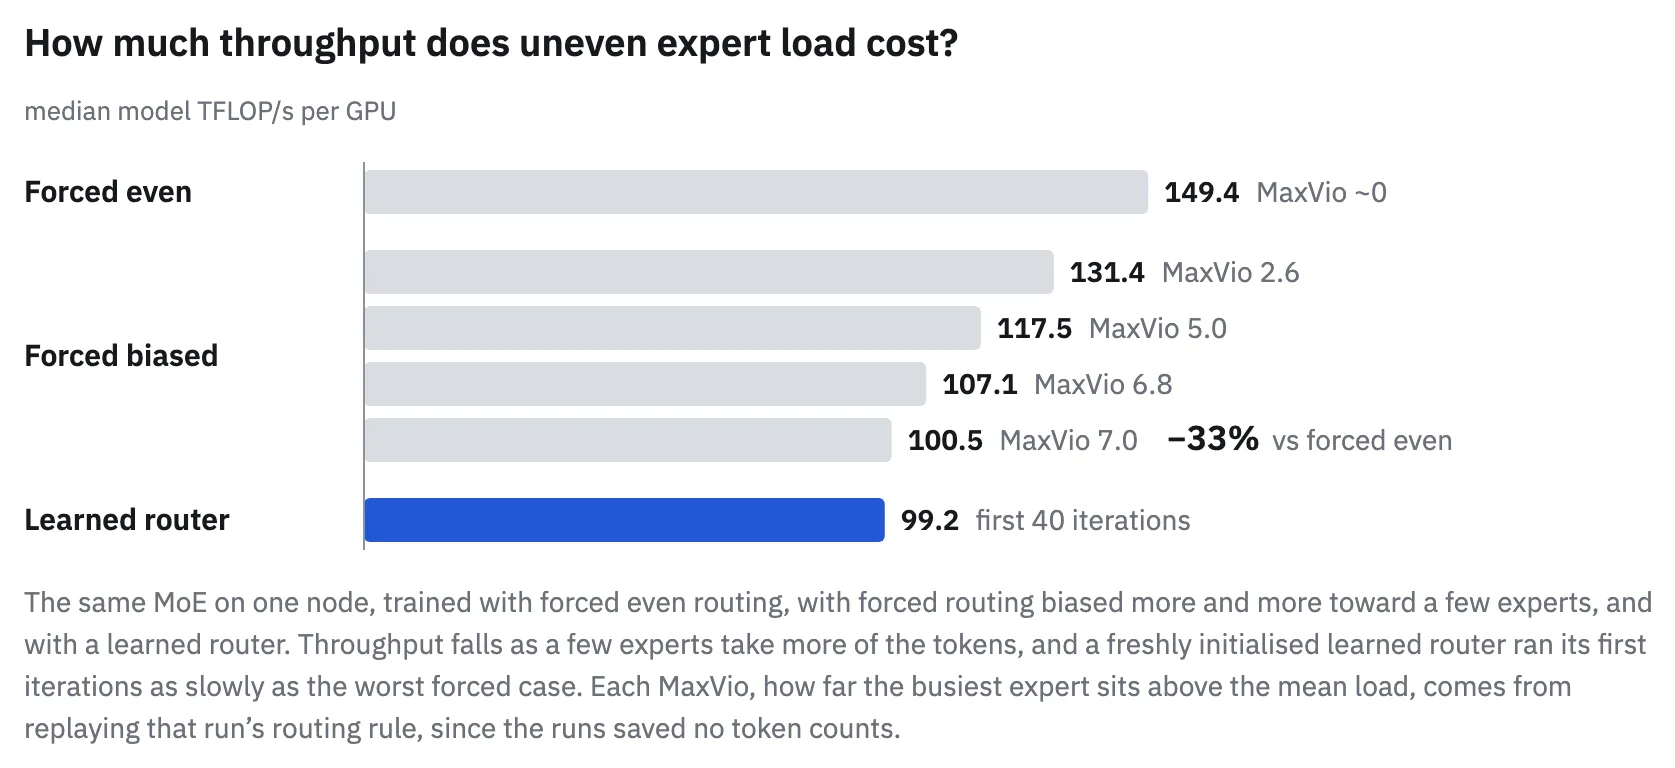 Figure 3.3.1: 강제 균등 라우팅(149.4 TFLOP/s)과 비교한 편향 증가 시 처리량 감소와 초기 학습 라우터의 추이 (출처: Hugging Face)
저자들이 --moe-router-force-load-balancing으로 무작위 균등 라우팅을 강제한 대조군 실험에서는 처리량이 149.4 TFLOP/s에 달했지만, 극단적인 불균형(MaxVio 7)을 강제하자 100.5 TFLOP/s로 떨어졌다. 막 초기화한 학습 라우터도 처음 40 스텝 동안은 속도가 최악의 불균형 대조군과 비슷하다. 최신 프론티어 모델들은 다음과 같이 서로 다른 부하 균형 전략을 조합한다.
- DeepSeek-V3: 배치 전체에서 집계하는 고정 업데이트 폭의 무손실 전문가 편향을 주력으로 쓰고, 계수
0.0001의 시퀀스 단위 보조 손실을 보충한다. - DeepSeek-V4.1-Flash: 시퀀스 단위 보조 손실(계수
0.0001)에 더해 텍스트와 이미지 모달리티별로 분리된 무손실 편향(업데이트 폭0.001)을 둔다. - Kimi K3: 보조 손실 없이(Aux-loss-free) 글로벌 배치 히스토그램으로 점수 분포의 분위수를 추정해 다음 스텝의 선택 편향에 반영한다.
- LongCat-Flash: 항등 전문가를 제외한 라우팅 전문가들에 PID 제어 기반 편향을 적용하고, 시퀀스 내 디바이스 단위 균형 손실을 함께 쓴다.
- Qwen3 MoE: 선택 편향 없이 글로벌 배치 범위에서 집계한 균형 보조 손실만으로 부하를 맞춘다.
가장 널리 쓰이는 보조 손실(Aux loss)은 각 전문가의 토큰 점유율과 평균 라우터 확률의 곱을 모두 더해 손실 항으로 쓴다(--moe-router-load-balancing-type aux_loss --moe-aux-loss-coeff 1e-3). 그러나 보조 손실의 기울기는 언어 모델링(LM) 손실의 기울기와 정면으로 경쟁한다. 계수가 너무 크면(예: 1e-2 이상) LM 손실이 악화되고, 너무 작으면(예: 1e-4) 불균형이 남는다.4
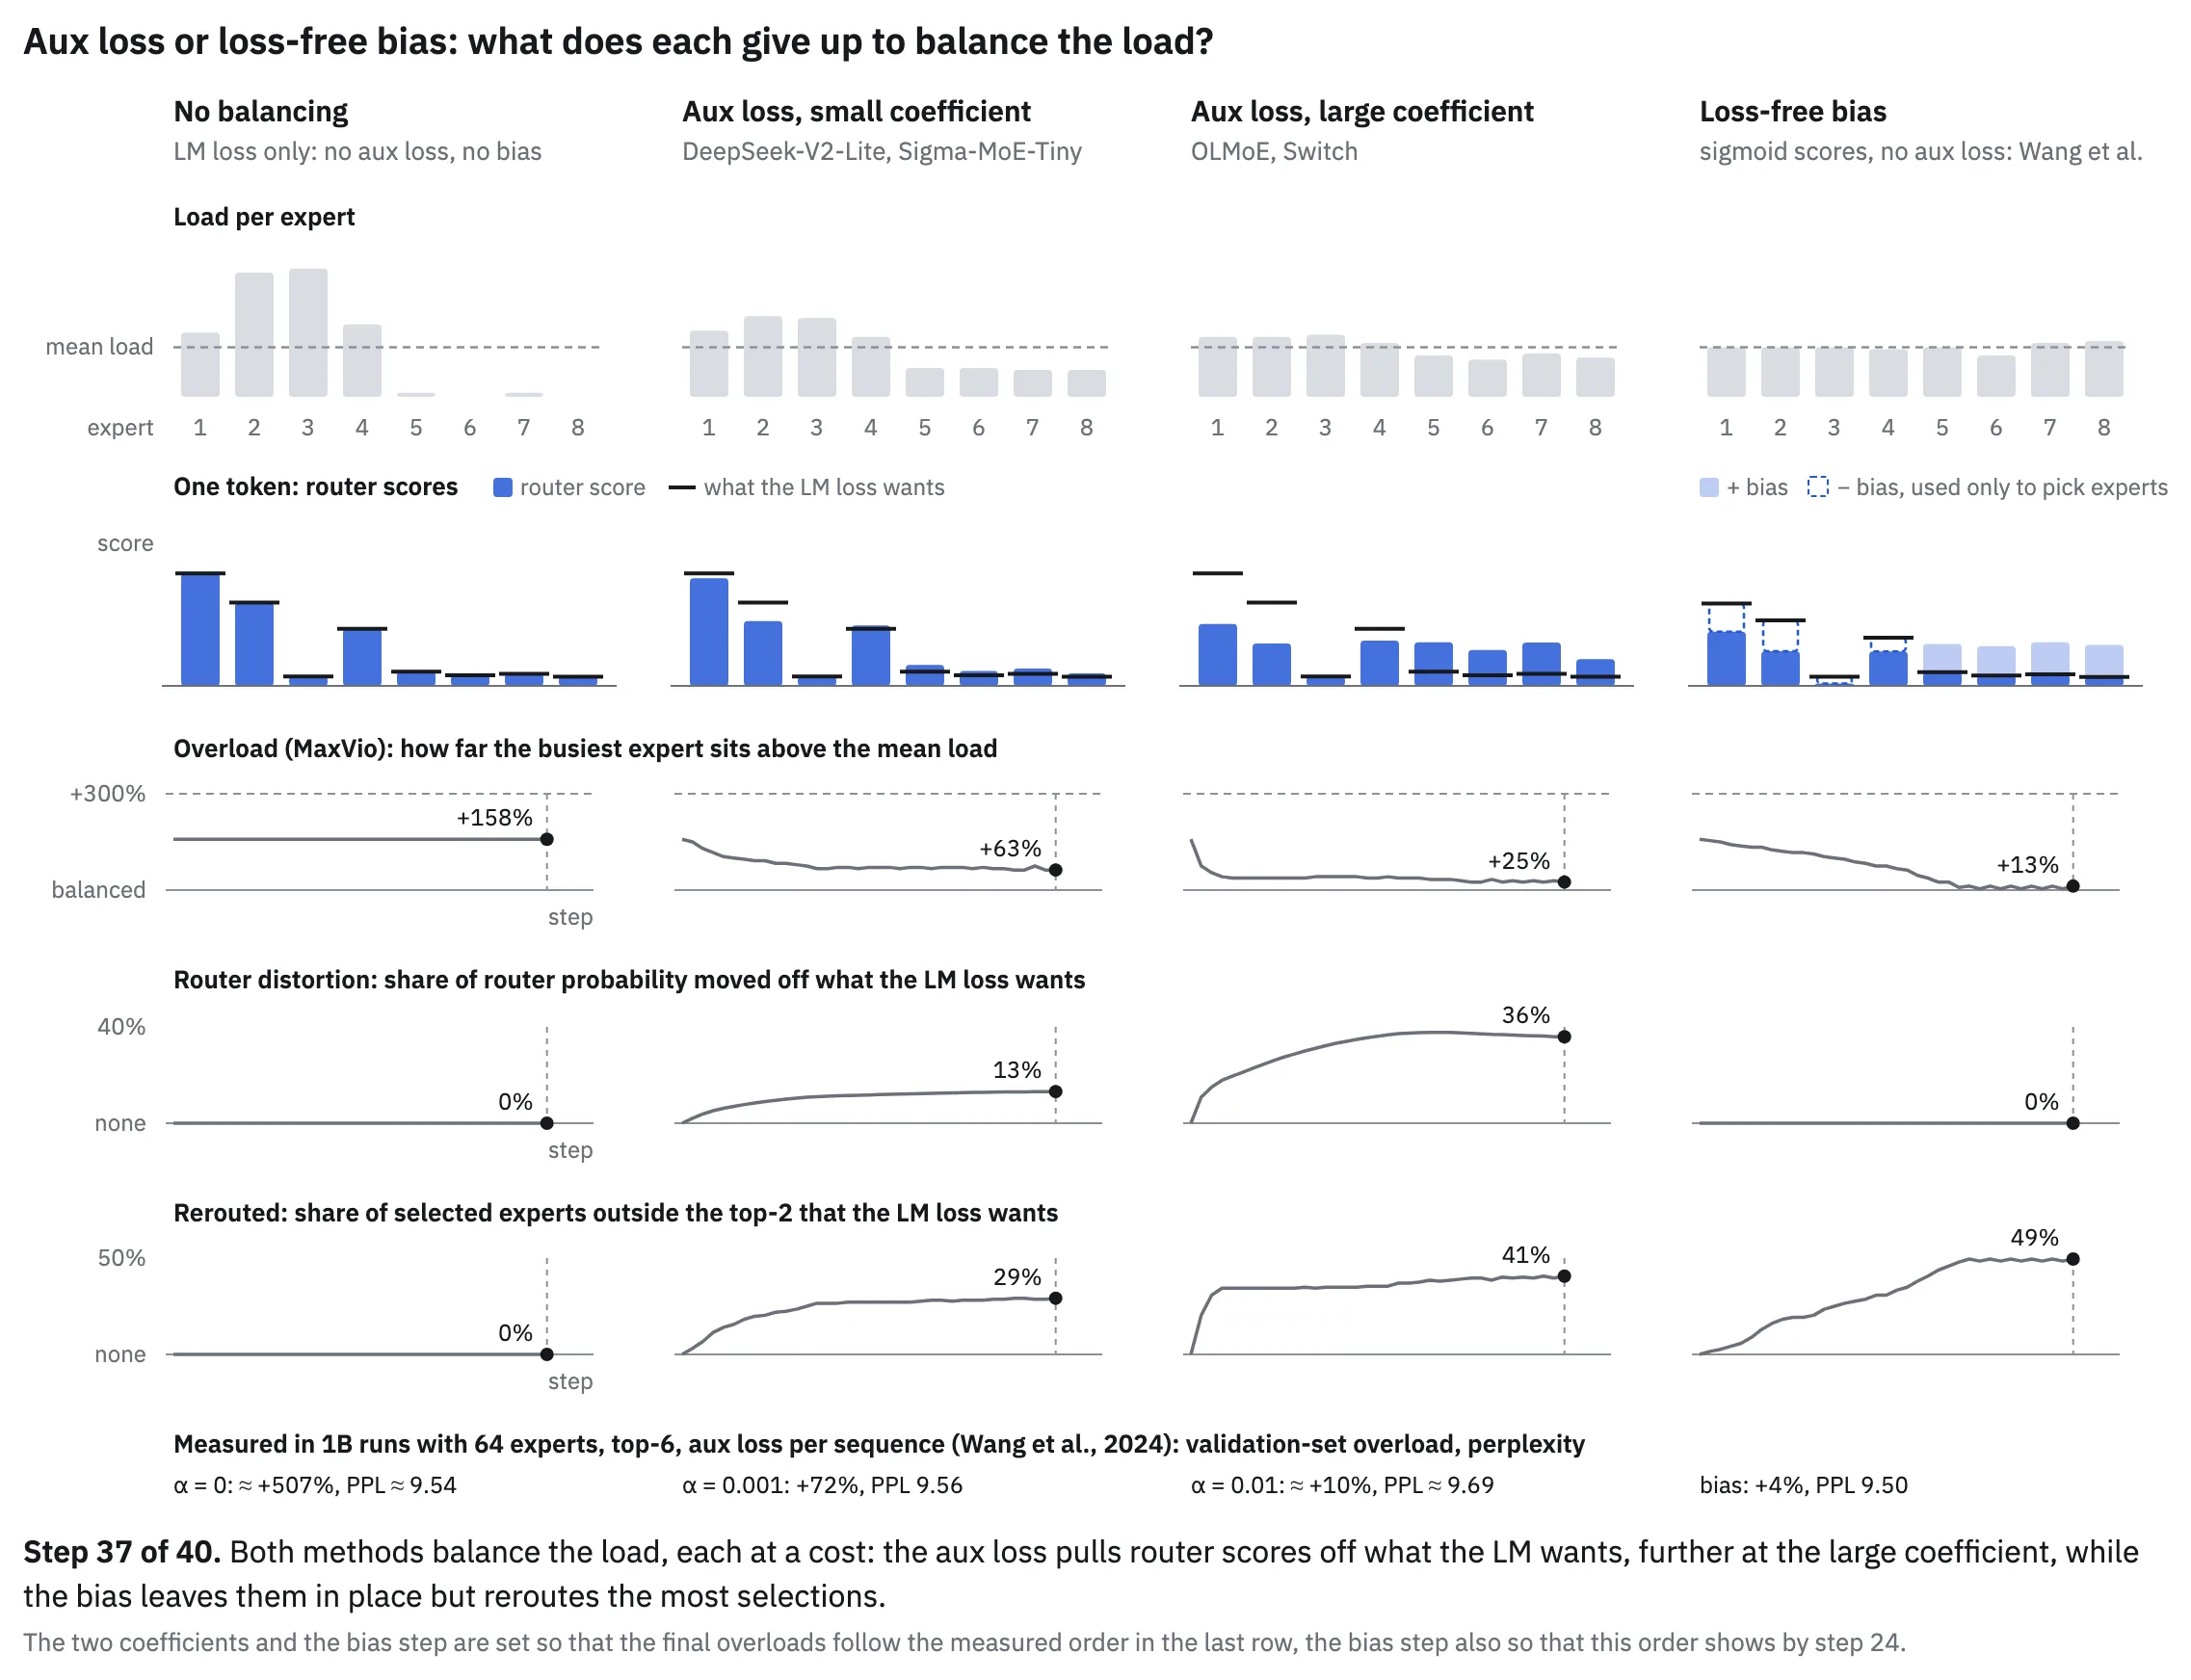 Figure 3.3.3: 보조 손실과 무손실 편향이 전문가 부하와 라우터 가중치에 미치는 영향 비교 (출처: Hugging Face)
부하를 어느 범위(Scope)에서 집계할지도 중요하다. 사전학습 데이터 파이프라인은 흔히 하나의 마이크로배치를 단일 도메인(예: 코드)으로 채운다. 이때 마이크로배치 단위로 균형을 강제하면 코드 토큰이 모든 전문가에 고루 배분되어 도메인 특화 전문가가 형성되지 않는다. 반대로 여러 도메인이 섞인 글로벌 배치 단위로 균형을 맞출 수도 있다(global_aux_loss). Qiu 등의 43B 모델 실험에서는 이렇게 하자 도메인 특화가 유지되고 퍼플렉서티(perplexity)가 낮아졌다. 대신 개별 GPU의 마이크로배치 부하가 불균형해져 스텝 시간이 5.8% 늘었다.
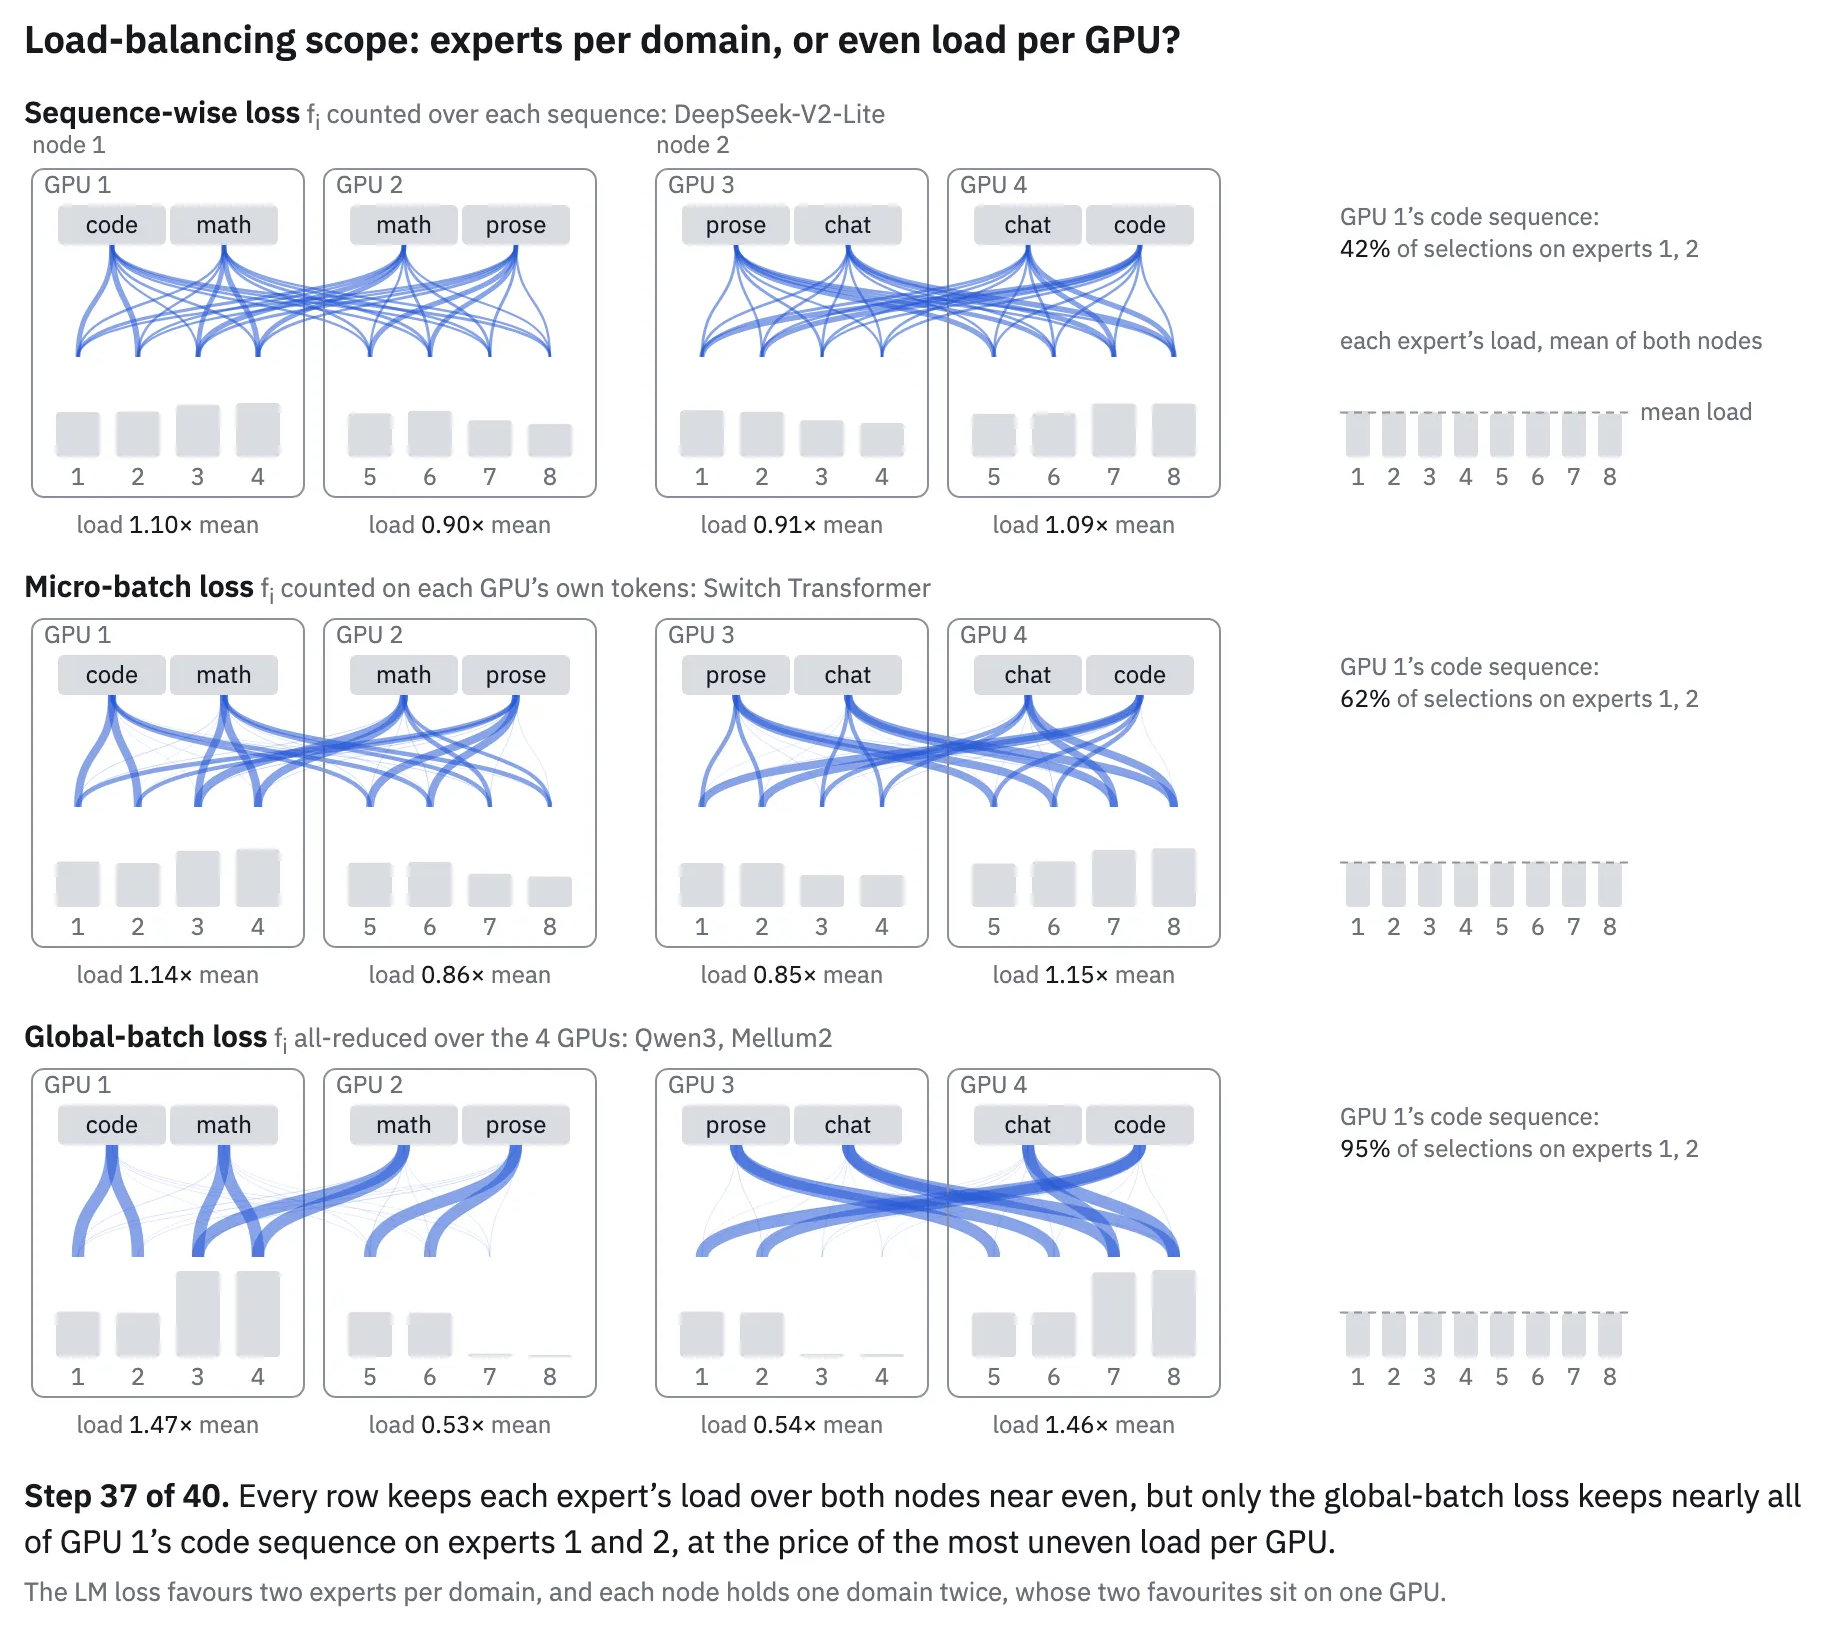 Figure 3.3.5: 균형 범위(시퀀스, 마이크로배치, 글로벌 배치)에 따른 코드 도메인 특화와 GPU 부하 편차 (출처: Hugging Face)
기울기 간섭 없이 부하를 맞추는 해법이 DeepSeek-V3가 도입한 무손실 편향(Loss-free bias)이다(--moe-router-enable-expert-bias --moe-router-score-function sigmoid). 각 전문가마다 편향 $b_i$를 두고 Top-$k$ 전문가를 선택할 때만 점수 $s_i + b_i$를 사용하며, 출력 결합 가중치는 원래 점수 $s_i$에서 계산한다. 매 스텝 과부하 전문가의 편향은 고정된 업데이트 폭(--moe-router-bias-update-rate, 기본 1e-3)만큼 내리고 과소부하 전문가는 올린다. 그런데 전문가 수가 128개를 초과해 896개(Kimi K3)나 1,024개 규모로 커지면 고정 폭 방식은 수렴이 느려지거나 업데이트 폭이 지나치게 커져 품질을 해친다.
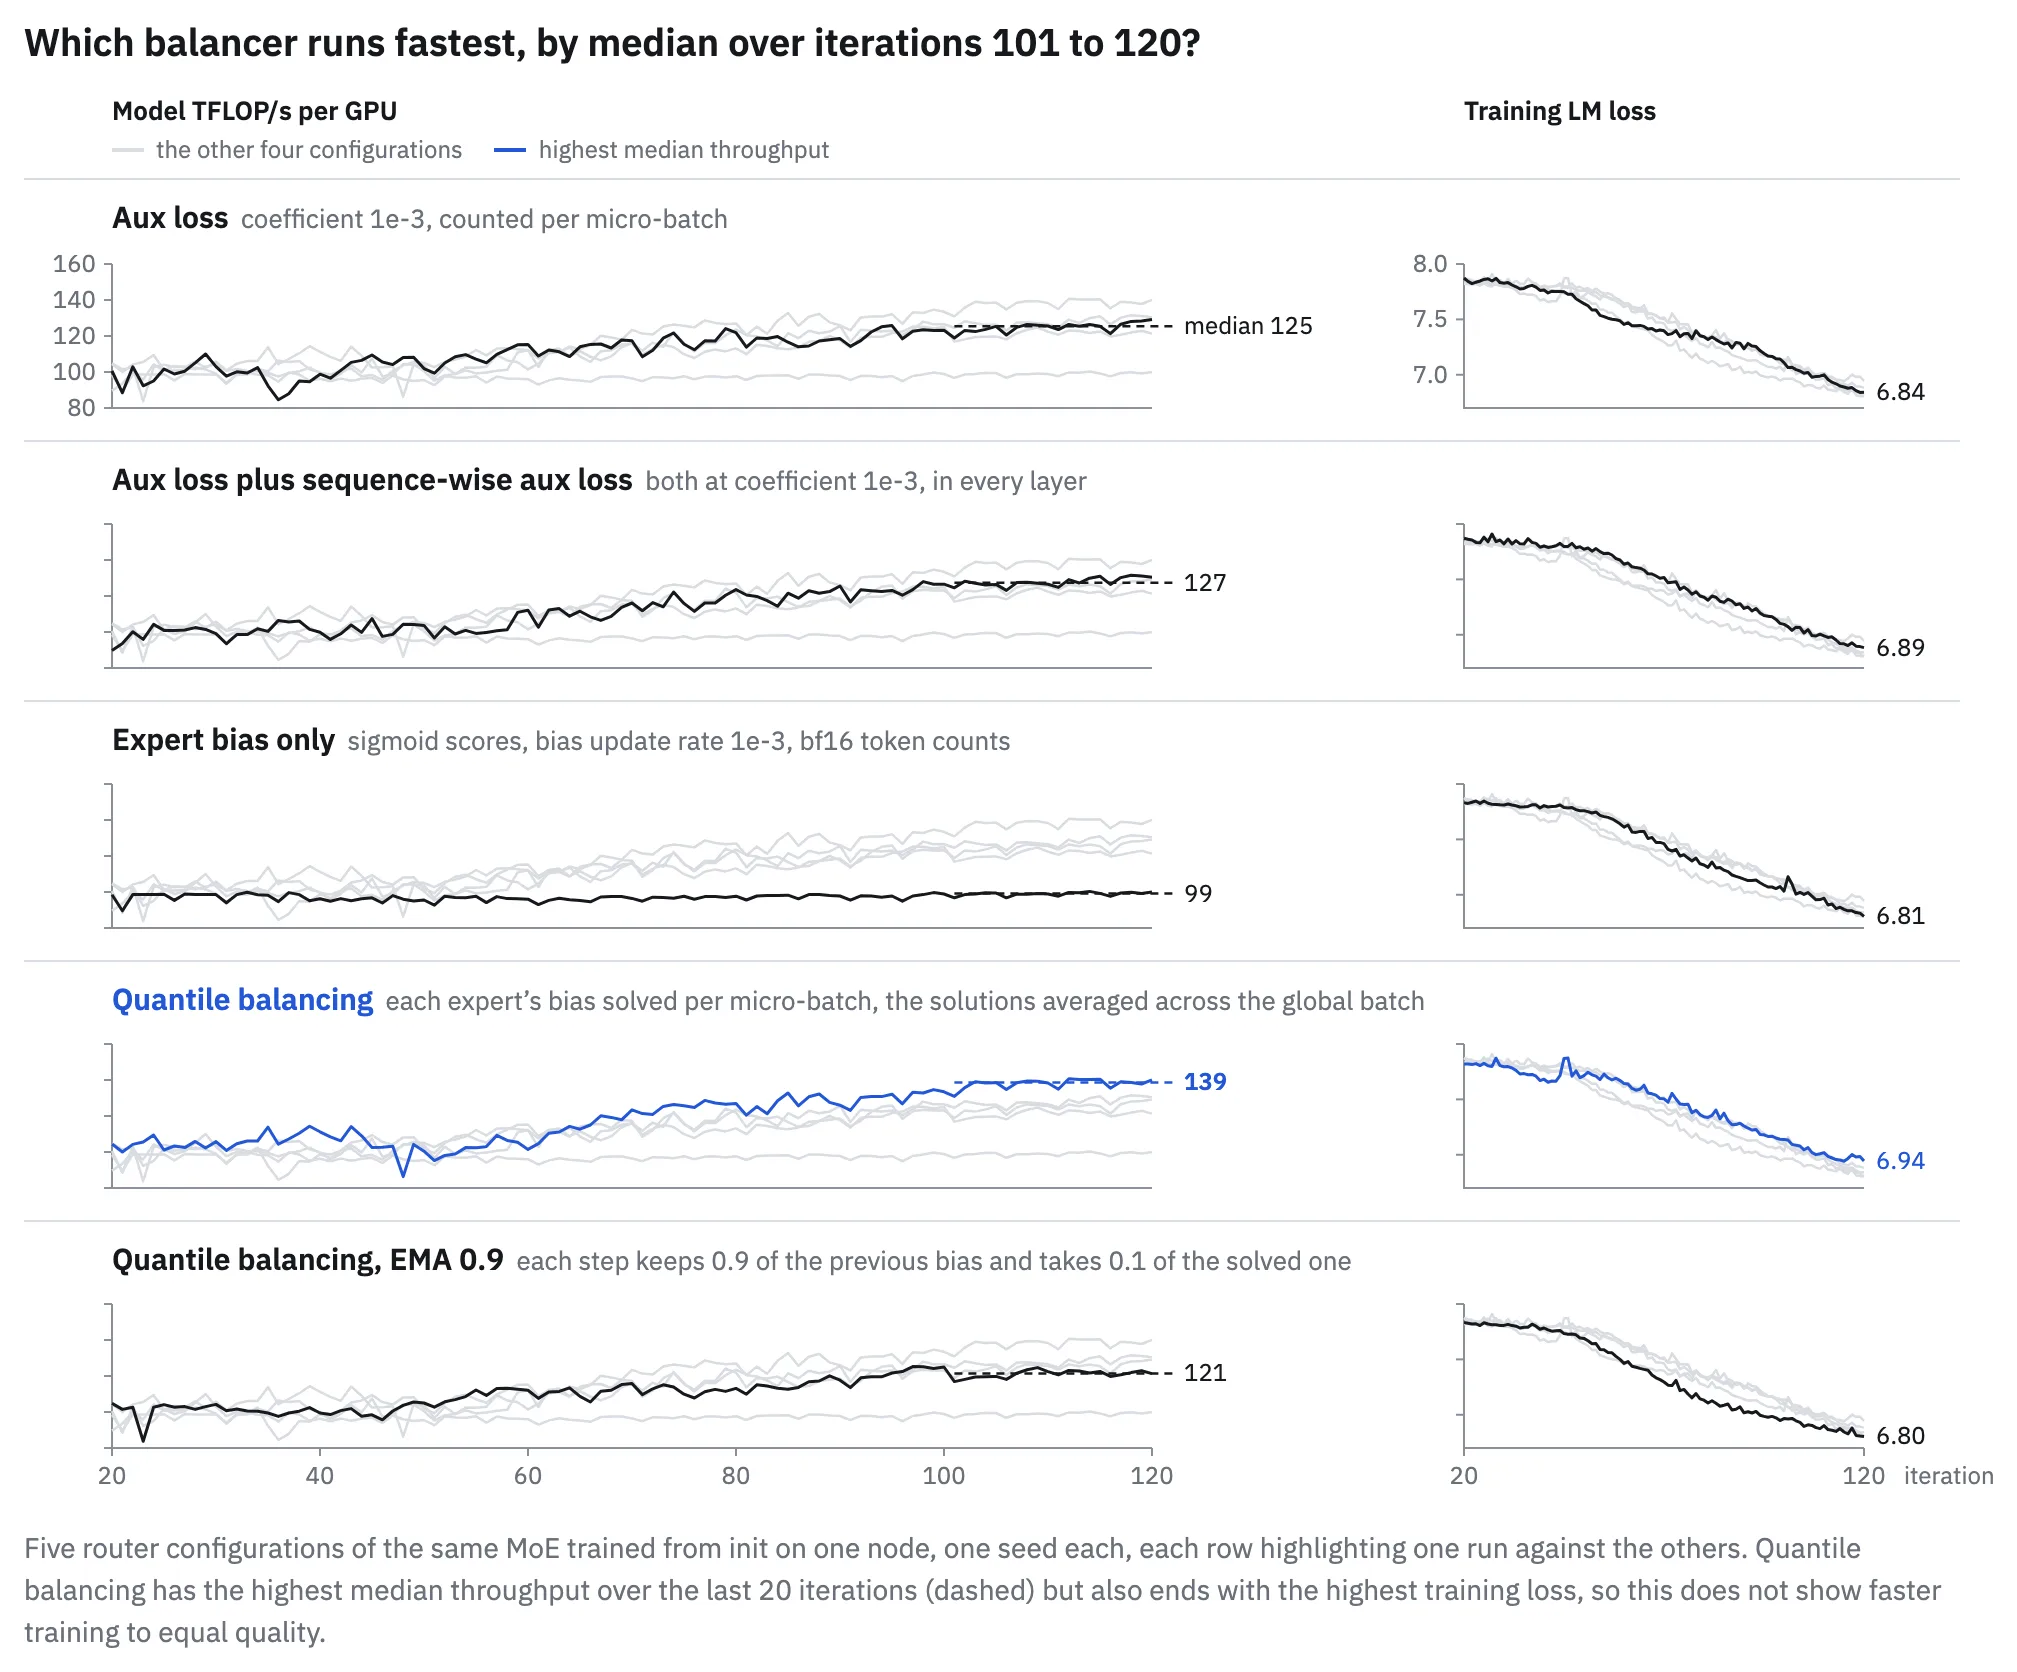 Figure 3.3.12: 같은 모델에서 5가지 부하 분산 설정을 적용했을 때의 초기 120 스텝 처리량(TFLOP/s)과 손실 추이 (출처: Hugging Face)
Kimi K3 등이 채택한 분위수 균형(Quantile balancing)은 이 문제를 보완한다(--moe-router-load-balancing-type quantile_balancing). 고정 폭으로 편향을 조금씩 조정하는 대신, 각 전문가가 목표 비율의 토큰만 통과시키는 분위수(quantile) 점수를 현재 배치의 점수 분포에서 직접 구해 다음 스텝의 편향으로 설정한다. 저자들의 120 스텝 비교 실험에서 분위수 균형은 마지막 20 스텝 중앙값 기준 139 TFLOP/s를 기록해 보조 손실(125 TFLOP/s)보다 빠르게 균형 처리량에 도달했다. 단, 글로벌 배치 평균 분위수를 쓰면 글로벌 MaxVio가 0.92로 낮아도 개별 마이크로배치의 로컬 MaxVio는 최악 레이어에서 5.96으로 높을 수 있다. 두 범위의 MaxVio를 함께 점검해야 한다.
3.4 전문가 설계와 3.5 블록 배치
전문가 내부 설계에서는 개수와 폭(세분성), 통신 압축(LatentMoE), 공유 전문가(Shared experts), 가변 연산, 활성화 함수 클리핑을 결정한다.
| 모델 | 활성 / 전체 전문가 | 전문가 폭 | 공유 전문가 (개수×폭) | 활성화 함수와 상한 |
|---|---|---|---|---|
| DeepSeek‑V4.1‑Flash | 6/384 | 2,304 | 1×2,304 | SwiGLU, 상한 10 |
| GLM‑5.3 | 8/256 | 2,048 | 1×2,048 | SiLU |
| Kimi K3 | 16/896 | 3,072 | 2×3,072 | SiTU‑GLU, 상한 4와 25 |
| LongCat‑Flash | 12/768 | 2,048 | 없음 | SiLU |
| MiMo‑V2.6‑Pro‑RL | 8/384 | 2,048 | 없음 | SiLU |
| Nemotron 3 Ultra | 22/512 | 5,120 | 1×10,240 | $\text{ReLU}^2$ |
| Qwen3.8 2.4T‑A95B | 10/512 | 2,048 | 1×2,048 | SiLU |
| Step 5 Preview | 8/352 | 1,536 | 1×1,536 | SwiGLU, 상한 7 |
표의 여덟 모델 중 일곱 모델은 모든 토큰에 같은 폭의 전문가를 고정 개수(Top-$k$)만큼 실행하지만, LongCat-Flash는 768개 전문가 가운데 256개를 연산이 없는 항등(무연산) 전문가로 두어 토큰마다 실제 활성 파라미터 수(평균 27B)를 달리한다. 한편 Liew 등은 18레이어 모델로 세분성(granularity) 실험을 했다. 총 파라미터와 활성 파라미터를 고정한 채 전문가 폭을 줄이고 개수와 $k$를 같은 배수로 늘리는 실험이다. 전문가 폭을 $d/4$로 줄인 구성(전문가 128개, Top-8)까지는 손실이 2.334에서 2.297로 꾸준히 내려갔다. 그보다 더 세분화하면 손실은 나아지지 않았고, 행렬곱(GEMM)이 작아지고 토큰 복사본이 늘어 GPU 효율만 떨어졌다. Sarkar 등은 시스템 효율까지 고려한 스케일링을 연구했다. 모델 FLOPs만 기준으로 삼으면 가장 희소한 구성을 고르게 된다. 실제 클러스터 학습 속도까지 반영하면 같은 학습 시간에서 예측 손실이 가장 낮은 구성은 덜 희소한 구성이었고, 가장 희소한 구성보다 손실이 0.031 nat 낮았다.
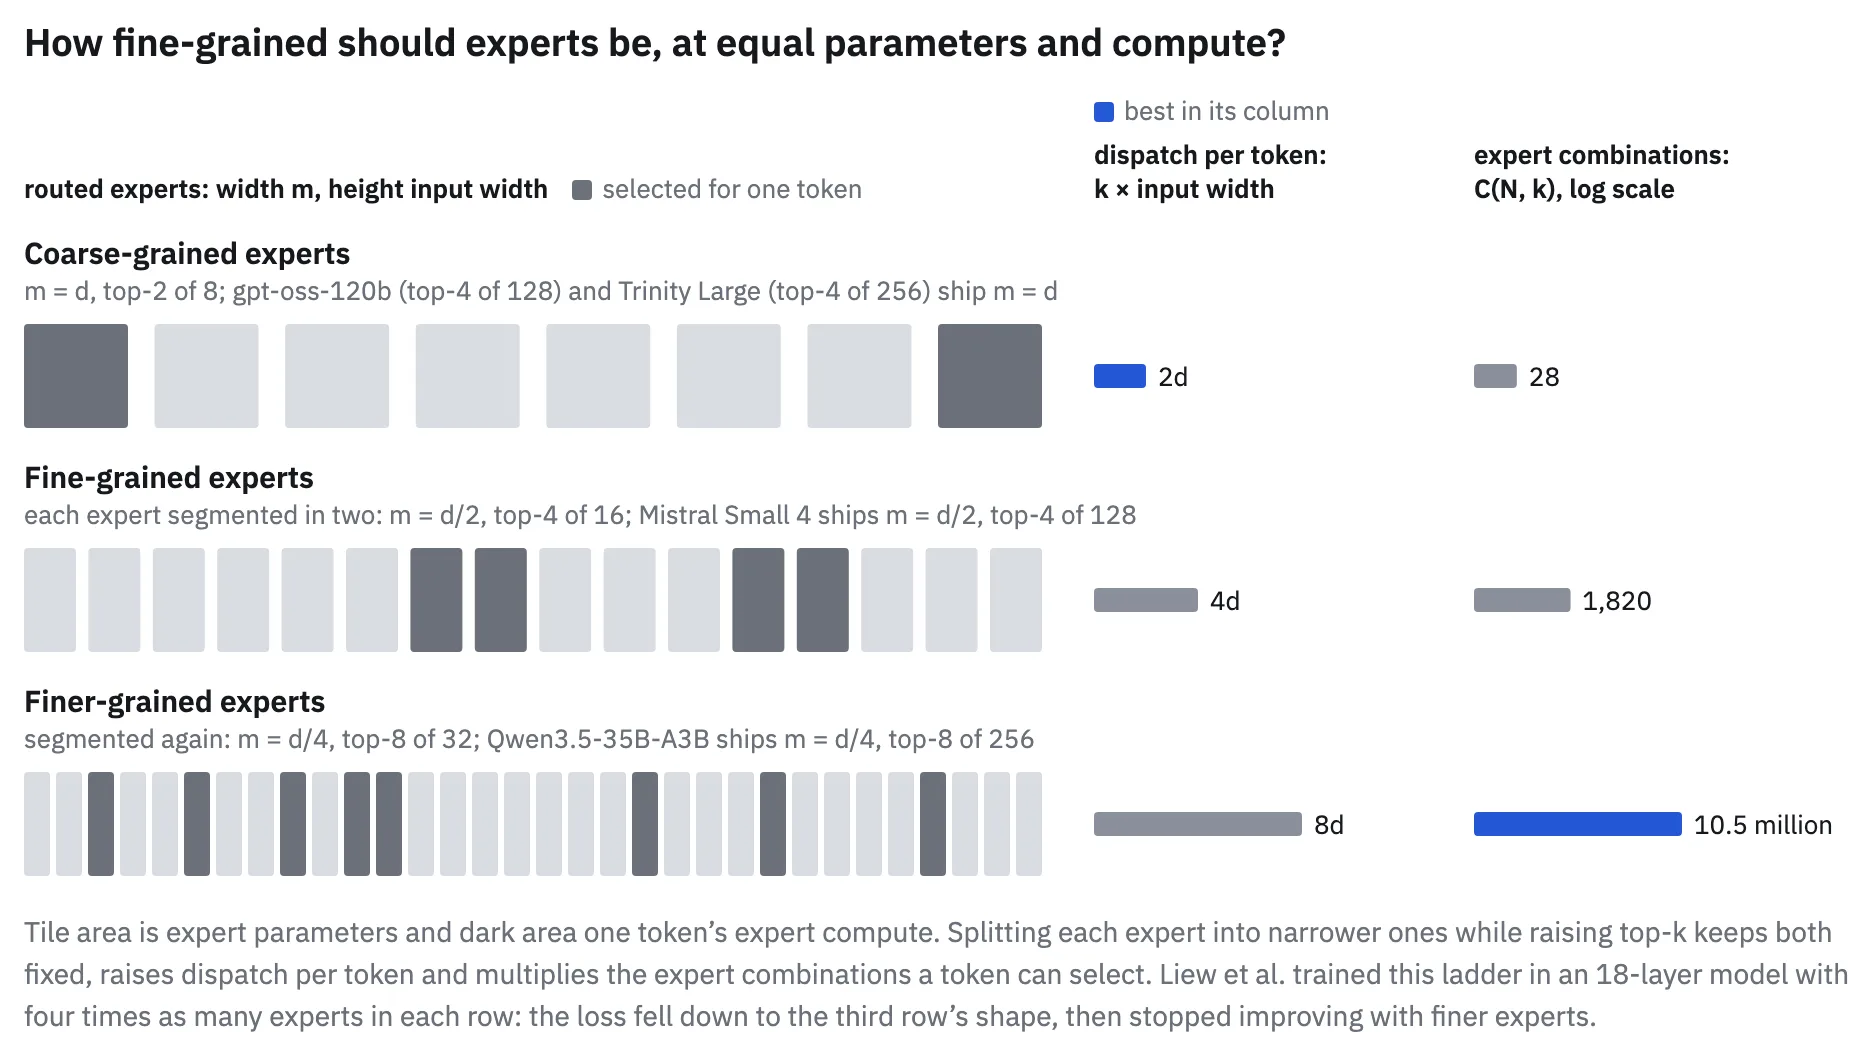 Figure 3.4.1: 총 파라미터(전체 면적)와 활성 연산량(진한 면적)을 유지한 채 전문가 폭을 줄이고 개수를 늘리는 세분화 단계 (출처: Hugging Face)
세분화를 진행할 때 늘어나는 네트워크 통신량을 억제하는 기법이 Nemotron 3 Ultra($8,192 \to 2,048$)와 Kimi K3($7,168 \to 3,584$)가 채택한 LatentMoE다(--moe-latent-size). 토큰을 디스패치하기 전에 은닉 차원 $d$를 더 작은 잠재 차원 $\ell = d/\alpha$로 선형 투영하고, $\ell$ 차원에서 전문가를 실행한 뒤 결합 이후 다시 $d$로 복원한다. 이렇게 하면 같은 통신량과 전문가 연산량 조건에서 전문가 수와 Top-$k$를 각각 $\alpha$배 늘릴 수 있다. NVIDIA의 73B-A8B 실험에서 LatentMoE는 같은 규모 표준 MoE보다 MMLU-Pro 점수를 4.6점 높였다. 단, Kimi K3(2.8T 규모)처럼 대규모 모델에서는 상향 투영 전 활성화가 폭주할 수 있어 --moe-use-norm-before-up-proj로 RMSNorm을 추가한다.
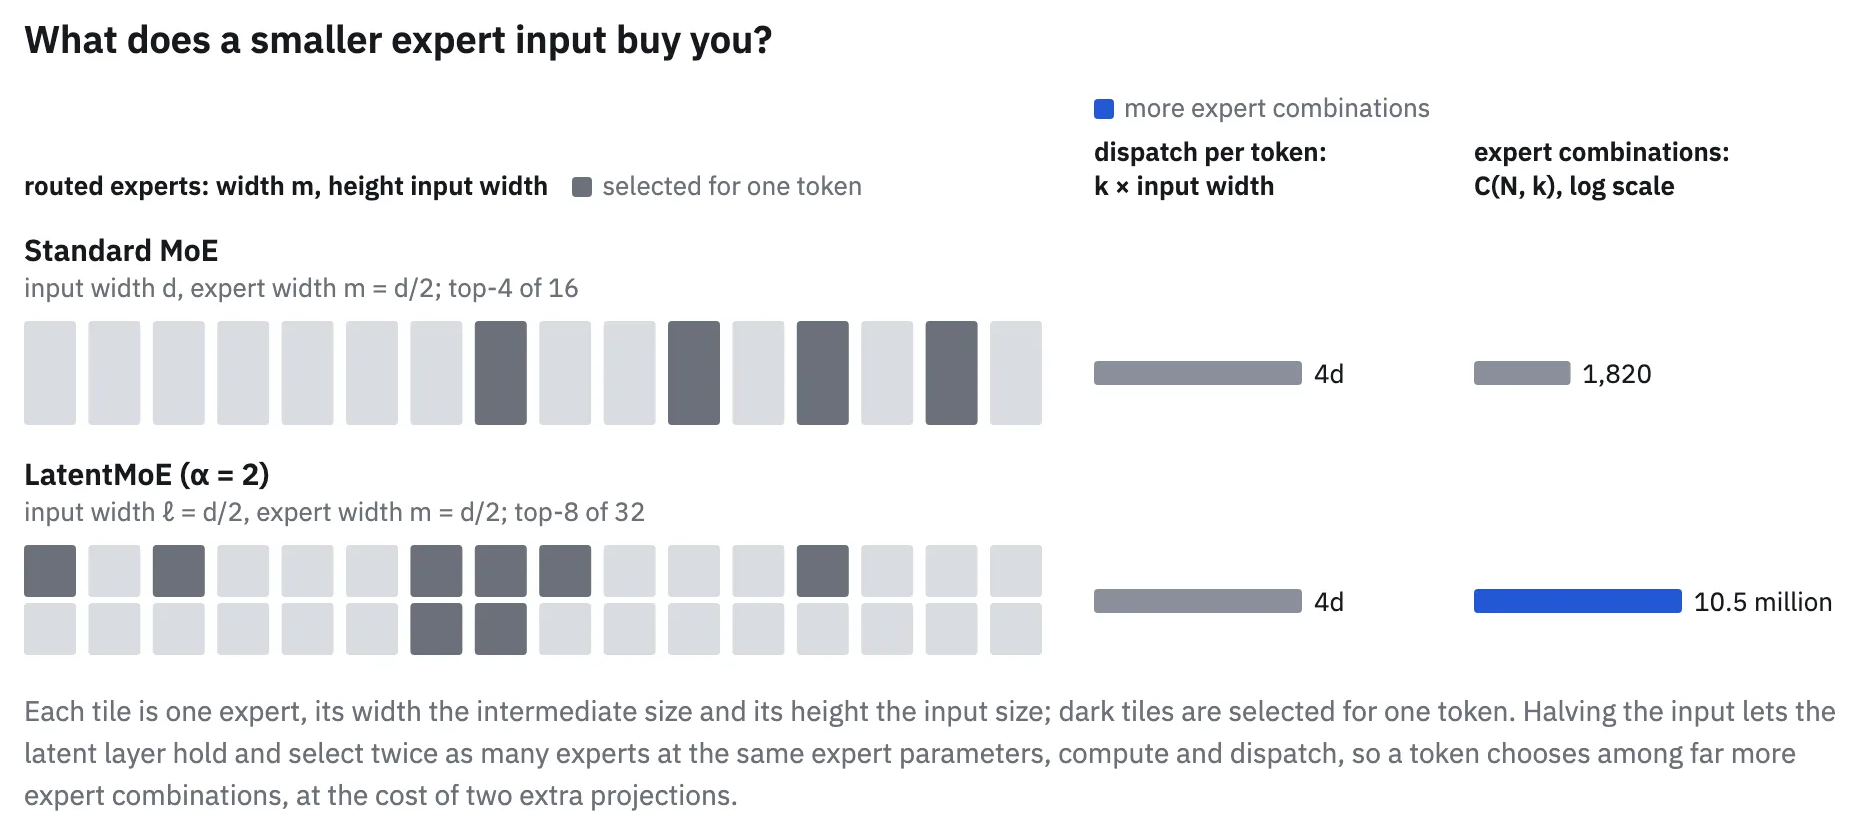 Figure 3.4.4: 토큰 차원을 절반으로 줄여 같은 통신량으로 2배 많은 전문가를 활성화하는 LatentMoE 구조 (출처: Hugging Face)
한편 SwiGLU나 $\text{ReLU}^2$ 활성화 함수의 출력은 입력 스케일의 제곱에 비례해 커진다. Step 3.5 Flash에서는 학습 손실에 이상이 없는데도 전문가 한두 개의 출력 노름이 레이어 중앙값의 5,700배까지 커졌다. 이를 예방하기 위해 DeepSeek-V4.1-Flash는 --activation-func-clamp-value 10으로 하드 클리핑을 걸고, Kimi K3는 매끄러운 상한 함수인 SiTU-GLU(--activation-func-tanh-clamp-scale 4 --activation-func-tanh-clamp-scale-linear 25)를 적용한다.
블록 배치(3.5절)에서 쓰이는 방법은 두 가지다. 첫 1~3개 레이어를 밀집 레이어로 두어(--moe-layer-freq "([0]+[1]*15)") 효율 손실 없이 All-to-All 횟수를 줄이는 방법과, 어텐션과 MoE의 실행 의존성을 재구성해 통신과 계산을 동시에 실행하는 방법이다. 표준 블록에서는 어텐션이 끝나야 디스패치가 시작된다. 병렬 블록이나 ScMoE 방식의 단축 연결(Shortcut-connected MoE, --moe-shortcut-connection --moe-shortcut-parallel)을 쓰면 어텐션 계산과 All-to-All 통신이 별도 CUDA 스트림에서 동시에 실행된다. 그만큼 다른 계산과 동시에 실행되지 않는 노출 통신의 비중이 크게 줄어든다. ScMoE는 단일 노드 학습 속도가 1.14배 빨라졌고, LongCat-Flash는 노출 통신 비중이 25.3%에서 8.4%로 줄었다.
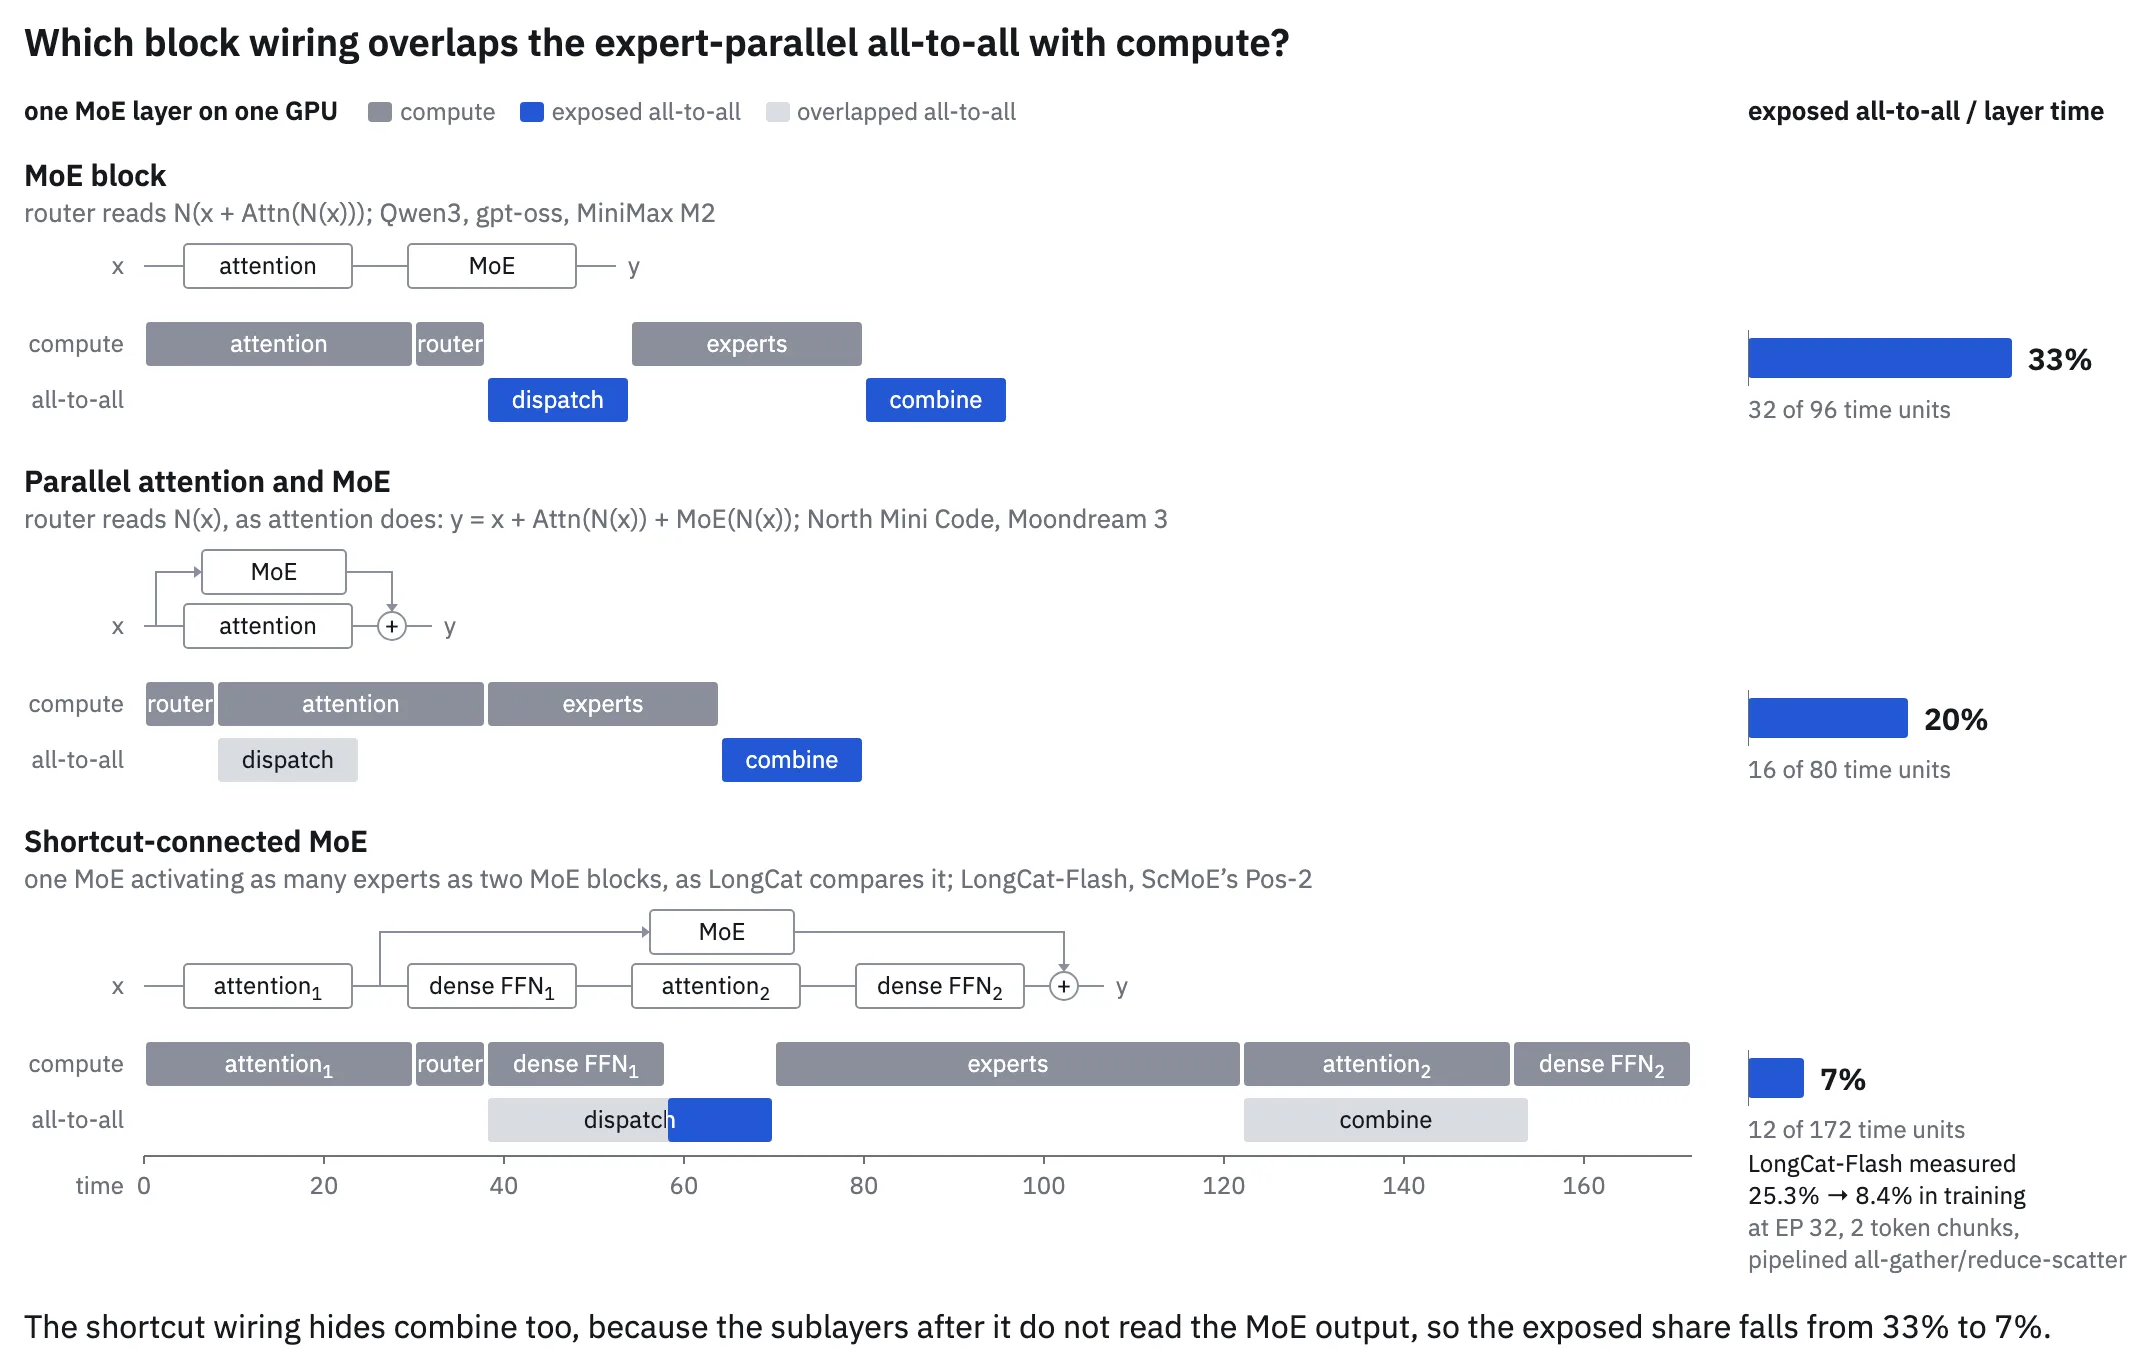 Figure 3.5.2: 블록 배선 방식별로 All-to-All 통신이 어텐션과 밀집 연산과 동시에 실행되는 비율 비교 (출처: Hugging Face)
3.6 학습 시작, 옵티마이저, 안정성과 3.7 시스템 최적화
업사이클링(Upcycling)은 밀집 체크포인트의 MLP를 분할해 전문가 초기값으로 복사하는 기법으로, 초기 수렴이 빨라진다. 그러나 처음부터(from scratch) 학습한 MoE도 시간이 지나면 같은 수준에 도달한다. 그 시점은 OLMoE에서 밀집 학습 토큰의 25%(500B 토큰), Komatsuzaki 등의 실험에서 밀집 연산량의 120%였다. 따라서 업사이클링은 단기 학습에 유리하다. Megatron d6316eb45에서 쓰려면 체크포인트 로더 인자명(ddp_model)과 시작 시점 설정 컨테이너 참조를 고치는 로컬 패치 두 개가 필요하다.
옵티마이저로는 DeepSeek-V4, Kimi K3, Step 3.5 Flash 등 최신 모델들이 행렬 파라미터에 Muon(--optimizer muon)을 채택한다. AdamW에서는 토큰을 적게 받은 전문가는 기울기에서 노이즈 비중이 커져 업데이트 폭이 작아진다. Muon은 전문가별로 행렬 직교화를 수행하므로, 토큰을 적게 받은 전문가도 행렬 형상에 비례하는 일정한 폭으로 업데이트한다. 단, Megatron 기본 스케일(1.0)은 발산 위험이 있어 --muon-extra-scale-factor 0.2에서 시작해야 한다. Qwen3.8-Next처럼 라우터만 AdamW로 분리하려면 --moe-router-skip-muon을 켠다.
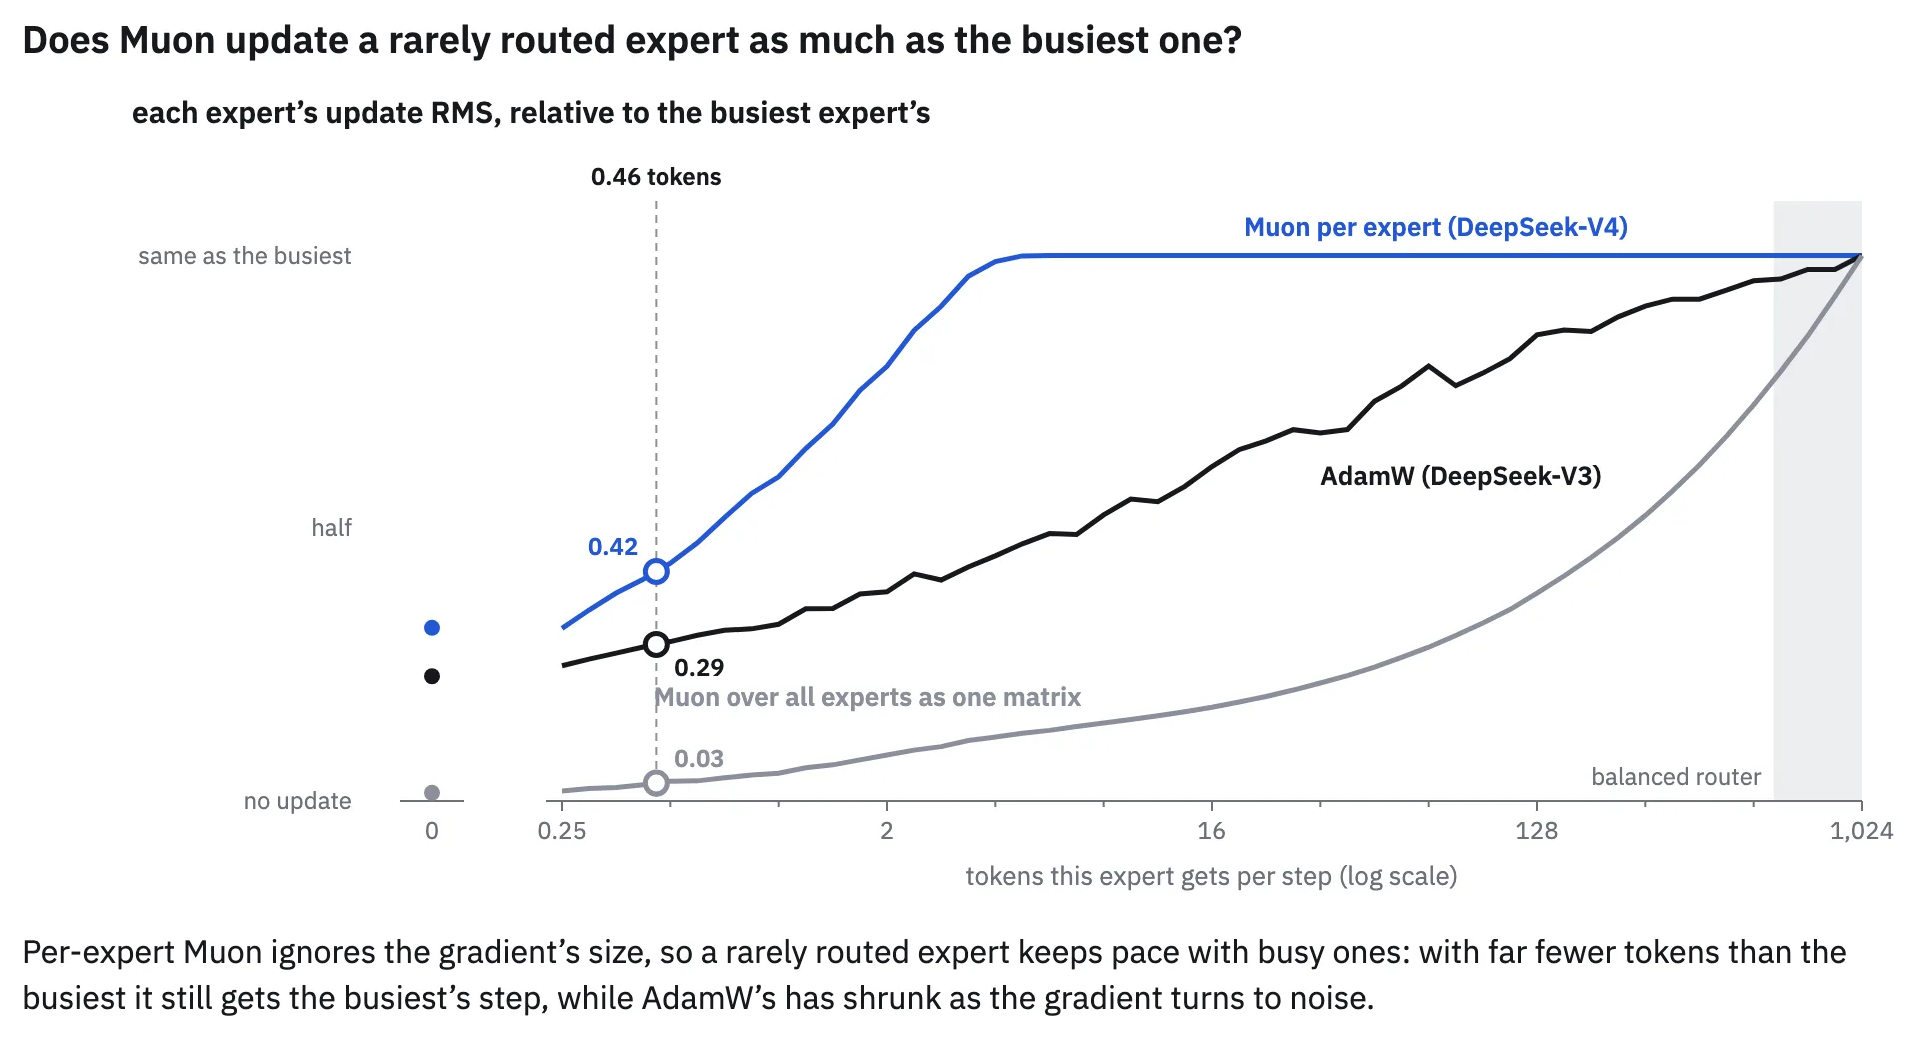 Figure 3.6.3: 스텝당 수신 토큰 수가 줄어들 때 AdamW, 전체 전문가 통합 Muon, 전문가별 Muon의 업데이트 폭 비교 (출처: Hugging Face)
학습 안정성(3.6절)에서는 손실이 튀거나 NaN이 발생하는 즉각적인 실패와, 손실 곡선은 멀쩡한데 내부에서 진행되는 조용한 실패를 구분해야 한다. 즉각적인 실패는 Megatron의 기본 재실행 검증(--rerun-mode validate_results)으로 일시적 하드웨어 오류인지, 재현 가능한 모델이나 데이터 결함인지 구분한다. 조용한 실패인 라우팅 붕괴(routing collapse), 죽은 전문가(dead expert), 폭주 전문가(rogue expert)는 손실 곡선만으로는 확인할 수 없다. 레이어별 MaxVio를 감시하고, 전문가 출력 노름의 최댓값과 최솟값이 중앙값의 몇 배인지도 별도로 감시해야 한다.
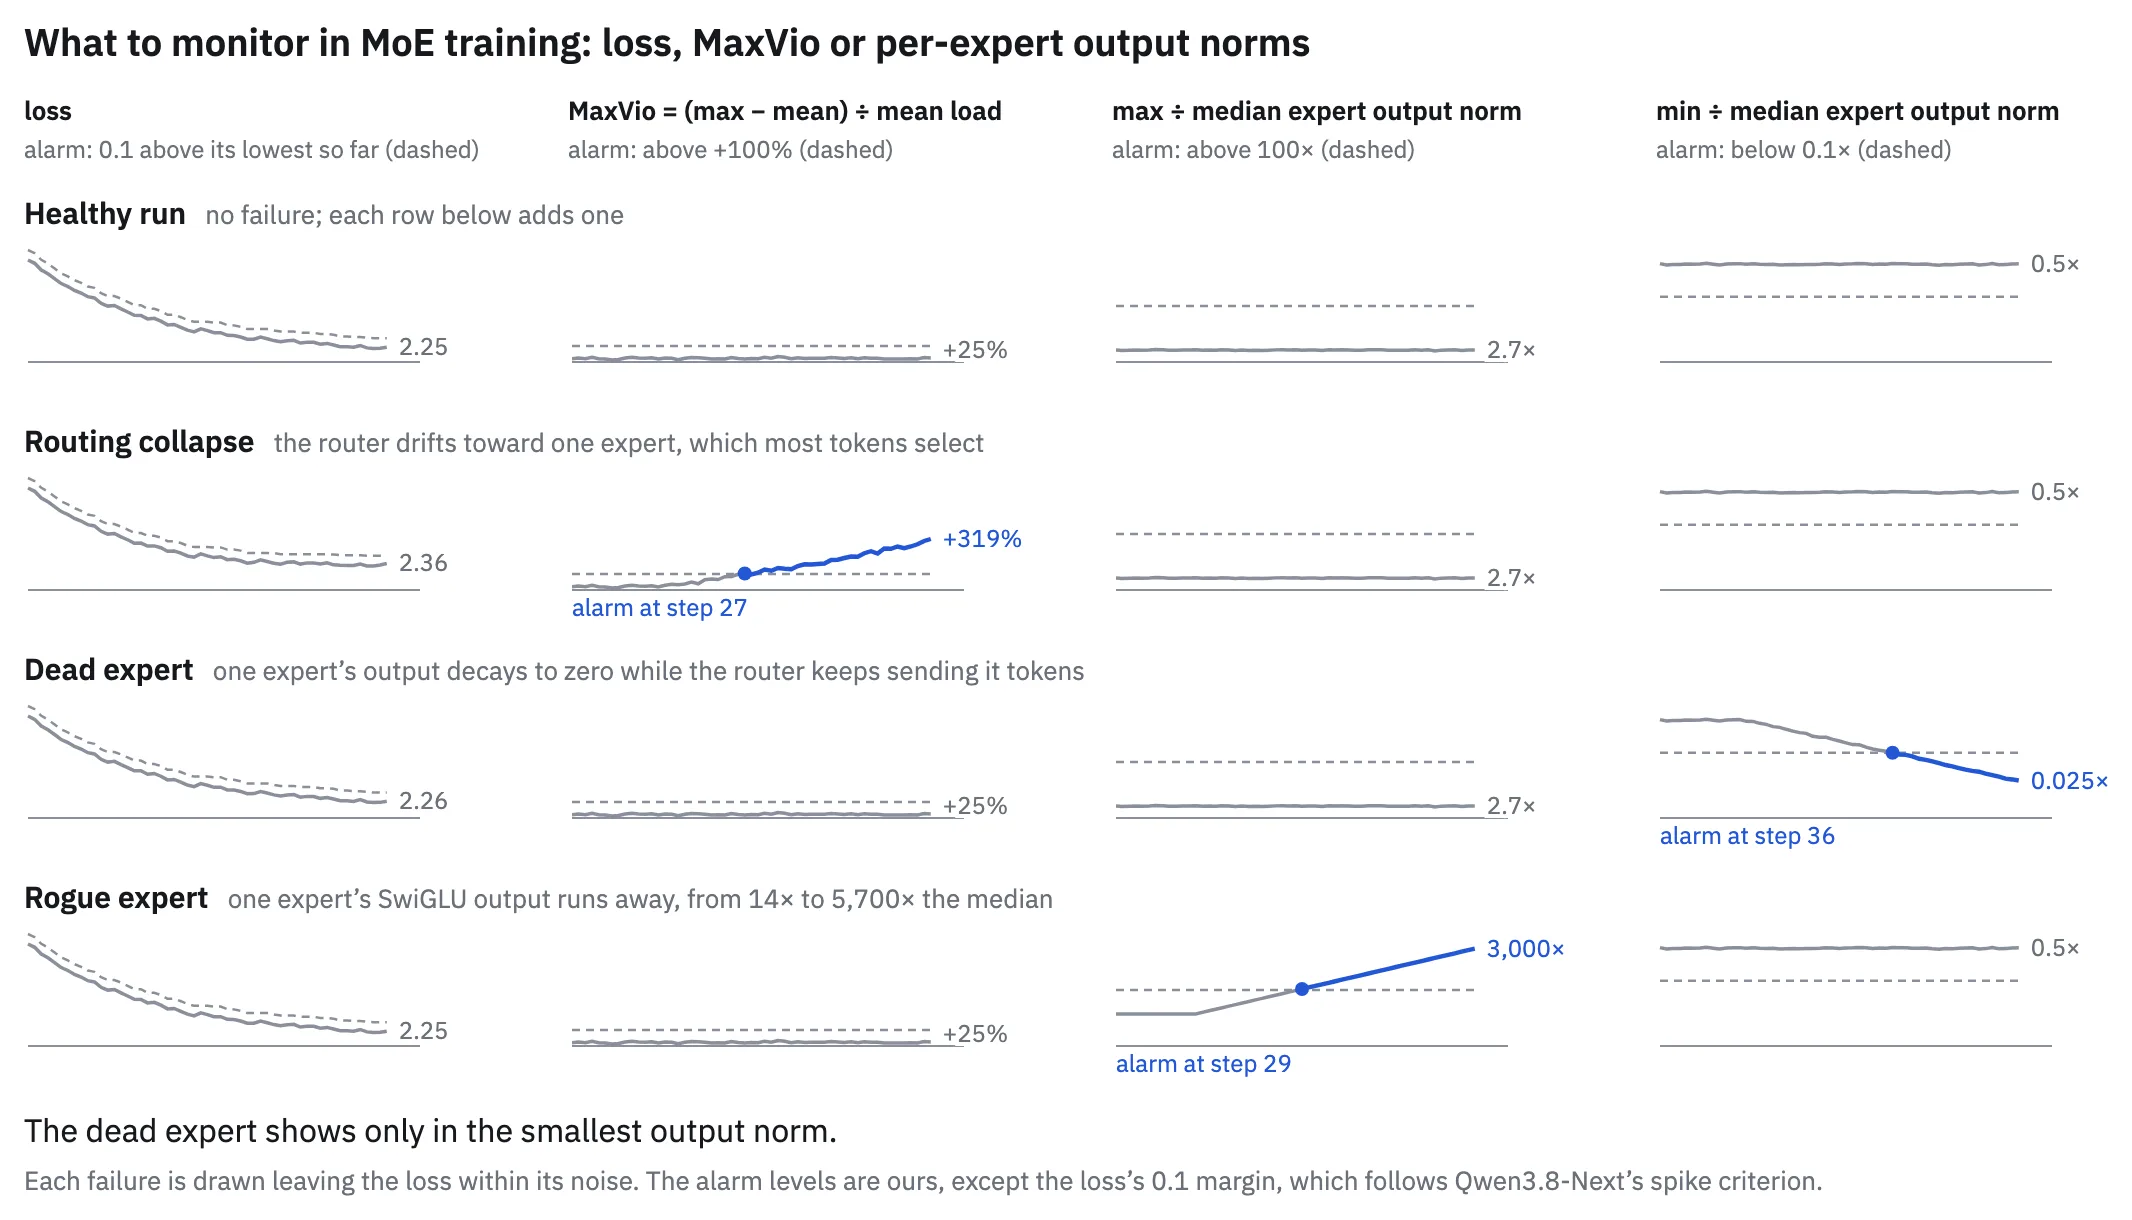 Figure 3.6.5: 학습 손실에는 드러나지 않는 라우팅 붕괴(MaxVio 상승), 죽은 전문가(최소 노름 급락), 폭주 전문가(최대 노름 급등) 신호 (출처: Hugging Face)
시스템 최적화(3.7절)는 프로파일러로 실제 스텝 구성을 측정하는 데서 시작한다. 저자들이 단일 노드 7B-A1B MoE의 4번째 스텝을 추적했을 때 전체 스텝 시간의 절반이 노출된 All-to-All이었다. 그런데 이 시간의 상당 부분은 순수 네트워크 전송 시간이라기보다 대기 시간이었다. 라우터가 불균형해(보조 손실 값 3.2, 균등 상태는 1) 가장 바쁜 GPU의 연산이 끝날 때까지 다른 랭크들이 동기화 지점에서 기다린 것이다. 실제로 강제 균등 라우팅을 켜자 같은 스텝이 40% 빨라졌고, 토큰 정렬 커널을 합치는 --moe-permute-fusion은 스텝 시간을 3.3% 줄였다.
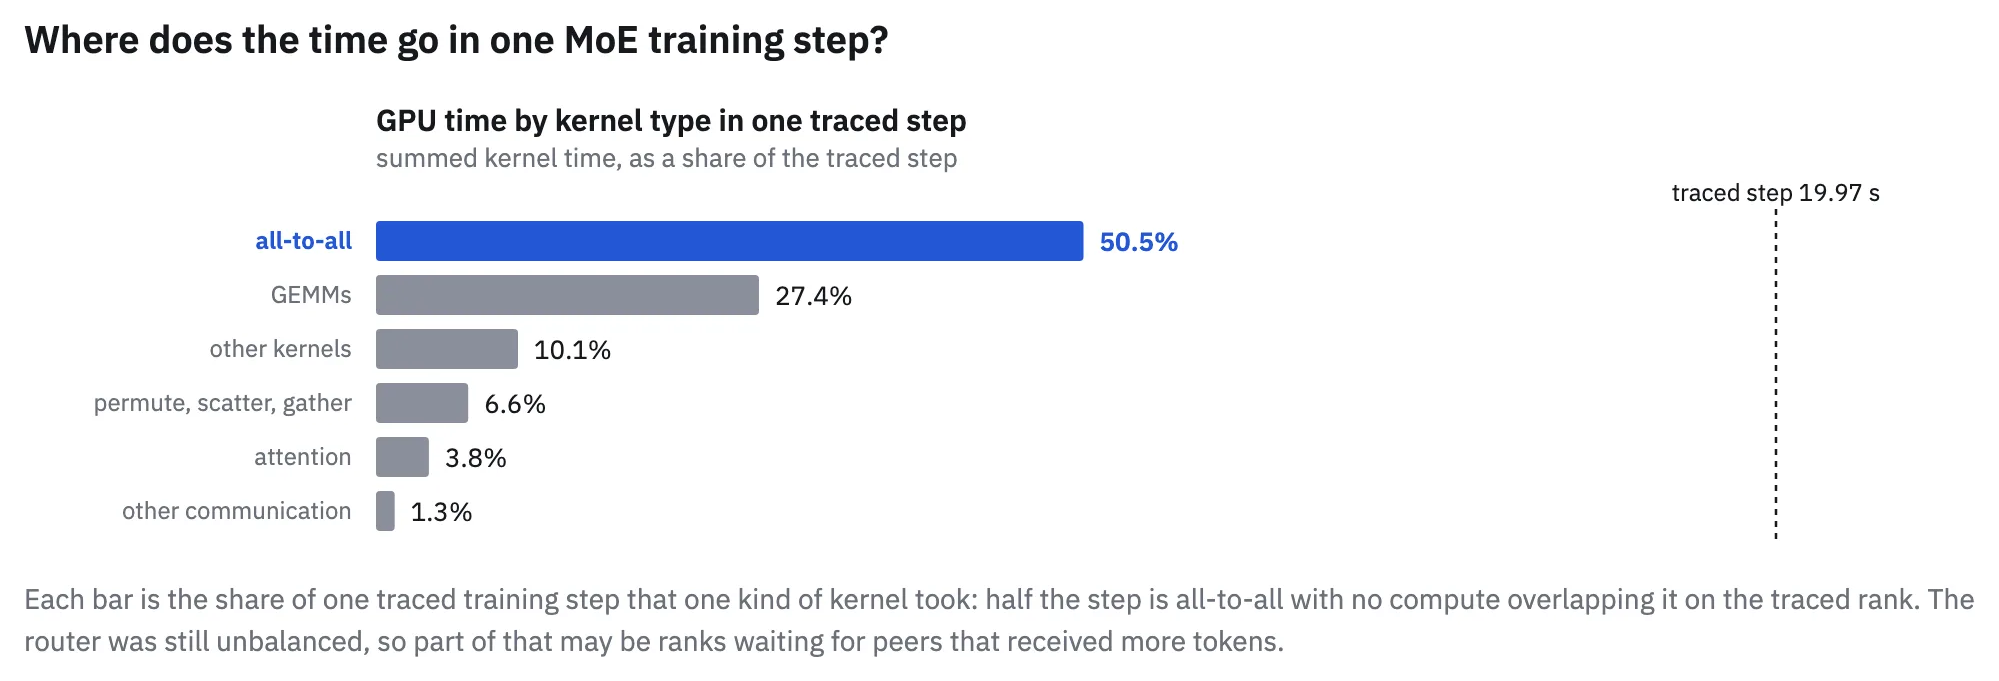 Figure 3.7.1: 불균형 상태의 초기 스텝에서 전체 시간의 절반을 차지하는 노출된 All-to-All 구간 (출처: Hugging Face)
부하 균형을 맞춘 뒤에도 남는 통신 지연은 마이크로배치 스케줄링으로 줄인다. 아키텍처를 바꾸지 않고 노출된 All-to-All 통신을 줄이려면 --overlap-moe-expert-parallel-comm --delay-wgrad-compute를 사용한다. 서로 다른 마이크로배치의 순방향과 역방향 계산을 교차 배치하고 가중치 기울기 계산을 미루는 옵션으로, 2노드 실험에서 처리량을 최대 35% 끌어올렸다. 단, 이 중첩 기능은 전체 활성화 재계산(--recompute-granularity full)과 함께 쓸 수 없고 GPU 메모리를 5~10 GB 더 예약한다.
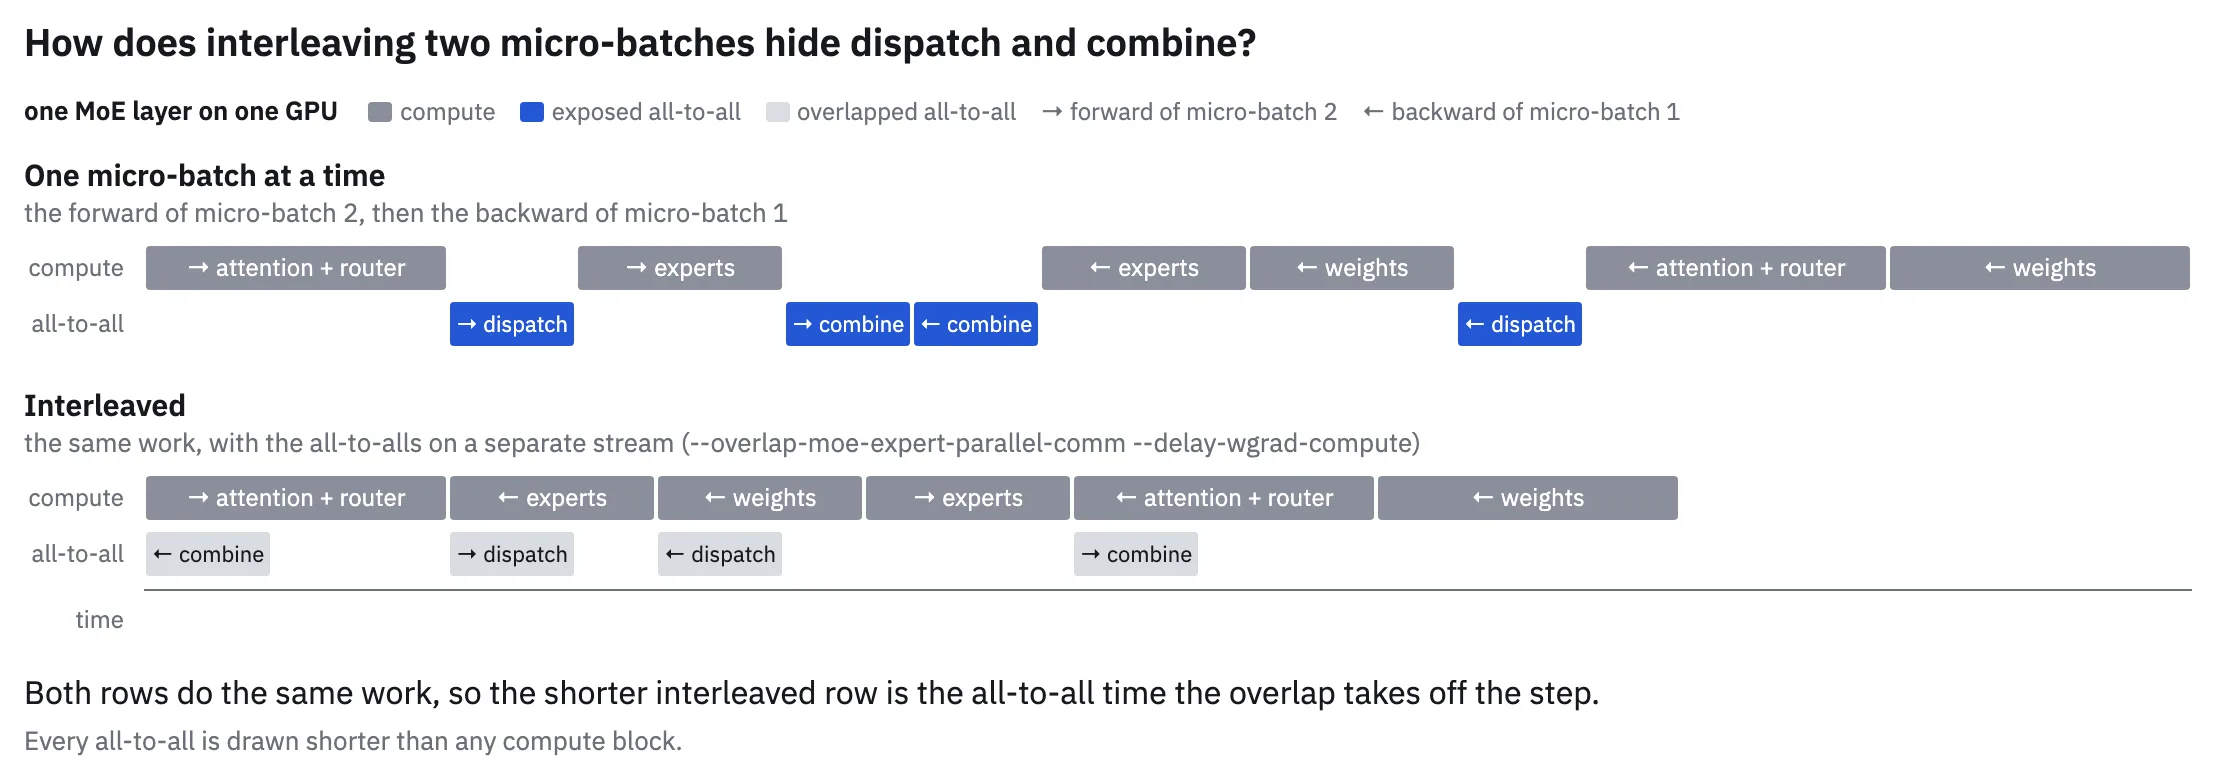 Figure 3.7.5: 순차 실행 시 노출되는 All-to-All 4개를 마이크로배치 교차와 wgrad 지연으로 다른 연산과 동시에 실행하는 스케줄 (출처: Hugging Face)
이때 부족한 메모리는 두 가지 방법으로 해결한다. 하나는 연산이 가벼운 정규화와 전문가 활성화만 선택적으로 재계산하는 것이다(--recompute-granularity selective --recompute-modules layernorm moe_act). 다른 하나는 세밀한 활성화 오프로딩이다(--fine-grained-activation-offloading --offload-modules core_attn attn_proj expert_fc1). 용량이 큰 어텐션 입출력과 전문가 첫 입력을 계산 도중 별도 스트림으로 CPU 핀 메모리에 저장했다가 다시 불러온다. NVIDIA의 H100 실측에서 이 조합은 피크 메모리를 18% 줄이면서 처리량 손실을 2%로 억제했다.
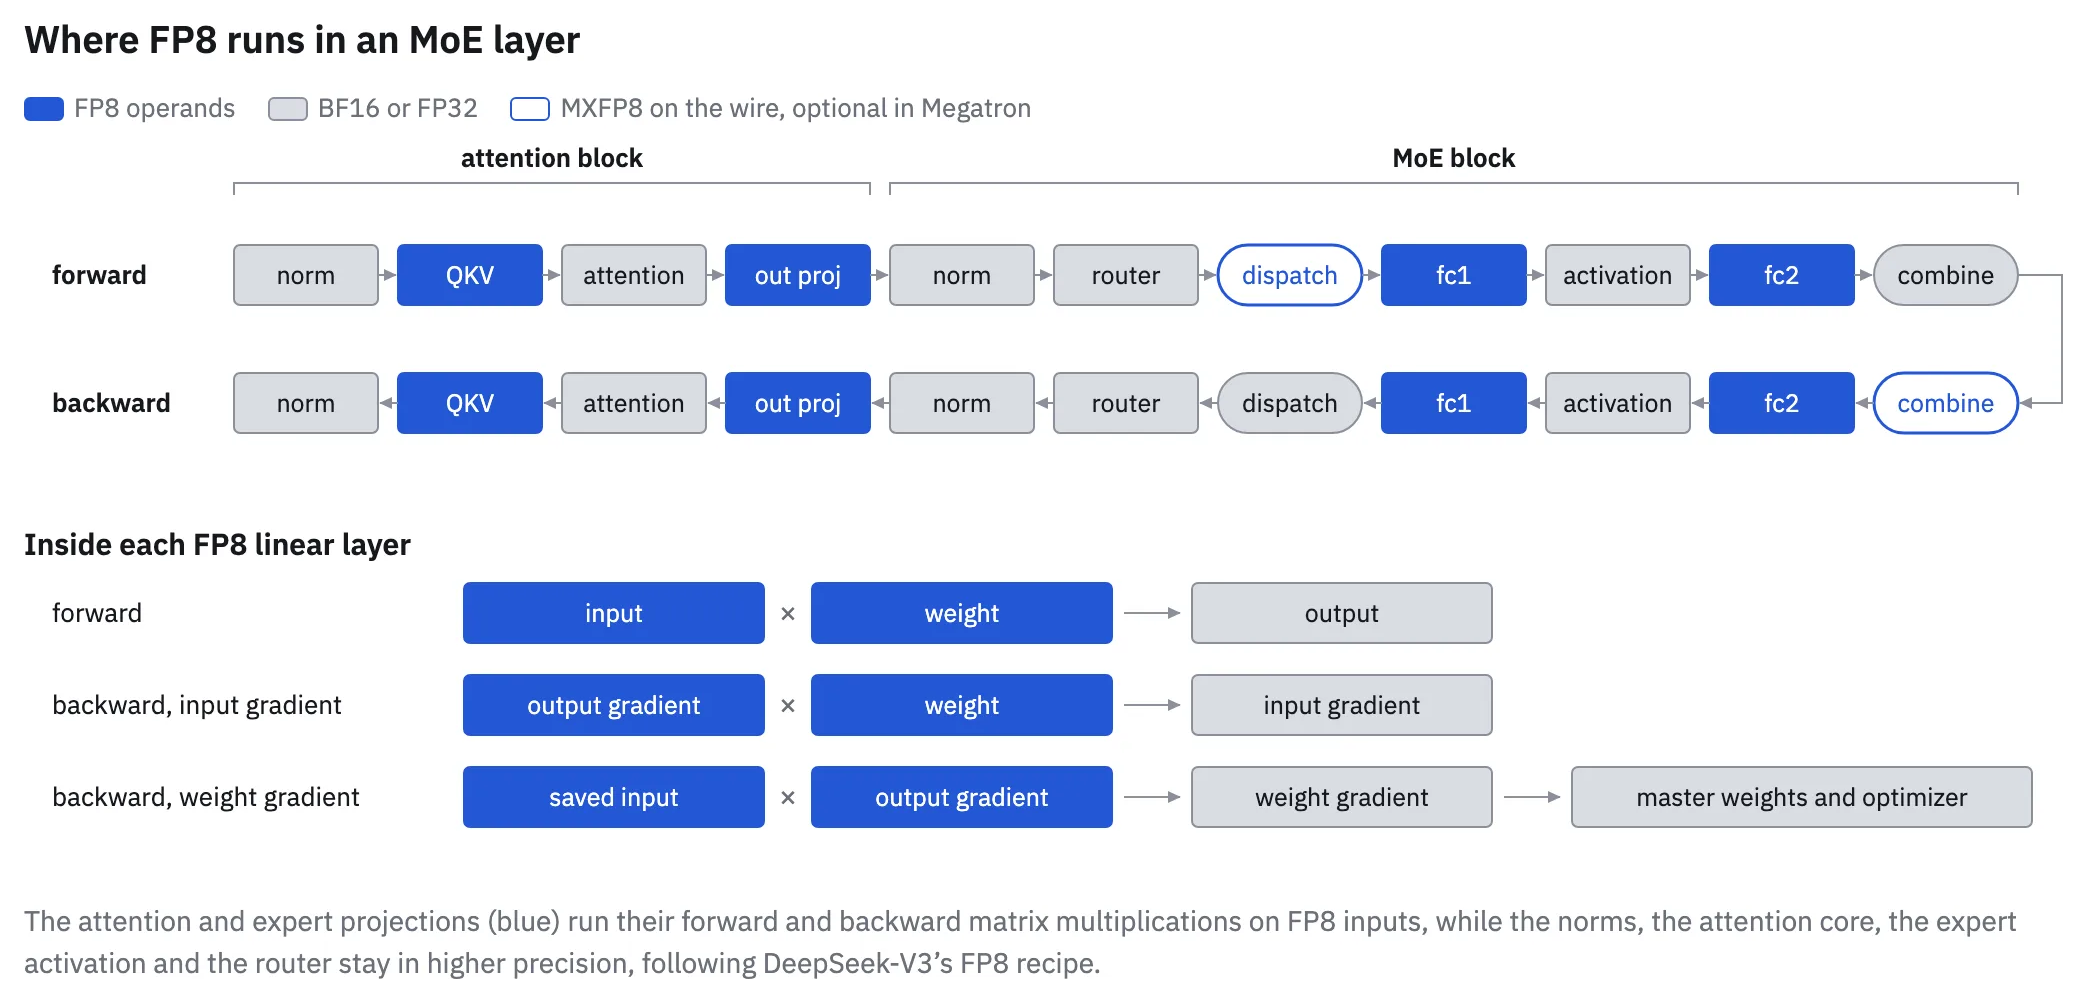 Figure 3.7.11: 순방향과 역방향 행렬곱에 FP8을 적용하면서 라우터, 정규화, 어텐션 코어는 BF16이나 FP32로 보호하는 구성 (출처: Hugging Face)
마지막은 연산 속도와 활성화 메모리를 함께 개선하는 저정밀도 학습이다. 라우터, 정규화, 어텐션 코어는 BF16이나 FP32로 보호하고, 전문가 선형 레이어는 낮은 정밀도로 실행한다. Hopper에서는 블록 단위 FP8(--fp8-recipe blockwise)을, Blackwell에서는 MXFP8이나 NVFP4(--fp4-format e2m1)를 쓴다. DeepSeek의 230B 모델과 Ling-1T는 FP8 학습에서 BF16보다 상대 손실 오차를 0.25% 이내로 유지했고, Ling-1T는 MFU도 약 15% 높였다. NVIDIA의 Nemotron 3 Super(120B-A12B, 25T 토큰)와 Ultra(550B-A55B, 20T 토큰)는 네트워크의 마지막 15%와 어텐션 투영을 BF16으로 유지하는 NVFP4 레시피를 썼고, Ultra는 BF16 분기와의 손실 차이가 평균 0.4% 미만이었다.
4. 학습에서 서빙과 강화학습 사후학습까지
서빙 시 활성 전문가 수($k$) 축소와 4비트 양자화
학습이 끝난 모델을 서빙할 때는 학습 때보다 적은 $k_1$개의 전문가만 실행해 토큰당 연산량을 줄일 수 있다. 이때 가중치를 다시 정규화하는 분모를 무엇으로 잡느냐에 따라 성패가 갈린다. Top-8로 학습한 모델을 Top-4로 서빙하면서 전문가 4개의 확률 합으로 재정규화하면, 남은 전문가들의 가중치가 학습 때보다 커져 출력 스케일이 왜곡된다. Chen과 Yao의 방법은 상위 $k_1=4$개 전문가만 실행하되 가중치 분모로는 상위 $k_2=16$개의 확률 질량을 쓴다. Qwen3.6-35B-A3B(전문가 256개 중 Top-8로 학습)에서 이 방법은 라우팅 파라미터 연산을 절반으로 줄였다. MMLU 하락폭은 남은 전문가만으로 재정규화했을 때 4.65점이었지만, 이 방법에서는 0.35점이었고 통계적으로 유의미하지 않았다($p=0.66$).
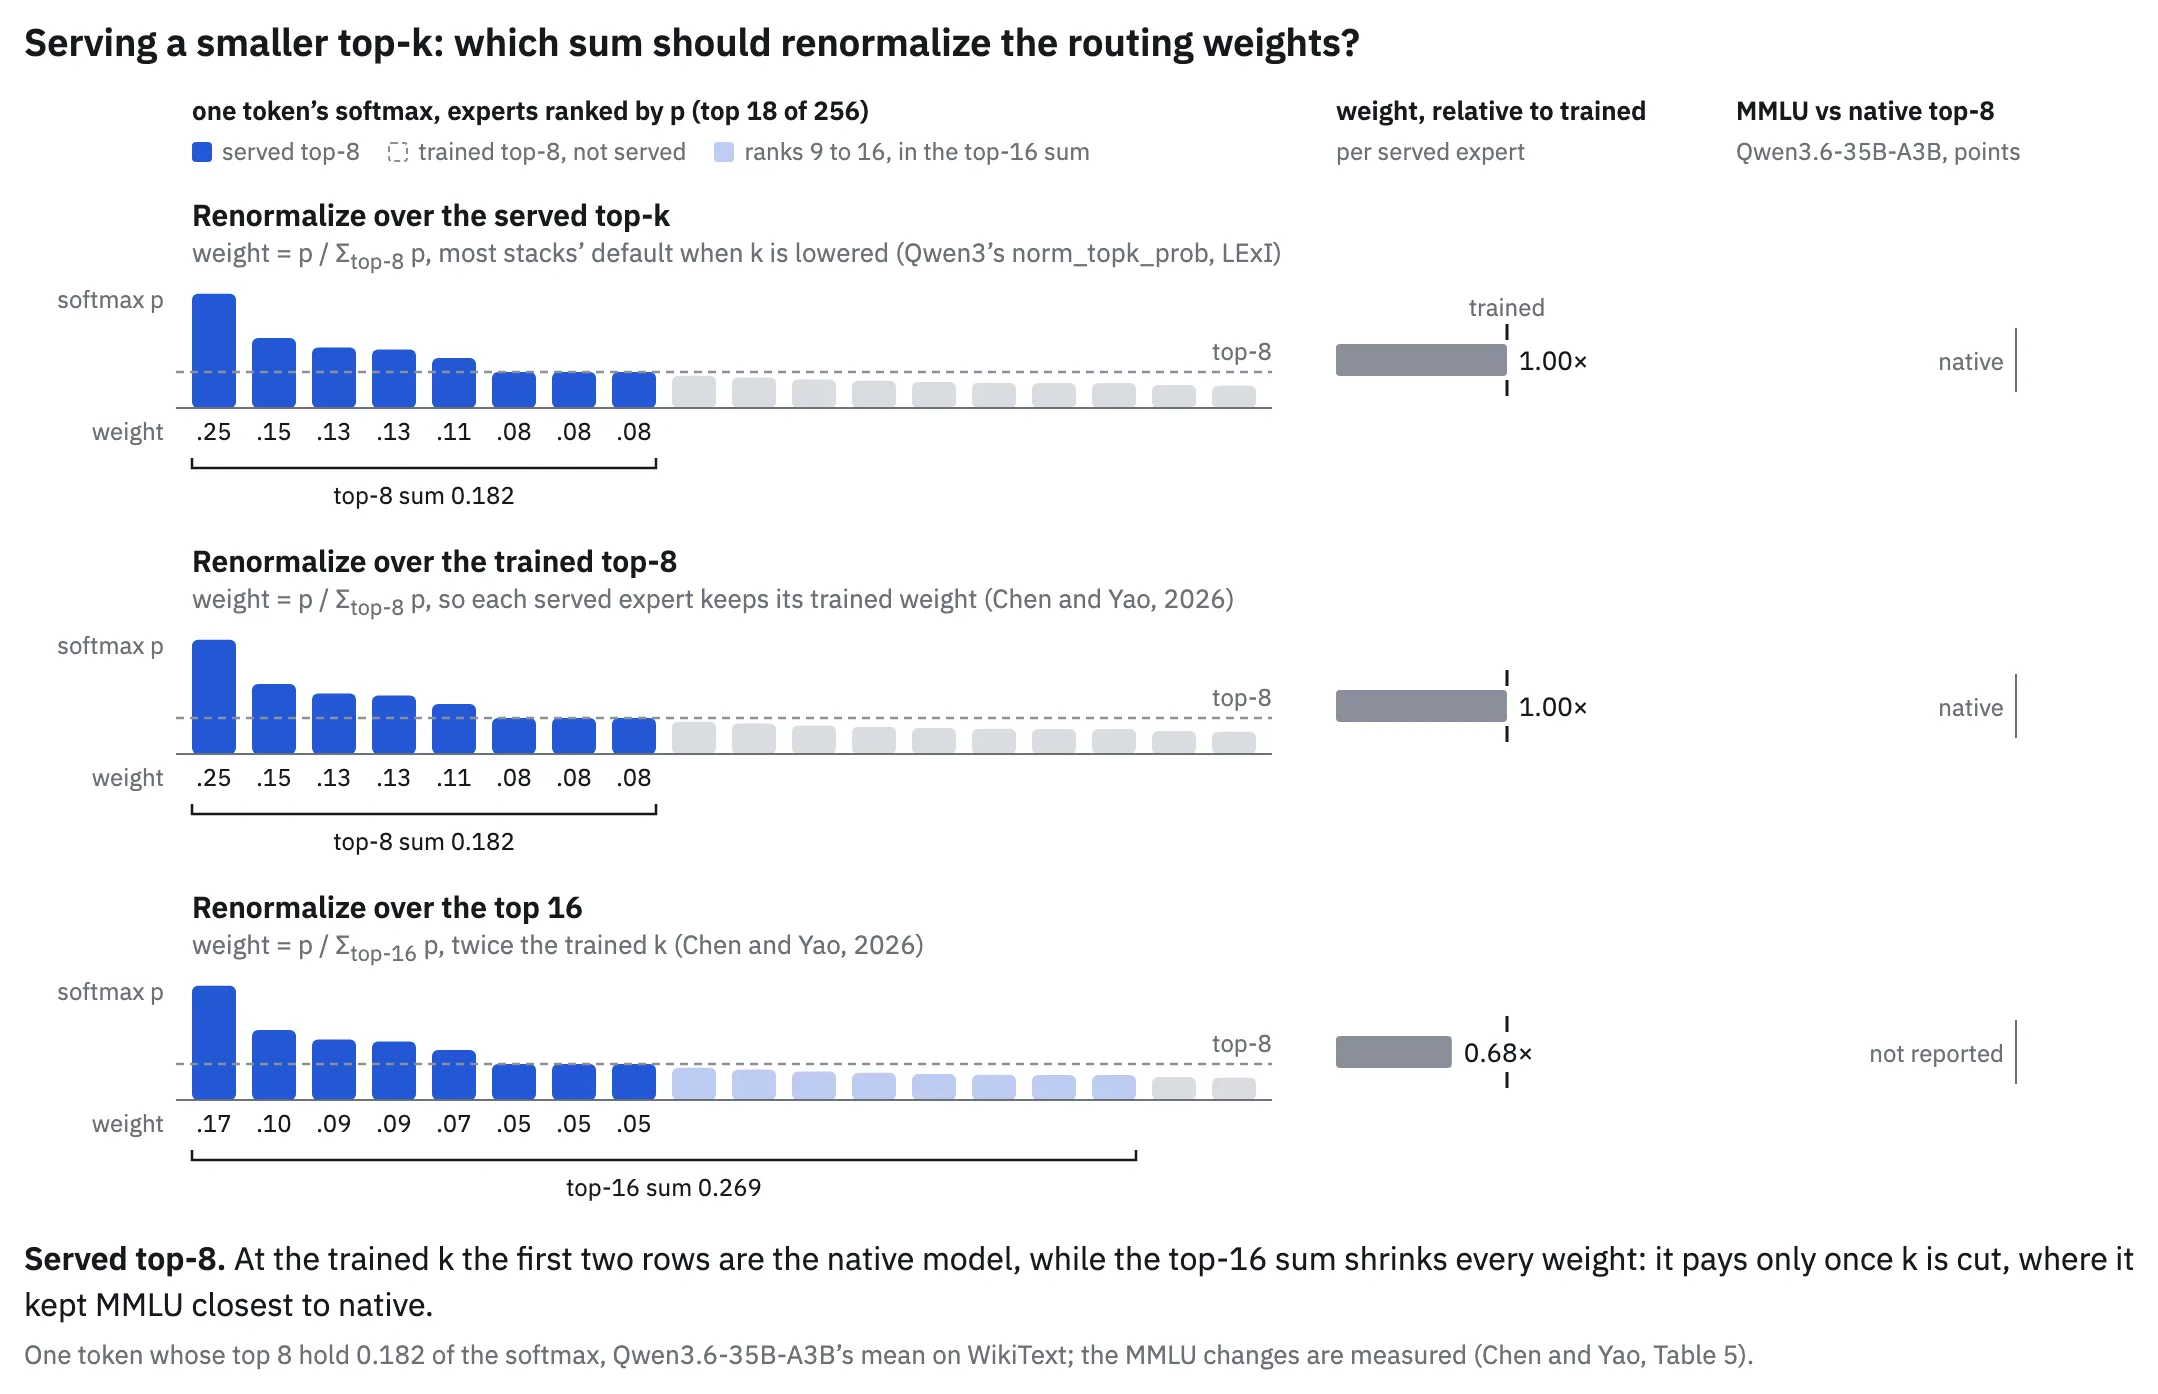 Figure 4.1: Qwen3.6-35B-A3B 형태의 평탄한 라우터에서 서빙 k를 줄일 때 분모 선택에 따른 가중치 크기와 MMLU 점수 변화 (출처: Hugging Face)
메모리가 병목일 때는 전체 파라미터의 90% 이상을 차지하는 라우팅 전문가만 4비트로 양자화한다. OpenAI의 gpt-oss-120b(MXFP4, 파라미터당 4.25비트)는 이 방법으로 80 GB GPU 한 대에 적재된다. Kimi K3와 DeepSeek-V4도 사후학습 단계에서 라우팅 전문가를 MXFP4로 양자화한다. gpt-oss-20b에서 라우팅 전문가를 4비트로 줄이면 전체 메모리 크기는 39.0 GiB에서 12.8 GiB로 약 3분의 1이 된다. 하지만 배치 1 디코딩에서 토큰 하나가 읽는 가중치 용량은 6.72 GiB에서 3.45 GiB로 약 절반이 되는 데 그친다. 토큰마다 전체를 다 읽는 BF16 어텐션과 출력 헤드가 남은 읽기 바이트의 3분의 2를 차지하기 때문이다.
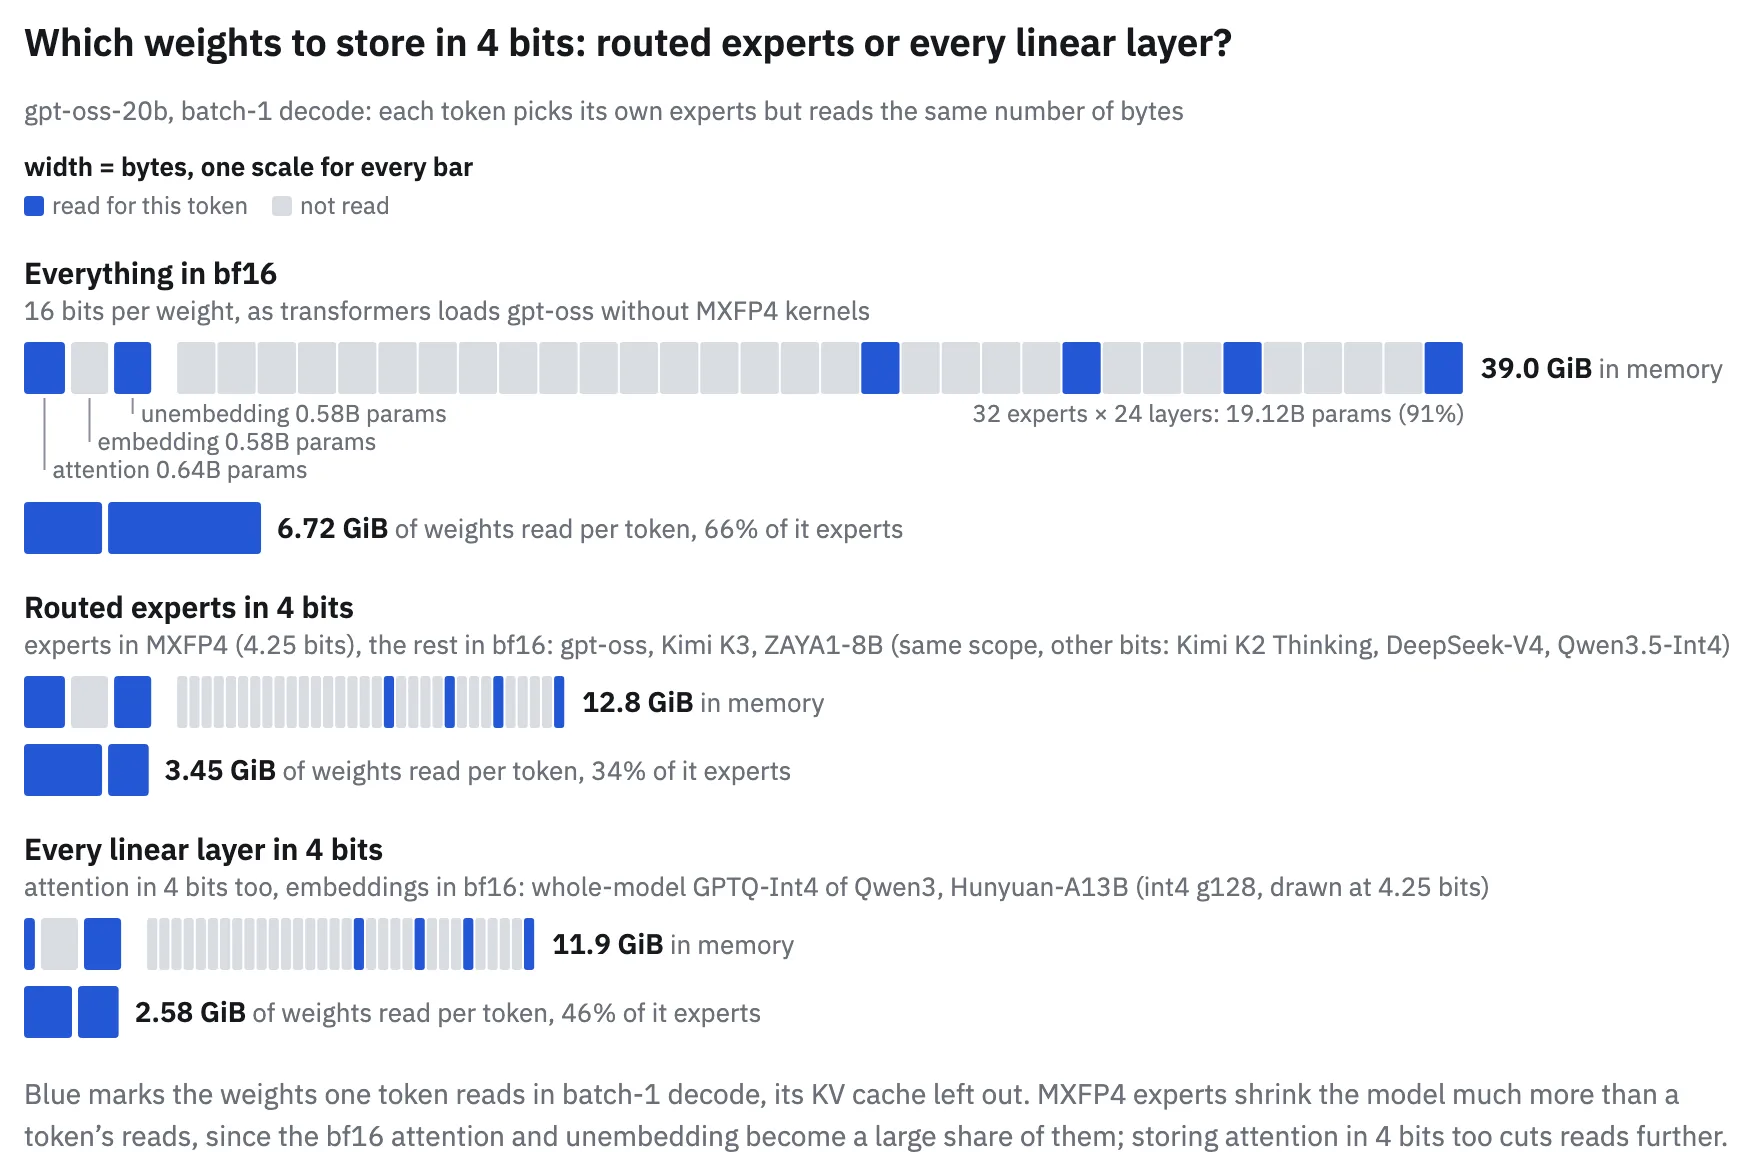 Figure 4.2: 전체 BF16, 라우팅 전문가만 4비트, 전체 선형 레이어 4비트 구성에서의 모델 메모리와 토큰당 읽기량 비교 (출처: Hugging Face)
서빙 단계의 전문가 병렬화(EP)와 어텐션-FFN 분리
서빙은 대량의 프롬프트 토큰을 한꺼번에 처리하는 프리필(prefill)과 요청당 토큰 하나씩을 생성하는 디코딩(decode)의 두 단계로 구분된다. 디코딩에서는 스텝당 토큰 수가 적어 각 전문가가 읽는 가중치보다 배치 크기가 너무 작아진다. 이 때문에 DeepSeek는 V4.1-Flash를 서빙할 때 프리필은 메모리가 허용하는 가장 좁은 범위인 EP2~EP8로 실행하고, 디코딩은 가능한 한 넓은 EP64~EP128로 실행한다. 넓은 EP의 효과는 실제 요청 부하에서 뚜렷하게 나타난다. GPU당 요청이 64개일 때 EP64(GPU당 전문가 7개)의 처리량은 GPU당 초당 약 15,700 토큰, 사용자당 초당 246 토큰이다. EP8(GPU당 전문가 52개)은 GPU당 초당 12,600 토큰, 사용자당 초당 198 토큰이므로 EP64가 약 25% 높다. 이때 DeepSeek의 추론 엔진 DeepInfer는 인기 전문가의 복제본(redundant experts)을 여유 슬롯에 배치하고, 디코딩 기준 10,000 스텝마다 재배치한다. 이렇게 하면 가장 느린 GPU의 부하가 평균의 1.09배 이내로 유지된다.
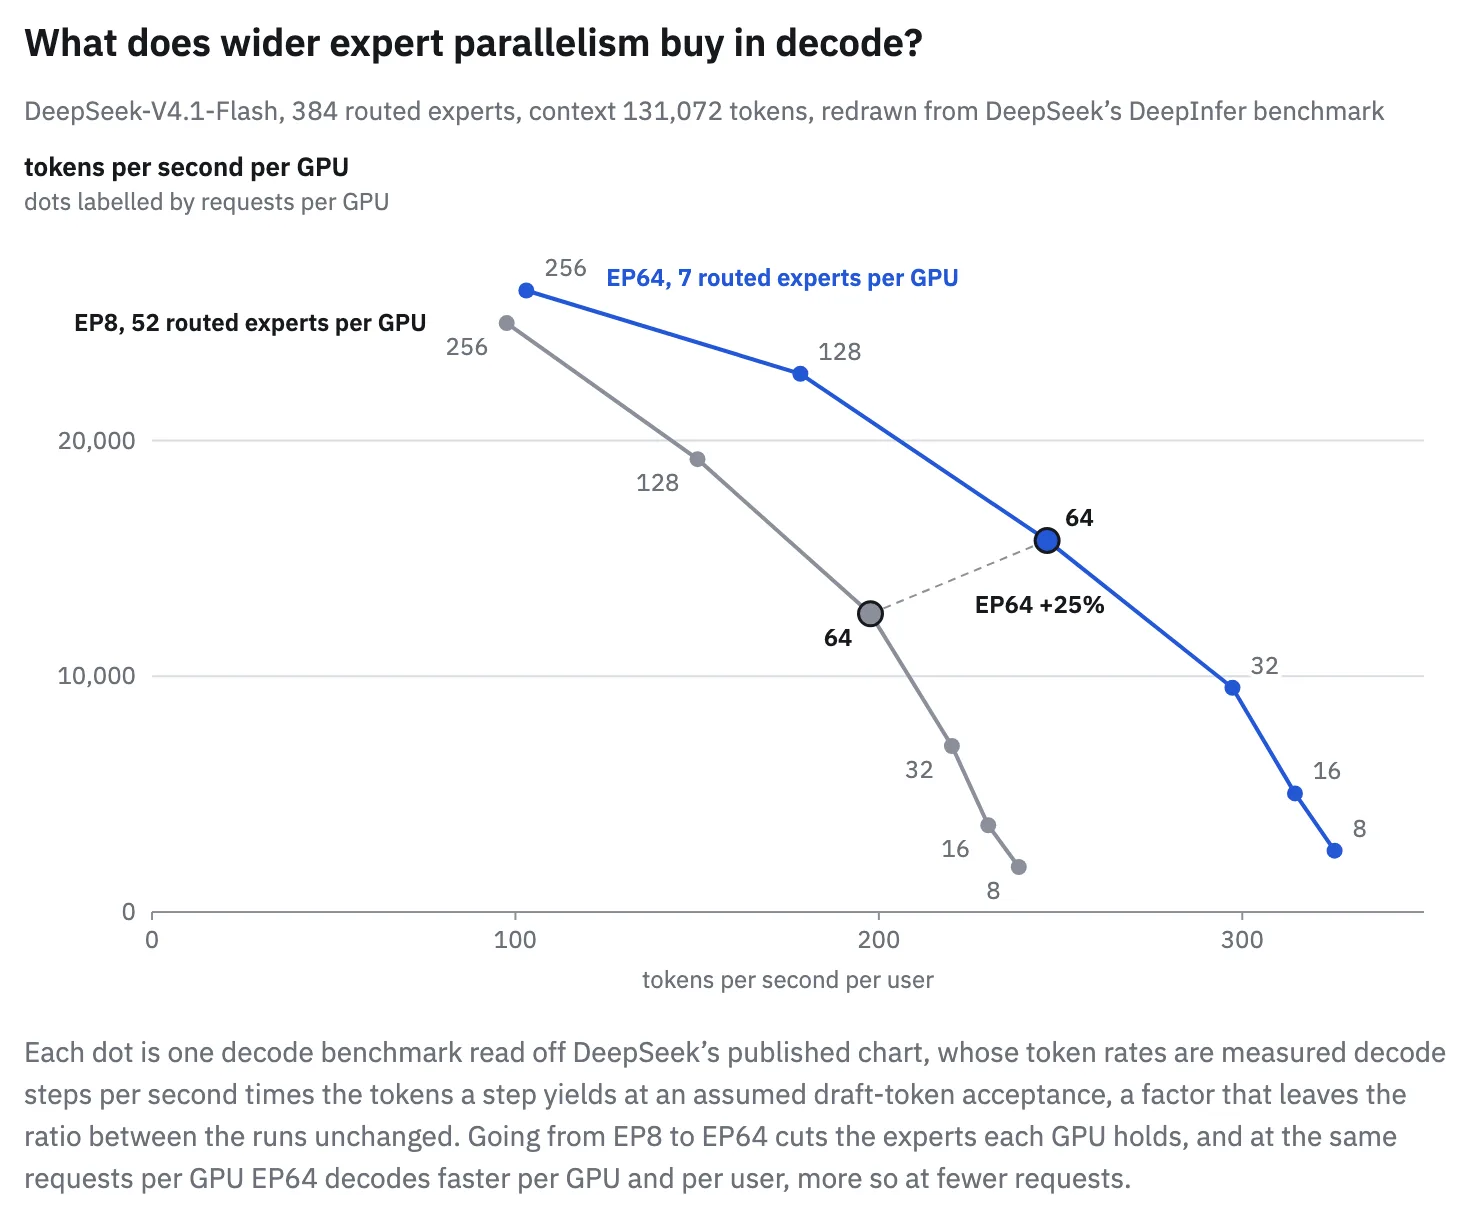 Figure 4.3: 디코딩 단계에서 전문가 병렬화 폭(EP8 대 EP64)에 따른 GPU당 처리량과 사용자당 출력 속도 비교 (출처: Hugging Face)
어텐션-FFN 분리(Attention-FFN Disaggregation, AFD)도 시도되고 있다. KV 캐시를 계속 유지해야 하는 어텐션과, 요청별 상태가 없는 전문가를 아예 별도의 GPU 풀에서 실행하는 방식이다. FastAFD는 동시 배치 EP4보다 처리량이 1.41배 높다고 보고했다. 그러나 Qiu 등(Meituan)이 분석 모델에서 같은 GPU 72대 예산으로 두 구성을 각각 다시 최적화하자 이 비율은 0.99배로 떨어졌다. 도입 전에 같은 GPU 예산 기준의 실익을 먼저 따져 봐야 한다.
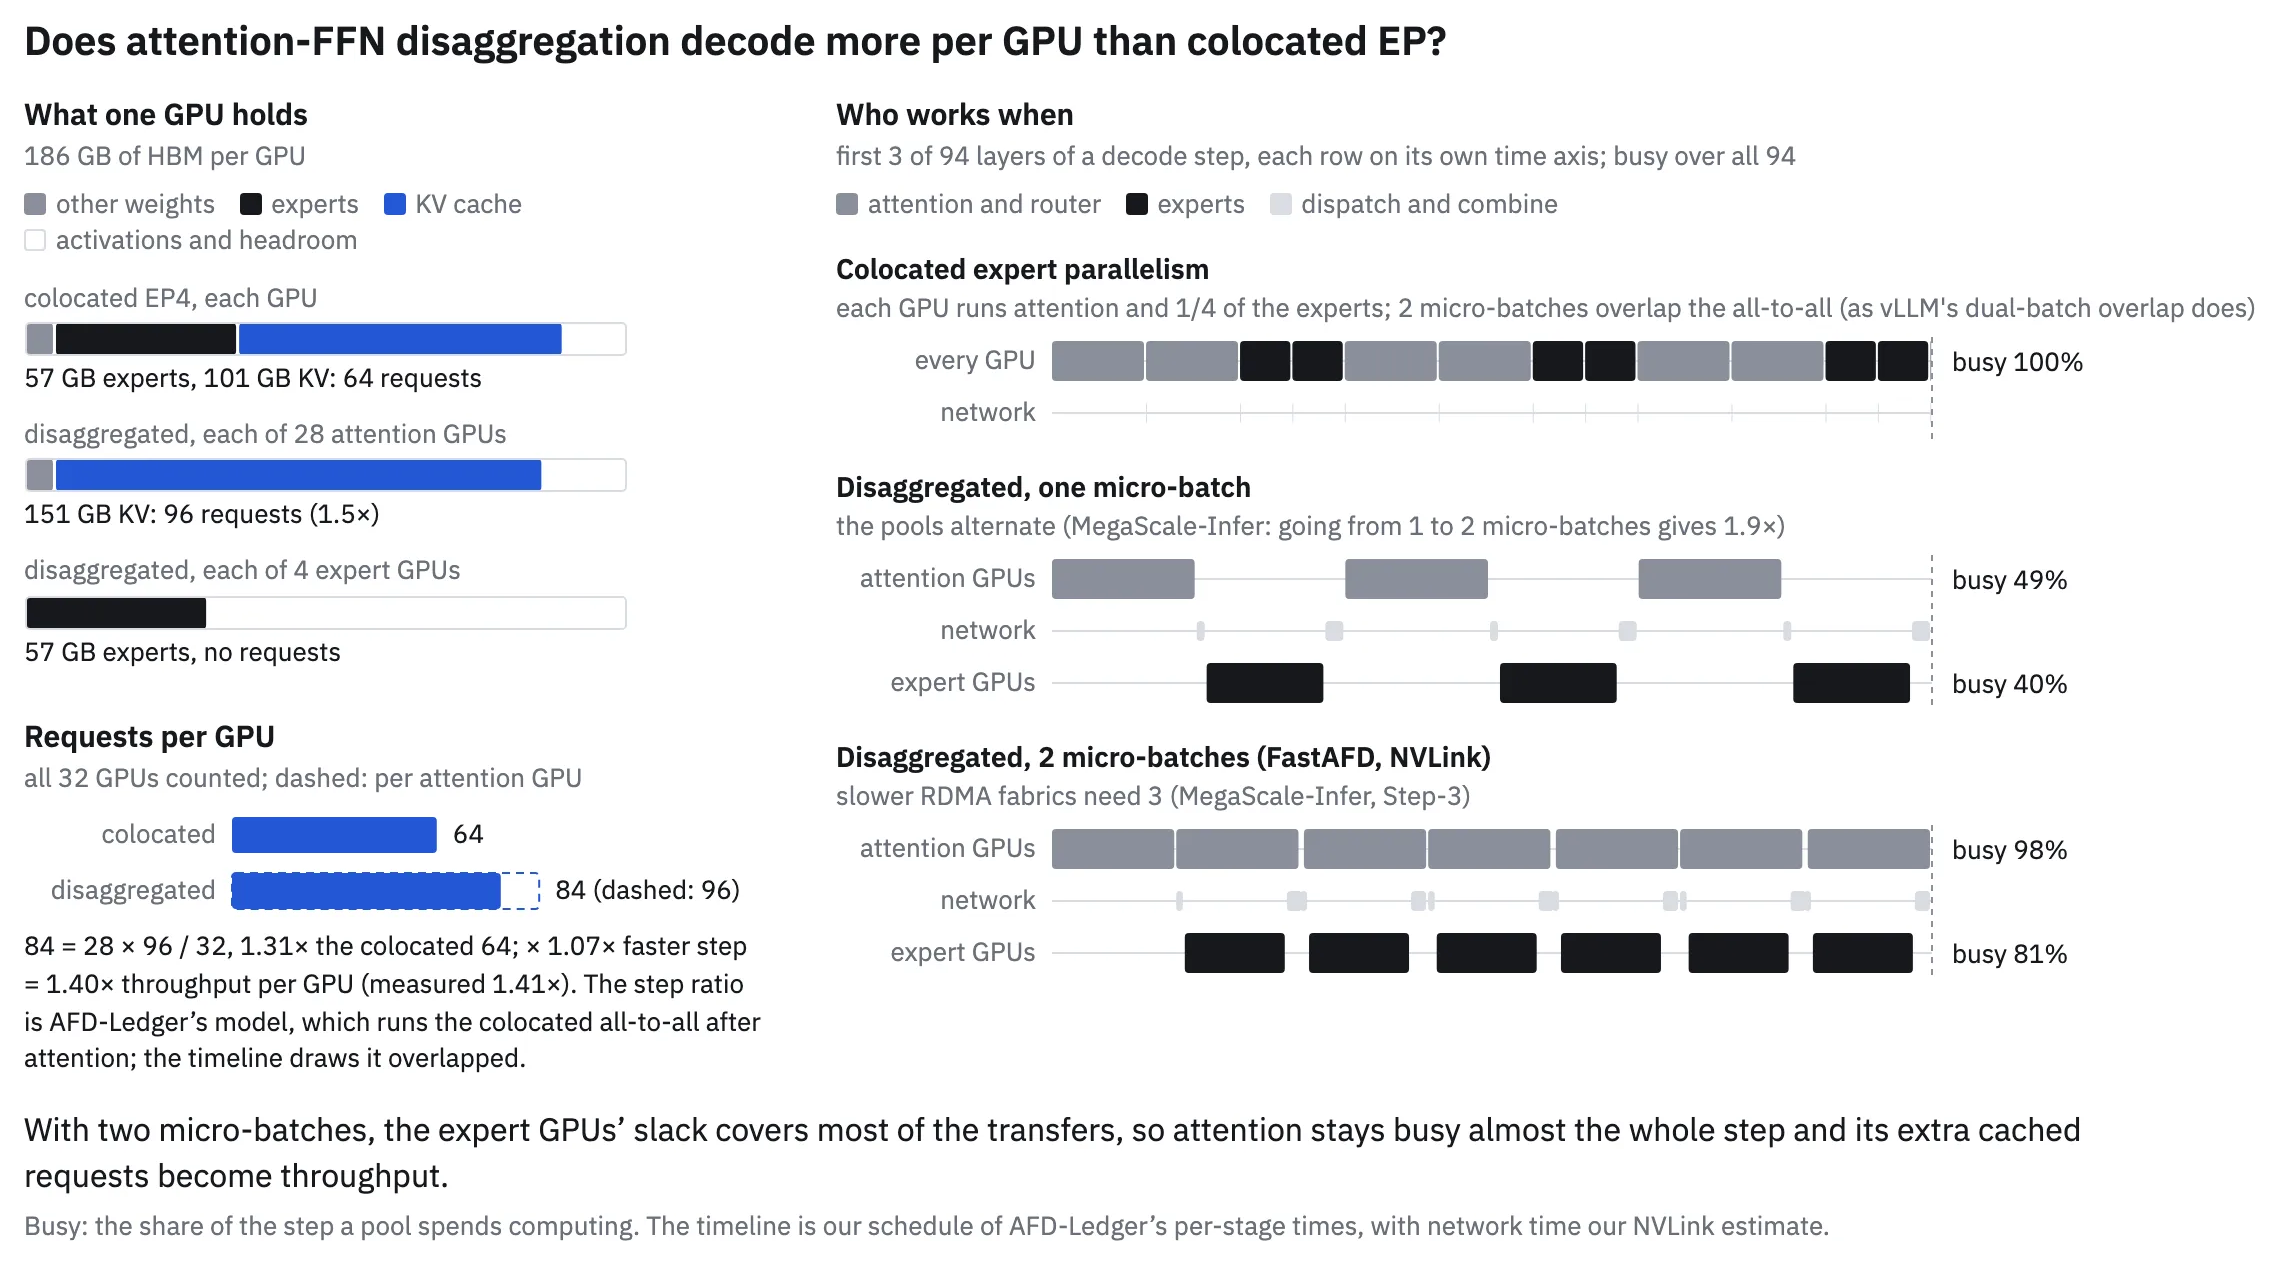 Figure 4.4: 동시 배치 EP4와 어텐션-FFN 분리(AFD) 구성의 GPU 메모리 배분과 마이크로배치 중첩 시 연산 가동률 비교 (출처: Hugging Face)
강화학습(RL) 사후학습의 라우팅 불일치와 라우팅 리플레이
강화학습 사후학습에서는 추론 엔진(SGLang, vLLM 등)이 롤아웃 샘플을 생성하고 트레이너(Megatron 등)가 같은 토큰에 대해 기울기를 계산한다. MoE에서는 두 엔진의 커널 수치 차이와 비동기 업데이트로 인한 가중치 시차 때문에 트레이너가 롤아웃 때와 다른 전문가를 선택할 수 있다. Ma 등의 Qwen3-30B-A3B 실측에서는 두 엔진 간 라우터 선택의 약 10%가 달랐고 전체 토큰의 94%가 최소 한 개 레이어에서 다른 전문가를 거쳤다. Zheng 등의 GSPO 연구에서도 단 한 번의 기울기 업데이트만으로 같은 롤아웃의 활성 전문가 중 약 10%가 바뀌었다.
이 불일치를 제거하는 대표적 방법이 Ma 등이 제안하고 DeepSeek-V3.2, MiMo-V2-Flash, Instella-MoE가 채택한 라우팅 리플레이(Routing replay, R3)다(--moe-enable-routing-replay). 롤아웃 엔진이 선택한 전문가 인덱스(routing_indices)를 기록해 둔다. 트레이너는 순방향(REPLAY_FORWARD)과 재계산 역방향(REPLAY_BACKWARD) 패스에서 이 인덱스를 그대로 불러와, 현재 라우터 점수를 해당 인덱스에서만 수집한다. Ma 등의 실험에서 리플레이는 학습-추론 간 KL 발산을 1.5e-3에서 밀집 모델 수준인 7.5e-4로 절반가량 낮추고 GRPO 학습 붕괴를 막았다.5 커널 자체의 배치 구성별 수치 차이까지 없애려면 FlashAttention 3이나 4 기반의 --batch-invariant-mode를 켠다. 롤아웃을 양자화할 때는 가중치만 양자화하는 편이 안전하다. Zhuge 등(Qwen)의 실험에서 활성화 양자화는 약 150 스텝 만에 학습 붕괴를 유발했다.
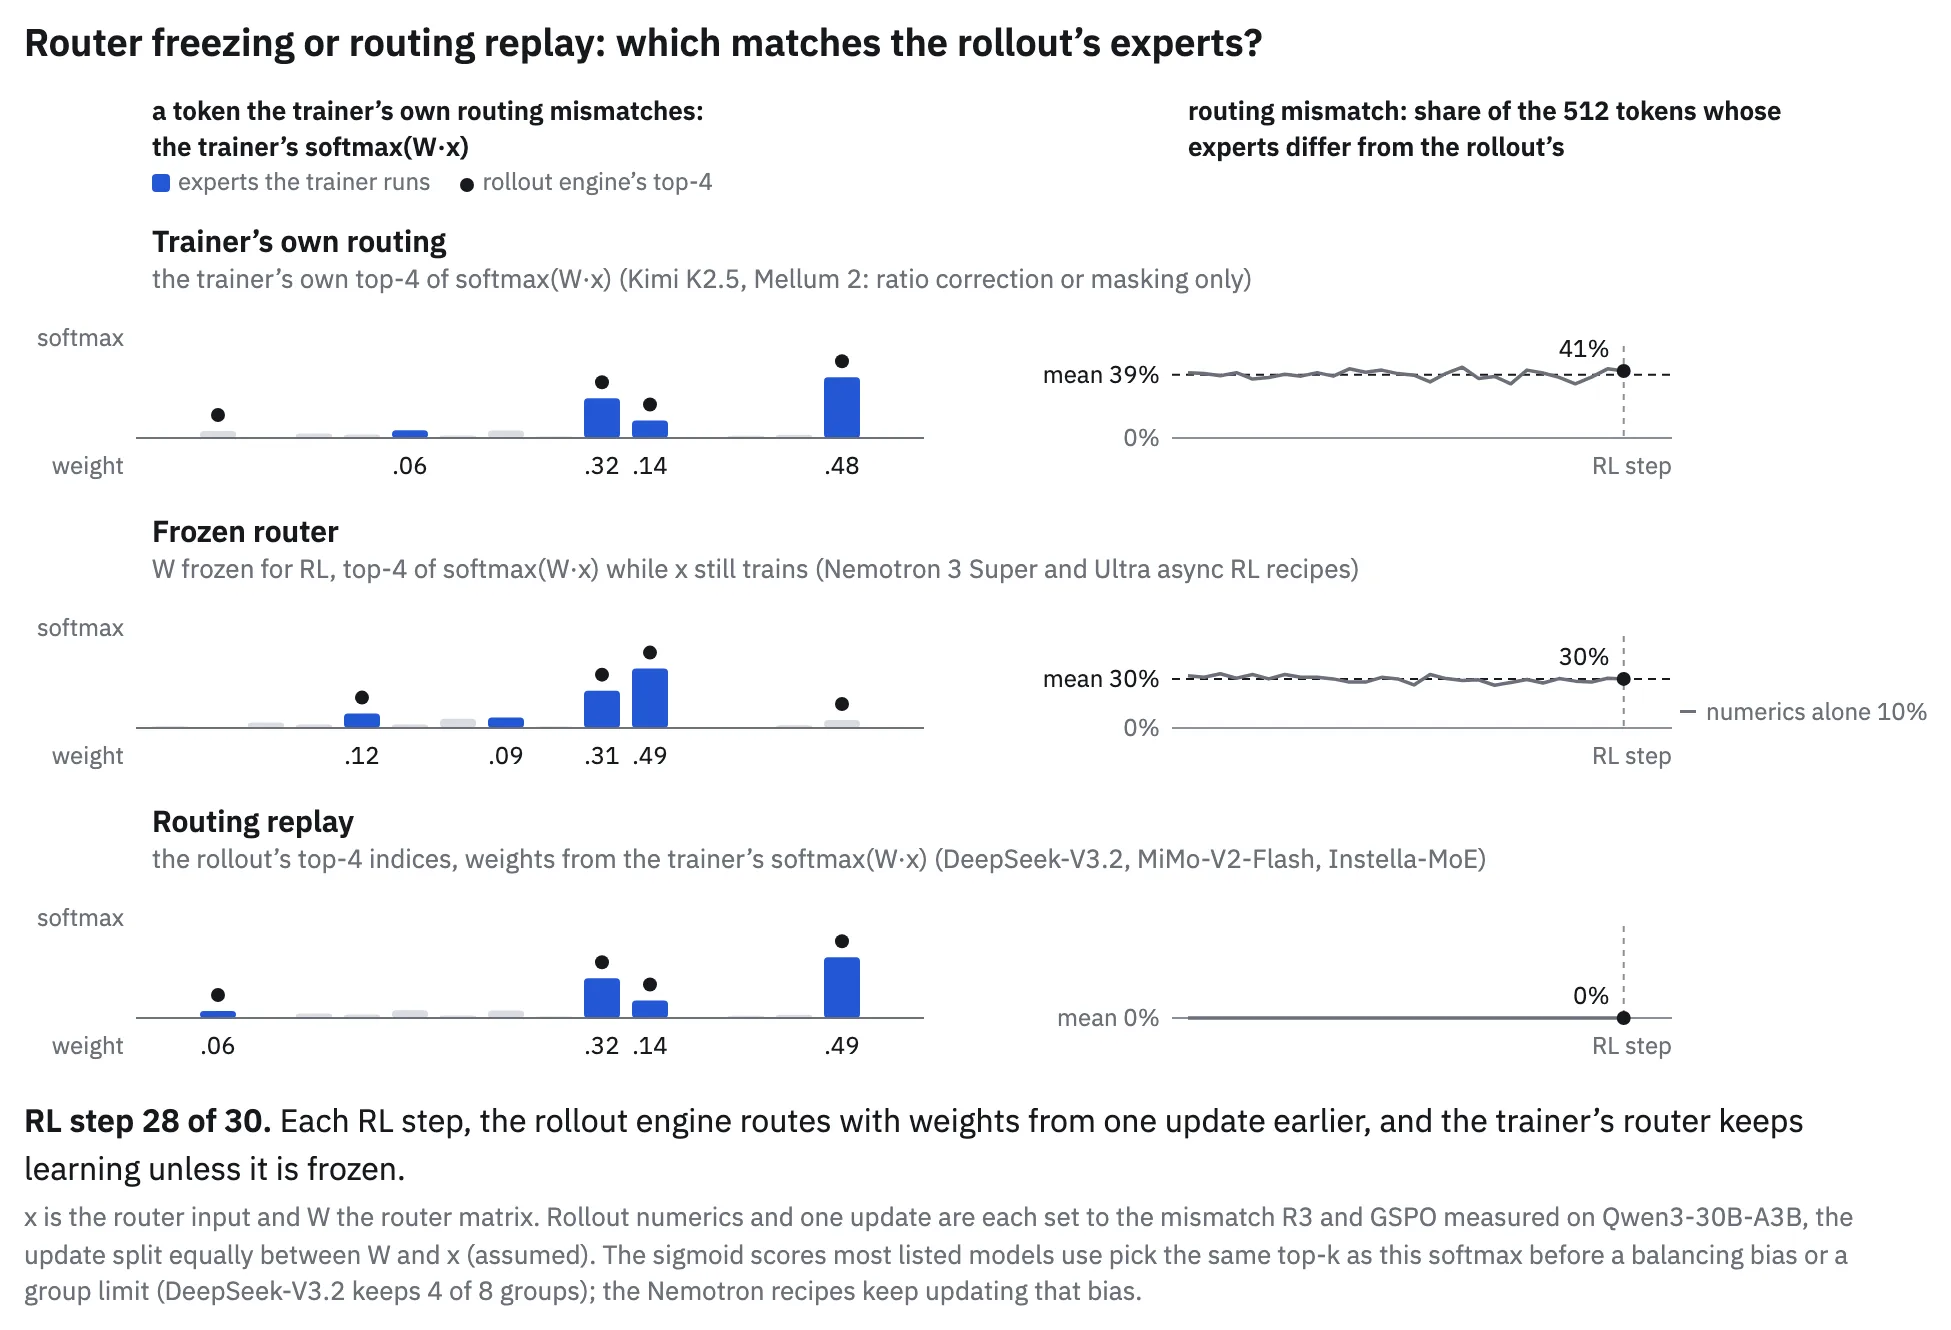 Figure 4.5: 롤아웃 엔진과 트레이너 사이의 전문가 선택 불일치 추이와 라우팅 리플레이(Replay)의 불일치 제거 효과 (출처: Hugging Face)
가장 흥미로운 지점
3.6절과 부록 A.2는 학습 손실 곡선에 아무런 이상이 없을 때도 내부에서 진행되는 조용한 실패(quiet failures)와 보조 손실 수치의 함정을 집중적으로 파헤친다. 밀집 모델을 훈련할 때는 보통 손실(loss)과 기울기 노름(grad norm)만 순조롭게 감소하면 내부 상태도 정상이라고 판단한다. 하지만 MoE에서는 전체 학습 손실이 꾸준히 줄어드는 동안에도 전문가가 폭주할 수 있다. Step 3.5 Flash의 45번 레이어에서는 전문가 한두 개의 출력 노름이 레이어 중앙값의 5,700배까지 커졌다. 이와 반대로 일부 전문가는 토큰을 전혀 받지 못하는 죽은 전문가가 되어 파라미터를 놀리기도 한다.
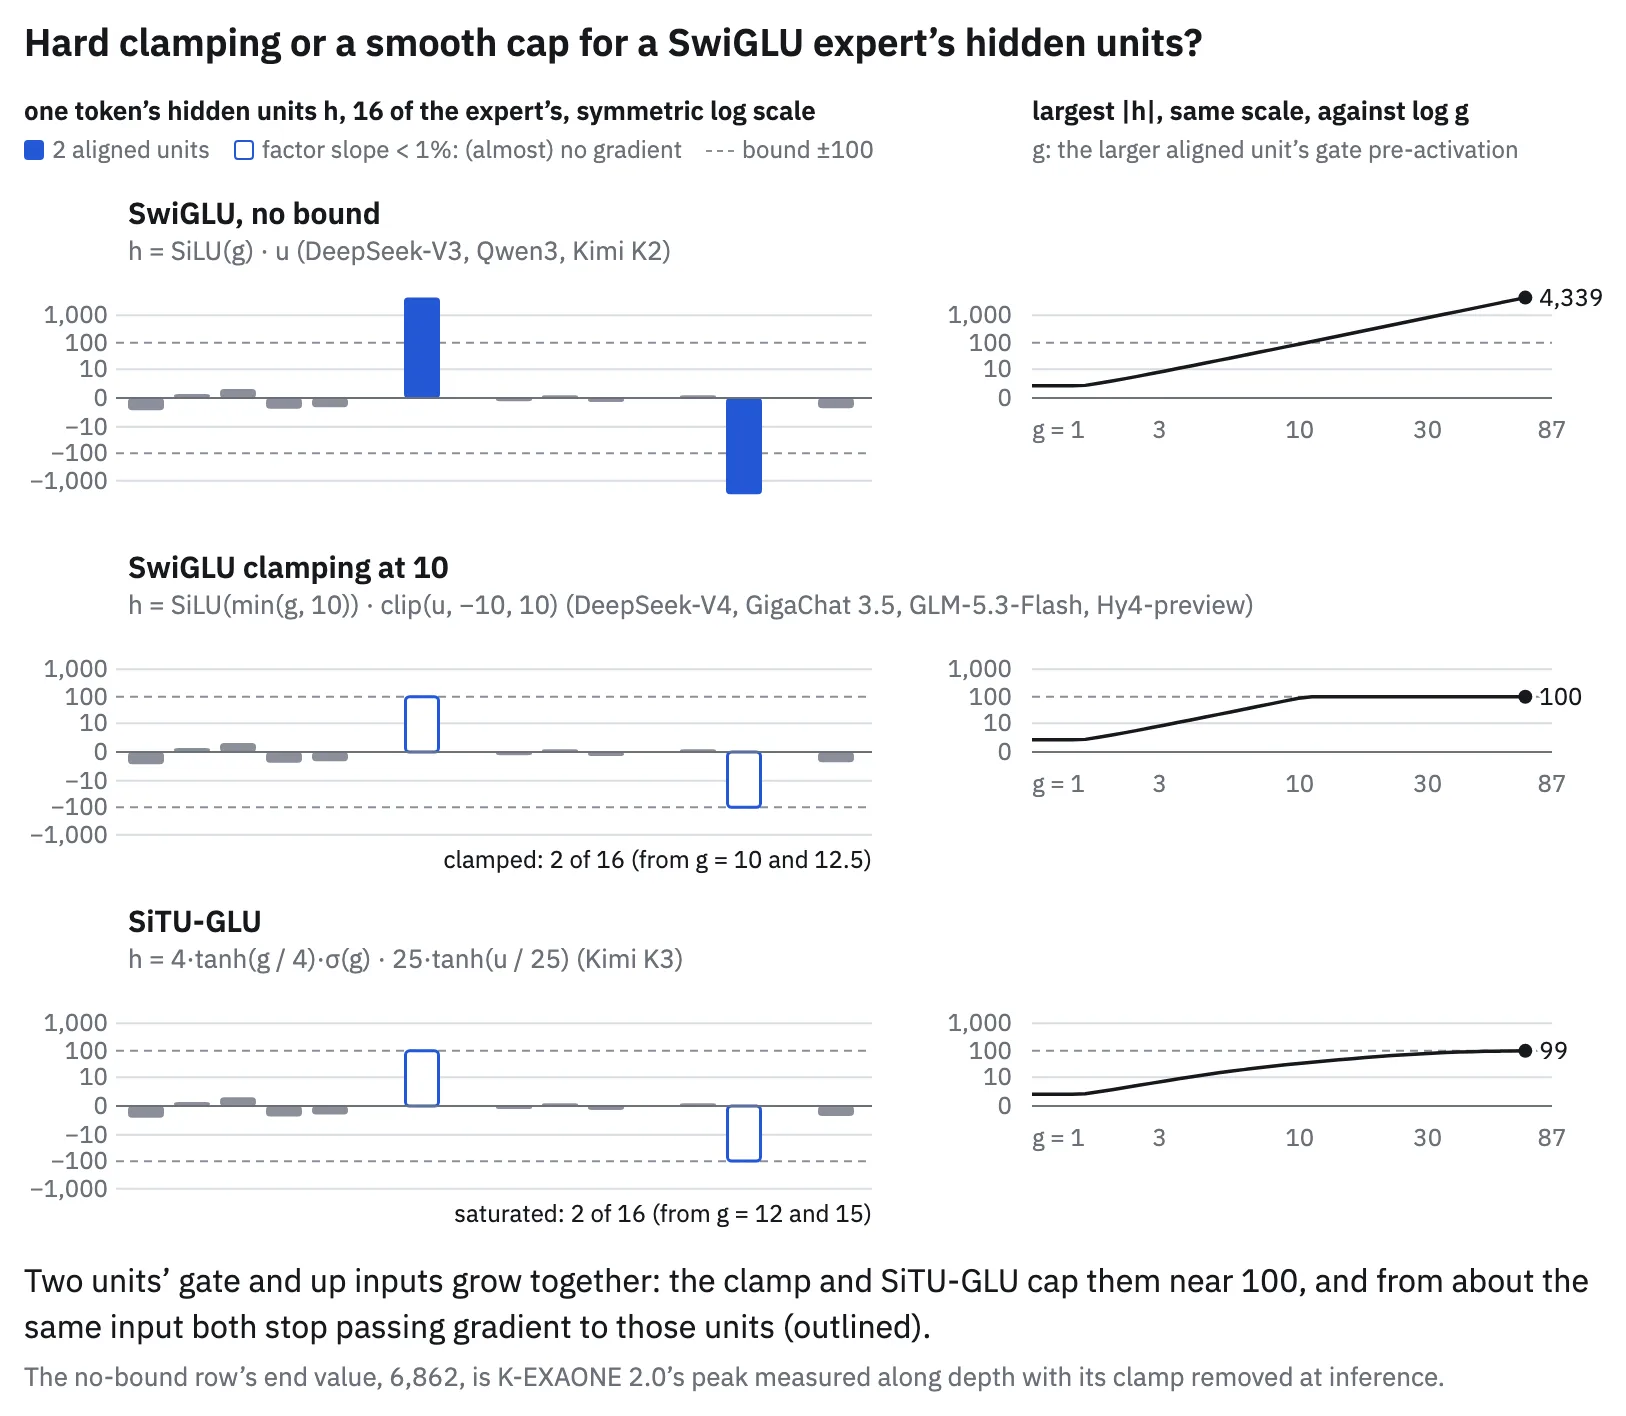 Figure 3.4.8: 상한이 없는 SwiGLU에서 게이트와 업 투영 입력이 정렬될 때 활성화 크기가 급증하는 현상과 클리핑(10), SiTU-GLU의 억제 효과 (출처: Hugging Face)
부하 분산을 확인하려고 켜 둔 보조 손실(aux loss) 수치마저 실제 상태를 반영하지 못한다. 보조 손실은 각 전문가의 토큰 점유율과 평균 라우터 확률을 곱해 더한다. 라우터가 확률 분포만 $1/N$로 균등하게 만들면, 실제 토큰이 소수 전문가에 몰려 GPU 한 대가 전체 스텝을 지연시켜도 보조 손실 값은 완전 균등 상태와 같은 1.0으로 기록된다(Sigma-MoE-Tiny 사례). 따라서 MoE 학습에서는 손실 함수 하나로 건전성을 판단할 수 없다. 실제 토큰 카운트에서 계산한 레이어별 MaxVio를 보고, 전문가 출력 노름의 최댓값과 최솟값이 중앙값의 몇 배인지도 직접 확인해야 한다. 그래야 클러스터가 왜 느려졌는지, 모델이 왜 조용히 망가지고 있는지 알아챌 수 있다.
출처
- 저자: Nouamane Tazi, Leandro von Werra, Thomas Wolf (Hugging Face)
- 발행일: 2026-11-05
- 원문: https://huggingface.co/spaces/huggingface/moe-training-handbook / https://huggingface.co/spaces/huggingface/moe-blogpost (본문 앱: https://huggingface-moe-blogpost.hf.space/)
Artificial Analysis Intelligence Index v5.0.1 기준 상위 20개 오픈웨이트 모델 중 밀집 모델은 12위 Nanbeige4.3-33B와 13위 Qwen3.8 27B 두 개뿐이다. ↩︎
시퀀스 길이 4,096, 마이크로배치 8, 글로벌 배치 512(스텝당 2,097,152 토큰), WSD 학습률 스케줄(피크
5e-4)을 사용하며 실험 지표는 Hugging Face의 경량 오픈소스 트래커인 Trackio(trackio==0.42.0)로 기록한다. ↩︎단, $k=1$(Top-1)에서 Softmax를 쓸 때는 선택된 단일 로짓에 대한 재정규화 산출값이 항상 1이 되어 라우터에 기울기가 흐르지 않는다. 이때는
--moe-router-pre-softmax를 켜서 전체 전문가에 대한 Softmax 확률을 먼저 구한 뒤 Top-1을 뽑아야 한다. ↩︎보조 손실 수치 자체만 보고 부하 균형을 판단해서는 안 된다. 라우터 확률이 $1/N$로 완전히 평탄해지면 실제 토큰 배정이 소수 전문가에 편중되어 있어도 보조 손실 값은 최소치인 1.0으로 계산된다(Sigma-MoE-Tiny 하위 레이어 사례). 따라서 반드시 실제 토큰 카운트에서 계산한 MaxVio를 함께 감시해야 한다. ↩︎
리플레이를 쓰지 않는 방법도 있다. Kimi K2.5, Mellum 2, GSPO(시퀀스 단위 중요도 샘플링 비율 사용)는 확률 비율의 차이가 큰 토큰이나 시퀀스의 기울기를 마스킹한다. 온폴리시 환경에서는 리플레이의 보상 이득이 뚜렷하지 않다는 후속 보고도 있다. 자신의 RL 파이프라인에서 불일치 비율을 먼저 측정한 뒤 채택 여부를 결정하는 것이 좋다. ↩︎