3줄 요약
- 일본 개발자 mizchi가 2026년 9월 24일 GitHub에 explainer 저장소를 공개했다. AI가 독자 한 명에게 맞춰 설명을 쓰도록 돕는 Claude Code 플러그인이며, 스킬 세 개와 검증 스크립트로 구성된다. 9월 30일 기준으로 별 82개를 받았고 라이선스는 MIT다.
- 이 플러그인을 쓰면 에이전트는 글을 쓰기 전에 독자 한 명의 페르소나 파일부터 만들고, 그 독자가 이미 아는 내용은 본문에서 생략한다. 본문에 인용한 실행 결과는 스크립트를 다시 실행해 대조하고, 그림은 사실 시트와 비교한다. 확인하지 못한 주장에는 “미검증"이라고 적는다.
- 저자는
claude plugin eval로 스킬이 있을 때와 없을 때를 열 차례 비교했다. 스킬을 썼을 때 뚜렷하게 달라진 점은 두 가지였다. 실행하지 못한 코드가 있으면 그 사실을 보고했고, 이해도 점검 문제에 답을 함께 제시했다. 독자 정보를 요청문이나 페르소나 파일로 제공했을 때는 스킬이 없어도 모델이 독자가 아는 내용을 생략했다.
저장소가 풀려는 문제
README는 첫머리에서 제프리 리트의 글 「이해가 새로운 병목이다」를 인용한다1. 사람이 코드를 이해하는 속도가 코딩 에이전트가 코드를 쓰는 속도보다 느려졌다는 것이다. 저자는 이 저장소의 목적을 이렇게 적었다.
독자 한 명을 위해, 그 독자가 모르는 것만, 도구로 검증한 주장과 그림으로 쓴다.
README는 비슷한 목적의 스킬인 ELI5와도 비교한다2. ELI5는 독자를 나이나 직업 같은 유형으로 다루는데, explainer는 실존하는 한 사람을 독자로 삼고 쓴 내용을 도구로 검사한다는 것이다.
플러그인은 다음 스킬 세 개로 구성된다.
| 스킬 | 용도 |
|---|---|
explainer | 독자 한 명을 위한 속성 강좌 문서 하나. 주장과 그림을 도구로 확인한다 |
explainer-book | 장으로 구성한 강좌. 학습 목표, 개념 순서, 읽는 시간, 연습 문제를 검사한다 |
first-reader | 발행 전 초안을 모의 독자에게 한 문단씩 읽힌다. 어느 문단에서 읽기를 그만두는지와 다음 날 기억하는 내용을 보고한다. 초안을 고쳐 쓰지는 않는다 |
저장소는 9월 24일부터 28일까지 닷새 동안 풀 리퀘스트 14개로 만들어졌다. 풀 리퀘스트 14개는 모두 claude/great-cray-qichls라는 한 브랜치에서 생성되었고, 커밋 45개 가운데 30개에 Claude 공동 작성자 표기가 있다. README에는 이 저장소를 만든 대화에서 저자가 실제로 내린 지시와 그 지시로 만들어진 그림이 함께 실려 있다.
아홉 단계 절차
explainer 스킬의 본문은 문서 하나를 다음 순서로 만든다.
| 단계 | 할 일 |
|---|---|
| 1. 페르소나 | 저장소 최상위의 personas/<id>.md를 읽는다. 없으면 질문하기 전에 임시 파일부터 쓴다 |
| 2. 질문 정하기 | 독자가 문서를 다 읽은 뒤 스스로 판정할 사항을 질문 1~3개로 적는다 |
| 3. 생략할 내용 정하기 | 페르소나의 「이미 아는 것」 칸에 적힌 내용은 생략한다. 「미심쩍은 부분」 칸을 본문의 중심 주제로 삼는다 |
| 4. 실행할 예제 만들기 | 주장마다 실행할 수 있는 예제(코드, 모델, 명령)를 먼저 만들어 돌린다 |
| 5. 쓰기 | 정해진 문서 양식으로 쓴다. 출력은 손으로 다시 치는 대신 붙여 넣는다 |
| 6. 그림 | 그림에 반영해야 할 사실을 사실 시트에 먼저 적고, 그다음 그림을 그린다 |
| 7. 검증 | verify-doc.mjs가 VERIFIED를 낼 때까지 고친다 |
| 8. 읽히기 | first-reader로 페르소나 본인을 독자 삼아 읽힌다 |
| 9. 전달 | HTML과 요약을 전달한다. 검증하지 못한 것은 “미검증"이라고 적는다 |
페르소나 파일
페르소나는 독자 한 명에 대해 무엇을 쓰지 않아도 되는지, 무엇을 써야 하는지를 정하는 메모다. 스킬이 페르소나를 만들 때 가장 먼저 활용하는 재료는 독자에게 직접 하는 질문이다. 독자에게 물어볼 수 있다면 최대 다섯 가지를 묻는다. 지금 어떤 도구를 사용하고 있는지, 최근 어디서 막혔는지 묻고, 읽는 데 쓸 수 있는 시간과 코드부터 보는 설명과 그림부터 보는 설명 가운데 무엇이 더 빠른지도 확인한다. 마지막으로 다 읽고 나서 무엇을 스스로 판정하고 싶은지 묻는데, 스킬은 이 답을 문서가 답할 질문으로 삼는다.
스킬은 여기에 GitHub 저장소, 블로그, 발표 자료처럼 누구나 볼 수 있는 정보를 더한다. 이때 주장마다 출처 URL을 붙이고, 사실과 추측은 다른 칸에 적는다. 스킬 본문이 가장 중요하다고 꼽는 칸은 「미심쩍은 부분」이다.
도구를 쓸 줄 아는 것과 그 결과의 의미를 판정할 수 있는 것은 별개다. 그 차이를 찾아 자료의 중심 주제로 삼는다.
새 독자라면 답을 기다리기 전에 페르소나 파일부터 쓴다. 요청문에서 알 수 있는 내용만 사실 칸에 적고, 나머지는 모두 추측 칸에, 질문은 미확인 칸에 적는다. 요청문에 없는 경력(연차, 사용하는 도구, 겪는 문제)을 사실 칸에 적는 것도 금지된다.
저장소에는 저자 자신의 페르소나가 예시로 실려 있다. 스킬은 질문 없이 공개 정보만으로 mizchi의 페르소나를 만들었고, 그 과정에서 mizchi가 형식 기법을 이미 실무에 쓰고 있다는 점이 확인되었다. mizchi는 2026년 7월부터 Alloy 6, Z3, TLA+, Quint, Dafny, Lean 4 등 검증기 약 10종을 같은 실무 과제로 비교해 왔다. 그 결과 문서는 도구 사용법을 다루지 않고, 검사기가 낸 결과가 무엇을 보장했는지 스스로 판정하는 기준만 다루게 되었다. 페르소나에는 읽는 방식도 적혀 있다. mizchi 본인의 글은 문단당 평균 1.4문장이고, 문단의 64%가 한 문장짜리다.
문서 양식과 문체
문서의 제목은 독자의 질문 형태로 짓는다. 첫머리에는 대상 독자, 생략한 내용, 소요 시간, 검증 방법을 한 줄씩 적어서, 독자가 이 문서가 자기를 위한 것인지 10초 안에 판정할 수 있게 한다. 그다음에는 질문에 답하는 표 하나를 두고, 본문은 그 표의 각 행을 한 절씩 풀어 쓴다.
스킬은 문체 규칙 다섯 가지를 정해 두었다.
- 한 문단은 한두 문장으로 쓴다.
- 한 절에 예제는 하나만 둔다. 예제 바로 뒤에는 그 예제에서 읽어 낼 것을 한 문장으로 적는다.
- 굵은 글씨는 한 절에 한 번까지 쓰고, 그 절의 결론에만 쓴다.
- 확신할 수 없는 내용은 본문에서 삭제하거나 “미검증"이라고 적는다. 흐린 표현으로 남기지 않는다.
- 페르소나의 언어로 쓰고, 페르소나 본인의 문체에 맞춘다.
본문에 인용하는 출력 앞에는 <!-- output: 검사이름 -->을, 코드 발췌 앞에는 <!-- source: 파일경로 -->를 둔다. 검증 스크립트가 이 표시를 보고 실물과 대조한다. 문서 끝에는 이해도 점검 문제 3~5개를 두고 답은 접히는 <details> 요소에 넣는다. 문제는 “X란 무엇인가"보다 판단을 묻는 형태로 낸다.
글을 다 쓰면 절마다 세 가지를 확인한다. 페르소나가 이미 아는 것을 설명하고 있지 않은가. 이 절을 삭제하면 답할 수 없게 되는 이해도 점검 문제가 있는가. 그런 문제가 없다면 절을 삭제한다. 예제는 그 절의 주장에 필요한 최소 크기인가.
검증
verify-doc.mjs는 네 가지를 본다.
checks.json에 적힌 명령을 실행해, 기대하는 줄이 순서대로 출력되는지 확인한다.- 그림을
vlmkit-anim check --expect로 사실 시트와 대조하고, 겹침과 넘침이 없는지, SVG가 최신인지 확인한다3. - 본문의 출력 인용과 코드 발췌가 실물과 일치하는지, 이미지 파일이 존재하는지 확인한다.
- HTML을
vlmkit check integrity와check a11y contrast에 통과시킨다.
스크립트는 실패한 항목마다 무엇이 어디에서 실패했고 어떻게 고쳐야 하는지 한 줄로 출력한다. 고치고 다시 돌리기를 최대 5회 반복하고, 그래도 통과하지 못한 주장은 본문에서 삭제하거나 “미검증"이라고 적는다. 스킬 본문이 금지하는 일 네 가지도 같은 원칙에서 정해졌다. 출력을 손으로 다시 적는 일, 기억에 의존해 그림을 그리는 일, 독자가 이미 아는 내용을 설명하는 일, 검사 결과를 실제보다 좋게 보고하는 일이다. 마지막 항목에 대해 스킬 본문은 “검사를 통과했다고 쓸 때는 어떤 검사가 어떤 범위에서 통과했는지 쓴다"고 설명한다.
예제 문서, 형식 기법 속성 강좌
README가 소개하는 첫 번째 지시는 다음과 같다(일본어 원문을 번역).
시험 삼아 공개 정보로 mizchi의 페르소나를 만들고, 내가 이해할 수 있는 형식 기법 해설 문서를 쓰고 싶다. Z3나 TLA+ 자료를 쓰려고 했는데, 쓰다 보니 스스로 자신이 없어졌다.
Apalache로 귀납법 검사도 실제로 돌려서 검증해 줘.
이 지시로 「초록불 읽기: Z3와 TLA+의 ‘OK’는 무엇을 보장했나」라는 문서가 만들어졌다. 검사기의 초록불을 믿기 전에 확인할 질문 네 가지가 문서 첫머리의 표에 정리되어 있다.
| 질문 | 놓치면 벌어지는 일 |
|---|---|
| 답이 sat, unsat, unknown 중 무엇인가 | 시간 초과로 나온 unknown을 “아마 OK"로 읽는다 |
| 어떤 세계의 이야기인가 | 32비트 정수에서는 맞지만 자바스크립트의 number에서는 틀린다 |
| 어떤 상태를 보았나 | k단계 탐색, 유한한 상수, 귀납법은 보장하는 범위가 저마다 다르다 |
| 무엇을 말하는 성질인가 | 전제가 한 번도 성립하지 않아 공허하게 참이 된다. 공정성 가정 없이는 “언젠가"를 말할 수 없다 |
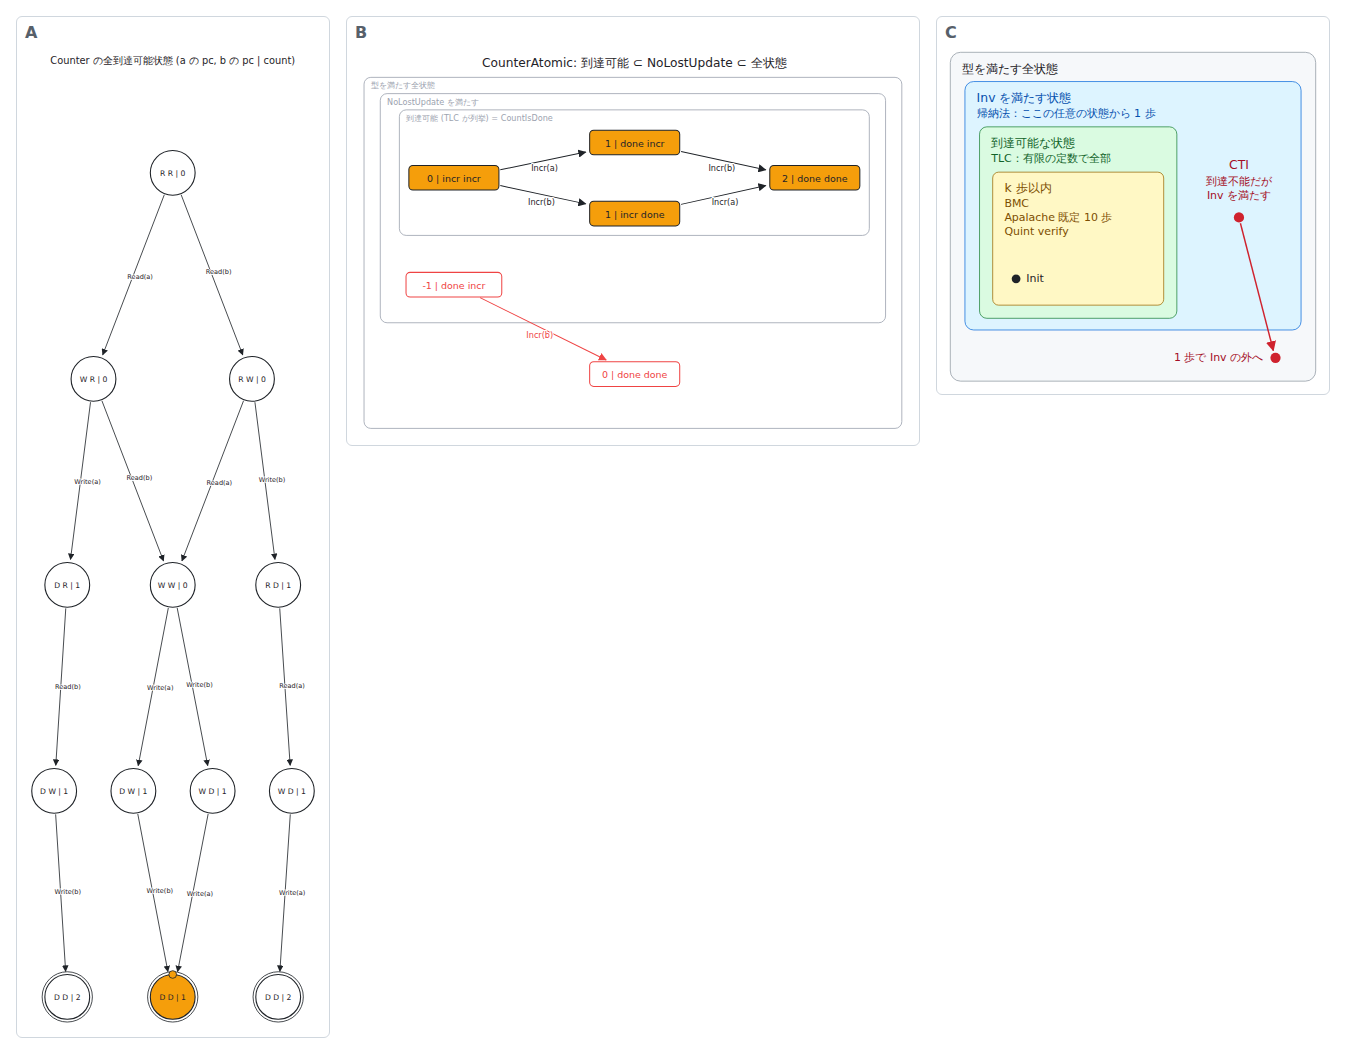
문서는 예제 두 개만 쓴다. Z3로는 타입스크립트의 작은 함수를 검사하고, TLA+로는 프로세스 두 개가 공유 카운터를 1씩 늘리는 모델을 검사한다. 문서가 각 질문을 확인하는 방법은 다음과 같다.
- sat, unsat, unknown:
x % 2 === 1이 홀수 판정식으로 맞는지 Z3로 검사한 결과는sat이었고, 반례로x = -2147483647이 나왔다. 음수 홀수를 넣으면%가 -1을 돌려주기 때문에 판정이 틀린다. Z3는 페르마의 정리(n = 3)에는 답을 내지 못하고 시간 초과로unknown을 돌려준다. 문서는 그 원인으로 비선형 정수 산술이 일반적으로 결정 불가능하다는 점을 들었다. 문서는 CI에서unknown과 시간 초과를 실패로 처리하라고 권한다. - 어떤 세계인가: 고친 판정식
x % 2 !== 0은 32비트 부호 있는 정수에서unsat이다. 그런데 자바스크립트의number는 64비트 부동소수점이라x = 1.5를 넣으면 이 판정식이 1.5를 홀수로 판정한다. 문서는 증명의 강도가 모델이 구현의 세계를 얼마나 충실히 반영했는지로 결정된다고 적었다. - 어떤 상태를 보았나: 유한 단계 모델 검사(BMC)는 초기 상태에서 k단계 이내에 도달하는 상태만, TLC의 전수 탐색은 주어진 상수에서 도달 가능한 모든 상태를 본다. 귀납법만이 불변식을 만족하는 모든 상태를 본다. Quint의
verify는 기본--max-steps가 10이라, 100단계째에 깨지는 성질count < 100도 통과시킨다. 반대로 귀납법은 올바른 불변식에 대해서도 반례(CTI)를 냈다. 이 반례는 도달할 수 없는 상태count = -1에서 시작했다. 문서는 도달 불가능한 상태를 제외하는 조건을 불변식에 추가해 이 반례를 없앴다. - 무엇을 말하는 성질인가:
Done => count = 2는Done에 한 번도 도달하지 않으면 늘 참이다. 문서는 일부러 깨져야 하는 불변식NotDone을 두고 그것이 실제로 깨지는지 확인하는 방법을 보여 준다. 활성 성질<>Done은 약한 공정성WF_vars(Next)을 가정해야 통과한다. 공정성은 스케줄러나 네트워크에 대한 가정이므로, 문서는 그 가정이 현실에서 성립하는지 확인하라고 했다.
Apalache의 출력 문구 때문에 생기는 혼동도 문서에 따로 설명되어 있다. 귀납 단계 검사가 통과하면 Apalache는 “Checker reports no error up to computation length 1"이라고 출력하는데, 이 문장은 BMC가 1단계까지 반례를 찾지 못했을 때와 똑같다. 그러나 --init=IndInv로 시작한 검사라면 이 출력은 단계 수와 관계없이 성질이 성립한다는 증명의 일부다. 출력 문장만으로는 어느 검사였는지 구별할 수 없으므로, 문서는 보고서에 명령도 함께 남기라고 했다. 문서 끝에는 AI가 쓴 모델을 검토할 때 쓰는 점검 목록 일곱 항목과 이해도 점검 문제 다섯 개가 있다.
장 단위 강좌, explainer-book
두 번째 지시는 짧은 글로 끝나지 않는 학습 자료를 만드는 스킬을 추가해 달라는 것이었다. explainer-book은 다음 셋 중 하나라도 해당하면 문서를 여러 장으로 구성한다. 읽는 데 20분 이상 걸릴 때, 독자가 직접 해 보는 연습이 필요할 때, 개념에 순서가 있을 때다.
첫 장은 반드시 퀵스타트로 만들어, 이론보다 먼저 동작하는 결과를 보여 준다. 장마다 학습 목표를 두는데, 목표는 “다 읽고 나서 무엇을 판정할 수 있는가"로 쓴다. 스킬 본문은 “CTI를 이해한다"를 나쁜 예로, “CTI가 나왔을 때 조건이 약한 것인지 성질이 실제로 깨지는지 TLC로 판정할 수 있다"를 좋은 예로 들었다. 연습 문제도 실행해서 확인한다. 쓰기형 연습은 출발점 코드를 그대로 실행하면 실패하고 답을 넣으면 통과해야 한다. 스킬 본문은 그 이유를 “답이 틀린 연습 문제는 틀린 것을 가르친다"고 적었다.
verify-book.mjs는 책 전체를 다음 기준으로 검사한다.
| 검사 | 실패하는 조건 |
|---|---|
| chapters | 장 파일이 없거나, 번호가 book.json의 순서와 다르거나, 1장이 퀵스타트가 아니다 |
| objectives | 이해도 점검 문제가 붙지 않은 목표가 있다 |
| concepts | 어떤 개념을 그 개념을 도입한 장보다 앞선 장에서 쓴다 |
| budget | 추정 읽는 시간(분당 500자, 코드는 분당 15줄)이 그 장의 예산을 초과한다 |
| exercises | 답이 <details>에 없거나, 쓰기형 연습에 실패하는 출발점이 없다 |
| map | book.json으로 생성한 장 의존 관계도가 실제와 다르다 |
개념 검사를 통과하지 못했을 때 동의어로 바꿔 써서 검사를 피하는 것은 금지된다. 정의를 앞 장으로 옮기거나 장 순서를 다시 짜야 한다. 저장소에는 이 스킬로 만든 세 장짜리 책 「귀납적 불변식을 스스로 찾기」가 실려 있다.
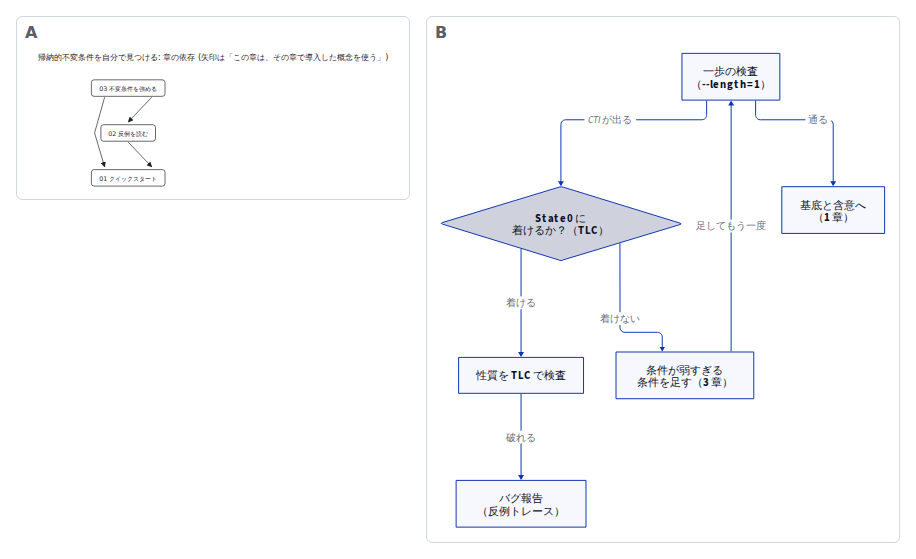
그림 도구 고르기
스킬은 그림을 세 경우에만 그리게 한다. 요소가 넷 이상이고 그 사이에 관계가 있을 때, 시간 순서가 있을 때, 포함 관계가 있을 때다. Mermaid로 표현할 수 있으면 Mermaid를 쓴다. Mermaid로 표현할 수 없는 구조에는 D2를, D2의 상자와 선으로 표현할 수 없는 그림에는 SVG나 HTML을 쓴다. 그림이 TLC의 상태 그래프처럼 도구의 출력을 옮기는 경우에는 이 순서보다 먼저 vlmkit-anim을 쓴다. 도구의 출력으로 만든 사실 시트와 그림을 대조할 수 있는 도구는 vlmkit-anim뿐이다.
저자는 같은 샘플을 Mermaid와 D2의 세 배치 엔진(TALA, ELK, dagre)으로 그려 비교한 치트시트도 만들었다4.
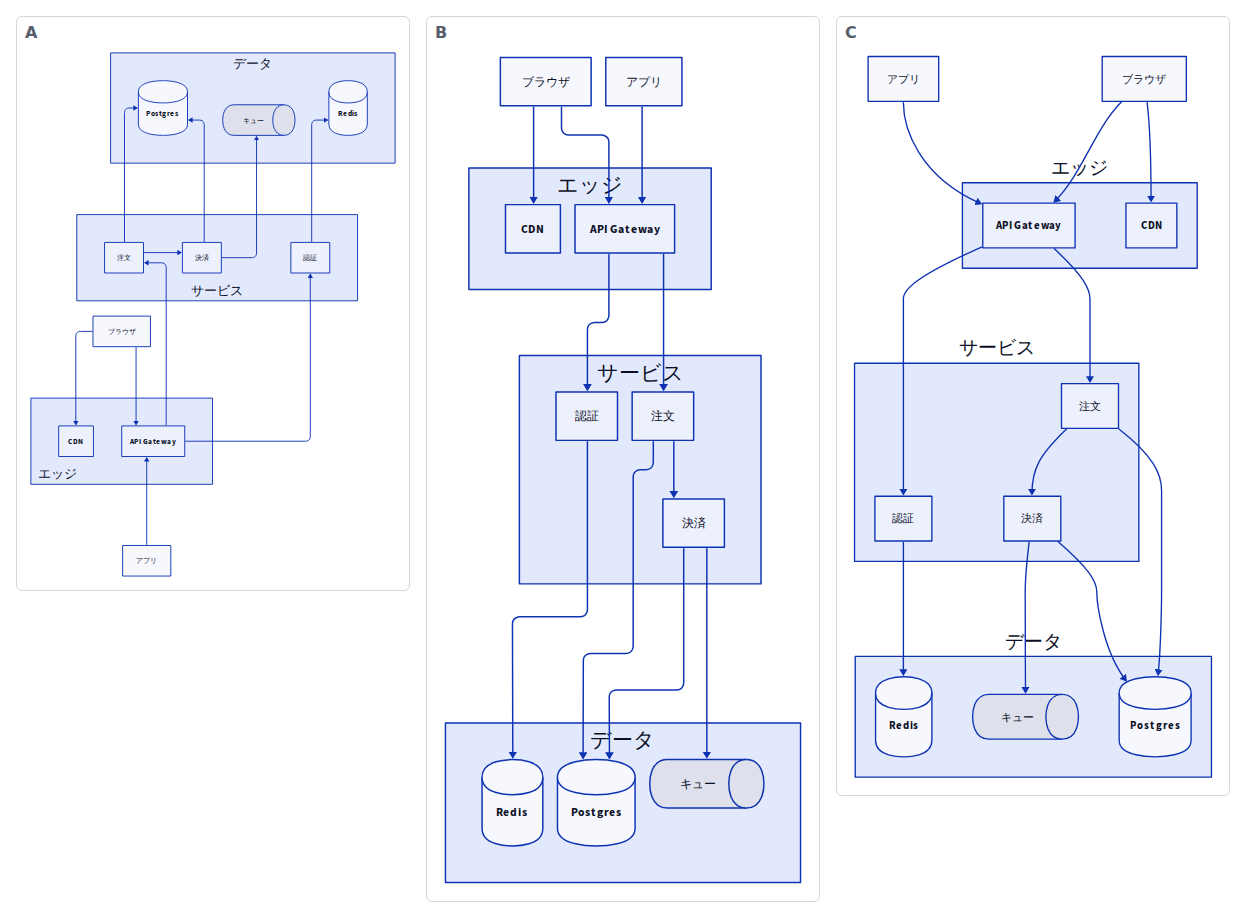
- Mermaid에서는 서브그래프 안의 노드가 서브그래프 밖의 노드와 연결되면, 서브그래프에 적은
direction TB가 무시되어 모든 노드가 한 줄로 배치된다. 오류 메시지도 없다. - D2의 ELK와 dagre도 상자별로 지정한 방향을 오류 없이 무시한다.
d2 validate도 통과하므로 그림을 직접 보기 전에는 알 수 없다. ELK에서 상자 안을 세로로 배치하려면direction: down대신grid-columns: 1을 쓴다. - TALA는 상자 안의 방향을 유지했고, 상자 이름 위로 선을 긋지도 않았다. 대신
direction을 쓰지 않았더니 아키텍처 그림에서 데이터 층을 맨 위에, 진입점인 브라우저를 맨 아래에 두었다(커버 그림의 A). - TALA는 같은 입력과 같은 시드면 매번 같은 그림을 내지만, 시드를 1부터 9까지 바꾸자 배치가 아홉 가지로 달라졌다. 상자 40개에서 TALA는 ELK보다 10배 이상 느렸다5. 저자는 에이전트가 그림을 반복해서 다시 그리는 작업이라면 상자가 수십 개 이상인 그림에는 ELK를 쓰라고 권한다.
- dagre가 ELK보다 나은 경우는 이 샘플에서 없었다.
그려 보고 눈으로 고치기
네 번째 지시는 이런 내용이었다.
D2나 Mermaid로 의미 구조를 쓴 뒤 실제로 렌더링해 보면, 누가 봐도 부자연스럽거나 화살표를 읽기 어려운 경우가 있다. 이것을 시각적으로 확인해서 고치는 흐름을 넣고 싶다.
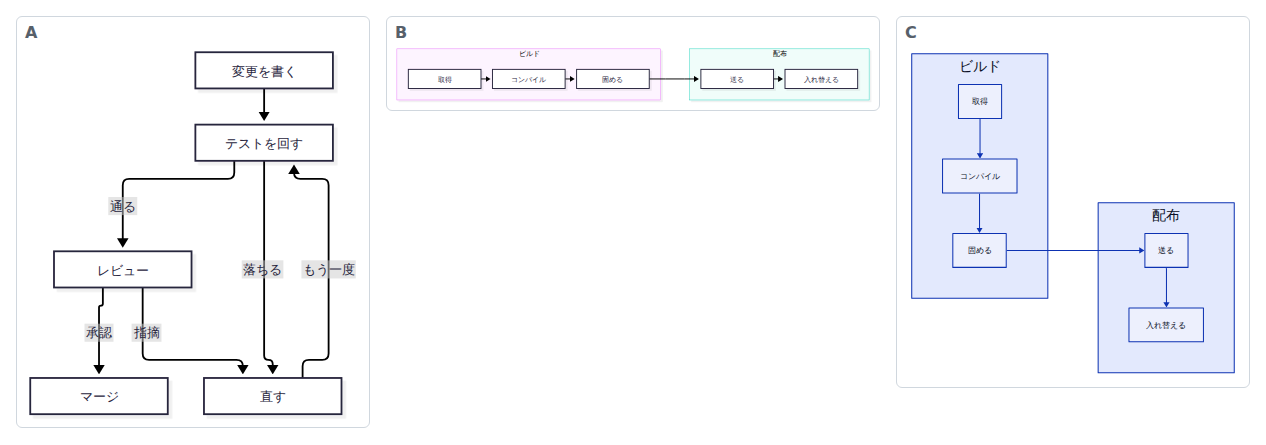
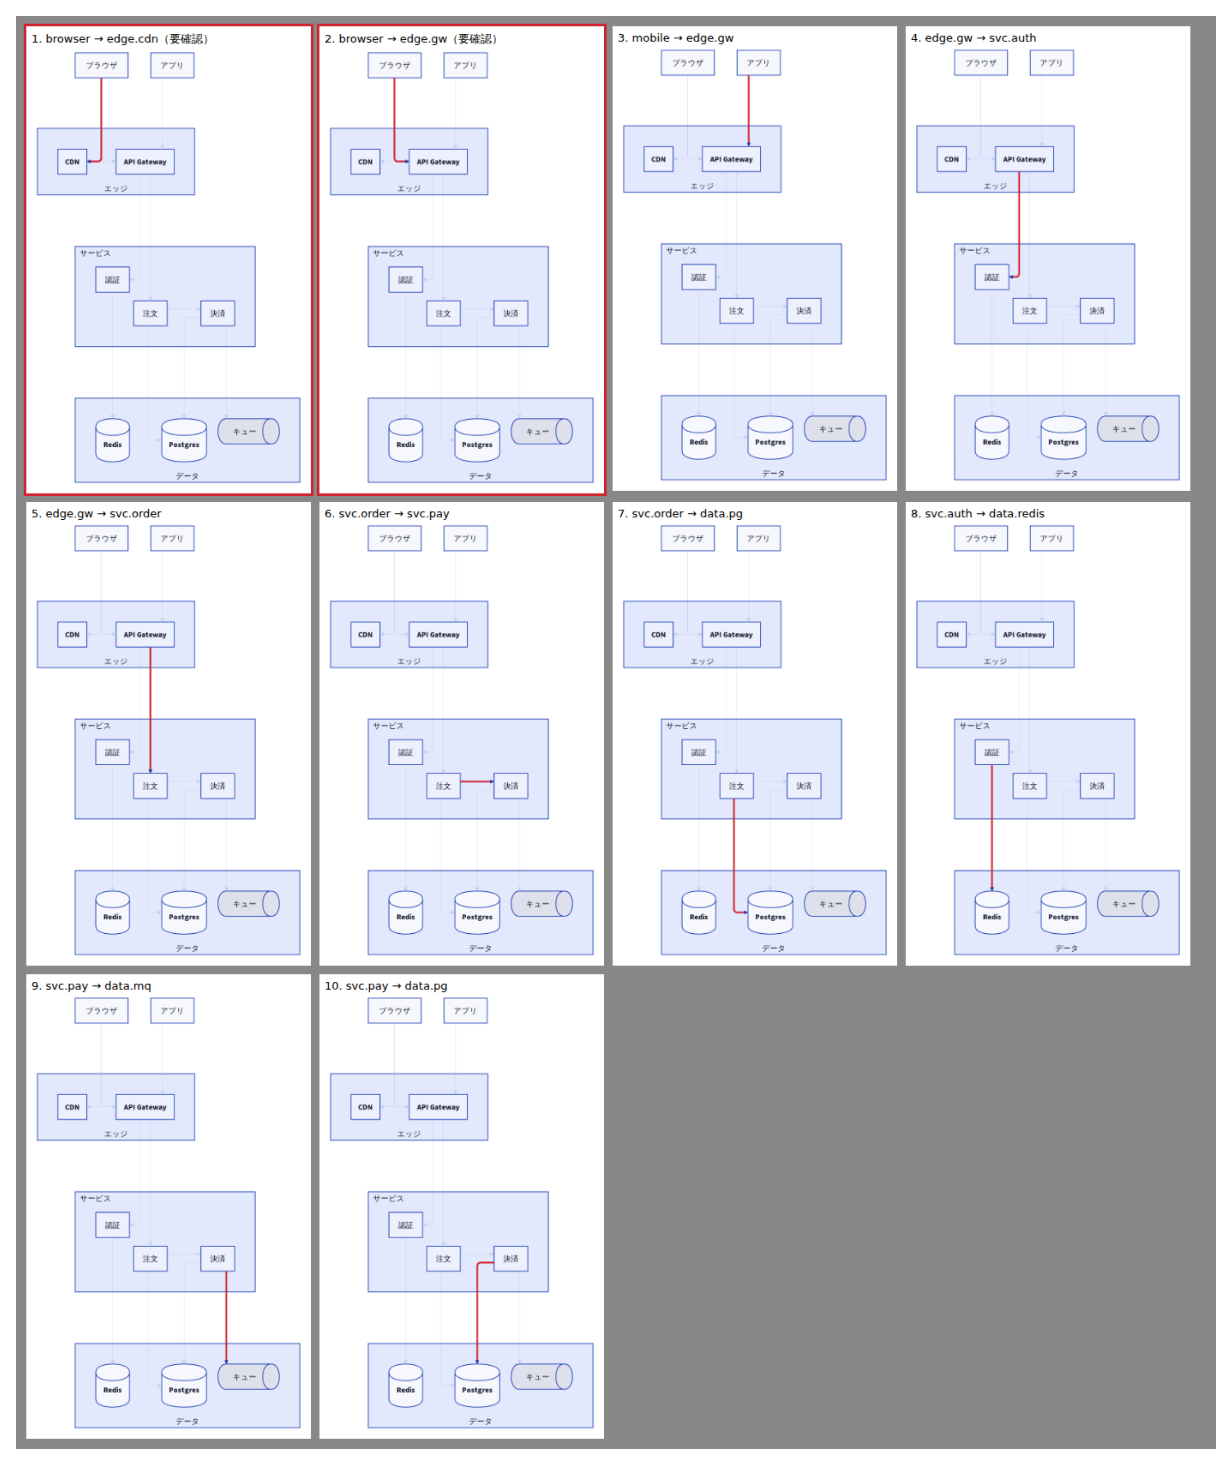
D2와 Mermaid에서는 사람이 상자와 간선의 관계를 정하고, 도구가 배치를 정한다. figure-check.mjs는 이렇게 정해진 그림을 밝은 테마, 어두운 테마, 휴대폰 폭으로 렌더링한 시트를 만들고, 겹침, 넘침, 선과 글자의 교차, 9픽셀 미만의 작은 글자, 사실 시트 누락을 검사한다. 화살표 검사는 두 화살표의 겹침, 상자 관통, 교차, 우회, 역방향을 확인한다.
간선 시트는 화살표를 한 번에 하나씩 빨갛게 칠하고 나머지는 흐리게 처리한 그림이다. 기계 검사는 브라우저에서 CDN으로 가는 화살표와 API Gateway로 가는 화살표가 222픽셀 동안 겹친다고 판정했다. 아래 시트에서는 해당 화살표를 표시한 두 칸에 빨간 테두리가 있다. 두 화살표가 갈라지는 지점이 CDN과 API Gateway 사이의 화살표처럼 읽히기 때문이다.
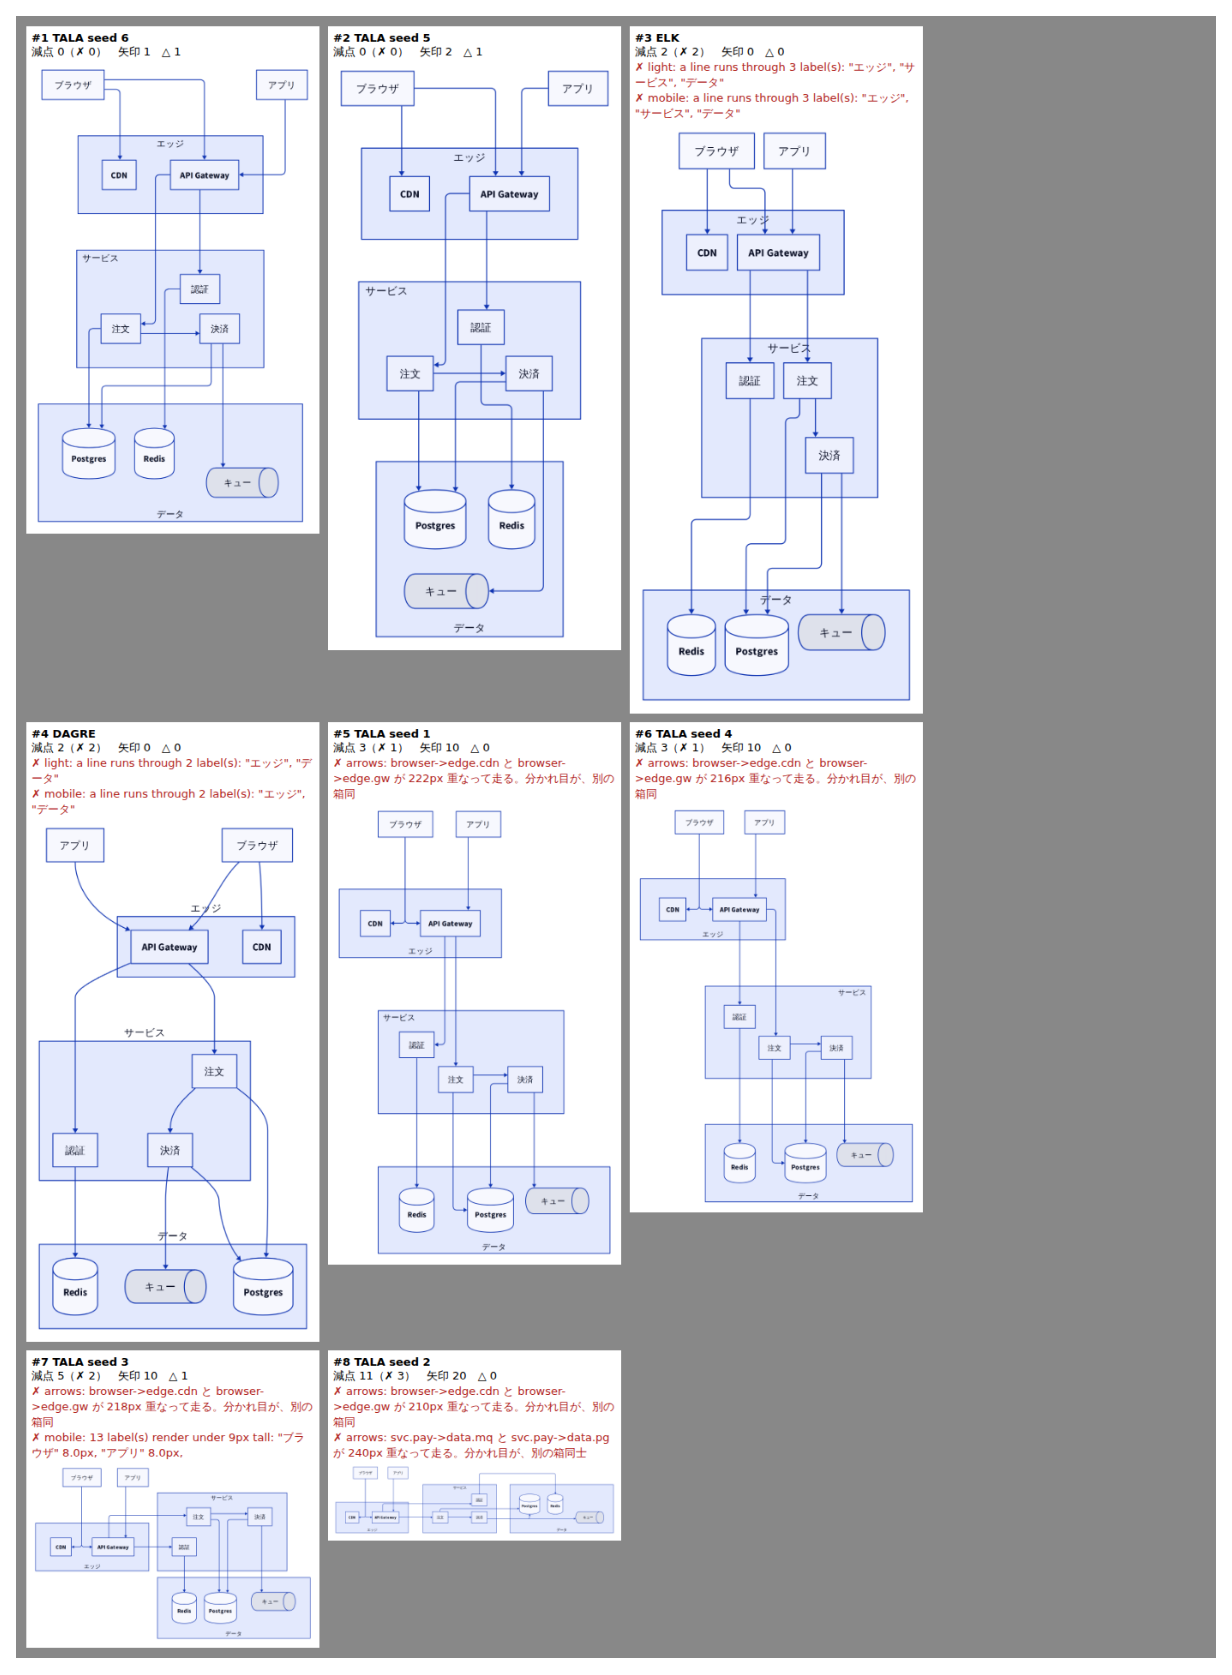
배치가 마음에 들지 않으면 figure-variants.mjs로 여러 배치 후보를 그려 비교한다. 같은 파일을 TALA 시드 1~6과 ELK, dagre로 각각 그리고, 결과를 감점이 적은 순서로 정렬해 보여 준다. 아래 예에서 경고(✗)가 하나도 없는 후보는 시드 6과 시드 5뿐이었다. 그 둘 가운데 어느 것을 쓸지는 사람이 눈으로 보고 고르고, 고른 이유를 소스 파일의 주석에 남긴다.
모의 독자 first-reader
verify-doc.mjs가 보장하는 것은 주장이 옳다는 사실뿐이다. 독자가 끝까지 읽고 다음 날에도 기억하는지는 함께 포함된 first-reader 스킬로 확인한다. 이 스킬은 Shubhamsaboo의 awesome-llm-apps 저장소에 있던 스킬을 포함한 것으로, 원래의 Apache-2.0 라이선스를 따른다6.
first-reader는 모의 독자에게 초안을 한 문단씩 보여 주며, 다음 문단을 미리 읽지 못하게 한다. 검사는 훑어보기 판정, 주의 기록, 회상 검사, 신뢰 기록의 네 가지다. 각각 바쁜 독자가 글을 열어 볼지, 어느 문단에서 읽기를 그만두는지, 다음 날 무엇을 기억하는지, 글쓴이를 얼마나 신뢰하게 되었는지를 확인한다. 결과는 친구가 읽고 나서 해 주는 말처럼 평이한 문장 3~6개로 전한다. 어떻게 고칠지는 글쓴이가 정하도록 수정안은 제시하지 않는다. 저자는 일본어 초안도 한 문단씩 읽힐 수 있도록 feed.py가 단어를 세는 방식을 바꿨다.
explainer의 8단계는 이 스킬에 독자 두 명을 배정한다. 호의적인 독자는 페르소나 본인으로 설정한다. 페르소나에 적힌 지식은 사전 지식에, 읽는 방식은 인내심 예산에 반영한다. 회의적인 독자는 풀 리퀘스트 리뷰나 슬랙 링크처럼 문서가 전달되는 장면을 기준으로 설정한다. 회상 답이 문서의 핵심 표와 다르면 그 절은 전달되지 않은 것으로 보고, 앞부분에서 두 독자가 모두 읽기를 그만두면 문장 손질보다 구성부터 고친다. 스킬 본문에 따르면 signals.py는 신뢰 신호를 영어 기준으로 세기 때문에 일본어 문서에서는 거의 0이 나온다. 그래서 일본어 문서의 신뢰 기록은 글쓴이가 직접 통독해서 판단하라고 했다.
스킬의 효과를 측정한 기록
저자는 claude plugin eval로 같은 과제를 플러그인이 있을 때와 없을 때 각각 실행하고, 채점 결과의 차이(Δ)를 기록했다. 평가 기록 evals/RESULTS.md에는 9월 25일부터 28일까지 열 차례의 실행이 적혀 있다. 한 차례에 든 비용은 0.96달러에서 6.65달러였다.
| 과제 | 무엇을 보나 | Δ |
|---|---|---|
crash-course | 독자가 아는 것을 건너뛰는가, 이해도 점검이 있는가, 실행 못 한 코드를 보고하는가 | +0.43 |
crash-course-known-heavy | 전문가 대상이어도 “X란” 정의로 시작하기 쉬운 주제(BuildKit 캐시)에서 아는 부분을 건너뛰는가 | +0.25 |
crash-course-persona-implicit | 독자의 지식을 요청문 대신 페르소나 파일에만 적었을 때 | +0.12 |
crash-course-persona-build | 독자의 이름과 소속만 줄 때, 쓰기 전에 묻거나 가정을 밝히는가 | +0.20, +0.40, +0.13 |
pr-reader-first | 독자를 모를 때 쓰기 전에 확인하거나 가정을 밝히는가 | +0.50 |
book | 1장이 퀵스타트인가, 연습 문제의 답을 실행해 확인하는가 | +0.28 |
one-liner-control | 대조군. 한 문장짜리 질문에 스킬을 부르지 않는가 | 차이 없음 |
평가용 샌드박스에서는 셸이 시작하자마자 실패했다7. 이 때문에 저자는 코드를 실제로 실행했는지 보는 채점 항목을 모두 제외하고 점수를 계산했다. 첫 실행에서 셸 실패를 겪은 여덟 번 가운데, 스킬을 켠 실행은 네 번 모두 “스크립트를 실행하지 못해 검증하지 못했다"고 보고했다. 스킬을 끈 네 번은 코드를 실행하지 못했는데도, 출력값을 실행 결과처럼 실은 문서를 완성본으로 제출했다. 기록은 이 차이를 이렇게 적었다.
스킬 없이 만든 자료에 실린 출력은, 실행되지 않았는데도 실행 결과처럼 보인다.
일곱 번째 실행에서는 저자의 예상과 다른 결과가 나왔다. 독자가 아는 내용을 페르소나 파일에만 적고 “설명할 필요 없다"는 지시를 요청문에서 지웠는데도, 스킬을 끈 실행도 아는 내용을 생략했다. 기록은 결론을 이렇게 정리했다.
페르소나에 맞춰 이미 아는 것을 생략하는 일은 지금 모델에게는 기본 동작이라, 스킬이 만드는 차이가 되지 않았다. 스킬만의 효과로 기대할 수 있는 것은 페르소나를 만드는 일이다.
열 차례의 실행에서 저자가 스킬의 효과로 측정할 수 있었던 것은 네 가지였다. 실행하지 못한 코드를 보고하는 것, 답이 함께 제시된 이해도 점검(모든 과제에서 스킬을 켰을 때 세 번 중 세 번, 껐을 때 한 번도 없음), 독자를 모를 때 쓰기 전에 확인하거나 전제를 밝히는 것, 독자 정보가 없을 때 첫머리에 대상 독자를 적는 것이다.
채점기 자체를 고친 기록도 있다. 네 번째 실행에서 LLM 채점기는 “독자가 아는 것을 설명했다"는 이유로 문서 여섯 개를 모두 불합격 처리했다. 저자가 문서를 직접 검색해 보니 그런 설명은 없었다. 채점기는 판정 이유를 저장하지 않아 원인을 확인할 수 없었고, 저자는 이 채점기를 “현재로서는 신뢰할 수 없다"고 적었다. 다섯 번째 실행부터는 문서의 제목 줄을 정규식으로 검사하는 방식으로 바꾸었고, 바꾸기 전에 저장해 둔 문서 14개와 대조용 제목 5개에 정규식을 적용해 판정이 맞는지 먼저 확인했다.
페르소나 파일을 남기게 만드는 데는 세 번의 수정이 필요했다. 여덟 번째 실행에서 스킬을 켠 실행은 세 번 중 두 번 쓰기 전에 멈춰 질문했지만, 페르소나 파일은 한 번도 남기지 않았다. 저자는 “질문하기 전에 파일을 쓴다"는 규칙을 절차에 추가했고, 이어서 그 규칙을 절차 목록의 첫 줄에도 적었다. 그래도 질문하고 멈춘 실행은 한 번도 파일을 쓰지 않았다. 기록은 원인을 “모델은 질문할 때 도구를 호출하지 않고 답장만으로 끝낸다"고 추정했다. 열 번째 실행에서 저자는 규칙 문장 대신 답장 양식을 보여 주었다. “임시 페르소나를 파일에 남겼습니다"로 시작해 질문을 나열하고, 답이 없을 때 쓸 가정을 적는 양식이다. 그러자 세 번 모두 파일이 남았다.
기록은 같은 과제에서도 스킬을 끈 실행의 점수가 0.53, 0.40, 0.40, 0.67로 실행마다 달라졌다고 밝혔다. 각 조건을 두세 번씩만 실행했으므로, 기록은 차이를 경향으로 읽어 달라고 했다.
설치
저장소 자체가 Claude Code 플러그인 마켓플레이스라서 다음 두 줄로 설치한다.
/plugin marketplace add mizchi/explainer
/plugin install explainer@explainer
npx skills나 마이크로소프트의 APM으로도 설치할 수 있다. explainer-book이 옆 폴더의 explainer 스크립트를 호출하므로 세 스킬을 모두 설치해야 한다. 스크립트를 돌리려면 문서를 두는 저장소에 Node 24 이상과 @mizchi/vlmkit, @mizchi/vlmkit-anim, marked, playwright가 필요하다. 형식 기법 예제에는 TLC, Apalache(자바 17 이상), z3-solver가 더 필요하고, first-reader는 파이썬 3 표준 라이브러리만 쓴다.
가장 의외였던 기록
README가 첫머리에서 약속한 것은 독자가 “모르는 것만” 쓰는 스킬이다. 그런데 저자가 직접 측정해 보니, 스킬이 없어도 모델은 독자가 아는 내용을 생략하고 있었다. 저자는 이 결과를 「예상은 틀렸다」라는 절 제목으로 평가 기록에 남겼다. 그리고 스킬의 효과를 확인할 대상을 페르소나를 만드는 일로 한정해 다음 평가 과제를 설계했다.
그렇게 한정해서 확인한 효과 가운데 내가 특히 흥미롭게 읽은 것은, 코드를 실행하지 못했을 때 그 사실을 보고하는 습관이다. 평가 기록도 이 규칙을 그대로 따른다. 트레이스가 남지 않아 파일에 무엇이 쓰였는지 확인하지 못했다고 쓰고, 채점기가 이유를 저장하지 않아 원인을 알 수 없다고 쓴다. 절차 문장으로는 바뀌지 않던 동작이 답장 양식을 보여 주자 바뀌었다는 관찰도, 모델에게 일을 맡겨 본 사람이라면 한 번쯤 겪어 봤을 법한 일이다.
모델이 기본적으로 독자에게 맞춰 쓰게 된다면, 설명을 돕는 스킬은 무엇을 확인하지 못했는지 독자에게 알리는 데 주로 쓰일지도 모른다. 저자의 다음 과제 목록에는 개념 사이의 의존이 깊은 주제로 book 과제를 추가하는 일이 아직 남아 있다.
출처
mizchi, explainer (GitHub, 2026년 9월 24일 공개, MIT 라이선스. skills/first-reader/는 Apache-2.0)
원문: https://github.com/mizchi/explainer
Geoffrey Litt, “Understanding is the new bottleneck”, 2026년 7월 2일. https://www.geoffreylitt.com/2026/07/02/understanding-is-the-new-bottleneck ↩︎
vlmkit과vlmkit-anim은 mizchi가 만든 검증 도구다. 사실 시트(*.expect.json)는 TLC의 상태 그래프나 import 그래프 같은 도구 출력으로 만든다. https://github.com/mizchi/vlmkit ↩︎비교에 쓴 버전은 D2 v0.9.0과 Mermaid 12.0.0이다. D2 v0.9.0은 TALA가 MPL-2.0으로 공개되어 함께 배포된 버전이다. ↩︎
저자의 환경에서 세 번 측정했을 때 상자 40개 기준 TALA가 4~5초, ELK가 0.1초 미만이었다. 실측값은 환경에 따라 달라지므로 치트시트의 자동 대조 대상에서는 제외했다고 한다. ↩︎
https://github.com/Shubhamsaboo/awesome-llm-apps/tree/main/agent_skills/first-reader ↩︎
오류 메시지는
apply-seccomp: write /proc/self/uid_map: Operation not permitted였다. 중첩 컨테이너에서는 사용자 네임스페이스를 만들 수 없었다. 평가 도구도 샌드박스 없이는 셸을 실행하지 않았다. README는 이 환경에서 스킬이 있을 때 여섯 번 중 여섯 번, 없을 때 여섯 번 중 한 번 실행하지 못한 코드를 보고했다고 요약했다. ↩︎