3줄 요약
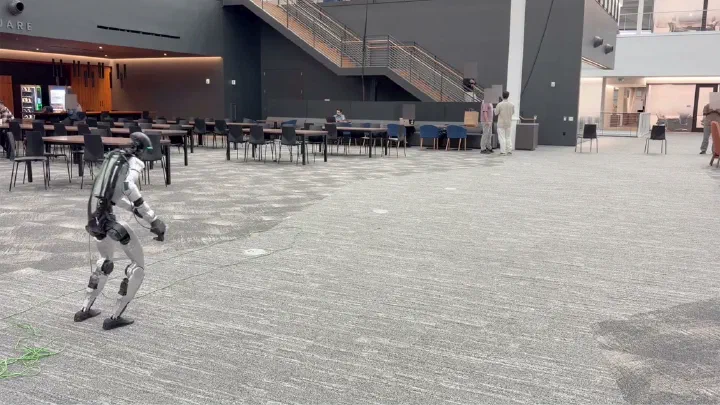
- Metatron은 NVIDIA와 Dollhouse Robotics가 연구한 휴머노이드 제어 방식이다. 손, 발, 몸통의 목표를 정하면 Metatron이 그에 맞는 전신 동작을 생성한다.
- 먼저 전신 동작 전체를 따라 하는 제어기를 훈련하고, 이 제어기를 교사로 삼아 일부 목표만 받아도 균형과 자세를 조절하는 정책을 학습시킨다.
- 학습을 마친 정책의 가중치는 고정한다. 이후 사람이나 코딩 에이전트가 목표를 지정하는 프로그램을 작성해 새로운 동작을 만든다.
손의 목표를 정하면 발도 함께 움직인다
로봇이 멀리 있는 물건에 손을 뻗으려면 팔을 펴는 것만으로는 부족하다. 발을 옮기거나 몸을 기울이면서 균형도 유지해야 한다. 연구진은 이런 전신 조절을 모든 작업이 함께 쓰는 정책 하나에 학습시키고, 작업마다 필요한 목표는 프로그램으로 정하게 했다.1
여기서 정책은 로봇의 관측과 목표를 받아 관절 명령을 출력하는 모델이다. 연구진은 정책에 주는 이 목표들을 통틀어 프롬프트라고 부른다. 일부 항목만 지정해도 된다. 지정하지 않은 신체 부위의 동작은 정책이 생성한다.
목표 위치는 공간에 고정된 세계 좌표로도, 로봇 몸을 기준으로 한 좌표로도 줄 수 있다. 로봇은 관절 센서와 관성 센서의 측정값으로 자기 몸의 상태를 계산한다. 세계 좌표로 준 목표를 추적하려면 공간에서 로봇이 어디 있는지도 따로 추정해야 한다. 가구를 이용하는 동작에서는 가구의 크기와 위치, 방향을 측정해 단순한 도형으로 정책에 전달한다.
| 목표 입력 | 지정하는 내용 |
|---|---|
| 신체 부위 | 손, 발, 몸통의 목표 위치와 방향 |
| 시간 | 목표에 도착할 시각 |
| 이동 | 이동 속도와 몸이 향할 방향 |
| 동작 스타일 | 참고할 자세 |
완전한 동작으로 배우고 일부 목표로 실행한다
학습은 두 단계로 진행된다. 먼저 모션 캡처 등의 완전한 동작 데이터를 따라 하는 제어기를 강화학습으로 훈련한다. 학습 데이터에는 가구를 이용하는 동작이 포함되고, 떠밀렸을 때 균형을 되찾는 동작과 넘어졌다 일어나는 동작도 합성해 추가했다.
다음 단계에서는 이 제어기를 교사로 삼는다. 학생 정책에는 목표 가운데 일부만 준다. 학생이 스스로 움직이며 겪는 자세와 상황마다, 교사가 같은 상황에서 낼 행동을 따라 하도록 학습시킨다. 이 과정을 온폴리시 증류라고 부른다. 교사는 완전한 기준 동작을 받아 행동을 정한다. 학생은 그 행동을 배우면서, 목표 일부만으로도 전신 동작을 생성하도록 훈련받는다.
학습이 끝나면 정책을 고정한다. 실행 중 목표는 스킬이라는 일반 프로그램이 정한다. 스킬은 자기 진행 상황을 기억하면서 로봇의 현재 상태에 맞춰 목표를 갱신한다. 실물 Unitree G1에서는 C++로 작성한 스킬 코드가 목표를 만들고, 정책은 50Hz, 즉 20밀리초마다 관절 명령을 낸다. 사람 체형의 시뮬레이션 캐릭터 SOMA에는 G1과 별도로 학습한 정책을 사용한다.
코딩 에이전트가 바꾸는 것은 목표 생성 프로그램이다
연구진은 코딩 에이전트에게 동작 데이터를 분석해 그에 맞는 간단한 규칙을 찾게 했다. 예를 들어 보행에서는 이동 속도에 따라 걸음 주기와 보폭을 계산하고 양발의 목표를 번갈아 지정한다. 에이전트는 정책의 가중치를 유지하면서, 스킬 코드가 정책에 전달하는 목표와 도착 시각을 조정한다.
이 방법은 작업별로 완전한 전신 궤적을 작성해야 하는 부담을 줄인다. 컵을 집을 때는 손의 목표만 주고 발의 세부 동작은 정책에 맡길 수 있다. 넘어졌을 때는 일어선 자세를 목표로 주는 프로그램으로 전환할 수 있다.
프로젝트 페이지는 사례 두 가지를 소개한다. 실물 로봇에서는 Claude Code가 보행 규칙을 조정했고, 시뮬레이션에서는 GPT-6 Astra가 사람의 지시를 받아 목표 생성 코드를 개선했다. LLM은 개발 과정에서 코드를 작성하고 시험한다. 로봇 실행 중에는 그 코드와 고정된 정책이 제어를 담당한다.2
| 확인 환경 | 연구진이 제시한 동작 |
|---|---|
| 실물 Unitree G1 | 보행, 넘어짐 복구, 원격 조작으로 물건 집기, 가구에 앉기 |
| 시뮬레이션 SOMA | 달리기, 미끄러지기, 낙하 후 복구, 벽 오르기 |
| G1 시뮬레이션 (에이전트가 작성한 스킬) | 허들, 넘어짐 후 달리기, 볼링, 테니스, 축구 킥 |
손목이 목표에 도달한 비율은 83%
연구진은 물리 시뮬레이터 MuJoCo에서 G1의 손목을 목표 54곳에 가져가는 실험을 했다. 목표까지의 거리는 0.35~1.8m, 높이는 0.55~1.35m다. 일부 목표에 손을 뻗으려면 발을 옮기거나 몸을 숙여야 했다. 로봇이 넘어지지 않은 채 손목을 목표 10cm 이내에 유지하면 성공으로 셌다.
| 제어 방식 | 목표 도달률 | 도달한 목표의 평균 오차 | 직립 유지율 |
|---|---|---|---|
| Metatron | 83% | 5.9cm | 100% |
| ARDY + SONIC | 39% | 6.4cm | 82% |
| GRU + IK + SONIC | 28% | 5.6cm | 81% |
| GRU + SONIC | 0% | 해당 없음 | 87% |
비교 대상은 동작 생성기가 만든 기준 궤적을 SONIC이라는 제어기가 따라가게 하는 방식이다. ARDY는 손의 목표를 포함한 전신 동작을 생성하는 모델이고, GRU는 연구진이 보행 동작 생성에 사용한 순환 신경망이다. GRU에 추가한 IK는 손 목표에 맞는 팔 관절 자세를 계산하는 역기구학 보정이다. 성공한 목표의 손목 오차는 비슷했지만, Metatron은 더 많은 목표에 도달했다. 연구진의 설명에 따르면, 높은 목표를 향해 균형을 잡아야 하거나 낮은 목표를 향해 몸을 숙여야 할 때 도달률 차이가 특히 컸다.
밀침 대응 실험에서는 초속 1m로 걷는 로봇의 몸통에 여덟 방향으로 100밀리초 동안 힘을 가했다. 8초 뒤에도 서 있으면 성공으로 셌다. 800N(뉴턴)으로 밀어도 1,000N으로 밀어도 Metatron은 75%의 시행에서 서 있었다. ARDY + SONIC과 GRU + SONIC에서는 두 조건 모두 성공한 시행이 없었다.3
목표를 얼마나 자세히 줄 것인가
내가 관심을 가진 것은 목표를 얼마나 자세히 정할지 개발자가 작업마다 고를 수 있다는 점이다. 논문의 손목 실험에서는 손의 목표를 달성하기 위해 보행과 자세 조절까지 함께 필요했다. 그런 조절을 정책에 맡기면 개발자는 관절 동작을 일일이 작성하지 않아도 된다. 대신 어떤 목표를 주고 언제 다음 동작으로 전환할지를 코드로 시험해 볼 수 있다.
그래서 다음 실험이 궁금해진다. 연구진이 공개한 스킬은 보행이나 일어서기처럼 분명한 동작 전환을 다룬다. 여러 물건을 정해진 순서대로 다뤄야 하는 작업에서도 이 목표 표현만으로 스킬을 얼마나 간단히 작성할 수 있을까.
출처
- Chen Tessler, Yifeng Jiang, Alec Otto, Yi Shi, Umar Iqbal, Gal Chechik, Xue Bin Peng, NVIDIA 및 Dollhouse Robotics.
- 프로젝트 페이지
- 논문 PDF
- 브라우저 체험 데모
논문 본문 I, III, IV, V절과 배포 부록을 바탕으로 정리했다. 프로젝트 페이지와 논문 모두 발표일을 밝히지 않았다. 이 글은 2026년 10월 29일에 확인한 자료를 기준으로 썼다. ↩︎
프로젝트 페이지의 에이전트 개발 설명. 연구진은 실물 보행 개선을 정성적으로 평가했다. 스포츠 예시는 시뮬레이션이며, 허들 위치나 공을 놓는 시각 등은 작업 코드가 제공한다. ↩︎
논문 VI-E절, 표 I과 II. 두 비교 실험에서는 합성 복구 데이터를 제외한 Metatron을 사용했다. 밀침 실험에서는 힘이 커질수록 성공률이 일정하게 낮아지지는 않았다. 이 비교는 제어 방식 전체를 견준 것이고, 설계 요소 하나의 효과를 분리한 실험은 아니다. ↩︎