3줄 요약
- Meta AI가 2025년 11월 19일 3D 복원 모델 두 가지를 공개했다. SAM 3D Objects는 2D 일상 사진 한 장으로 객체와 장면을, SAM 3D Body는 인체 자세와 체형을 복원한다.
- 전문 아티스트가 모두 수작업으로 제작하는 대신 모델이 만든 후보를 검증하고 순위를 매기는 데이터 엔진으로 실제 이미지 약 100만 장과 메시 314만 개를 구축했다. 합성 데이터 사전학습과 실세계 사후학습을 결합한 결과 인간 선호도 평가에서 경쟁 모델보다 5대 1 이상으로 더 많이 선택됐다.
- 모델 체크포인트와 추론 코드, 골격과 연조직을 분리한 오픈소스 인체 모델 MHR, 실세계 평가 벤치마크 SA-3DAO를 함께 공개했다. 두 모델은 Segment Anything Playground와 Facebook Marketplace의 ‘View in Room’ 기능에 즉시 적용됐다.
일상 사진을 3D로 복원하는 두 모델과 공개 생태계
Meta AI가 공개한 SAM 3D는 단일 2D 자연 이미지에서 물리 세계의 객체와 인체를 3D로 복원하는 파운데이션 모델 제품군이다. 기존 Segment Anything(SAM) 시리즈가 이미지와 영상 속 대상을 2D 마스크로 분할하는 데 집중했다면, SAM 3D는 정지 사진 한 장만으로 물체의 3D 형상과 텍스처, 공간 배치, 인체 골격과 체형까지 추론한다.
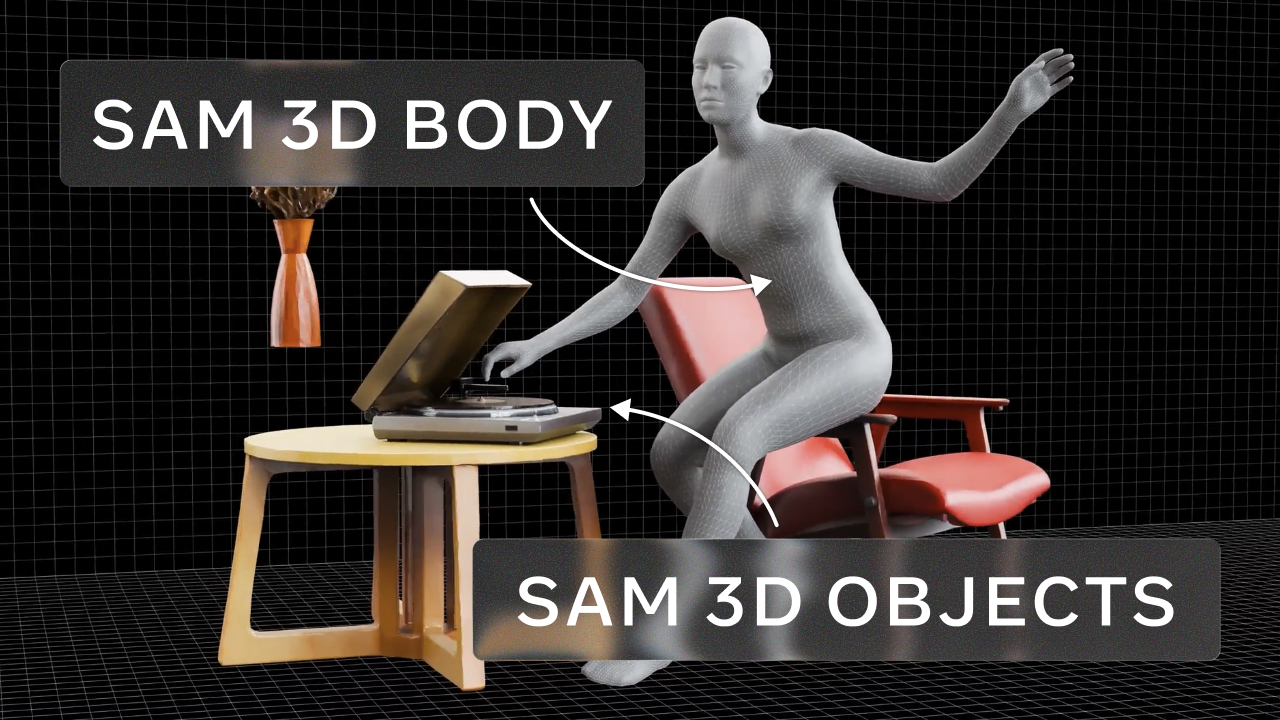 단일 이미지에서 인체 메시를 복원하는 SAM 3D Body와 주변 사물을 3D 객체로 재구성하는 SAM 3D Objects. 출처: Meta AI
이번 발표는 두 개의 핵심 모델과 오픈소스 인체 리깅 포맷, 실세계 평가 벤치마크, 웹 체험 도구, 상용 서비스 적용을 포괄한다.
| 공개 항목 | 역할과 공개 형태 |
|---|---|
| SAM 3D Objects | 객체 및 장면 3D 복원 모델 (가중치와 코드) |
| SAM 3D Body | 3D 인체 자세 및 체형 복원 모델 (가중치와 코드) |
| MHR | 골격과 연조직 분리 인체 포맷 (상업용 오픈소스) |
| SA-3DAO | 실세계 사진과 정답 메시 평가 벤치마크 |
| Segment Anything Playground | 사진을 올려 3D 복원을 시험하는 웹 체험 도구 |
| Facebook Marketplace ‘View in Room’ | 구매 전 상품을 방에 3D로 배치하는 상용 기능 |
SAM 3D Objects: 데이터 엔진과 다단계 학습으로 해결한 실세계 3D 복원
단일 자연 이미지에서 물체의 3D 형상과 텍스처, 포즈(공간 배치)를 복원하는 일은 오랫동안 데이터 부족으로 제약을 받아 왔다. 텍스트나 2D 이미지와 비교하면 3D 정답(Ground Truth) 데이터의 규모는 수백에서 수천 배 작고, 기존에 공개된 데이터도 대부분 단순한 배경으로 제작된 합성 단일 객체 에셋에 편중되어 있었다. 이 때문에 기존 3D 생성 모델은 단일 객체만 따로 생성할 때는 성능이 좋았다. 그러나 일상 사진에서는 작은 물체, 비스듬한 촬영 시점, 다른 물체에 가려진 영역(Occlusion) 때문에 복원 정확도가 크게 낮아졌다.
Meta 연구진은 이 문제를 모델 루프 내(Model-in-the-loop) 데이터 엔진과 LLM식 다단계 학습 레시피의 결합으로 해결했다. 3D 모델을 처음부터 제작하려면 숙련된 3D 아티스트가 필요하고 시간과 비용도 많이 든다. 반면 여러 모델이 생성한 3D 메시 후보의 품질을 검증하거나 순위를 매기는 일(Verifying or Ranking)은 일반 작업자도 수행할 수 있다. 연구진은 이 차이를 활용했다.
여러 모델 조합이 생성한 후보 메시를 일반 작업자가 평가하게 하고, 모델들이 모두 실패하는 가장 까다로운 사례만 전문 3D 아티스트에게 배정해 부족한 데이터를 보충했다. 이 데이터 엔진으로 실제 이미지 약 100만 장에 3D 객체 형상과 텍스처, 공간 배치 정보를 주석으로 기록했다. 이 과정에서 구축한 메시는 약 314만 개다.
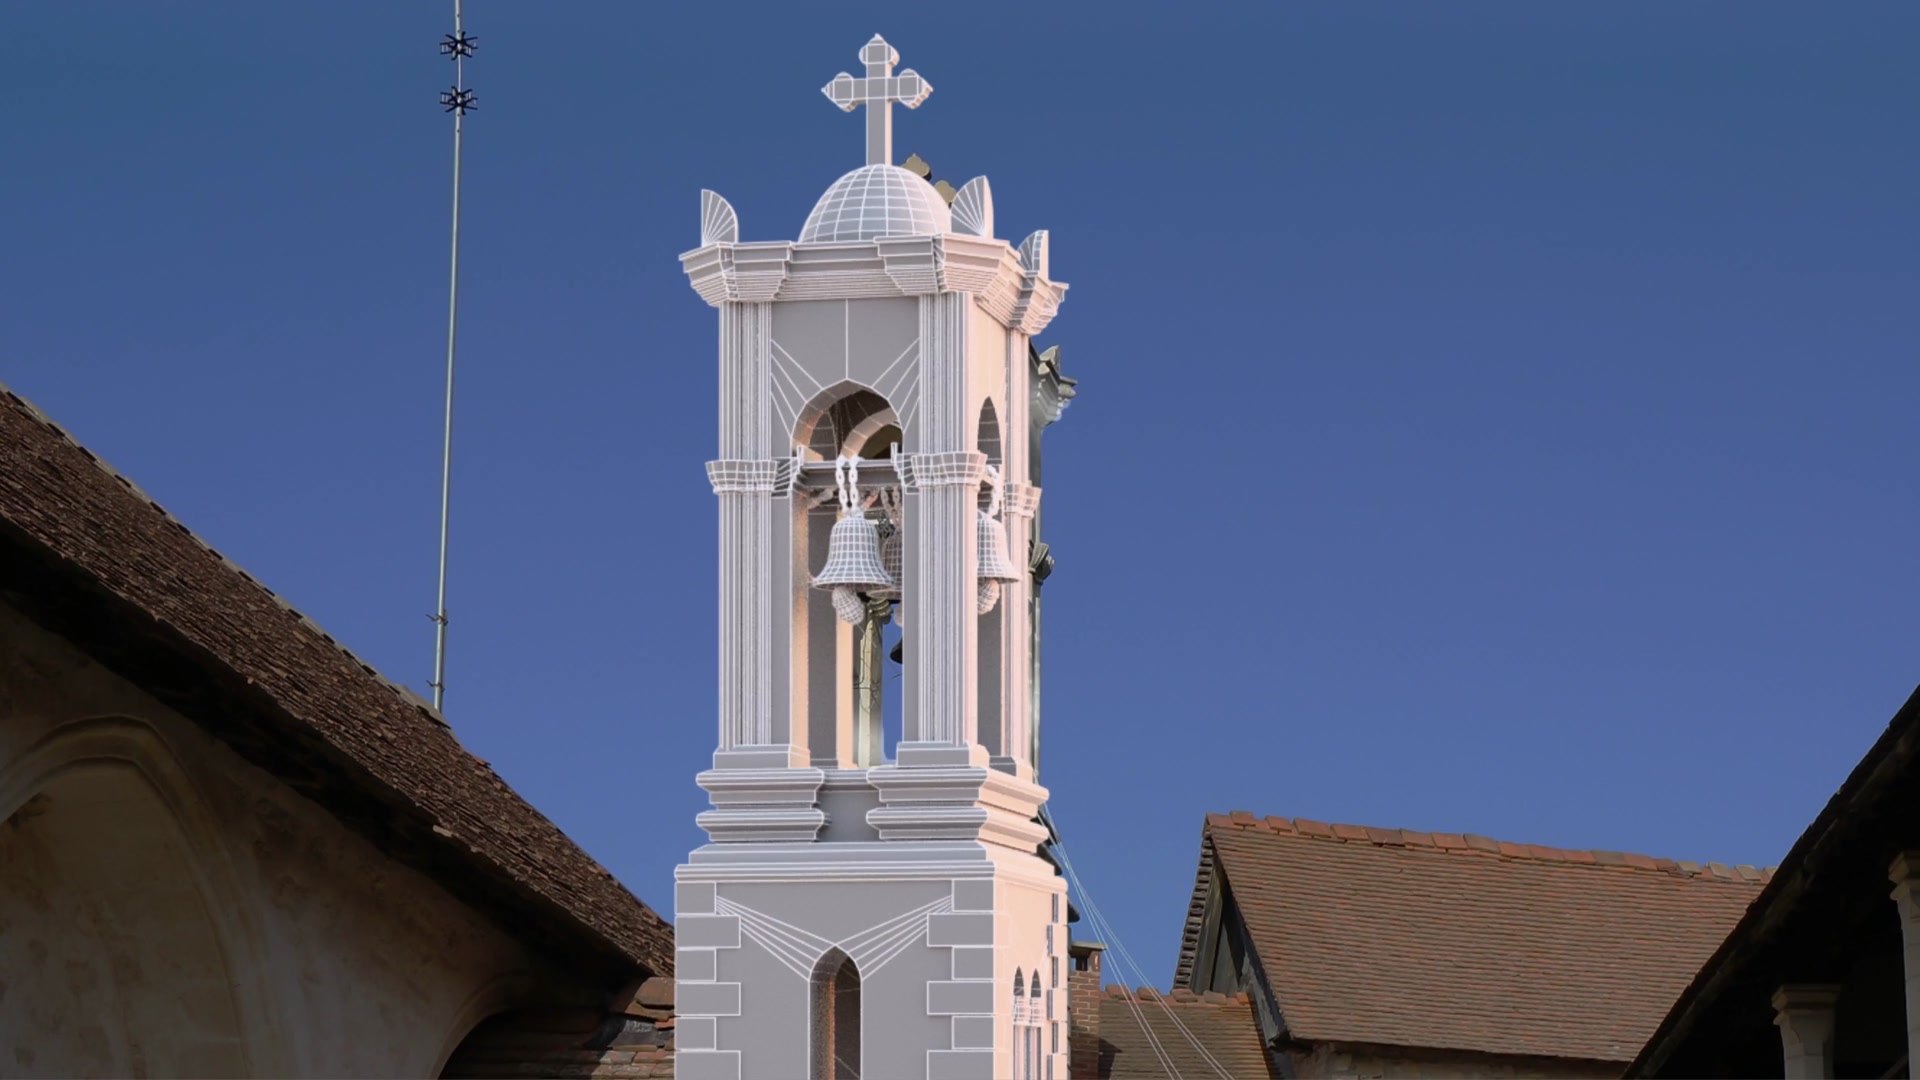 실제 사진 속 건축물 구조와 종의 세부 형태를 3D 와이어프레임 메시로 복원한 예시. 출처: Meta AI
학습 과정에는 최근 대규모 언어 모델(LLM)이 확립한 다단계 공식을 도입했다. 대규모 합성 3D 에셋으로 모델을 사전학습(Pre-training)한 뒤, 데이터 엔진에서 수집한 실제 이미지로 사후학습 정렬(Post-training Alignment)을 거쳤다. 합성 데이터와 실제 사진 사이의 차이(Sim-to-Real Gap)를 극복하기 위한 과정이다. 사후학습으로 모델의 강건성과 출력 품질이 향상되면 데이터 엔진이 더 나은 후보 메시를 생성하고, 그 데이터가 다시 다음 세대 모델을 개선하는 선순환이 반복된다.
또한 실제 일상 사진 분포를 평가할 벤치마크가 부족하다는 문제를 해결하기 위해 아티스트들과 협업해 SA-3DAO(SAM 3D Artist Objects) 데이터셋을 새로 구축했다. 연출된 이미지나 합성 에셋 대신 난도가 높은 실제 이미지와 정답 객체 메시 쌍으로 구성된 평가 기준이다.
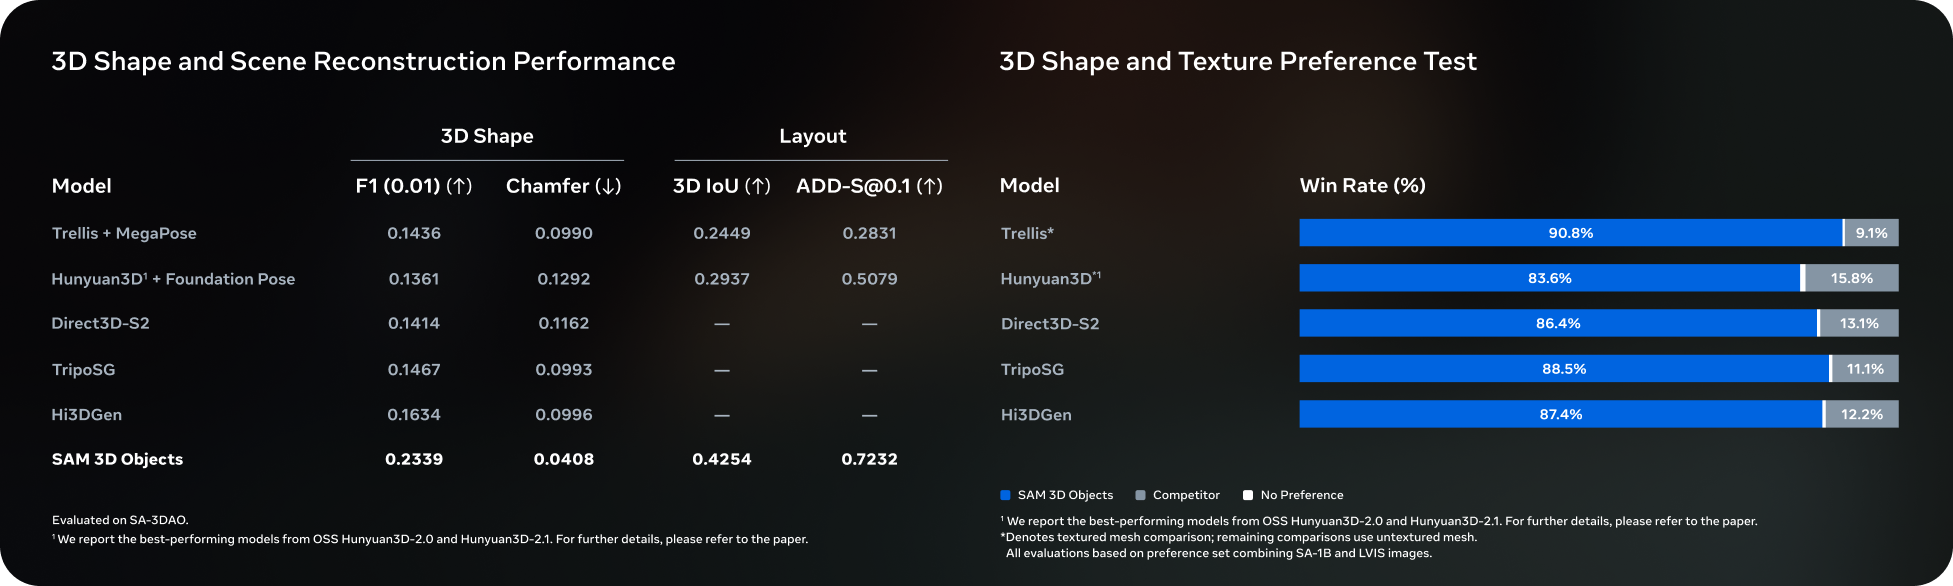 SA-3DAO 벤치마크 정량 성적(왼쪽)과 SA-1B 및 LVIS 이미지 기반 1:1 인간 선호도 평가 승률(오른쪽). 출처: Meta AI
SA-3DAO 평가와 선호도 테스트에서 SAM 3D Objects는 3D 형상, 공간 배치, 시각적 품질 모두 기존 모델보다 높은 성적을 거두었다1.
- 3D 형상과 공간 배치: 형상 지표 F1(0.01) 0.2339, 오차 거리 Chamfer Distance 0.0408을 기록해 오차를 비교 모델(0.0990~0.1292)의 절반 이하로 줄였다. 장면 배치 정확도도 3D IoU 0.4254, [email protected] 0.7232로 기존 2단계 파이프라인(Hunyuan3D + Foundation Pose, Trellis + MegaPose)보다 높았다.
- 인간 선호도와 추론 속도: SA-1B와 LVIS 이미지 기반 일대일 선호도 평가에서 경쟁 모델 대비 5대 1 이상의 승패 비율(승률 83.6%~90.8%)을 달성했다2. 확산 모델 단축 기법(Diffusion Shortcuts)과 최적화를 거쳐 텍스처가 포함된 3D 복원 결과를 수 초 안에 반환하므로 로보틱스의 준실시간 3D 인식 모듈로도 쓸 수 있다.
SAM 3D Objects의 현재 한계는 두 가지다. 첫째, 출력 해상도가 중간 수준이라 사람 전신처럼 복잡한 대상을 객체 모델로 복원하면 왜곡이나 세부 형태 손실이 발생한다. 둘째, 장면 속 객체를 하나씩 개별 예측하기 때문에 물체 간 접촉(Contact)이나 객체끼리 겹치는 현상(Interpenetration) 같은 물리적 상호작용을 함께 추론하지 못한다. 해상도 향상과 다중 객체 동시 예측 손실 함수 도입이 후속 과제로 제시됐다.
SAM 3D Body: MHR 포맷과 프롬프트 기반 3D 인체 복원
인체 복원 전용 모델인 SAM 3D Body는 사진 한 장으로 3D 인체 자세와 체형을 추정한다. 자세가 특이하거나 신체 일부가 가려진 경우, 여러 인물이 함께 있는 장면에서도 작동한다. 사용자가 세그멘테이션 마스크나 2D 관절 키포인트를 프롬프트로 입력해 복원할 대상을 지정할 수 있다.
기반 포맷으로는 Meta가 함께 공개한 오픈소스 MHR(Meta Momentum Human Rig)을 사용한다. 인체의 골격 구조(Skeletal Structure)와 근육, 피부 같은 연조직 형상(Soft Tissue Shape)을 분리한 파라메트릭 인체 모델이다. Meta의 고정밀 아바타 기술인 Codec Avatars의 핵심 포맷이며, 상업적 이용이 허용되는 라이선스(Permissive Commercial License)로 배포된다.
모델은 트랜스포머 인코더-디코더 구조를 사용해 MHR 메시 파라미터를 예측한다. 이미지 인코더는 신체 각 부위의 고해상도 세부를 포착하기 위해 다중 입력 설계를 채택했고, 메시 디코더는 프롬프트 기반 예측과 다단계 정제(Multi-step Refinement)를 수행해 이미지의 시각적 근거를 반영하고 2D 정렬 정확도를 높인다.
연구진은 수십억 장 규모의 사진 컬렉션, 다중 카메라 캡처 시스템으로 촬영한 고화질 영상, 전문가가 제작한 합성 데이터를 학습의 기초 자료로 활용했다. 여기에 희귀한 자세와 드문 촬영 조건을 가진 고가치 이미지만 자동으로 선별해 내는 데이터 엔진을 적용해 약 800만 장 규모의 고품질 학습 데이터셋을 구축했다. 이 데이터셋으로 학습해 가림 현상이나 복잡한 의상, 비정형 자세에서도 강건하게 작동한다.
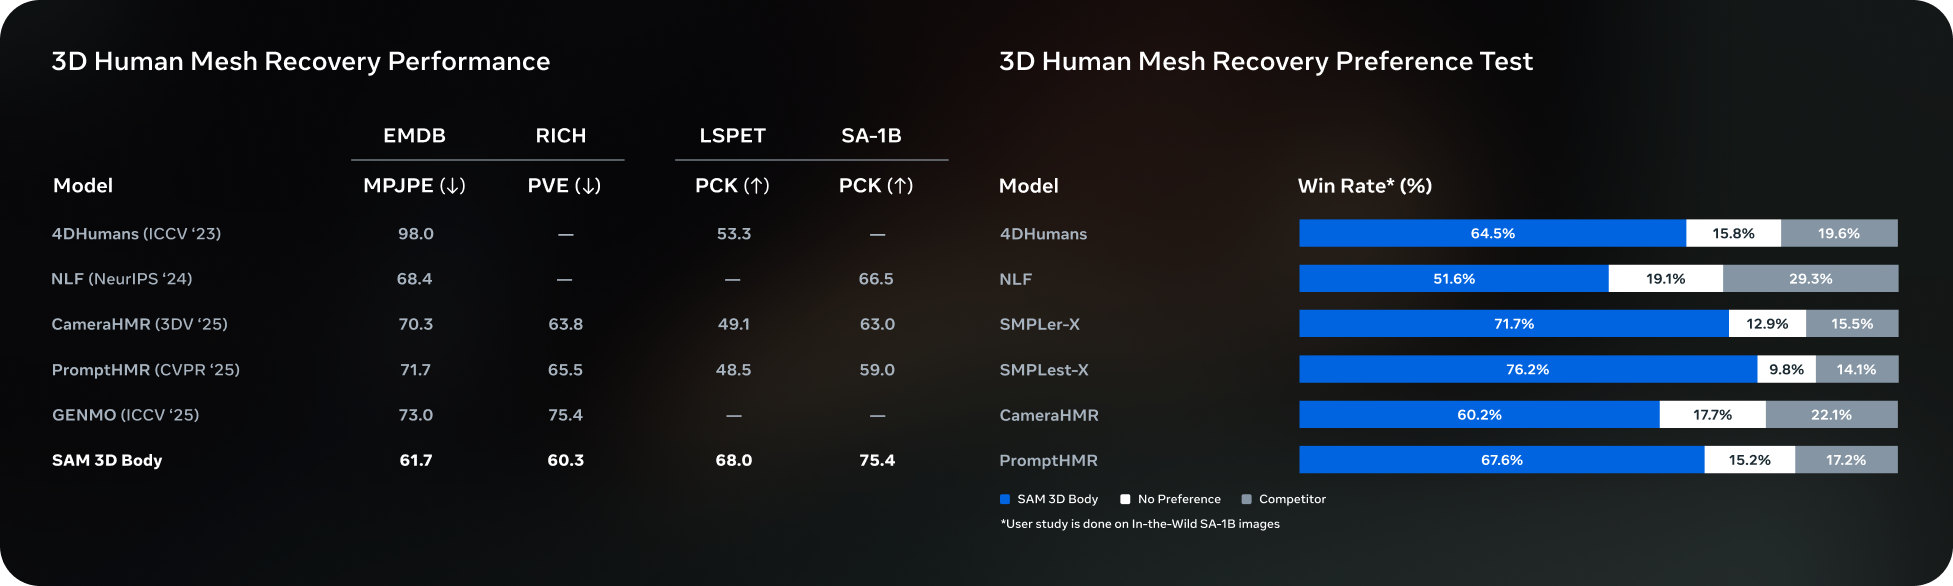 3D 인체 메시 복원 벤치마크 정량 성적(왼쪽)과 SA-1B 야외 이미지 기반 사용자 선호도 승률(오른쪽). 출처: Meta AI
다수의 3D 인체 복원 벤치마크와 사용자 선호도 평가에서 SAM 3D Body는 기존 최신 모델들보다 일관되게 우수한 성적을 기록했다3.
- 벤치마크 오차와 정합률: 3D 관절 좌표 오차를 재는 EMDB MPJPE에서 61.7, 정점 단위 오차를 재는 RICH PVE에서 60.3을 기록해 비교 모델들 중 가장 낮은 오차를 보였다. 2D 관절 정합 비율인 PCK 평가에서도 LSPET 68.0, SA-1B 75.4로 가장 높은 정합률을 달성했다.
- 야외 이미지 선호도 평가: 실제 야외 사진(In-the-Wild SA-1B)을 대상으로 한 사용자 선호도 조사에서는 비교 대상인 6개 인체 복원 모델 대비 51.6%에서 76.2%의 승률을 기록했다.
SAM 3D Body 역시 두 가지 후속 개선 과제를 남겼다. 현재는 사진 속 인물을 한 사람씩 독립적으로 처리하므로 여러 사람 사이의 상호작용이나 사람과 주변 사물 간의 물리적 접촉 및 상대적 배치를 함께 추론하지 못한다. 또한 전신 추정 과제의 일부로서 손 자세(Hand Pose) 추정 성능을 크게 향상시켰으나, 손만 단독으로 다루는 전용 추정 모델의 정확도보다는 아직 낮다.
가장 흥미로운 지점
인터넷에서 텍스트와 2D 이미지는 쉽게 모을 수 있지만 3D 정답 데이터는 그렇지 않다. 이 만성적인 데이터 부족 때문에 기존 3D 컴퓨터 비전 연구는 배경 없는 합성 에셋에 의존해 왔다. 이번 발표에서 눈여겨볼 대목은 이 병목을 푼 방식이다. 3D 메시를 처음부터 직접 제작하는 일은 어렵지만, 모델이 만든 여러 메시 후보 중 더 나은 것을 고르는 일은 훨씬 쉽다. 이 비대칭성을 활용해 일반 작업자 평가와 전문 아티스트 작업을 결합한 데이터 엔진을 만들었고, LLM에서 검증된 학습 방식도 그대로 적용했다. 합성 데이터로 사전학습한 뒤 실세계 데이터로 사후학습하고 정렬하는 방식이다. 실제 이미지 100만 장과 메시 314만 개라는 규모는 알고리즘 구조 변경 못지않게 데이터 파이프라인 설계가 3D 인식 성능을 결정하는 중요한 요인임을 보여준다.
다른 하나는 오랫동안 학계 표준으로 쓰이던 SMPL 계열 대신 골격과 연조직을 분리한 MHR 포맷을 상업적 이용이 가능한 오픈소스로 공개했다는 점이다. 기존 인체 복원 연구나 게임, AR/VR 파이프라인에서는 인체 모델의 라이선스 제약과 리깅 호환성이 실무 도입의 제약이 되는 경우가 많았다. SAM 3D Objects와 SAM 3D Body는 각각 개별 사물과 개별 인체를 높은 정확도로 복원한다. 두 모델의 공통 한계는 여러 객체와 인물 사이의 물리적 접촉 및 공간 상호작용을 통합적으로 추론하지 못한다는 점이다. 이를 해결하는 일이 다음 세대 3D 파운데이션 모델의 핵심 과제가 될 것으로 예상된다.
출처
Meta AI, 「Introducing SAM 3D: Powerful 3D Reconstruction for Physical World Images」, 2025-11-19. 원문: https://ai.meta.com/blog/sam-3d/
- SAM 3D Objects 논문: SAM 3D: 3Dfy Anything in Images / 코드: facebookresearch/sam-3d-objects
- SAM 3D Body 논문: SAM 3D Body: Robust Full-Body Human Mesh Recovery / 코드: facebookresearch/sam-3d-body
- Meta Momentum Human Rig (MHR): facebookresearch/MHR
- 치비 서소영 삽화 2장은 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
F1(0.01)은 거리 임계값 0.01로 예측 점군과 정답 점군을 비교했을 때 정밀도와 재현율의 조화 평균이며 값이 높을수록 우수하다. Chamfer Distance는 두 점군 사이의 평균 최근접 거리 오차로 값이 낮을수록 우수하다. 배치 지표인 3D IoU는 3D 바운딩 박스의 교집합 대비 합집합 비율이고, [email protected]은 객체 지름의 10% 이내로 정점 좌표가 정합된 비율(높을수록 우수)이다. 오픈소스 Hunyuan3D 비교치는 Hunyuan3D-2.0과 Hunyuan3D-2.1 중 더 높은 성적을 낸 모델을 기준으로 집계했다. ↩︎
선호도 평가에서 Trellis*와 Hunyuan3D*는 텍스처가 포함된 메시 기준으로 비교했고, 나머지 모델(Direct3D-S2, TripoSG, Hi3DGen)은 텍스처가 없는 형상 메시 기준으로 비교했다. ↩︎
MPJPE(Mean Per Joint Position Error)는 예측된 3D 관절 좌표와 정답 관절 좌표 사이의 평균 오차(mm 단위, 낮을수록 우수)이며, PVE(Per Vertex Error)는 인체 메시 표면 정점 전체의 평균 좌표 오차(낮을수록 우수)다. PCK(Percentage of Correct Keypoints)는 재투영된 2D 관절점이 임계 거리 안에 들어온 정답 비율(높을수록 우수)이다. ↩︎