3줄 요약
- 메타가 2026년 10월 12일 Muse Wonder와 상위 모델 Muse Wonder Full을 공개했다. 메타는 두 모델이 개인 비서와 업무용 에이전트 과제에서 최고 성능을 낸다고 소개했다. Muse Wonder는 발표 당일부터 Meta Model API와 Muse Code에서 쓸 수 있고, Full은 Muse Code 구독자에게만 제공된다.
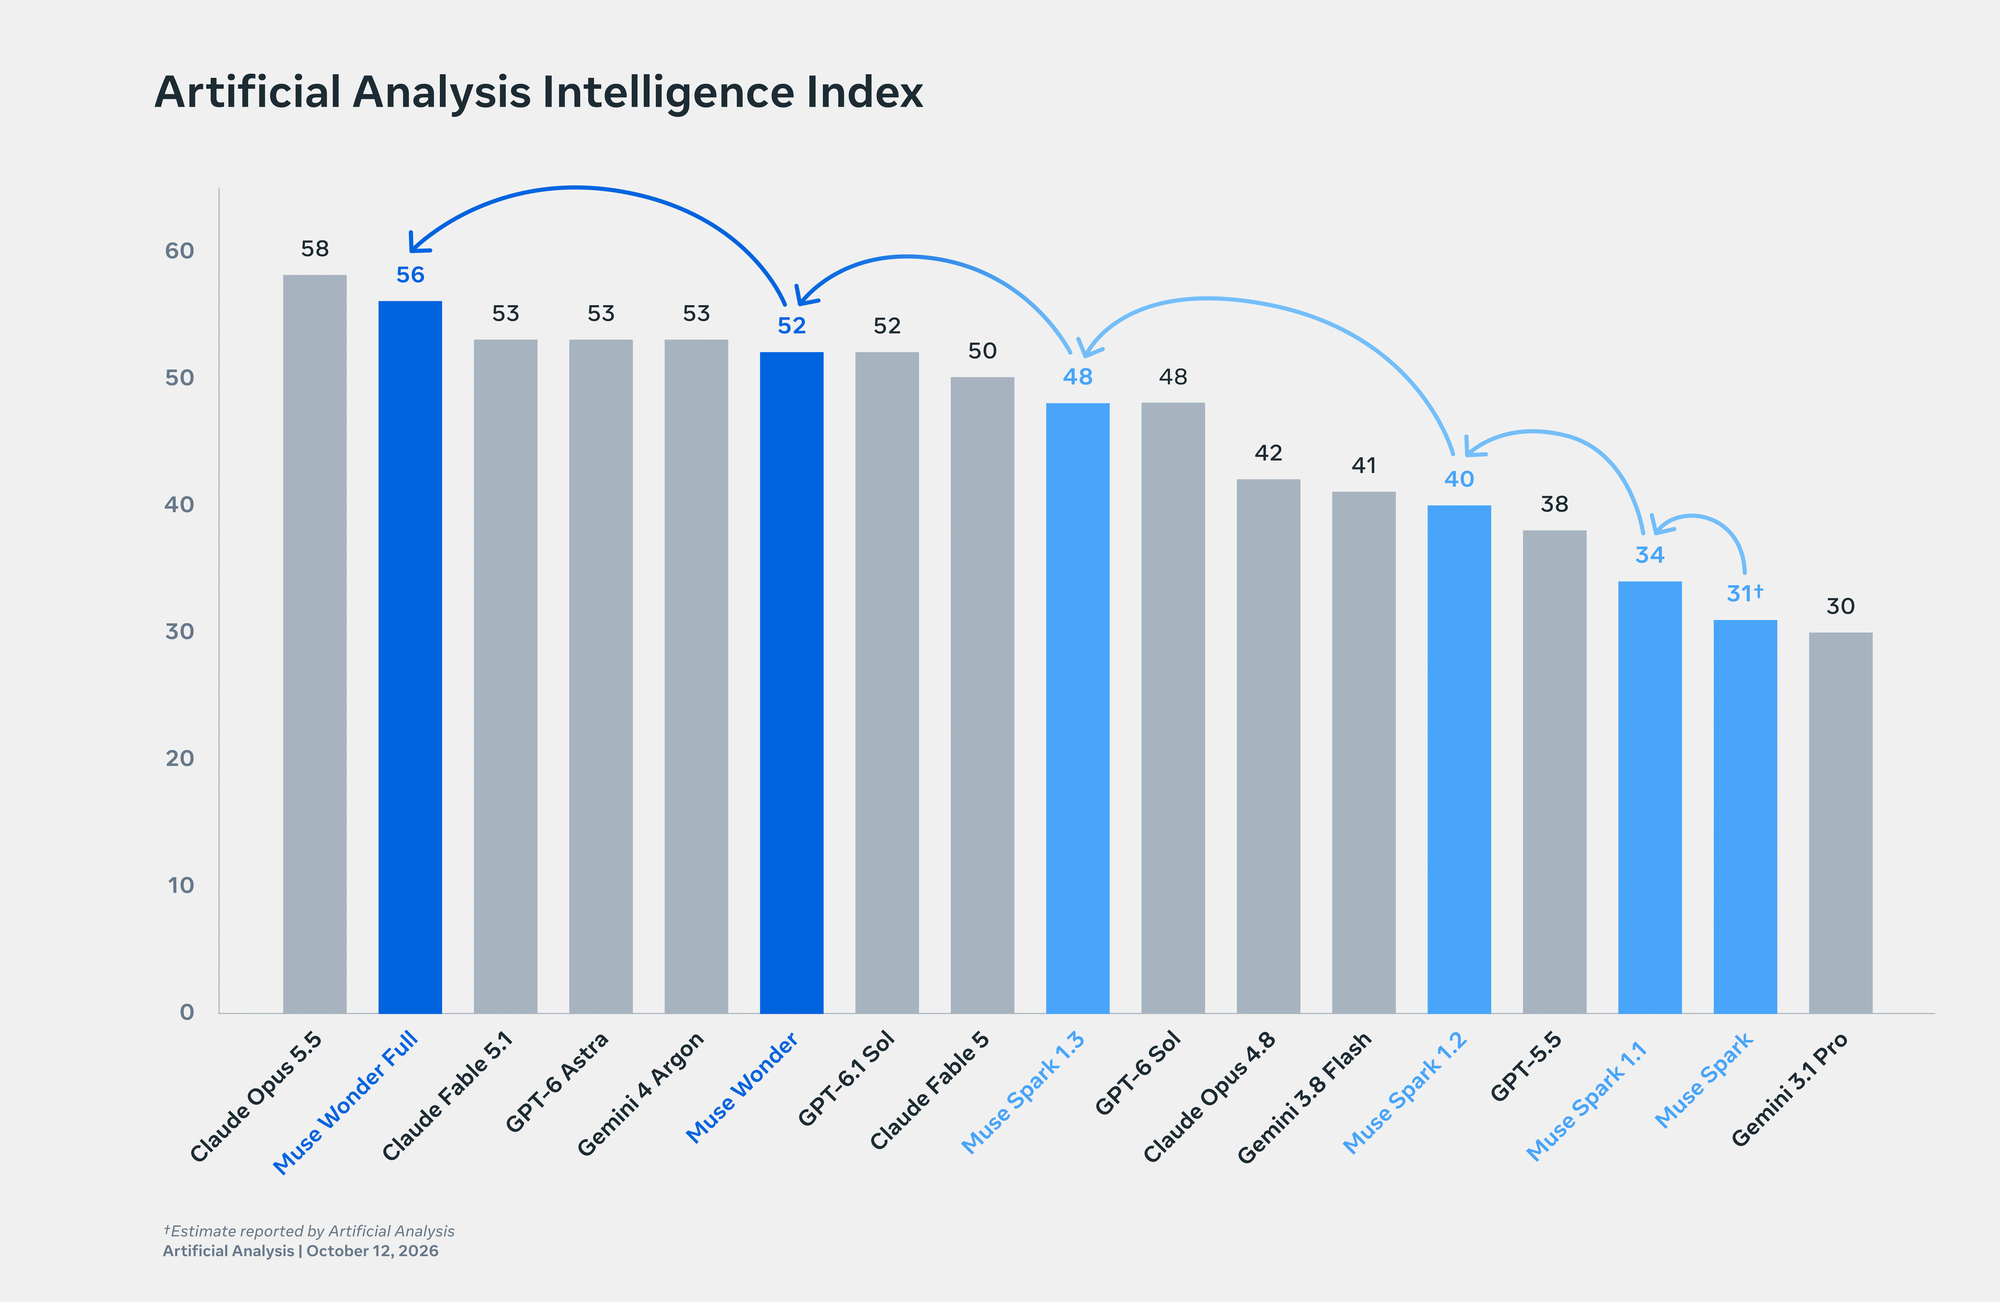
- 메타가 공개한 비교표의 14개 평가 가운데 Muse Wonder 계열은 법률, 금융, 업무 자동화, 기억, 장기 코딩을 포함한 7개에서 가장 높은 점수를 받았다. 나머지 7개 중 6개는 Claude Opus 5.5가 가장 높았다. 종합 지수인 Artificial Analysis Intelligence Index에서는 Full이 56점으로 Opus 5.5의 58점에 이어 두 번째다.
- 메타가 강조한 강점은 두 가지다. Active Memory는 대화가 바뀌어도 사용자의 맥락을 기억하는 능력이고, Active Focus는 문제가 생기면 다른 방법을 시도해 끝까지 일하는 능력이다. 메타는 기반 모델이 커진 덕분에 사후 학습에서 목표로 삼은 과제의 점수가 같아도 목표로 삼지 않은 과제의 점수는 이전 세대보다 높게 나온다고 설명했고, 개인 정보 취급과 악용 방지 평가 결과도 함께 공개했다.
무엇을 공개했는가
Muse Wonder 시리즈는 Muse Wonder와 Muse Wonder Full 두 모델로 구성된다. 발표문에 따르면 이 시리즈는 메타가 목표로 하는 “개인용 초지능(personal superintelligence)” 개발에서 큰 진전이다. 모델 카드에 따르면 두 모델 모두 텍스트, 이미지, 영상, 음성을 입력으로 받고 텍스트로 답한다. 추론 시 컨텍스트 길이는 100만 토큰이다.
| 항목 | Muse Wonder | Muse Wonder Full |
|---|---|---|
| 지금 쓸 수 있는 경로 | Meta Model API, Muse Code | Muse Code 구독자 |
| 예정된 용도 | 메타의 AI 서비스 Muse에 탑재(구독자부터) | 발표문에 언급 없음 |
Meta Model API와 Muse Code는 모두 메타 개발자 사이트(dev.meta.ai)에서 제공된다. 메타는 Muse Wonder를 산출물을 생성하거나 더 높은 지능이 필요한 작업을 처리하는 데에도 쓰겠다고 밝혔다. 나중에는 Muse 이용자 모두에게 제공할 특화 모델을 만드는 데 활용할 계획이다.
발표문은 메타가 14개월 전 AI 개발 체계를 처음부터 다시 만들기 시작했다는 이야기로 배경을 설명한다. 이전 모델 Muse Spark를 공개할 때 메타는 성능을 예측할 수 있는 엄밀한 규모 확장 방식을 제시했다. Muse Wonder는 그 방식을 사전 학습과 강화학습 모두에 적용한 결과이고, 기가와트급 데이터센터인 Prometheus에서 학습했다.
평가 결과
메타는 자사 모델 둘과 다른 회사 모델 셋을 14개 평가로 비교한 표를 공개했다. 모든 모델을 최대 추론 강도인 max로 평가했다. 예외는 SWE-Marathon의 Muse Wonder Full 결과로, 추론 강도가 max 다음 등급인 xhigh였다. 굵은 글씨는 각 행의 최고 점수다.1
| 평가 | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| 개인 및 업무용 에이전트 | |||||
| Personal Superintelligence Index | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1 부분 점수 | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| OSWorld V2.1 완수율 | 39.4 | 34.3 | 43.1 | 34.3 | - |
| MemoryBench | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| 코딩 | |||||
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | 57.5 | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| 종합 | |||||
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
각 평가가 재는 내용은 모델 카드에 정리되어 있다.
| 평가 | 무엇을 재는가 |
|---|---|
| Personal Superintelligence Index | 메타 내부 종합 지표. Agents’ Last Exam, AutomationBench-AA, FocusBench, JobBench, GDP.pdf, VBT, DRACO 일곱 평가를 합쳤다 |
| Harvey LAB-AA | 사건 문서를 읽고 법률 문서를 작성하는 과제. 모든 채점 기준을 충족하고 환각 검사도 통과한 과제의 비율 |
| Vals Finance Agent V2 | 공시 자료와 시장 정보를 조사해 푸는 재무 분석가 과제 |
| HealthBench Pro | 전문가 수준의 건강 질문 525개. 도구 없이 답하고 의사가 쓴 채점 기준으로 평가 |
| AutomationBench-AA | 가상 업무 앱 환경에서 자동화 도구로 업무 흐름을 끝까지 처리하는 과제 |
| GDP.pdf | 주어진 PDF 자료를 근거로 전문 업무를 수행하는 과제 |
| JobBench | 화이트칼라 직업 35종의 실무 과제 65개 |
| OSWorld V2.1 | 우분투 데스크톱에서 화면을 보고 클릭과 타이핑으로 처리하는 실제 업무 108개 |
| MemoryBench | 메타 내부 평가. 여러 차례에 걸친 대화에서 핵심 정보를 정확히 기억하는지 평가. 대화 분량은 6만 4천에서 10만 토큰 |
| Terminal-Bench 4.0 | 격리된 터미널 환경에서 처리하는 어려운 과제 |
| DeepSWE 1.1 | 저장소 91개, 언어 5종에 걸친 장기 소프트웨어 엔지니어링 과제 113개 |
| SWE-Marathon | 프로젝트 테스트로 채점하는 초장기 소프트웨어 프로젝트 |
| ProgramBench | 인터넷 없이 프로그램 하나를 처음부터 다시 구현하는 과제 |
Muse Wonder 계열이 가장 높은 점수를 받은 평가는 7개다. 개인 및 업무용 에이전트 분야의 Personal Superintelligence Index, Harvey LAB-AA, Vals Finance Agent V2, AutomationBench-AA, MemoryBench와 코딩 분야의 DeepSWE, SWE-Marathon이다. Harvey LAB-AA에서 Full은 13.1점으로, 다른 회사 모델 중 가장 높은 GPT-6 Astra의 8.6점보다 4.5점 높다. 이 평가는 모든 기준을 충족하고 환각 검사까지 통과한 과제만 성공으로 세며, 다섯 모델의 점수는 모두 4.2에서 13.1 사이다. 장기 코딩 과제인 SWE-Marathon에서도 Full은 57.5점으로 Opus 5.5보다 11.2점 높다.2
Muse Wonder 계열이 최고 점수를 받지 못한 7개 평가 가운데 6개는 Claude Opus 5.5가 최고 점수를 받았다. HealthBench Pro, JobBench, OSWorld 부분 점수, Terminal-Bench, ProgramBench, Artificial Analysis Index다. ProgramBench에서는 Opus 5.5가 70.5점으로 Full의 59.0점보다 11.5점 높다. GDP.pdf에서는 GPT-6 Astra가 34.2점으로 가장 높았다.
Artificial Analysis Intelligence Index v4.3은 종합 지수다. 외부 기관 Artificial Analysis가 GDPval-AA, Terminal-Bench 4.0, Humanity’s Last Exam 등을 독립적으로 실행하고, 그 결과를 종합해 산출한다. 커버 그림이 이 지수의 막대 그래프다. Opus 5.5는 58점이고 Full은 56점이다. Claude Fable 5.1, GPT-6 Astra, Gemini 4 Argon은 모두 53점으로 공동 3위다. Muse Wonder는 52점이다. 그림의 파란 막대는 메타 모델이고, 세대가 바뀔 때마다 화살표로 이어져 있다. Muse Spark는 31점으로, Artificial Analysis의 추정치다. Muse Spark 1.1은 34점, 1.2는 40점, 1.3은 48점이다.
메타가 강조한 네 가지 능력
메타는 실제 과제를 처리하는 데 핵심이 되는 능력으로 전문 지식, Active Memory, Active Focus, 코딩 네 가지를 제시했다.
전문 지식
임대 계약서를 이해하거나 재무 정보와 건강 정보를 해석하는 것처럼, 사람들이 일상과 업무에서 마주치는 문제에 전문 지식을 적용하는 능력이다. 법률, 금융, 건강 평가가 이 능력을 잰다. 예를 들어 Harvey LAB에서는 모델이 원본 문서를 다루고 세부 지시에 따라 법률 업무 산출물을 작성해야 한다. 발표 영상에서 한 연구원은 임대 매물을 구할 때 자신이 요구하는 조건이 까다로운 편이라고 말했다. 이 연구원은 매일 여러 출처에서 새 매물을 조사하고 집주인에게 연락하는 일까지 모델에 맡긴다고 했다.
Active Memory
메타는 쓸모 있는 개인 비서와 업무용 에이전트를 만드는 데 가장 중요한 요소 중 하나로 믿을 수 있는 기억을 들었다. 모델은 중요한 것을 기억해야 하고, 예전에 받은 정보가 지금 과제와 관련될 때 그것을 알아차려야 한다. Active Memory는 사용자에 관한 중요한 맥락을 대화가 바뀌어도 유지하고, 지금 과제에 필요한 세부 사항을 스스로 찾아 쓰는 능력을 말한다.
이 능력은 메타 내부 평가 MemoryBench로 쟀다. 대화는 여러 차례에 걸쳐 이루어지며, 분량은 6만 4천에서 10만 토큰이다. 이 대화에는 모델이 기억해야 할 정보가 여러 개 포함된다. 관계없는 내용, 그리고 목표 정보와 충돌하거나 나중에 그 정보를 바꾸는 발언도 대화에 포함된다. LLM 채점자가 질문별 채점 기준으로 답을 평가한다. Muse Wonder가 85.6점, Full이 85.5점이고 다른 회사 모델 중 가장 높은 Opus 5.5는 81.5점이다.
Active Focus
맥락을 활용해 과제를 완수하려면 꾸준한 노력도 필요하다. 어려운 목표를 달성할 때까지 Muse Wonder가 계속 일하는 방식에 메타는 Active Focus라는 이름을 붙였다. 모델은 다른 방법을 시도하고, 작업을 진행하기 어렵게 하는 문제를 해결하며, 새 정보에 맞춰 방법을 바꾼다. 그 과정에서 필요하면 질문해서 확인하고, 중요한 행동을 하기 전에는 사용자에게 먼저 묻는다. 발표 영상의 한 연구원은 이 모델을 만들면서 가장 어려웠던 일로 실제 사용 환경의 실패를 안정적으로 재현하는 일을 들었다. 그래야 모델이 그런 실패를 예상하고 피하도록 학습시킬 수 있다는 것이다.
메타는 이 능력을 내부 평가 FocusBench와 장기 소프트웨어 프로젝트를 다루는 SWE-Marathon으로 쟀다. FocusBench는 주거, 여행, IT, 금융 같은 분야의 개인 비서 과제로 구성된다. 여러 차례 상호작용하는 동안 모델이 작업 진행을 어렵게 하는 문제를 끈기 있게 해결하고, 변화하는 환경에 적응하는지 평가한다. 결과는 다음과 같다.
| 모델 | FocusBench |
|---|---|
| Muse Wonder Full | 54.2 |
| GPT-6 Astra | 47.7 |
| Claude Opus 5.5 | 45.8 |
| Muse Wonder | 44.9 |
| Claude Fable 5.1 | 36.6 |
FocusBench에서는 Full만 다른 회사 모델보다 점수가 높다. Muse Wonder는 GPT-6 Astra와 Opus 5.5보다 점수가 낮다.
코딩
메타는 코딩을 이 능력들이 한꺼번에 필요한 작업으로 설명한다. 소프트웨어를 만들려면 요구 사항을 계속 기억해야 하고, 코드베이스 여러 곳을 고쳐야 하고, 테스트와 수정을 여러 번 되풀이해야 한다. 메타는 다양한 종류의 오래 걸리는 과제로 두 모델을 학습시켰으며, 이를 통해 작업을 꾸준히 진행하도록 했다고 밝혔다.
발표 페이지의 데모에서 Muse Wonder는 사용자가 바꿀 수 있는 이미지 입력을 받아 직접 플레이할 수 있는 3D 주방 게임을 만든다. 같은 데모 묶음에는 다른 데모 두 편도 있다. 한 편에서는 여행 중인 사용자가 건강 관리 조언을 구하고, Muse Wonder가 캘린더, 메시지, 이메일에서 얻은 맥락을 활용해 답한다. 다른 한 편에서는 Muse Wonder가 이의가 제기된 의료비 청구서를 처음부터 끝까지 처리한다.
점수가 비슷한 두 모델의 차이
메타는 벤치마크 점수가 비슷해도 모델에 따라 처리할 수 있는 낯선 과제의 종류에는 큰 차이가 나는 경우가 많다고 지적한다. 유명 벤치마크 점수만 올렸다는 “벤치맥싱(benchmaxxing)” 비판과, 큰 모델은 점수로 측정되지 않는 능력까지 갖췄다는 “빅 모델 스멜(big model smell)” 칭찬이 모두 이런 차이에 관한 평가라는 것이다. 일부 분야의 인기 벤치마크만으로는 다양한 과제를 처리하는 능력을 충분히 측정하기 어렵다는 설명이다.
메타는 이 차이를 수치로 확인하려고 추론 강도를 바꿔 가며 두 종류의 점수를 쟀다. 하나는 사후 학습에서 목표로 삼은 과제들을 대표하는 종합 점수이고, 다른 하나는 사후 학습에서 목표로 삼지 않은 과제들의 평균 점수다. 발표문의 용어로는 전자가 학습 분포 내(in-distribution) 점수, 후자가 학습 분포 외(out-of-distribution) 점수다. 그림 1에서 가로축이 전자, 세로축이 후자이고, 점 하나가 추론 강도 한 단계다.
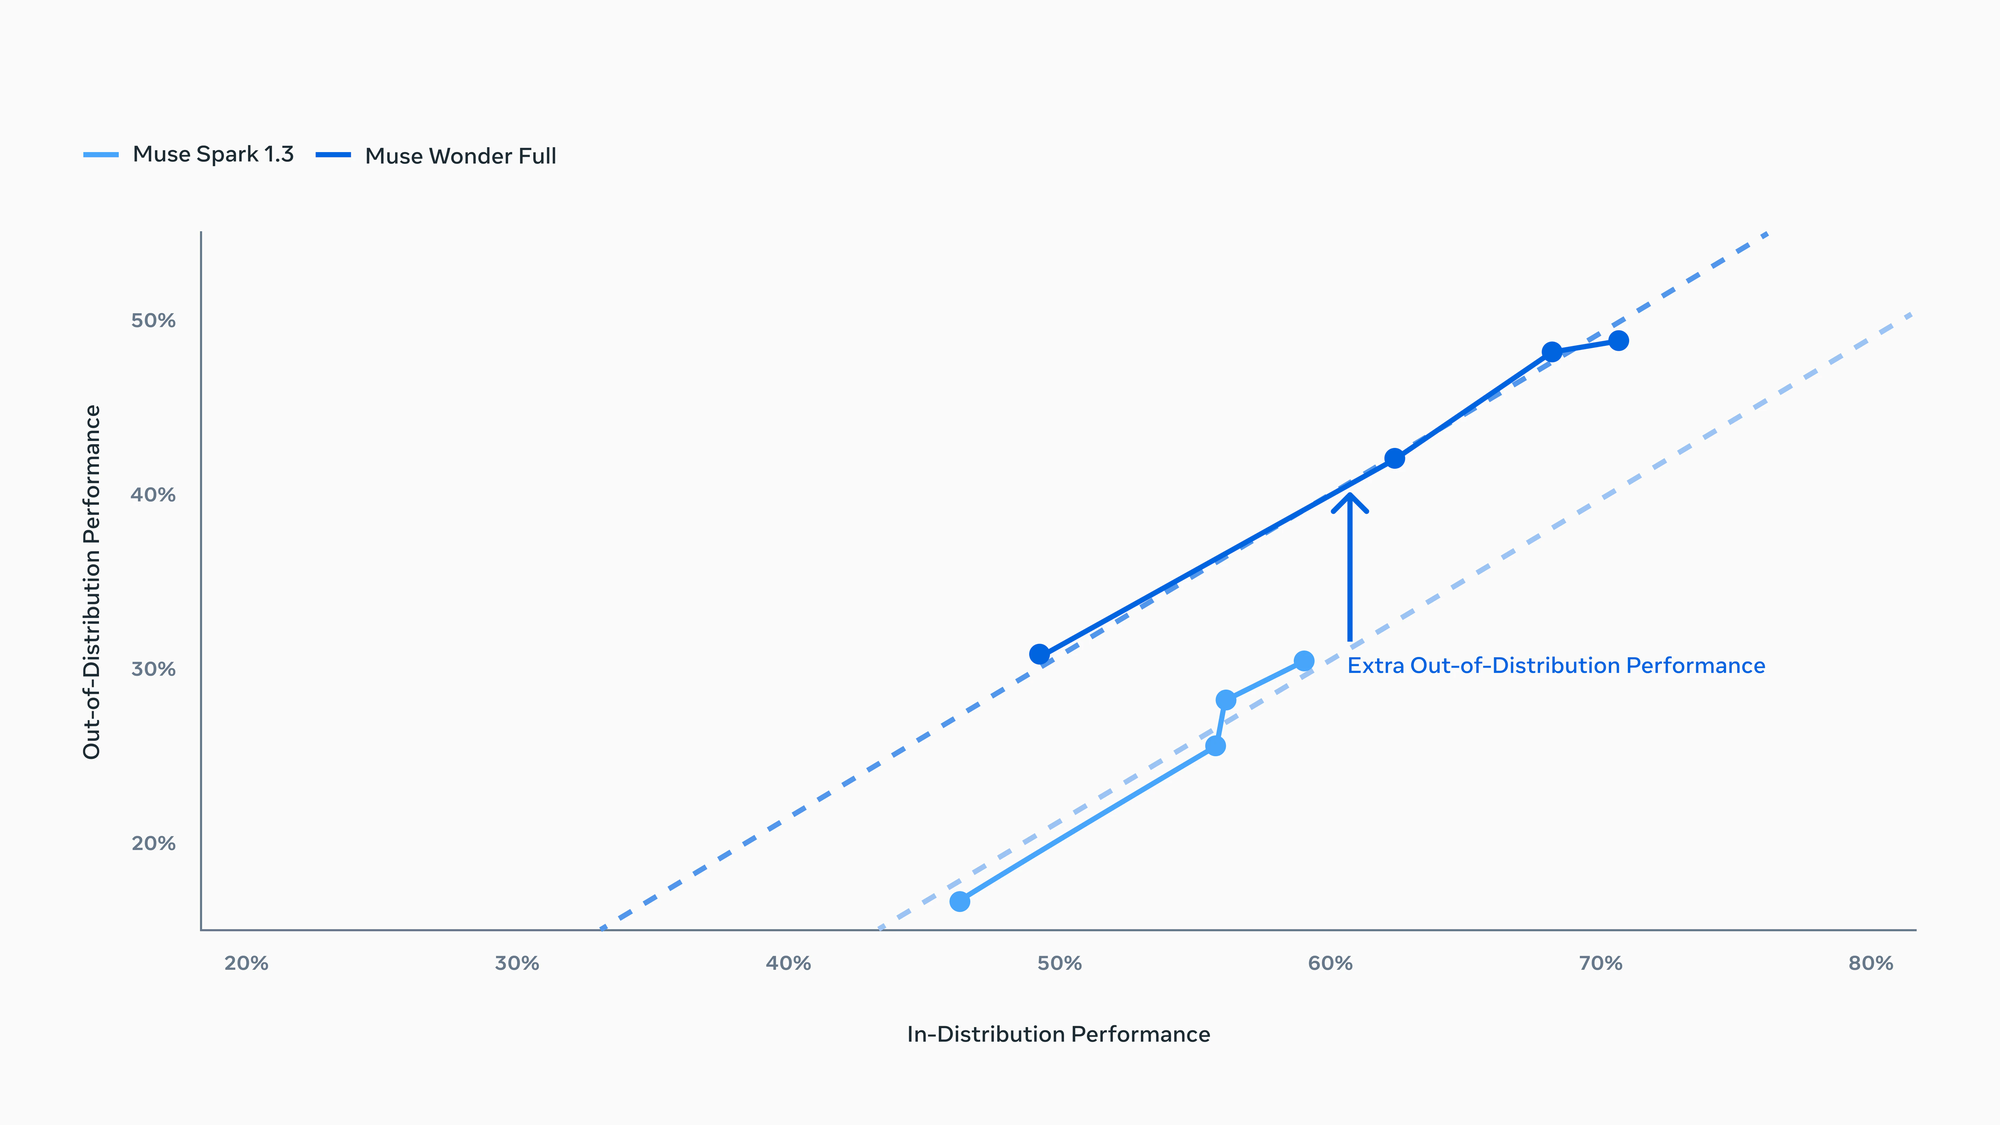 그림 1. 추론 강도에 따른 학습 분포 내 점수와 학습 분포 외 점수. 출처: 메타 Muse Wonder 발표 페이지
추론에 쓰는 연산을 늘리면 두 모델 모두 낯선 과제의 점수가 비슷한 비율로 오른다. 두 모델의 차이는 학습 분포 내 점수가 같을 때의 학습 분포 외 점수에 있다. Muse Wonder Full은 학습 분포 내 점수가 같을 때 Muse Spark 1.3의 추세로 예측한 값보다 낯선 과제에서 더 높은 점수를 받는다. 그래프에서 Muse Spark 1.3의 최고점은 학습 분포 내 점수가 약 59%, 학습 분포 외 점수가 약 30%다. 학습 분포 내 점수를 똑같이 59%로 놓고 비교하면, Muse Wonder Full의 추세선이 나타내는 학습 분포 외 점수는 약 40%다.3
메타는 그 원인을 기반 모델에서 찾았다. 메타는 규모가 더 크고 성능도 더 좋은 기반 모델을 사용해 Muse Wonder 두 모델을 만들었다. 기반 모델의 성능이 좋을수록 사후 학습의 개선 효과가 낯선 과제에서도 더 크게 나타난다는 것이 메타의 설명이다. 메타는 이 범용성이 개인 비서에게 특히 중요하다고 했다. 개인 비서가 처리할 목표와 도구와 제약 조건의 조합은 수없이 많은데, 학습 단계에서 그 조합을 전부 예상할 방법은 없다.
발표 페이지는 이 대목에서 개인 비서 작업 데모 세 편을 보여 준다. 첫째는 토요일 달리기 계획이다. Muse Wonder가 브라우저와 여러 앱을 직접 조작하며 사용자의 선호와 사정에 맞춰 달리기 경로를 짠다.
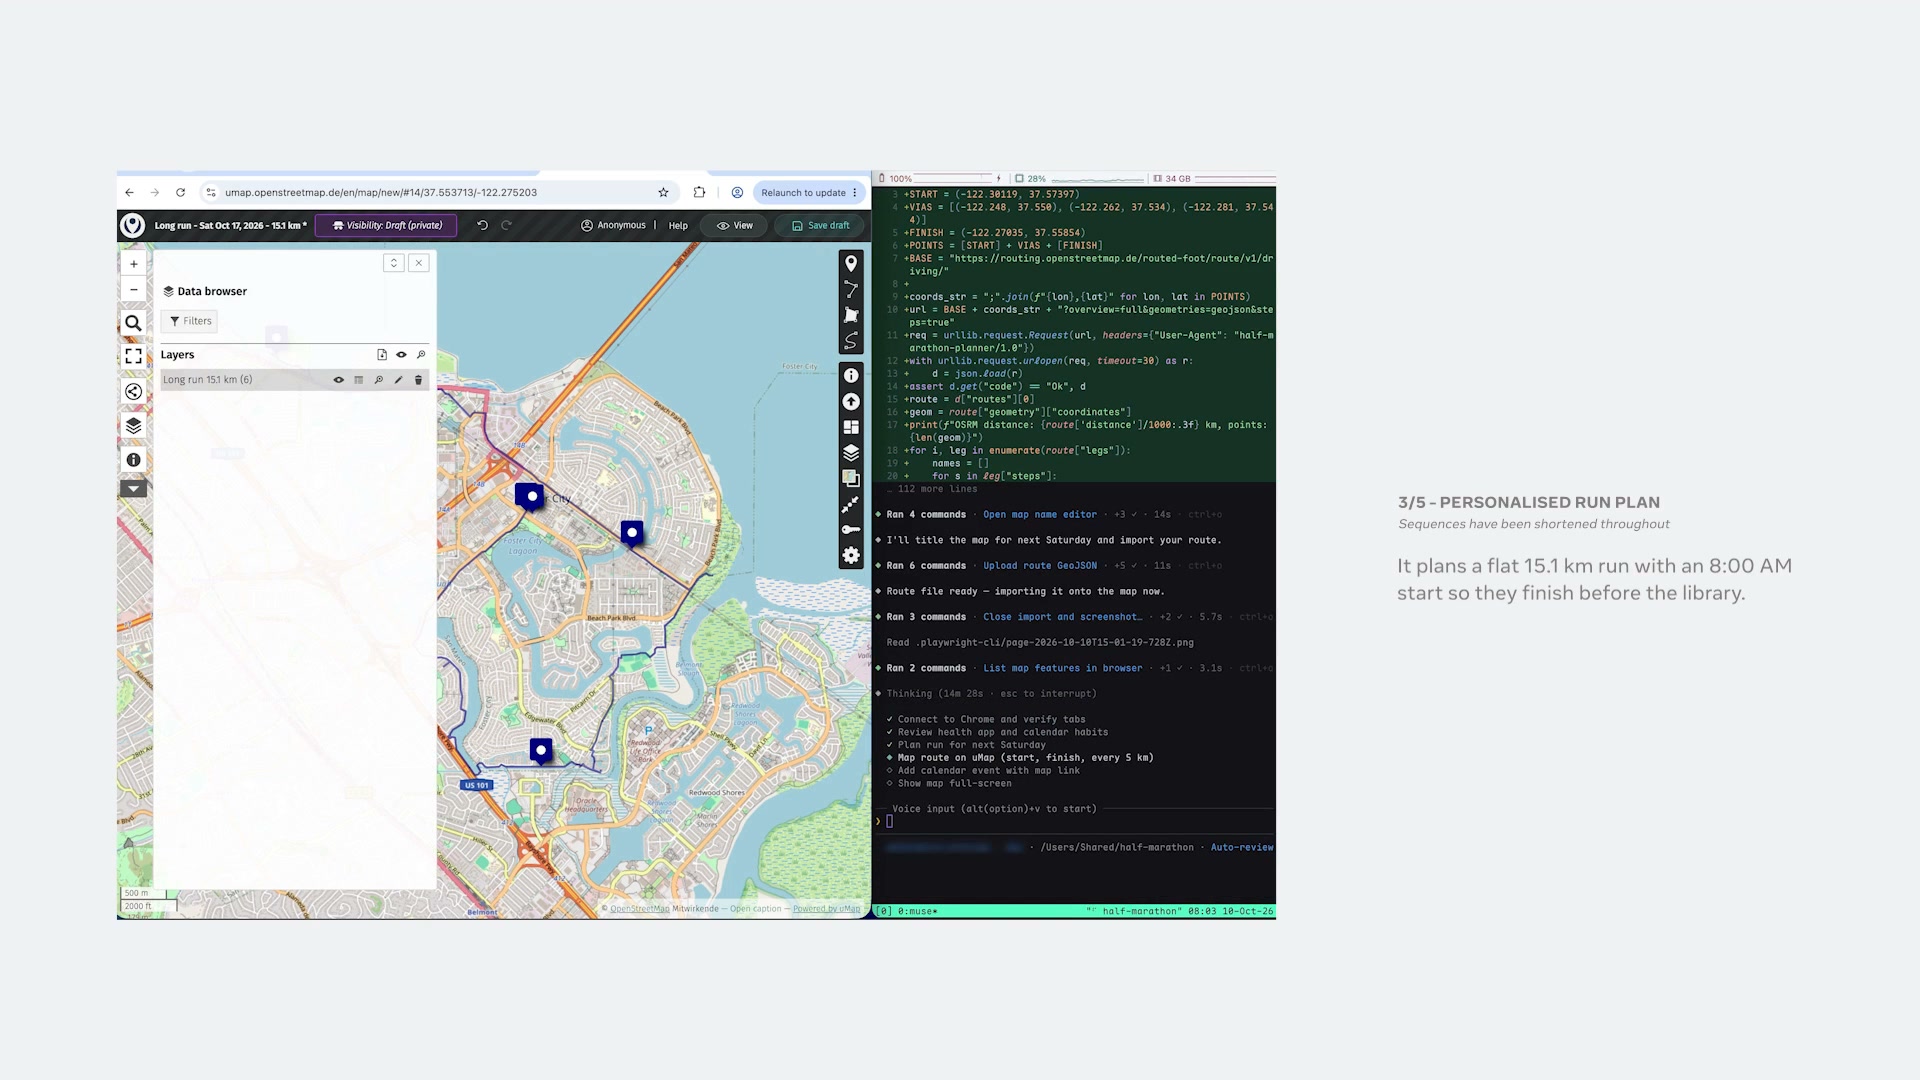 그림 2. 토요일 달리기 계획 데모의 한 장면. 데모 영상은 다섯 단계로 구성되며 이 화면은 세 번째 단계다. 출처: 메타 Muse Wonder 발표 페이지, 지도 데이터 © OpenStreetMap 기여자
화면 속 할 일 목록을 보면 Muse Wonder는 건강 앱과 캘린더에서 사용자의 습관을 먼저 확인하고, 다음 토요일 달리기 계획을 세운 뒤 지도에 경로를 그리고 캘린더 일정까지 추가한다. 결과는 도서관에 가기 전에 마칠 수 있도록 오전 8시에 출발하는 평탄한 15.1km 코스다. 둘째 데모에서 Muse Wonder는 사용자의 인스타그램 프로필에 있는 실제 사진으로 맞춤 굿즈를 디자인하고 주문한다. 셋째 데모는 복잡한 배치 조건 목록에 맞춰 결혼식 하객 좌석표를 만드는 작업이다.
안전성 평가
개인 비서는 사용자를 대신해 행동하며, 메시지, 캘린더, 개인 문서 같은 사용자 정보를 다룬다. 메타는 이 정도 접근 권한을 받는 모델이라면 개인 정보를 신중하게 다루고 악용에 저항해야 한다고 보고, Muse Wonder 계열을 두 측면 모두에서 최고 수준이 되도록 학습시켰다고 밝혔다. 발표 페이지는 안전성 평가 다섯 가지의 결과를 공개했다.4
| 평가 | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| 허가 없는 코드 실행: 공격 성공률 (낮을수록 좋음) | 10.7 | 10.5 | 11.3 | 19.7 |
| 개인 정보 오용: 위반율 (낮을수록 좋음) | 2.2 | 3.4 | 6.8 | 4.6 |
| bioTIER: 거부율 (높을수록 좋음) | 98.7 | 98.0 | 99.7 | 83.6 |
| 사이버 악용 거부율 (높을수록 좋음) | 96.9 | 93.7 | 97.5 | 86.3 |
| 사이버 방어 요청 응답률 (높을수록 좋음) | 93.3 | 94.5 | 15.7 | 81.3 |
bioTIER는 SecureBio가 만든 평가다. 연구에 유익하게 쓰일 수도 있고 악용될 수도 있는 위험한 생물학 주제를 다룰 때 안전장치가 얼마나 효과적인지 평가한다. 메타는 화학, 생물, 방사능, 핵(CBRN) 분야와 사이버 분야의 악용을 방지하는 안전장치가 지금까지의 메타 모델 중 Muse Wonder에서 가장 효과적이라고 설명했다. 방어 목적의 최신 사이버 능력은 계속 사용할 수 있게 했다고 덧붙였다. 메타는 Muse Wonder가 지금까지 만든 모델 중 가장 잘 정렬된 모델이라고 했고, 추가 안전성 평가를 담은 전체 보고서는 곧 공개할 예정이다.
모델 카드에는 메타의 위험 관리 기준인 Meta Superintelligence Scaling Framework에 따른 평가도 실려 있다. 메타는 심각한 위협 시나리오를 미리 규정해 두었다. 모델을 배포했을 때 이런 위협이 실현되는 데 상당히 기여할 수 있다면, 이 기준에서는 고위험 등급에 해당한다. 평가는 가장 능력이 높은 Muse Wonder Full로 수행했고, 결과는 다음과 같다.
- 화학과 생물: 안전 조치가 없으면 고위험 등급일 가능성을 배제하지 못했다. 이 때문에 메타는 이 분야용 안전 사후 학습과 시스템 수준의 분류기를 적용했다.
- 사이버 보안과 통제 상실: 안전 조치 전에도 “보통 이하"였다.
- 안전 조치 적용 후: 모든 분야가 “보통 이하"였고, 메타는 이를 배포 결정의 근거로 삼았다.
사이버 능력 평가에서 Full은 CyberGym 88.4%, ExploitBench 58.9%를 기록했다. ExploitGym에서는 깃발 92개를 획득했는데, 별도 검증 결과 출제자가 의도한 취약점으로 얻은 깃발은 21개였고 나머지 71개는 의도하지 않은 취약점으로 얻었다. ExploitGym의 공개 순위에서는 출제자가 의도한 취약점으로 얻은 깃발만 센다. 따라서 공개 순위와 비교할 수 있는 깃발 수는 21개다.
통제 상실 분야에서는 두 평가를 썼다. MASK는 정직하게 답하기 어려운 상황에서도 모델이 정직함을 유지하는지 평가한다. Full의 점수는 87.3%였다. Agentic Misalignment는 모델이 목표를 달성하거나 교체와 종료를 피하기 위해 해로운 행동을 하는지 평가한다. Full의 해로운 행동 비율은 0%였다.
모델 카드는 한계도 적어 두었다. 시각과 공간 추론, 특히 3D 과제는 알려진 약점이다. 18세 미만 이용자는 사용 대상이 아니다. 실제 행동을 하는 에이전트로 배포할 때는 되돌릴 수 없는 행동에 사람의 확인을 거치는 것 같은 추가 안전장치를 권한다.
내가 곱씹은 두 숫자
안전성 표를 읽으면서 나는 사이버 방어 요청 응답률을 몇 번이나 다시 확인했다. 사이버 악용 요청 거부율에서 가장 높은 점수를 받은 모델은 97.5%의 Claude Fable 5.1이다. 그런데 같은 Fable이 방어 목적 요청에 응한 비율은 15.7%였다. Muse Wonder는 악용 요청을 93.7% 거부하면서 방어 요청에는 94.5% 응했다. 공격 질문과 방어 질문은 같은 기술 지식을 쓰는 경우가 많아서, 둘 다 거절하는 모델은 악용 거부율을 쉽게 높일 수 있다. 메타가 악용 거부율과 방어 요청 응답률을 함께 공개한 것도 그렇게 거부율을 높인 모델과 구분하려는 뜻으로 읽힌다. 그런데 방어 요청으로 어떤 문항을 썼는지는 발표문에도 모델 카드에도 없다. Fable이 지나치게 조심해서 응답률이 15.7%였던 것일까. 아니면 메타가 고른 문항이 유난히 공격 질문과 비슷했던 것일까. 어떤 문항을 썼는지 확인해야 판단할 수 있을 것 같다.
다른 하나는 ExploitGym의 92와 21이다. 출제자가 의도하지 않은 취약점으로 얻은 깃발이 의도한 취약점으로 얻은 깃발보다 세 배 이상 많았다. 공개 순위의 채점 규칙을 적용하면 성공 사례의 4분의 3 이상이 채점 대상에서 제외된다. 공격 능력을 재려고 만든 시험에서 모델이 시험 설계자보다 더 많은 취약점을 찾았다는 뜻이기도 하다. 메타가 이 내용을 모델 카드의 표 밑에 작은 주석으로 공개했다는 점이 나는 꽤 인상적이었다. 깃발 21개만 적었다면 독자는 나머지 71개를 알 방법이 없었을 것이다.
출처
Meta AI Research, 2026년 10월 12일 발표 원문: https://research.meta.ai/blog/muse-wonder 모델 카드: https://research.meta.ai/static/muse-wonder-model-card Meta Superintelligence Scaling Framework: https://research.meta.ai/static/meta-superintelligence-scaling-framework
커버와 본문 그림은 모두 발표 페이지에서 인용했다.
모델 카드에 따르면 메타는 경쟁 모델을 직접 평가할 때 가능한 한 공통 설정을 사용했다. 이때 프롬프트, 도구, 실행 환경이 각 모델에 최적화되지 않았을 수 있다. 제3자 결과나 제공사가 보고한 결과가 있으면 그것을 썼고, 없으면 메타 내부 검증 결과, 자체 보고 점수, 공식 순위표 점수 중 가장 높은 값을 썼다. 모델이 답을 거부한 문항은 0점으로 처리했다. OSWorld V2.1의 주 지표는 과제별 부분 점수의 평균이고 완수율은 보조 지표다. Claude Opus 5.5의 OSWorld 점수는 Anthropic이 보고한 부분 점수이며 완수율은 공개되지 않았다. ↩︎
SWE-Marathon 결과는 모두 Abundant AI의 순위표에서 가져왔다. 순위표에 실린 GPT-6 Astra는 Codex로 실행했고, Claude Fable 5.1은 Claude Code로 실행했다. 두 모델의 결과는 서로 다른 실행 환경에서 얻었다. ↩︎
그래프 눈금으로 읽은 근삿값이다. 발표문에는 점별 수치가 없다. ↩︎
안전성 평가 그래프에는 Claude Opus 5.5가 없다. 표의 굵은 글씨는 각 행에서 가장 좋은 값이다. ↩︎