3줄 요약
- 순환 신경망(RNN)은 메모리 크기가 고정되어 있어 장문 인출 과제에서 성능이 떨어진다. 구글 리서치(Google Research)의 Ali Behrouz 등 연구진이 2026년 2월 arXiv에 공개한 이 논문은 그 한계를 해결하려고 메모리 캐싱(Memory Caching, MC) 기법을 제안했다.
- 입력 시퀀스를 $N$개의 세그먼트로 분할하고, 세그먼트가 끝날 때마다 메모리 상태를 체크포인트로 캐싱한다. 출력을 만들 때는 현재 세그먼트의 온라인 메모리와 과거 캐시 메모리를 게이트 가중합(GRM), 가중치 보간(Memory Soup), 라우터 기반 상위 $k$개 선택(SSC) 방식으로 함께 참조하며, 연산 복잡도는 $\mathcal{O}(NL)$로 조절된다.
- 7억 6,000만 파라미터와 13억 파라미터 규모 실험에서 MC를 적용한 SWLA, DLA, Titans는 언어 모델링, 상식 추론, NIAH, LongBench, 문맥 내 인출에서 기본 순환 모델과 로그 분할 기준선(Log-Linear++)보다 높은 평균 성적을 냈다. 특히 SSC 변형은 32K 장문 학습에서 트랜스포머보다 높은 처리량을 유지하면서 트랜스포머와의 인출 정확도 차이를 줄였다.
고정 크기 메모리와 이차 복잡도 사이의 절충
트랜스포머(Transformer)가 다양한 시퀀스 모델링 과제에서 높은 성능을 내는 핵심 요인은 문맥 길이에 비례해 커지는 메모리 용량이다. 어텐션(Attention) 모듈은 과거의 모든 토큰을 키(Key)와 값(Value) 캐시로 보존하고 직접 조회하므로 정보를 정확히 인출할 수 있다. 그러나 시퀀스 길이 $L$에 대해 연산량이 $\mathcal{O}(L^2)$으로 증가하고 추론 시 KV 캐시 메모리 사용량이 커진다는 단점이 있다.
어텐션의 대안으로 연구된 선형 어텐션(Linear Attention)과 최신 순환 신경망들은 과거 데이터를 고정된 크기의 메모리 상태(은닉 상태)로 압축해 시퀀스 전체에서 $\mathcal{O}(L)$ 복잡도를 유지한다.1 이러한 순환 아키텍처는 짧은 문맥의 언어 모델링이나 비디오 처리에서는 준수한 성적을 낸다. 하지만 시퀀스가 길어지면 고정된 용량에 새로운 정보를 계속 압축해야 해서 과거 정보를 잊어버리는 메모리 과부하(memory overflow)가 생기고, 문맥 내 인출(in-context recall)이나 장문 이해 과제에서 트랜스포머보다 성능이 낮아진다.
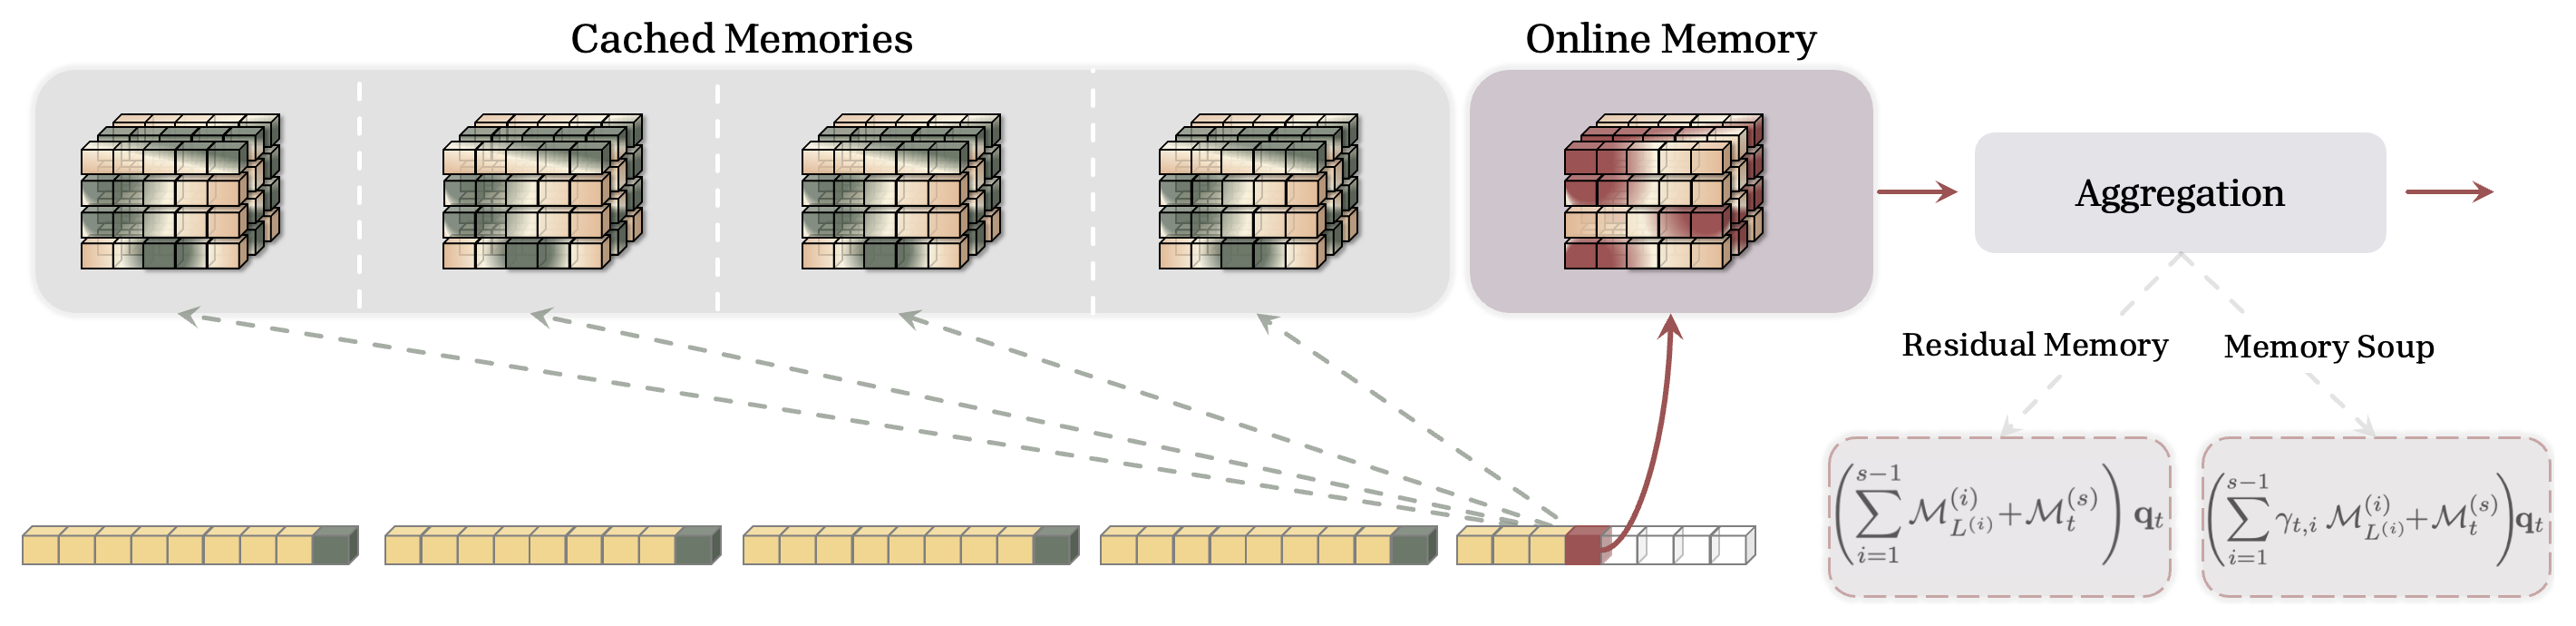
연구진은 Miras 프레임워크를 바탕으로 이 문제를 다룬다.2 Miras는 시퀀스 모델의 갱신 규칙을 순전파 도중에 키와 값의 대응 관계를 학습하는 온라인 최적화(Test-time Memorization) 과정으로 해석한다. 시점 $t$의 연상 메모리 $\mathcal{M}_t$는 내부 목적함수(어텐션 편향) $\mathcal{L}(\mathcal{M}(\mathbf{k}_t); \mathbf{v}_t)$와 이전 상태 유지 항 $\texttt{Ret}(\mathcal{M}; \mathcal{M}_{t-1})$의 합을 최소화하며 갱신된다. 표지 그림(원문 Figure 1)에 나타난 메모리 캐싱(MC)은 이 최적화 과정에서 일정 구간마다 메모리의 체크포인트를 캐시로 남겨 두는 기법이다.
| 아키텍처 분류 | 세그먼트 수 ($N$) | 세그먼트당 길이 | 과거 정보 보존 방식 | 시퀀스당 연산 복잡도 |
|---|---|---|---|---|
| 표준 순환 신경망 (RNN) | $1$ | $L$ | 단일 온라인 메모리에 전체 압축 | $\mathcal{O}(L)$ |
| 메모리 캐싱 (MC, 균일 분할) | $N = L/C$ | $C \ge 2$ | 세그먼트별 마지막 메모리 상태 캐싱 | $\mathcal{O}(NL) = \mathcal{O}(L^2 / C)$ |
| 메모리 캐싱 (MC, 로그 분할) | $\le \log_2 L$ | $2$의 거듭제곱 | 이진 분해 세그먼트별 상태 캐싱 | $\mathcal{O}(L \log L)$ |
| 메모리 캐싱 (MC, 희소 선택 SSC) | $N$ 중 $k$개 활성 | $C$ | 라우터가 선택한 상위 $k$개 캐시만 인출 | $\mathcal{O}(kL)$ |
| 표준 트랜스포머 (Attention) | $L$ | $1$ | 모든 개별 토큰의 KV 직접 캐싱 | $\mathcal{O}(L^2)$ |
메모리 캐싱은 길이가 $L$인 입력 시퀀스 $x \in \mathbb{R}^{L \times d_{\text{in}}}$를 $N$개의 세그먼트 $S^{(1)}, \dots, S^{(N)}$으로 분할한다. 각 세그먼트의 길이는 $L^{(1)}, \dots, L^{(N)}$이다. 세그먼트 $s$ 내부에서는 기존 순환 모델과 동일하게 $\mathcal{M}^{(s)}_t = f(\mathcal{M}^{(s)}_{t-1}; \mathbf{k}_t, \mathbf{v}_t)$ 규칙으로 메모리를 갱신하고, 세그먼트의 마지막 상태인 $\mathcal{M}^{(s)}_{L^{(s)}}$를 캐시에 저장한다.
표준 RNN은 현재 시점의 메모리 상태 하나만으로 출력 $\mathbf{y}_t = \mathcal{M}_t(\mathbf{q}_t)$를 계산한다. MC는 여기에 이전 세그먼트들이 끝날 때 저장한 캐시 메모리 $\{\mathcal{M}^{(1)}_{L^{(1)}}, \dots, \mathcal{M}^{(s-1)}_{L^{(s-1)}}\}$를 더한다. 현재 세그먼트 $s$에서 갱신 중인 온라인 메모리 $\mathcal{M}^{(s)}_t$와 과거 캐시 메모리를 집계 함수 $\texttt{Agg}$로 함께 참조해 질의 $\mathbf{q}_t$에 대한 출력을 계산한다. 메모리 갱신 비용은 세그먼트 길이의 합에 비례하므로 여전히 $\mathcal{O}(L)$이다. 하지만 인출할 때는 토큰마다 $N$개의 메모리에 순전파를 수행해야 해서 전체 복잡도가 $\mathcal{O}(NL)$이 된다. 세그먼트 수 $N$은 두 아키텍처 사이를 잇는 매개변수가 되어, 시퀀스 전체를 세그먼트 하나로 두면($N=1$) 표준 RNN으로 환원되고 토큰마다 길이 1인 세그먼트를 할당하면($N=L$) 모든 과거 토큰 상태를 개별 캐싱하는 어텐션이 된다.
과거 메모리를 결합하는 네 가지 변형
연구진은 과거 캐시 메모리와 현재 온라인 메모리를 결합하는 $\texttt{Agg}$ 연산자를 네 가지로 설계했다. 잔차 메모리(RM), 게이트 잔차 메모리(GRM), 메모리 수프(Memory Soup), 희소 선택적 캐싱(SSC)이다.
| 변형 기법 | 출력 및 파라미터 계산 방식 | 선형 메모리에서의 특성 | 심층(MLP) 메모리에서의 특성 | 토큰당 참조 메모리 수 |
|---|---|---|---|---|
| Residual Memory (RM) | 온라인 출력 + 전체 캐시 출력 단순 합산 | 사전 합산 가능 (수식상 고정 크기 메모리로 축약) | 비선형 출력들의 등가중 앙상블 | $s$개 전체 |
| Gated Residual Memory (GRM) | 문맥 유사도 게이트 $\gamma_t^{(i)}$로 출력 가중합 | 토큰별 게이트 변화로 고정 메모리에 축약되지 않음 | 비선형 메모리 출력들의 문맥 가중 앙상블 | $s$개 전체 |
| Memory Soup | 게이트 $\gamma_t^{(i)}$로 메모리 가중치 자체를 보간 후 단일 질의 | 선형성에 의해 GRM과 수식상 완전히 동일 | 파라미터 보간으로 시점별 비선형 인출 함수 생성 | 합산된 단일 메모리 1개 (보간 대상 $s$개) |
| Sparse Selective (SSC) | 라우터가 선택한 상위 $k$개 캐시와 온라인 메모리만 가중합 | 선택된 $k+1$개 선형 메모리만 활성화 | 거대 통합 메모리 중 일부 블록만 희소 읽기 수행 | $k + 1$개 ($k \ll s$) |
가장 단순한 잔차 메모리(Residual Memory, RM)는 온라인 메모리 출력과 과거 캐시 메모리 출력을 단순 합산한 $\mathbf{y}_t = \mathcal{M}^{(s)}_t(\mathbf{q}_t) + \sum_{i=1}^{s-1} \mathcal{M}^{(i)}_{L^{(i)}}(\mathbf{q}_t)$를 사용한다. 메모리 $\mathcal{M}$이 선형 행렬이면 분배법칙에 의해 $\bigl(\mathcal{M}^{(s)}_t + \sum_{i=1}^{s-1} \mathcal{M}^{(i)}_{L^{(i)}}\bigr)\mathbf{q}_t$로 묶이므로 과거 캐시를 미리 더한 고정 크기 메모리와 수식상 같다. 이전 체크포인트들을 더해 주면 먼 과거 정보를 유지하는 연산자(retention) 효과가 생기므로, 실험에서는 단순 합산만으로도 기본 순환 모델보다 성적이 올랐다. 그러나 질의 $\mathbf{q}_t$와 관련이 있든 없든 모든 과거 세그먼트를 같은 비중으로 더한다는 한계가 있다.
이 한계를 보완하는 게이트 잔차 메모리(Gated Residual Memory, GRM)는 각 세그먼트 메모리 출력에 문맥 의존 게이트 가중치 $\gamma_t^{(i)} \in [0, 1]$를 곱해 합산한다.
$$\mathbf{y}_t = \gamma_t^{(s)} \mathcal{M}^{(s)}_t(\mathbf{q}_t) + \sum_{i=1}^{s-1} \gamma_t^{(i)} \mathcal{M}^{(i)}_{L^{(i)}}(\mathbf{q}_t)$$$$\gamma_t^{(i)} = \operatorname{softmax}_i\bigl(\langle \mathbf{u}_t, \texttt{MeanPooling}(S^{(i)}) \rangle\bigr)$$$\gamma_t^{(i)}$를 현재 입력 $x_t$만 투영해 정의하면 세그먼트 내용과 무관하게 순서에 따라서만 비중이 정해진다. 연구진은 입력을 투영한 연결자 벡터 $\mathbf{u}_t = x_t W_{\mathbf{u}}$와 $i$번째 세그먼트의 평균 표현을 내적해 게이트 점수를 구하고 소프트맥스를 취했다.3 가중치 $\gamma_t^{(i)}$가 시점별 입력에 따라 달라지므로 선형 메모리라도 과거 캐시를 미리 합쳐 둘 수 없고, 유효 메모리 용량이 세그먼트 수에 비례해 늘어난다.
메모리 수프(Memory Soup)는 모델 가중치를 평균 내어 성능을 높이는 모델 수프(Model Soups) 기법에서 착안했다. 각 세그먼트의 캐시 메모리를 출력 단계에서 합치지 않고, 메모리 모듈의 가중치 파라미터 $\bm{\theta}_{\mathcal{M}^{(i)}} = \{W^{(i)}_1, \dots, W^{(i)}_c\}$ 자체를 게이트 가중치 $\gamma_t^{(i)}$로 선형 결합한다. 이렇게 시점 $t$ 전용 메모리 $\mathcal{M}^*_t$를 즉석에서 구성하고, 질의 $\mathbf{q}_t$는 이 메모리에 한 번만 입력한다.
$$\bm{\theta}_{\mathcal{M}^*_t} = \left\{ \sum_{i=1}^{s} \gamma_t^{(i)} W^{(i)}_1, \dots, \sum_{i=1}^{s} \gamma_t^{(i)} W^{(i)}_c \right\}, \qquad \mathbf{y}_t = \mathcal{M}^*_t(\mathbf{q}_t)$$메모리 모듈이 단층 선형 행렬이면, 가중치를 먼저 평균 내고 질의를 곱하든 메모리마다 질의를 곱한 뒤 출력을 가중 평균 내든 선형성에 의해 결과가 같다. 따라서 이 경우 Memory Soup와 GRM은 같은 수식이 된다. 메모리 모듈을 다층 퍼셉트론(MLP) 같은 비선형 심층 신경망으로 바꾸면 이 동치 관계는 성립하지 않는다. Memory Soup는 파라미터 공간에서 보간을 수행해 해당 시점의 토큰에 특화된 새로운 비선형 인출 함수를 만들어 낸다.
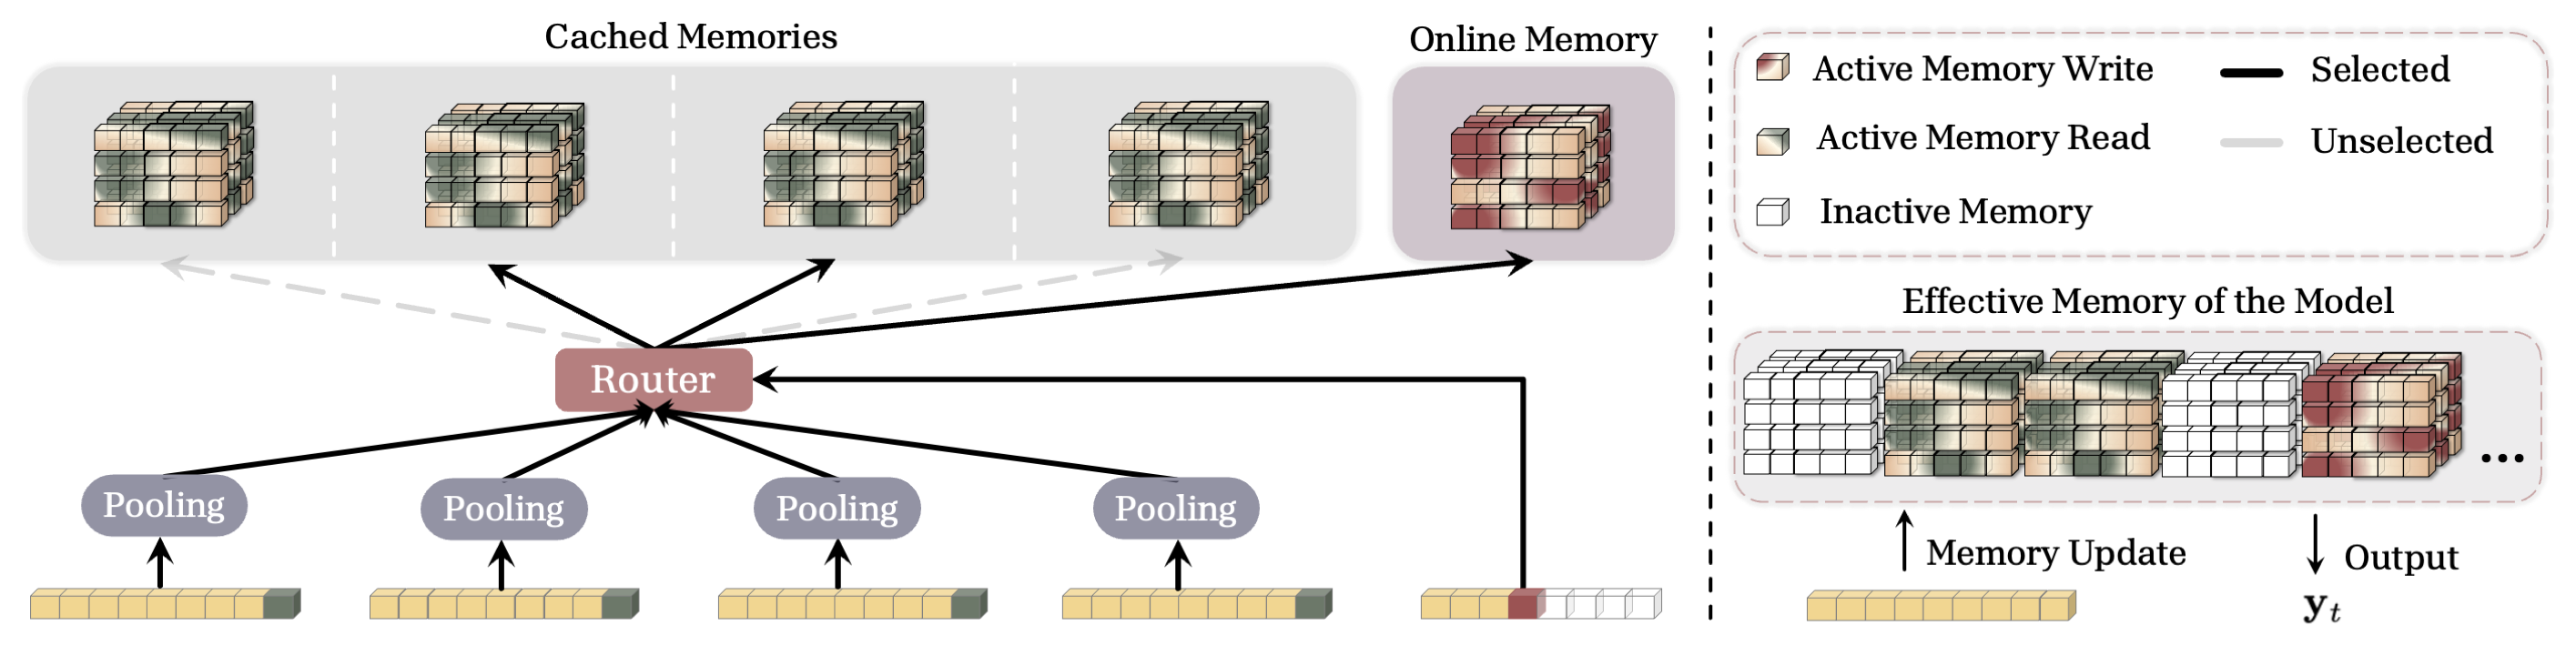 원문 Figure 2: 희소 선택적 캐싱(SSC). 왼쪽은 라우터가 각 세그먼트의 풀링된 문맥과 현재 토큰의 유사도를 재어 일부 캐시 메모리만 선택하는 과정이다. 오른쪽은 같은 구조를 하나의 거대한 희소 통합 메모리로 해석한 도식으로, 토큰마다 쓰기 블록과 읽기 블록의 일부만 활성화된다. 출처: arXiv:2602.24281
초장문 시퀀스에서 과거 캐시 메모리를 모두 참조하면 연산량과 메모리 대역폭 부담이 커진다. 희소 선택적 캐싱(Sparse Selective Caching, SSC)은 이를 줄이려고 전문가 혼합(MoE) 방식의 라우터를 도입한다(원문 Figure 2). 균일 길이 세그먼트 $S^{(i)}$의 문맥 요약으로 상수 나눗셈을 생략한 키 벡터 합 $\texttt{MeanPooling}(S^{(i)}) = \sum_{j \in S^{(i)}} \mathbf{k}_j$를 미리 계산해 두고, 현재 토큰의 연결자 벡터 $\mathbf{u}_t = x_t W_{\mathbf{u}}$와 내적해 관련도 점수 $\mathbf{r}_t^{(i)}$를 구한다. 라우터는 이전 세그먼트들 가운데 점수 상위 $k$개의 집합 $\mathcal{R}_t = \arg\texttt{Top-k}(\{\mathbf{r}_t^{(i)}\}_{i=1}^{s-1})$만 고르고, 출력은 이 캐시들과 온라인 메모리로만 계산한다.
$$\mathbf{y}_t = \gamma_t^{(s)} \mathcal{M}^{(s)}_t(\mathbf{q}_t) + \sum_{i \in \mathcal{R}_t} \gamma_t^{(i)} \mathcal{M}^{(i)}_{L^{(i)}}(\mathbf{q}_t)$$세그먼트별 문맥 요약 값은 세그먼트가 끝날 때 한 번만 계산해 두면 되므로, 각 토큰에서 관련도 점수를 구하고 상위 $k$개를 고르는 연산은 쉽게 병렬화된다. 선택된 $k$개의 메모리 상태만 불러오면 되므로 비활성 캐시 메모리를 GPU나 TPU 같은 가속기 메모리에 상주시킬 필요가 없고, 학습과 추론 모두에서 메모리 소비가 줄어든다.
새 세그먼트의 초기 메모리 상태 $\mathcal{M}^{(s)}_0$는 두 가지로 정할 수 있다(원문 3.4절). 첫째는 체크포인트(Checkpoint) 설계로, $\mathcal{M}^{(s)}_0 = \mathcal{M}^{(s-1)}_{L^{(s-1)}}$로 두어 이전 세그먼트의 마지막 상태에서 학습을 이어 간다. 둘째는 독립 압축기(Independent Compressors, Restart) 설계다. 세그먼트 간 정보 간섭을 막기 위해 세그먼트마다 이전 세그먼트와 무관한 초기 상태 $\mathcal{M}^{(s)}_0$에서 새로 시작하고, 그 세그먼트 내부의 정보만 압축한다.
선형 및 심층 메모리에서의 수식적 의미와 세그먼트 분할
연구진은 원문 4장에서 메모리 캐싱이 기존 어텐션 및 하이브리드 아키텍처와 어떻게 연결되는지 수식으로 보였다. 먼저 세그먼트 길이를 1로 둔다($L^{(i)}=1$). 값(Value) 투영 없이 키만 더하는 가장 단순한 벡터 순환 메모리 $\mathcal{M}^{(t)}_1 = \mathbf{b}_{\mathbf{K}} + x_t \mathbf{W}_{\mathbf{K}}$에 GRM을 적용하면 다음 출력식이 유도된다.4
$$\mathbf{y}_t = \left( \sum_{i=1}^{t} \frac{\exp(\mathbf{u}_t^\top \mathbf{k}_i)}{\sum_{\ell=1}^{t} \exp(\mathbf{u}_t^\top \mathbf{k}_\ell)} \mathbf{v}_i' \right) \otimes \sigma(x_t \mathbf{W}_{\mathbf{Q}})$$여기서 $\mathbf{v}_i' = \mathcal{M}^{(i)}_1$로 재매개변수화하면, 이 식은 어텐션 출력에 입력을 선형 투영한 게이트를 곱하는 게이트 전역 소프트맥스 어텐션(gated global softmax attention) 블록과 정확히 일치한다. 곧 표준 소프트맥스 어텐션은 가장 단순한 형태의 메모리 캐싱에서 세그먼트 길이를 1로 둔 특수 사례에 해당한다.
| 메모리 구조 및 설정 | 세그먼트 길이 ($L^{(i)}$) | 캐시 상태의 형태 | 대응하는 기존 아키텍처 및 수식적 의미 |
|---|---|---|---|
| 값 없는 벡터 순환 + GRM | $1$ | 개별 토큰 벡터 $\mathcal{M}^{(i)}_1 \in \mathbb{R}^{d}$ | 게이트 전역 소프트맥스 어텐션과 수식상 동치 |
| 질의 없는 벡터 순환 + GRM | $1$ (체크포인트) | 누적 압축 벡터 $\mathcal{M}_i \in \mathbb{R}^{d}$ | 벡터 순환 층 뒤에 전역 어텐션 층을 배치한 2층 하이브리드와 동치 |
| 일반 선형 행렬 + GRM | $C \ge 1$ | 선형 행렬 $\mathcal{M}^{(i)}_{L^{(i)}} \in \mathbb{R}^{d \times d}$ | 현재 질의 $\mathbf{q}_t$에 조건화된 동적 표현열 $\{\mathcal{M}^{(i)}(\mathbf{q}_t)\}$에 대한 어텐션 |
| 심층 신경망(MLP) + GRM/Soup | $C \ge 1$ | 신경망 가중치 텐서 $\bm{\theta}_{\mathcal{M}^{(i)}}$ | 질의마다 비선형 함수가 달라지는 메타 학습 캐시 (하이브리드로 환원 불가) |
최근 많이 쓰이는 순환 모듈과 전역 어텐션의 하이브리드 모델도 MC로 설명할 수 있다. 벡터 순환 층 뒤에 전역 어텐션 층을 배치한 2층 하이브리드 구조가 그 예다. 순환 층이 질의 게이팅 없이 압축만 수행하면($\mathbf{q}_t = \mathbf{1}$, 출력 $\mathbf{y}_t = \mathcal{M}_t$), 이 구조는 세그먼트 길이를 1로 두고 독립 압축기 대신 메모리 체크포인트를 캐싱하는 MC와 수식상 동치다. 일반 질의 $\mathbf{q}_t = x_t \mathbf{W}_{\mathbf{Q}}$를 쓰면 하이브리드 모델과 차이가 생긴다. 하이브리드 모델은 이전 층이 출력한 고정 시퀀스 $\mathbf{y}_{1:t}$에 어텐션을 수행하지만, MC는 각 세그먼트 메모리가 현재 질의 $\mathbf{q}_t$로 즉석에서 생성한 표현열 $\{\mathcal{M}^{(i)}_{L^{(i)}}(\mathbf{q}_t)\}_{i=1}^{s}$에 어텐션을 수행한다.
메모리 모듈을 2층 MLP 같은 심층 메모리(Deep Memory)로 확장하면 기존 하이브리드 모델에는 없는 특성이 생긴다. 세그먼트 길이가 1이더라도 각 토큰의 메모리 상태 $\mathcal{M}^{(t)}_1 = \mathcal{M}^{(t)}_0 - \eta_t \nabla \mathcal{L}(\mathcal{M}^{(t)}_0; \mathbf{k}_t, \mathbf{v}_t)$는 고정된 벡터 대신 신경망 가중치 텐서가 된다. 따라서 같은 과거 토큰 $x_i$라도 현재 들어오는 질의 $\mathbf{q}_t$가 무엇이냐에 따라 비선형 함수를 통과한 문맥 표현 $\mathcal{M}^{(i)}_1(\mathbf{q}_t)$가 달라진다. 일반 지식을 담는 초기 상태 $\mathcal{M}^{(i)}_0$ 역시 신경망이므로 질의마다 다른 영향을 미친다.
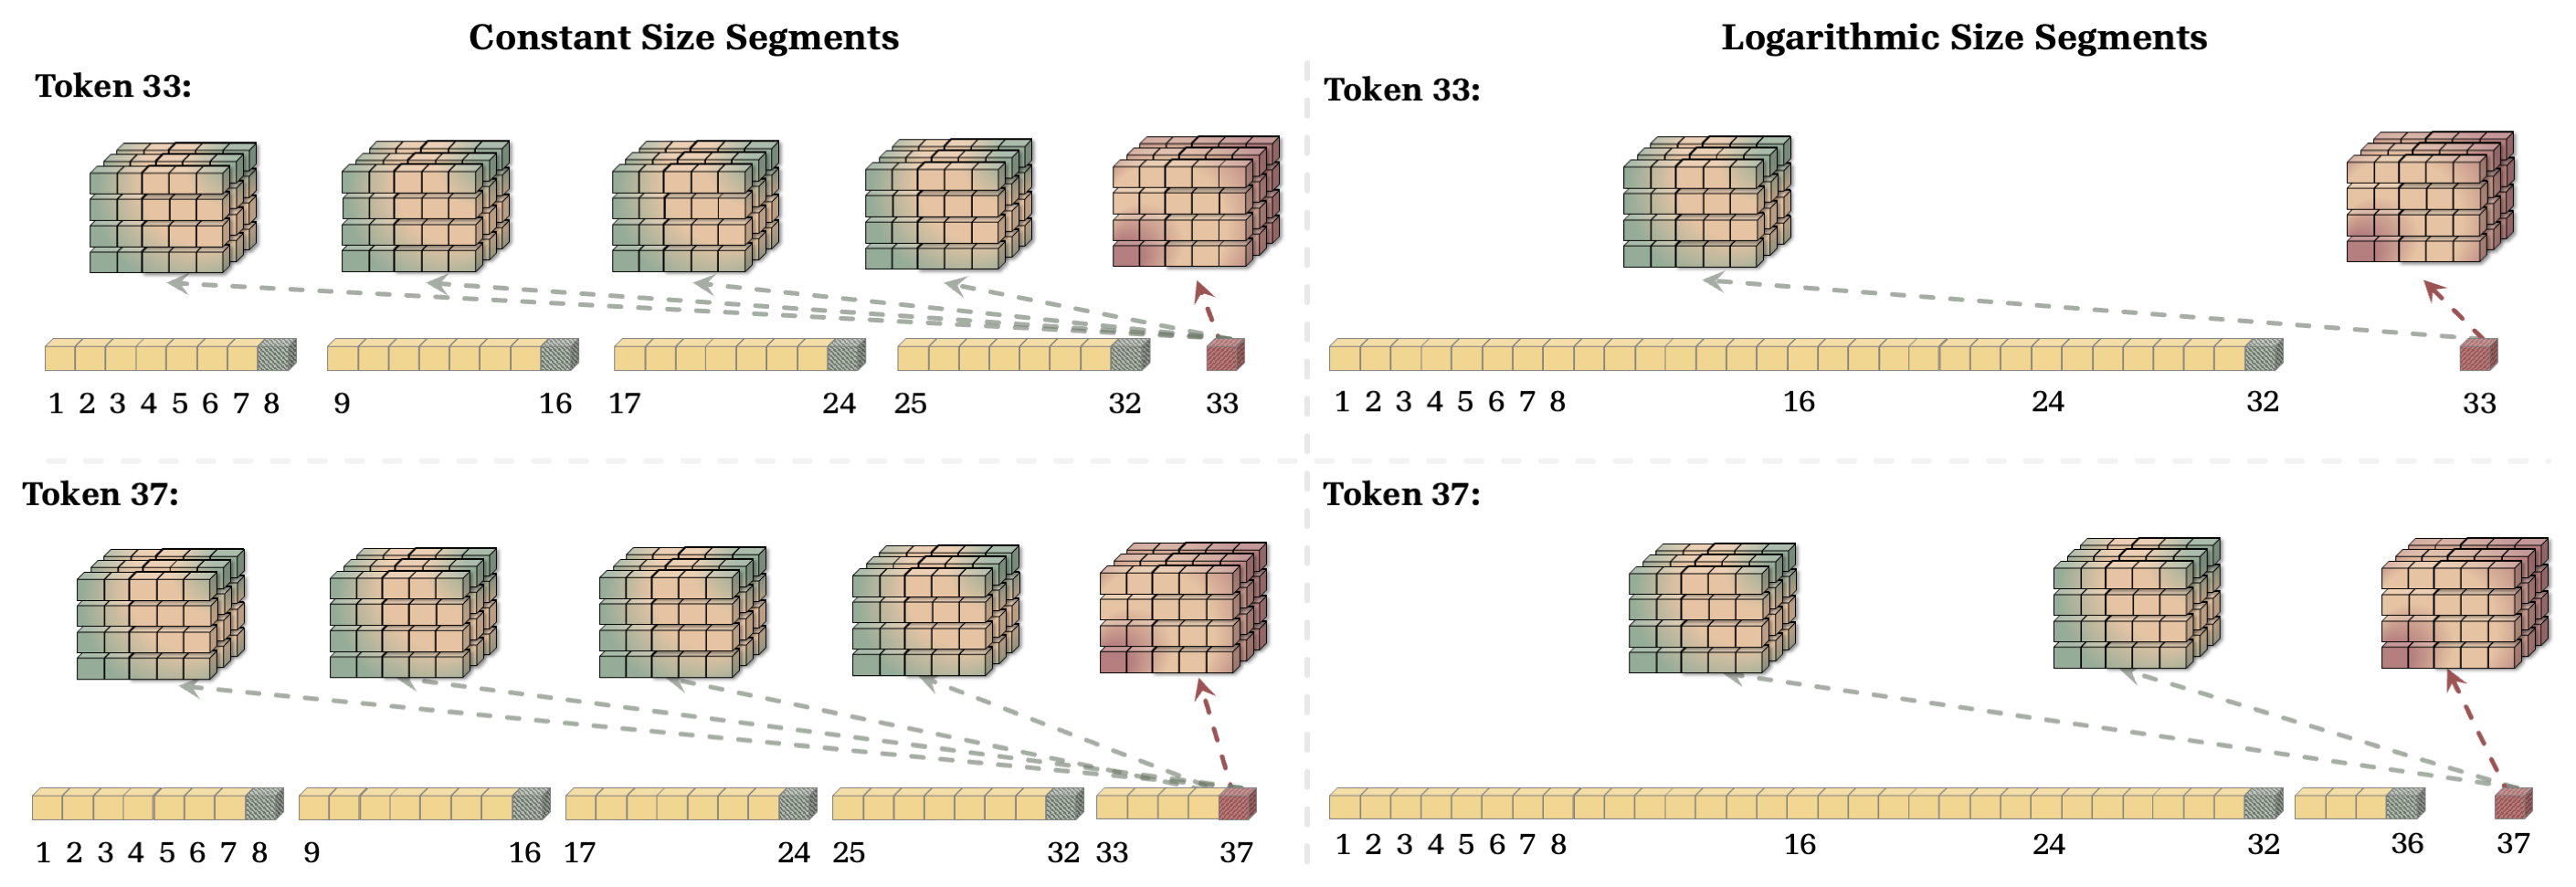 원문 Figure 3: 균일 크기(Constant Size) 세그먼트 분할과 로그 크기(Logarithmic Size) 세그먼트 분할 비교. 시퀀스 길이가 33일 때와 37일 때 각 토큰이 참조하는 캐시 메모리 구성을 보여 준다. 출처: arXiv:2602.24281
시퀀스를 어떻게 분할할 것인가도 압축률과 연산량의 상충 관계를 결정한다(원문 Figure 3). 메모리 1회 순전파 비용을 $p$라 하자. 세그먼트 길이를 모두 $C = L/N \ge 2$로 같게 두는 균일 분할(Constant-size segmentation)은 전체 연산량이 $\mathcal{O}(p L^2 / C)$이므로 트랜스포머보다 상수 인자 $C$만큼 효율적이다. 이와 달리 로그 분할(Logarithmic segmentation)은 시퀀스 길이 $L$을 이진수로 나타내 2의 거듭제곱 단위로 분할한다. 예를 들어 $L = 37$은 이진수로 $100101$이므로 길이가 $32, 4, 1$인 세그먼트 세 개만 유지한다. 따라서 캐시 개수는 최대 $\log_2 L$개로 제한되고, 연산 복잡도는 $\mathcal{O}(p L \log L)$로 줄어든다.
그러나 원문 Figure 3 오른쪽에서 보듯 로그 분할에는 구조적 약점이 두 가지 있다. 첫째, 오래된 과거 구간(예: 16K 시퀀스의 앞쪽 8K 토큰)은 메모리 하나에 한꺼번에 압축되므로 메모리 과부하가 일어나 세부 정보를 잃기 쉽다. 둘째, 최근 구간(길이 1, 2, 4 등)은 세그먼트가 너무 짧아서 내부 최적화 루프가 메모리를 충분히 학습시키기 전에 끝난다. 최근 제안된 Fenwick 트리 기반의 Log-Linear Attention에는 순서 편향과 문맥 비의존성 문제도 있다. 연구진은 공정한 비교를 위해 여기에 GRM의 문맥 의존 게이팅을 결합하고 세그먼트 구성만 로그 분할로 맞춘 개선 기준선 Log-Linear++를 구현해 비교 대상으로 삼았다.5
언어 모델링, NIAH, 문맥 내 인출, LongBench 실험 결과
연구진은 슬라이딩 윈도우 선형 어텐션(Sliding Window Linear Attention, SWLA), 심층 선형 어텐션(Deep Linear Attention, DLA), 그리고 Titans의 장기 메모리 모듈(Long-term Memory Module, LMM) 세 가지 순환 백본에 메모리 캐싱을 적용해 성능을 검증했다. 심층 메모리 모듈은 기본적으로 확장 계수 4와 GELU 활성화 함수를 쓰는 2층 MLP로 구성했다.6
| 적용 백본 | 메모리 모듈 구조 | 내부 목적함수 ($\mathcal{L}$) | 세그먼트 내 메모리 갱신 규칙 |
|---|---|---|---|
| SWLA | 선형 행렬 $(\mathbb{R}^{d \times d})$ | 헵 규칙 (내적) | 직전 $c=2$개 토큰의 키-값 외적을 가중 합산 ($\alpha_t \mathcal{M}_{t-1} + \beta_t \mathbf{v}_{t-1}\mathbf{k}_{t-1}^\top + \lambda_t \mathbf{v}_t \mathbf{k}_t^\top$) |
| DLA | 심층 신경망 (2층 MLP) | 내적 손실 $-\langle \mathcal{M}(\mathbf{k}_t), \mathbf{v}_t \rangle$ | 목적함수에 대한 1차 경사하강법 갱신 ($\mathcal{M}_{t-1} - \eta_t \nabla \mathcal{L}$) |
| Titans (LMM) | 심층 신경망 (2층 MLP) | $L_2$ 회귀 손실 $\|\mathcal{M}(\mathbf{k}_t) - \mathbf{v}_t\|_2^2$ | 가중치 감쇠($\alpha_t$)와 모멘텀($\mathcal{S}_t$)을 결합한 경사하강법 갱신 |
언어 모델링과 상식 추론 실험(원문 Table 1)에서는 FineWeb 데이터셋에서 추출한 300억(30B) 토큰으로 학습한 7억 6,000만(760M) 파라미터 모델과, 1,000억(100B) 토큰으로 학습한 13억(1.3B) 파라미터 모델을 평가했다. 기본 학습 문맥 길이는 4K, 균일 세그먼트 길이는 256이다. 표에서 Wiki.는 Wikitext, LMB.는 LAMBADA, Hella.는 HellaSwag, Wino.는 Winogrande를 가리키며, 슬래시(/)로 묶인 행은 변형 기법 열에 적힌 순서대로 각 모델의 수치를 나타낸다.
| 모델 규모 및 백본 | 변형 기법 | Wiki. (ppl ↓) | LMB. (ppl ↓) | LMB. (acc ↑) | PIQA (acc ↑) | Hella. (acc_n ↑) | Wino. (acc ↑) | ARC-e (acc ↑) | ARC-c (acc_n ↑) | SIQA (acc ↑) | BoolQ (acc ↑) | 평균 정확도 (↑) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 760M / 30B | Transformer++ | 24.18 | 24.27 | 36.3 | 67.2 | 41.8 | 52.0 | 65.6 | 33.4 | 39.1 | 61.7 | 49.64 |
| Samba (하이브리드) | 21.07 | 22.85 | 39.2 | 68.9 | 47.8 | 53.1 | 65.8 | 34.9 | 38.9 | 63.1 | 51.46 | |
| RetNet / DeltaNet / RWKV-7 | 25.77 / 24.52 / 23.75 | 24.19 / 24.38 / 23.08 | 34.5 / 36.8 / 37.1 | 66.8 / 67.3 / 67.3 | 41.2 / 44.5 / 47.6 | 51.9 / 51.8 / 52.2 | 63.6 / 64.2 / 64.7 | 32.5 / 32.7 / 34.2 | 38.8 / 39.6 / 39.4 | 56.2 / 60.1 / 61.9 | 48.19 / 49.63 / 50.55 | |
| Miras (Memora) | 22.28 | 22.31 | 38.2 | 67.8 | 49.3 | 53.3 | 63.6 | 36.1 | 40.9 | 63.0 | 51.53 | |
| 760M SWLA | 기본 모델 | 23.83 | 22.74 | 36.5 | 66.9 | 44.1 | 54.9 | 64.2 | 34.1 | 39.6 | 60.1 | 50.05 |
| + Log-Linear++ | 23.37 | 22.19 | 36.9 | 67.3 | 44.7 | 55.0 | 64.9 | 34.6 | 39.4 | 60.4 | 50.40 | |
| + GRM (= Soup) | 22.81 | 21.50 | 37.8 | 68.3 | 45.8 | 55.0 | 65.4 | 36.2 | 40.6 | 61.0 | 51.26 | |
| + SSC | 23.06 | 22.39 | 37.2 | 67.9 | 45.2 | 54.9 | 65.2 | 35.5 | 39.8 | 60.6 | 50.79 | |
| 760M DLA | 기본 모델 | 23.12 | 22.09 | 36.1 | 68.0 | 47.9 | 52.7 | 65.8 | 34.6 | 39.1 | 59.6 | 50.48 |
| + Log-Linear++ | 23.08 | 21.15 | 36.8 | 68.1 | 47.7 | 53.0 | 65.6 | 35.1 | 39.2 | 59.3 | 50.60 | |
| + GRM | 22.91 | 20.10 | 37.5 | 69.2 | 48.7 | 52.8 | 66.1 | 36.8 | 40.3 | 59.9 | 51.41 | |
| + Memory Soup | 22.78 | 20.49 | 37.2 | 69.6 | 48.3 | 53.4 | 65.8 | 36.5 | 39.6 | 60.2 | 51.33 | |
| + SSC | 23.14 | 20.86 | 37.0 | 68.4 | 47.7 | 52.7 | 66.0 | 35.2 | 39.7 | 60.1 | 50.85 | |
| 760M Titans | 기본 모델 (LMM) | 20.04 | 21.96 | 37.4 | 69.3 | 48.5 | 52.3 | 66.3 | 35.8 | 40.1 | 62.8 | 51.56 |
| + Log-Linear++ | 19.79 | 20.62 | 37.8 | 70.1 | 48.0 | 52.5 | 66.8 | 35.6 | 40.3 | 62.8 | 51.74 | |
| + GRM | 19.14 | 20.21 | 38.3 | 70.6 | 48.4 | 54.0 | 67.5 | 36.4 | 41.7 | 63.5 | 52.55 | |
| + Memory Soup | 19.52 | 20.38 | 38.0 | 71.4 | 48.6 | 53.7 | 67.1 | 35.4 | 41.3 | 63.1 | 52.33 | |
| + SSC | 19.39 | 20.46 | 37.7 | 70.9 | 48.7 | 53.5 | 66.9 | 36.3 | 41.2 | 63.1 | 52.29 | |
| 1.3B / 100B | Transformer++ | 17.92 | 17.73 | 42.6 | 71.4 | 51.3 | 54.1 | 69.9 | 36.0 | 41.8 | 58.4 | 53.19 |
| Samba (하이브리드) | 16.15 | 13.21 | 45.2 | 71.5 | 53.8 | 55.8 | 69.1 | 36.7 | 40.6 | 63.0 | 54.46 | |
| Miras (Memora) | 15.90 | 12.04 | 48.7 | 73.1 | 56.0 | 57.4 | 71.5 | 37.9 | 40.2 | 61.3 | 55.76 | |
| 1.3B SWLA | 기본 / Log-Linear++ | 18.47 / 18.67 | 16.23 / 16.09 | 39.4 / 39.9 | 70.9 / 71.2 | 48.8 / 49.3 | 56.5 / 56.6 | 67.3 / 68.1 | 35.8 / 36.3 | 41.5 / 41.4 | 60.2 / 60.4 | 52.55 / 52.90 |
| + GRM / + SSC | 18.51 / 18.61 | 15.95 / 16.01 | 40.6 / 40.4 | 72.6 / 71.9 | 50.5 / 50.0 | 57.8 / 57.1 | 69.5 / 68.9 | 40.8 / 38.6 | 42.8 / 42.2 | 62.2 / 61.2 | 54.60 / 53.79 | |
| 1.3B DLA | 기본 / Log-Linear++ | 16.31 / 16.22 | 12.29 / 12.25 | 44.5 / 44.9 | 70.6 / 71.1 | 53.9 / 54.5 | 54.2 / 54.8 | 69.6 / 70.0 | 36.0 / 36.6 | 40.8 / 41.3 | 60.2 / 60.7 | 53.72 / 54.24 |
| + GRM / + Soup / + SSC | 16.08 / 16.16 / 16.20 | 12.10 / 12.17 / 12.19 | 45.8 / 45.6 / 45.3 | 72.5 / 71.9 / 71.7 | 55.9 / 55.4 / 54.8 | 55.8 / 55.6 / 55.3 | 71.5 / 70.9 / 70.4 | 41.2 / 37.7 / 37.1 | 42.8 / 42.0 / 41.4 | 62.2 / 61.5 / 61.1 | 55.96 / 55.08 / 54.64 | |
| 1.3B Titans | 기본 / Log-Linear++ | 15.60 / 15.49 | 11.41 / 11.38 | 49.1 / 49.4 | 73.1 / 73.6 | 56.3 / 56.5 | 59.8 / 60.3 | 72.4 / 72.8 | 40.8 / 41.1 | 42.1 / 42.5 | 61.0 / 61.3 | 56.82 / 57.19 |
| + GRM | 15.37 | 11.29 | 50.4 | 74.5 | 57.4 | 61.5 | 73.8 | 42.6 | 43.9 | 62.5 | 58.33 | |
| + Memory Soup / + SSC | 15.42 / 15.44 | 11.31 / 11.35 | 49.9 / 49.6 | 74.2 / 73.8 | 57.3 / 57.0 | 60.8 / 60.6 | 73.5 / 73.1 | 42.2 / 41.9 | 43.4 / 42.8 | 62.0 / 61.8 | 57.91 / 57.58 |
세 백본 모두에서 MC 변형(GRM, Memory Soup, SSC)은 기본 모델보다 LAMBADA 퍼플렉시티가 낮아지고 8개 과제 평균 정확도가 상승했다. 1.3B 규모에서 GRM을 결합하면 평균 정확도는 SWLA가 52.55%에서 54.60%로(+2.05%p), DLA가 53.72%에서 55.96%로(+2.24%p), Titans가 56.82%에서 58.33%로(+1.51%p) 올랐다. 세 모델 모두 어텐션과 선형 RNN을 결합한 하이브리드 모델 Samba(54.46%)보다 평균 정확도가 높고, 균일 크기 분할을 쓰는 MC 변형들이 로그 크기 분할을 쓰는 Log-Linear++보다 높은 평균 점수를 기록했다.
연구진은 장문 문맥의 정보 보존 능력을 직접 시험하려고, 16K 문맥 길이로 학습한 모델들을 건초더미 속 바늘 찾기(Single-Needle-In-A-Haystack, S-NIAH) 과제 세 가지로 4K, 8K, 16K 길이에서 평가했다(원문 Table 2). 세 과제는 암호키를 찾는 S-NIAH-1, 숫자를 찾는 S-NIAH-2, UUID를 찾는 S-NIAH-3이다.
| 모델 | S-NIAH-1 (4K / 8K / 16K) | S-NIAH-2 (4K / 8K / 16K) | S-NIAH-3 (4K / 8K / 16K) |
|---|---|---|---|
| Transformer | 88.6 / 76.4 / 79.8 | 100 / 98.8 / 94.2 | 78.0 / 69.2 / 40.8 |
| DLA (기본) | 96.4 / 71.2 / 44.0 | 79.6 / 42.6 / 28.2 | 18.2 / 8.8 / 4.0 |
| + Log-Linear++ | 100 / 96.2 / 70.4 | 87.6 / 70.4 / 18.0 | 28.8 / 20.4 / 6.0 |
| + GRM | 100 / 100 / 82.4 | 94.6 / 82.8 / 54.8 | 48.2 / 34.4 / 18.2 |
| + Memory Soup | 100 / 100 / 78.2 | 91.8 / 77.2 / 40.4 | 43.0 / 32.8 / 14.8 |
| + SSC | 100 / 98.2 / 76.8 | 89.2 / 74.8 / 37.6 | 34.0 / 28.6 / 11.2 |
| Titans (LMM 기본) | 100 / 100 / 100 | 99.6 / 84.6 / 75.4 | 74.2 / 42.8 / 21.2 |
| + Log-Linear++ | 100 / 100 / 100 | 95.6 / 88.4 / 74.8 | 76.0 / 48.4 / 24.2 |
| + GRM | 100 / 100 / 100 | 99.8 / 96.6 / 88.2 | 89.4 / 69.0 / 32.2 |
| + Memory Soup | 100 / 100 / 100 | 98.8 / 92.2 / 83.0 | 84.2 / 61.8 / 28.6 |
| + SSC | 100 / 100 / 100 | 98.6 / 90.4 / 79.6 | 81.0 / 54.2 / 27.0 |
NIAH 실험에서는 균일 분할과 로그 분할의 차이가 뚜렷하게 드러났다. 예를 들어 S-NIAH-2를 16K 길이에서 평가하면 DLA 기본 모델은 28.2%였고, Log-Linear++는 첫 세그먼트 하나가 8K 토큰을 한꺼번에 압축해야 해서 18.0%로 도리어 더 낮았다. 압축 부하를 균일하게 분배한 DLA + GRM은 같은 조건에서 54.8%를 기록했다. 가장 난도가 높은 UUID 인출(S-NIAH-3)에서 Titans + GRM은 4K에서 89.4%로 트랜스포머(78.0%)보다 높았고, 8K에서는 69.0%로 트랜스포머(69.2%)와 거의 같았다. 16K에서는 트랜스포머(40.8%)보다 낮지만 기본 Titans(21.2%)보다는 11.0%p 높은 32.2%를 기록했다.
같은 경향은 두 실험에서도 확인됐다. 하나는 순환 신경망이 가장 취약한 실세계 문맥 내 인출(In-context Retrieval) 벤치마크 6개(SWDE, SQuAD, FDA, TriviaQA, DROP, NQ)로, 입력을 512부터 16K까지 길이별로 잘라 평가했다(원문 Table 3). 다른 하나는 장문 이해 벤치마크 LongBench의 14개 과제다(원문 Table 4). 표에서 Titans(MAL, Memory as a Layer)는 메모리 모듈과 어텐션 층을 결합한 하이브리드 기준선이다.
| 모델 | SWDE (512 / 16K) | SQuAD (512 / 16K) | FDA (512 / 16K) | TriviaQA (512 / 16K) | DROP (512 / 16K) | NQ (512 / 2048) | 인출 전체 평균 (↑) | LongBench 14개 과제 평균 (↑) |
|---|---|---|---|---|---|---|---|---|
| Transformer | 46.2 / 44.0 | 33.1 / 33.4 | 71.0 / 71.0 | 47.5 / 47.6 | 21.8 / 21.4 | 23.6 / 23.7 | 41.00 | 17.47 |
| Titans (MAL, 하이브리드) | 51.9 / 48.5 | 28.3 / 28.8 | 71.1 / 71.7 | 44.8 / 44.8 | 20.6 / 20.9 | 22.1 / 22.5 | 40.46 | 미보고 |
| DLA (기본) | 44.5 / 32.5 | 23.8 / 24.1 | 55.6 / 23.3 | 43.3 / 43.2 | 20.1 / 20.0 | 19.7 / 18.5 | 30.51 | 15.09 |
| + Log-Linear++ | 43.7 / 30.6 | 27.8 / 28.3 | 55.1 / 18.9 | 43.7 / 43.8 | 20.3 / 20.2 | 19.9 / 21.0 | 30.75 | 16.13 |
| + GRM | 52.4 / 48.5 | 29.5 / 30.1 | 63.3 / 41.5 | 50.1 / 50.0 | 21.9 / 21.7 | 23.5 / 23.4 | 38.03 | 19.04 |
| + Memory Soup | 49.5 / 37.7 | 28.4 / 29.1 | 60.5 / 34.6 | 48.0 / 48.7 | 21.5 / 21.2 | 22.8 / 22.5 | 35.05 | 18.09 |
| + SSC | 47.0 / 35.3 | 26.0 / 28.8 | 58.0 / 29.4 | 45.8 / 46.1 | 20.9 / 20.6 | 21.4 / 21.8 | 33.09 | 17.11 |
| Titans (LMM 기본) | 43.2 / 29.7 | 25.7 / 25.6 | 59.3 / 32.5 | 44.2 / 44.5 | 20.2 / 20.6 | 20.1 / 19.1 | 31.75 | 19.53 |
| + Log-Linear++ | 48.0 / 37.0 | 27.2 / 27.1 | 67.0 / 32.4 | 44.5 / 44.7 | 20.4 / 20.7 | 21.5 / 20.4 | 34.37 | 17.92 |
| + GRM | 52.6 / 50.1 | 29.7 / 32.0 | 72.9 / 52.6 | 50.2 / 50.9 | 21.7 / 21.5 | 23.7 / 23.3 | 40.50 | 20.53 |
| + Memory Soup | 50.3 / 45.4 | 29.2 / 30.3 | 70.3 / 45.8 | 48.3 / 49.4 | 21.3 / 21.1 | 22.9 / 22.5 | 38.43 | 19.80 |
| + SSC | 48.6 / 41.4 | 28.3 / 28.8 | 68.2 / 38.9 | 46.1 / 46.9 | 20.8 / 20.9 | 21.9 / 21.5 | 36.27 | 19.19 |
문맥 내 인출 과제에서 기본 DLA(평균 30.51%)와 기본 Titans LMM(평균 31.75%)은 문맥 길이가 512에서 16K로 길어질 때 FDA와 SWDE 정확도가 12~32%p씩 급락했다. GRM을 결합한 DLA는 평균 38.03%로 7.52%p 올랐고, 순수 순환 모델인 Titans LMM은 GRM을 결합해 평균 40.50%가 됐다. 하이브리드 모델인 Titans(MAL, 40.46%)보다 조금 높고 트랜스포머(41.00%)와는 0.50%p 차이다. LongBench 14개 과제에서도 DLA + GRM(평균 19.04)과 Titans + GRM(평균 20.53, TriviaQA few-shot 49.7점)이 기본 순환 모델과 트랜스포머(평균 17.47)보다 높은 점수를 냈다.7
연상 인출, 설계 요소별 절제 연구, 학습 처리량 효율성
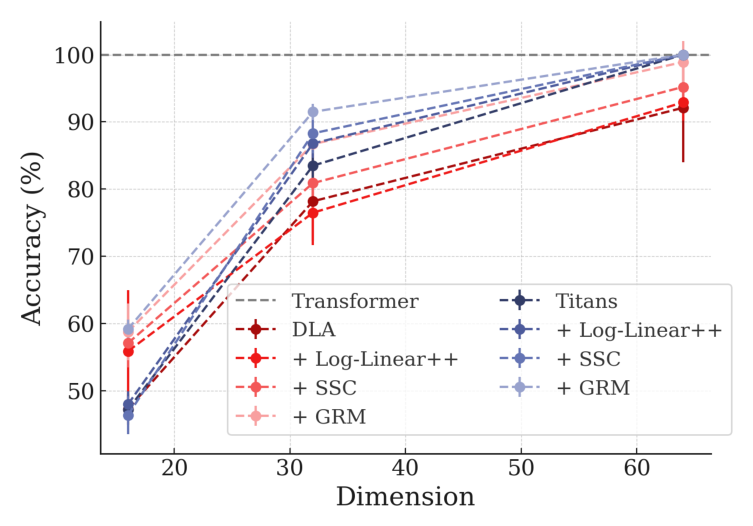 원문 Figure 5: 다중 질의 연상 인출(MQAR) 과제에서 모델 차원(Dimension)에 따른 시드 5개의 평균 정확도(%). 출처: arXiv:2602.24281
원문 Figure 5의 실험에서 DLA와 Titans는 MC 변형(GRM, SSC)을 결합했을 때 모든 차원에서 기본 모델과 Log-Linear++보다 정확도가 높았다. 차원이 64일 때는 Titans + GRM과 Titans + SSC가 트랜스포머 기준선과 같은 약 100% 정확도를 보인다.
원문 Table 5의 절제 연구(Ablation Study)는 Titans(GRM)과 Titans(SSC)에서 핵심 설계 요소를 하나씩 제거하거나 교체했을 때 언어 모델링(ppl), 상식 추론(acc), 문맥 내 인출(acc) 성적이 어떻게 변하는지 보여 준다.
| 절제 실험 구성 | 언어 모델링 (ppl ↓) | 상식 추론 (acc ↑) | 문맥 내 인출 (acc ↑) |
|---|---|---|---|
| Titans (GRM) 전체 적용 | 13.3 | 58.3 | 40.5 |
| − 문맥 의존 게이팅 제거 (입력 $x_t$만으로 $\gamma_t$ 결정) | 13.4 | 57.4 | 33.0 |
| − 게이팅 전체 제거 (단순 Residual Memory로 전환) | 13.5 | 56.9 | 32.4 |
| − 심층 메모리를 선형 메모리로 교체 | 13.7 | 56.3 | 34.5 |
| Titans (SSC) 전체 적용 | 13.4 | 57.6 | 36.3 |
| − 문맥 의존 게이팅 제거 (입력 $x_t$만으로 $\gamma_t$ 결정) | 13.4 | 57.1 | 32.6 |
| − 게이팅 전체 제거 (선택된 캐시 단순 합산) | 13.5 | 56.8 | 31.9 |
| − 심층 메모리를 선형 메모리로 교체 | 13.8 | 56.8 | 33.4 |
가장 큰 변화가 나타난 항목은 문맥 내 인출(Retrieval) 정확도다. 게이트 가중치 $\gamma_t^{(i)}$를 계산할 때 세그먼트 문맥 $\texttt{MeanPooling}(S^{(i)})$를 빼고 현재 입력 $x_t$만 쓰면, Titans(GRM)의 인출 정확도가 40.5%에서 33.0%로 7.5%p 떨어졌다. 원문 3.1절은 세그먼트 내용을 보지 않고 순서에 따라서만 가중치를 주면 정밀한 인출이 어렵다고 분석했는데, 실제 실험 수치가 그 분석을 뒷받침한다. 게이팅까지 모두 빼고 단순 잔차 메모리(RM)만 남겼을 때의 인출 정확도는 32.4%다. GRM보다는 낮으나 기본 Titans LMM(31.75%)은 상회한다. 심층(MLP) 메모리를 선형 메모리로 교체하면 인출 정확도는 GRM에서 34.5%, SSC에서 33.4%다. 단일 메모리의 표현력이 낮아져도 메모리 캐싱을 쓰면 성능 하락 폭이 완만하다.8
마지막으로 원문 Figure 4는 문맥 길이를 2K에서 32K까지 늘릴 때의 학습 처리량(초당 처리 토큰 수)을 비교한다. 왼쪽 그래프에서 트랜스포머는 2K일 때 초당 약 5만 1,000토큰으로 가장 빠르다. 그러나 연산량이 문맥 길이의 제곱으로 늘어나는 탓에 16K(약 3만 7,000토큰)에서 순환 모델들과 처리량 순위가 바뀌고, 32K에서는 초당 3만 토큰 수준으로 가장 느리다. SWLA와 Titans에 SSC를 결합한 모델은 기본 순환 모델과 거의 같은 처리량을 유지해, 32K에서 SWLA + SSC는 초당 약 3만 6,000토큰, Titans + SSC는 초당 약 3만 4,000토큰을 처리했다. 모든 캐시를 읽는 GRM은 32K에서 초당 3만 1,500~3만 2,000토큰으로 SSC보다 약간 느리나 트랜스포머보다는 빠르다.
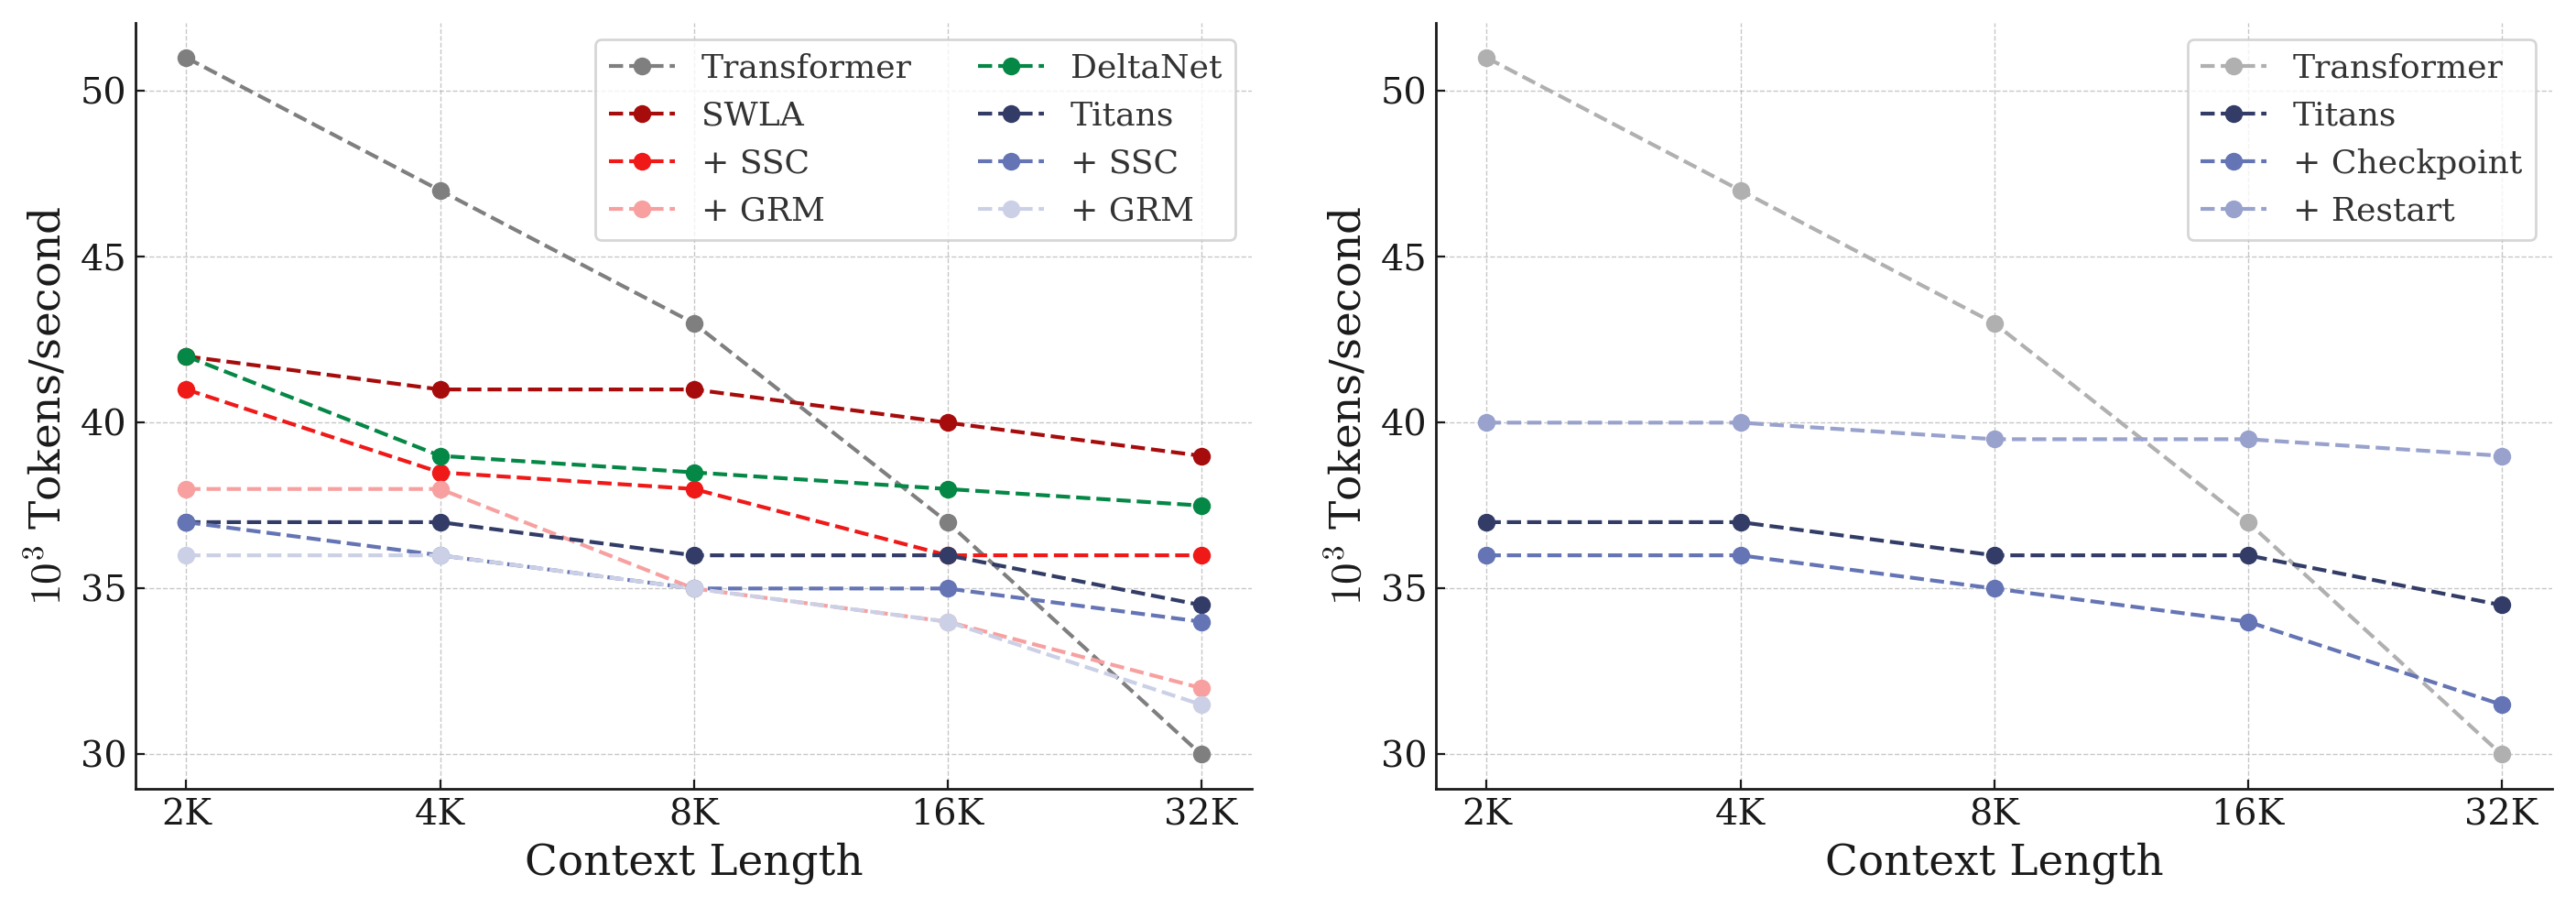 원문 Figure 4: 문맥 길이(2K~32K)에 따른 학습 처리량(단위: 초당 1,000토큰) 비교. 왼쪽은 Transformer, DeltaNet, SWLA, Titans 및 각 모델의 SSC, GRM 변형 비교이고, 오른쪽은 Titans에서 체크포인트 캐싱(+ Checkpoint)과 독립 압축기 재시작(+ Restart) 방식의 처리량 비교다. 출처: arXiv:2602.24281
오른쪽 그래프에서는 원문 3.4절에서 다룬 두 가지 세그먼트 초기화 설계를 비교했다. 독립 압축기(+ Restart) 설계는 세그먼트마다 메모리를 새로 초기화하므로 세그먼트 간 순차 의존성이 없고, 세그먼트별 메모리 갱신을 병렬화할 수 있다. 그 결과 2K부터 32K까지 초당 약 3만 9,000~4만 토큰의 처리량을 일관되게 유지했다. 이전 세그먼트의 마지막 상태를 이어받는 체크포인트(+ Checkpoint) 설계나 기본 Titans보다 높은 값이다.
가장 흥미로운 지점
이 논문에서 가장 눈여겨본 대목은 원문 4.1절이다. 순환 신경망과 소프트맥스 어텐션을 하나의 수식 스펙트럼으로 통합해 설명한다. 세그먼트 길이를 $L$ 전체로 두면($N=1$) 모든 과거를 단일 은닉 상태에 압축하는 순환 신경망이 되고, 세그먼트 길이를 토큰 하나($L^{(i)}=1, N=L$)로 줄여 값 없는 벡터 메모리에 GRM을 적용하면 게이트 전역 소프트맥스 어텐션이 그대로 복원된다. 두 패러다임은 그동안 별개의 아키텍처로 다뤄지거나 하이브리드 모델에서 층 단위로 번갈아 배치됐다. MC로 보면 두 패러다임은 세그먼트 길이 $C$를 조절하는 문제로 연결된다. “얼마나 긴 구간마다 메모리 체크포인트를 캐시에 남길 것인가"라는 질문 하나로 둘을 설명하는 정리가 명쾌하다.
메모리 모듈이 단층 선형 행렬일 때는 분배법칙이 성립해 게이트 가중합(GRM)과 가중치 보간(Memory Soup)이 완전히 같은 수식이 되지만, 메모리를 2층 MLP 같은 비선형 신경망으로 확장하는 순간 두 기법이 서로 다른 함수가 된다는 점도 흥미롭다. 이 설계에서 각 세그먼트는 데이터를 압축한 작은 신경망의 가중치 체크포인트가 된다. 질의 토큰이 새로 입력될 때마다 과거 체크포인트들의 가중치를 문맥 유사도 비율로 결합해, 그 토큰만을 위한 비선형 인출 신경망 $\mathcal{M}^*_t$를 즉석에서 구성한다. KV 벡터를 저장해 두는 기존 캐시 개념을 가중치 공간의 메타 학습으로 확장해 보여 준다.
출처
Ali Behrouz, Zeman Li, Yuan Deng, Peilin Zhong, Meisam Razaviyayn, Vahab Mirrokni (Google Research), “Memory Caching: RNNs with Growing Memory”, arXiv:2602.24281v1, 2026-02-27.
원문: https://arxiv.org/abs/2602.24281
그림은 논문(arXiv:2602.24281)에서 인용했다. 치비 서소영 삽화 두 장은 「느낌적인 느낌을 숫자로 옮기는 일」의 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
선형 어텐션(Katharopoulos et al., 2020)은 소프트맥스의 $\exp(\mathbf{q}_i^\top \mathbf{k}_t)$를 분리 가능한 커널 $\phi(\mathbf{q}_i)^\top \phi(\mathbf{k}_t)$로 대체한다. 이를 통해 $\mathcal{M}_t = \mathcal{M}_{t-1} + \mathbf{v}_t \phi(\mathbf{k}_t)^\top$ 형태의 고정 크기 행렬 메모리를 순환 갱신하고, 출력 $\mathbf{y}_i = \frac{1}{Z_i} \mathcal{M}_i \phi(\mathbf{q}_i)$를 선형 시간 안에 계산한다. ↩︎
Behrouz et al.(2026, arXiv 초판 2025)의 Miras 프레임워크는 어텐션 편향 목적함수 $\mathcal{L}$과 상태 유지 연산자 $\texttt{Ret}$의 선택에 따라 기존 시퀀스 모델들을 복원한다. 예를 들어 $\mathcal{L}(\mathcal{M}(\mathbf{k}_t); \mathbf{v}_t) = -\langle \mathcal{M}(\mathbf{k}_t), \mathbf{v}_t \rangle$이고 $\mathcal{M} \in \mathbb{R}^{d \times d}$이면 비정규화 선형 어텐션이 유도된다. ↩︎
논문은 별도의 투영 행렬 $W_{\mathbf{u}}$를 두어 $\mathbf{u}_t = x_t W_{\mathbf{u}}$를 계산하는 방식 외에, 추가 파라미터를 줄이는 대안도 제시했다. 질의 벡터를 그대로 재사용하는 $\mathbf{u}_t = \mathbf{q}_t$ 매개변수화다. ↩︎
원문 각주 1은 값(Value) 없는 벡터 순환 메모리를 사용하더라도 모델의 표현력이 손실되지 않는 이유를 선형 어텐션과의 비교로 설명한다. 선형 어텐션에서 Rank-1 행렬 메모리 $\mathcal{M}_t = \mathcal{M}_{t-1} + \mathbf{k}_t \mathbf{v}_t^\top$를 가정하고 모든 시점의 값을 상수 벡터 $\mathbf{v}_t = \mathbf{1}$로 고정하면, 메모리 갱신식이 벡터 덧셈인 $\mathcal{M}_t = \mathcal{M}_{t-1} + \mathbf{k}_t$로 단순화된다. ↩︎
Guo et al.(2025)이 제안한 Log-Linear Attention은 선형 RNN의 구조화된 행렬 표현에 Fenwick 트리 분할을 적용해 $\mathcal{O}(L \log L)$ 학습 복잡도와 $\mathcal{O}(\log L)$ 디코딩 메모리를 달성한 기법이다. 이 논문은 심층 메모리와 문맥 의존 게이팅(GRM) 환경에서도 공정하게 비교할 수 있도록, 로그 크기 세그먼트 분할만 유지하고 나머지 구성 요소를 MC와 통일한 Log-Linear++를 비교군으로 사용했다. ↩︎
세 백본의 세그먼트 내 메모리 갱신식은 다음과 같다. SWLA($c=2$)는 $\mathcal{M}^{(s)}_t = \alpha_t \mathcal{M}^{(s)}_{t-1} + (\beta_t \mathbf{v}_{t-1}\mathbf{k}_{t-1}^\top + \lambda_t \mathbf{v}_t \mathbf{k}_t^\top)$다. DLA는 $\mathcal{M}^{(s)}_t = \mathcal{M}^{(s)}_{t-1} - \eta_t \nabla \mathcal{L}(\mathcal{M}^{(s)}_{t-1}; \mathbf{k}_t, \mathbf{v}_t)$ ($\mathcal{L} = -\langle \mathcal{M}(\mathbf{k}_t), \mathbf{v}_t \rangle$)로 갱신한다. Titans는 모멘텀 상태 $\mathcal{S}_t = \beta_t \mathcal{S}_{t-1} - \eta_t \nabla \mathcal{L}(\mathcal{M}_{t-1}; \mathbf{k}_t, \mathbf{v}_t)$ ($\mathcal{L} = \|\mathcal{M}(\mathbf{k}_t) - \mathbf{v}_t\|_2^2$)를 이용해 $\mathcal{M}_t = \alpha_t \mathcal{M}_{t-1} - \mathcal{S}_t$로 갱신한다. ↩︎
원문 4.3절 마지막 문단에 따르면 메모리 캐싱은 사전학습이 끝난 순환 모델의 추론 단계에 사후(post-training) 방식으로도 적용할 수 있다. 추론 시 학습 문맥 길이 단위로 메모리 상태를 캐싱하고, 디코딩할 때 별도의 학습 가중치 없이 과거 캐시 메모리들의 이동평균(moving average)을 사용하면 순환 모델의 길이 외삽(length extrapolation) 성능이 향상된다. ↩︎
원문 Table 5에는 연결자 벡터와 질의 벡터를 공유하는
Shared u and q행도 있다. 그러나 arXiv v1 표에는 이 행의 수치가00.0으로만 적혀 있어 본문 표에서 뺐다. ↩︎