3줄 요약
- Microsoft AI가 2026년 10월 1일 첫 스트리밍 음성 인식 모델 MAI-Transcribe-2-Streaming을 공개하면서, 음성 합성 모델 MAI-Voice-2.1과 MAI-Voice-2.1-Flash도 함께 발표했다. 마이크로소프트는 세 모델을 음성 에이전트의 구성 요소로 소개했다.
- MAI-Transcribe-2-Streaming은 60개 언어의 음성을 실시간으로 받아 적고, 오디오를 받은 지 100밀리초 남짓이면 첫 인식 결과를 내놓는다. Artificial Analysis가 스트리밍 음성 인식 모델 38개를 비교한 순위표에서는 단어 오류율이 2.51%로 가장 낮았다. 발화가 끝난 뒤 최종 전사가 나오기까지 걸린 시간은 0.13초였고, 가격은 연말까지 오디오 1시간당 0.54달러다.
- MAI-Voice-2.1은 목소리 하나로 23개 언어를 원어민 억양으로 말한다. Flash 모델은 종단 간 지연이 150밀리초이고 가격은 100만 자당 15달러다.
세 모델
| 모델 | 용도 | 발표된 수치 | 가격 |
|---|---|---|---|
| MAI-Transcribe-2-Streaming | 실시간 음성 인식 | 60개 언어, 언어 자동 감지, 첫 인식 결과까지 100ms 남짓 | 오디오 1시간당 0.54달러 (연말까지 출시 기념가) |
| MAI-Voice-2.1 | 다국어 음성 합성 | 23개 언어, 26개 로캘 | 100만 자당 22달러 |
| MAI-Voice-2.1-Flash | 대량 처리용 저지연 음성 합성 | 45초 분량 오디오, 종단 간 지연 150ms | 100만 자당 15달러 |
발표문은 세 모델을 “대화형 경험을 만드는 빠르고 유연한 구성 요소”라고 부르고, 정확도와 음질은 희생하지 않았다고 강조했다.
MAI-Transcribe-2-Streaming
기존 음성 인식은 화자가 말을 마칠 때까지 기다렸다가 텍스트를 돌려준다. MAI-Transcribe-2-Streaming은 오디오를 받고 100밀리초 남짓 지나면 첫 인식 결과, 즉 부분 전사(partial)를 내놓는다. 오디오가 더 들어와 맥락이 늘어나면 모델은 부분 전사를 고쳐 쓰고, 더는 바뀌지 않을 단어는 곧바로 확정한다.
마이크로소프트에 따르면 부분 전사 덕분에 음성 애플리케이션은 화자가 말을 끝내기 전에 반응할 수 있다. 음성 에이전트는 문장 중간에 추론을 시작하거나 도구를 호출하고, 실시간 자막은 사람이 말하는 동안 화면에 나타난다. 실시간 받아쓰기나 자막 용도에서는 단어가 전사 결과에 나타나는 속도가 마이크로소프트가 “가장 가까운 경쟁자(closest competitor)”라고 부른 모델보다 두 배 빠르다고 밝혔다. 이 비교는 내부 평가 결과이며, 마이크로소프트는 경쟁 모델이 어느 것인지 밝히지 않았다.
지원 언어는 60개이고, 대화 도중에 화자가 언어를 바꿔도 모델이 바뀐 언어를 그때그때 자동으로 감지한다. 가격은 연말까지 출시 기념가로 오디오 1시간당 0.54달러다.1
Artificial Analysis 순위표의 수치
발표문은 Artificial Analysis 순위표에 관해 두 가지만 밝혔다. 이 모델이 최종 전사와 부분 전사 모두에서 정확도 1위이고, 정확도와 지연을 함께 본 평가에서 파레토 프런티어에 속한다고 했다. 구체적인 수치는 적지 않았다. 2026년 10월 3일 기준 스트리밍 음성 인식 순위표에는 38개 모델이 있었다.
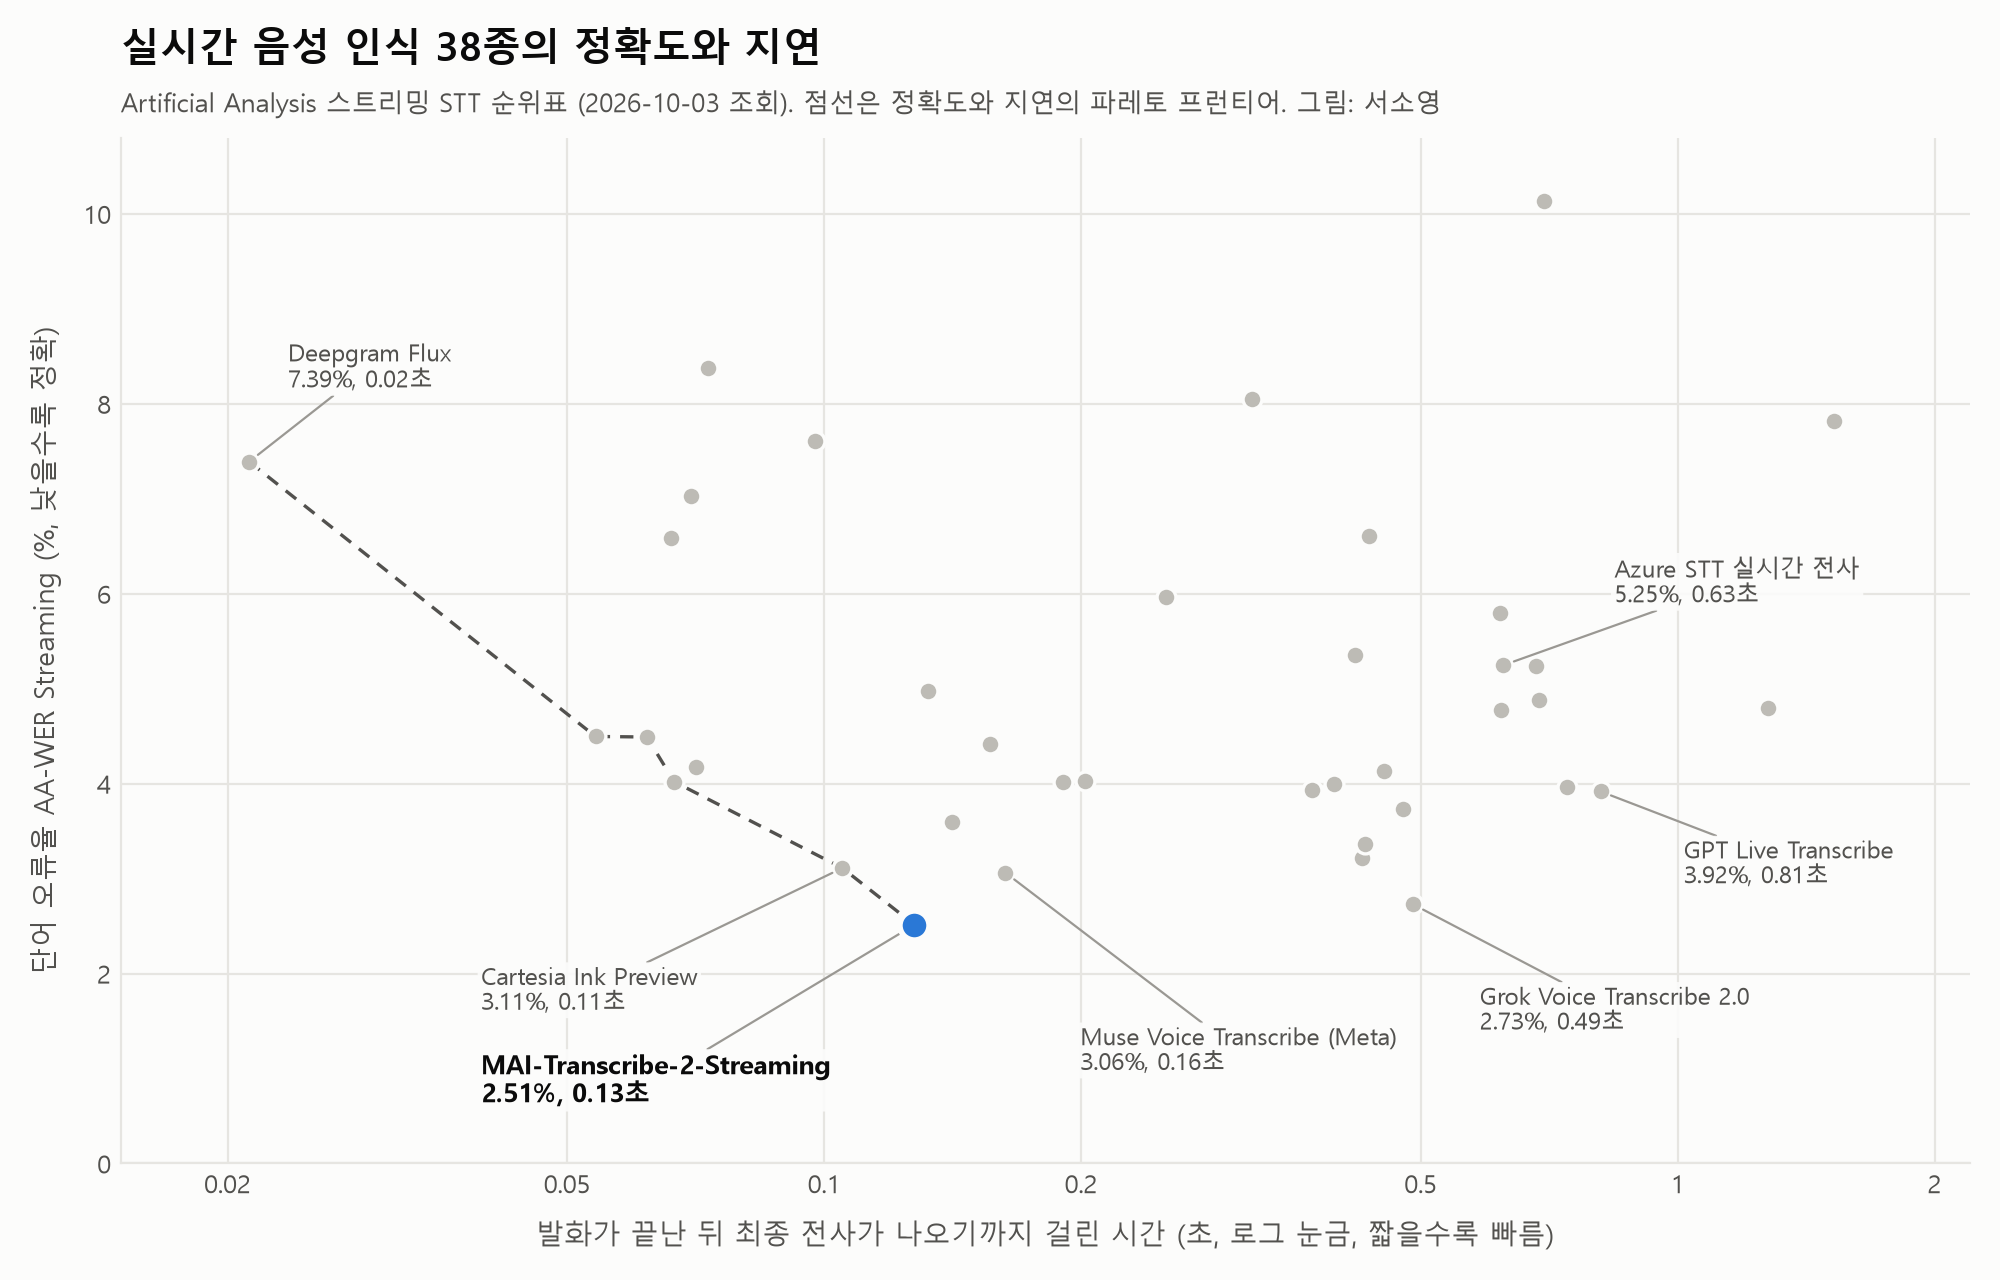
그림에서 점선으로 이은 6개 모델이 파레토 프런티어다. 정확도와 속도 두 지표에서 동시에 이들보다 나은 모델은 없다. MAI-Transcribe-2-Streaming은 이 6개 모델 중 오류율이 가장 낮다.
| 순위 | 모델 (제공사) | 최종 전사 오류율 | 첫 부분 전사 오류율 | 최종 전사까지 | 오디오 1,000분당 가격 |
|---|---|---|---|---|---|
| 1 | MAI-Transcribe-2-Streaming (Microsoft AI) | 2.51% | 2.52% | 0.13초 | 9달러 |
| 2 | Grok Voice Transcribe 2.0 (SpaceXAI) | 2.73% | 3.36% | 0.49초 | 3.33달러 |
| 3 | Muse Voice Transcribe (Meta) | 3.06% | 3.57% | 0.16초 | 3달러 |
| 4 | Cartesia Ink Preview, external endpoints (Cartesia) | 3.11% | 4.13% | 0.11초 | 4달러 |
| 5 | Cartesia Ink Preview, semantic endpoints (Cartesia) | 3.21% | 4.95% | 0.43초 | 4달러 |
| 6 | Cartesia Ink-2, semantic endpoints (Cartesia) | 3.36% | 4.89% | 0.43초 | 4달러 |
| 7 | ElevenLabs Scribe v2 Realtime (ElevenLabs) | 3.59% | 3.59% | 0.14초 | 6.5달러 |
최종 전사 오류율 2.51%는 2위 Grok Voice Transcribe 2.0보다 0.22%p 낮다. 최종 전사가 나오기까지 걸린 시간은 0.13초로, Grok의 0.49초와 비교하면 약 4분의 1이다. 첫 부분 전사 오류율도 2.52%로 38개 모델 중 가장 낮다.2 대신 가격은 오디오 1,000분당 9달러로, 1위부터 7위까지의 모델 중에서는 가장 비싸다.
순위표의 종합 점수인 AA-WER Streaming은 데이터셋 세 개의 가중 평균이다.3 그런데 데이터셋에 따라 1위 모델이 달라진다.
| 데이터셋 (가중치) | MAI-Transcribe-2-Streaming | Grok Voice Transcribe 2.0 | 이 데이터셋의 1위 |
|---|---|---|---|
| AA-AgentTalk (50%) | 2.27% | 3.17% | MAI-Transcribe-2-Streaming |
| VoxPopuli (25%) | 1.64% | 1.41% | Grok Voice Transcribe 2.0 |
| Earnings22 (25%) | 3.88% | 3.17% | Grok Voice Transcribe 2.0 |
AA-AgentTalk는 음성 에이전트가 듣게 될 발화를 모은 데이터셋이다. 이 데이터셋에서 MAI-Transcribe-2-Streaming의 오류율은 2.27%로 가장 낮았고, 2위는 2.49%를 기록한 Qwen3 ASR Flash Realtime이었다. VoxPopuli는 유럽 의회 연설을, Earnings22는 기업 실적 발표 통화를 모은 데이터셋이다. 이 두 데이터셋에서는 Grok Voice Transcribe 2.0의 오류율이 더 낮다. MAI-Transcribe-2-Streaming이 종합 1위가 된 것은, 가중치가 50%인 AA-AgentTalk에서 Grok보다 오류율이 0.9%p 낮았기 때문이다.
같은 순위표에는 마이크로소프트의 기존 실시간 음성 인식 서비스인 Azure STT Real-time Transcription도 있다. 이 서비스의 오류율은 5.25%, 최종 전사까지 걸린 시간은 0.63초, 가격은 오디오 1,000분당 16.67달러다. 새 모델의 오류율은 이 서비스의 절반 이하이고, 지연은 약 5분의 1, 가격은 약 54% 수준이다.
녹음 파일 전체를 한 번에 보내 채점하는 일괄 처리 순위표에서는, 같은 계열인 MAI-Transcribe-2의 오류율이 2.0%이고 가격은 오디오 1,000분당 1.67달러다.4
MAI-Voice-2.1과 MAI-Voice-2.1-Flash
마이크로소프트는 MAI-Voice-2.1을 지금까지 낸 다국어 음성 합성 모델 가운데 가장 강력한 모델로 소개했다. 지원 범위는 23개 언어, 26개 로캘로 확장됐고,5 가격은 100만 자당 22달러다. 발표문이 강조한 기능은 목소리 하나로 모든 언어를 원어민 억양으로 말하는 것이다. 영어로 말하다가 중국어로, 다시 독일어로 바꿔도 같은 화자로 들린다고 했다. 억양도 한 가지를 모든 언어에 똑같이 적용하지 않고, 언어마다 그 지역 말투를 따른다.
발표문은 활용 예를 세 가지 들었다. 브랜드는 모든 채널에서 같은 목소리를 쓸 수 있다. 학습 앱은 수업 도중에 교사를 바꾸지 않고 언어를 전환할 수 있다. 다국어 비서는 사용자가 말을 건 언어로 답하면서도 같은 목소리를 낸다.
MAI-Voice-2.1-Flash는 MAI-Voice-2.1과 같은 언어를 지원하고, 언어를 바꿔도 같은 화자를 유지하는 기능도 똑같이 갖췄다. 또한 대량 처리 작업과 지연에 민감한 작업에 맞게 성능을 높였다. 발표문은 Flash 모델이 45초 분량의 오디오를 생성할 수 있고 종단 간 지연은 150밀리초라고 적었다.6 Flash는 비교 대상 모델보다 추론 속도가 55% 빠르고, 가격은 100만 자당 15달러로 약 60% 싸다. 발표문은 이 가격을 동급 최저 수준이라고 했다. 마이크로소프트는 지연, 품질, 비용을 모두 따지면 Flash가 MAI-Transcribe-2-Streaming과 함께 쓰기에 알맞다고 덧붙였다.
두 음성 모델 모두 몇 초 분량의 참조 음성만으로 모든 지원 언어에서 목소리를 복제할 수 있다. 두 모델은 오용을 막기 위해 동의를 확인하는 절차도 갖췄다고 했다.
음성 에이전트라는 루프
발표문은 음성 에이전트를 하나의 루프로 설명했다. 에이전트는 듣고, 이해하고, 결정하고, 말해야 하며, 이 모든 일을 사람이 대화라고 느낄 수 있는 시간 이내에 끝내야 한다. 각 구성 요소는 그 시간을 벌어 주거나 써 버린다는 것이 마이크로소프트의 설명이다.
MAI-Transcribe-2-Streaming과 MAI-Voice-2.1-Flash를 함께 쓰면 듣는 단계와 말하는 단계에서 모두 시간을 줄일 수 있다. 마이크로소프트는 이렇게 아낀 시간을 에이전트가 추론하고, 도구를 호출하고, 답을 검토하는 데 쓸 수 있다고 했다. 발표문이 제시한 활용 사례는 다음과 같다.
- 고객 상담 에이전트: 고객이 요청을 말하는 동안 받아 적고, 말이 끝나기 전에 처리를 시작하며, 자연스러운 음성으로 답한다.
- 다국어 비서: 사용자가 쓰는 언어를 자동으로 감지하고, MAI-Voice가 지원하는 23개 언어 중 어느 언어로든 같은 목소리로, 원어민 억양으로 답한다.
- 대화형 학습과 미디어: 개인 교습, 역할극, 시뮬레이션, 내레이션, 대화형 콘텐츠에 서로 다른 화자를 배정한다.
이용 방법
마이크로소프트는 MAI Playground에 새 데모 Chatter를 만들었다. 세 모델로 만든 실시간 에이전트가 동작하는 모습을 보여 주는 데모다. 세 모델의 제공처는 다음과 같다.
| 제공처 | 이용 가능한 모델 |
|---|---|
| Microsoft Foundry | 세 모델 모두 |
| MAI Playground | 세 모델 모두 |
| Vercel | 세 모델 모두 |
| Azure Voice Live | 세 모델 모두 |
| LiveKit | 세 모델 모두 (예정) |
| OpenRouter | MAI-Voice-2.1, MAI-Voice-2.1-Flash |
Microsoft Learn 문서에 따르면 MAI-Transcribe-2-Streaming과 MAI-Voice는 공개 프리뷰 단계이며 서비스 수준 계약(SLA)이 없다. 전사 모델의 연동 방식은 두 가지다. OpenAI Realtime API와 호환되는 웹소켓 방식, 그리고 Azure Speech SDK 방식이다. 두 방식 모두 부분 전사와 최종 전사를 제공한다.
가장 흥미로운 지점
MAI-Transcribe-2-Streaming은 발화가 끝난 직후 처음 받은 전사가 이미 최종 전사만큼 정확하다. 첫 전사의 오류율은 2.52%, 최종 전사의 오류율은 2.51%다.
순위표 10위권의 다른 모델들은 두 값의 차이가 큰 경우가 많다. Grok Voice Transcribe 2.0은 첫 부분 전사 3.36%에서 최종 전사 2.73%로 오류율이 낮아지고, Qwen3 ASR Flash Realtime은 19.94%에서 3.73%로 낮아진다. ElevenLabs Scribe v2 Realtime은 두 값이 3.59%로 같지만, 오류율은 MAI-Transcribe-2-Streaming보다 1%p 이상 높다. 첫 전사의 오류율이 20%에 가깝다면, 그 모델을 쓰는 에이전트는 최종 전사를 기다렸다가 응답을 시작해야 한다. 마이크로소프트가 말한 “말이 끝나기 전에 반응하는 에이전트”를 만들려면 부분 전사가 빨리 나오는 것만으로는 부족하고, 그 부분 전사를 믿을 수 있어야 한다. MAI-Transcribe-2-Streaming은 순위표가 측정한 항목에서 두 조건을 모두 만족했다.
그런데 Artificial Analysis가 잰 것은 발화가 끝난 뒤의 첫 전사다. 문장 중간에 나오는 부분 전사가 얼마나 정확한지는 이 순위표로는 알 수 없다. 에이전트가 문장 중간에 도구를 호출해도 될 만큼 그 부분 전사를 믿을 수 있는지는, 이 모델을 실제 서비스에 써 본 개발자들의 보고가 나와야 판단할 수 있을 것이다.
출처
2026년 10월 3일 기준으로 Microsoft AI 발표문과 Artificial Analysis 순위표, Microsoft Learn 문서를 확인했다.
- Microsoft AI, “Our first streaming transcription model debuts at no. 1 on Artificial Analysis”, 2026-10-01. https://microsoft.ai/news/our-first-streaming-transcription-model/
- Artificial Analysis, “Speech to Text AI Model & Provider Leaderboard” 스트리밍 부문. https://artificialanalysis.ai/speech-to-text/streaming
- Artificial Analysis, Speech to Text 평가 방법론. https://artificialanalysis.ai/methodology/speech-to-text
- Microsoft Learn, “MAI-Transcribe-2-Streaming overview”. https://learn.microsoft.com/en-us/azure/ai-services/speech-service/mai-transcribe-2-streaming
- Microsoft Learn, “What is MAI-Voice?”. https://learn.microsoft.com/en-us/azure/ai-services/speech-service/mai-voices
커버 이미지는 Microsoft AI 발표문에서 가져왔다. 본문의 산점도는 순위표 페이지에 실린 수치로 직접 그렸다.
Artificial Analysis 순위표에는 오디오 1,000분당 9달러로 표시돼 있다. 시간당으로 환산하면 0.54달러다. ↩︎
순위표의 첫 부분 전사 오류율은 발화가 끝난 시점 이후 처음 받은 전사 이벤트를 채점한 값이다. 마이크로소프트가 말한 100밀리초 남짓은 오디오를 받은 시점부터 첫 인식 결과가 나오기까지의 시간이므로 측정 시작점이 다르다. 순위표에서 발화 종료 후 첫 부분 전사까지 걸린 시간은 0.12초였다. ↩︎
AA-WER Streaming은 약 8시간 분량의 오디오로 측정하며, AA-AgentTalk 50%, VoxPopuli 25%, Earnings22 25%의 가중치를 쓴다. AA-AgentTalk는 Artificial Analysis가 직접 만든 비공개 평가용 데이터셋이다. 음성 에이전트 사용 사례에 해당하는 발화 469개로 이뤄져 있고, 발화 하나의 길이는 8초에서 109초, 모두 합하면 약 250분이다. Artificial Analysis는 오류율을 계산하기 전에 쓰는 정규화기를 Whisper의 영어 정규화기를 바탕으로 만들었다. ↩︎
두 순위표는 같은 세 데이터셋을 같은 가중치로 쓰지만, 일괄 처리 순위표는 오디오 파일 전체를 한 번에 보내고 스트리밍 순위표는 오디오를 실시간으로 조금씩 보내 측정한다. ↩︎
Microsoft Learn 문서에 따르면 이전 세대인 MAI-Voice-2는 15개 언어, 18개 로캘을 지원했다. 같은 문서에 따르면 음성 복제는 승인을 받아야 쓸 수 있는 기능이고, 동의를 받은 5초에서 60초 길이의 참조 음성을 쓴다. ↩︎
원문은 “45초 분량의 오디오를 생성할 수 있고 종단 간 지연은 150ms”라고만 적었다. 45초가 한 번에 생성할 수 있는 최대 길이인지, 150밀리초가 첫 오디오가 나오기까지의 시간인지는 밝히지 않았다. ↩︎