3줄 요약
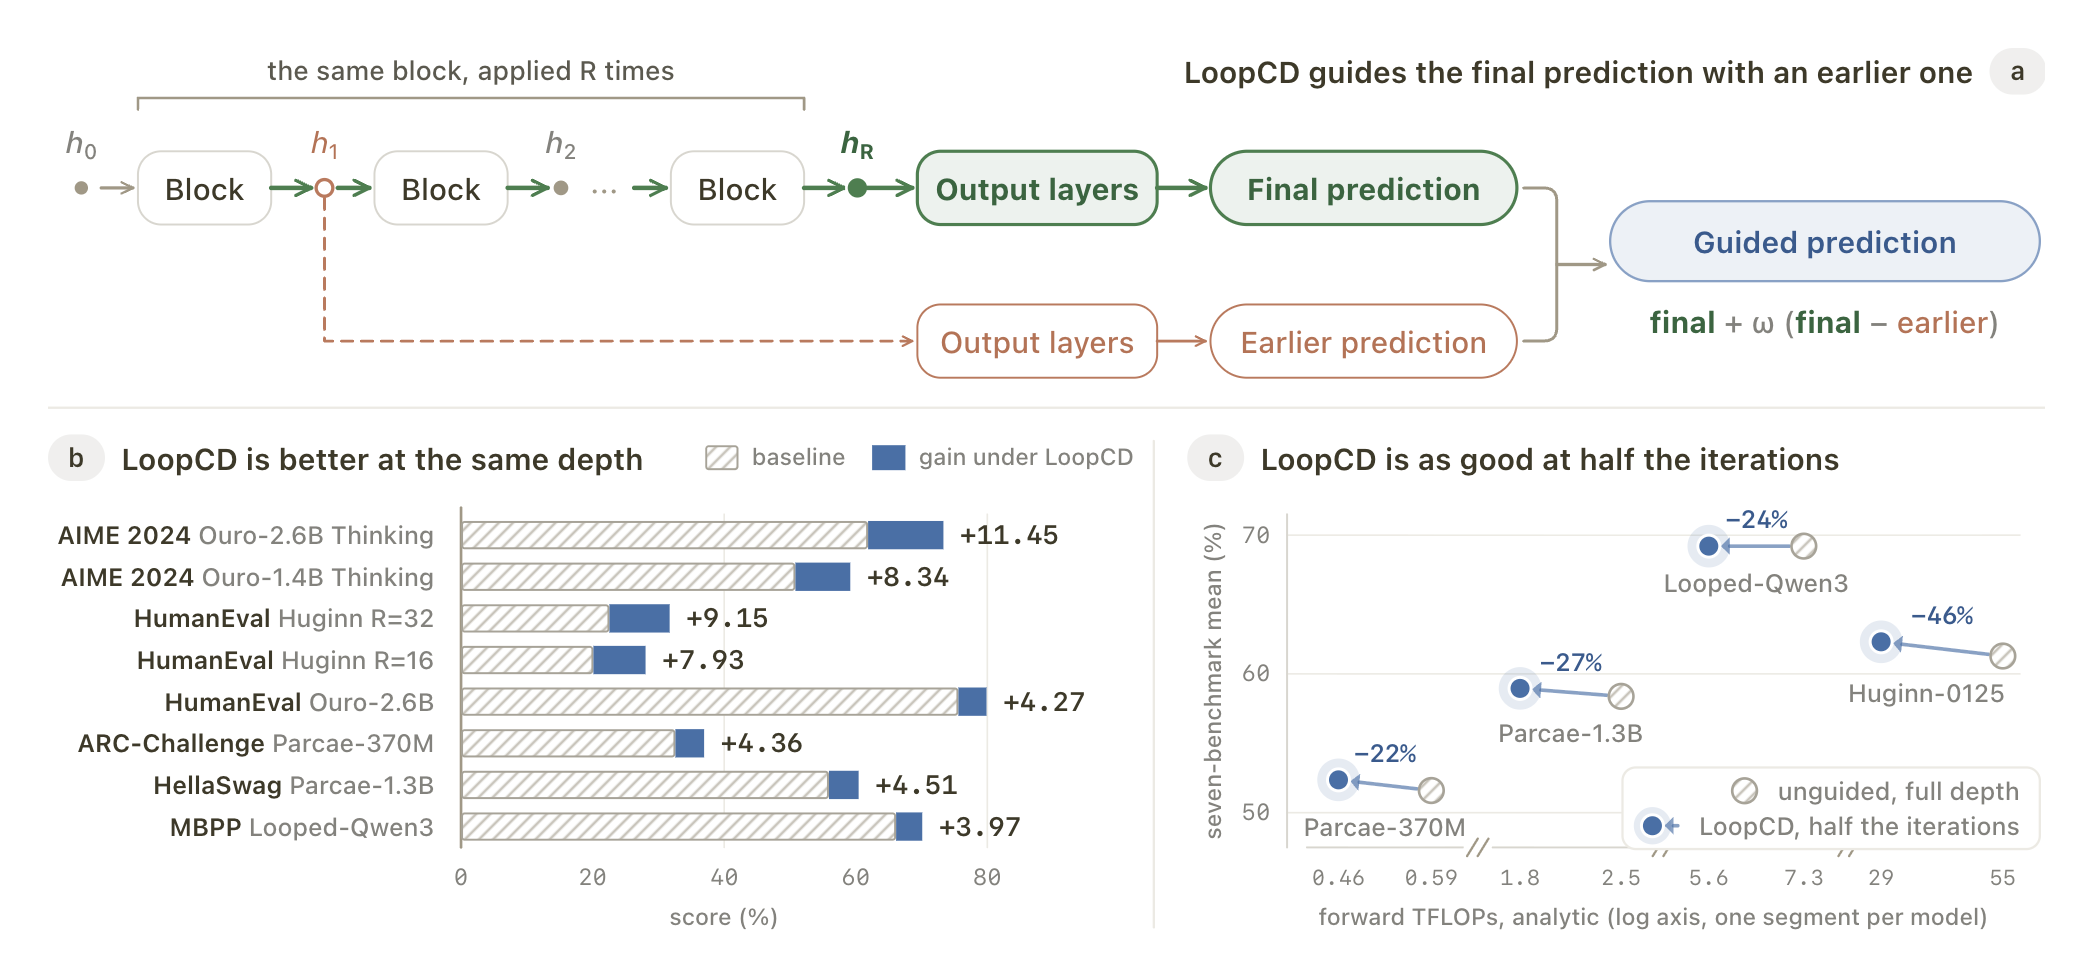
- Apple 연구진이 2026년 10월 1일 arXiv에 공개한 논문이다. 같은 블록을 여러 번 반복 실행하는 루프 트랜스포머를 대상으로, 디코딩 때 쓰이지 않던 중간 반복의 상태를 활용하는 방법 LoopCD를 제안한다.
- LoopCD는 첫 번째 반복의 약한 예측과 마지막 반복의 강한 예측이 얼마나 다른지를 이용해 다음 토큰을 고르며, 추가 학습이 필요 없다. Ouro-2.6B-Thinking의 AIME 2024 pass@1은 61.88%에서 73.33%로 올랐고, Huginn의 HumanEval pass@1은 22.56%에서 31.71%로 높아졌다.
- 반복 횟수를 절반으로 줄인 모델에 LoopCD를 적용하자, 객관식 벤치마크 일곱 종의 평균 점수가 전체 반복으로 돌린 기준 모델과 같거나 더 높았다. 이때 순방향 연산량의 절감폭은 설정에 따라 22.5%에서 48.2% 사이였다.
디코딩에 쓰이지 않던 중간 상태
루프 트랜스포머는 파라미터를 공유하는 블록 하나를 여러 번 반복해서 실행한다. 반복 횟수를 늘리면 저장하는 파라미터 수는 그대로인 채 계산량과 실질 깊이만 늘릴 수 있다.1 입력 문맥이 주어지면 초기 상태 $h_0$에 갱신 $f$를 $R$번 적용한다. 마지막 상태 $h_R$을 뒷단인 코다(coda) 층과 언어 모델 헤드에 통과시키면 다음 토큰의 로짓 $z_R$이 나온다.
$$h_0 \xrightarrow{f} h_1 \xrightarrow{f} \cdots \xrightarrow{f} h_R, \qquad z_R = \mathrm{lm\_head}\bigl(\mathrm{coda}(h_R)\bigr)$$기존 디코딩은 $h_R$에서 나온 분포만 사용한다. 그런데 중간 반복의 상태 $h_1, h_2, \ldots$도 같은 블록이 만든 벡터라서 $h_R$과 표현 공간이 같다. 이 상태를 출력층(코다와 헤드)에 통과시켜 해독하면 다음 토큰의 분포를 얻을 수 있다. 반복을 덜 거친 만큼 이 분포는 마지막 분포보다 약한 예측이다.
연구진은 이 성질을 대조 디코딩(contrastive decoding)과 연결한다. 대조 디코딩은 강한 예측기의 출력을, 같은 입력과 어휘를 공유하는 약한 예측기의 출력과 반대 방향으로 조정하는 기법이다. 확산 모델에서 쓰는 classifier-free guidance도, 같은 네트워크의 성능을 낮춘 판본과 대조하는 autoguidance도 같은 원리다. 일반 언어 모델에서 약한 예측기를 구하려면 별도의 작은 모델이나 교란한 프롬프트, 혹은 중간 층의 출력이 필요했다. 반면 루프 트랜스포머는 반복하는 동안 같은 입력 문맥의 약한 예측과 강한 예측을 차례로 계산한다.
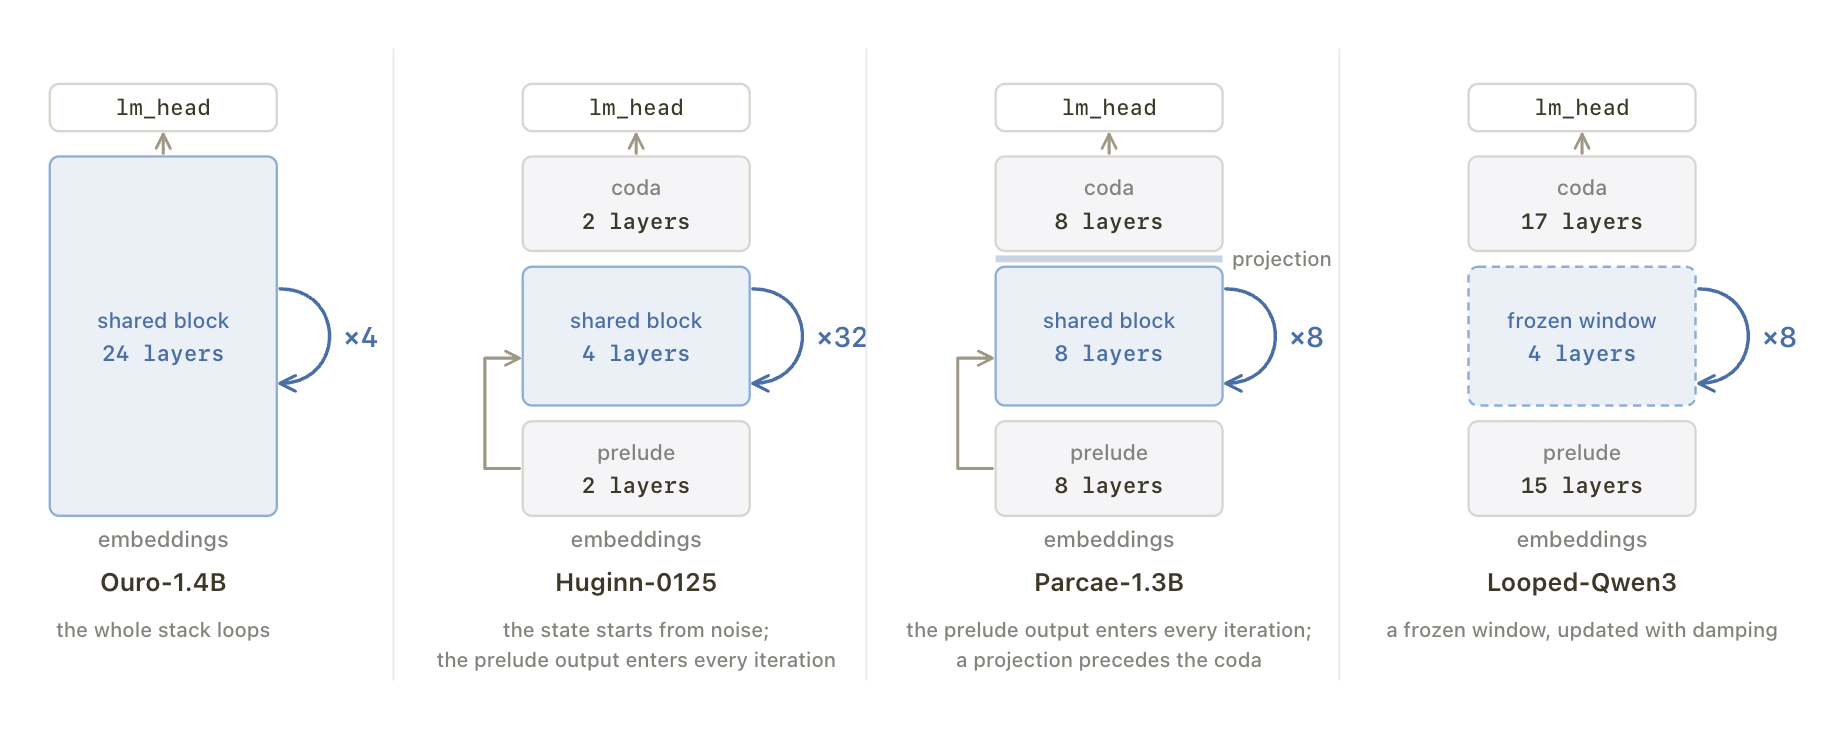 그림 1. 모델 계열마다 반복하는 부분이 다르다. Ouro는 스택 전체를 반복하고, 나머지 세 계열은 고정된 앞단(prelude)과 뒷단(coda) 사이의 공유 블록(파란색)을 반복한다. 출처: 논문 Figure 2
평가에 쓴 네 계열은 반복을 학습한 방식이 서로 다르다.
| 계열 | 반복하는 부분 | 반복을 학습한 방식 | 평가한 반복 수 |
|---|---|---|---|
| Ouro (1.4B, 2.6B) | 디코더 스택 전체 | 매 반복의 출력을 학습 신호로 사용 | 4 |
| Huginn-0125 (3.5B) | 앞단과 뒷단 사이의 공유 블록 | 사전학습 중 반복 깊이를 무작위로 추출 | 32, 16 |
| Parcae (370M, 1.3B) | 앞단과 뒷단 사이의 공유 블록 | 사전학습 중 반복 깊이를 무작위로 추출, 반복 동역학도 학습 | 8 |
| Looped-Qwen3 (Qwen3-4B 기반) | 동결한 중간층 구간 | 반복이 없던 모델에 감쇠 갱신 반복을 사후 적용 | 8 |
LoopCD의 두 가지 형태
LoopCD는 첫 번째 반복의 상태 $h_1$을 약한 참조로, 마지막 상태 $h_R$을 강한 예측으로 삼는다. 그리고 마지막 예측을 참조와 반대 방향으로 외삽한다. 대조를 적용하는 단계에 따라 두 가지 형태가 있다.
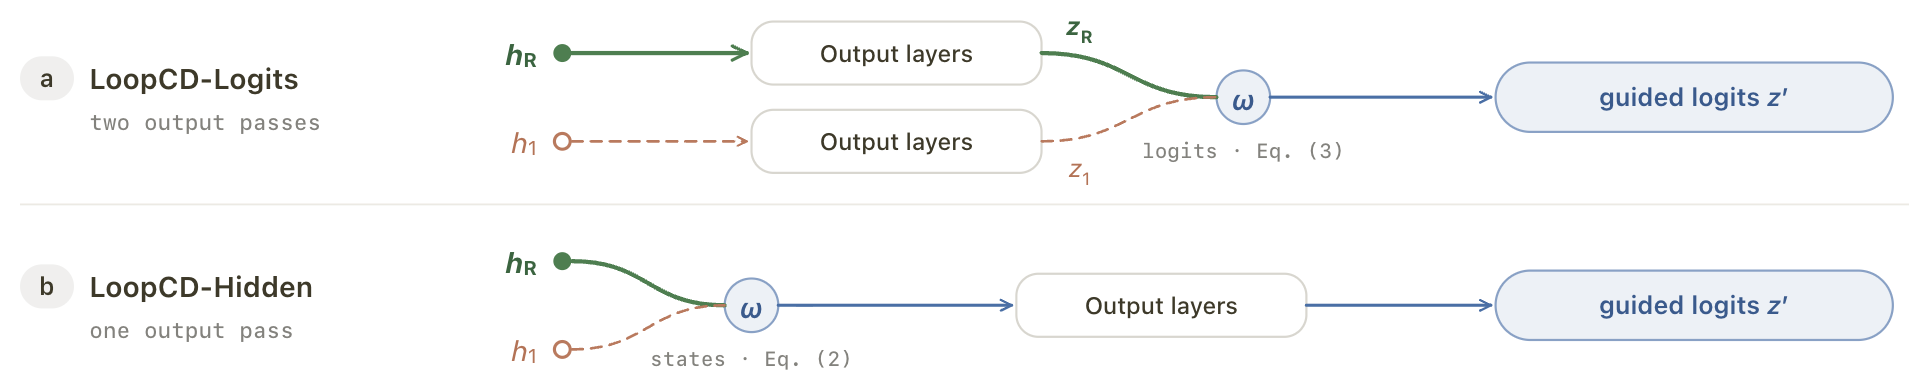 그림 2. LoopCD-Logits는 두 상태를 각각 출력층에 통과시킨 뒤 로짓을 결합하고, LoopCD-Hidden은 두 상태를 먼저 결합한 뒤 출력층을 한 번만 통과시킨다. 출처: 논문 Figure 3
LoopCD-Logits는 두 상태를 각각 코다와 헤드에 통과시켜 로짓을 구한 다음 결합한다. 참조 로짓 $z_1$을 구하려면 출력층을 한 번 더 실행해야 한다.
$$z' = z_R + \omega\,(z_R - z_1)$$LoopCD-Hidden은 코다에 들어가기 전의 은닉 상태를 결합한다. 결합한 상태가 출력층을 한 번만 통과하므로 출력층 연산량은 기준 모델과 같다.
$$h' = h_R + \omega\,(h_R - h_1)$$두 식 모두 $\omega \ge 0$이며, $\omega = 0$이면 기존 디코딩과 같다.
유도 강도 $\omega$를 정하는 규칙도 두 가지다. 고정 강도는 평가 설정 하나에서 모든 토큰에 같은 값을 쓴다. 적응형 강도는 기준 예측 $p_R$에서 상위 두 토큰의 확률 차를 보고 토큰마다 강도를 정한다.
$$\omega = \omega_{\max}\,\bigl[1 - (p_{R,(1)} - p_{R,(2)})\bigr]$$상위 두 후보의 확률이 비슷할수록 강도는 최댓값 $\omega_{\max}$에 가까워지고, 한 후보가 우세할수록 약해진다. 이 규칙은 어휘 전체의 엔트로피 대신 상위 두 후보 사이의 불확실성만 측정한다. LoopCD-Hidden에서 적응형 강도를 쓰려면 $p_R$을 얻어야 하고, 그러자면 출력층을 한 번 더 실행해야 한다. 이 때문에 논문은 적응형 강도를 LoopCD-Logits에만 적용했다.
같은 반복 깊이에서의 성능
첫 번째 실험에서는 기준 모델과 같은 반복 횟수로 LoopCD를 적용했다. 체크포인트와 프롬프트는 동일하다.
수학 추론에서는 Ouro-Thinking 두 모델의 점수가 모든 벤치마크에서 올랐다. 아래 표의 값은 문제마다 16개씩 샘플링해 구한 pass@1(%)이다.
| 모델 | 벤치마크 | 기준 | LoopCD 고정 | LoopCD 적응형 |
|---|---|---|---|---|
| Ouro-1.4B-Thinking | AIME 2024 | 50.83 | 56.88 | 59.17 |
| AIME 2025 | 38.96 | 46.25 | 47.08 | |
| OlympiadBench | 61.27 | 63.75 | 63.48 | |
| Ouro-2.6B-Thinking | AIME 2024 | 61.88 | 70.62 | 73.33 |
| AIME 2025 | 49.58 | 58.33 | 56.88 | |
| OlympiadBench | 64.05 | 66.66 | 67.29 |
세 벤치마크 평균의 상승폭은 모델과 강도 규칙에 따라 pass@1이 5.27점에서 7.33점 사이, pass@10이 2.53점에서 4.12점 사이였다. Ouro-2.6B에서 LoopCD-Logits의 연산량은 기준 모델의 1.010배이므로, AIME 2024 점수를 11.45점 올리는 데 순방향 연산이 1% 남짓 더 들었다.2
코드 생성은 HumanEval과 MBPP를 EvalPlus의 기본 테스트와 확장 테스트로 평가했다. 두 벤치마크의 기본과 확장 점수 네 개를 평균하면 모든 설정에서 점수가 높아졌다.
| 설정 | 네 점수 평균 변화, 고정 | 네 점수 평균 변화, 적응형 |
|---|---|---|
| Ouro-1.4B | +0.37 | +1.27 |
| Ouro-2.6B | +1.09 | +2.54 |
| Huginn-0125, R=32 | +3.97 | +2.57 |
| Huginn-0125, R=16 | +3.04 | +3.90 |
| Looped-Qwen3 | +1.42 | +1.41 |
상승폭은 Huginn에서 가장 컸다. R=32에서 적응형 LoopCD-Logits는 HumanEval pass@1을 23.17%에서 28.66%로 높였다. 로짓 대신 은닉 상태를 결합하는 LoopCD-Hidden은 22.56%에서 31.71%로 더 높였고3, 네 점수 평균 상승폭도 5.13점으로 LoopCD-Logits의 고정 강도와 적응형 강도보다 컸다. 개별 점수 가운데는 기준보다 낮아진 값도 있다. 예를 들어 Ouro-1.4B의 MBPP 기본 테스트는 고정 강도에서 73.28%가 72.75%로 내려갔다.
객관식 일곱 종(ARC-Challenge, ARC-Easy, SciQ, MMLU, HellaSwag, WinoGrande, PIQA)은 보기마다 모델이 매기는 확률을 계산해 답을 고르는 방식으로 평가했다. LoopCD-Logits는 모든 모델의 일곱 종 평균을 높였다.
| 모델 | 고정 | 적응형 |
|---|---|---|
| Ouro-1.4B | +0.58 | +0.29 |
| Ouro-2.6B | +0.84 | +0.95 |
| Huginn-0125, R=32 | +0.74 | +0.86 |
| Huginn-0125, R=16 | +0.62 | +0.63 |
| Parcae-370M | +0.90 | +1.29 |
| Parcae-1.3B | +1.38 | +1.59 |
| Looped-Qwen3 | +0.32 | +0.79 |
벤치마크별로 보면 WinoGrande에서는 Ouro 두 모델의 점수가 고정 강도와 적응형 강도 모두에서 낮아졌다. 한편 고정 강도의 LoopCD-Hidden은 Huginn의 R=32에서 0.83점, R=16에서 0.75점 올라, 같은 조건의 LoopCD-Logits(0.74점, 0.62점)보다 상승폭이 컸다. Parcae-1.3B에서는 0.85점 올라 고정 강도 LoopCD-Logits의 1.38점보다 작았다.
네 계열은 반복을 학습한 방식이 서로 다른데도 모두 점수가 올랐고, 연구진은 이 결과를 LoopCD의 효과가 특정 학습 목표에 의존하지 않는다는 근거로 삼았다. Huginn의 제로샷부터 Ouro의 25샷까지 프롬프트 형식이 달라도, MMLU-Pro에서 생각의 사슬을 생성하게 해도 개선은 유지됐다.
반복을 절반으로 줄였을 때
같은 깊이에서 점수가 오르자, 연구진은 LoopCD가 반복 일부를 대신할 수 있는지 시험했다. 이 실험은 객관식 일곱 종으로만 진행했다.
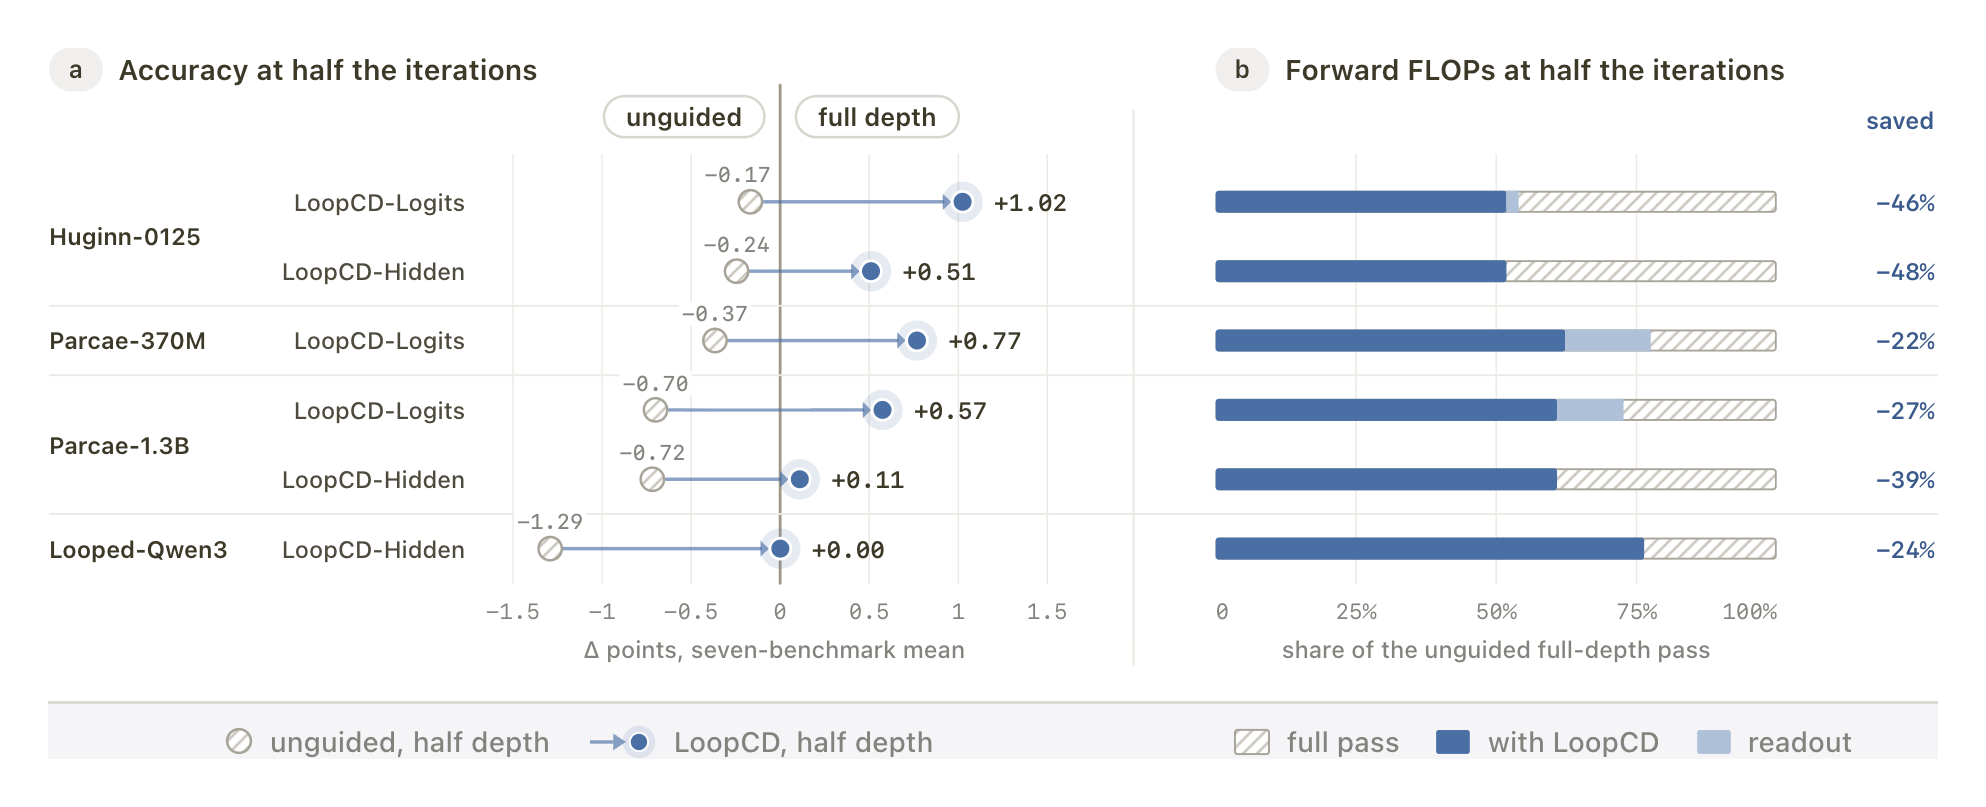 그림 3. (a)는 전체 반복으로 돌린 기준 모델 대비 일곱 종 평균의 변화다. 회색 원은 반복을 절반으로 줄인 기준 모델, 파란 점은 같은 조건에 LoopCD를 적용한 결과다. (b)는 절반 반복의 순방향 연산량을 전체 반복 기준 모델 대비 비율로 표시했고, 연한 파란색 막대는 LoopCD-Logits가 출력층을 한 번 더 실행하는 비용을 나타낸다. 출처: 논문 Figure 4
반복을 절반으로 줄이면 LoopCD를 쓰지 않은 모델의 일곱 종 평균이 낮아졌고, 그 폭은 설정에 따라 0.17점에서 1.29점 사이였다. 절반 반복 모델에 LoopCD를 적용하자 여섯 설정 모두 전체 반복으로 돌린 기준 모델과 같거나 높은 점수를 냈다.4
| 설정 | 반복 수 | 절반 반복, LoopCD 없음 | 절반 반복, LoopCD 적용 | 연산량 비율 | 절감률 |
|---|---|---|---|---|---|
| Huginn-0125, Logits | 32 → 16 | −0.17 | +1.02 | 0.54 | 46.0% |
| Huginn-0125, Hidden | 32 → 16 | −0.24 | +0.51 | 0.52 | 48.2% |
| Parcae-370M, Logits | 8 → 4 | −0.37 | +0.77 | 0.78 | 22.5% |
| Parcae-1.3B, Logits | 8 → 4 | −0.70 | +0.57 | 0.73 | 27.3% |
| Parcae-1.3B, Hidden | 8 → 4 | −0.72 | +0.11 | 0.61 | 39.2% |
| Looped-Qwen3, Hidden | 8 → 4 | −1.29 | +0.00 | 0.76 | 23.6% |
점수는 전체 반복으로 돌린 기준 모델 대비 일곱 종 평균의 변화(점)이고, 연산량 비율은 그 기준 모델의 순방향 연산을 1로 둔 값이다.
절감률은 모델 구조에 따라 달라진다. 반복 횟수를 줄여 아낄 수 있는 연산은 전체 연산 가운데 반복 블록이 차지하는 몫으로 한정된다. 반면 LoopCD-Logits의 추가 비용은 반복 블록 뒤에 있는 코다와 헤드의 크기로 정해진다. LoopCD-Logits를 쓰면 연산량이 Ouro-2.6B에서 기준의 1.010배, Huginn(R=32)에서 1.022배로 거의 늘지 않았다. Parcae-370M에서는 1.152배, Looped-Qwen3에서는 1.306배까지 늘었다. Looped-Qwen3는 반복하지 않는 층의 비중이 커서 출력층을 한 번 더 실행하는 비용이 반복을 줄여 아낀 연산보다 크다. 그래서 이 모델의 연산을 줄이는 데는 LoopCD-Hidden만 쓸 수 있었다.
LoopCD가 효과를 내는 이유
첫 반복의 예측은 마지막 예측과 크게 다르다
첫 번째 반복만으로 예측하면 일곱 종 평균 정확도가 마지막 반복의 정확도보다 낮고, 그 폭은 모델에 따라 4.0점에서 23.7점 사이다. 정확도는 반복을 거칠수록 꾸준히 오른다.
예측은 초반 반복에서 크게 바뀌고 후반 반복에서는 거의 바뀌지 않는다. Ouro-1.4B는 최종 예측과의 젠슨-섀넌 발산이 첫 반복 뒤 0.71비트였다가 세 번째 반복 뒤 0.013비트로 줄었다. Huginn은 최종 예측과의 쿨백-라이블러 발산이 첫 반복 뒤 3.0나트였다가 16번째 반복 뒤 0.04나트로 줄었다.
LoopCD의 이득은 참조 예측이 최종 예측과 얼마나 다른지에 비례한다. Huginn의 첫 반복은 ARC-Challenge 문제의 51%에서 최종 예측과 다른 보기를 골랐다. 이 반복을 참조로 쓰면 $\omega=0.5$에서 정확도가 3.07점 올랐다. 16번째 반복은 7%에서만 최종 예측과 달랐고, 참조로 썼을 때의 이득은 0.17점에 그쳤다. 논문의 설명에 따르면 참조가 주는 정보는 예측이 바뀌어 온 방향이다. 이미 최종 상태로 수렴한 후반 반복의 예측은 최종 예측과 거의 같아서 이 방향 정보를 거의 주지 못한다.
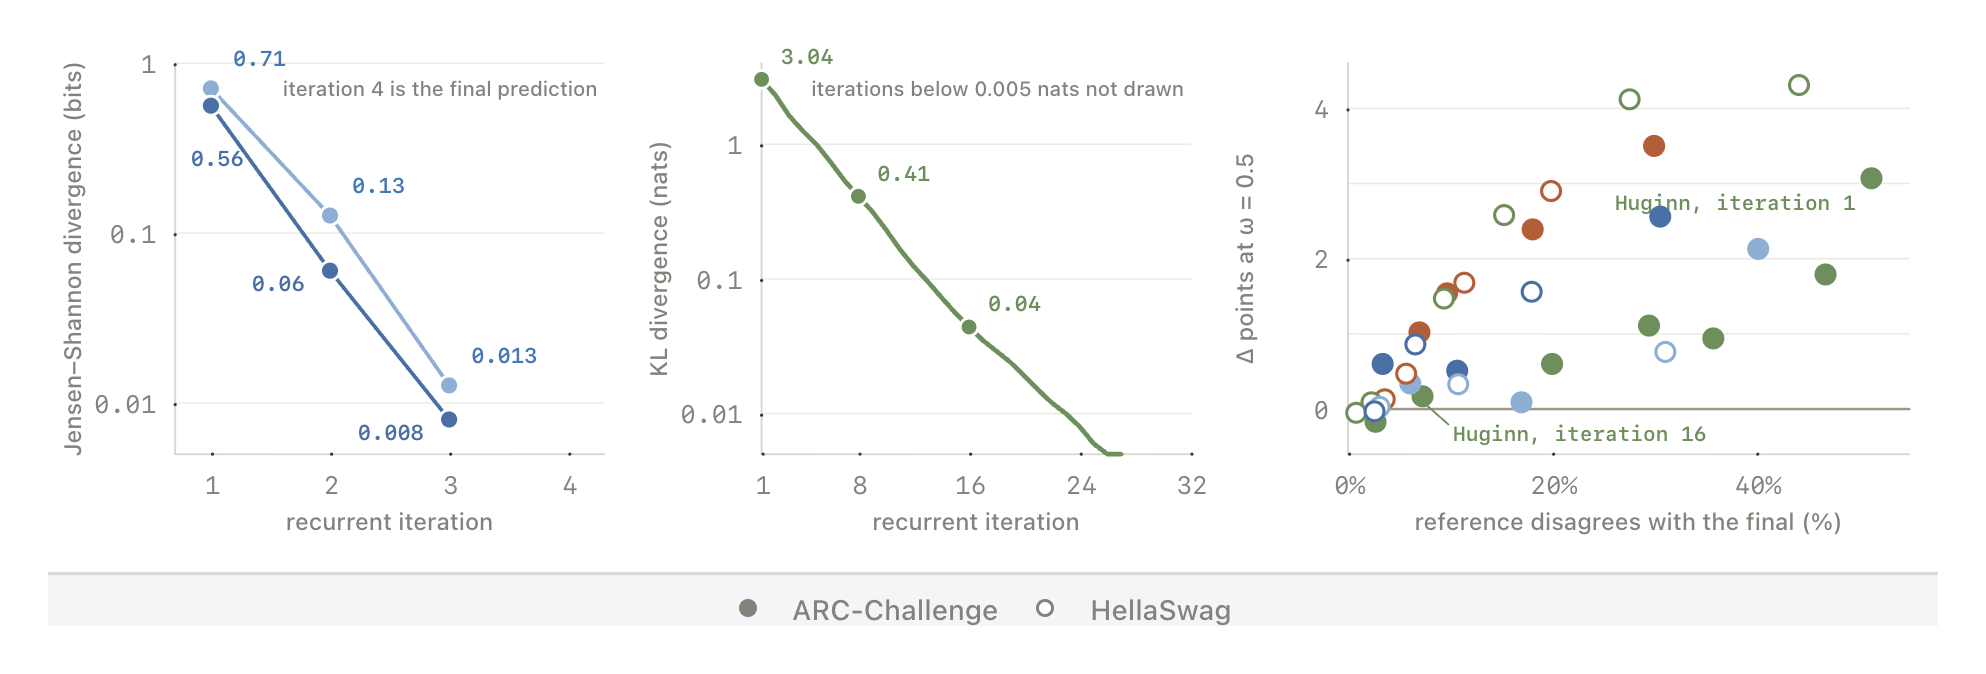 그림 4. (a)와 (b)는 각각 Ouro와 Huginn에서 반복마다 최종 예측과의 발산을 측정한 결과다. (c)는 참조가 최종 예측과 다른 보기를 고른 문항의 비율과 LoopCD-Logits의 이득(ω=0.5)을 비교하며, 채운 점은 ARC-Challenge, 빈 점은 HellaSwag 결과다. 출처: 논문 Figure 6
같은 이유로 LoopCD-Logits는 모든 모델에서 첫 반복을 참조로 쓸 때 이득이 가장 컸다. 참조로 쓰는 반복의 순번이 커질수록 ARC-Challenge 이득은 Huginn이 3.07점에서 0.17점으로, Parcae-1.3B가 3.50점에서 1.02점으로 줄었다.
Huginn에 LoopCD-Hidden을 적용한 경우는 예외였다. Huginn은 가우스 잡음에서 반복을 시작한다. 로짓으로 변환할 때는 코다가 이 잡음을 제거하지만, 은닉 상태끼리 직접 빼면 잡음이 그대로 남는다. 이 때문에 초반 반복을 참조로 썼을 때 일곱 종 평균이 0.58점 낮아졌고, 여섯 번째 반복을 참조로 썼을 때 0.83점 올라 가장 높았다. 결정론적 표현에서 시작하는 Parcae와 Looped-Qwen3는 두 형태 모두 첫 반복을 참조로 쓸 수 있었다.
이득은 순위 재조정에서 나온다
대조 벡터 $z_R - z_1$은 $z_R$과 평행한 성분, 그리고 직교하는 성분으로 분해할 수 있다. 평행 성분은 로짓 전체에 같은 배율을 곱하는 것과 같아서 온도 조절에 해당하고, 토큰 순위를 바꾸지 않는다. 직교 성분은 토큰 사이의 상대적 차이를 바꿔 순위를 재조정한다. HellaSwag에서 $\omega=0.5$일 때 직교 성분만 적용한 결과가 대조 벡터 전체를 적용한 결과보다 높았다. Ouro-1.4B는 1.72점 대 0.76점, Ouro-2.6B는 2.27점 대 1.56점 올랐다.
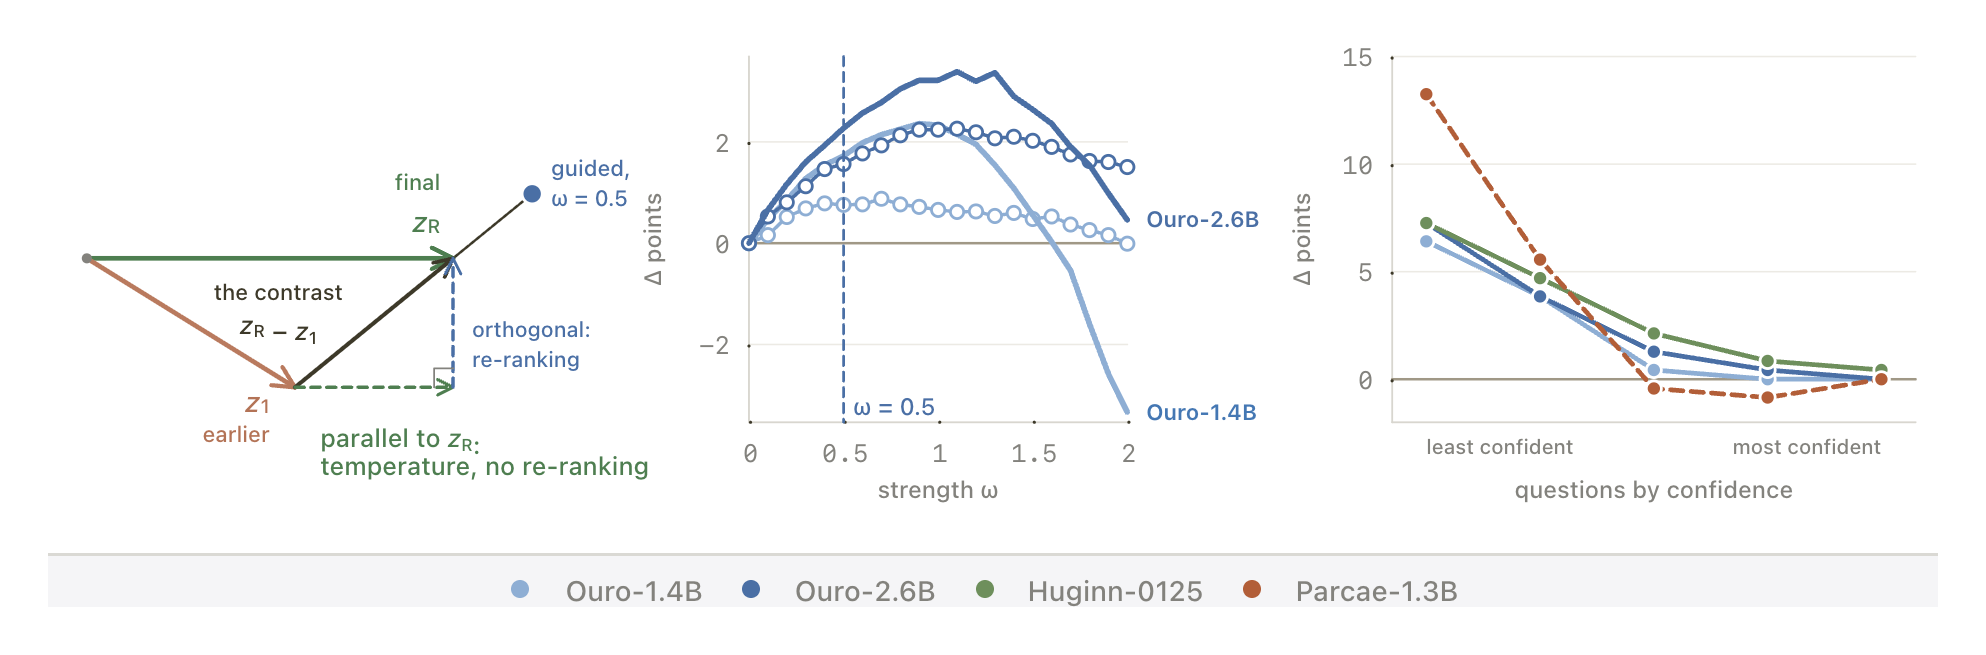 그림 5. (a)는 대조 벡터를 온도 조절에 해당하는 평행 성분과 순위를 바꾸는 직교 성분으로 분해한 도식이다. (b)는 HellaSwag에서 강도에 따른 Ouro 두 모델의 정확도 변화로, 직교 성분만 적용한 결과와 대조 벡터 전체를 적용한 결과를 비교한다. (c)는 ARC-Challenge 문항을 기준 예측의 확신도에 따라 다섯 묶음으로 구분했을 때 묶음별 정확도 변화다(ω=0.5, 네 모델). 출처: 논문 Figure 8
순위 재조정이 답을 바꾸는 경우는 대조가 더하는 변화가 상위 두 후보의 확률 차보다 클 때뿐이다. 확신이 높은 결정은 그대로 유지되고, 비슷한 후보 사이에서 망설이던 결정만 바뀐다. ARC-Challenge 문항을 기준 예측의 확신도로 다섯 묶음으로 구분하면, 확신이 가장 낮은 묶음에서는 네 모델 모두 정확도가 올랐고 상승폭은 모델에 따라 6.4점에서 13.3점 사이였다. 확신이 가장 높은 묶음에서는 상승폭이 많아야 0.4점이었다. 답이 바뀐 문항은 모델에 따라 전체의 5.8%에서 14.9% 사이였고, 순이득은 2.1점에서 3.5점 사이였다. 적응형 강도가 확률 차가 작은 토큰에 높은 강도를 주는 것도 이 결과에 근거한 설계다.
생성 과제는 객관식보다 작은 강도가 필요하다
객관식 채점에서는 강도를 넓은 범위에서 바꿔도 이득이 유지되며, $\omega=0.5$ 근처에서 이득이 가장 크다. 자기회귀 생성에서는 $\omega$가 0.2에서 0.3 사이일 때만 이득이 생기고, $\omega$가 0.6보다 커지면 점수가 가파르게 떨어진다. 예를 들어 Ouro-1.4B의 GSM8K 점수는 $\omega=0.8$에서 8점, $\omega=1.0$에서 20점 낮아졌다. 논문은 그 원인으로, 생성 초반에 바뀐 토큰이 뒤이어 생성되는 모든 토큰에 영향을 주어 오류가 누적된다는 점을 들었다. $\omega$를 음수로 두어 약한 참조와 같은 방향으로 외삽하면 두 과제 모두 정확도가 낮아졌다.
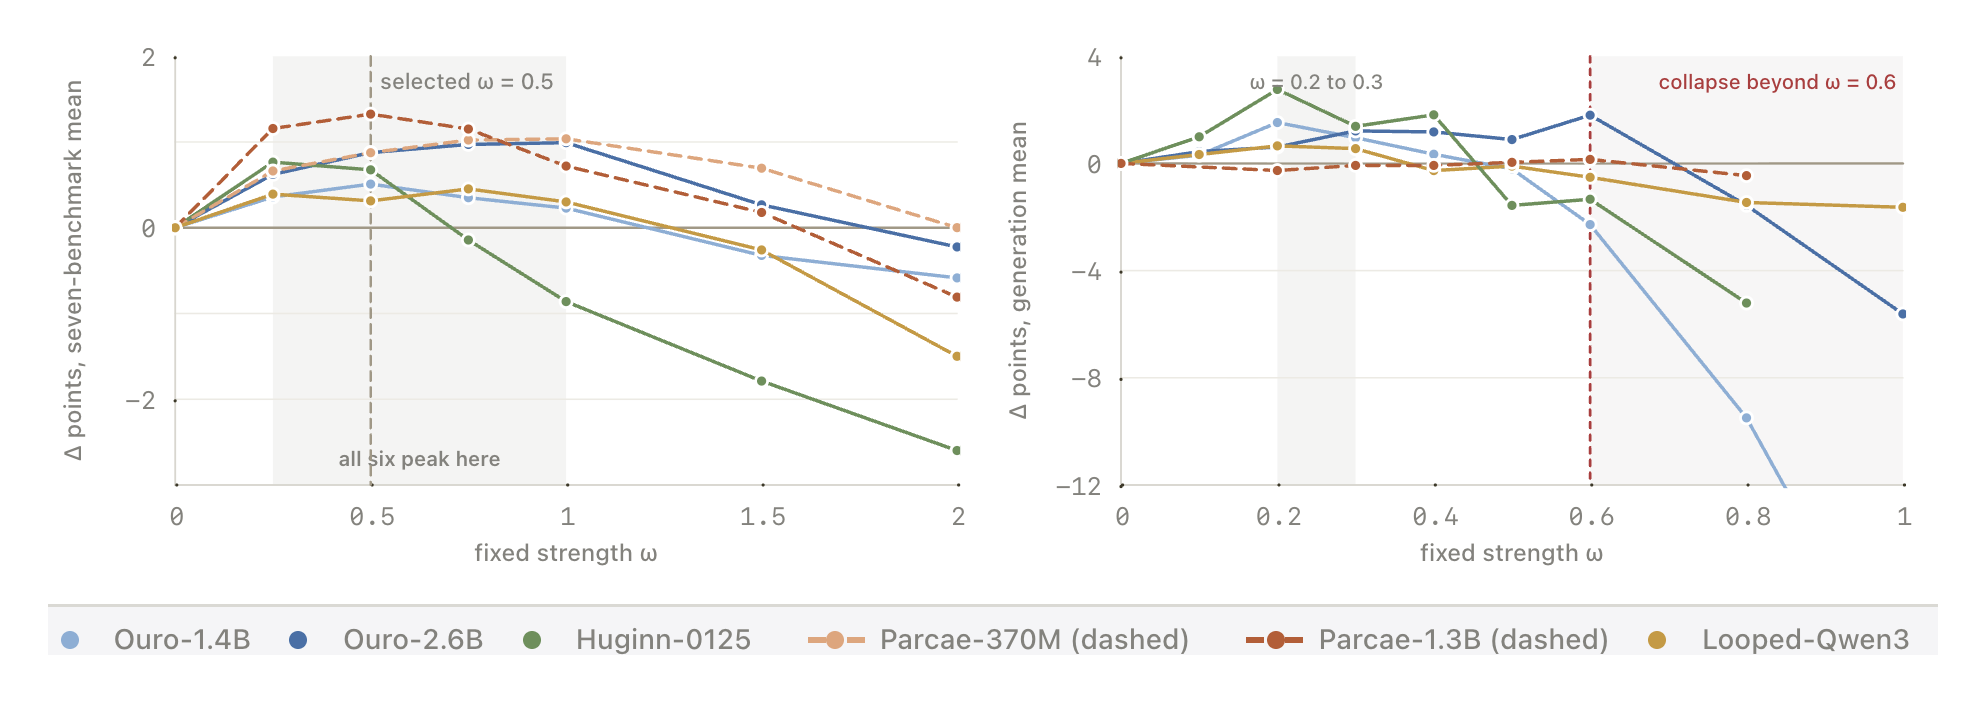 그림 6. 고정 강도에 따른 정확도 변화다. (a)는 객관식 일곱 종 평균(여섯 모델)이며 점선은 선택한 값 ω=0.5를 표시한다. (b)는 생성 과제 평균(다섯 모델)이며 음영 구간은 선택한 0.2에서 0.3 범위다. 출처: 논문 Figure 9
적응형 강도는 확률 차가 큰 토큰에는 대조를 거의 적용하지 않으므로, 확신이 높은 결정이 대조 때문에 바뀌는 일을 막는다. 여섯 모델 평균으로 보면 고정 강도와 적응형 강도 모두 0.5에서 이득이 가장 컸다. 강도를 1.0까지 높이자 고정 강도의 이득은 절반가량으로 줄었지만, 적응형 강도의 이득은 거의 줄지 않았다. 강도가 1.5 이상인 구간에서는 고정 강도의 점수가 기준보다 낮아졌고, 적응형 강도는 2.0에서도 기준보다 조금 높았다.
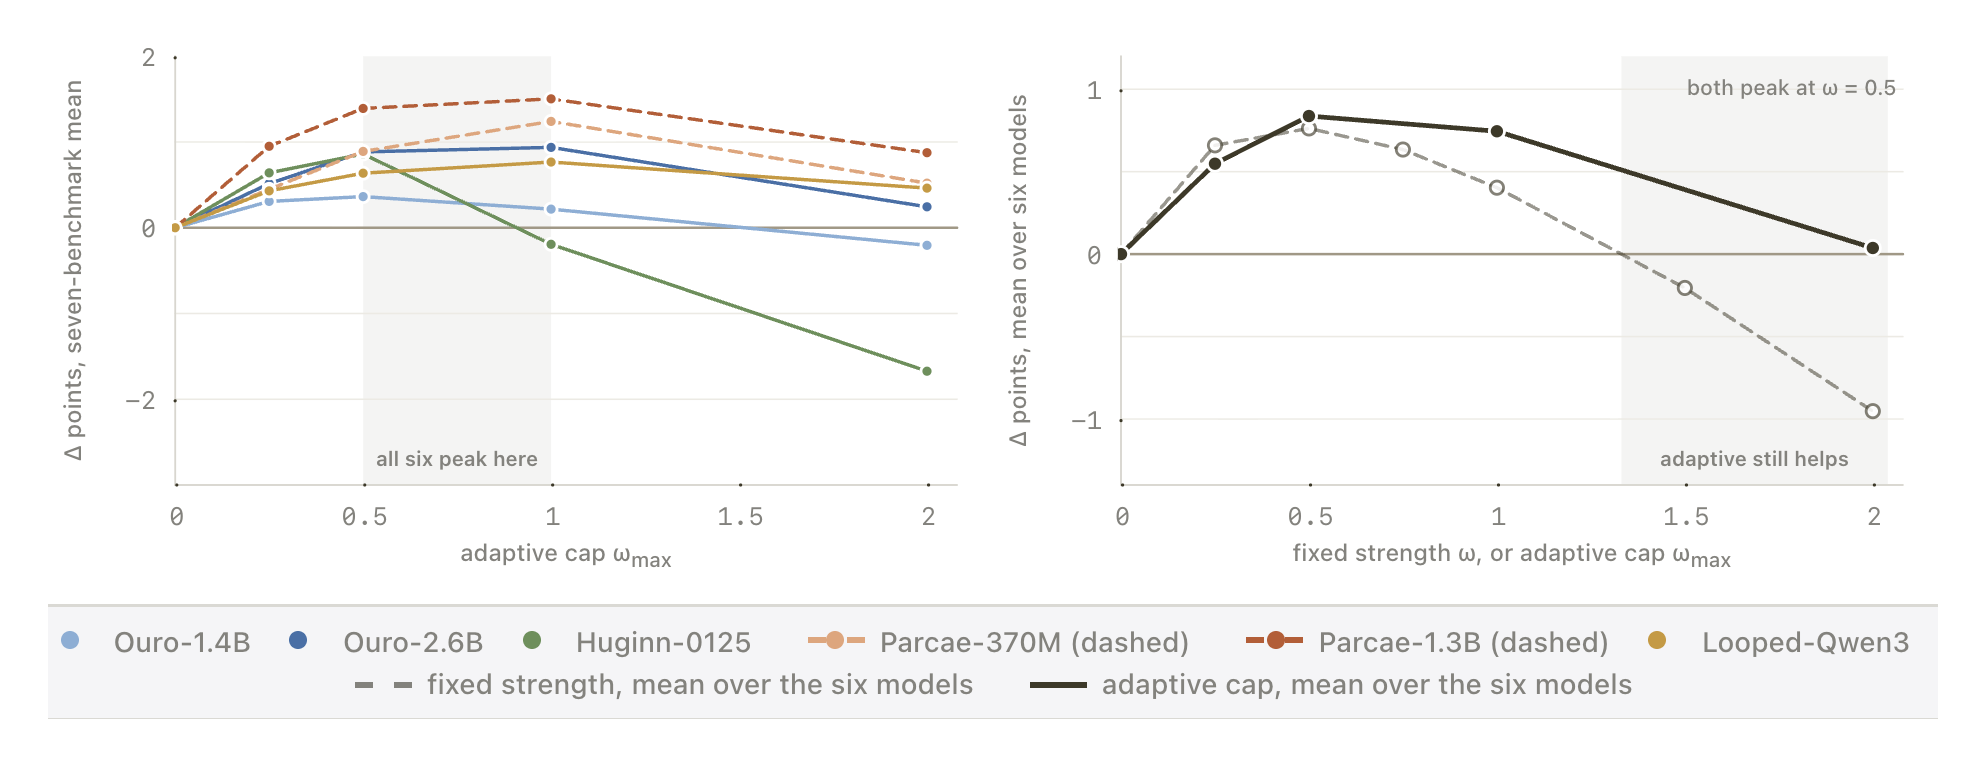 그림 7. (a)는 적응형 강도의 최댓값 ω_max에 따른 모델별 일곱 종 평균의 변화이며, 음영 구간(0.5에서 1.0)에서 여섯 모델 모두 이득이 가장 크다. (b)는 여섯 모델 평균을 고정 강도(점선)와 적응형 강도(실선)로 비교한다. 출처: 논문 Figure 10
가장 흥미로운 지점
LoopCD는 새로운 정보를 하나도 만들어 내지 않는데도 점수를 올린다. 처음 읽을 때 나는 이 대목을 의외라고 생각했다. LoopCD가 쓰는 첫 반복의 상태는 모델이 원래 계산하던 값이며, 기존 디코딩에서는 이 값이 다음 반복의 입력으로만 쓰였다. 연구진이 결론에 적은 설명도 단순하다. 반복은 예측을 초반에 대부분 확정하지만 일부 결정은 후보 간 확률 차가 작은 상태로 남는다. 첫 반복의 예측과 마지막 예측의 차이는 그사이 예측이 바뀐 방향을 나타내고, LoopCD는 그 방향을 한 번 더 연장해 반복이 확률을 높여 가던 후보를 고르게 한다.
이 설명대로라면 이득의 크기는 반복을 거치며 예측이 얼마나 많이 바뀌는지에 달려 있다. Huginn처럼 첫 반복과 마지막 반복이 절반 이상의 문항에서 다른 답을 고르는 모델에서는 효과가 크고, 첫 반복에서 이미 답이 거의 정해지는 설정에서는 효과가 작다. 연구진은 Ouro처럼 중간 예측까지 학습 신호로 쓰는 모델이라면 약한 예측과 강한 예측의 쌍이 더 유용할 수 있다고 덧붙였다.
반복을 절반으로 줄인 실험에서 LoopCD는 반복이 줄어 생긴 성능 하락을 회복했다. 이 결과를 보면 루프 모델에서는 반복 횟수와 디코딩 규칙을 함께 고려해 정해야 한다. 나는 이 논문을 읽고서야 두 결정이 연결되어 있다는 것을 알았다.
출처
Weihao Liu, Huangjie Zheng, Tianrong Chen, Rohit Dilip, Richard He Bai, Yizhu Jiao, Yuyang Wang, Ruixiang Zhang (Apple). “Decoding Looped Transformers Better for (Almost) Free”. arXiv:2610.02185, 2026년 10월 1일. 제1저자는 Apple 인턴십 기간에 이 연구를 진행했다.
원문: https://arxiv.org/abs/2610.02185
소개 트윗: https://x.com/mylifcc/status/21072912502402380065
그림은 모두 논문 HTML판에서 인용했다.
루프 트랜스포머의 구조와 Ouro, Huginn 같은 사례는 GPT-6 Astra, Looped Transformers, and Hidden Reasoning 다이제스트에 정리했다. ↩︎
논문의 연산량은 512토큰 프리필 한 번을 기준으로 행렬곱의 곱셈과 덧셈을 센 이론값이다. 논문은 이 값이 실제 실행 시간의 단축과 같지 않다고 밝혔다. ↩︎
논문의 LoopCD-Hidden 표에 실린 기준 점수(22.56%)는 LoopCD-Logits 표의 기준 점수(23.17%)와 다르다. 논문은 두 형태를 각자의 기준 모델과 비교했다. ↩︎
절반 반복의 Huginn은 첫 반복 대신 LoopCD-Logits에서 다섯 번째, LoopCD-Hidden에서 여섯 번째 반복의 상태를 참조로 썼다. 나머지 설정은 첫 반복을 참조로 썼다. ↩︎
소개 트윗은 연산 47% 절감과 수학 pass@1 11점 상승을 하나의 결과처럼 함께 적었다. 논문에서 AIME 2024의 11.45점 상승은 Ouro-2.6B-Thinking을 전체 반복으로 돌린 실험에서 나왔다. 연산 절감(최대 48.2%)은 Huginn, Parcae, Looped-Qwen3의 반복을 절반으로 줄인 객관식 평가에서 나왔다. ↩︎