3줄 요약
- 메이퇀 LongCat 팀이 2025년 10월 25일 공개한 LongCat-Video는 136억 매개변수의 영상 생성 모델이다.
- 기존 영상의 후속 장면을 만드는 과제를 사전학습했다. 분 단위 영상 생성과 생성 도중 지시 변경을 지원한다.
- 코드와 가중치는 MIT 라이선스로 공개했다. 자체 평가에서 텍스트 기반 생성은 Wan 2.2보다 종합 점수가 높았다. 이미지 기반 생성은 화질 점수가 높고 움직임 점수가 낮았다.1
입력으로 주는 프레임
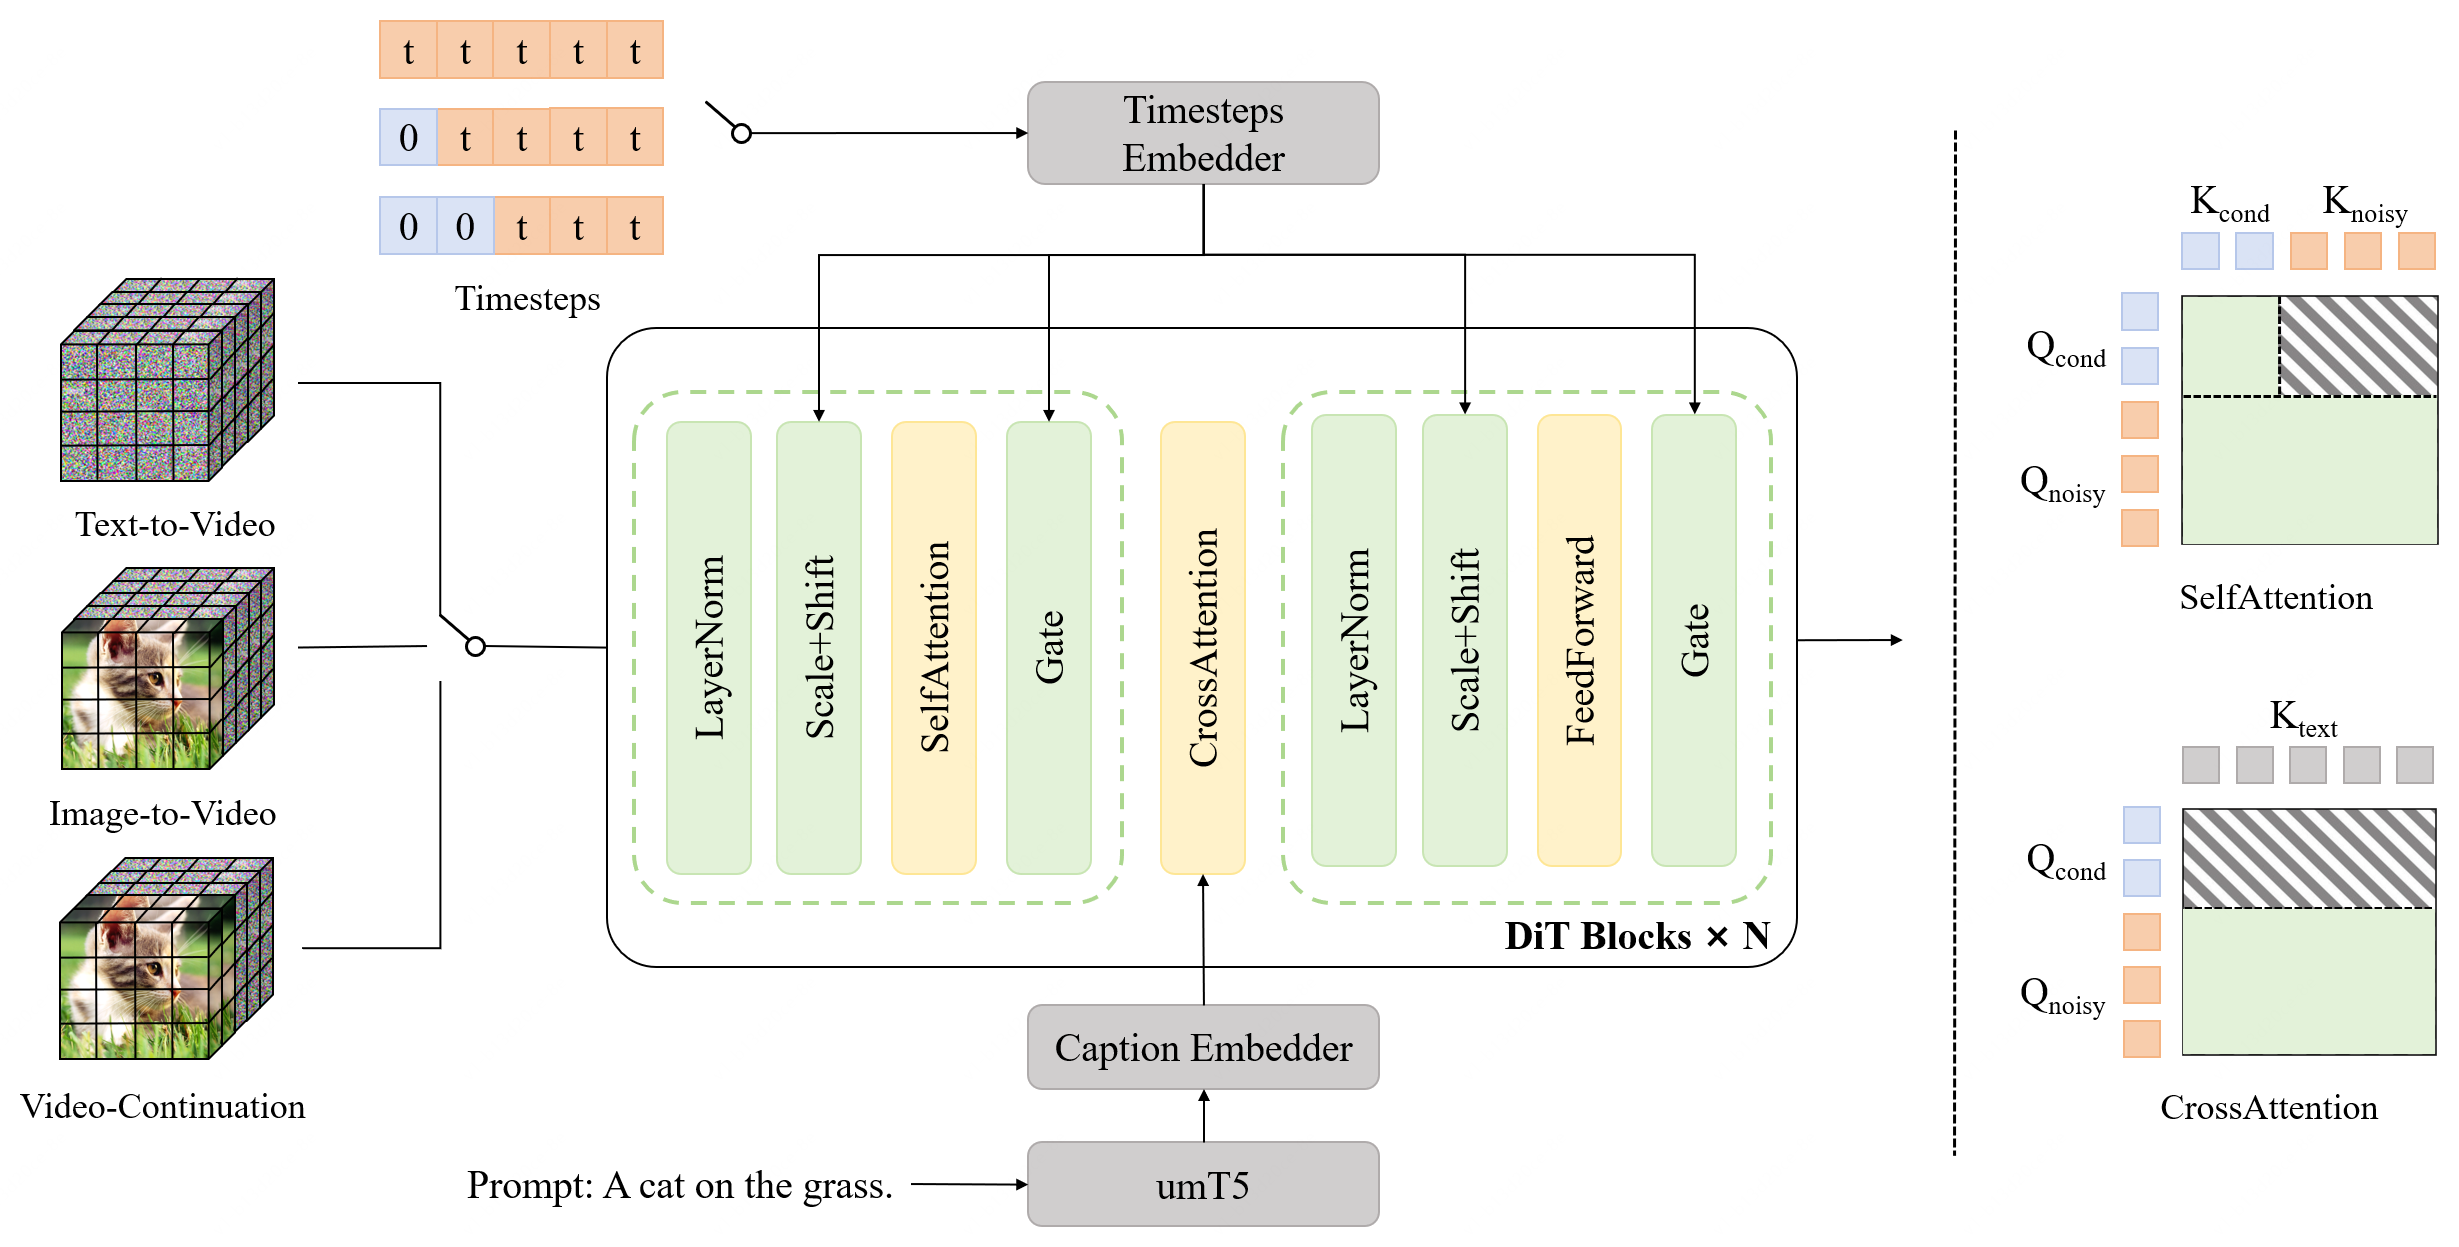
LongCat-Video는 확산 트랜스포머(DiT)를 사용한다. 세 가지 생성 방식의 차이는 입력으로 제공하는 조건 프레임의 수다.2
| 생성 방식 | 조건 프레임 | 하는 일 |
|---|---|---|
| 텍스트 기반 생성 | 0장 | 글로 묘사한 영상을 생성한다 |
| 이미지 기반 생성 | 1장 | 참고 이미지 이후의 장면을 생성한다 |
| 영상 이어 만들기 | 여러 장 | 이전 장면을 참고해 후속 장면을 생성한다 |
팀은 영상 이어 만들기를 사전학습 과제에 포함했다. 공식 소개에 따르면 약 5분 길이의 영상을 연속으로 생성할 수 있다.3 프로젝트 페이지에는 긴 영상과 여러 지시를 순서대로 적용한 생성 예제가 공개돼 있다.4
모델은 이미 제공된 조건 프레임을 고정하고 새 프레임을 생성한다. 조건 프레임의 어텐션 계산 결과를 캐시에 보관해 샘플링 단계마다 재사용한다.2
720p까지의 생성 과정
고해상도 생성에 필요한 계산량을 줄이기 위해 먼저 480p, 초당 15프레임 영상을 만든다. 이후 해상도와 프레임 수를 늘린다. LoRA로 학습한 보정 모듈을 적용해 720p, 초당 30프레임 영상을 완성한다.3
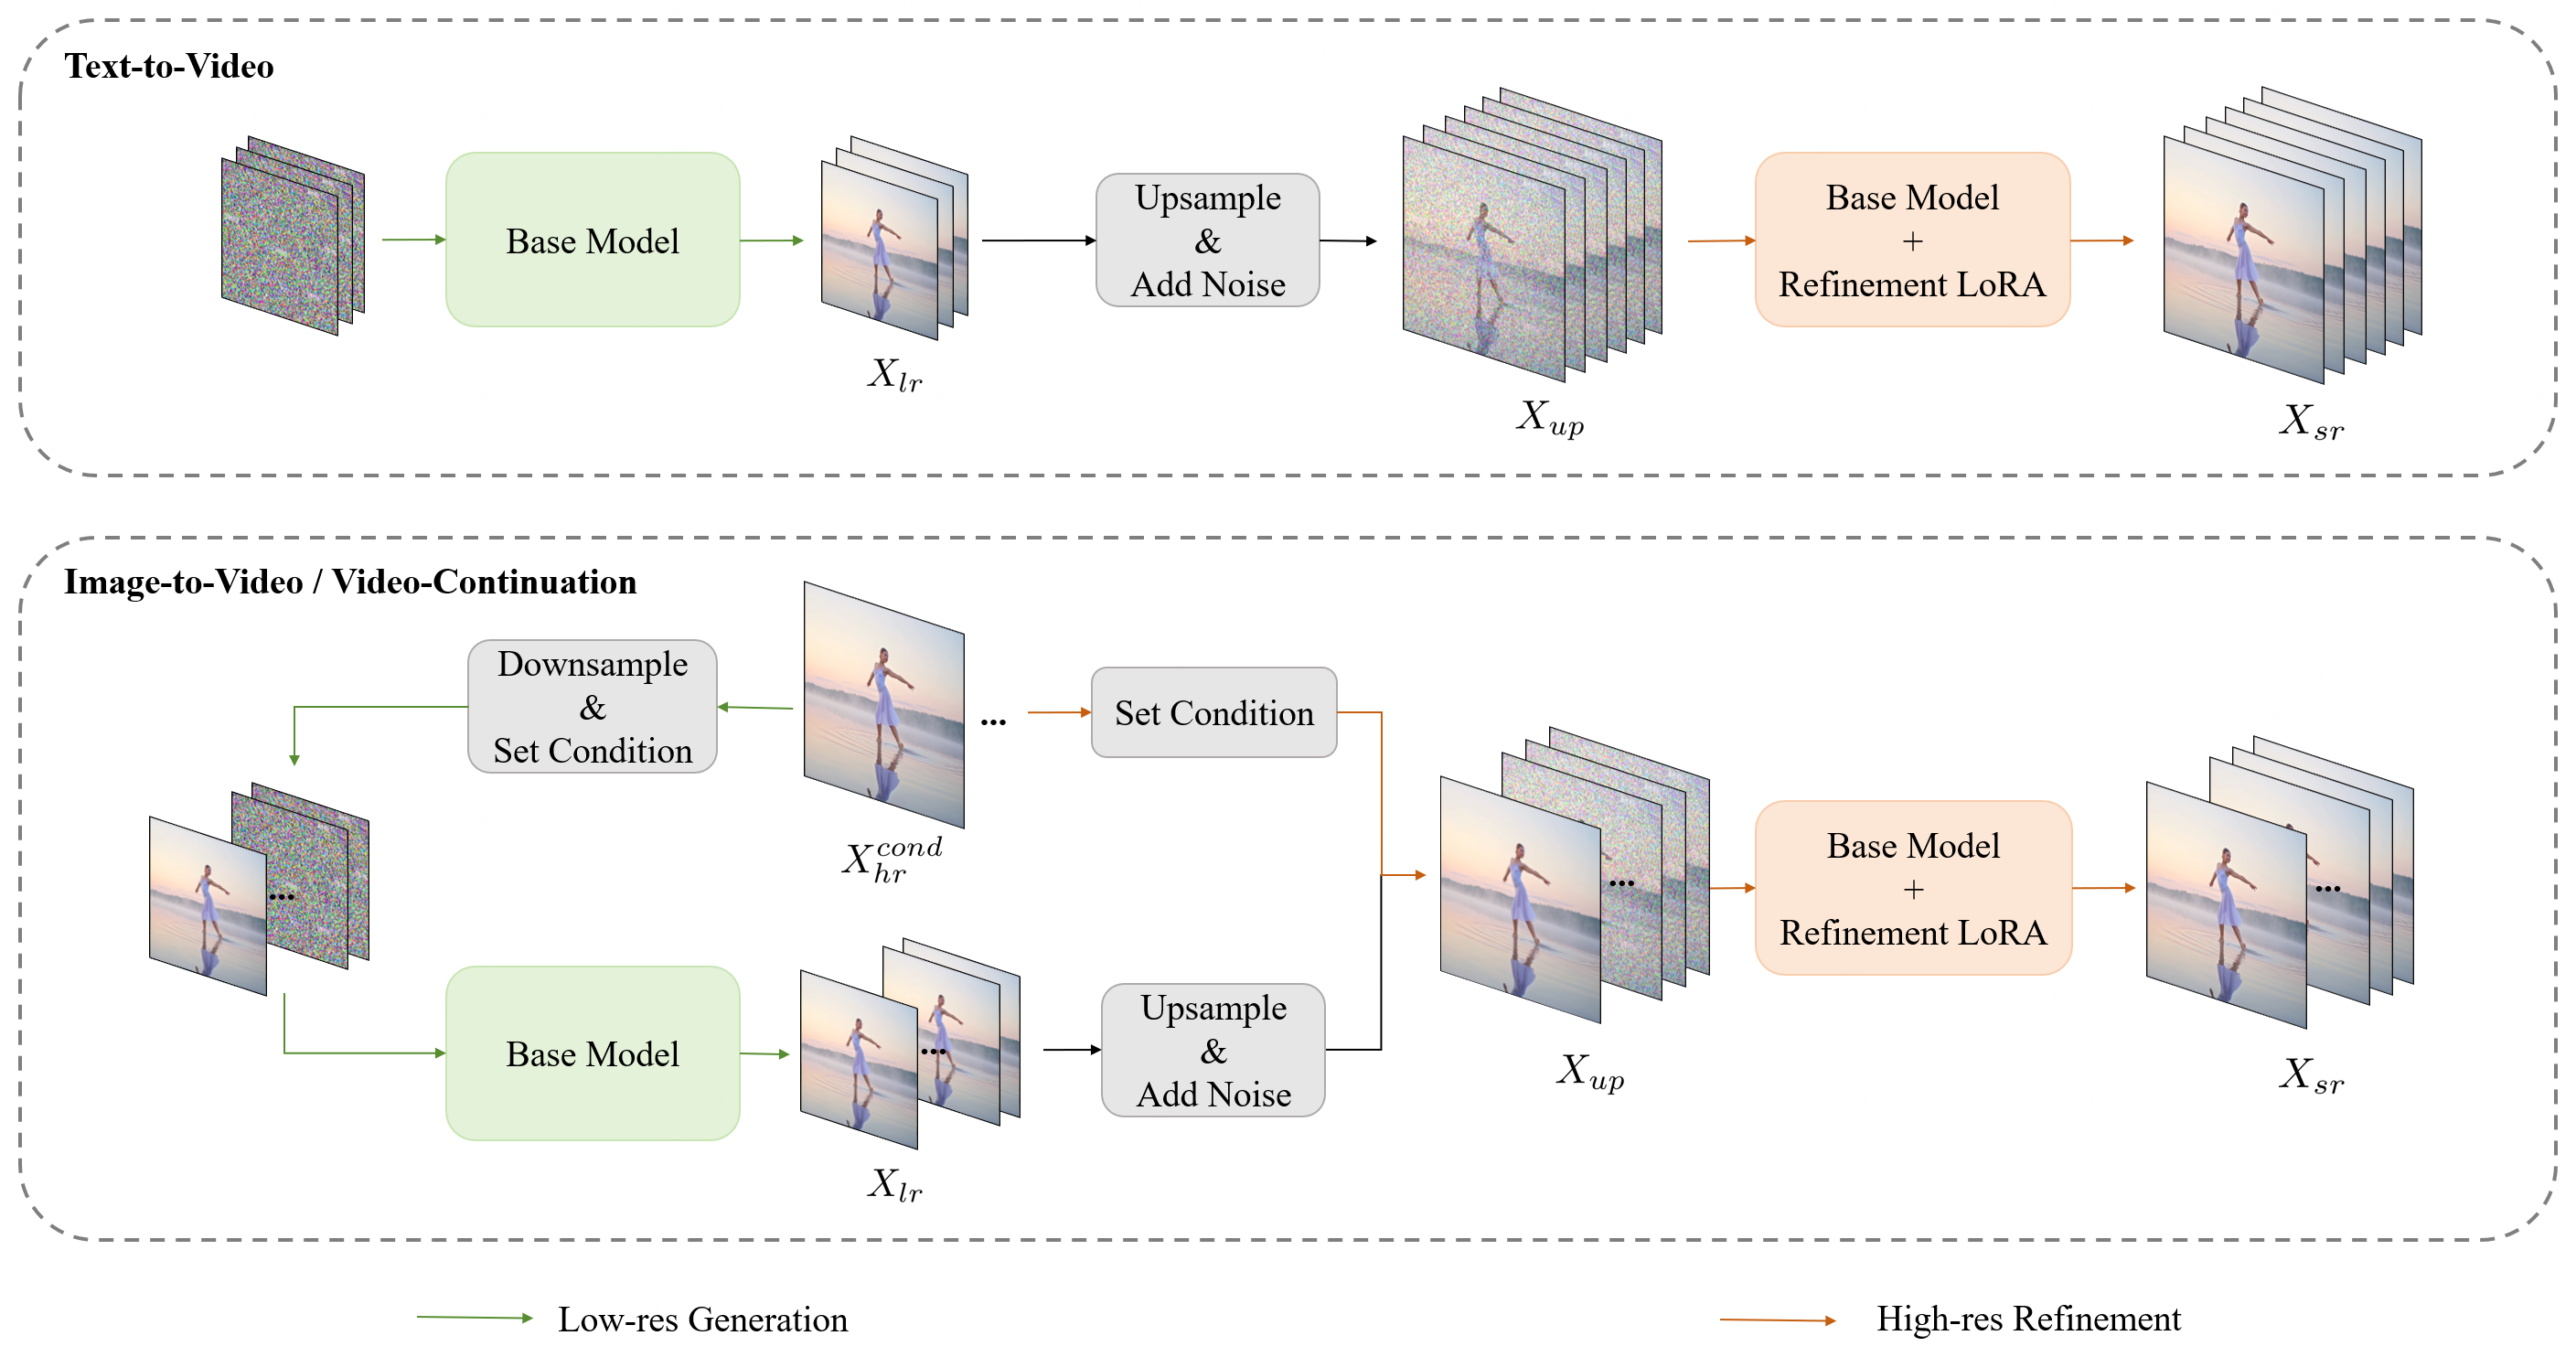
출처: LongCat-Video 공식 프로젝트 페이지. 원본 도식의 바깥 여백만 줄였다.
모델은 시공간 토큰을 블록 단위로 구성한다. 블록 간 관련성을 평가하고 선택한 블록에 대해 어텐션을 계산한다. 공식 소개에 따르면 어텐션 계산량은 일반 밀집 어텐션의 10% 미만이다. 모델 증류로 기본 생성의 샘플링 단계도 50회에서 16회로 줄였다.3
기술 보고서는 H800 GPU 한 대에서 설정별 생성 시간을 측정했다.5
| 설정 | 출력 | 생성 시간 |
|---|---|---|
| 기본 모델, 50단계 | 720p, 93프레임 | 1,429.5초 |
| 증류 적용, 16단계 | 720p, 93프레임 | 244.6초 |
| 증류, 두 단계 생성, 희소 어텐션 적용 | 720p, 93프레임 | 116.5초 |
| 같은 최적화에 프레임 수 증가 적용 | 720p, 189프레임 | 142.0초 |
평가표에서 확인할 차이
공식 저장소는 자체 벤치마크의 평균 의견 점수(MOS)를 공개한다. 텍스트 기반 생성에서 LongCat-Video의 종합 점수는 3.38점이었다. Veo3는 3.48점을 받아 LongCat-Video보다 높았다. PixVerse-V5의 3.36점과 Wan 2.2의 3.35점은 LongCat-Video보다 낮았다.1
이미지 기반 생성에서는 항목별 차이가 더 크다.
| 항목 | Seedance 1.0 | Hailuo-02 | Wan 2.2 | LongCat-Video |
|---|---|---|---|---|
| 참고 이미지 일치도 | 4.12 | 4.18 | 4.18 | 4.04 |
| 화질 | 3.22 | 3.18 | 3.23 | 3.27 |
| 움직임 품질 | 3.77 | 3.80 | 3.79 | 3.59 |
| 종합 품질 | 3.35 | 3.27 | 3.26 | 3.17 |
LongCat-Video의 화질 점수는 비교 모델 중 가장 높지만, 움직임 품질과 종합 품질 점수는 가장 낮다. 영상을 만드는 목적에 따라 비교해야 할 항목이 달라진다.16
보상 하나만 사용할 때
나는 긴 영상의 예제와 함께 다중 보상 학습의 설명을 눈여겨봤다. 팀은 GRPO 강화학습에 화질, 움직임, 텍스트 일치도를 평가하는 보상 모델을 사용했다. 화질 보상만 최적화하면 영상이 거의 움직이지 않는 사례가 발생했다고 한다. 팀은 움직임 보상을 함께 적용해 이 경향을 줄였다고 설명한다.7
강화학습에는 텍스트 기반 생성 과제만 사용했다. 팀은 이미지 기반 생성과 영상 이어 만들기에도 학습 효과가 적용됐다고 설명한다. 긴 영상의 품질 저하를 벌점으로 평가하는 전용 보상은 후속 연구 과제로 남겼다.7 나는 이 전용 보상을 추가했을 때, 영상 후반의 화질과 움직임이 얼마나 개선되는지 궁금하다.
출처
Meituan LongCat Team, LongCat-Video Technical Report, 2025년 10월 25일 공개.
공식 GitHub 저장소의 Evaluation Results와 License Agreement. 비교 점수는 최초 모델의 공개 평가이며, 2026년 10월의 최신 모델 순위와는 평가 시점이 다르다. 같은 저장소에는 후속 음성 기반 모델인 LongCat-Video-Avatar와 Avatar 1.5도 공개돼 있다. ↩︎ ↩︎ ↩︎
기술 보고서 3.1절과 3.2절. 조건 프레임의 수와 캐시 재사용을 설명한다. ↩︎ ↩︎
메이퇀 기술팀 공식 소개, 2025년 10월 27일. 약 5분 영상 생성은 팀이 소개한 기능이다. ↩︎ ↩︎ ↩︎
공식 프로젝트 페이지. 긴 영상, 대화형 생성, 텍스트 기반 생성, 이미지 기반 생성 예제를 제공한다. ↩︎
기술 보고서 표 2. H800 한 대와 FlashAttention3로 측정했다. 기본 설정에서 720p 93프레임의 생성 시간은 1,429.5초였다. 최적화한 설정에서 720p 189프레임의 생성 시간은 142.0초였다. 두 시간을 비교한 값이 10.1배다. 5분 영상 전체의 생성 시간은 이 표에 없다. ↩︎
기술 보고서 5.1절. MOS는 5점 척도이며 사람 평가와 자동 평가를 2:1로 가중 평균했다. ↩︎
기술 보고서 3.3.2절과 그림 9. 화질 보상에 대한 과도한 최적화와 움직임 보상의 효과를 설명한다. 텍스트 기반 생성만 사용한 강화학습과 후속 과제는 4.2절에서 설명한다. ↩︎ ↩︎