3줄 요약
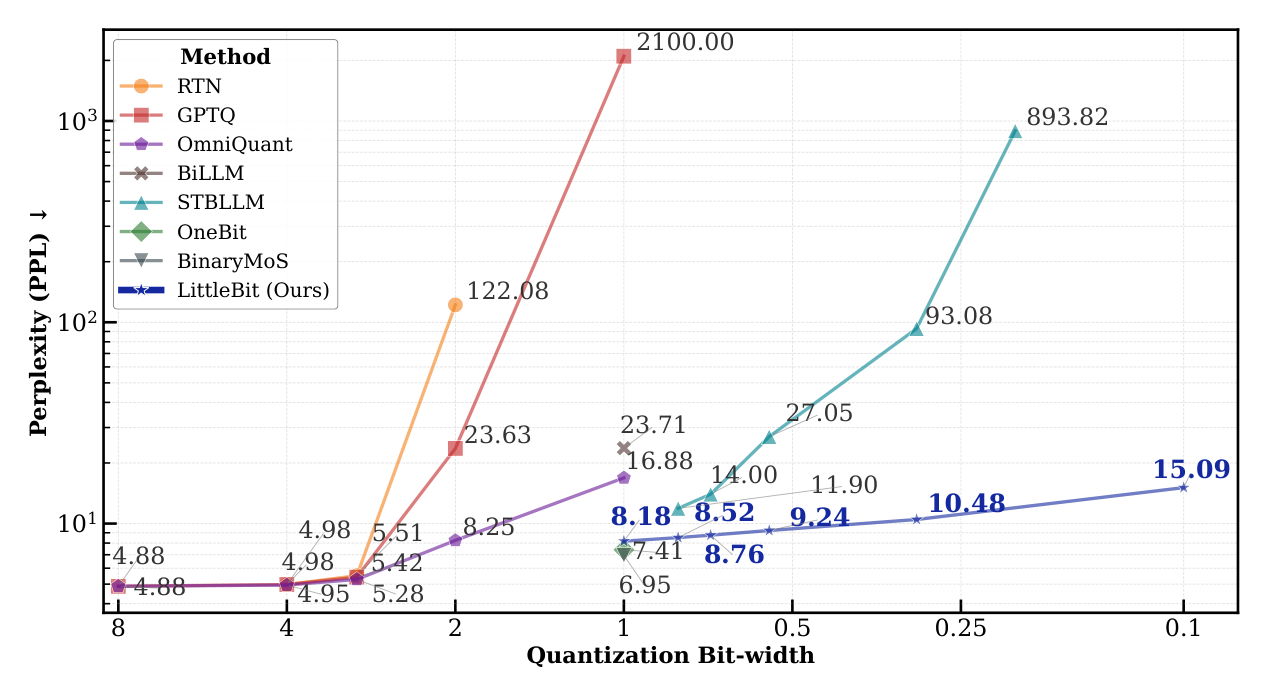
- LittleBit은 삼성리서치 연구진이 NeurIPS 2025에서 발표한 대형 언어 모델(LLM) 양자화 기법이다. 이 기법은 가중치 하나당 평균 0.1비트까지 모델을 압축해 Llama2-13B의 용량을 26.06GB에서 0.84GB로 줄였다.
- LittleBit은 가중치 행렬을 폭이 좁은 두 행렬의 곱으로 근사하고, 두 행렬의 원소를 +1과 -1로만 표현한다. 이진화로 잃은 크기 정보는 행, 열, 잠재 차원에 하나씩 둔 16비트 스케일 벡터 세 개가 보완한다. 연구진은 이 구조를 특잇값 분해(SVD) 결과로 초기화하는 Dual-SVID를 쓰고, 근사 오차를 맡는 두 번째 경로(잔차 보상)를 추가했다. 그다음 원본 모델을 교사로 삼아 압축된 모델을 다시 학습시켰다.
- 0.1비트로 압축한 Llama2-7B의 퍼플렉시티는 15.92로, 기존 최고 기법 STBLLM이 0.7비트에서 낸 19.17보다 낮다. 그러나 원본 모델의 5.47과는 차이가 크고, 정확히 1비트로 맞춘 조건에서는 기존 1비트 전용 학습 기법보다 성적이 낮다. 전용 GPU 커널로 측정했을 때 Llama2-70B 크기의 MLP 층 하나는 FP16보다 11.6배 빨랐다. Llama2-7B 모델 전체의 디코딩 속도는 2.46배 빨라졌다.
1비트로도 부족한 이유
LLM의 용량은 대부분 가중치가 차지한다. 원본 모델은 가중치 하나를 16비트 부동소수점(FP16)으로 저장하므로, 가중치가 약 70억 개인 Llama2-7B의 용량은 13.49GB다. 양자화는 가중치를 더 적은 비트로 표현해 용량을 줄이는 기법이다. 논문은 압축 정도를 BPW(bits per weight)로 표시한다. BPW는 압축된 모델이 원본 가중치 하나를 평균 몇 비트로 표현하는지를 뜻한다.
사후 학습 양자화(PTQ)는 학습이 끝난 모델을 추가 학습 없이 변환하는 방식이다. GPTQ나 AWQ 같은 PTQ 방법은 4비트 정도까지 성능을 유지한다. 하지만 2비트 미만에서는 성능을 유지하기 어렵다. 1비트까지 압축하려면 양자화된 상태로 모델을 다시 학습시키는 양자화 인식 학습(QAT)이 필요하다. OneBit과 BinaryMoS 같은 QAT 기법은 1비트 모델로도 상당한 성능을 유지했다.
그런데 1비트 모델도 그리 작지 않다. 논문이 인용한 계산으로는 70B 모델을 1비트로 압축해도 약 15.4GB가 필요하다. 자원이 아주 제한된 기기에서 쓰기에는 여전히 큰 용량이다. 연구진이 0.1 BPW 근처까지 압축하는 기술을 목표로 잡은 이유다.
1비트 미만으로 압축하려면 가중치마다 비트를 하나씩 배정할 수 없다. 0.1 BPW라면 가중치 10개가 평균 1비트를 공유하는 셈이다. 이전까지 1비트 미만 압축에서 성능이 가장 좋았던 기법은 STBLLM이다. STBLLM은 PTQ 방식이며, 가중치 M개 가운데 N개만 남기는 N:M 희소화와 이진화를 결합한다. 예를 들어 8개 중 4개를 남기는 4:8 희소화는 0.55 BPW에 해당한다. 논문에 따르면 STBLLM은 0.5 BPW 미만에서 성능이 급격히 떨어진다.
논문이 주로 보고한 성능 지표는 퍼플렉시티다. 퍼플렉시티는 언어 모델이 다음 토큰을 얼마나 잘 예측하는지 나타내는 지표로, 값이 낮을수록 좋다. 모델이 토큰마다 평균 몇 개의 후보 중에서 고민하는지로 이해하면 된다.
연구진의 두 가지 관찰
첫째, LLM의 가중치 행렬은 저랭크 구조가 뚜렷하다. 랭크가 낮다는 말은 큰 행렬이 담은 정보 대부분을 폭이 좁은 행렬 두 개의 곱으로 근사할 수 있다는 뜻이다. 이런 근사를 구하는 대표적인 방법이 특잇값 분해(SVD)다. SVD는 행렬을 특잇값이 큰 순서대로 정렬된 성분들의 합으로 분해한다. 앞에서부터 성분 $r$개만 남기면 원래 행렬은 $d_{out} \times r$ 행렬과 $d_{in} \times r$ 행렬의 곱으로 근사된다. 여기서 $d_{out}$과 $d_{in}$은 원래 행렬의 출력 차원과 입력 차원이다.
연구진은 압축률이 높을 때 SVD가 가지치기보다 안정적이라는 점을 근거로 들었다. 가지치기는 가중치 일부를 지워 모델을 압축하는 방식이다. 아래 표는 Llama-7B에서 가지치기 기법 Wanda와 SVD 기반 압축 기법 SVD-LLMv2의 WikiText-2 퍼플렉시티를 비교한 결과다. 원본 FP16 모델의 퍼플렉시티는 5.68이다.
| 남긴 파라미터 비율 | 가지치기(Wanda) | SVD(SVD-LLMv2) |
|---|---|---|
| 50% | 8.7 | 13.6 |
| 37.5% | 46.0 | 20.1 |
| 25% | 1,842.7 | 52.6 |
파라미터를 절반 남기는 조건에서는 가지치기가 더 낫다. 그러나 남긴 비율이 37.5% 이하가 되면 가지치기의 퍼플렉시티는 급격히 커지는 반면 SVD의 퍼플렉시티는 비교적 완만하게 커진다. 분해된 밀집 행렬은 희소 행렬과 달리 특수 하드웨어 없이도 효율적으로 계산된다는 점도 SVD를 고른 이유였다.
둘째, 이진화는 필연적으로 정보를 잃는다. 가중치를 +1과 -1로만 표현하면 가중치마다 다른 크기 정보가 사라진다. 최근 성능이 좋은 1비트 기법들은 행과 열 같은 여러 차원에 스케일 계수를 두어 이 손실을 보완했다.
LittleBit의 구조
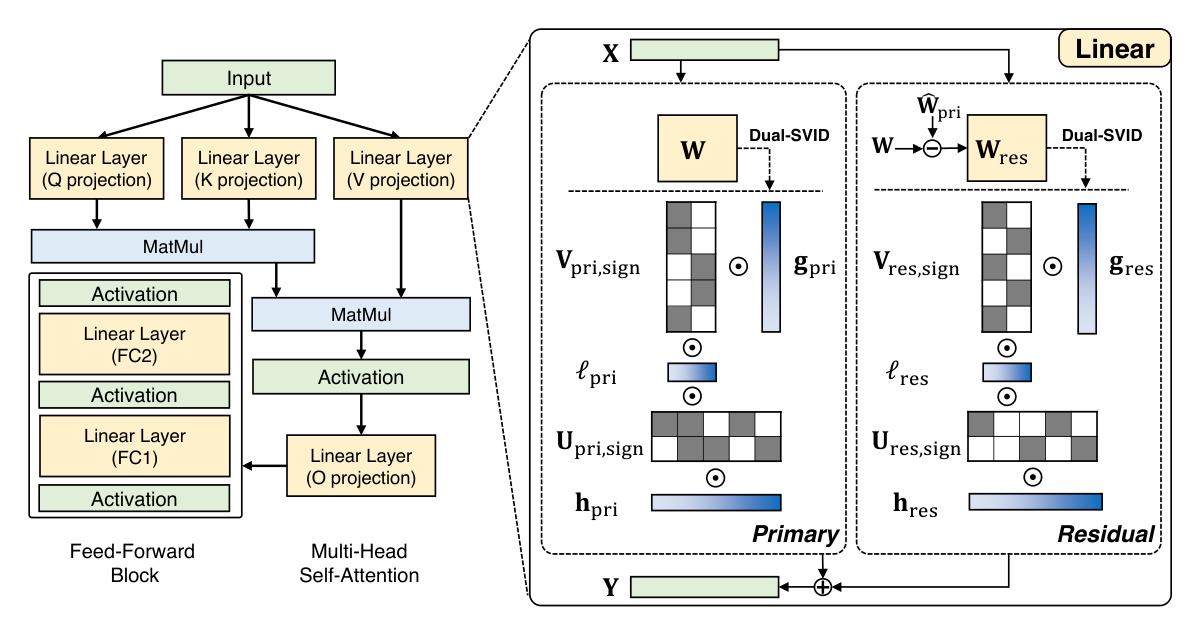 Figure 2. 일반 트랜스포머 층(왼쪽)과 LittleBit 선형 층(오른쪽). 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0
LittleBit은 트랜스포머의 선형 층을 하나씩 다음 방식으로 대체한다. 먼저 원래 가중치 행렬 $\mathbf{W}$를 랭크가 $r$인 두 행렬의 곱으로 근사한다. $r$은 행렬의 가로 세로 크기보다 훨씬 작다.
$$\mathbf{W} \approx \mathbf{U}\mathbf{V}^{\top}$$여기서 $\mathbf{U}$는 $d_{out} \times r$ 행렬이고, $\mathbf{V}$는 $d_{in} \times r$ 행렬이다.
다음으로 $\mathbf{U}$와 $\mathbf{V}$의 원소를 부호만 남긴 $\mathbf{U}_{sign}$과 $\mathbf{V}_{sign}$으로 바꾼다. 원소 하나를 저장하는 데 1비트가 든다. 이진화로 잃은 크기 정보는 16비트 스케일 벡터 세 개가 보완한다. 이 벡터 세 개는 행 스케일 $\mathbf{h}$, 열 스케일 $\mathbf{g}$, 잠재 스케일 $\boldsymbol{\ell}$이다. $\mathbf{h}$에는 출력 차원마다, $\mathbf{g}$에는 입력 차원마다 값이 하나씩 있다. 잠재 스케일은 LittleBit이 새로 추가한 것으로, $r$개의 잠재 차원이 각각 얼마나 중요한지를 학습한다. 세 스케일을 반영한 근사 가중치는 다음과 같다.
$$\begin{aligned}\widehat{\mathbf{W}}_{pri} &= \mathrm{diag}(\mathbf{h})\,\mathbf{U}_{sign}\,\mathrm{diag}(\boldsymbol{\ell}) \\ &\qquad \mathbf{V}_{sign}^{\top}\,\mathrm{diag}(\mathbf{g})\end{aligned}$$추론할 때 이 행렬을 실제로 만들 필요는 없다. 입력 $\mathbf{X}$에 스케일을 원소별로 곱하는 연산과 이진 행렬을 곱하는 연산을 번갈아 수행하면 같은 출력을 얻는다. 중간 결과를 편의상 $\mathbf{Z}$로 적으면 계산은 두 단계다.
$$\mathbf{Z} = \big( (\mathbf{X} \odot \mathbf{g})\,\mathbf{V}_{sign} \big) \odot \boldsymbol{\ell}$$$$\mathbf{Y} = (\mathbf{Z}\,\mathbf{U}_{sign}^{\top}) \odot \mathbf{h}$$$\mathbf{Z}$의 각 행은 길이가 $r$인 잠재 벡터다.
이렇게 계산하면 큰 FP16 행렬 곱셈 하나가 작은 이진 행렬 곱셈 두 번과 원소별 곱셈 세 번으로 바뀐다. +1이나 -1을 곱하는 연산은 부호를 바꾸거나 그대로 두는 것과 같으므로, 이진 행렬 곱셈에는 부동소수점 곱셈이 필요 없다.
BPW를 정하는 랭크
LittleBit 층은 같은 구조의 경로 두 개, 곧 주 경로와 잔차 경로로 이뤄진다. 경로 하나가 저장하는 값은 원소당 1비트인 이진 행렬 두 개($d_{out} \times r$, $d_{in} \times r$)와 16비트 스케일 벡터 세 개(길이 $d_{out}$, $d_{in}$, $r$)다. 두 경로의 저장 비트를 모두 합한 값을 원래 가중치 개수 $d_{out} \times d_{in}$로 나눈 값이 BPW $b$다.
$$b = \frac{(2r+32)(d_{out}+d_{in}) + 32r}{d_{out}\,d_{in}}$$목표 BPW를 정하면 이 식을 $r$에 대해 풀어 랭크를 구한다. 논문의 예시에 따르면 4,096×4,096 층을 0.55 BPW로 압축하려면 $r$이 546이어야 하고, 4,096×11,008 층을 0.1 BPW로 압축하려면 $r$이 133이어야 한다. 두 번째 예시에서는 원래 가중치 약 4,509만 개를 폭이 133인 이진 행렬 네 개와 스케일 벡터 여섯 개로 표현하는 셈이다. 랭크만 바꾸면 되므로 1.0 BPW에서 0.1 BPW까지 압축률을 연속적으로 고를 수 있다.
Dual-SVID 초기화와 잔차 보상
이렇게 제약이 강한 구조를 무작위로 초기화하면 QAT가 불안정해진다. 연구진은 Dual-SVID를 제안했다. 이 방법은 SVD 결과에서 부호와 크기 정보를 추출해 LittleBit 파라미터의 초깃값으로 쓴다. 절차는 세 단계로 이뤄진다.
- 원래 행렬 $\mathbf{W}$를 SVD로 분해하고 앞쪽 성분 $r$개만 남겨 $\mathbf{U}'$와 $\mathbf{V}'$를 얻는다.
- $\mathbf{U}'$와 $\mathbf{V}'$의 부호를 이진 행렬의 초깃값으로 쓴다.
- 절댓값 행렬 $|\mathbf{U}'|$와 $|\mathbf{V}'|$를 각각 랭크 1 행렬로 근사한다. $|\mathbf{U}'|$의 근사에서 나온 길이 $d_{out}$ 벡터를 행 스케일 $\mathbf{h}$의 초깃값으로, $|\mathbf{V}'|$의 근사에서 나온 길이 $d_{in}$ 벡터를 열 스케일 $\mathbf{g}$의 초깃값으로 쓴다. 두 근사에서 하나씩 나온 길이 $r$ 벡터는 원소별로 곱해 잠재 스케일 $\boldsymbol{\ell}$의 초깃값으로 쓴다.
학습하는 동안 모델은 실수 값 행렬 $\mathbf{U}$와 $\mathbf{V}$를 따로 보관하고, 순전파를 계산할 때마다 그 부호를 이진 행렬로 쓴다. 이 실수 값 행렬의 초깃값도 SVD로 얻은 $\mathbf{U}'$와 $\mathbf{V}'$다. 분해 방법으로는 기본 SVD를 썼다. 기본 SVD로 초기화해도 이후 QAT 과정에서 성능이 회복되었기 때문에, 연구진은 SVD-LLMv2 같은 개선된 분해를 추가하지 않았다.
잔차 보상(Residual Compensation)은 주 경로와 같은 구조의 보조 경로를 하나 더 두는 기법이다. 보조 경로는 주 경로의 초기 근사가 남긴 오차 $\mathbf{W} - \widehat{\mathbf{W}}_{pri,0}$에 Dual-SVID를 적용해 초기화한다. 최종 가중치는 두 경로가 만든 근사의 합이다. 연구진은 이 기법이 전체 비트 예산을 늘리지 않는다고 강조했다. 랭크가 높은 경로 하나에 쓸 비트를 랭크가 낮은 경로 두 개에 배분했기 때문이다. “잔차"라는 이름은 초기화 단계의 역할에서 나왔다. QAT가 시작되면 두 경로는 함께 학습되며, 두 근사를 합쳐 원래 가중치를 표현한다.
부록 A는 이 설계의 근거를 다음과 같이 설명한다. 주 성분은 특잇값이 크고 정보가 소수의 성분에 집중되어 있는 반면, 나머지 성분은 특잇값 분포가 평평하다. 그러니 성질이 다른 두 행렬은 한꺼번에 양자화할 때보다 따로 양자화할 때 오차가 작아질 수 있다.1
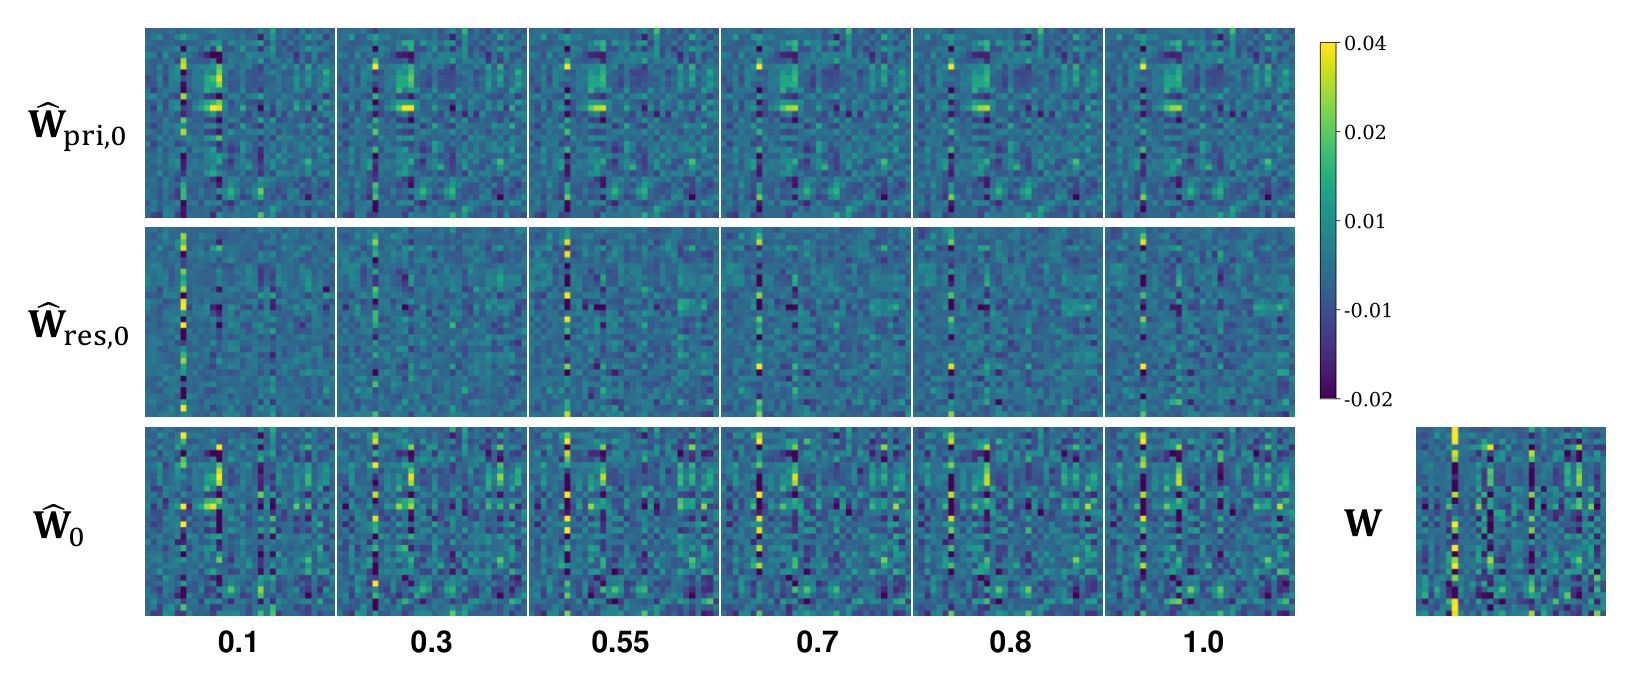 Figure 3. Dual-SVID로 초기화한 가중치 성분(Llama2-7B, 0번 층 쿼리 가중치). 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0
그림 3은 Llama2-7B 첫 층의 쿼리 가중치 일부를 Dual-SVID로 초기화한 결과다. 0.1 BPW에서도 주 경로의 근사는 원래 가중치의 큰 패턴을 포착한다. 논문은 0.3 BPW에서 두 경로를 합친 근사가 1.0 BPW에서 주 경로 하나만 쓴 근사보다 원래 가중치를 더 충실하게 표현하는 경우가 많다고 분석했다.
OPT-1.3B로 진행한 절제 실험에서 잔차 보상은 대부분의 BPW에서 퍼플렉시티를 낮췄다.
| BPW | 잔차 보상 사용 | 잔차 보상 미사용 | 차이 |
|---|---|---|---|
| 1.00 | 20.33 | 21.69 | -1.36 |
| 0.55 | 23.46 | 24.79 | -1.33 |
| 0.30 | 28.98 | 29.72 | -0.74 |
| 0.10 | 60.01 | 48.51 | +11.50 |
0.1 BPW에서만은 결과가 반대였다. 잔차 보상을 쓴 모델의 퍼플렉시티가 11.50 더 높았다. 논문은 이 결과의 원인으로, 작은 모델을 극단적으로 압축할 때 잔차 보상이 더하는 복잡도가 이득보다 커질 가능성을 들었다. 그러면서도 더 큰 모델에서는 대체로 잔차 보상이 유리했다는 이유로 모든 실험에 이 기법을 적용했다.
학습 방법
연구진은 원본 모델을 교사로, LittleBit 모델을 학생으로 삼는 지식 증류 방식으로 QAT를 진행했다. 손실 함수는 두 모델의 출력 분포 차이(KL 발산)에 중간 층 은닉 표현의 평균제곱오차를 더한 값이고, 중간 층 항에는 계수 10을 곱했다. 학습 데이터는 WikiText-2와 C4의 일부를 섞은 말뭉치다. 이 말뭉치는 Llama2 토크나이저 기준으로 에폭당 약 2억 토큰이며, 모델은 5에폭 동안 약 10억 토큰을 학습했다. GPU는 QwQ-32B에 A100 32장, 나머지 모델에 H100 4장이 쓰였다.
부호 함수는 미분할 수 없으므로, 역전파할 때는 대신 쓸 기울기가 필요하다. 흔히 쓰는 직통 추정기(STE)는 부호 함수의 기울기를 항등 함수의 기울기로 대체한다. LittleBit은 순전파에서는 부호 함수를 그대로 쓰고 역전파에서는 $\tanh(100x)$의 도함수를 쓰는 SmoothSign을 택했다. OPT-1.3B 실험에서 SmoothSign은 대부분의 BPW에서 STE보다 퍼플렉시티가 낮았고, BPW가 낮을수록 그 차이가 커져 0.1 BPW에서 0.39로 가장 컸다.
최근 모델이 많이 쓰는 그룹 쿼리 어텐션(GQA)에서는 키(K)와 값(V) 투영 층의 출력 차원이 쿼리 투영 층보다 작다. 이 층에 같은 BPW 공식을 적용하면 랭크가 지나치게 작아진다. 예를 들어 Llama3-8B 전체를 0.1 BPW로 압축하면 K, V 투영 층의 랭크는 20 안팎이 된다. 연구진은 K, V 투영 층의 랭크만 4배로 늘렸다. 모델 전체의 BPW는 0.098에서 0.107로 조금 높아졌고, WikiText-2 퍼플렉시티는 25.80에서 24.93으로 낮아졌다. GQA를 쓰는 Llama3-8B, Phi-4, QwQ-32B의 본 실험에는 모두 이 설정을 적용했다.
퍼플렉시티 비교
평가 대상은 OPT, Llama, Llama2, Llama3, Phi-4, QwQ 계열의 1.3B부터 32B까지 8개 모델이다. 아래 표에는 Llama2-7B의 WikiText-2 퍼플렉시티만 추려 실었다. 원본 FP16 모델의 퍼플렉시티는 5.47이다.
| BPW | STBLLM | LittleBit |
|---|---|---|
| 0.8 | 13.81 | 9.53 |
| 0.7 | 19.17 | 9.85 |
| 0.55 | 30.67 | 10.47 |
| 0.3 | 약 1,800 | 12.00 |
| 0.1 | 결과 없음 | 15.92 |
0.55 BPW에서 STBLLM의 퍼플렉시티는 30.67이고 LittleBit은 10.47이다. 0.3 BPW에서는 STBLLM의 퍼플렉시티가 약 1,800으로 커졌고, LittleBit은 12.00을 기록했다. 0.1 BPW로 압축한 LittleBit의 퍼플렉시티(15.92)는 STBLLM을 0.7 BPW로 압축한 결과(19.17)보다도 낮다.2
다른 모델에서도 경향은 같다. Llama2-13B를 0.1 BPW로 압축한 LittleBit의 퍼플렉시티는 15.09로, 0.55 BPW에서 STBLLM이 낸 27.05보다 낮다. 양자화하기 어렵다고 알려진 Llama3-8B의 0.55 BPW 퍼플렉시티는 LittleBit이 18.47, STBLLM이 241.95였다. QwQ-32B의 0.3 BPW 퍼플렉시티는 LittleBit이 16.48, STBLLM이 512.01이었다.
정확히 1비트로 맞춘 조건에서는 결과가 다르다. LittleBit은 랭크를 늘려 1.0 BPW로 맞출 수 있는데, 이때 Llama2-7B의 퍼플렉시티는 9.08로, 1비트 QAT 기법인 OneBit(8.36)과 BinaryMoS(7.74)보다 높아 성적이 나쁘다. 연구진은 BinaryMoS가 동적 스케일링처럼 더 복잡한 장치를 쓰기 때문에 생긴 차이라고 설명했다.
BPW를 1.0에서 0.1까지 낮춰 가며 보면, 0.55 BPW까지는 성능 저하가 작지만 0.3 BPW에서 0.1 BPW로 줄이면 급격히 커진다. Llama2-7B는 0.3 BPW의 12.00에서 0.1 BPW의 15.92로, QwQ-32B는 16.48에서 35.26으로 퍼플렉시티가 높아졌다. 논문은 이 구간을 “양자화 절벽(quantization cliff)“이라 부르고, 압축률과 정확도의 균형이 가장 좋은 범위로 0.3에서 0.55 BPW를 꼽았다.
제로샷 정확도
상식 추론 과제 7개의 제로샷 정확도에서도 두 기법의 우열은 퍼플렉시티 비교와 같았다. Llama2-7B의 평균 정확도는 다음과 같다.
| 조건 | 평균 정확도 |
|---|---|
| 원본(FP16) | 62.97% |
| STBLLM 0.55 BPW | 44.29% |
| LittleBit 0.55 BPW | 47.26% |
| STBLLM 0.3 BPW | 35.78% |
| LittleBit 0.3 BPW | 45.20% |
LittleBit은 같은 BPW의 STBLLM보다 정확도가 높지만, 원본과의 차이는 크다. 0.55 BPW에서도 평균 정확도가 원본보다 15.71%p 낮다. 과제별로 보면 HellaSwag 정확도는 72.95%에서 44.57%로, ARC-Easy 정확도는 69.44%에서 44.15%로 떨어졌다.3
같은 7개 과제 평가는 더 큰 모델인 Phi-4 14B와 QwQ-32B로도 진행했다. Phi-4를 0.55 BPW로 압축했을 때 LittleBit의 평균 정확도는 약 52.3%로, STBLLM의 54.2%보다 조금 낮았다. 0.3 BPW에서는 LittleBit이 48.7%, STBLLM이 40.3%로 순서가 바뀌었다. LittleBit은 0.1 BPW에서도 43.6%를 기록했다. QwQ-32B에서도 STBLLM의 정확도는 0.5 BPW 미만에서 급락했고, LittleBit의 정확도는 0.1 BPW까지 완만하게 떨어졌다.
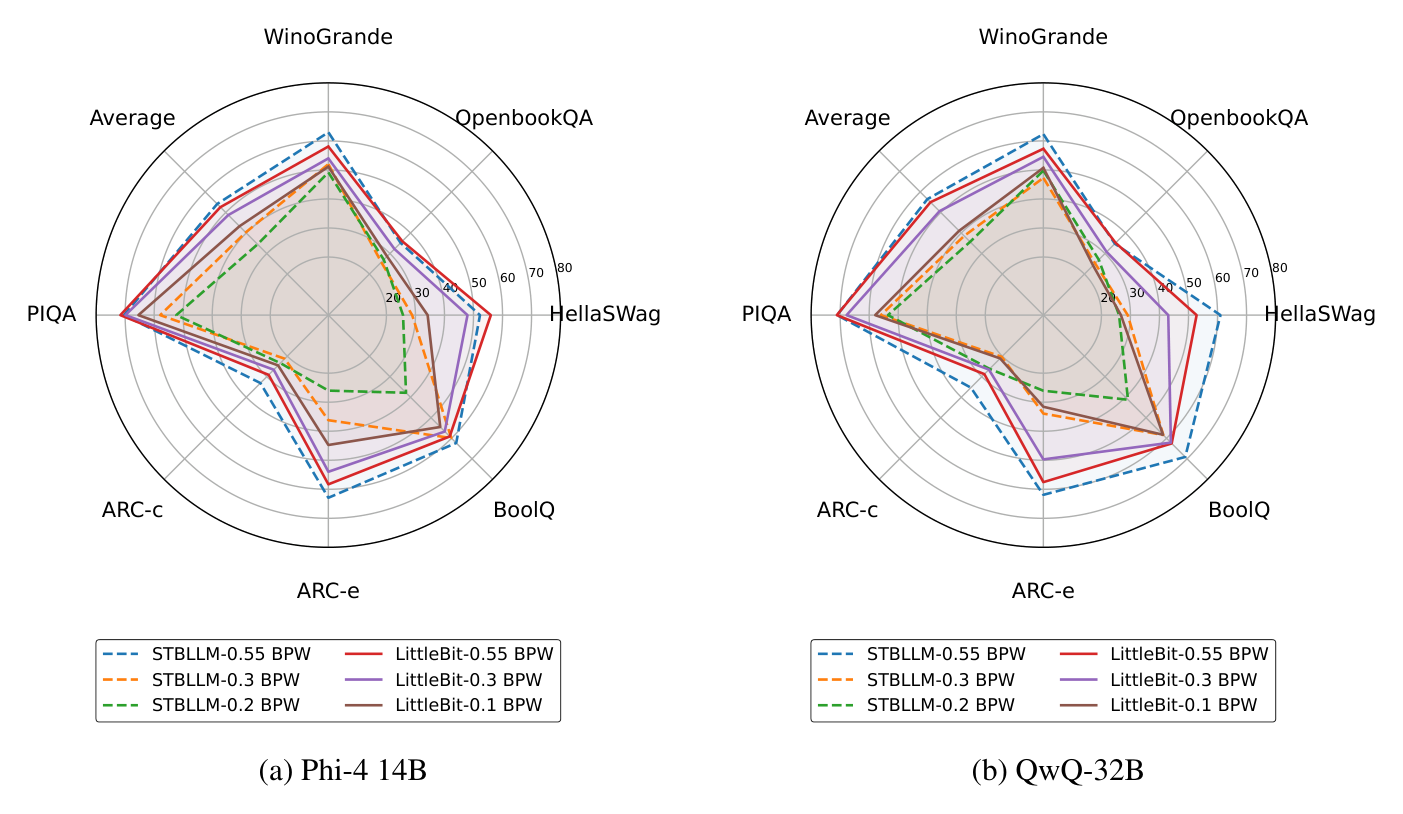 Figure 4. 상식 추론 과제 7개의 제로샷 정확도. 실선은 LittleBit, 점선은 STBLLM. 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0
압축된 모델이 쓴 문장
부록에는 Phi-4를 압축한 모델의 생성 예시가 실려 있다. “레오나르도 다빈치가 모나리자를 그렸다. 모나리자는"이라는 프롬프트에 대한 응답은 BPW에 따라 이렇게 달라졌다. 아래는 영어 원문의 번역이다.
0.8 BPW: …20세기의 가장 중요한 그림 중 하나로 여겨진다. (중략) 레오나르도 다빈치는 20세기의 가장 중요한 화가 중 한 명으로 여겨진다.
0.55 BPW: 모나리자는 프랑스 파리의 루브르 박물관에 있다. 박물관에 있는지 없는지는 잘 모르겠다. 모나리자 그림 찾는 것 좀 도와줄 수 있을까? 여기저기 찾아보고 있다.
0.1 BPW: 모나리자는 이탈리아 미술의 상징적인 걸작이며 (중략) 이 조각상은 밀라노 패션계에서도 가장 인기 있는 작품 중 하나다.
0.8 BPW 모델은 같은 말을 반복하고 다빈치를 20세기 화가로 소개했다. 0.55 BPW 모델은 도움을 요청하는 사람의 말투로 바뀌었다. 0.1 BPW 모델은 모나리자를 밀라노 패션계의 조각상이라고 썼다.
“튜링은 컴퓨터 과학의 아버지로 불린다. 컴퓨터 과학은"이라는 프롬프트에서도 비슷한 차이가 나타났다. 0.8 BPW 모델은 컴퓨터 과학을 계산 시스템의 설계와 분석을 연구하는 수학의 한 분야로 정의했다. 0.1 BPW 모델은 컴퓨터 과학을 “인간의 마음과 뇌가 어떻게 작동하는지에 대한 이론과 방법을 연구하는 학문"이자 “마음의 과학"이라고 설명했다.
부록의 정리에 따르면 BPW를 아주 낮춰도 문법 구조는 남는 반면, 정확한 정보를 기억해 문장으로 쓰는 능력은 손상된다. 연구진은 그럴듯하게 들리지만 말이 되지 않는 문장이 자주 나오는 원인을 이 손상에서 찾았다.
메모리, KV 캐시, 속도
압축 후 모델 용량(GB)을 BPW별로 정리하면 다음과 같다.
| BPW | 7B | 13B | 70B |
|---|---|---|---|
| 16 (FP16) | 13.49 | 26.06 | 138.04 |
| 0.55 | 0.98 | 1.51 | 5.83 |
| 0.3 | 0.79 | 1.15 | 3.70 |
| 0.1 | 0.63 | 0.84 | 1.98 |
모델은 모두 Llama2이고, 0.1 BPW의 압축률은 7B가 21.4배, 13B가 31.0배, 70B가 69.7배다. 16비트를 0.1비트로 압축하면 계산상 160배 압축이지만, 실제 압축률은 21배에서 70배다. 이는 양자화를 트랜스포머 블록에만 적용하고 임베딩 층과 출력 층(lm_head)은 FP16으로 유지하기 때문이다. 모델이 클수록 압축률이 높은 것도 FP16으로 유지되는 두 층이 전체 용량에서 차지하는 비중이 줄어서다.4
키와 값 투영 층에 같은 분해를 적용하면 KV 캐시도 작아진다. 순전파의 중간 결과가 길이 $r$인 잠재 벡터이므로, $d_{model}$ 차원 벡터 대신 이 잠재 벡터를 캐시에 저장하면 된다. 이때 캐시 크기는 대략 $d_{model}/r$배 줄어든다. 논문이 Llama2-7B($d_{model}$ = 4,096)를 기준으로 추산한 값은 다음과 같다.
| BPW | K, V 투영 층의 잠재 랭크 | KV 캐시 감소 배율 |
|---|---|---|
| 0.8 | 1,624 | 약 2.5배 |
| 0.55 | 1,112 | 약 3.7배 |
| 0.3 | 600 | 약 6.8배 |
| 0.1 | 192 | 약 21.3배 |
연구진은 이 효과가 KV 캐시를 명시적으로 압축하는 멀티헤드 잠재 어텐션(MLA)과 비슷하다고 설명했다. LittleBit은 가중치를 압축하려고 도입한 분해 하나로 가중치 메모리와 활성값 메모리를 함께 줄인다는 점에서 MLA와 다르다.
속도 측정에는 연구진이 직접 작성한 이진 행렬 곱셈용 CUDA 커널을 썼다. 커널은 +1과 -1로 된 가중치를 32비트 정수 하나에 비트 단위로 묶어 저장한다. 곱셈은 FP16 입력의 부호 비트를 XOR 연산으로 바꾸는 방식으로 대신한다. 아래 그림은 NVIDIA A100 GPU에서 배치 크기 1로, Llama2-70B의 MLP 층과 같은 크기(8,192×28,672)인 행렬 연산의 지연 시간을 측정한 결과다.
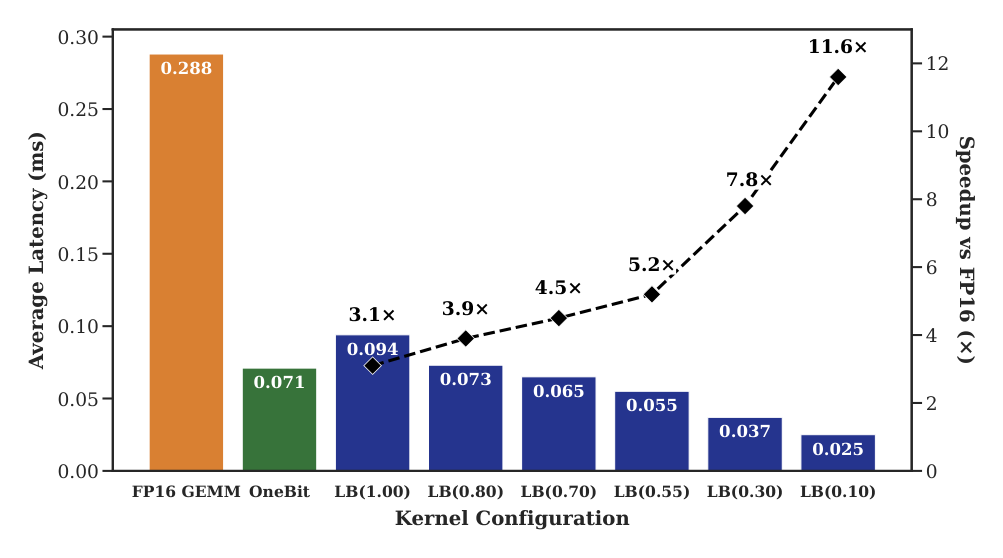 Figure 6. A100 GPU에서 측정한 Llama2-70B MLP 층 크기 연산의 커널 지연 시간과 FP16 대비 속도 향상. 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0
FP16 행렬 곱셈으로 0.288ms가 걸린 연산을 LittleBit 커널은 0.1 BPW에서 0.025ms에 처리했다. 11.6배 빠르다. 1.0 BPW에서는 3.07배 빨랐지만, 같은 1비트인 OneBit 커널의 4.04배에는 못 미쳤다.
행렬이 작으면 속도 향상 폭도 작다. Llama2-7B의 MLP 층 크기(4,096×11,008)에서는 0.1 BPW에서 3.26배에 그쳐 0.55 BPW의 3.23배와 거의 같았다. Llama2-70B의 어텐션 층 크기(8,192×8,192)에서는 0.1 BPW에서 4.33배였다.
모델 전체의 디코딩 속도는 Llama2-7B로 측정했다. 선형 층만 이 커널로 교체했고, 어텐션과 정규화 층은 FP16 구현을 그대로 썼다. 새 토큰 128개를 생성할 때 FP16 모델은 초당 82.56토큰을 생성했다. LittleBit 모델은 0.55 BPW에서 초당 174.24토큰(2.11배), 0.1 BPW에서 초당 203.20토큰(2.46배)을 생성했다.
이론상 줄어든 연산량만큼 실측 속도가 빨라지지는 않았고, 논문은 그 원인으로 두 가지를 들었다. 하나는 배치가 작은 추론에서는 연산보다 메모리 접근에 시간이 더 많이 든다는 점이고, 다른 하나는 직접 작성한 커널이 업계 표준 라이브러리만큼 최적화되지 않았다는 점이다. 부록의 계산에 따르면 Llama2-7B의 MLP 층을 0.3 BPW로 압축할 때 부동소수점 연산은 약 9,020만 회에서 약 1,300만 회로 줄어 7분의 1 수준이 된다. 그 대신 비트 연산이 같은 규모인 약 1,300만 회 추가된다.
한계와 후속 과제
연구진은 부록에서 세 가지 한계를 인정했다. 첫째, 출력 층(lm_head)은 압축하지 않았다. 트랜스포머 블록을 0.1 BPW로 압축하면 어휘가 큰 모델에서는 출력 층이 전체 용량의 상당 부분을 차지하게 된다. 둘째, QAT는 계산 비용이 커서 70B 이상의 모델에 적용하기 어렵다. 연구진도 이 규모의 모델에서는 자원 제약을 겪었다고 밝혔다. 셋째, 원래 가중치 정보의 극히 일부만 남은 0.1 BPW 모델이 복잡한 과제를 어떻게 수행하는지 아직 근본적으로 이해하지 못했다. 연구진은 정보 이론을 활용하거나 학습된 표현의 변화를 분석해 이 원리를 밝혀야 한다고 제안했다.
또 QAT 비용 때문에 모든 실험은 한 번씩만 실행했고, 결과에 오차 범위를 표시하지 않았다.
후속 과제로는 NPU 같은 엣지 기기용 하드웨어와의 공동 설계를 제시했다. 층마다, 또는 한 층의 주 경로와 잔차 경로에 비트를 다르게 배분하는 방법도 후속 과제로 꼽았다.5
가장 흥미로운 지점
모나리자 예시는 부록에 짧게 실려 있지만, 나는 퍼플렉시티 표보다 이 예시를 여러 번 다시 읽었다. 0.1 BPW 모델은 “이탈리아 미술의 상징적인 걸작"이라는 그럴듯한 문장으로 시작해서 모나리자를 밀라노 패션계의 조각상으로 바꾼다. 문법과 문체는 멀쩡한데 내용만 틀렸다.
15.92라는 퍼플렉시티가 원본 5.47의 세 배에 가깝다는 것은 알 수 있어도, 그 차이가 실제 문장에서 어떤 모습인지는 숫자만으로 떠올리기 어렵다. 예시를 보면 0.1 BPW 모델에 남은 능력은 영어 문장을 만드는 능력이고, 손상된 능력은 모나리자가 루브르에 있는 그림이라는 지식이다. 압축이 심해질수록 지식이 먼저 손상되고 문장의 형식은 끝까지 유지된다. 이 관찰은 모델이 두 종류의 능력을 서로 다른 방식으로 저장한다는 단서일 수 있다. 한계 절의 세 번째 물음은 바로 이 현상을 설명할 이론을 요구한다. 나는 압축 기법의 수치보다 이 물음의 답이 더 궁금하다.
출처
Banseok Lee, Dongkyu Kim, Youngcheon You, Youngmin Kim (Samsung Research), “LittleBit: Ultra Low-Bit Quantization via Latent Factorization”, NeurIPS 2025. arXiv:2506.13771, 2025년 5월 30일 v1 공개, 2026년 2월 5일 v5 갱신. 정리 기준은 v5다.
원문: https://arxiv.org/abs/2506.13771
코드: https://github.com/SamsungLabs/LittleBit
그림은 모두 원 논문에서 가져왔으며, 논문의 라이선스는 CC BY-NC-ND 4.0이다.
부록 A는 이 주장을 증명 개요 수준의 논증으로 제시했다. 따로 양자화한 두 행렬의 오차 합이 한꺼번에 양자화한 오차보다 작으면 두 단계 방식이 유리하다는 내용이다. 연구진은 실제 LittleBit의 잔차 경로가 이 분석과 다른 방식으로 학습된다고 덧붙였다. ↩︎
커버 그림(논문의 그림 1)은 Llama2-13B 결과다. 이 그림의 STBLLM 곡선은 0.3 BPW 근처에 93.08을, 그보다 낮은 BPW에 893.82를 표시한다. 그런데 논문의 표 1은 Llama2-13B STBLLM의 0.3 BPW 퍼플렉시티를 893.82로 적었다. 본문의 수치는 표 1을 따랐다. ↩︎
HellaSwag와 ARC는 보기 4개 중 하나를 고르는 과제여서 무작위로 골라도 정확도가 25% 안팎이다. WinoGrande는 보기 2개 중 하나를 고르는 과제라 무작위 정확도가 50%이며, 0.3 BPW LittleBit의 WinoGrande 정확도는 51.30%였다. ↩︎
논문의 성능 실험은 32B 모델까지다. 표에는 Llama2-70B의 용량도 있지만, 70B 모델에 QAT를 실제로 적용해 얻은 성능 결과는 논문에 없다. ↩︎
공식 코드 저장소는 후속 연구인 LittleBit-2(ICML 2026)의 구현도 함께 공개하고 있다. ↩︎