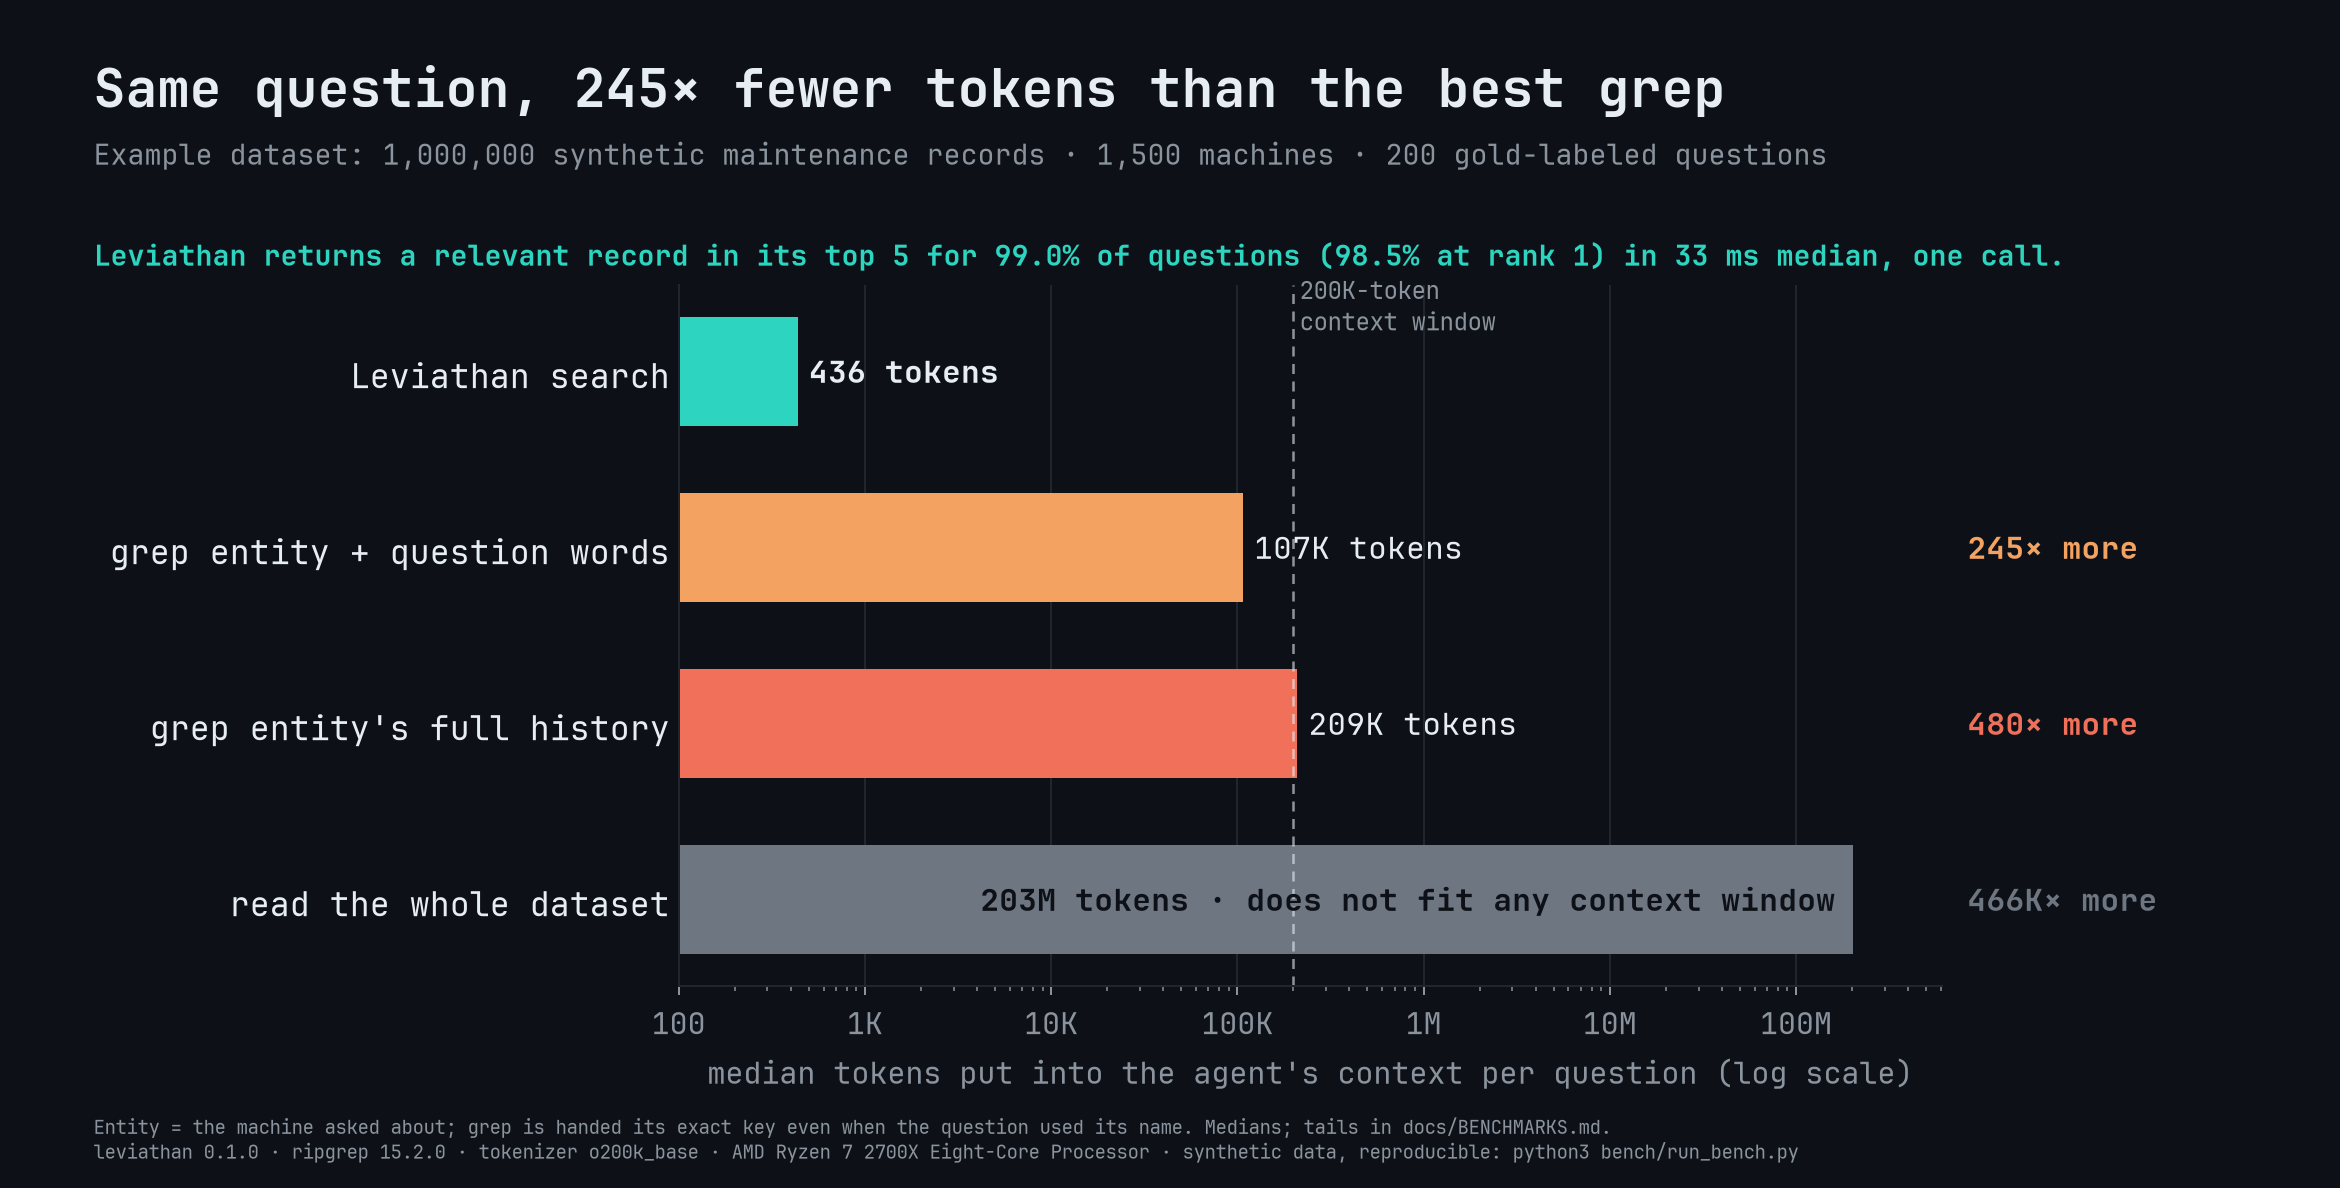
3줄 요약
- 개발자 Joshua Baker(깃허브 계정 elstongun)가 2026년 10월 5일 Rust 프로그램 Leviathan을 Apache-2.0 라이선스로 공개했다. Leviathan은 JSONL, CSV, SQLite 파일, 또는 데이터베이스 CLI가 내보낸 레코드를 SQLite 파일 하나에 전문 검색 인덱스로 만들어 둔다. 에이전트가 평소 말투로 질문하면 레코드 ID가 붙은 짧은 결과 카드를 몇 장 돌려준다. 공개 다음 날 아침 기준으로 스타가 205개, 포크가 12개다.
- 저자가 만든 합성 정비 기록 100만 건(678MB)에서, 질문 하나당 에이전트가 읽게 되는 토큰의 중앙값은 436개였다. grep으로 찾는 방법 가운데 가장 효율이 좋은 방식의 토큰 중앙값은 107,122개로, Leviathan의 245배였다. Leviathan의 결과에서 정답 레코드가 상위 5건에 포함된 질문은 99.0%였고, 1위로 나온 질문은 98.5%였다.
- 검색 방식은 임베딩을 쓰지 않는 BM25 어휘 검색이다. 저자는 한계도 문서에 함께 밝혔다. 데이터는 합성이고, 데이터셋은 하나뿐이며, LLM이 결과를 읽고 최종 답을 내는 과정은 측정하지 않았다.
Leviathan이 하는 일
README 첫머리에서 Leviathan은 자신을 “대규모 데이터셋을 다루는 에이전트를 위한 깊은 기억(Deep memory for agents over large datasets)“이라고 소개한다. 테이블이나 내보낸 파일, 로그를 한 번 인덱싱해 두면 에이전트는 질문에 답하는 레코드 몇 건만 받는다는 설명이다. 여기서 말하는 기억은 에이전트가 대화하면서 적어 둔 메모와 다르다. 고객 지원 티켓, 장애 기록, 설비 정비 기록, 주문 내역처럼 조직이 오랫동안 보관해 온 레코드를 가리킨다.
에이전트가 “이 기계를 지난번에 무엇으로 고쳤나”, “이 고객이 전에도 같은 문제를 겪었나” 같은 질문을 받으면 보통 grep으로 그 기계나 고객의 기록을 찾아 원문을 그대로 읽는다. 그러면 기록이 늘어나는 만큼 읽어야 할 토큰도 늘어난다. Leviathan은 데이터 크기와 관계없이 질문 하나에 돌려주는 분량을 약 450토큰으로 유지하는 것을 목표로 한다.
| 항목 | 내용 |
|---|---|
| 언어 | Rust(최소 버전 1.88). unsafe 코드 사용 금지 |
| 배포 | crates.io 패키지 leviathan-index 0.1.0. 실행 파일 이름은 leviathan1 |
| 저장 형식 | SQLite 파일 하나(FTS5 전문 검색 모듈 사용). 실행하는 데 따로 설치할 것이 없음 |
| 입력 | JSONL과 NDJSON, JSON 배열, CSV와 TSV(gzip 압축 파일 포함), SQLite, 표준 입력, 디렉터리 |
| 에이전트 연결 | CLI와 스킬 파일, 또는 읽기 전용 MCP 서버 |
| 라이선스 | Apache-2.0 |
사용 방식
다음은 Leviathan을 설치하고 저장소의 예제 티켓 데이터를 인덱싱한 뒤, 고객 Acme Corp의 티켓만 검색하는 예시다.
cargo install leviathan-index
cd examples/tickets && leviathan index
leviathan search -g acme "sso login loop after password reset"
위 명령의 영어 검색어는 “비밀번호를 재설정한 뒤 SSO 로그인이 반복된다"는 뜻이다. 이 검색에 Leviathan은 다음과 같은 카드를 돌려준다.
leviathan search · customer C-ACME "Acme Corp" (7 tickets) · query "sso login loop after password reset" · shown 3 of 3 · 24 tickets indexed
[1] T-1001 · 2024-01-08 09:12 · rel 16.9
  Login loops back to sign-in page after password reset
  status: closed · priority: high
  resolution: Cleared stale session cookies on password reset; shipped in 4.2.1. Workaround: clear site data.
  match: Users who reset their password get redirected to the sign-in page again in an endless loop.
...
맨 윗줄은 검색 범위와 결과 수를 알려 준다. 카드마다 첫 줄에는 레코드 ID와 날짜, 관련도 점수가 있고, 그다음 줄부터 제목과 설정한 표시 필드가 나온다. 마지막 match: 줄은 검색 대상 텍스트 가운데 질문 단어와 일치한 부분을 발췌한 것이다. 기본 설정에서 필드 값과 발췌문은 각각 300자까지만 표시되고 나머지는 잘린다.2 레코드 전체가 필요하면 leviathan get <id>로 따로 불러온다.
그룹 한정 옵션 -g는 다음과 같이 동작한다.
- 그룹 키, 이름, 이름의 일부를 모두 받는다. 일치하는 그룹이 여러 개이거나 하나도 없으면 후보 목록을 보여 주고 종료 코드 3으로 끝낸다. README는 이 동작을 “절대 추측하지 않는다(never guess)“고 설명한다.
- 지정한 그룹에서 맞는 레코드를 찾지 못하면 다른 그룹의 결과를 보여 준다. 이때 결과에는
OTHER CUSTOMER처럼 다른 그룹의 레코드라는 표시가 붙는다. -g와 함께--where field=value필터,--since와--until날짜 범위, 따옴표로 감싼 구절 검색,-단어형태의 제외 검색을 쓸 수 있다.
| 명령 | 하는 일 |
|---|---|
init | 데이터를 표본 추출해 필드 매핑 설정 파일을 제안 |
index, upsert, delete | 인덱스 생성, 레코드 추가와 갱신, 레코드 삭제 |
search | 순위를 매긴 레코드 검색 |
recent, resolve, get, describe | 최신순 조회, 그룹 후보 조회, 레코드 전체 조회, 인덱스 요약 |
mcp, wrap | MCP 서버 실행, 에이전트별 MCP 설정 출력 |
종료 코드는 네 가지다. 0은 정상(결과가 0건인 경우 포함), 1은 오류, 2는 잘못된 요청, 3은 그룹을 찾지 못했거나 후보가 여럿인 경우다.
데이터 연결
Leviathan이 알아야 하는 정보는 레코드의 어느 필드가 어떤 역할을 하는지뿐이다. 반드시 지정해야 하는 필드는 id 하나이고, 다른 필드를 지정할 때마다 쓸 수 있는 기능이 늘어난다. 필드는 a.b 같은 중첩 경로나 items[].name 같은 배열 경로로 지정한다.
| 필드 | 쓸 수 있게 되는 기능 |
|---|---|
id | get, upsert, delete, 결과 인용 |
title, text | 카드 제목(검색 가중치 2배), 검색 대상 텍스트(기본값은 모든 문자열 필드) |
group, group_name | -g 그룹 한정 검색, 이름으로 그룹 찾기, 다른 그룹 결과 표시 |
date | --since, --until, recent |
filters, display | --where 필터, 카드에 표시할 필드 |
empty_values, rank.boost | 값이 없는 것으로 처리할 형식적 문구, 내용이 충실한 레코드에 주는 가산점 |
매핑을 정하는 방법은 세 가지이고 함께 쓸 수 있다. 아무것도 지정하지 않으면 leviathan index가 데이터를 보고 추론한다. leviathan init이 제안한 leviathan.toml 파일을 고쳐 쓸 수도 있고, --id나 --group 같은 명령줄 옵션으로 파일의 값을 덮어쓸 수도 있다.
init은 기본 2,000건을 표본으로 삼아 각 필드가 얼마나 자주 나오는지, 서로 다른 값이 몇 개인지, 길이는 얼마인지, 날짜로 해석되는지를 조사한다. 예를 들어 ID 필드로는 레코드의 99% 이상에 나타나고, 값이 모두 다르며, 길이가 짧은 필드를 고른다. 그룹 필드로는 서로 다른 값의 개수가 2개 이상이고 레코드 수의 4분의 1 이하이며, 이름이 customer, host, device 같은 단어와 비슷한 필드를 고른다. 선택마다 이유를 주석으로 달아 두며, 설정 문서는 이 파일을 “풀 리퀘스트처럼 검토하라"고 권한다.
데이터베이스의 경우에는 그 데이터베이스의 CLI가 내보낸 결과를 표준 입력으로 받는다. Leviathan은 데이터베이스 접속 정보를 직접 다루지 않는다.
psql "$DATABASE_URL" -At -c "SELECT row_to_json(t) FROM tickets t" | leviathan index - -c tickets.toml
duckdb -json -c "SELECT * FROM 'events/*.parquet'" | leviathan index - -c events.toml
원본 파일과 매핑이 그대로이면 인덱싱을 건너뛴다. 빌드할 때는 새 인덱스 파일을 끝까지 만든 다음 기존 파일과 한 번에 교체한다. 그 뒤의 변경은 upsert와 delete로 반영한다.
에이전트에 연결하는 두 방법
README가 권하는 방법은 CLI와 스킬 파일의 조합이다. 셸을 쓸 수 있는 에이전트라면 종류와 관계없이 leviathan 명령을 실행할 수 있다. 저장소의 skills/leviathan/SKILL.md를 Claude Code 스킬 폴더에 복사하거나, 내용을 AGENTS.md 또는 .cursor/rules에 붙여 넣으면 된다. 이 방식은 에이전트가 실제로 명령을 실행하기 전까지는 토큰을 쓰지 않는다.
스킬 파일은 에이전트에게 정해진 순서를 지시한다. 세션을 시작하면 먼저 leviathan describe를 한 번 실행해, 이 데이터셋에서 레코드와 그룹을 무엇이라고 부르는지, 어떤 필드로 거를 수 있고 그 필드에 어떤 값이 있는지 확인한다. 검색할 때는 사용자가 한 말을 그대로 검색어로 쓴다. 결과가 0건이면 레코드가 존재하지 않는다고 결론 내리지 말고 단어를 줄이거나 바꿔 다시 찾으라고 한다. 종료 코드 3을 받으면 후보 목록을 보여 주고 사용자에게 어느 그룹인지 물으라고 한다.
MCP 서버는 선택 사항이다. leviathan mcp는 search, resolve_group, get, describe 네 가지 읽기 전용 도구를 표준 입출력으로 제공한다. 도구 설명에는 서버가 지금 사용하는 데이터셋의 요약이 포함된다. 100만 건 인덱스에서 이 도구 목록의 분량은 638토큰이므로, MCP 서버로 등록하면 세션마다 이만큼의 토큰을 쓴다. leviathan wrap claude처럼 실행하면 Claude Code, Cursor, Codex, VS Code, Gemini CLI, Windsurf 같은 클라이언트에 맞는 설정을 출력한다.
검색 방식
레코드는 SQLite 파일 하나에 FTS5 전문 검색 인덱스와 함께 저장된다. 검색은 네 단계로 진행된다.
- 그룹 이름을 해석한다. 키가 정확히 일치하는지, 이름이 일치하는지, 이름의 일부로 포함되는지, 철자가 비슷한지를 순서대로 확인한다.
- FTS5 질의를 한 번 실행한다. 그룹과 필터 값도 인덱싱된 토큰으로 저장되어 있어서 질의 하나로 함께 처리된다. 검색이 끝난 뒤에 결과를 다시 거르는 단계는 없다.
- BM25 점수에 설정한 가중치를 곱해 순위를 매긴다.
- 상위 N건만 복원해서 길이 제한이 있는 카드로 만든다.
세부 처리도 몇 가지 있다. 그룹 한정 검색에서는 레코드에 포함된 그 그룹의 이름을 검색어와 일치한 것으로 치지 않는다. “done” 같은 형식적 문구는 값이 없는 것으로 처리한다. 모든 응답에는 shown N of M을 붙여서, 에이전트가 조건에 맞는 레코드가 없는 경우와 데이터 자체가 없는 경우를 구분할 수 있게 했다.
벤치마크 설계
벤치마크 문서는 에이전트가 큰 데이터셋에서 대상 하나에 관한 질문을 받았을 때 얼마나 많은 분량을 읽어야 하는지, 그리고 답을 찾을 수 있는지를 측정한다.
데이터
벤치마크 데이터는 가상 시설의 정비 기록이다. bench/synth 생성기가 만들며, 같은 인자를 주면 항상 같은 바이트를 출력한다. 문서에 따르면 이 생성기는 검색 엔진에 “불친절하게” 설계되었다. 엔진이 이 데이터에 관해 아는 정보는 매핑 파일 하나뿐이다.
| 속성 | 값 |
|---|---|
| 대상 | 기계 1,500대, 가상의 기계 종류 11가지(공조기, 프레스, 크레인, 톱 등) |
| 기록 편중 | 지수가 0.75인 지프(Zipf) 분포. 기록이 가장 많은 기계는 수만 건 |
| 기록 구성 | 계획 정비 50%, 고장 수리 38%, 작업 요청 12%. 기간은 2014년부터 2026년까지 |
| 고장 유형 | 27가지(공통 7가지, 기계 종류에 따라 다른 20가지). 기계마다 반복되는 만성 고장이 한두 가지 |
| 형식적 기록 | 고장 수리 해결 내용의 27%는 “done”, “fixed”, “see notes” 같은 문구이고 15%는 비어 있음. 계획 정비 기록의 82%는 형식적 문구만 있음 |
| 방해 요소 | 같은 부품을 언급하는 계획 정비 체크리스트, 자유 메모, 관련 없는 작업 요청 |
질문과 정답
규모마다 질문 200개를 만든다. 질문 하나를 만들 때마다 기계 한 대와, 그 기계에서 실제로 조치한 증거가 남은 고장 유형 하나를 고른다. 질문 문장은 레코드 문장을 복사하지 않고 별도의 질문용 어휘로 만든다. 기계를 부르는 방식도 사람이 부르듯 다양하게 바꾼다. 질문의 50%는 키(HPR-Q01)로, 30%는 이름(“Hall Q Hydraulic Press 01”)으로, 20%는 소문자 이름으로 기계를 부른다.
정답 레코드는 질문과 같은 기계, 같은 고장 유형의 레코드 가운데 해결 내용, 실행한 작업, 사용한 부품, 기술자 메모 같은 증거가 있는 것이다. 100만 건 규모에서 질문 하나에 해당하는 정답 레코드는 중앙값 90건이고, 그중 하나만 찾아도 답한 것으로 인정한다.
비교한 방식
| 방식 | 내용 |
|---|---|
| Leviathan | leviathan search -g <질문 속 기계 표기> "<질문>" -n 5 호출 1회 |
| 단어 필터 grep | 기계 키로 거른 결과를 질문의 내용어(3글자 이상, 불용어 제외)로 한 번 더 거름 |
| 이력 전체 grep | 기계 키로 거른 전체 기록. 에이전트가 “이 기계의 이력을 살펴본다"고 할 때 읽는 양 |
| 데이터셋 전체 읽기 | 파일 전체. 규모마다 한 번만 계산 |
grep 방식에는 질문이 기계를 이름으로 불렀더라도 정확한 키를 미리 제공했다. 실제 에이전트라면 키를 먼저 알아내야 하므로, 문서는 grep 방식의 결과를 낙관적인 수치로 본다.
토큰 수는 에이전트의 컨텍스트에 들어갈 출력을 tiktoken o200k_base로 센 값이다.3 코딩 에이전트는 도구 출력을 흔히 30,000자에서 자르므로, 저자는 grep 출력의 처음 30,000자에 정답 레코드 ID가 포함되었는지를 기준으로 grep 방식이 답을 찾았는지 판정했다. 길이 제한을 두지 않았을 때 정답 레코드를 포함한 grep 출력은 98.5%에서 100% 사이였다.
벤치마크 결과
100만 건 기준
| 100만 건(678MB) | Leviathan | 가장 효율이 좋은 grep 방식 |
|---|---|---|
| 질문당 토큰 중앙값 | 436 | 107,122(245배) |
| 정답 레코드 반환 | 상위 5건 99.0%, 1위 98.5% | 30,000자로 자른 출력 기준 96.0% |
| 최악의 경우 | 602토큰(전체 질문 1,200개 중 최대) | 970만 토큰 |
| 응답 시간 중앙값 | 33ms | 92ms |
규모에 따른 변화
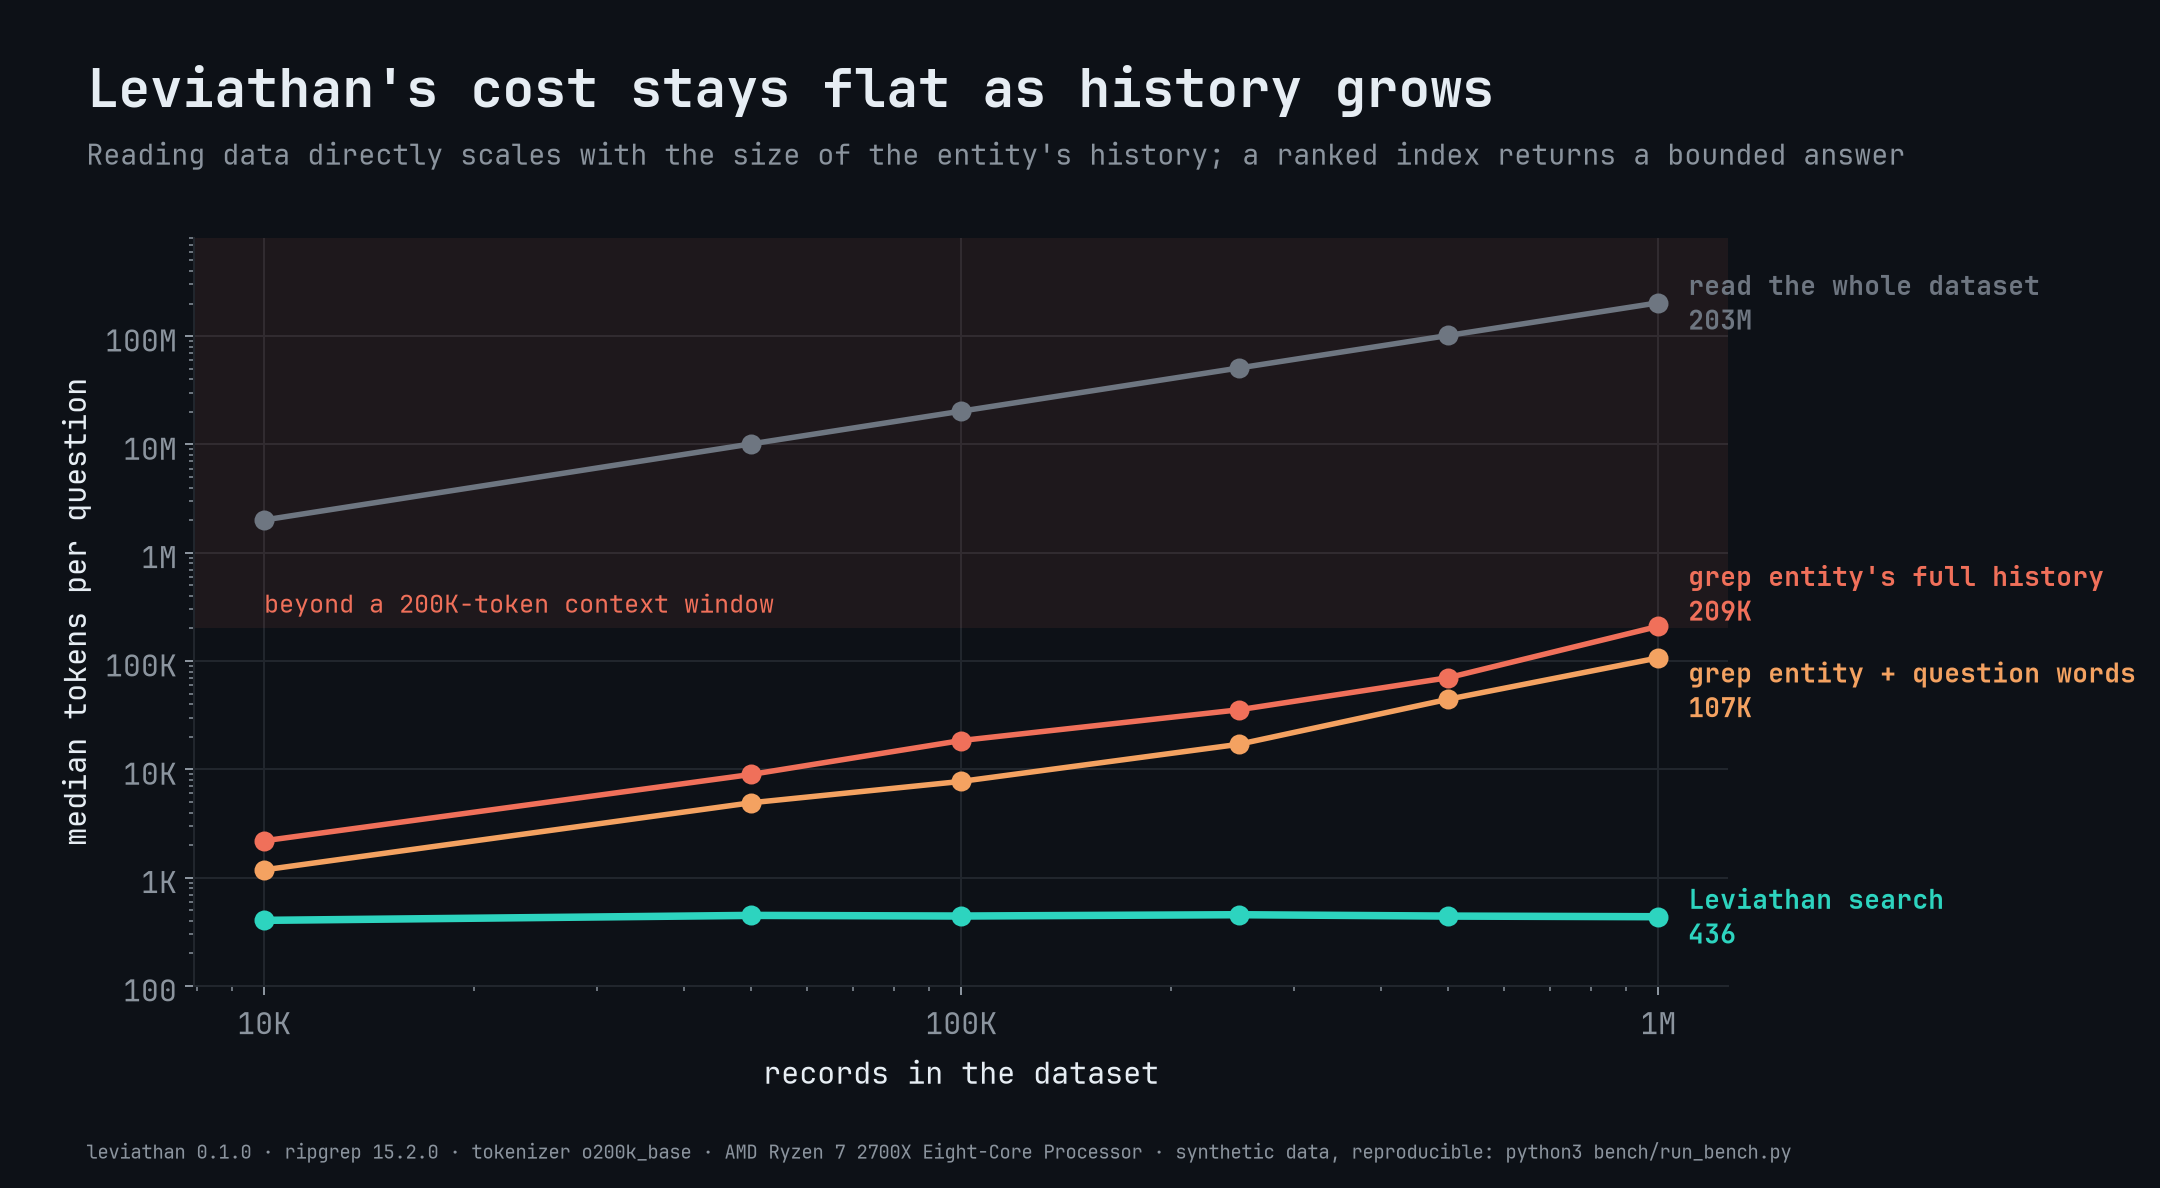 데이터셋 크기에 따른 질문당 토큰 중앙값(로그 눈금). 저장소
docs/assets의 그래프다.
| 레코드 수 | 데이터 크기 | Leviathan 토큰 중앙값 | 단어 필터 grep | 이력 전체 grep | Leviathan 1위 / 상위 5건 |
|---|---|---|---|---|---|
| 10,000 | 7MB | 404 | 1,182 | 2,193 | 90.0% / 97.5% |
| 50,000 | 34MB | 449 | 4,923 | 8,992 | 91.0% / 95.0% |
| 100,000 | 68MB | 443 | 7,750 | 18,484 | 93.5% / 98.0% |
| 250,000 | 170MB | 456 | 17,044 | 35,496 | 94.0% / 98.0% |
| 500,000 | 339MB | 442 | 44,479 | 70,336 | 94.5% / 97.0% |
| 1,000,000 | 678MB | 436 | 107,122 | 209,412 | 98.5% / 99.0% |
데이터가 1만 건에서 100만 건으로 늘어나는 동안 Leviathan의 토큰 중앙값은 404에서 456 사이를 유지했다. 1위 정답률은 규모가 클수록 높아져서, 1만 건에서 90.0%였던 값이 100만 건에서는 98.5%가 되었다. 문서는 데이터가 커질수록 질문마다 정답 레코드가 많아지고 단어 통계도 좋아진다는 점을 이유로 든다. 1만 건 규모에서는 질문마다 정답 레코드가 몇 건 되지 않아서, 질문과 공통 단어가 하나도 없는 경우 정답이 1위가 되지 못하고 2위에서 5위 사이에 나왔다고 한다.
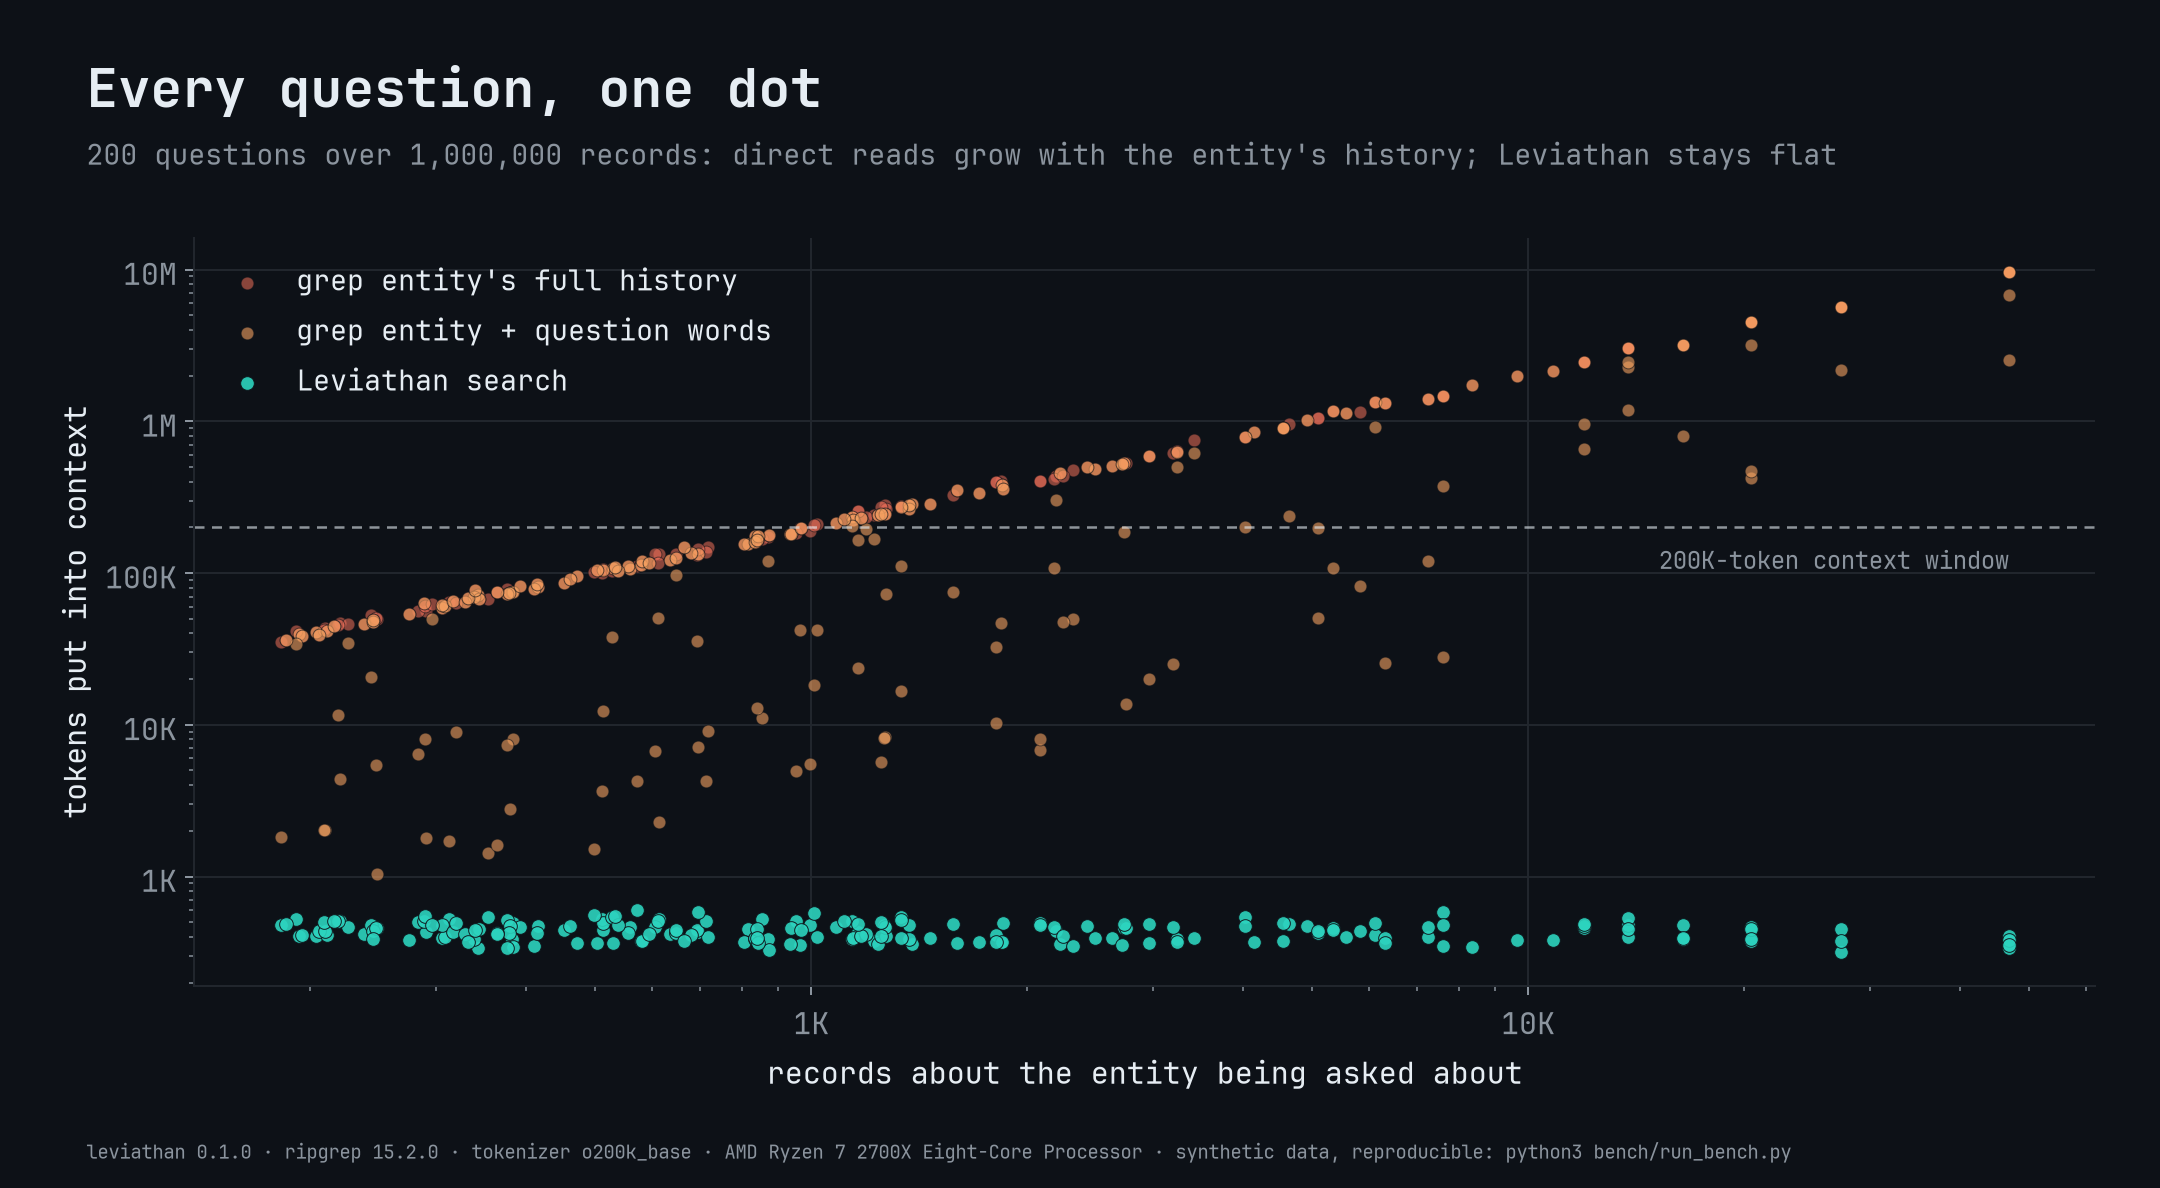 질문 하나당 점 하나. 가로축은 질문 대상 기계의 기록 수, 세로축은 컨텍스트에 들어간 토큰 수다.
문서는 중앙값이 grep 방식의 비용을 실제보다 작게 나타낸다고 지적하면서, 에이전트가 실제로 실패하는 경우는 기록이 많은 기계에 관한 질문이라고 설명한다. 100만 건 규모에서 이력 전체 grep의 토큰 수는 평균이 840,727개, 90번째 백분위수가 2,465,482개였다. 토큰 수가 컨텍스트 창 크기인 20만 토큰 이하인 질문은 50%뿐이었다. 같은 규모에서 Leviathan은 평균 437토큰, 최대 602토큰이었다. 출력 형식을 --json으로 바꾸면 100만 건 기준 중앙값이 약 555토큰으로 늘어난다.
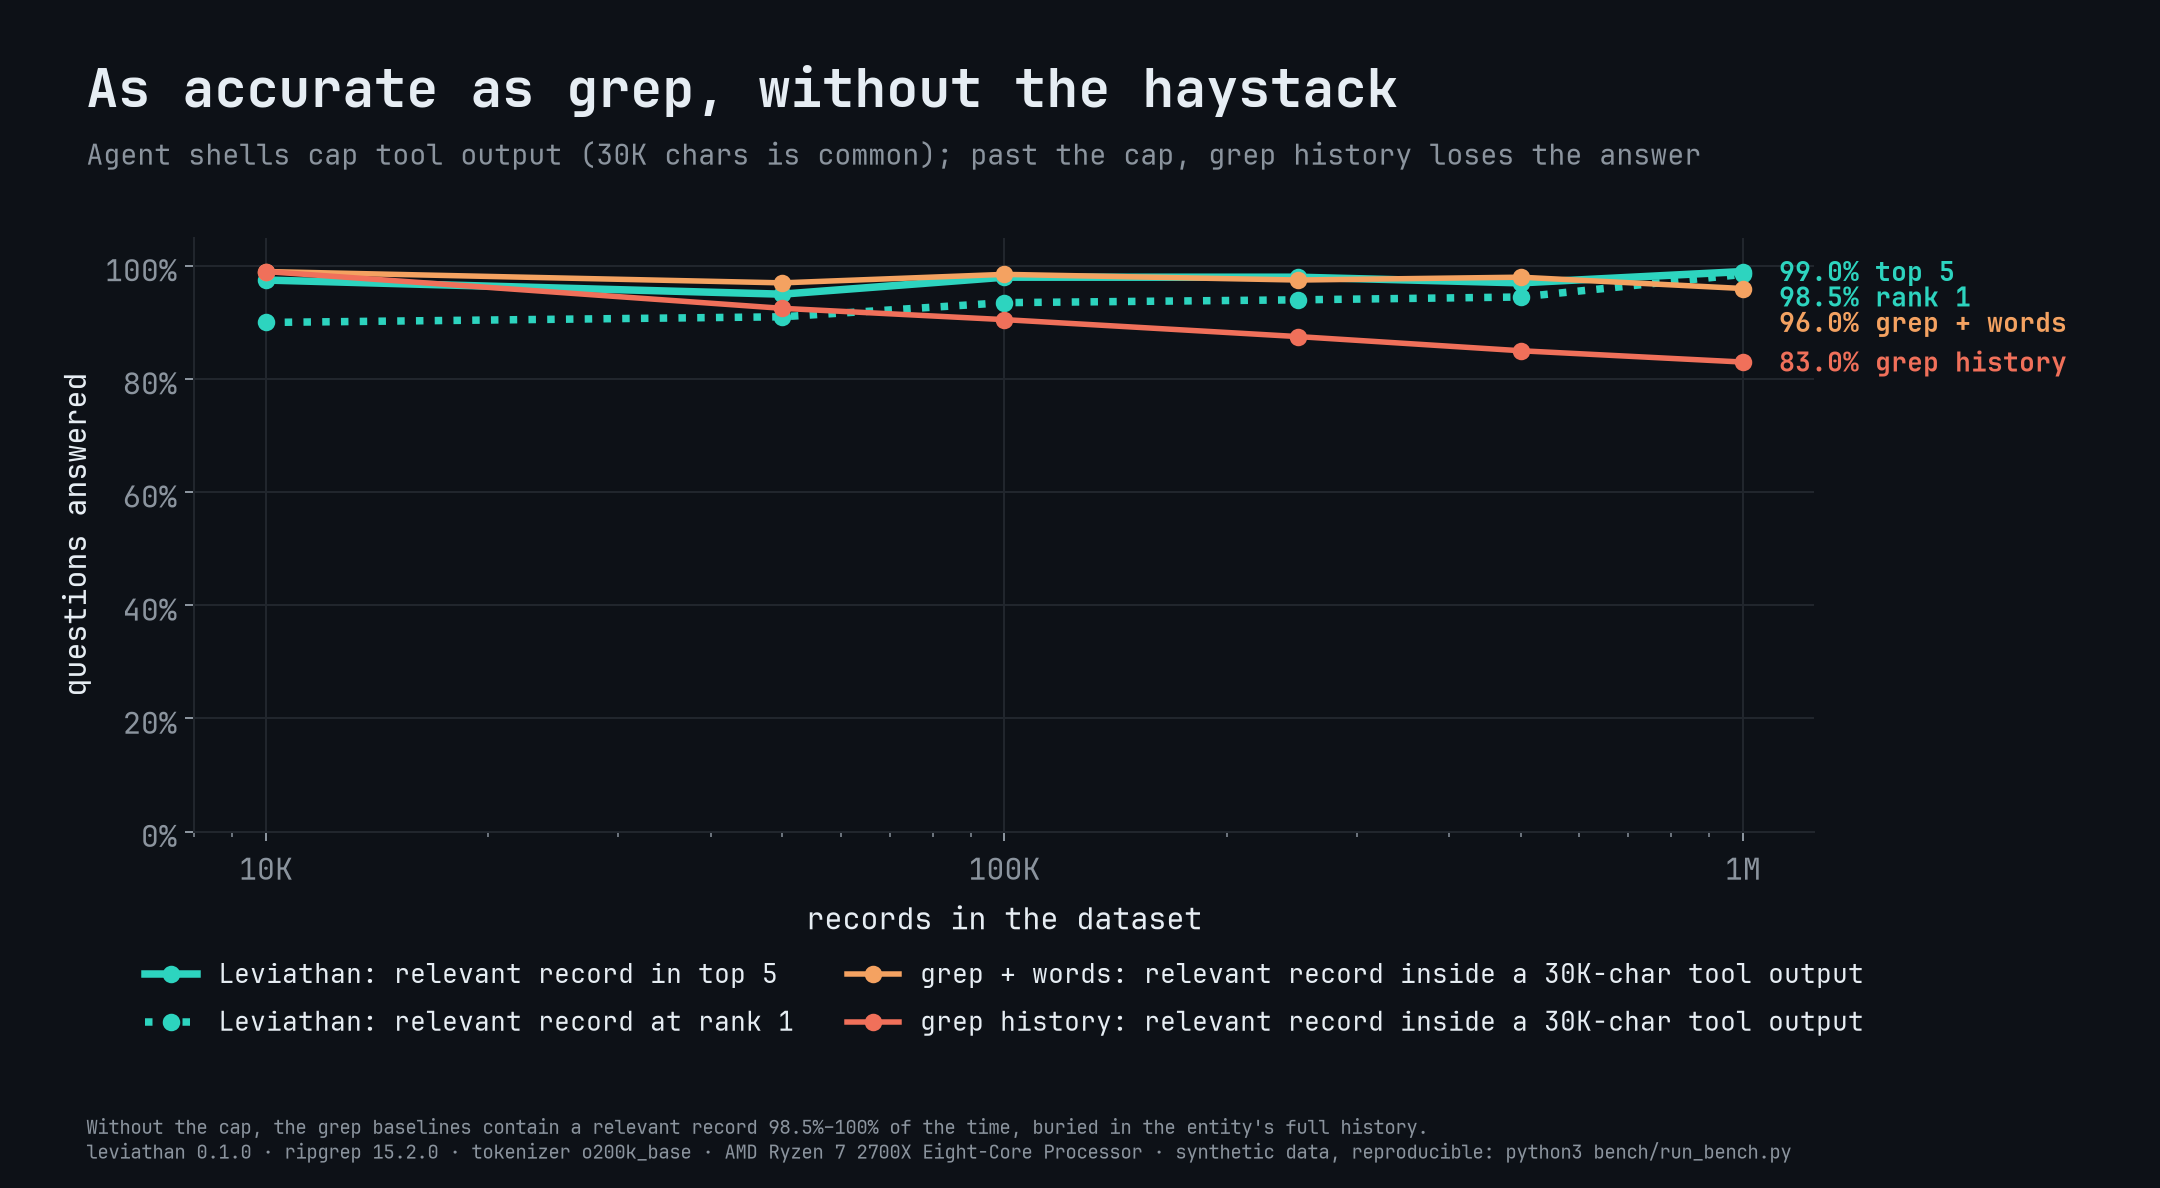 규모별 정답률. grep 방식은 출력을 30,000자에서 잘랐을 때의 값이다.
질문마다 정답 레코드가 여럿이어서 그중 일부는 키워드 일치로 출력 앞부분에 나오고, 그 덕분에 단어 필터 grep도 처음 30,000자에 정답이 포함되는 비율이 높았다(100만 건에서 96.0%). 문서는 그렇더라도 에이전트가 순위 없이 나열된 약 7,500토큰 분량의 줄을 읽고 판단해야 한다고 지적한다. 30,000자보다 긴 출력은 그냥 잘려 버린다는 점도 덧붙인다. 이력 전체 grep은 기록이 길수록 정답 레코드가 잘려 나간 뒷부분에 있는 경우가 많아져서, 100만 건에서 정답률이 83.0%까지 떨어졌다.
응답 시간과 인덱싱
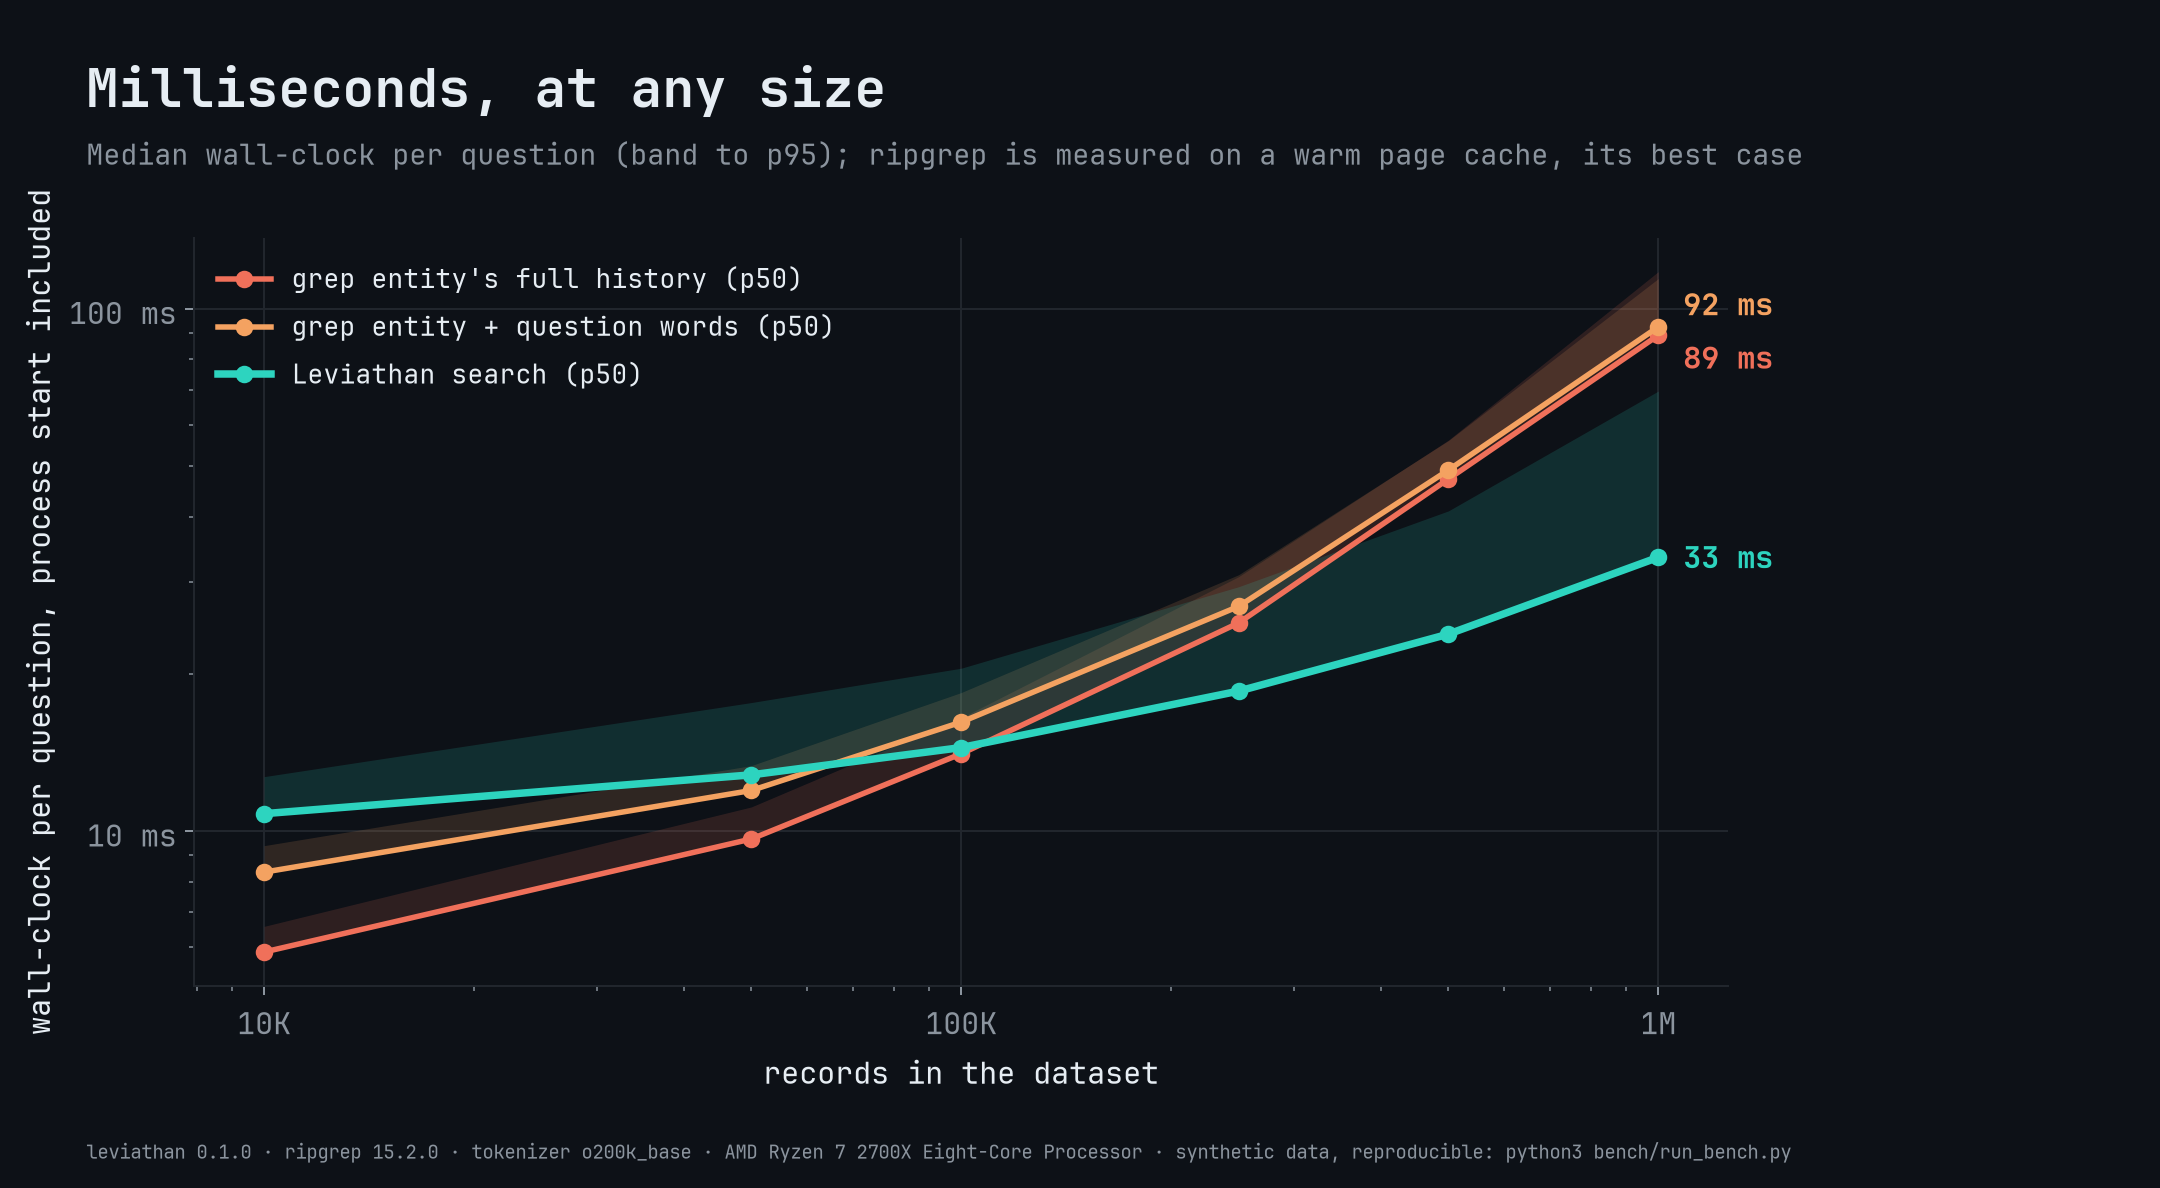 질문당 응답 시간 중앙값. 음영은 95번째 백분위수까지의 범위이고, ripgrep은 검색할 파일이 이미 메모리의 페이지 캐시에 올라와 있는 상태에서 측정했다.
| 레코드 수 | Leviathan p50 / p95 | 이력 전체 grep p50 |
|---|---|---|
| 10,000 | 10.8 / 12.7ms | 5.9ms |
| 100,000 | 14.5 / 20.5ms | 14.1ms |
| 1,000,000 | 33.4 / 69.6ms | 88.9ms |
10만 건까지는 grep이 Leviathan과 같거나 더 빠르다. 이 규모에서 Leviathan이 쓰는 시간은 대부분 프로세스를 시작하고 인덱스를 여는 데 들어간다. 그래도 저자는 모델이 약 10만 7천 토큰을 읽는 데 grep의 90밀리초보다 훨씬 긴 시간이 걸린다는 점을 들어, 에이전트에게는 응답 시간보다 토큰 수가 중요하다고 판단한다.
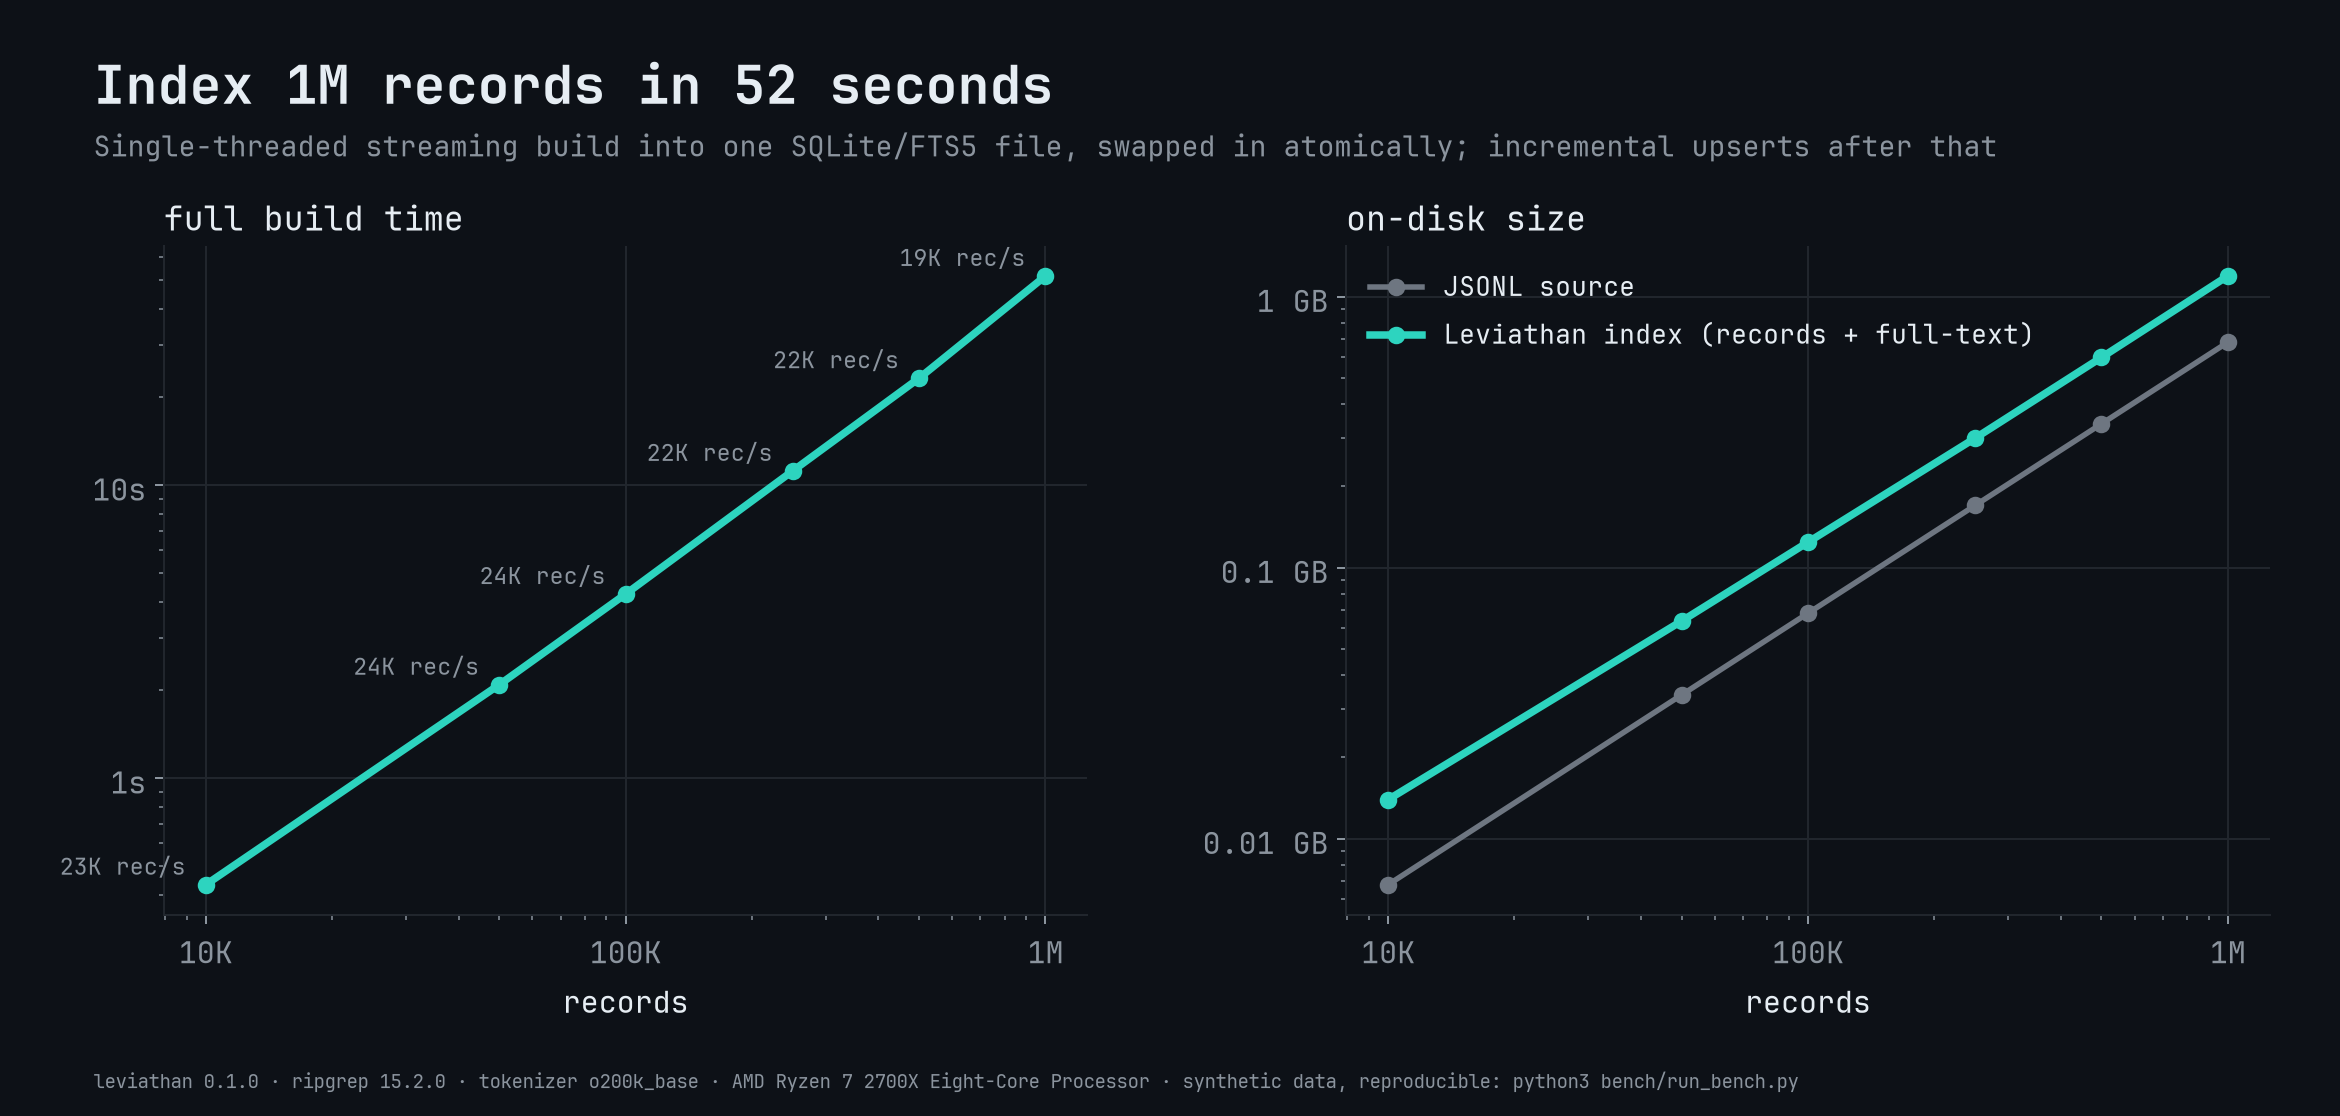 인덱스 빌드 시간(왼쪽)과 디스크 크기(오른쪽).
| 레코드 수 | 빌드 시간 | 처리량 | 인덱스 크기(원본 크기) |
|---|---|---|---|
| 10,000 | 0.4초 | 초당 23K건 | 14MB(7MB) |
| 100,000 | 4.3초 | 초당 24K건 | 124MB(68MB) |
| 1,000,000 | 52초 | 초당 19K건 | 1.2GB(678MB) |
빌드는 단일 스레드에서 스트리밍 방식으로 진행된다. Leviathan은 카드를 표시하고 get 요청에 응답하려고 레코드 원문을 전문 인덱스, 필터 값 집계와 함께 저장하므로, 인덱스 크기가 원본의 약 1.8배가 된다. 측정 환경은 AMD Ryzen 7 2700X(8코어 16스레드), 리눅스, Leviathan 0.1.0 릴리스 빌드, ripgrep 15.2.0, 파이썬 3.12였다.
저자가 밝힌 한계
벤치마크 문서에서 한계를 다루는 부분은 “수치를 인용하기 전에 읽어 달라"는 당부로 시작한다.
- 합성 데이터다. 실제 데이터는 텍스트가 더 지저분하고 어휘 차이도 크다. 그래서 정확도는 상한으로, 토큰 수는 대표값으로 받아들이라고 한다.
- 데이터셋이 하나다. 이 수치는 대상마다 기록이 많고 질문이 대상 하나에 관한 형태인 데이터에서 나왔다. 자연스러운 그룹이 없는 데이터나 데이터 전체를 묻는 질문에서는 결과가 달라진다.
- 검색만 측정했다. LLM이 출력을 읽고 최종 답을 내는 과정은 측정하지 않았다. LLM을 포함한 벤치마크는 로드맵에 있다.
- 비교 기준을 일부러 단순하게 잡았다. 신중한 에이전트라면 키워드를 바꿔 가며 여러 번 검색하거나, 결과를 페이지 단위로 차례로 조회하거나,
jq를 쓸 수 있다. 문서는 그런 방법도 호출과 토큰이 더 들고, 모든 방법이 원본 레코드를 읽는 데서 시작한다고 덧붙인다. - 어휘 검색이다. 어간 추출을 적용한 BM25를 쓰므로, 뜻이 같아도 단어가 다르면 일치하지 않는다. 기록에 “leak”(누수)이라고 적혀 있는데 질문에서 “weeping”(스며 나옴)이라고 물으면, 이 단어로는 찾지 못하고 질문의 다른 단어로 찾아야 한다.
- 한 대의 컴퓨터에서 한 번 측정했다. 응답 시간은 2018년에 나온 데스크톱 CPU 한 대에서 잰 값이다.
저장소는 이 수치가 유지되는지 계속 확인하는 장치도 갖추었다. CI의 bench-smoke 작업은 풀 리퀘스트마다 1만 건 규모 벤치마크를 돌려, 상위 5건 정답률이 93% 미만으로 떨어지거나 Leviathan 출력의 토큰 중앙값이 1,500을 초과하면 실패로 처리한다. 순위 계산을 바꾸는 풀 리퀘스트에는 변경 전후의 벤치마크 수치를 함께 제출해야 한다.
저장소의 AGENTS.md에는 Leviathan 코드를 수정하는 코딩 에이전트가 지킬 규칙이 적혀 있다. 엔진 코드는 특정 종류의 데이터를 가정하지 않고, 도메인 지식은 설정 파일로만 넣는다. MCP 서버는 읽기 전용으로 유지하며, 쓰기 도구, SQL 직접 실행, 파일 접근 기능은 두지 않는다. 출력을 자를 때는 말줄임표(…)나 shown N of M으로 표시하고, 건너뛴 입력 레코드는 몇 건인지 세어서 알린다. 벤치마크의 정답 라벨은 생성기에서만 가져오고, 순위 계산 결과를 정답의 근거로 삼지 않는다.
가장 흥미로운 지점
Leviathan이 쓰는 검색 기술이 생각보다 평범해서 나는 조금 놀랐다. BM25는 1990년대에 정립된 순위 함수이고, FTS5는 SQLite에 기본으로 포함된 전문 검색 모듈이다. 임베딩도 벡터 인덱스도 쓰지 않는다. 비교 대상이 grep이었으니 245배라는 차이도 납득이 간다. 같은 벤치마크에서 임베딩 기반 검색과 비교한 수치는 문서에 없다.
저자는 검색 기술보다 에이전트가 결과를 잘못 읽지 않게 하는 장치에 공을 들였다. 그룹 이름이 모호하면 후보를 보여 주고 종료 코드 3으로 끝낸다. 결과가 0건이어도 shown 0 of M으로 검색 범위를 함께 알린다. 다른 고객의 레코드에는 OTHER CUSTOMER를 붙이고, “done” 같은 형식적 문구는 값이 없는 것으로 친다. 에이전트는 질문이 어느 고객에 관한 것인지 짐작으로 정하기도 하고, 검색 결과가 0건이면 그런 기록이 없다고 단정하기도 하며, 다른 고객의 해결 사례를 이 고객의 이력처럼 전하기도 한다. 앞의 장치들은 이 세 가지 실수에 하나씩 대응한다. 사람 사용자라면 화면을 보고 알아챘을 문제도 에이전트는 그대로 답에 반영해 버린다. 이 때문에 출력 형식 자체가 그런 잘못을 미리 방지하도록 설계됐다고 나는 읽었다.
벤치마크도 응답 시간이나 정확도보다 컨텍스트에 들어가는 토큰 수를 주된 지표로 삼았다. 문서는 10만 건까지 grep이 더 빠르다는 측정 결과도 숨기지 않았다. 모델이 카드 다섯 장, 합쳐서 436토큰 안팎인 검색 결과를 받았을 때 실제로 맞는 답을 내는지는 아직 측정되지 않았다. 저자가 로드맵에서 예고한 LLM 포함 벤치마크가 나와야 이 여부를 확인할 수 있다.
저자의 깃허브 소개에는 “전에는 고빈도 매매 일을 했고, 지금은 지능형 제조 분야에서 일한다"고 적혀 있다. 벤치마크 데이터는 공장 설비의 정비 기록이고, 계획 정비 기록의 82%에는 “done"이나 “fixed” 같은 문구만 남도록 만들어졌다.
출처
Joshua Baker(GitHub elstongun), Leviathan 0.1.0, Apache-2.0 License. 2026년 10월 5일 공개.
원문: https://github.com/elstongun/leviathan
벤치마크 문서: https://github.com/elstongun/leviathan/blob/main/docs/BENCHMARKS.md
설정 문서: https://github.com/elstongun/leviathan/blob/main/docs/CONFIG.md
커버와 본문의 그래프는 모두 저장소 docs/assets의 이미지이며 Apache-2.0 라이선스를 따른다. 스타 수와 포크 수, 릴리스 현황은 2026년 10월 6일 오전(한국 시간) 기준이다.
README는 미리 빌드한 실행 파일을 Releases 페이지에서 받을 수 있다고 안내한다. 10월 6일 오전 기준으로
v0.1.0태그와 릴리스 빌드 워크플로는 있지만 공개된 릴리스는 없다. crates.io에는 10월 5일(UTC) 0.1.0이 등록됐다. ↩︎전역 옵션
--max-chars나 환경 변수LEVIATHAN_MAX_CHARS로 이 길이를 바꿀 수 있고, 최솟값은 40자다. ↩︎1MB 미만의 출력은 토큰을 정확히 셌고, 그보다 큰 출력은 고르게 뽑은 512줄 표본으로 추정했다. 100만 건 규모에서 가장 큰 출력 네 개(10MB에서 32MB)는 추정값을 정확히 센 값과 비교했고, 오차는 최대 0.28%였다. ↩︎