3줄 요약
- LemonSlice가 2026년 9월 23일 인터랙티브 아바타 모델 Character World Model-1(CWM-1)을 공개했다. CWM-1은 대화가 진행되는 동안 캐릭터의 얼굴, 몸, 손과 주변 장면까지 모든 프레임을 실시간으로 생성하는 인과적(causal) 비디오 확산 트랜스포머다. 웹 앱은 누구나 무료로 이용할 수 있고, API는 Enterprise와 Ultra 고객에게만 제공된다.
- LemonSlice는 이 모델을 캐릭터 월드 모델이라고 부른다. CWM-1은 사진 한 장만 있으면 사람이든 애니메이션 캐릭터든 동물이든 전신을 애니메이션한다. 손으로 옷깃과 머리카락을 만지는 물리 상호작용과 물이 흐르는 배경도 생성한다. 내장된 감정 엔진은 대화를 듣고 캐릭터가 지을 표정과 취할 행동을 예측한다.
- 발표문은 모델을 만들며 풀어야 했던 난제 다섯 가지를 소개했다. LemonSlice는 표현력을 높이기 위해 비디오 DiT를 직접 학습했다. 사용자가 말을 끊으면 471ms 만에 반응하도록 어텐션을 인과적으로 바꿨고, 확산 스텝을 증류해 재생 속도보다 빠르게 프레임을 생성한다. 오차 누적은 GAN 기반 학습과 어텐션 가중치 조절을 결합해 해결했고, 비용은 GPU 대역폭 병목을 해소하는 커스텀 커널로 낮췄다고 한다.
CWM-1은 무엇인가
LemonSlice는 CWM-1을 세계에서 제어력이 가장 높은 인터랙티브 아바타 모델이라고 소개했다. 발표문의 요약에 따르면 CWM-1은 인과적 비디오 DiT(Diffusion Transformer)를 소수 스텝으로 증류한 모델이다. 이 모델은 행동과 감정을 조건으로 받아 영상을 생성하며, 길이 제한 없이 더 높은 해상도와 매우 낮은 지연 시간으로 영상을 만들어 낸다고 한다. 캐릭터가 하는 말과 별개로, 캐릭터의 행동과 감정은 내장 감정 엔진이 결정한다.
발표문은 첫머리에서 CWM-1의 특징을 네 가지로 정리했다.
| 특징 | 설명 |
|---|---|
| 모든 캐릭터 | 이미지 한 장을 넣으면 곧바로 라이브 아바타가 만들어진다. 파인튜닝이나 대기 시간이 필요 없다 |
| 전신 | 제스처와 몸짓 언어, 공간 속 이동까지 생성한다 |
| 손과 사물의 상호작용 | 사물, 옷, 머리카락과의 현실적인 물리 상호작용을 생성한다 |
| 제어 가능성 | 대화 내용에 어울리는 행동과 감정을 표현한다 |
말하는 얼굴에서 장면 속의 캐릭터로
지난 몇 년 동안 “AI 아바타"는 입술만 움직이는 얼굴을 뜻하는 말로 쓰였다고 발표문은 적었다. 하지만 사람은 그런 방식으로 소통하지 않는다고 한다. 사람은 대화하면서 어깨를 으쓱하고, 손가락으로 가리키고, 몸을 기울이고, 머리카락을 만지작거리고, 휴대폰을 흘끗 보고, 무언가를 가지러 걸어간다. 발표문은 대화를 실감 나게 하는 요소 대부분이 몸짓에서 나온다고 설명했다.
LemonSlice는 인간과 AI 사이의 다음 인터페이스가 얼굴을 마주하고 대화하는 캐릭터가 되리라 본다. 인터넷 트래픽의 82%가 영상이라는 통계를 보면 사람들은 대체로 글을 읽기보다 영상을 보는 편을 택한다고, LemonSlice는 근거를 댔다. 이 때문에 LemonSlice는 미래의 ChatGPT가 챗봇보다는 FaceTime 통화나 TikTok 영상과 더 비슷할 것이라고 전망했다.
그러려면 인터랙티브 아바타 모델은 얼굴을 애니메이션하는 데 그쳐서는 안 된다. 모델은 몸짓 언어, 물리적 환경, 빛, 감정을 이해하고 이를 실시간으로 시뮬레이션해야 한다. LemonSlice는 이런 모델을 캐릭터 월드 모델(Character World Model)이라고 부르고, “실시간으로 듣고, 말하고, 반응하는 캐릭터를 주인공으로 하는 월드 모델"로 정의했다. 캐릭터는 하나의 세계에 살면서 그 세계를 돌아다닐 수 있고, 자신이 누구이며 어떤 기분인지에 대한 내부 상태를 가진다. 이 기법을 처음 선보인 곳이 자신들이라고 LemonSlice는 밝혔다.
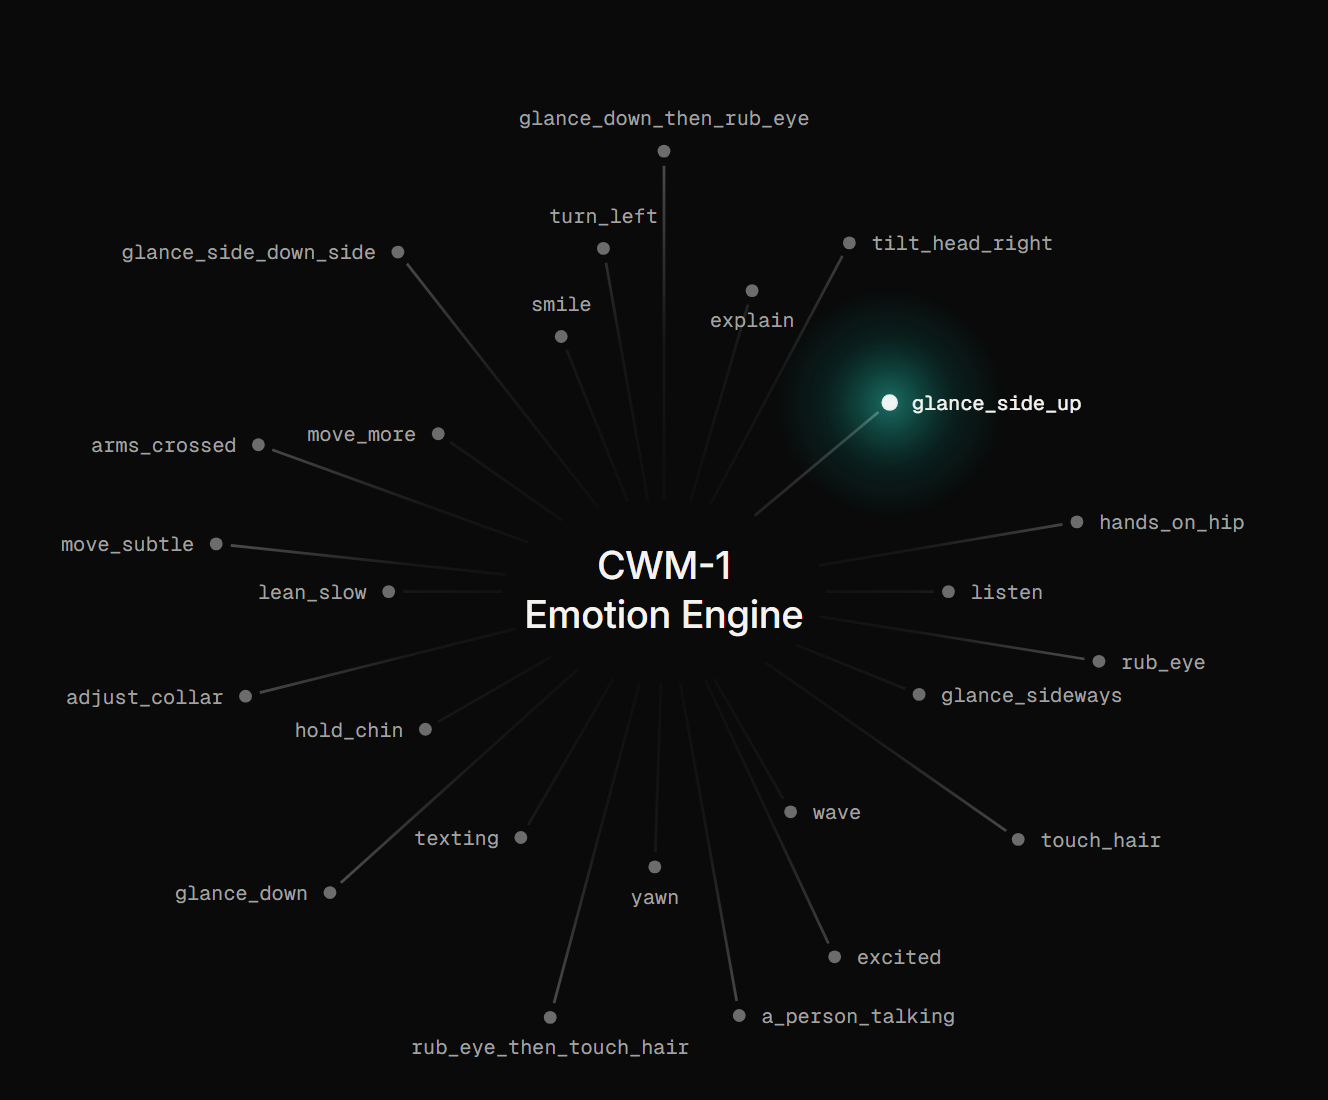
그림은 CWM-1이 가진 행동 상태의 일부를 보여 준다. 감정 엔진은 캐릭터의 내부 상태가 바뀔 때마다 행동 상태를 실시간으로 전환한다. 발표문은 이 모델의 의미를 다음과 같이 설명했다.
CWM-1은 아바타 튜링 테스트 통과라는 우리 목표를 위한 또 하나의 진전이다. 아바타 튜링 테스트란 화상 통화 상대가 사람인지 아닌지 구별할 수 없는 상태를 말한다.
다섯 가지 기능
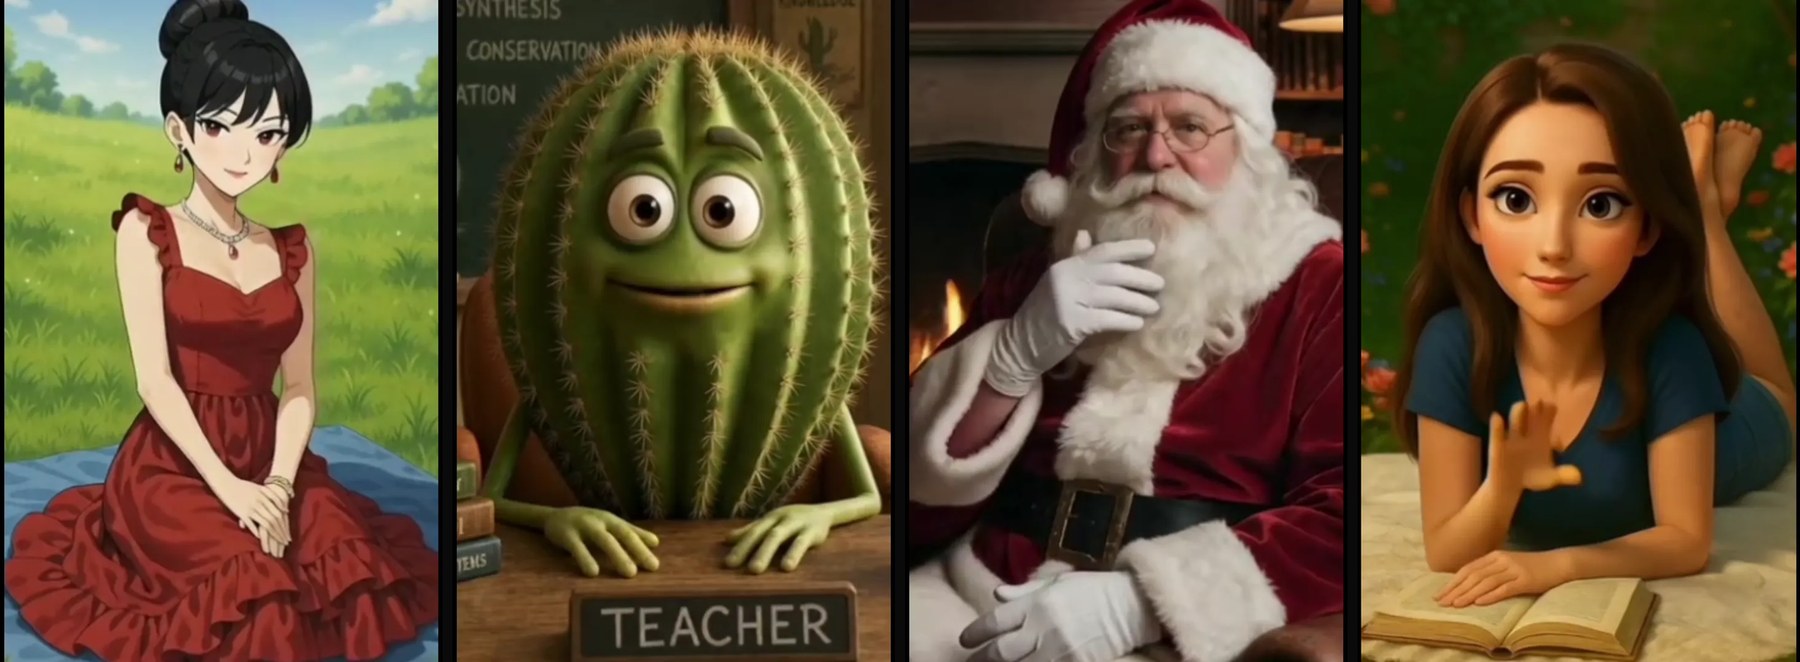
발표문에 따르면 CWM-1은 입력 오디오와 프롬프트를 받아 캐릭터와 몸짓, 장면 전체를 처음부터 생성한다. 하나의 모델이 전 과정을 처리하는 엔드투엔드 비디오 확산 트랜스포머다. 개발자는 감정 엔진으로 캐릭터가 무엇을 할지 정밀하게 지정할 수 있다. 모델은 사람, 애니메이션 캐릭터, 동물 등 어떤 종류의 캐릭터에도, 어떤 화풍에도 일반화된다고 한다.
어떤 캐릭터든 즉시 전신을 애니메이션한다
CWM-1은 캐릭터별 학습 없이 어떤 캐릭터든 얼굴, 손, 어깨, 자세를 애니메이션한다. 사용자가 자기 사진이나 애니메이션 캐릭터, 반려견 사진을 넣으면 몸 전체가 움직인다.
감정 엔진
감정 엔진은 대화하는 동안 캐릭터가 어떻게 움직이고 행동할지를 제어한다. 개발자는 LemonSlice가 제공하는 기본 감정 엔진 가운데 하나를 사용하거나, 도구 호출(tool call)로 감정 엔진을 직접 만들 수 있다.
발표 페이지에는 행동 스무 가지의 예시 영상이 실려 있다. 표정과 감정으로는 미소, 웃음, 화남, 혼란, 하품을 보여 준다. 몸짓으로는 손 흔들기, 끄덕임, 키스 날리기, 하트 손, 춤, 몸 앞으로 기울이기, 팔짱 끼기, 자기 몸 껴안기, 두리번거리기가 있다. 나머지 여섯 가지는 턱, 머리카락, 옷깃, 눈을 만지는 동작과 문자 보내기, 전화 통화처럼 손을 쓰는 동작이다.
세계를 만지는 손
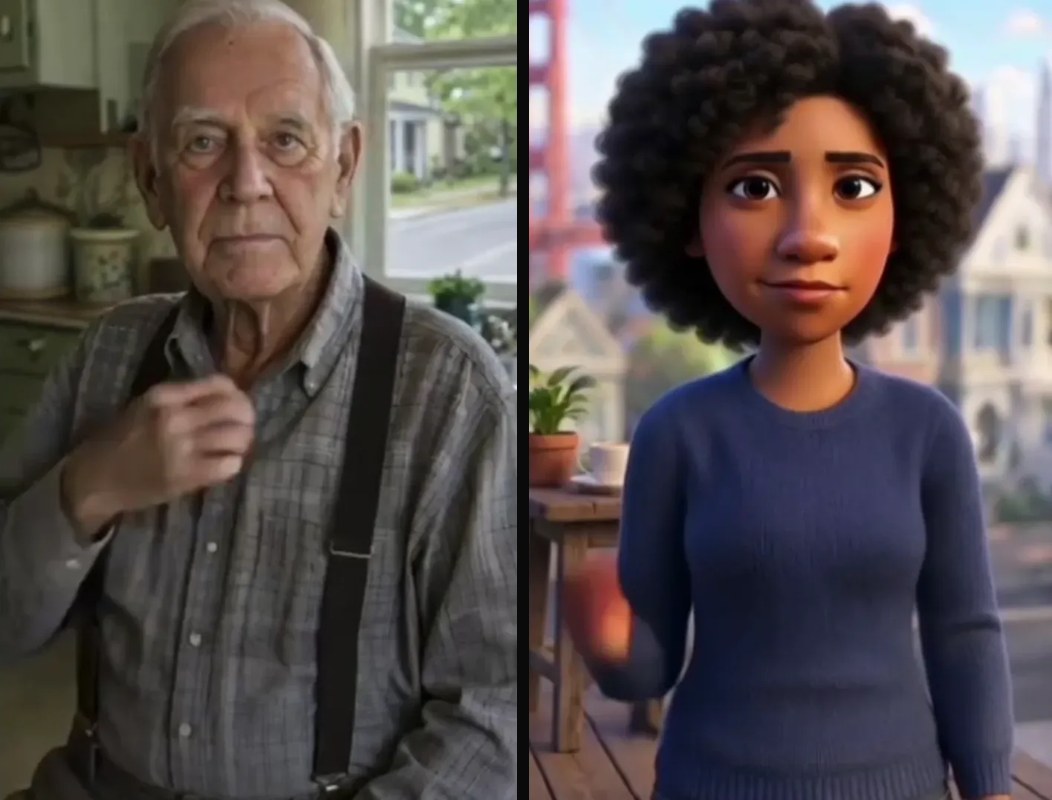
CWM-1은 내부 물리 엔진을 갖추고 있으며, 손이 머리카락과 천과 사물을 어떻게 움직이는지 학습했다. 캐릭터는 옷깃을 매만지고, 머리카락을 쓸어 넘기고, 문자를 보내고, 전화를 받을 수 있다. 발표 페이지의 예시 영상에서 캐릭터는 어떤 종류의 셔츠를 입고 있든 옷깃을 고쳐 잡으며, 이때 천이 현실감 있게 변형된다. 머리카락을 만지라는 지시를 받은 캐릭터의 영상에서는 머리카락의 물리가 시뮬레이션된다.
살아 있는 장면
물리 엔진 덕분에 배경도 정지해 있지 않다. 물이 흐르고, 사람들이 지나가고, 그림자와 반사가 캐릭터의 동작에 맞춰 변한다. 발표 페이지는 물이 흐르는 장면, 반사, 유체와 중력의 역학을 예시로 보여 준다.
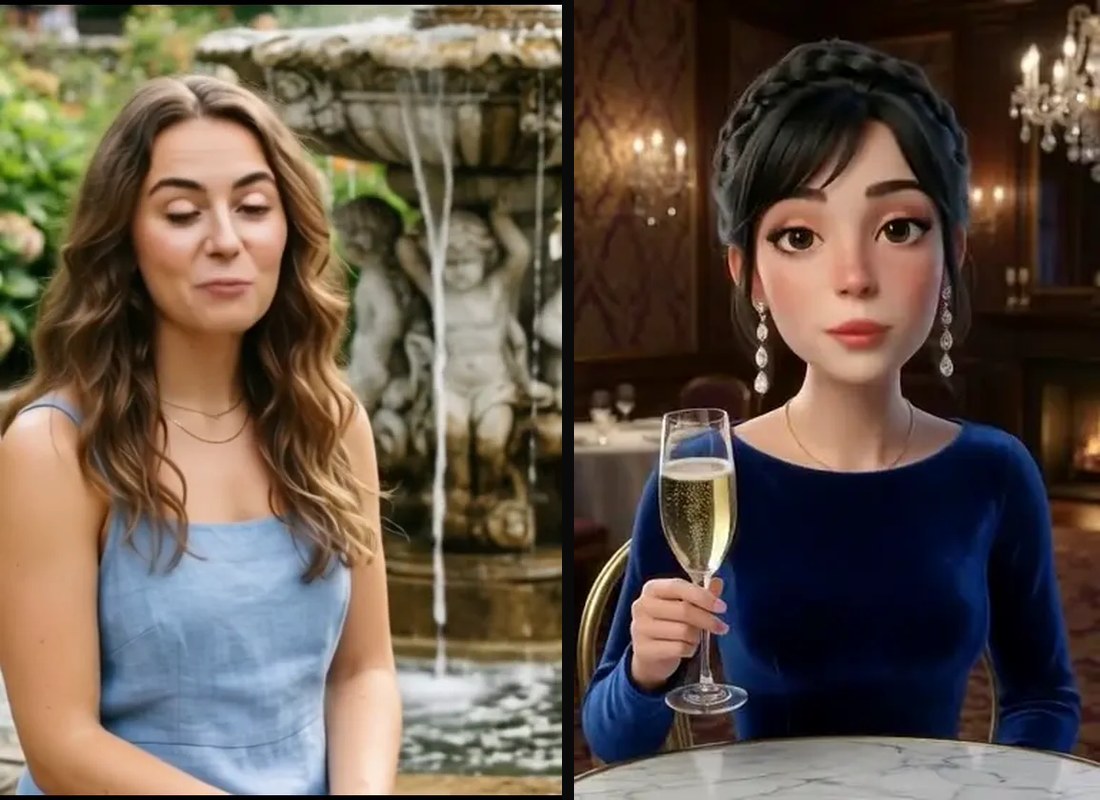
드리프트 없는 무한 길이
LemonSlice는 대부분의 비디오 월드 모델이 몇 분 만에 품질이 떨어지는 데 비해, CWM-1은 24시간 이상 눈에 띄는 드리프트나 끊김 없이 스트리밍한다고 밝혔다. 드리프트는 생성 시간이 길어질수록 캐릭터의 외형과 화질이 조금씩 변질되는 현상을 말한다.
발표 페이지에는 사용자가 CWM-1 아바타와 대화하는 장면을 편집 없이 녹화한 데모 영상도 여러 편 실려 있다.
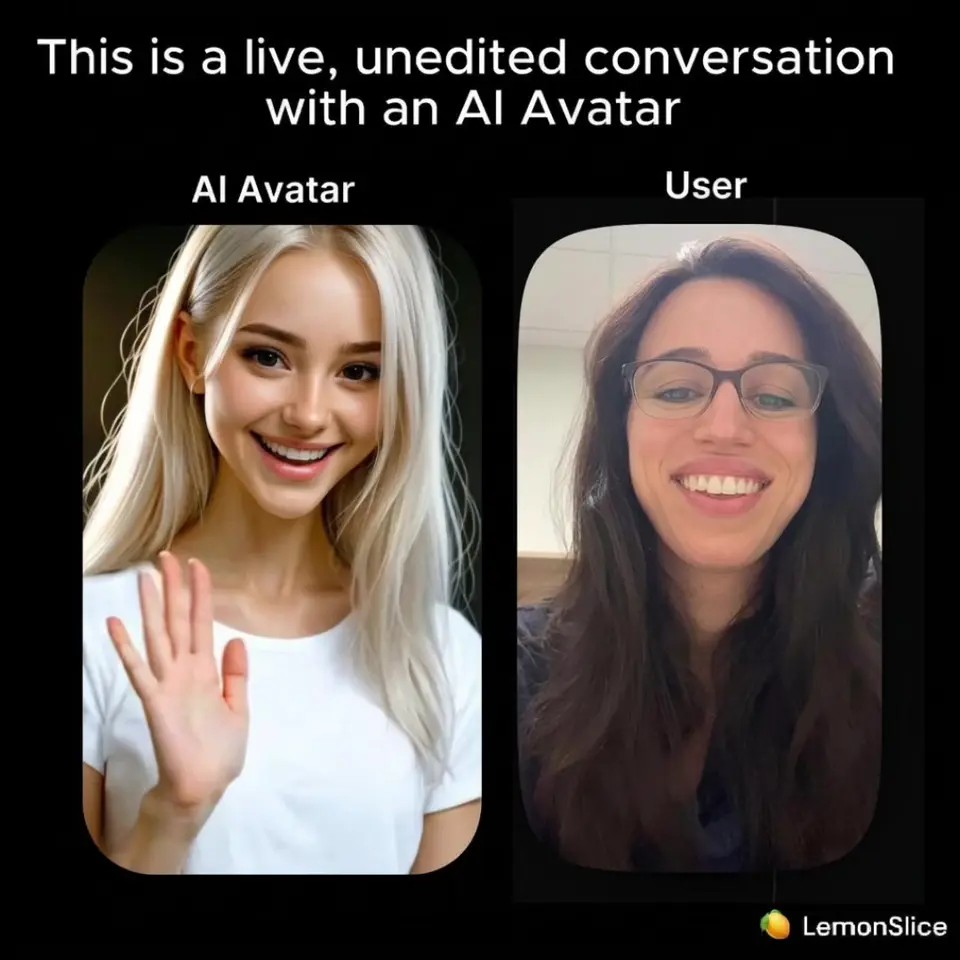
모델을 만들며 푼 다섯 가지 난제
LemonSlice는 CWM-1이 인과적으로 작동하고, 사용자 입력에 즉시 반응하며, 오래 끊기지 않고, 실시간으로 영상을 생성하며, 감정적인 공감을 일으킨다고 설명했다. 이어서 이런 성질을 갖추려고 풀어야 했던 난제 다섯 가지를 차례로 소개했다.
1. 표현력: 비디오 DiT를 직접 학습한다
LemonSlice는 비디오 DiT 모델을 직접 학습한다. 그래야 자신들이 가장 중시하는 목표인 자연스러운 인간의 표현에 맞춰 모델을 최적화할 수 있기 때문이다. 직접 학습하는 과정에서는 생성 영상의 표현력이 오디오 인코더의 품질에 따라 제한된다는 점도 확인했다고 한다. 오디오 인코더는 주로 오디오북 데이터로 학습되기 때문에, 인코더가 구분할 수 있는 감정의 범위가 좁다. LemonSlice가 더 나은 오디오 잠재 표현(latent)을 쓰자 생성 영상의 감정 표현 범위가 크게 확대됐다고 한다.
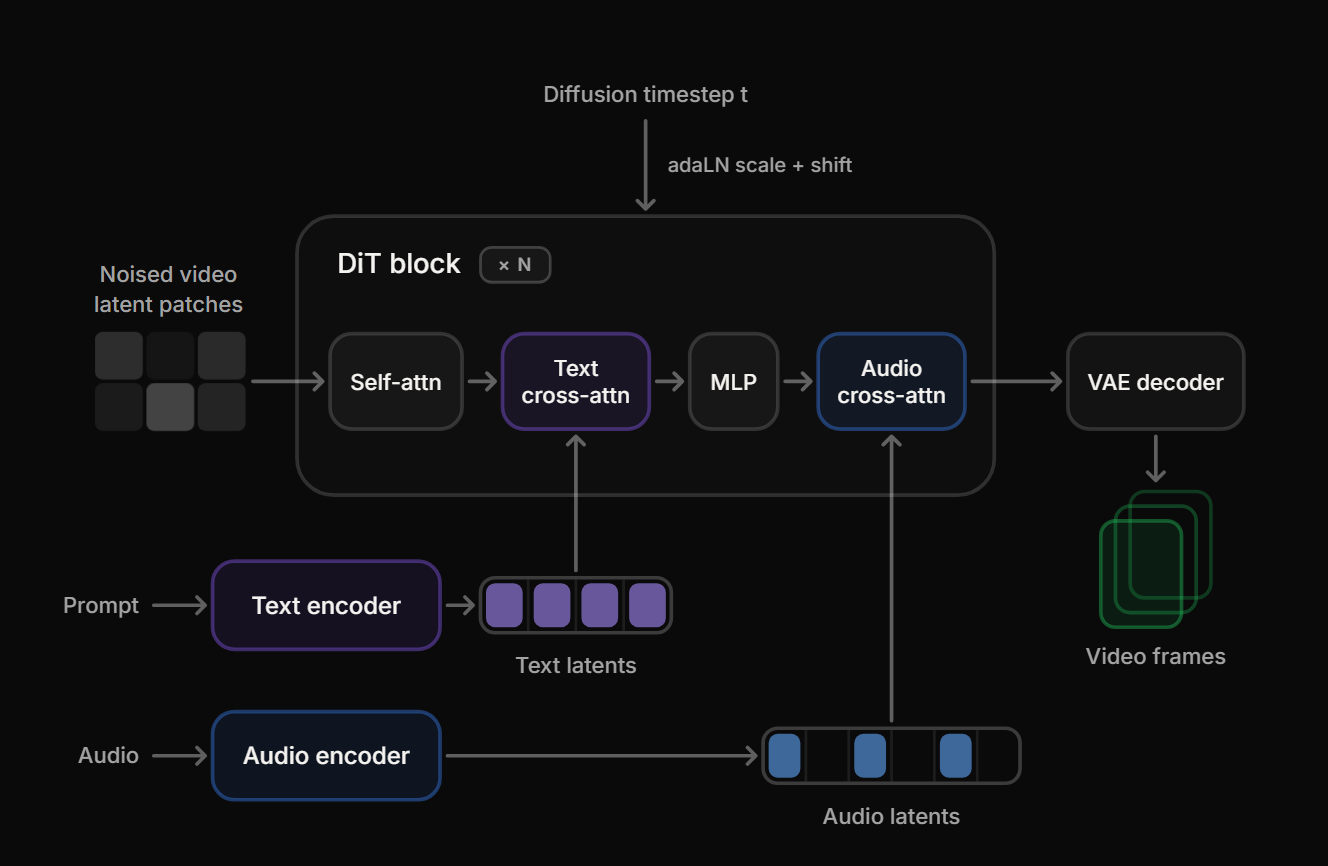
이 구조에서 텍스트 잠재 표현과 오디오 잠재 표현은 각자의 크로스 어텐션을 통해 DiT 블록을 조건화한다. 그림 설명에 따르면 오디오 잠재 표현의 품질이 표현력의 상한을 결정한다.
2. 인터랙티브: 확산 모델을 인과적으로 만든다
월드 모델은 인터랙티브해야 한다. 여기서 인터랙티브란 사람의 입력에 즉시 반응한다는 뜻이다. 비디오 게임을 시뮬레이션하는 범용 비디오 월드 모델은 사용자가 “왼쪽으로 회전"을 누르면 영상의 시점을 즉시 왼쪽으로 돌려야 한다. 캐릭터 월드 모델은 사람이 말을 끊거나 질문할 때 아바타가 즉시 반응해야 한다. 사용자가 질문으로 말을 끊으면, CWM-1이 응답 영상 프레임을 생성하기까지 471ms가 걸린다고 한다.1
모델을 인터랙티브하게 만들려면 인과적으로 만들어야 한다. 표준 DiT는 양방향 모델이라서 과거 프레임과 미래 프레임을 모두 참조한다. 반면 CWM-1은 과거 프레임만 참조한다. 미래 프레임은 외부의 새 입력을 반영해 실시간으로 결정된다. 아래 그림은 모델이 과거 프레임만 참조하도록 제한하는 어텐션 마스크다.2
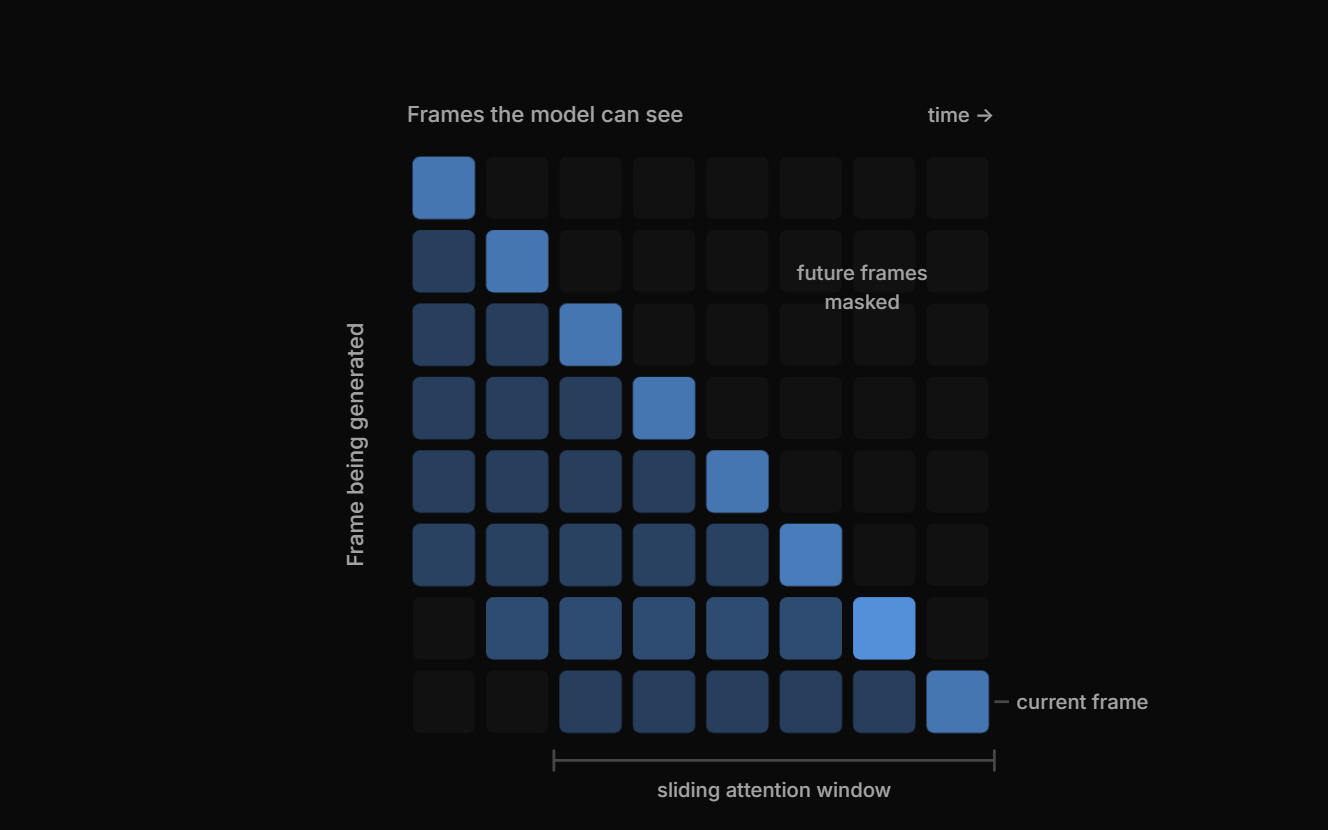
그림에서 각 프레임은 자기 자신과 이전 프레임 최대 다섯 개만 참조한다. 참조 범위는 슬라이딩 윈도 방식이어서, 생성이 진행될수록 가장 오래된 프레임부터 참조 대상에서 제외된다.
3. 실시간: 많은 확산 스텝을 몇 스텝으로
월드 모델은 실시간으로 작동해야 한다. 실시간이란 영상을 시청 속도보다 빠르게 생성한다는 뜻이다. 예를 들어 10초 분량의 영상이라면 8초 안에 생성해야 한다. 발표문은 앞서 설명한 인터랙티브 조건이 실시간 조건보다 더 까다롭다고 덧붙였다. 실시간 생성은 월드 모델이 반드시 갖춰야 하는 조건이다. 하지만 실시간 생성만 갖췄다고 월드 모델이 완성되지는 않는다고 한다.
LemonSlice는 CWM-1을 실시간으로 만들기 위해, 여러 스텝이 필요하던 확산 과정을 단일 스텝으로 증류했다.3 자체 버전의 희소 어텐션(Sparse Attention)도 함께 적용했다. 두 기법 덕분에 CWM-1은 사용자에게 보여 주는 속도보다 빠르게 새 프레임을 생성한다.
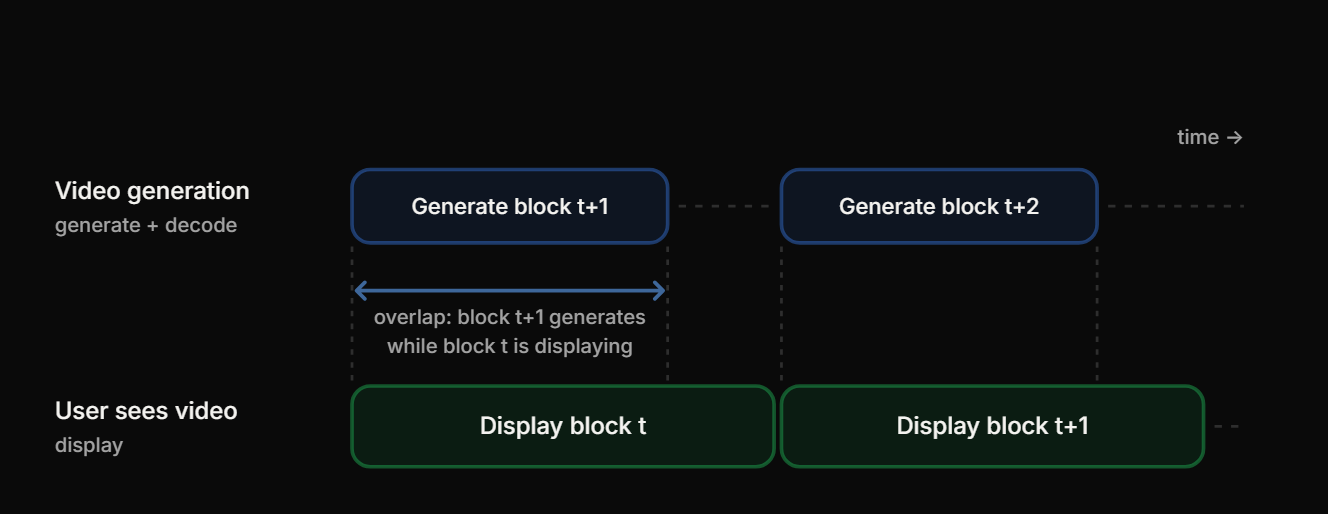
각 블록은 재생 시간보다 짧은 시간 안에 생성된다. 다음 블록은 현재 블록의 재생이 끝나기 전에 준비된다. 따라서 스트림은 끊기지 않는다.
4. 안정성: 오차 누적을 해결한다
오늘날 인터랙티브 월드 모델의 큰 문제는 오차 누적이다. 모델은 추론 중에 다음 프레임을 생성하면서 이전에 생성한 프레임을 맥락으로 참조한다. 그런데 새로 생성되는 프레임은 이전 프레임에 섞인 오차를 그대로 참조하고, 거기에 새 오차를 더한다. 그래서 오차는 시간이 지날수록 커진다.
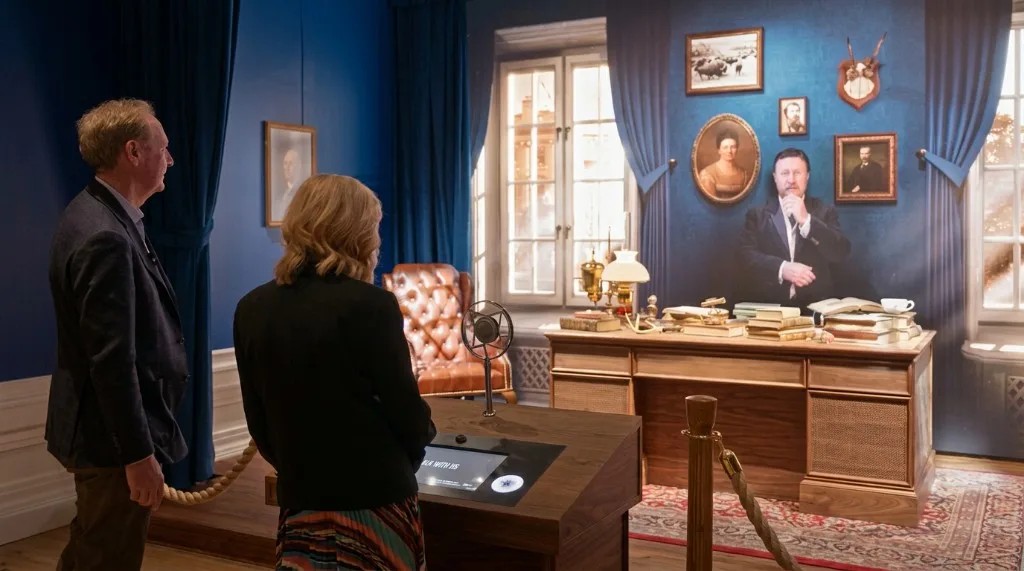
LemonSlice는 이 문제에 대한 고유한 해법을 발명했다고 밝혔다. 해법은 GAN 기반 학습과 지능적인 어텐션 가중치 조절을 결합한 방식이라고 한다. LemonSlice의 주요 고객들은 오차 누적 없이 8시간에서 16시간 동안 끊김 없는 세션을 정기적으로 스트리밍한다고 한다. 발표문이 사례로 든 것은 시어도어 루스벨트 대통령 도서관의 루스벨트 아바타로, 하루 10시간씩 가동되는데도 눈에 띄는 품질 저하가 없다고 한다.
5. 비용과 지연: 커널 수준까지 최적화한다
LemonSlice는 모델을 저렴하게 운영하고 더 빠르게 만들기 위해 자사 하드웨어에 맞춘 최적화에 크게 투자한다고 밝혔다. 저렴한 선택지로는 Lite 모델이 따로 있다. 발표문에 따르면 인터랙티브 영상 생성 비용은 오디오 생성 비용과 비슷한 수준으로 빠르게 낮아지고 있다. 보통 해상도의 영상이라도 1초 분량의 압축 데이터는 음성 오디오의 약 20배에 이른다. 발표문은 이 비교를 들어, 데이터가 20배 많은 영상의 생성 비용이 오디오와 비슷해졌다는 점을 강조했다.
비용을 낮추는 데는 작은 최적화 여러 개가 함께 쓰였다고 한다. 가장 큰 개선은 추론 병목인 GPU 대역폭 문제를 해소하는 커스텀 커널을 만든 것이다. 그 밖에 CUDA 그래프 최적화, 텐서의 선택적 다운캐스트, 최대한의 캐싱, CPU와 GPU 사이 데이터 전달 최적화 등을 적용했다고 한다.
시스템 하네스: Conductor와 Performer
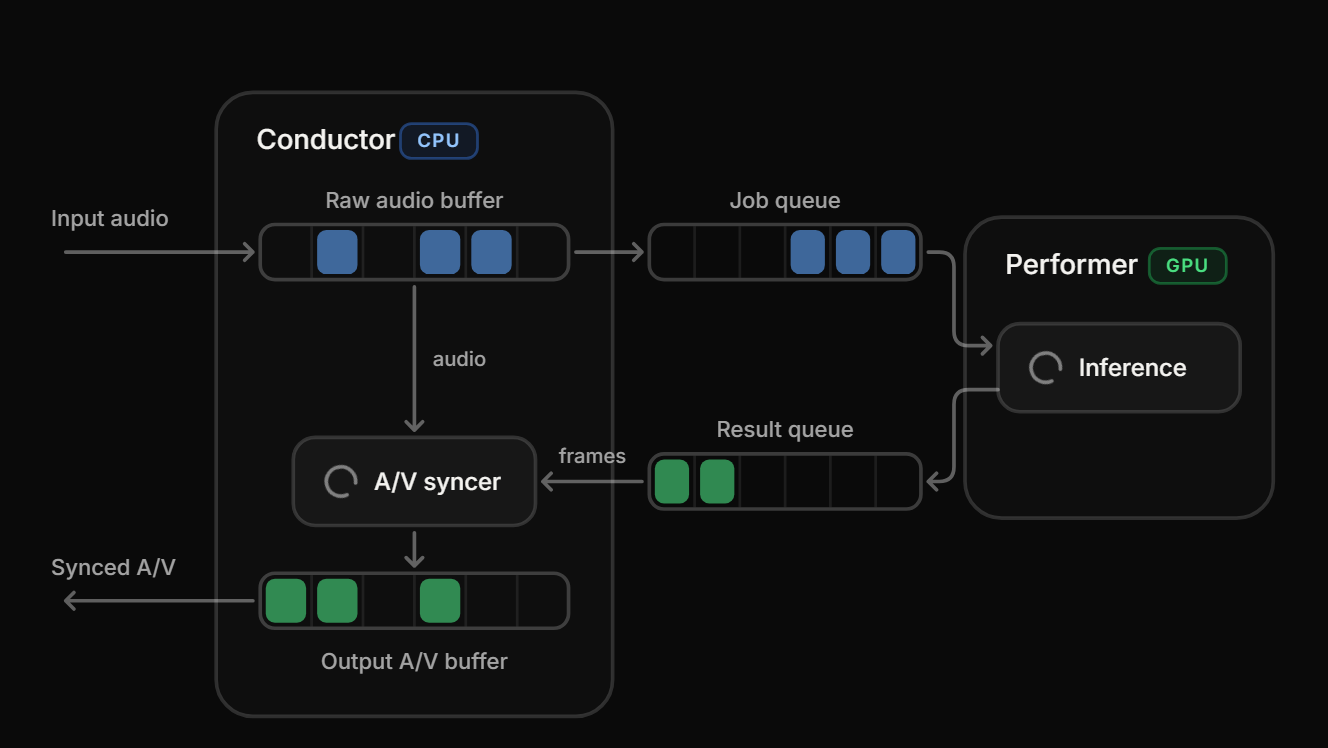
모델 하네스는 실시간 상호작용을 조율한다. 하네스에서는 두 프로세스가 협력해 영상과 오디오를 끊김 없이 연속 스트리밍한다. Conductor 워커는 외부 인터페이스로서 오디오 패킷을 받고, 동기화된 오디오와 영상 패킷을 내보낸다. Performer는 GPU로 새 비디오 프레임을 생성한다.
LemonSlice가 가장 어려웠다고 꼽은 부분은 사용자 입력의 변화에 대응하는 일이다. 사용자가 말을 끊으면 영상 출력을 최대한 빨리 조정해야 한다. 이를 위해 LemonSlice는 GPU와 큐에서 대기 중인 작업을 지능적으로 비우는(flush) 기능에 큰 노력을 들였다고 한다. 이 과정에서 지연된 프레임은 하나도 생성되지 않는다.
제어: 감정 엔진
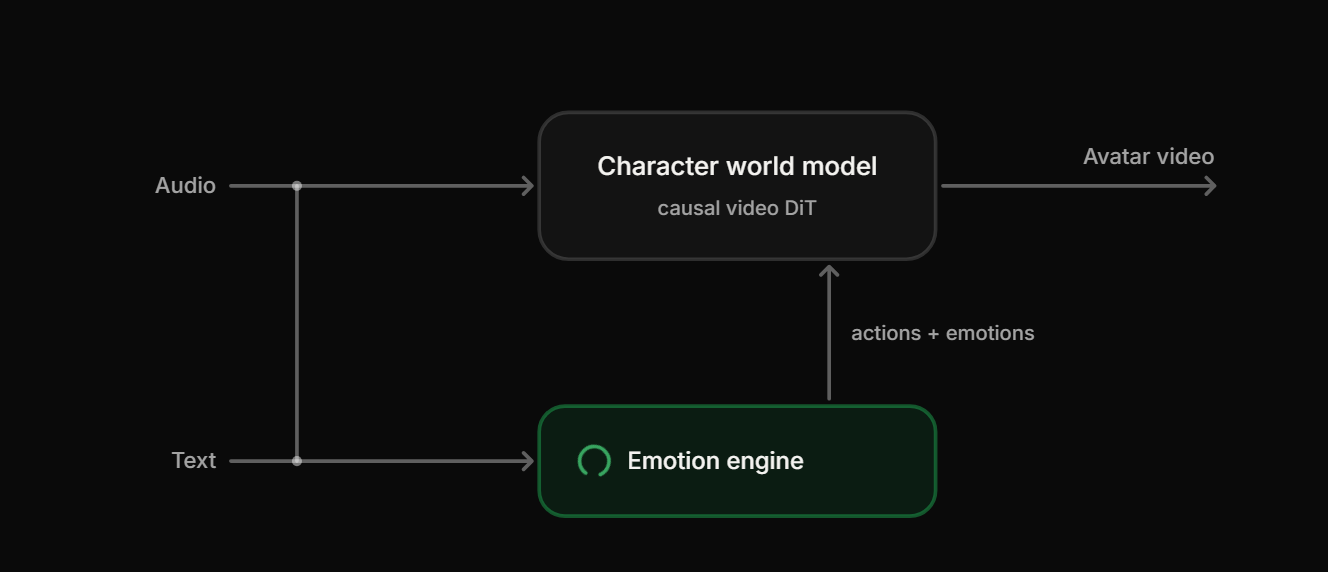
감정 엔진은 모델 하네스에 가장 최근에 추가된 구성 요소다. 감정 엔진은 아바타의 내부 상태를 모델링하고, 그 상태를 바탕으로 아바타가 보일 감정과 행동을 예측한다. 감정 엔진은 아바타의 오디오와 그 오디오의 전사(transcription) 텍스트, 그리고 사용자의 오디오를 예측에 쓴다.
LemonSlice는 아바타 튜링 테스트를 통과하려면 아바타가 자기 상태를 더 잘 인식해야 한다고 봤다. 그리고 감정 엔진을 그 목표를 이루는 데 중요한 진전으로 평가했다.
이용 방법
LemonSlice는 CWM-1을 앞으로 이어질 모델 계열의 첫 번째 모델로 소개했다. LemonSlice 사용자는 누구나 웹 앱에서 커스텀 캐릭터로 CWM-1을 써 볼 수 있고, API는 LemonSlice Ultra와 Enterprise 고객에게 제공된다. 발표문에 실린 기술 내용의 상당 부분은 CTO 시드니(Sidney)가 AI Engineer World’s Fair 발표에서 더 자세히 설명했다고 한다.
오디오 인코더가 정한 표현력의 상한
발표문에서 가장 의외였던 대목은 첫 번째 난제에 딸린 짧은 일화다. 비디오 모델의 표현력을 제한한 요인은 오디오 인코더였다. 그 인코더가 오디오북으로 학습된 탓에 구분할 수 있는 감정의 범위가 좁았다고 한다. 오디오북 낭독은 대개 또렷하고 고른 톤으로 녹음된다. 그런 데이터로 학습한 인코더라면 웃음 섞인 말투나 짜증 섞인 억양을 세밀하게 구분하기 어려웠을 것이다. 입 모양만 맞추던 아바타에서는 이 한계가 문제 되지 않았을 것이다. 표정과 몸짓 전체를 오디오로 조건화하게 되면서 비로소 한계가 드러난 것으로 보인다.
감정 엔진의 설계도 눈여겨볼 만하다. 구조도에서 캐릭터 월드 모델은 이미 만들어진 오디오를 입력으로 받는다. 대사의 내용은 CWM-1이 생성하지 않고, 감정 엔진은 그 대사에 어울리는 표정과 행동을 정한다. 감정 엔진이 사용자의 오디오까지 입력으로 받는 이유는, 상대가 말하는 동안 고개를 끄덕이거나 딴청을 피우는 반응을 아바타 자신의 발화만으로는 예측할 수 없기 때문일 것이다.
한편 내가 가장 궁금했던 오차 누적 해법은 “GAN 기반 학습과 어텐션 가중치 조절의 결합"이라는 한 문장으로만 소개되어 있다. 24시간 스트리밍을 가능하게 한 구체적인 방법은 CTO의 발표나 후속 자료가 나와야 확인할 수 있다.
출처
LemonSlice, 「Introducing CWM-1」, 2026년 9월 23일 원문: https://lemonslice.com/cwm-1
본문 그림은 모두 발표 페이지에서 인용했다. 도식은 페이지의 SVG를 캡처했고, 캐릭터 이미지 세 장은 예시 영상의 포스터 프레임 여러 장을 이어 붙여 만들었다.
471ms 수치의 분석은 LemonSlice 블로그의 「LemonSlice Flash」 글에 있다. https://lemonslice.com/blog/lemonslice-flash ↩︎
LemonSlice는 인과적 어텐션의 배경 자료로 「Talking Machines」(arXiv 2506.03099)를 소개했다. https://arxiv.org/abs/2506.03099 ↩︎
증류 기법의 참고 연구로 CausVid(https://causvid.github.io/)와 Self-Forcing(https://self-forcing.github.io/)을 들었다. 이 대목의 본문은 단일 스텝까지 증류했다고 적었다. 반면 발표문의 소개 문단과 요약 문단은 CWM-1을 소수 스텝(few-step) 모델로 표현했다. ↩︎