3줄 요약
- mizorewww가 2026년 9월 19일에
laya-coreml을 공개했다. 이 저장소는 비자기회귀 결정 모델 Laya를 애플 Core ML과 Neural Engine으로 옮긴 독립 포팅이다. PyPI 패키지와 Hugging Face 가중치, 벤치마크 원자료를 함께 담았고 라이선스로 Apache-2.0을 달았다. - M3 Max에서 짧은 질문 하나를 처리하는 완전한
predict는 4.98ms P50을 기록했다.1 같은 조건에서 컴파일한 MLX FP16과 비교하면 속도는 1.39배, 결정 한 건당 전체 시스템 에너지는 2.78배 좋아졌다. 8비트 팔레트 압축본은 각각 1.42배와 3.19배였다. - 저자가 목표로 받았던 10배는 달성되지 않았다. 저장소는 그 미달을 README 첫 화면에 적어 두고, 왜 이 모델과 이 칩에서 10배가 어려운지를 연산량과 메모리 대역폭과 암달의 법칙으로 따로 계산해 두었다.
Laya는 무엇을 하는 모델인가
원본 Laya는 Convai Innovations가 공개한 비자기회귀 결정 엔진이다. 텍스트를 생성하지 않고, 상태 하나와 타입이 붙은 질문 여러 개를 받아 한 번의 순전파로 확률을 돌려준다. 질문에는 세 가지 타입을 쓸 수 있다. 선택지 중 하나를 고르는 choice, 정도를 점수로 매기는 score, 참과 거짓을 판정하는 noul이다. 출력이 자연어가 아니므로 파싱할 JSON도 없고, 형식이 깨질 여지도 없다.
체크포인트는 세 종류이며 인코더가 서로 다르다.
| 체크포인트 | 인코더 | 파라미터 | 컨텍스트 | 용도 |
|---|---|---|---|---|
laya | ModernBERT-large | 421M | 512 | 영어 |
laya-multilingual | mmBERT-base | 322M | 1024 | 100개 이상의 언어 |
laya-typed-decisions | ModernBERT-large | 421M | 1024 | 타입 결정 워크플로 |
laya-coreml은 이 모델을 애플 실리콘 위로 옮긴 것이다. 같은 저자의 MLX 형제 프로젝트 laya-mlx 위에 세워졌다. Convai Innovations나 애플의 공식 릴리스는 아니라고 README가 먼저 밝힌다.
설치해서 불러 쓰는 과정은 몇 줄이면 끝난다.
import laya_coreml as laya

agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
    "The customer requests a refund of a duplicate payment.",
    {
        "refund": {
            "type": "noul",
            "instructions": "Does the customer request a refund?",
        }
    },
)
print(result["answers"]["refund"])
Hugging Face에는 여섯 종류의 번들이 올라와 있다. 기본 엔진이 CPU와 GPU인 일반 번들이 네 개, Neural Engine을 쓰는 FP16 번들과 그 8비트 압축본이 각각 하나씩이다. ANE 번들에는 질문과 선택지와 상태를 모두 합쳐 96토큰이라는 상한이 있고, 이를 넘기는 요청은 용량 오류를 낸다. 긴 입력이 필요하면 1024토큰짜리 범용 모델을 써야 한다. 모든 번들은 토크나이저와 설정, 모델 카드, 출처 기록, 체크섬, 패키징 시점 검증을 함께 담는다.
M3 Max에서 잰 숫자
측정 환경은 40코어 GPU와 128GiB 메모리를 갖춘 M3 Max, macOS 27.2다. 질문은 91개의 실제 토큰을 96으로 패딩한 네 선택지 문항 하나다. 프롬프트 구성과 토크나이즈, 배열 생성, 동기 추론, 보정, 출력 정리까지 전부 측정 구간 안에 들어간다. 모델 로딩과 워밍업은 제외했다. 비교 대상인 MLX는 mx.compile과 프롬프트 접두 캐싱, 32토큰 형상 버킷을 켠 상태다. 저자는 예전의 느린 즉시 실행(eager) MLX 결과를 분모로 쓰지 않겠다고 밝히고, 강한 쪽을 다시 재서 분모로 삼았다.
각 구현이 20초짜리 블록을 여섯 번씩 돌았고, 세 번의 균형 사이클에서 합계 65,598번의 호출을 기록했다.
| 지표 | MLX GPU FP16, 컴파일 | ANE FP16 | ANE W8 K-means |
|---|---|---|---|
| 완료한 결정 수 | 17,184 | 23,961 | 24,453 |
| P50 | 6.937ms | 4.976ms | 4.879ms |
| P95 | 7.393ms | 5.307ms | 5.227ms |
| 평균 시스템 전력 추정 | 61.39W | 30.75W | 27.39W |
| 결정당 시스템 에너지 | 0.4288J | 0.1540J | 0.1344J |
| 속도 이득 | 1배 | 1.394배 | 1.423배 |
| 에너지 이득 | 1배 | 2.784배 | 3.189배 |
문서는 두 이득을 곱하지 말라고 한 문단을 따로 썼다. 속도비와 평균 전력비를 곱한 값이 곧 에너지비다. FP16의 경우 1.394에 1.997을 곱하면 2.784가 나온다. 그러니 이미 구한 에너지비에 속도를 한 번 더 곱하면 같은 시간을 두 번 곱하는 셈이 된다.
8비트 압축본이 FP16보다 빠르긴 하지만 평균 속도 차이는 이 세션에서 약 2.1%에 그쳤다. 대신 본체 패키지 용량이 251.91MB에서 129.29MB로 줄었다. 저자는 이 용량 감소가 속도 비율로 번역되지 않는다고 덧붙인다. W8은 가중치만 그룹 K-means로 팔레트 압축한 것이고 활성값은 여전히 FP16이며, 호스트 쪽 액션 테일은 FP32로 남아 있다.
원래 그래프는 왜 Neural Engine에 올라가지 않았나
평범하게 변환한 Core ML 모델은 CPU_AND_NE 설정을 줘도 Neural Engine으로 가지 않았다. 컴퓨트 플랜을 열어 보니 배정된 1,318개 연산이 전부 CPU를 선호했고, SDPA 연산 24개는 어느 장치에 갈지 기록조차 없었다. 개별 연산 988개가 ANE를 지원 장치로 표시하고 있었는데도 그랬다. 저자는 여기서 하나를 분명히 밝힌다. 어떤 연산이 ANE를 지원한다는 것과 그 그래프가 ANE로 분할된다는 것은 다른 이야기다.
프로토타입은 애플이 트랜스포머 배포 연구에서 권한 형태를 그대로 따라 그래프를 다시 썼다.
- 활성값 레이아웃을
B,C,1,L채널 우선으로 바꾸고, 모든 선형층 가중치를 1×1 합성곱 커널로 옮겼다. 이 과정에서 모델을 다시 학습시키거나 가중치를 근사하지는 않았다. - 어텐션을 64채널 헤드 단위로 쪼개고, 키 텐서를 한 번만 전치한 뒤 두 개의 명시적 einsum으로 QK와 AV를 계산했다. 소프트맥스는 키 축, 곧 1번 축을 따라 계산한다.
- RoPE는 각 헤드 안에서 32채널씩 두 묶음으로 나누어 적용했다. 헤드를 전부 이어 붙인 뒤 앞뒤 절반으로 끊으면 틀린 결과가 나온다.
- LayerNorm은 원본의
정규화 곱하기 weight 더하기 bias순서와 엡실론을 그대로 지켰다. 애플 참조 구현은 아핀 순서가 달라서 그 클래스를 그대로 가져다 쓰면 bias가 0이 아닐 때 틀린다. - 임베딩 조회와 마커 선택, 작은 스코어러, 액션 헤드는 CPU 경계로 보냈다. 엔진을 넘나드는 지점을 모델의 양 끝에만 두려는 배치다.
이렇게 다시 쓴 그래프, 즉 배치 1에 길이 96인 B=1, L=96 형상에서는 비상수 연산 6,390개 전부가 Neural Engine을 선호하게 바뀌었다. 나머지 3,809개 항목은 상수라서 배치 대상이 아니다. 여러 변경을 한꺼번에 적용했으므로 이 결과가 어떤 연산 하나를 범인으로 지목하는 제거 실험은 아니라는 단서도 함께 달려 있다.
Neural Engine이 실제로 돌았다는 증거
컴퓨트 플랜은 연산을 어디에 배치할 예정인지를 적은 문서다. 하드웨어가 실제로 무엇을 했는지는 거기 적혀 있지 않다. 애플 문서도 이를 anticipated device use라고 부른다. 그래서 저자는 별도로 Instruments의 Core ML 템플릿을 붙여 15.97초를 녹화했고, 그 안에서 Neural Engine Prediction 구간 3,124개를 잡았다.
이 증거에도 단서가 붙는다. 하드웨어 테이블은 전역이라 각 구간에 PID나 모델 정체를 붙여 주지 않으며, 이번 녹화에서 Core ML 모델 시그포스트 테이블은 비어 있었다. 그러므로 모든 구간을 Laya의 것이라고 주장하지는 않겠다는 말이 뒤따른다. 반대 방향의 단서도 함께 적혀 있다. 모니터링 도구가 ANE 카운터를 0으로 보고했다고 해서 ANE가 놀았다고 결론 내릴 수는 없다는 것이다. 이 OS와 이 기기에서 그 카운터가 유효한지부터 확인해야 한다.
포팅이 원본과 같은 답을 내는가
검증은 원본 FP32 모델의 저장된 로짓과 결정을 기준으로 삼았다.
- 범용 FP16 체크포인트 세 종은 업스트림이 고른 답과 189개 검증 문항 전부에서 일치했다. 각각 100회 반복 호출도 통과했다.
- ANE FP16 L96은 길이가 맞는 59개 문항을 전부 통과했고, 보정 확률의 최대 변화는 0.002925였다.
- W8은 같은 59개를 통과했고 최대 변화는 0.014393이었다. 통과 기준인 0.02는 후보를 통과시키려고 느슨하게 바꾸지 않았다.
- 6비트와 4비트 실험은 이 기준을 넘지 못했고, 그래서 가중치로 공개하지 않았다.
길이 쪽 결과는 더 조심스럽다. 따로 내보낸 FP16 ANE L1024 그래프는 63개 픽스처를 전부 통과한다. 그러나 실제로 1024토큰짜리 요청을 던지면 91.7ms P50이 나왔고, 같은 모델의 과거 MLX 긴 입력 측정치는 51.98ms였다. 두 값은 같은 회차에 짝지어 잰 것이 아니므로 직접 비교로 쓸 수는 없다. 그래도 짧은 입력에서 얻은 4.98ms가 긴 컨텍스트에서도 유지된다는 증거는 어디에도 없다는 점은 분명하다.
저자는 이 숫자들이 변환 회귀를 확인하는 픽스처일 뿐 일반 과제 정확도를 증명하지는 못한다고 반복해서 적는다. 59개 문항 중에는 같은 루브릭이 여러 번 등장하는 것도 있어서 독립된 59개 라벨 예제로 세면 안 된다는 설명까지 붙어 있다.
10배는 왜 나오지 않았나
이 저장소에서 내 손이 제일 늦게 떠난 문서는 ANE_MATH.md였다. 10배가 왜 안 나왔는지를 변명으로 적는 대신, 그 목표에 필요한 수치를 직접 계산해 놓았기 때문이다.
다국어 체크포인트는 은닉 폭 768, 게이트 중간 폭 1152, 인코더 22층이다. 주요 행렬 파라미터를 세면 124,452,864개, 약 1억 2,445만 개이고 FP16으로 248.91MB다. 배치 1에 길이 96이면 밀집 연산량이 24.574 GFLOP이다. 지금 MLX P50보다 10배 빠르려면 0.787ms 안에 이 연산을 끝내야 하고, 그러려면 실효 31.23 TFLOP/s가 필요하다. 영어 모델은 조건이 더 나쁘다. 1.333ms 안에 53.89 TFLOP/s가 있어야 한다.
메모리 쪽에서도 하한이 걸린다. 40코어 M3 Max의 통합 메모리 대역폭은 400GB/s로 명시돼 있다. 요청마다 주요 FP16 행렬을 딱 한 번씩만 DRAM에서 읽는다고 가정해도 다국어 모델에 0.622ms, 영어 모델에 1.842ms가 든다. 저자는 이것이 무조건적인 물리 하한은 아니라고 단서를 단다. ANE가 실제로 쓰는 대역폭은 더 작을 수 있고, 캐시나 압축된 가중치는 가정을 바꾼다.
마지막으로 암달의 법칙이 남는다. 어떤 구간을 무한히 가속하더라도 그 구간이 원래 지연의 90% 이상을 차지하지 않으면 전체는 10배가 되지 않는다. 최종 헤드의 선택 질의 최적화는 모델 산술의 몇 퍼센트만 없애고, L이 64 이하이면 지역 어텐션 희소성도 의미가 없다. 창이 모든 위치를 덮기 때문이다. 저자는 어느 쪽도 단독으로 10배에 이르는 길이 아니라고 결론 짓는다.
그러면서 목표 선언의 기준도 미리 정해 둔다. 속도든 동일 부하 전력이든 에너지든, 불확실성의 하한까지 10을 넘길 때만 10배라고 부르고, 그렇지 않으면 측정된 비율을 그대로 보고한다는 규칙이다.
측정을 믿게 만들려고 한 일
전력 측정에서 한 번 사고가 났다. 공식 macmon CLI는 시스템 전력을 PSTR 센서값과 부품 전력 합계 중 더 큰 쪽으로 계산한다. 이 OS에서 CPU와 ANE 카운터는 보통 0을 돌려주다가, 한 샘플에서 CPU 약 38,021W와 ANE 약 2,068W로 튀었다. 부품 합계를 바닥값으로 쓰는 계산이 그 오류를 시스템 전력 40,089W로 그대로 옮겼다.
저자의 처리가 특이하다. 이상한 샘플 하나만 지우거나 잘라내지 않고, 영향을 받은 에너지 런 전체를 폐기했다. 그러면서 원자료 파일은 저장소에 그대로 남기고 “여기 저장된 에너지 집계값을 결과로 쓰지 말라"고 적어 두었다. IOReport 이상의 정확한 원인은 미해결로 남겨 두었다.
이후 최종 비교는 PSTR 값만 500ms마다 읽는 작은 비특권 샘플러를 따로 만들어 수행했다. 그 결과는 다음 조건 아래 있다.
- 1,101개 전력 샘플을 남겼고, 최대 간격은 0.510초, 최대 시스템 전력은 74.47W였다. 버린 샘플은 없다.
- 2초 또는 샘플 간격의 3배 중 큰 값보다 긴 공백이 생기거나, 값이 빠지거나, 0 이하이거나, 무한대처럼 계산할 수 없는 값이거나, 500W를 넘으면 런 전체를 기각한다.
- 이것은 전체 시스템 센서 추정치이지 외부 벽면 전력계나 배터리 측정이 아니다.
- 유휴값을 뺀 에너지 이득은 3.823배와 4.749배로 더 크게 나오지만, 측정 경계가 다르므로 노트북 전체 전력이 그만큼 떨어진다는 뜻으로 읽으면 안 된다.
- 세 사이클을 한 번의 데스크톱 세션에서 얻었으므로 모든 배경 부하와 센서 정확도를 대표하지 않는다.
스네이크 데모가 보여주는 것과 보여주지 않는 것
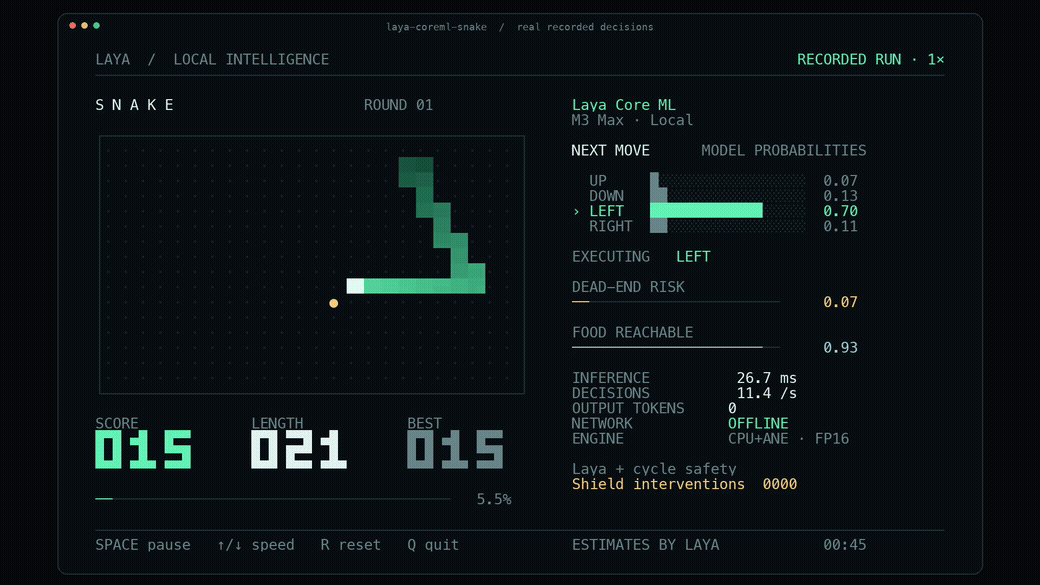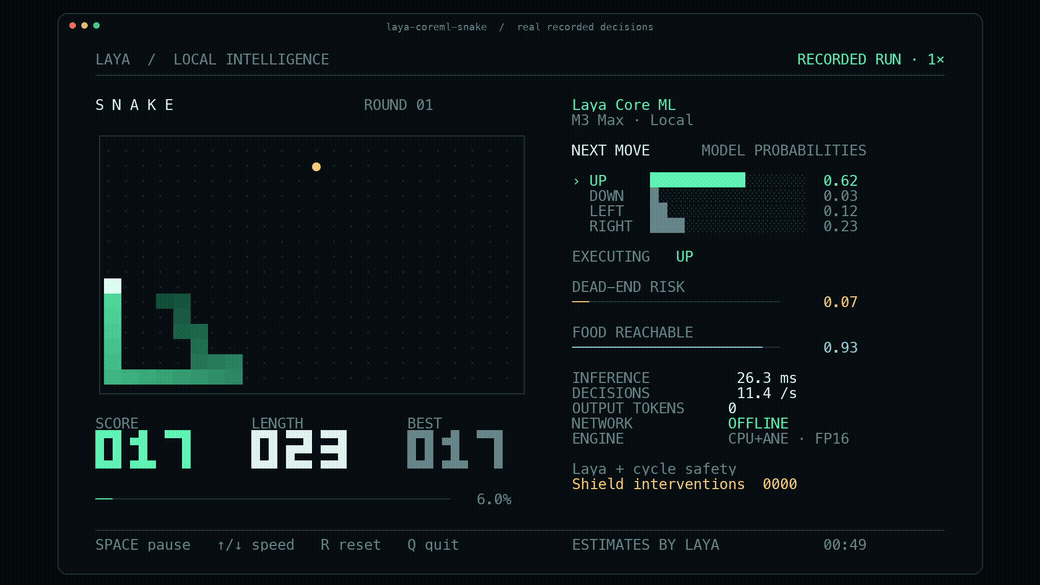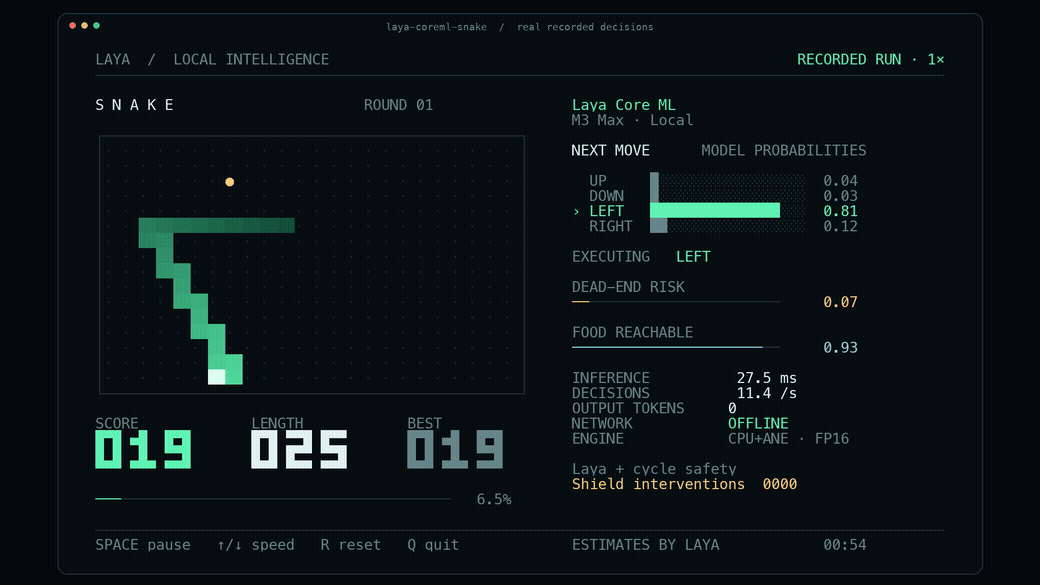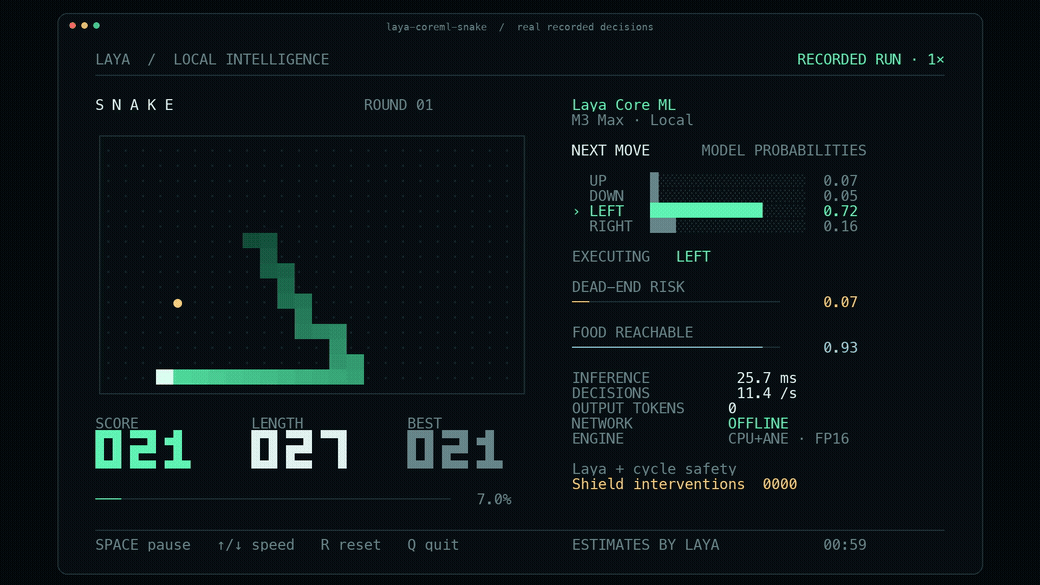
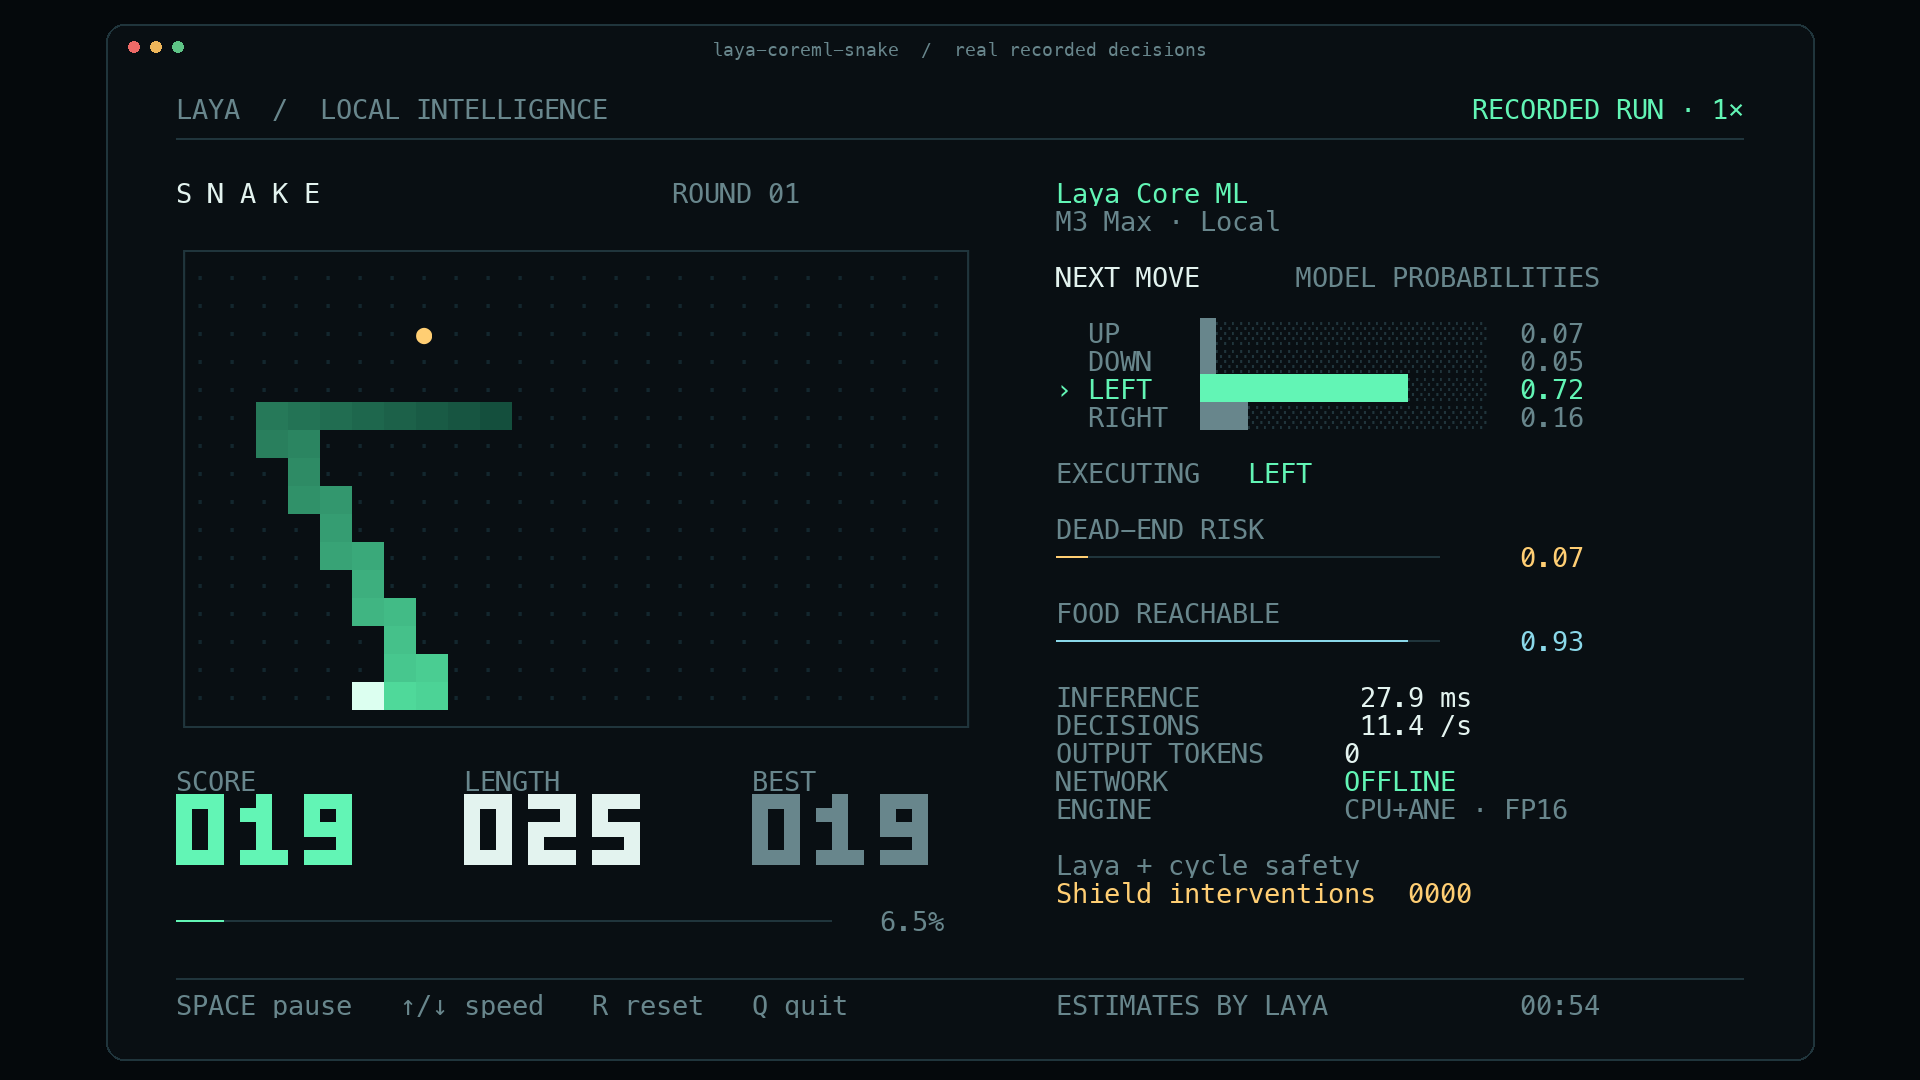
저장소 첫 화면에 걸린 GIF는 실제 Laya 모델이 로컬에서 스네이크를 두는 장면이다. 매 수마다 세 개의 질문을 순차로 던지고, 네 방향 확률과 막다른 길 위험, 먹이 도달 가능성을 화면에 그대로 띄운다. 출력 토큰은 0이고 네트워크는 오프라인이다.
무제한 모드에서 시드 세 개로 각각 600수를 두었을 때 초당 결정 수는 49.10과 49.89와 49.99였고, 사망은 0, 사이클 안전층의 개입은 두 번이었다. 이 1,800회 결정에서 세 질문 API 지연은 16.32ms P50, 전체 틱 지연은 19.07ms P50이었다.
요청 속도를 고정하는 페이싱 실험에서는 통과와 실패가 뚜렷하게 구분됐다. 초당 20회는 마감 초과가 0.83%로 통과했지만, 30회에서는 10.83%, 40회에서는 37.50%, 60회에서는 100%가 마감을 넘겼다. 흥미롭게도 페이싱을 건 에피소드에서는 세 질문 API가 약 26.3ms로 느려졌다. 무제한 모드의 16.3ms보다 도리어 느리다. 문서는 스케줄링이나 장치 전력 상태 전환을 가능한 설명으로 들면서도, 이 보고서가 그 원인을 증명하지는 않는다고 선을 긋는다.
ANE와 컴파일 MLX를 같은 실제 게임 상태에서 번갈아 돌린 짝비교에서는 600수 전부에서 제안한 행동과 실행한 행동이 일치했고 최대 확률 차이는 0.0036이었다. 그런데 여기에도 단서가 곧바로 붙는다. ANE 어댑터는 세 질문을 배치 1, 길이 96으로 하나씩 순차 호출하고 MLX는 최대 길이 64에서 세 질문을 묶어 처리하므로, 이 결과가 풀게임에서의 속도 우위를 입증하지는 않는다. 단일 질문 4.98ms를 스네이크 한 프레임의 시간처럼 광고해서는 안 된다는 문장도 함께 있다.
읽다가 표시해 둔 대목
성능 표보다 오래 들여다본 것은 각 주장 바로 옆에 붙어 있는 단서들이었다.
README 첫 화면, 속도와 에너지 수치를 적은 바로 다음 문장이 “요청받은 10배 개선은 달성되지 않았다"이다. 컴퓨트 플랜이 전부 ANE로 잡혔다고 적은 문단 다음 문장은 “이것은 예상 배치이며 그것만으로 충분한 하드웨어 증거가 되지 못한다"이다. 189개 문항 전부 일치했다고 적은 문단 끝에는 “이것은 변환 충실도 픽스처이지 일반 과제 정확도의 증명이 아니다"가 붙는다. 유휴값을 뺀 에너지 이득이 4.749배로 가장 커 보이는 행에는 “측정 경계가 다르므로 노트북 전력이 그만큼 떨어진다는 뜻이 아니다"가 따라온다.
폐기한 텔레메트리 처리는 그중에서도 눈에 띈다. 이상값 하나를 지우면 그 런의 나머지 데이터를 그대로 쓸 수 있었을 것이다. 저자는 대신 런 전체를 버렸고, 그러면서도 원자료 파일은 저장소에 남겨 두고 쓰지 말라는 주석만 달았다.
오픈 웨이트 포팅 저장소에서 이런 서술은 흔하지 않다. 대개는 가장 좋은 숫자를 제목에 올리고 조건은 아래쪽 문단에 흘려 둔다. 이 저장소를 읽고 나면 4.98ms라는 숫자보다, 그 숫자가 무엇을 증명하지 못하는지를 같은 크기로 적어 둔 문장들이 더 오래 남는다.
출처
mizorewww, laya-coreml, 2026년 9월 19일 공개. Apache-2.0.
원문: https://github.com/mizorewww/laya-coreml
원본 Laya (Convai Innovations): https://github.com/NandhaKishorM/laya
커버와 마지막 GIF는 저장소의 데모 자산이다. 본문 삽화는 원문에 인용할 도식이 없어 치비 서소영 라인아트로 대신했다. 블로그 글 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조하여 gpt-image-2.5-flare image-to-image로 생성했다.
P50은 측정값을 줄 세웠을 때 가운데 값이다. 요청의 절반이 그 시간 안에 끝난다는 뜻이다. P95는 95%가 그 안에 끝나는 값으로, 느린 쪽 꼬리가 얼마나 긴지를 보여준다. ↩︎