3줄 요약
- 컨텍스트 길이가 1,000만(10M) 토큰에 이르면 기존 희소 어텐션에서도 어떤 키를 읽을지 고르는 인덱서(indexer) 연산이 어텐션 레이어 프리필 시간의 98%, 디코드 시간의 89%를 차지한다.
- 잠재 희소 어텐션(Latent Sparse Attention, LSA)은 학습된 저차원 잠재 공간에서 키들을 의미 유사도에 따라 계층적 버킷으로 군집화한다. 쿼리는 개별 키 대신 버킷 중심점만 비교하므로, 탐색 비용이 준이차 복잡도인 $\mathcal{O}(T \log T)$로 줄어든다.
- 사전학습 모델의 어텐션 분포를 증류한 D-LSA는 1,000만 토큰에서 어텐션 레이어 프리필을 기존 희소 어텐션보다 22.7배, 풀 어텐션보다 72.4배 빠르게 처리했다. SGLang 종단간 서빙에서도 첫 토큰 생성 시간(TTFT)이 최대 9.21배 빨라졌고, RULER와 새 과학 문헌 벤치마크 PaperTrail의 정확도는 그대로 유지됐다.
1,000만 토큰 시대의 새로운 병목: 어텐션보다 느린 인덱서
언어모델이 긴 문서를 읽고 다단계 에이전트 세션을 처리하면서 컨텍스트 길이는 수십만 토큰에서 1,000만(10M) 토큰 규모로 확장되고 있다. 시퀀스 길이를 $T$라 할 때 표준 풀 어텐션(Full Attention)의 계산량은 프리필(prefill)에서 $\mathcal{O}(T^2)$, 디코드(decode)에서 토큰당 $\mathcal{O}(T)$로 증가한다. 이를 줄이려고 등장한 희소 어텐션(Sparse Attention)은 각 쿼리마다 경량 인덱서를 먼저 실행해 관련성이 높은 상위 $k$개의 키만 고른 뒤, 선택된 키들에 대해서만 어텐션을 계산한다. 어텐션 본체의 복잡도는 프리필 $\mathcal{O}(Tk)$, 디코드 $\mathcal{O}(k)$로 줄어든다.
어텐션 본체가 가벼워져도 키를 고르는 인덱서 계산량은 그대로 남는다. DeepSeek의 DSA나 Qwen의 QSA, GLM-5.3-Flash에 들어간 기존 희소 어텐션 인덱서는 여전히 모든 선행 키나 인접 키 블록마다 점수를 매긴다. 상수 계수는 작아졌어도 점근적 복잡도는 프리필 $\mathcal{O}(T^2)$, 디코드 $\mathcal{O}(T)$ 그대로다.1
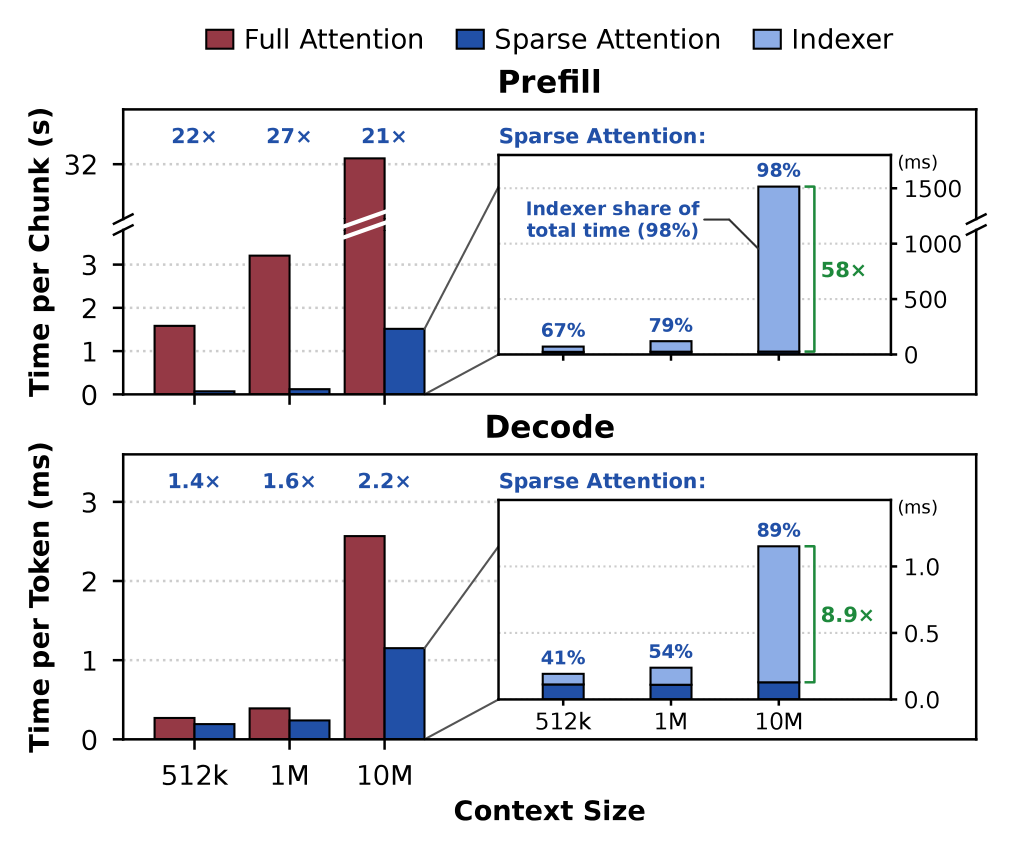 그림 1. H200 단일 GPU에서 측정한 GLM-5.3-Flash 글로벌 어텐션 레이어 1개의 프리필(위)과 디코드(아래) 소요 시간. 1,000만 토큰에서는 희소 어텐션 전체 프리필 시간의 98%, 디코드 시간의 89%가 인덱서에서 소모된다. 인덱서 비용을 0으로 가정하면 프리필은 58배, 디코드는 8.9배 더 빨라질 수 있다. (출처: Kubicek et al., 2026)
이 인덱서 병목을 직접 다룬 논문이 2026년 10월 30일 공개됐다. Prefrontal AI와 ETH 취리히의 공동 연구로, 알레스 쿠비체크(Ales Kubicek), 안드레아 카촐라이(Andrea Caciolai), 량쭈 펑(Liangzu Peng), 토르스텐 회플러(Torsten Hoefler), 제임스 위팅턴(James C.R. Whittington) 등이 참여했다. 그림 1처럼 1,000만 토큰 구간에서는 희소 어텐션 레이어 시간의 대부분이 키를 찾는 인덱서 연산에 쓰인다. 컨텍스트가 수백만 토큰으로 길어지면 실제 어텐션 행렬 곱셈은 금방 끝나고, 참조할 키 인덱스를 추려내는 단계에서 대부분의 시간을 쓴다.
잠재 희소 어텐션(LSA)의 작동 원리: 위치 대신 의미로 묶기
인덱서가 모든 키를 일일이 검사하지 않으려면 여러 키를 묶어서 한 번에 대표 점수를 매겨야 한다. 지금까지의 블록 희소 어텐션(Block Sparse Attention)은 시퀀스에서 위치상 연속된 토큰들을 하나의 블록으로 묶었다. 위치 기반 블록은 구현이 단순하지만, 블록이 클수록 서로 다른 내용의 토큰들이 하나의 평균 벡터로 합쳐지고 정작 필요한 키 하나의 신호는 희석된다.2
연구진이 제안한 잠재 희소 어텐션(Latent Sparse Attention, LSA)은 토큰의 시퀀스 위치 대신 의미 유사도(semantic similarity)를 기준으로 키를 묶는다. LSA는 잠재 공간에서 벡터 방향이 비슷한 인덱스 키들을 하나의 버킷(bucket)으로 묶어 둔다. 쿼리는 버킷 중심점(centroid)에만 점수를 매기고, 상위 버킷에 속한 키들만 후보로 삼는다.
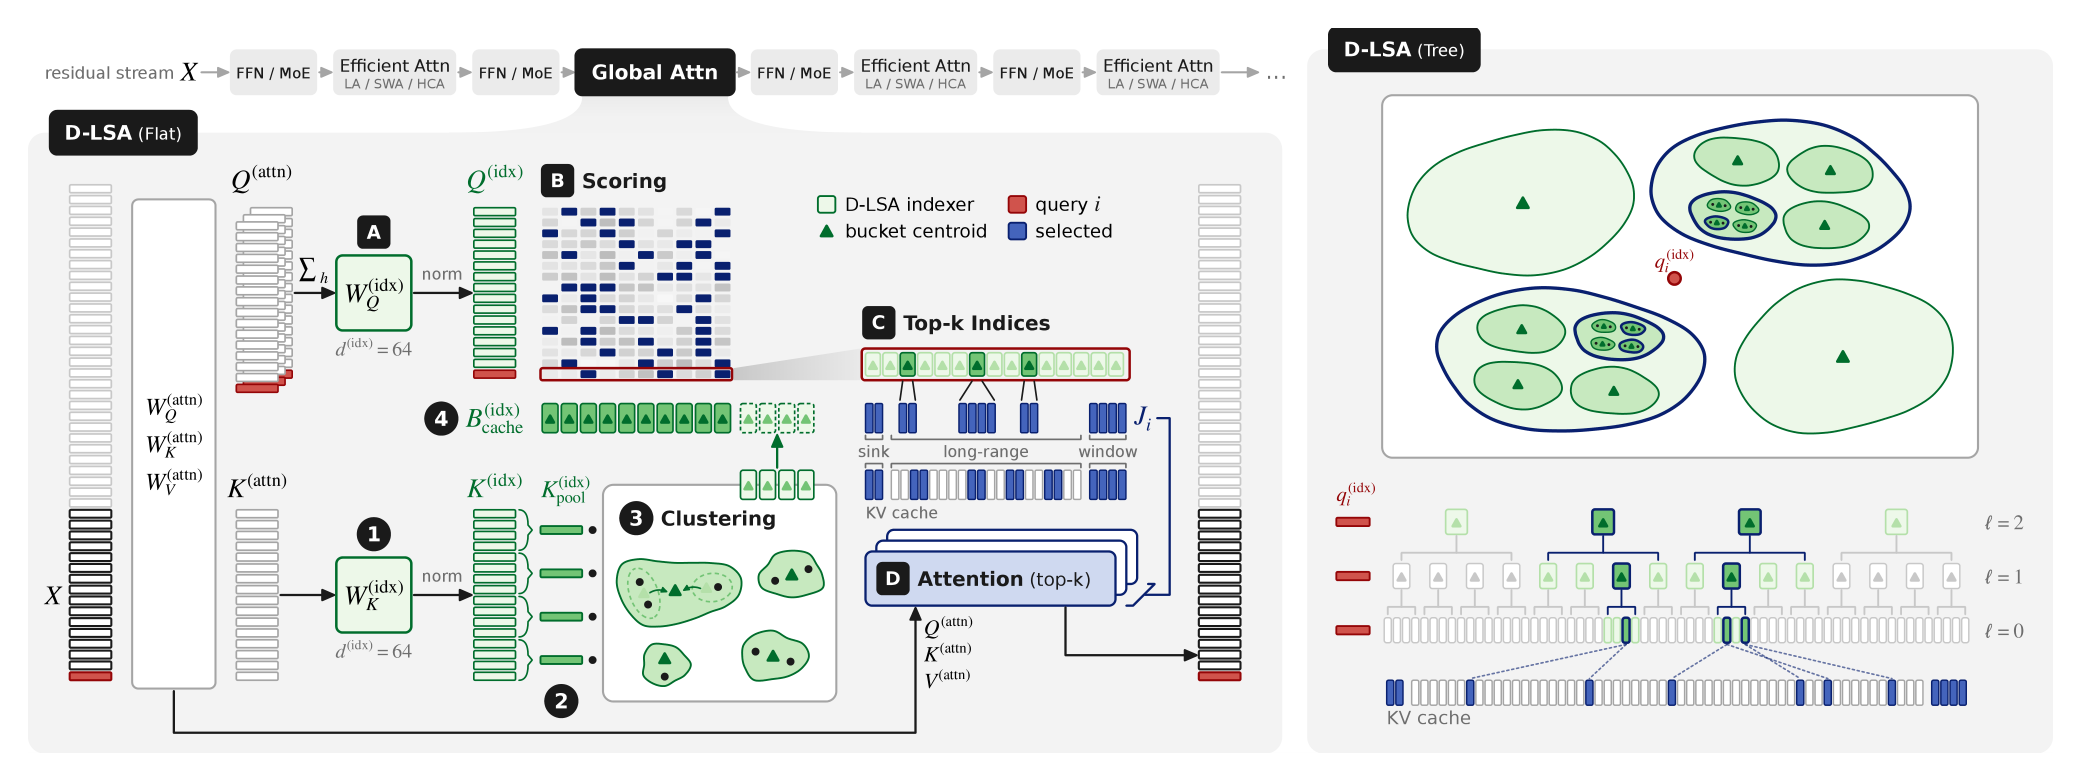 그림 2. D-LSA 설계도. 왼쪽(Flat)은 인덱스 키를 정규화(1) 및 4:1 풀링(2)한 뒤 워드(Ward) 응집 군집화(3)로 버킷 캐시(4)를 만들고, 쿼리가 버킷 중심점 점수를 매겨(A, B) 상위 버킷의 키 인덱스를 추출해 어텐션을 수행하는(C, D) 과정이다. 오른쪽(Tree)은 버킷들을 다시 다단계 계층 트리로 묶어 빔 서치로 탐색하는 구조다. (출처: Kubicek et al., 2026)
그림 2를 따라 LSA의 키 군집화와 쿼리 탐색 과정을 단계별로 살펴보자.
1단계: 의미 기반 키 군집화 (Semantic Clustering)
- 키 정규화: 각 토큰 위치 $j$의 인덱스 키 $k_j^{(\mathrm{idx})} \in \mathbb{R}^{d^{(\mathrm{idx})}}$를 L2 정규화해 단위 구면 위의 벡터로 만든다($d^{(\mathrm{idx})}=64$).
- 인접 풀링(Pooling): 군집화 연산량을 줄이려고 연속된 인덱스 키 4개($n_{\mathrm{pool}}=4$)를 합산해 하나의 풀 키(pool key)로 압축한다. 연속된 네 토큰은 국소 문맥을 공유한다. 이 넷을 풀 키 하나로 합치면 군집화 단계가 다뤄야 할 벡터 수가 4분의 1로 줄어든다.
- 워드(Ward) 상향식 응집 군집화: 연속된 키 512개($n_{\mathrm{cluster}}=512$)마다 클러스터 블록 하나를 구성한다. 블록에 속한 풀 키 128개(512/4)를 초기 버킷으로 두고, 상호 최소 비용 쌍(mutual cheapest pair)을 병렬로 반복 병합한다. 상호 최소 비용 쌍은 합쳤을 때 버킷 내 제곱 거리 합이 가장 적게 늘어나는 두 버킷이다. 버킷당 평균 키 개수가 8개($\bar{n}_b=8$), 즉 블록당 버킷이 64개($m=64$)가 되면 병합을 멈추고, 한 버킷의 키가 16개($n_b^{\mathrm{max}}=16$)를 초과하게 되는 병합은 건너뛴다.
- 버킷 캐시 저장: 완성된 각 버킷 $b$의 키 합산 벡터를 정규화해 단위 중심점 $c_b$를 구하고, 중심점 벡터와 버킷에 속한 키들의 위치 인덱스를 버킷 캐시 $B_{\mathrm{cache}}^{(\mathrm{idx})}$에 저장한다. 한 번 만든 클러스터 블록의 버킷은 생성이 끝날 때까지 그대로 쓴다.
2단계: 평면 탐색(Flat)과 트리 탐색(Tree)
쿼리 $i$가 주어지면 인덱스 쿼리 $q_i^{(\mathrm{idx})}$를 L2 정규화한 뒤, 버킷 중심점들과의 내적 $s_{i,b} = c_b \cdot q_i^{(\mathrm{idx})}$로 점수를 구한다. 여기서 탐색 방식은 두 가지로 구분된다.
| 구분 | 평면 탐색 (LSA Flat) | 트리 탐색 (LSA Tree) |
|---|---|---|
| 탐색 구조 | 단일 계층 버킷 ($m=64$/블록) 전수 비교 | 다단계 계층 노드 버킷 ($\ell=0 \dots \ell^{\mathrm{max}}$) |
| 쿼리당 탐색 방법 | 모든 버킷 중심점 스캔 후 상위 $p$개 선택 | 루트에서 빔 서치(폭 $p_\ell$)로 하향 탐색 |
| 쿼리당 복잡도 | $\mathcal{O}(T)$ (상수 계수 약 $1/\bar{n}_b = 1/8$ 축소) | $\mathcal{O}(\log T)$ |
| 프리필 전체 복잡도 | $\mathcal{O}(T^2)$ | $\mathcal{O}(T \log T)$ (준이차) |
평면 탐색(Flat)은 단일 계층의 모든 버킷 중심점을 직접 비교해 상위 $p$개 버킷을 고른다. 점근적 복잡도는 여전히 $\mathcal{O}(T)$다. 그러나 비교 대상이 개별 키에서 평균 8개 키를 대표하는 버킷 중심점으로 바뀌어 개수가 8분의 1로 줄고, 벡터도 64차원(BF16)이라 실제 연산 시간과 메모리 대역폭 사용량이 크게 줄어든다.
트리 탐색(Tree)은 32개의 클러스터 블록이 쌓일 때마다 버킷들을 같은 워드 군집화 알고리즘으로 다시 묶어 상위 레벨($\ell=1, 2, \dots$)의 노드 버킷 트리를 구축한다. 쿼리는 최상위 레벨에서 빔 서치(beam search)를 시작한다. 레벨마다 점수가 가장 높은 노드 $p_\ell$개만 남기는 과정을 리프 레벨까지 반복해 최종 리프 버킷 $p$개를 고른다. 쿼리당 탐색 비용이 $\mathcal{O}(\log T)$이므로 프리필 전체 복잡도는 준이차(subquadratic)인 $\mathcal{O}(T \log T)$가 된다.
상위 버킷 $p$개를 고르면, 그 버킷들에 속한 키 위치에서 장거리(long-range) 키 인덱스를 총 $k$개 얻는다.3 여기에 시퀀스 맨 앞의 어텐션 싱크 토큰 4개($n_{\mathrm{sink}}=4$)와 현재 쿼리 직전의 슬라이딩 윈도우 토큰 512개($n_w=512$)를 더해 인덱스 집합 $J_i$를 만들고, 실제 어텐션은 이 집합에 대해서만 계산한다.
두 가지 학습 경로: 증류형 D-LSA와 네이티브 N-LSA
연구진은 LSA를 두 가지 방식으로 구현했다. D-LSA(Distilled-LSA)는 이미 학습된 모델에 경량 인덱서만 증류해 붙이고, N-LSA(Native-LSA)는 백지상태 모델의 사전학습 단계부터 LSA를 직접 적용한다.
| 구분 | 증류형 D-LSA (Distilled-LSA) | 네이티브 N-LSA (Native-LSA) |
|---|---|---|
| 적용 대상 | 사전학습 완료 모델 (가중치 동결) | 처음부터 사전학습하는 모델 (0.5B 하이브리드) |
| 인덱스 공간 | 레이어별 64차원 투영 $W_Q^{(\mathrm{idx})}, W_K^{(\mathrm{idx})}$ | 단일 KV 헤드 어텐션 키 $K$ 직접 사용 (128차원) |
| 학습 손실 함수 | 어텐션 분포 순방향 KL 발산 | 다음 토큰 예측(NTP) 단일 손실 |
| 학습 토큰 규모 | LongDocs 3억 5,200만(352M) 토큰 | FineWeb-Edu 100B + LongDocs 12B (128k) |
D-LSA: 3억 5,200만 토큰만으로 기존 모델에 이식
D-LSA는 이미 학습이 끝난 대형 모델의 가중치를 전부 동결(freeze)한 채, 각 어텐션 레이어에 64차원 경량 인덱스 투영 행렬 $W_Q^{(\mathrm{idx})}, W_K^{(\mathrm{idx})}$와 소프트맥스 온도 스칼라 $\tau$를 추가하고 이 새 파라미터만 학습한다. 학습 방식은 지식 증류(distillation)로, 원래 모델의 헤드 평균 어텐션 분포 $A_i$와 인덱서가 만드는 분포 $\hat{A}_i$ 사이의 순방향 KL 발산(Forward KL divergence)을 최소화한다.
$$\mathcal{L}_{\mathrm{KL}} = \frac{1}{T} \sum_{i=1}^T D_{\mathrm{KL}}\!\left(A_{i, 1:i} \,\|\, \hat{A}_{i, 1:i}\right)$$인덱서 파라미터는 레이어마다 독립적이므로 전체 모델을 메모리에 올릴 필요 없이 원래 모델의 은닉 상태를 한 번 추출해 두고 레이어별로 따로 학습할 수 있다. 연구진은 구텐베르크 도서, arXiv 논문, 코드 리포지토리, 자체 에이전트 실행 궤적을 모은 장문 데이터셋 LongDocs에서 3억 5,200만(352M) 토큰만 샘플링해 D-LSA 인덱서를 증류했다. 기존 DSA와 GLM-5.3-Flash는 희소 어텐션 적응에 21억(2.1B) 토큰 이상을 썼는데, D-LSA는 그 6분의 1도 안 되는 분량으로 학습을 마쳤다. 연구진은 학습 없이 기존 키와 쿼리의 주성분 분석(PCA)만으로 64차원 인덱스 공간을 만드는 변형 D-LSA (Training-Free)도 구현했다.
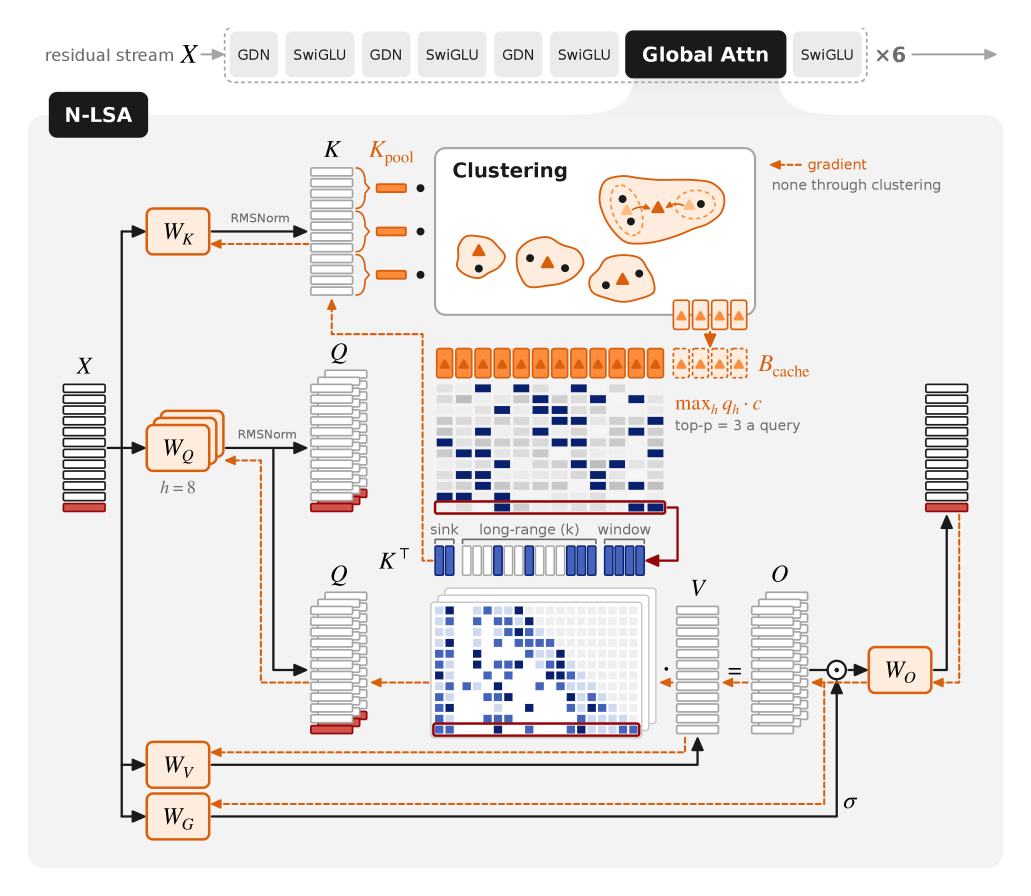 그림 3. N-LSA 어텐션 레이어 구조도. 별도의 인덱스 투영 행렬 없이 단일 KV 헤드의 키 $K$를 그대로 군집화한다. 역전파 기울기(주황색 점선)는 선택된 상위 $k$개 키의 어텐션 연산에서 쿼리와 키로 직접 전달된다. (출처: Kubicek et al., 2026)
N-LSA: 보조 손실 없이 다음 토큰 예측만으로 사전학습
인덱서를 사후에 증류하지 않고 처음부터 희소 어텐션 구조로 모델을 사전학습하는 경로가 N-LSA다. 기존 네이티브 희소 어텐션(NSA, PISA 등)은 압축된 블록 표현을 원래 어텐션과 따로 학습해야 하거나 구조가 복잡했다. 그림 3의 N-LSA에는 별도의 인덱스 투영 행렬이나 보조 손실 함수가 필요 없다. 단일 KV 헤드($d_h=128$)를 쓰는 어텐션 레이어에서 어텐션 키 $K$ 자체를 그대로 L2 정규화하고 군집화해 버킷을 만든다.
상위 $k$개 키를 고르는 이산 선택(top-$k$)은 미분할 수 없다. 그래도 고른 키들로 소프트맥스 어텐션을 계산하는 단계에서 역전파 기울기가 쿼리와 그 키들로 직접 전달된다. 다음 토큰 예측(Next-Token Prediction, NTP) 손실 하나만으로도 키와 쿼리 표현이 군집 탐색에 맞게 학습된다.
실험 결과 1: 1,000만 토큰까지의 정확도와 신규 벤치마크 PaperTrail
연구진은 오픈 가중치 모델 두 종에 D-LSA를 적용해 1,000만 토큰까지 평가했다. Qwen-3.8-27B는 선형 어텐션 레이어 48개와 표준 풀 어텐션 레이어 16개로 구성되며, 기본 256k 컨텍스트를 YaRN으로 10M까지 확장했다. GLM-5.3-Flash는 전체 30B 파라미터 중 3B가 활성화되는 MoE 모델로, 기본 탑재된 블록 희소 어텐션(DSA 계열)과 200k 컨텍스트를 역시 YaRN으로 10M까지 늘려 실험했다.
특히 이 논문은 초장문 컨텍스트의 고질적인 평가 한계를 보완하기 위해 PaperTrail이라는 새로운 과학 문헌 벤치마크를 직접 제작해 공개했다. RULER 같은 기존 건초더미 속 바늘 찾기(needle-in-a-haystack) 벤치마크는 무관한 합성 텍스트 사이에 짧은 문장을 숨기는 방식이라, 단순 어휘 매칭만으로도 문제를 풀 수 있었다.
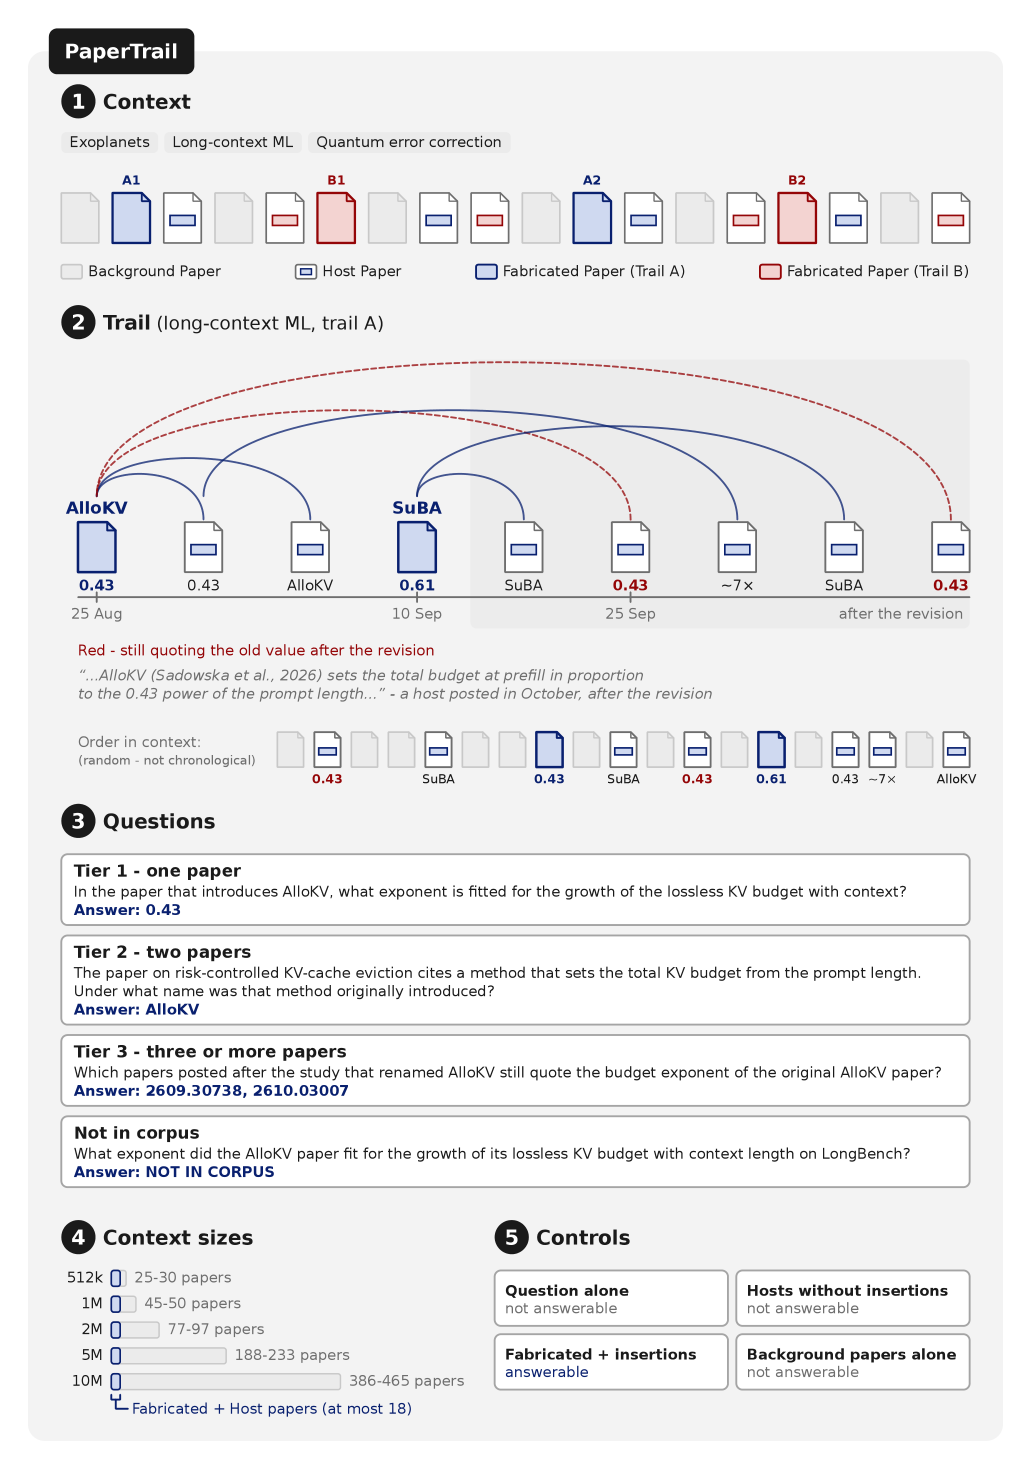 그림 4. 초장문 과학 문헌 추론 벤치마크 PaperTrail 구조도. (1) 실제 arXiv 배경 논문들 사이에 가상 논문(A1, A2, B1, B2)과 인용 문구가 삽입된 호스트 논문을 배치한다. (2) 후속 논문에서 기법 이름이
AlloKV에서 SuBA로 바뀌고 지수가 0.43에서 0.61로 수정되는 연구 계보를 형성한다. (3) 단일 논문 확인(Tier 1)부터 다중 논문 계보 추적(Tier 3) 및 미수록 질문까지 평가한다. (출처: Kubicek et al., 2026)
PaperTrail은 2026년에 공개된 실제 arXiv 프리프린트 1,246편(외계행성, 장문 머신러닝, 양자 오류 정정의 3개 분야)을 배경 코퍼스로 삼는다.4 연구진은 이 코퍼스에 직접 작성한 가상 논문(fabricated paper) 2편을 추가했다. 그리고 실제 호스트 논문 6편에서 7편에 가상 논문을 인용하거나 나중에 수정된 수치를 쓰는 삽입 문구(insertion) 8개에서 9개를 자연스럽게 끼워 넣어 연구 계보(trail)를 만들었다. 예를 들어 첫 논문이 AlloKV라는 기법과 지수 0.43을 제안하면, 몇 주 뒤 후속 논문이 이름을 SuBA로 바꾸고 지수를 0.61로 정정하며, 이후 논문들은 옛 이름과 새 수치를 섞어 인용한다.
1,000만 토큰 기준으로 코퍼스는 논문 386~465편으로 이뤄지며, 각 논문은 발표 시점과 무관한 순서로 섞여 있어 인용하는 호스트 논문이 인용 대상 논문보다 앞에 나오기도 한다. 모델은 이 논문들을 읽고 세 등급의 질문을 푼다. 한 논문의 내용을 확인하는 Tier 1, 두 논문을 연결하는 Tier 2, 세 편 이상이 관련된 연구 계보 전체를 추적하는 Tier 3다.
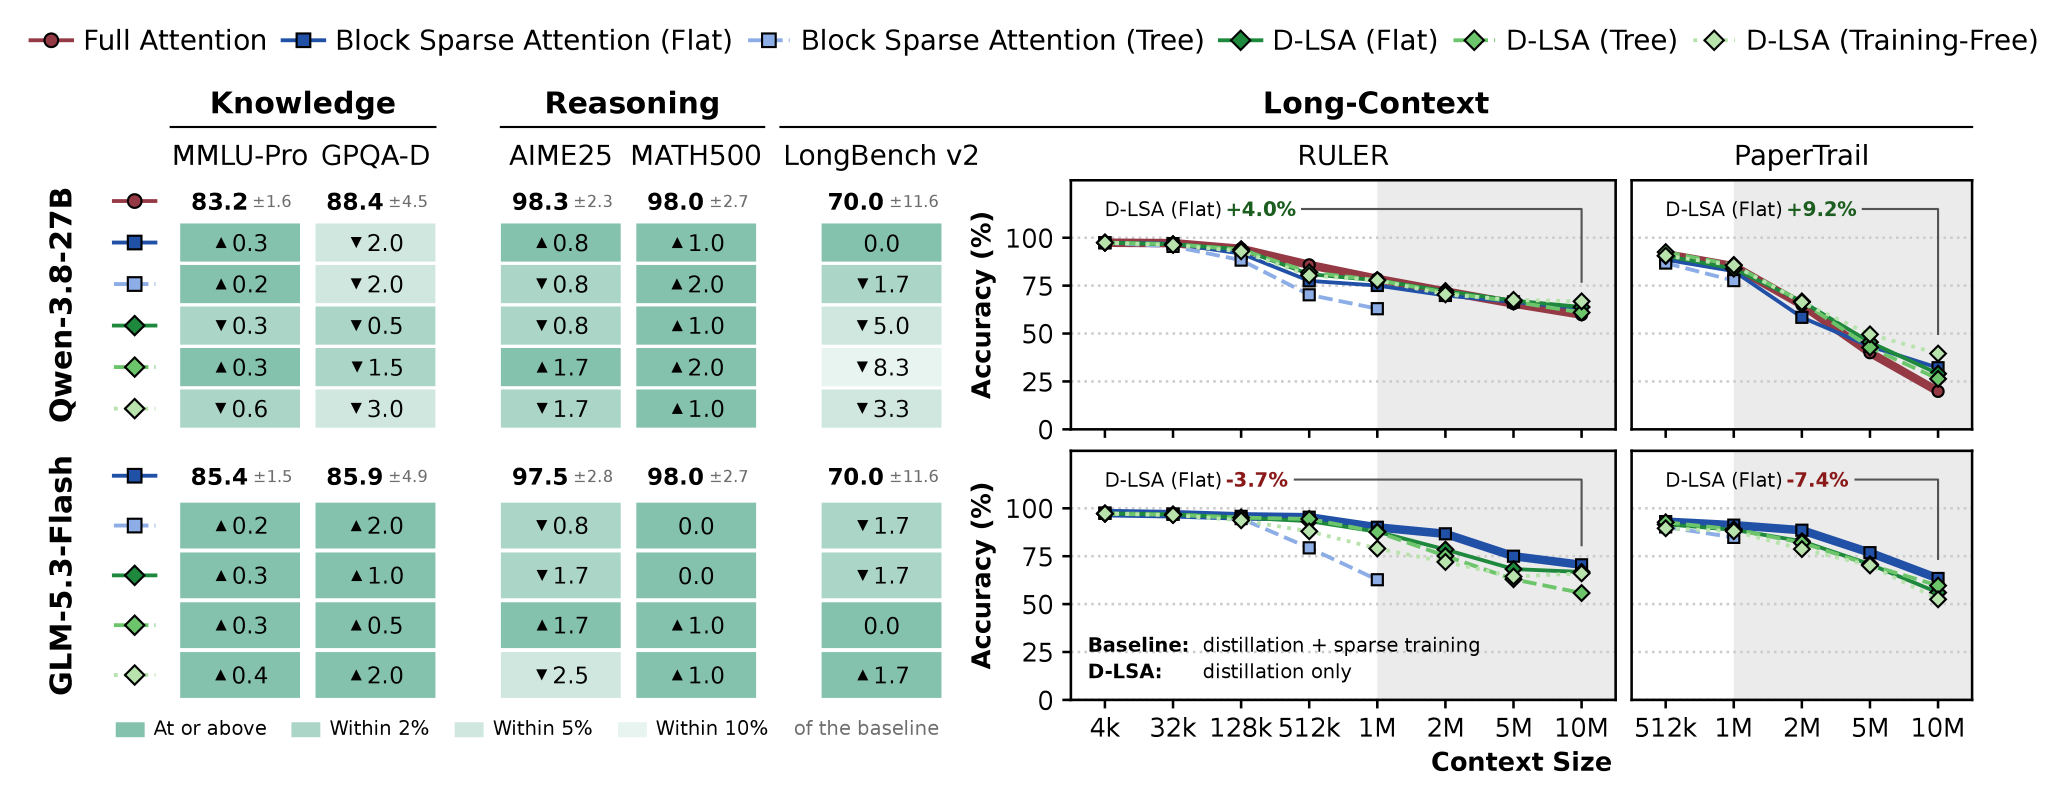 그림 5. Qwen-3.8-27B(위)와 GLM-5.3-Flash(아래)에서 측정한 D-LSA의 다운스트림 정확도. 왼쪽은 단문 지식(MMLU-Pro, GPQA-D), 수학 추론(AIME25, MATH500), LongBench v2 성적이며, 오른쪽은 4k부터 1,000만(10M) 토큰까지 확장한 RULER와 PaperTrail 정확도 곡선이다. (출처: Kubicek et al., 2026)
D-LSA는 단문 지식과 추론 벤치마크 5종 모두에서 원본 모델과의 차이가 95% 신뢰구간 이내였다. 1,000만 토큰까지의 장문 평가 결과는 세 가지로 요약된다.
- Qwen-3.8-27B (풀 어텐션과 비교): D-LSA(Flat)와 D-LSA(Tree)는 4k부터 1,000만 토큰까지 전 구간에서 원본 풀 어텐션과 대등하거나 더 높은 성적을 거뒀다. 500만~1,000만 토큰 구간에서는 풀 어텐션의 소프트맥스 분포가 수백만 개의 무관한 토큰으로 분산되면서(attention dilution) 점수가 떨어진다. 상위 핵심 키만 남기는 D-LSA(Flat)는 1,000만 토큰에서 전체 평균 정확도가 풀 어텐션보다 RULER는 4.0%p, PaperTrail은 9.2%p 높았다(PaperTrail Tier 1 기준 53.3점 대 32.2점).
- GLM-5.3-Flash (기존 희소 어텐션과 비교): 베이스라인 모델은 이미 21억 토큰 규모의 희소 어텐션 적응을 거쳤다. D-LSA(Flat)는 가중치를 동결한 채 3억 5,200만 토큰만 증류했는데도 200만 토큰까지 베이스라인과 거의 같은 성적을 냈고, 1,000만 토큰에서도 차이가 RULER -3.7%p, PaperTrail -7.4%p에 그쳤다.
- 의미 군집화 트리 vs 위치 블록 트리: 위치상 연속된 키를 묶어 계층 탐색을 수행하는 Block Sparse Attention(Tree)은 512k 토큰부터 정확도가 급락해 100만 토큰 RULER에서 두 모델 모두 약 63점에 머물렀다. 같은 100만 토큰 RULER에서 의미 유사도로 키를 묶은 D-LSA(Tree)는 Qwen 78점, GLM 88점을 기록했다.
실험 결과 2: 최대 72.4배 빠른 어텐션 레이어와 SGLang 프로덕션 서빙
연구진은 NVIDIA H200과 차세대 B300 GPU용 D-LSA 전용 커널을 CuTe DSL과 Triton으로 직접 구현했다. 이 커널을 프로덕션 서빙 프레임워크 SGLang에 통합해 텐서 병렬화(TP8), 컨텍스트 병렬화(CP8, DCP8)와 함께 쓸 수 있게 했다.
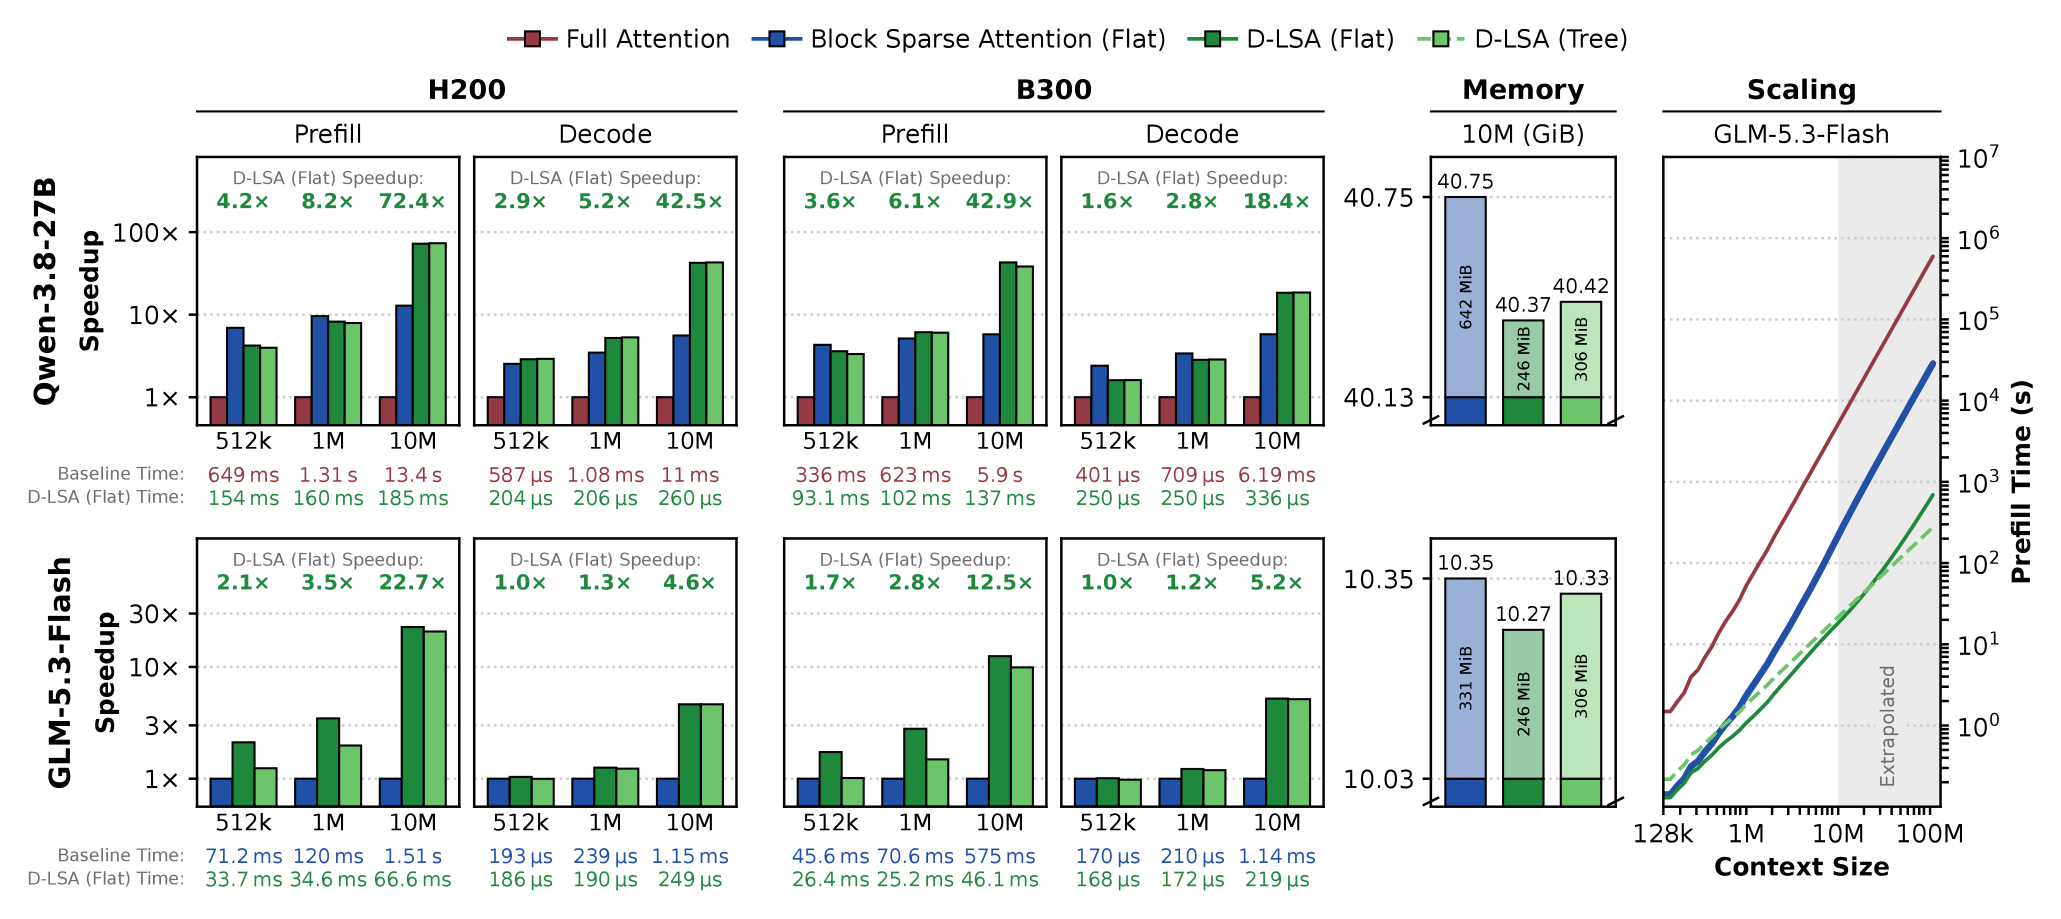 그림 6. 단일 글로벌 어텐션 레이어 기준 D-LSA의 가속 성능. H200과 B300에서의 프리필 및 디코드 속도 향상 배율(왼쪽), 1,000만 토큰 시점의 레이어당 인덱서 메모리 점유량(가운데), 1억(100M) 토큰까지 외삽한 프리필 시간 스케일링(오른쪽)을 보여준다. (출처: Kubicek et al., 2026)
그림 6은 단일 글로벌 어텐션 레이어의 실행 시간과 메모리 효율을 보여준다. H200 GPU에서 1,000만 토큰을 처리할 때 D-LSA(Flat)는 Qwen-3.8-27B의 풀 어텐션보다 프리필이 72.4배(13.4초에서 185ms로), 디코드가 42.5배(11ms에서 260µs로) 빨랐다. 블록 희소 어텐션을 쓰는 GLM-5.3-Flash와 비교해도 1,000만 토큰에서 프리필이 22.7배(1.51초에서 66.6ms로), 디코드가 4.6배(1.15ms에서 249µs로) 빨라졌다. 인덱서는 평균 8개 키마다 64차원 중심점 하나만 저장하므로, 추가 메모리가 1,000만 토큰 기준 레이어당 246 MiB에 그친다. GLM-5.3-Flash 기본 인덱서(331 MiB)나 QSA(642 MiB)보다 적은 양이다.
전체 모델을 SGLang에 올려 측정한 종단간(end-to-end) 서빙 속도도 크게 빨라졌다. FFN(또는 MoE) 레이어와 선형 어텐션 레이어의 연산 시간은 그대로다. 1,000만 토큰 구간에서는 글로벌 어텐션의 인덱서 연산이 전체 실행 시간의 상당 부분을 차지하므로, 이 구간만 가속해도 모델 전체 응답 시간이 큰 폭으로 준다.
| 모델 / 병렬화 구성 (H200) | 방식 | 1M TTFT | 10M TTFT | 1M TPOT | 10M TPOT |
|---|---|---|---|---|---|
| Qwen-3.8-27B (TP8 DCP8) | Full Attention (기준) | 16.5초 | 1,288.2초 | 8.2ms | 48.0ms |
| Qwen-3.8-27B (TP8 DCP8) | D-LSA (Flat) | 2.22배 | 9.21배 | 1.54배 | 2.87배 |
| Qwen-3.8-27B (TP8 DCP8) | D-LSA (Tree) | 2.13배 | 9.20배 | 1.38배 | 2.89배 |
| GLM-5.3-Flash (TP8) | Sparse Attention (기준) | 38.4초 | 1,861.4초 | 5.6ms | 17.6ms |
| GLM-5.3-Flash (TP8) | D-LSA (Flat) | 1.49배 | 5.83배 | 1.02배 | 1.90배 |
| GLM-5.3-Flash (CP8 DCP8) | Sparse Attention (기준) | 18.8초 | 462.6초 | 7.3ms | 23.0ms |
| GLM-5.3-Flash (CP8 DCP8) | D-LSA (Flat) | 1.00배 | 2.24배 | 1.03배 | 2.10배 |
H200 노드에서 1,000만 토큰 요청 1건을 처리할 때, Qwen-3.8-27B의 첫 토큰 생성 시간(TTFT)은 풀 어텐션에서 1,288.2초(약 21분 28초)였다. D-LSA를 적용하자 약 140초로 줄어 9.21배 빨라졌고, 출력 토큰당 생성 시간(TPOT)도 2.87배 빨라졌다. GLM-5.3-Flash 역시 1,000만 토큰에서 기존 희소 어텐션보다 TTFT가 TP8 구성에서 5.83배, CP8 DCP8 구성에서 2.24배 빨라졌다.
실험 결과 3: N-LSA 네이티브 사전학습 검증
마지막으로 연구진은 5억(0.5B) 파라미터 규모의 하이브리드 모델을 처음부터 사전학습하며 N-LSA를 검증했다. 이 모델은 24개 레이어 중 네 번째 레이어마다 글로벌 어텐션을 쓰고, 나머지 레이어는 Gated DeltaNet이다. 학습은 두 단계로 진행했다. FineWeb-Edu 1,000억(100B) 토큰으로 4k 컨텍스트에서 Warmup-Stable 단계를, LongDocs 120억(12B) 토큰으로 128k 컨텍스트에서 Decay 단계를 학습했다. 비교 대상은 풀 어텐션, 슬라이딩 윈도우(SWA), NSA, PISA다. 참조하는 키 개수는 모든 희소 어텐션 기법에서 쿼리당 약 2,560개로 통일했다.
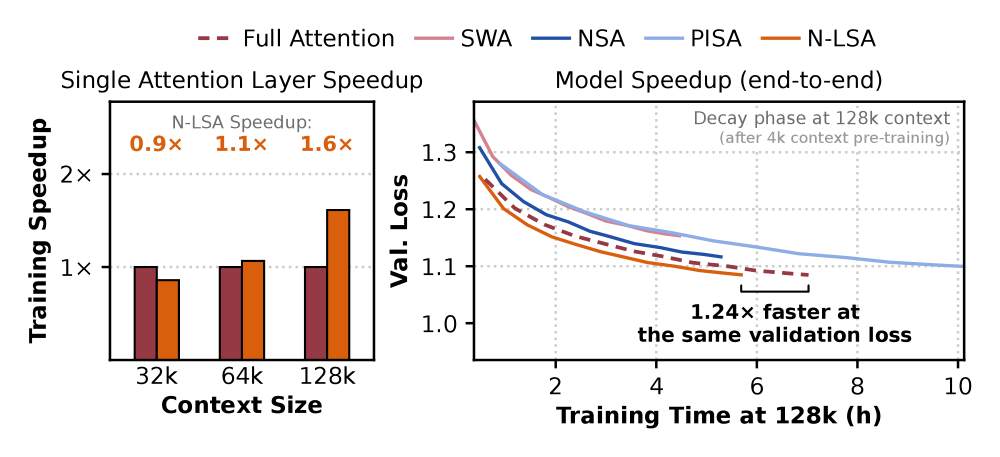 그림 7. N-LSA 네이티브 사전학습 성능. 왼쪽은 H200 단일 GPU에서 측정한 어텐션 레이어 1개의 순전파 및 역전파 학습 속도 향상 배율이고, 오른쪽은 128k 컨텍스트 Decay 단계에서 전체 모델 학습 시간에 따른 검증 손실(validation loss) 추이다. (출처: Kubicek et al., 2026)
| 학습 방식 (0.5B 모델) | 검증 손실 (128k) | ARC-c | HellaSwag | SWDE | FDA | RULER (64k) | RULER (128k) |
|---|---|---|---|---|---|---|---|
| Full Attention | 1.085 | 30.0 | 45.6 | 67.8 | 79.3 | 35.6 | 34.7 |
| SWA (슬라이딩 윈도우) | 1.154 | 31.4 | 45.2 | 64.6 | 69.6 | 3.0 | 3.0 |
| NSA (평면 블록 희소) | 1.117 | 30.1 | 45.8 | 62.2 | 72.2 | 18.9 | 19.2 |
| PISA (트리 블록 희소) | 1.100 | 28.7 | 45.5 | 63.7 | 78.6 | 19.1 | 14.6 |
| N-LSA (본 논문) | 1.085 | 30.8 | 45.5 | 66.4 | 79.2 | 32.9 | 32.2 |
128k 컨텍스트 학습 종료 시점에 N-LSA는 보조 손실이나 별도 인덱서 없이 풀 어텐션과 똑같은 검증 손실(1.085)에 도달했다. 위치 기반 블록을 쓰는 PISA(1.100)와 NSA(1.117), 그리고 SWA(1.154)는 풀 어텐션보다 높은 손실로 학습을 마쳤다. RULER 128k 평가에서도 NSA(19.2점)와 PISA(14.6점)가 큰 폭으로 하락한 것과 달리 N-LSA는 32.2점을 기록해 풀 어텐션(34.7점)에 근접했다. 학습 속도에서도 이점이 있었다. 128k 토큰 기준으로 N-LSA 어텐션 레이어 하나의 순전파와 역전파는 FlashAttention-3 기반 풀 어텐션보다 1.6배 빨랐고, 전체 모델의 128k Decay 단계 학습도 1.24배 빨라졌다.5
가장 흥미로운 지점
부록(Appendix E)과 본문 그림 5에 실린 D-LSA (Training-Free)의 성적을 따로 떼어 볼 만하다. 이 변형에는 가중치 학습이 한 스텝도 없다. 기존 어텐션 키와 쿼리 행렬에서 주성분 분석(PCA)으로 상위 64개 방향만 뽑아 워드 군집화를 적용할 뿐이다. 그런데도 Qwen-3.8-27B에서 1,000만 토큰까지 풀 어텐션과 대등한 RULER와 PaperTrail 정확도를 유지했다.
| Qwen-3.8-27B 비교 항목 | Full Attention | D-LSA (Flat, 증류) | D-LSA (Tree, 증류) | D-LSA (Training-Free) |
|---|---|---|---|---|
| MMLU-Pro | 83.2 | 82.9 | 83.5 | 82.6 |
| MATH500 | 98.0 | 99.0 | 100.0 | 99.0 |
| LongBench v2 | 70.0 | 65.0 | 61.7 | 66.7 |
| PaperTrail 미수록 판별 (512k) | 100.0% | 96.3% | 96.3% | 98.1% |
학습 없이 PCA 투영만 쓴 변형은 512k 토큰 PaperTrail의 미수록 질문 판별(not-in-corpus)에서 98.1%를 기록해, 지식 증류를 거친 D-LSA(96.3%)보다 조금 높았다. 별도 학습 없이 주성분 64개만 추려도 군집 탐색이 작동한다는 점은, 사전학습된 트랜스포머의 키 벡터들이 이미 의미별로 뭉쳐 있음을 뜻한다. 지금까지의 희소 어텐션 연구는 대개 하드웨어 메모리 접근 패턴에 맞춰 인접한 토큰들을 고정 길이 블록으로 묶는 데 집중했다. 그러나 문서 수백 편이 이어지는 초장문 컨텍스트에서는 시퀀스에서 인접한 토큰이라고 해서 의미도 비슷하다고 보기 어렵다. 반대로 비슷한 주제를 다루는 키들은 문서 전체에 흩어져 있어도 벡터 공간에서는 서로 높은 코사인 유사도를 갖는다.
LSA는 512개 키 단위 클러스터 블록마다 그람 행렬(Gram matrix) 내적으로 워드 군집화를 병렬 처리하고, 쿼리마다 버킷 중심점만 비교한다. 하드웨어 친화적인 블록 단위 텐서 코어 연산을 유지한 채 의미 기반 군집화로 탐색 대상을 8분의 1로 줄인 설계다. 100만 토큰을 웃도는 초장문 서빙에서는 어텐션 커널 못지않게 인덱서의 색인 구조가 처리 속도와 검색 정확도를 결정한다.
출처
- Ales Kubicek, Andrea Caciolai, Liangzu Peng, Sukrit Sumant, Benjamin Hoover, Fraser Greenlee, Ruairidh M. Battleday, Radim Urban, Torsten Hoefler, James C.R. Whittington, “Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention”, arXiv:2610.42147, 2026-10-30. 원문 링크
논문 부록 A의 오라클 실험(Top-$k$ Oracle Attention)에 따르면, 128k 토큰 컨텍스트에서 각 쿼리가 장거리 키 상위 512개(전체의 0.8%)와 싱크 4개, 윈도우 512개만 정확히 찾아 참조해도 풀 어텐션 RULER 정확도의 98%가 유지된다. 즉 초장문 희소 어텐션의 핵심 과제는 어텐션 연산보다 관련 키를 저비용으로 찾아내는 인덱싱이다. ↩︎
논문 부록 E.6(그림 14)은 블록 희소 어텐션 트리의 블록 크기($n_{\mathrm{pool}}$)를 8, 16, 64로 바꿔 가며 실험했다. 같은 개수의 키(4,608개)를 선택해도 블록이 클수록 대표 점수 하나가 대변하는 토큰이 많아져, 더 짧은 컨텍스트 길이에서부터 정확도가 급락했다. ↩︎
선택된 $p$개의 버킷에 속한 전체 키 개수는 버킷 크기가 가변적($\bar{n}_b=8, n_b^{\mathrm{max}}=16$)이기 때문에 일정하지 않다. 구현에서는 버킷 점수에 따라 상위 버킷부터 순서대로 키를 채워 정확히 $k$개(예: Qwen-3.8-27B는 $p=512, k=4096$)에서 자른다. ↩︎
데이터 오염, 다시 말해 평가 모델이 사전학습 때 본 논문을 기억해 답하는 일을 막기 위해, 500만 토큰 이하 PaperTrail 코퍼스는 Qwen-3.8-27B와 GLM-5.3-Flash의 출시일 이후에 공개된 2026년 프리프린트로만 구성했다. ↩︎
N-LSA는 역전파를 위해 각 쿼리가 선택한 키 인덱스를 저장해야 하므로 128k 토큰 기준 레이어당 피크 메모리가 6.8 GiB로 풀 어텐션(5.8 GiB)보다 약 1 GiB 더 높다. 이번 논문의 N-LSA 검증은 0.5B 모델, 128k 토큰, 평면 탐색(Flat) 조건에 한정되며, 연구진은 트리 탐색을 결합한 대규모 네이티브 학습을 후속 과제로 남겼다. LSA는 키를 찾는 인덱싱 비용만 줄이고 KV 캐시 크기는 그대로 두므로, KV 캐시 압축이나 레이어 간 인덱스 공유 기법과 독립적으로(orthogonal) 함께 쓸 수 있다. ↩︎