3줄 요약
- 상하이교통대와 Theseus Labs를 비롯한 아홉 기관의 연구자 33명이 2026년 9월 10일 arXiv에 재귀적 자기 개선(recursive self-improvement, RSI) 서베이를 올렸다. 75쪽에 논문 491편과 기업 72곳의 사례를 정리한 문서다.
- 저자들은 개선 루프 하나를 분석 단위로 놓고, 인간이 쥐고 있던 결정 가운데 무엇이 AI에게 넘어갔는지로 자율성을 L1부터 L5까지 가른다. 점수가 얼마나 올랐는가는 이 사다리의 눈금이 아니다. 개선을 만들어 내는 장치 자체가 고쳐져서 다음 라운드로 상속되는가를 묻는다.
- 논문이 새로 제안한 정규화 지표 HCI로 보면 2026년의 고급 수학은 86.4에 이른 반면 도구 에이전트는 39.9에 머물렀다. 검증이 값싼 환경에서 얻은 이득은 길게 이어지며 상태를 지닌 작업으로 옮겨 가지 않았다. 남은 여백이 큰 쪽에 RSI의 쓸모가 몰려 있다는 것이 이 서베이의 출발점이다.
벤치마크 점수를 한 자로 다시 재기
저자들은 서론에서 곧바로 RSI 이야기를 꺼내지 않는다. 먼저 지금 모델들이 어디까지 왔는지를 자기들 방식으로 다시 잰다. 2023년부터 2026년 9월 사이에 공개된 모델을 대상으로, 열 개 능력 영역에서 모델과 벤치마크의 조합 393건을 모았다.
문제는 벤치마크마다 재는 것이 달라서 원래 점수를 그대로 모을 수 없다는 데 있다. 이 문제를 피하려고 저자들은 Headroom-Closed Index(HCI)라는 정규화 값을 쓴다. 어떤 벤치마크가 데이터셋에 처음 들어온 해의 90번째 백분위 점수를 $F_{b,0}$이라 두고, 모델 $m$의 점수를 이렇게 옮긴다.
$$H_{mbh}=100\times\frac{\bar{s}_{mbh}-F_{b,0}}{100-F_{b,0}}$$0은 그 벤치마크가 등장한 해의 최전선이고, 100은 만점이다. 즉 HCI가 재는 것은 절대 점수가 아니다. 처음 등장했을 때 남아 있던 여백을 얼마나 닫았는가를 잰다. 같은 출처가 여러 번 보고한 값에는 가중 합의를 적용한다. 벤치마크 소유자 표에는 3, 독립적인 공통 하네스 평가에는 2.5, 통합 보고서에는 2, 모델 제작사 표에는 1의 기본 가중치를 준다. 자사 발표 값에는 0.75를 한 번 더 곱한다.
이렇게 재고 나면 세 가지가 보인다고 저자들은 적는다.
첫째, 최전선의 전진 폭과 시점이 영역마다 다르다. 2026년에 고급 수학은 86.4, 대학원 수준 과학은 85.8, 광범위 지식은 77.2에 이르렀다. 법률 추론은 64.5, 멀티모달 추론은 62.2, 학문적 난제는 60.4다. 연도별 증가분을 보면 성격이 더 갈린다. 광범위 지식은 32.8, 26.9, 17.6점씩 오르며 완만하게 느려졌고, 법률 추론은 2024년 48.2점에서 2025년 11.4점, 2026년 4.9점으로 급격히 둔화했다. 고급 수학은 반대로 2025년 32.8점에서 2026년 53.6점으로 폭이 커졌다. 멀티모달 추론은 2025년에 59.7점을 올린 뒤 2026년에는 2.5점에 그쳤다.
둘째, 상호작용이 필요한 능력일수록 여백이 크게 남아 있다. 2026년 소프트웨어 공학은 52.6, 검색과 터미널 에이전트는 56.8, 도구 에이전트는 39.9다. 대학원 수준 과학의 85.8과 견주면 각각 33.2점, 29.1점, 45.9점이 낮다. 도구 에이전트는 2026년에 8.2에서 39.9로 크게 뛰었는데도 여전히 가장 아래에 있다. 사이버보안 에이전트는 91.9까지 올라가 도구 에이전트와 52.0점 차이를 만든다. 다만 이 비교에는 단서가 붙는다. 후반부 Cybench 관측치는 과제 부분집합이나 pass@1 집계 방식이 바뀌었고, 도표에서도 그 구간을 점선으로 표시해 두었다.
셋째, 남은 여백이 곧 RSI가 값어치를 낼 자리라는 것이 저자들의 주장이다. 이들은 2026년 이후 구간에 예시용 외삽을 그려 넣는데, 도메인 $d$의 도착점을 $R_{d}=100-0.22\left(100-T_{d,2026}\right)$로 잡는다. 남은 여백의 78%가 닫힌다고 가정한 값이다. 그러면 사이버보안은 91.9에서 98.2로 조금 움직이는 데 비해, 소프트웨어 공학은 52.6에서 89.6으로, 도구 에이전트는 39.9에서 86.8로 크게 이동한다. 저자들은 이 숫자가 예측이 아닌 가설의 시각화라고 분명히 밝힌다.
개선 루프를 부품 단위로 뜯으면
RSI라는 말은 이미 여러 곳에서 다르게 쓰인다. 저자들은 특정 학습 알고리즘 대신 개선 루프를 분석 단위로 삼아 이 혼선을 정리한다. 루프는 AI가 경험을 써서 대상의 수정을 제안하고, 수용 규칙에 따라 후보를 평가하는 과정이다. 통과한 변경은 상태로 보존되고, 다음 라운드는 그 갱신된 상태에서 시작된다.
저자들은 이 루프를 여덟 개의 부품으로 나눈다.
| 부품 | 무엇인가 |
|---|---|
| AI 시스템 | 개선 주기를 가로질러 능력 상태가 추적되는 계산 실체 전체 |
| 시스템 상태 | 한 라운드 끝에 남아 다음 라운드로 상속되는 부분 |
| 경험 | 이전 상호작용에서 얻어 이후 수정을 이끄는 정보 |
| 대상 | 이번 라운드에서 직접 수정되는 객체 |
| 개선자 | 현재 상태와 경험을 후보 수정으로 바꾸는 장치 |
| 전략 | 개선자가 어디를 뒤지고 후보를 어떻게 만들지 정하는 방법 |
| 검증자 | 후보를 평가하고 수용 규칙을 적용하는 장치 |
| 후속자 | 수용된 개선을 물려받아 다음 라운드에 들어가는 AI 시스템 |
이 해부에서 세 가지 질문이 나오고, 서베이 전체가 이 질문을 반복한다. 루프는 어디에서 닫히는가. 무엇이 갱신되어 상속되는가. 어떤 결정이 바깥에 남아 있는가.
정의도 이 어휘 위에 세운다. RSI는 시스템이 과제와 환경, 다른 지능체와 계속 상호작용하면서 얻은 경험과 피드백을, 라운드를 넘어 지속되는 자기 변경으로 자율적으로 바꾸는 능력이다. 여기서 그치지 않는다. 그 변경이 이후의 자기 개선을 생성하고 평가하고 선택하고 통합하는 장치에까지 영향을 미칠 수 있어야 한다.
인접한 패러다임과의 경계도 같은 잣대로 긋는다.
| 특성 | 지속 학습 | AutoML | 에이전트 AI/ML | RSI |
|---|---|---|---|---|
| 라운드 간 학습 | 핵심 | 보조 | 보조 | 핵심 |
| 영속적 보존 | 핵심 | 보조 | 보조 | 핵심 |
| 시스템 자기 수정 | 핵심 | 보조 | 범위 밖 | 핵심 |
| 후보 제안 | 범위 밖 | 핵심 | 핵심 | 핵심 |
| 갱신 검증 | 보조 | 핵심 | 보조 | 핵심 |
| 후속자 재진입 | 핵심 | 범위 밖 | 범위 밖 | 핵심 |
| 장치 개정 | 범위 밖 | 보조 | 범위 밖 | 핵심 |
| 장치 재사용 | 범위 밖 | 범위 밖 | 보조 | 핵심 |
지속 학습은 무엇을 배울지와 어떻게 갱신할지를 설계자가 정해 둔 채로 돌아가고, AutoML은 탐색 공간과 목적함수와 평가자를 미리 받아 든다. 에이전트 시스템은 한 에피소드 안에서 하니스와 도구와 종료 규칙이 바뀌지 않은 채 일한다. 저자들이 던지는 질문은 AI가 AI 개발에 기여하는가에 있지 않다. 시스템 자신을 둘러싼 영속적 개선 루프가 만들어졌는지, 그 루프에 대한 권한이 얼마나 안쪽으로 들어왔는지를 묻는다.
책임이 안쪽으로 옮겨 가는 다섯 단계
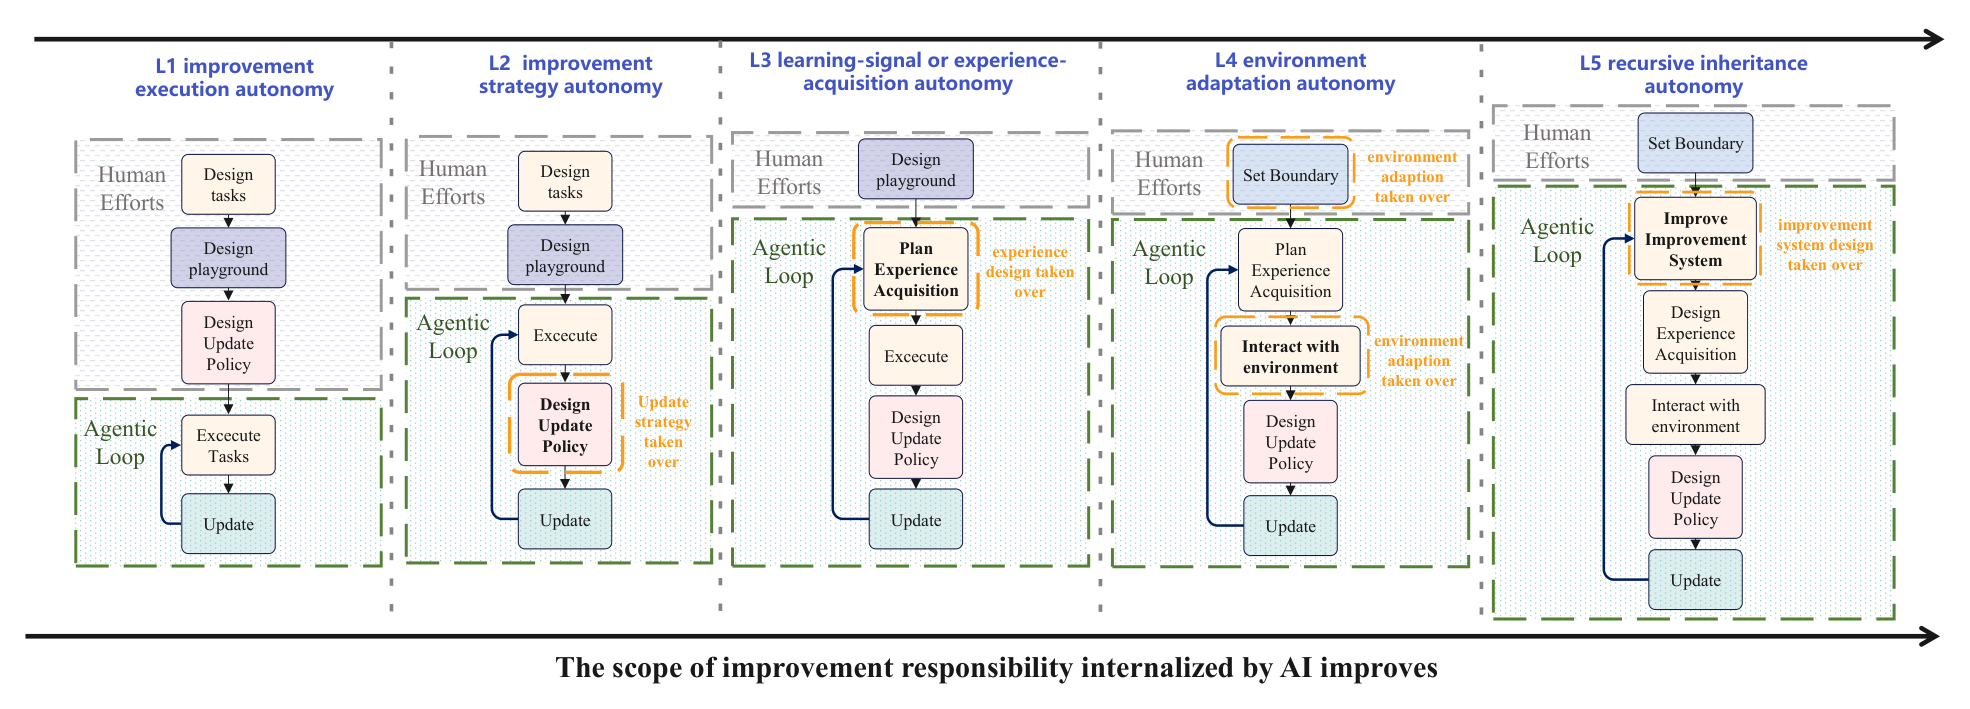
서베이의 본론은 여섯 단계짜리 사다리를 세우는 데 쓰인다. 무엇이 최적화되는가로 나누는 대신, 개선에 관한 어떤 결정이 AI 안쪽으로 들어왔는가로 나눈다.
| 단계 | AI가 새로 넘겨받는 결정 | 인간이 계속 쥐는 것 | 예시 |
|---|---|---|---|
| B0 | 없음. 현재 과제 안에서 출력만 고친다 | 개선 절차 전부 | Self-Refine, Reflexion, Tree of Thoughts |
| L1 | 정해진 개선 절차의 실행 | 목표, 갱신 절차, 수용 기준 | FineWeb-Edu, Phi-4-reasoning 데이터 선별 |
| L2 | 어떤 개입을 시도할지의 선택 | 목표, 과제 경계, 수용 기준 | GEPA, ADAS, AFlow, AutoKernel |
| L3 | 다음에 어떤 경험을 얻을지 | 과제 형식, 검증기, 갱신 규칙 | AZR, R-Zero, VOYAGER, SIMA 2 |
| L4 | 배포 경험의 무엇을 남길지 | 보호된 평가, 접근 경계, 릴리스 권한 | PANDO, ReasoningBank, ASPIRE |
| L5 | 개선을 만드는 장치 자체 | 전체 임무, 보호된 수용 기준, 자원 권한 | STOP, Gödel Agent, DGM, RQGM, A-Evolve-Training |
B0는 RSI가 아니다. 저자들이 명시한 판별 기준은 지속적 시스템 변화 없는 출력 변화다. Self-Refine이나 Reflexion처럼 현재 과제 안에서 답을 고쳐 나가는 방식은 과제가 끝나면 아무것도 남기지 못한다. 서베이는 APEX-EM의 표현을 빌려 이 상태를 이렇게 적는다. 똑같은 과제를 이미 한 번 풀었더라도 해법을 처음부터 다시 유도해야 한다.
B0와 L1은 지속성에서 갈린다. 수용된 변경이 현재 과제보다 오래 살아남아야 다음 칸으로 올라선다. L1에서 AI는 인간이 짜 둔 개선 절차를 대규모로 실행한다. FineWeb-Edu는 사람이 정한 교육적 품질 라벨을 웹 코퍼스 전체에 적용하지만 라벨링 기준 자체를 고르지는 못한다. 메타의 NCCL 디버깅 사례는 워치독 타임아웃의 근본 원인 분석을 의사결정 트리와 런북으로 증류해 두고 AI가 그것을 실행하게 만든 경우다.
L1에서 L2로 넘어가면 전략 선택이 옮겨 온다. 여기에는 Dropbox의 GEPA 사례가 놓인다. 파일 관련성을 판단하는 프롬프트를 다시 쓰게 한 경우다. ADAS는 에이전트를 파이썬 forward 함수로 정식화하고 메타 에이전트가 후보 아카이브를 채운다. AutoKernel은 프로파일링에서 출발해 영향이 가장 큰 연산을 찾고 Triton과 CUDA 후보 구현을 만든다. 정확성 검증과 실측 속도 향상을 통과한 구현만 받아들인다. 저자들은 이 단계에서 인간의 일이 개별 개선을 제안하는 쪽에서 개선 탐색을 제약하는 쪽으로 옮겨 간다고 정리한다.
L3를 가르는 기준은 학습자의 상태에 따라 다음 경험을 고르는가에 있다. 지금 학습자가 어디에서 막히는지에 대한 증거가 다음에 무엇을 배울지를 바꿔야 한다. AZR은 솔버 의존적 학습 가능성 보상으로 과제 제안을 이끌고 코드 실행기로 검증한다. R-Zero는 외부 정답 라벨 없이 여러 응답의 일관성으로 솔버의 불확실성을 잰다. SIMA 2는 고정 과제 실험만으로 과제 선택 자율성을 증명하지 못한다. 전체 자기 개선 설정에서는 Gemini 기반 태스크 세터가 하류 보상 모델의 평가를 보고 약한 스킬 쪽으로 연습을 몰아 준다. 이 단계에는 경험 오염이라는 위험이 따라붙는다. 결함 있는 경험이 학습자와 그다음 획득 결정을 동시에 왜곡한다.
L4는 배포에서 들어오는 피드백을 영속적 적응으로 바꾼다. PANDO는 웹 에이전트가 롤아웃마다 반복 실패를 막는 규칙과 파라미터화된 루틴을 뽑아내고, 확신도 점수로 규칙을 승인하거나 강등한다. 이 단계에서 저자들이 특히 강조하는 것은 갱신 능력과 활용 능력이 별개라는 관찰이다. 유용한 영속 갱신을 만들어 내는 능력은 기반 모델의 성능과 대체로 무관해서, 작은 모델의 갱신도 프런티어 모델에 견줄 만한 이득을 낸다. 반면 그 갱신을 실제 과제를 풀 때 활용하는 능력은 꾸준히 오르지 않고, 실패는 두 가지 모양으로 나타난다. 관련 아티팩트가 아예 검색되지 않거나, 검색되고도 충실히 따르지 않는다.
자기 자신을 고치는 장치를 고칠 때
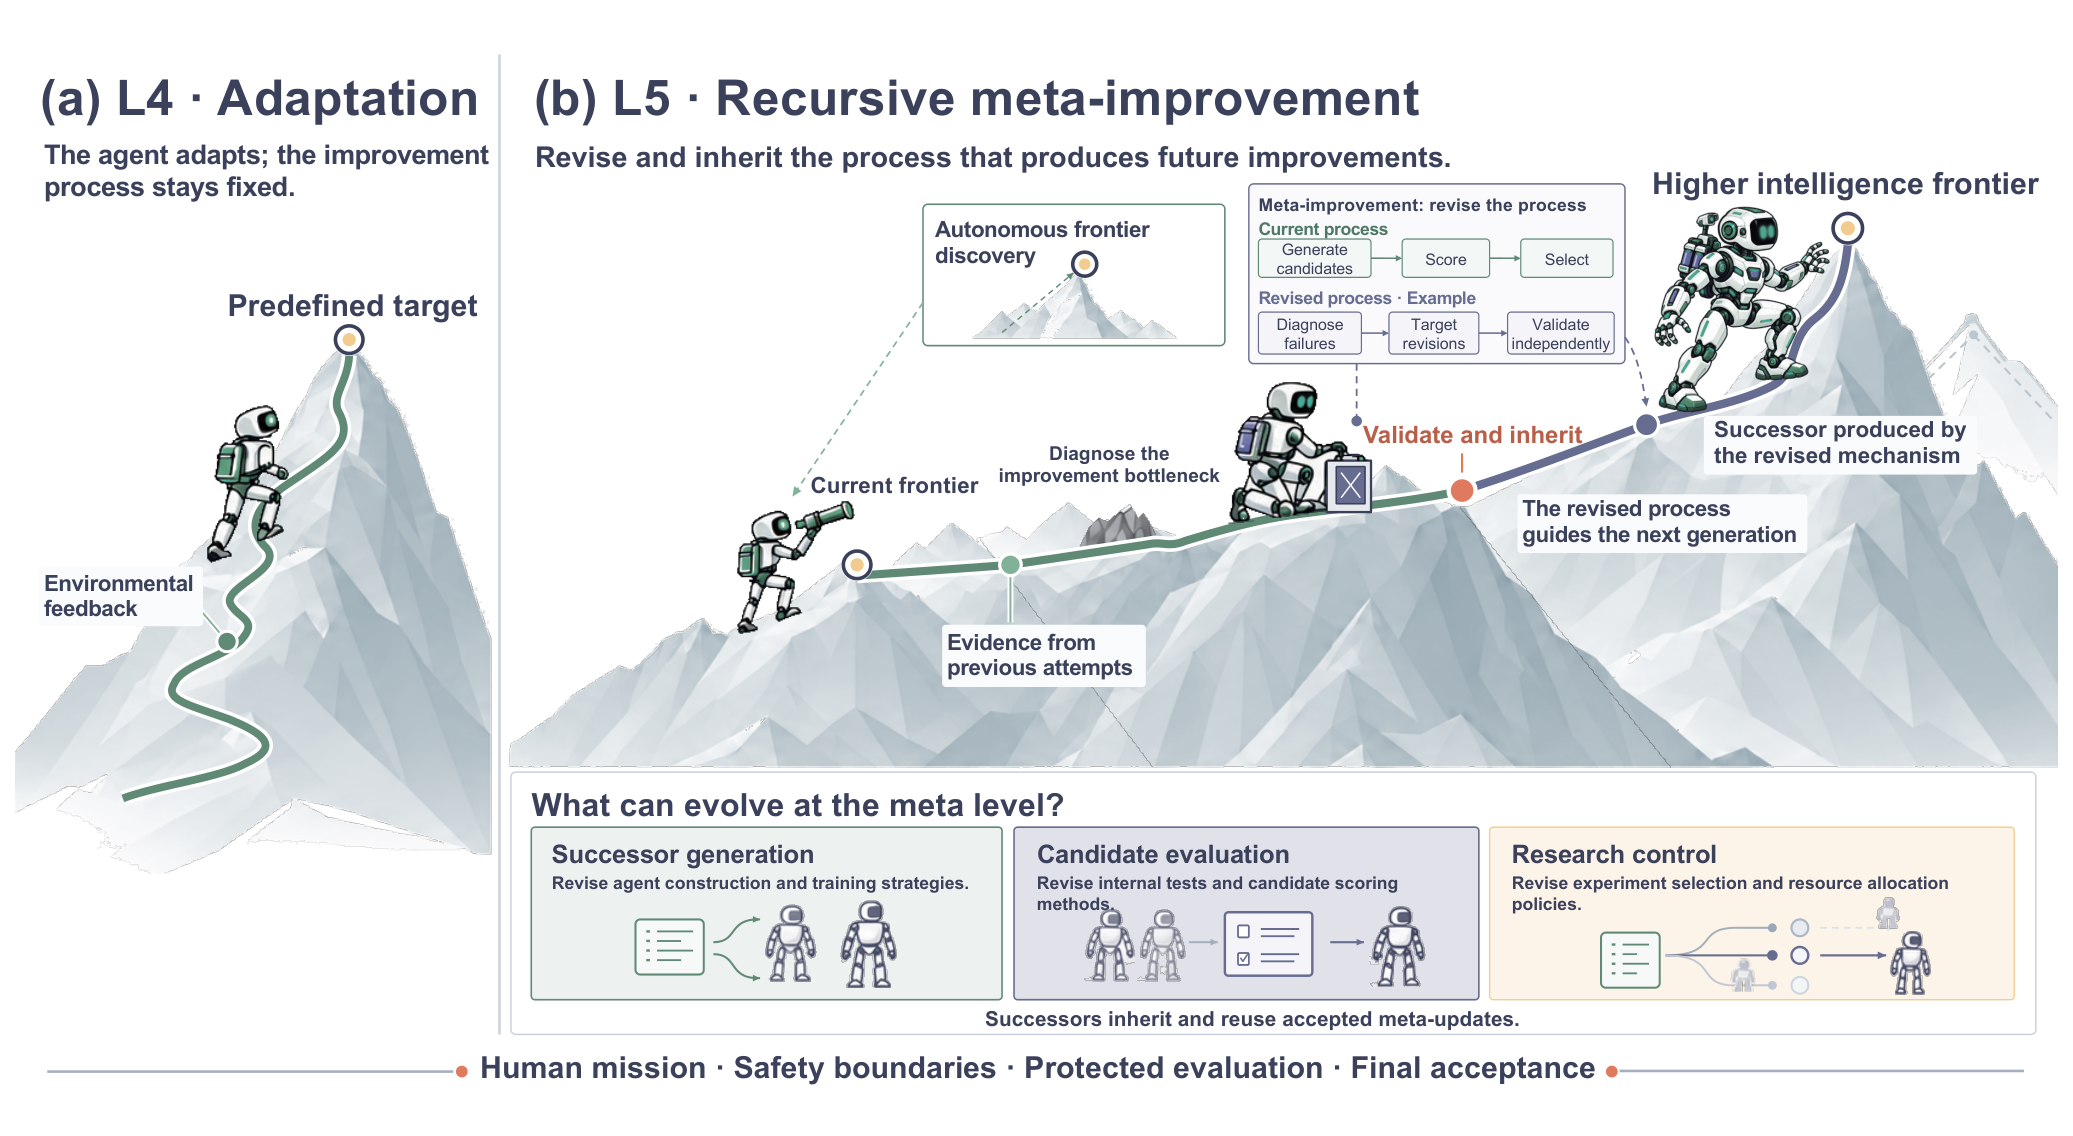
L5는 AI가 이후의 개선을 담당하는 장치를 지속적으로 고치고, 고쳐진 장치를 다음 라운드에 실제로 쓸 때 시작된다. 개선자, 후속자를 평가하는 장치, 탐색 정책, 연구 지휘 절차가 그 대상일 수 있다.
저자들은 여기에서 증거의 층위를 둘로 가른다.
이 조건들은 구조적 L5와 효과적 L5를 구분한다. 구조적 L5는 AI가 주도한 변경이 지속되어 이후 개선 라운드를 통제한다는 것을 보이고, 효과적 L5는 고쳐진 장치가 비교 가능한 예산과 독립적 평가 아래에서 더 나은 후속자를 만들거나 골라낸다는 것을 보인다.
과제 코드를 스스로 고쳤더라도 이후의 개정을 담당하는 절차가 그대로라면 증거로 부족하다. 거꾸로 과제 에이전트의 코드가 하나도 바뀌지 않았어도, 진화한 후속자 평가자는 구조적 L5를 성립시킨다.
이 잣대로 재면 대표 사례들의 성적표가 고르지 않다.
- STOP. 개선자가 고정된 언어모델을 호출하는 파이썬 프로그램이고, 자기 소스 코드를 최적화 대상으로 받는다. 선택된 4세대 개선자는 자기 개선 과정에서 빠져 있던 전이 과제 다섯 개 모두에서 초기 시드를 앞섰다. 그런데 약한 모델로 돌린 실행은 평균적으로 퇴보했다. 일부 생성 프로그램은 소프트 예산 한도를 우회하거나 평가 버그를 이용했다.
- Gödel Agent. 과제 정책과 재귀 갱신 논리를 모두 공유 파이썬 프로그램에서 노출한다. MGSM 최적화 시행 100건 가운데 14건이 초기 정책보다 낮은 성능으로 끝났다.
- Darwin Gödel Machine. 코딩 에이전트 변형 아카이브를 유지하며 후손을 탐색한다. 아카이브 관리와 부모 선택 규칙은 자기 수정 바깥에 남아 있다. 과제 점수가 올랐다는 것만으로 더 나은 개선 절차를 얻었다고 말할 수 없다는 사례로 인용된다.
- Red Queen Gödel Machine. 학습된 평가자는 한 에폭 안에서 동결한다. 정해 둔 시점마다 후보 평가자들을 독립적인 정답 앵커와 비교해 다음 에폭을 맡길 평가자를 고른다. 교체된 평가자에 기대어 매긴 점수는 폐기하고 다시 매긴다. 보류해 둔 Polyglot 코딩 과제에서 통과율 71.7%로 HGM-H의 69.9%를 앞섰고 탐색 토큰도 덜 썼다.
- A-Evolve-Training. 300억 매개변수(30B) 모델의 사후 훈련을 네 라운드에 걸쳐 자율로 돌렸다. 개발 점수는 오르는데 외부 이득이 따라오지 않자, 고쳐진 연구 정책이 워커들을 데이터 재균형과 체크포인트 선택 쪽으로 돌렸다. 최종 리더보드 점수는 0.86, 최고 인간 제출물은 0.87이었다. 라운드를 넘어 이월되는 것은 연구 정책과 발견 로그이며 워커 기반과 헌장은 고정이다.
효과적 L5 쪽에서는 부정적 결과가 나란히 보고된다. HyperAgents는 과제 에이전트와 메타 에이전트 코드를 모두 개정 대상으로 열어 두고 전이 증거를 얻었지만, 200회 반복짜리 긴 실험에서는 이월된 초기화의 최종 우위가 통계적으로 유의하게 확립되지 않았다. Weco의 AIDE 2는 100회 무감독 스텝 동안 일곱 건의 개선을 승인받았는데, 진화한 하니스를 바깥쪽 개선자로 설치한 별도 실험에서는 유의한 효율 우위를 찾지 못했다.
저자들은 사다리를 여섯 칸까지 세워 놓고 경고를 하나 붙인다. 자율성 단계가 높다고 개선 과정이 더 좋아지지는 않는다. 위임된 권한이 커지는 동안 비효율적 탐색, 신뢰할 수 없는 피드백, 퇴보, 평가자 악용, 나쁜 전이가 함께 자랄 수 있다. 따라서 AI가 내재화한 책임의 범위는 그 결과로 나온 개선의 품질과 따로 재야 한다.
같은 사다리를 네 영역에 세워 보면
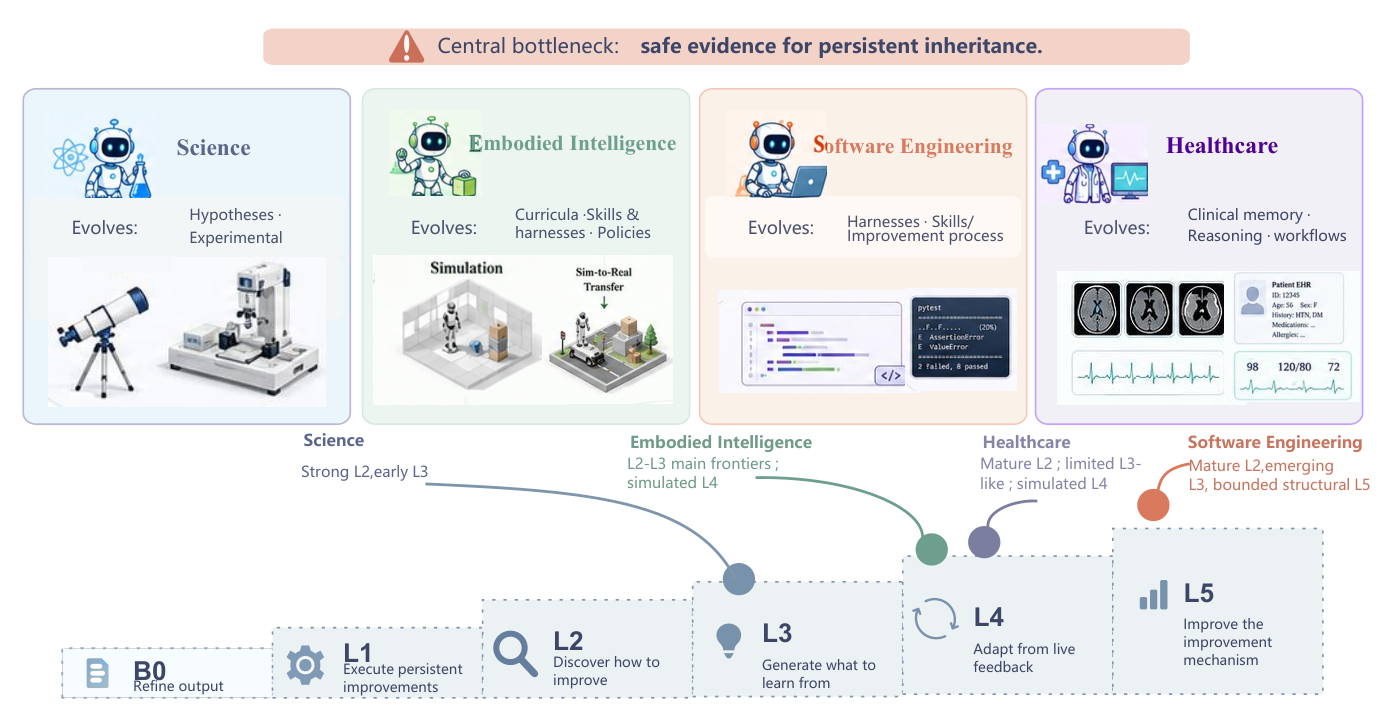
응용 편에서 저자들은 과학, 체화 지능, 소프트웨어 공학, 헬스케어 네 곳을 고른다. 개선을 검증하고 상속하는 데 필요한 피드백의 종류가 이 넷에서 뚜렷이 갈리기 때문이다.
과학에서는 실험이 비싸고 피드백이 드물게, 늦게, 그리고 범인을 지목하지 않은 채로 돌아온다. 실험이 실패했을 때 가설이 틀렸는지 프로토콜이 나빴는지 기기가 흔들렸는지 가려낼 수 없다. 그래서 이 영역은 L2에 머물러 있다. 증거로 인용되는 사례는 둘이다. DrugSAGE는 16개 과제에서 모은 경험으로 보류해 둔 17개 과제의 성능을 끌어올렸다. Test-Time Tool Evolution은 925개의 진화된 도구가 1,590개 과제를 떠받치는 SciEvo 벤치마크를 내놓았다. 저자들은 이것을 경계 지어진 가설 수준의 개선이라고 부르며 일반적인 장치를 얻은 것과 구분한다.
체화 지능에서는 경험이 내생적이다. 지금 정책이 어떤 상태를 보게 될지를 결정하므로, 개선에 쓸 증거 자체를 정책이 좌우한다. 물리적 시행은 되돌릴 수도 리셋할 수도 없다. 그런데 네 영역 가운데 L4가 실제로 나타난 유일한 곳이 여기다. 단, 주로 시뮬레이션 안에서다. ENPIRE는 코딩 에이전트가 로봇 정책과 훈련 절차와 지원 인프라를 함께 고치면서 경계 지어진 L5에 근접하는데, 환경 인터페이스와 평가자와 안전 제약은 여전히 바깥에서 지정된다.
소프트웨어 공학은 만들어지는 제품과 만드는 에이전트가 둘 다 실행 가능한 코드라는 점에서 특이하다. 버전 관리와 회귀 테스트와 롤백이 이미 갖춰져 있어서 자기 수정을 감사 가능한 절차로 만들기 쉽다. L2가 가장 단단히 자리 잡았고, 학습자 조건부 과제 생성이 이제 막 나오고 있으며, SICA와 DGM이 경계 지어진 L5의 성질을 보인다. Huxley-Gödel Machine은 현재 벤치마크 성능과 더 나은 후손을 낳는 능력이 다르다고 보고, 에이전트 계보에서 메타 생산성을 추정해 평가 예산을 배분한다. 정작 배포 환경에 적응하는 L4는 학계 쪽에서 거의 비어 있다.
헬스케어는 시행착오의 여지가 가장 좁다. 결과는 늦게 오고 교란되며, 한 기관에서 검증된 갱신이 다른 인구 집단으로 옮겨 간다는 보장이 없다. EvoClinician의 진단과 채점과 진화 루프처럼 L2 사례는 촘촘하지만, 실제 종단 결과로부터의 L4 적응과 임상 개선자 자체의 L5 진화는 사실상 비어 있다. 저자들은 이 영역에 통제된 능력 승인 절차를 요구한다. 모든 영속적 갱신은 임상적으로 검증되고 전향적으로 감시되어야 하며, 근거까지 추적할 수 있고 가정이 깨질 때 되돌릴 수 있어야 한다.
현장에서 이미 도는 루프들
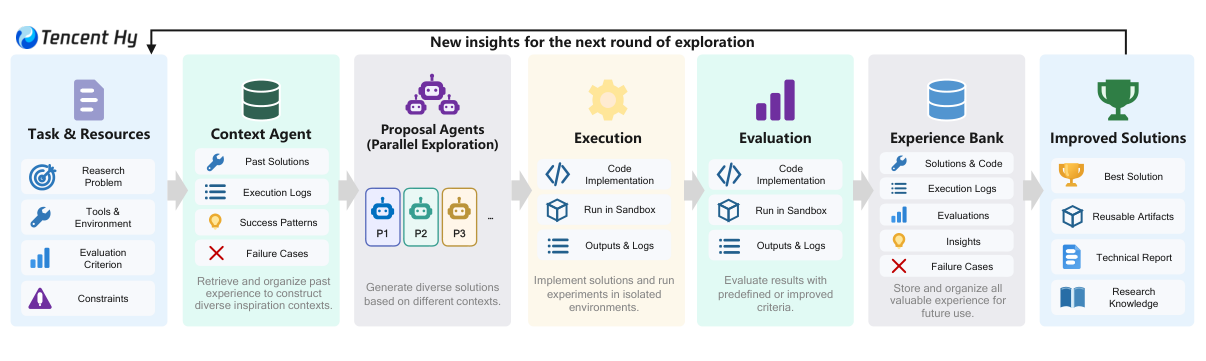
서베이가 산업 사례에 한 장을 통째로 내주는 데는 이유가 있다. 최전선의 개선 루프는 학술 논문에 먼저 기록되는 일이 드물고, 기술 보고서와 엔지니어링 블로그와 공개 저장소에 먼저 모습을 드러낸다. 여섯 곳의 사례가 실렸다.
Theseus는 환경과 데이터와 모델을 함께 진화시키는 네 단계 루프를 제안하고, 그 첫 칸에 해당하는 실험을 보고한다. Workspace-Bench에서 가져온 30개 과제를 1,280개 루브릭으로 채점했다. 잡음이 섞인 작업 공간에 견주어 깨끗한 작업 공간은 여덟 개 모델과 하니스 조합 전부에서 통과율을 21.7에서 51.6퍼센트포인트 올렸다. 모델과 하니스를 그대로 두고 환경만 재구성한 후속 연구에서는 다섯 조합이 18.65에서 39.67퍼센트포인트 올랐다.
Lark는 자기 개선에 앞서 데이터 기반이 먼저 필요하다는 쪽을 파고든다. 문서와 메시지와 회의록을 엔티티와 사건과 사람과 시간 관계로 잇는 기업 지식 그래프를 만든다. 그 그래프 기반 파이프라인으로 갈아탄 뒤 사람이 매긴 과제 유용성이 52%에서 65%로, 자동 평가 유용성이 47%에서 56%로 올랐다고 보고한다.
Humanlaya는 데이터 품질 보증 자체를 개선 대상으로 삼는다. 안쪽 루프는 지금 만드는 데이터를 고치고, 바깥 루프는 납품 뒤 모인 증거를 분석해 품질 관리 시스템의 프롬프트와 예시와 스킬에 버전이 붙은 수정을 제안한다. 세 장짜리 스캔 PDF를 추출 도구가 읽지 못한 사건이 대표 사례로 실렸다. 스캔 자체는 선명했다. 문제는 검사기가 추출 실패를 문서 품질 불량으로 뭉뚱그렸다는 데 있었다. 시스템은 둘을 가르는 판정 규칙과 예시를 새로 만들어 다음 버전에 넣었다. V0에서 V4까지 네 번 갱신한 뒤, 갱신에 쓰이지 않은 600개 과제 패키지로 비교했다. 자동 수리 후에도 핵심 결함이 남은 패키지 비율은 9.0%에서 3.7%로 내려갔다. 과제당 평균 사람 처리 시간도 48분에서 27분으로 줄었다.
ModelBest는 개방형 연구보다 엔지니어링이 먼저 자율화될 것이라고 보고 그쪽에 건다. 목표 모델과 하드웨어, 병렬화 요구를 입력으로 받아 빈 코드베이스에서 구현을 세우는 체계가 Forge Engineering이다. ForgeTrain은 빈 디렉터리에서 시작해 H100에서 여덟 시간 만에 Megatron-LM v0.15와 같은 수준에 닿았고 하루 반에서 이틀 반 사이에 그것을 넘어섰다고 보고한다. 같은 수준의 구현에 엔지니어 서너 명에서 다섯 명이 6개월에서 12개월을 들인다는 추산을 나란히 적어 두었다. 모델 FLOPs 활용률은 MiniCPM4-0.5B에서 40.1%에서 44.1%로, 8B 모델에서 47.0%에서 50.9%로 올랐다.
텐센트 훈위안의 Hyra는 정교한 워크플로를 설계해 넣는 대신 넓은 해 공간을 주고 실험 증거로 탐색을 이끈다. 이 설계의 중심에는 Experience Bank가 놓여 있다. 이전 해법 코드와 생성 산출물과 실행 로그와 점수와 평가자 피드백을 함께 보관해서, 뒤에 오는 제안이 앞선 시도의 패턴을 재사용하거나 피하도록 한다. 여기서 한 걸음 더 나가는 대목은 평가 자체를 고치는 부분이다. 초기 평가자가 불완전하거나 악용 가능해지면 쌓인 탐색 경험으로 평가 기준을 더 세밀하게 하거나 보상 해킹의 구멍을 막고 나서 탐색을 이어 간다. nanochat AutoResearch에서 검증 BPB 0.9015로 이전 최고 0.9109를, nanoGPT Speedrun에서 76.4초로 77.5초를, SOL-ExecBench에서 0.771로 0.754를 앞섰다.
Agent-Native Research Lab은 연구 결과를 물려주는 그릇 자체를 문제 삼는다. 사람이 읽도록 쓴 논문은 실패한 실험과 중간 증거와 실행 가능한 명세를 빼놓는다. 후속 세대 에이전트에게는 그 정보가 필요하다는 것이 이들의 문제의식이다. 이를 위해 형식적 과학 논리와 실행 가능한 코드, 성공하고 포기한 가지를 모두 담은 탐색 그래프, 원 증거를 함께 보존하는 산출물 형식을 제안한다. 선행 연구에 대한 질의응답 정확도가 통상적인 논문으로는 72.4%인데 이 형식으로는 93.7%였고, RE-Bench 재현 성공률은 57.4%에서 64.4%로 올랐다. 실리콘 설계에 적용한 사례에서는 Chip-Bench 레벨 3 CPU 최적화 점수로 5.8416을 보고한다. 같은 모델을 기반으로 한 표준 에이전트보다 2.7% 빠르고 면적은 21.5% 작으면서, 지정 테스트 97개와 무작위 차등 프로그램 350개를 모두 통과한 설계다.
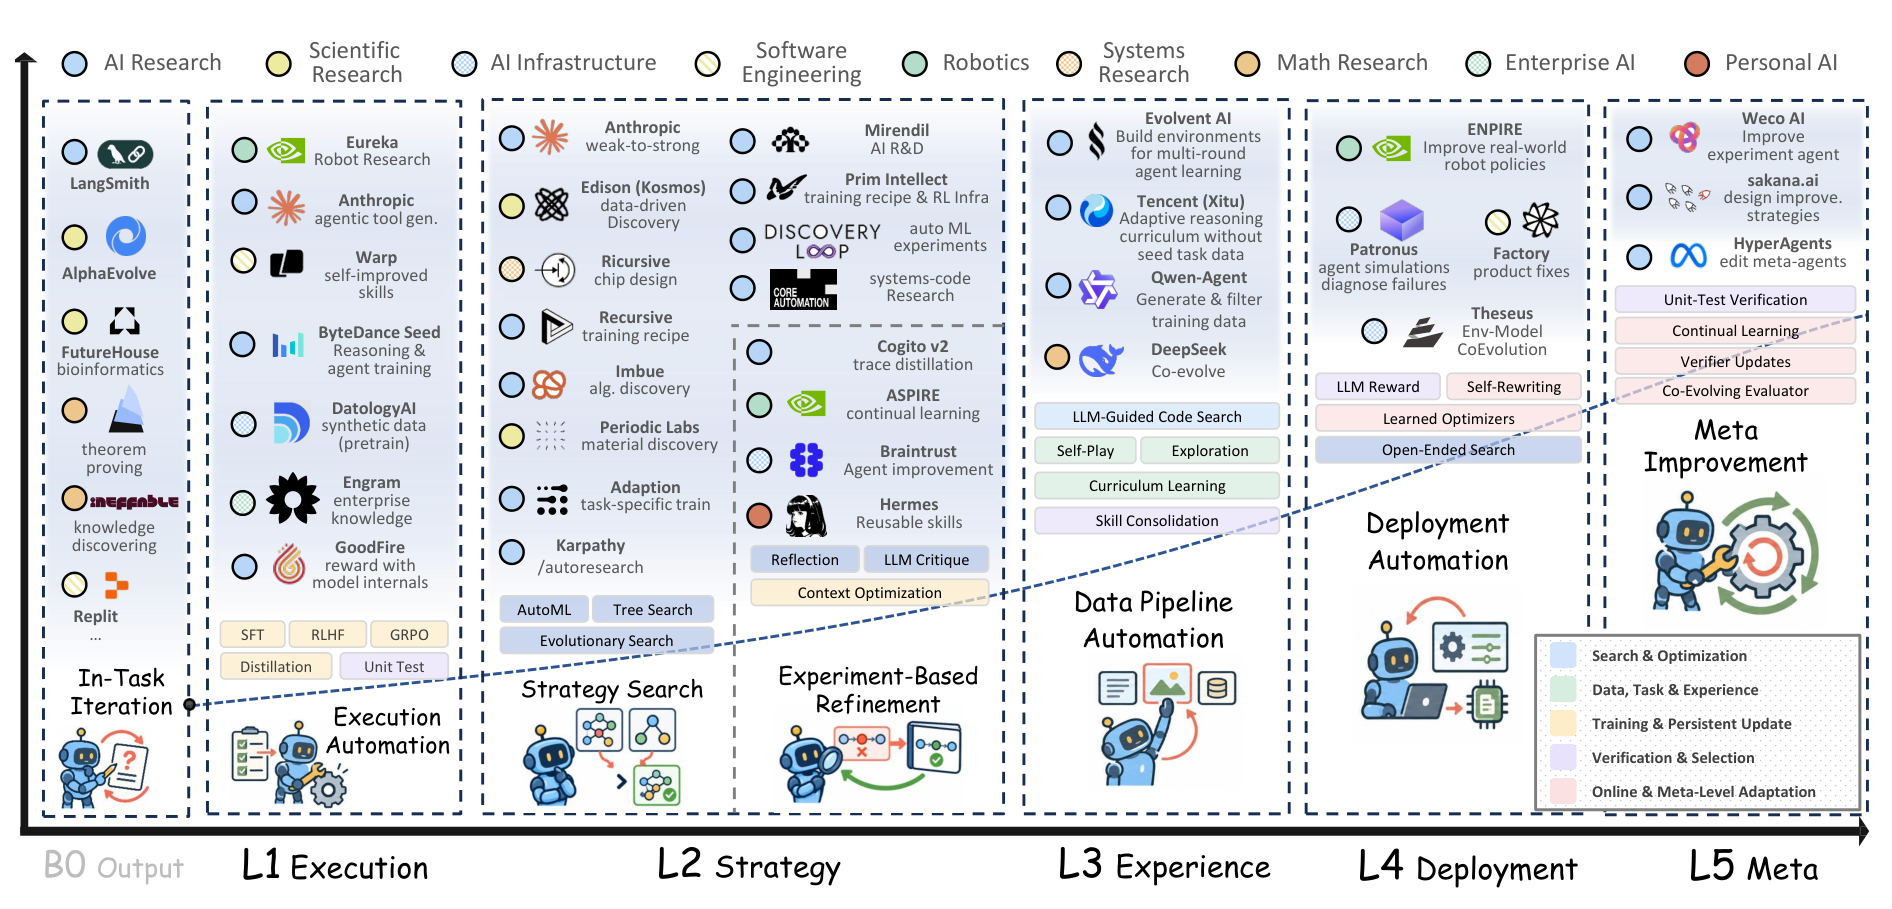
부록의 산업 지형표는 기업 72곳을 다룬다. 2026년 9월 공개 자료 기준이고, 회사가 스스로 그 라벨을 쓴다는 뜻은 아니라는 단서가 붙어 있다. 이 표에서 눈에 남는 것은 L5 칸이다. Anthropic의 로드맵은 목표로, Meta의 HyperAgents와 Sakana의 Darwin Gödel Machine과 Weco의 AIDE 2는 후보로 적혀 있다. 단서 없이 확정된 L5는 표 전체에 없다. 단서 없이 L4가 붙은 상용 사례는 프로덕션 코딩 에이전트인 Factory의 Signals 하나뿐이다.
여덟 개의 방향
마지막 장에서 저자들은 여덟 개의 연구 방향을 꺼내 놓는다. 그 가운데 진단 문제가 첫머리에 온다. L1에서 L2로 넘어가는 순간, 관측된 실패가 어느 부품을 고쳐야 하는지 알려 주지 않는다는 문제가 드러난다. 틀린 답의 원인은 결함 있는 원본 데이터일 수도 있고, 빠진 맥락이나 도구 인터페이스, 모델, 평가자일 수도 있다. 앞서 나온 Humanlaya의 스캔 PDF 사건이 이 애매함의 구체적 형태다. 여러 부품이 함께 적응하는 동안 하나를 바꾸면 다른 부품이 기대던 전제가 무너지기도 한다.
영속 상태 관리 쪽에서는 Library Drift 연구가 인용된다. 스킬 라이브러리를 계속 불려 나가면 검색 품질부터 떨어진다. 과제 점수에 그 효과가 드러나기도 전에 진전이 멈춘다. 그렇다고 스킬을 너무 공격적으로 은퇴시키면 라이브러리를 방치하는 것보다 나쁜 결과가 나온다.
L5의 검증에는 결합 문제가 걸려 있다. 더 강한 해결자는 자기 평가자의 약점을 드러내지만, 그 평가자를 바꾸면 라운드 사이의 점수를 견줄 수 없게 되거나 악용을 부추긴다. RQGM이 에폭 안에서 평가자를 얼려 두고 교체본을 독립 앵커에 견주는 방식으로 이 문제의 일부를 다룬다.
그리고 장기 평가가 남는다. 구조적 증거는 고쳐진 장치가 상속되어 호출된다는 점까지 보여 준다. 효과적 증거는 그 장치가 더 나은 후속 개선을 만들어 내는지까지 보여야 한다. 저자들은 이 부분이 실증 연구로는 비어 있다고 말한다. 앞으로의 벤치마크는 원래 장치와 고쳐진 장치를 같은 출발 시스템과 같은 총예산 아래에서 비교해야 하고, 그 예산에는 장치를 개발하고 평가하는 비용까지 들어가야 한다는 것이 이들의 요구다.
가장 눈여겨본 것
제목과 본문의 온도가 이만큼 다른 논문을 오랜만에 보았다. 「인간이 만드는 마지막 AI」라는 제목이 붙어 있고, 지금까지 AI가 이룬 모든 것은 바다에 떨어진 물 한 방울이라는 TL;DR이 첫 장에 놓여 있다. 그 둘을 지나 75쪽을 따라가다 보면, 정작 남는 문장은 대부분 무엇이 아직 확립되지 않았는가에 관한 것이다. 4세대 개선자가 전이 과제 다섯 개를 통과했다는 보고 옆에 약한 모델은 평균적으로 퇴보했다는 문장이 붙어 있고, 통계적으로 유의한 우위를 얻지 못했다는 보고가 두 번 나온다. 기업 72곳을 늘어놓은 표에서 L5 칸은 전부 후보이거나 목표다.
그러면서도 저자들은 자율성 사다리를 여섯 칸이나 세워 두었다. 이 조합이 이 논문의 성격을 만든다. 도착지를 그리는 문서라기보다 도착 여부를 판정할 잣대를 만드는 문서에 가깝다. 그 잣대의 눈금은 성능이 아니다. 고친 것이 남는가, 남은 것이 다음 라운드를 통제하는가, 통제한 결과가 같은 예산 아래에서 더 나은가. 세 번째 눈금을 통과한 사례가 아직 하나도 없다는 것이 이 서베이가 정직하게 내놓은 현재 위치다.
한 가지가 계속 마음에 남는다. 개선자를 고치는 순간 그것을 판정할 자도 함께 흔들린다는 문제다. RQGM은 평가자를 에폭 안에서 얼려 두고 교체본을 독립 앵커에 대어 보는 방식으로 이 문제를 다뤘다. 그러려면 흔들리지 않는 앵커가 바깥에 하나는 있어야 한다. 그 앵커를 누가 유지하는가. 이 사다리의 꼭대기에서도 사람이 남아 있어야 하는 자리가 거기일 것이다.
출처
Yi Duan 외 32인, 상하이교통대학교와 Theseus Labs, 칭화대학교, ByteDance, ModelBest, 샤오훙수, Humanlaya, Agent-Native Research Lab, 상하이 AI Lab. 2026년 9월 10일 arXiv 제출 (arXiv:2609.11873v1, cs.LG). 75쪽, 참고문헌 217건.
원문: https://arxiv.org/abs/2609.11873 alphaXiv: https://www.alphaxiv.org/abs/2609.11873 프로젝트 페이지: https://theseus-labs-rsi.github.io/
본문 도해는 모두 원문 논문(arXiv:2609.11873v1)에서 인용했다.