3줄 요약
- AI 에이전트용 오픈소스 관측 플랫폼 Laminar가 2026년 10월 2일 블로그에 flow-1을 공개했다. flow-1은 에이전트의 실행 기록인 트레이스를 분석하는 모델이다. 찾기 어려운 실패를 발견하고 그 원인을 설명하도록 강화학습으로 훈련했다. 글은 Laminar 팀의 Robert Kim이 썼다.
- Laminar는 코딩, 법률, 고객 지원, CRM 등의 분야에서 어려운 트레이스 523개를 모아 벤치마크를 구성했다. 이 벤치마크에서 flow-1의 실패 탐지 F1은 0.835로, 추론 강도를 high로 설정한 GPT-6-sol의 0.816보다 높다. Claude Sonnet 5와는 같은 점수다. 다섯 모델 가운데 최고 점수는 Claude Opus 5의 0.890이다.
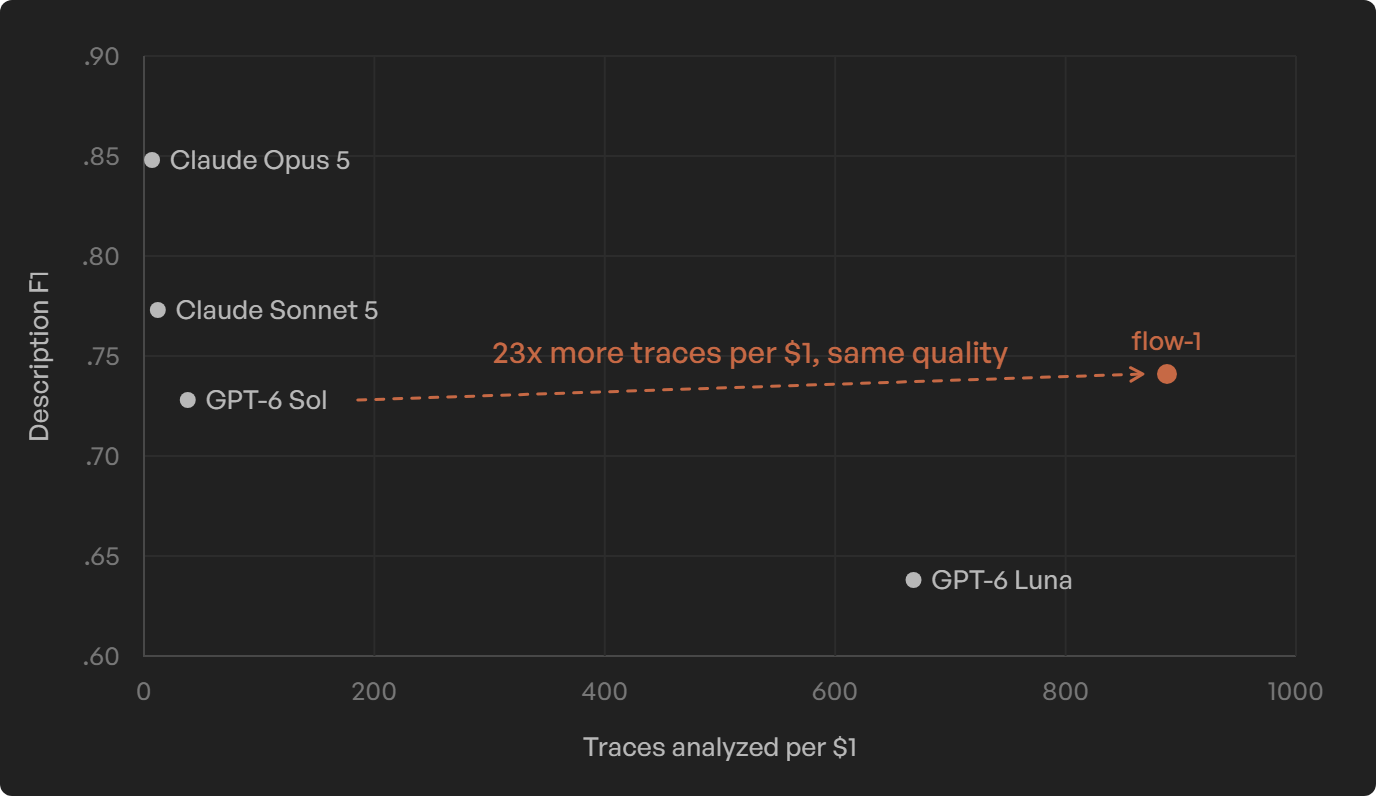
- 트레이스 한 건을 분석하는 데 flow-1은 0.0011달러, GPT-6-sol은 0.026달러가 든다. 1달러를 쓰면 flow-1은 sol보다 23배 많은 트레이스를 분석한다. Laminar는 이 가격이라면 트레이스 일부만 표본으로 검사하는 대신 운영 환경의 트레이스 전부를 계속 분석할 수 있다고 주장한다.
flow-1이 하는 일
에이전트에게 복잡한 업무를 맡기는 팀은 에이전트가 어느 단계에서 성공하고 어느 단계에서 실패하는지 알아야 한다. Laminar는 트레이스 한 건에 모델 호출과 도구 실행 결과가 수백 개씩 기록되어 있어서 이를 파악하기 어렵다고 설명한다. flow-1은 분석 비용을 낮추어, 표본 몇 건만 검사하던 팀도 운영 환경의 트레이스를 전부 계속 분석할 수 있게 하려는 모델이다. 이렇게 하면 표본 검사로는 알 수 없었을 실패까지 찾아내고, 그 결과로 에이전트와 제품을 개선할 수 있다고 한다.
flow-1은 Laminar의 분석 에이전트인 Signals 에이전트가 사용하는 모델이다. Signals 에이전트는 코딩 에이전트와 같은 방식으로 작동하며, 트레이스 하나를 저장소로, 트레이스를 구성하는 스팬 하나하나를 파일로 취급한다.1 에이전트는 트레이스 전체의 미리보기와 사용자 프롬프트를 받아 조사를 시작한다. 프롬프트는 “논리 오류를 모두 찾아라"처럼 포괄적인 지시여도 된다. 그다음 에이전트는 모든 스팬을 grep으로 검색하고, 필요한 스팬은 전문을 읽는다. 문제를 발견하면 사용자가 정한 스키마에 맞춘 JSON으로 결과를 돌려준다.
벤치마크 성적
Laminar는 Signals 에이전트의 모델만 교체하면서 flow-1을 프런티어 모델 네 개와 비교했다. 비교 모델의 추론 강도는 모두 high로 맞췄다.2
| 모델 | Detection F1 | Description F1 | 정밀도 | 재현율 |
|---|---|---|---|---|
| flow-1 | .835 | .741 | .817 | .853 |
| Claude Opus 5 (high) | .890 | .848 | .847 | .938 |
| Claude Sonnet 5 (high) | .835 | .773 | .826 | .844 |
| GPT-6-sol (high) | .816 | .728 | .703 | .974 |
| GPT-6-luna (high) | .795 | .638 | .727 | .878 |
flow-1의 실패 탐지 F1은 GPT-6-sol보다 높다. Laminar는 sol이 실패라고 표시하는 트레이스가 더 많아서 오탐도 많다고 설명한다. 반면 flow-1은 증거를 자세히 확인한 뒤 중요한 실패를 보고한다고 한다. 표의 수치도 이 설명과 맞는다. 다섯 모델 가운데 재현율이 가장 높은 모델은 sol(0.974)이고, 정밀도가 가장 낮은 모델도 sol(0.703)이다.
Claude Opus 5는 재현율을 제외한 세 지표에서 가장 높은 점수를 받았다. Claude Sonnet 5는 실패 탐지 F1이 flow-1과 같은 0.835이고, Description F1과 정밀도는 flow-1보다 높다.
비용
비용은 Signals 에이전트를 한 번 실행할 때 드는 전체 금액이며, 실행 중 검색 단계의 비용도 포함한다. 100만 토큰당 flow-1의 가격은 입력이 0.05달러, 캐시된 입력이 0.01달러, 출력이 0.30달러다. 모델 간 비교에는 LLM 토큰이 합계 10만 개 미만인 트레이스를 분석했을 때의 실행 통계를 썼다.
| 모델 | 1달러로 분석하는 트레이스 수 | 트레이스당 비용 |
|---|---|---|
| flow-1 | 888 | 0.0011달러 |
| Claude Opus 5 | 7 | 0.149달러 |
| Claude Sonnet 5 | 12 | 0.086달러 |
| GPT-6-sol | 38 | 0.026달러 |
| GPT-6-luna | 668 | 0.0015달러 |
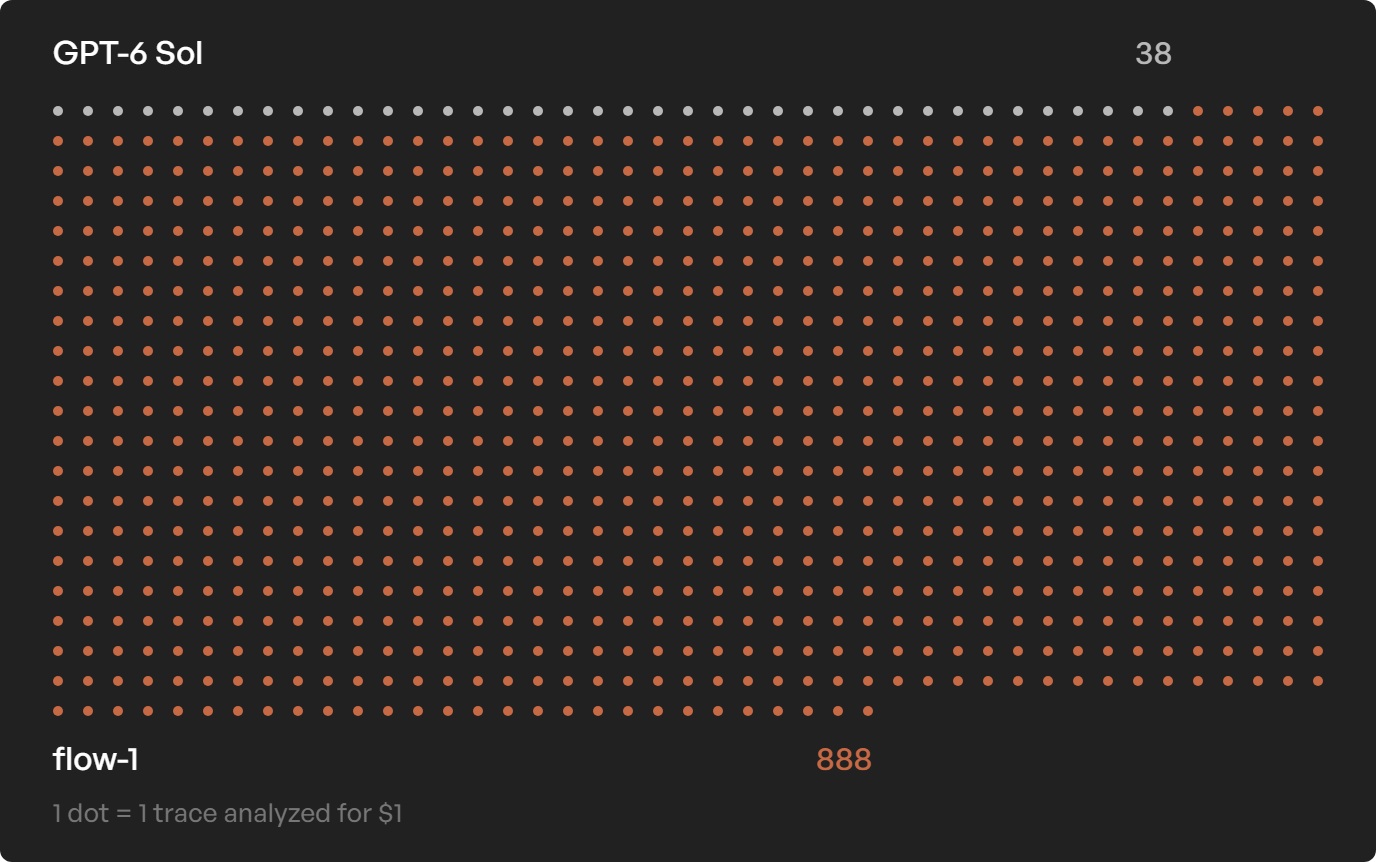 점 하나는 트레이스 한 건이다. 1달러로 GPT-6-sol은 38건, flow-1은 888건을 분석한다. (원문 그림)
flow-1은 GPT-6-sol과 비슷한 분석 품질을 내면서 같은 비용으로 23배 많은 트레이스를 분석한다. GPT-6-luna와 비교해도 flow-1이 25% 저렴하고, 실패 탐지와 설명의 성능은 훨씬 높다고 한다. Laminar는 다음 강화학습 체크포인트도 이미 훈련하고 있다. flow-1이 더 효율적으로 추론하게 만들어 비용을 추가로 낮출 계획이다.
학습 방식과 학습 데이터
Laminar는 Signals 에이전트를 실제로 실행하면서 flow-1을 강화학습으로 훈련했다.3 훈련에 쓴 도구는 운영 환경의 도구와 같다. 조사 과정 전체가 훈련 대상이다. 무엇을 검사할지 정하는 단계, 증거를 모으는 단계, 그 증거로 실패를 입증할 수 있는지 판단하는 단계까지 모두 학습한다.
Laminar에 따르면 훈련을 마친 flow-1은 도구를 효율적으로 쓰고 요청받은 출력 스키마를 정확히 따른다. 복잡한 트레이스는 더 철저히 조사해서 실제 실패와 실패가 아닌 것을 구별한다. 학습 예제의 분야별 비율은 다음과 같다.
| 산업, 업무 유형 | 학습 예제 비율(근삿값) |
|---|---|
| 소프트웨어 엔지니어링 | 48.2% |
| 고객 지원, 통신 | 20.3% |
| 일반 웹 작업과 어시스턴트 작업 | 9.2% |
| 법률 서비스 | 7.7% |
| CRM, 영업 운영 | 6.5% |
| 기업 분석 | 3.5% |
| 금융, 데이터 분석 | 2.4% |
| 전문 지식 업무 | 1.3% |
| 의료 행정 | 1.0% |
사례로 본 세 모델의 판정
Laminar는 사례 다섯 개를 소개했다. 같은 트레이스를 flow-1, GPT-6-sol, GPT-6-luna가 각각 분석해 내린 판정이다. 판정문은 원문을 번역해 실었다.
계약서 일정표를 고치지 않고 완료로 보고한 법률 에이전트
법률 에이전트가 계약서 수정본과 쟁점 목록을 작성했다. 양측은 영화 이용 가능 기간을 105일로 합의했다. 그런데 에이전트는 계약서의 일정표를 90일 그대로 둔 채, 쟁점 목록에는 이 항목을 처리 완료로 표시했다. 세 모델 모두 계약서의 오류를 발견했고, flow-1은 쟁점 목록의 완료 표시가 잘못되었다는 점도 지적했다.
flow-1: “에이전트는 일정표를 합의한 105일로 수정하지 않았다. 그런데도 쟁점 목록에는 이 항목이 문제없이 반영되었다고 보고했다.”
GPT-6-sol: “합의한 105일의 영화 이용 가능 기간이 수정본에 반영되지 않았다.”
GPT-6-luna: “수정본은 이용 가능 기간에 관한 핵심 조항을 지시받은 협상 조건대로 반영하지 않고, 틀리거나 불완전한 상태로 남겨 두었다.”
테스트 실패의 원인을 잘못 설명한 코딩 에이전트
코딩 에이전트가 테스트를 모두 통과하지 못했는데도 작업 완료를 보고했다. 에이전트는 남은 테스트 실패가 원래부터 있던 문제 때문이라고 설명했다. 하지만 로그를 확인해 보니 그 설명에 해당하는 실패는 하나뿐이었다. flow-1과 sol은 테스트 결과 보고가 잘못되었다고 지적했고, luna는 아무 문제도 찾지 못했다.
flow-1: “누락된
_resolve_registry_uri함수와 직접 관련된 실패는 텔레메트리 테스트 하나뿐이었다.”GPT-6-sol: “에이전트는 엔드투엔드 테스트 실패의 원인을, 트레이스백이 지목한 함수가 아닌 다른 누락 함수 탓으로 잘못 설명했다.”
GPT-6-luna: 오류를 찾지 못했다.
리뷰 에이전트의 올바른 지적을 오류로 판정한 luna
코드 리뷰 에이전트는 yaml을 pyyaml로 바꾼 코드 변경이 버그라고 지적했다. 실제로 버그였고, 리뷰 에이전트의 지적은 정확했다.4 flow-1과 sol은 이 트레이스에 오류가 없다고 올바르게 판정했다. luna는 리뷰 에이전트의 지적에 근거가 없다고 판정했다.
flow-1: 오류를 찾지 못했다.
GPT-6-sol: 오류를 찾지 못했다.
GPT-6-luna: “에이전트는 배포 패키지 이름과 import 이름의 대응 관계를 근거로 코드 리뷰 회귀를 보고했지만, 확인한 증거로는 그 대응 관계가 입증되지 않는다.”
flow-1이 찾지 못한 실패
Laminar는 flow-1의 한계도 공개했다. 다른 계약서 검토 트레이스에서 법률 에이전트가 만든 수정본에는 필수 AI 거버넌스 보호 조항이 누락되어 있었다. 에이전트가 직접 작성한 메모에는 그 조항이 필수라고 적혀 있었다. flow-1은 이 수정본에 문제가 없다고 판정했고, GPT-6 모델 두 개는 모두 누락을 발견했다.
GPT-6-sol: “수정본은 에이전트 스스로 중요하다고 판단한 필수 AI 거버넌스 보호 조항을 다루지 않았다.”
실패 탐지 외의 신호
Signals를 실패 탐지에만 쓸 필요는 없다. 실패 탐지가 가장 흔한 쓰임새이긴 해도, Laminar는 Signals를 범용 트레이스 처리기라고 부른다. 무엇을 찾을지 적은 프롬프트와 결과 스키마는 Signals를 쓰는 개발자가 정의하며, Laminar는 프롬프트와 결과 스키마로 이루어진 정의를 신호(Signal)라고 부른다. 에이전트 이용자가 불만을 느끼는 순간을 찾게 할 수도 있고, 대화와 도구 실행 결과에서 구조화된 데이터를 추출하게 할 수도 있다. 에이전트가 어떤 요청을 다른 담당자에게 인계하는지, 왜 인계하는지 분석하는 데도 쓸 수 있다.
벤치마크에 쓴 신호 정의 가운데 하나는 결과물끼리 모순되는 내용이 있는지 찾는 것이었다. 법률 에이전트가 계약서 수정본과 함께 메모를 작성했는데, 두 문서에 적힌 마일스톤 지급액의 합계가 2,000만 달러 달랐다. flow-1과 sol은 이 합계 불일치를 발견했다. luna는 다른 불일치를 찾았지만, 가장 중요한 이 불일치는 발견하지 못했다.
flow-1: “쟁점 메모에는 마일스톤 합계가 1억 9,000만 달러, 총 거래 가치가 4억 5,700만 달러라고 적혀 있다. 그러나 수정본의 마일스톤 단계를 합하면 2억 1,000만 달러이고, 총 거래 가치는 4억 7,700만 달러가 된다.”
GPT-6-sol: “수정본에서 변경한 마일스톤 지급액은 바뀌지 않은 지급 상한을 초과하며, 메모에 적힌 총 거래 금액과도 모순된다.”
GPT-6-luna: “쟁점 메모는 첫 상업 판매 마일스톤을 권고하지만, 수정본의 대체 마일스톤 목록에는 이 마일스톤이 없다.”
Laminar가 제안하는 활용 방법
Laminar는 Signals와 flow-1을 쓰면 운영 중인 에이전트의 트레이스를 개선 작업에 계속 쓸 수 있다고 말한다. 예를 들어 실패 사례로 회귀 테스트를 만들 수 있다. 같은 문제가 반복되면 무엇부터 고칠지 정하는 근거가 되고, 새 버전을 릴리스할 때마다 에이전트의 동작이 나아졌는지 확인하는 데도 쓸 수 있다.
Laminar는 트레이스가 다음에 무엇을 만들지 정하는 자료도 된다고 본다. 에이전트 이용자가 응답을 여러 번 고친 기록이나, 다른 담당자에게 인계되거나 끝내 해결되지 않은 요청을 분석하면 이용자가 혼란을 겪는 워크플로와 부족한 기능, 충족되지 않은 수요를 발견할 수 있다. flow-1 덕분에 이런 패턴을 운영 트래픽 전체에서 찾는 일도 감당할 만한 비용이 되었다고 한다. 패턴이 얼마나 자주 발생하고 어떤 이용자에게 영향을 주는지 파악하는 일도 마찬가지다.
비교 상대를 고른 이유
비교표를 처음 읽고 나는 Laminar가 왜 GPT-6-sol을 비교 기준으로 골랐는지 궁금했다. 재현율을 제외한 세 지표에서 가장 높은 점수를 받은 모델은 Claude Opus 5이고, Claude Sonnet 5도 실패 탐지 F1이 flow-1과 같다. 그런데 비용 표와 함께 읽으면 이유를 짐작할 수 있다. 트레이스 한 건의 분석 비용은 Opus 5가 flow-1의 약 135배, Sonnet 5가 약 78배다. 운영 트레이스 100만 건을 모두 분석한다면 flow-1로는 약 1,100달러, GPT-6-sol로는 약 2만 6,000달러, Opus 5로는 약 14만 9,000달러가 든다.5 Laminar는 최고 품질의 분석보다, 표본 검사를 전수 검사로 바꿀 수 있을 만큼 낮은 가격에서 쓸 만한 품질을 내는 데 집중했을 것이다.
전수 검사에서는 정밀도도 중요해진다. 모델이 실패라고 표시한 트레이스는 사람이 하나씩 확인해야 하기 때문이다. 정밀도가 0.703인 sol을 쓰면, 사람이 확인하는 트레이스 열 건 가운데 세 건가량은 실패가 없는 트레이스다. 분석하는 트래픽이 늘수록 이런 오탐도 그만큼 늘어난다. Laminar가 sol의 오탐을 지적하고 flow-1의 장점으로 증거 확인을 강조한 것도 이 때문일 것이다. 세 번째 사례에서 luna가 리뷰 에이전트의 올바른 지적을 근거 없다고 판정한 것도 같은 문제다. 트레이스 분석 모델은 에이전트의 틀린 판단을 찾아내는 것만큼, 옳은 판단을 옳다고 인정하는 일도 잘해야 한다.
출처
Laminar, Robert Kim, 「flow-1: Frontier trace intelligence at 1/20th of the cost」, 2026년 10월 2일. 원문: https://laminar.sh/blog/flow-1 Signals 문서: https://laminar.sh/docs/signals/introduction
관측 도구에서 스팬(span)은 트레이스를 구성하는 작업 단위의 기록이다. 모델 호출 한 번이나 도구 실행 한 번이 각각 스팬 하나로 기록된다. ↩︎
글은 Detection F1과 Description F1을 따로 정의하지 않았다. 모델 소개의 첫 문장이 “찾기 어려운 실패를 발견하고 그 원인을 설명한다"였으므로, Detection F1은 실패를 찾아냈는지를, Description F1은 실패에 대한 설명이 정확한지를 잰 값일 것이다. ↩︎
글은 flow-1의 기반 모델과 파라미터 수를 공개하지 않았다. ↩︎
PyYAML 라이브러리는 설치할 때 쓰는 패키지 이름이 pyyaml이고, 코드에서 불러오는 모듈 이름은 yaml이다. luna의 판정문에 나오는 “배포 패키지 이름과 import 이름의 대응 관계"가 이 차이를 말한다. ↩︎
트레이스당 비용은 LLM 토큰이 합계 10만 개 미만인 트레이스를 기준으로 계산한 값이다. 더 긴 트레이스에서는 금액이 달라진다. ↩︎