3줄 요약
- 카네기멜런대(CMU) 연구진이 2026년 9월 22일 arXiv에 공개한 논문이다. 연구진은 판정 근거를 쓰지 않고 판정과 레이블별 확률만 반환하는 TypeSafe의 JEV 1.13을 LLM 판정자로 쓰고, 생성형 LLM 판정자와 보상 모델 16종과 비교했다. 연구 질문은 JEV가 저렴한 1차 판정을 맡으면서, 더 강한 판정자가 필요한 문항을 스스로 식별할 수 있는가였다.
- JEV의 정확도가 가장 강한 비교 대상인 GPT-6 Astra와 비슷했던 작업은 일반적인 선호 판정과, 근거 문서를 기준으로 한 사실성 판정이었다. 두 작업에서 정확도 차이는 3%포인트 이내였고, JEV는 GPT-6이 쓴 비용의 0.36%만 썼다. 그러나 풀이 과정을 검증해야 하는 JudgeBench에서는 JEV가 14.6%포인트 뒤처졌고, 오답이 더 공들여 쓰인 RM-Bench 문항에서는 19.8%포인트 뒤처졌다.
- JEV의 오답은 확신도가 낮은 판정에 집중됐다. 연구진은 확신도가 높으면 JEV 판정을 채택하고 낮으면 GPT-6에 다시 판정을 맡기는 캐스케이드 정책을 미리 정해 두고 시험했다. 이 캐스케이드는 92.5%의 정확도로 GPT-6 단독 정확도(93.1%)의 99%를 유지하면서, 비용은 GPT-6만 쓸 때의 57%로 줄였다. 연구진은 확신도 기준값을 작업 종류마다 따로 검증해야 한다고 결론지었다.
판정만 반환하는 판정자
벤치마크를 채점하거나 여러 응답 가운데 하나를 고를 때, 또 학습 데이터를 평가할 때 많은 개발자가 LLM에 채점 기준(루브릭)을 주고 응답을 평가하게 한다. 이 방식을 LLM-as-a-judge라고 부른다. 논문 서론은 이 방식을 대규모로 쓸 때 두 가지 문제가 생긴다고 설명했다. 첫째, 판정 비용이 커진다. 추론 모델은 판정 하나를 내기 전에 추론 토큰을 많이 생성하고, 토큰 단위로 과금하면 그만큼 요금이 늘어나며, 토큰을 순서대로 생성하므로 지연도 길어진다. 둘째, 판정을 얼마나 믿을 수 있는지 알기 어렵다. LLM이 스스로 보고하는 확신도는 과신하는 경향이 있어서, 틀린 답에도 높은 확률을 매기는 일이 잦다.
시험 대상인 JEV는 TypeSafe AI가 호스팅 서비스로 제공하는 판정 모델이다.1 이 모델은 자연어 지시문과 구조화된 입력을 받아, 개발자가 지정한 형식으로 판정을 돌려준다. Choice는 주어진 레이블별 확률을, Noul은 ‘예’일 확률을, Score는 순서가 있는 채점 단계별 확률을 반환한다. 주 실험에서는 요청 하나에 Choice 질문 하나를 보냈다. 연구진이 데이터를 수집할 때 JEV 1.13.0은 입력 토큰에만 요금을 받았는데, 100만 토큰당 0.042달러였다.
JEV는 자체 confidence 값도 반환한다. 그러나 이 논문의 분석에 쓰인 확신도는 레이블별 확률 가운데 가장 큰 값이며, 논문은 이 값을 q로 표기한다. 자체 confidence와 q의 순위 상관은 과제에 따라 0.948에서 0.999였는데, 이는 두 값이 문항을 거의 같은 순서로 매긴다는 뜻이다.2
비교 조건을 맞추기 위해 연구진은 생성형 판정자에게도 같은 지시문과 입력을 주고, 판정 근거 없이 판정과 레이블별 확률만 JSON으로 답하게 했다. 추론 모델은 낮은 추론 강도(low effort)로 실행했다.3 JEV의 내부 구현은 공개되지 않았으므로, 연구진은 판정자의 설정 전체를 한 단위로 삼아 비교했다고 밝혔다.
과제와 실험 절차
주 실험에는 네 가지 과제를 썼다.
| 과제 | 표본 | 판정 내용 |
|---|---|---|
| RewardBench | 400쌍 | 일반 대화, 어려운 대화, 안전성, 추론 범주에서 100쌍씩 추출한 두 응답 중 더 나은 응답 고르기 |
| JudgeBench | 350쌍 | 지식, 추론, 수학, 코딩 문제의 두 응답 중 정답인 응답 고르기 |
| HaluEval | 240건 | 질문 120개마다 정답과 환각 답변을 근거 문서와 대조해 사실 여부 판정 |
| 기존 레이블 | 150건 | 다회차 대화 실험에서 저장한 응답의 최종 답을 기준 답과 비교해 정답, 오답, 무응답으로 판정 |
기초 처리 능력을 확인하는 대조 과제도 두 개 있었다. 하나는 GSM8K 대화 응답 108건이고, 다른 하나는 합성 근거 판정 64건이다. 적용 가능한 15개 구성 중 14개가 두 과제 모두 만점을 받았으므로, 이 두 과제는 판정자 간 차이를 드러내지 못했다. 추가 표본에는 JEV, GPT-6, Skywork 보상 모델만 참여했다. 추가 표본은 RewardBench 2의 4지선다 100문항과, RM-Bench 80문항을 문체 조합 9종과 두 제시 순서로 조합한 문항으로 구성했다.
실험에 쓸 표본은 판정자를 한 번도 실행하기 전에 확정됐다. 642건의 파일럿 표본에서 공개 벤치마크 문항을 원래 질문 단위로 분할해, 40%는 선택 세트에, 60%는 시험 세트에 배정했다. 선택 세트는 온도 보정값과 캐스케이드 기준값을 정하는 데에만 썼다. 670건의 확장 표본은 파일럿 정확도를 확인하기 전에 고정했고, 어떤 값을 맞추는 데에도 쓰지 않았다.4
모든 출력은 형식 검사를 거쳤다. 스키마 필드, 허용 레이블, 확률의 합, 판정과 최고 확률 레이블의 일치 여부를 확인했고, 검사에 실패한 출력은 정확도 계산에서 오답으로 셌다. 더 좋은 답을 얻으려고 출력을 고치거나 재실행하지는 않았다.
벤치마크 레이블에도 오류가 있을 수 있으므로, 연구진 중 한 명이 사람 재판정을 따로 수행했다. 재판정자는 벤치마크 레이블과 판정자 출력을 모르는 상태에서, JEV와 GPT-6의 정오가 다른 문항을 모두 다시 판정했다.5
벤치마크별 정확도
| 판정자 | RewardBench | JudgeBench | HaluEval | 기존 레이블 |
|---|---|---|---|---|
| JEV 1.13 | 92.2 | 78.6 | 87.5 | 94.0 |
| GPT-4.1 mini | 89.0 | 64.0 | 86.2 | 84.0 |
| GPT-5.4 | 93.0 | 90.9 | 88.3 | 92.7 |
| GPT-5.6 Sol | 93.2 | 93.1 | 89.2 | 95.3 |
| GPT-6 Astra | 93.5 | 93.1 | 86.7 | 96.7 |
| Claude Sonnet 5 | 91.2 | 88.9 | 85.8 | 94.7 |
| Gemini 3 Flash | 92.8 | 76.0 | 83.3 | 95.3 |
| Gemini 3.1 Pro | 94.5 | 87.4 | 87.1 | 94.7 |
| Qwen3.8 27B | 93.8 | 74.3 | 87.9 | 95.3 |
| PairRM (로컬) | 68.0 | 54.3 | – | – |
원문 표 1에서 판정자 10개를 발췌했다. 단위는 %이며, 형식 검사에 실패한 출력은 오답으로 계산했다. JEV의 출력 가운데 형식 검사에 실패한 것은 1,312건 중 한 건도 없었다.
일반 선호와 근거 기반 사실성
RewardBench 정확도는 GPT-6이 93.5%로 JEV의 92.2%보다 조금 높았다. 두 판정자의 차이는 −1.25%포인트이고, 95% 신뢰구간은 −3.8에서 +1.5까지였다. HaluEval에서는 JEV가 87.5%, GPT-6이 86.7%로 JEV가 0.83%포인트 높았다. 벤치마크 레이블 기준으로는 두 과제 모두 유의한 차이가 없었다.
사람 재판정 결과는 벤치마크 레이블 기준 결과보다 GPT-6에 유리했다. RewardBench에서 두 판정자의 정오가 다른 29문항 중 재판정자는 17문항에서 GPT-6, 5문항에서 JEV가 옳다고 판정했고 7문항은 판단을 보류했다. 이 기준으로 계산한 차이는 −3.0%포인트다. HaluEval에서는 정오가 다른 10문항 중 8문항에서 GPT-6이 옳았고, 차이는 −2.5%포인트였다.
재판정 과정에서 HaluEval 레이블의 오류도 발견됐다. 두 판정자가 모두 틀린 것으로 채점된 26문항 중 24문항은 레이블이 근거 문서와 맞지 않았다. 이 레이블을 고치면 JEV는 95.8%, GPT-6은 98.3%가 된다. 따라서 HaluEval에서 두 판정자의 정확도가 비슷하게 나온 데에는, 두 판정자가 모두 틀린 것으로 채점된 문항 대부분이 레이블 오류였다는 사정도 영향을 주었다. 벤치마크 레이블로 계산하든 재판정 레이블로 계산하든 성립하는 결론으로, 논문은 “JEV는 GPT-6과 3%포인트 이내"를 제시했다.
풀이 검증이 필요한 정답 판정
JudgeBench 결과는 앞의 두 벤치마크와 달랐다. JEV는 78.6%였고 GPT-5.6과 GPT-6은 모두 93.1%였다. JEV와 GPT-6의 차이는 −14.6%포인트다. 영역별로 보면 추론에서 JEV 68.4% 대 GPT-6 95.9%(98문항), 코딩에서 76.2% 대 97.6%(42문항)로 격차가 가장 컸고, 지식에서는 84.4% 대 90.9%(154문항)로 가장 작았다.
이 격차는 레이블 오류로 설명되지 않는다. 정오가 다른 69문항 중 재판정자는 57문항에서 GPT-6, 1문항에서 JEV가 옳다고 판정했고 11문항은 보류했다. 추론, 코딩, 수학 영역만 보면 GPT-6 대 JEV가 27대 0, 9대 0, 7대 0이었다.
보상 모델 Skywork-Reward-V2-Qwen3-8B의 정확도는 RewardBench 94.0%, JudgeBench 71.1%였다. 구형 순위 모델 PairRM은 68.0%와 54.3%였다.6 판정 1,000건당 비용이 1달러 미만인 호스팅 판정자만 비교하면, JEV는 JudgeBench에서 가장 정확했고 HaluEval에서 공동 1위였으며 RewardBench에서는 1위와 0.6%포인트 차이였다.
공들여 쓴 오답과 참조 없는 글
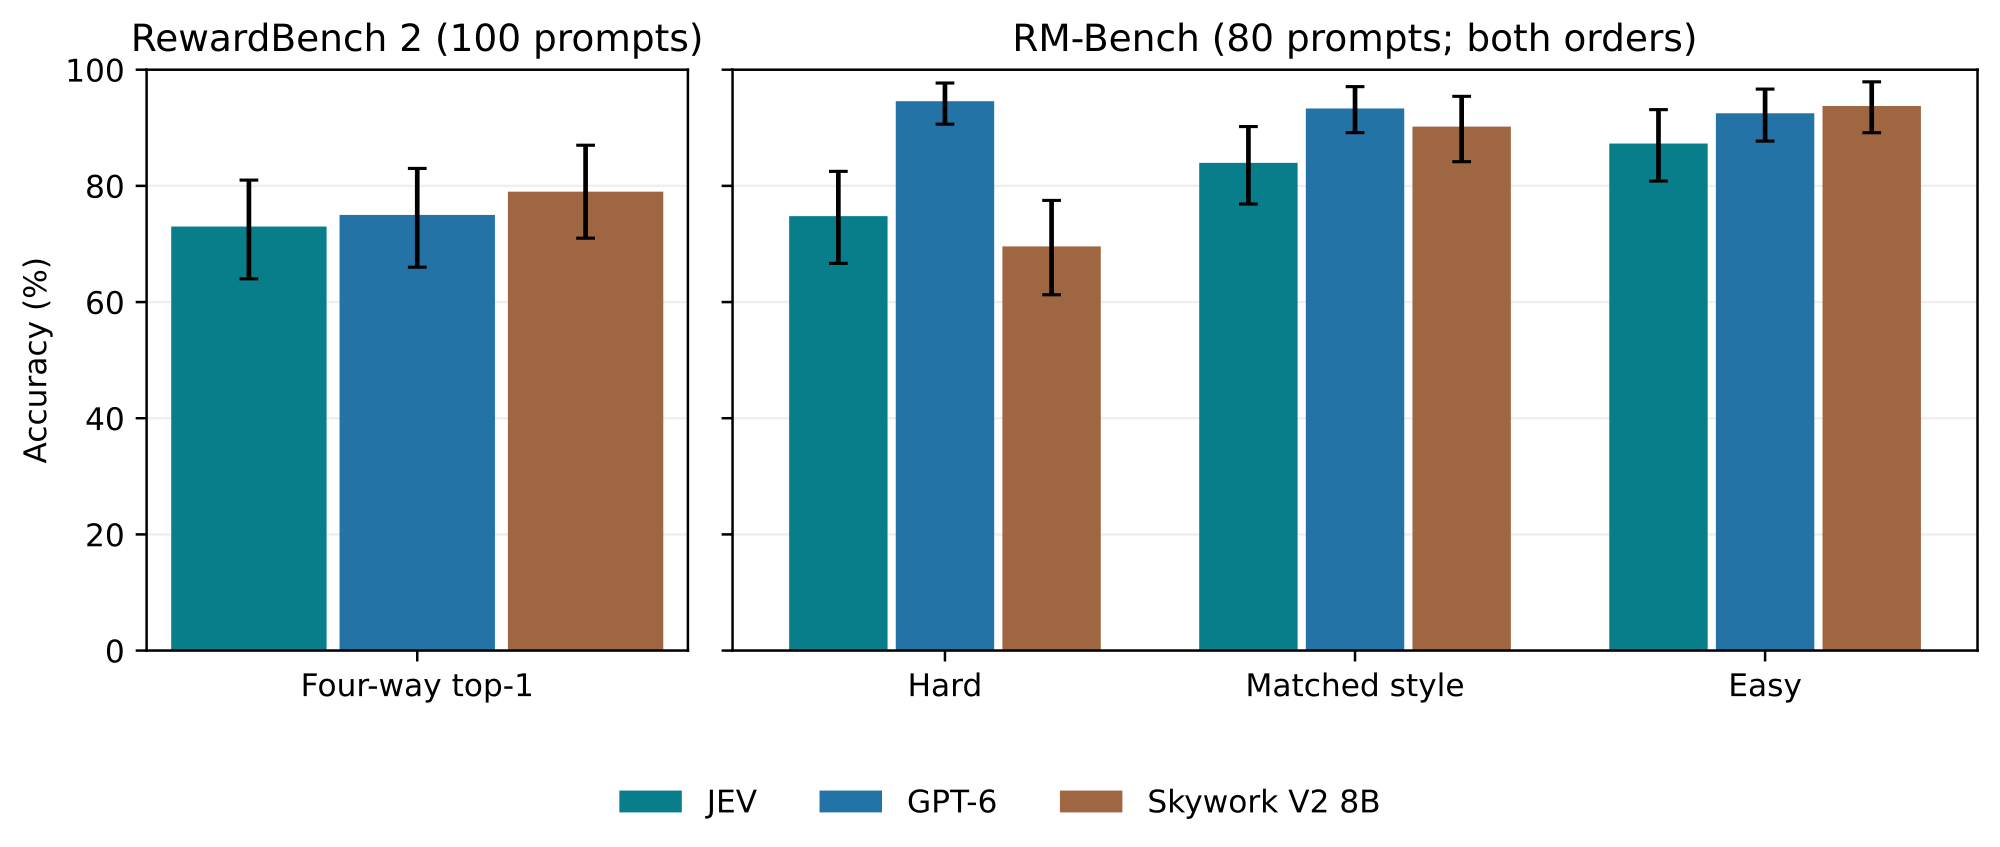
RewardBench 2의 4지선다 선택에서 JEV는 73.0%, GPT-6은 75.0%, Skywork는 79.0%였다. 네 응답 중 하나를 고르는 과제에서 JEV와 GPT-6의 차이는 2.0%포인트로 크지 않았다.
RM-Bench에서는 문체가 결과를 바꿨다. 두 응답의 문체가 같을 때 JEV의 정확도는 84.0%였지만, 오답 응답이 더 공들여 쓰였을 때는 74.8%로 9.2%포인트 떨어졌다. 같은 조건에서 GPT-6의 정확도는 93.3%에서 94.6%로 1.3%포인트 올랐다. 어려운 쌍에서 JEV와 GPT-6의 격차는 19.8%포인트였다. 연구진은 옳은 답을 고르는 능력과, 오도하는 문체에 속지 않는 능력은 서로 다른 능력이라고 적었다.
답변 형식에 따른 JEV 일치율 차이는 크지 않았다. 객관식 답변을 기준 답과 직접 대조해 판정했을 때 JEV의 일치율은 91.3%였고, 기준 답을 보여 주지 않고 최종 선택지만 추출한 뒤 코드로 비교했을 때는 86.0%였다. 추출 방식은 검사하기 쉬운 결과를 남기지만 일치율을 높이지는 못했다. 같은 HaluEval 질문 40개를 객관식과 서술형으로 바꿔 제시하자, JEV의 일치율은 객관식 100.0%에서 서술형 92.5%로 7.5%포인트 낮아졌다. 이 차이는 작업 종류에 따른 차이보다 훨씬 작았다.
긴 답변의 사실성을 판정할 때는 근거 문서가 있는지에 따라 성능이 크게 달랐다. HaluEval QA 표본에는 20단어보다 긴 답변이 16개뿐이어서, 연구진은 문서 요약 80건과 일반 응답 80건을 따로 고정했다. 근거 문서가 있는 요약에서 JEV, GPT-4.1 mini, GPT-5.4의 정확도는 71.2%, 62.5%, 72.5%였다. 참조 없이 일반 응답의 환각 여부를 판정하는 과제에서는 52.5%, 53.8%, 55.0%로 세 판정자 모두 우연 수준이었다. 그런데도 세 판정자의 평균 최대 확률은 0.90, 0.95, 0.96으로 높았다. 이 과제에서 JEV 확신도의 오류 탐지 AUROC는 0.518로, 오답과 정답을 거의 구분하지 못했다.7
형식 검사 통과율에서도 판정자별 차이가 났다. JEV는 모든 문항에서 형식 계약을 지켰고, 출력 형식 제약을 적용한 생성형 판정자 가운데 일부도 그랬다. 반면 Qwen3.6 27B는 1,312건 중 1,206건만 유효했다. 연구진은 실패한 호출을 두고 “추론 오류는 아니지만 판정도 아니다"라고 적었다.
속도와 비용
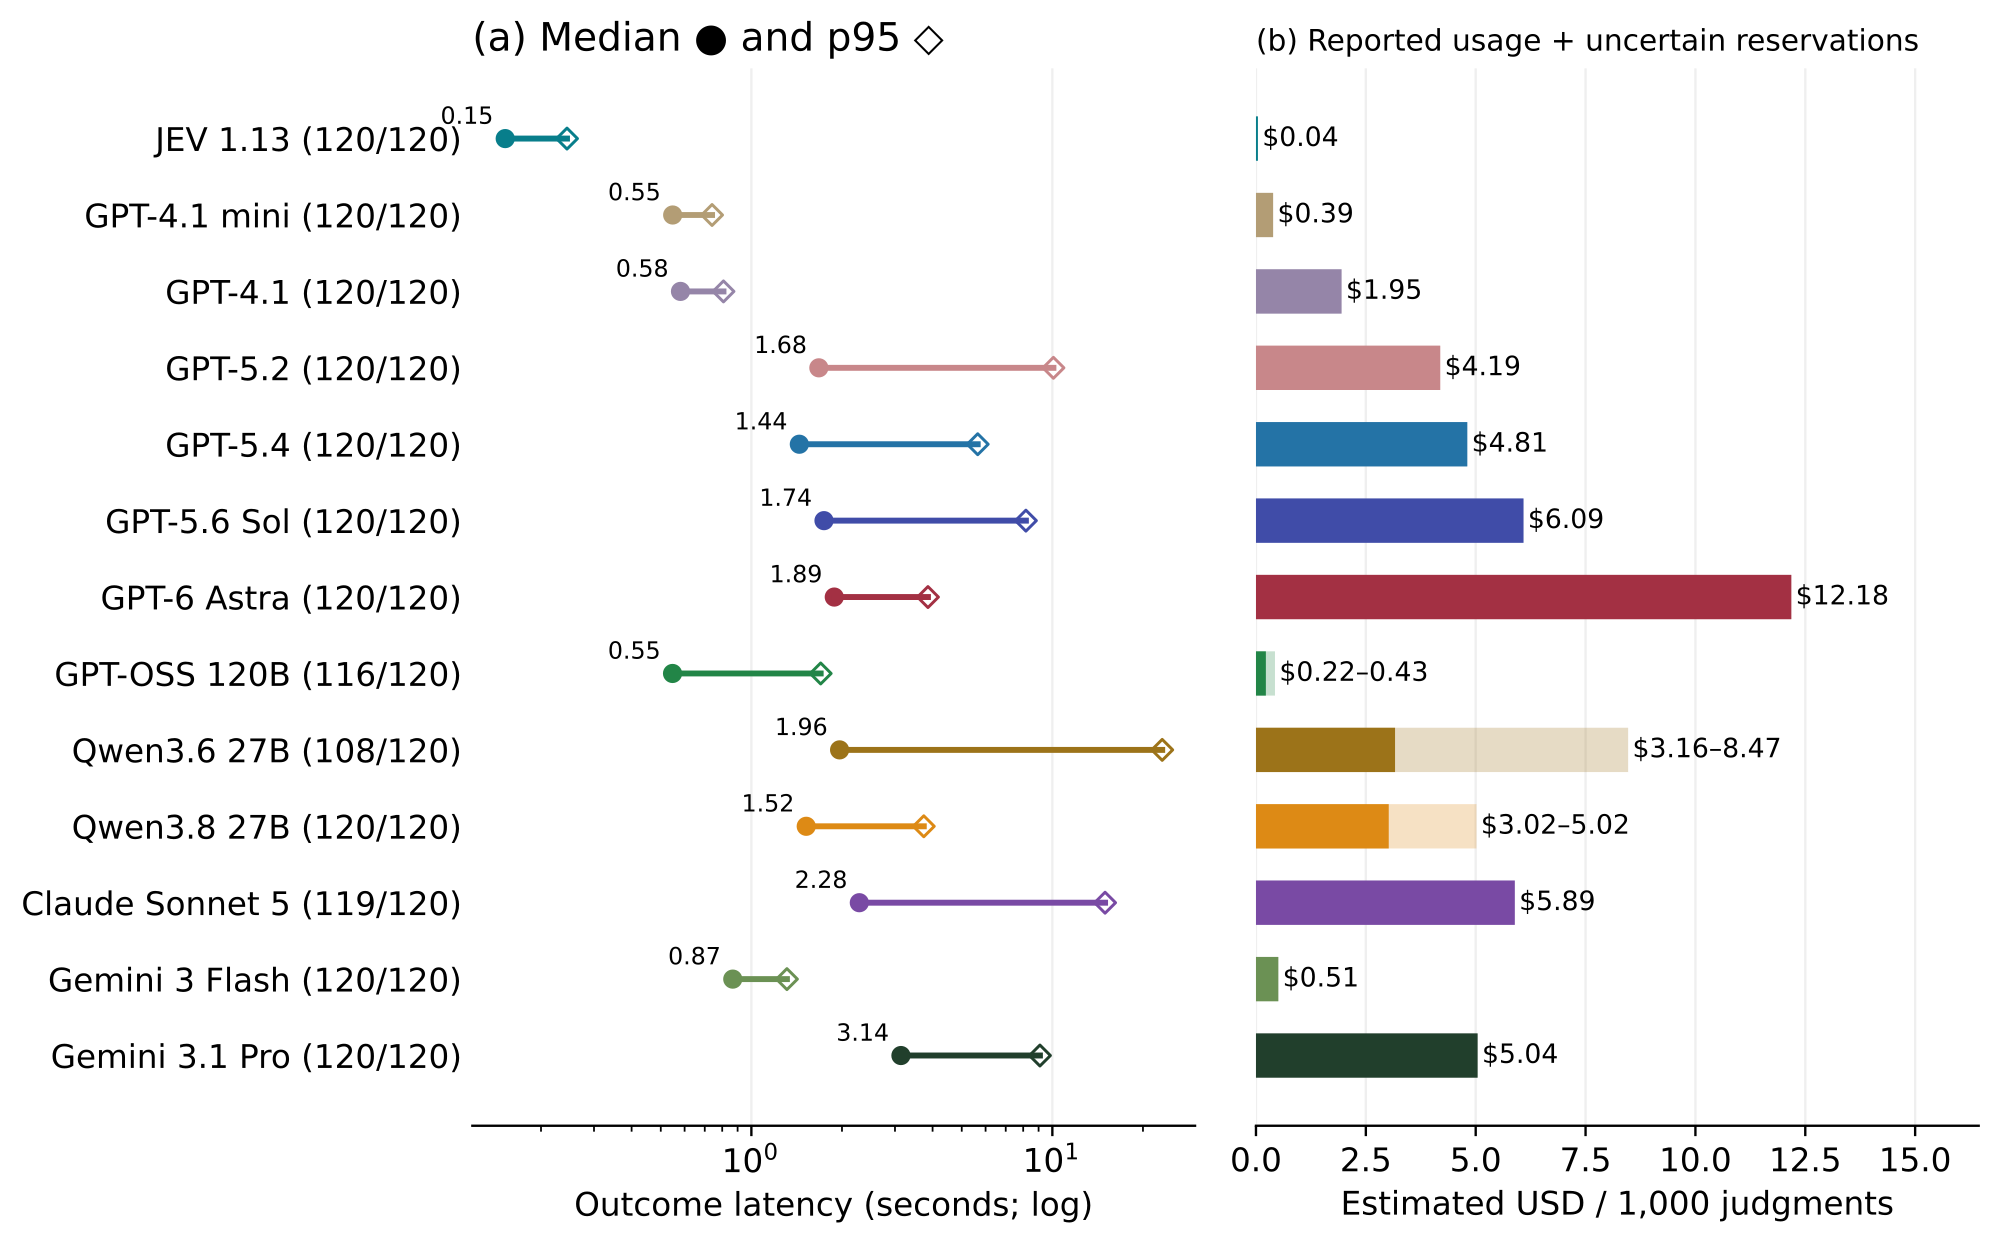
지연과 비용은 공개 과제별 40건씩, 총 120건으로 구성한 별도 패널에서 측정했다.8
| 판정자 | 중앙값 지연 | 판정 1,000건당 비용 |
|---|---|---|
| JEV 1.13 | 0.15초 | 0.04달러 |
| GPT-4.1 mini | 0.55초 | 0.39달러 |
| Gemini 3 Flash | 0.87초 | 0.51달러 |
| GPT-5.6 Sol | 1.74초 | 6.09달러 |
| GPT-6 Astra | 1.89초 | 12.18달러 |
| Claude Sonnet 5 | 2.28초 | 5.89달러 |
| Gemini 3.1 Pro | 3.14초 | 5.04달러 |
JEV의 중앙값 지연은 0.152초이고, 비용은 판정 1,000건당 0.044달러였다. GPT-4.1 mini는 0.548초에 0.390달러, GPT-6은 1.885초에 12.182달러였다. 이 작업 기준으로 JEV는 GPT-4.1 mini보다 약 9배, GPT-6보다 약 277배 저렴하다.
연구진은 작업별 결과를 JEV 적용 안내표로 정리하고, 작업마다 JEV를 그대로 써도 되는지, 더 강한 판정자에게 다시 판정을 맡겨야 하는지(에스컬레이션) 안내했다.9
| 작업 | 표본 | JEV | 가장 강한 비교 대상 | 차이(%p) | 안내 |
|---|---|---|---|---|---|
| 일반 선호 | RewardBench 400 | 92.2 | GPT-6 93.5 | −1.3 | JEV 사용 |
| 근거 기반 사실성 | HaluEval 240 | 87.5 | GPT-6 86.7 | +0.8 | JEV 사용 |
| 최종 답 판정 | 기존 레이블 150 | 94.0 | GPT-6 96.7 | −2.7 | JEV 사용 |
| 풀이 검증이 필요한 정답 판정 | JudgeBench 350 | 78.6 | GPT-6 93.1 | −14.6 | 에스컬레이션 |
| 오답이 더 공들여 쓰인 쌍 | RM-Bench 어려움 480 | 74.8 | GPT-6 94.6 | −19.8 | 에스컬레이션 |
| 문체가 같은 쌍 | RM-Bench 보통 480 | 84.0 | GPT-6 93.3 | −9.4 | 에스컬레이션 |
| 4지선다 선택 | RewardBench 2 100 | 73.0 | Skywork 79.0 | −6.0 | 먼저 검증 |
| 근거 문서 기반 요약 | HaluEval 요약 80 | 71.2 | GPT-5.4 72.5 | −1.2 | 먼저 검증 |
| 참조 없는 글 | HaluEval 일반 80 | 52.5 | GPT-5.4 55.0 | −2.5 | 지원 안 됨 |
근거 문서나 기준 답이 주어지는 판정과 일반적인 선호 판정에서 JEV는 가장 강한 판정자와 3%포인트 이내였고, 비용은 10분의 1에서 100분의 1 수준이었다. 여러 단계로 푼 답을 검증하는 작업과 공들여 쓴 오답이 섞인 쌍을 판정하는 작업에서는 GPT-6과 9%포인트에서 20%포인트 차이가 났다. 참조 없는 글의 판정은 시험한 모든 판정자가 우연 수준이었으므로, 연구진은 이 한계를 JEV만의 문제로 보지 않았다.
반복 요청, 제시 순서, 확률의 품질
같은 요청을 반복해도 JEV의 판정은 바뀌지 않았다. 예시 48개로 반복 비교를 96회 실행했을 때 판정은 한 번도 바뀌지 않았다. 루브릭 문구를 바꾼 48회에서는 네 번 바뀌었다. 두 응답의 제시 순서를 뒤집으면 RewardBench 판정의 3.25%, JudgeBench 판정의 11.14%가 바뀌었다. 두 순서 모두에서 정답을 고른 비율은 91.0%와 74.0%였다. JEV가 먼저 제시된 응답을 고른 비율은 48.9%와 48.4%였으므로, 순서에 따른 불일치를 특정 순서에 대한 선호로 설명할 수는 없다. 순서에 따라 판정이 달라진 JudgeBench 39쌍 가운데 14쌍은 언제나 먼저 제시된 응답을, 25쌍은 언제나 나중에 제시된 응답을 골랐다.
확률의 보정 성능으로 매긴 순위는 정확도 순위와 달랐다. JEV의 Brier 점수는 RewardBench, JudgeBench, HaluEval에서 0.111, 0.297, 0.176이었고, GPT-6은 0.104, 0.095, 0.245였다. 어려운 비교가 모인 JudgeBench에서는 GPT-6이 더 정확하면서 확률도 더 잘 보정돼 있었지만, 근거 문서 기반 판정인 HaluEval에서는 JEV의 확률이 더 정확했다. 확신도 0.9 이상인 HaluEval 판정에서 JEV는 199건 중 10건을 틀렸고, GPT-6은 233건 중 28건을 틀렸다.
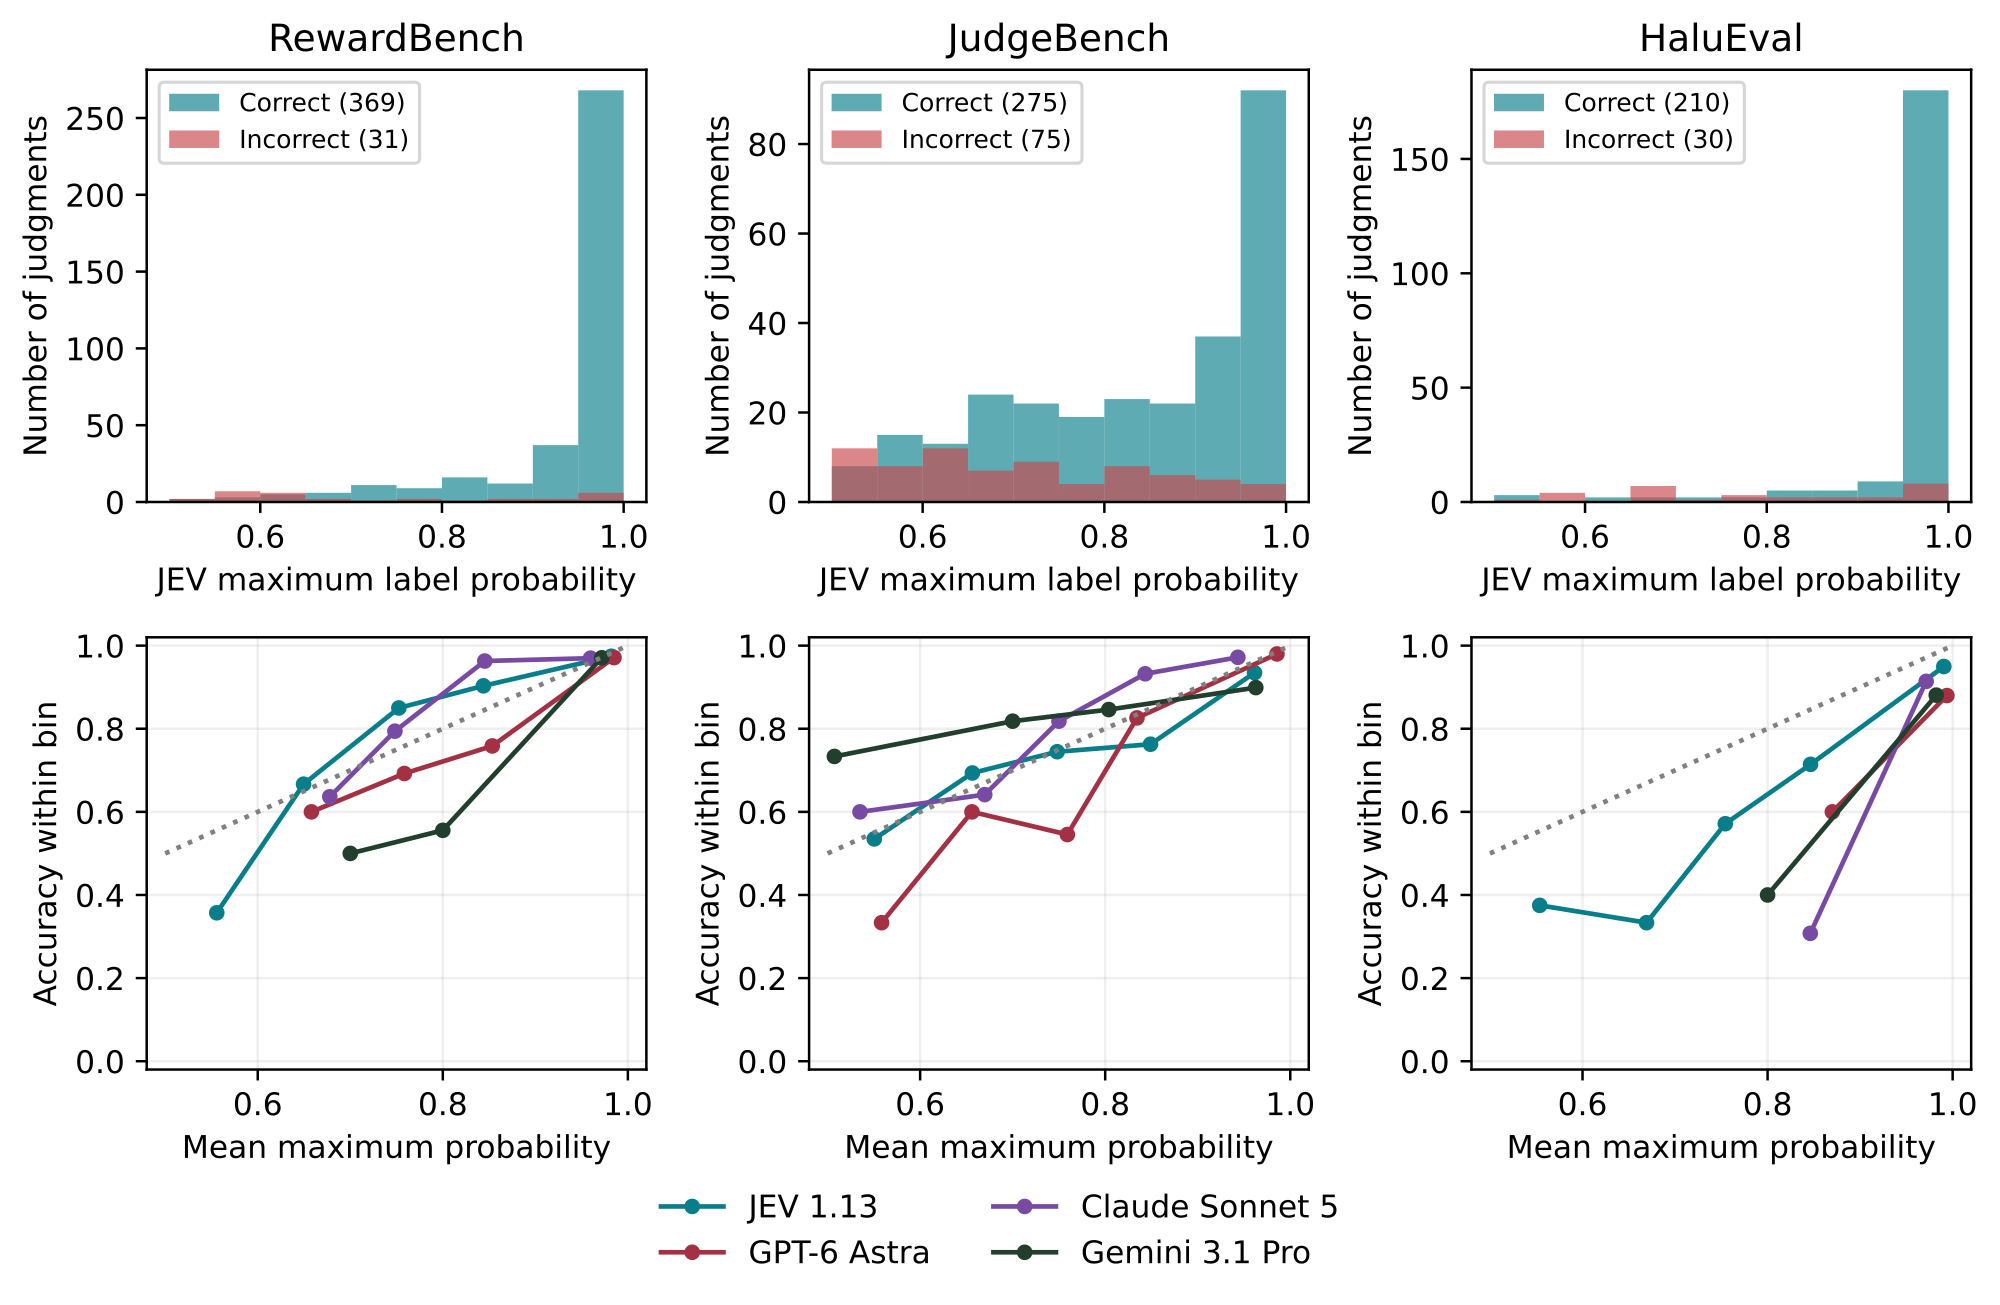
오답의 순위를 매기는 능력은 보정과 또 다른 성질이었다. 확신도로 오답을 식별하는 AUROC는 JEV가 0.869, 0.745, 0.863이었고 GPT-6이 0.891, 0.907, 0.899였다. HaluEval에서 GPT-6은 Brier 점수가 JEV보다 나빴지만 오답 순위는 더 잘 매겼다.
선택 세트에서 정한 온도 값은 작업마다 다른 결과를 냈다. 이 온도를 확장 표본에 적용하자, HaluEval에서는 JEV의 NLL이 0.333에서 0.284로 좋아졌지만 JudgeBench에서는 0.449에서 0.475로, RewardBench에서는 0.205에서 0.232로 나빠졌다. 정한 온도 값도 RewardBench에서는 확률을 0과 1에 가깝게 만드는 0.65였고, JudgeBench와 HaluEval에서는 확률을 0.5에 가깝게 만드는 2.15와 4.45였다. 보정 방향이 작업마다 반대였다. 하나의 온도로는 모든 작업을 보정할 수 없었다.
같은 판정을 JEV의 다른 인터페이스로 물어도 확률이 조금씩 달랐다. 예시 48개에서 Choice와 Noul 확률의 평균 차이는 0.055였고, 판정 레이블이 달라진 경우는 1건이었다.
확신할 때 채택하고, 불확실할 때 맡긴다
두 판정자는 서로 다른 문항에서 틀렸다. JudgeBench에서 GPT-6은 JEV가 틀린 75문항 중 60문항을 맞혔고, JEV는 GPT-6이 틀린 24문항 중 9문항을 맞혔다. 두 판정자 가운데 옳은 판정을 언제나 골라 쓸 수 있다면 정확도는 95.7%가 된다. 그러나 이 상한은 정답 레이블을 알아야 계산할 수 있으므로, 실제로 쓸 수 있는 캐스케이드는 판정 시점에 얻을 수 있는 신호로 오답을 찾아야 한다.
JEV는 확신도 q가 낮을수록 더 자주 틀렸다. 세 과제의 990건 판정을 q 구간별로 분류하자, q가 높을수록 JEV의 정확도가 단조롭게 올랐다. q가 0.6 미만인 65건에서 JEV의 정확도는 47.7%였고, 0.7 이상 0.8 미만인 85건에서는 76.5%, 0.95 이상 0.99 미만인 147건에서는 93.9%, q가 1인 322건에서는 99.1%였다. 같은 문항에서 GPT-6의 정확도는 78.5%에서 99.1%로 변화 폭이 작았다.
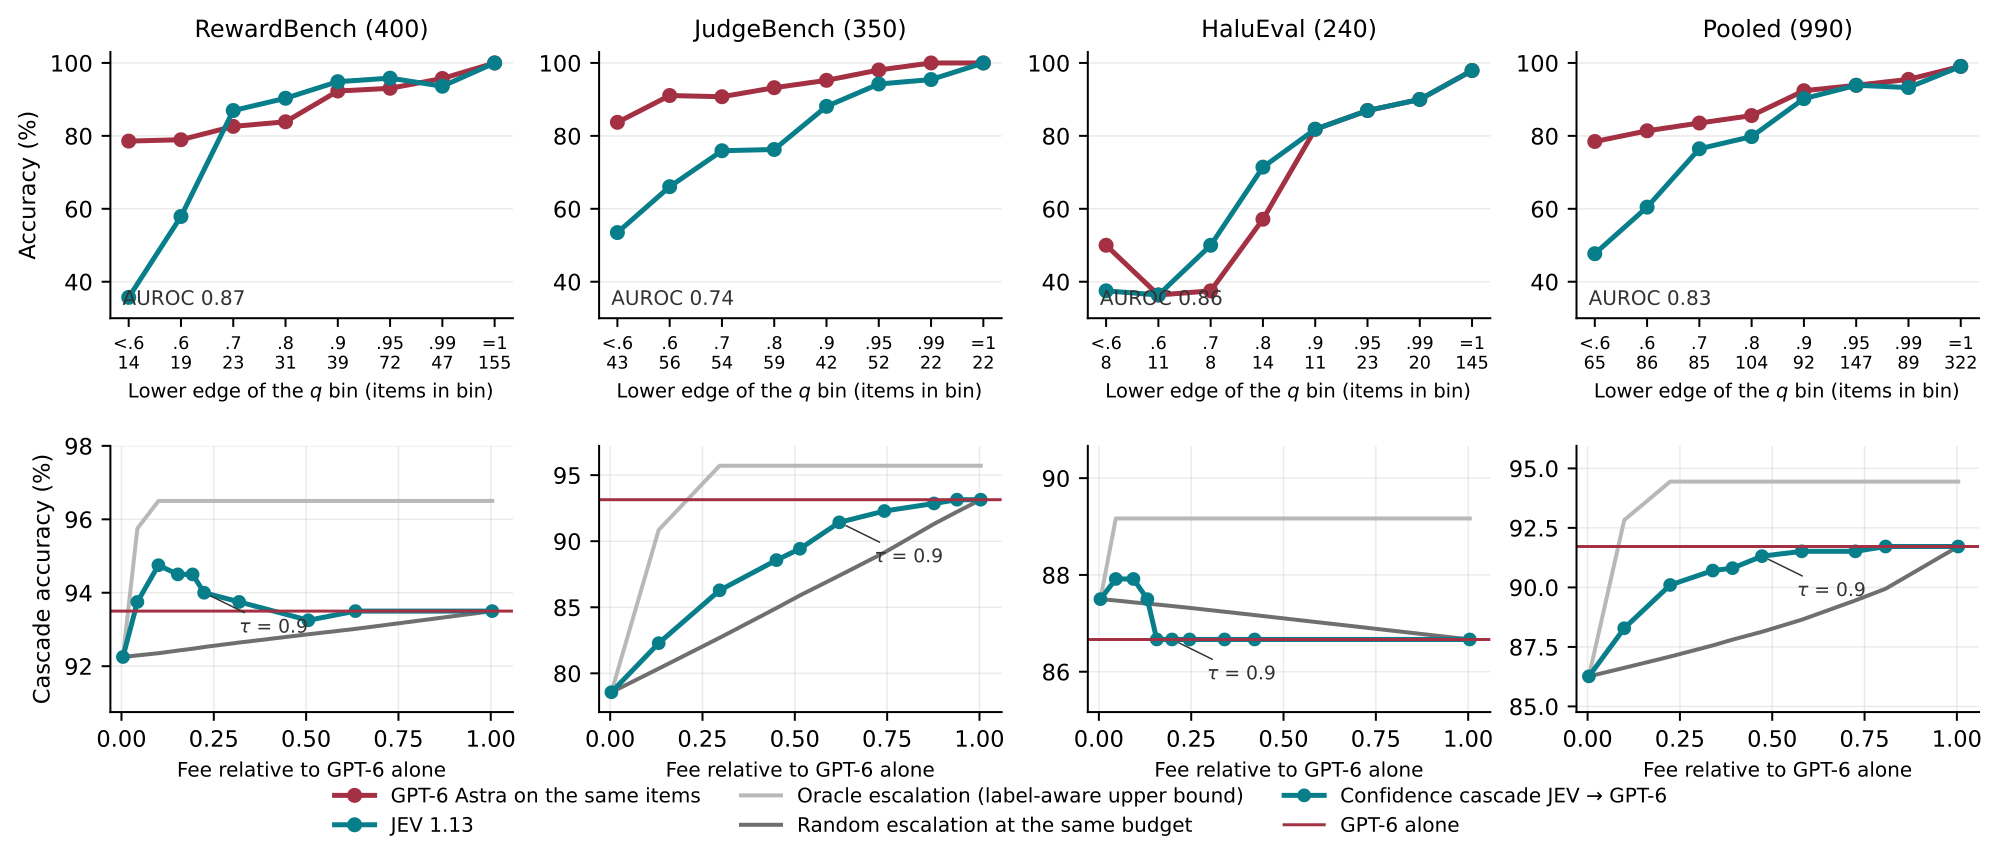
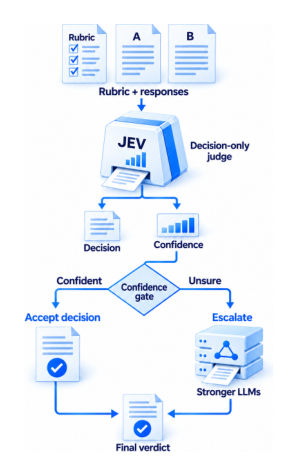
확신도 q가 0.9 이상인 문항에서 JEV와 GPT-6의 정확도는 95.8%와 96.5%로 거의 같았다. 사람 재판정 레이블로 계산하면 97.2%와 98.5%다. 반면 JEV가 에스컬레이션할 문항에서는 GPT-6이 82.6%로 JEV의 67.9%보다 약 15%포인트 높았다. 이 경향은 세 과제 각각에서도 나타났고, q로 JEV의 정오를 판별하는 AUROC는 0.869, 0.745, 0.863이었다. 캐스케이드 설계는 이 결과를 근거로 삼는다. JEV가 확신할 때는 JEV의 판정을 채택하고, 나머지 문항에만 더 강한 판정자의 비용을 쓰는 방식이다.
단일 순서 캐스케이드
연구진은 먼저 기본 제시 순서의 판정에 이 규칙을 적용해 시뮬레이션했다.10 기준값 τ를 0.9로 정하면 세 과제 합산 문항의 34%가 GPT-6 에스컬레이션 대상이 된다. 이때 캐스케이드 정확도는 91.3%로 GPT-6 단독의 91.7%와 비슷했다. 이는 GPT-6 정확도의 99.6%이며, 비용은 GPT-6의 47%, 판정 1,000건당 약 6.3달러였다. 같은 34%를 무작위로 에스컬레이션하면 정확도는 88.1%에 그쳤고, 정답을 알고 JEV의 오답부터 에스컬레이션하는 이상적인 경우는 94.4%였다. 논문은 이를 두고, JEV의 확신도가 얻을 수 있는 개선 폭의 절반 정도를 실현했다고 평가했다.
과제별 결과는 앞의 적용 안내표와 일치했다.
- RewardBench에서는 캐스케이드가 GPT-6 단독보다 정확했다. 캐스케이드가 94.0%, GPT-6 단독이 93.5%였다. 캐스케이드에 든 비용은 GPT-6 단독 비용의 22%에 그쳤다. 두 판정자가 틀리는 문항이 달랐기 때문이다.
- JudgeBench에서는 JEV의 평균 q가 0.81에 그쳤다. 같은 τ 0.9에서 문항의 61%가 에스컬레이션됐고, GPT-6 정확도의 98.2%를 비용 62%로 유지했다. τ를 0.95로 올리면 99.1%를 비용 74%로 유지했다.
- HaluEval에서는 어떤 기준값을 써도 벤치마크 레이블 기준 정확도가 오르지 않았다. 확신도가 낮은 문항 대부분이 레이블 오류 문항이었기 때문이다. 사람 재판정 레이블로 계산하면 τ 0.8에서 문항의 11%를 에스컬레이션해 GPT-6과 같은 98.3%를 비용 13%로 얻었다.
에스컬레이션 대상이 가장 비싼 판정자일 필요도 없었다. GPT-5.6을 2차 판정자로 쓴 τ 0.9 캐스케이드는 세 과제 합산 91.9%를 판정 1,000건당 약 3.4달러로 달성했다.
미리 고정한 두 순서 정책
사전에 정한 규칙을 시험하기 위해, 연구진은 각 쌍을 두 제시 순서로 모두 판정하고 같은 응답이 두 순서에서 받은 확률을 평균한 값으로 에스컬레이션 여부를 정했다. 동점은 0.5점으로 셌다. 2차 판정자별 기준값은 파일럿 선택 세트 96쌍(RewardBench 64쌍, JudgeBench 32쌍)에서 정했다. 선택 세트 정확도를 2차 판정자 단독 정확도와 2%포인트 이내로 유지하면서 JEV가 채택하는 비율을 최대화하는 값이다. 1단계 출력이 형식 검사에 실패하면 언제나 에스컬레이션했다. 기준값 후보 목록과 선정 규칙은 모델을 추가하기 전에 고정했고, 파일럿 시험 세트와 확장 표본은 평가에만 썼다.
| 2차 판정자 | τ | JEV 채택(%) | 캐스케이드 정확도(%) | 2차 판정자 단독(%) | 차이(%p) | 비용 비율 |
|---|---|---|---|---|---|---|
| GPT-5.4 | 0.90 | 53.7 | 91.4 | 91.6 | −0.2 | 0.639 / 1.096 |
| GPT-5.6 Sol | 0.70 | 81.0 | 91.0 | 93.3 | −2.4 | 0.288 / 0.380 |
| GPT-6 Astra | 0.90 | 53.7 | 92.5 | 93.1 | −0.6 | 0.568 / 0.622 |
확장 표본의 선호 쌍 510개로 계산했다. 비용 비율은 두 순서의 JEV 호출 비용을 포함하며, 보고된 사용량 기준 값과 보수적 상한 값을 함께 적었다.11
GPT-6을 2차 판정자로 쓴 τ 0.9 정책은 확장 표본 510쌍 중 53.7%에서 JEV 판정을 채택했다. 정확도는 92.5%로 GPT-6 단독 정확도 93.1%보다 0.59%포인트 낮았고, 비용은 GPT-6 단독의 56.8%(보수적 상한 62.2%)였다. 그러나 이 규칙이 모든 2차 판정자에게 통하지는 않았다. GPT-5.6용 정책은 τ 0.7에서 81.0%를 채택했지만 정확도가 2.35%포인트 낮아져 허용 오차 2%포인트를 초과했다. τ가 0.5로 정해진 정책 세 개는 2차 판정자를 한 번도 부르지 않아, 두 순서의 확률을 평균하는 규칙과 같아졌다.
확신도가 경고하지 못하는 오답
캐스케이드는 JEV가 틀린 문항에서 JEV가 스스로 불확실하다고 평가할 때 작동한다. RM-Bench에서는 이 조건이 성립하지 않았다. q로 JEV의 정오를 판별하는 AUROC는 쉬운 쌍에서 0.918, 보통 쌍에서 0.902였지만, 오답이 더 공들여 쓰인 어려운 쌍에서는 0.770으로 낮아졌다. 어려운 쌍에서 JEV는 q가 0.9 이상 0.95 미만인 판정의 3분의 1을 틀렸고, 0.95 이상 0.99 미만인 판정의 15%를 틀렸다.
그 결과 τ 0.9로 GPT-6에 에스컬레이션하는 캐스케이드는 어려운 쌍에서 GPT-6 정확도의 96.5%만 유지했다(90.8% 대 94.2%). 98.7%를 유지하려면 τ를 0.95로 올리고 문항의 58%를 에스컬레이션해야 했다. 보통 쌍에서는 τ 0.9로도 99.6%를 유지했다. 참조 없는 글 판정에서는 AUROC가 0.518이어서 어떤 기준값도 도움이 되지 않았다.
연구진은 이 결과를 이렇게 정리했다. 1단계 판정자가 유능하지만 불확실한 문항에서는 확신도가 에스컬레이션 대상을 잘 고르고, 1단계 판정자가 확신에 찬 채 오도되는 문항에서는 잘 고르지 못한다. 캐스케이드는 실제로 판정할 쌍과 같은 종류의 쌍으로 검증해야 한다는 것이 연구진의 권고다.
연구진이 제시한 점검 목록
결론에서 연구진은 판정자를 운용할 때 확인할 다섯 가지를 제시했다.
- 선호 쌍은 두 제시 순서로 모두 판정하고, 같은 응답의 확률을 평균한다.
- 에스컬레이션 기준값은 현장의 선택 세트에서 고르고, 선택에 쓰지 않은 문항에서 다시 확인한다. 이 연구에서도 기준값이 모든 2차 판정자에게 통하지는 않았다.
- 판정자를 비교할 때는 형식 검사에 실패한 출력을 오답으로 센다.
- 확신도는 정답의 보증서로 쓰지 말고 에스컬레이션 신호로 쓴다. 문체로 오도하는 쌍에서 확신도를 따로 확인하고, 온도 보정값도 작업마다 검증한다.
- 새 종류의 작업에 적용하기 전에 소규모 현장 검증을 먼저 한다.
연구진은 논문을 이렇게 마무리했다.
A usable verdict, a correct decision, and reliable uncertainty are three different things, and each has to be checked.
사용 가능한 판정, 옳은 판정, 믿을 만한 불확실성은 서로 다른 세 가지이며, 각각을 따로 확인해야 한다는 뜻이다.
논문이 밝힌 한계
- 비공개 JEV 한 버전만 평가했고, 학습 데이터와 벤치마크의 중복 여부는 알 수 없다. 판정자마다 추론 강도, 모델 크기, 컨텍스트 한도, 서빙 시스템이 다르므로 계산량을 맞춘 구조 비교는 아니다.
- 모델 계열을 추가한 확장 분석은 최초 결과를 확인한 뒤에 진행했으므로 여러 모델 계열의 비교는 모두 탐색적 분석이다. 확장 표본은 기준값을 맞추는 데 쓰지 않았지만 파일럿과 같은 벤치마크에서 추출했다.
- 사람 재판정은 판정자 간 불일치로 선정한 183문항만 다뤘고, 저자 한 명이 모든 문항을 판정했다.
- 지연은 한 곳의 클라이언트와 한 번의 수집 기간에서 측정했다. 캐스케이드 비용은 시뮬레이션 값이며, 실제 순차 캐스케이드의 지연은 측정하지 않았다.
- 판정 근거 생성, 긴 숙고, 다양한 채점 루브릭은 실험 범위에 없었고, 전문 직업 영역도 시험하지 않았다.
GPT-6이 더 정확했던 문항
나는 비용 절감 수치보다 그림 5 위쪽의 q 구간별 정확도 그래프가 더 의외였다. 벤치마크별 정확도 표만 보면 GPT-6이 모든 문항에서 JEV보다 조금씩 더 잘한다고 짐작하게 된다. 그러나 이 그래프에서 GPT-6의 우위는 JEV가 확신하지 못한 문항에 집중돼 있었고, JEV가 확신한 문항에서는 두 판정자의 차이가 1%포인트도 되지 않았다. 비싼 판정자에게 맡길 문항을 저렴한 판정자의 확신도로 고를 수 있다는 것이 이 논문이 제시한 캐스케이드의 근거다.
그런데 그 근거가 성립하지 않는 조건도 이 논문이 함께 보고했다. 지난주 정리한 Jev 발표 다이제스트에서 TypeSafe 공식 문서는 confidence를 정답 확률로 읽지 말고, 실제 업무 자료로 자동 처리 기준값을 검증하라고 안내했다. 이 논문은 외부 연구진의 측정으로 그 안내가 필요한 이유를 제시했다. 선택 세트에서 정한 온도는 작업마다 보정 방향이 반대였고, GPT-5.6용 기준값은 확장 표본에서 허용 오차를 초과했다. 공들여 쓴 오답이 섞인 쌍을 판정할 때 JEV는 틀린 판정에도 0.9 이상의 확신도를 냈다. JEV의 확신도는 JEV가 스스로 낮은 확신도를 낸 문항에서만 에스컬레이션 신호로 쓸 수 있었다. 입력이 JEV를 오도해서 확신도가 높게 나오면, 이 신호는 경고 역할을 하지 못했다.
출처
Yubo Li, Yidi Miao, Ramayya Krishnan, Rema Padman (Carnegie Mellon University). “JEV-as-a-Judge: Accept When Confident, Escalate When Unsure.” arXiv:2609.26550 [cs.AI], 2026년 9월 22일 v1 공개. 미국 국립표준기술연구소(NIST)와 CMU AI 측정과학공학센터(AIMSEC)가 연구를 지원했고, OpenAI Researcher Access Program이 API 크레딧을 제공했다.
논문은 CC BY 4.0 라이선스로 공개되었다. 이 글의 그림은 원문 HTML판에서 가져왔으며, SVG 그림은 PNG로 변환했고 그림 4는 가장자리 여백만 조정했다.
원문: https://arxiv.org/abs/2609.26550
TypeSafe는 Jev를 문장을 생성하지 않고 선택지와 확률을 반환하는 System One Model로 소개했다. 제품 발표 내용은 Introducing System One Models & Jev 다이제스트에 정리했다. 논문은 모델명을 JEV로 표기한다. ↩︎
JEV 자체 confidence와 최대 레이블 확률의 스피어만 순위 상관은 RewardBench 0.971, JudgeBench 0.999, HaluEval 0.948이었다. 자체 confidence는 인터페이스 진단에만 썼다. ↩︎
Qwen3.6은 기본 추론 설정과 JSON 객체 모드로 실행했고, 나머지 호스팅 판정자에는 JSON 스키마 제약을 적용했다. GPT-4.1 계열은 온도 0으로 실행했다. Groq에서 Qwen3와 Qwen3.5를 쓸 수 없어서, 연구진은 공식 체크포인트를 H100 한 장에서 비추론 모드로 직접 실행했다. 설정마다 계산량이 다르며, 그 차이는 비용과 지연 측정에 반영된다. ↩︎
최초 실험 기간에는 JEV, GPT 판정자 3종, PairRM만 평가했다. 다른 모델 계열은 그 결과를 확인한 뒤 1,312건 전체에 추가했으므로, 연구진은 여러 모델 계열의 비교를 탐색적 분석으로 분류했다. 판정자마다 순서를 뒤집은 선호 쌍 750개와 반복 요청, 루브릭 문구 변경을 포함한 진단 요청 894건도 따로 실행했다. ↩︎
재판정 대상은 판정자 간 불일치로 선정한 183문항이며, 벤치마크 전체의 무작위 감사는 아니다. 한 명이 모든 문항을 판정했고, 그는 문항별 결과는 보지 않았지만 집계 결과는 본 논문 저자였다. 183문항 중 36문항은 판단 보류로 남았다. 주요 결과는 모두 원래 벤치마크 레이블로 계산했고, 재판정 결과는 민감도 분석에만 썼다. ↩︎
PairRM은 쌍 입력을 2,048토큰으로 잘라서 처리하므로 RewardBench 7쌍과 JudgeBench 59쌍이 잘렸다. 잘리지 않은 쌍만 계산하면 67.7%와 53.3%다. PairRM은 루브릭을 받지 않는 독립 순위 모델이다. Skywork는 응답마다 점수를 매기므로 두 점수를 비교했고, 동점은 0.5점으로 셌다. ↩︎
Brier 점수는 예측 확률과 실제 결과 사이 제곱 오차의 평균으로, 낮을수록 확률이 정확하다. 오류 탐지 AUROC는 1에서 q를 뺀 값을 점수로 삼아 오답을 정답보다 높은 순위로 매기는 정도이며, 0.5가 무작위 수준이다. 연구진은 NLL과 10구간 ECE도 함께 보고했다. ↩︎
모델 그룹 하나씩 차례로, 작업자 8개와 최소 시작 간격 0.12초 조건에서 측정했다. 지연은 네트워크, 제공사, 재시도 시간을 포함하며 순수 추론 시간이나 처리량과는 다르다. 비용은 수집 당시 가격과 보고된 사용량으로 추정한 값이고 청구서 금액은 아니다. 사용량이 누락된 호출에는 보수적인 예약 금액을 매겼다. ↩︎
원문 표 2의 안내는 측정 결과를 서술한 것이다. ‘지원 안 됨’은 시험한 모든 판정자가 우연 수준이었다는 뜻이다. 비교 대상은 작업마다 시험한 판정자 중 가장 강한 판정자다. ↩︎
단일 순서 캐스케이드의 기준값은 채점 대상 문항에서 사후적으로 읽은 값이다. 미리 정한 규칙을 시험한 것은 다음 절의 두 순서 고정 정책뿐이다. ↩︎
GPT-5.4의 보수적 비용 비율 1.096이 1보다 큰 것은 사용량이 누락된 호출에 예약 금액을 매겼기 때문이다. 표의 결과는 모두 오프라인 시뮬레이션이다. 2차 판정자 9종 전체의 결과는 원문 부록 표 11에 있다. ↩︎