3줄 요약
- 일본 개발자 pentacoxian(@pentacoxian_dev)이 2026년 10월 11일에 Turbo LoRA와 코드를 공개했다. 이 LoRA를 적용하면 Speridlabs가 사흘 전 내놓은 이미지 생성 모델 Iris-3B가 4스텝만으로 이미지를 만든다.
- Iris-3B는 VAE를 거치지 않고 픽셀을 직접 생성하는 30억 파라미터 모델이다. 기본 설정(100스텝, 매 스텝 CFG)에서는 1024×1024 이미지 한 장을 만드는 데 포워드 패스가 약 200번 필요해서, M3 Max 노트북에서 9~11분이 걸렸다.
- pentacoxian은 증류 기법 DMD2로 CFG의 효과까지 LoRA가 학습하게 해서 포워드 패스를 4번으로 줄였다. 생성 시간은 RTX 5090에서 0.68초, M3 Max에서 약 11초가 됐다. 공개 첫날에는 여러 사용자가 Hugging Face 웹 데모, RTX 5090, 아이폰, 스냅드래곤 NPU에서 직접 실행한 결과를 올렸다.
트윗 타래와 인용 관계
pentacoxian이 처음 올린 글은 트윗 두 개짜리 타래다. 첫 트윗의 내용은 다음과 같다.
Iris-3B의 100스텝을 4스텝으로 줄인 Turbo LoRA를 만들었습니다. 빠르면 1초 안에 1024×1024 해상도 이미지를 픽셀 공간 확산(Pixel space diffusion)으로 생성할 수 있습니다!
픽셀 공간에서 직접 생성하는 방식(VAE 없음)은 디테일에 강한 반면 계산이 무거워서, 원래의 100스텝으로는 M3 Max에서 몇 분에서 십수 분이 걸리는 것이 약점이었습니다. 이것을 4스텝과 CFG 베이크로 단번에 개선했습니다.
- RTX 5090: 약 0.7초
- M3 Max: 약 11초(
--preset mac16에서 피크 약 7GB)Hugging Face Spaces 데모도 있으니 꼭 속도를 체감해 보세요!
두 번째 트윗에는 코드 저장소(GitHub pentaCoxian/iris-3b-turbo)와 LoRA 가중치(Hugging Face pentacoxian-dev/iris-3b-turbo-lora) 링크가 있다. 이 타래는 일본의 AI 해설 계정 studio_yebisu가 Iris-3B를 소개한 글을 인용했고, 그 글은 다시 Speridlabs의 공개 트윗을 인용했다.
Iris-3B는 어떤 모델인가
Iris-3B는 Speridlabs가 2026년 10월 8일 X에 공개한 텍스트 투 이미지 모델이다.1 저자는 Hanqiu Li Cai와 Chema Garabito 두 사람이다. 공개 트윗은 모델을 이렇게 소개했다.
Iris-3B를 소개합니다. 모든 픽셀을 직접 생성하는 픽셀 공간 텍스트 투 이미지 모델이자 범용 비전 학습기입니다. VAE는 없습니다. 처음부터 사전학습한 30억 파라미터 모델이고 가중치를 공개합니다. 디테일이 중요한 비전 과제인 깊이 추정과 이미지 복원에 이 모델이 생성 학습으로 얻은 사전지식을 활용하는 방법도 탐구했습니다. 가중치, 코드, 데모 모두 공개입니다(Apache 2.0).
VAE를 뺀다는 것의 의미
Stable Diffusion이나 FLUX 같은 기존 이미지 생성 모델은 VAE(변분 오토인코더)라는 별도의 신경망을 쓴다. VAE가 이미지를 작은 압축 표현으로 바꾸면, 생성 모델은 이 표현의 공간(잠재 공간)에서 이미지를 만들고, 마지막에 VAE가 결과를 다시 이미지로 복원한다. 압축 덕분에 계산량이 크게 줄어 고해상도 이미지를 다루기 쉬워졌다.
그 대가로 압축과 복원 과정에서 작은 글자나 가는 선 같은 세부가 사라질 수 있다. studio_yebisu의 해설은 이 점을 이렇게 설명했다. 생성 모델이 아무리 잘 만들어도, 마지막에 이미지로 되돌리는 VAE가 표현하지 못하는 세부는 결과에 나타나지 않는다. Iris-3B는 VAE 없이 RGB 픽셀을 직접 생성해서 이 제약을 없앴다. Speridlabs는 VAE의 잠재 표현이 정보를 잃는 압축이고 질감 위주로 편향되어 있다고 설명했다.
구조
| 항목 | 내용 |
|---|---|
| 파라미터 | 30억(고정된 텍스트 인코더 제외) |
| 입력 단위 | 이미지를 16×16 픽셀 패치로 잘라 처리 |
| 본체 | 폭 2560의 트랜스포머 블록 24개. 이미지와 텍스트에 각각 다른 가중치를 쓰는 블록 8개, 둘을 합쳐 처리하는 블록 16개 |
| 픽셀 헤드 | 작은 픽셀 트랜스포머(PiT) 블록 4개가 각 패치 토큰을 다시 픽셀로 복원 |
| 텍스트 인코더 | Qwen3-VL-4B-Instruct(학습하지 않고 고정) |
| 학습 목표 | 정류 흐름(rectified flow) |
2차원 RoPE 위치 인코딩을 쓰기 때문에 같은 가중치로 100만 화소 이하의 여러 해상도와 가로세로 비율의 이미지를 생성한다. Speridlabs는 패치 단위 트랜스포머 다음에 픽셀 단위 트랜스포머를 두는 2단 설계를 PixelDiT 논문에서 가져왔고, 코드는 독자적으로 구현했다고 밝혔다.
학습은 256×256, 512×512, 1024×1024 해상도의 3단계 사전학습과 지도 미세조정으로 이루어졌고, 스텝 수는 모두 합쳐 66만 5천이다. 첫 단계에서는 모델의 내부 표현을 DINOv2의 표현과 일치시키는 REPA 기법을 함께 적용했고, 옵티마이저는 Muon과 AdamW를 섞어 썼다. 학습 코드와 설정 파일도 모두 공개했다.
벤치마크
Speridlabs는 공식 평가기로 1024×1024 해상도에서 점수를 측정해 공개했다. 프롬프트를 다시 쓰거나 여러 장 중 가장 나은 한 장을 고르는 과정은 거치지 않았다. 일부 모델만 추리면 다음과 같다.
| 모델 | GenEval | DPG | LongText | OneIG |
|---|---|---|---|---|
| FLUX.1-dev 12B | 0.66 | 83.8 | 0.607 | 0.434 |
| HiDream-I1-Full | 0.83 | 85.89 | 0.543 | 0.477 |
| Z-Image 6B2 | 0.84 | 88.1 | 0.935 | 0.546 |
| Qwen-Image 20B | 0.87 | 88.3 | 0.943 | 0.539 |
| Iris-3B | 0.798 | 86.52 | 0.857 | 0.540 |
OneIG 점수는 Qwen-Image 20B와 같은 수준이다. studio_yebisu는 Iris-3B의 파라미터가 Qwen-Image의 절반에도 못 미친다는 점을 강조했다. GenEval, 그리고 긴 글자 렌더링을 평가하는 LongText에서는 Qwen-Image와 Z-Image가 더 높다. Speridlabs는 경쟁 모델이 학습에 쓴 연산량의 일부만 들여 이 성능을 냈다고 주장했다.
깊이 추정과 이미지 복원, 그리고 논문의 결론
Speridlabs는 같은 본체를 구조 변경 없이 미세조정해 다른 과제에도 쓰고, 그래서 Iris-3B를 범용 비전 학습기라고 부른다. 이번에는 미세조정 모델 두 개가 함께 공개됐다. 깊이 추정 모델은 사진을 받아 앞뒤 거리를 나타내는 깊이 지도를 출력하고, 복원 모델은 화질이 떨어진 이미지를 복원하면서 4배로 확대한다. 두 모델 모두 빈 프롬프트를 넣고 포워드 패스 한 번에 결과를 낸다.
하지만 arXiv 논문의 초록을 보면 연구진이 처음에 세운 가설은 실험에서 확인되지 않았다. 연구진은 “VAE로 인한 정보 손실이 없으니 세부가 중요한 과제에서는 픽셀 공간 모델이 유리할 것"이라고 예상하고 이를 검증했다. 실험에서는 픽셀 공간 생성 모델의 사전지식을 쓴 이점이 유의미하게 나타나지 않았다. 깊이 추정에서는 Iris-3B와 잠재 공간 모델인 FLUX.2 Klein의 성능이 비슷했다. 논문은 FLUX.2 Klein을 픽셀 공간으로 변환한 모델도 함께 시험했는데, 4배 복원에서는 Iris-3B와 이 변환 모델 모두 원래의 잠재 공간 FLUX.2 Klein보다 높은 점수를 내지 못했다. studio_yebisu도 “이것으로 글자와 세부가 모두 좋아진다는 것까지는 실증되지 않았다"고 적었다.
저자들은 성과도 함께 정리했다. 픽셀 공간 사전학습을 30억 파라미터 규모까지 확장했고, 그렇게 학습한 모델로 잠재 공간 모델과 겨룰 만한 생성 품질을 얻었다.
100스텝이 왜 느린가
확산 모델은 노이즈 상태에서 시작해 여러 단계를 거치며 조금씩 이미지를 선명하게 만든다. 한 단계마다 신경망 전체를 한 번 실행하는 포워드 패스가 필요하다. CFG(classifier-free guidance)를 쓰면 같은 단계에서 계산을 두 번 한다. 프롬프트를 넣은 계산과 넣지 않은 계산이다. 두 결과의 차이를 증폭하면 이미지가 프롬프트를 더 충실히 따르는 대신, 단계마다 포워드 패스가 두 번 필요해진다.
Iris-3B의 기본 샘플러는 DPM-Solver++ 100스텝에 CFG 스케일 3을 매 스텝 적용한다. 그래서 이미지 한 장에 포워드 패스가 약 200번 필요하다. pentacoxian이 M3 Max(40코어 GPU)에서 잰 바로는, 1024×1024 한 스텝에 CFG를 포함하면 약 6.4초가 걸리고 CFG 없이 포워드 패스 한 번만 하면 약 3.1초가 걸린다. 100스텝이면 이미지 한 장에 약 11분이 드는 셈이다.
첫 번째 최적화: 학습 없이 줄이기
pentacoxian은 Speridlabs의 저장소를 포크해 iris-3b-turbo를 만들고, 이 포크에 학습 없이 쓸 수 있는 가속 옵션 세 가지를 먼저 추가했다. 세 옵션 모두 품질을 일부 희생하므로, 사용자가 각자 쓰는 프롬프트로 기본값과 비교해 보라고 권했다.
--steps 30: 2차 DPM-Solver++는 보통 100스텝보다 훨씬 적은 단계로도 충분하다. 비용은 단계 수에 비례한다.--cfg-interval 0 0.9: 노이즈가 가장 많은 초반 단계에서는 CFG를 생략해 포워드 패스를 한 번만 한다. 기본 설정에서는 전체 단계의 약 3분의 1이 이 초반 단계에 해당한다.--cache-threshold 0.1: 인접한 두 단계에서 첫 번째 블록의 입력이 거의 바뀌지 않으면 본체의 출력을 재사용한다. 재사용한 단계는 일반 단계 비용의 약 15%만 든다. 픽셀 헤드는 항상 현재 이미지로 다시 계산하고, 재사용은 최대 3단계 연속까지만 한다.
M3 Max에서 스텝 수를 30으로 줄이고 CFG 생략 구간을 함께 쓰면(--steps 30 --cfg-interval 0 0.9) 약 2.6분이 걸렸다. 캐시 옵션까지 켜고 측정한 이미지 한 장은 30단계 중 18단계에서 본체 출력을 재사용했고, 생성 시간은 77초였다. 77초도 노트북에서 이미지 한 장을 기다리기에는 긴 시간이다.
두 번째 최적화: Turbo LoRA
증류와 CFG 베이크
Turbo LoRA는 증류(distillation)로 만들었다. 100스텝으로 이미지를 만드는 원래 모델을 교사로 두고, 4스텝만으로 비슷한 이미지를 만들도록 학생 모델을 학습시키는 방식이다. 교사는 CFG 스케일 3을 적용한 상태의 원래 모델이므로, 학생은 CFG가 적용된 결과를 포워드 패스 한 번으로 내도록 배운다. pentacoxian은 트윗에서 이 과정을 “CFG 베이크"라고 불렀다. 그 결과 단계마다 포워드 패스가 한 번으로 줄어, 이미지 한 장에 필요한 포워드 패스가 약 200번에서 4번이 됐다.
증류 방법은 DMD2(분포 일치 증류)에서 GAN 손실 항을 뺀 형태다. DMD 계열은 학생이 만드는 이미지 전체의 분포를 교사의 분포와 일치시키도록 학습한다. 학생의 출력을 교사의 출력과 하나씩 짝지어 비교하지는 않는다. 이를 위해 학생이 만든 이미지만 보고 학습하는 비평자(critic) 모델을 따로 둔다. 학생이 만든 이미지에 노이즈를 섞은 뒤 교사와 비평자가 각각 그 노이즈를 제거하게 한다. 두 예측의 차이는 학생의 분포가 교사의 분포와 얼마나 다른지를 나타내고, 학생은 이 차이가 줄어들도록 갱신된다.
가중치 사본 하나로 세 모델 돌리기
교사, 학생, 비평자는 원래 모델의 bf16 가중치 사본 하나를 함께 쓴다. 이 가중치는 고정하고, 학생과 비평자에는 각각 LoRA 어댑터를 하나씩 추가했다. LoRA 어댑터는 원래 가중치를 바꾸지 않고 작은 추가 가중치만 학습하는 부품이다. 교사는 어댑터 없는 원래 가중치 그대로다. 학습 대상은 랭크 64짜리 어댑터 두 개로 한정된다.
pentacoxian은 학습 데이터로 이미지를 한 장도 쓰지 않았다. 학생이 만든 이미지와 교사의 예측만으로 학습하므로 프롬프트만 있으면 된다. PartiPrompts 1,632개 전부와 improved-flux-prompts에서 뽑은 6,000개, 합계 7,632개의 프롬프트를 썼다. 학습은 RTX 5090 한 장(반복당 약 1.4초, 메모리 약 18GB)으로 했고, 텍스트 인코더는 별도의 RTX 4090에서 돌렸다.
학습 세부
- 학생은 시간값 t가 1.0, 0.923, 0.8, 0.571인 네 단계로 이미지를 만든다. 한 단계를 마치면 예측한 이미지에 새 노이즈를 섞어 다음 단계의 입력으로 쓴다.
- 학습에는 역방향 시뮬레이션을 썼다. 학생을 그래디언트 없이 무작위 횟수만큼 먼저 실행한 뒤 마지막 한 단계에만 그래디언트를 계산한다. 이렇게 하면 학생은 추론 때 실제로 받게 될 중간 입력으로 학습한다.
- 학생을 한 번 갱신할 때 비평자는 다섯 번 갱신한다. 학생의 분포가 바뀌어도 비평자가 그 분포를 계속 정확히 배우게 하려는 설정이다.3
- 어댑터는 패치 임베딩, 시간 임베딩, 트랜스포머 블록, 픽셀 단계, 최종 층에 포함된 모든 선형 층에 적용했다. 어댑터 하나는 약 1억 1,500만 파라미터이고, fp32로 저장하면 460MB다.
- 학습 해상도는 반드시 100만 화소 안팎이어야 한다. 원래 체크포인트는 512×512에서 16픽셀 크기의 블록 모양 결함을 보이고, 512×512로 학습한 학생은 이 결함까지 그대로 배운다.
두 번의 학습과 공개 버전
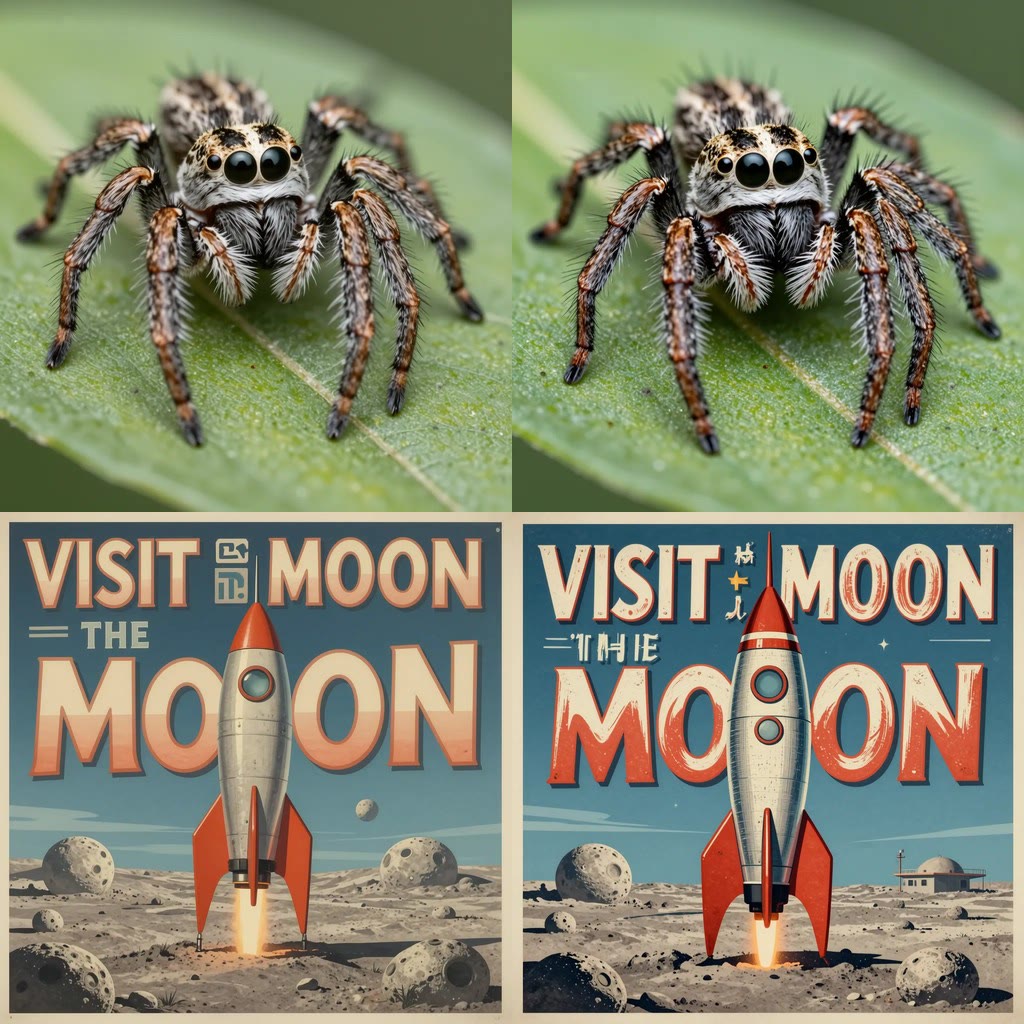
첫 번째 학습(r1)은 학습률 5e-5로 처음부터 진행했다. 1,500번째와 1,750번째 반복 사이에 학생이 질감만 남은 이미지를 내는 상태로 붕괴해서, 붕괴 직전인 1,500번째 반복을 r1-1500으로 공개했다. 이 버전은 일부 시드에서 여우 두 마리가 몸 하나를 공유하는 식으로 피사체를 합쳐 버린다.
두 번째 학습(r2)은 r1-1500에서 이어서 학습률을 절반인 2.5e-5로 낮추고, 학생 가중치의 지수이동평균(EMA)을 함께 유지했다. 미리보기 이미지의 명암 대비가 떨어지면 자동으로 멈추는 장치도 넣었다. r2는 1,500번째 반복까지 붕괴하지 않았다. pentacoxian은 결과를 눈으로 비교해 1,000번째 반복(누적 2,500번)을 r2-1000으로 골랐고, 이것이 권장 버전이다.
세 번째 최적화: 메모리 16GB 맥에서 돌리기
--preset mac16은 메모리 16GB인 맥에서 실행하기 위한 설정이다. 네 가지를 조합한다.
- 프롬프트 인코딩은 잠깐 실행되는 별도 프로세스에서 끝낸다. 그래서 텍스트 인코더와 이미지 모델이 메모리에 동시에 올라가지 않는다.
- 이미지 모델은 텐서 단위로 하나씩 GPU 메모리에 올리면서, 그동안 LoRA를 병합한다.
- 텍스트 인코더와 이미지 본체의 가중치를 int8로 양자화한다.
- 이미지를 한 장씩 생성한다.
측정에는 M3 Max를 썼고, GPU 메모리 할당은 16GB 맥의 작업 한도인 약 10.7GB로 제한했다. 이때 측정한 피크 메모리는 다음과 같다.
| 설정 (1024×1024, Turbo) | 피크 메모리 |
|---|---|
| FP32 가중치, 텍스트 인코더 상주 | 30.3GB |
| BF16 가중치(기본값), 텍스트 인코더 상주 | 24.3GB |
--preset mac16 --quantize none | 9.3GB |
--preset mac16 (int8) | 6.9GB |
int8로 양자화한 텍스트 인코더의 임베딩은 원래 임베딩과 코사인 유사도 0.9999를 유지했다. 4스텝 생성 결과는 bf16 결과와 비교해 PSNR이 28~38dB였고, 눈으로 보기에 차이가 없었다고 pentacoxian은 밝혔다.
결과: 속도 정리
모델 카드에 실린 측정값이다. 해상도 1024×1024에서 예열을 마친 뒤, 프롬프트 인코딩까지 포함해 잰 전체 시간이다.4
| 하드웨어 | 4스텝 Turbo | 비고 |
|---|---|---|
| NVIDIA RTX 5090 (bf16) | 장당 0.68초 | 배치 1에서 분당 88장 |
| Hugging Face ZeroGPU | GPU 시간 약 1.1초 | 요청마다 ZeroGPU 연결에 약 3초 추가 |
| Apple M3 Max 40코어 GPU (bf16) | 장당 약 10~11초 | |
Apple M3 Max, --preset mac16 (int8) | 장당 약 11초 | 피크 메모리 약 7GB |
같은 M3 Max에서 원래 모델의 기본 100스텝 샘플러는 장당 약 9~11분이 걸린다. 저장소에는 세 모드의 시간을 같은 프롬프트와 시드로 재는 Gradio 페이지 demo/speed.py도 들어 있다. 세 모드는 Fast(4스텝 Turbo), Balanced(학습 없는 30스텝 설정), Standard(100스텝)다.
공개 하루 동안의 사례
타래의 첫 트윗에는 직접 실행한 결과를 덧붙인 인용 글이 여러 건 달렸다. 영상이나 측정값이 있는 네 건을 소개한다.
Space 데모에서 1.12초
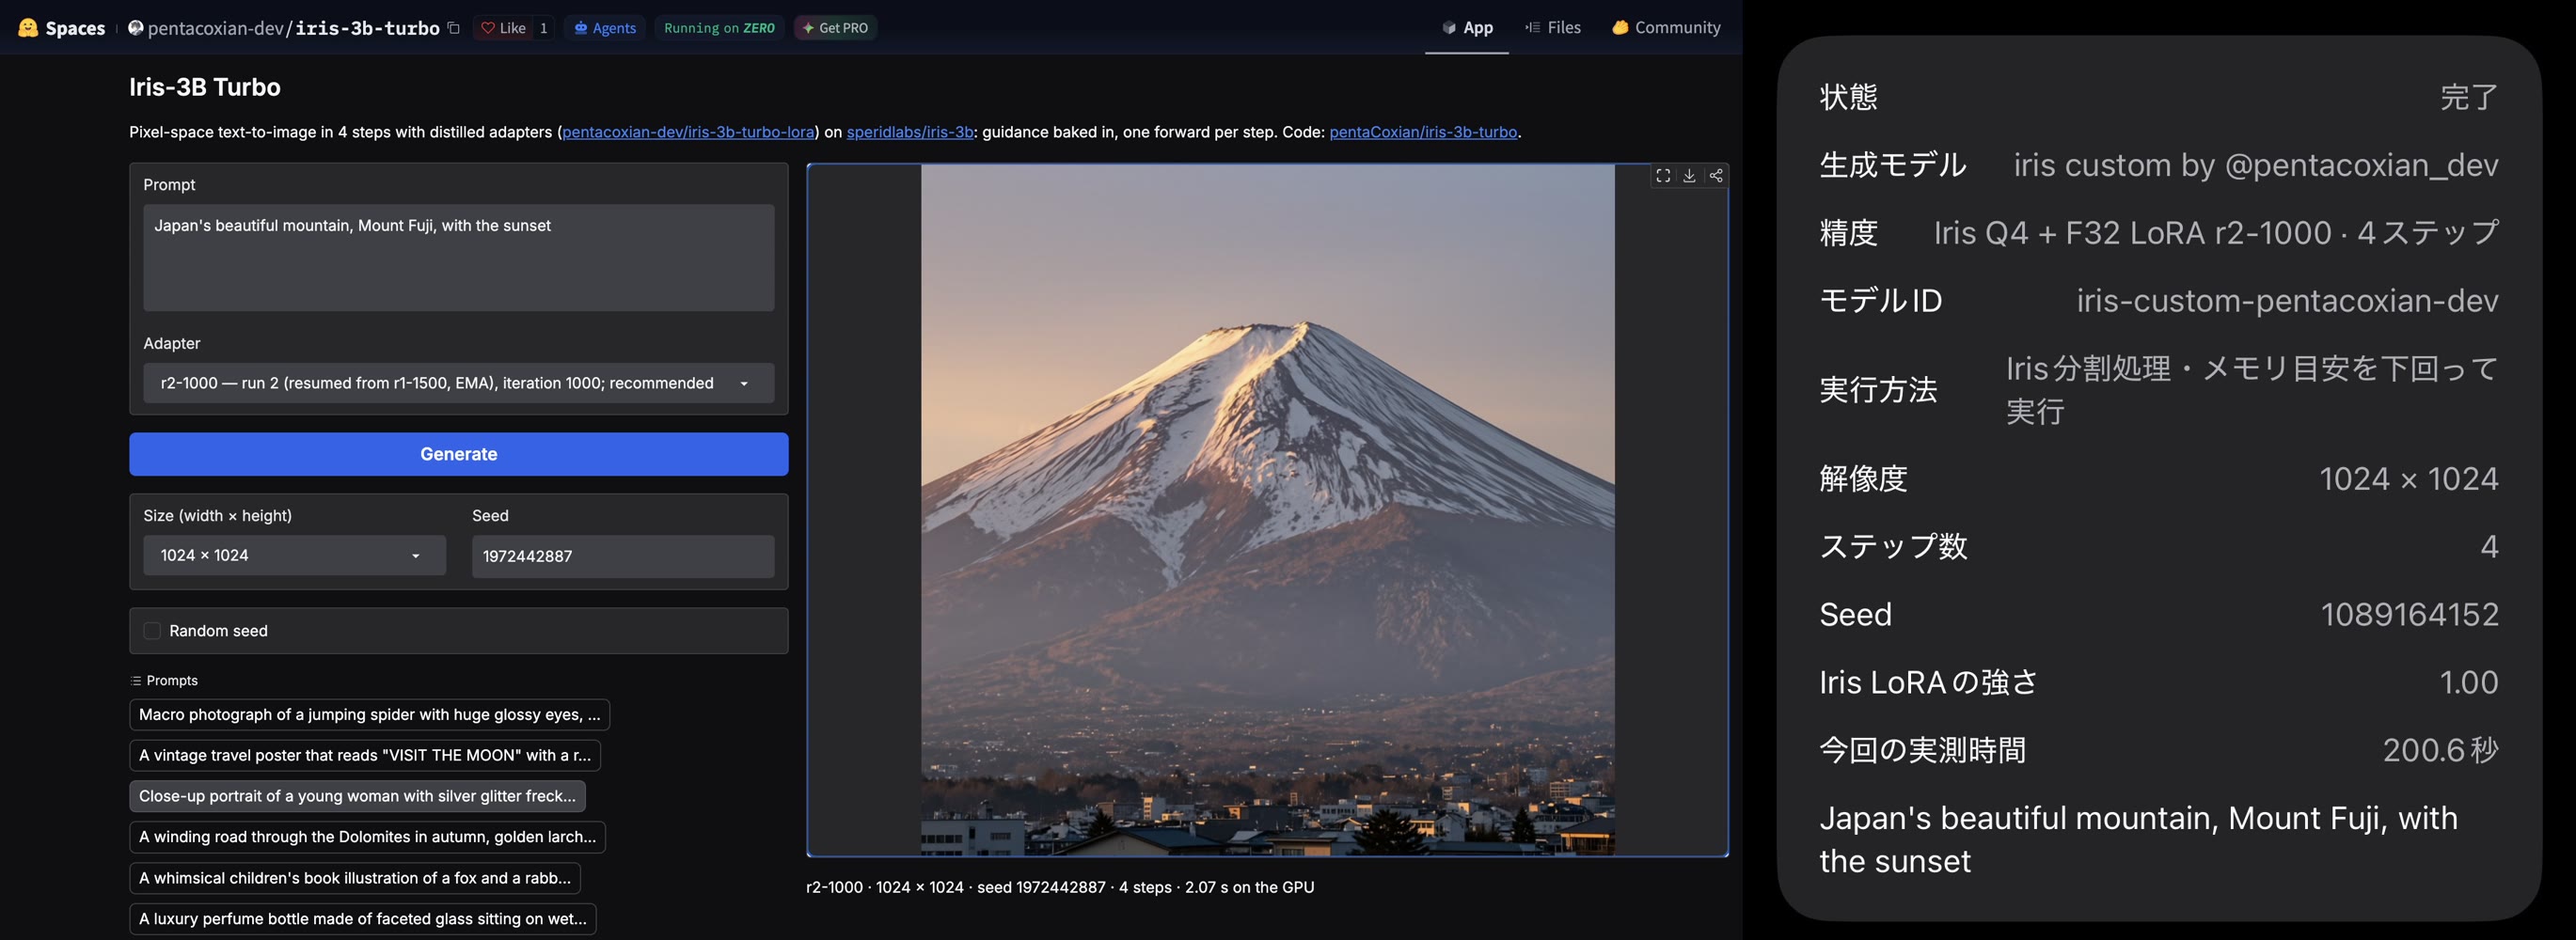
studio_yebisu는 pentacoxian의 Hugging Face Space에서 1024×1024 인물 사진을 생성하는 화면을 녹화해 올렸다. 화면 아래에는 r2-1000 어댑터, 4스텝, GPU 1.12초라는 표시가 나온다. 그는 “VAE 없이 1024×1024 이미지를 1.12초에 만드는 것은 너무 빠르다"고 적었다. 발표된 지 이틀 된 모델을 pentacoxian이 빠르게 돌아가도록 개조해 GitHub와 Hugging Face에 벌써 공개한 점에도 놀랐다고 했다. Speridlabs의 공동 저자 Chema Garabito는 이 글을 리트윗했다.
RTX 5090에서 0.9초
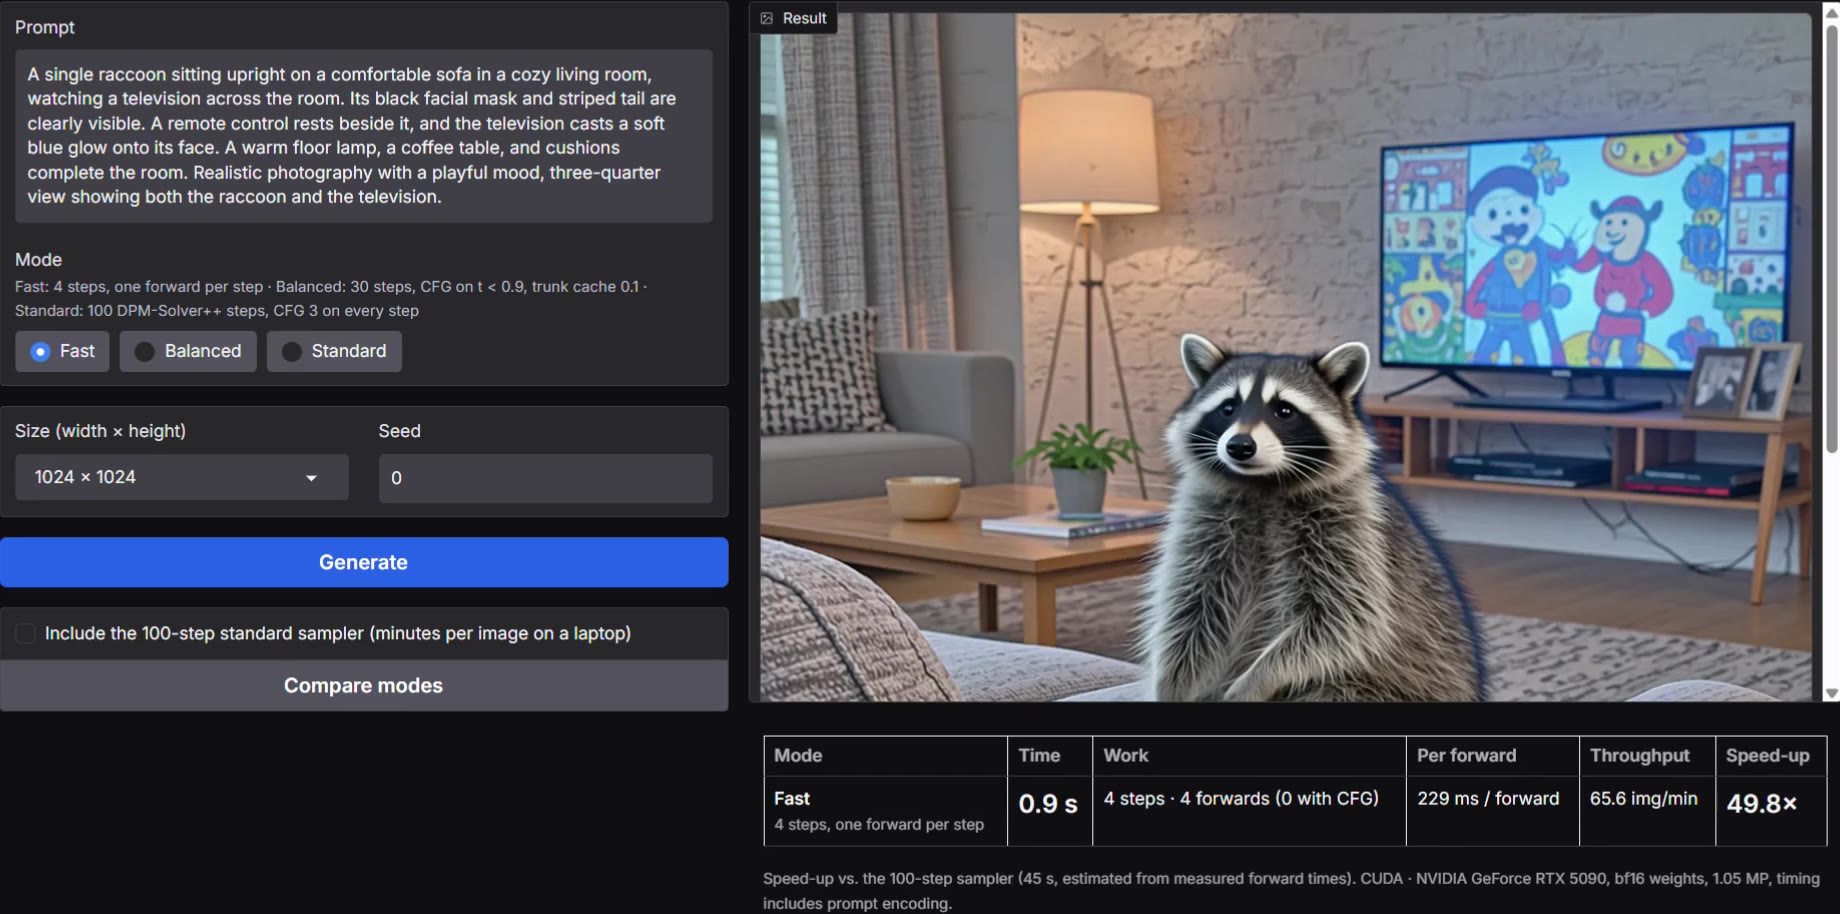
“RTX 5090 약 0.7초"라는 문장을 본 jun1228909는 직접 시험해 보았다. 로컬에서 demo/speed.py를 띄우고 Fast 모드로 고양이, 눈 덮인 숲의 사슴, 해변을 달리는 남녀, 우주 헬멧을 쓴 오리, 텔레비전을 보는 너구리를 연달아 생성했다. 측정표에는 장당 0.9초, 포워드 한 번에 약 229ms, 분당 약 65장이라고 나온다. 100스텝 샘플러의 소요 시간은 데모가 포워드 측정값으로 추정한 45초이고, 표는 이를 기준으로 49.8배 빠르다고 표시한다. 그는 “생성 시간이 1초 미만이라는 것은 초당 1프레임짜리 영상을 실시간으로 생성할 수 있다는 뜻"이라고 덧붙였다.
아이폰 15 Pro에서 200초
아이폰 15 Pro에서는 4스텝 생성에 200.6초가 걸렸다. SORA_LNV는 자신이 만든 로컬 모델 실행 앱에서 이 LoRA를 쓸 수 있게 했다. 4비트로 양자화한 Iris 본체에 fp32 r2-1000 LoRA를 적용했고, 메모리 사용량을 미리 정한 기준치보다 적게 유지하려고 모델을 나눠 처리했다. 같은 프롬프트를 Space에서 생성했을 때는 2.07초였다. 그는 두 결과물의 품질을 구별할 수 없다고 했다.
스냅드래곤 X Elite NPU
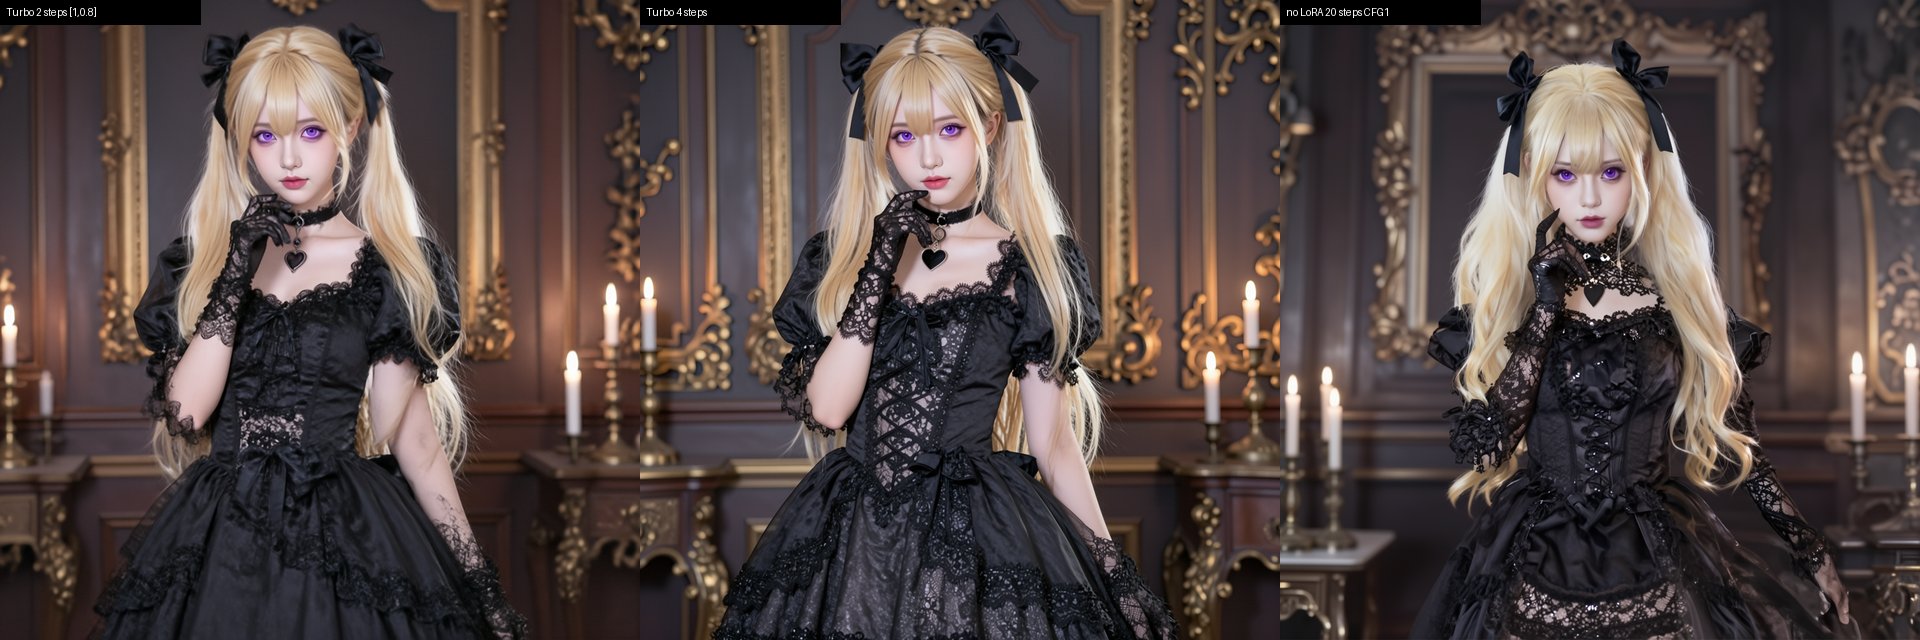
Zimo41650079726은 Iris-3B 본체 전체를 스냅드래곤 X Elite의 NPU에서 FP16으로 실행했다. 1024×1024 기준으로 Turbo 2스텝은 35초, Turbo 4스텝은 68초였다. LoRA 없이 CFG 스케일 1로 20스텝을 생성했을 때는 319초가 걸렸다.
같은 날 다른 개발자도 Turbo LoRA와 무관한 방식으로 Iris-3B를 가속한 결과를 공개했다.5
한계
pentacoxian은 모델 카드에 한계를 직접 정리해 두었다.
- 정성 평가뿐이다. FID나 GenEval 같은 벤치마크는 실행하지 않았고, 고정한 프롬프트와 시드에서 눈으로 품질을 판단했다.
- 글자 표현이 약하다. 단어가 반복되거나 뭉개지는 경우가 많다.
- 일부 시드에서 구도 오류가 생긴다. 피사체가 합쳐지거나 중복되며, r1-1500에서 더 자주 나타난다.
- 결과의 다양성이 원래 샘플러보다 떨어진다. DMD 계열 학생은 명암 대비가 강한 전형적인 이미지를 내놓는 경향이 있다.
- 100만 화소 안팎에서만 시험했다. 1024×1024와 그에 가까운 가로세로 비율만 확인했다.
- adaLN 공유 모듈의 어댑터가 작동하지 않았다. 공개한 두 버전에서는 버그 때문에, 확산 단계의 시간값에 따라 각 층의 출력을 조절하는 adaLN 공유 모듈의 어댑터가 포워드 패스에서 한 번도 쓰이지 않았다. 따라서 이 어댑터의 값은 정확히 0이고, 시간값에 따른 조절은 학습되지 않았다. 버그는 포크에서 고쳤고, 다음 학습부터는 이 모듈도 학습한다.
가장 흥미로운 지점
일주일 사이에 Iris-3B를 두고 나온 두 평가를 함께 읽으면 조금 묘한 기분이 든다. 논문은 VAE를 빼면 세부가 중요한 과제에서 유리할 것이라는 처음의 가설을 데이터가 뒷받침하지 못했다고 보고했다. 반면 공개 트윗이 나오고 사흘이 지나자, 다른 사람이 만든 LoRA 하나로 이 모델은 노트북과 아이폰에서도 실행되는 가볍고 빠른 생성 모델이 됐다. 연구진이 가중치와 학습 코드를 Apache 2.0으로 공개해 두었고, 외부 개발자는 그 덕분에 이 모델을 곧바로 새 용도에 맞게 고칠 수 있었다.
포워드 패스를 200번에서 4번으로 줄이는 데 든 자원은 적었다. 학습 데이터는 이미지 한 장 없이 프롬프트 7,632개가 전부였고, 학습한 대상은 랭크 64 어댑터 두 개였으며, 학습에 쓴 GPU는 RTX 5090 한 장과 텍스트 인코더용 RTX 4090 한 장이었다. 게다가 어댑터 가운데 adaLN 공유 모듈에 해당하는 부분은 버그 때문에 0인 채로 남아 있었는데도 이 결과가 나왔다. 그 부분까지 학습한 다음 버전이 얼마나 달라질지는 아직 아무도 모른다.
출처
- pentacoxian(@pentacoxian_dev), Iris-3B Turbo LoRA 공개 트윗 타래, 2026-10-11
- pentacoxian, pentaCoxian/iris-3b-turbo (GitHub, Speridlabs 저장소의 포크)
- pentacoxian, pentacoxian-dev/iris-3b-turbo-lora (Hugging Face 모델 카드), Iris-3B Turbo Space
- studio_yebisu, Iris-3B 해설 트윗, 2026-10-08
- Speridlabs(@speridlabs), Iris-3B 공개 트윗, 2026-10-08
- Speridlabs, Iris-3B 프로젝트 페이지, speridlabs/iris-3b (GitHub), speridlabs/iris-3b (Hugging Face)
- Hanqiu Li Cai, Chema Garabito, Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning, arXiv:2610.09450, 2026-10-07
- 사용자 사례: @studio_yebisu, @jun1228909, @SORA_LNV, @Zimo41650079726, 2026-10-11
프로젝트 페이지의 게시일은 10월 5일, arXiv 제출일은 10월 7일, X 공개 트윗은 10월 8일(UTC)이다. ↩︎
Z-Image 6B의 점수는 프롬프트 재작성을 사용한 결과다. 다른 모델의 점수는 Qwen-Image와 Z-Image 보고서에서 가져왔다고 Speridlabs가 밝혔다. ↩︎
그 밖의 설정은 다음과 같다. DMD 노이즈 수준은 시간 이동 전 기준으로 t가 0.02 이상 0.98 이하이고, DMD 그래디언트는 샘플마다 정규화한다. 옵티마이저는 AdamW이고 베타 값은 0과 0.999다. 배치는 1, 해상도는 1024×1024, 그래디언트 클리핑은 1.0이다. ↩︎
저장소 README에는 4스텝 생성이 M3 Max에서 약 11~13초, RTX 5090에서 약 0.9초라고 적혀 있다. jun1228909의 영상에 나오는 0.9초는 프롬프트 인코딩을 포함한 값이다. ↩︎
ANAg2bGOD가 공개한 Apple Silicon용 추론 엔진이다. 그는 자신의 맥북에서 10스텝 추론이 원래 구현의 346초에서 42초로 약 8.2배 빨라졌고 피크 메모리는 약 10GB라고 밝혔다. 깊이 추정과 4배 복원도 지원하는 macOS 앱도 함께 제공한다(트윗). ↩︎