3줄 요약
- 멀티모달 AI 스타트업 Elorian이 시각 추론 모델 Glimpse를 API와 웹 채팅 인터페이스로 공개했다. 오픈웨이트 기반 모델에 수백 대 규모의 GPU만으로 사후학습을 적용해 만든 모델이다.1
- Glimpse는 텍스트로만 추론을 이어 가지 않는다. 추론 도중 이미지의 특정 영역을 확대하고 비디오의 모호한 구간을 더 높은 프레임 빈도로 다시 확인하며, 멀티모달 도구를 호출하고 서브에이전트를 조율해 시각적 근거를 검증한다.
- API 단가는 백만 토큰당 입력 0.6달러, 출력 3달러로 GPT-6 Astra보다 94%, Claude Opus 5.5보다 85% 저렴하다. 그러면서도 과학 차트 추론, 개방형 어휘 개수 세기, 단편 비디오 캡셔닝, 로봇 조작 사건 이해에서는 두 프론티어 모델과 대등하거나 더 높은 점수를 냈다.
시각적 사고를 추론 과정에 통합한 모델
출처: Elorian
Glimpse는 눈에 보이는 장면을 단서 삼아 물리 세계의 인과와 상태를 추론하도록 설계된 시각적 사고(visual thinking) 모델이다. 움직이는 물체나 바뀌는 시점에서도 대상을 일관되게 추적하고, 부품들이 맞물리는 구조를 파악하며, 현재 관찰한 장면이 다음 순간 어떤 물리적 결과로 이어질지 연결한다. 이러한 능력은 로보틱스, 과학 연구, 미디어 제작처럼 물리적 공간과 시간의 변화를 다루는 분야에서 핵심적인 역할을 한다.
기존 프론티어 대형 언어 모델들이 첫인상으로 얻은 텍스트 요약에 의존해 답을 내린다면, Glimpse는 추론 과정에서 시각 표현을 직접 다룬다. 생각이 전개되는 동안 내부 시각 표현을 반복해서 다시 확인하고 정밀하게 고치는 식이다. 에이전트로서도 코드를 작성하고 이미지를 변환하며 비디오를 탐색하는 멀티모달 도구를 종단간(end-to-end) 학습으로 익혔다. 나아가 하나의 문제를 풀기 위해 텍스트, 시각 산출물, 내부 표현을 서로 주고받는 서브에이전트들을 생성하고 조율할 수도 있다. Elorian 플랫폼의 채팅 화면은 이러한 시각적 작업 공간(visual scratch space)을 실시간으로 표시한다. 사용자는 모델이 특정 영역을 확대하거나 짧은 시간 구간을 더 촘촘한 프레임 빈도로 다시 재생하는 과정을 직접 확인할 수 있다.
프론티어 모델과의 가격 및 벤치마크 비교
Elorian은 소규모 팀과 수백 대의 GPU만으로 오픈웨이트 기반 모델을 사후학습해 Glimpse를 개발했다. API 가격은 캐시 미적용 기준 백만 토큰당 입력 0.6달러, 출력 3달러다. 이는 GPT-6 Astra보다 94%, Claude Opus 5.5보다 85%, GPT-6.1 Sol보다 70% 저렴하며, Gemini 3.8 Flash의 초기 할인가와 비교해도 20% 낮은 금액이다.
| 단가 (USD / 1M 토큰) | Glimpse | GPT-6 Astra | GPT-6.1 Sol | Opus 5.5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| 입력 (캐시 미적용) | 0.60 | 10.00 | 2.00 | 4.00 | 0.75 |
| 출력 | 3.00 | 50.00 | 10.00 | 20.00 | 3.75 |
멀티모달 벤치마크 전반에서도 Glimpse는 상위 프론티어 모델들과 경쟁력 있는 성적을 기록했다.2 과학 차트 추론(CharXiv-R), 개방형 어휘 개수 세기(FSC-147), 단편 비디오 캡셔닝(UGC-VideoCap), 로봇 조작 사건 이해(WGO Bench) 네 가지 평가에서는 GPT-6 Astra보다 높은 점수를 기록했고, 체화 공간 추론(ERQA)에서는 Astra와 동점을 기록했다.
| 벤치마크 | Glimpse | GPT-6 Astra | GPT-6.1 Sol | Opus 5.5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| WGO Bench (조작 사건) | 42.70 | 39.42 | 38.91 | 12.34 | 33.99 |
| ERQA (체화 공간) | 83.75 | 83.75 | 82.45 | 82.20 | 81.20 |
| BabyVision (세밀 지각) | 95.36 | 97.68 | 97.16 | - | 83.25 |
| HSS (장면 이해) | 46.36 | 53.6 | 46.6 | 49.81 | 41.6 |
| CharXiv-R (과학 차트) | 92.90 | 92.10 | 92.60 | 93.40 | 91.80 |
| UGC-VideoCap (단편 캡션) | 82.66 | 80.32 | 80.41 | 76.35 | 78.33 |
| DREAM-1K (고밀도 캡션) | 76.04 | 79.05 | 77.93 | 72.05 | 70.00 |
| TOMATO (시간 추론) | 93.60 | 96.02 | 89.02 | 72.44 | 83.02 |
| Video-MME v2 (비디오) | 56.68 | 64.06 | 65.27 | - | 59.58 |
| E.T. Bench (사건 이해) | 63.55 | - | 59.79 | - | 63.45 |
| FSC-147 (개방형 개수) | 83.36 | 82.02 | 82.69 | 73.78 | 67.06 |
| CountQA (제품 개수) | 82.66 | 86.42 | 86.42 | 82.20 | 81.09 |
시각 정보를 면밀하고 조밀하게 재검토해 정확한 추론 결정을 내리는 방식이 Glimpse의 성능을 뒷받침한다. 그 대신 장면을 거듭 확인하는 과정에서 시간과 토큰을 많이 쓰게 되므로, 연구팀은 고난도 시각 추론 기술의 고도화와 함께 토큰 효율성 개선을 다음 최우선 과제로 두고 있다.
시각적 사고의 네 가지 작동 방식
사건과 움직임의 연속 추적
Glimpse는 띄엄띄엄 추출한 프레임 몇 장만 보지 않고 시간의 흐름에 따라 사건을 추적하며 모호한 구간을 다시 돌려본다. 승강장으로 들어오는 기차의 속도 변화를 묻는 과제에서는 기차가 화면에 진입하는 2.2초 시점의 창문 모서리를 기준점으로 잡는다. 2.2초부터 3.0초까지는 관찰 시점 사이의 이동 거리가 길고 모션 블러도 뚜렷하다. 반면 다시 확인한 4.5초부터 4.9초 구간에서는 이동 폭이 급격히 줄고, 4.9초부터 5.13초 사이에는 몇 픽셀만 움직인다. 모델은 이 변화를 근거로 기차가 감속 중이라는 답을 내놓는다.
두 마리의 파란 새가 황동 문손잡이에 앉았다가 날아가는 6.13초짜리 애니메이션 과제에서는 프레임 빈도를 능동적으로 조절한다. 모델은 먼저 전체 영상을 초당 8프레임(8fps)으로 훑어본 뒤, 2.4초부터 4.0초 구간을 확대한다. 여기서 앞선 새는 자홍색 끈을, 뒤따르는 새는 연녹색 머리쓰개를 하고 있음을 구분한다. 이어서 카메라가 빠르게 회전하는 4.3초부터 5.2초까지의 0.9초 구간을 다시 살핀다. 장면 전환(하드 컷)인지 연속적인 카메라 패닝인지 판별하기 위해 프레임 빈도를 초당 약 14프레임(14fps)으로 높여 재생하는 것이다. 중간 벽면의 위치가 끊기지 않고 이어지는 것을 확인한 모델은 컷 편집 없는 카메라 패닝으로 결론짓고, 두 새가 차례로 빛나는 아치로 들어가는 사건 순서를 복원한다.
지지점과 회전축에 기반한 물리적 결과 예측
 출처: Elorian
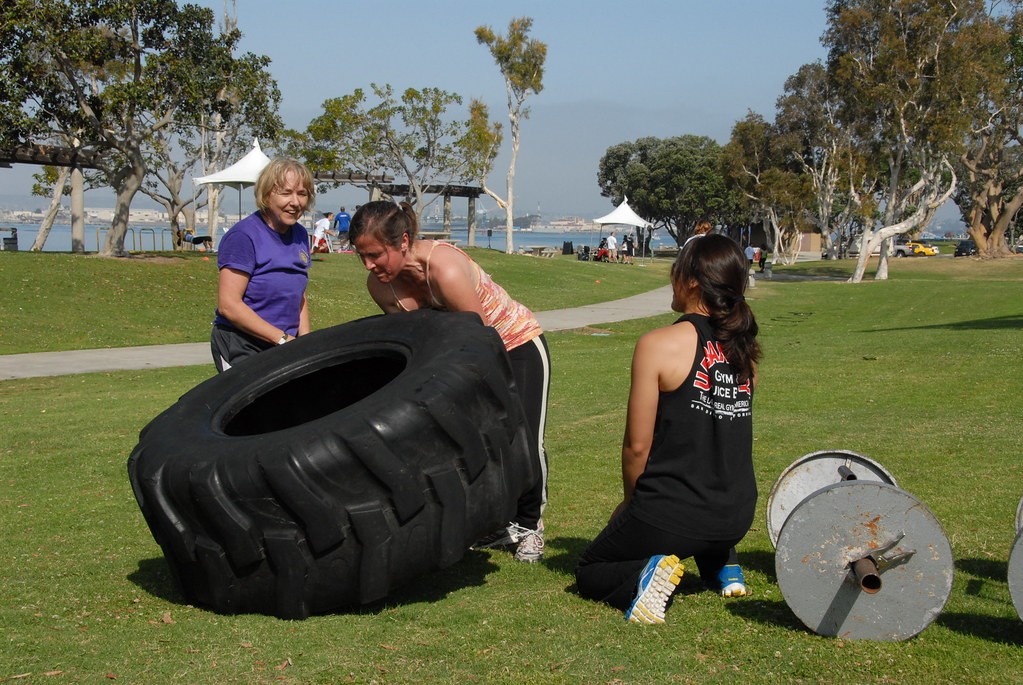
정지 사진 한 장에서도 물체의 지지점과 회전축을 파악하면 그다음에 일어날 물리적 결과를 예측할 수 있다. 위 사진에서는 세 여성이 대형 트랙터 타이어를 들어 올리고 있다. 질문은 “타이어가 수직으로 세워지기 전에 줄무늬 상의를 입은 여성이 갑자기 손을 놓친다면 누가 가장 먼저 부딪힐 위험에 처하며 타이어는 어떻게 움직이겠는가"다. 타이어의 아랫부분 모서리는 아직 잔디밭에 닿아 있고, 들려 올라간 쪽은 수직 균형점을 지나지 못한 상태다. 여기서 지지력이 사라지면 들려 있던 위쪽 부분은 중력 때문에 지면에 닿은 아랫부분을 회전축 삼아 바닥으로 다시 넘어간다. 이때 들려 있는 타이어 모서리 위로 몸을 숙인 줄무늬 상의 여성이 낙하 경로에 그대로 놓이므로 가장 먼저 부딪힐 위험에 처한다.
행동과 물리적 변화의 인과 연결
사람의 조작 행동을 기계 장치의 물리적 변화와 연결하는 과제도 있다. 증기 기관차 옆에서 작업자가 15초부터 20초 사이에 원형 추가 달린 선로 전환기 레버를 오른쪽에서 왼쪽으로 넘기는 영상을 보고, 그 행동이 어떤 물리적 결과를 낳았는지 설명하는 문제다. 모델은 먼저 기관차 옆의 작업자와 전환기 장치를 찾은 뒤, 레버를 넘기는 손동작이 선로의 분기점(track points)을 움직여 기차의 진행 경로를 바꾼다는 인과를 도출한다. 로봇 팔 영상을 검사하는 과제에서도 동작이 끝나는 시점을 정밀하게 구분한다. 통에서 마커 펜을 집어 올리는 동작이 끝나는 8.9초와, 테이블 위에 내려놓고 그리퍼를 떼는 동작이 끝나는 14.085초를 두 개의 완료 사건으로 분리해 기록한다.
종류와 상태 조건을 분리한 개수 세기
 출처: Elorian
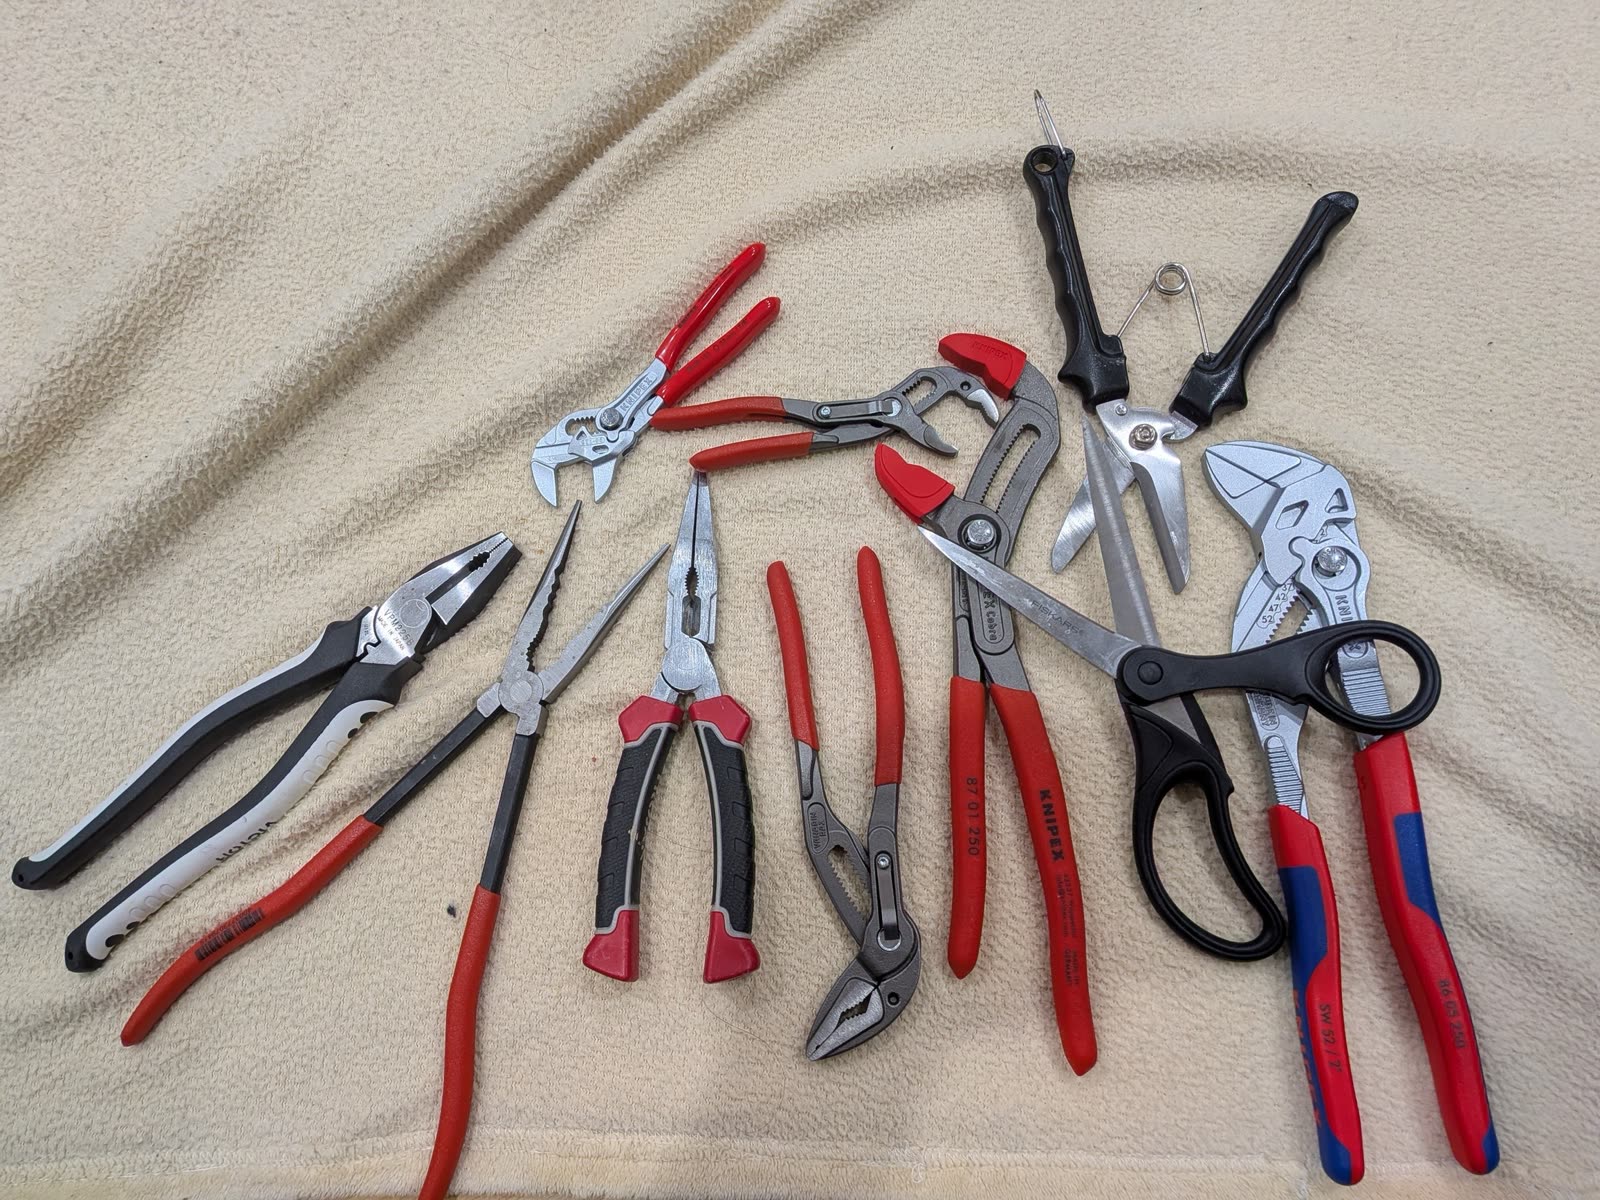
모양이 비슷한 물체들이 섞여 있는 장면에서는 질문이 요구하는 종류와 상태 조건을 분리해 개수를 센다. 위 사진에서 “열려 있는 플라이어(open pliers)가 몇 개인지 정수로 답하라"는 질문을 받으면, 모델은 먼저 찾을 대상을 ‘손잡이와 집게 주둥이가 눈에 띄게 벌어져 있는 플라이어’로 정의한다. 그다음 닫혀 있는 플라이어는 종류는 맞지만 상태가 다른 것으로 빼고, 가위는 두 개의 손잡이와 힌지를 가졌으나 종류가 다른 유사물로 분류해 제외한다. 마지막으로 남은 후보들을 도구의 종류와 열림 상태라는 두 기준에 다시 대조해 총 4개라는 답을 구한다.
실제 응용 사례와 타 모델 비교
로보틱스 데이터 라벨링과 VLA 상위 계획
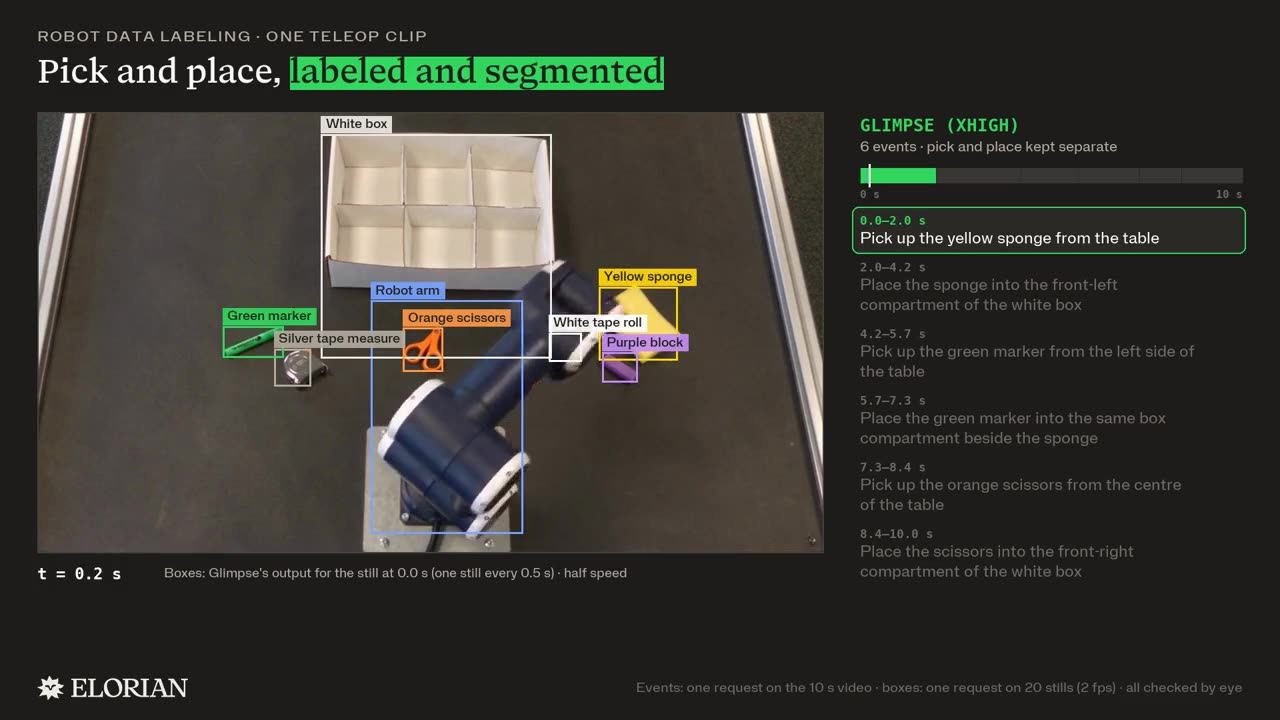 로봇 원격조작 영상에서 물체 위치 박스와 6개의 세부 동작 구간을 추출한 결과. 출처: Elorian
로보틱스 분야에서는 학습용 데이터 라벨링과 로봇 제어 정책의 상위 계획기(System 2 플래너) 두 가지 역할을 맡는다. 먼저 10초짜리 로봇 팔 원격조작(teleoperation) 영상에서는 0.5초 간격(2fps)으로 정지 프레임을 추출해 물체마다 이름과 바운딩 박스를 표시한다. 인식 대상은 흰색 상자와 로봇 팔을 비롯해 초록색 마커, 은색 줄자, 주황색 가위, 흰색 테이프 롤, 노란색 스펀지, 보라색 블록까지 여덟 가지다. 동시에 전체 에피소드를 “테이블에서 노란색 스펀지 집기(0.0초부터 2.0초)”, “흰색 상자의 앞쪽 왼쪽 칸에 스펀지 넣기(2.0초부터 4.2초)“처럼 여섯 개의 집기 및 놓기(pick-and-place) 사건으로 분할한다. 각 구간에 시작과 끝 시각을 붙여 로봇 학습 데이터셋에 바로 쓸 수 있는 라벨을 자동으로 생성한다.
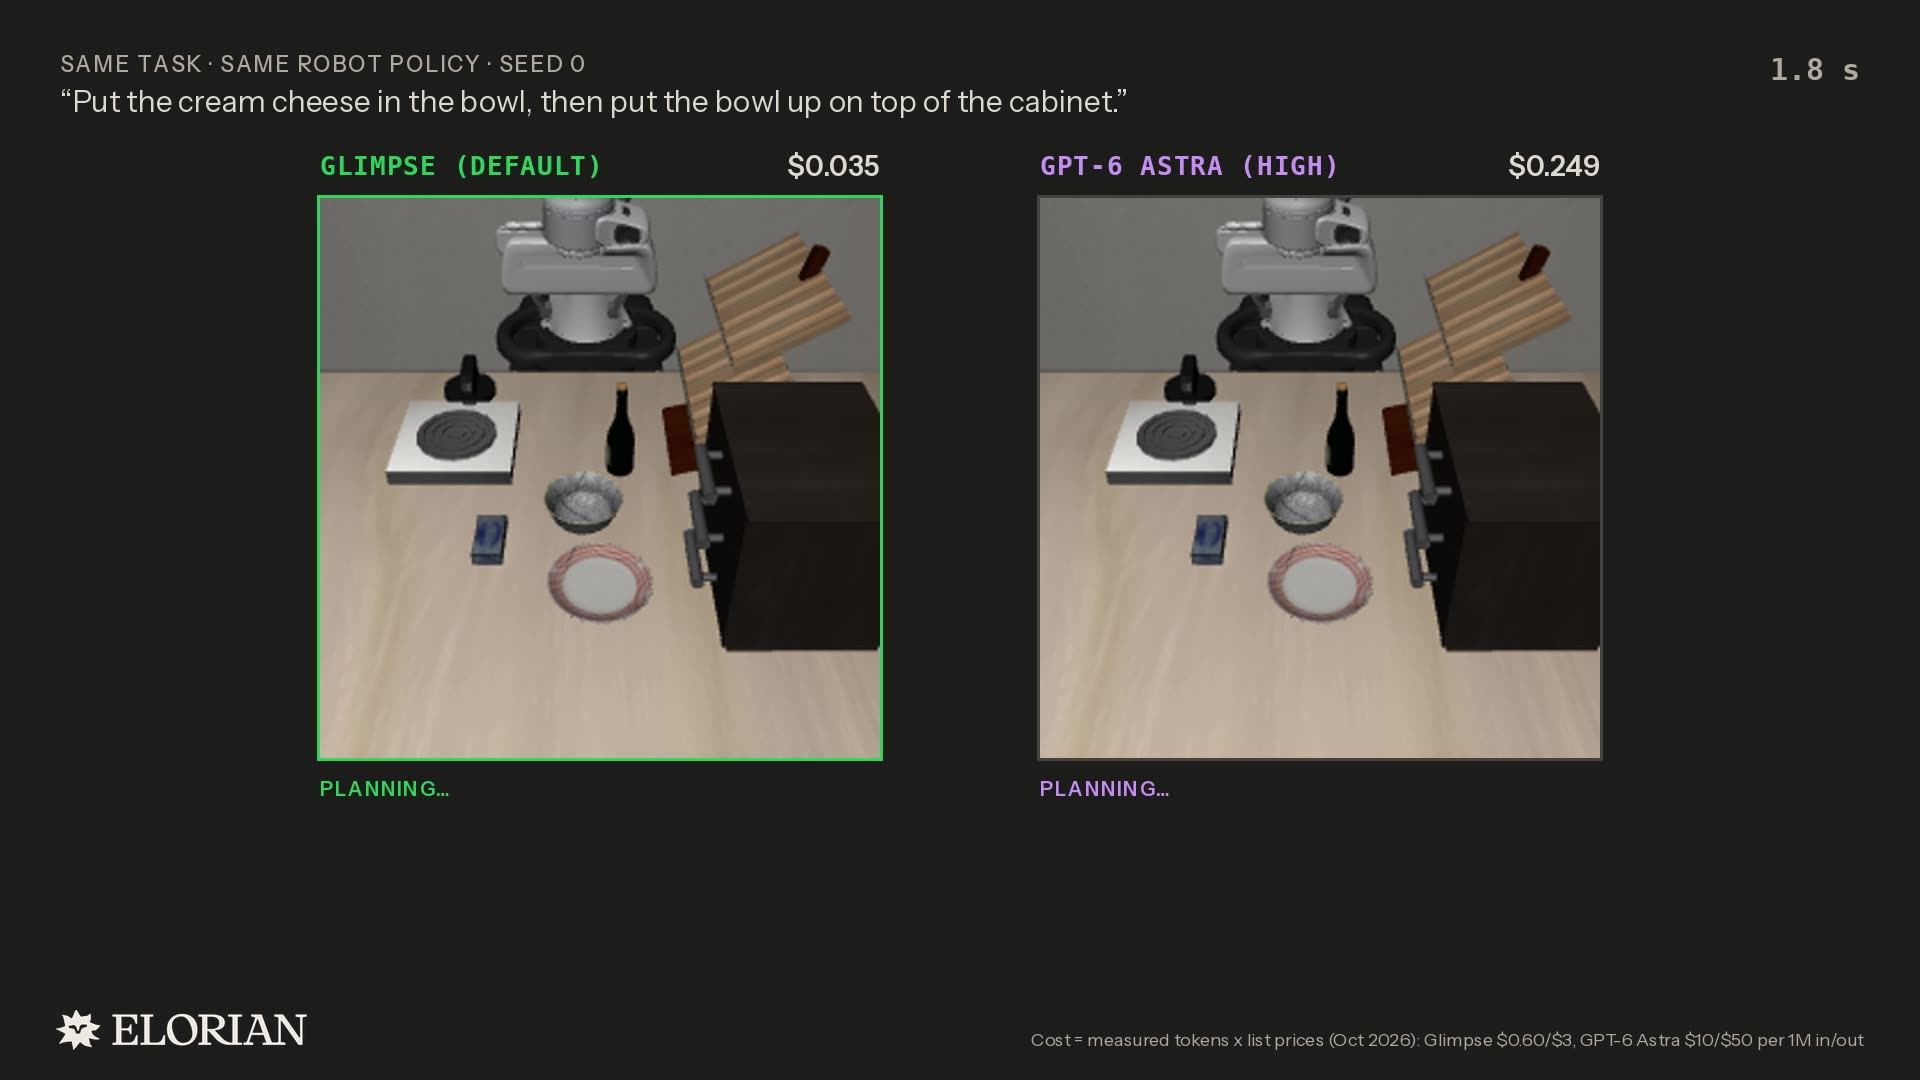 LIBERO 과제에서 π0.5 모델의 상위 플래너로 동작할 때의 비용 비교. 출처: Elorian
고수준 계획 실험에서는 Physical Intelligence의 시각-언어-행동(VLA) 정책인 π0.5에 Glimpse와 GPT-6 Astra를 각각 상위 플래너로 연결해 동일한 LIBERO 과제를 수행하게 했다. “크림치즈를 그릇에 넣은 뒤, 그 그릇을 캐비닛 위쪽에 올려놓으라"는 지시를 받으면 플래너는 요청을 단계별 하위 과제로 분해하고, 로봇 팔이 움직이는 동안 카메라 영상을 확인해 현재 단계가 끝났는지와 다음 단계로 무엇을 해야 할지를 판단한다. 두 모델 모두 과제를 완수했지만, 에피소드 1회당 계획에 들어간 토큰 비용은 Glimpse가 0.035달러로 GPT-6 Astra(0.249달러)의 7분의 1 수준이었다.
단편 비디오의 고밀도 캡셔닝
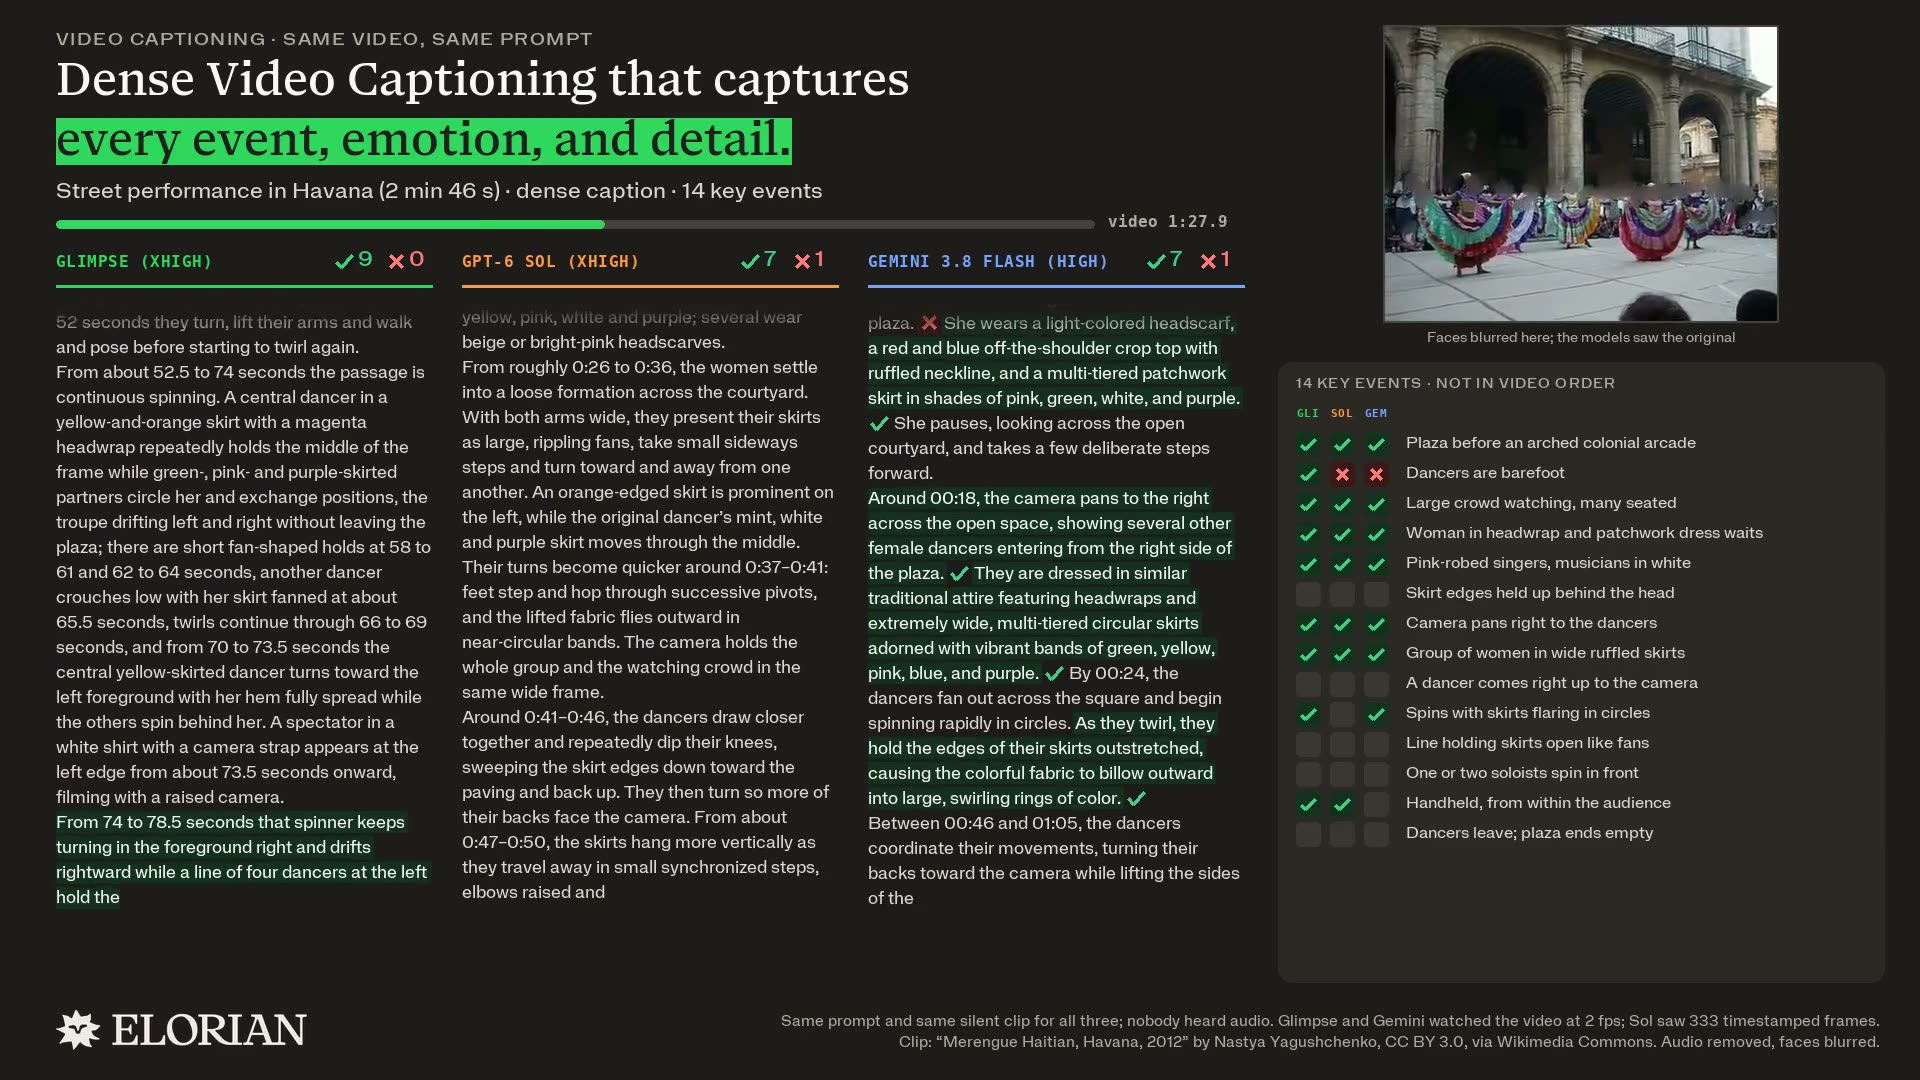 하바나 거리 공연 영상의 14개 핵심 사건 포착 여부를 비교한 화면. 출처: Elorian
비디오 아카이브 분석 사례로는 두 편의 영상이 쓰였다. 미세한 신체 움직임에 초점을 맞춘 2분 46초짜리 하바나 거리 공연 영상과, 인물의 감정과 관계에 초점을 맞춘 16초짜리 남녀 커플의 짐 싸기 스톡 영상이다.3 모든 모델에 오디오를 제거한 동일한 무음 영상과 같은 프롬프트를 주고 각각 3회씩 실행해 핵심 사건 포착 개수를 채점했다.
- 하바나 거리 공연(14개 핵심 사건, 2fps 입력): Glimpse는 무용수들이 맨발인 모습, 치마 자락을 머리 뒤로 들어 올리는 동작, 군중 속에서 손으로 들고 촬영한 카메라 시점 등을 포착해 3회 평균 13.7개(개별 실행 14, 13, 14개)를 맞혔다. 같은 영상에서 GPT-6.1 Sol은 평균 12.0개, Gemini 3.8 Flash는 평균 11.0개를 기록했다.
- 커플과 여행 가방(13개 핵심 사건, 10fps 입력): 여성이 급하게 가방에 옷을 챙기는 동안 남성이 뒤에서 어쩔 줄 몰라 하며 손을 올리는 동작, 여성이 팔을 뒤로 뻗어 거리를 두는 제스처, 이별 상황이라는 맥락 등 13개 항목에서 Glimpse는 3회 모두 13.0개 만점을 기록했다. GPT-6.1 Sol은 평균 12.3개(13, 12, 12개), Gemini 3.8 Flash는 평균 10.3개(9, 11, 11개)를 맞혔다.
카메라 이동과 드론 영상에서의 개수 세기
영상 속 객체 세기에서는 마당의 강아지들을 찍은 스마트폰 영상과 건설 현장 야적장을 찍은 37초짜리 드론 영상이 쓰였다. 스마트폰 영상에서는 카메라가 마당을 두루 비추며 회전하는 동안에도 강아지마다 고유한 색상과 번호를 붙여, 화면 밖으로 나갔다가 다시 나타난 강아지를 중복해서 세지 않고 총 5마리를 끝까지 추적한다.
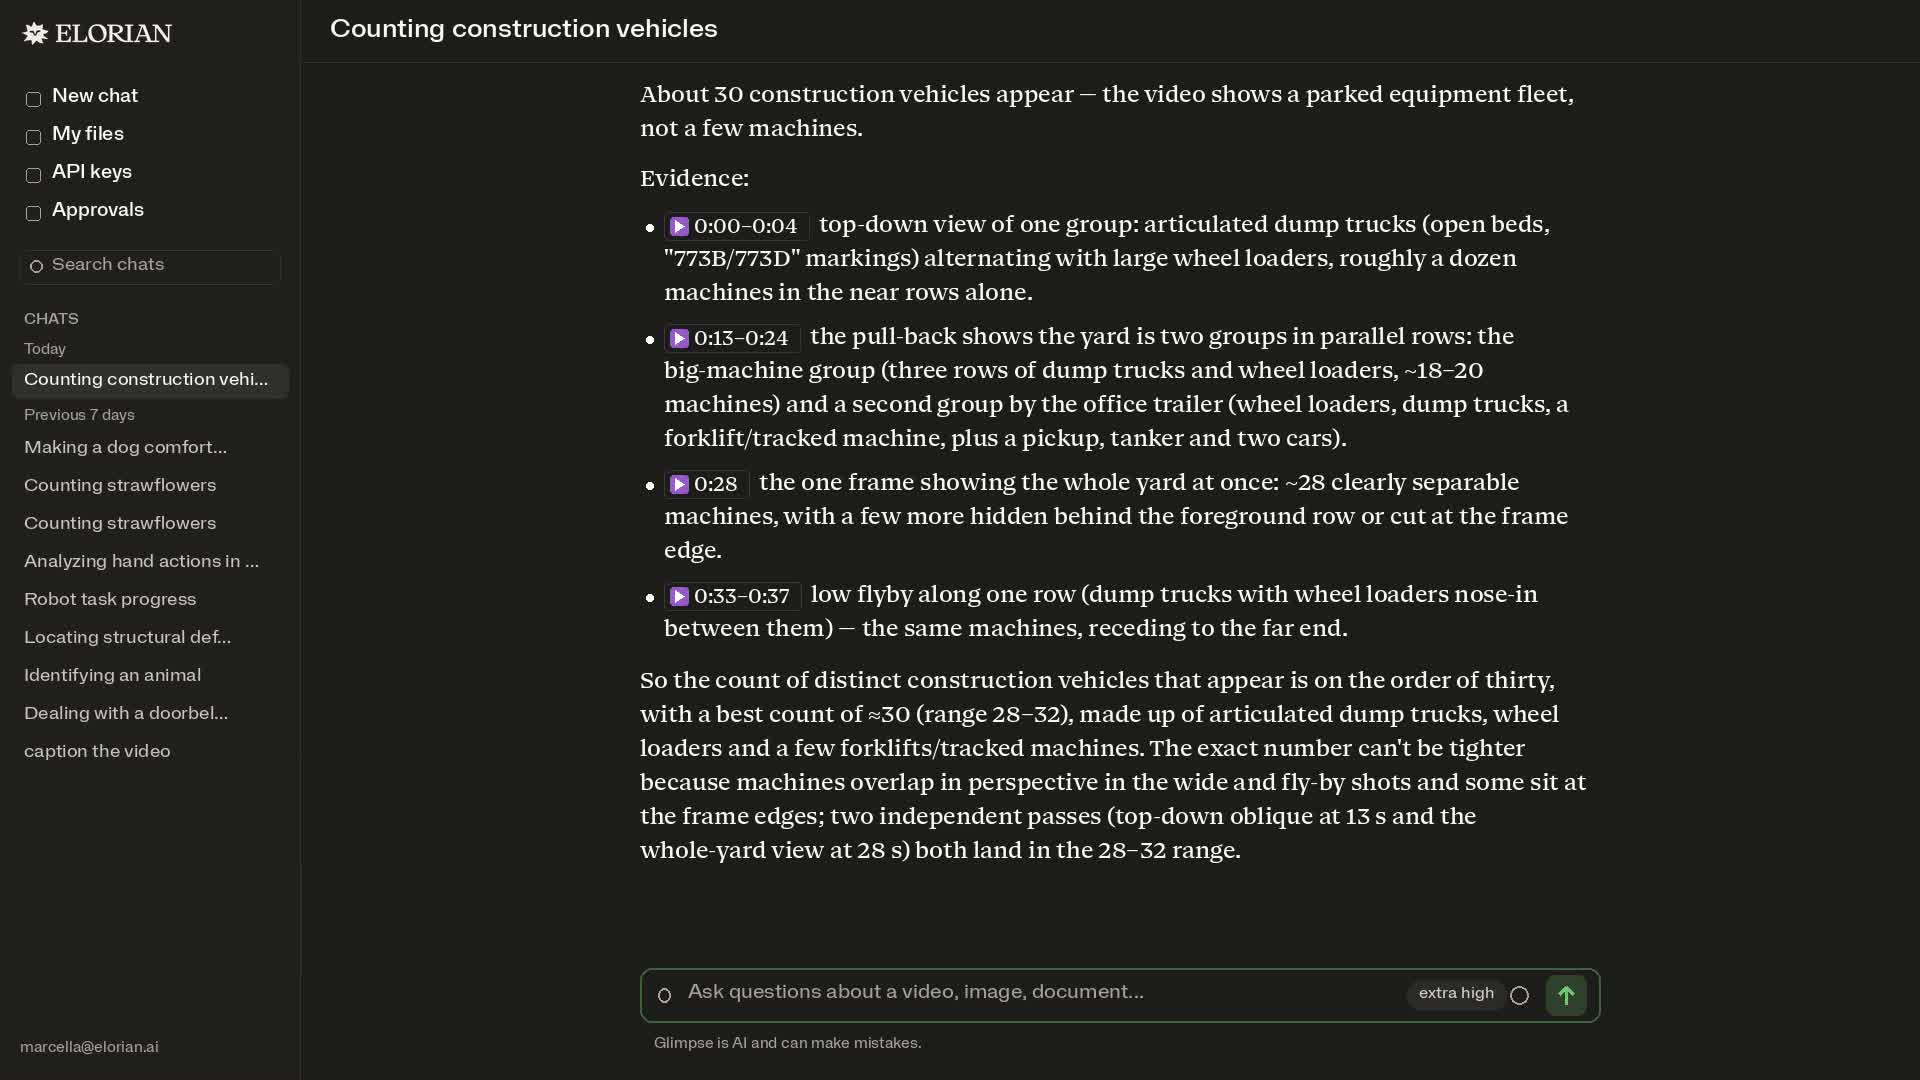 드론 영상에서 구간별 대조를 거쳐 건설 장비 대수를 약 30대로 추산한 플랫폼 실행 결과. 출처: Elorian
건설 현장 드론 영상에서 “건설 차량이 몇 대나 등장하는가"를 물었을 때, Glimpse는 extra high 설정으로 476초 동안 영상을 정밀 분석해 구간별 타임스탬프 근거와 함께 약 30대(28대에서 32대 사이)라는 답을 내놓았다. 모델은 먼저 0초부터 4초까지의 부감 화면에서 앞줄의 장비 약 12대를 확인한다. 굴절식 덤프트럭과 대형 휠로더가 번갈아 서 있는 줄이다. 카메라가 뒤로 물러나는 13초부터 24초 구간에서는 전체 배치를 파악한다. 대형 장비가 3개 열(18대에서 20대)로 서 있고, 사무실 트레일러 옆에는 휠로더, 덤프트럭, 지게차와 궤도 장비, 픽업트럭, 탱크로리, 승용차 2대로 이뤄진 두 번째 그룹이 모여 있다. 28초 프레임에서는 야적장 전체가 한눈에 들어온다. 모델은 여기서 뚜렷이 구분되는 장비 약 28대를 세고, 원근 때문에 겹치거나 화면 가장자리에 걸린 장비도 감안한다. 13초의 경사 화면과 28초의 전체 화면으로 따로 진행한 두 번의 검산이 모두 28대에서 32대 사이로 일치한다는 근거도 함께 제시한다.
시각 추론 퍼즐과 물리적 직관 평가
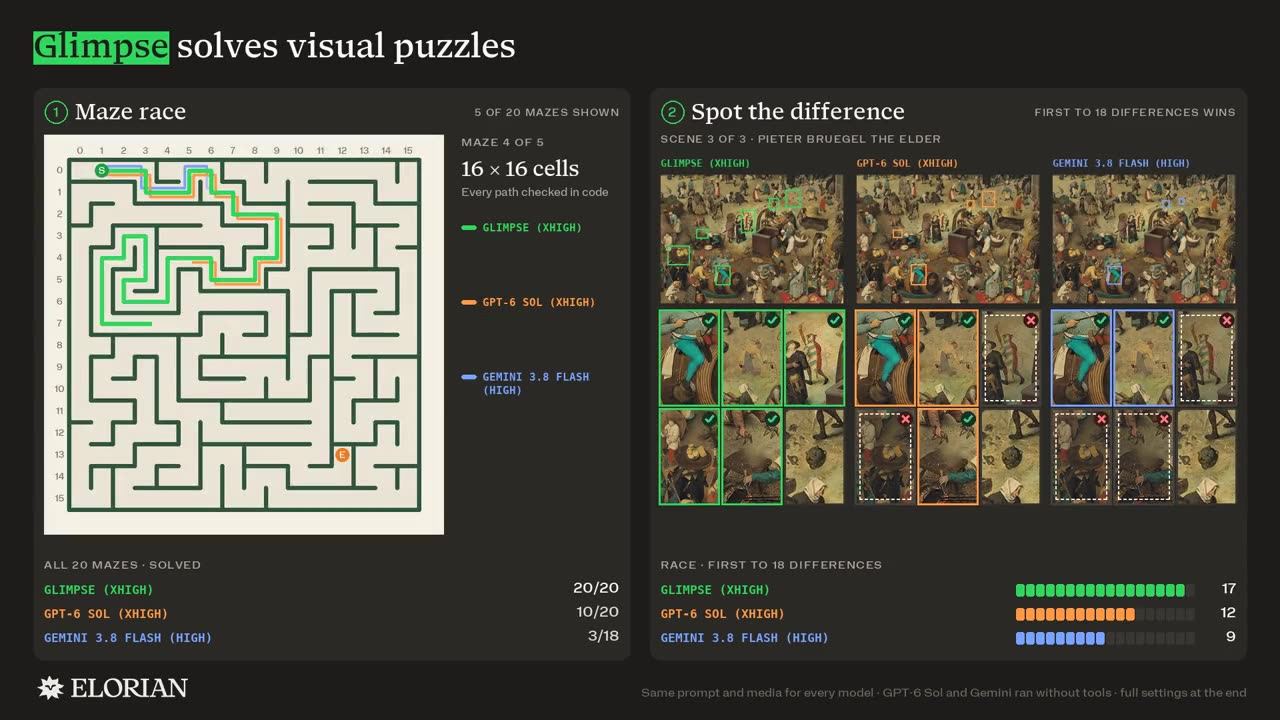 미로 찾기와 틀린 그림 찾기 퍼즐에서 세 모델의 성적을 비교한 결과. 출처: Elorian
어린아이에게는 쉽지만 오늘날 프론티어 모델들에는 여전히 까다로운 시각 추론 퍼즐 두 종류와 물리 예측 벤치마크 결과도 공개됐다.4
- 미로 찾기(Maze race): 크기가 점점 커지는 미로 20개를 푸는 과제에서 Glimpse는 코드로 모든 경로를 검증하며 20개 중 20개를 모두 풀었다. 같은 조건에서 GPT-6.1 Sol은 20개 중 10개, Gemini 3.8 Flash는 18개 중 3개를 해결했다.
- 틀린 그림 찾기(Spot the difference): 피테르 브뤼헐(Pieter Bruegel the Elder)의 회화 등에서 18개의 차이점을 먼저 찾는 경주 과제로, 세 장면 중 세 번째 장면에서 Glimpse는 17개, GPT-6.1 Sol은 12개, Gemini 3.8 Flash는 9개를 찾아냈다.
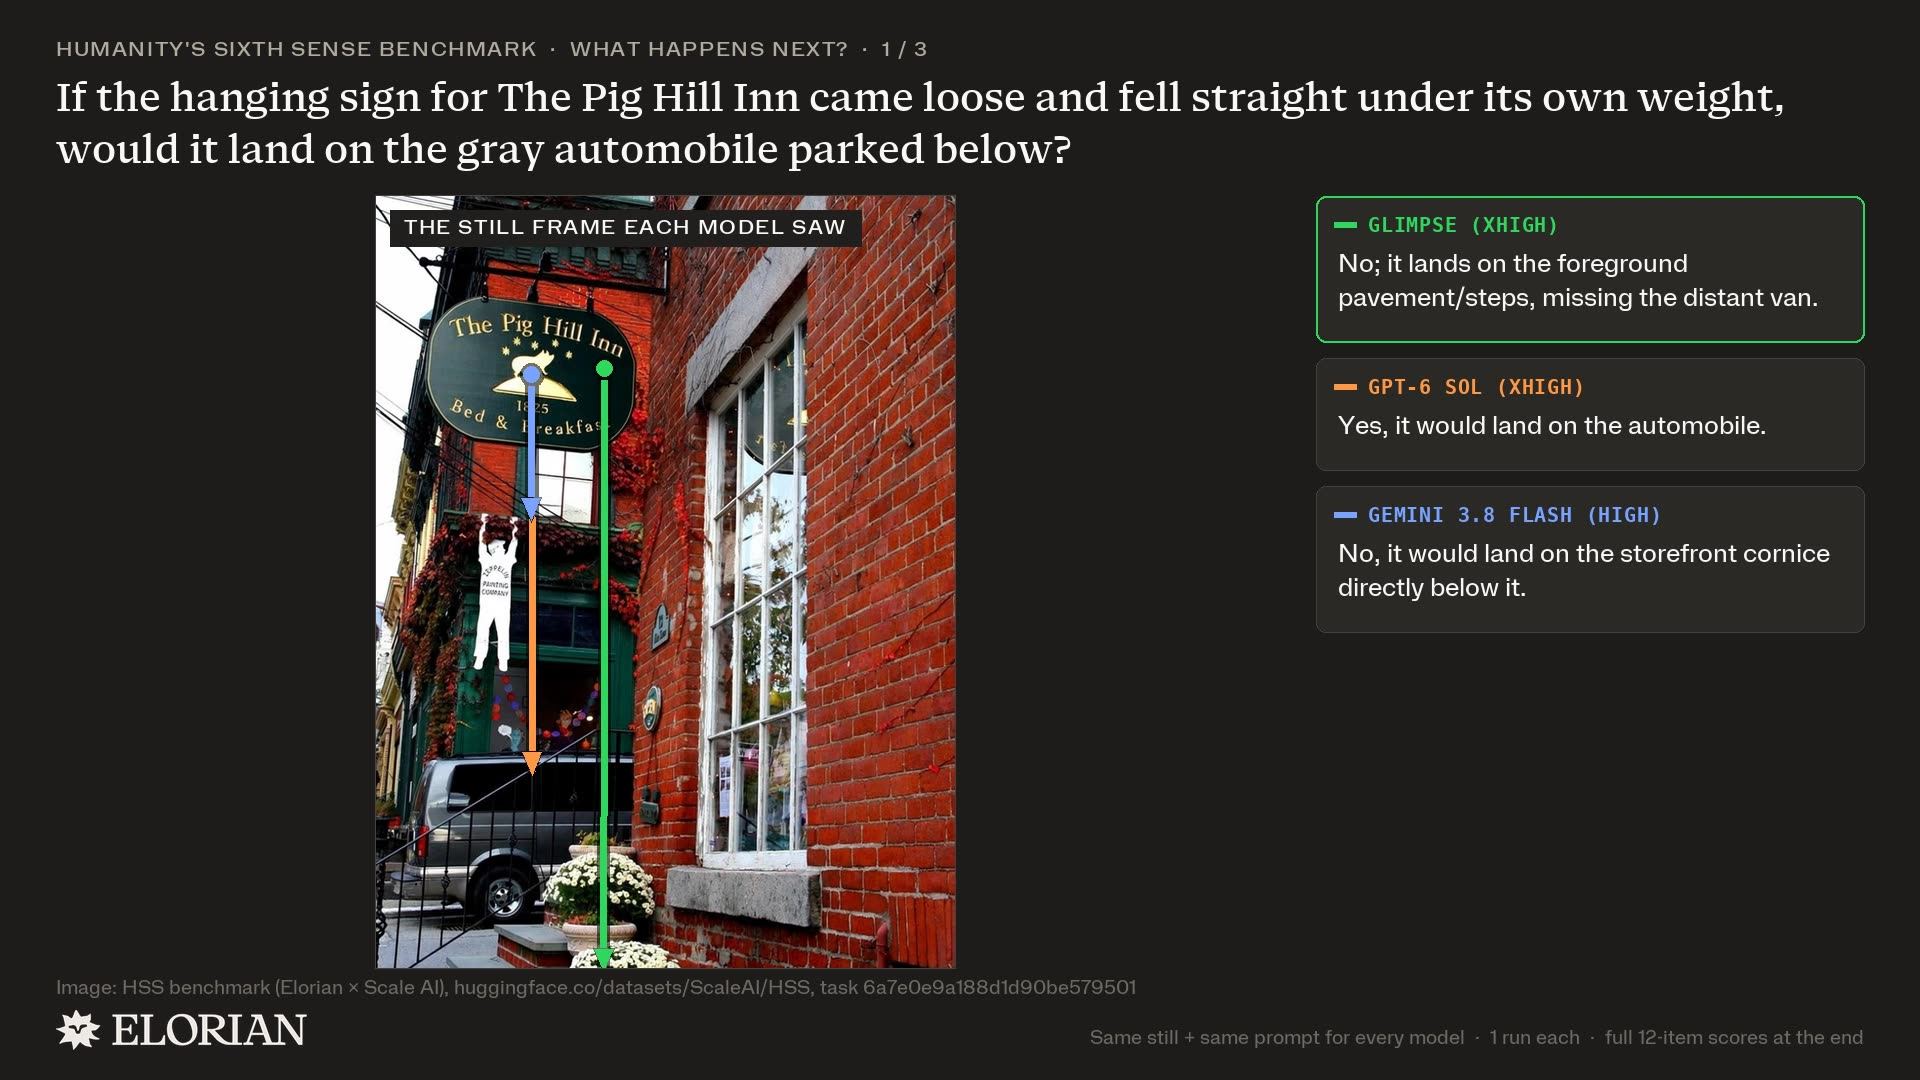 Humanity’s Sixth Sense 벤치마크의 간판 낙하 궤적 예측 문항 비교. 출처: Elorian
마지막으로 Elorian과 Scale AI가 함께 만든 Humanity’s Sixth Sense(HSS) 벤치마크 결과도 함께 공개됐다. 물체가 어디로 이동하거나 떨어져 무엇과 부딪힐지 묻는 ‘다음에 일어날 일(what happens next)’ 이미지 문항 58개 가운데 무작위로 12개를 뽑아 세 모델을 비교한 실험이다. 예를 들어 “The Pig Hill Inn의 매달린 간판이 풀려 자기 무게로 곧장 떨어진다면 아래 주차된 회색 자동차 위에 떨어지겠는가"라는 문항에서, GPT-6.1 Sol은 “자동차 위에 떨어진다"고 답했고 Gemini 3.8 Flash는 “바로 아래 상점 처마 위에 떨어진다"고 답해 모두 틀렸다. 반면 Glimpse는 원근과 간판이 매달린 지점을 고려해 “전경의 보도와 계단 위에 떨어지며 멀리 서 있는 밴을 빗나간다"고 답하고 초록색 낙하 궤적을 정확히 그렸다. 무작위 12문항 전체 성적에서는 Glimpse가 12개 중 5개, Gemini 3.8 Flash가 12개 중 5개, GPT-6.1 Sol이 12개 중 2개를 맞혔다.
물리 세계를 이해하는 모델을 향하여
물리 세계의 범용 인공지능(AGI)을 구현하려면 시스템, 데이터, 모델 아키텍처, 학습에 걸친 전체 기술 스택을 멀티모달 지능에 맞춰 처음부터 설계해야 한다는 것이 Elorian의 출발점이다. 그러한 모델은 장면을 재구성하고, 무언가 움직였을 때 일어날 일을 예측하며, 그 이해를 바탕으로 다음 행동까지 안내할 수 있어야 한다. 이 역량은 로보틱스, 엔지니어링, 국방 분야를 비롯해 크리에이터의 영상 제작과 편집, 기술 기업의 온라인 미디어 검색과 정리, 게임 개발자의 인터랙티브 환경 구축 및 테스트에도 두루 쓰일 수 있다.
연구팀의 다음 연구 주제는 멀티모달 네이티브 사전학습, 이해와 생성을 겸비한 모델, 로봇을 위한 직접 행동 출력(direct action outputs) 세 가지다. Glimpse가 실증한 시각 이해 능력은 그 첫 단계이며, 정밀하게 보정된 3차원 장면 재구성(calibrated reconstruction)과 직접적인 로봇 제어는 앞으로 풀어야 할 과제로 남아 있다.
가장 흥미로운 지점
이번 발표를 읽으며 눈길이 머문 대목은 시각 추론의 성패를 결정한 요인이었다. 얼마나 큰 모델로 한 번에 보느냐보다, 모호한 순간에 다시 돌아가 얼마나 조밀하게 확인하느냐가 결과를 좌우했다. 파란 새 두 마리가 날아가는 영상에서 카메라 회전이 컷 편집인지 연속 패닝인지 헷갈리자, Glimpse는 전체 영상을 보던 초당 8프레임에서 그 0.9초 구간만 초당 14프레임으로 높여 다시 확인한다. 미로를 풀 때는 코드로 경로를 일일이 대조하고, 건설 현장 드론 영상에서는 전체 영상을 분석하며 13초의 경사 화면과 28초의 전체 화면을 따로 세어 교차 검증하는 데 476초를 쓴다. 오픈웨이트 모델에 수백 대의 GPU만으로 사후학습한 작은 모델이 단가가 열여섯 배 넘게 비싼 GPT-6 Astra와 대등한 성적을 낸 비결은, 한 번 본 인상을 텍스트로 그럴듯하게 부풀리지 않고 필요한 시각적 증거를 반복해서 재검토하는 에이전트 루프에 있었다.
백만 토큰당 입력 0.6달러, 출력 3달러라는 단가가 로보틱스 플래너 실험에서 에피소드당 0.035달러라는 실측 비용으로 이어진 결과도 인상적이다. 물리 세계의 로봇이나 대규모 비디오 아카이브를 다루는 일은 한 번의 질문으로 끝나지 않고 카메라 프레임을 끊임없이 주고받아야 하므로, 호출 단가가 낮지 않으면 현장에 도입하기 어렵다. 한편 건설 차량 서른 대를 세는 데 476초가 걸렸듯 조밀한 재검토가 토큰과 시간을 많이 소모한다는 한계를 Elorian도 숨기지 않았다. 연구팀이 다음 과제로 지목한 토큰 효율성 개선이 이뤄져 ‘다시 들여다볼 가치가 있는 순간’만 더 빠르게 골라낼 수 있게 된다면, 시각 에이전트의 실용성은 한층 높아질 것이다.
출처
Elorian, “Introducing Glimpse”, 2026-10-16. 원문: https://elorian.ai/blog/introducing-glimpse
치비 서소영 삽화 1장은 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
Elorian은 Andrew Dai(CEO), Yinfei Yang, Dustin Tran, Seth Neel 등이 설립한 연구 기업이다. Andrew Dai는 Google Brain과 DeepMind에서 언어 모델 사전학습과 Gemini 데이터 부문을 이끌었고, Yinfei Yang은 Apple의 멀티모달 파운데이션 모델(MM1)과 Google ALIGN을 공동 개발했다. Dustin Tran은 xAI 사후학습 팀 리드와 Gemini 핵심 기여자를 지냈고, Seth Neel은 하버드대 교수를 역임했다. 출처: https://elorian.ai/team ↩︎
별도 표기가 없는 한 모든 모델은 최대 추론 강도(thinking effort)와 기본 에이전트 하네스를 사용해 평가했다. Glimpse는 max 설정을 썼고, GPT-6 Astra와 GPT-6.1 Sol, Opus 5.5는 max 설정에 Code Interpreter를 결합했다. Gemini 3.8 Flash는 이미지 평가에서 high 설정과 Code Interpreter를, 비디오 평가에서 high 설정과 Video Agent를 사용했다. 비디오 평가의 경우 max 설정 결과를 쓸 수 없는 항목이 있어 GPT-6.1 Sol(Video-MME v2 제외)과 Opus 5.5는 high 설정과 Code Interpreter로 측정했다. 세부 지표는 WGO Bench(종단간 조작 사건 이해), ERQA(체화 공간 추론 정확도), HSS(이미지 및 비디오 장면 이해, 논문 보고 수치 포함), Video-MME v2(자막 포함 그룹 루브릭 점수), CountQA(제품 이미지 개수 세기) 기준이다. ↩︎
하바나 거리 공연과 커플 영상 평가에서 Glimpse(xhigh)는 Elorian API의 호스팅 도구를 사용해 작업용 도해를 생성하며 분석했고, GPT-6.1 Sol(xhigh)과 Gemini 3.8 Flash(high)는 도구 없이 프레임 입력만으로 캡션을 생성했다. 채점은 블라인드 Claude 심판 모델이 1차 판정한 뒤 사람이 모든 판정을 캡션 원문 및 프레임과 대조해 검수했다. ↩︎
시각 퍼즐과 HSS 12문항 비교에서 Glimpse는 xhigh 추론 강도와 호스팅 도구를 함께 사용했고, GPT-6.1 Sol(xhigh)과 Gemini 3.8 Flash(high)는 도구 없이 동일한 이미지와 프롬프트로 실행했다. HSS 문항에서 정답 공개용으로 재생되는 영상은 Seedance 2.5로 정지 사진에서 생성한 참고 애니메이션이며, 평가 당시 어떤 모델도 이 영상을 보지 못했다. ↩︎