3줄 요약
- 라고스(Lagos)에 있는 연구소 Bad Theory Labs(BTL)의 Al-ameen이 2026년 9월 25일 GitHub에 리포지터리와 논문을 공개했다. 언어 모델은 토큰을 하나씩 이어 쓰면서 추론하는데, 저자는 이 방식 대신 명시적인 상태를 두고 여러 분기를 한꺼번에 전개하는 탐색 방식 Interference Search를 제안했다. 같은 상태에 이른 분기는 하나로 병합하고, 작게 학습시킨 판정기가 목표에 도달할 수 없는 분기를 제거한다. 코드와 학습된 판정기, 원시 결과, 실패한 실험까지 담은 연구 로그를 Apache 2.0으로 공개했다.
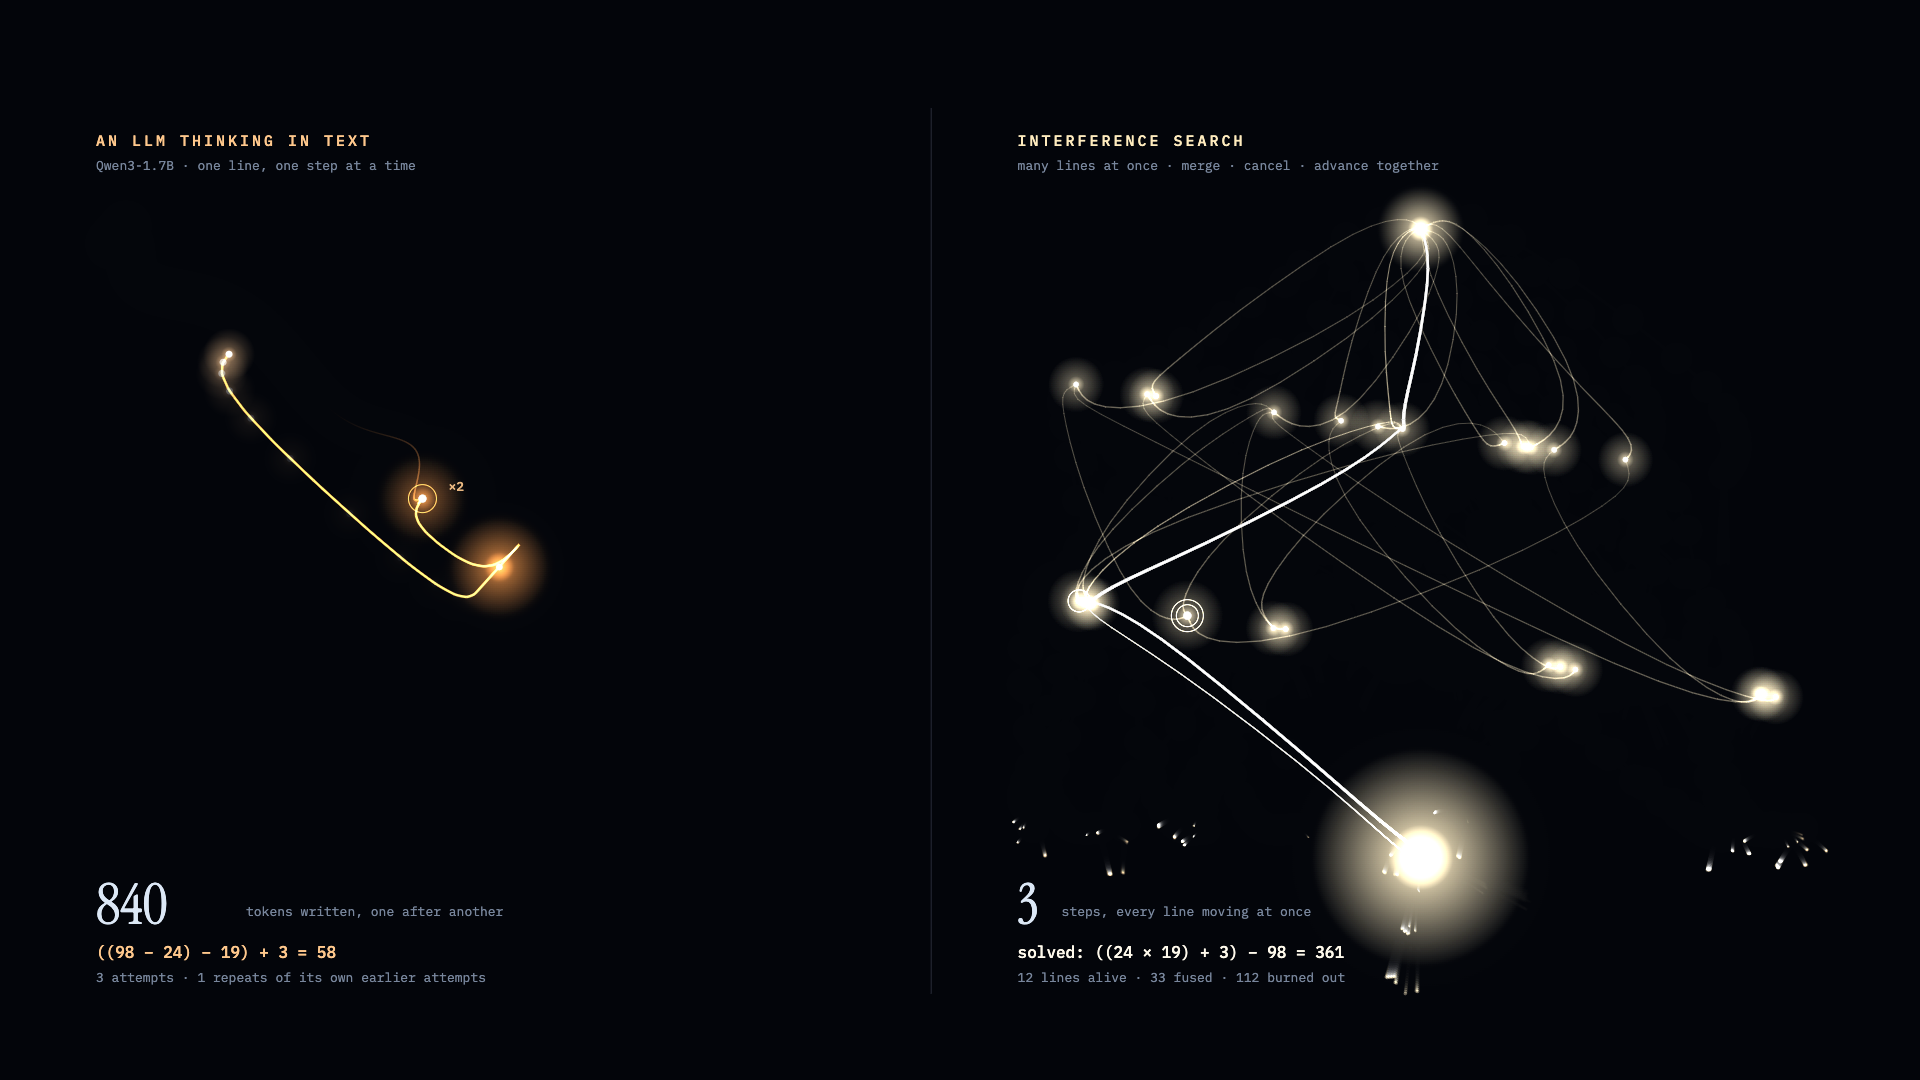
- 어려운 4숫자 카운트다운 30문제에서 같은 판정기와 같은 예산(상태 판정 200회)을 주었을 때, 한 줄로 이어 가는 단일 사슬은 21문제를 풀었고 Interference Search는 30문제를 모두 풀었다. 30문제를 모두 풀려면 단일 사슬은 평균 23.7단계를 순서대로 밟아야 했지만, Interference Search는 3단계면 충분했다. 텍스트로 생각하는 Qwen3-1.7B는 같은 30문제 중 3문제를 풀었다.
- 코드 과제(MBPP 30문제)에서 Interference Search는 9문제를 풀어 독립 샘플링(8문제)보다 한 문제를 더 풀었는데, 저자는 이 차이를 잡음 범위로 보았다. 실패한 시도를 프롬프트로 알려 주는 방법, 되감아 다시 샘플링하는 방법, 서로를 참조하는 병렬 스트림은 모두 효과가 없었다. 저자는 다음 단계로 이 탐색 방식을 강화학습으로 언어 모델에 학습시키고 SWE-bench와 Terminal-Bench에서 같은 계산량으로 시험하겠다고 밝혔다.
한 줄로 이어 쓰는 추론의 문제
오늘날의 추론 모델은 하나의 사고 흐름만 유지한다. 모델은 대안을 탐색할 때도 그 대안을 하나씩 차례로 적어야 하고, 포기한 대안도 기록에서 지워지지 않는다. 논문은 모델 여러 개를 병렬로 돌려도 이 문제가 해결되지 않는다고 설명했다. 같은 모델에서 뽑은 독립 샘플은 같은 편향을 공유하므로 같은 방식으로 실패하는 경향이 있기 때문이다.
저자가 Qwen3-1.7B로 카운트다운을 풀게 했을 때, 실패한 시도의 45.1%는 같은 샘플이 이미 기각한 시도를 다시 반복한 것이었다. 다른 샘플이 앞서 기각한 시도를 되풀이한 경우도 29.7%였다.
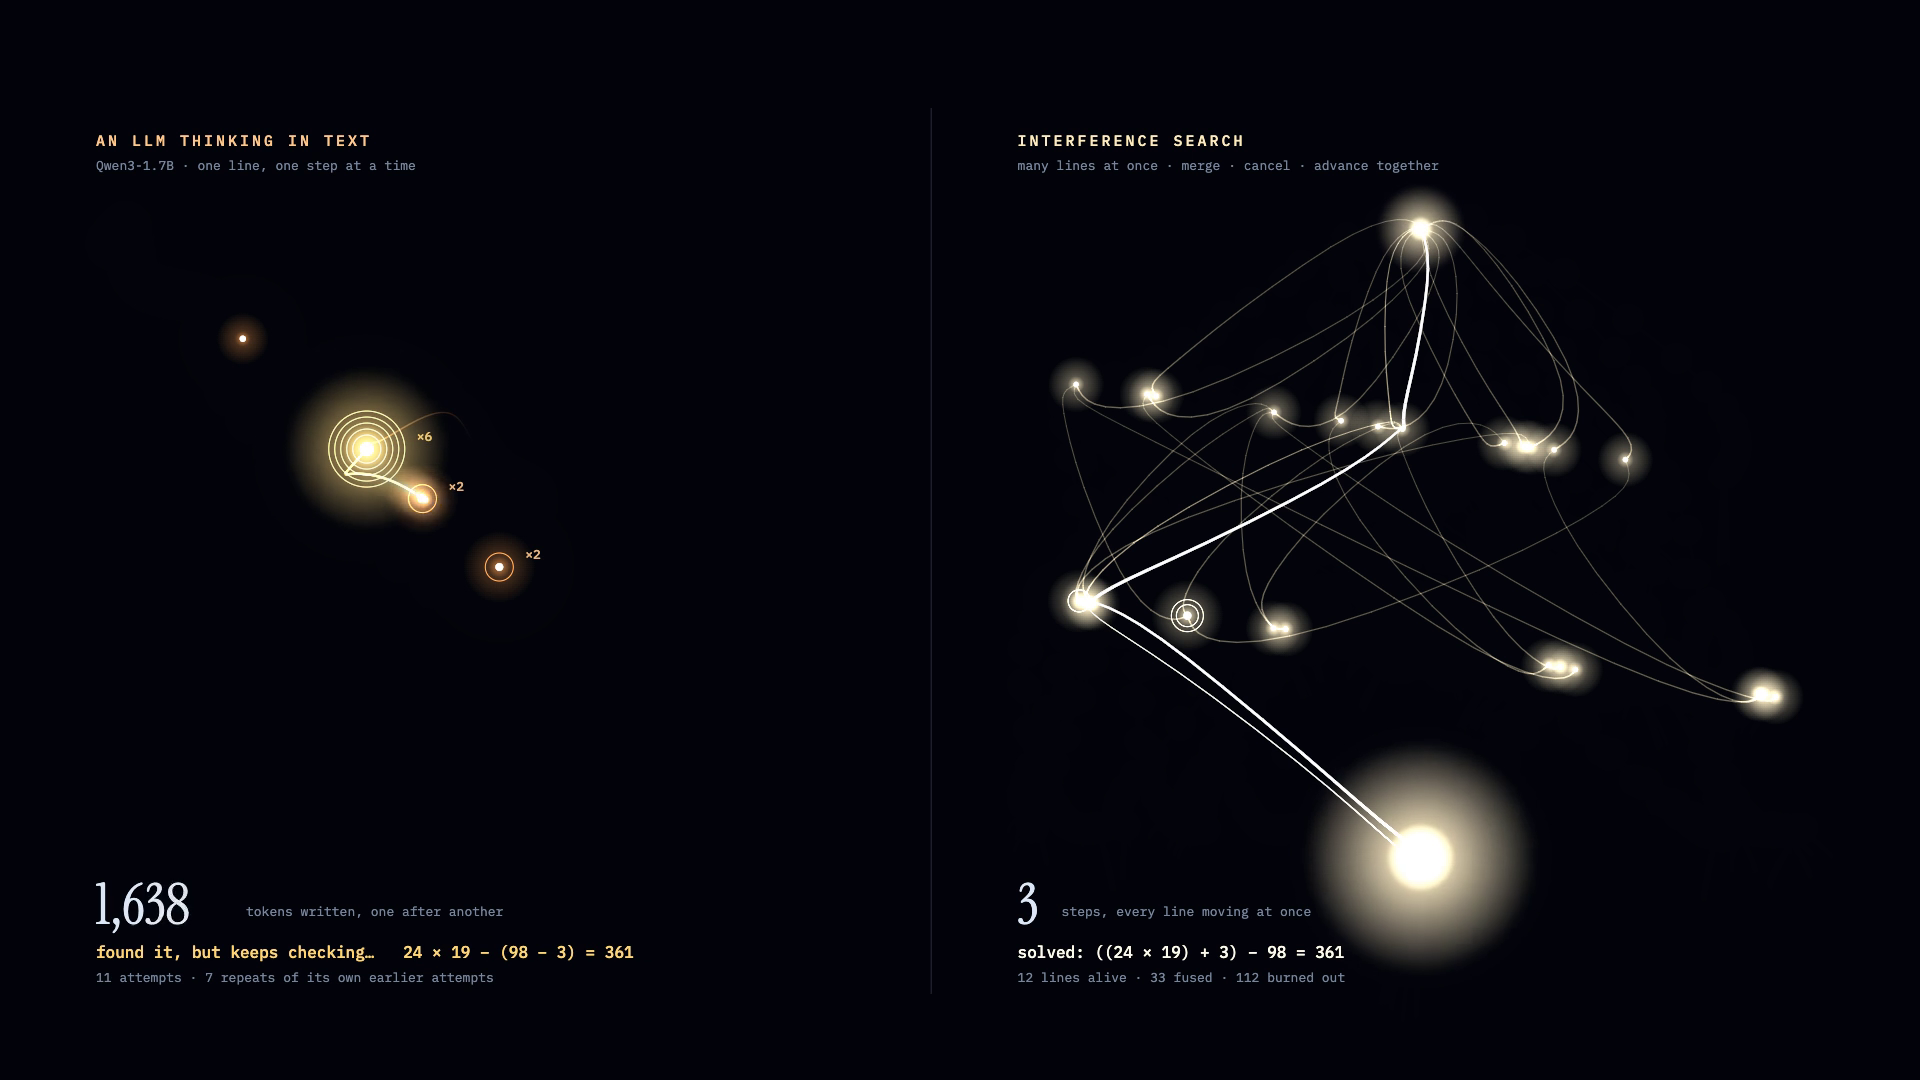
저자는 24, 98, 19, 3 네 숫자로 361을 만드는 문제의 기록을 가장 분명한 사례로 들었다. 이 문제에서 모델은 1,313번째 토큰에서 ((24 × 19) − 98) + 3 = 361이라는 정답을 적었다. 그러고는 이 식을 아홉 번 더 검산하다가 틀린 조합을 다시 시도하기 시작했고, 2,048토큰 예산을 다 쓸 때까지 답을 내지 못했다. 이 기록에서 모델은 17번 시도했는데, 그중 11번이 반복이었다. 저자는 모델이 답을 찾을 능력은 있었지만, 한 줄짜리 기록에서는 찾아낸 답을 아직 탐색 중인 다른 대안과 비교해 확정할 방법이 없었다고 진단했다.
저자는 방법의 이름을 양자 탐색에서 따왔다.1 그로버 알고리즘은 모든 후보를 중첩시킨 상태에 검사를 한 번 적용하고, 진폭의 부호를 이용해 틀린 후보들이 함께 약해지게 만든다. 저자는 고전 컴퓨터로 이 속도 향상을 재현할 수 없고, 양자 가속을 주장하지도 않는다고 분명히 했다. 그 대신 고전적으로도 성립하는 요소 두 가지를 가져왔다. 첫째, 문제에 구조가 있으면 수많은 경로가 훨씬 적은 수의 상태로 합쳐진다. 따라서 상태 단위로 추론하는 방식은 여러 경로를 상태 하나의 비용으로 처리할 수 있다. 둘째, 어떤 상태를 한 번 기각하면 그 상태를 지나는 모든 경로가 함께 제거된다. 아직 적지 않은 경로도 여기에 포함된다.
실험 과제로 카운트다운을 쓴 이유
카운트다운은 숫자 몇 개와 목표 수를 주고, 모든 숫자를 한 번씩 써서 목표 수를 만드는 식을 찾게 하는 퍼즐이다. 한 단계마다 두 수를 덧셈, 뺄셈, 곱셈, 나눗셈 중 하나로 결합하고, 결과는 양의 정수여야 한다. 계산 자체는 쉽고, 탐색 조건에서는 모델이 아닌 환경이 계산을 맡는다. 이 퍼즐이 어려운 이유는 어떤 두 수를 어떤 연산으로, 어떤 순서로 결합할지 골라야 하기 때문이다.
선택지의 수는 숫자 개수에 따라 빠르게 늘어난다. 숫자가 4개면 문제당 완결된 수순이 평균 약 570개지만, 6개면 831,176개가 된다. 게다가 두 번 결합한 시점에서 이미 이 수순의 80% 이상이 목표에 도달할 수 없는 상태를 지나간다.
저자는 한 줄로 추론하는 모델이 바로 이 선택에 토큰을 쓴다고 설명했다. Interference Search가 바꾸려는 부분도 이 선택이다. Qwen3-1.7B도 실패할 때 계산을 틀리지는 않았고, 스스로 이미 기각한 식을 다시 시도하는 경우가 많았다. 또 카운트다운에는 정확한 솔버가 있어서, LLM에게 채점을 맡기지 않고도 모든 상태에 목표 도달 가능 여부를 표시할 수 있다. Stream of Search와 APR 같은 선행 연구가 언어 모델의 탐색을 연구할 때 카운트다운을 쓴 것도 같은 이유에서다.
탐색 한 라운드의 구조
Interference Search를 적용하려면 도메인이 시작 상태, 제안기, 병합 키, 판정기, 목표 판정, 막다른 상태 판정의 여섯 가지 함수를 제공해야 한다. 살아 있는 상태마다 다음 상태 후보를 만드는 것은 제안기의 일이고, 두 상태가 같은 상황인지는 병합 키가 정하며, 점수는 판정기가 매긴다. 비용을 세는 단위도 도메인마다 달라서, 카운트다운은 판정한 상태 수로, 코드는 생성한 토큰 수로 비용을 센다.
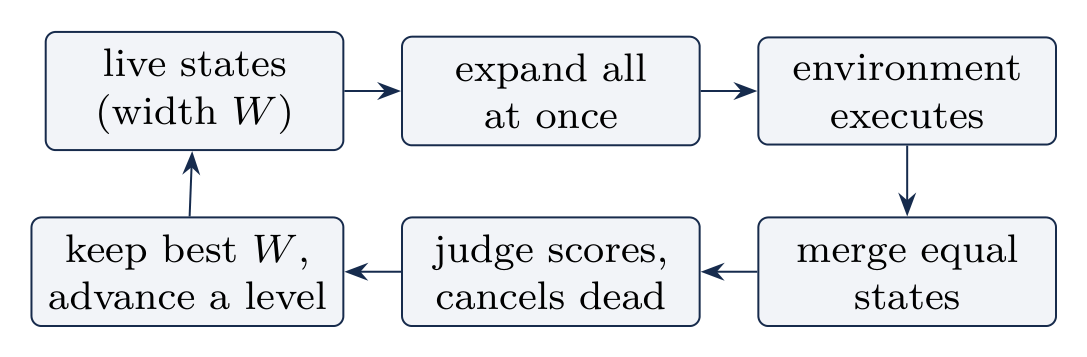
한 라운드는 다음 순서로 진행된다.
- 살아 있는 상태를 모두 전개하고, 환경이 제안된 수를 실행한다.
- 결과 상태를 병합 키로 모은다. 여러 부모가 같은 상태를 제안하면 그 상태는 하나만 남기고, 부모들이 그 상태를 제안한 순위는 투표로 합산한다.
- 이미 전개한 적이 있는 키의 상태는 버린다. 이 기록이 분기가 자기 실패를 다시 방문하지 못하게 막는 메모리 역할을 한다.
- 판정기가 남은 상태에 점수를 매기고, 상위 W개만 살아남아 모두 함께 다음 레벨로 진행한다.
폭 W는 예산으로 정한다. 따라서 예산을 늘리면 동시에 유지하는 상태 수가 늘어난다. 탐색 깊이는 문제가 정한다. 라운드 사이에 전달되는 정보는 상태들과 이미 전개한 병합 키의 목록뿐이다. 이 루프는 대화 기록을 보관하지 않으며, 제안기는 매번 상태 하나만 본다.
모든 비교의 기준선인 단일 사슬도 같은 여섯 함수를 쓴다. 단일 사슬은 현재 상태의 자식들을 판정하고, 점수에 비례해 하나를 골라 계속 진행하며, 사슬이 막다른 상태에 이르면 처음부터 다시 시작한다.
탐색 공간은 대부분 중복이다
카운트다운에서는 상태를 정확하게 정의할 수 있다. 상태는 남은 숫자들을 정렬한 다중집합이고, 동적 계획법으로 모든 상태의 목표 도달 가능 여부를 계산할 수 있다.
| 숫자 개수 | 경로 | 상태 | 상태당 경로 | 두 번 결합 뒤 막힌 경로 비율 |
|---|---|---|---|---|
| 4 | 566 | 159 | 3.6배 | 95.4% |
| 5 | 17,266 | 1,511 | 11.4배 | 96.2% |
| 6 | 831,176 | 13,229 | 62.8배 | 82.6% |
원문 표 1을 옮겼다. 크기마다 해가 있는 무작위 문제 20개의 평균이고, 마지막 비종결 레벨을 기준으로 셌다. 오른쪽 열은 완결된 경로 가운데, 두 번 결합한 시점에 이미 목표에 도달할 수 없게 된 상태를 지나는 경로의 비율이다.
이 표에서 방법의 전제 두 가지를 확인할 수 있다. 첫째, 다섯 번째 숫자를 더하면 상태당 경로 수가 3.2배, 여섯 번째 숫자를 더하면 5.5배 늘어난다. 따라서 상태 단위로 탐색해서 얻는 절감 효과는 문제 크기보다 빠르게 커진다. 둘째, 두 번만 결합해도 전체 경로의 80% 이상이 이미 막다른 상태를 지나간다. 그 시점에 한 상태를 정확하게 기각하면 탐색의 대부분을 한 번에 제거할 수 있다.
언어 모델에서도 중복이 직접 관찰됐다. 어려운 문제 6개에 독립 샘플 8개씩을 돌린 실험에서 실패한 시도는 381건이었다. 그중 29.7%는 다른 샘플이 앞서 낸 실패를 반복했다. 저자가 미리 등록한 지표로 계산하면, 이 반복에 전체 생성 토큰의 16.5%가 쓰였다. 45.1%는 같은 샘플이 앞서 낸 실패를 반복했다.2
학습 때보다 큰 문제에도 통하는 판정기
카운트다운 판정기는 폭 64인 2층 set transformer다. 입력으로는 숫자 하나마다 특징 벡터 하나를 받는다. 이 벡터에는 목표 수를 기준으로 계산한 값들, 즉 로그 크기와 목표까지의 거리, 나누어떨어지는지 여부, 2~12로 나눈 나머지가 포함된다. 숫자의 순서를 바꿔도 판정 결과가 같고, 숫자 개수가 달라도 입력으로 받을 수 있다. 저자는 학습용으로 4숫자 문제 400개와 5숫자 문제 400개를 준비했다. 이 문제들에서 도달 가능한 상태는 모두 632,279개였고, 저자는 동적 계획법으로 각 상태의 목표 도달 가능 여부를 계산한 뒤 판정기를 여섯 에포크 동안 학습시켰다. 632,279개 가운데 목표에 도달할 수 있는 상태는 2.6%뿐이었다. README는 판정기의 파라미터 수를 약 10만 개로 소개했다.
저자는 판정기를 학습에 쓰지 않은 크기의 문제로 시험했다. 병합된 상태를 너비 우선으로 탐색하되, 판정기 점수가 기준값 τ 이상인 상태만 남기는 방식이다.
| 시험 세트 | 가지치기 | 해결 | 작업량 |
|---|---|---|---|
| 6숫자 무작위 100문제 | 없음 | 100% | 100% |
| 수작업 상한3 | 100% | 97.8% | |
| 판정기, τ = 0.7 | 100% | 9.3% | |
| 판정기, τ = 0.9 | 86% | 3.7% | |
| 정확한 오라클 | 100% | 1.1% | |
| 6숫자 어려운 문제(해 경로 24개 이하) | 판정기, τ = 0.2 | 98% | 17.9% |
| 판정기, τ = 0.5 | 78% | 7.3% | |
| 판정기, τ = 0.7 | 43% | 4.3% | |
| 7숫자 무작위 10문제 | 판정기, τ = 0.7 | 100% | 7.9% |
| 판정기, τ = 0.9 | 90% | 3.3% |
원문 표 2를 옮겼다. 작업량은 가지치기를 하지 않았을 때와 비교한 전개 상태 수의 비율이다.
판정기를 쓰자 무작위 6숫자 문제에서 전개한 상태 수가 90.7% 줄었고, 놓친 해는 하나도 없었다. 같은 문제에서 수작업 상한이 제거한 비율은 2.2%였다. 7숫자 문제는 학습에 쓴 가장 큰 문제보다 숫자가 2개 많은데, 여기서도 판정기는 탐색량을 92.1% 줄였다. 12.6분의 1로 줄어든 셈이다. 이 세트는 10문제뿐이다.
어려운 문제에서는 판정기의 약점이 드러났다. 저자는 무작위 문제가 판정기에 유리하다고 지적했다. 해가 여러 개인 경우가 많아서, 판정기가 해 몇 개를 잘못 가지치기해도 나머지 해가 남기 때문이다. 해 경로가 24개 이하인 어려운 문제에서는 무작위 문제에서 안전했던 기준값 0.7이 문제의 절반 이상을 놓쳤다. 이 세트에서 안전한 기준값은 0.2였고, 해결률을 2%포인트 잃는 대신 탐색량을 5.6분의 1로 줄였다.
탐색의 형태를 바꾼 효과
저자는 판정기를 고정하고 탐색의 형태만 바꿔서 비교했다.
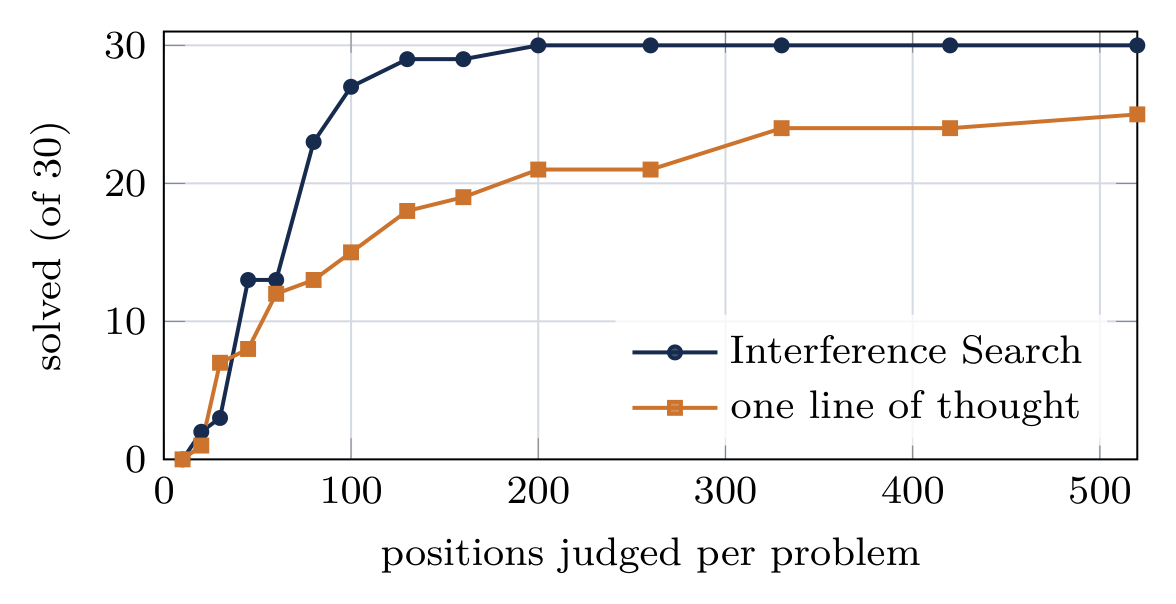
| 예산 | 단일 사슬 해결 | 단일 사슬 단계 | Interference Search 해결 | Interference Search 단계 |
|---|---|---|---|---|
| 150 | 19 | 6.8 | 29 | 3.0 |
| 200 | 21 | 7.9 | 30 | 3.0 |
| 500 | 24 | 10.8 | 30 | 3.0 |
| 1,500 | 30 | 23.7 | 30 | 3.0 |
원문 표 3을 옮겼다. 어려운 4숫자 문제 30개가 대상이고, 단계는 푼 문제에서 순서대로 거친 라운드 수의 평균이다. 어려운 문제의 기준은 연산 한 번으로 목표와의 차이를 25 이내로 줄일 수 없고, 해가 2개 이하인 문제다.
Interference Search에서는 분기들이 함께 진행하므로, 필요한 라운드 수가 실수 횟수와 무관하게 문제의 깊이로 정해진다. 벽시계 시간은 노트북 CPU에서 두 방식 모두 문제당 몇 밀리초였다. 프런티어4는 8~14ms, 단일 사슬은 11~24ms였는데, 저자의 구현이 분기를 하나씩 순서대로 실행하기 때문이다. 저자는 단계마다 비싼 모델 호출을 병렬로 실행하는 상황에서 단계 수의 차이가 지연 시간의 차이가 된다고 설명했다.
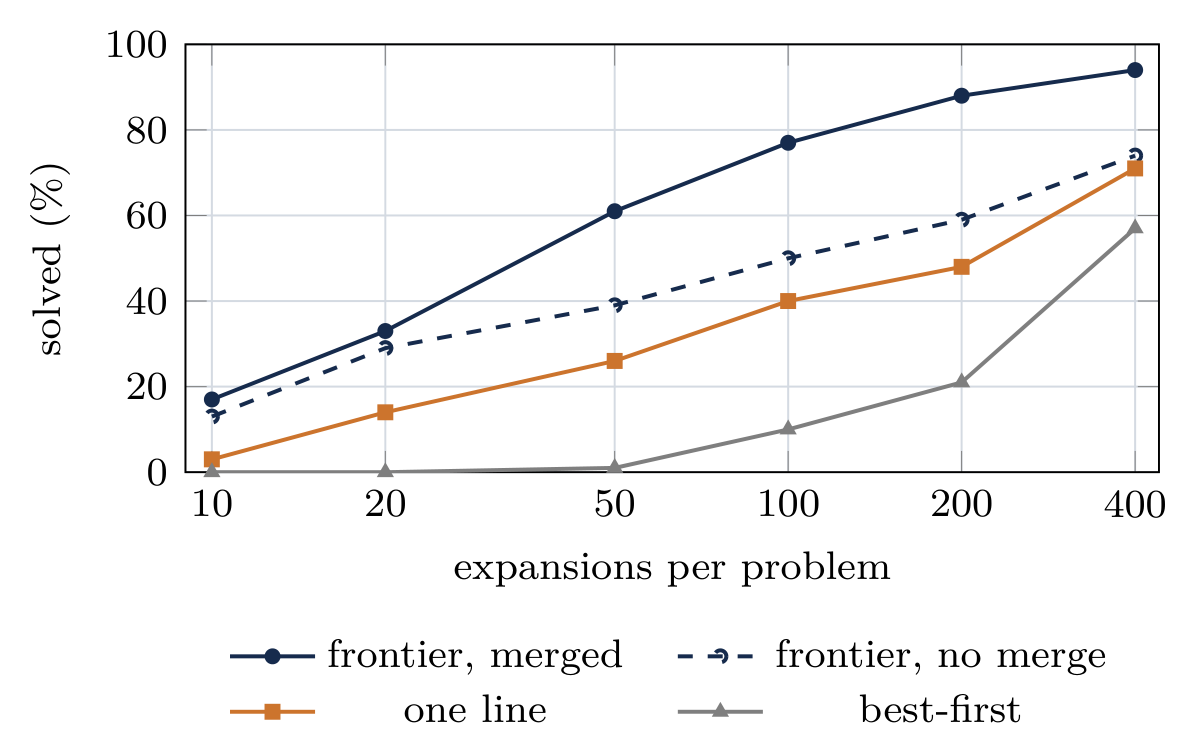
이득이 어디서 오는지 확인하려고 저자는 학습에 쓰지 않은 6숫자 문제 100개에서 네 가지 방식을 같은 전개 횟수로 비교했다. 전개 100회에서 해결률은 병합한 프런티어 77%, 병합하지 않은 프런티어 50%, 단일 사슬 40%, 최선 우선 탐색 10%였다.
- 병합을 빼면 살아남는 W개 상태 가운데 상당수가 중복 상태가 된다. 따라서 계산량 대비 이득의 대부분은 병합에서 나온다.
- 최선 우선 탐색은 지금까지 본 모든 상태를 한 순위표로 관리한다. 이 방식은 안전해 보이는 얕은 상태만 계속 고르고 깊은 단계로 진행하지 않았다. 저자는 이 결과를 근거로 레벨 단위로 함께 진행하는 구조가 중요하다고 보았다.
- 프런티어는 5라운드 만에 끝났고, 단일 사슬은 116라운드가 걸렸다.
- 예산이 크면 7숫자 문제에서 두 방식의 차이가 없어졌다. 전개 400회를 주자 두 방식 모두 87%를 풀었다. 프런티어의 이점은 작은 예산과 중간 예산에서 나타났다.
저자는 병렬 스트림이 스스로 협력하는 법을 배우는지도 따로 시험했다. 숨겨진 목표를 찾는 트리 탐색 환경에서 모든 스트림이 같은 잡음 섞인 힌트를 받고, 소형 트랜스포머 정책을 처음부터 그룹 정책 경사법으로 학습시켰다. 스트림 4개가 서로 격리된 조건의 성공률은 0.508, 서로를 참조(attention)할 수 있는 조건은 0.511로 차이가 없었다. 두 조건 모두 자기 메모리를 가진 단순한 확률적 플레이어(0.70)에 못 미쳤고, 메모리를 공유하는 플레이어(0.82)에는 훨씬 못 미쳤다. 저자는 서로를 볼 수 있다는 조건만으로는 정보 공유가 생기지 않았으며, 협력은 명시적인 연산으로 구현해야 했다고 결론지었다. Interference Search에서는 병합과 판정기가 그 역할을 맡는다.
언어 모델과 결합한 결과
같은 어려운 30문제에서 사고 모드를 켜고 1,500토큰 예산을 준 Qwen3-1.7B는 3문제를 풀었다. 저자는 이 결과를, 환경이 수를 나열하고 판정기가 상태 순위를 매기는 탐색과 비교했다.
| 시스템 | AUC | 해결(30문제 중) |
|---|---|---|
| Qwen3-1.7B의 텍스트 사고 | 3 | |
| Interference Search, 모델에게 예/아니오를 묻는 판정기 | 0.58 | 4 |
| Interference Search, 모델 은닉 상태의 선형 프로브 | 0.87 | 15 |
| Interference Search, 숫자 특징의 선형 프로브 | 0.94 | 22 |
| Interference Search, 학습된 set transformer | 0.98 | 23 |
원문 표 4를 옮겼다. AUC는 학습에 쓰지 않은 4숫자 문제에서 목표에 도달할 수 있는 상태와 없는 상태를 얼마나 잘 구분하는지 나타낸다. 프로브는 다른 60문제의 상태 1,376개로 학습했고, 학습된 판정기는 632,279개로 학습했다.5
저자는 이 표에서 두 가지를 읽어 냈다. 첫째, 성능 향상의 원인은 탐색 구조였다. 프런티어의 판정기로 단순한 숫자 특징 프로브를 써도, 모델이 혼자 추론할 때보다 7배 많은 문제가 풀렸다. 모델은 약 1,400개의 토큰을 생성했지만, 탐색은 3라운드 만에 끝났다. 둘째, 모델의 은닉 상태에는 모델의 답변보다 많은 도달 가능성 정보가 들어 있었다(AUC 0.87 대 0.58). 그러나 은닉 상태 프로브의 AUC는 단순한 숫자 특징으로 만든 프로브의 0.94보다 낮았다. 저자는 처음에 프로브 결과를 모델이 말하는 것보다 더 많이 안다는 뜻으로 읽었는데, 숫자 특징으로 만든 대조군이 그 해석을 뒷받침하지 않았다고 밝혔다.
저자는 학습 없이 모델에서 이런 동작을 끌어내려는 시도 세 가지가 모두 실패했다고 보고했다.
- 텍스트 장부. 256토큰마다 스트림 8개에게 자신과 다른 스트림이 이미 기각한 식을 알려 주었다. 그러자 메모를 받은 뒤 80토큰 동안 나온 시도의 33.6%가 다른 스트림이 기각한 식을 반복했다. 메모가 없을 때는 약 21%였다. 저자는 어떤 식이 틀렸다고 알려 주면 도리어 모델이 그 식을 떠올리게 된다고 해석했다. 해결 수는 24문제 중 22, 21, 22로 변화가 없었다.
- 디코딩 중 되감기. 스트림이 이미 기각된 식을 쓰면 되감아서 다시 샘플링하게 했다. 모델은 같은 줄을 최대 16번 연속으로 다시 생성했다. 저자는 반복의 원인이 문맥의 더 앞부분에 있으므로, 같은 문맥에서 다시 샘플링하면 같은 줄이 다시 나온다고 설명했다.
- 상태만 보여 주는 프롬프트. 현재 상태만 보여 주고 다음 수를 물었더니, 모델은 목록의 처음 두 숫자를 더하고 같은 3단계 경로를 반복했다. 메모리를 주고 숫자 순서를 섞어도 작은 문제 세트에서 한 문제도 풀지 못했다.
코드 과제
코드에서는 제안기가 선택지를 직접 만들어 내야 한다. 저자는 상태를 프로그램과 그 동작의 쌍으로 정의했다. 동작은 각 테스트에서 프로그램이 돌려준 값이나 발생시킨 예외다. 인터프리터가 실행을 맡고, 동작이 같은 프로그램은 병합하며, 판정기 점수는 통과한 테스트 수다. 각 제안에는 과제 설명, 현재 프로그램, 그 프로그램의 테스트 결과만 보여 준다.
| 전략(생성 토큰 1,500) | 해결 |
|---|---|
| 전체 대화 기록을 유지하는 에이전트 루프 | 7 / 30 |
| 최신 프로그램을 테스트 결과로 수정 | 7 / 30 |
| 매번 새로 시도(best of N) | 8 / 30 |
| Interference Search | 9 / 30 |
원문 표 5를 옮겼다. MBPP 처음 150문제 가운데 Qwen3-1.7B가 첫 탐욕 디코딩 시도에서 틀린 문제는 69개였고, 그중 30문제를 썼다. 예산 이내에 푼 문제만 해결로 셌다.
병렬 전략 두 가지가 순차 전략 두 가지보다 많이 풀었고, Interference Search는 독립 샘플링보다 한 문제 많이 풀었다. 저자는 30문제에서 한 문제 차이는 잡음 범위라고 적었다. 동작 병합으로 모델이 생성한 프로그램의 83%가 중복으로 제거됐다. 에이전트 루프는 세 번째 라운드 이후로는 대화 기록만 늘어났을 뿐 새로 푼 문제가 없었다.
저자는 실행 기록을 보면 성능이 더 오르지 않는 이유를 알 수 있다고 설명했다. 학습하지 않은 이 작은 모델은 처음 떠올린 방법이 틀리면 수정할 때도 같은 방법을 다시 만들어 냈다. 따라서 이 실험에서 탐색은 모델이 떠올린 방법들을 정리할 뿐, 새로운 방법을 더해 주지는 못했다. 저자는 이 한계를 해결할 방향 두 가지를 제시했다. 프런티어에서 학습한 모델은 서로 다른 살아 있는 분기를 내야 보상을 받는다. 중복은 병합되어 보상을 받지 못하기 때문이다. 또 검색처럼 환경을 바꾸지 않는 행동은 제약 없이 분기시킬 수 있다. 두 방향 모두 이번 실험에서는 시험하지 않았다.
토큰 소비
| 카운트다운 30문제 | 생성 | 읽기 | 해결 |
|---|---|---|---|
| Qwen3-1.7B의 텍스트 사고 | 1,490 | 83 | 3 |
| Interference Search, 은닉 상태 프로브 판정기 | 0 | 4,290 | 15 |
| Interference Search, 학습된 판정기 | 0 | 0 | 23 |
| 코드, MBPP 30문제 | 생성 | 읽기 | 해결 |
|---|---|---|---|
| 전체 기록 에이전트 루프 | 1,218 | 기록 안 됨 | 7 |
| 최신 프로그램 수정 | 1,273 | 4,216 | 7 |
| 매번 새로 시도(best of N) | 1,357 | 1,473 | 8 |
| Interference Search | 1,368 | 1,934 | 9 |
원문 표 6을 옮겼다. 30문제 전체의 문제당 평균 언어 모델 토큰 수이며, 생성은 모델이 만든 토큰, 읽기는 모델이 처리한 프롬프트 토큰이다. 에이전트 루프는 라운드마다 늘어나는 대화 기록을 다시 읽는데, 읽기 토큰은 기록되지 않았다.
카운트다운에서 텍스트 사고는 푼 문제 하나당 약 14,900토큰을 생성했다(3문제에 44,703토큰). Interference Search는 토큰을 하나도 생성하지 않는다. 수는 환경이 만들고, 판정기는 상태마다 한 번의 순전파로 상태를 읽기만 한다. Qwen3-1.7B의 은닉 상태로 판정할 때 이 탐색은 푼 문제 하나당 약 8,600토큰을 읽었다. 판정 프롬프트는 66토큰인데, 상태에 따라 달라지는 부분은 그중 18토큰뿐이다. 공통 지시문을 캐시해 두면 문제당 새로 읽어야 하는 토큰이 약 1,200개로 줄어든다. 저자는 읽기가 생성보다 저렴하다는 점도 언급했다. 프롬프트 토큰은 병렬로 처리되고, 호스팅 모델은 대개 입력 토큰을 출력 토큰보다 싸게 받는다.
코드에서는 모델과 예산을 고정했으므로, 공정한 척도는 푼 문제 하나당 토큰 수다. 모든 전략이 풀지 못한 문제에서 1,500토큰 한도를 거의 다 쓰기 때문에, 문제당 평균은 비슷하게 나올 수밖에 없다. 푼 문제 하나당 생성 토큰은 Interference Search가 약 4,560개로 가장 적었고, 매번 새로 시도하는 전략이 5,090개, 최신 프로그램을 수정하는 전략이 5,460개였다. 푼 문제 하나당 읽은 토큰은 Interference Search가 6,450개로, 수정 전략의 18,070개보다 2.8배 적었다. 매번 새로 시도하는 전략보다는 조금 더 읽었는데, 프로그램을 수정하게 하려면 그 프로그램을 보여 줘야 하기 때문이다.
시간도 크게 달랐다. README에 따르면 탐색은 CPU에서 문제당 약 5ms가 걸렸고, 모델이 텍스트로 생각하는 데는 약 21초가 걸렸다. 저자는 둘이 다른 시스템이라는 점을 분명히 했다. 빠른 쪽은 환경으로 수를 나열하고 파라미터 10만 개짜리 판정기로 순위를 매길 뿐, 언어 모델을 실행하지 않는다. 언어 모델을 실제로 쓰는 조건끼리 비교하면, M2에서 한 번에 한 문제씩 풀었을 때 Qwen3-1.7B의 텍스트 사고는 57.4초에 1문제를 풀었고, Qwen3-1.7B 은닉 상태 프로브를 판정기로 쓴 탐색은 15.2초에 15문제를 풀었다.6
선행 연구와의 관계
구성 요소마다 이미 선행 연구가 있다는 점은 저자도 인정했다.
| 구성 요소 | 선행 연구 |
|---|---|
| 한 모델 내 병렬 스레드 | APR, ThreadWeaver |
| 환경 스냅샷을 기준으로 에이전트를 분기 | ParallelEnv |
| 트리 탐색에서 등가 상태 병합 | FETCH, 전치표(transposition table) |
| 전체 기록 대신 간결한 추론 상태 유지 | Atom of Thoughts, Markovian Thinker, PENCIL |
| 더 큰 문제에도 통하는 학습된 가지치기 | 관계형 Q-함수 |
저자는 이 요소들을 조합한 연구는 찾지 못했다고 밝혔다. 조합한 요소는 명시적 상태, 병합, 학습된 판정기, 레벨 단위로 함께 진행하는 프런티어다. 저자는 이 네 요소를 사고 단계(제안과 판정)와 실행 단계(수 적용과 테스트 실행)에 모두 적용했다. 리포의 선행 연구 문서는 APR의 스레드가 상태를 공유하거나 병합하지 않으므로, 같은 토큰 수에서 APR과 직접 비교하는 실험이 가장 깔끔한 비교가 될 것이라고 적었다. 그 비교는 아직 하지 않았다.
한계와 재현
논문은 한계를 다음과 같이 정리했다.
- 모든 결과는 시드 하나로 얻었다. 주요 주장은 조건마다 30문제, 7숫자 시험은 10문제에 근거한다. 저자의 수치 대조표에 따르면, 30문제에서 이 정도 해결률이면 표본 잡음이 대략 ±2.5문제다.
- 최상위 모델이라면 이 카운트다운 문제 대부분을 텍스트 추론으로 풀 가능성이 크다. 이 연구는 모델과 판정기를 고정하고 탐색 형태만 바꿨으며, 최상위 모델 규모에서는 실험하지 않았다.
- 가장 좋은 카운트다운 수치는 작은 학습된 판정기와 수를 나열하는 환경으로 얻었고, 언어 모델을 실행하지 않았다. 문제당 5~14ms라는 시간을 언어 모델 자체의 속도 향상으로 볼 수는 없다.
- 판정기는 상태가 정확하고 솔버로 레이블을 만들 수 있는 카운트다운에서만 만들었다. 개방형 도메인에서는 병합 키를 학습해야 하고, 레이블도 롤아웃으로 만들어야 하는데, 저자는 아직 이 부분을 구현하지 않았다.
- 코드에서 독립 샘플링 대비 이득은 잡음 범위다.
- 언어 모델은 학습시키지 않았다. 이렇게 추론하도록 학습시킨 모델이 같은 이득을 유지하는지는 아직 알 수 없다.
모든 실험은 메모리 16GB인 Apple M2 노트북 한 대에서 돌렸다. 리포의 paper/CLAIMS.md는 논문의 모든 수치를 그 수치를 만든 결과 파일과 명령어에 연결해 둔다. scripts/reproduce_countdown.sh는 GPU 없는 리눅스 VM의 CPU로 약 10분이면 카운트다운 수치 전체를 다시 계산하고, 결과를 공개된 결과 파일과 대조한다. 해결률과 단계 수는 결정적이어서 정확히 일치해야 하고, 시간은 기계마다 다르다. 언어 모델 실험은 MLX를 쓰므로 Apple 실리콘이 필요하다.
내가 눈여겨본 결과
나는 저자가 정리한 실패 목록에 가장 관심이 갔다. 이미 틀린 식을 알려 주었더니 모델이 그 식을 더 자주 반복했다는 결과(33.6% 대 약 21%)는, 코끼리를 생각하지 말라는 말을 들으면 코끼리가 떠오르는 현상과 닮았다. 저자는 이 실패를 근거로, 반복을 막는 장치는 프롬프트나 디코딩 요령으로는 만들 수 없고 탐색 구조로 구현하거나, 모델을 학습시켜 그런 동작을 익히게 해야 한다고 결론지었다. 에이전트 하네스에서 실패 이력을 대화 기록에 계속 누적하는 방식이 흔한 만큼, 작은 모델에서 얻은 결과라 해도 참고할 가치가 크다.
연구 로그의 기록 방식도 눈에 띄었다. 저자는 은닉 상태 프로브 결과를 처음에 모델이 말하는 것보다 더 많이 안다는 증거로 읽었다가, 숫자 특징 대조군을 돌린 뒤 그 해석을 스스로 철회했다. 외부 리뷰를 받고 수정한 내용과 폐기한 실험도 순서대로 남겼고, 코드 과제의 9 대 8은 잡음이라고 먼저 밝혔다. 수치마다 결과 파일과 명령어를 연결한 대조표까지 있어서, 독자가 어느 수치를 믿을지 직접 확인할 수 있다.
출처
Al-ameen, Bad Theory Labs(나이지리아 라고스), 2026년 9월. 리포지터리 생성일 2026년 9월 25일, Apache 2.0 라이선스. 논문은 리포의 paper/PAPER.pdf이며 Bad Theory Labs 웹사이트에도 게시됐다.
원문: https://github.com/Badtheorylabs/interference-search
논문 페이지: https://www.badtheorylabs.com/papers/interference-search
간섭(interference)은 파동이 겹칠 때 서로 강해지거나 상쇄되는 현상이다. 저자는 틀린 경로들이 서로 상쇄되는 양자 탐색의 모습에서 이름을 따왔다. ↩︎
같은 실험에서 전체 토큰의 46%는 어느 샘플이 이미 답을 찾은 뒤에 생성됐다. 이 몫은 합의 기반 조기 종료 기법(Parallel-Probe 등)이 줄이는 부분이어서 저자는 중복 계산에 포함하지 않았다. ↩︎
도달할 수 있는 가장 큰 값조차 목표보다 작으면 그 상태를 가지치기하는 규칙이다. 해가 있는 상태를 잘못 제거하지 않는다는 보장이 있지만, 가지치기할 수 있는 상태가 적다. ↩︎
프런티어는 한 라운드에서 살아 있는 상태들의 집합이다. 이 글에서는 Interference Search의 레벨 단위 탐색을 가리킨다. ↩︎
같은 학습된 판정기가 이 표에서는 23문제, 앞의 표 3에서는 30문제를 풀었다. 리포의
experiments/llm/probe.py를 보면 이 표의 탐색은 폭 6, 판정 상한 150회로 설정되어 있어, 판정 200회를 준 앞의 비교와 조건이 다르다. ↩︎이 시간 측정은 별도 실행이어서, 텍스트 사고의 해결 수가 표 4의 3문제와 다르다. 결과 파일은
results/llm/cot_timing.json과results/llm/probe_search_timing.json이다. ↩︎