3줄 요약
- 홍콩이공대, 중국과학원, 막스플랑크 연구소, 튀빙겐 AI 센터 공동 연구진이 2026년 10월 arXiv에 공개한 논문이다. 같은 트랜스포머 블록을 수천에서 수만 번 반복 실행하면서 직전 반복의 상태만 다음 반복으로 넘기면, 이후의 갱신이 이미 옳게 구한 중간 추론과 완성된 정답을 덮어쓴다. 연구진은 이 현상을 ‘잠재 과잉사고(latent overthinking)’로 진단했다.
- 연구진은 이를 해결하려고 반복 구조 전용 잔차 연결인 InfiLoop를 제안했다. InfiLoop는 각 반복이 내놓는 후보 상태를, 학습된 내용 점수와 지수 시간 감쇠를 곱한 가중치로 합산한다. 이 합산은 정확한 스트리밍 점화식으로 유도할 수 있어, 토큰마다 가중합 분자 벡터 하나와 정규화 분모 스칼라 하나만 저장하면 된다. 따라서 반복 횟수가 아무리 늘어나도 메모리 사용량이 일정하다.
- 700만 파라미터 크기의 InfiLoop 모델은 Sudoku-Extreme에서 정확도 97.9%, ARC-AGI-2에서 pass@2 기준 13.6%를 달성해 같은 크기의 재귀 추론 모델들보다 높은 점수를 냈다. 테스트 시점에 실행 층 수를 2만 4,960층까지 늘려도 정확도는 계속 올랐다. 별도의 정답 감독 신호가 없는데도 모델은 탐색 중에는 갱신 폭을 억제하다가, 정답이 완성되는 순간 새 상태를 크게 반영하는 자기 검증 동작을 보였다.
반복이 늘어나면 이미 맞힌 답을 잃는다
루프 트랜스포머(Looped Transformer)는 가중치를 공유하는 트랜스포머 블록 하나에 입력을 여러 번 반복해서 통과시키는 구조다.1 파라미터 수를 늘리지 않고도 테스트 시점에 반복 횟수만 늘려 연산 깊이를 확장할 수 있다. 이때 연속된 반복을 잇는 가장 흔한 방식은 직전 반복의 마지막 출력을 다음 반복의 입력으로 그대로 넘기는 ‘최신 상태 전달 규칙(carry-last rule)’이다.
그러나 이 규칙을 쓰면 이전 반복에서 계산한 정보는 오직 가장 최근 상태에 남아 있는 만큼만 다음 반복으로 전달된다. 일반 트랜스포머의 잔차 연결(Pre-LN, Post-LN)은 한 블록 내부의 층 사이에서만 정보를 전달할 뿐, 여러 반복에 걸친 과거 출력들을 따로 보존하거나 선별하지 못한다. 그 결과 어느 한 반복에서 잡음이 섞인 상태 갱신이 일어나면 그때까지 구해 둔 중간 추론 결과가 훼손되고, 이후 반복은 이미 손상된 표현에서 정보를 복구해야 한다. 반복을 더 돌릴수록 이후의 갱신이 유효한 중간 상태를 덮어써서 정확도가 도리어 낮아진다. 연구진은 이 현상을 잠재 과잉사고(latent overthinking)라고 불렀다.
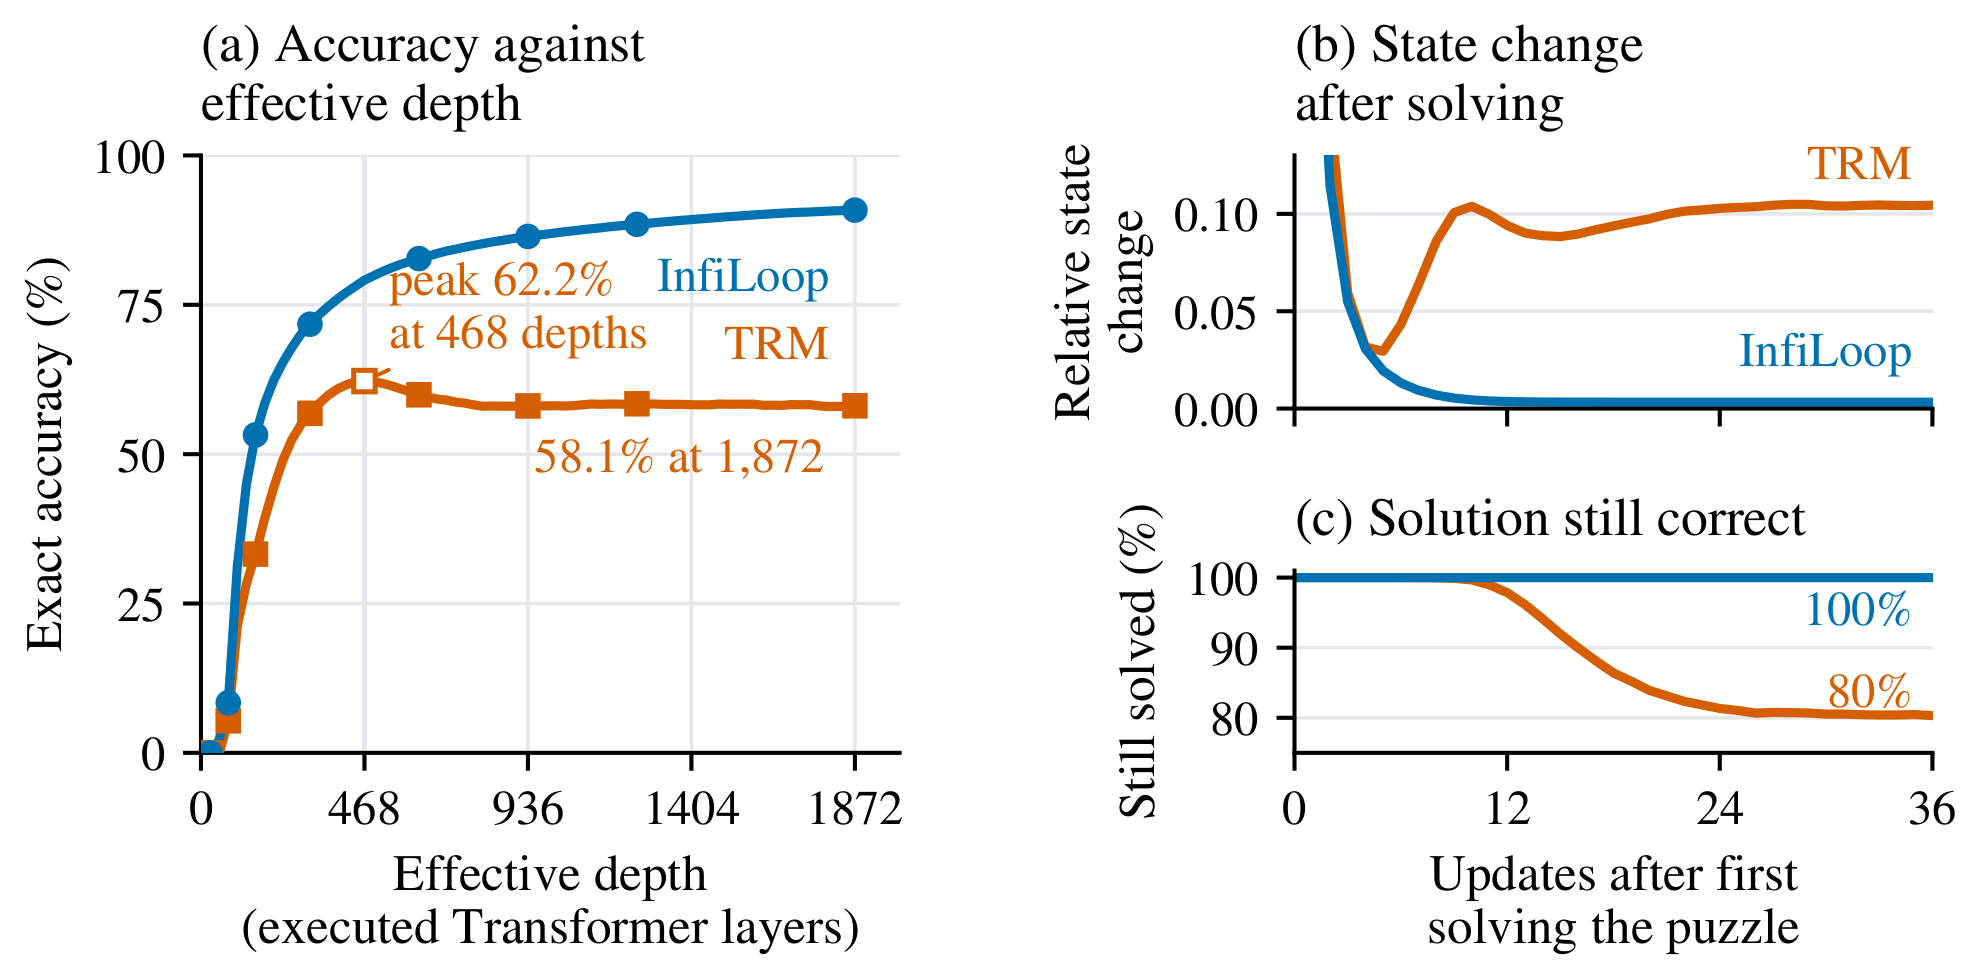
표지 그림(논문 Figure 1)은 Sudoku-Extreme에서 TRM(Tiny Recursive Model)과 InfiLoop를 비교한 결과다. Sudoku-Extreme은 고난도 스도쿠 벤치마크이고, TRM은 최신 상태 전달 규칙을 쓰는 재귀 추론 모델이다. 두 모델은 같은 반복 스케줄로 학습한 뒤 외부 순환 갱신(outer update)을 72회까지 실행했다. 외부 순환 갱신 1회는 트랜스포머 26개 층을 실행하는 것에 해당한다.
| 비교 항목 (Sudoku-Extreme, 외부 갱신 72회) | TRM (최신 상태 전달) | InfiLoop (제안 기법) |
|---|---|---|
| 실행 층 수에 따른 정확도 변화 | 468층에서 62.2% 기록 후 1,872층에서 58.1%로 하락 | 같은 구간에서 계속 올라 1,872층에서 90.9% 달성 |
| 갱신 36~72회 사이 퍼즐당 빈칸 예측 변경 횟수 | 77.0회 (오답 칸 수 퍼즐당 0.21개 증가) | 24.0회 (오답 칸 수 퍼즐당 1.25개 감소) |
| 36회 시점 정답 칸(142만 개)이 이후 한 번 이상 오답으로 바뀐 비율 | 20.9% | 2.4% |
| 정답 도달 후 상태의 상대 변화율 $\|\mathbf{h}_t - \mathbf{h}_{t-1}\| / \|\mathbf{h}_{t-1}\|$ | 5회 이내 3%로 줄었다가 다시 갱신당 10%로 상승 | 갱신당 0.3%로 감소 후 유지 |
| 36회 이내에 푼 퍼즐이 36회 추가 갱신 뒤에도 정답을 잃지 않은 비율 | 80.3% (19.7% 손실) | 100.0% (손실 없음) |
TRM은 퍼즐을 이미 다 푼 뒤에도 상태를 매번 10%씩 계속 바꾸다가 갱신 9회 뒤부터 정답을 잃기 시작했다. 최신 상태 전달 규칙은 가장 최근 출력이 이전 상태보다 더 나은지 따지지 않고, 매 반복의 출력을 100% 그대로 다음 상태로 삼는다.
상수 메모리로 과거 반복을 합산하는 점화식
연구진은 직전 출력을 그대로 넘기는 대신, 이전 반복들의 출력에 어텐션 가중치를 매겨 합산하는 잔차 연결을 설계했다. 본래의 어텐션 잔차(Attention Residuals) 기법은 깊은 신경망에서 각 층이 고유한 의사 질의(pseudo-query) 벡터를 두고 이전의 모든 층 출력을 참조한다.2 하지만 반복 횟수가 고정되지 않는 루프 트랜스포머에서 과거 반복의 상태를 모두 메모리에 저장하면, 메모리는 반복 수 $T$에 비례해 늘어나고($O(Td)$) 전체 합산 연산량은 $T$의 제곱에 비례해 늘어난다($O(T^2 d)$).
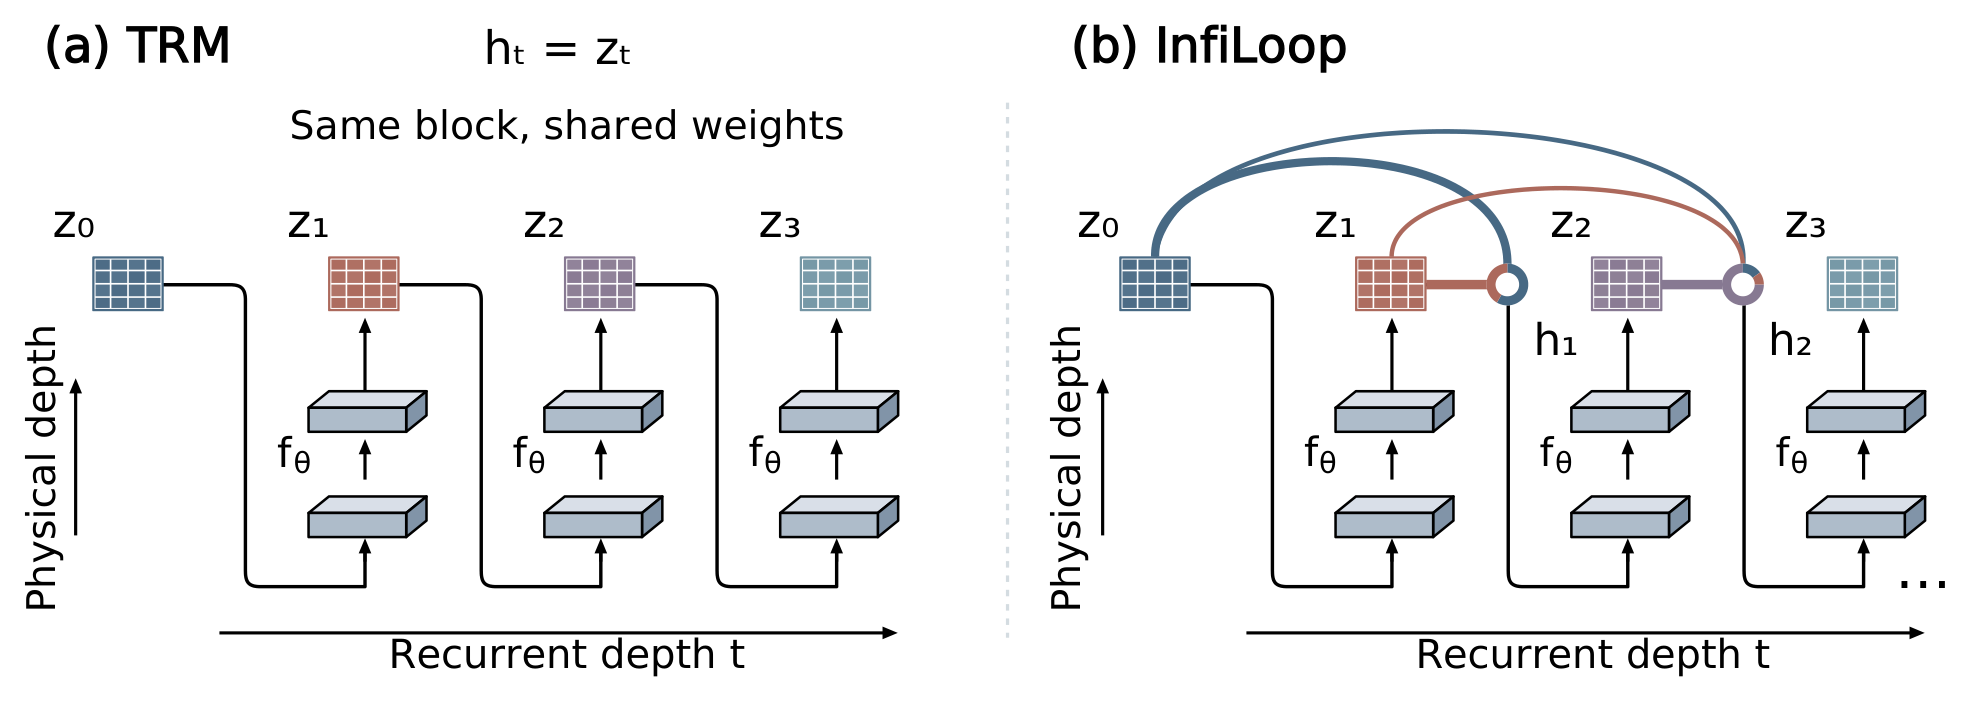 그림 1. 공유 블록 $f_\theta$를 반복 적용할 때의 연결 방식 비교. (a) TRM은 매 단계의 후보 출력 $z_t$를 다음 순환 상태 $h_t$로 그대로 넘긴다. (b) InfiLoop는 이전 단계들의 후보 출력에 내용 가중치와 지수 시간 감쇠를 적용해 합산한 상태 $h_t$를 다음 블록에 전달한다. 출처: 논문 Figure 2
InfiLoop는 두 가지 설계로 이 메모리 증가를 없앴다. 첫째, 모든 반복 단계가 학습된 의사 질의 벡터 $q \in \mathbb{R}^d$ 하나를 공유한다. 후보 상태 $z_i$가 생성될 때 내용 점수 $s_i = q^\top \operatorname{RMSNorm}(z_i)$를 단 한 번만 계산하며, 이 점수는 이후 반복에서도 바뀌지 않는다. 둘째, 오래된 후보일수록 가중치를 줄이는 지수 시간 감쇠율 $\lambda > 0$을 학습한다. 초기 상태를 $z_0 = h_0$이라 할 때, $t$번째 반복이 다음 블록에 넘기는 상태 $h_t$는 다음과 같이 정의된다.
$$h_t = \sum_{i=0}^{t} \alpha_{t,i} z_i$$$$\alpha_{t,i} = \frac{\exp\bigl(s_i - \lambda(t-i)\bigr)}{\sum_{j=0}^{t} \exp\bigl(s_j - \lambda(t-j)\bigr)}$$여기서 내용 가중치를 $e_i = \exp(s_i)$로, 한 단계당 시간 감쇠 인자를 $\beta = e^{-\lambda} \in (0, 1)$로 둔다. 그러면 정규화 전 가중합 분자 $N_t \in \mathbb{R}^d$와 정규화 분모 $D_t \in \mathbb{R}_{>0}$를, 과거 후보 전체를 저장하지 않고도 정확한 점화식으로 갱신할 수 있다.
$$N_t = \beta N_{t-1} + e_t z_t$$$$D_t = \beta D_{t-1} + e_t$$$$h_t = \frac{N_t}{D_t}$$이 점화식은 근사를 쓰지 않고 위 합산식을 대수적으로 다시 적은 항등식이다. 토큰마다 벡터 $N_t$ 하나와 스칼라 $D_t$ 하나만 유지하면 되므로, 반복을 몇만 번 돌리더라도 상태 메모리는 $O(d)$로 일정하고 반복당 합산 연산량도 $O(d)$에 그친다.3
| 연결 방식 | 과거 상태 반영 방식 | 상태 메모리 (토큰당) | $T$회 반복 시 총 합산 연산 | 경로당 추가 파라미터 |
|---|---|---|---|---|
| 최신 상태 전달 (Carry-Last) | 직전 후보 $z_t$로 전면 교체 | $O(d)$ | $O(Td)$ | $0$ |
| 전체 어텐션 잔차 (Full AttnRes) | 단계별 질의로 과거 후보 전체 참조 | $O(Td)$ | $O(T^2 d)$ | $Td$ |
| InfiLoop (제안 기법) | 공유 질의 점수와 지수 감쇠의 점화식 | $\boldsymbol{O(d)}$ | $\boldsymbol{O(Td)}$ | $\boldsymbol{d + 1}$ |
이 점화식에 $N_{t-1} = D_{t-1} h_{t-1}$을 대입해 정리하면, InfiLoop의 갱신은 직전 상태 $h_{t-1}$과 새 후보 $z_t$ 사이를 적응형 보폭(step size) $\gamma_t$로 보간하는 잔차 갱신식으로 다시 쓸 수 있다.
$$h_t = h_{t-1} + \gamma_t (z_t - h_{t-1})$$$$\gamma_t = \frac{e_t}{\beta D_{t-1} + e_t} \in (0, 1)$$보폭 $\gamma_t$는 새 후보의 내용 가중치 $e_t$와 감쇠된 과거 누적 질량 $\beta D_{t-1}$의 상대적 크기로 결정된다. 새 후보의 점수가 과거 누적치보다 훨씬 크면($e_t \gg \beta D_{t-1}$) $\gamma_t$가 1에 가까워져 새 후보를 적극 수용한다. 반대로 훨씬 작으면($e_t \ll \beta D_{t-1}$) $\gamma_t$가 0에 가까워져 기존 상태를 보존한다. 또한 모든 가중치가 양수이고 합이 1이므로 $h_t$는 언제나 후보 상태들의 볼록 조합(convex combination)이다. 따라서 상태 노름은 후보 노름의 최댓값 이하로 유지되고 발산하지 않는다($\|h_t\| \le \max_{0 \le i \le t} \|z_i\|$).
연구진은 이 연결을 TRM 같은 중첩 재귀 추론기(nested recurrent reasoner)에 적용했다. 후보를 반복 정제하는 내부 루프(inner loop)와 문맥을 갱신하는 외부 루프(outer loop), 두 순환 경로에 독립된 $(q, \beta)$ 쌍을 각각 두었다. 이렇게 추가되는 학습 파라미터는 경로당 $d+1 = 513$개, 둘을 합쳐 1,026개뿐이다.
네 가지 추론 벤치마크와 테스트 시점 확장
실험에 사용한 InfiLoop 모델은 2층 공유 트랜스포머 블록으로 구성한 700만(7M) 파라미터 모델이다. 블록은 은닉 차원 512, 어텐션 헤드 8개에 SwiGLU 활성함수와 $3 \times 3$ 깊이별 합성곱을 갖췄다. 이 모델의 추론 성능은 성격이 다른 네 가지 벤치마크로 검증했다.
| 벤치마크 | 과제 구성 및 평가 데이터 | 채점 지표 |
|---|---|---|
| Sudoku-Extreme | 빈칸이 많은 고난도 $9 \times 9$ 스도쿠 퍼즐 (학습 기본 1,000개 × 1,000배 증강, 테스트 42만 2,786개) | 81칸 전체 일치율 (exact accuracy) |
| Maze-Hard | $30 \times 30$ 격자 미로에서 시작 지점부터 목표 지점까지의 최단 경로 예측 (학습과 테스트 각 1,000개, 증강 없음) | 전체 격자 일치율 (exact accuracy) |
| ARC-AGI-1 | 소수의 예시 격자 쌍(최대 $30 \times 30$)에서 변환 규칙을 추론해 정답 격자 생성 (평가 400개) | 상위 2개 후보 정답률 (pass@2) |
| ARC-AGI-2 | 다중 규칙이 결합되어 단순 탐색이 통하지 않는 고난도 시각 추론 과제 (평가 120개) | 상위 2개 후보 정답률 (pass@2) |
다음 표는 프론티어 대형 언어 모델 및 기존 재귀 추론 모델들과 성능을 비교한 결과다. 표에서 –는 원 논문에서 보고되지 않은 항목이다.
| 모델 | 파라미터 | Sudoku-Ext. | Maze-Hard | ARC-1 | ARC-2 |
|---|---|---|---|---|---|
| DeepSeek R1 | 671B | 0.0 | 0.0 | 15.8 | 1.3 |
| Claude 3.7 Sonnet (16K) | – | 0.0 | 0.0 | 28.6 | 0.7 |
| o3-mini-high | – | 0.0 | 0.0 | 34.5 | 3.0 |
| Gemini 2.5 Pro (32K) | – | – | – | 37.0 | 4.9 |
| HRM | 27M | 55.0 | 74.5 | 40.3 | 5.0 |
| Attractor Model | 27M | 91.4 | 93.1 | – | – |
| URM4 | 14M | 77.6 | – | 53.8 | 16.0 |
| TRM (원 논문 보고치) | 7M | 74.7 | 85.3 | 44.6 | 7.8 |
| TRM (저자 재현치) | 7M | 73.6 | – | – | 4.6 |
| EqR | 7M | 93.0 | – | – | – |
| Attractor Model | 7M | 54.3 | 46.7 | – | – |
| FPRM | 7M | 94.2 | 87.0 | 47.5 | 6.2 |
| InfiLoop (제안 기법) | 7M | 97.9 | 87.4 | 49.1 | 13.6 |
InfiLoop는 비교 대상인 700만 파라미터 모델들 가운데 네 벤치마크 모두에서 가장 높은 점수를 냈다. Sudoku-Extreme에서는 97.9%로 TRM(74.7%), 그리고 감쇠 고정점 갱신을 쓰는 FPRM(94.2%)보다 높았다. 복합 변환 규칙을 요구하는 ARC-AGI-2에서는 13.6%로, TRM(7.8%)의 약 1.7배, FPRM(6.2%)의 약 2.2배 성적이다.
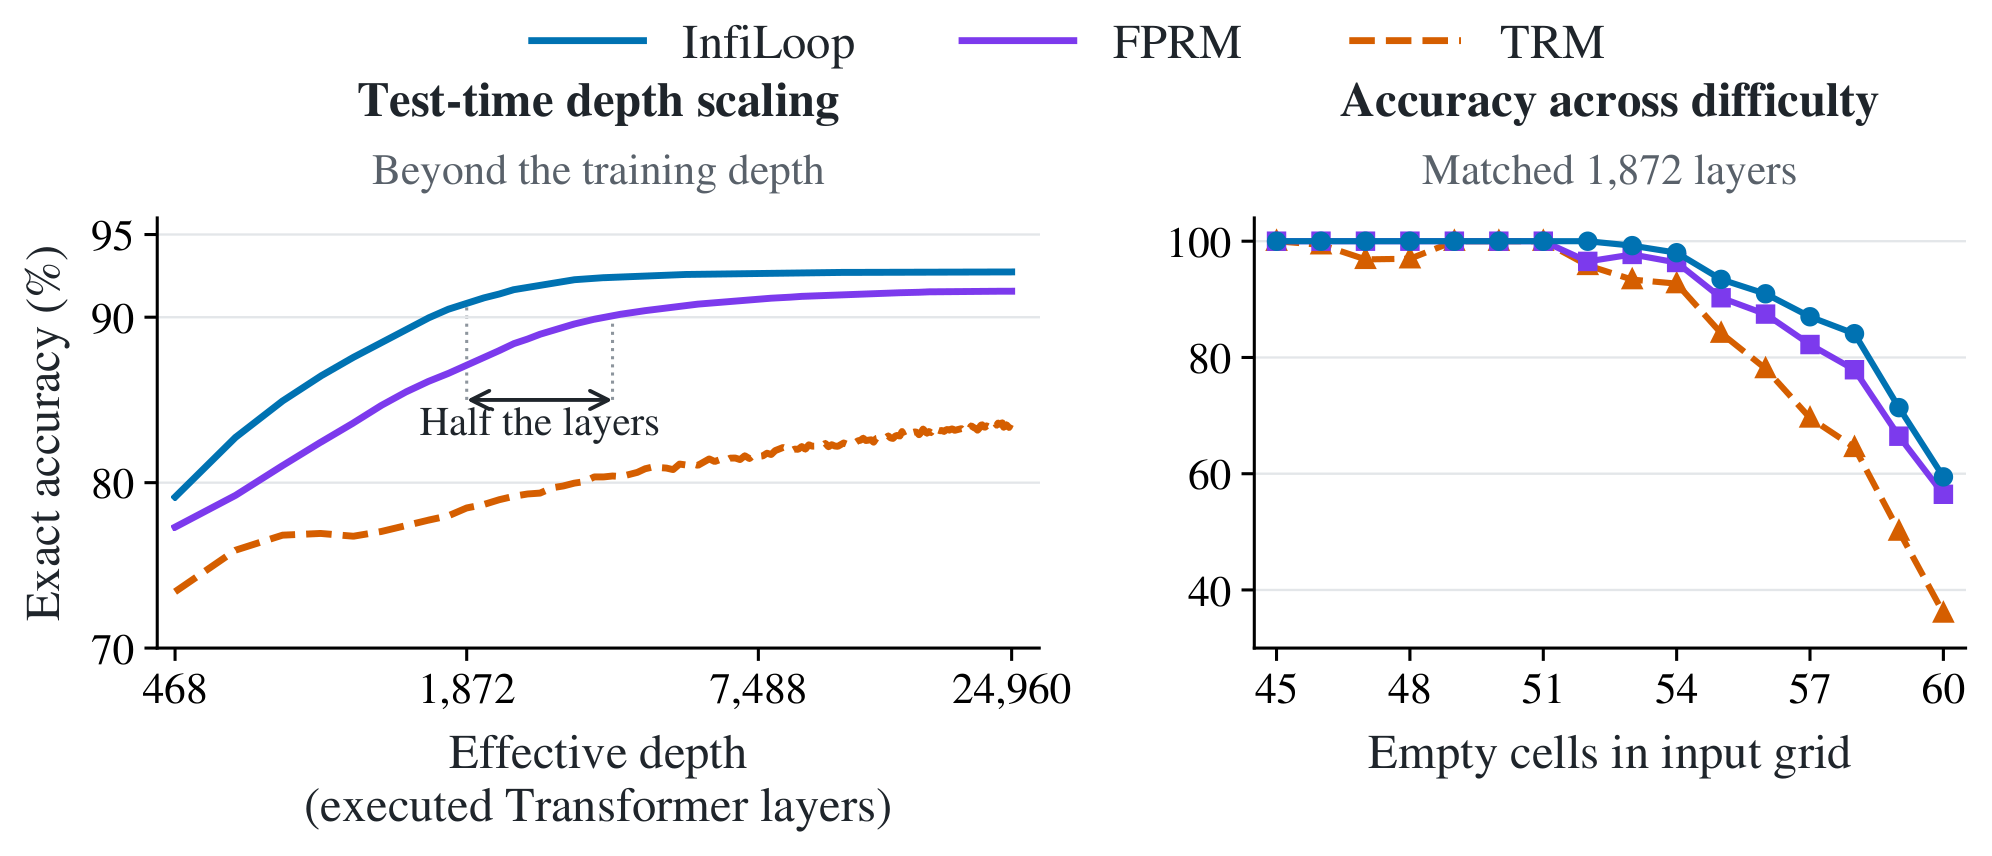 그림 2. 왼쪽은 Sudoku-Extreme에서 재학습 없이 테스트 시점 실행 층 수를 2만 4,960층까지 늘렸을 때의 정확도다. 오른쪽은 실행 층 수를 1,872층으로 맞춘 상태에서 초기 빈칸 개수(난이도)에 따른 정확도다. 출처: 논문 Figure 3
학습 때는 504층($S{=}12, H{=}3, L{=}6$)만 실행한 모델을, 재학습 없이 테스트 시점에 최대 2만 4,960층($S{=}160, H{=}6, L{=}12$)까지 반복 실행해 연산 효율도 측정했다. InfiLoop는 1,872층에서 정확도 90.9%를 기록했다. FPRM은 그 두 배인 3,744층을 실행하고도 90.1%였다. 같은 3,744층에서 InfiLoop는 92.4%에 도달했고, 2만 4,960층에서는 InfiLoop 92.74%, FPRM 91.63%, TRM 83.65%였다. 특히 TRM은 2만 4,960층까지 반복해도, InfiLoop가 936층에서 얻은 정확도 86.5%보다 낮았다. 936층은 2만 4,960층의 약 27분의 1 수준이다.
그림 2 오른쪽은 스도쿠 초기 빈칸 수(45~60개)로 난이도를 구분해 평가한 결과다(1,872층 기준, 테스트 퍼즐 3만 2,768개). 빈칸이 45~51개인 쉬운 퍼즐에서는 InfiLoop와 FPRM 모두 정확도가 100.0%였다. 빈칸이 52개가 되자 InfiLoop는 100.0%를 유지했지만, FPRM은 96.5%, TRM은 95.8%로 낮아졌다. 빈칸 58개에서는 InfiLoop(84.1%)와 FPRM(77.9%)의 차이가 6.2%p까지 벌어졌고, 가장 어려운 빈칸 60개에서는 InfiLoop가 59.5%, FPRM이 56.5%, TRM이 36.0%여서 TRM과의 격차가 23.4%p에 달했다.
정답을 찾은 순간에 커지는 갱신 비중
학습된 잔차 연결이 추론 도중 어떤 후보 상태를 받아들이고 어떤 후보를 거르는지는 적응형 보폭 $\gamma_t$와 내용 점수 $\ln e_t$의 변화에서 드러난다. 만약 내용 점수가 모든 블록 출력에서 같다면 보폭 $\gamma_t$는 균등 가중 기준선인 $1 - \beta = 0.56$으로 수렴한다. 보폭과 0.56의 차이는 모델이 학습한 내용 선호도에 의해 결정된다.
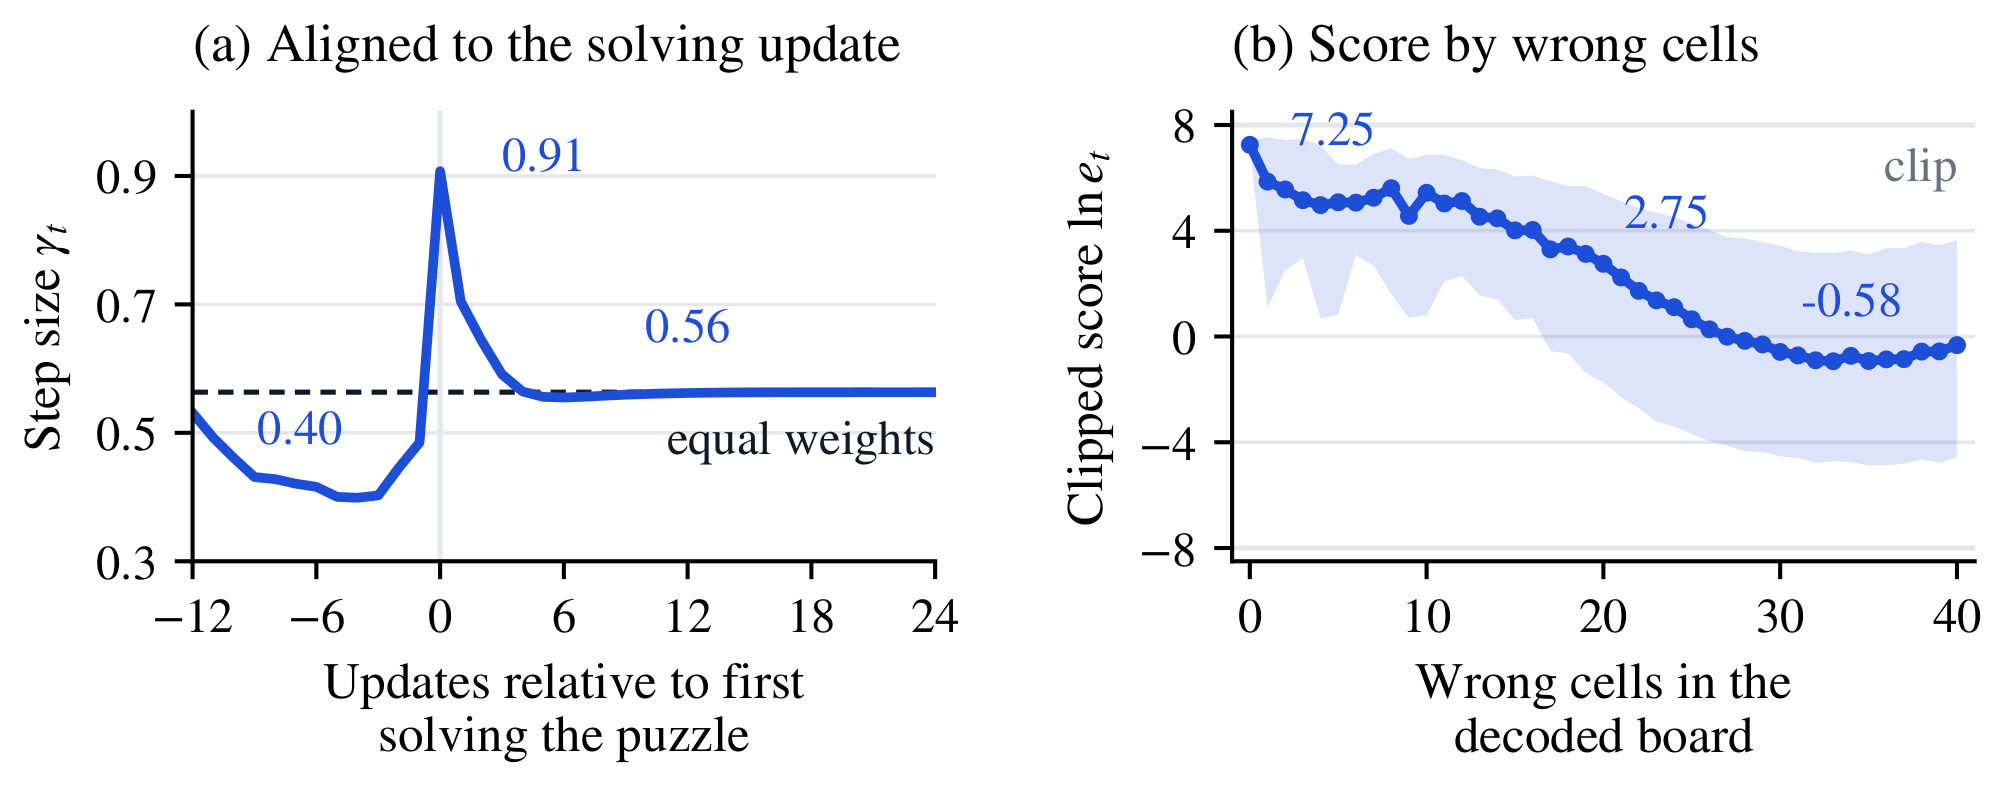 그림 3. (a) 외부 갱신 13회 이후에 풀린 퍼즐들을 최초로 정답에 도달한 갱신 시점(0)에 맞춰 정렬했을 때의 평균 보폭 $\gamma_t$ 변화. (b) 갱신 12회 이후 생성된 후보 상태들의 클리핑된 내용 점수 $\ln e_t = \operatorname{clip}(s_t, -8, 8)$ 중앙값을 해독된 보드의 오답 칸 수에 따라 나타낸 그래프. 출처: 논문 Figure 4
그림 3a를 보면, 정답을 찾기 전 탐색 구간의 평균 보폭 $\gamma_t$는 약 0.40으로 기준선(0.56)보다 낮게 억제된다. 그러다 퍼즐의 정답이 완성되는 갱신에서 보폭이 0.91까지 급증해, 새로 찾은 정답 상태의 비중이 기존 요약 상태보다 훨씬 커진다. 이후 6회 이내에 보폭은 기준선 0.56 수준을 회복한다. 끝내 풀리지 않는 퍼즐에서는 이런 급증이 한 번도 나타나지 않고 보폭이 내내 낮다.
모델은 추론 도중 정답 여부나 외부 힌트를 전혀 받지 않는다. 그런데도 그림 3b의 내용 점수는 보드의 정합성을 스스로 반영한다. 해독한 보드에 오답 칸이 하나도 없는 후보 상태는 중앙값 7.25점을 받는데, 클리핑 상한 8.0에 가까운 값이다. 반면 오답 칸 수가 늘어날수록 점수는 단조 감소해, 오답이 20칸일 때 2.75점, 33칸일 때 $-0.58$점까지 떨어진다. 제약 조건을 어긴 후보 상태에는 낮은 가중치가 매겨져 추론 상태의 오염이 차단된다.
| 내용 점수 제거 실험 (Sudoku-Extreme, 1,872층) | 정확도 (%) |
|---|---|
| InfiLoop 기본 모델 | 90.9 |
| 학습 시점부터 $q = 0$으로 고정 (단순 지수이동평균) | 84.1 |
| 학습된 모델에서 테스트 시점에 $q = 0$으로 제거 | 84.8 |
| 학습된 모델에서 테스트 시점에 $\beta = 0$으로 설정 (최신 상태 전달로 전환) | 1.5 |
부록 D의 절제 실험(위 표)은 의사 질의를 $q = 0$으로 두어 내용 점수를 없앴다. 그러면 고정 지수이동평균($\gamma_t \to 1 - \beta$)만 남는다. 처음부터 이렇게 학습해도(84.1%), 학습된 모델에서 테스트 시점에 제거해도(84.8%) 정확도는 6~7%p 낮아진다.5 즉 InfiLoop의 성능 향상은 내용 점수에 따라 상태를 골라 받아들이는 데서 나온다. 갱신 감쇠(damping)만으로는 이 성능을 얻지 못한다.
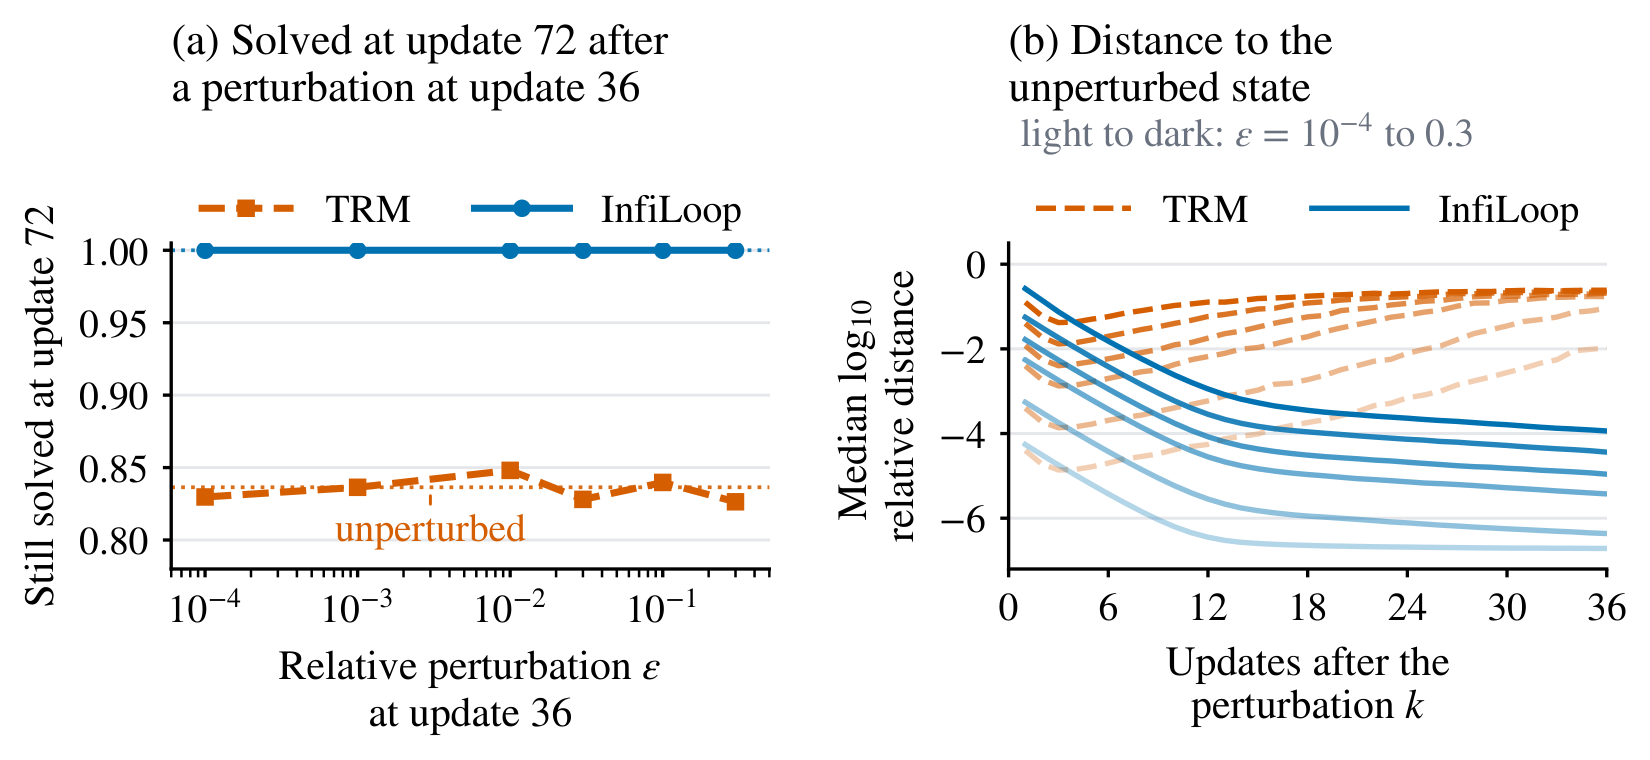 그림 4. 외부 갱신 36회 시점에 상대 크기 $\epsilon \in [10^{-4}, 0.3]$의 무작위 섭동을 주입한 뒤 36회를 더 실행한 결과. (a) 36회 시점에 풀렸던 퍼즐이 72회에서도 정답으로 남는 비율. (b) 섭동을 가한 궤적과 원래 궤적 사이의 상대 유클리드 거리($\log_{10}$ 척도) 변화. 출처: 논문 Figure 5
외부 잡음을 주입하는 실험에서도 같은 특성이 관찰됐다. 연구진은 외부 갱신 36회 시점의 순환 상태에 상대 크기 $\epsilon \in [10^{-4}, 0.3]$의 섭동(perturbation)을 주입하고 36회를 더 실행했다(그림 4). TRM은 가장 작은 섭동($\epsilon = 10^{-4}$)에도 12회 이내에 궤적 거리가 $O(1)$ 수준으로 발산했다. 섭동이 없을 때조차 TRM은 이미 푼 퍼즐의 15~20%를 잃었다. 반면 InfiLoop는 가장 큰 섭동($\epsilon = 0.3$)까지 모든 조건에서 36회 시점에 풀었던 퍼즐을 100% 유지했고, 궤적 변화도 제한된 범위로 억제했다.
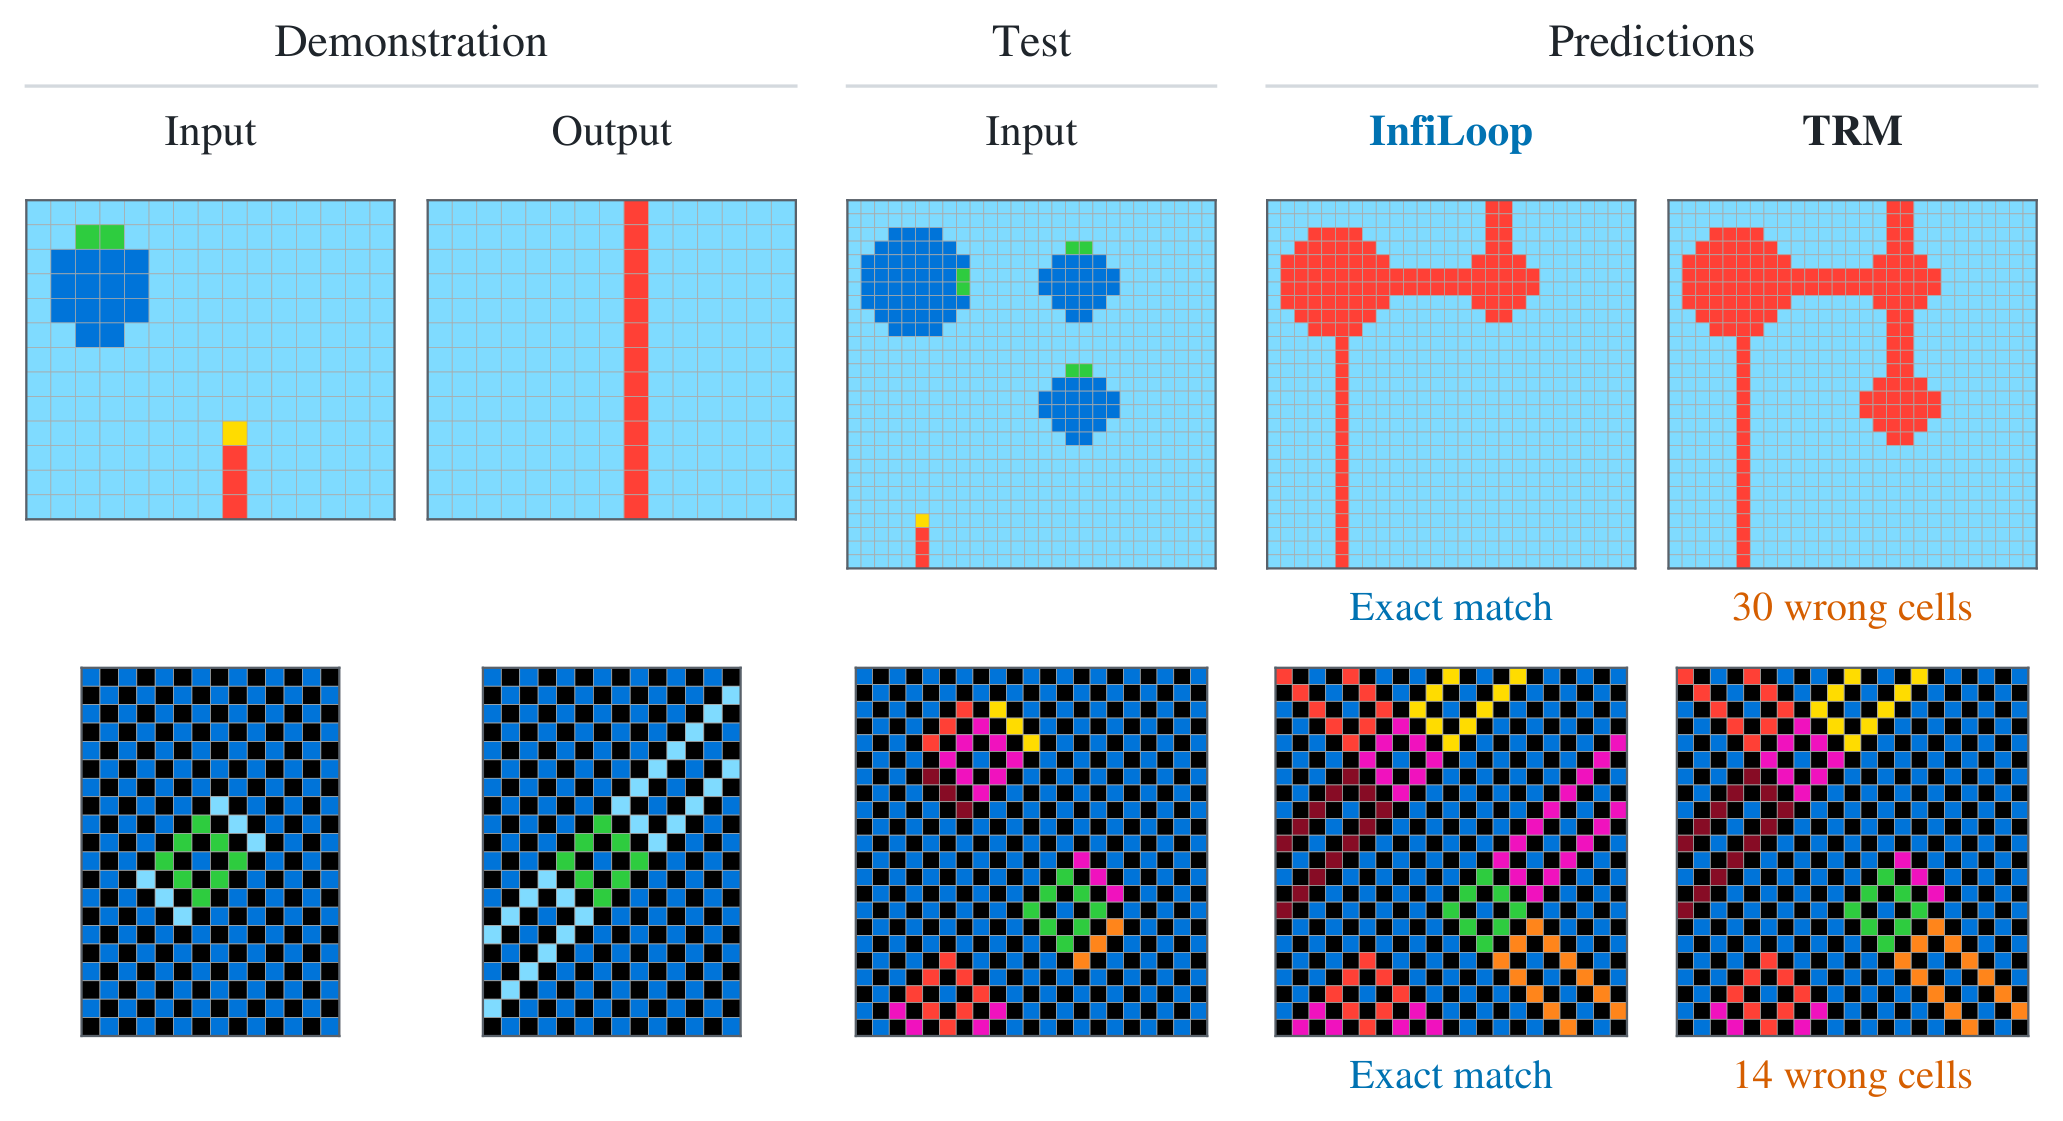 그림 5. ARC-AGI-2 공개 평가셋 과제 두 건(
5961cc34, 80a900e0)에 대한 정성 비교. 위 행은 공간 구성 요소의 기하학적 확장을 요구하는 과제이고, 아래 행은 체크무늬 배경 위로 대각선 광선을 연장하는 과제다. TRM은 두 과제에서 각각 30칸과 14칸을 틀렸고, InfiLoop는 두 과제 모두 정답 격자를 정확히 예측했다. 출처: 논문 Figure 6
연결 적용 범위와 감쇠 초기값 비교
Sudoku-Extreme 테스트셋에서 무작위로 고른 퍼즐 7,680개로는 두 가지 설계 선택을 검증했다. InfiLoop를 중첩 루프의 어느 경로에 적용할지, 그리고 시간 감쇠 인자 $\beta$를 어떻게 초기화할지다.
| 연결 적용 경로 비교 | $H3\,L6$ (학습 깊이) | $H3\,L12$ | $H3\,L96$ | $H32\,L6$ |
|---|---|---|---|---|
| 내부 루프(inner) 단독 적용 | 72.6% | 75.2% | 77.2% | 79.4% |
| 외부 루프(outer) 단독 적용 | 75.1% | 76.3% | 76.2% | 80.0% |
| 양쪽 루프 모두 적용 (InfiLoop) | 82.1% | 85.3% | 87.4% | 89.7% |
모든 연산 예산에서 양쪽 루프에 모두 적용한 경우가 한쪽에만 적용한 경우보다 정확도가 높았다. 학습 깊이($H3\,L6$)에서 7~9.5%p였던 격차는 외부 루프를 32회로 늘린 $H32\,L6$ 예산에서 약 10%p(89.7% 대 79.4%, 80.0%)로 더 커졌다.
| 감쇠 설정 | 감쇠 인자 $\beta$ | $H3\,L6$ 정확도 | $H32\,L6$ 정확도 |
|---|---|---|---|
| 역방향 감쇠 | $\beta = 1.82$ 고정 | 2.0% | 2.0% |
| 균등 가중 | $\beta = 1.00$ 고정 | 38.4% | 40.2% |
| 순방향 감쇠 | $\beta = 0.55$ 고정 | 74.0% | 77.9% |
| 학습 감쇠 (빠른 초기값) | $\beta_0 = 0.10$ 학습 | 66.3% | 72.2% |
| 학습 감쇠 (느린 초기값) | $\beta_0 = 0.90$ 학습 | 63.3% | 66.0% |
| 학습 감쇠 (InfiLoop) | $\boldsymbol{\beta_0 = 0.55}$ 학습 | 82.1% | 89.7% |
시간 감쇠 실험에서는 오래된 출력에 더 큰 비중을 두는 역방향 감쇠($\beta = 1.82$)가 2.0%에 그쳤고, 감쇠 없이 내용 점수만 쓰는 균등 가중($\beta = 1$)도 38.4~40.2%를 기록했다. 오래된 출력의 가중치를 지수적으로 줄이는 순방향 감쇠($\beta = 0.55$)를 도입하자 정확도가 74.0~77.9%로 크게 올랐다. 가장 높은 정확도(82.1%, 89.7%)는 초기값 $\beta_0 = 0.55$로 시작해 $\beta$를 함께 학습했을 때 나왔다.
가장 흥미로운 지점
이번 논문에서 유독 눈에 들어온 수치는 경로당 513개라는 파라미터 개수다. 700만 파라미터 모델에서 경로마다 추가한 것은 512차원 의사 질의 벡터 하나와 스칼라 감쇠율 하나다. 내부와 외부 루프를 합쳐도 파라미터 1,026개뿐이다. 그런데도 별도의 검증기(verifier)나 보상 모델 없이, 정답이 완성되는 단계에서 보폭 $\gamma_t$가 0.40에서 0.91로 급증하는 자기 검증 동작이 학습됐다. 언제 멈추고 언제 덮어쓸지는 모델에 따로 가르치지 않았다. 최종 과제 손실만 주었는데도 제약 조건에 맞는 보드 상태에 높은 내용 점수를 매기는 규칙이 학습됐다.
어텐션 잔차를 루프 구조에 맞게 변형해 메모리 복잡도를 상수로 줄인 대목도 눈여겨볼 만하다. 층마다 서로 다른 질의 벡터를 쓰던 기존 방식을 ‘모든 반복이 공유하는 단일 의사 질의와 지수 시간 감쇠’로 바꾸자, 과거 모든 반복의 가중합이 분자 벡터 $N_t$와 분모 스칼라 $D_t$ 두 값의 점화식으로 정확히 환원됐다. 근사를 전혀 쓰지 않고도 어텐션 잔차를 퍼즐당 388.8KiB(키비바이트)의 추가 메모리만으로 구현한 덕분에, 학습 때 504층만 본 모델을 테스트 시점에 2만 4,960층까지 반복 실행할 수 있었다.
출처
Pengxiang Li, Dilxat Muhtar, Di He, Guinan Su, Lu Yin, Shiwei Liu (The Hong Kong Polytechnic University, SIAT CAS, Peng Cheng Laboratory, UCAS, ELLIS Institute Tübingen, Max Planck Institute for Intelligent Systems, Tübingen AI Center, SUAT). “Scaling to Tens of Thousands of Test-Time Iterations with Loop-Native Attention Residuals”. arXiv:2610.11570v2, 2026년 10월 16일(v1 2026년 10월 8일).
원문: https://arxiv.org/abs/2610.11570 코드: https://github.com/pixeli99/InfiLoop
그림은 모두 논문 PDF에서 추출해 인용했다.
루프 트랜스포머의 개념과 주요 선행 연구는 GPT-6 Astra, Looped Transformers, and Hidden Reasoning과 Decoding Looped Transformers Better for (Almost) Free 다이제스트에 정리되어 있다. ↩︎
Kimi Team 등이 2026년 발표한 Attention Residuals 논문은 각 트랜스포머 층마다 고유한 의사 질의를 두고 이전의 모든 층 출력에 어텐션 가중치를 매겨 잔차 스트림을 구성했다. 그러나 반복 횟수가 정해져 있지 않은 루프 트랜스포머에 이를 그대로 적용하면 이전 모든 반복의 출력을 저장해야 하므로 메모리가 반복 수에 비례해 늘어난다. ↩︎
부록 A의 메모리 계산에 따르면 배치 크기 1, 시퀀스 길이 $n = 97$(스도쿠 칸 81개와 접두 토큰 16개), 은닉 차원 $d = 512$ 기준으로 기존 TRM은 내부와 외부 순환 상태 두 개(BF16)로 퍼즐당 194.0KiB를 유지한다. InfiLoop는 여기에 두 순환 경로의 분자 $N_t$와 분모 $D_t$(FP32, $2n(d+1) \times 4$바이트)로 388.8KiB만 더해 총 582.8KiB의 상수 메모리를 사용한다. 이 크기는 반복 횟수 $H, L, S$가 아무리 늘어나도 변하지 않는다. ↩︎
논문 표 1에서 URM(14M)의 ARC-AGI-1(53.8%)과 ARC-AGI-2(16.0%) 성적은 pass@2가 아닌 pass@1 기준 보고치이므로, 원 논문에서도 하한($\ge$) 표기와 함께 별도 주석으로 구분했다. ↩︎
학습된 InfiLoop 체크포인트에서 테스트 시점에 $\beta = 0$으로 설정해 최신 상태 전달 규칙으로 강제 전환하면 정확도가 1.5%까지 급락한다. 공유 블록의 가중치가, 블록 출력 하나를 그대로 받는 대신 과거 상태를 가중 합산한 표현을 입력으로 받도록 학습됐기 때문이다. ↩︎