3줄 요약
- 스위스 장크트갈렌 대학교(University of St. Gallen) 다미안 보르트(Damian Borth) 교수가 ICML 2026 가중치 대칭성 워크숍(Weight Symmetry Workshop) 키노트에서 발표한 가중치 공간 학습(Weight Space Learning, WSL) 연구를 종합한 강연이다.
- 가중치 공간 학습은 훈련된 신경망의 가중치와 편향을 텍스트나 이미지처럼 독립된 데이터 모달리티로 다룬다. 신경망 집단(Model Population)의 파라미터 구조에서 모델 속성과 생성 요인을 학습하고 새로운 가중치를 합성한다.
- 핵심 실증 사례로는 위성 이미지 없이 Hugging Face의 사전학습 모델 100개만으로 지리공간 모델을 생성하는 GeoSANE(CVPR 2026)과, 데이터셋 임베딩을 조건으로 삼아 맞춤형 가중치를 즉시 합성하고 잠재 공간에서 미세조정하는 WeightCLIP(ICML 2026)을 다룬다.
가중치를 새로운 데이터 모달리티로 다루는 가중치 공간 학습
기계학습에서 지식이 저장되는 방식은 크게 세 가지로 구분된다. 첫째는 데이터셋 증류(Dataset Distillation)나 합성 데이터 학습처럼 지식을 데이터셋 자체에 압축하는 경로다. 둘째는 순환신경망(RNN)의 은닉 상태, 어텐션 메커니즘의 컨텍스트 벡터, 대규모 언어 모델(LLM)의 프롬프트처럼 컨텍스트에 정보를 기록하는 경로다. 셋째는 훈련된 신경망의 파라미터에 지식을 저장하는 경로다. 가중치 공간 학습(Weight Space Learning, WSL)은 이 세 번째 저장소인 신경망 파라미터를 직접 학습의 입력과 출력으로 삼는다.1
자연어 처리에서 단어와 문장을 다루고 컴퓨터 비전에서 픽셀과 이미지 패치를 다루듯, 가중치 공간 학습은 개별 가중치(weights)와 신경망 층(layers)을 고유한 구조를 지닌 데이터 모달리티로 다룬다. 이 접근법은 두 가지 기본 가설에서 출발한다. 첫째, 훈련된 신경망들의 집단(Model Population)은 가중치 공간($\Theta$)에서 무작위로 흩어지지 않고 일정한 기하학적 구조를 형성한다. 둘째, 이 구조는 개별 신경망의 성능이나 행동 특성뿐 아니라 학습에 사용된 데이터셋($\mathcal{D}$), 과제($\tau$), 하이퍼파라미터($\lambda$), 아키텍처($\mathcal{A}$)에 관한 정보를 보존한다.
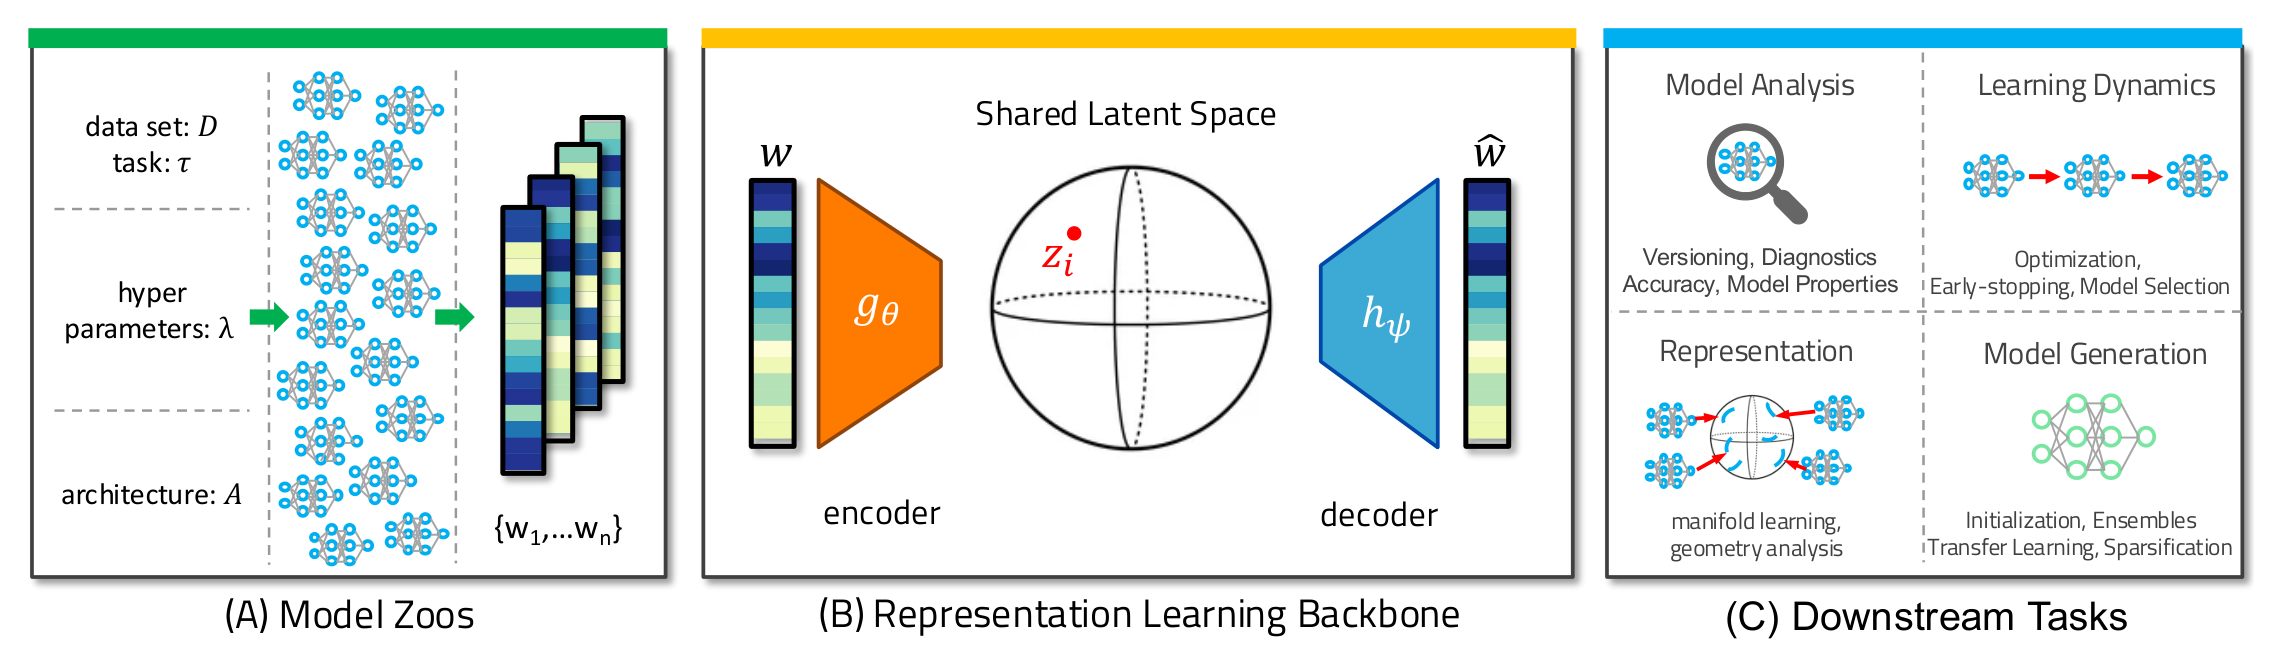 (A) 데이터셋, 과제, 하이퍼파라미터, 아키텍처 조합으로 형성된 모델 동물원(Model Zoos), (B) 가중치 벡터 $w$를 공유 잠재 공간의 $z_i$로 매핑하고 $\hat{w}$로 복원하는 표현 학습 백본, (C) 모델 분석, 학습 역학, 표현 학습, 모델 생성의 4대 다운스트림 과제로 구성된 가중치 공간 학습 파이프라인 (출처: 원문 슬라이드 11)
가중치 공간 학습의 전체 파이프라인은 세 단계로 구성된다. 먼저 다양한 데이터셋($\mathcal{D}$), 과제($\tau$), 하이퍼파라미터($\lambda$), 아키텍처($\mathcal{A}$) 조건에서 훈련된 신경망 집단인 모델 동물원(Model Zoo) $\{w_1, \dots, w_n\}$을 수집한다. 이어서 표현 학습 백본(Representation Learning Backbone)의 인코더 $g_\theta$는 입력 가중치 $w$를 공유 잠재 공간(Shared Latent Space)의 저차원 벡터 $z_i$로 변환한다. 디코더 $h_\psi$는 이 잠재 벡터에서 다시 가중치 $\hat{w}$를 복원하도록 학습한다. 이렇게 얻은 잠재 표현은 네 가지 다운스트림 과제에 활용된다.
| 다운스트림 영역 | 세부 활용 과제 |
|---|---|
| 모델 분석 (Model Analysis) | 모델 버전 관리, 진단, 테스트 정확도 예측, 모델 속성 추정 |
| 학습 역학 (Learning Dynamics) | 최적화 경로 분석, 조기 종료(Early‑stopping) 판단, 모델 선택 |
| 기하 및 표현 (Representation) | 가중치 다양체 학습(Manifold learning), 손실 지형 및 기하 구조 분석 |
| 모델 생성 (Model Generation) | 가중치 초기화, 앙상블 구성, 전이 학습, 모델 희소화(Sparsification) 및 압축 |
신경망 가중치를 데이터로 다룰 때 직면하는 고유한 난제는 대칭성(Symmetry)이다. 아키텍처 계산 그래프(Architecture Computational Graph)와 가중치가 결합해 하나의 입출력 함수를 정의하므로, 신경망 파라미터를 단순한 수치 배열로만 취급할 수는 없다. 예컨대 은닉층 뉴런의 순서를 바꾸는 순열 변환(Permutation)을 적용해도 신경망의 입출력 함수 자체는 동일하게 유지된다. 따라서 가중치 공간의 표현 학습 모델을 구축할 때는 이러한 뉴런 순열 대칭성을 구조에 반영해 설계하거나, 대칭 변환을 데이터 증강(Deep Augmentations) 기법으로 활용해 일반화 성능을 확보해야 한다.
가중치 공간 학습의 분류 체계와 평가 지형도
보르트 교수 연구팀은 연구실마다 달랐던 가중치 공간 학습의 평가 방식을 체계화하려고 2026년 서베이 논문 「Weight Space Learning needs to unify benchmarking! A taxonomy of evaluation practices」를 발표했다.2 이 논문은 가중치 공간 학습을 개념적 관점, 모델 집단 관점, 방법론적 관점, 평가 관점의 네 가지 기준선으로 분류한다.
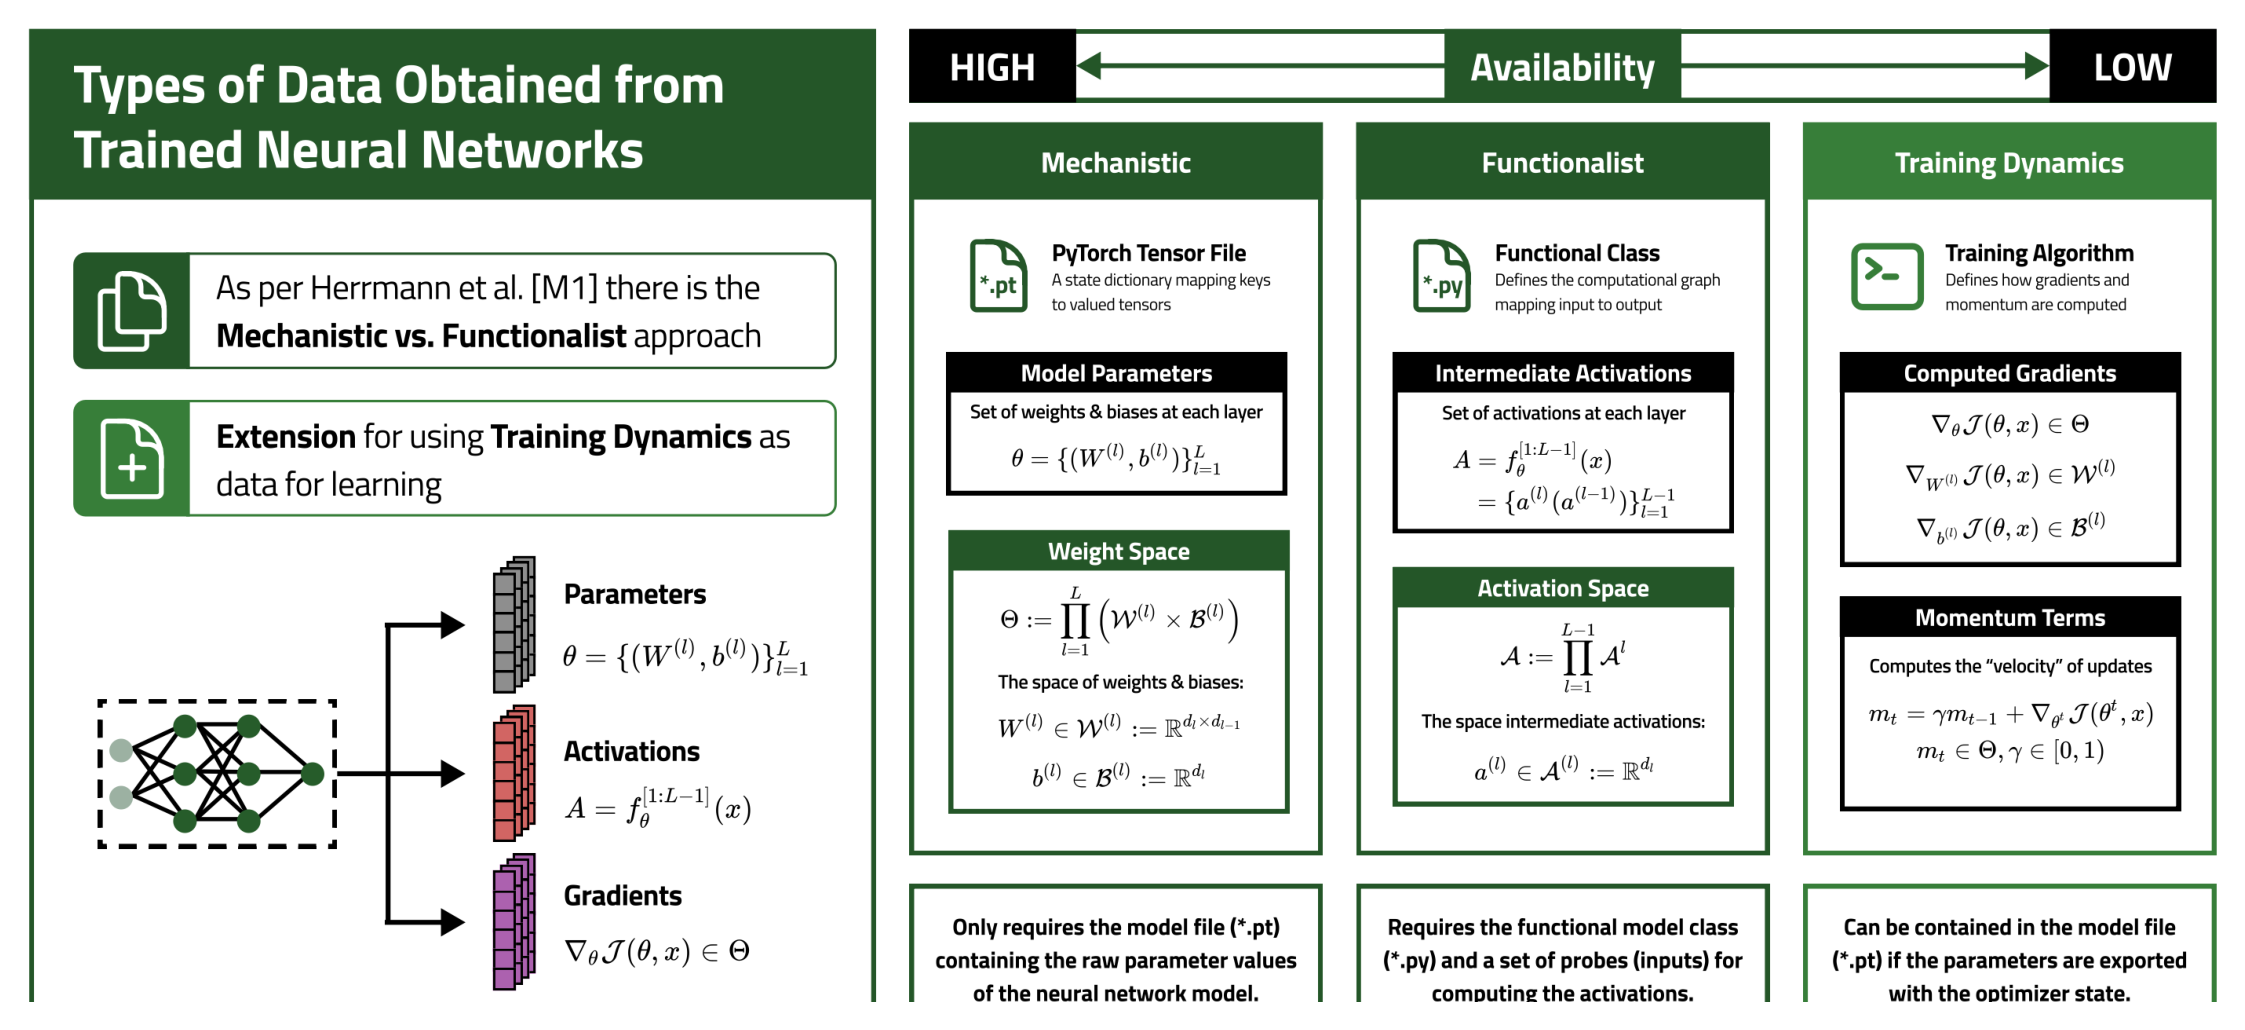 훈련된 신경망에서 얻는 데이터 유형을 가용성 순으로 분류한 개념도. 원시 파라미터만 사용하는 기계론적(Mechanistic) 접근, 순전파 활성화 값을 사용하는 기능주의적(Functionalist) 접근, 경사와 모멘텀을 사용하는 학습 역학(Training Dynamics) 접근으로 구분된다 (출처: 원문 슬라이드 17)
개념적 관점(Conceptual View)에서는 훈련된 신경망으로부터 어떤 형태의 데이터를 추출해 학습에 사용하는지에 따라 연구를 세 범주로 구분한다. 확보하기 가장 쉬운 데이터는 기계론적(Mechanistic) 접근이 사용하는 원시 파라미터 텐서(*.pt)로, 각 층의 가중치와 편향 집합 $\theta = \{(W^{(l)}, b^{(l)})\}_{l=1}^L$만 있으면 된다. 두 번째인 기능주의적(Functionalist) 접근은 모델의 계산 그래프를 정의한 소스 코드(*.py)와 입력 프롬프트(Probes) $x$를 함께 사용한다. 입력이 각 층을 통과할 때 생성되는 중간 활성화 값 $A = f_\theta^{[1:L-1]}(x)$를 추출해 학습 특징으로 활용한다. 세 번째인 학습 역학(Training Dynamics) 접근은 옵티마이저 상태에 기록된 손실 경사 $\nabla_\theta \mathcal{J}(\theta, x)$와 모멘텀 항 $m_t = \gamma m_{t-1} + \nabla_{\theta^t}\mathcal{J}(\theta^t, x)$까지 학습 데이터로 사용한다.
모델 집단 관점(Model Population View)은 모델 동물원의 분포를 결정하는 다섯 가지 생성 요인을 정의한다. 다섯 요인은 학습 데이터셋($\mathcal{D}$), 신경망 아키텍처($\mathcal{A}$), 하이퍼파라미터($\lambda$), 학습 과제($\tau$), 그리고 가중치 초기화나 미니배치 샘플링 순서 같은 확률적 요소($\mathcal{E}$)로 구성된다. 개별 연구는 분석하려는 목표에 맞춰 특정 요인을 통제하고 나머지 요인의 조건만 달리하여 실험용 모델 집단을 구성한다.
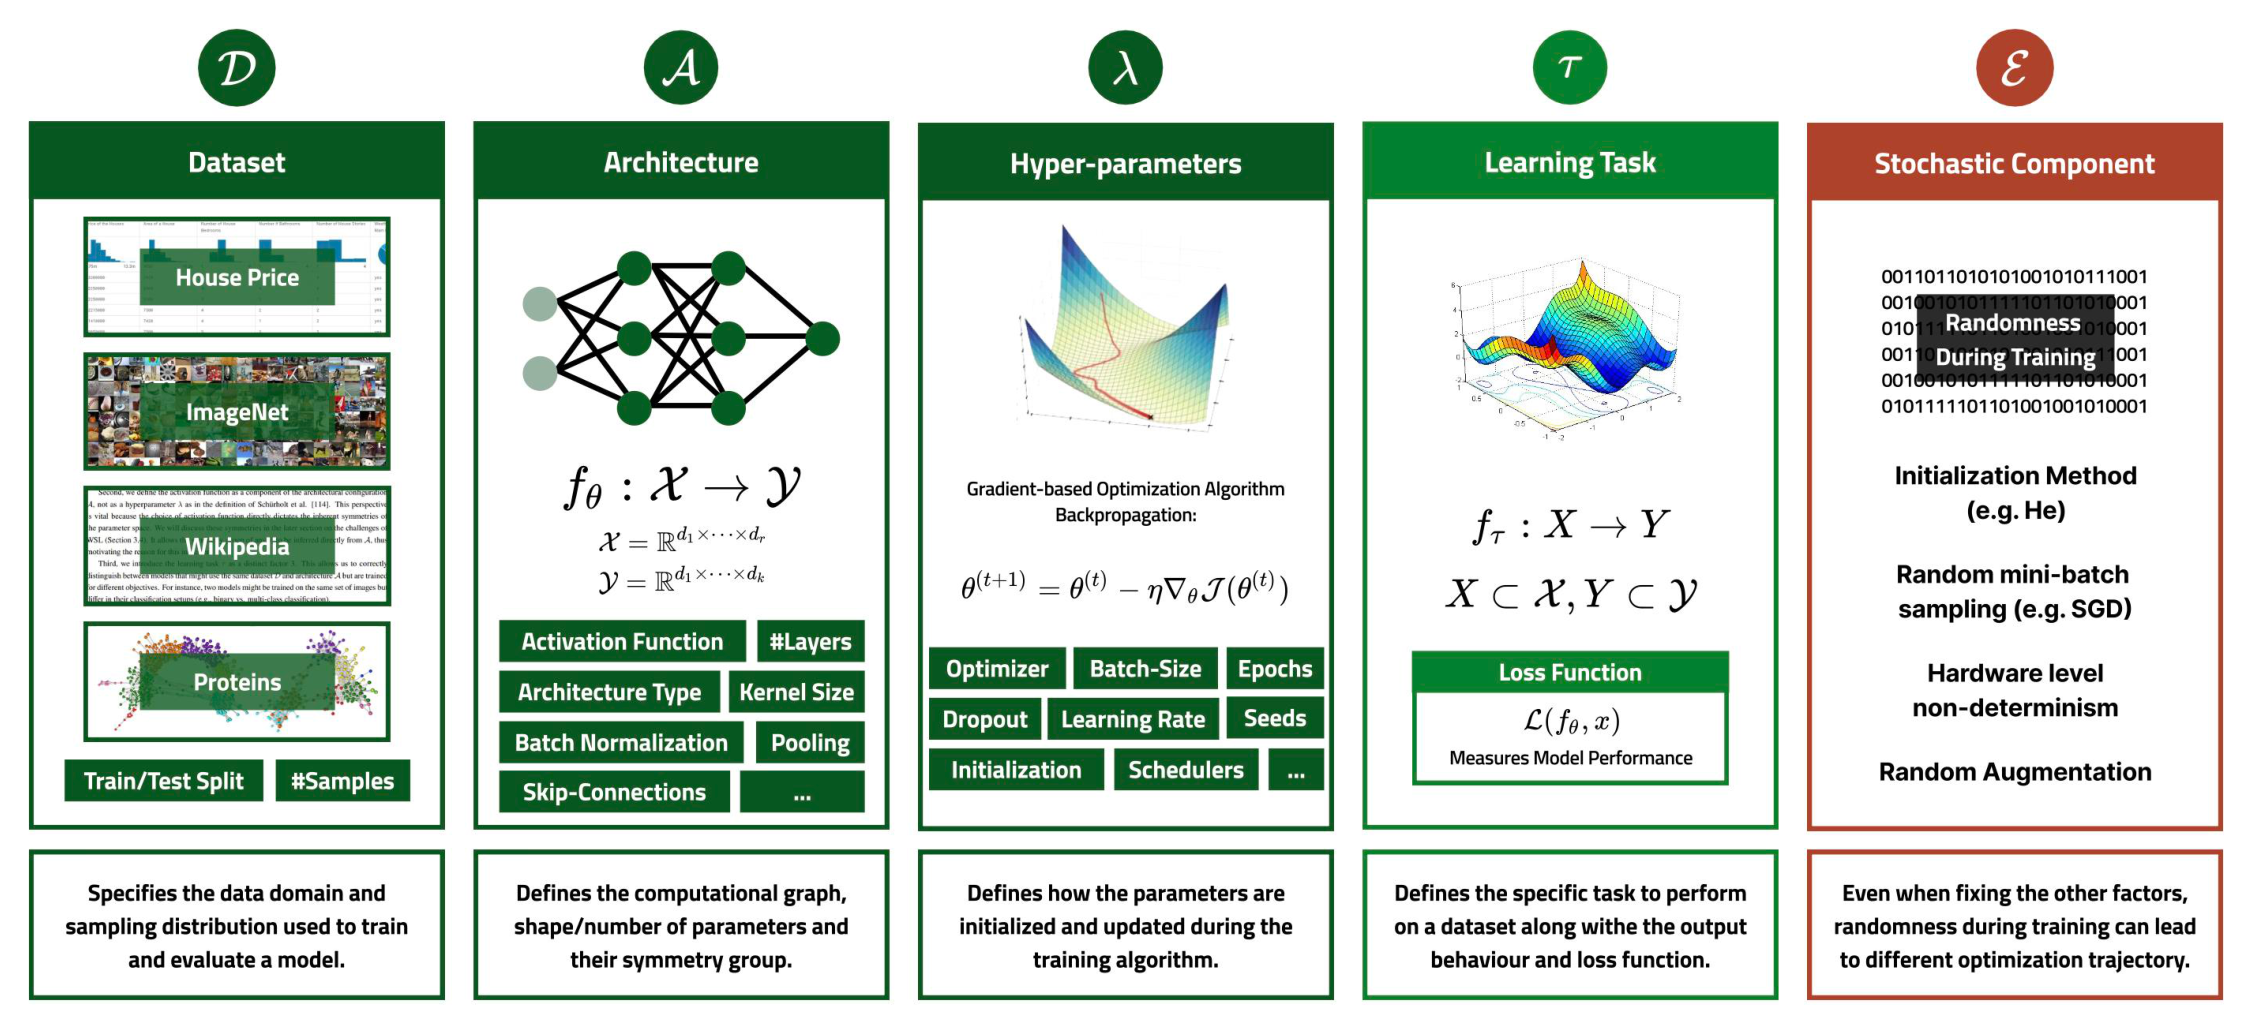 신경망 집단을 형성하는 다섯 가지 생성 요인: 데이터셋($\mathcal{D}$), 아키텍처($\mathcal{A}$), 하이퍼파라미터($\lambda$), 학습 과제($\tau$), 확률적 요소($\mathcal{E}$) (출처: 원문 슬라이드 18)
방법론적 관점(Methodological View)에서는 가중치 공간을 학습하는 기존 아키텍처들을 네 가지 패러다임으로 분류한다.
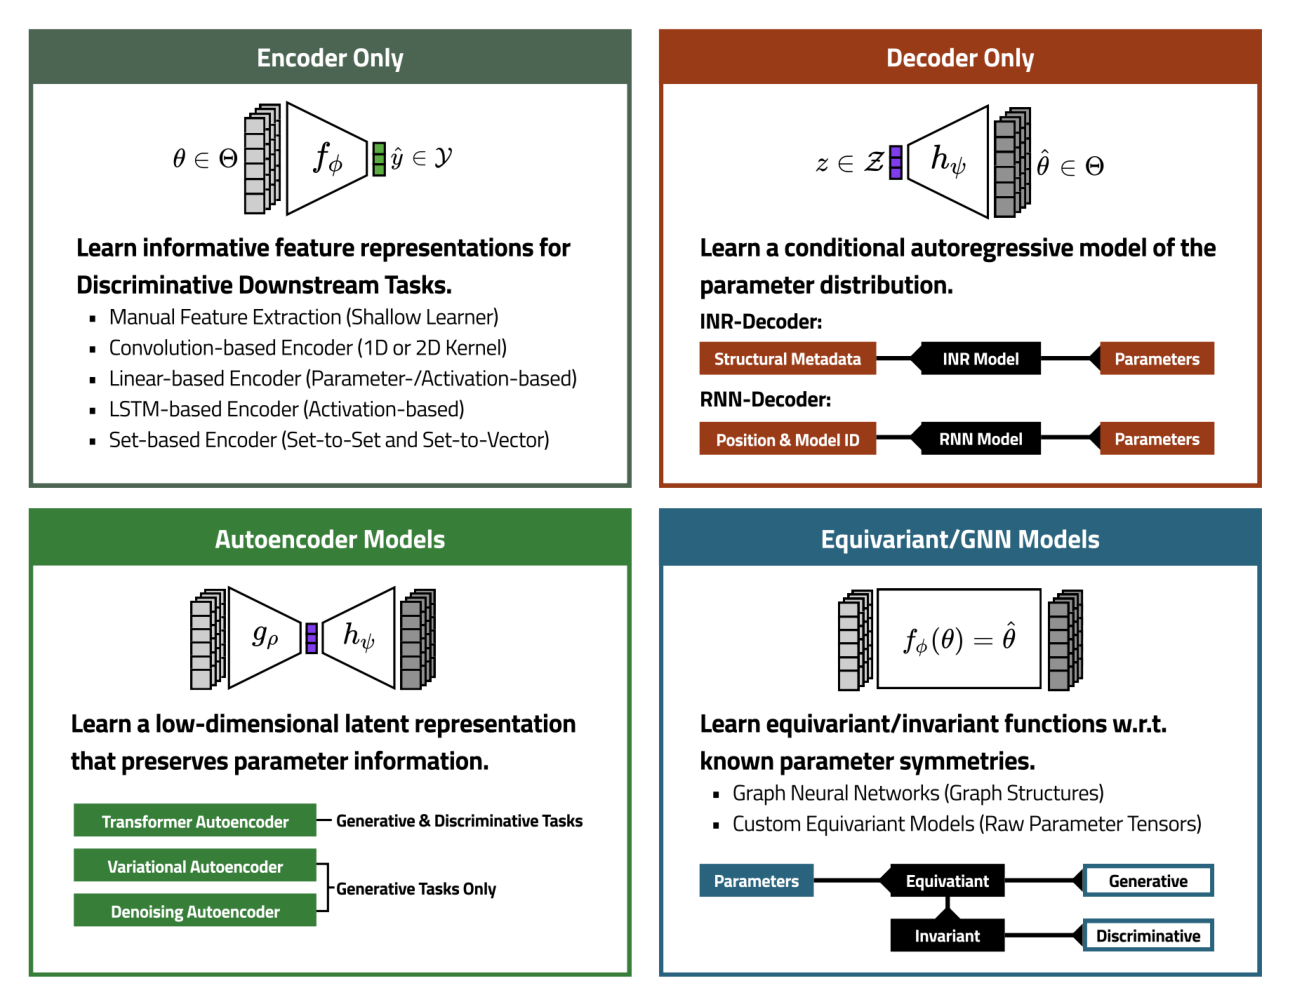 가중치 공간 학습의 4대 방법론 패러다임 분류 (출처: 원문 슬라이드 20)
- 인코더 단독 (Encoder Only): 가중치 $\theta$에서 판별 과제용 특징 벡터를 추출해 속성 $\hat{y}$를 예측하며, 수동 통계량 추출과 1D/2D 합성곱, 선형, LSTM, 집합(Set) 인코더를 사용한다. 대표 모델은 StatNN, LinDet, MoTHer(86M ViT-B), PhyDet(67M Llama3), ModelZoo, NeRN이다.
- 디코더 단독 (Decoder Only): 조건부 잠재 벡터 $z$와 구조 메타데이터를 입력받는 암묵적 신경 표현(INR) 또는 RNN 디코더를 활용해 파라미터 분포를 자기회귀 방식으로 생성($\hat{\theta} \in \Theta$)한다. 대표 모델은 NeuMeta(25M ResNet50)와 RNN-Decoder다.
- 오토인코더 (Autoencoder Models): 파라미터 정보를 보존하는 저차원 잠재 표현($g_\rho, h_\psi$)을 학습해 판별과 가중치 생성을 모두 수행하며, 트랜스포머 오토인코더와 VAE/DAE, 잠재 확산 결합 모델을 포함한다. 대표 모델은 HypRep, SANE(44M ResNet101), SANE-HF(125M GPT-2), G.pt, HyperDiff, P-diff, D2NWG(164M GPT2-small), RPG-diff(198M ConvNeXt-L)다.
- 등변 및 그래프 신경망 (Equivariant/GNN): 파라미터 순열 대칭성에 대해 등변(생성용) 또는 불변(판별용)인 함수를 커스텀 등변 블록이나 계산 그래프 기반 그래프 신경망(GNN)으로 학습한다. 대표 모델은 DWSNet(209k MLP), NFN, NFT, UNF(330k Transformer), GL-net, GMN, NG-GNN, NiNo(111M Llama3-B), ScaleGMN이다.
평가 관점(Evaluation View)에서는 다운스트림 과제를 판별 과제(Discriminative DST)와 생성 과제(Generative DST)로 구분한다. 판별 과제는 테스트 데이터 없이 가중치만으로 정확도, 일반화 격차(Generalization gap), CLIP 점수, F1 점수를 예측하거나, 모델의 파생 계보(Lineage)와 학습 도메인 및 하이퍼파라미터를 역추론한다. 생성 과제는 신경망 전체 가중치를 합성, 편집, 최적화하거나, 배치 정규화(BN) 층, 분류 헤드, LoRA 및 DoRA 어댑터 같은 부분 가중치를 생성한다. 2022년 수천($10^3$) 파라미터 규모의 소형 MLP와 CNN을 다루던 생성 연구는 2024년과 2025년에 이르러 1억($10^8$) 파라미터를 상회하는 GPT-2 및 ConvNeXt-L 규모로 확장됐다. 그러나 개별 논문마다 서로 다른 모델 동물원과 평가 지표를 사용하고 있어, 연구팀은 분야 전체의 발전을 위해 표준화된 통합 벤치마크 구축이 필수적이라고 지적한다.
GeoSANE: 위성 데이터가 아닌 100개 사전학습 모델에서 지리공간 모델 생성하기
가중치 공간 학습의 실용성을 보여주는 첫 번째 핵심 사례는 CVPR 2026 채택 논문인 GeoSANE(「GeoSANE: Learning Geospatial Representations from Models, Not Data」)이다. 기존의 지리공간 파운데이션 모델(Geospatial Foundation Models, GFM)은 방대한 위성 영상을 직접 학습하는 데이터 중심 패러다임을 따랐다. 예를 들어 TerraFM을 학습하는 데는 Sentinel-1 및 Sentinel-2 위성 타일 1,870만 장(약 23조 픽셀)과 12,000 GPU시간의 연산 자원이 투입됐다. 더구나 지구 관측 데이터는 합성개구레이더(SAR), 다중분광(Multispectral), RGB 항공영상 등 센서마다 해상도와 채널 수가 달라 단일 모델로 통합하기 까다롭다.
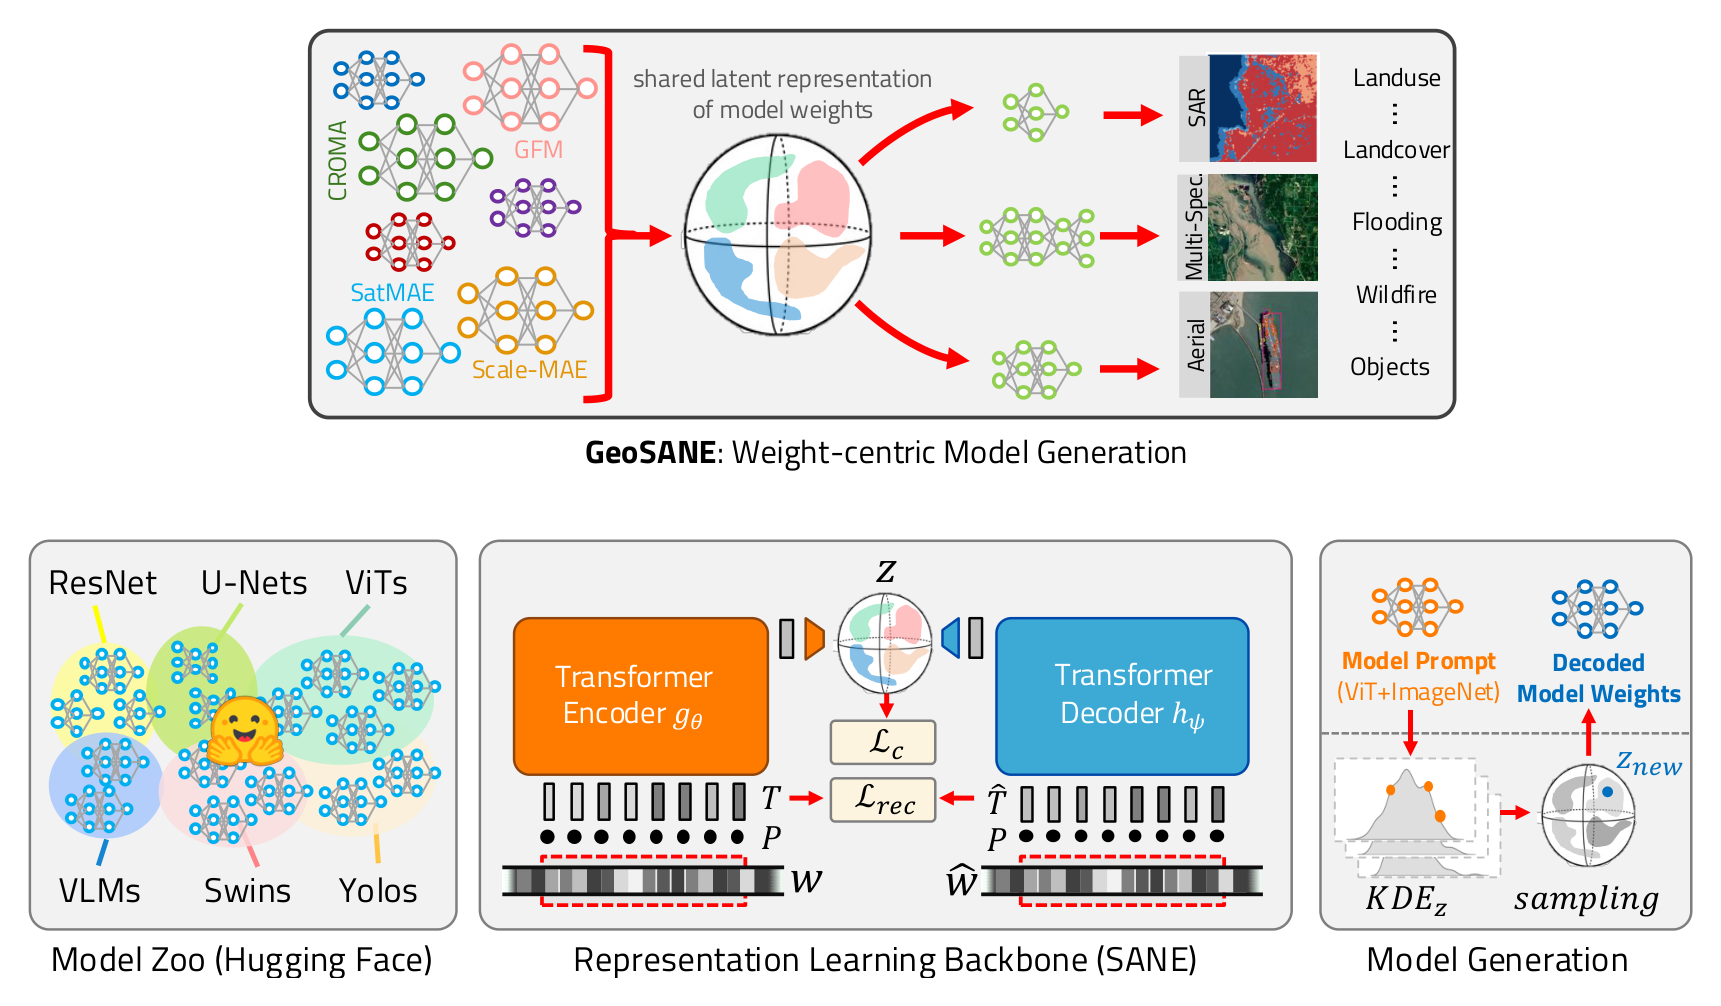 원격탐사 원시 데이터 대신 Hugging Face에 공개된 이종 사전학습 모델 동물원(ResNet, U-Net, ViT, Swin, YOLO, VLM)의 가중치를 SANE 백본으로 학습해 지리공간 모델 가중치를 생성하는 GeoSANE 아키텍처 (출처: 원문 슬라이드 27)
원시 위성 데이터셋 없이 학습하는 GeoSANE은 Hugging Face에 공개된 원격탐사 및 지구 관측(RS/EO) 사전학습 모델 약 100개(총 380억 파라미터 규모)의 가중치로부터 지리공간 표현을 추출한다. 이 모델 동물원에는 ResNet, U-Net, ViT, Swin, YOLO, 비전-언어 모델(VLM) 등 서로 다른 아키텍처와 SAR, 다중분광, 항공영상 등 다양한 센서 모달리티로 학습된 체크포인트가 포함돼 있다. GeoSANE은 가중치 텐서를 토큰 시퀀스로 분할해 처리하는 SANE(Sequential Autoencoder for Neural Embeddings) 트랜스포머 백본을 사용하여, 아키텍처나 크기에 구애받지 않고 가중치 조각들을 단일 공유 잠재 공간으로 매핑한다.3
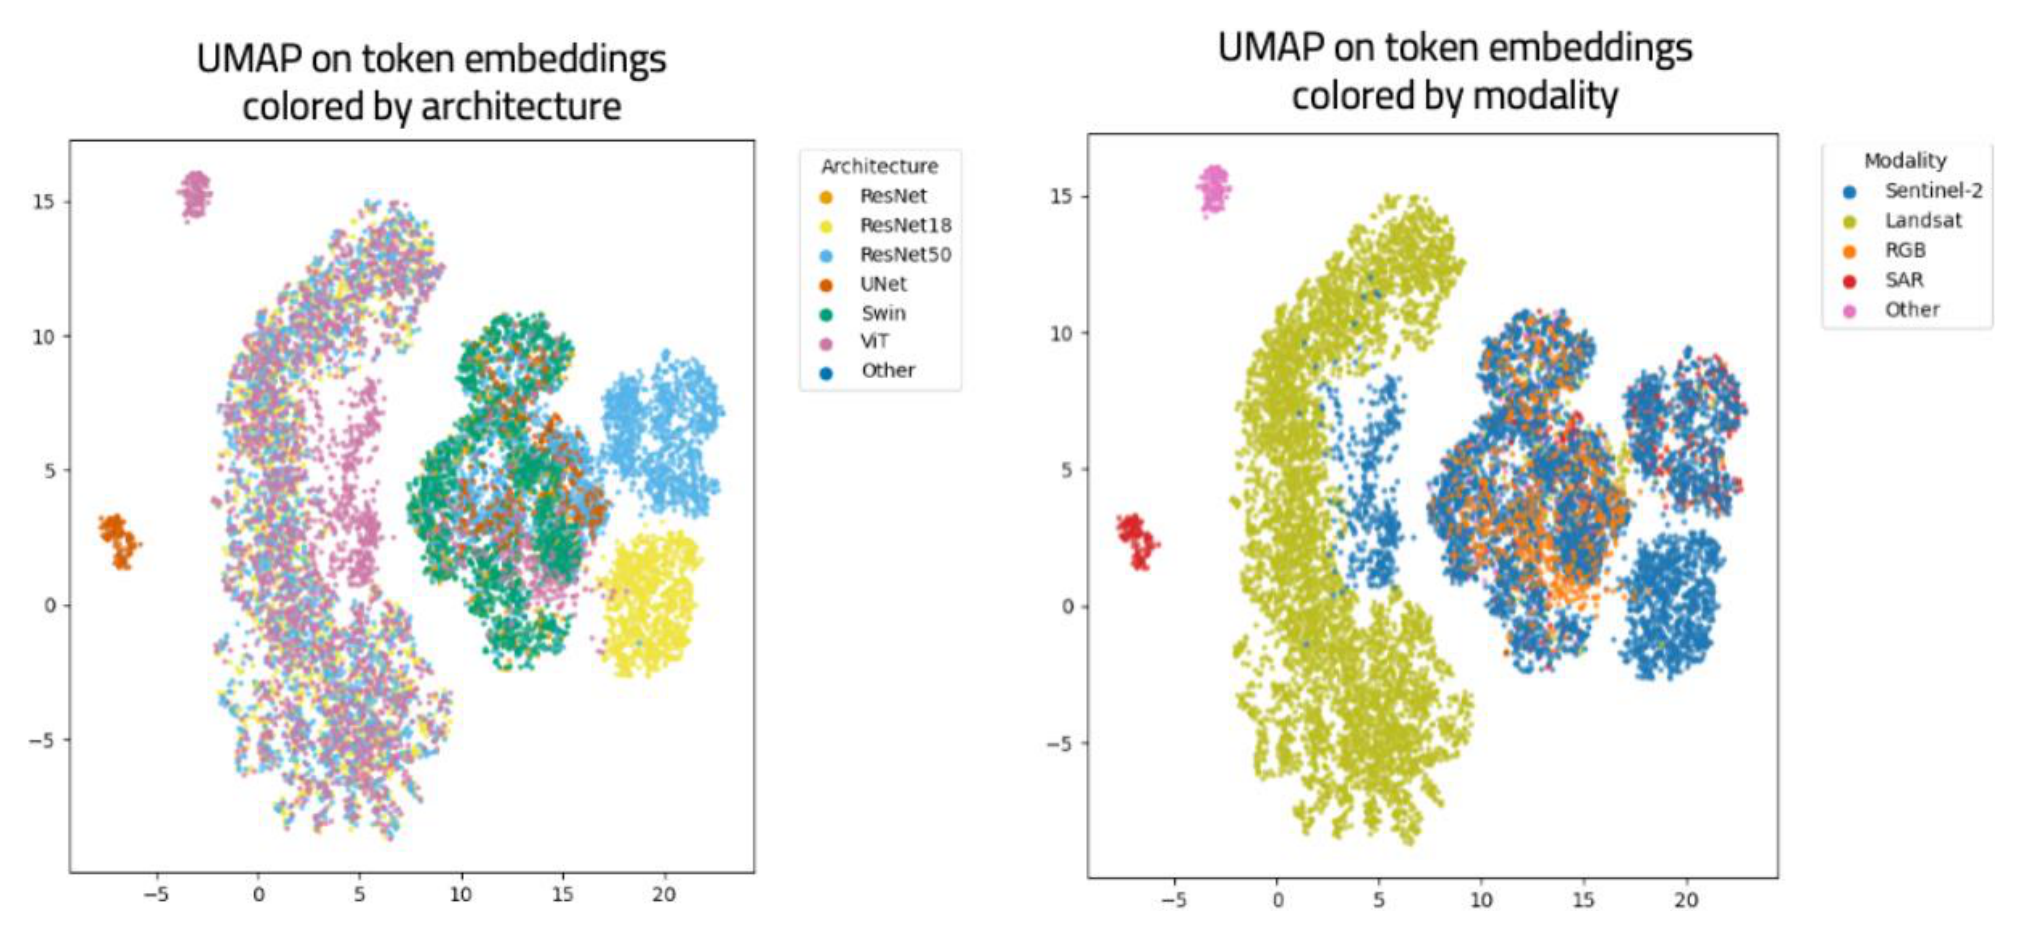 학습된 가중치 토큰 임베딩의 UMAP 시각화 결과. 좌측은 아키텍처(ResNet, UNet, Swin, ViT 등) 기준, 우측은 센서 모달리티(Sentinel-2, Landsat, RGB, SAR) 기준으로 색상을 표시한 것으로, 별도의 감독 신호 없이도 명확한 군집 구조가 형성됐다 (출처: 원문 슬라이드 29)
학습된 공유 잠재 공간의 토큰 임베딩을 UMAP으로 시각화하면, 아키텍처 종류별(ResNet, ResNet18, ResNet50, UNet, Swin, ViT)로 뚜렷한 군집이 형성될 뿐 아니라 센서 모달리티별(Sentinel-2, Landsat, RGB, SAR)로도 정교한 군집 구조가 나타난다. 새로운 지리공간 모델을 생성할 때는 일반적인 ImageNet 사전학습 모델(예: ViT+ImageNet)을 모델 프롬프트(Model Prompt)로 삼아 인코더 $g_\theta$에 통과시킨다. 그 결과로 얻은 잠재 분포에서 커널 밀도 추정($\text{KDE}_z$)으로 새로운 잠재 벡터 $z_{\text{new}}$를 샘플링하고, 디코더 $h_\psi$로 타깃 신경망의 가중치를 복원한다.
연구팀은 다섯 가지 실험 질문(Q1~Q5)을 통해 GeoSANE이 생성한 가중치의 성능을 검증했다. 첫 번째 실험(Q1)에서는 10개 지리공간 벤치마크(분류, 분할, 객체 탐지)를 대상으로 무작위 초기화(From Scratch) 후 학습한 모델과 GeoSANE이 생성한 가중치로 초기화한 모델의 성능을 비교했다.
| 백본 아키텍처 | 벤치마크 데이터셋 | 과제 유형 (모달리티) | 무작위 초기화 (Scratch) | GeoSANE 초기화 | 성능 향상폭 |
|---|---|---|---|---|---|
| ViT‑L | EuroSAT | 토지 피복 분류 (Sentinel‑2) | 95.0% | 99.1% | +4.1%p |
| ViT‑L | RESISC‑45 | 장면 분류 (RGB 항공영상) | 78.0% | 96.5% | +18.5%p |
| ViT‑L | fMoW | 시설물 분류 (다중분광) | 34.1% | 58.9% | +24.8%p |
| ViT‑L | Sen12Flood | 홍수 탐지 (SAR + 광학) | 80.4% | 85.2% | +4.8%p |
| ViT‑L | Cal. Wildfires | 산불 피해 분류 (다중분광) | 88.7% | 94.9% | +6.2%p |
| ViT‑L | BigEarthNet | 다중 라벨 분류 (Sentinel‑2) | 68.3% | 88.7% | +20.4%p |
| Swin‑B | DFC2020 | 의미론적 분할 (SAR + 다중분광) | 46.8% | 54.3% | +7.5%p |
| Swin‑B | Spacenet1 | 건물 분할 (고해상도 광학) | 72.2% | 78.2% | +6.0%p |
| Swin‑B | Sen1Floods11 | 홍수 영역 분할 (SAR) | 81.0% | 89.6% | +8.6%p |
| Swin‑B | DIOR | 객체 탐지 (RGB 항공영상) | 67.5% | 79.0% | +11.5%p |
10개 벤치마크 전 구간에서 큰 폭의 성능 향상이 확인됐으며, 특히 다중분광 위성 영상을 다루는 fMoW(+24.8%p)와 BigEarthNet(+20.4%p)에서 상승폭이 두드러졌다. 두 번째 실험(Q2)에서는 수천만 장의 위성 영상으로 직접 사전학습한 전용 원격탐사 파운데이션 모델(RSFM)들과 성적을 대조했다. GeoSANE은 Sen12Flood(85.2%, CROMA 83.4% 대비 +1.8%p), Wildfires(94.9%, CROMA 93.3% 대비 +1.6%p), DFC2020(54.3%, CROMA 49.8% 대비 +4.5%p), BigEarthNet(88.7%, SkySense 88.6% 대비 +0.1%p)에서 기존 전용 모델들보다 높은 정확도를 기록했다. 또한 Geo-Bench 4개 과제 중 m-bigearthnet(74.2% 대 73.1%)과 m-so2sat(65.7% 대 64.9%)에서도 12,000 GPU시간을 투입한 TerraFM의 성적을 상회했다.
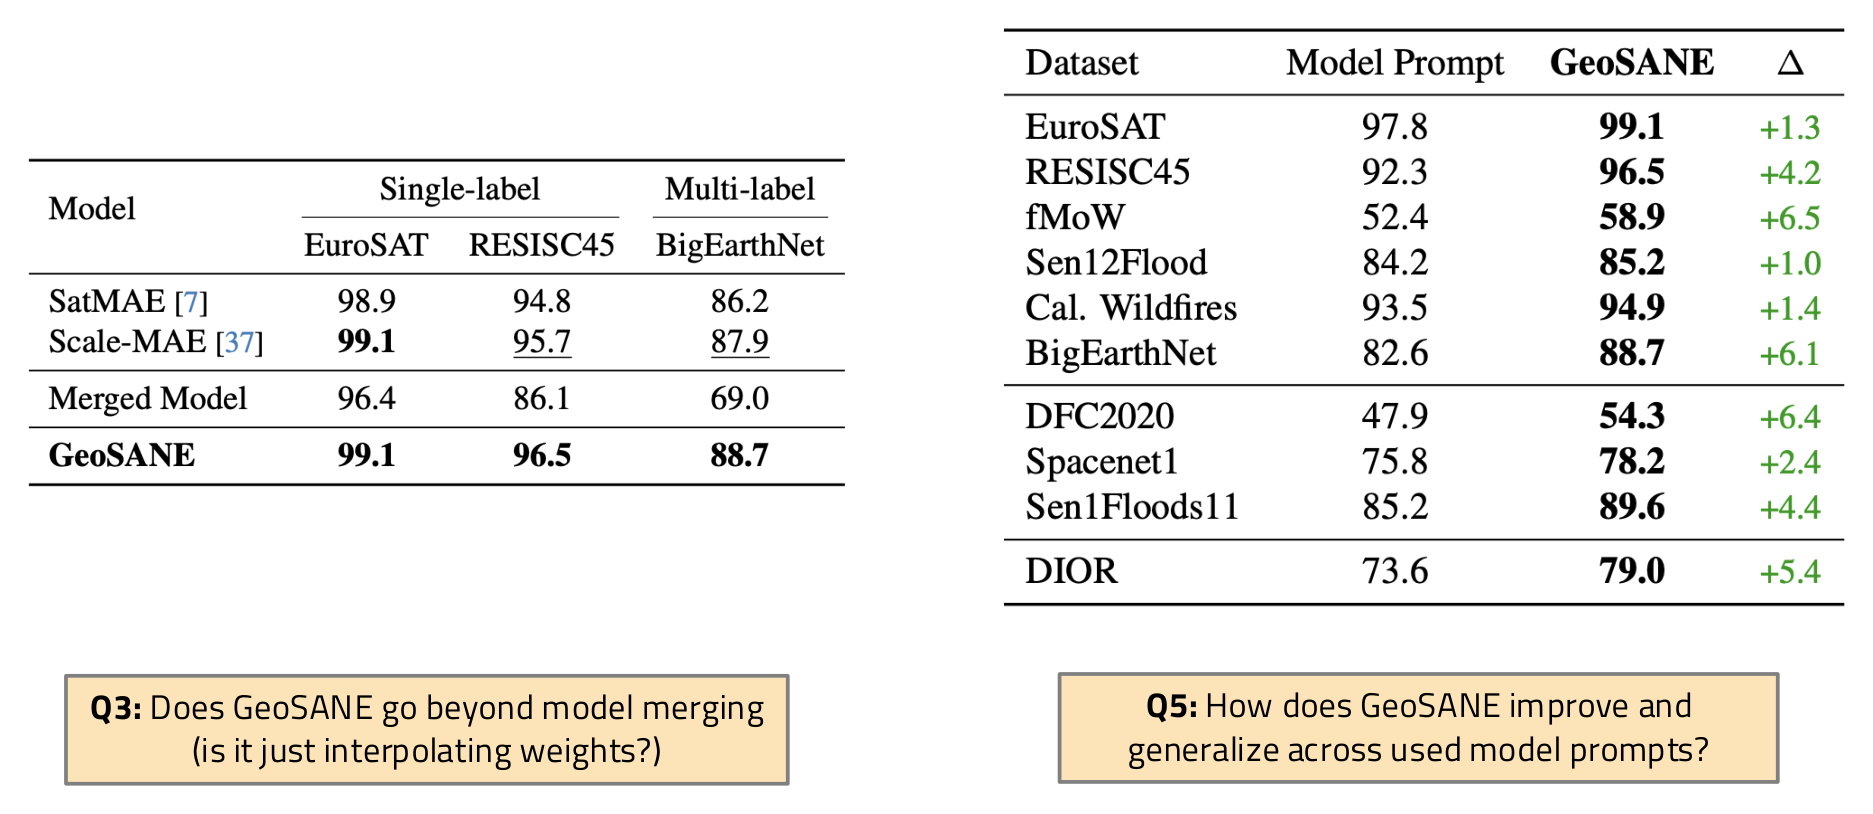 단순 가중치 보간을 통한 모델 병합(Q3, 좌측)과 입력 모델 프롬프트 단독 미세조정(Q5, 우측) 대비 GeoSANE의 성능 우위 (출처: 원문 슬라이드 35)
세 번째와 다섯 번째 실험(Q3, Q5)은 GeoSANE이 단순한 가중치 평균(Model Merging)이나 입력 모델 프롬프트의 복제에 그치지 않는다는 점을 입증한다. BigEarthNet 벤치마크에서 SatMAE와 Scale-MAE의 가중치를 단순 보간해 병합한 모델은 69.0% 정확도에 그쳤으나, GeoSANE이 생성한 모델은 두 원본 모델까지 웃도는 88.7%를 달성했다. 또한 모델 프롬프트로 사용된 ImageNet 사전학습 모델을 직접 미세조정한 경우와 비교해도 10개 데이터셋 모두에서 1.0%p(Sen12Flood)부터 6.5%p(fMoW)까지 일관된 성능 우위를 보였다.
네 번째 실험(Q4)에서는 별도의 압축 알고리즘 없이 1,100만(11M) 파라미터와 350만(3.5M) 파라미터 규모의 경량 아키텍처 가중치를 직접 생성했다. 이를 크기 기반 가지치기(Magnitude Pruning), 변분 드롭아웃(Variational Dropout), 지식 증류(Knowledge Distillation) 기법과 비교한 결과는 다음과 같다.4
| 목표 모델 크기 | 비교 데이터셋 | 가지치기 / 드롭아웃 최고치 | 지식 증류 (KD) 최고치 | GeoSANE 직접 생성 | KD 최고치 대비 격차 |
|---|---|---|---|---|---|
| 11M 파라미터 | RESISC‑45 | 62.6% | 91.1% (ScaleMAE) | 92.2% | +1.1%p |
| 11M 파라미터 | EuroSAT | 93.8% | 97.9% (SatMAE) | 98.7% | +0.8%p |
| 11M 파라미터 | fMoW | 34.4% | 43.1% (ScaleMAE) | 53.5% | +10.4%p |
| 11M 파라미터 | BigEarthNet | 66.7% | 67.3% (ViT‑L) | 83.7% | +16.4%p |
| 11M 파라미터 | Sen12Flood | 82.8% | 82.1% (ViT‑L / SatMAE) | 84.0% | +1.9%p |
| 11M 파라미터 | Cal. Wildfires | 89.2% | 88.0% (ViT‑L) | 91.6% | +3.6%p |
| 3.5M 파라미터 | BigEarthNet | 67.5% (5M 기준) | 60.7% (ViT‑L) | 73.3% | +12.6%p |
| 3.5M 파라미터 | Sen12Flood | 80.5% (5M 기준) | 64.7% (ViT‑L) | 70.2% | +5.5%p |
| 3.5M 파라미터 | RESISC‑45 | 51.3% (5M 기준) | 68.1% (ScaleMAE) | 70.0% | +1.9%p |
1,100만 파라미터 규모에서는 6개 데이터셋 전부에서 GeoSANE이 지식 증류 최고치를 앞섰으며, BigEarthNet(+16.4%p)과 fMoW(+10.4%p)에서는 큰 격차를 벌렸다. 350만 파라미터 초경량 모델에서도 6개 중 5개 데이터셋에서 지식 증류를 상회하여, 교사-학생 증류 파이프라인 없이도 원하는 크기의 고성능 소형 모델을 즉시 합성할 수 있음을 확인했다.
WeightCLIP: 데이터셋 프롬프트로 맞춤형 가중치를 생성하고 잠재 공간에서 미세조정하기
두 번째 핵심 사례인 WeightCLIP(「WeightCLIP: Aligning Datasets and Models for Weight Space Learning」, ICML 2026)은 가중치 생성의 조건을 기존 모델 프롬프트에서 데이터셋 자체로 전환한 연구다. 비전-언어 모델인 CLIP이 이미지와 텍스트의 잠재 공간을 대조 학습으로 정렬하듯, WeightCLIP은 데이터셋 인코더 $d_\theta$가 추출한 데이터셋 부분집합($x \subseteq D$)의 임베딩 $e_D$와 그 데이터셋으로 훈련된 신경망 가중치의 잠재 표현 $z_w$를 공유 잠재 공간에서 정렬한다.
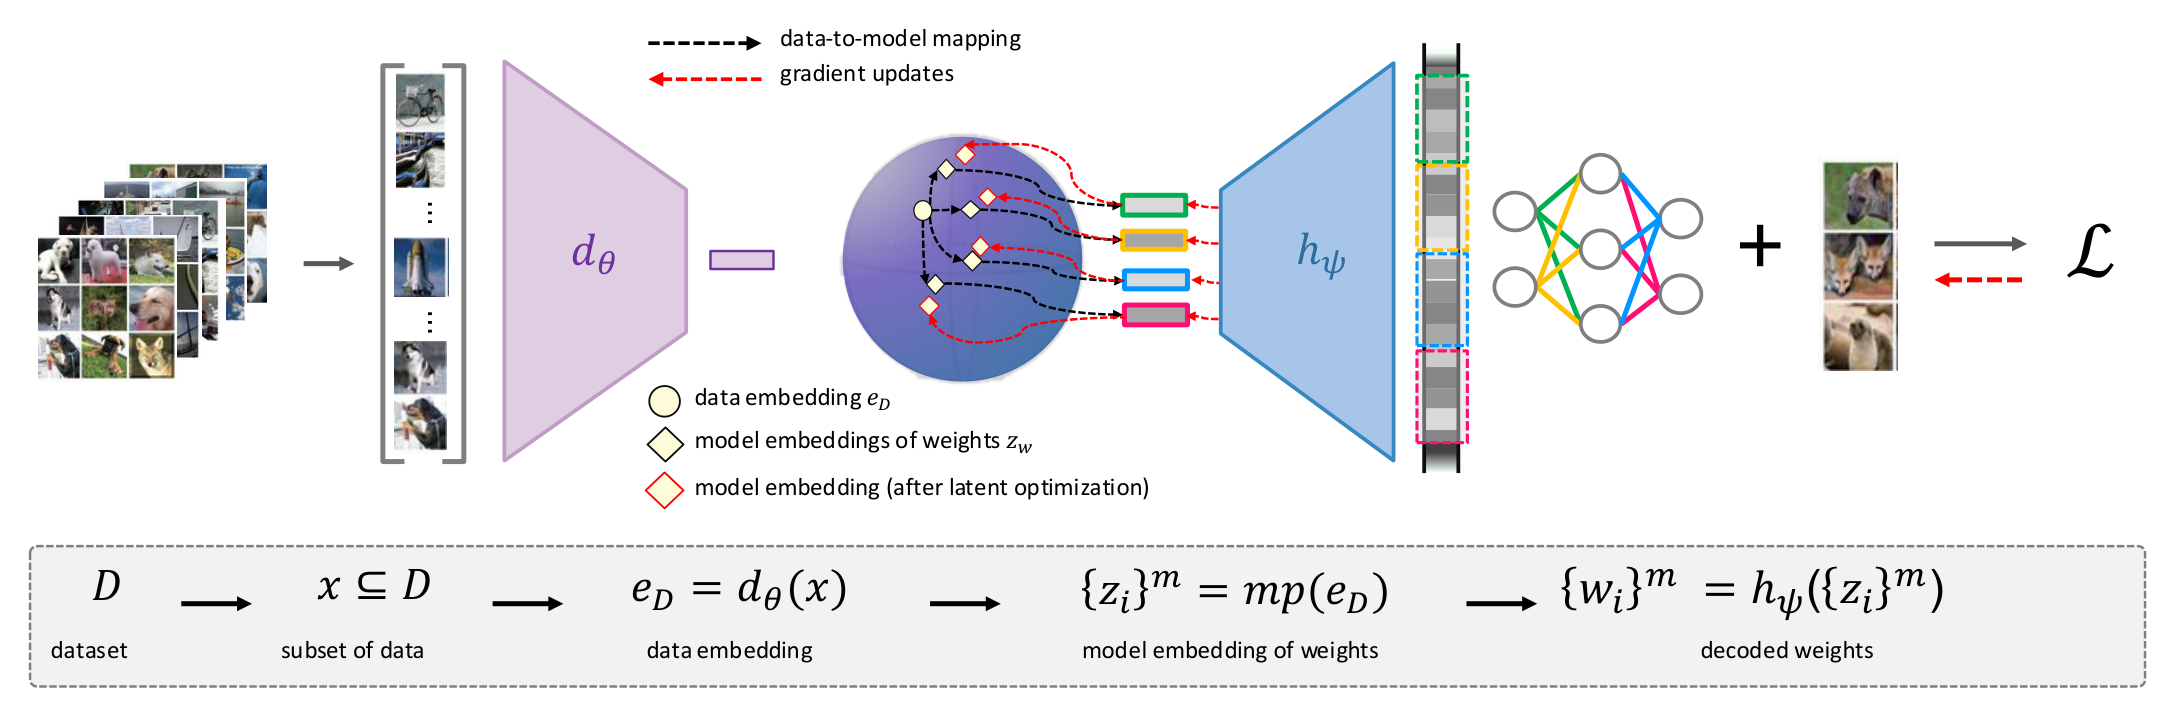 데이터셋 부분집합 $x \subseteq D$를 인코더 $d_\theta$로 임베딩($e_D$)한 뒤 가중치 잠재 공간의 모델 임베딩 $z_w$로 매핑하고 디코더 $h_\psi$로 가중치 $\{w_i\}^m$를 생성하는 WeightCLIP 파이프라인. 우측의 손실 $\mathcal{L}$로부터 역전파되는 붉은 점선은 가중치 공간 대신 잠재 공간에서 수행되는 경사 업데이트(Latent Optimization)를 나타낸다 (출처: 원문 슬라이드 40)
데이터-가중치 대조 정렬을 적용하기 전에는 서로 다른 데이터셋으로 훈련된 신경망 임베딩들이 잠재 공간에 무질서하게 섞여 분포한다. 반면 대조 정렬 손실을 적용한 후에는 동일한 데이터셋에서 학습된 모델 가중치들이 잠재 공간에서 조밀한 군집을 형성한다. 추론 단계에서 기존 학습에 쓰지 않은 새로운 데이터셋(Out-of-Distribution Data Prompt) $D$가 주어지면, 데이터 인코더가 샘플 이미지들을 임베딩 $e_D = d_\theta(x)$로 변환한다. 이어서 매핑 모듈 $mp(e_D)$로 가중치 잠재 토큰 $\{z_i\}^m$을 예측하고, 디코더 $h_\psi(\{z_i\}^m)$를 거쳐 해당 데이터셋에 특화된 신경망 가중치 $\{w_i\}^m$을 즉시 생성한다.
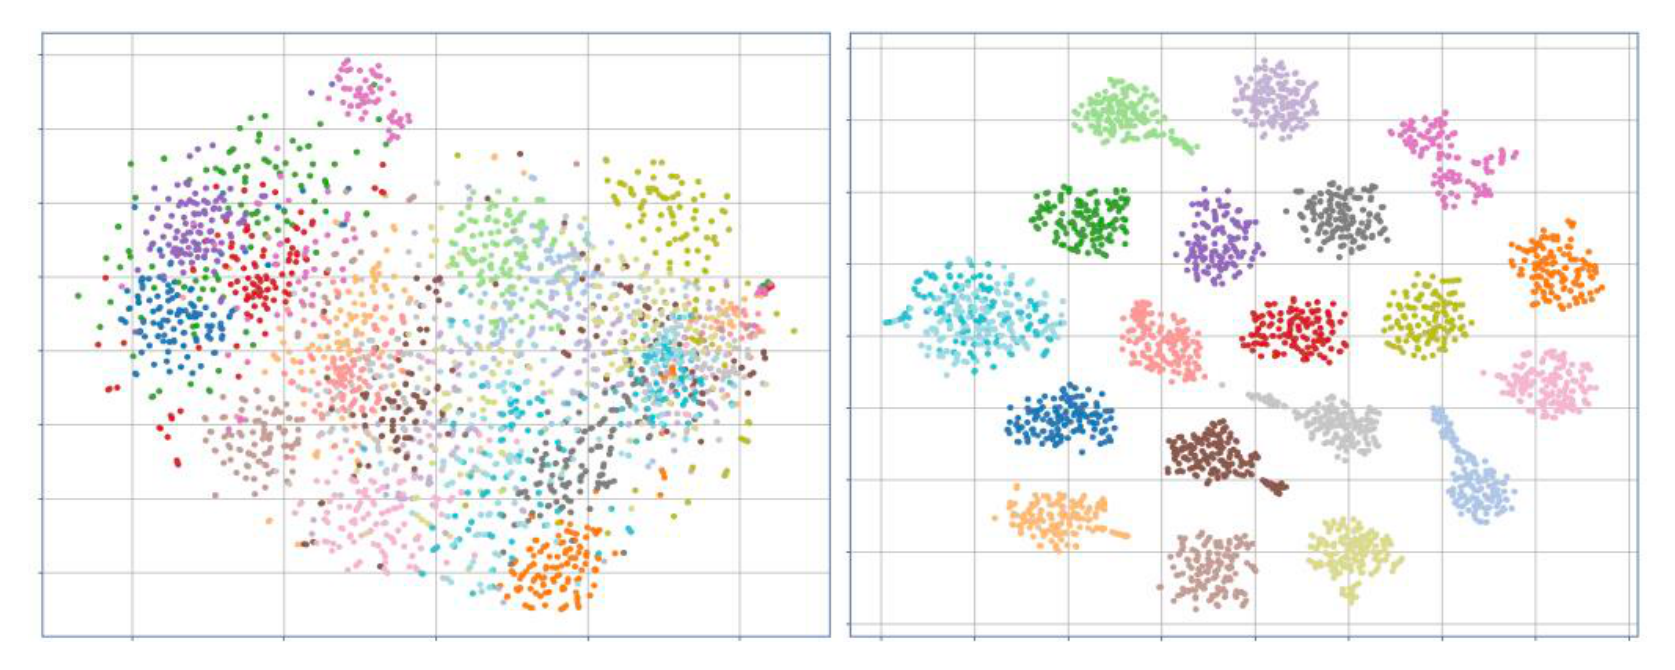 WeightCLIP 적용 전(좌측)에는 서로 다른 데이터셋에서 훈련된 모델 임베딩들이 뒤섞여 있으나, 데이터-가중치 대조 정렬을 적용한 후(우측)에는 학습 데이터셋별로 뚜렷한 군집이 형성된다 (출처: 원문 슬라이드 41)
연구팀은 미지(OOD)의 시각 데이터셋 6종을 프롬프트로 입력해 ResNet-18 가중치를 생성했다. 생성 직후인 미세조정 전(Epoch 0)과 1에폭 미세조정 후(Epoch 1)의 분류 정확도를 무작위 초기화(Scratch), 모델 검색 기법(TANS), 하이퍼네트워크(Hypernetwork)와 각각 비교했다.5
| 비교 방법론 (Epoch 0) | Colo.H | COVID‑19 | CIFAR10 | Speed. | Honey P. | Real/Draw. |
|---|---|---|---|---|---|---|
| 무작위 초기화 | 12.5% | 33.3% | 10.0% | 25.0% | 25.0% | 10.0% |
| TANS | 13.7% | 37.9% | 10.6% | 28.4% | 23.0% | 9.5% |
| Hypernetwork | 10.9% | 26.8% | 10.0% | 25.2% | 26.8% | 11.4% |
| WeightCLIP | 18.3% | 47.4% | 12.2% | 40.0% | 26.5% | 18.1% |
단 한 번의 경사 업데이트도 거치지 않은 Epoch 0 상태에서 WeightCLIP은 COVID-19 데이터셋 47.4%(무작위 초기화 33.3%), Speed Signs 데이터셋 40.0%(무작위 초기화 25.0%)를 기록하며 6개 중 5개 데이터셋에서 가장 높은 초기 정확도를 달성했다.
| 비교 방법론 (Epoch 1) | Colo.H | COVID‑19 | CIFAR10 | Speed. | Honey P. | Real/Draw. |
|---|---|---|---|---|---|---|
| 무작위 초기화 | 54.1% | 60.7% | 38.9% | 26.1% | 56.4% | 27.0% |
| TANS | 50.8% | 60.7% | 32.0% | 32.4% | 48.0% | 19.6% |
| Hypernetwork | 59.1% | 82.9% | 42.7% | 27.8% | 82.3% | 34.2% |
| WeightCLIP | 68.4% | 90.8% | 47.7% | 48.0% | 82.8% | 35.9% |
이어서 단 1에폭의 미세조정을 수행하자 6개 데이터셋 전부에서 1위를 기록했으며, 무작위 초기화 대비 COVID-19에서는 30.1%p(60.7% 대 90.8%), Honey Bee Pollen에서는 26.4%p(56.4% 대 82.8%), Speed Signs에서는 21.9%p(26.1% 대 48.0%) 높은 정확도를 보여 빠른 수렴 속도를 증명했다.
WeightCLIP이 제시한 또 하나의 중요한 기법은 잠재 공간 미세조정(Latent Refinement)이다. 고차원 가중치 공간($\Theta$)에서 직접 경사하강법을 수행하는 표준 미세조정(Standard Fine-tuning)과 달리, 이 기법은 다운스트림 손실 $\mathcal{L}$의 경사를 디코더 $h_\psi$를 거쳐 저차원 가중치 잠재 공간($\mathcal{Z}$)으로 역전파한다. 이를 통해 잠재 임베딩 $z$를 먼저 갱신한 뒤 가중치로 다시 복원한다. 동일한 연산 예산(1,000 스텝) 조건에서 6개 CNN 데이터셋에 대해 표준 미세조정과 잠재 공간 미세조정을 비교한 결과는 다음과 같다.
| 데이터셋 | 초기 정확도 (Initial) | 표준 미세조정 (Fine‑tune, 1000 steps) | 잠재 공간 미세조정 (Latent Refine, 1000 steps) | 표준 미세조정 대비 향상폭 |
|---|---|---|---|---|
| CIFAR‑10 | 10.6% | 21.2% | 23.1% | +1.9%p |
| EuroSAT | 11.7% | 26.5% | 28.0% | +1.5%p |
| MedMNIST (COVID) | 49.0% | 55.2% | 63.5% | +8.3%p |
| Honey Bee Pollen | 51.3% | 69.2% | 76.6% | +7.4%p |
| Speed. Signs | 31.3% | 34.4% | 46.4% | +12.0%p |
| Real / Drawing | 12.1% | 26.1% | 31.8% | +5.7%p |
| 6개 데이터셋 평균 | 27.7% | 38.8% | 44.9% | +6.1%p |
6개 데이터셋 모두에서 잠재 공간 미세조정이 표준 미세조정을 앞섰으며, 평균 정확도는 38.8%에서 44.9%로 6.1%p 상승했다. 체계적으로 구조화된 저차원 가중치 잠재 다양체(Manifold)에서 최적화를 수행하면 동일한 스텝 수로도 훨씬 효율적인 파라미터 탐색이 가능하다는 점을 확인한 셈이다. 보르트 교수는 발표를 마무리하며 야생의 이종 모델 동물원 활용 확대, 다양한 아키텍처를 포괄하는 가중치 공간 파운데이션 모델 구축, 그리고 파편화된 평가 관행을 통합하는 표준 벤치마크 확립을 가중치 공간 학습의 3대 당면 과제로 제시했다.
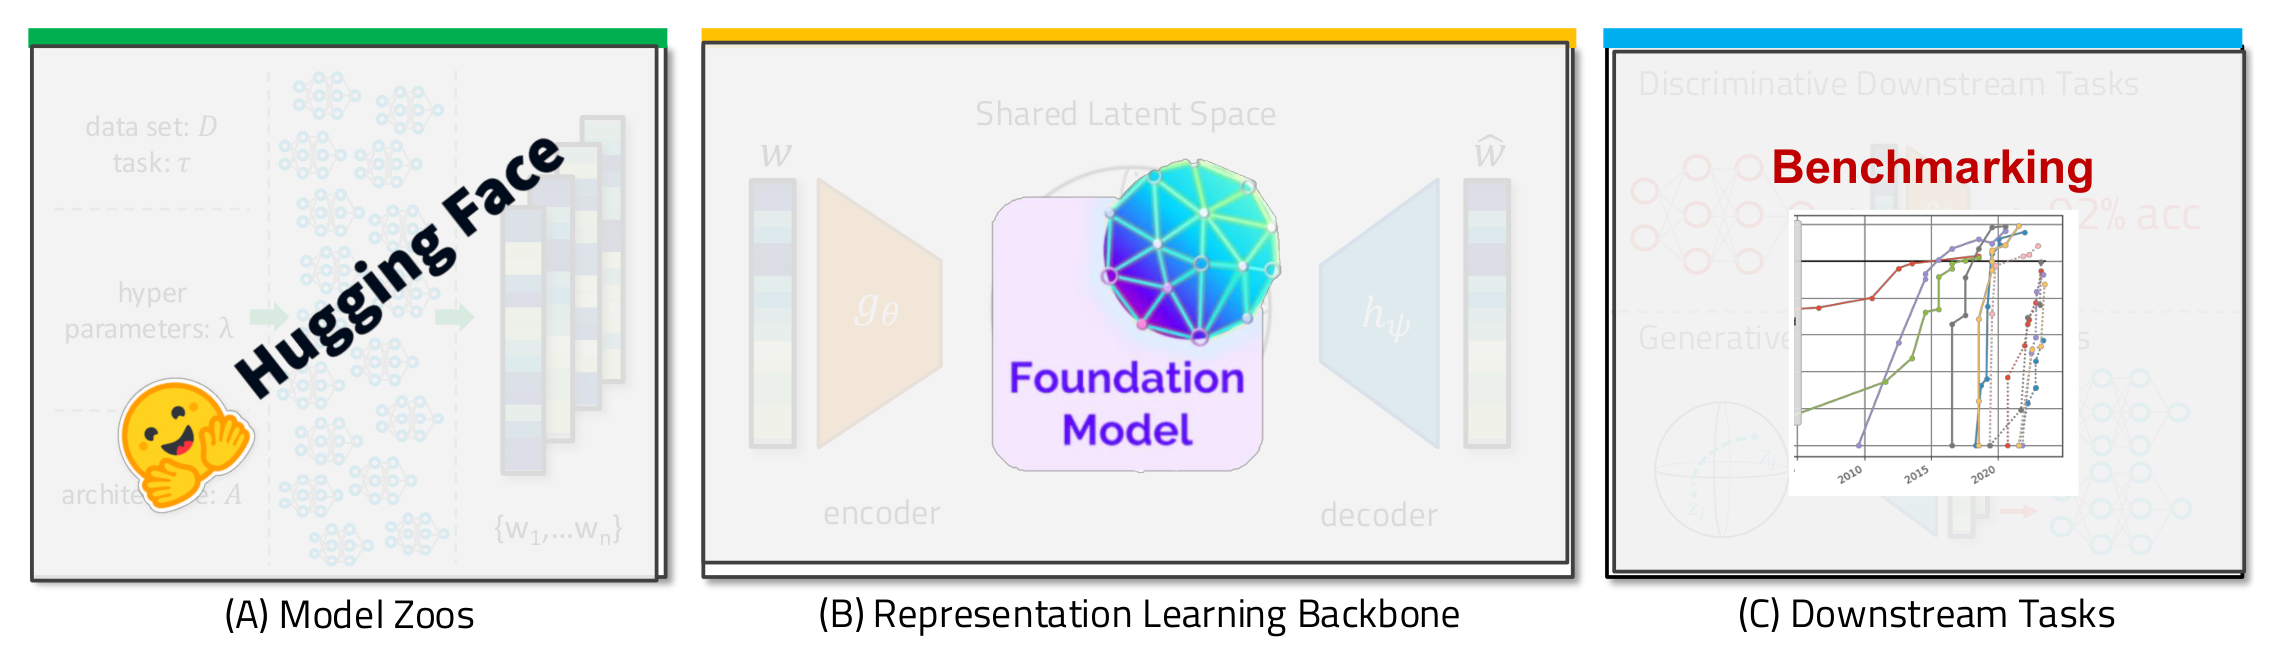 가중치 공간 학습이 해결해야 할 세 가지 핵심 과제: (A) Hugging Face 등 야생의 모델 동물원 활용, (B) 가중치 공간 파운데이션 모델 구축, (C) 다운스트림 과제의 표준 벤치마킹 확립 (출처: 원문 슬라이드 46)
가장 흥미로운 지점
이번 발표에서 가장 인상적이었던 대목은 오픈소스 생태계에 축적된 수십만 개의 사전학습 체크포인트를 바라보는 관점의 전환이다. 지금까지 연구자들은 새로운 도메인이나 경량 디바이스용 모델이 필요할 때마다 원시 데이터를 다시 수집해 처음부터 사전학습을 수행하거나, 거대 교사 모델로부터 지식을 증류하는 복잡한 파이프라인을 구축했다. 반면 GeoSANE은 Hugging Face에 이미 올라와 있는 100개의 원격탐사 모델 가중치만을 학습 자원으로 삼아 지리공간 모델을 생성했다. 위성 사진을 단 한 장도 직접 보지 않고도 12,000 GPU시간을 투입한 데이터 중심 파운데이션 모델과 대등한 가중치를 합성해 낸 것이다. 더 나아가 1,100만 및 350만 파라미터 소형 모델 가중치를 직접 디코딩해 지식 증류보다 최대 16.4%p 높은 정확도를 얻은 결과는, 개별 모델들이 각자의 학습 과정에서 습득한 표현을 가중치 잠재 공간에서 재조합하는 방식이 얼마나 강력한지를 잘 보여준다.
WeightCLIP이 선보인 잠재 공간 미세조정(Latent Refinement) 역시 신경망 최적화에 시사하는 바가 크다. 가중치 오토인코더가 압축해 둔 잠재 공간에서만 경사를 갱신하고 수백만 개의 원시 파라미터는 디코더로 복원하는 절차를 택했음에도, 1,000스텝 학습 후 평균 정확도는 표준 미세조정보다 6.1%p 높게 나타났다. 이는 LoRA처럼 모델 내부에 저랭크 행렬을 수동으로 삽입하는 방식에서 나아가, 신경망 집단 전체의 분포에서 학습된 비선형 잠재 다양체 자체가 효과적인 저차원 최적화 공간으로 기능할 수 있음을 실증한 사례다.
출처
- 발표자 및 소속: Prof. Dr. Damian Borth (University of St. Gallen, HSG-AIML)
- 발표 학회: Weight Symmetry Workshop at ICML 2026 (Keynote)
- 원문 슬라이드: https://drive.google.com/file/d/1yy6HwyUYX4sgApBUeZMIrrEm9tWXU8Vo/view
- 커버의 치비 서소영 삽화는 gpt-image-2.6-flare로 그렸다.
발표를 맡은 다미안 보르트 교수는 스위스 장크트갈렌 대학교 인공지능 및 기계학습 연구실(HSG-AIML)을 이끌고 있으며, 2020년부터 신경망 가중치 집단의 표현 학습(Hyper-Representations)과 모델 동물원(Model Zoo) 연구를 지속해 왔다. ↩︎
T. Ettling, D. Falk, A. Asefaw, L. Meynent, K. Tzevelekakis, Z. Wang, K. Wang, B. Knyazev, H. Maron, D. Borth가 공동 집필한 2026년 제출 논문으로, 수십 종의 가중치 공간 학습 모델과 다운스트림 벤치마크를 전수 조사해 분류 체계를 수립했다. ↩︎
SANE은 신경망 가중치 행렬을 일정한 크기의 조각(토큰)으로 분해한 뒤 층과 조각의 순번 임베딩(Position Embedding)을 더해 트랜스포머 인코더와 디코더로 학습하는 순차 오토인코더다. 덕분에 입력 모델과 출력 모델의 전체 파라미터 수나 아키텍처가 달라도 가중치를 인코딩하고 디코딩할 수 있다. ↩︎
크기 기반 가지치기와 변분 드롭아웃은 350만 파라미터 규모에서 학습 불안정성이 심해 500만(5M) 파라미터까지만 압축해 평가했으며, 지식 증류는 ViT-L, Scale-MAE, SatMAE 세 가지 대규모 교사 모델로부터 각각 증류한 성적 중 최고치를 비교 기준으로 삼았다. ↩︎
실험에서는 선형 매핑을 사용하는 WeightCLIP-LM과 다층 매핑 모듈을 사용하는 WeightCLIP-MBM 두 가지 변형을 평가했으며, 표에는 두 변형 중 더 높은 성적을 기록한 값을 제시했다. ↩︎