3줄 요약
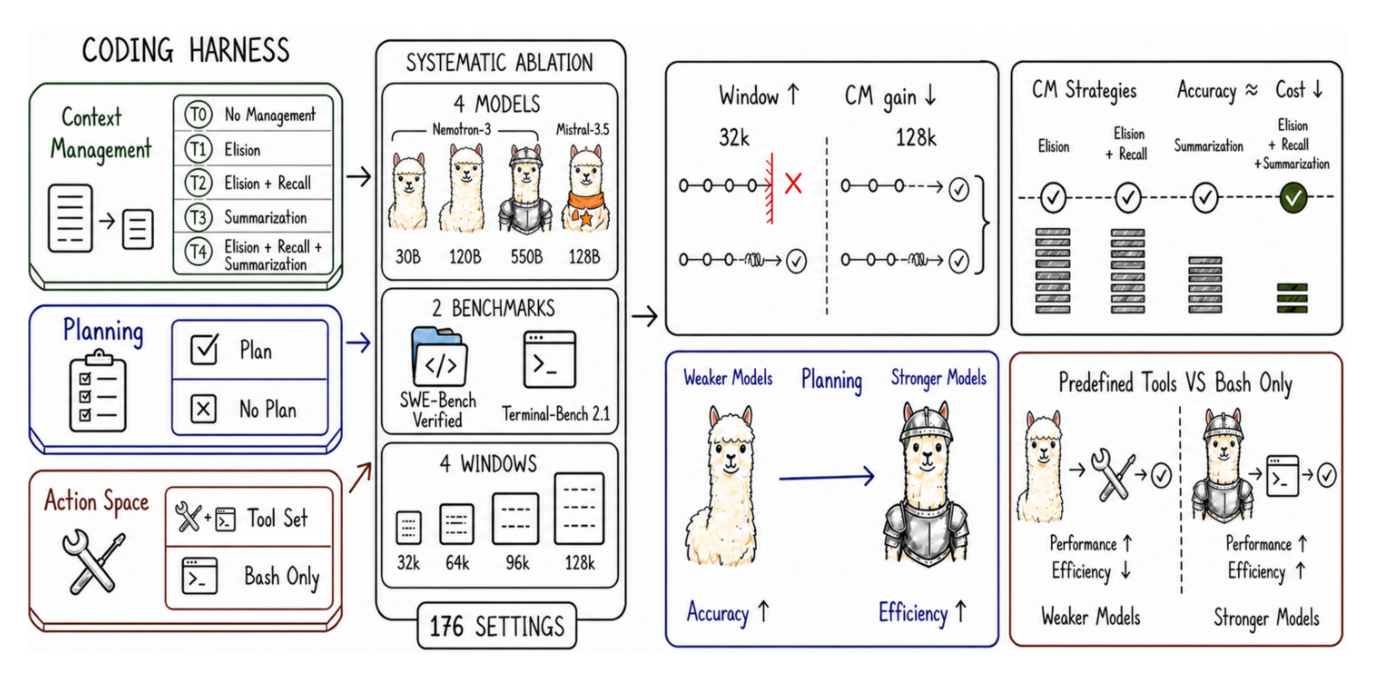
- UMass Amherst와 Emory 대학, UNC Charlotte, Zoom 연구진이 2026년 9월 17일 arXiv에 공개한 실증 연구다. 기존 연구는 코딩 에이전트의 하네스를 하나의 완성품으로 놓고 비교했다. 이 연구는 그 방식을 접고, 실행 루프는 고정한 채 계획, 액션 공간, 컨텍스트 관리라는 세 부품만 바꿔 가며 176개 설정을 돌렸다.
- 세 부품의 값어치는 조건에 따라 크게 달랐다. 컨텍스트 관리가 정확도에 기여하는 폭은 컨텍스트 창이 32k 토큰일 때 평균 35.7%포인트였지만 128k에서는 2.7%포인트로 줄었고, 그 기여의 대부분은 컨텍스트 초과로 실행이 중간에 끊기는 것을 막는 데서 나왔다.
- 계획은 약한 모델에서 정확도를 올렸고, 강한 모델에서는 정확도 대신 비용을 줄이는 장치가 됐다. 미리 정의된 도구는 셸에 서툰 모델의 성공률을 크게 올렸지만, 셸을 능숙하게 쓰는 모델에게는 비용만 더 물리는 결과를 낳았다.
왜 하네스를 부품 단위로 쪼갰나
코딩 하네스는 언어 모델을 에이전트로 바꿔 주는 소프트웨어 계층이다. 계획 발판은 작업의 구조를 유지한다. 액션 인터페이스는 모델의 의도를 실행 가능한 조작으로 옮긴다. 컨텍스트 관리 정책은 유한한 창 안에 어떤 대화 이력을 남길지 결정한다. Claude Code, Codex, OpenCode, OpenHands 같은 제품과 프레임워크가 모두 이 계층 위에서 작동한다.
그런데 지금까지의 연구는 하네스를 통째로 놓고 비교해 왔다. 논문이 인용한 교차 하네스 평가에 따르면 Claude-Opus-4.5는 OpenHands에서 가장 좋은 성적을 냈고, Claude-Sonnet-4.5는 SWE-Agent에서 가장 좋았다. 두 에이전트 사이에 성능 차이가 나왔다 해도, 그 차이가 계획과 도구 설계와 컨텍스트 관리 가운데 어디에서 비롯됐는지는 알 수 없다. 완성품끼리 비교하면 여러 기제가 한꺼번에 섞여 들어오고, 그래서 원인을 떼어낼 방법이 없어진다.
그래서 저자들은 질문을 이렇게 다시 세웠다. 하네스의 부품은 어떤 설정에서나 두루 쓸모가 있는가, 아니면 각 부품의 효과가 모델의 능력과 작업 유형과 자원 예산에 따라 달라지는가.
실험 설계
저자들은 가벼운 하네스를 직접 만들었다. 기존 하네스는 구현 선택들이 서로 얽혀 있어 하나만 떼어 바꾸기 어렵기 때문이다. 이 하네스는 ReAct 루프를 따르며 한 턴이 추론과 액션과 관찰로 이루어진다. 여기서 계획, 액션 공간, 컨텍스트 관리 세 가지만 바꾸고 나머지는 전부 고정했다.
모델은 같은 계열 안에서 능력 차이를 비교하기 위해 Nemotron-3의 세 크기(30B, 120B, 550B)를 썼고, 계열 밖으로 일반화되는지 보려고 Mistral-Medium-3.5-128B를 추가했다. 토큰 가격은 OpenRouter 기준으로 매겼다.
| 모델 | 입력 100만 토큰 | 출력 100만 토큰 |
|---|---|---|
| Nemotron-3 30B | 0.05달러 | 0.20달러 |
| Nemotron-3 120B | 0.08달러 | 0.45달러 |
| Nemotron-3 550B | 0.50달러 | 2.20달러 |
| Mistral-Medium-3.5-128B | 1.50달러 | 7.50달러 |
벤치마크는 두 가지를 썼다. SWE-Bench Verified는 사람이 검수한 실제 깃허브 이슈 500건으로 저장소 수준의 이슈 해결 능력을 재고, Terminal-Bench 2.1은 명령줄 환경에서 끝까지 완수해야 하는 89개 과제로 구성된다. 두 벤치마크 모두 과제 성공률과 과제당 평균 비용을 함께 보고한다.
구현 쪽 설정도 전부 고정됐다. 네 모델 모두 SGLang에서 BF16 정밀도로 서빙했고, 온도는 0, top-p는 0.95, 턴당 출력은 16,384토큰으로 제한했다. 하네스는 LangGraph 위에 올렸고 벤치마크는 Harbor로 몰았다. 한 과제에 허용된 스텝은 최대 300개다. 도구 결과는 24,000자에서 잘리고, 한 스텝에 읽기 전용 도구를 최대 여덟 개까지 병렬로 돌릴 수 있다.
컨텍스트 창 예산은 32k, 64k, 96k, 128k 네 가지다. 각각 3만 2천 토큰부터 12만 8천 토큰까지다. 여기에 컨텍스트 관리 전략 다섯 개를 돌리면 모델과 벤치마크 조합 하나당 20개 설정이 나온다. 그 위에 128k와 T4를 기준선으로 삼아 계획을 끄는 설정 하나와 액션 공간을 bash 전용으로 바꾸는 설정 하나를 더하면 조합 하나당 22개가 된다. 모델 넷과 벤치마크 둘을 곱하면 176개 설정이다. 성공률 비교는 과제 단위로 짝지은 양측 정확 McNemar 검정으로 했고, Benjamini-Hochberg 절차로 거짓 발견율을 0.05에서 통제했다.
하네스의 구조
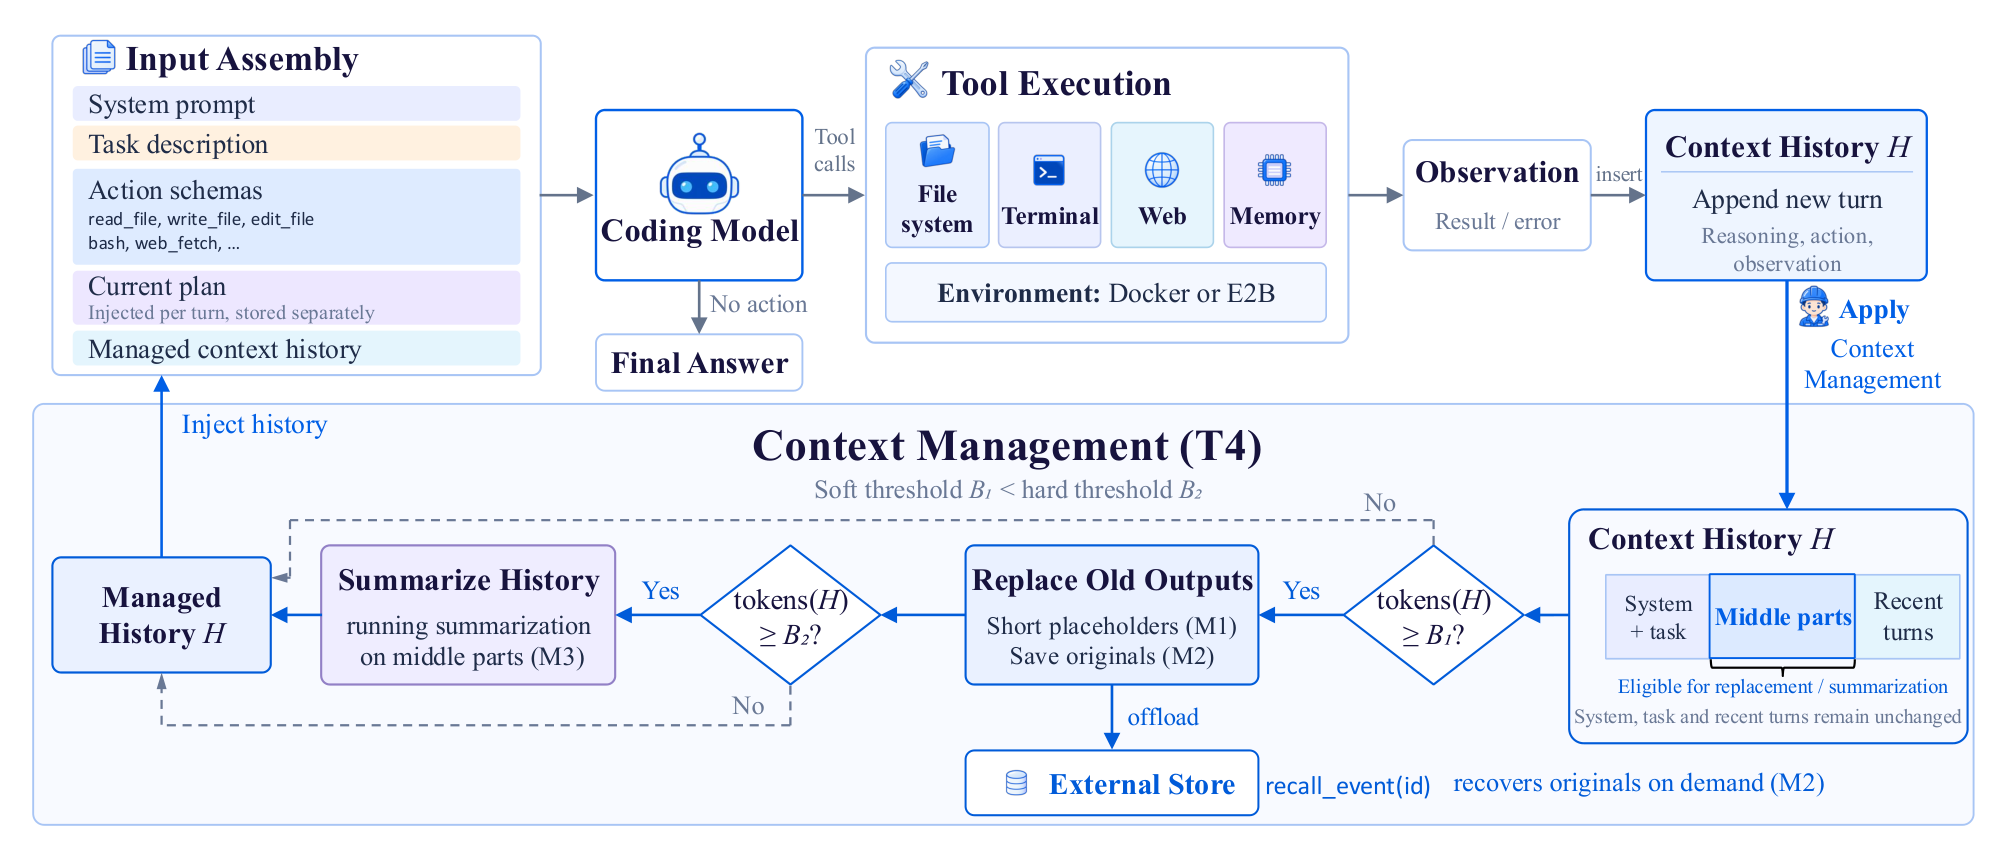
계획 부품은 모델이 직접 갱신하는 명시적인 작업 계획을 유지한다. 계획을 켜면 시스템 지시가 규약을 정의한다. 첫 턴에는 계획을 먼저 세우라는 알림이 붙는다. 그다음부터 모델은 update_plan 도구로 계획을 고쳐 나간다. 이후의 턴에서 계획은 대화 이력에 저장되지 않고 모델 입력에 따로 주입된다. 계획을 끄면 지시와 알림과 주입과 도구가 모두 사라진다. 그러므로 이 실험이 재는 것은 일반적인 추론 전략으로서의 계획이라기보다 이 지속적인 계획 발판의 효과다.
액션 공간은 미리 정의된 도구 세트와 bash 전용 인터페이스 중 하나를 모델에게 노출한다. 미리 정의된 도구 세트는 read_file, write_file, edit_file, list_files, glob_files, grep_text, web_fetch, bash를 제공하며 각 도구에는 인자 스키마와 규약, 오류, 부작용을 적은 설명이 붙는다. bash 전용 설정은 파일, 검색, 웹 도구를 제거하고 bash 하나만 남긴다. 저자들은 이 개입으로 달라지는 것이 도구 수만은 아니라고 분명히 밝혔다. 미리 정의된 파일 도구는 쓰기 전에 읽었는지 검사하고, 하네스의 파일 상태를 갱신하며, 편집 이후 자동 진단을 돌린다. 그래서 이 비교는 도구 개수나 액션 단위의 효과로 읽으면 안 되고, 인터페이스 전체의 효과로 읽어야 한다.
세 부품 외에 고정된 장치도 세 가지가 있다. 첫째, 안전 장치는 모든 워크스페이스 접근을 세 관문에 거치게 한다. 경로가 프로젝트 루트를 벗어나면 심링크를 거쳤더라도 거부되고, 현재 세션에서 읽지 않은 파일은 편집이나 덮어쓰기가 막히며, 각 액션은 허용과 확인과 거부로 분류된다. 도구 오류는 예외로 처리하지 않고 관찰로 되돌린다. 그래서 액션 하나가 실패해도 루프는 계속 돌아간다. 둘째, 편집 후 진단은 파이썬 파일을 고치면 ruff나 pyflakes로 빠른 읽기 전용 검사를 돌려 결과를 도구 응답에 붙인다. 셋째, 막힘 감지는 같은 도구를 같은 인자로 다섯 번 연속 부르면 접근을 바꾸라는 알림을 한 번 주고, 같은 실패 호출이 여덟 번 연속되면 예산을 다 태우기 전에 실행을 끝낸다.
다섯 가지 컨텍스트 관리 전략
컨텍스트 관리는 함께 쓸 수 있는 세 기제로 구성된다. 생략(M1)은 오래된 도구 관찰의 본문을 짧은 표지로 바꾼다. 되살리기(M2)는 생략된 관찰을 파일 시스템에 저장하고 recall_event 도구로 다시 불러오게 해서, 생략한 내용을 나중에 되찾도록 한다. 요약(M3)은 오래된 메시지를 하나의 자연어 요약으로 바꾼다. 요약은 평가 대상과 같은 모델을 도구 없이 따로 호출해서 만든다.
두 개의 임계값이 있다. 이력이 소프트 임계값을 넘으면 중간 영역의 부피 큰 도구 관찰이 생략되고 원본은 외부 저장소로 간다. 그래도 하드 임계값을 넘으면 가장 오래된 중간 이벤트가 요약으로 바뀐다. 시스템 프롬프트와 최초 과제 설명, 그리고 최소 두 턴 이상인 최근 창은 원문 그대로 남고 중간 영역만 압축된다. 실제 설정에서 소프트 임계값은 사용 가능한 창의 0.6, 하드 임계값은 0.85이고, 원문으로 남기는 최근 창의 예산은 0.3이다.
| 전략 | 생략(M1) | 되살리기(M2) | 요약(M3) |
|---|---|---|---|
| T0 | 없음 | 없음 | 없음 |
| T1 | 있음 | 없음 | 없음 |
| T2 | 있음 | 있음 | 없음 |
| T3 | 없음 | 없음 | 있음 |
| T4 | 있음 | 있음 | 있음 |
T0은 컨텍스트 관리를 끈 설정이라 창을 넘기는 궤적은 오류로 끝난다. T1부터 T3까지는 이력이 찼을 때 취할 행동이 하나뿐이라 하드 임계값에서만 작동하고, T4만 소프트 임계값에서 생략한 뒤 하드 임계값에서 요약한다.
발견 1: 창이 좁을수록 컨텍스트 관리의 값어치가 커진다
저자들은 컨텍스트 관리의 값어치를 관리 전략들(T1에서 T4)과 관리 없음(T0) 사이의 성공률 격차로 정의했다. 네 모델의 평균을 내면 이 격차는 창이 넓어질수록 꾸준히 줄어든다.
| 컨텍스트 창 | SWE-Bench 격차 | Terminal-Bench 격차 |
|---|---|---|
| 32k | 35.7%포인트 | 9.5%포인트 |
| 64k | 15.9%포인트 | 7.5%포인트 |
| 96k | 5.5%포인트 | 4.8%포인트 |
| 128k | 2.7%포인트 | 2.8%포인트 |
이 격차가 줄어드는 곡선은 T0의 창 초과 실패가 줄어드는 곡선과 그대로 겹친다. 모델 평균으로 볼 때 T0의 창 초과 비율은 SWE-Bench에서 78.7%에서 8.7%로, Terminal-Bench에서 61.0%에서 12.1%로 떨어진다. 반면 관리를 켠 전략들은 모든 예산에서 창 초과 실패가 정확히 0건이었다. 컨텍스트 관리가 값어치를 갖는 까닭은 컨텍스트 창이 좁을 때 실행이 미리 잘리는 것을 막아 주는 데 있다. 관리하지 않은 궤적까지 창 한도 아래에 머무르기 시작하면 그 한계 이득은 줄어들고 모델에 따라 달라진다.
SWE-Bench Verified의 실제 숫자를 보면 이 흐름이 더 분명해진다.
| 설정 | 30B | 120B | 550B | Mistral |
|---|---|---|---|---|
| 32k, T0 | 9.40% | 11.40% | 6.40% | 12.60% |
| 32k, T4 | 21.20% | 42.20% | 55.60% | 63.80% |
| 128k, T0 | 24.80% | 40.20% | 59.80% | 67.40% |
| 128k, T4 | 25.20% | 44.00% | 65.80% | 68.60% |
32k에서 550B의 성공률은 컨텍스트 관리 없이 6.40%까지 떨어진다. 가장 큰 모델의 성적이 가장 크게 떨어지는데, 이는 큰 모델일수록 궤적이 길어져 창을 먼저 넘기기 때문이다. 같은 모델이 T4를 켜면 성공률은 55.60%가 된다. 그런데 128k로 올라가면 T0과 T4의 성공률이 각각 59.80%와 65.80%까지 좁혀진다.
발견 2: 생략을 요약보다 앞에 두면 가장 싸게 끝난다
T4는 여덟 개의 모델과 벤치마크 조합 가운데 일곱 개에서 가장 낮은 비용을 기록했고, 성공률은 T1, T2, T3과 비슷했다. 저자들은 그 까닭을 최대 컨텍스트 점유율에서 찾았다. 32k에서 T1과 T2의 궤적은 여전히 창을 거의 가득 채우는 데 비해, T3과 T4는 최대 컨텍스트를 창보다 한참 낮은 수준으로 유지한다. 네 예산 전부에서 T4의 평균 최대 컨텍스트 비율이 가장 낮았다.
이유는 각 기제를 몇 번이나 불렀는지 세어 보면 알 수 있다. T4는 32k와 64k에서 T1과 T2보다 생략을 덜 부르고, 더 큰 창에서도 비슷하게 낮은 수준을 유지한다. 그러면서 모든 예산에서 T3보다 요약을 덜 부른다. 요약을 한 번 하려면 같은 모델을 다시 불러야 하니 그만큼 돈이 더 든다. T4가 이른 시점의 생략으로 많은 경우를 먼저 처리해 버리니, 굳이 요약까지 갈 일이 줄어든다.
발견 3: 되살리기 기능은 거의 호출되지 않는다
되살리기(M2)는 생략을 되돌릴 수 있게 만드는 기제다. T1과 T2는 M2의 유무만 다르므로 그 값어치를 재기에 알맞은 짝이다. 32개의 모델과 벤치마크와 창 조합을 비교하면 T2가 T1보다 성적이 높은 설정이 15개, 낮은 설정이 14개, 차이가 없는 설정이 3개였다. 동일 가중 평균 차이는 -0.36%포인트다.
호출 빈도는 더 극적이다. T2와 T4를 쓰는 64개 설정 가운데 36개(56.3%)는 recall_event를 한 번도 부르지 않았고, 호출률의 중앙값은 0이었다. 동일 가중 평균 호출 횟수는 32k에서 과제당 0.540회였다. 이 값이 64k에서 0.069회, 96k에서 0.011회, 128k에서 0.007회로 떨어진다. 128k와 T4에서 돌린 계획과 액션 공간 설정 16개는 되살리기를 단 한 번도 부르지 않았다. 가장 많이 쓴 설정인 30B의 32k T2 Terminal-Bench조차 과제당 4.326회를 부르고도 T1보다 3.37%포인트 낮은 성적을 냈다.
무손실 저장은 대부분의 모델이 좀처럼 쓰지 않는 장치를 하나 더 늘리는 일이었고, 생략된 관찰을 되찾는 행위가 완수한 과제로 꾸준히 이어지지도 않았다.
발견 4: 계획은 모델이 강해질수록 역할이 바뀐다
계획은 128k와 T4, 전체 도구 세트를 기준선으로 놓고 켜고 끄며 비교했다.
Nemotron-3 30B에서 계획은 SWE-Bench 성공률을 11.6%포인트, Terminal-Bench를 4.5%포인트 올렸고 두 벤치마크 모두에서 비용을 늘렸다. 120B에서는 성공률 이득이 일관되지 않았고 비용은 SWE-Bench에서 늘고 Terminal-Bench에서 줄었다. 550B와 Mistral에서는 계획이 두 벤치마크 모두에서 비용을 줄이는 대신 성공률을 조금씩 떨어뜨렸다. SWE-Bench 기준으로 두 모델의 비용은 각각 약 30%와 32% 감소했고, 성공률은 2.0%포인트와 0.4%포인트 감소했다.
실행 통계가 이 비용 변화를 설명한다. 아래는 계획을 끈 조건을 기준으로 삼았을 때, 계획을 켠 조건에서 나타난 변화율이다.
| 모델 | SWE-Bench 턴 | SWE-Bench 도구 호출 | Terminal-Bench 턴 | Terminal-Bench 도구 호출 |
|---|---|---|---|---|
| Nemotron-3 30B | +293.2% | +474.0% | +66.7% | +83.8% |
| Nemotron-3 120B | +20.1% | +42.7% | -15.0% | -23.1% |
| Nemotron-3 550B | -24.3% | -24.5% | +6.8% | +7.9% |
| Mistral-Medium-3.5-128B | -23.2% | -23.3% | -22.5% | -21.9% |
30B에서 계획은 턴과 도구 호출을 폭발적으로 늘리고, 550B와 Mistral에서는 오히려 줄인다. 같은 부품을 붙였는데 모델에 따라 작동 방향이 정반대로 나온다.
발견 5: 액션 공간의 선택은 모델의 셸 숙련도에 달려 있다
미리 정의된 도구 세트와 bash 전용 인터페이스를 128k와 T4, 계획 켜짐 조건에서 비교했다.
Nemotron-3 30B에서는 미리 정의된 도구가 성공률을 SWE-Bench에서 15.0%포인트, Terminal-Bench에서 10.1%포인트 올렸다. 이 이득은 모델이 학습 과정에서 익힌 액션 어휘가 하네스 인터페이스와 일치했기 때문에 나왔다. 미리 정의된 도구가 없으면 30B는 의도한 조작을 bash로 옮기는 대신 학습 때 익힌 도구 호출 패턴을 그대로 내놓는다. bash 전용 레지스트리에는 그런 도구가 없으니 하네스는 그 호출을 실행 가능한 액션으로 풀어내지 못한다. Terminal-Bench에서 bash 전용 궤적의 66%가 이런 인터페이스 밖 호출 뒤에 종료됐고, 평균 궤적 길이는 71턴에서 15턴으로 짧아졌다.
120B에서는 정확도 이득이 SWE-Bench 1.6%포인트, Terminal-Bench 4.5%포인트로 줄어드는 대신 실행이 더 효율적이 됐다. 미리 정의된 도구가 평균 실행 길이를 SWE-Bench에서 101턴에서 77턴으로, Terminal-Bench에서 96턴에서 70턴으로 줄이면서도 비용은 늘리지 않았다.
550B에 이르면 앞의 두 모델과 반대되는 결과가 나온다. bash 전용이 성공률을 SWE-Bench에서 3.6%포인트, Terminal-Bench에서 5.6%포인트 올리면서 비용을 각각 53%와 30% 줄였다. 호출 횟수도 SWE-Bench에서 32%, Terminal-Bench에서 24% 적었다. 능력 있는 모델은 더 촘촘하고 복합적인 셸 명령을 쓰는데, 미리 정의된 도구 세트는 이런 모델에게 발판이 되기보다 액션 선택과 상호작용 부담만 더한다.
Mistral은 이 교차점이 작업 종류에 따라 한 번 더 달라진다는 것을 보여 준다. 전체 도구 세트가 SWE-Bench 성공률을 23.2%포인트 올리는데, Terminal-Bench에서는 bash 전용이 6.7%포인트 더 낫다. 이유는 Mistral이 도구를 전부 줬을 때도 Terminal-Bench 워크스페이스 액션의 71.9%를 bash로 처리한 반면 SWE-Bench에서는 40.4%만 bash로 처리했다는 데 있다. Terminal-Bench가 더 셸 중심이라 경쟁하는 워크스페이스 도구를 치우는 편이 모델이 선호하는 액션과 잘 맞는다. 반대로 SWE-Bench에서는 미리 정의된 읽기와 검색과 편집 액션이 여전히 중요하다. Mistral의 bash 전용 SWE-Bench 실행 가운데 32.8%가 파일을 한 번도 고치지 못하고 끝났는데, 전체 도구 세트에서는 그 비율이 1.2%였다.
궤적 분석이 설명하는 것
저자들은 GPT-5.5를 판정자로 써서 각 턴에 작업 단계 라벨을 붙였다. 검증을 위해 사람 주석자 세 명이 궤적 200개에 같은 기준으로 라벨을 달았다. 총 15,610개 라벨 단위를 비교한 결과 원시 일치율은 약 94.2%, 가중 평균 코헨 카파는 0.929였다.
이 라벨로 본 세 부품의 작동 방식은 다음과 같다.
컨텍스트 관리는 궤적을 늘릴 뿐 행동을 크게 바꾸지 않는다. 32k에서 컨텍스트 관리가 없으면 아직 진행 중인 SWE-Bench 실행의 비율이 가파르게 떨어지고, 네 모델의 중앙값 궤적 길이는 20턴에서 30턴 사이에 머문다. 대부분의 실행이 위치 파악 단계에서 끝나고 검증 단계까지 가는 경우는 드물다. 관리를 켜면 중앙값이 대략 50턴에서 180턴까지 늘어나면서 단계의 순서와 비율은 대체로 그대로 유지된다. 128k에서는 전략 사이의 차이가 거의 사라진다.
계획은 가장 약한 모델의 궤적을 편집 시도까지 버티게 한다. 30B에서 계획을 끄면 SWE-Bench 중앙값 궤적이 40턴에서 5턴으로 줄어든다. 계획이 없을 때 실행의 68.6%가 파일을 한 번도 고치지 못하고 끝나고 58.4%가 위치 파악 단계에서 끝난다. 계획을 켜면 두 비율이 각각 27.8%와 10.4%로 낮아진다.
계획은 강한 모델의 중복 검증을 걷어낸다. 550B에서 계획은 중앙값 궤적을 108턴에서 74턴으로, Mistral에서는 68턴에서 53턴으로 줄인다. 단계별 구성을 보면 감소분의 대부분이 검증 단계에서 나왔다. 위치 파악과 수정 단계의 감소분은 작았다. 계획이 위치 파악이나 수리를 빠르게 만드는 것은 아니고, 멈춰야 할 때 멈추게 만드는 쪽에 가깝다.
bash 전용은 코드 작성 액션을 크게 만들고 상호작용 횟수를 줄인다. 550B의 Terminal-Bench에서 전체 도구 세트를 bash 전용으로 바꾸면 중앙값 궤적이 47개 액션에서 31개로 줄고, 코드 작성 액션의 비중은 16%에서 27%로 올라간다. 더 짧은 궤적의 더 큰 몫이 코드를 만드는 데 쓰인다는 뜻이다.
세밀한 증거는 아래 표에 있다. 재수정은 이미 고친 파일을 다시 고치는 횟수이고, 편집 줄 수는 SWE-Bench에서 가장 큰 편집의 중앙값이며, 생성 비중은 Terminal-Bench에서 파일 쓰기 액션 가운데 통째로 만들거나 갈아 치우는 비중이다.
| 모델 | 재수정(도구) | 재수정(bash) | 편집 줄 수(도구) | 편집 줄 수(bash) | 생성 비중(도구) | 생성 비중(bash) |
|---|---|---|---|---|---|---|
| Nemotron-3 30B | 3.3 | 0.4 | 26 | 13 | 28% | 64% |
| Nemotron-3 120B | 2.8 | 2.2 | 22 | 24 | 39% | 76% |
| Nemotron-3 550B | 4.6 | 1.5 | 18 | 54 | 51% | 76% |
| Mistral-Medium-3.5-128B | 3.0 | 1.3 | 87 | 68 | 28% | 57% |
미리 정의된 도구는 개별 액션의 복잡도를 낮추는 대신, 같은 조작을 표현하는 데 필요한 상호작용 횟수와 점진적 수리 주기를 늘린다.
저자들이 밝힌 한계
저자들은 세 가지를 명시했다. 첫째, 이 결과는 여기서 다룬 특정 구현의 조건부 효과를 재는 것이지 보편적으로 최적인 하네스를 찾은 것은 아니다. 계획은 하나의 프롬프트와 갱신 기제로만 구현됐고, 컨텍스트 관리는 고정된 압축 설정을 쓰는 하나의 임계값 기반 정책을 따른다. 액션 공간 개입은 도구 가용성과 인터페이스 프롬프트와 파일 상태 추적과 자동 편집 후 진단을 한꺼번에 바꾸는 묶음이라 도구 개수나 액션 단위의 효과를 떼어내지 못한다.
둘째, 설계 공간의 커버리지와 통계적 검정력이 제한적이다. 계산 자원이 모자라 계획과 액션 공간은 기본 설정인 128k와 T4에서만 제거 실험을 했고, 다른 조합에서도 효과가 유지되는지 보려면 완전 요인 설계가 필요하다. 각 설정은 과제당 한 번만 돌렸고 Terminal-Bench는 과제가 89개뿐이라 상당수의 대조가 짝지은 McNemar 검정에서 유의성에 이르지 못했다. Terminal-Bench 쪽 결론은 개별 칸의 유의성보다 모델과 예산을 가로지르는 방향의 일관성에 기대고 있다.
셋째, 외적 타당도가 평가한 모델과 과제의 범위로 묶인다. SWE-Bench Verified는 파이썬 전용이고, 모델 크기는 능력의 불완전한 대리 지표다. 학습 방식이나 도구 인터페이스에 대한 사전 노출, 타고난 셸 숙련도의 차이도 관찰된 경향에 영향을 줬을 수 있다. Mistral이 벤치마크에 따라 서로 다른 인터페이스를 선호한 것이 그 증거다.
내가 다시 들여다본 숫자
되살리기 기제의 통계를 나는 몇 번이나 다시 읽었다. 생략된 관찰을 외부 저장소에 넣어 두고 필요할 때 되찾게 해 주는 기능은 설계 시점에서 보면 거의 반박할 수 없는 개선이다. 정보를 버리지 않으면서 컨텍스트를 줄이니 손해 볼 일이 없어 보인다. 그런데 64개 설정 가운데 36개가 그 도구를 한 번도 부르지 않았고, 128k에서는 평균 호출이 과제당 0.007회였다. 결국 만들어만 두고 아무도 쓰지 않은 기능이 된 셈이다.
더 의외였던 것은 그 기능을 가장 많이 쓴 설정의 성적이었다. 30B가 32k Terminal-Bench에서 과제당 4.326회를 불렀는데, 그렇게 열심히 되살리고도 되살리기 없는 T1보다 3.37%포인트 낮았다. 정보를 되찾을 수 있다는 것과 되찾은 정보로 과제를 끝낸다는 것은 서로 다른 문제였다. 무손실이 무조건 낫다는 직관이 실측으로 반박되는 장면을 이렇게 깔끔하게 보기도 쉽지 않다.
논문의 결론 문장도 같은 이야기를 한다. 하네스 설계는 조건부 시스템 문제이며, 각 부품은 기본값으로 채택할 것이 아니라 대상 모델과 작업 종류와 자원 예산에 맞춰 골라야 한다. 176개 설정을 돌린 끝에 나온 답이 “경우에 따라 다르다"라는 것은 얼핏 맥 빠지게 들리지만, 어느 경우에 어떻게 다른지를 숫자로 적어 놓았다는 점에서 충분히 쓸모 있는 답이다.
출처
Run-Ze Fan, Zihao Zhang, Simin Ma, Yebowen Hu, Shouju Wang, Kaiqiang Song, Fei Liu, Hamed Zamani, Xiaoyang Wang. “An Empirical Study of Harness Design for Coding Agents.” arXiv:2609.20804, 2026년 9월 17일. UMass Amherst, Zoom Video Communications, Emory University, UNC Charlotte.
원문: https://arxiv.org/abs/2609.20804
본문에 실은 그림 두 장은 논문 원문에서 인용했다.