3줄 요약
- SonyAI와 일본 시스템생물학연구소(SBI) 공동 연구진이 Hakken(핫켄)을 발표했다. 과학 문헌에서 추출한 시계열 지식 그래프와 대규모 언어 모델(LLM)을 결합해, 아직 보고되지 않은 과학 개념 사이의 새로운 관계와 구체적인 상호작용 유형을 예측하는 시스템이다.
- 예측 모델 THiGERLLM은 삼중항 712만 개 규모의 바이오메디컬 지식 그래프에서, 2020년 이전 데이터로 학습해 그 뒤에 처음 보고된 관계를 예측했을 때 Macro Recall 60.72%, Macro F1 51.16%를 기록했다. 1990년, 2000년, 2010년을 기준으로 각각 10년 뒤까지 예측한 백테스팅에서도 평균 nDCG가 0.98 이상이었다.
- 설명 프레임워크 PHELInE이 제시한 근거 경로를 바탕으로 노화 관련 가설 154만여 건 가운데 세 건을 골라 인간 세포주 실험(Wet-lab)을 진행했다. 그 결과 TP53의 BAMBI 발현 조절과 RAF1의 TNF 발현 조절, 이렇게 보고된 적 없는 생물학적 상호작용 두 가지가 실제로 입증됐다.
문헌 요약을 대체하는 지식 예측과 Hakken의 구조
과학 논문의 출판 속도가 기하급수적으로 빨라지면서 개별 연구자가 자신의 세부 분야 문헌조차 전부 파악하기 어려워졌다. 문헌 기반 발견(Literature-Based Discovery, LBD)이나 생성형 AI로 논문을 요약하고 개념 간 연관성을 탐색하는 연구가 이어졌으나, 대부분은 문헌에 이미 기록된 관계들의 연역적 범위(deductive closure)를 재조합하는 수준이었다.
SonyAI 연구진이 공개한 Hakken(핫켄)은 ‘발견’을 뜻하는 일본어 명사에서 이름을 따왔다. 이 시스템은 기존 문헌을 정리하거나 요약하는 대신, 아직 학계에 보고되지 않은 과학 개념 사이의 관계를 직접 예측한다. AlphaFold가 단백질 구조를, GNoME이 미발견 결정 구조를 예측하듯 지식을 예측(Knowledge Prediction)하는 방식이다. Hakken은 두 개념이 연관되어 있다는 수준에 그치지 않고, 주체(subject), 관계 유형(relation type), 객체(object)로 구성된 삼중항 $(s, r, o)$를 다중 레이블 분류로 산출한다. 예측마다 지금까지 축적된 문헌 증거를 종합했을 때 그 관계가 성립할 잠재적 확률인 보정 신뢰도 점수(calibrated confidence score)도 함께 매긴다.
| 구성 요소 | 핵심 역할 | 주요 기술 및 특징 |
|---|---|---|
| THiGERLLM (지식 예측 모델) | 미발견 삼중항 $(s, r, o)$ 다중 레이블 예측 및 확률 보정 | 계층적 시간 트랜스포머 + Mistral-7B-Instruct-v0.3 공동 학습, DWF 손실 함수 |
| PHELInE (설명 생성 프레임워크) | 예측된 가설을 지지하는 기존 지식 그래프 내 다중 홉 경로 추출 | GraphSAGE 서로게이트 기반 가상 재학습, 충분성(Sufficiency) 및 필요성(Necessity) 채점 |
| HakkenOSS (오픈소스 버전) | 공개 데이터셋 기반 재현 및 커뮤니티 연구 지원 | NCBI PubTator3 데이터셋 학습, 코드 및 사전학습 가중치 공개 |
AI가 확률 높은 가설을 제시하더라도, 그 예측이 왜 도출되었는지 기존 과학 지식으로 설명하지 못하면 연구자는 비용과 시간이 많이 드는 실험실 검증(Wet-lab validation)을 결정하기 어렵다. Hakken이 예측 모델 THiGERLLM과 설명 프레임워크 PHELInE, 두 핵심 모듈로 구성된 까닭이다. 연구진은 바이오메디컬 분야에서 두 모듈의 예측 성능을 검증했고, 미국 국립생물공학정보센터(NCBI)의 공개 데이터셋 PubTator3만으로 학습한 오픈소스 버전 HakkenOSS도 공개했다1.
시계열 지식 그래프와 LLM을 결합한 THiGERLLM
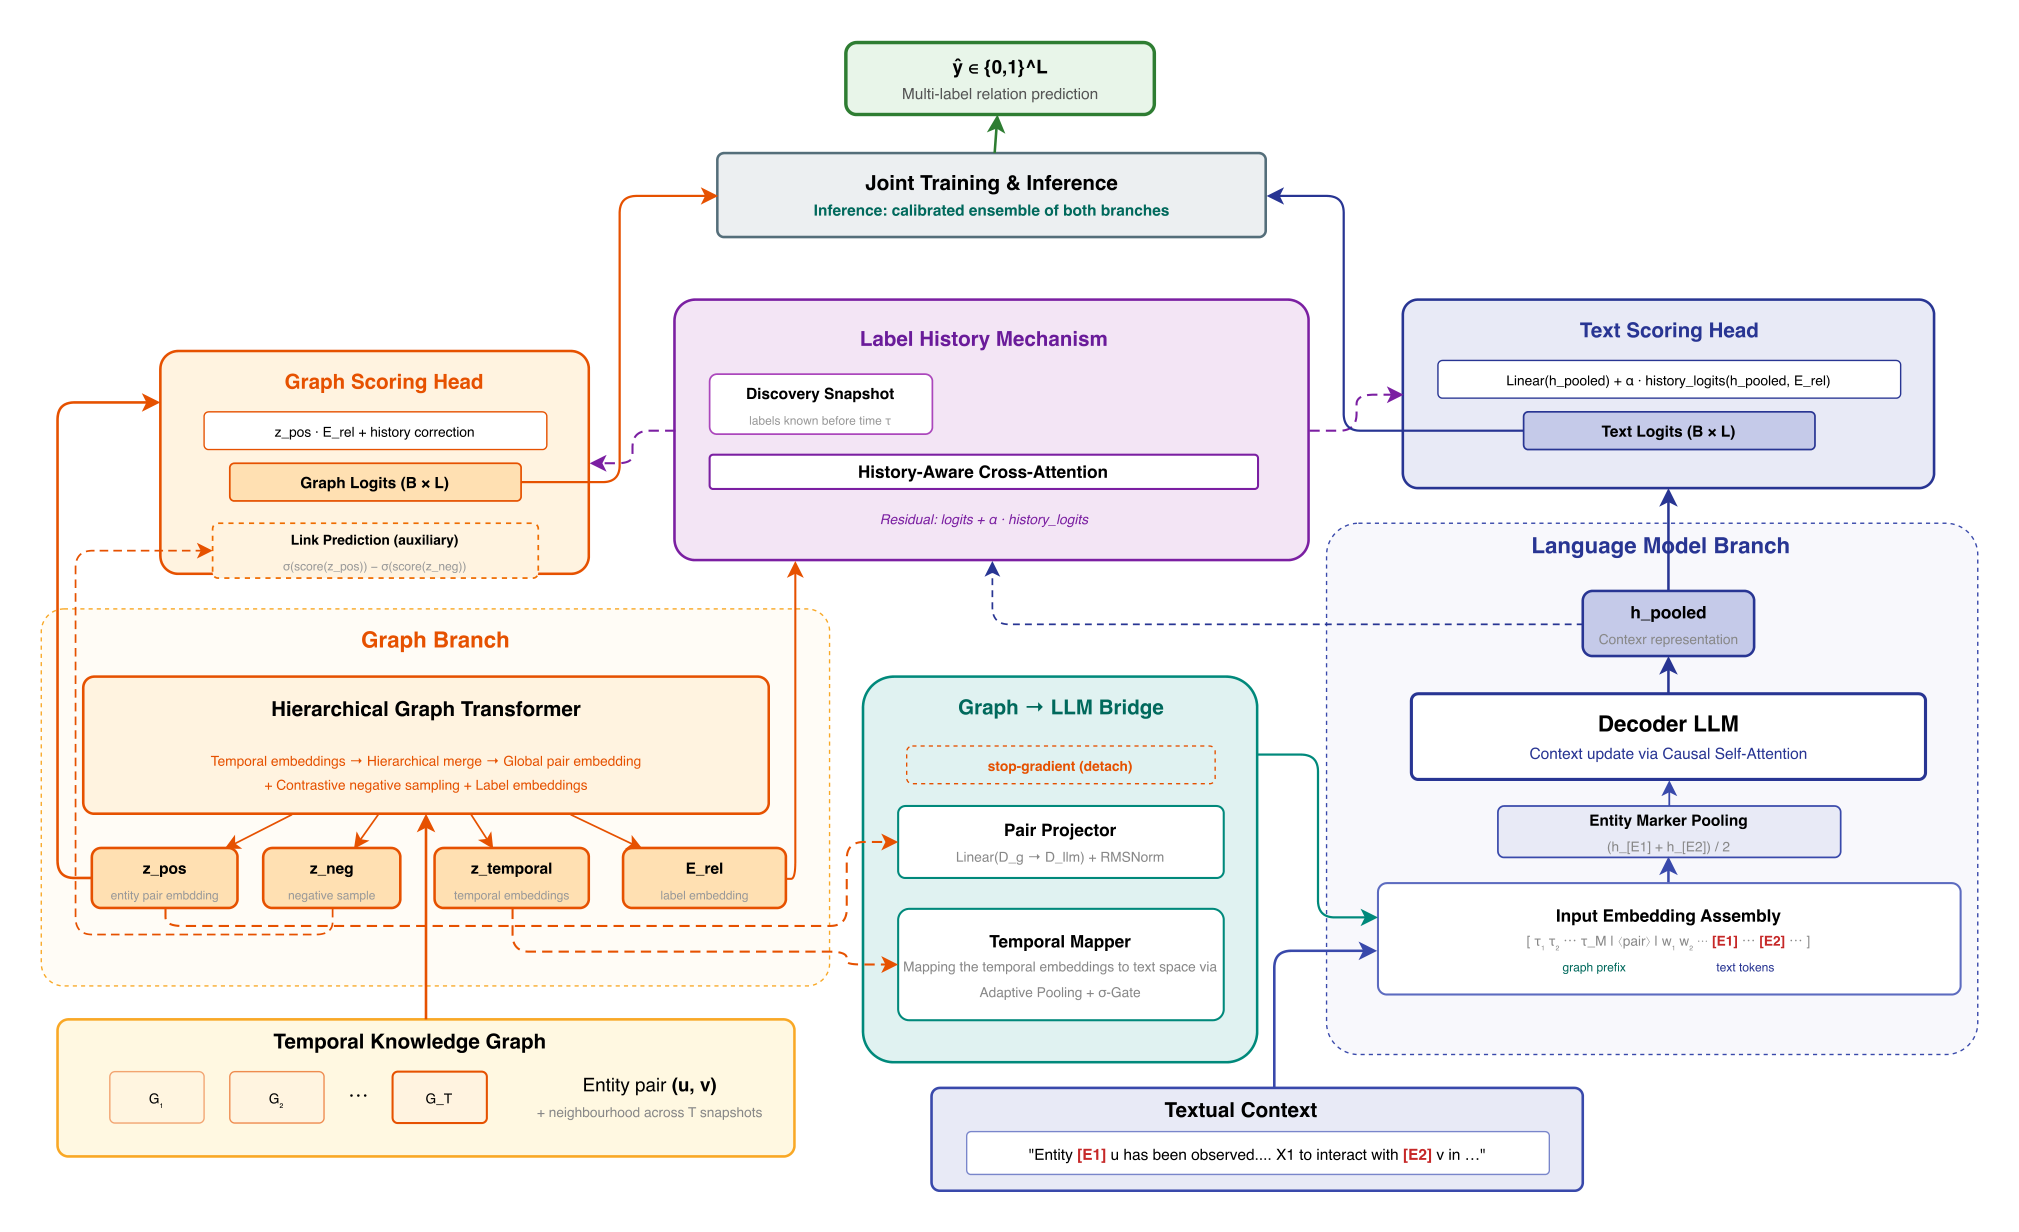
THiGERLLM(Temporal Hierarchical Graph-based Encoder Representation with LLM)은 과학 문헌에서 추출한 시계열 지식 그래프 $\mathcal{G}^{(1)}, \dots, \mathcal{G}^{(T)}$와 논문 본문 문장을 함께 입력받는다. 이를 바탕으로 두 개체 $(s, o)$ 사이의 후보 관계 유형 $C$개가 각각 성립하는지 예측한다. 선행 모델 THiGER가 그래프의 구조와 시간 신호만으로 관계가 있을지를 순위로 매겼다면, THiGERLLM은 여기에 언어 모델의 의미론적 배경지식을 결합해 구체적인 관계 유형까지 다중 레이블로 분류한다.
| 구분 | 그래프 브랜치 (Graph Branch) | 언어 모델 브랜치 (LLM Branch) |
|---|---|---|
| 입력 데이터 | 연도별 지식 그래프 스냅샷 $\mathcal{G}^{(1)}, \dots, \mathcal{G}^{(T)}$ 및 도메인 온톨로지 계층 | 학습 기준 연도 이전 문헌에서 추출한 개체별 단독 언급 문장(개체당 20개) |
| 인코더 구조 | RDF2Vec 온톨로지 임베딩 + 시점별 GraphSAGE + 계층적 시간 트랜스포머 | Mistral-7B-Instruct-v0.3 + 시계열 그래프 프리픽스 토큰 $M$개 및 <htg> 주입 |
| 산출 표현 | 전역 그래프 벡터 $\mathbf{z}^{\mathrm{graph}}_{so}$, 시간 잠재 시퀀스 $\mathbf{Z}^{\mathrm{temp}}_{so}$ | 개체 마커 토큰 은닉 상태의 평균 풀링 벡터 $\mathbf{h}^{\mathrm{text}}_{so}$ |
| 출력 및 결합 | 그래프 로짓 $\bm{\ell}^{\text{graph}}_{so}$ (+ 기존 관계 이력 잔차) | 텍스트 로짓 $\bm{\ell}^{\text{text}}_{so}$ (+ 기존 관계 이력 잔차) |
모델은 그래프 브랜치와 언어 모델 브랜치를 공동으로 학습한다. 먼저 그래프 브랜치에서는 개체 노드의 초기 표현을 만들 때 무작위로 초기화한 학습 가능 임베딩에 도메인 온톨로지 임베딩을 결합한다. 이 온톨로지 임베딩은 질병 $\rightarrow$ 감염성 질환 $\rightarrow$ 바이러스성 호흡기 질환 $\rightarrow$ COVID-19 같은 계층 구조에서 RDF2Vec과 word2vec 알고리즘으로 추출한다. 이후 시간 스냅샷 $t \in \{1, \dots, T\}$마다 GraphSAGE 방식으로 이웃 정보를 집계해 시점별 개체 쌍 표현 $\mathbf{p}^{(t)}_{so} \in \mathbb{R}^{d_g}$를 만들고, 이를 시계열 시퀀스 $\mathbf{P}_{so} \in \mathbb{R}^{T \times d_g}$로 묶는다.
묶인 시계열 시퀀스는 계층적 시간 트랜스포머(Hierarchical Temporal Transformer)에 입력된다. 이 모듈은 단계마다 트랜스포머 어텐션을 수행한 뒤 인접한 두 시점의 표현 $(2k-1, 2k)$를 합산해 시퀀스 길이를 절반으로 줄이고, 최종적으로 $\lceil \log_2 T \rceil$ 단계를 거쳐 단일 전역 그래프 벡터 $\mathbf{z}^{\mathrm{graph}}_{so}$와 시간 순서를 보존한 잠재 시퀀스 $\mathbf{Z}^{\mathrm{temp}}_{so}$를 산출한다2.
| 처리 모듈 | 입력 텐서 및 차원 | 핵심 연산 | 출력 텐서 및 역할 |
|---|---|---|---|
| 계층적 시간 트랜스포머 | 시계열 쌍 표현 $\mathbf{P}_{so} \in \mathbb{R}^{T \times d_g}$ | 짝 마스킹($-\beta$) 어텐션 및 인접 시점 $(2k-1, 2k)$ 단계별 합산 | 전역 그래프 벡터 $\mathbf{z}^{\mathrm{graph}}_{so}$, 시간 잠재 시퀀스 $\mathbf{Z}^{\mathrm{temp}}_{so}$ |
| 시간 토큰 매퍼 | $\mathbf{Z}^{\mathrm{temp}}_{so}$ 및 $\mathbf{z}^{\mathrm{graph}}_{so}$ | 푸리에 시간 인코딩 및 학습 가능 스칼라 게이트 $\sigma(\gamma)$ 결합 | 프리픽스 토큰 $\mathbf{g}_1, \dots, \mathbf{g}_M \in \mathbb{R}^{d}$, 조건화 벡터 $\mathbf{G}_{so} \in \mathbb{R}^{d}$ |
그래프 브랜치에서 추출한 정보는 시간 토큰 매퍼(Temporal Token Mapper)를 거쳐 언어 모델의 임베딩 공간 $\mathbb{R}^{d}$로 투영된다. 시간 잠재 시퀀스는 프리픽스 토큰 $\mathbf{g}_1, \dots, \mathbf{g}_M$으로 압축된다. 토큰 수는 최대 $M_{\max}$개 이하이며, 푸리에 시간 인코딩과 그래프 정보를 얼마나 반영할지 조절하는 게이트 $\sigma(\gamma)$가 함께 곱해진다. 전역 그래프 벡터는 단일 조건화 벡터 $\mathbf{G}_{so} \in \mathbb{R}^{d}$로 변환된다.
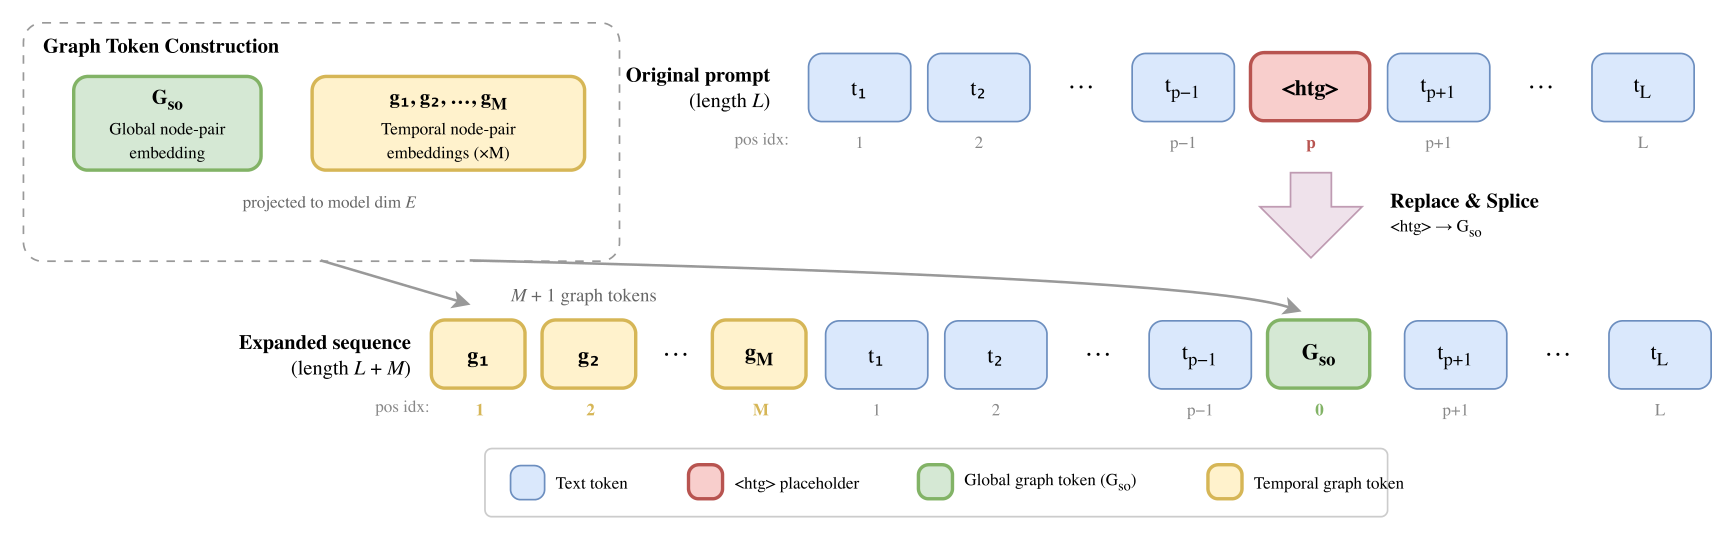 Figure 5:
<htg> 플레이스홀더를 전역 개체 쌍 임베딩 $\mathbf{G}_{so}$로 치환하고 $M$개의 시계열 그래프 토큰을 앞에 추가하는 토큰 주입 방식. 출처: arXiv:2609.04494 (arXiv non-exclusive license)
Mistral-7B-Instruct-v0.3을 백본으로 쓰는 언어 모델 브랜치는 학습 기준 연도(cut-off) 이전의 PMC Open Access 논문에서 입력 텍스트를 고른다. 두 개체 $s$와 $o$가 함께 나오지 않고 한 개체만 단독으로 언급된 문장을 개체마다 20개씩 무작위로 뽑는다. 두 개체가 함께 쓰인 문장을 빼면, 모델이 답이 적힌 문장을 그대로 읽는 일을 막고 각 개체의 고유한 특성에서 미발견 관계를 추론하게 유도할 수 있다3. Figure 5처럼 프롬프트의 <htg>는 전역 개체 쌍 토큰 $\mathbf{G}_{so}$로 치환하고, 맨 앞에 시간 그래프 토큰 $M$개를 추가해 길이 $L+M$의 시퀀스를 입력한다.
이어 개체 마커 토큰의 은닉 상태들을 평균 풀링해 텍스트 표현 $\mathbf{h}^{\mathrm{text}}_{so}$를 얻고, 두 브랜치에서 관계별 로짓 $\bm{\ell}^{\text{graph}}_{so}, \bm{\ell}^{\text{text}}_{so} \in \mathbb{R}^{C}$를 구한다. 여기에 기준 시점 $\tau$까지 관측된 관계 이력(label history)을 교차 어텐션으로 요약해 잔차로 더한다. 관계 사이의 상호 의존성을 반영하기 위해서다. 그래프는 구조와 시간을, 언어 모델은 개체의 성질을 맡는다.
학습 목적 함수는 미관측 관계($y_{so,c}=0$)를 미확인(unlabeled) 상태로 다루는 Positive-Unlabeled(PU) 학습으로 설계했다. 학습에는 DWF(Dynamically Weighted Balanced Focal) 손실 함수를 쓴다. 이진 교차 엔트로피에 소프트 타깃 어닐링을 적용하고 음성 항 가중치($\lambda_u$)를 줄인 다음, 초점 계수와 동적 클래스 균형 계수, 베르누이 분산 정규화 항을 결합한 식이다:
$$\begin{aligned} \mathcal{L}_{\mathrm{DWF}}(z,y) &= \mathrm{Dyn}(p_{t};c_{w}) \\ &\cdot \mathrm{Focal}(p_{t}) \cdot \widetilde{\mathrm{BCE}}(z,y) \\ &- \lambda_{\mathrm{reg}}\,p(1-p) \end{aligned}$$| 손실 함수 구성 항 | 수식 표현 | 설계 목적 |
|---|---|---|
| PU 소프트 타깃 BCE | $\widetilde{\mathrm{BCE}}(z, y)$ | 미관측 관계($y=0$)를 거짓이 아닌 미확인 상태로 취급하고 레이블별 사전 확률을 반영 |
| 초점 계수 (Focal) | $\mathrm{Focal}(p_t) = (1 - p_t)^\gamma$ | 이미 쉽게 분류되는 다수 클래스 대신 불확실하고 어려운 예제에 학습 가중치 집중 |
| 동적 클래스 균형 | $\mathrm{Dyn}(p_t; c_w) = c_w^{1 - p_t}$ | 희귀 관계 유형과 빈번한 관계 유형 사이의 극심한 클래스 불균형 완화 |
| 베르누이 분산 정규화 | $-\lambda_{\mathrm{reg}}\, p(1 - p)$ | 예측 확률이 $0.5$ 부근의 모호한 값으로 수렴하는 현상을 억제하고 결정 경계를 또렷하게 유지 |
추론 시에는 두 브랜치의 로짓을 레이블별 가중치 $\alpha^{\mathrm{ens}}_c$로 선형 결합한 뒤, 검증 세트에서 학습한 로지스틱 보정(Platt scaling)과 등위 회귀 보정(Isotonic calibration)을 혼합해 최종 확률 추정치 $\hat{p}_{so,c}$를 산출한다. 대규모 웹 코퍼스를 수 주에서 수 개월 동안 학습해야 하는 거대 LLM 시스템과 달리, THiGERLLM은 NVIDIA H100(80GB SXM5) GPU 8개와 메모리 960GB를 갖춘 서버 두 대로 며칠 만에 학습을 마친다. 추론은 범용 하드웨어에서도 가능하다.
예측의 근거를 역추적하는 설명 프레임워크 PHELInE
THiGERLLM이 높은 신뢰도로 새로운 가설 $(s, r, o)$를 제시하더라도, 생물학자가 이를 실험으로 검증하려면 기존에 알려진 생물학적 메커니즘과 어떻게 연결되는지 확인해야 한다. 연구진이 함께 개발한 PHELInE(Predicted Hypothesis Elucidation with Literature-Inferred Explanations)은 모델 불가지론적(model-agnostic) 설명 프레임워크다. 예측 모델의 내부 구조나 가중치, 그래디언트에 접근하지 않고, 예측 점수 함수 $f_\theta(s, r, o)$에 질의한 결과만 활용한다.
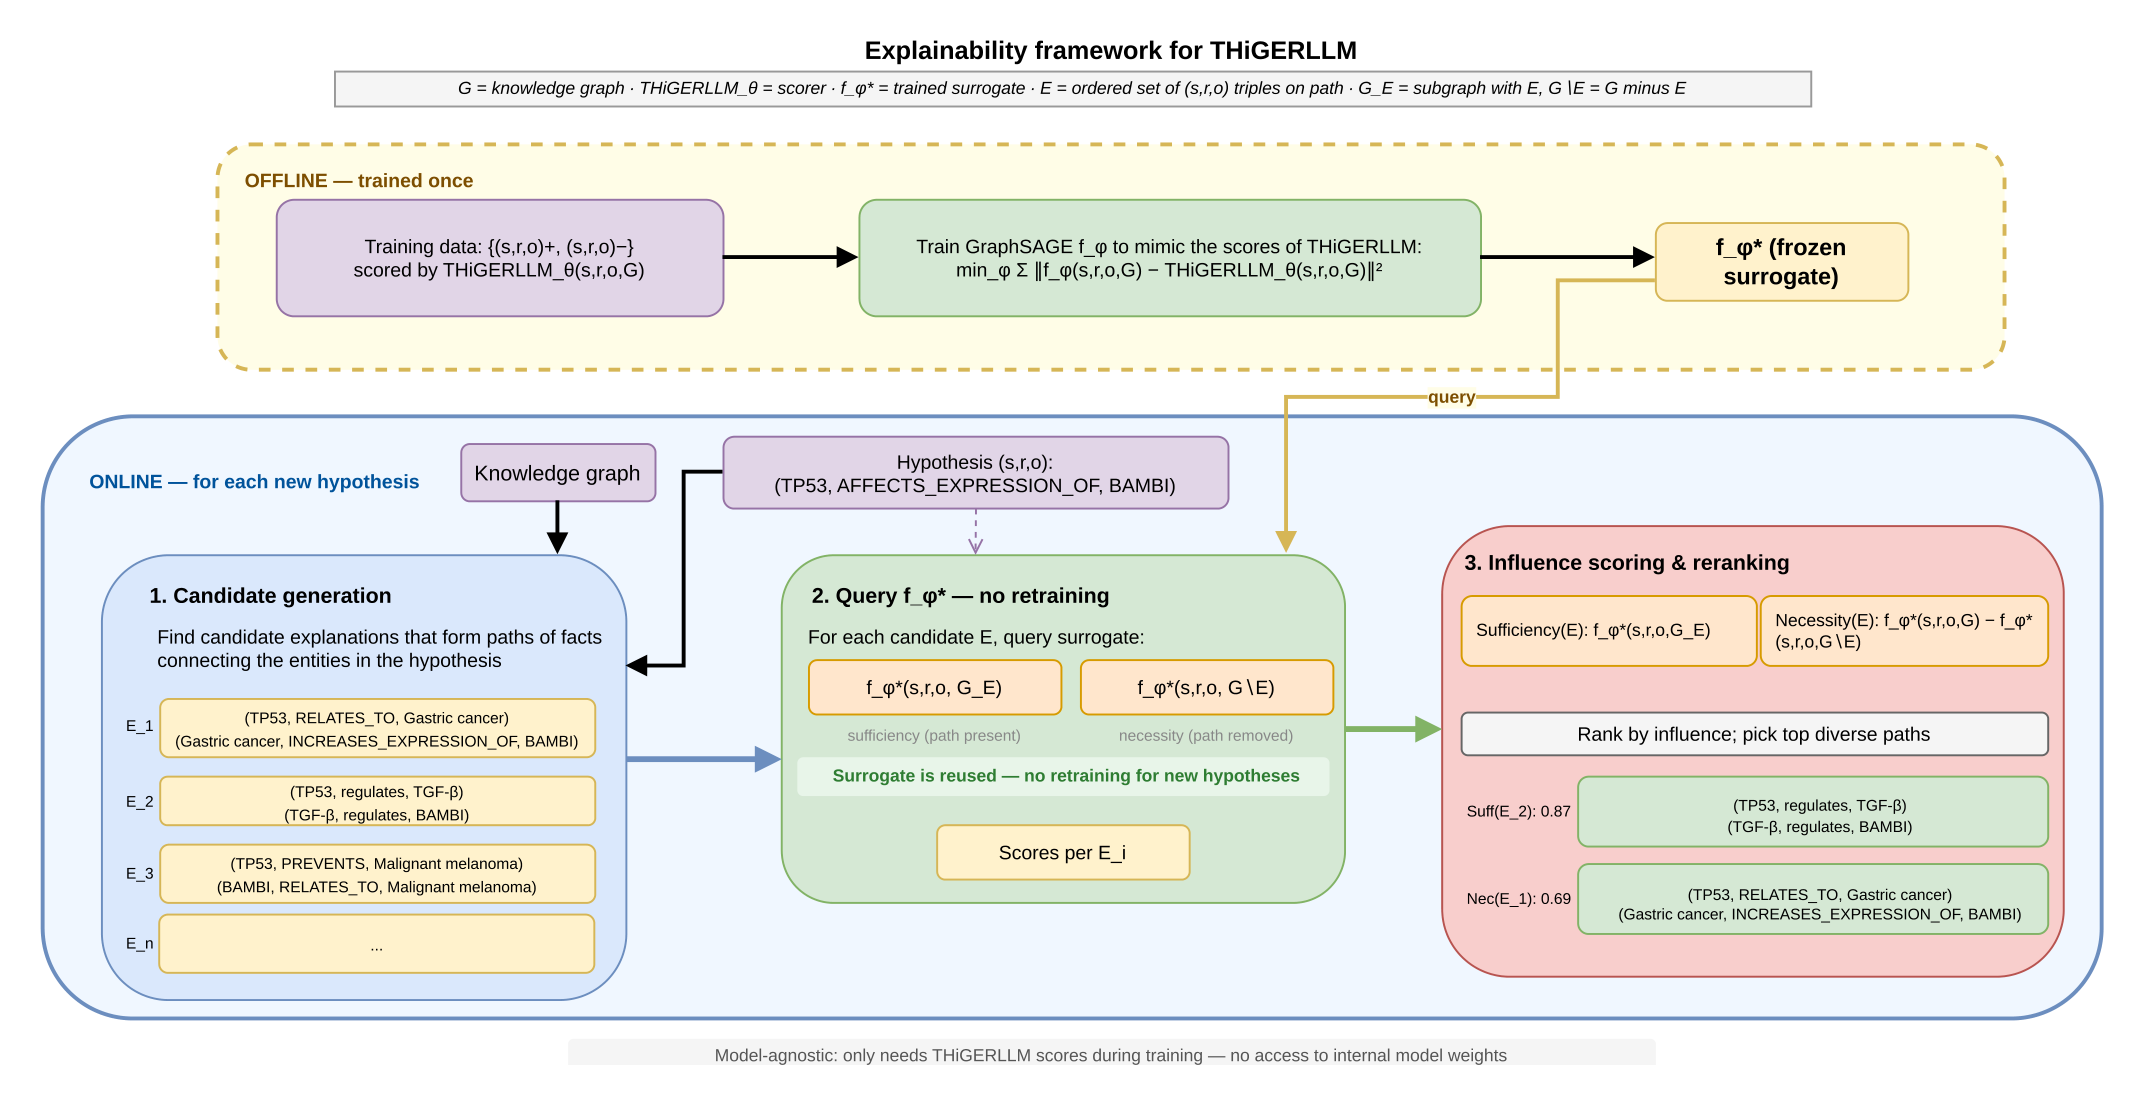 Figure 2: THiGERLLM의 예측에 대한 설명을 생성하는 PHELInE 프레임워크의 오프라인 서로게이트 학습 및 온라인 추론 과정. 출처: arXiv:2609.04494 (arXiv non-exclusive license)
Figure 2는 PHELInE이 설명 경로를 추출하는 세 과정을 보여준다.
- 후보 경로 생성: 주체 $s$와 객체 $o$를 잇는 길이 $k$(주로 2~4홉)의 관계 경로를 탐색해 후보 설명 집합 $\mathcal{X}$를 구성한다. 기존 그래프의 관측 삼중항만 쓰는 코퍼스 경로 탐색과, 미관측 상태라도 모델 $f_\theta$가 기준치 $\tau$ 이상의 점수를 부여한 잠재 삼중항을 포함하는 잠재 경로 탐색을 모두 지원한다.
- 서로게이트 기반 가상 재학습: 후보 경로 $\mathcal{X}$를 추가하거나 제거할 때마다 예측 모델을 재학습하는 것은 연산상 불가능하다. 그 대신 오프라인에서 가벼운 GraphSAGE 서로게이트 모델 $s_\phi(s, r, o \mid \mathcal{G}_{\mathrm{train}})$을 한 번 학습해 $f_\theta$의 출력 점수를 근사한다. 온라인 단계에서는 변형한 부분 그래프를 서로게이트에 입력해, 순전파 한 번으로 점수 변화를 추정한다.
- 영향력 채점 및 다양성 재순위화: 점수는 두 가지를 계산한다. 충분성(Sufficiency)은 후보 경로 $\mathcal{X}$만으로 원래 예측 점수를 얼마나 재현하는지, 필요성(Necessity)은 전체 학습 그래프에서 $\mathcal{X}$를 제거했을 때 점수가 얼마나 떨어지는지를 나타낸다. 마지막으로 같은 중간 개체를 경유하는 중복 경로는 억제하고 서로 다른 생물학적 경로를 우선한다. 이 과정 전체가 수백만 삼중항 규모의 그래프에서도 가설 하나당 몇 초면 끝난다4.
| 구분 | 모드 / 지표 | 정의 및 수식 | 생물학적 해석 |
|---|---|---|---|
| 경로 탐색 | 코퍼스 경로 탐색 (Corpus Path) | $\mathcal{G}_{\mathrm{train}}$에 이미 기록된 관측 삼중항만으로 $k$-홉 경로 구성 | 문헌에 확립된 삼중항만으로 가설의 타당성 검증 |
| 경로 탐색 | 잠재 경로 탐색 (Latent Path) | $f_\theta(e_i, r, e_j) \ge \tau$인 미관측 고신뢰 예측 삼중항을 경로에 포함 | 아직 보고되지 않은 중간 연결고리까지 포함한 연쇄 가설 탐색 |
| 영향력 채점 | 충분성 (Sufficiency) | $\text{Suff}(\mathcal{X}) = s_\phi(s, r, o \mid \mathcal{X}) - f_\theta(s, r, o)$ | 다른 배경지식 없이 해당 경로 $\mathcal{X}$ 단독으로 가설을 정당화하는 정도 |
| 영향력 채점 | 필요성 (Necessity) | $\text{Nec}(\mathcal{X}) = f_\theta(s, r, o) - s_\phi(s, r, o \mid \mathcal{G}_{\mathrm{train}} \setminus \mathcal{X})$ | 전체 지식 그래프에서 해당 경로 $\mathcal{X}$가 제거될 때 예측 신뢰도가 손실되는 정도 |
바이오메디컬 벤치마크와 10년 장기 백테스팅
연구진은 Hakken의 실제 성능을 평가하기 위해 PMC Open Access 전문(全文), MEDLINE 제목 및 초록, 상용 라이선스 데이터베이스에서 규칙 기반 자연어 처리 파이프라인으로 추출한 바이오메디컬 데이터를 사용했다. 처음 추출한 데이터는 원시 삼중항 249,329,650개와 출판 연도 타임스탬프로 이루어졌다.
여기에 MeSH, MONDO(질병), UniProt, HGNC(유전자 및 단백질), ChEBI(화합물) 등의 표준 온톨로지를 결합하고, 바이오메디컬 전문가 패널의 검토를 거쳐 데이터를 정제했다. 중복 삼중항은 가장 이른 출판 연도만 남겼고, 아래 표의 규칙으로 극성 충돌(polarity conflict)을 해소하고 동의어 관계를 통합했다. 완성된 데이터셋은 개체 254,806개, 삼중항 7,127,960개, 관계 유형 23개, 매크로 도메인 20개로 이루어진다.
| 정제 전 상충 삼중항 (시점 포함) | 충돌 해소 규칙 | 정제 후 반영되는 삼중항 |
|---|---|---|
(A, INCREASES, B, t1) 및 (A, DECREASES, B, t4) | 반대 극성 충돌 시 두 관계를 제거하고 더 이른 시점($t_1$)에 상위 중립 관계 부여 | (A, AFFECTS, B, t1) |
(A, INCREASES_EXPRESSION_OF, B, t2) 및 (A, DECREASES_EXPRESSION_OF, B, t5) | 발현 증감 충돌 시 더 이른 시점($t_2$)의 발현 영향 관계로 통합 | (A, AFFECTS_EXPRESSION_OF, B, t2) |
(A, PREVENTS, B, t3) 및 (A, CAUSES, B, t6) | 인과 및 예방 충돌 시 더 이른 시점($t_3$)의 연관 관계로 통합 | (A, ASSOCIATED_WITH, B, t3) |
연구진은 먼저 2020년 시점 분할(temporal cut-off) 벤치마크로 단기 예측 성능을 시험했다. 2020년 이전에 처음 관측된 삼중항만으로 모델을 학습하고, 2020년 이후(2021~2023년)에 최초로 문헌에 등장한 관계를 예측하게 했다. 비교 대상은 무작위 예측(Random), 복소수 지식 그래프 임베딩(ComplEx), 최근접 이웃(KNN), 다층 퍼셉트론(MLP), 공통 이웃 및 선호적 연결 기반 규칙 분류기(RuleBased), LSTM 기반 시간 그래프 임베딩(TNodeEmbed), 텍스트 없이 시간 그래프만 사용하는 선행 모델(THiGER)까지 일곱 모델이다(아래 표의 모든 지표 단위는 %다).
| 모델 | Macro P | Macro R | Macro F1 | W P | W R | W F1 | nDCG |
|---|---|---|---|---|---|---|---|
| Random | 6.08 | 6.86 | 3.78 | 18.21 | 6.07 | 8.36 | 35.20 |
| ComplEx | 5.34 | 8.29 | 5.80 | 17.15 | 19.68 | 18.15 | 47.21 |
| KNN | 33.00 | 26.85 | 28.53 | 60.93 | 58.52 | 59.10 | 74.59 |
| MLP | 39.46 | 26.81 | 28.75 | 66.96 | 60.19 | 61.52 | 86.81 |
| RuleBased | 12.81 | 56.39 | 19.08 | 29.43 | 91.08 | 42.22 | 78.98 |
| TNodeEmbed | 40.57 | 27.41 | 29.17 | 68.94 | 62.42 | 63.47 | 87.63 |
| THiGER | 60.20 | 46.13 | 50.98 | 86.15 | 71.66 | 77.97 | 92.19 |
| THiGERLLM | 53.77 | 60.72 | 51.16 | 84.01 | 66.54 | 73.73 | 90.30 |
빈도가 높은 관계 유형에 가중치를 두는 Weighted F1과 평균 nDCG에서는 그래프만 쓰는 THiGER가 더 높았다. Weighted F1은 77.97% 대 73.73%, 평균 nDCG는 92.19% 대 90.30%다. 반면 관계 유형 23개를 모두 같은 비중으로 평가하는 Macro 지표에서는 THiGERLLM의 Macro Recall이 60.72%로 THiGER(46.13%)보다 14.59%p 높았고, Macro F1도 51.16%로 전체 모델 중 가장 높았다. 개체 쌍마다 예측 상위 $m$개($m=1, 3, 5$)만 양성으로 인정하는 고정 예산 평가(Top-$m$ evaluation)에서는 $m$이 커질수록 THiGERLLM의 우위가 뚜렷해졌다. Macro F1은 $m$이 3일 때 44.68%(THiGER 37.71%), 5일 때 38.26%(THiGER 25.95%)였다.
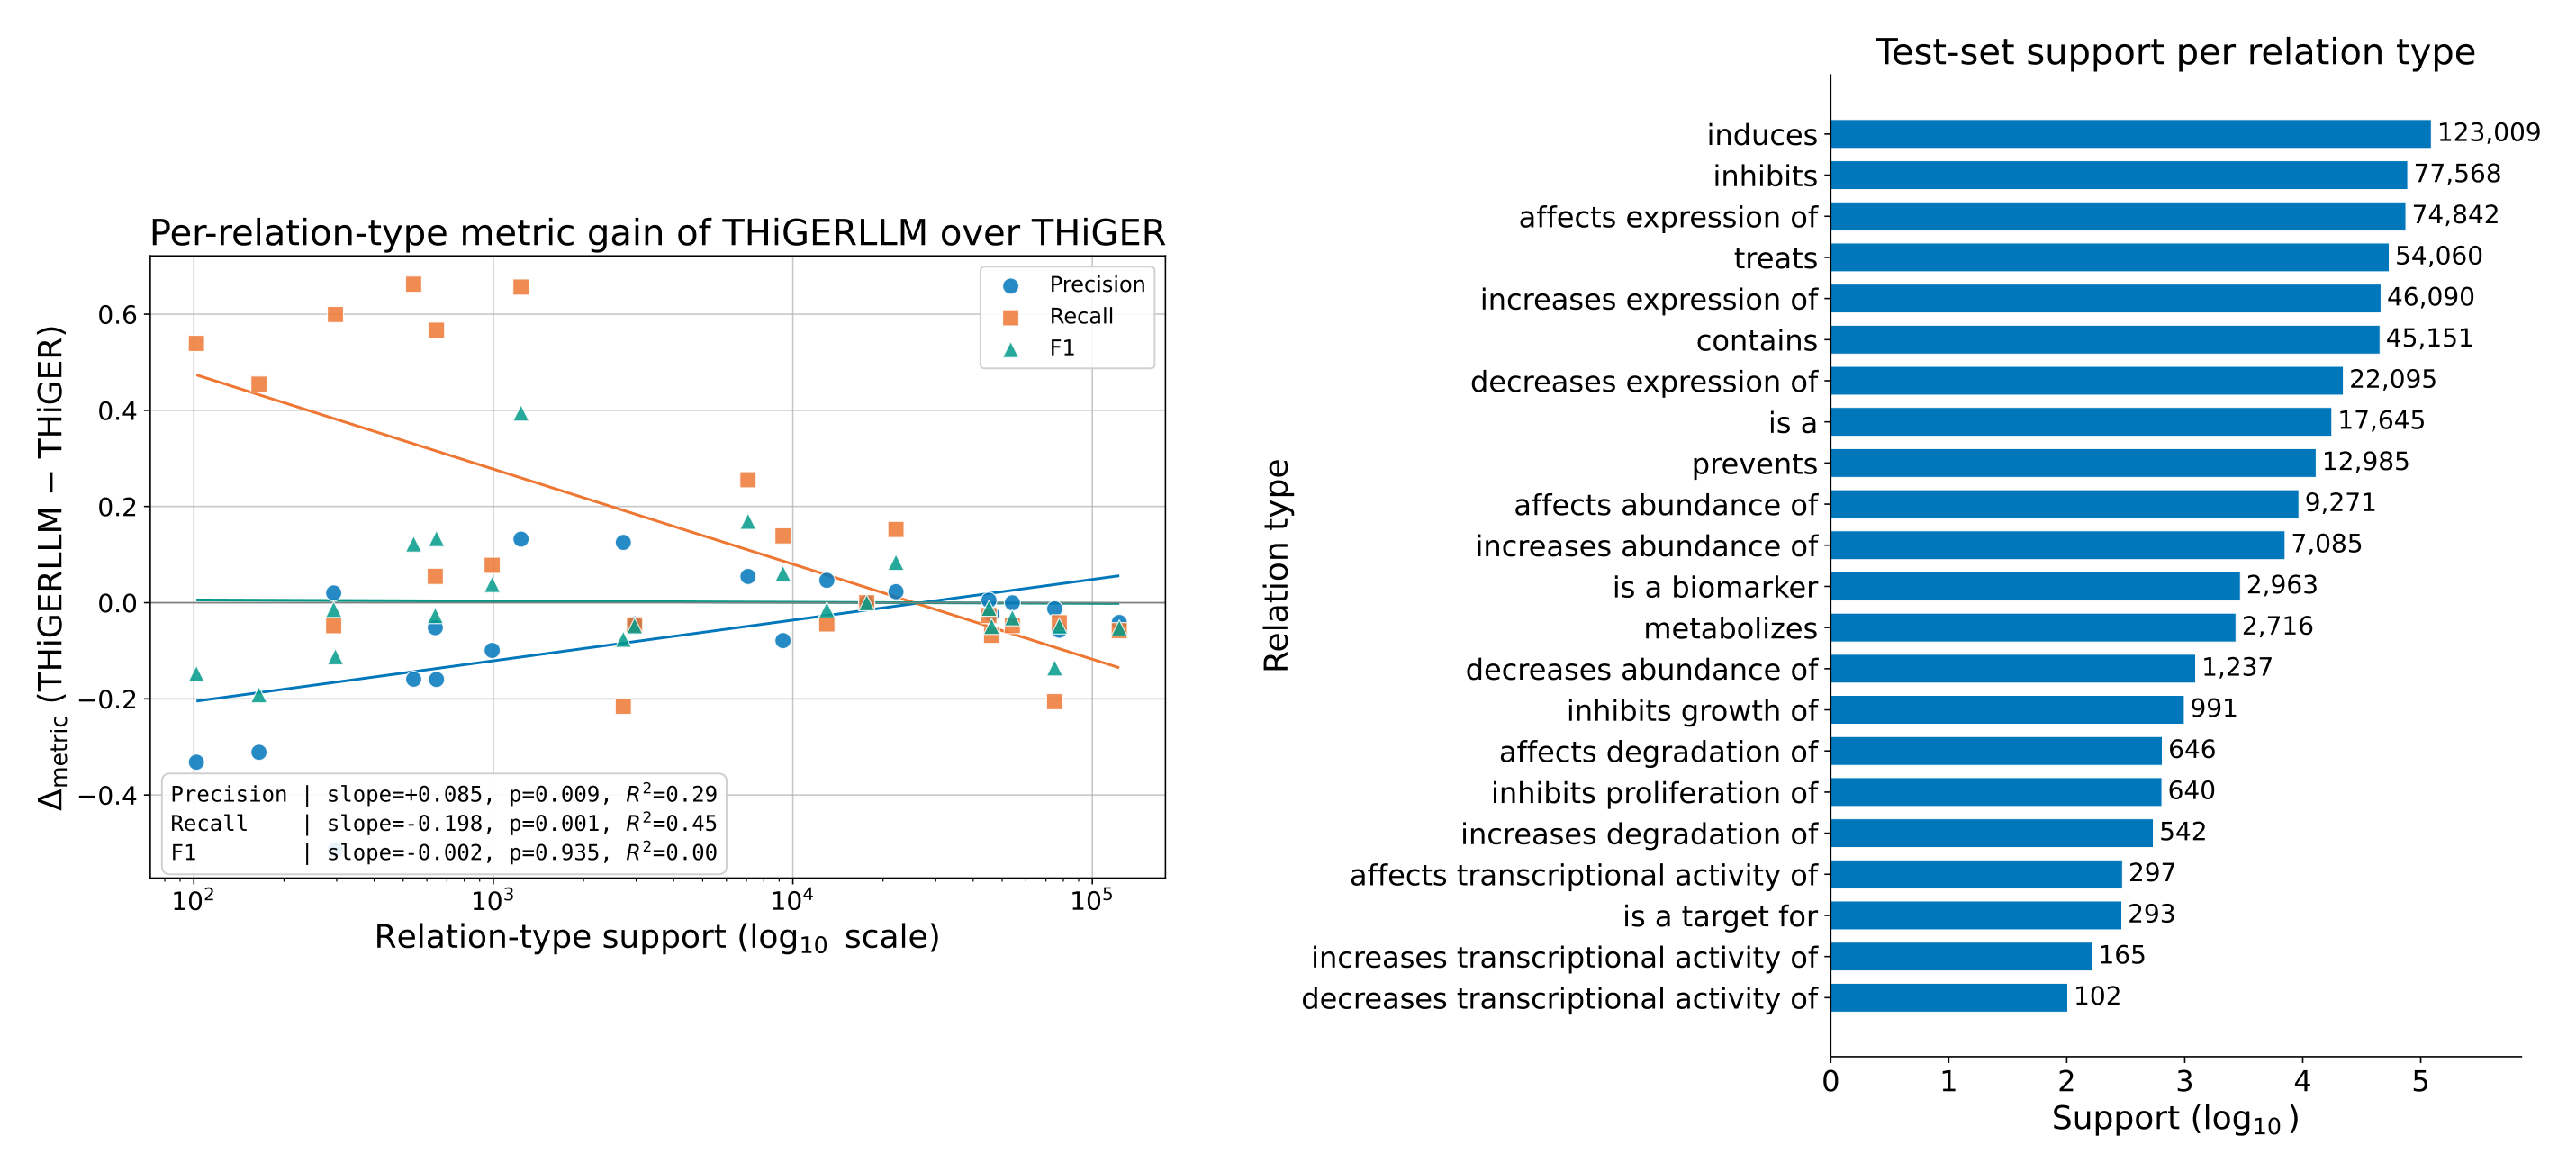 Figure 8: 좌측은 관계 유형별 테스트 데이터 빈도($\log_{10}$ 스케일)에 따른 THiGER 대비 THiGERLLM의 정밀도, 재현율, F1 차이 회귀 분석. 우측은 2020년 이후 테스트 세트의 관계 유형별 빈도 분포. 출처: arXiv:2609.04494 (arXiv non-exclusive license)
텍스트 정보를 결합하면 Macro Recall이 크게 오르는 이유는 Figure 8의 관계 유형별 빈도 회귀 분석에서 드러난다. 테스트 세트에서 induces(123,009건)나 inhibits(77,568건)는 흔한 관계다. 반면 전사 활성을 낮추는 관계(decreases transcriptional activity of, 102건)나 높이는 관계(increases transcriptional activity of, 165건)는 드물어서, 그래프에 연결이 적고 구조 신호만으로는 식별하기 어렵다. 회귀 분석 결과 관계 빈도가 낮을수록 THiGER 대비 THiGERLLM의 재현율 이득이 통계적으로 유의미하게 증가했다(기울기 $-0.198, p=0.001, R^2=0.45$). 과학적 발견에서는 흔하고 일반적인 관계보다 아직 연구가 덜 되었거나 구체적인 작용 기전을 설명하는 희귀 관계가 훨씬 가치 있다. 또한 과학 문헌 평가에서 정밀도(Precision)의 거짓 양성(false positive) 가운데 상당수는 틀린 가설이라기보다 평가 기간 내에 아직 실험되지 않은 미발견 관계일 수 있으므로, 희귀 관계의 재현율 향상은 실질적인 발견 능력과 직결된다.
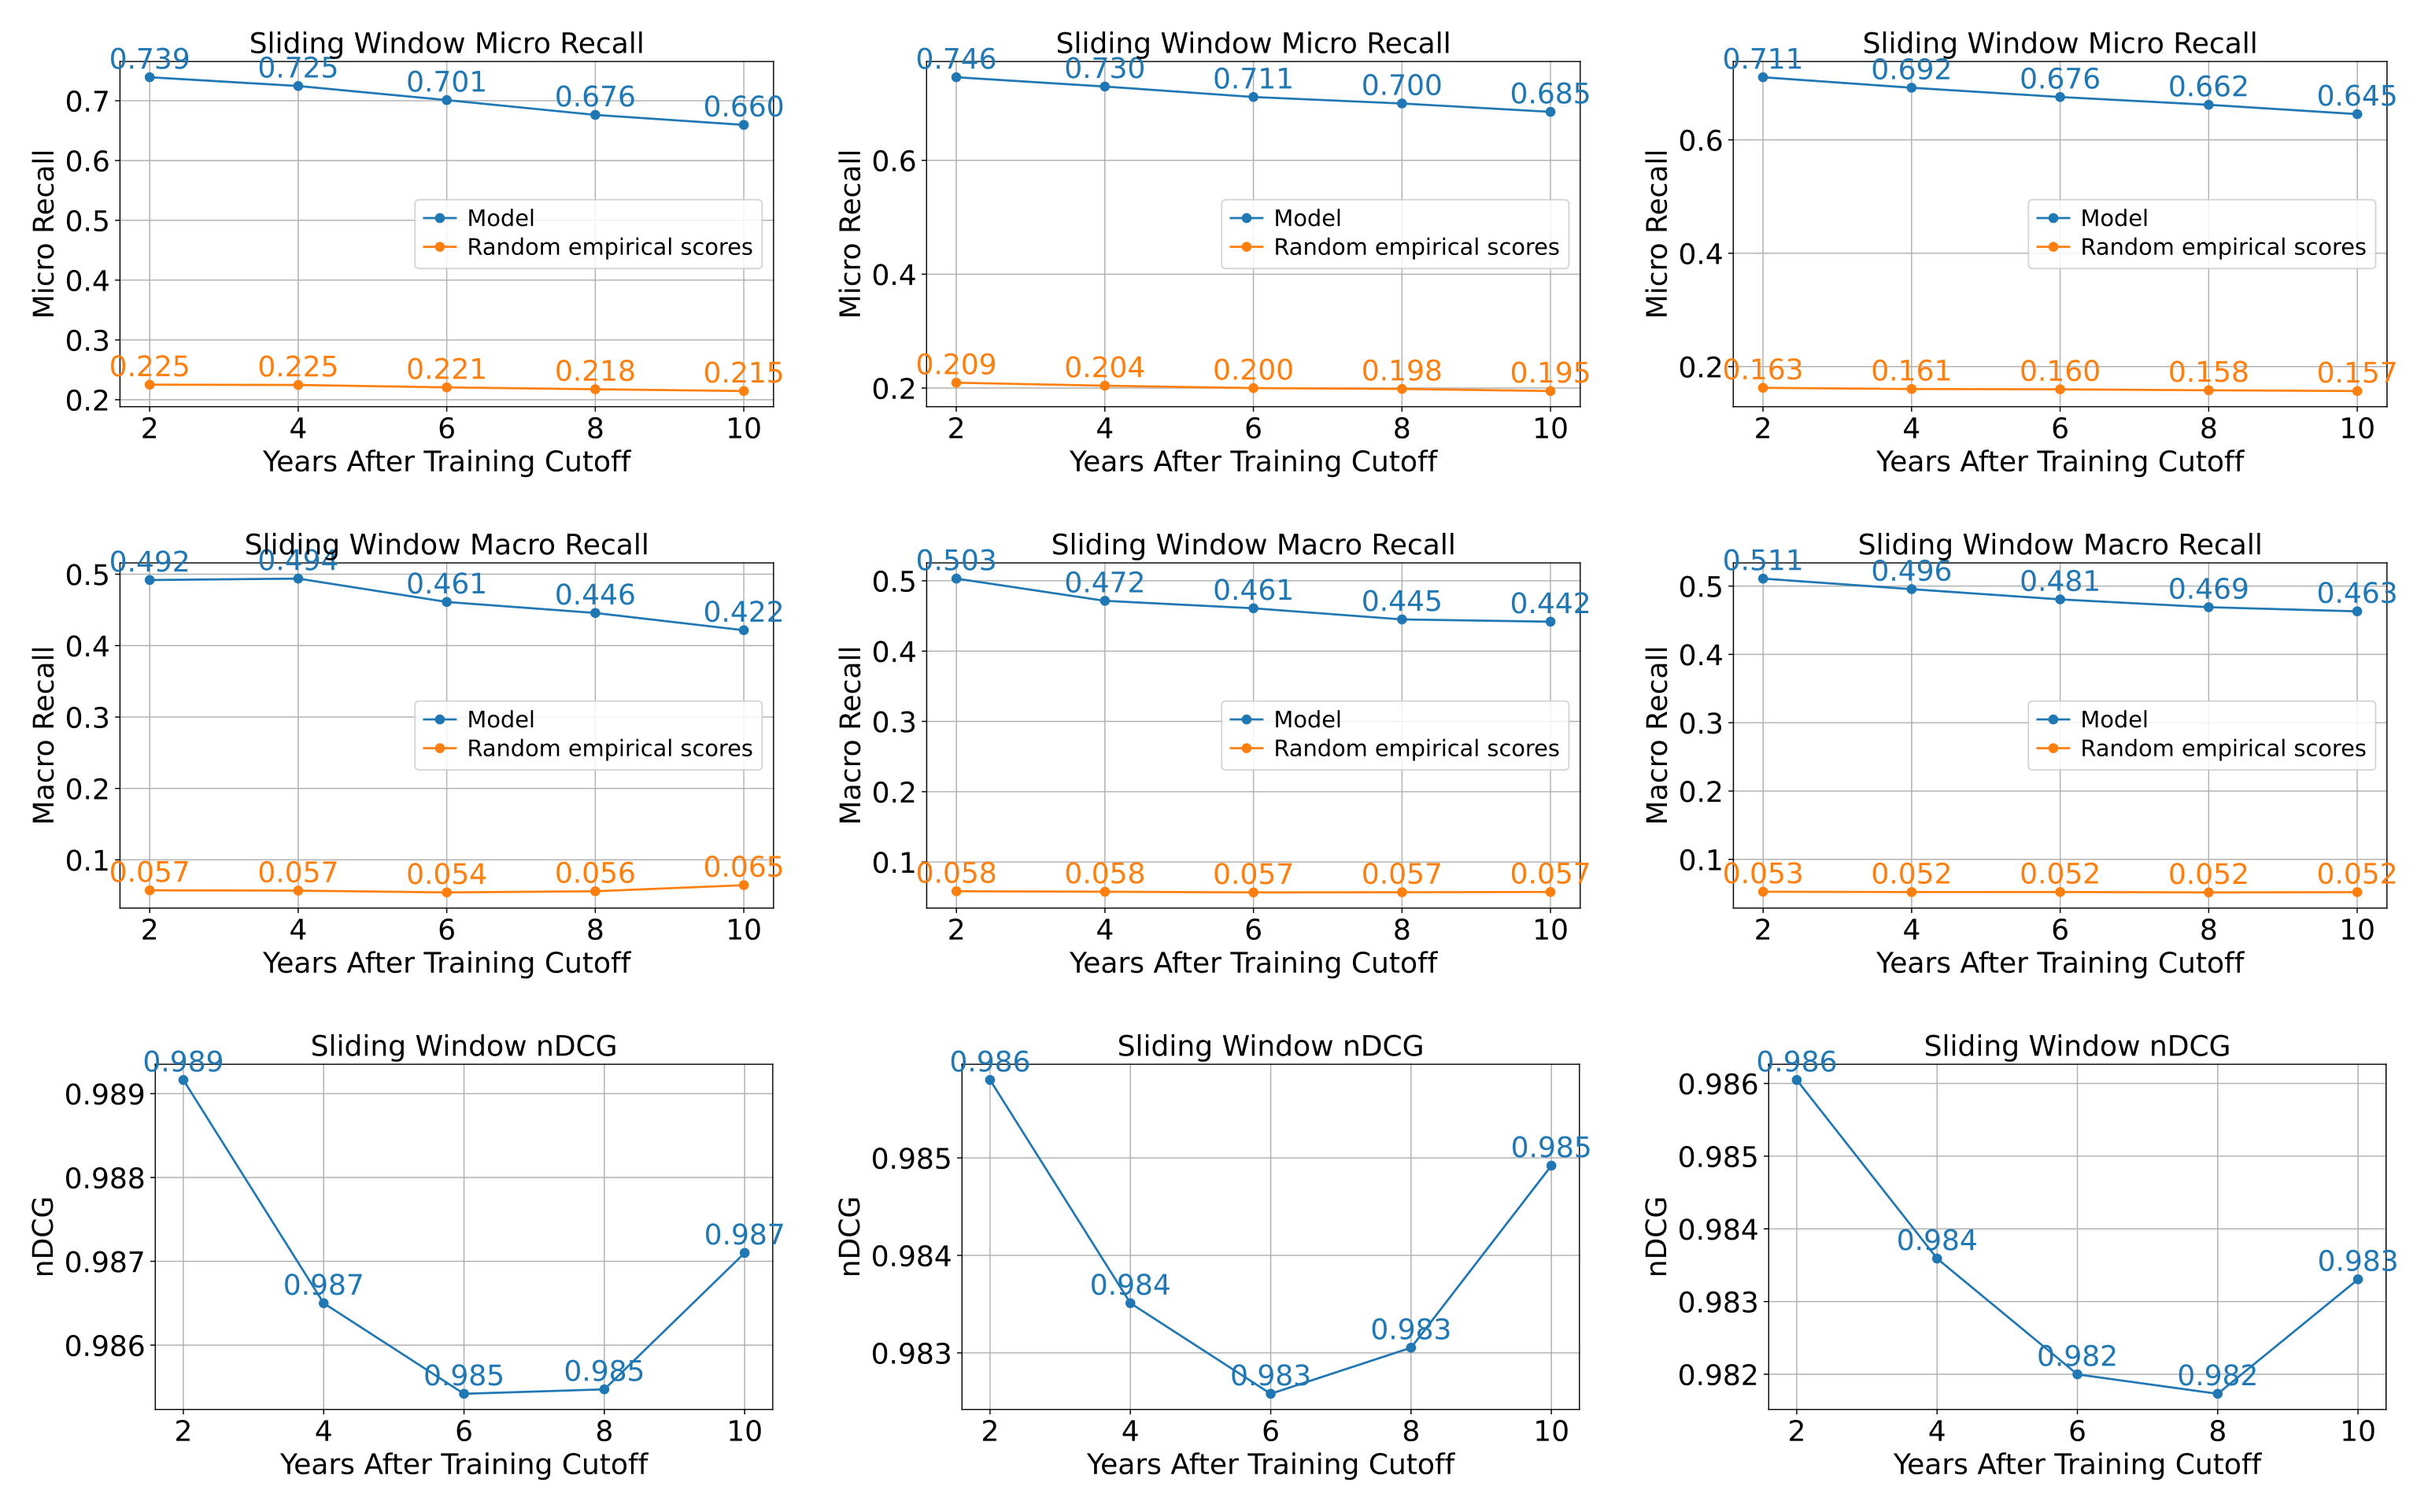 Figure 3: 1990년(왼쪽), 2000년(가운데), 2010년(오른쪽) 시점까지의 데이터로 학습한 THiGERLLM의 향후 10년간 2년 단위 구간별 Micro Recall(윗줄), Macro Recall(가운데 줄), Mean nDCG(아랫줄) 추이. 주황색 선은 동일한 점수 분포에서 무작위로 점수를 배정한 무작위 기준선(null baseline)이다. 출처: arXiv:2609.04494 (arXiv non-exclusive license)
이어 연구진은 모델이 예측한 가설이 시간이 흘러도 유효한지 검증하기 위해 역사적 장기 백테스팅(historic back-testing)을 수행했다. 학습 컷오프를 각각 1990년, 2000년, 2010년으로 설정한 뒤, 각 시점 이후 10년의 미래를 겹치지 않는 2년 단위 구간 $(t_k, t_k+2], (t_k+2, t_k+4], \dots, (t_k+8, t_k+10]$으로 구분해 각 구간에 처음 출현한 실제 발견들을 모델이 얼마나 미리 맞혔는지(구간별 Recall과 평균 nDCG) 추적했다.
| 평가 지표 (1990 / 2000 / 2010 컷오프) | 초기 2년 구간 $(t_k, t_k+2]$ | 10년차 구간 $(t_k+8, t_k+10]$ | 무작위 기준선 (Null Baseline) |
|---|---|---|---|
| Micro Recall | 0.720 ~ 0.755 | 0.645 ~ 0.685 | 0.160 ~ 0.220 |
| Macro Recall | 0.500 ~ 0.545 | 0.422 ~ 0.463 | 0.050 ~ 0.060 |
| Mean nDCG | 0.984 ~ 0.989 | 0.982 ~ 0.988 | - |
Figure 3과 요약 표에서는 세 가지 결과가 확인된다. 첫째, 예측 시점으로부터 10년이 지난 구간에서도 Micro Recall은 0.645~0.685, Macro Recall은 0.422~0.463을 기록해, 초기 2년 구간 대비 Macro Recall 감소 폭이 약 0.08(8%p)에 그쳤다. 모델의 출력 점수 분포는 그대로 두고 입력과 출력을 무작위로 섞어 만든 무작위 기준선과 비교하면, 10년 뒤에도 예측 신호가 뚜렷하다. 둘째, 1990년, 2000년, 2010년이라는 서로 다른 역사적 시점에서 학습했음에도 향후 10년에 걸친 예측력 감쇠 곡선(decay profile)의 기울기와 형태가 세 시기 모두 거의 동일하게 나타났다. 과학 지식의 총량이 늘고 그래프 밀도가 높아져도, 단기 발견과 장기 발견을 예측하는 난이도의 구조가 시대와 관계없이 일정함을 보여준다. 셋째, 가설의 우선순위를 평가하는 평균 nDCG는 세 시점, 모든 미래 구간에서 0.982~0.989였다. 시간이 지나도 모델이 가장 유망하다고 꼽은 상위 가설들의 상대적 순위가 바뀌지 않는다는 점을 입증하는 수치다.
인간 세포주 실험(Wet-lab)으로 확인한 새 생물학적 발견
연구진은 벤치마크 검증에 그치지 않고, 실제 생명과학 연구자들, 그리고 독립 임상시험수탁기관(CRO)인 Pharmagene Discovery Services와 함께 가설 생성부터 세포 실험 검증까지 전 과정을 진행하며 공동 연구진의 전문 분야인 노화(aging) 관련 유전학을 탐색 주제로 삼았다.
먼저 전문가들이 노화 관련 시드 유전자와 개체 1,386개를 골랐다. 순서를 따지지 않은 쌍으로는 959,805개다. 이 쌍마다 THiGERLLM으로 가능한 모든 관계를 예측해, 신뢰도가 기준치 이상인 가설 1,543,297건을 얻었다. 이어 기존 지식 그래프에 이미 기록된 관계를 제거해 순수 신규 가설 1,524,046건을 추렸다. 연결성이 높은 허브 유전자가 결과를 독점하지 않도록 개체당 신뢰도 상위 3개 예측만 남기는 필터링(Top-3 entity filtering)을 적용해, 후보를 2,804건까지 줄였다5.
| 필터링 단계 | 대상 및 조건 | 남은 가설(삼중항) 수 |
|---|---|---|
| 1. 시드 개체 쌍 구성 | 노화 관련 전문가 선정 시드 개체 1,386개 (순서 없는 쌍 959,805개) | - |
| 2. 전체 고신뢰 예측 | THiGERLLM 예측 신뢰도 기준치 통과 삼중항 전체 | 1,543,297건 |
| 3. 기존 삼중항 제거 | 기존 학습 지식 그래프 $\mathcal{G}_{\mathrm{train}}$에 이미 존재하는 삼중항 제외 | 1,524,046건 |
| 4. 허브 독점 방지 필터링 | 개체별 신뢰도 상위 3개 예측만 유지 (Top-3 per entity) | 2,804건 |
| 5. 전문가 및 PHELInE 검토 | 신뢰도 $\ge 0.8$, PHELInE 다중 홉 경로 타당성 및 실험 가능성 심층 평가 | 최종 3건 |
생물학 전문가들은 후보 2,804건과 PHELInE이 생성한 설명 경로, 각 개체의 연구 활성도(논문 출판 연도 중앙값 2011~2021년), 그리고 신뢰도 점수(0.8 이상)를 종합 검토해 실험실 검증을 진행할 최종 가설 세 건을 선정했다.
| 대상 쌍 | 예측된 관계 유형 | 신뢰도 | 검증 세포주 | 실험 결과 |
|---|---|---|---|---|
| TP53 → BAMBI | 발현에 영향 | 0.85391 | HepG2 (인간 간암) | 지지됨 |
| RAF1 → TNF | 발현 감소 및 조절 | 0.83114 | THP-1 (급성 단핵구 백혈병) | 지지됨 |
| SOAT1 → STAT3 | 전사 활성에 영향 | 0.84183 | HepG2 (인간 간암) | 기각됨 |
첫 번째로 검증된 가설은 TP53이 BAMBI의 발현에 영향을 미친다는 예측이다(신뢰도 0.85391). TP53은 인간 암에서 변이가 가장 흔한 종양 억제 유전자이고, BAMBI는 TGF-$\beta$ 신호전달의 비신호성 유사수용체(pseudoreceptor)다. 연구진은 인간 간세포암종 세포주 HepG2에 MDM2 억제제인 저분자 화합물 Nutlin-3를 0.01~10 $\mu$M 농도로 처리해 P53 단백질 수준을 인위적으로 높이고, RT-qPCR로 BAMBI mRNA 발현량을 측정했다. 양성 대조군에는 TGF-$\beta$1 10 ng/mL를 썼다.
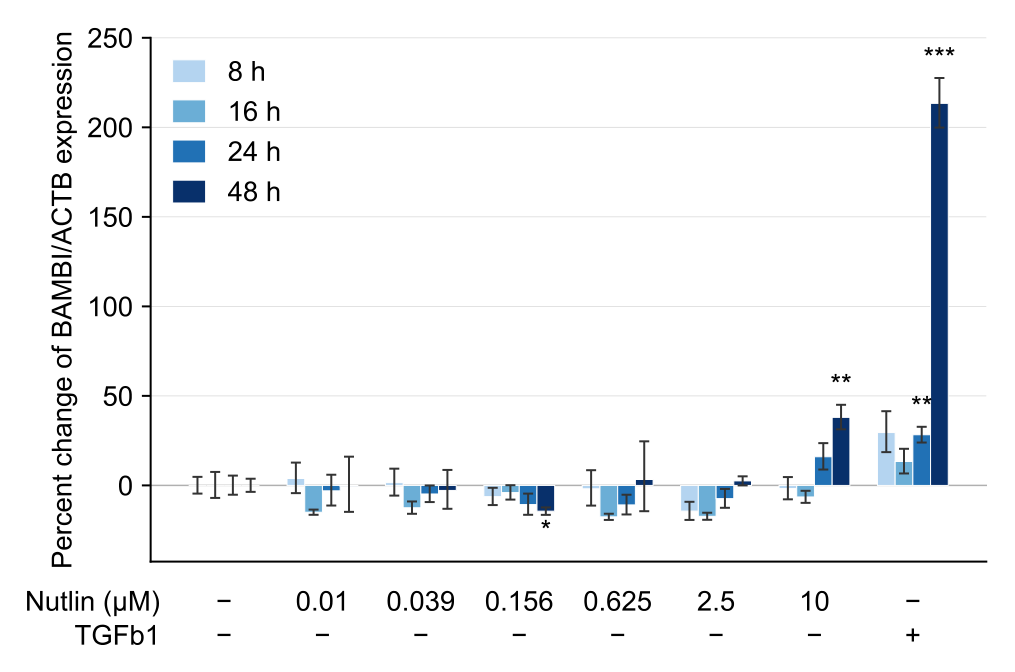 Figure 14: 확증 실험(confirmatory assay)에서 Nutlin-3 농도 및 시간 경과(8, 16, 24, 48시간)에 따른 HepG2 세포의 BAMBI/ACTB 발현 변화율(%). 출처: arXiv:2609.04494 (arXiv non-exclusive license)
24시간 한 시점만 본 1차 실험에서는 10 $\mu$M Nutlin-3를 처리하자 P53 단백질이 8.7배 늘었고, BAMBI 발현은 세 가지 세포 밀도 조건에서 대조군보다 각각 33%, 17%, 23% 높아졌다. 8, 16, 24, 48시간에 걸쳐 진행한 2차 확증 실험(Figure 14)에서는 10 $\mu$M Nutlin-3가 P53 단백질을 최대 11배까지 늘렸고, BAMBI 발현은 24시간에 16%, 48시간에 38% 유의미하게 증가했다. 반면 0.156~2.5 $\mu$M의 낮은 농도에서는 BAMBI 발현이 최대 18% 줄어 농도와 맥락에 따라 조절 양상이 달라졌다. 이로써 기존 문헌에 보고된 적 없던 TP53과 BAMBI 사이의 기능적 조절 관계가 실험으로 입증되었으며, TP53이 결손된 암세포가 BAMBI와 TGF-$\beta$ 경로를 통해 종양 진행이나 섬유화, 전이를 어떻게 조절하는지 밝힐 새 단서도 확보되었다.
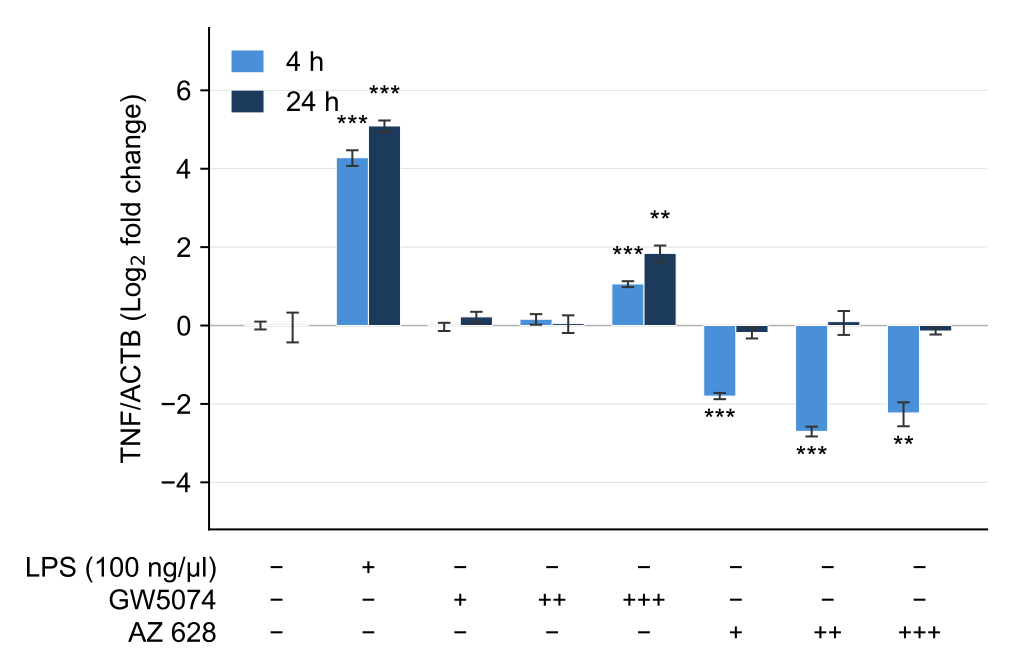 Figure 11: RAF1 억제제 GW5074 및 AZ 628 처리 후 4시간 및 24시간 시점의 THP-1 세포 내 TNF/ACTB 발현 변화($\log_2$ fold change). 출처: arXiv:2609.04494 (arXiv non-exclusive license)
두 번째로 입증된 가설은 MAPK 신호전달 경로의 핵심 효소인 RAF1이 염증성 사이토카인 TNF의 발현을 조절한다는 예측이다(신뢰도 0.83114). 연구진은 급성 단핵구 백혈병 세포주(THP-1)에 선택적 RAF1 억제제인 GW5074와 범-RAF(pan-RAF) 억제제인 AZ 628을 처리해 실험을 진행했다. 2차 확증 실험에서는 또 다른 선택적 RAF1 억제제 ZM336372도 함께 사용했다.
1차 실험(Figure 11)과 2차 확증 실험 모두에서 GW5074를 1,000 nM 농도로 처리하자 TNF mRNA 발현이 유의미하게 늘었다6. $\log_2$ 배율 변화는 1차 실험에서 4시간 1.1, 24시간 1.8이었고, 2차 실험에서는 24시간에 0.9였다. 모세관 전기영동 면역분석(Jess Simple Western)으로 하위 신호인 ERK1/2 인산화(pERK1/2)를 측정한 결과, GW5074(1,000 nM)와 ZM336372 처리 시 역으로 pERK1/2 단백질 수준이 뚜렷하게 증가했다. 이 결과는 RAF1 억제제가 표적에 결합할 때 도리어 RAF1의 이량체화(dimerization)와 교차활성화(transactivation)를 촉진해 하위 MEK/ERK 경로를 활성화하는 역설적 ERK 활성화(paradoxical ERK activation) 현상과 정확히 부합한다. 정상 상태에서는 RAF1 활성이 TNF 발현을 억제하거나 조절하고, 억제제가 경로를 역설적으로 변조하면 TNF 전사도 달라진다는 기능적 연결고리를 확인한 결과다.
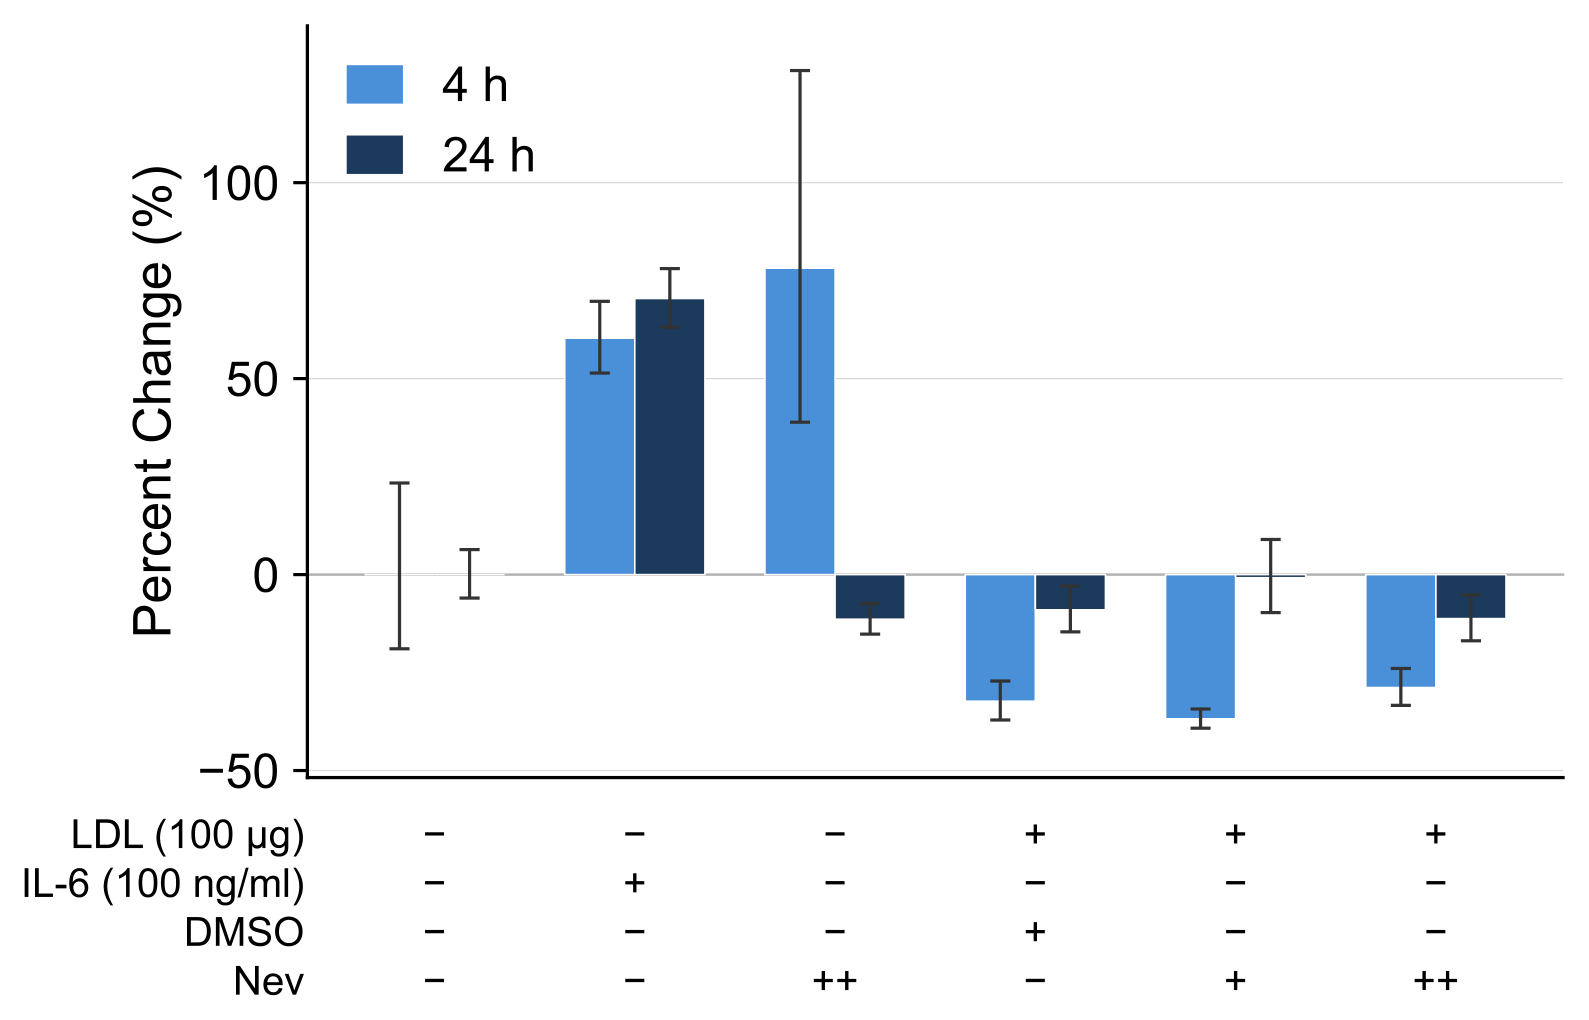 Figure 10: LDL, IL-6(양성 대조군), SOAT1 억제제 Nevanimibe(Nev) 처리 후 4시간 및 24시간 시점의 HepG2 세포 내 STAT3 mRNA 발현 변화율(%). 출처: arXiv:2609.04494 (arXiv non-exclusive license)
반면 세 번째 가설이었던 지질 대사 효소 SOAT1과 전사인자 STAT3 사이의 관계(신뢰도 0.84183)는 기각되었다. 연구진은 HepG2 세포에 저밀도 지단백질(LDL)을 처리해 SOAT1을 활성화했고, 내부 대조군인 콜레스테롤 에스테르(CE)가 약 2배 늘어난 것까지 확인했다. SOAT1 억제제 nevanimibe를 처리하자 이 증가가 최대 50% 억제됐다. 그러나 양성 대조군(IL-6 자극)과 달리 LDL 처리 조건에서는 STAT3 단백질 인산화(pSTAT3)의 피크도, STAT3 mRNA 발현 증가도 관찰되지 않았다(Figure 10). 이로써 실험실 검증에 올린 미보고 가설 세 건 가운데 두 건에서 실제 인간 세포주 내 조절 반응이 확인되었다.
신약 개발 워크플로우와 과학 AI 생태계의 결합
연구진은 일선 과학자들이 일상 연구에서 Hakken을 쓸 수 있도록 그래픽 사용자 인터페이스(GUI)를 만들고, PubTator3 기반 버전을 학계와 산업계 7개 기관의 바이오메디컬 연구자들에게 제공해 정성 평가를 진행했다. 연구자들은 GUI를 통해 특정 유전자나 질병에 관한 Hakken의 예측 가설을 검색하거나 자신이 세운 가설의 신뢰도 점수를 조회할 수 있으며, 최근 문헌(인기 주제) 또는 오래된 문헌(초기 연구 분야) 가중치와 선호하는 그래프 경로 길이를 직접 조정할 수 있다. 사용자 피드백은 대부분 예측 점수와 함께 제시되는 PHELInE의 다중 홉 설명 경로가 가설의 타당성을 판단하는 데 큰 도움이 된다는 내용이었다.
또한 연구진은 전임상 신약 개발(preclinical drug discovery) 단계에서 Hakken의 보정 신뢰도 점수를 일종의 지식 점수(knowledge score)로 활용하는 방안을 제시했다. 신약 후보 물질을 선별할 때 약물동태학 및 독성을 평가하는 ADMET 점수와 함께, 해당 후보 물질과 표적 질병 사이의 관계가 기존 과학 문헌의 구조와 의미 증거로부터 얼마나 강하게 지지되는지를 정량화해 초기 단계의 실패 위험을 줄이는 방식이다. 아울러 바이오메디컬 외에 19세기 원예학 문헌을 활용한 친환경 집약 농업 아이디어 도출과 재료과학의 신규 화학 관계 예측 프로토타입도 함께 시험해 도메인 범용성을 확인했다7.
끝으로 논문은 Hakken이 거대 언어 모델 기반 과학 시스템과 경쟁하기보다 서로 보완하는 생태계를 이룰 것으로 전망한다. Google의 Gemini 2.0 기반 멀티에이전트 시스템인 AI Co-Scientist, 그리고 The AI Scientist, HypoGeniC, ResearchAgent 같은 시스템들이다. LLM 에이전트 시스템은 웹 규모의 이질적인 데이터로 막대한 연산 자원을 들여 학습하는 반면, Hakken은 동료 심사를 거친 정제된 학술 문헌으로 가볍게 학습한다. 이런 Hakken이 구조화된 예측 지식과 설명 경로, 보정된 신뢰도 점수를 에이전트에 제공하면, 기존 문헌의 연역적 한계를 극복하면서 고질적인 환각(hallucination)과 부정확성도 억제할 수 있다는 구상이다.
| 비교 항목 | 거대 LLM 기반 과학 에이전트 (AI Co-Scientist 등) | Hakken (THiGERLLM + PHELInE) |
|---|---|---|
| 주요 학습 데이터 | 웹 스케일의 비정형 다중 도메인 코퍼스 | 동료 심사를 거친 학술 문헌에서 정제한 시계열 지식 그래프 및 본문 |
| 출력과 추론 성격 | 자연어 기반의 자유로운 가설 서술 및 연구 계획 생성 | 정규화된 삼중항 $(s, r, o)$, 보정 신뢰도 확률, 다중 홉 근거 경로 |
| 연산 자원 요구량 | 대규모 클러스터에서 수 주~수 개월 학습, 고비용 추론 | H100 서버 2대로 수일 내 학습 완료, 범용 하드웨어에서 추론 가능 |
| 상호보완 역할 | 광범위한 문맥 통합 및 실험 프로토콜 초안 작성 | 환각 억제용 구조화 사전 지식(prior) 및 정량적 지식 점수 공급 |
가장 흥미로운 지점
THiGERLLM은 언어 모델에 논문 문장을 입력할 때 두 개체가 함께 나오는 문장을 일부러 빼고, 각 개체가 따로 언급된 문장만 20개씩 뽑아 넣는다. 과학 분야에 LLM을 적용하는 대다수 연구가 관련 초록을 최대한 많이 검색해 컨텍스트에 넣고(RAG) 그 문맥에서 단서를 조합하게 만드는 방식과 정반대다. 두 개체가 이미 같은 문맥에 나온다면, 그 문장을 읽고 관계를 추출하는 작업은 기존 문헌을 요약하거나 독해하는 일이기 때문이다. 연구진은 거시적인 연결 구조와 시간에 따른 축적 패턴을 그래프 신경망과 계층적 시간 트랜스포머에 맡겼다. 언어 모델에는 각 개체의 독립적인 생물학적 성질만 텍스트로 주고, 두 신호를 결합해 아직 문헌에 기록되지 않은 연결고리를 추론하게 만들었다. Figure 8에서 확인되듯 이 결합의 이득은 데이터가 풍부한 흔한 관계보다 그래프 연결이 부족한 희귀 관계(long-tail)의 재현율에서 집중적으로 나타났다. 그래프는 축적된 구조와 시간을 파악하고, 언어 모델은 연결이 희소한 관계의 의미 정보를 보완한다.
1990년, 2000년, 2010년까지의 지식 그래프로 각각 학습해 이후 10년을 예측한 백테스팅(Figure 3)에서는 세 시점의 예측력 감쇠 곡선이 거의 일치했다. 1990년과 2010년 사이에 생명과학 논문의 수와 실험 분석 기술은 비교할 수 없을 만큼 달라졌다. 그럼에도 특정 시점의 지식으로 2년 뒤, 6년 뒤, 10년 뒤의 발견을 예측하는 상대적 난이도는 시대와 관계없이 일정했고, 가설 순위의 안정성도 평균 nDCG 0.98 이상으로 동일했다. 과학 지식의 총량이 아무리 늘어나도, 기존 문헌 네트워크의 구조가 다음 시기에 검증될 발견 후보들을 어느 시대나 일정한 비율과 우선순위로 제약하기 때문이다.
출처
- 논문: Tarek R. Besold, Uchenna Akujuobi, Pablo Sanchez, Alessandra Toniato, Kana Maruyama, Jihun Choi, Samy Badreddine, Frederick Gifford, Daniel Evans-Yamamoto, Sucheendra K. Palaniappan, Miquel Ferrer, Kae Nagano, Iris Rossell, Tom Joy, Hatem ElShazly, Chrysa Iliopoulou, Christoph Wehner, Thiviyan Thanapalasingam, Susana Nunes, Pedro G. Cotovio, Peter Wurman, Peter Stone, Hiroaki Kitano, Michael Spranger (SonyAI, The Systems Biology Institute, OIST), “Hakken: Predicting future discoveries to fill the gaps in today’s knowledge”, arXiv:2609.04494v1, 2026-09-03.
- 원문: https://arxiv.org/abs/2609.04494 (PDF: https://arxiv.org/pdf/2609.04494)
- 오픈소스 저장소: https://github.com/SonyResearch/HakkenOSS
- 치비 서소영 삽화 두 장은 「느낌적인 느낌을 숫자로 옮기는 일」의 라인아트를 참조해 gpt-image-2.5-flare로 생성했다.
오픈소스 코드는 GitHub 저장소(https://github.com/SonyResearch/HakkenOSS)에 공개되어 있다. 상용 라이선스 데이터가 포함된 본 실험 모델과 달리, HakkenOSS는 공개 접근이 허용된 PubTator3 데이터셋만을 사용해 학습되었다. ↩︎
계층적 시간 트랜스포머에서 인접한 두 시점을 확정적으로 합산하면, 직전 어텐션 레이어가 전체 시계열 문맥을 참조하는 대신 곧 합쳐질 짝(pairmate) 토큰끼리만 어텐션을 집중해 손실을 줄이려는 퇴행적 지름길(degenerate pre-merge shortcut)이 발생하기 쉽다. 연구진은 이를 막으려고 짝 마스킹(pairmate masking)을 도입했다. 합산될 두 토큰 $(2k-1, 2k)$ 사이의 교차 어텐션 가중치에만 $-\infty$에 준하는 음수 편향($-\beta$)을 더해, 각 토큰이 반드시 다른 시간대의 토큰에서 문맥 정보를 참조하도록 강제하는 방식이다. ↩︎
연구진은 기준 연도 이전 문헌만 샘플링해 시간적 정보 누출(temporal leakage)을 통제했으나, Mistral-7B-Instruct-v0.3 자체가 광범위한 코퍼스로 사전학습되었으므로 가중치에 포함된 미세한 누출 가능성까지 완전히 배제할 수는 없다고 명시했다. ↩︎
연구진은 PHELInE의 한계로 두 가지를 명시했다. 첫째, 설명의 충실도(fidelity)가 그래프를 섭동했을 때 원래 예측 모델의 동작을 서로게이트 모델(GraphSAGE)이 얼마나 정확하게 근사하느냐에 좌우된다. 둘째, 충분성과 필요성 점수는 모델 예측값에 대한 통계적 영향력을 측정할 뿐 엄밀한 인과적(causal) 영향력을 직접 증명하지는 않으므로, 향후 인과 추론 및 불확실성 추정 기법을 결합할 필요가 있다. ↩︎
최종 후보군 2,804건에서 두 개체 사이의 최단 경로 길이(shortest path length)를 기존 지식 그래프로 세어 보면, 3홉이 104건, 4홉이 2,068건, 5홉이 631건, 6홉이 1건이었다. 유망 가설 대부분은 최단 경로가 4~5홉인 관계라, 연구자가 문헌 검색만으로 직관적으로 유추하기 어렵다. ↩︎
한편 배양 상층액에서 분비된 TNF 단백질 농도를 측정했을 때는 양성 대조군(LPS 100 ng/mL 처리)이 658 pg/mL였지만, RAF1 억제제 처리군은 모두 정량 한계(15.6 pg/mL) 미만으로 나타나 전사(mRNA) 수준의 변화가 분비 단백질 수준까지 이어지려면 추가적인 자극이나 조건이 필요할 수 있음을 시사했다. ↩︎
연구진은 향후 Hakken의 표현력을 확장하기 위한 과제로 네 가지를 제시했다. 첫째, 개념 간 관계 유무에 더해 성립 조건이나 정량적 비율(quantity ratios)까지 지식 그래프와 예측에 반영하는 것. 둘째, 삼중항의 최초 등장 시점과 더불어 지지하는 논문 수, 최근 관측 연도, 시간별 등장 빈도 등 증거 메타데이터를 추가하는 것. 셋째, 특정 관계가 미래의 어느 시점에 발견될지, 그리고 그 발견이 후속 연구에 미칠 파급력(예: 후속 발견 수)이 얼마일지 예측하는 것. 넷째, 예측된 가설을 검증하기 위한 실험 설계(experimental design)까지 함께 생성하는 과제다. ↩︎