3줄 요약
- 구글이 2026년 9월 23일 텍스트를 음성으로 바꾸는 TTS 모델 두 종을 공개했다. Gemini 3.8 Flash TTS는 창작용 모델로, 목소리를 새로 설계하고 대사 한 줄마다 연기를 지시할 수 있다. Gemini 3.8 Flash-Lite TTS는 단가를 낮춘 모델로, 더빙과 음성 에이전트처럼 음성을 대량으로 만드는 작업에 쓴다.
- 3.8 Flash TTS는 자연어 설명만으로 목소리를 새로 만들고, 30초 이내의 녹음으로 목소리를 복제하며, 두 사람의 대화를 대본 하나로 생성한다. 구글은 Hume AI의 음성 디자인 벤치마크에서 3.8 Flash TTS가 71.4점으로 1위를 기록했다고 밝혔다.
- 오디오 출력 단가는 100만 토큰당 3.8 Flash TTS가 9달러, Flash-Lite TTS가 6달러로, 이전 세대인 3.1 Flash TTS의 20달러보다 훨씬 싸다. 이 가격은 2026년 12월 31일까지만 적용되고 2027년부터 두 배로 오르지만, 오른 뒤에도 3.1 Flash TTS보다는 싸다.
두 가지 모델
발표문은 두 모델의 용도를 이렇게 소개했다.
Gemini 3.8 Flash TTS: Built for deep creative direction and character design.
Gemini 3.8 Flash-Lite TTS: Built for high-volume, cost-efficient scale.
3.8 Flash TTS는 게임과 오디오북, 팟캐스트, 인터랙티브 미디어에 쓸 캐릭터 목소리를 만드는 용도로 설계됐다. 사용자는 자연어 프롬프트로 목소리를 새로 만들고, 연기 지시와 말의 빠르기, 방언 전환, 맞장구를 대사 단위로 조절할 수 있다. Flash-Lite TTS는 대량 더빙과 오디오 콘텐츠 제작, 음성 에이전트를 위한 모델이다. Flash-Lite TTS도 어조와 빠르기, 미묘한 감정 표현을 조절할 수 있다.
API 문서는 두 모델의 관계를 더 분명하게 설명한다. 두 모델은 API 스키마와 프롬프트 형식이 같아서 모델 이름만 바꾸면 서로 교체할 수 있다. 문서는 Flash-Lite TTS를 gemini-3.1-flash-tts-preview를 대체하는 주력 모델로 소개한다. 3.8 Flash TTS는 스튜디오 수준의 창작 작업과 복잡한 2인 대화에 쓰고, 지역 방언이나 소수 방언, 긴 내레이션에도 쓰라고 권한다.1
모델 카드는 두 TTS 모델을 먼저 공개된 3.8 Live와 3.8 Live Extended Thinking과 함께 “Gemini 3.8 Audio"라는 이름으로 통칭한다. 네 모델은 모두 Gemini 3 Pro에 기반한다고 적혀 있다.
목소리를 고르고 만드는 기능
발표문은 30종이던 프리셋 음성을 무한한 음성 라이브러리로 확장했다고 했다. 3.8 Flash TTS가 제공하는 기능은 다음과 같다.
| 기능 | 내용 |
|---|---|
| 음성 디자인 | 역할과 억양, 목소리 특성을 자연어로 설명해 목소리를 새로 만든다. 100개 이상의 언어와 방언에서 쓸 수 있다. |
| 음성 라이브러리 | 바로 쓸 수 있는 음성 2,000종 이상을 제공한다. 멕시코 스페인어, 퀘벡 프랑스어, 스코틀랜드 영어 같은 지역 변종도 포함된다.2 |
| 음성 복제 | 본인 목소리나 사용 권리를 가진 목소리를 30초 이내의 녹음으로 재현한다. |
| 저장 | 직접 만든 목소리를 저장해 두고, 여러 프로젝트에서 같은 목소리를 일관되게 쓸 수 있다. |
| 음성 리믹스 (출시 예정) | 라이브러리의 목소리를 골라 음색과 음높이, 빠르기, 억양을 프롬프트로 조정한다. “add subtle Southern US accent"나 “soften the delivery” 같은 식이다. |
발표문은 음성 디자인의 예시로 멜버른 출신의 활기찬 DJ, 쇳소리가 나는 단조로운 로봇, 일본의 용을 들었다.
API 문서에는 세부 조건이 적혀 있다.
- 음성 복제에는 같은 성인 화자의 녹음 두 개가 필요하다. 첫 번째는 참조 음성으로, 복제할 목소리를 10초에서 30초 길이로 녹음한 파일이다. 두 번째는 동의 음성으로, 그 화자가 정해진 동의 문구를 직접 읽어 녹음한다. 영어 동의 문구는 “I am the owner of this voice and I consent to Google using this voice to create a synthetic voice model.“이다.
- 저장한 목소리는 프로젝트당 200개까지 만들 수 있고 1년 동안 유지된다. 저장하지 않는 방식을 고르면 클라이언트가 음성 키를 직접 관리하며, 이 키는 7일 동안 유효하다.
- 지원 언어는 3.8 Flash TTS가 130개, Flash-Lite TTS가 101개다. 모델이 입력 언어를 자동으로 감지하며, 한국어는 두 모델 모두 지원한다.
대사 한 줄마다 연기를 지시한다
목소리를 정하고 나면 두 모델 모두 대사마다 어떻게 읽을지 지시할 수 있다. 발표문이 소개한 기능은 네 가지다.
- 대사 단위 연출: 사용자가 지문을 직접 쓰거나, 대본의 흐름을 보고 Gemini가 읽는 방식을 정하게 할 수 있다. 차분한 상담원 목소리부터 긴장감 있는 속삭임까지 조절한다.
- 장편 생성: 몇 시간 분량의 오디오에서도 음질과 빠르기, 캐릭터의 음색을 유지하고, 화자의 목소리가 조금씩 달라지는 현상(speaker drift)을 최소화한다. 팟캐스트와 오디오북을 위한 기능이다.
- 2인 대화 연출: 대본 하나로 여러 턴에 걸친 대화를 만든다. 두 목소리를 또렷하게 구분하고, 자연스럽게 말을 주고받게 한다.
- 음성 효과와 맞장구:
<laughs>,<sigh>,<gasp>같은 비언어 음성과|mhm|,|yeah|같은 맞장구를 대본에 적어 코미디 타이밍과 반응을 조절한다.
API 문서를 보면 이 기능들이 어떤 문법으로 구현되는지 알 수 있다. 모델은 입력 텍스트를 글자 그대로 읽어야 하는 대본으로 취급한다. 따라서 연기 지시는 대본과 별도로 적는다. 한 턴 전체에 적용할 감정과 말투, 빠르기, 음량은 speech_metadata.style 필드에 “whispered urgently"처럼 적는다. 기침이나 한숨처럼 한순간에 나는 소리는 대본 중간에 꺾쇠 태그로 적는다. 맞장구는 한 화자의 대사 중간에 파이프 문자로 감싸 적으면, 턴을 새로 만들지 않고도 상대 화자의 반응이나 두 사람의 말이 겹치는 소리를 만들 수 있다.
2인 대화에는 제약이 하나 있다. 요청 한 번으로 여러 화자의 대화를 생성하는 기능은 프리셋 음성 두 개까지만 지원한다. 직접 디자인하거나 복제한 목소리로 대화를 만들려면 화자별로 턴을 하나씩 합성한 다음 오디오를 이어 붙여야 한다.
벤치마크
발표문은 평가 결과 세 가지를 표 이미지로 공개했다. 구글 DeepMind의 평가 방법론 문서에 따르면 모두 2026년 9월 기준 결과이며, 프로덕션 체크포인트로 한 번씩 생성한 음성(pass@1)을 평가했다.3
Hume AI 음성 디자인 벤치마크
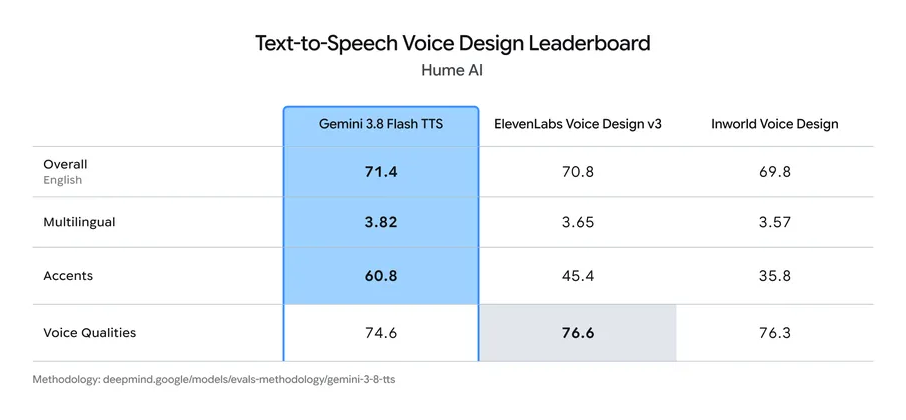
3.8 Flash TTS의 영어 종합 점수는 71.4로, ElevenLabs Voice Design v3의 70.8과 Inworld Voice Design의 69.8보다 높다. 점수 차이가 가장 큰 항목은 억양이다. 3.8 Flash TTS가 60.8점, ElevenLabs가 45.4점, Inworld가 35.8점을 받았다. 반면 목소리 특성(Voice Qualities) 항목에서는 ElevenLabs가 76.6점으로 1위이고, 3.8 Flash TTS는 74.6점으로 세 모델 중 가장 낮다.
Hume AI 음성 품질 벤치마크
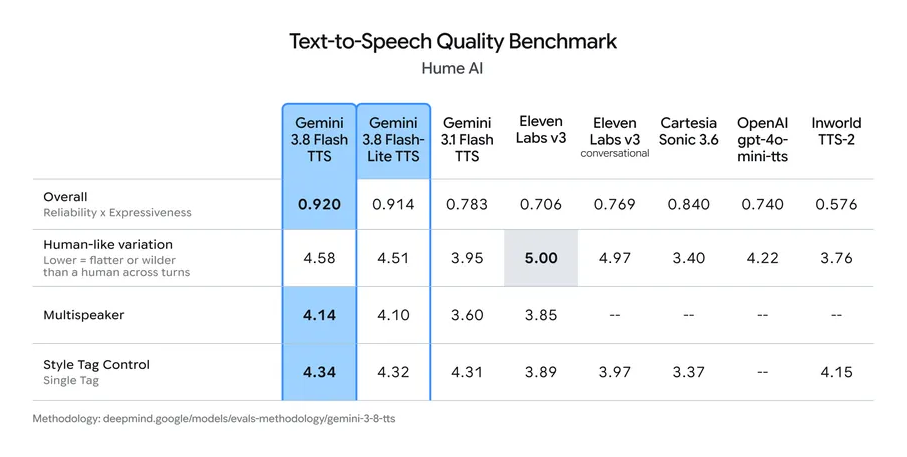
종합 점수는 신뢰도(Reliability)와 표현력(Expressiveness)을 곱한 값이다. 3.8 Flash TTS가 0.920, Flash-Lite TTS가 0.914로 각각 1위와 2위다. 3위인 Cartesia Sonic 3.6은 0.840이고, 이전 세대 3.1 Flash TTS는 0.783이다. 다중 화자(4.14)와 스타일 태그 제어(4.34) 항목에서도 3.8 Flash TTS의 점수가 가장 높다.
사람다운 변화(Human-like variation) 항목의 결과는 다르다. 이 항목은 여러 턴에 걸친 말투 변화가 사람과 얼마나 비슷한지 평가하며, 점수가 낮을수록 사람보다 밋밋하거나 과장됐다는 뜻이다. 여기서는 ElevenLabs v3가 5.00점, ElevenLabs v3 conversational이 4.97점으로 1위와 2위이고, 3.8 Flash TTS는 4.58점이다.
Voice Arena 언어별 선호도
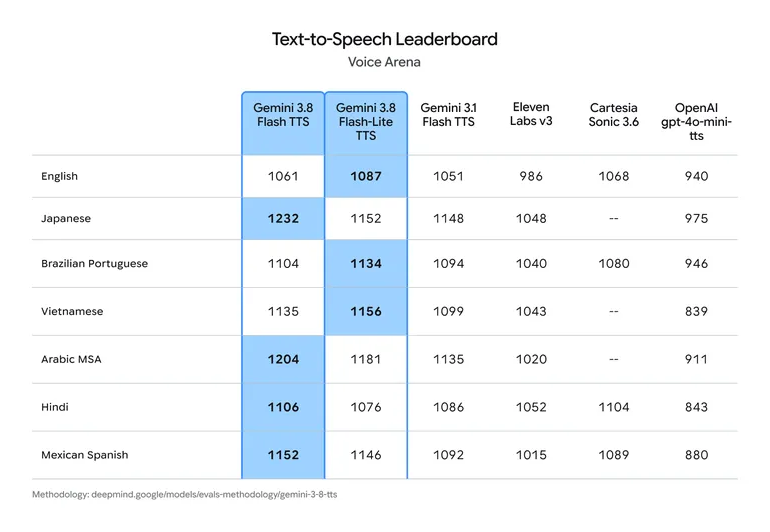
Voice Arena는 불특정 다수의 청취자가 두 음성을 모델 이름을 모른 채 듣고 더 나은 음성을 고르는 방식으로 Elo 점수를 매긴다. 일곱 개 언어 모두에서 두 Gemini 3.8 모델 중 하나가 1위다.
| 언어 | 1위 모델 | 3.8 Flash TTS | 3.8 Flash-Lite TTS |
|---|---|---|---|
| 영어 | Flash-Lite TTS | 1061 | 1087 |
| 일본어 | Flash TTS | 1232 | 1152 |
| 브라질 포르투갈어 | Flash-Lite TTS | 1104 | 1134 |
| 베트남어 | Flash-Lite TTS | 1135 | 1156 |
| 아랍어 표준어 | Flash TTS | 1204 | 1181 |
| 힌디어 | Flash TTS | 1106 | 1076 |
| 멕시코 스페인어 | Flash TTS | 1152 | 1146 |
영어에서는 Flash-Lite TTS 다음으로 Cartesia Sonic 3.6이 1068점을 받아 2위이고, 3.8 Flash TTS는 1061점으로 3위다.
가격
Gemini API 가격표의 표준 등급 단가는 다음과 같다. 오디오는 1초에 25토큰으로 계산하므로, 오디오 1시간은 9만 토큰이다.
| 모델 | 입력 (텍스트, 100만 토큰당) | 출력 (오디오, 100만 토큰당) | 오디오 1시간 출력 비용 |
|---|---|---|---|
| 3.8 Flash TTS | 0.50달러 → 1.00달러 | 9.00달러 → 18.00달러 | 0.81달러 → 1.62달러 |
| 3.8 Flash-Lite TTS | 0.50달러 → 1.00달러 | 6.00달러 → 12.00달러 | 0.54달러 → 1.08달러 |
| 3.1 Flash TTS Preview | 1.00달러 | 20.00달러 | 1.80달러 |
화살표 왼쪽은 2026년 12월 31일까지, 오른쪽은 2027년 1월 1일부터 적용되는 가격이다.
- 배치(Batch)와 플렉스(Flex) 등급의 오디오 출력 단가는 2026년 말까지 3.8 Flash TTS가 4.50달러, Flash-Lite TTS가 3.00달러로, 표준 등급의 절반이다.
- 무료 등급에서도 두 모델을 쓸 수 있다. 대신 무료 등급의 입력은 구글의 제품 개선에 쓰인다.
- 음성 디자인이나 음성 복제에 대한 별도 요금은 가격표에 적혀 있지 않다.
안전 장치와 모델 카드
발표문은 음성 생성과 복제 기능에 다음과 같은 안전 장치를 적용했다고 밝혔다.
- 동의 검증: 제출한 동의 음성의 화자가 참조 음성의 화자와 일치해야 목소리를 만들 수 있다.
- SynthID: Gemini Audio 모델이 생성하는 모든 오디오에 사람 귀로는 들리지 않는 워터마크가 들어간다. AI가 만든 음성을 판별해 허위 정보 유포를 막기 위한 장치다.
- C2PA 콘텐츠 자격증명: 복제한 음성에는 콘텐츠의 출처를 기록하는 C2PA 인증 정보가 함께 포함된다.
모델 카드에서는 다음 사항을 추가로 확인할 수 있다.
- 입력은 텍스트 최대 8천 토큰이고, 출력은 오디오 최대 6만 4천 토큰이다. 출력 한도를 오디오 길이로 환산하면 요청 한 번에 40분 남짓이다.
- 알려진 한계로 환각과 함께 간헐적인 지연이나 타임아웃이 적혀 있다.
- 프런티어 안전 평가는 Gemini 3.7 Flash의 평가 결과를 그대로 적용했다. 구글은 두 TTS 모델이 3.7 Flash와 비교해 의미 있는 새 능력이나 성능 향상을 보이지 않았기 때문에 같은 결론을 적용할 수 있다고 판단했다.
어디서 쓸 수 있는가
| 대상 | 3.8 Flash TTS | 3.8 Flash-Lite TTS |
|---|---|---|
| 개발자 | Gemini API, Google AI Studio | Gemini API, Google AI Studio |
| 기업 | Gemini Enterprise API (출시 예정) | Gemini Enterprise API (출시 예정) |
| 일반 사용자 | Gemini Notebook | Google Vids |
Google AI Studio에는 음성 디자인 작업 공간이 새로 생겼다. 사용자는 이곳에서 목소리를 새로 만들거나 자기 목소리를 복제한 다음, 2인 대본 편집기에서 대사별 연기를 지시할 수 있다.
Agora, LiveKit, Pipecat, Vercel 같은 개발 플랫폼이 Gemini API를 통해 이 모델을 지원한다. 발표문은 Figma, HeyGen, Linguana, Wondercraft, 99.co, Ollang을 파트너 기업으로 소개했다. 발표문에 따르면 이 기업들은 글로벌 더빙과 지역 억양을 살린 현지화, 대규모 음성 에이전트에 새 TTS 모델을 도입하고 있다.
가장 흥미로운 지점
발표문은 3.8 Flash TTS를 품질과 연기력에 집중한 모델로, Flash-Lite TTS를 단가를 낮춘 대량 생산용 모델로 소개했다. Hume AI의 품질 벤치마크 결과도 이 구분과 일치한다. 그런데 일반 청취자가 직접 듣고 고르는 Voice Arena에서는 영어와 브라질 포르투갈어, 베트남어에서 Flash-Lite TTS가 3.8 Flash TTS보다 높은 점수를 받았다. 영어에서는 3.8 Flash TTS의 점수가 Cartesia Sonic 3.6보다도 낮다.
여기에 가격까지 고려하면, 영어 음성을 대량으로 만드는 사용자에게는 Flash-Lite TTS가 더 나은 선택이다. 출력 단가가 3.8 Flash TTS의 3분의 2인데 청취자 선호도 점수도 더 높기 때문이다. API 문서가 Flash-Lite TTS를 주력 모델로 권하는 것도 이 결과와 부합한다.
가격 정책도 눈여겨볼 만하다. 출시 가격을 2026년 말까지만 유지하는 것은 초기 사용자 확보를 위한 한시적 할인으로 볼 수 있다. 3.1 Flash TTS를 쓰던 사용자라면 올해 안에 모델을 교체할 이유가 하나 더 생겼다.
출처
2026년 9월 24일 기준으로 구글 공식 발표와 DeepMind 모델 카드, 평가 방법론 문서, Gemini API 문서를 확인했다.
- Leland Rechis, “Gemini 3.8 text-to-speech says hello”, Google Blog, 2026-09-23. https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/
- Google DeepMind, “Gemini 3.8 Audio” 모델 카드. https://deepmind.google/models/model-cards/gemini-3-8-audio/
- Google DeepMind, “Gemini 3.8 Audio (Flash TTS, Flash-Lite TTS) Model evaluation”. https://deepmind.google/models/evals-methodology/gemini-3-8-tts/
- Gemini API, “Speech generation”. https://ai.google.dev/gemini-api/docs/speech-generation
- Gemini API, “Voice replication”. https://ai.google.dev/gemini-api/docs/voice-replication
- Gemini API, “Pricing”. https://ai.google.dev/gemini-api/docs/pricing
커버와 본문에 쓴 이미지는 구글 발표문에서 가져왔다.