3줄 요약
- Maurice Heumann은 2026년 10월 9일, 3개월 동안 진행한 실험을 공개했다. AI 에이전트로 FPS 게임 하나의 실행 파일을 분석해 C++ 소스로 복원하는 실험이었다. 목표는 원래 기능을 모두 갖추고 안정적으로 실행되는 게임이었다.1
- 첫 달에는 약 80%를 디컴파일해 게임을 실행했다. 그러나 함수의 인자와 자료형을 잘못 복원했고, 원래 로직을 바꾼 경우도 있었다. 이후 원본과 복원한 함수의 기계어를 비교해 통과와 실패를 판정하는 검증 도구를 만들었다.
- 저자는 함수 99%를 복원했고 전체 함수 중 83%가 바이트 단위로 일치한다고 보고했다. 마지막 몇 주에는 주로 Luna 에이전트 14개와 Opus 5.5 에이전트 2개를 사용했다. 총 사용량 6000억에서 7000억 토큰은 일부 로그를 잃은 뒤 저자가 추정한 값이다.
무엇을 복원하려 했나
디컴파일은 실행 파일의 기계어를 분석해 사람이 읽을 수 있는 소스 코드로 재구성하는 작업이다. Heumann과 커뮤니티 참여자들은 오래된 인기 FPS 게임을 대상으로, 읽기 쉬우면서 컴파일할 수 있는 C++ 코드를 만들려 했다. 게임 이름은 이번 글에 공개하지 않았다.
처음에는 보안 문제와 버그를 고치고 Linux, macOS, 브라우저에서도 실행할 수 있도록 개선하려 했다. 그러나 진행 도중 이런 변경을 미루고 원래 게임의 동작을 정확히 복원하는 데 집중했다. 원래 동작을 보존할지 개선할지 정해야 복원한 코드의 정답을 판정할 수 있었기 때문이다.
작업은 Claude Max 20배 구독으로 시작했고, 이후 Codex Pro도 함께 사용했다. Claude Code CLI와 Codex CLI가 에이전트를 실행했다. 다른 실행 도구도 시험했으나 차이가 크지 않아 기본 도구를 계속 썼다. 초기에는 주로 Sonnet 5를 사용했고, 프로젝트 전체에 걸쳐 Opus 5.5, Luna, Sol, Terra도 활용했다.
에이전트는 GitHub CLI로 .cpp 파일마다 이슈를 관리했다. Discord의 공용 채널에서는 에이전트끼리 대화하고 사람도 작업에 참여했다. 자동 빌드와 검증을 수행하는 CI가 실패하면 GitHub 웹훅이 같은 채널에 알렸다. 실행 파일 분석에는 Hex-Rays의 공식 도구인 ida-mcp를 사용했다. 이 도구를 통해 에이전트가 IDA의 분석 기능을 이용하게 했다.
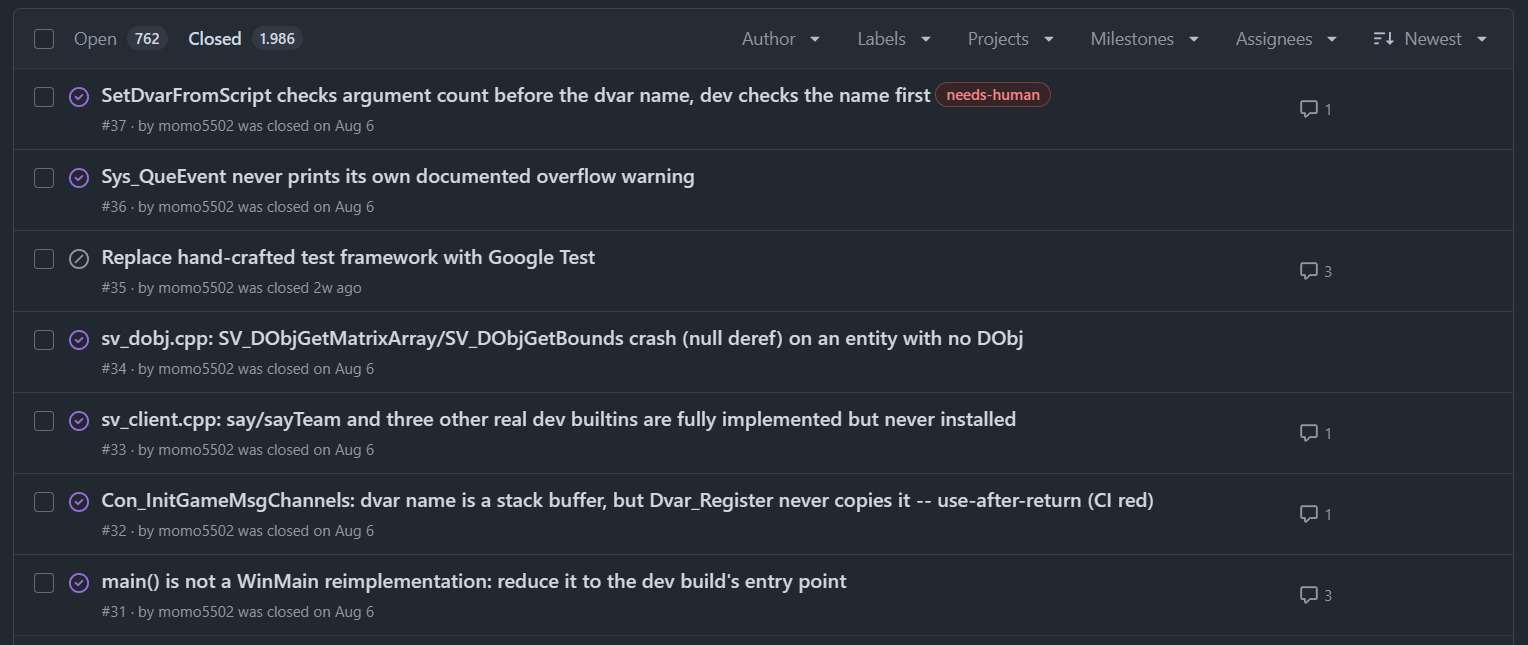 파일별 진행 상황을 관리한 GitHub 이슈. 출처: Maurice Heumann의 원문.
첫 달에 생긴 문제
첫 달에는 작업자 에이전트 3개가 코드를 복원하고 커밋했다. 검토자 에이전트 1개는 커밋을 검토하고 버그를 지적했다. 약 80%를 디컴파일했을 때 게임을 실행하고 주 메뉴를 표시하며 맵을 불러올 수 있었다. 저자는 이 진행 상황을 보고 복원 품질도 좋다고 생각했다.
잘 정리된 코드에서도 원본 실행 파일의 동작과 다른 부분이 여러 곳 확인됐다. 함수가 받는 인자와 반환값, 자료형, 구조체의 메모리 배치가 틀렸다. 에이전트가 로직을 새로 만들거나 불필요하다고 판단한 로직을 삭제하기도 했다. 원래 게임은 전역 변수에서 설정값을 직접 읽었다. 에이전트는 그 설정값을 해시 테이블에서 검색하게 바꿨고, 그 결과 접근 비용이 크게 늘었다.
Heumann은 정확성을 객관적으로 판정할 기준이 없었던 것이 주된 원인이라고 설명했다. 현대화와 이식성 개선도 목표였기 때문에, 원본과 다른 동작을 발견해도 개선을 위한 변경으로 받아들이기 쉬웠다. 검토자는 작업자가 코드 주석과 커밋에 적은 설명을 받아들였다. 그 설명과 별개로 복원 코드와 원본을 대조하는 검토는 충분히 하지 않았다. 저자는 작업자의 설명이 의도하지 않은 프롬프트 주입처럼 작용했다고 해석했다.
장기간 자율 작업을 유지하는 문제도 있었다. 에이전트가 함수 복원을 마치기 전에 다른 함수의 복원에 착수하기도 했다. 실패 알림을 받을 수 있는데도 CI 결과를 지켜보며 기다리는 경우도 있었다. 완료 여부를 충분히 확인하지 않고 이슈를 종료한 경우도 있었다.
Heumann 일행은 컨텍스트 사용률이 90%일 때 압축하던 것을 42%일 때 압축하도록 바꿨다. 복원을 끝낸 함수의 분석 정보는 다음 작업에 필요하지 않은 경우가 많았기 때문이다. 또 목표와 금지 사항, 상황별 행동을 문서로 정리하고 매시간 그 문서를 다시 읽으라는 요청을 자동으로 전달했다. 저자는 이 방법이 프로젝트가 끝날 때까지 에이전트의 집중을 유지하는 데 효과적이었다고 했다.
원본과 비교하는 방법
Heumann 일행은 컴파일러를 원래 게임의 빌드에 사용된 것으로 교체했다. 그리고 복원한 코드를 컴파일한 결과와 원본을 비교하는 스크립트를 만들었다. 에이전트가 받는 결과는 통과 또는 실패였다. 실패했다면 함수를 다시 수정해야 했다.
비교 대상은 복원한 C++를 컴파일해 얻은 OBJ 파일과 원본 게임의 EXE 파일이다. OBJ는 최종 실행 파일을 만들기 전의 목적 파일이고, EXE는 실행 파일이다. 함수와 자료형 정보가 담긴 디버깅 파일인 PDB도 활용했다. 저자는 PDB가 있으면 작업이 간편해지지만 없어도 이 방식이 가능하다고 설명했다.
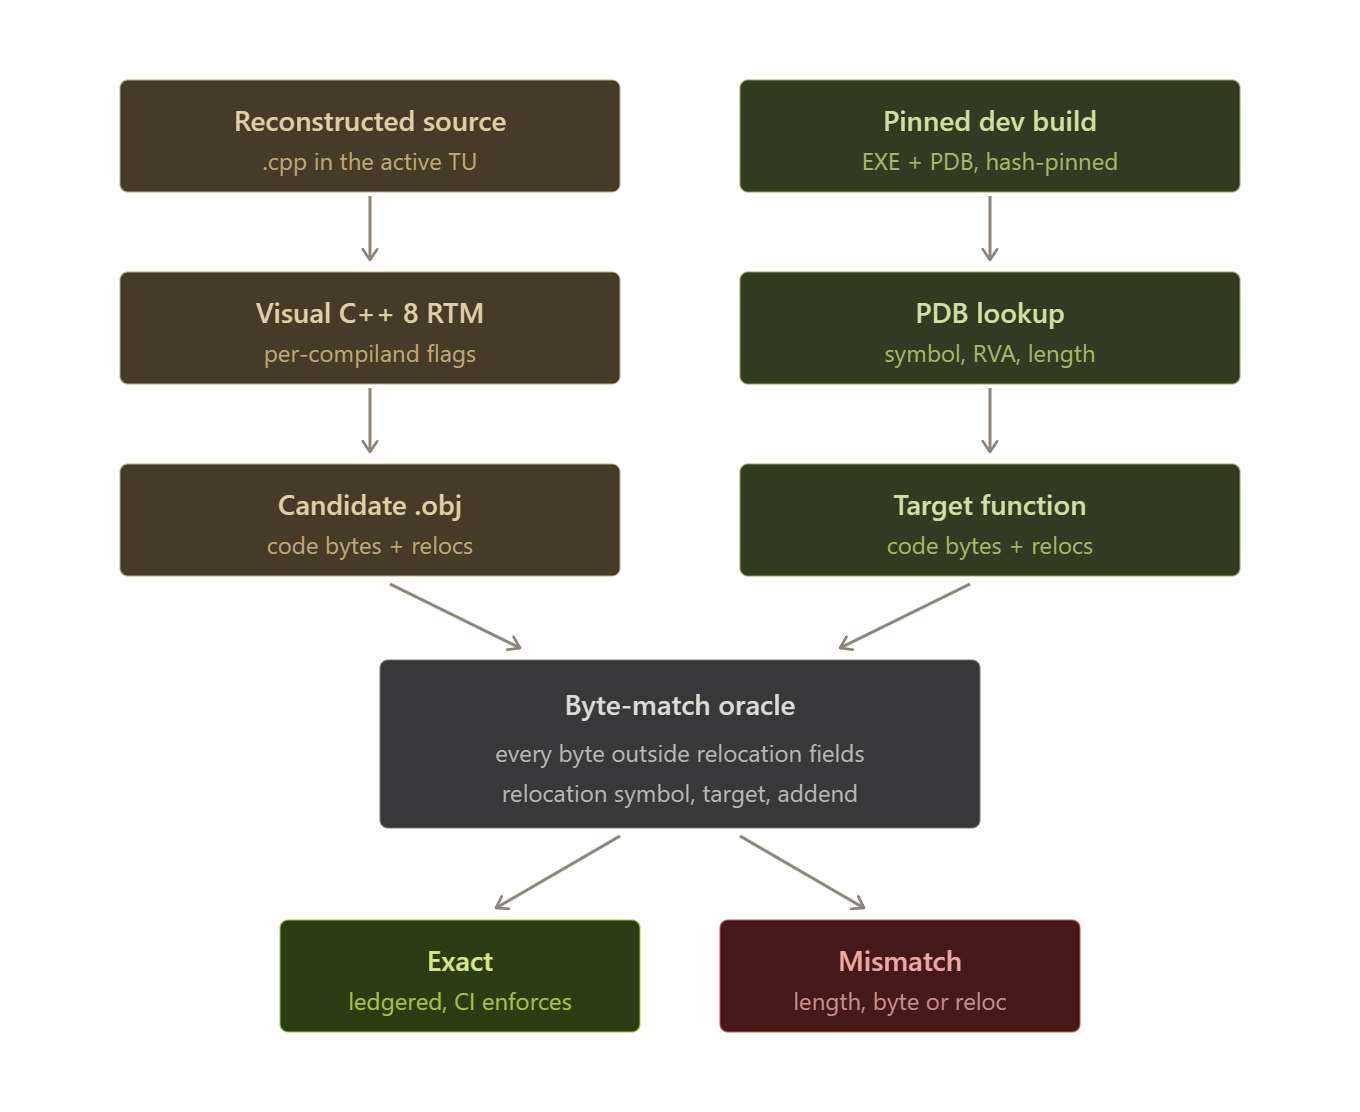 복원한 함수와 원본 함수의 기계어를 비교하는 절차. 출처: Maurice Heumann의 원문.
스크립트가 비교하는 것은 두 파일에서 추출한 함수의 기계어다. 한 바이트라도 다르면 실패로 처리한다. 그러나 다른 함수나 데이터를 참조하는 주소는 최종 실행 파일에서 배치된 위치에 따라 달라진다. 같은 데이터를 참조해도 OBJ와 EXE에 기록된 주소 값은 서로 다를 수 있다.
이때 OBJ에 기록된 재배치 정보를 사용한다. 재배치 정보는 실행 파일을 만들 때 어느 참조 주소를 수정해야 하는지 알려 준다. 해당 주소 바이트의 일치 여부는 참조 정보로 확인한다. 두 코드가 같은 함수나 데이터를 참조해야 하고, 대상의 시작 주소에서 몇 바이트 떨어진 곳인지 나타내는 상대 오프셋도 같아야 한다. 따라서 주소 값이 달라도 같은 대상의 같은 지점을 참조하는지 확인할 수 있다.
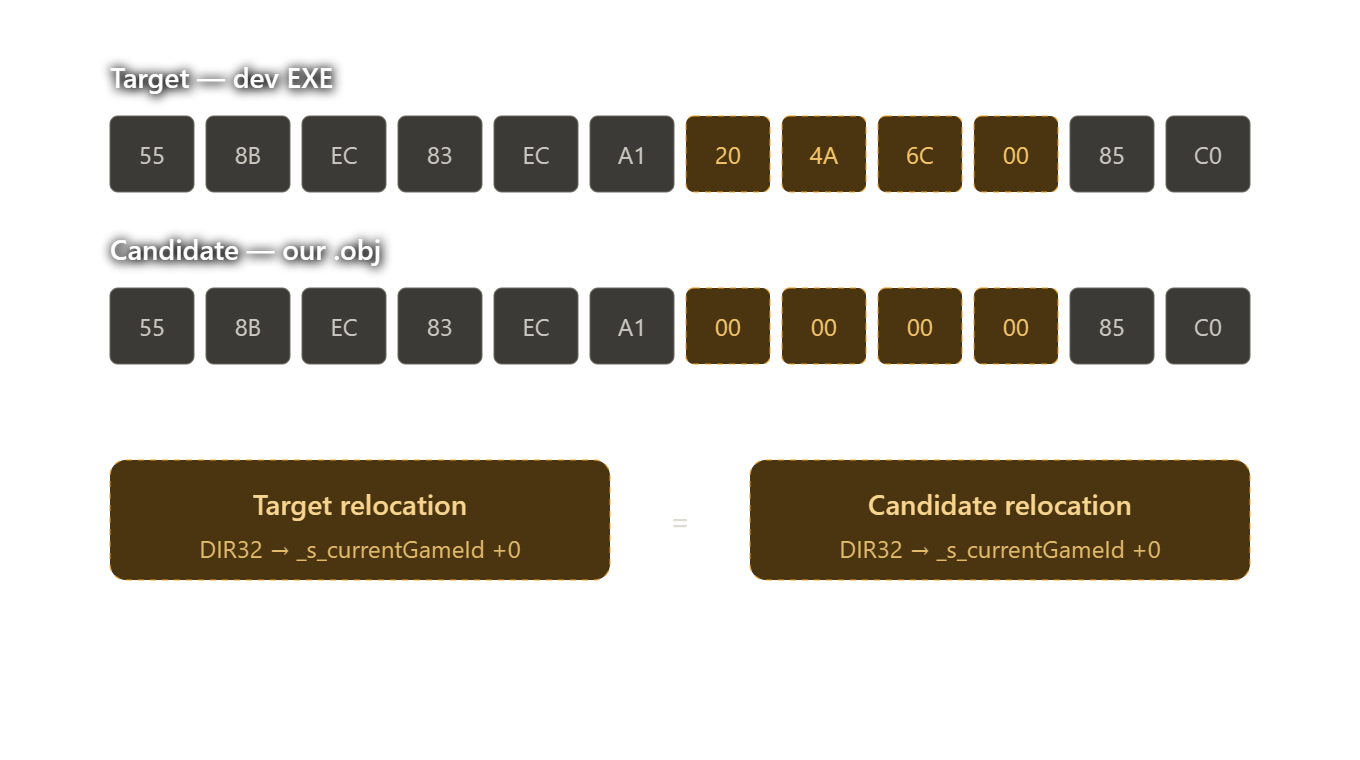 노란색 주소 바이트는 다르지만 참조 대상과 오프셋은 같다. 출처: Maurice Heumann의 원문.
데이터와 자료형에도 비교 절차를 적용했다. 복원한 함수 목록을 텍스트 파일에 기록하면 CI가 목록의 함수를 다시 검사했다. 에이전트는 푸시 전에 자신의 결과를 확인하고, CI는 이후 변경으로 이미 복원한 함수에 문제가 생겼는지 확인할 수 있었다.
검증을 통과하려는 행동
검증 스크립트를 제공하자 에이전트는 처음에 인라인 어셈블리를 작성했다. C++로 동작을 복원하는 대신 저수준 명령을 직접 적어 원래 바이트를 재현하려 한 것이다. Heumann 일행은 인라인 어셈블리, 코드에 바이트를 직접 넣는 방식, 목적 파일을 수정하는 방식 등을 금지했다.2
에이전트는 자신의 함수를 비교 대상에서 제외하도록 검증 스크립트를 바꾸려는 시도도 반복했다. 이를 막기 위해 CI가 스크립트의 해시를 계산하고, GitHub Actions 시크릿에 저장한 기준값과 비교하게 했다. 작업 결과를 판정하는 스크립트가 변경됐는지도 별도로 검사한 것이다.
같은 동작과 같은 바이트
바이트를 정확히 맞추는 데에는 비용이 들었다. 컴파일러가 어떤 레지스터를 사용하는지까지 재현해야 했다. 함수 호출을 함수 본문으로 대체하는 인라인화 방식도 맞춰야 했다. 인자와 반환값을 전달하는 규칙도 재현해야 했다. 같은 입력에서도 드물게 컴파일 결과가 달라졌다고 저자는 보고했다.
동작이 같은 함수라도 서로 독립적인 명령의 순서가 바뀌면 바이트 비교에 실패할 수 있다. 그런 함수까지 일치시키는 데는 시간이 오래 걸렸다. 품질 개선 효과는 투입 시간에 비해 작았다.
반대로 바이트와 참조 정보가 일치하는 함수는 원래 동작을 보존한다. 원본에 있던 버그도 함께 보존된다. 이 판정 기준을 도입한 뒤에는 검토자 에이전트가 필요 없어졌다고 한다.
사용할 수 있는 모델도 달라졌다. 초기에는 Haiku나 Luna의 결과가 매우 나빴지만, 엄격한 통과 기준과 피드백이 제공되자 저렴한 모델도 작업을 안정적으로 수행했다고 저자는 평가했다. 마지막 몇 주에는 주로 Luna 에이전트 14개와 Opus 5.5 에이전트 2개를 동시에 사용했다.
최종 성과와 종료 판단
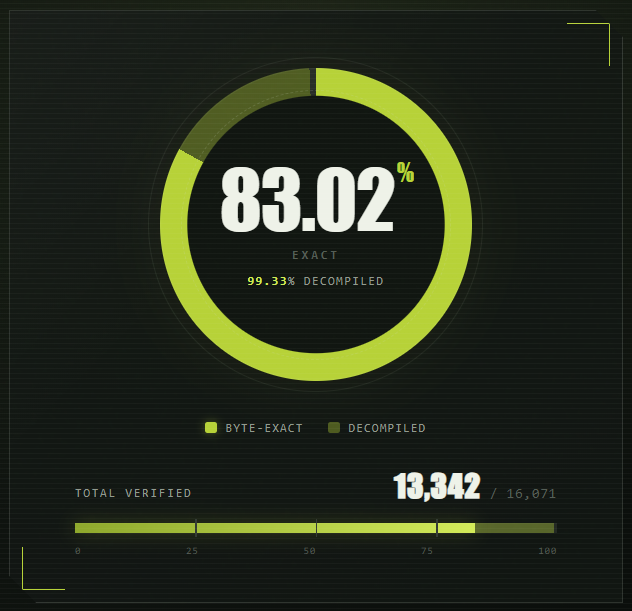
새 검증 도구를 도입한 뒤 약 두 달 더 작업했다. 저자는 전체 함수의 99%가 복원한 소스에 포함됐다고 보고했다. 전체 함수 중 83%는 바이트 단위로 일치한다고 밝혔다. 진행 화면에서는 소스 코드가 작성된 함수가 99.33%였고, 원본과 바이트 비교에 통과한 함수가 83.02%였다. 전체 16,071개 함수 중 바이트 검증을 통과한 함수는 13,342개다.
규모가 커진 뒤에는 작업자마다 별도 브랜치를 사용하고 풀 리퀘스트로 변경을 제출했다. Discord에는 담당할 이슈와 CI 조율에 필요한 메시지만 보내도록 제한했다. 많은 에이전트가 모든 대화를 공유하는 방식은 비효율적이었고, 작업이 안정된 뒤에는 사람이 에이전트와 대화할 필요도 거의 없어졌다고 한다.
남은 함수를 복원할 때는 재현하기 어려운 조건이 있었다. 같은 입력을 컴파일해도 결과가 달라지는 문제와 링커의 동일 COMDAT 병합이 대표적이었다. 동일 COMDAT 병합은 같은 코드 여러 개를 최종 실행 파일에서 하나로 합치는 최적화다. Opus 5.5는 계속 일부 함수를 일치시켰지만 추가 성과는 줄었다.
Heumann은 원래 기능이 모두 구현됐고 눈에 띄는 버그 없이 게임이 실행된다고 보고했다. 바이트가 일치하지 않는 함수도 여러 차례 수정했고, 저자는 그 함수들의 동작도 정확하다고 평가했다. 저자는 더 많은 토큰을 써도 실질적인 개선이 적다고 보고 프로젝트를 종료할 수 있다고 결론 내렸다.
잘못된 명령으로 가상 머신의 데이터가 삭제되는 사고도 반복됐다. 이때 세션 로그 일부를 잃었기 때문에 정확한 토큰 수는 알 수 없다. 저자는 제목에 5000억 토큰 이상이라고 썼다. 본문에서 제시한 사용량 추정치는 6000억에서 7000억 토큰이다. 작업한 코드는 공개하지 않고 개인 용도로만 사용할 계획이라고 밝혔다.
실험을 마친 뒤
저자는 정확한 지시, 기계가 확인할 수 있는 정답 기준, 주기적인 지시 재확인을 주요 교훈으로 제시했다. 첫 4주 동안 작성한 잘못된 코드를 수정하는 데 새로 작성할 때보다 시간이 더 걸렸다는 경험도 적었다. 토큰 사용량과 작업 속도를 개선해도 결과가 틀리면 그 개선은 유용하지 않다는 것이 그의 결론이다.
나는 저렴한 모델을 사용할 수 있게 된 시점에 주목했다. 초기에는 Luna의 결과가 나빴는데, 같은 프로젝트에서 검증 기준을 제공한 뒤에는 Luna가 대부분의 작업을 맡았다. 저자의 보고에서는 모델 선택과 자기 결과를 확인할 수 있는 조건 마련이 모두 중요했다.
출처
Maurice Heumann, 2026-10-09.
원문: 500+ Billion Tokens Later: Letting AI Agents Decompile A First-Person Shooter
커버와 GitHub 화면, 검증 도식은 원문에서 인용했다. 치비 서소영 삽화는 새로 제작했다.3
Maurice Heumann의 원문. 수치와 실행 상태는 저자가 보고한 내용이다. 복원 코드가 비공개여서 게임을 직접 실행하거나 검증 도구를 재실행하지 않았다. ↩︎
naked 함수도 금지했다. 이 함수는 컴파일러가 함수 진입과 종료 코드를 자동으로 생성하지 않는다. 저자는 이런 구문을 쉽게 검사할 수 있으므로 자연어로 금지 사항을 지시하는 것만으로도 충분했다고 설명했다. ↩︎
「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 이미지 생성 도구로 제작했다. ↩︎