3줄 요약
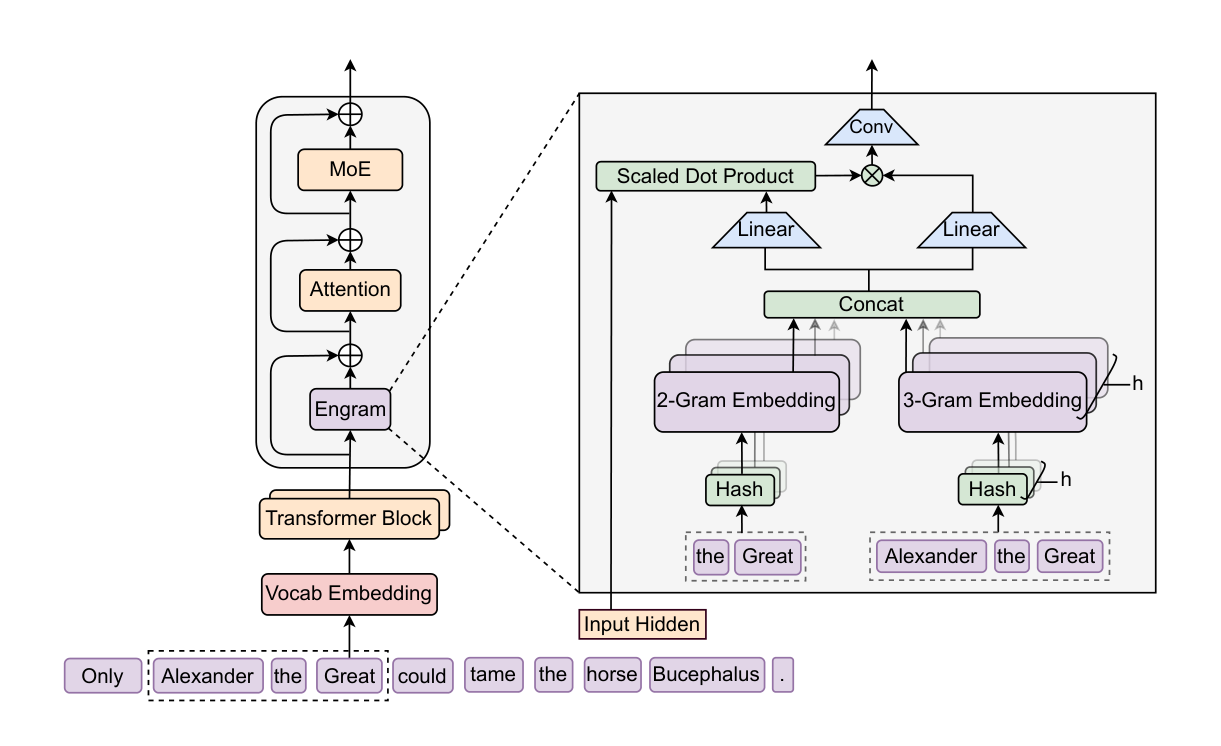
- DeepSeek과 베이징대 연구진은 트랜스포머에 지식을 찾아오는 전용 연산이 빠져 있다고 진단했다. 그러니 모델은 고정되어 있는 표를 매번 계산으로 다시 만들어 낸다. 연구진은 그 자리를 메우려고 고전적인 N그램 임베딩을 현대식으로 손질한 Engram 모듈을 내놓았다. 지역 문맥을 열쇠로 삼아 거대한 임베딩 표에서 상수 시간에 한 줄을 꺼내 오는 구조다.
- 전체 파라미터 수와 토큰당 연산량을 같게 맞춘 채 MoE 전문가와 Engram 메모리 사이에 용량을 나눠 보았더니 U자 곡선이 나왔다. 순수 MoE는 최적점이 아니었다. 활성화되지 않는 파라미터 예산의 20~25%를 메모리 쪽으로 옮겼을 때 검증 손실이 가장 낮았고, 이 최적 지점은 두 연산 예산에서 거의 같은 비율로 나타났다.
- 2,620억 토큰으로 학습한 267억 파라미터 모델은 파라미터 수와 연산량을 같게 맞춘 MoE 기준선보다 지식 과제에서 앞섰다(CMMLU +4.0). 그런데 추론 과제가 더 크게 올랐다(BBH +5.0). 연구진은 초기 층이 고정 패턴을 다시 조립하는 일에서 풀려나 모델이 실질적으로 깊어졌기 때문이라고 설명한다.
트랜스포머에는 찾아오기라는 연산이 없다
논문의 출발점은 언어 모델이 하는 일이 두 갈래라는 관찰이다. 하나는 문맥을 조합해 답을 만들어 내는 추론이고, 다른 하나는 이미 정해져 있는 지식을 꺼내 오는 인출이다. 앞의 것은 깊고 동적인 계산을 요구한다. 뒤의 것은 고정되어 있고 지역적이며 대단히 정형화되어 있다. 고유명사와 관용구가 여기에 해당한다.
지금의 희소성 설계는 앞쪽만 다룬다. MoE는 토큰마다 다른 전문가를 골라 활성화하는 방식으로 용량을 늘린다. 계산을 조건부로 만든 것이다. 그런데 표준 트랜스포머에는 지식을 주소로 찾아오는 기본 연산이 아예 없다. 그 빈자리를 모델은 계산으로 메운다.
연구진은 선행 연구에서 가져온 예시 하나로 이 낭비를 보여 준다. PatchScope로 각 층의 은닉 상태를 사람이 읽을 수 있는 문장으로 풀어 보면, “Diana, Princess of Wales"라는 이름 하나를 알아보는 데 여섯 개 층이 들어간다.
| 층 | 내부 표현을 옮긴 문장 | 무엇을 붙잡고 있는가 |
|---|---|---|
| 1~2 | 영국을 이루는 나라 중 하나 | 웨일스라는 지명 |
| 3 | 유럽의 한 나라 | 여전히 지명 |
| 4 | 여성 군주나 왕비가 지니는 칭호 | 공비라는 칭호(누구인지는 미정) |
| 5 | 웨일스 공의 아내에게 주어지는 칭호 | 웨일스 공비(누구인지는 미정) |
| 6 | 다이애나, 웨일스 공비(1961-1997), 찰스 왕세자의 첫 부인 | 다이애나 본인 |
사전에서 한 줄을 찾아오면 끝날 일에 여섯 개 층 분량의 어텐션과 FFN이 소모된다. 논문은 이것을 정적 조회표를 실행 시간에 비싸게 재구성하는 일이라고 부른다. 그 층들은 원래 더 높은 수준의 추론에 쓰일 수 있었다.
Engram이 손질한 네 곳
N그램 임베딩 자체는 새로운 착상이 아니다. 지역 문맥 몇 개를 이어 붙여 해시하고, 그 값으로 임베딩 표를 찾는다. 이 논문은 그 고전적인 구조를 현대 MoE 백본에서 쓸 수 있도록 네 곳을 손봤다.
토크나이저 압축. 표준 서브워드 토크나이저는 원문을 손실 없이 복원하는 데 최적화되어 있어서, 의미가 같은 표기에 서로 다른 ID를 준다. Apple과 앞에 공백이 붙은 apple이 따로 논다. N그램 표에서 이런 분산은 낭비다. 연구진은 NFKC 정규화와 소문자화 등을 적용해, 원래 토큰 ID를 표준 ID로 모으는 대응 함수를 미리 계산해 둔다. 128k 토크나이저에서 유효 어휘 크기가 23.43% 줄었다.
멀티헤드 해싱. 가능한 N그램 조합을 전부 파라미터로 두는 것은 불가능하다. 그러므로 해싱으로 임베딩 표의 인덱스를 만든다. 충돌을 줄이려고 N그램 차수마다 서로 다른 해시 헤드를 K개 두고, 각 표의 크기는 소수로 잡는다. 해시 함수 자체는 곱셈과 XOR을 섞은 가벼운 형태다. 각 헤드가 꺼낸 벡터를 하나로 이어 붙여 메모리 벡터를 만든다.
문맥 인지 게이팅. 여기서 꺼내 온 임베딩은 문맥과 무관한 사전 지식이다. 문맥에 맞춰 변하지 못하고, 해시 충돌이나 다의어 때문에 잡음을 안고 온다. 연구진은 어텐션에서 착상을 가져와 게이트를 하나 둔다. 현재 은닉 상태가 질의가 되고, 꺼내 온 메모리가 키와 값이 된다. 질의와 키에 RMSNorm을 적용한 뒤 내적을 시그모이드에 통과시켜 0과 1 사이의 스칼라 게이트를 얻는다. 꺼내 온 메모리가 현재 문맥과 어긋나면 게이트가 0 쪽으로 내려가 그 잡음을 눌러 준다. 그 뒤에 커널 크기 4짜리 깊이별 인과 합성곱을 한 번 통과시킨다. 이 합성곱의 가중치는 0으로 초기화해서, 학습을 막 시작한 시점에는 입력이 그대로 통과하도록 했다.
다분기 통합. 백본은 잔차 흐름을 M개의 병렬 분기로 펼치는 다분기 구조를 쓴다. 실험에서 쓴 것은 M을 4로 둔 mHC다. 임베딩 표와 값 투영 행렬은 모든 분기가 공유하고, 키 투영 행렬만 분기마다 따로 둔다. 이 덕분에 분기마다 다른 게이트가 열린다. 이렇게 나누면 투영들을 하나의 FP8 행렬곱으로 융합할 수 있다.
Engram은 모든 층에 붙지 않는다. 267억 파라미터 모델에서는 30개 블록 중 2번과 15번 층에만 들어간다. 어디에 넣을지는 모델링 성능과 시스템 지연이 함께 정한다.
희소 용량을 어떻게 나눌 것인가
여기서 논문의 중심 실험이 시작된다. 전체 파라미터와 토큰당 활성 파라미터를 고정하면, 활성화하지 않는 파라미터 예산이 남는다. 여기에는 선택되지 않은 전문가와 조회되지 않은 임베딩 슬롯이 들어간다. 연구진은 이 예산을 MoE 전문가와 Engram 메모리에 어떻게 나눌지 살폈다. 예산 가운데 MoE 몫의 비율을 ρ라고 부른다. ρ가 1이면 순수 MoE이고, ρ를 낮추면 전문가 수를 줄여 그만큼을 임베딩 슬롯으로 옮긴다.
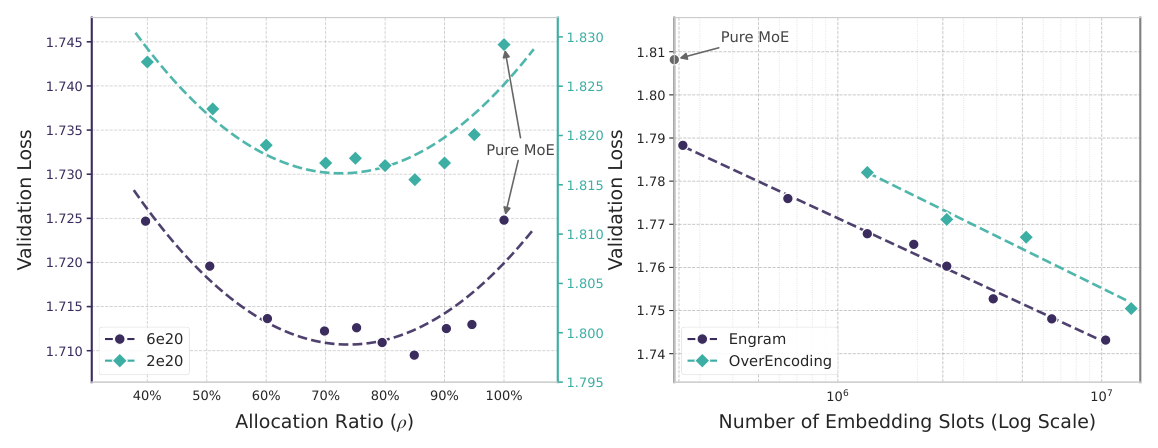
두 연산 예산에서 이 비율을 훑었다. 두 설정 모두 전체 파라미터가 활성 파라미터의 약 10배가 되도록 맞췄다.
| 연산 예산 | 전체 파라미터 | 활성 파라미터 | 순수 MoE의 전문가 수 |
|---|---|---|---|
| 2×10²⁰ FLOPs | 약 5.7B | 568M | 106개 |
| 6×10²⁰ FLOPs | 약 9.9B | 993M | 99개 |
결과는 두 예산 모두에서 U자 곡선이었다. 두 가지가 눈에 띈다.
첫째, ρ를 40% 근처까지 낮춰도, 다시 말해 전문가 절반 이상을 임베딩으로 바꿔 놓아도 순수 MoE와 비슷한 성능이 나왔다. 57억 파라미터 모델에서는 전문가가 106개에서 46개로 줄어든 상태다.
둘째, 순수 MoE는 최적점이 아니었다. 예산의 20~25%를 메모리로 옮겼을 때 가장 좋았다. 약 99억 파라미터 규모에서 검증 손실이 1.7248에서 1.7109로 0.0139만큼 내려갔다. 두 연산 예산 모두 MoE 몫이 75에서 80퍼센트인 곳에서 최적점을 보였다.
U자의 양 끝이 말하는 바는 서로 반대다. ρ가 100%로 가면 정적 패턴을 담아 둘 전용 공간이 없어 모델이 그것을 깊이와 계산으로 다시 만들어야 한다. ρ가 0으로 가면 문맥에 따라 달라지는 계산 능력이 사라진다. 메모리가 계산을 대신해 주지는 못한다.
메모리만 계속 키우면 어떻게 되는가
배분 문제와 별개로, 예산 제약을 풀고 메모리만 공격적으로 늘리면 어떤 곡선이 나오는지도 재어 보았다. 30억 파라미터 규모의 MoE 백본을 고정해 두고 1,000억 토큰까지 학습시킨 뒤, 붙인 임베딩 표의 슬롯 수를 25만 8천 개에서 1천만 개까지 훑었다. 마지막 설정에서 더해진 파라미터가 약 130억 개다.
검증 손실은 로그 공간에서 직선으로 내려갔다. 멱법칙을 따른다는 말이고, 추가 계산 없이 메모리만 키워도 검증 손실이 예측 가능한 흐름으로 낮아진다. 비교 대상으로는 N그램 임베딩을 어휘 임베딩과 평균 내어 합치는 OverEncoding을 썼는데, 같은 메모리 예산에서 Engram 쪽이 훨씬 큰 폭으로 개선됐다.
2,620억 토큰으로 재어 본 결과
연구진은 이렇게 찾은 배분 법칙을 그대로 적용해 실제 사전학습 규모에서 다시 검증했다. 네 모델은 같은 데이터와 순서로, 같은 토큰 예산을 써서 학습했다. 활성 파라미터는 모두 38억 개다. 백본은 30개 블록, 은닉 차원 2,560, MLA 어텐션 32헤드로 구성했고 Muon 옵티마이저를 썼다. 토크나이저는 DeepSeek-V3의 128k짜리를 그대로 가져왔다.
| 모델 | 전체 파라미터 | 라우팅 전문가 | Engram 메모리 |
|---|---|---|---|
| Dense-4B | 4.1B | 없음 | 없음 |
| MoE-27B | 26.7B | 72개(상위 6개 선택) | 없음 |
| Engram-27B | 26.7B | 55개(상위 6개 선택) | 5.7B |
| Engram-40B | 39.5B | 55개(상위 6개 선택) | 18.5B |
Engram-27B는 MoE-27B에서 전문가를 72개에서 55개로 줄이고 그만큼을 임베딩으로 옮긴 모델이다. ρ로 치면 74.3%로, 앞서 찾은 최적 구간에 들어간다. 전체 파라미터도 활성 파라미터도 기준선과 정확히 같다.
주요 벤치마크만 추려 보면 이렇다.
| 벤치마크 | Dense-4B | MoE-27B | Engram-27B | Engram-40B |
|---|---|---|---|---|
| Pile (loss) | 2.091 | 1.960 | 1.950 | 1.942 |
| 검증셋 (loss) | 1.768 | 1.634 | 1.622 | 1.610 |
| MMLU | 48.6 | 57.4 | 60.4 | 60.6 |
| CMMLU | 47.9 | 57.9 | 61.9 | 63.4 |
| MMLU-Pro | 21.1 | 28.3 | 30.1 | 31.3 |
| C-Eval | 46.9 | 58.0 | 62.7 | 63.3 |
| TriviaQA | 33.0 | 48.8 | 50.7 | 51.8 |
| BBH | 42.8 | 50.9 | 55.9 | 57.5 |
| ARC-Challenge | 59.3 | 70.1 | 73.8 | 76.4 |
| DROP | 41.6 | 55.7 | 59.0 | 60.7 |
| HumanEval | 26.8 | 37.8 | 40.8 | 38.4 |
| GSM8K | 35.5 | 58.4 | 60.6 | 62.6 |
| MATH | 15.2 | 28.3 | 30.7 | 30.6 |
지식 과제의 개선은 예상 범위 안이다. CMMLU가 4.0점, MMLU가 3.0점, MMLU-Pro가 1.8점 높아졌다. 더 눈에 들어오는 것은 다른 항목이다. BBH가 5.0점, ARC-Challenge가 3.7점, DROP이 3.3점 올랐다. 코드와 수학도 함께 개선돼서 HumanEval이 3.0점, MATH가 2.4점, GSM8K가 2.2점 높아졌다. 표를 찾아오는 모듈을 붙였는데 표에 없는 것을 푸는 능력이 더 많이 올라간 셈이다.
수치 하나는 원문 안에서 어긋난다. 초록은 MMLU 개선 폭을 +3.4로 적었는데, 표와 본문은 둘 다 +3.0이다. MMLU-Redux가 60.6에서 64.0으로 +3.4 올랐으니 초록에서 두 지표가 섞였을 가능성이 크다.
Engram-40B는 메모리를 185억 파라미터까지 키운 모델이다. 손실은 계속 낮아졌지만 모든 과제에서 Engram-27B를 앞서지는 못했다. HumanEval과 MBPP, MATH는 Engram-27B보다 조금 낮다. 저자들은 학습이 덜 된 탓으로 본다. 학습 막바지까지 손실 격차가 계속 벌어지고 있어서, 늘어난 메모리 용량을 2,620억 토큰 예산 안에서 아직 채우지 못했다는 설명이다.
왜 추론 쪽이 더 올랐는가
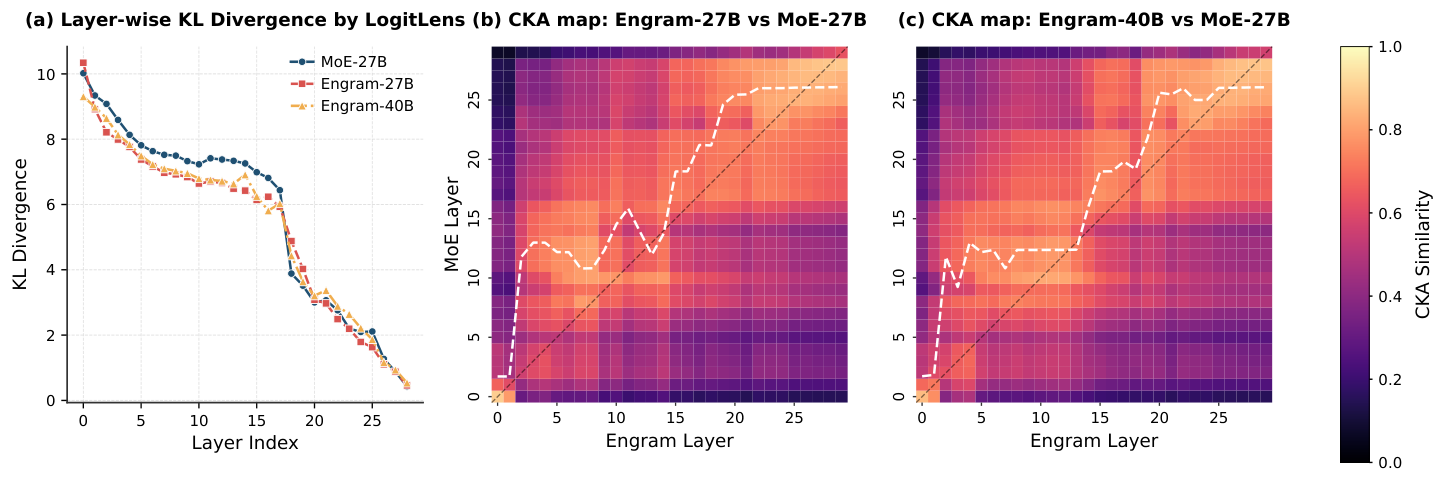
왜 그런지에 대한 설명은 앞서 본 다이애나 예시에 이미 들어 있다. Engram이 초기 층을 정적 재구성 작업에서 해방시키면, 남은 층은 더 높은 수준의 일에 쓰인다. 층 수를 그대로 두고도 유효 깊이가 늘어난다. 연구진은 두 가지 도구로 이 가설을 검증했다.
첫째는 LogitLens다. 중간 층의 은닉 상태를 최종 LM 헤드에 통과시켜 예측 분포를 만든다. 그 분포와 모델의 최종 출력 분포 사이의 KL 발산을 잰다. 그 값이 작을수록 그 층의 표현이 이미 예측할 준비를 마쳤다고 볼 수 있다. Engram 쪽이 층 전반에 걸쳐 발산이 작았고, 격차는 앞쪽 블록에서 가장 컸다. 특징 조합이 더 일찍 끝난다는 신호다.
둘째는 CKA다. 두 모델의 각 층 표현이 얼마나 닮았는지를 재는 지표다. Few-NERD에서 고유명사의 마지막 토큰에 해당하는 은닉 상태를 추려 비교했다. 연구진은 Engram의 각 층마다 가장 유사한 MoE 층 다섯 개를 고른 뒤, 유사도를 가중치로 삼아 평균을 냈다. 이 값을 그 층의 유효 MoE 깊이로 삼았다. 유사도 대각선은 위로 밀려 올라가 있었다. Engram-27B의 5번 층에서 만들어진 표현이 MoE 기준선의 12번 층 근처와 가장 닮았다.
긴 컨텍스트에서 벌어진 간격
지역 의존성을 조회가 떠맡으면, 어텐션은 전역 문맥에 더 많은 용량을 쓸 수 있다. 이 예측을 확인하려고 사전학습 이후 YaRN으로 문맥 길이를 32,768 토큰까지 늘렸다. 이 확장 학습은 고품질 장문 데이터 300억 토큰으로 5,000스텝 동안 진행했다.
비교 설계가 꼼꼼하다. Engram-27B의 중간 체크포인트 두 개도 함께 넣었는데, 그중 4만 6천 스텝 체크포인트의 사전학습 손실은 학습을 마친 MoE-27B와 같은 1.63이다. 긴 문맥 성능은 기본 모델의 일반적 품질과 얽힌다. 학습 스텝만 맞춰서는 구조 자체의 기여를 분리하기 어렵다는 판단이다.
| 모델(스텝, 손실) | LongPPL Book | LongPPL Code | RULER MQ | RULER VT | RULER FWE |
|---|---|---|---|---|---|
| MoE-27B (50k, 1.63) | 4.38 | 2.49 | 84.2 | 77.0 | 73.0 |
| Engram-27B (41k, 1.66) | 4.37 | 2.50 | 89.5 | 83.2 | 99.6 |
| Engram-27B (46k, 1.63) | 4.19 | 2.45 | 97.0 | 87.2 | 98.6 |
| Engram-27B (50k, 1.62) | 4.14 | 2.44 | 97.0 | 89.0 | 99.3 |
손실을 맞춘 46k 비교에서 다중 질의 바늘 찾기가 84.2에서 97.0으로, 변수 추적이 77.0에서 87.2로 올라갔다. 빈출 단어 추출은 73.0에서 98.6으로 크게 올랐다. 사전학습 연산을 82%만 쓴 41k 체크포인트도 LongPPL에서는 기준선과 맞먹고 RULER에서는 앞선다.
모든 칸이 오르지는 않았다. 공통 단어 추출은 MoE-27B의 4.5에서 Engram-27B(46k)의 4.3으로 오히려 내려갔다. 이 항목은 네 모델 모두 3.8에서 5.9 사이에 몰려 있다. 어느 쪽도 이 과제는 아직 풀지 못한 상태다.
어느 층에 넣고 무엇을 뺄 수 없는가
구조 실험은 12층짜리 30억 파라미터 MoE 백본에서 1,000억 토큰으로 돌렸다. 기준선 검증 손실이 1.808이고, 16억 파라미터짜리 Engram 메모리를 2번과 6번 층에 나눠 넣은 참조 설정이 1.768이다.
같은 16억 파라미터 메모리를 한 층에만 넣고, 삽입 위치를 1번부터 12번 층까지 바꿔가며 확인했다. 2번 층이 1.770으로 제일 나았다. 1번 층보다 낫고, 뒤로 갈수록 나빠진다.
두 힘이 서로 반대 방향으로 작용한다. 모듈을 일찍 넣을수록 백본은 지역 패턴을 다시 만드는 데 깊이를 쓰기 전에 그 일을 넘겨받는다. 너무 일찍 넣으면 게이팅이 부정확해진다. 앞쪽 은닉 상태는 전역 문맥을 아직 모으지 못했고, 병렬 분기도 충분히 갈라지지 않은 상태이기 때문이다. 2번 층이 이긴 것을 보면, 어텐션을 한 번만 거쳐도 게이팅에 쓸 만한 문맥이 은닉 상태에 실리는 모양이다. 같은 예산을 둘로 쪼개 2번과 6번에 나눠 넣으면 더 좋아지는 이유도 여기에 있다. 이르게 개입해서 얻는 이득과, 문맥이 무르익은 뒤에 게이팅해서 얻는 이득을 한 모델 안에서 함께 얻는다.
구성 요소를 하나씩 빼 보았을 때 손실이 크게 나빠진 항목은 세 가지였다. 분기별 융합과 문맥 인지 게이팅, 그리고 토크나이저 압축이다. 가벼운 깊이별 합성곱을 빼는 것은 영향이 작았다. 고정된 예산 안에서 4그램에 용량을 떼어 주는 것은 조금 손해였는데, 더 자주 등장하는 2그램과 3그램 패턴에서 용량을 빼앗기 때문으로 본다. 메모리 규모가 훨씬 커지면 높은 차수가 이득이 될 가능성은 열어 두었다.
Engram을 꺼 보면 무엇이 남는가
학습을 마친 모델에서 추론 시점에 Engram의 출력만 완전히 눌러 버리고 백본은 그대로 두면, 무엇이 무너지고 무엇이 버티는지 볼 수 있다. 학습과 추론이 어긋나는 상태라 복합 과제에서는 잡음이 끼지만, 양 극단은 뚜렷하다.
사실 관계를 묻는 벤치마크는 원래 성능의 29~44%만 남았다. TriviaQA는 29%까지 무너졌다. 파라미터에 담긴 지식을 주로 Engram이 보관하고 있었던 것이다. 반대로 독해 과제는 81~93%를 유지했고, C3는 93%였다. 문맥에 근거해 푸는 과제는 백본의 어텐션에 기대고 있다.
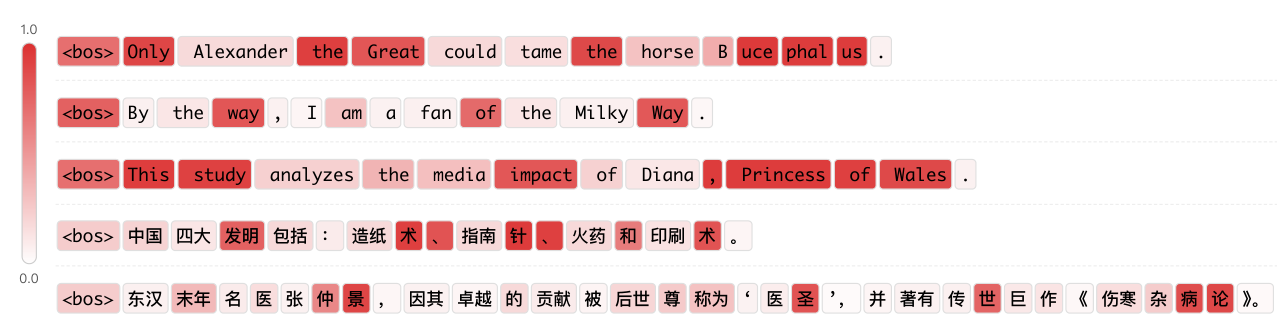
게이트가 실제로 어디서 열리는지도 눈으로 확인할 수 있다. 게이팅 스칼라를 문장 위에 겹쳐 보면, 지역적이고 고정된 패턴이 완성되는 자리에서 값이 뛴다. 영어에서는 “Alexander the Great”, “the Milky Way” 같은 여러 토큰짜리 고유명사와 “By the way” 같은 관용구에서 강하게 켜진다. 중국어 예시에서도 사대발명(四大发明) 같은 고정 표현과 장중경(张仲景) 같은 역사 인물에서 같은 일이 벌어진다.
1,000억 파라미터를 CPU 메모리에 두고
Engram이 MoE와 갈라지는 지점이 시스템 쪽에 하나 더 있다. MoE의 라우팅은 실행 도중의 은닉 상태를 보고 정해지기 때문에, 어떤 전문가가 필요할지 미리 알 방법이 없다. Engram의 조회 인덱스는 입력 토큰 열만으로 결정된다. 해당 층이 실행되기 전에 무엇을 읽어 올지 이미 알 수 있다.
이 예측 가능성 덕분에 추론 때는 임베딩 표 전체를 호스트 메모리에 둔다. 앞선 블록이 계산하는 동안 필요한 행을 PCIe로 미리 가져온다. 아래는 nano-vLLM 기반 하네스에서 H800 한 장과 512개 시퀀스로 측정한 값이다.
| 백본 | 기본 | 1,000억 파라미터 Engram을 CPU에 두고 |
|---|---|---|
| Dense-4B | 9,031.62 tok/s | 8,858.28 tok/s |
| Dense-8B | 6,315.52 tok/s | 6,140.02 tok/s |
처리량 손해가 8B 백본에서 2.8%로 가장 컸다. 한 스텝에 실제로 오가는 통신량은 표 전체 크기와 무관하게, 활성화된 슬롯 수에만 비례하기 때문이다. 이 측정은 보수적 조건에서 이뤄졌다. 논문이 제안한 계층적 캐시는 N그램의 지프 분포를 이용해 자주 쓰는 항목을 HBM에 둔다. 이번 실험에서는 그 캐시를 쓰지 않고 모든 조회를 PCIe로 보냈다.
내가 곱씹은 대목
곡선의 최적점보다 그 왼쪽 절반이 더 놀라웠다. 전문가를 106개에서 46개로 줄이고 그 자리를 해시 테이블로 채웠는데도 순수 MoE와 비슷한 손실이 나왔다. 조건부 계산으로 하던 일의 상당 부분을, 문맥을 전혀 보지 않는 정적 조회가 대신할 수 있었다. 물론 더 줄이면 무너진다. 그 무너지는 지점이 생각보다 훨씬 왼쪽에 있었다.
두 번째는 이득이 나타난 자리다. 메모리를 붙였으니 지식 과제가 개선되는 것은 자연스럽다. 그런데 추론과 수학 과제의 개선 폭이 더 컸다. 제거 실험에서도 같은 대비가 방향만 바꿔 되풀이된다. Engram을 끄면 사실 관계를 묻는 과제가 29%까지 무너지지만 독해는 93%가 남는다. 그러니까 Engram은 지식을 맡고, 백본은 그 덕분에 다른 일을 할 여유를 얻는다. 모듈이 직접 담당하는 능력과 모듈 덕분에 좋아지는 능력이 서로 다르다는 점이 흥미로웠다.
세 번째는 결정론이라는 성질이 시스템 설계에서 가지는 값이다. MoE가 GPU 메모리 한계에 묶이는 이유는 성능 탓이라기보다 예측 불가능성 탓이다. 어떤 전문가가 필요한지 실행해 봐야 알기 때문에 미리 가져올 수 없다. Engram은 토큰 열만 있으면 주소가 결정된다. 그 덕분에 1,000억 파라미터짜리 표를 호스트 메모리에 두고도 처리량 손해가 3% 안쪽이었다. 모델링 성능에는 이른 삽입이 좋고, 전송 시간을 감추는 데에는 늦은 삽입이 유리하다. 모듈을 넣을 층을 고를 때는 이 두 요구를 함께 맞춰야 한다.
한 가지 아쉬운 것은 규모다. 이 실험은 267억 파라미터 모델을 2,620억 토큰으로 학습했다. 지금 기준으로는 작은 규모이고, Engram-40B가 아직 학습이 덜 됐다는 저자들의 관찰이 그 한계를 그대로 보여 준다. 배분 법칙의 최적 비율이 연산 예산을 바꿔도 거의 그대로였다는 것은 좋은 신호지만, 그 두 예산의 간격은 세 배에 불과하다. U자의 최적점이 수천억 파라미터 규모에서도 같은 비율에 남을지는 논문이 답하지 않는다.
출처
Xin Cheng, Rui Tian, Wangding Zeng, Damai Dai 외 (Peking University, DeepSeek-AI), “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models”, arXiv:2601.07372v2, 2026년 1월 12일 최초 공개, 7월 12일 개정. CC BY 4.0.
이 글에 실린 그림 네 장은 모두 원문 논문의 Figure 1, 3, 4, 7이다. CC BY 4.0 조건에 따라 인용했다.