3줄 요약
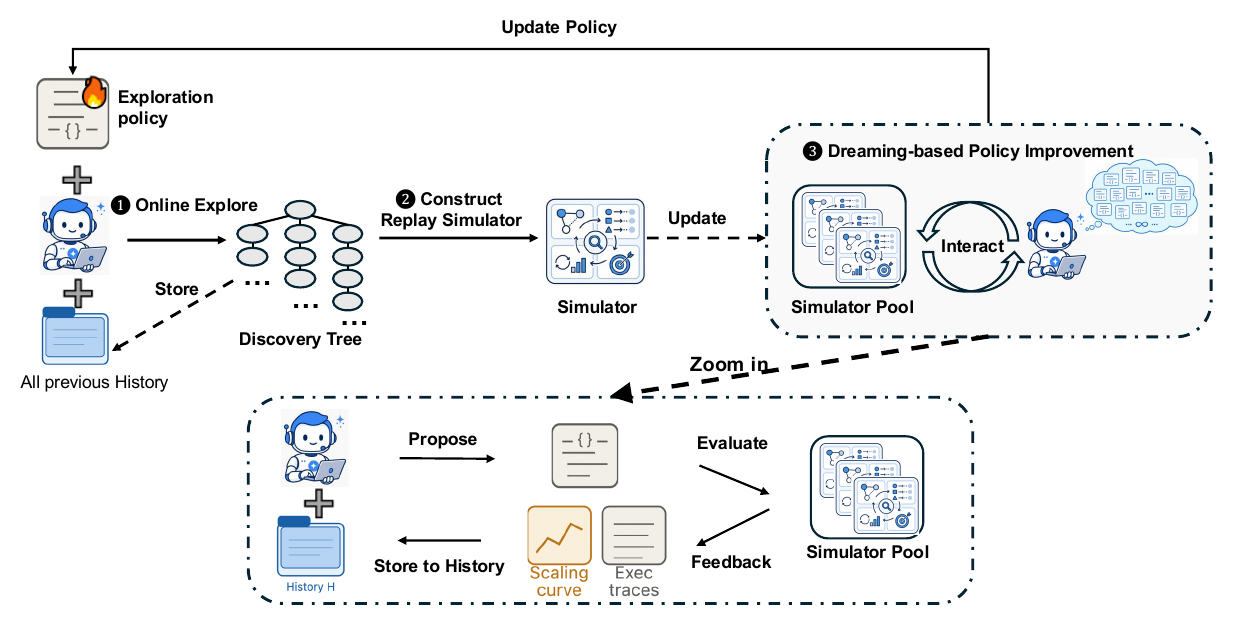
- 구글과 구글 딥마인드, 메릴랜드대, 버지니아대의 연구자 17명이 테크니컬 리포트 36쪽을 공개했다. 코딩 에이전트가 알고리즘을 발견해 나가는 루프에서, 사람이 손으로 써 두고 한 번도 고치지 않던 탐색 정책을 에이전트가 스스로 고쳐 쓰게 만든 시스템이다.
- 새 탐색 정책을 시험하려면 발견 과정을 끝까지 다시 돌려야 한다는 것이 이 분야의 비용 구조였다. 저자들은 이미 끝난 실행이 남긴 발견 트리를 다시 읽어, 그 트리를 다른 순서로 걸어 보는 방식으로 후보 정책을 채점한다. 노드마다 실행 결과가 이미 저장되어 있으므로 채점에는 코드 실행이 한 번도 들어가지 않는다.
- 알고리즘 공학과 수학 최적화, GPU 커널 세 영역의 여덟 과제에서 측정했다. 탐색 정책만 고정한 기준 시스템과 견주었을 때, VGG16 커널은 2.43배 적은 생성으로 같은 성능에 도달했다. Lasso 회귀 경로에서는 Dream-RSI가 317회만 호출해, SimpleTES가 쓴 51,200회보다 훨씬 적은 비용으로 더 빠른 코드를 찾아냈다.
고쳐지지 않는 부품 하나
재귀적 자기 개선은 제안과 평가를 반복하는 발견 루프 위에서 이루어진다. 지금 문제가 되는 규모에서는 그 루프가 수천 번 반복된다. 그 반복이 계산 자원을 쓸 값어치가 있는지를 결정하는 것은 탐색이다. 어디서 가지를 칠지, 무엇을 병렬로 실행할지, 어느 갈래를 언제 끊을지가 탐색이 하는 일이다. 저자들은 이 부품 하나만 여전히 사람이 손으로 써 둔 그대로 쓰인다는 관찰에서 출발한다.
여기에는 어느 쪽을 골라도 손해인 딜레마가 있다. 고정된 전략은 쌓인 경험에서 배우지 못하므로 이미 실패한 방향에 계속 비용을 치른다. 그렇다고 온라인에서 최적화하려 들면 두 개의 벽을 동시에 만난다. 하나는 메타 수준의 피드백이 늦고 비싸다는 것이다. 탐색 정책을 평가하려면 후보 하나를 채점하는 것으로 끝나지 않고, 그 정책이 발견 과정 전체를 끝까지 이끌어 가는 것을 지켜봐야 한다. 다른 하나는 메타 정책의 공간이 넓다는 것이다. 시도해야 할 정책의 대부분은 나쁜 정책이고, 나쁘다는 것을 알아내는 데 매번 완전한 실행 한 번이 들어간다.
저자들이 내세우는 반전은 그 피드백을 얻는 비용을 이미 치렀다는 관찰이다. 끝난 발견 실행이 디스크에 남기는 것은 다시 읽을 텍스트 더미를 훨씬 넘어선다. 에이전트가 내린 모든 탐색 결정이 트리 구조로 기록되어 있고, 결정마다 실제로 나온 실행 결과가 함께 붙어 있다. 그리고 탐색 정책이 하는 일은 한 가지다. 지금까지 본 것을 근거로 어느 시도를 이어갈지 고른다. 그러므로 대안 정책은 무엇도 다시 실행할 필요가 없다. 같은 기록 트리를 다른 순서로 걸으면 된다. 그 과정에서 정책이 묻는 결과는 전부 디스크에 저장되어 있다. 수천 개의 후보를 실행 횟수 0으로 걸러 낸 다음, 실제 실행은 승자에게만 쓴다.
끝난 실행은 이미 시뮬레이터다
저자들이 세우는 정의는 넓다.
A simulator is anything that can answer “what would have happened if…” without running the world.
탐색 정책에 관한 한, 그런 시뮬레이터는 이미 존재했다. 완전히 만들어져 있었고, 비용도 이미 치러진 상태였다. 쓰는 사람이 없었을 뿐이다.
낯선 지형을 처음 건너는 에이전트를 떠올려 보자. 비효율적인 경로를 택하고, 막다른 길에 부딪히고, 되돌아 나온다. 그러면서 지도를 그린다. 다음 정책은 땅을 다시 밟지 않아도 된다. 지도 위에서 추론하면 된다. 알려진 막다른 길을 피하고, 앞선 정책이 너무 일찍 확정해 버린 결정을 다시 검토하고, 경로 전체를 비교한 다음에 출발한다.
긴 호흡의 발견 과정이 바로 이 구조를 갖고 있다. 완료된 실행 하나는 탐색 결정의 트리와 각 결정이 실제로 낳은 코드 실행 결과를 함께 기록한다. 그러므로 다른 정책을 그 위에서 재생한다는 것은 다른 가지를, 다른 순서로, 다른 병렬 묶음과 다른 중단 지점으로 순회한다는 뜻이다. 순회하는 노드는 전부 이미 실행된 것들이다. 평가는 즉시 돌아오고 실행 횟수는 0이다.
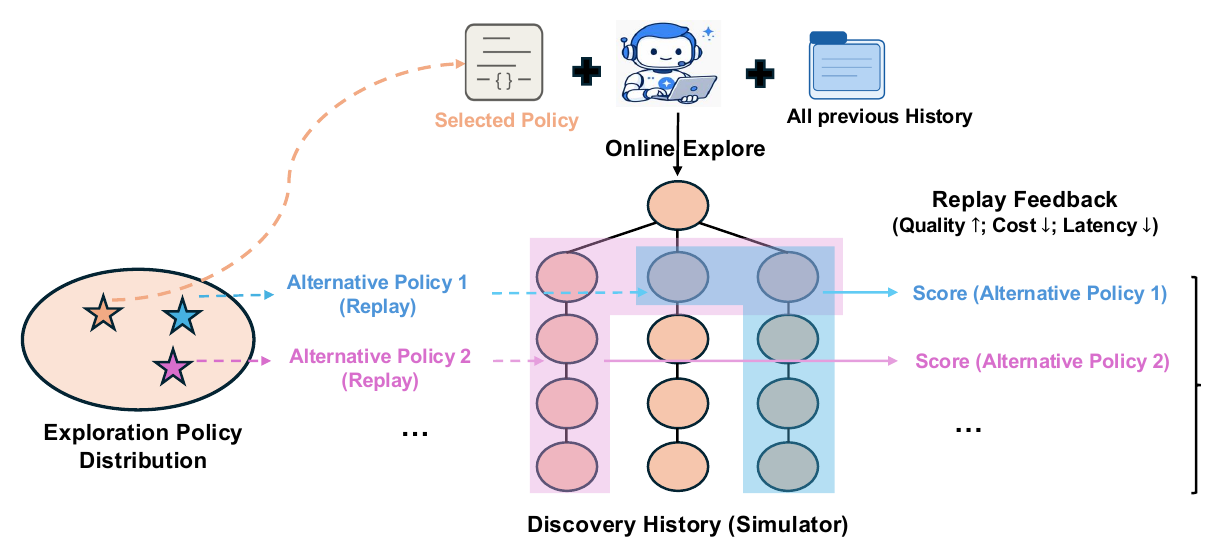
그림 2. 발견 이력을 재생 시뮬레이터로 사용한다. 노드 하나는 관측 전체가 기록된 시도 하나다. 결과가 미리 저장되어 있으므로, 값비싼 온라인 실행 한 번으로 빠른 오프 폴리시 평가를 수천 번 치를 수 있다. 출처: 프로젝트 페이지.
이 기록은 내내 그대로 있었고, 선행 연구는 그것을 다른 물건으로 읽었을 뿐이다. 프롬프트에 붙일 정적인 텍스트 맥락으로 읽거나, 가중치를 미세조정할 학습 데이터로 읽었다. 트리로 읽으면 시뮬레이터가 된다. 그리고 학습된 월드 모델과 달리 이것은 근사가 아니다. 예측하는 것이 하나도 없다. 실현된 탐색 공간 위에서 이 시뮬레이터는 정확한데, 그 공간 자체이기 때문이다.
그리고 바로 그 정확함이 이 방법의 한계까지 규정한다. 정책을 꿈꿀 수 있는 범위는 역사가 실제로 다녀온 곳까지다. 저자들은 이 제약이 방법을 한 번의 처리에서 루프로 바꿔 놓는다고 본다. 온라인 배포를 한 번 할 때마다 트리가 하나씩 더 기록된다. 그래서 에이전트는 세계 하나를 넘어 계속 늘어나는 세계들의 집합을 갖게 된다. 더 많은 세계에서 꿈꿔진 정책은 한 번의 운에 맞춰진 정책을 이기고, 그렇게 이긴 정책은 앞선 어떤 정책도 도달하지 못했을 세계를 가지고 돌아온다. 세계가 에이전트와 함께 진화한다는 제목의 뒷부분은 여기서 나왔다.
저자들은 이 루프를 관리하는 가벼운 오케스트레이션 계층에 Dream-RSI라는 이름을 붙였다. 이 계층은 탐색을 명시적이고 프로그램 가능한 대상으로 만들되, 그 아래에서 일하는 코딩 에이전트는 손대지 않은 채로 둔다.
루프의 수식과 “나빠질 수 없다"는 보장
바깥 반복을 $t = 1, 2, \ldots$로 센다. 초기 정책 $\pi_{1}$과 빈 이력 $\mathcal{H}_{0}$에서 시작한다. 반복 $t$에서는 $\pi_{t}$를 온라인으로 배포해 발견 에이전트를 이끌고, 트리 구조를 가진 발견 이력 $\mathcal{T}_{t}$를 모은다. 완료된 트리는 이력에 덧붙는다.
$$\mathcal{H}_{t} = \left(\mathcal{T}_{1}, \ldots, \mathcal{T}_{t}\right) \overset{\text{replay}}{\longrightarrow} \pi_{t+1} \overset{\text{deploy}}{\longrightarrow} \mathcal{T}_{t+1}$$오프라인 단계에서는 정책 개발 에이전트가 정책 코드의 개정판을 $M$개 연달아 쓴다. $\pi^{0} = \pi_{t}$에서 시작해 $\pi^{1}, \ldots, \pi^{M-1}$까지다. 개정판은 각각 이력 전체에 대한 재생으로 채점된다. 지금 배포되어 있는 정책 $\pi^{0}$이 후보 집합에 들어 있으므로, 승자 $\pi_{t+1} = \pi^{m^{*}}$은 $\pi_{t}$보다 나쁠 수 없다.
이 보장이 어디까지 미치는지는 정확히 적어 둘 만하다. 리포트가 내세우는 부등식은 $V^{m^{\star}} \geq V^{0}$이고, 이 부등식은 고정된 이력 $\mathcal{H}_{t}$ 위에서 잰 평균 재생 점수에 대해서만 성립한다. 온라인 환경에 다시 배포했을 때의 실제 성능을 보장한다는 뜻은 아니다. 재생 점수는 세 항으로 짜여 있다. 발견 품질에서 실행 비용을 빼고 병렬성 보너스를 더한다.
$$V_{i}^{m} = \max_{v} s_{v} - \beta_{1} N_{i}^{m} + \beta_{2} \frac{N_{i}^{m}}{\max\left(1, k_{i}^{m,\star}\right)}$$$N_{i}^{m}$은 재생이 훑은 노드의 수다. 재생으로 시험하는 정책은 자신이 연 서브트리의 모든 노드에 대해 비용을 부담한다. 여러 가지를 한꺼번에 열고 값이 나오지 않는 가지를 접는 정책이라면, 훑은 노드의 수만큼 계산 비용을 치른 것으로 계산된다. 채점이 값싸다고 해서 마음껏 넓게 여는 정책이 유리해지지 않도록 만든 장치다.
정책은 파이썬 클래스 하나다
탐색 정책이 실행 가능한 코드라는 말은 비유가 아니다. 리포트가 다루는 정책은 파이썬 클래스 OptimalPolicy다. 이 클래스는 see.policy.api의 LLMDesignedMethod를 상속한다. 구현해야 할 메서드는 solve(self, question, budget=None) 하나다.
question 객체가 정책에게 열어 주는 창은 좁다. reset()으로 상태를 되돌리고, observed()로 지금까지 드러난 것을 보고, legal_actions()와 legal_roots()로 이어갈 수 있는 노드를 받고, opened_branches()로 지금 열어 둔 가지를 세고, meta(cell_id)로 노드의 메타데이터를 읽고, probe_batch(cells, on_reveal=...)로 노드 묶음을 한 번에 연다. 기준값은 baseline_score, 병렬도 상한은 max_parallelism으로 주어진다.
원자 연산은 CONTINUE(v) 하나뿐이다. 정책이 한 라운드에 하는 일은 이어갈 노드의 묶음 $C$를 고르는 것이고, 묶음의 크기는 워커 수 $W$를 넘을 수 없다. 빈 묶음을 고르면 탐색이 끝난다. 어디서 가지를 칠지, 몇 개를 동시에 돌릴지, 언제 멈출지가 이 한 번의 선택 안에 모두 들어 있는 셈이다.
재생은 언제나 루트에서 시작한다. 정책이 노드를 고르면 기록된 트리 안의 실제 자식만 드러난다. 기록에 없는 곳을 고르면 드러나는 것이 없고, 이어갈 기록이 남지 않으면 재생이 종료된다. 기록 밖으로 나가려는 후보는 벌점을 받지도 않고 근사값을 받지도 않는다. 그 경로가 그냥 없어진다.
세 영역 여덟 과제
저자들은 알고리즘 공학과 수학 최적화, GPU 커널 공학 세 영역의 여덟 과제에서 이 방법을 평가했다. 통제 기준선은 Recursive Fixed Exploration이다. 에이전트와 평가기, 초기화, 라운드당 예산까지 모두 같게 두고 탐색 정책만 그대로 유지한다. 양쪽 모두 사람이 쓴 같은 병렬 정련 정책에서 출발하므로 1라운드는 설계상 동일하다.
모델은 Gemini CLI를 거친 Gemini-3.1-Pro와 Gemini-3.7-Flash다. 3.1-Pro에는 병렬 워크스페이스 10개를 두고 각 워크스페이스에서 11회까지 정련하게 했다. 따라서 라운드당 호출은 110회다. 3.7-Flash에는 워크스페이스 32개를 두고 20회씩 정련하게 해서 640회가 된다. 라운드 수는 Lasso가 5라운드, 수학 최적화가 10라운드다.
알고리즘 공학: Lasso 정규화 경로
| Method | Model | Compute | Gisette | RCV1 | DNA | Leukemia | Colon | Duke Breast | Avg. |
|---|---|---|---|---|---|---|---|---|---|
| sklearn | – | – | 11275.2 | 252881.7 | 93.8 | 227.2 | 229.8 | 374.0 | 44180.3 |
| glmnet | – | – | 9063.6 | 73072.8 | 351.9 | 45.0 | 24.2 | 47.7 | 13767.5 |
| SimpleTES | gpt-oss-120b | 51,200 | 3141.9 | 19625.6 | 15.9 | 15.5 | 11.6 | 18.1 | 3804.8 |
| SimpleTES (저자 재현) | gpt-oss-120b | 51,200 | 8651.0 | 41143.1 | 37.6 | 28.2 | 19.5 | 31.1 | 8318.4 |
| Recursive Fixed Exploration | Gemini-3.1-Pro | 550 | 1861.8 | 19550.1 | 41.5 | 26.1 | 14.5 | 28.4 | 3587.1 |
| Recursive Fixed Exploration | Gemini-3.7-Flash | 3200 | 1133.1 | 13873.0 | 29.8 | 24.1 | 15.7 | 24.4 | 2516.7 |
| Dream-RSI | Gemini-3.1-Pro | 317 | 2841.0 | 14616.0 | 49.9 | 30.2 | 16.4 | 32.5 | 2931.0 |
| Dream-RSI | Gemini-3.7-Flash | 1879 | 1091.9 | 12923.4 | 31.4 | 21.0 | 12.2 | 23.6 | 2350.6 |
이 표는 여섯 개의 미공개 데이터셋에서 잰 최종 실행 시간을 밀리초(ms) 단위로 나타낸 것이다. 낮을수록 좋다. Compute 열은 발견 에이전트를 부른 누적 횟수다.
두 열을 함께 봐야 한다. Gemini-3.1-Pro 기준으로 Dream-RSI는 317회 호출로 평균 2931.0ms를 냈고, 정책을 고정한 같은 시스템은 550회를 쓰고도 3587.1ms에 머물렀다. SimpleTES는 51,200회로 3804.8ms다. 호출 수로는 162배 차이인데 결과는 Dream-RSI 쪽이 더 빠르다. Flash에서도 Dream-RSI는 1,879회만 호출해 기준 시스템의 3,200회보다 절반가량 적게 썼다. 평균 실행 시간도 2,516.7ms에서 2,350.6ms로 줄었다.
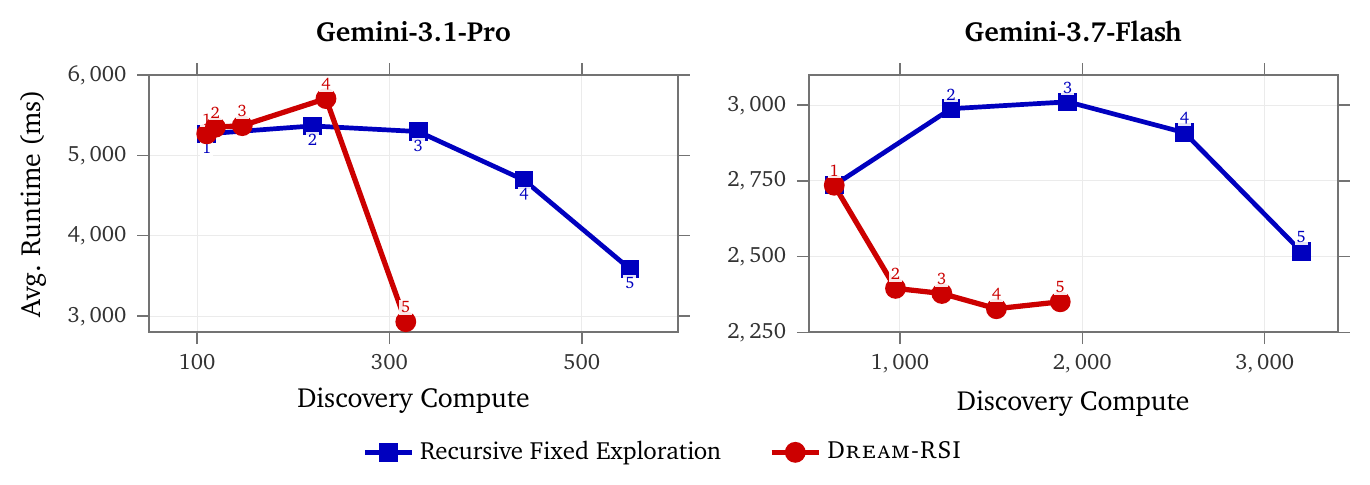
그림 3(b). 표식 옆의 숫자가 재귀 라운드다. 설계상 1라운드를 공유한 뒤 두 방법이 갈라진다. 출처: 프로젝트 페이지.
수학 최적화
| Method | LLM | Sum Diff ↑ | Auto Correlation ↓ | Circle Packing ↑ |
|---|---|---|---|---|
| AlphaEvolve | Gemini-2.0 Pro + Flash | – | 1.455700 | 2.635862 |
| AlphaEvolveV2 | Gemini-2.0 Pro + Flash | 1.121936 | – | 2.635983 |
| OpenEvolve | – | – | 1.460000 | – |
| CodeEvolve | – | – | – | 2.635980 |
| ShinkaEvolve | Mixed | – | 1.457800 | 2.635982 |
| TTS-Discovery | Qwen3-8B | – | – | 2.635983 |
| ThetaEvolve | Distilled-Qwen3-8B | – | 1.493000 | 2.635983 |
| EvoX | Gemini-3.0-Pro | – | 1.458900 | 2.635900 |
| SimpleTES | GPT-OSS-120B | 1.143975 | 1.453675 | 2.635983 |
| Recursive Fixed Exploration | Gemini-3.1-Pro | 1.144047 | 1.456001 | 2.635983 |
| Dream-RSI | Gemini-3.1-Pro | 1.145427 | 1.456375 | 2.635983 |
Sum Diff와 Circle Packing은 높을수록, Auto Correlation은 낮을수록 좋다. Auto Correlation의 최고 기록은 SimpleTES가 갖고 있는데, 저자들이 덧붙이는 조건은 그 기록에 51,200세대가 들어갔다는 것이다. 여기서 쓴 예산은 1,000세대 미만이다.
GPU 커널 공학
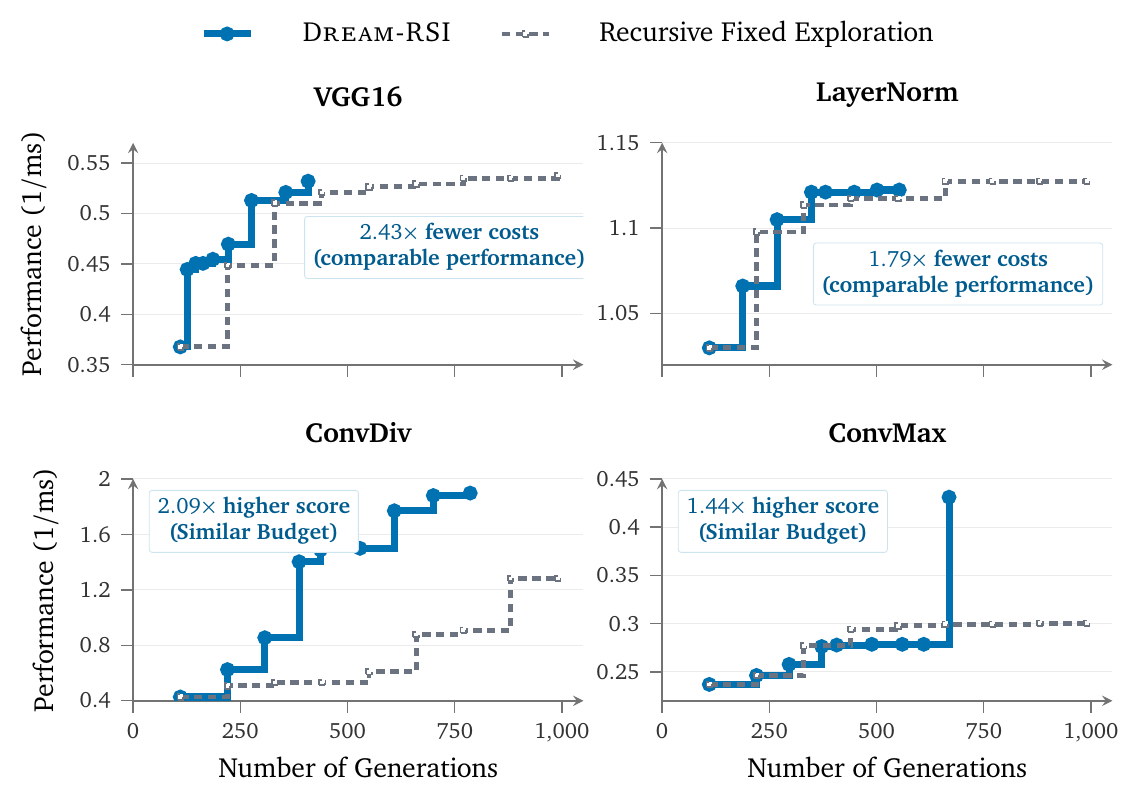
그림 4. KernelBench 네 과제. 모두 높을수록 좋다. 출처: 프로젝트 페이지.
VGG16과 LayerNorm에서는 같은 성능에 2.43배와 1.79배 적은 생성으로 도달했고, ConvDiv와 ConvMax에서는 비슷한 예산에서 2.09배와 1.44배 높은 성능을 냈다.
정책이 학습한 행동
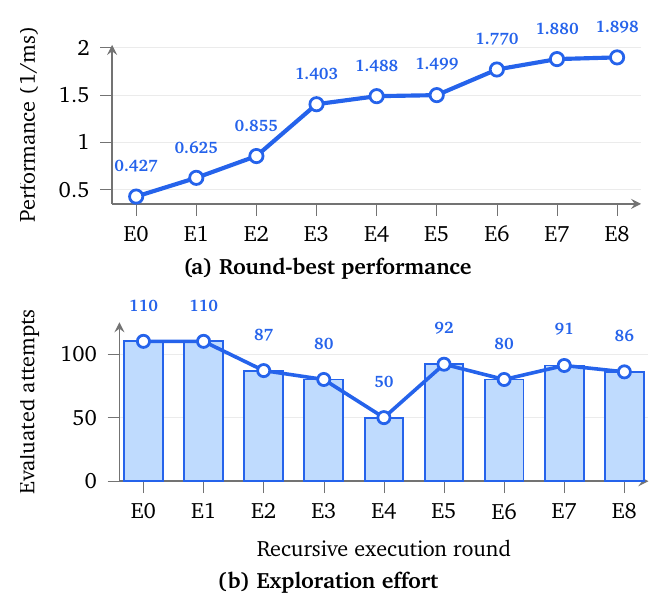
그림 6. ConvDiv에서 관찰한 탐색 행동의 변화. (a) 라운드별 최고 성능, (b) 라운드당 평가 시도 수. 출처: 프로젝트 페이지.
학습된 정책은 한 가지 방향으로만 변해 가지 않는다. 정책은 더 탐욕적으로 좁히지도, 더 넓게 벌리지도 않고 상황에 따라 행동을 바꾼다. ConvDiv에서 아홉 라운드 동안 라운드 최고 성능은 0.427, 0.625, 0.855, 1.403, 1.488, 1.499, 1.770, 1.880, 1.898로 올라간다. 같은 구간에서 라운드당 평가 시도의 수는 110, 110, 87, 80, 50, 92, 80, 91, 86으로 변한다. 성능이 개선되는 동안에는 110에서 50까지 계산을 아끼고, 진전이 멎으면 다시 92까지 늘린다. 그리고 그 확장 구간이 라운드 최고 점수의 다음 도약과 맞물린다.
프롬프트로 방향을 일러 주면 오히려 나빠진다
이쯤에서 누구나 떠올릴 만한 대안을 저자들이 직접 시험해 보았다. 과거의 궤적을 고수준의 방향성 통찰로 요약해 프롬프트에 넣는 방법이다. 저자들은 이 방법을 두 패러다임 양쪽에 적용해 ConvDiv에서 비교했다.
explicit directional guidance consistently underperforms its unguided counterpart across both paradigms under equivalent discovery budgets
같은 발견 예산에서 명시적인 방향 지시는 지시 없는 대조군보다 일관되게 낮은 성능을 냈다. 저자들의 해석은 이렇다. 병렬 스레드가 많은 긴 발견 과정에서는, 어디를 뒤질지 미리 정해 준 강한 의미적 지식이 탐색 공간을 지나치게 좁혀 다양한 탐색을 막는다.
내가 곱씹은 대목
승자가 현재 정책보다 나쁠 수 없다는 문장이 이 리포트에서 가장 많이 인용될 것 같다. 그 부등식은 고정된 이력 위에서 잰 평균 재생 점수에 대해서만 성립한다. 재생 점수가 온라인 성능을 얼마나 대변하는지는 별개의 질문이고, 리포트는 그 질문에 이론으로 답하지는 못한다. 여덟 과제의 실측으로 답을 대신한다. 실측이 좋으니 결론은 달라지지 않겠지만, 보장의 문구와 실측의 증거는 서로 다른 종류의 근거다.
기록 밖으로 나가려는 후보를 다루는 방식도 다시 읽었다. 정책이 기록에 없는 노드를 고르면 드러나는 것이 없고, 이어갈 기록이 없어진 시점에 재생이 끝난다. 벌점이 붙지도 않고 근사값으로 메워지지도 않는다. 그 경로는 아무 기록도 남기지 못한 채 지워진다. 그러므로 이 시뮬레이터가 높게 평가할 수 있는 정책은 이미 일어난 일을 더 좋은 순서로 다시 배열하는 정책으로 한정된다. 앞선 정책이 한 번도 가 보지 않은 방향으로 크게 벗어나려는 정책은 채점대에 오르지도 못한다.
저자들이 이 성질을 숨기지는 않는다. 초록에서부터 실현된 탐색 공간 위의 재생 시뮬레이터라고 적어 두었다. 그런데 36쪽 어디에도 한계를 따로 다루는 절이 없고 결론은 성과 요약으로 끝난다. 온라인 배포가 매 라운드 새 트리를 더하므로 재생할 세계들의 집합도 넓어진다는 반론은 리포트 안에 이미 들어 있다. 이 반론이 맞다면 초기 몇 라운드에 기록되는 세계의 다양성이 이후 결과 전체를 좌우한다. 나는 그 초기 의존성을 재는 실험이 다음 판에 들어가기를 기대한다.
세 번째로 눈에 걸린 것은 의미적 지시가 재생보다 못했다는 결과다. 사람이 좋은 말로 요약해 준 방향이, 기록을 그대로 다시 걷는 것보다 나쁜 결과를 냈다. 압축이 정보를 버린다는 일반론으로 정리할 수도 있다. 그런데 이 실험은 버려지는 것의 정체를 훨씬 좁게 지목한다. 실패한 가지의 위치와 그 가지가 얼마나 비쌌는지다. 요약문에 담기는 것은 무엇이 통했는가까지다. 무엇이 통하지 않았고 그 실패에 얼마가 들었는지는 트리에만 남는다.
출처
Tong Zheng 외 16명, “Dream-RSI: Recursive Self-Improvement through Evolving Worlds”, 테크니컬 리포트, 2026년. Google, University of Maryland College Park, Google DeepMind, University of Virginia.
- 프로젝트 페이지: https://dream-rsi.com/
- 리포트 PDF: https://dream-rsi.com/assets/dream-rsi.pdf
- 코드: https://github.com/zhengkid/Dream-RSI
본문에 실은 도식 네 장과 표지 그림은 프로젝트 페이지가 공개한 그림을 흰 여백만 정리해 인용했다. BibTeX의 arXiv 번호는 아직 기재되지 않았다. XXXX.XXXXX가 그대로 남아 있다.