3줄 요약
- 임페리얼 칼리지 런던(Imperial College London)의 리자 알프 귈러(Rıza Alp Güler)가 발표한 Dense4D는 단안 RGB 이미지 집합에서 신체, 의복, 머리카락의 픽셀 단위 4D 대응 관계와 3D 이동 궤적을 한 번의 순전파로 복원한다. 사전 정의된 인체 메시 템플릿도, 카메라 포즈 추정도 쓰지 않는다.
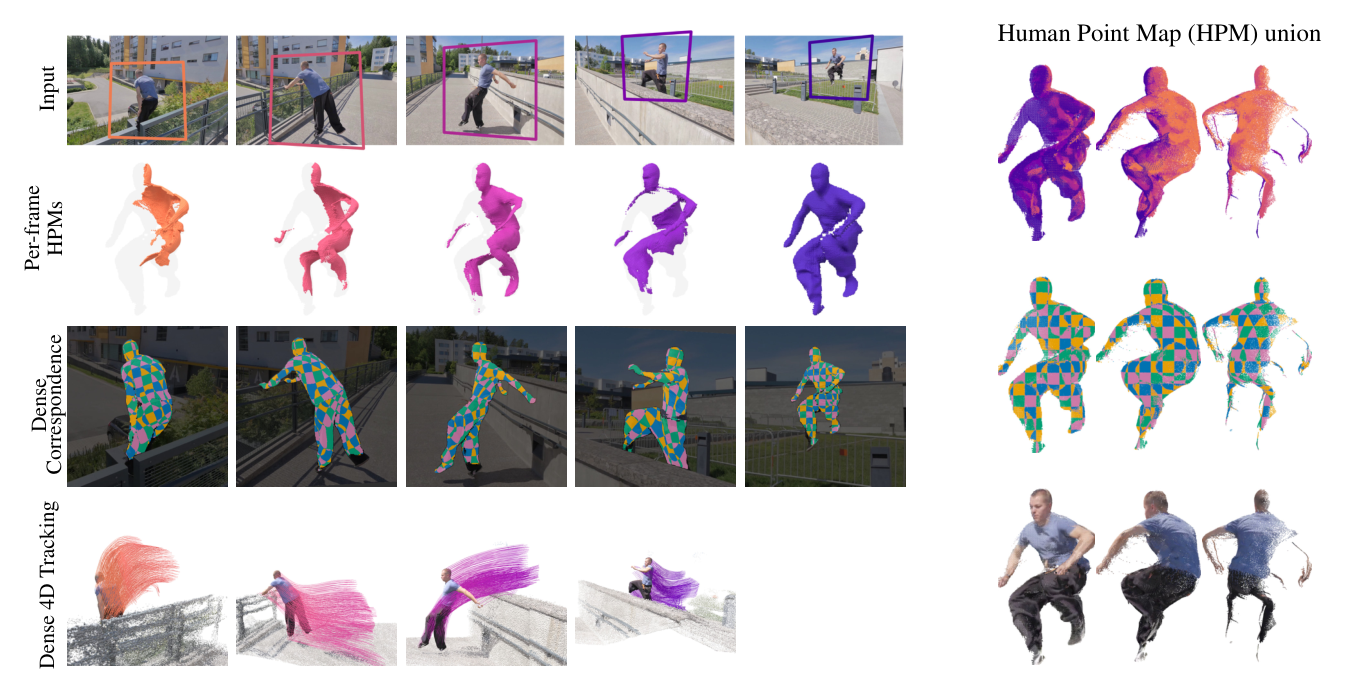
- 핵심은 인간 포인트 맵(Human Point Map, HPM)이다. 가상 카메라로 보정한 인물 크롭의 모든 픽셀에 대해, 그 픽셀이 기준 시점 인물 표면의 어디에 해당하는지를 3D 좌표로 직접 예측한다. 그 덕분에 기준 이미지에서 가려진 부위까지 대응시키는 아모달(amodal) 대응과 장기 3D 추적이 가능해졌다.
- 실사 벤치마크인 Panoptic Studio Humans 3D 점 추적에서 평균 자카드(AJ) 38.4점을 기록해 기존 상위 두 모델인 TAPIP3D(17.0점)와 V-DPM(16.9점)의 두 배 이상을 기록했다. 4D-DRESS 실측 스캔과의 평균 표면 오차는 0.86cm로, V-DPM(2.31cm)의 3분의 1 수준이었다.
신체 템플릿도 카메라 포즈 추정도 없이 구하는 4D 인간 대응 관계
비디오에서 움직이는 사람을 4차원(3차원 공간과 시간)으로 재구성하려면 관절이 굽혀지고 옷자락과 머리카락이 변형되며 가려졌다가 다시 나타나는 과정 내내 동일한 표면 지점을 식별해야 한다. 각 프레임을 독립적으로 3D 복원하는 방식만으로는 시간에 따른 표면 점들의 대응 관계(correspondence)를 알 수 없다.
기존의 인체 대응 관계 연구는 주로 이미지 픽셀을 SMPL이나 DensePose 같은 공통 신체 템플릿의 해부학적 좌표에 매핑하는 방식을 썼다.1 하지만 정해진 신체 템플릿은 피부가 드러난 몸통과 사지의 위상만 표현할 뿐, 몸과 독립적으로 흔들리는 헐렁한 겉옷이나 긴 머리카락의 기하학적 형상과 변형은 직접 표현하지 못한다. 반대로 최근의 4D 동적 장면 재구성 모델들(V-DPM, 4RC, St4RTrack 등)은 템플릿 없이 장면 전체의 기하 구조와 점의 이동, 카메라 포즈를 동시에 추정한다. 카메라의 큰 이동과 배경의 변화, 인물의 비강체 변형을 한꺼번에 추정해야 하는 탓에 인물 표면의 시간적 정합성은 낮아진다. 여러 프레임의 관측을 합치면 팔다리가 여러 겹으로 어긋나는 현상이 생긴다.
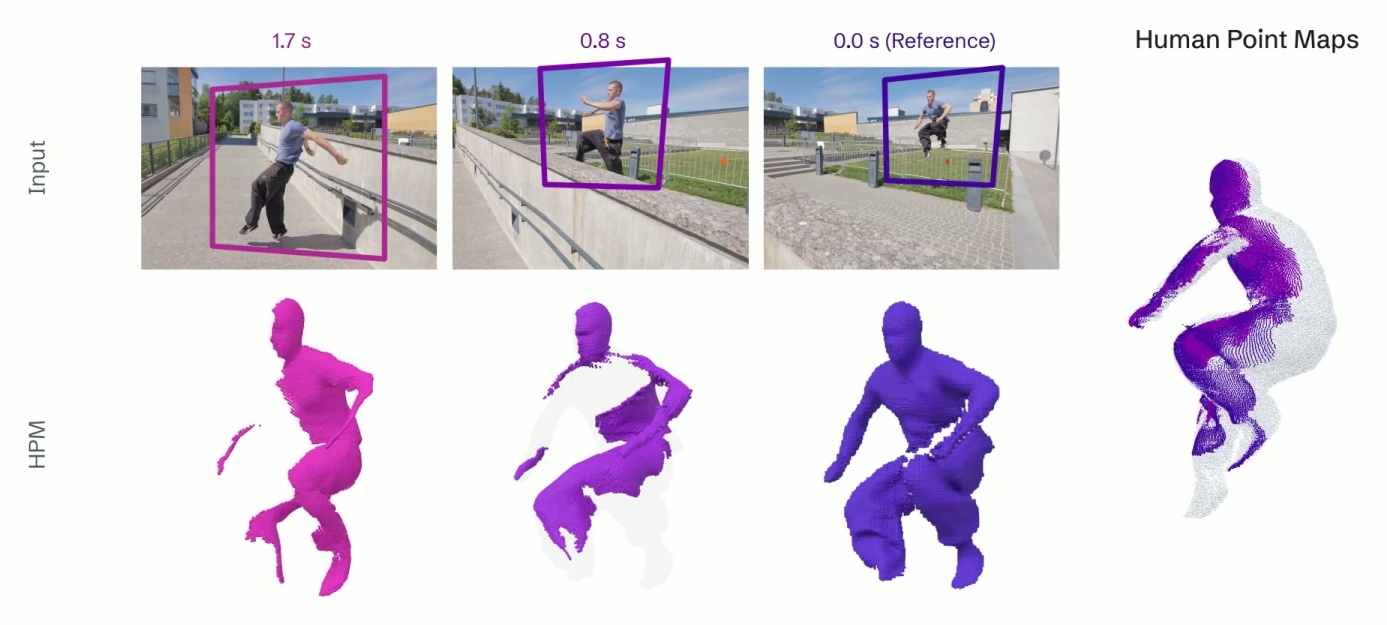 세 시점(0.0초, 0.8초, 1.7초)의 입력 프레임에서 추출한 인물 크롭과 각 프레임에서 예측한 인간 포인트 맵(HPM), 그리고 이들을 기준 시점(0.0초) 자세 하나로 합친 점군. 출처: Dense4D 프로젝트 페이지
상향식으로 장면 전체를 복원할 때 생기는 문제와 고정된 신체 템플릿의 한계를 함께 해결하기 위해, Dense4D는 하향식(top-down) 인물 중심 접근을 도입했다. 배경을 재구성하거나 월드 카메라 포즈를 추정하는 과정은 생략하고, 장면에서 분리해 낸 인물 크롭들만으로 픽셀 단위의 4D 대응 관계를 직접 학습한다.
Dense4D가 제안하는 핵심 표현은 인간 포인트 맵(Human Point Map, HPM)이다. HPM은 각 프레임 $t$의 모든 인물 픽셀 $p \in M_t$마다 3차원 좌표 $X_t(p) \in \mathbb{R}^3$를 하나씩 할당한다. 이 좌표는 그 픽셀이 가리키는 표면 지점이 공통 기준 시점(reference time)에 있던 위치이고, 기준 시점은 첫 번째 입력 프레임($r=1$, 그림에서는 0번 프레임)이다. 모든 프레임의 HPM 좌표는 기준 프레임의 가상 카메라 좌표계를 공유한다. 따라서 서로 다른 프레임에서 관측된 픽셀이라도 인물의 같은 부위(예컨대 왼쪽 소매 끝이나 오른쪽 무릎)를 담고 있다면 같은 HPM 3D 좌표를 받는다.
이 표현은 기준 이미지에서 보이지 않는 부위까지 대응시키는 아모달(amodal) 특성을 자연스럽게 지원한다. 예를 들어 기준 프레임의 인물이 정면을 보고 있어 등이 가려져 있어도, 나중 프레임에서 돌아서서 뒷모습이 드러나면 HPM은 그 픽셀들이 기준 시점의 등 표면 어디에 해당하는지 예측한다. 모든 입력 프레임의 HPM 예측값을 하나의 공간에 합치면(HPM union), 별도의 신체 템플릿 없이도 기준 시점의 온전한 3D 인체와 의복, 머리카락 형상이 조합된다.
| 접근 방식 | 대표 모델 | 좌표계와 표현 | 의복과 머리카락 표현 | 주요 한계 |
|---|---|---|---|---|
| 신체 템플릿 매핑 | DensePose, SMPL 계열 | 사전 정의된 공통 인체 메시(UV/정점) | 불가능 (맨몸 위상만 표현) | 헐렁한 겉옷과 긴 머리카락의 독립적 변형 누락 |
| 전체 동적 장면 복원 | V-DPM, 4RC, St4RTrack | 월드 카메라 좌표계 + 장면 포인트 맵 | 가능 (표면 점군) | 카메라 이동과 비강체 변형 동시 추정 시 인물 정합 붕괴 |
| 인물 중심 HPM (Dense4D) | Dense4D | 기준 시점 가상 카메라의 인물 3D 표면 | 가능 (신체, 의복, 머리카락 통합) | 자기 접촉 시 기준 시점 3D 좌표 모호성 |
인간 포인트 맵과 가상 카메라 크롭 아키텍처
Dense4D는 추론할 때 한 인물을 찍은 $S$장의 단안 RGB 이미지 집합 $\{I_t\}_{t=1}^S$, 인물 전경 마스크 $M_t$, 그리고 각 이미지의 초점 거리 $f_t$만 입력받는다. 월드 좌표계에서의 카메라 위치나 회전은 입력받지도 않고 예측하지도 않는다. 입력 프레임의 순서도 시간순일 필요가 없다.
먼저 각 프레임에 가상 카메라 회전 $R_{v,t}$를 적용한다. 카메라 중심은 고정한 채, 인물 마스크와 초점 거리 $f_t$로 카메라가 인물 바운딩 박스의 중심을 정면으로 바라보게 돌린다. 카메라 중심이 고정되어 있으므로 원본 이미지 평면과 $512 \times 512$ 해상도의 정사각형 가상 크롭 평면은 장면의 깊이와 무관한 평면 호모그래피(planar homography) $H_t = K_{v,t} R_{v,t} K_t^{-1}$로 정확히 변환된다.2 여기에 원본 카메라에서 바운딩 박스 중심을 향하는 단위 광선 벡터 $(R_{v,t})_{3,:}$와 정규화된 가상 초점 거리의 로그값 $\log(f_{v,t}/\ell)$을 묶어 4차원 크롭 기하 벡터 $c_t \in \mathbb{R}^4$를 만든다.
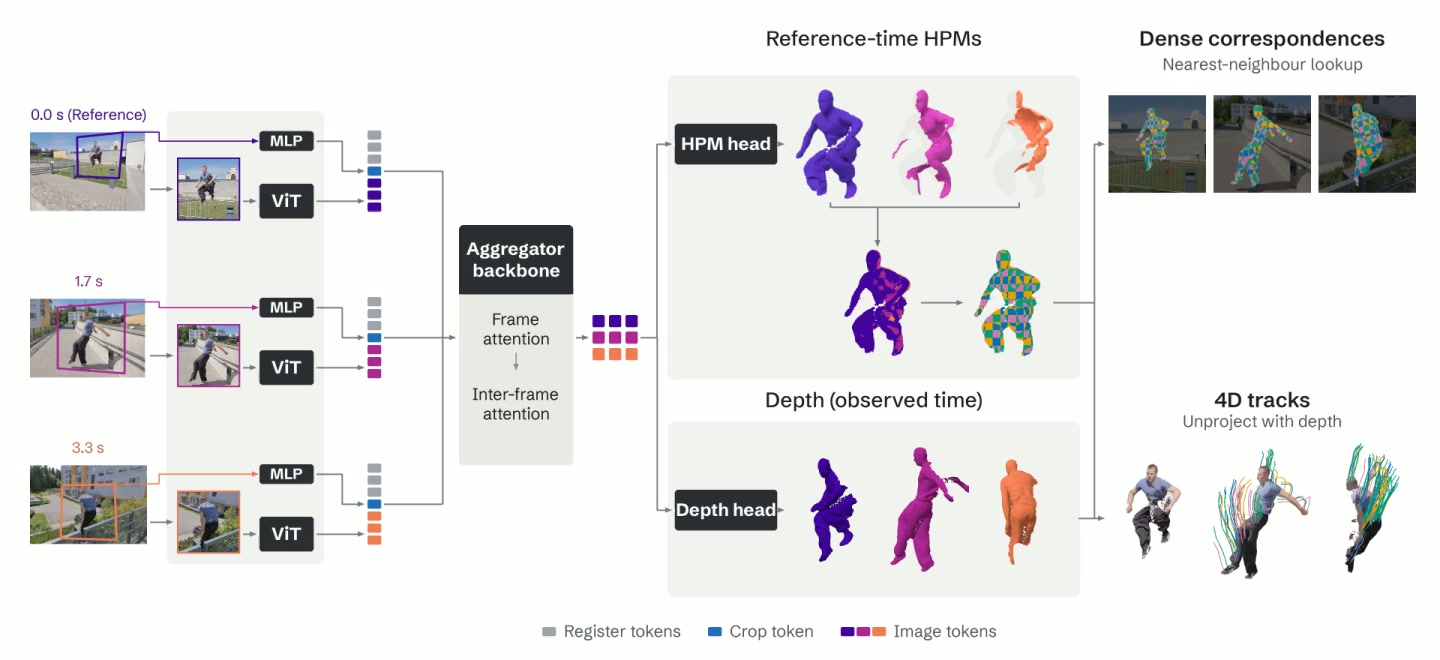 Dense4D 아키텍처. 어그리게이터가 인물 중심 크롭 이미지와 크롭 기하 토큰을 프레임 내부와 프레임 간 어텐션으로 함께 처리한 뒤, 두 개의 밀집 헤드가 기준 시점 HPM과 관측 시점 깊이를 한 번의 순전파로 예측한다. 출처: Dense4D 프로젝트 페이지
학습 목표가 되는 기준 시점 HPM 좌표 $X_t(p)$와 관측 시점의 광축 깊이 $D_t(p)$는 공통 정규화 스케일 $s$를 사용해 다음과 같이 정의된다.
$$X_t(p) = \frac{1}{s} E_{v,r} \begin{bmatrix} x_{t \to r}(p) \\ 1 \end{bmatrix}, \quad D_t(p) = \frac{1}{s} \begin{bmatrix} 0 & 0 & 1 \end{bmatrix} E_{v,t} \begin{bmatrix} x_{t \to t}(p) \\ 1 \end{bmatrix}$$여기서 $x_{t \to u}(p)$는 프레임 $t$의 픽셀 $p$에서 관측된 표면 점이 시점 $u$에 갖는 월드 좌표이고, $E_{v,t} \in \mathbb{R}^{3 \times 4}$는 월드 좌표를 프레임 $t$의 가상 카메라 좌표계로 변환하는 외부 파라미터 행렬이다. 정규화 스케일 $s$는 기준 가상 카메라의 중심과 기준 시점 표면 점들 사이의 평균 거리다. 정규화된 공간에서 예측하므로 모델은 인물의 절대적인 신체 크기나 카메라까지의 실제 미터 단위 거리를 직접 복원하지 않는다. 인물이 장면에서 먼 거리를 이동하더라도 스케일 변화에 좌우되지 않고, 오직 인물 표면의 대응 관계를 정밀하게 맞추는 데 집중할 수 있다.
| 구성 모듈 | 입력 및 내부 구조 | 출력 및 역할 | 파라미터 규모 |
|---|---|---|---|
| 이미지 인코더 | $512 \times 512$ 가상 크롭, 패치 크기 16의 DINOv3-L ViT | 프레임당 1,024차원 패치 토큰 1,024개 생성 | 백본 포함 총 974M |
| 조건 및 상태 토큰 | 4차원 크롭 기하 벡터 $c_t$를 2층 MLP(GELU)로 임베딩 | 크롭 토큰 1개 + 카메라 토큰 1개 + 레지스터 토큰 16개 결합 | 기준/비기준 전용 토큰 분리 |
| 교차 어그리게이터 | 프레임 내부 및 프레임 간 어텐션 24쌍 반복 (VGGT-$\Omega$ 기반) | 19개 블록은 전체 토큰, 5개 블록(2, 6, 9, 14, 20번)은 비패치 토큰만 갱신 | 다중 프레임 정보 동시 교환 |
| HPM 및 깊이 헤드 | 4, 11, 17, 23번 블록 특징을 RefineNet + 픽셀 셔플로 융합 | 기준 시점 3D 좌표 $\hat{X}_t$, 관측 깊이 $\hat{D}_t$, 신뢰도 $\sigma_i^k \ge 1$ 예측 | 헤드당 32.3M (총 64.6M) |
네트워크 아키텍처는 VGGT-$\Omega$(Wang et al., 2026)의 이미지 인코더와 어그리게이터(aggregator) 구조를 기반으로 설계되었으며 전체 파라미터 수는 약 9억 7,400만 개(974M)다. 첫 번째 프레임이 기준 시점임을 구별하기 위해 기준 프레임은 전용 카메라 토큰과 레지스터 토큰을 쓰고, 나머지 프레임들은 두 번째 토큰 세트를 공유한다. 밀집 예측 헤드는 두 개이고 각각 3,230만 파라미터 규모다. 두 헤드는 어그리게이터의 중간 특징을 받아 한 번의 순전파로 모든 프레임의 기준 시점 좌표 $\hat{X}_t$와 관측 시점 깊이 $\hat{D}_t$를 함께 출력한다.
기준 시점 좌표 $\hat{X}_t$와 관측 시점 깊이 $\hat{D}_t$가 구해지면 별도의 시간 추적기(tracker)나 모션 디코더는 쓰지 않는다. 프레임 $t$의 질의 픽셀 $p$에 대응하는 목표 프레임 $u$의 픽셀 $\hat{q}$는 최근접 이웃 탐색(nearest-neighbour lookup)만으로 찾는다.
$$\hat{q}(p; t \to u) = \arg\min_{q \in M_u} \|\hat{X}_u(q) - \hat{X}_t(p)\|_2$$탐색 대상은 목표 프레임의 인물 마스크 $M_u$ 내부 픽셀들이다. 매칭된 두 픽셀의 HPM 좌표 거리(잔차)가 임계값 $\tau = 0.005$ 미만이면 그 시점에 점이 보이는 것(visible)으로, 그 이상이면 가려진 것(occluded)으로 판정한다.3 마지막으로 매칭된 목표 픽셀 $\hat{q}$에 목표 프레임의 예측 깊이 $\hat{D}_u(\hat{q})$와 가상 카메라 역변환을 적용해 3차원 공간으로 역투영(unproject)하면 4D 이동 궤적 $\hat{T}_{t,p}(u)$가 완성된다. 목표 프레임의 실제 인물 픽셀을 먼저 찾고 그 픽셀의 예측 깊이로 3D 좌표를 구하기 때문에, 복원된 3D 궤적은 언제나 그 프레임에서 예측된 인물 표면과 일치한다.
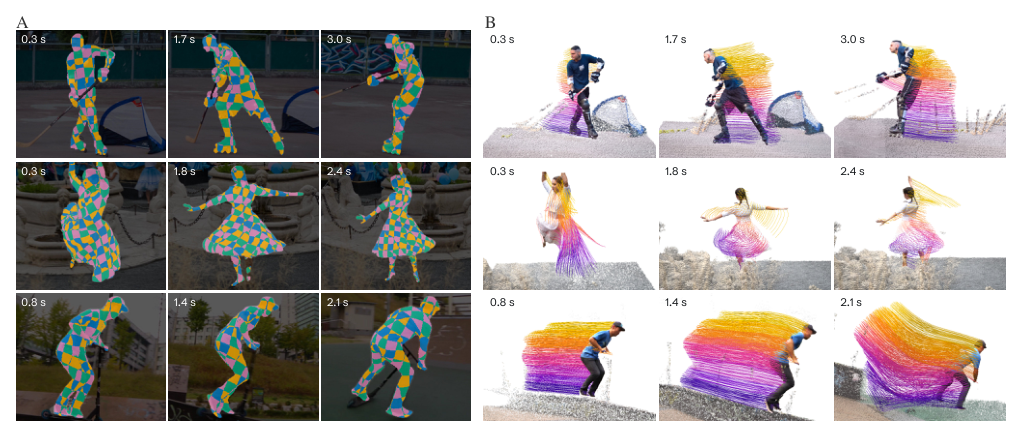 최근접 이웃 탐색과 깊이 역투영으로 복원한 픽셀 단위 대응 관계(A)와 4D 이동 궤적(B). 회전하는 치마와 빠른 스포츠 동작에서도 시간적 정합이 유지된다. 출처: arXiv:2610.22325
신체와 의복, 머리카락을 아우르는 표면 지도 학습
Dense4D가 신체 템플릿 없이도 옷주름과 머리카락의 대응 관계를 학습할 수 있었던 비결은 세 가지 데이터를 결합한 정밀한 표면 라벨(surface supervision)에 있다. 학습에는 합성 인체 모션 데이터셋인 BEDLAM2, 정적 실사 3D 인체 스캔을 다양한 시점에서 렌더링한 THuman2.1, 그리고 여러 사람의 상호작용과 내려다보는 카메라 시점을 보완하는 합성 데이터인 MammaSyn을 각각 65%, 22%, 13% 비율로 샘플링해 사용했다.
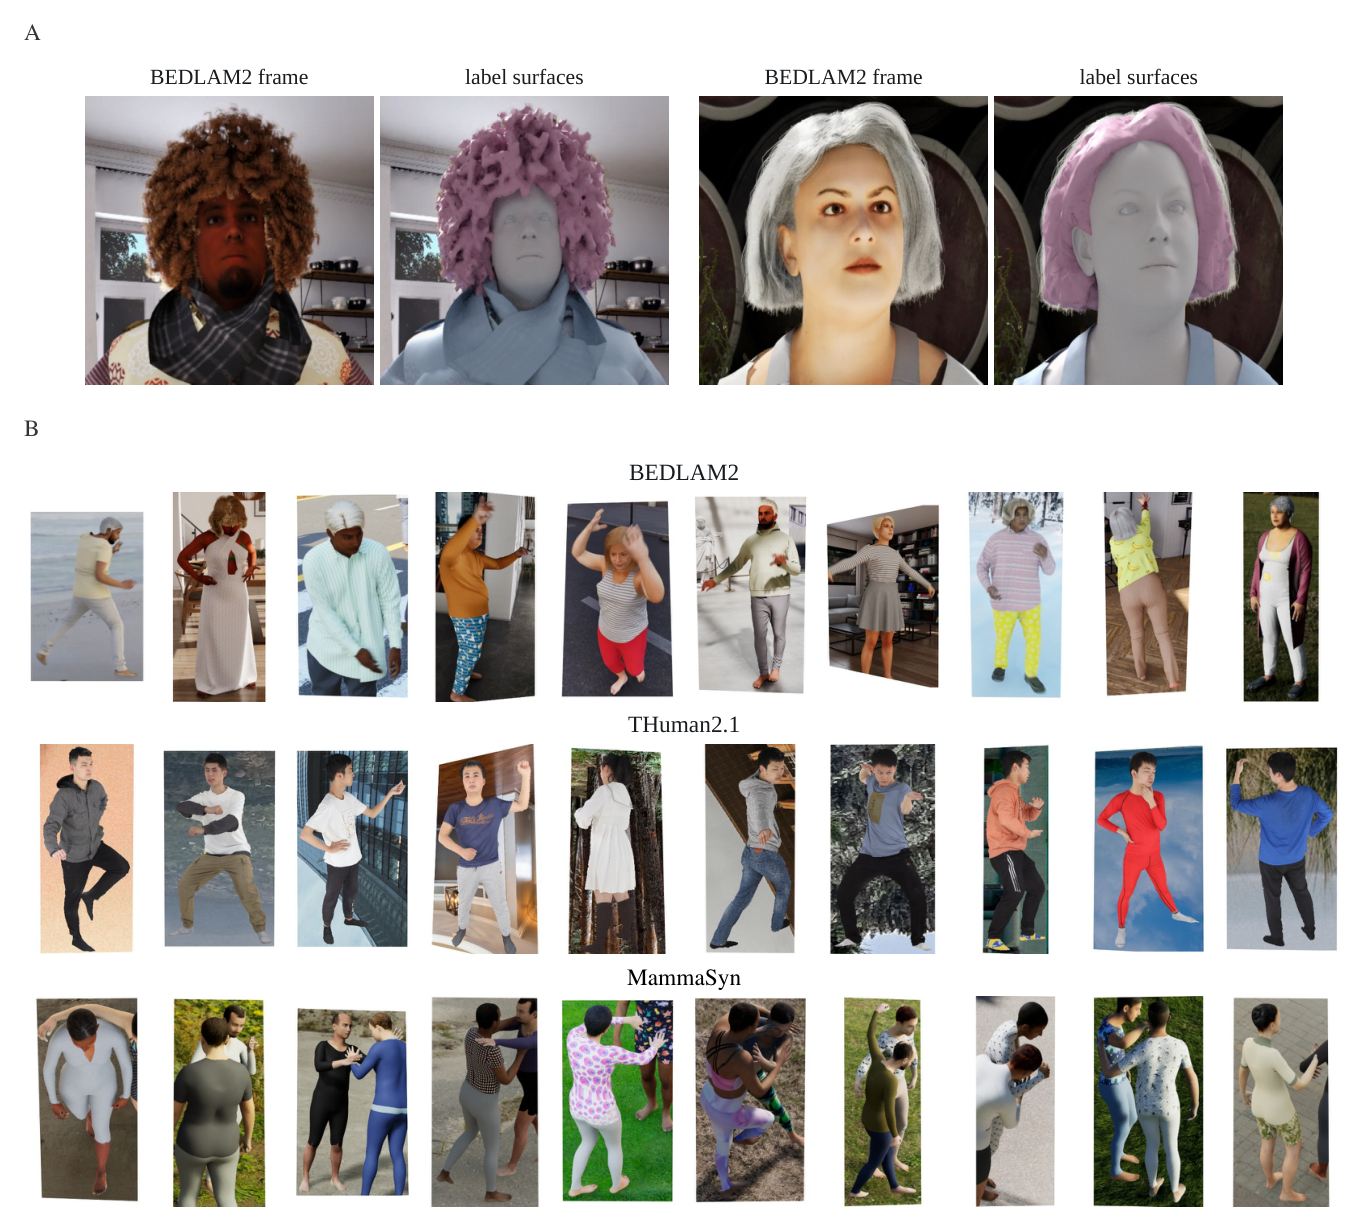 (A) BEDLAM2 이미지와 지도 학습에 사용된 신체, 의복, 머리카락 엔벨로프 표면 메시. (B) BEDLAM2, THuman2.1, MammaSyn에서 추출한 학습용 인물 크롭 샘플. 출처: arXiv:2610.22325
세 데이터셋 모두 시간에 따라 정점(vertex)과 삼각형 면(face) 인덱스가 일관되게 유지되는 3D 메시를 제공한다. BEDLAM2는 SMPL-X 신체 메시와 고정 위상 의복 메시를 제공하지만, 머리카락은 개별 머리카락 가닥(strand)으로 렌더링되어 그대로 표면 대응 학습에 쓰기 어렵다. 머리카락에도 일관된 표면 라벨을 부여하기 위해, 가닥 전체의 외곽을 감싸는 엔벨로프(envelope) 메시를 별도로 생성했다. 각 헤어 그룸(groom)의 가닥 밀도장(density field)에서 값이 0.3인 등가면(레벨셋)을 추출하고, 안쪽으로 3mm 오프셋한 뒤, 면 개수를 25%로 줄였다. 이 메시는 머리 메시의 삼각형에 묶여 머리와 함께 움직인다. 렌더러가 만든 실제 헤어 매트(matte)와 비교하면 정밀도는 약 92%, 재현율은 84%였다. 학습 라벨 전체에서 신체, 의복, 머리카락 픽셀이 차지하는 비중은 각각 21%, 71%, 8%다.
래스터화 단계에서는 각 픽셀 $p$가 속한 삼각형의 인덱스 $\phi_t(p)$와 원근 보정된 무게중심 좌표(barycentric coordinates) 가중치 $\omega_{t,p,m}$을 함께 저장한다. 이 가중치를 기준 시점 메시에서 같은 삼각형의 정점 $V_r[m]$에 그대로 적용하면 기준 시점의 정확한 3D 표면 좌표 $x_{t \to r}(p) = \sum_{m \in F[\phi_t(p)]} \omega_{t,p,m} V_r[m]$을 얻는다.
| 학습 데이터셋 | 데이터 유형 및 규모 | 샘플링 비중 | 표면 메시 구성 및 역할 |
|---|---|---|---|
| BEDLAM2 | 합성 인체 모션 비디오 (27,727개 트랙, 약 125만 프레임) | 65% | SMPL-X 신체 + 시뮬레이션 의복 + 가닥 밀도장 기반 머리카락 엔벨로프 메시 |
| THuman2.1 | 정적 실사 3D 인체 스캔 다중 시점 렌더링 (2,200개 스캔 × 50시점) | 22% | 의복과 머리카락을 포함한 고해상도 실사 표면 스캔, 광각 및 근접 시점 보강 |
| MammaSyn | 여러 사람의 상호작용 합성 비디오 (15,710개 인물 트랙) | 13% | 피사체 간 가림(occlusion) 및 위에서 내려다보는 하이앵글 카메라 시점 보완 |
손실 함수는 DUSt3R, VGGT와 동일한 신뢰도 가중 손실에 상위 2% 극단값을 잘라내는 98백분위수 절삭 연산자 $Q_{.98}$을 결합한 형태다. HPM 좌표 오차 $r_i^{\text{pt}} = \|\hat{X}_i - X_i\|_2$와 깊이 오차 $r_i^{\text{dp}} = |\hat{D}_i - D_i|$에 대해 각각 다음 손실을 계산해 동일한 가중치로 합산한다.
$$L_k = Q_{.98}\left(\left\{r_i^k \sigma_i^k - 0.2 \log \sigma_i^k\right\}_i\right) + Q_{.98}\left(\left\{r_i^k\right\}_i\right), \quad k \in \{\text{pt}, \text{dp}\}$$상위 2%의 오차를 평균에서 빼서 메시 경계나 급격한 가림 경계에서 생기는 노이즈 라벨이 학습을 불안정하게 만드는 현상을 막았다. 모델은 NVIDIA GH200 GPU 4대에서 배치당 96장의 이미지로 총 68만 6,000스텝, 약 490시간 동안 학습되었다. 시퀀스당 프레임 수 $S$는 $\{2, 3, 4, 6, 8, 12, 24\}$에서 혼합 샘플링했다.
Panoptic Studio 3D 추적과 4D-DRESS 아모달 복원
합성 데이터와 정적 스캔만으로 학습된 Dense4D가 실제 촬영된 동적 인물 영상에서 얼마나 정확하게 작동하는지는 두 가지 정량 평가로 확인했다.
첫 번째 평가는 Panoptic Studio Humans 벤치마크다. TAPVid-3D의 Panoptic Studio는 여러 사람이 공놀이나 스포츠를 하는 모습을 캡처 돔에서 촬영한 영상이고, 이 벤치마크는 그중 인물 질의점만 모았다. 규모는 150프레임 클립 156개, 인물 질의점 총 40,779개다. 인물 마스크는 SAM 3로 추출했고, 장면 내 인물 간 상대적인 스케일은 VGGT-$\Omega$의 깊이 비율 중앙값으로 맞췄다. 평가 지표는 위치와 가시성 정확도를 결합한 평균 자카드(AJ), 깊이 적응형 임계값 내 점들의 평균 비율(APD), 가림 판정 정확도(OA) 세 가지다.
| 모델 | AJ (↑) | APD (↑) | OA (↑) |
|---|---|---|---|
| Dense4D (본 논문) | 38.4 | 50.3 | 89.6 |
| TAPIP3D | 17.0 | 27.1 | 85.2 |
| V-DPM† | 16.9 | 27.6 | 76.7 |
| SpatialTrackerV2 | 15.5 | 24.4 | 78.7 |
| 4RC† | 14.4 | 24.1 | 76.6 |
| Shape of Motion | 12.5 | 21.3 | 80.7 |
| Any4D† | 7.3 | 13.6 | 76.6 |
Dense4D는 AJ 38.4점, APD 50.3점, OA 89.6점을 기록했다. 세 지표 모두 비교 모델보다 높았고, AJ와 APD에서는 격차가 특히 컸다.4 지표마다 가장 높은 비교 모델과 견줘도, AJ는 3D 점 추적 전용 모델 TAPIP3D(17.0점)보다 21.4점, APD는 동적 포인트 맵 기반 V-DPM(27.6점)보다 22.7점 높다. 별도의 시간 평활화(temporal smoothing)나 모션 모델 없이 각 프레임의 HPM 최근접 이웃 탐색만으로 얻은 결과다.
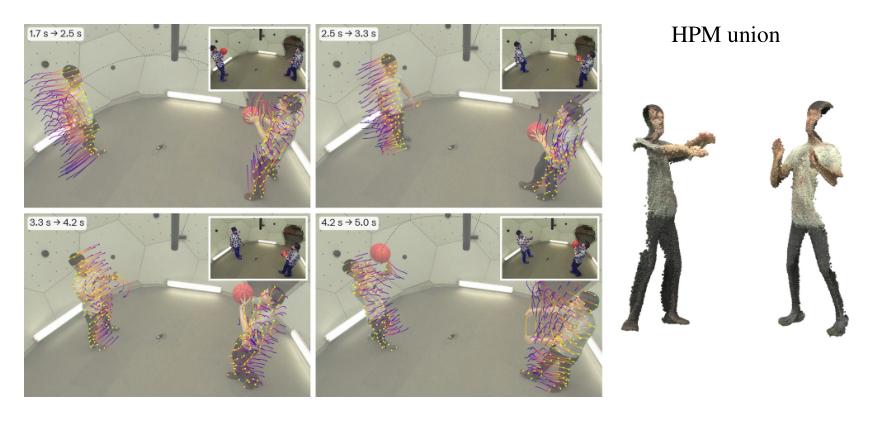 Panoptic Studio Humans 추적 결과. 왼쪽은 1.7초부터 5.0초까지 농구공을 주고받는 두 인물의 3D 궤적이며, 오른쪽은 150프레임 전체에서 관측된 픽셀들을 각 인물의 기준 시점 자세로 모은 HPM 합집합이다. 출처: arXiv:2610.22325
두 번째 평가는 4D-DRESS 데이터셋에서 수행한 아모달(amodal) 3D 위치 추정이다. 4D-DRESS는 일상복과 헐렁한 겉옷을 입은 실제 사람들의 움직임을 동기화된 카메라와 3D 스캐너로 촬영한 데이터셋이다. 동적 테이크 128개마다 첫 프레임을 기준 시점으로 삼아 16프레임 윈도우를 입력했다. 16개 프레임의 인물 픽셀을 모두 기준 시점 공간에 모은 합집합 점군이 실제 3D 스캔 표면과 얼마나 일치하는지는 단방향 점-스캔 거리(point-to-scan distance)로 측정했다. 기준 프레임 하나만으로는 인물의 앞면이나 옆면 일부만 보이기 때문에, 다른 프레임에서 관찰된 뒷면과 가려진 옷자락까지 기준 시점의 올바른 3D 위치로 가져와야 오차가 줄어든다.
| 모델 | 평균 오차 (cm, ↓) | > 2cm 비율 (%, ↓) | > 5cm 비율 (%, ↓) | 기준 프레임 오차 (cm) | 비기준 프레임 오차 (cm) |
|---|---|---|---|---|---|
| Dense4D (본 논문) | 0.86 | 6.8 | 0.1 | 0.80 | 0.87 |
| V-DPM | 2.31 | 41.5 | 9.1 | 1.64 | 2.36 |
| 4RC | 4.84 | 53.4 | 20.7 | 4.07 | 4.89 |
각 모델이 스스로 매긴 신뢰도 하위 5% 점을 뺀 조건에서, Dense4D의 16프레임 합집합 점군과 실제 3D 스캔 표면 사이의 평균 거리는 0.86cm였다. V-DPM(2.31cm)과 4RC(4.84cm)에 비해 오차가 3분의 1에서 5분의 1 수준으로 작다. 표면에서 2cm 이상 벗어난 외곽 오차 점의 비율 역시 V-DPM은 41.5%, 4RC는 53.4%에 달했으나 Dense4D에서는 6.8%로 낮아졌다.
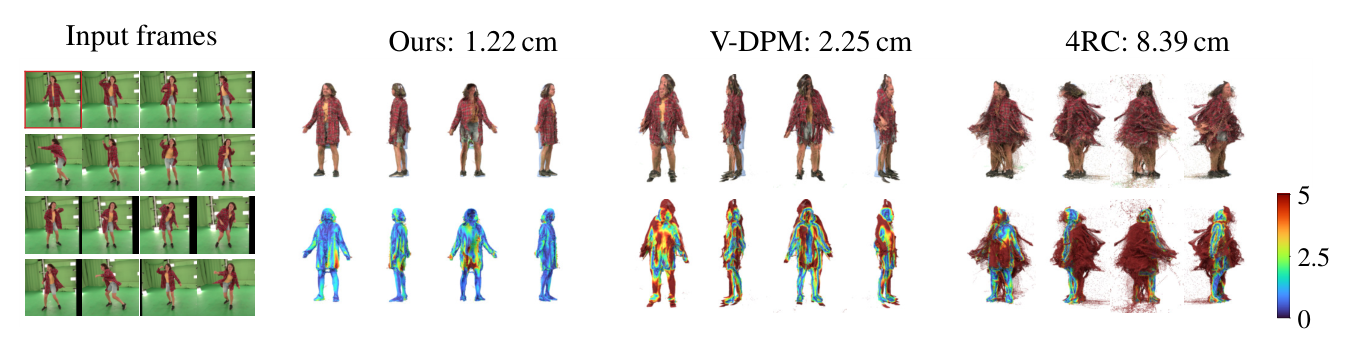 4D-DRESS의 16개 프레임(빨간 테두리가 기준 프레임)을 기준 시점 자세로 모은 결과. 윗줄은 원본 색상을 입힌 점군과 실측 스캔(청회색)의 중첩이고, 아랫줄은 실측 스캔까지의 거리(0cm는 파란색, 5cm는 빨간색)다. 출처: arXiv:2610.22325
특히 주목할 만한 수치는 기준 프레임과 비기준 프레임 사이의 오차 차이다. V-DPM은 기준 프레임 오차가 1.64cm에서 비기준 프레임 2.36cm로 커지고, 4RC도 4.07cm에서 4.89cm로 커지며 시간이 지날수록 오차가 누적된다. 반면 Dense4D에서 측정된 오차는 기준 프레임 픽셀이 0.80cm, 다른 시점 프레임에서 모은 픽셀이 0.87cm로 두 값의 차이가 0.07cm 남짓이다. 약 4초 동안 오차는 기준 프레임과 0.1cm 안팎의 차이를 일정하게 유지했다. 신뢰도 하위 점을 하나도 빼지 않은 조건(0% 절삭)에서도 평균 오차는 0.93cm였다.
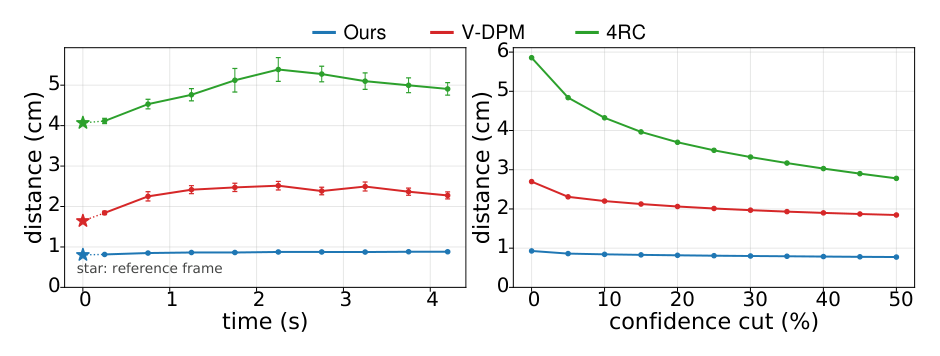 4D-DRESS에서 시간에 따른 표면 오차 변화(왼쪽)와 신뢰도 하위 점 절삭 비율에 따른 오차 변화(오른쪽). 별표는 기준 프레임의 오차다. 출처: arXiv:2610.22325
한편 가상 카메라 크롭 조건화 벡터 $c_t$의 역할은 절제 실험(ablation)으로 확인했다. 크롭 임베딩을 아예 빼면 BEDLAM2 재구성 오차가 2.99cm에서 4.06cm로 늘고, Panoptic Studio Humans의 AJ는 38.4점에서 30.4점으로 떨어졌다. 흥미롭게도 추론할 때 크롭 확대 배율(zoom)만 남기고 중심 광선 방향의 세 채널을 $(0, 0, 1)$로 고정해도, 성능은 최종 모델과 소수점 둘째 자리까지 같았다(AJ 38.4, APD 50.3, BEDLAM2 2.99cm). 회전 호모그래피 보정이 이미 크롭의 시선 방향을 인물 정면으로 정렬해 주었기 때문에, 네트워크에 실질적으로 필요한 조건 정보는 크롭의 확대 배율이었다는 뜻이다.
| 조건화 변형 | Panoptic AJ (↑) | Panoptic APD (↑) | Panoptic OA (↑) | BEDLAM2 오차 (cm, ↓) |
|---|---|---|---|---|
| 크롭 조건화 제거 | 30.4 | 41.4 | 89.3 | 4.06 |
| 중심 광선 $(0,0,1)$ 고정 + 크롭 줌 유지 | 38.4 | 50.3 | 89.6 | 2.99 |
| 최종 모델 (4채널 전체 사용) | 38.4 | 50.3 | 89.6 | 2.99 |
학습 때는 최대 24프레임까지만 입력했다. 추론 단계에서 BEDLAM2의 16초 시퀀스를 대상으로 입력 프레임 수를 4개부터 96개까지 늘려 한 번에 넣었을 때도, 재구성 오차는 3.5~3.7cm, 점-표면 거리는 0.87~0.92cm 범위를 유지했다.
일반 영상의 표면 일관성과 86초 단일 순전파 추적
통제된 스튜디오 밖의 일반 영상(DAVIS와 Pexels 비디오)에서도 Dense4D의 대응 관계는 일관되게 유지된다. 논문은 DAVIS 영상에서 두 가지 방향의 시각적 검증을 제시한다.
- 역방향(기준 시점) 집계: 여덟 프레임에서 관측된 인물 픽셀들을 모두 $t=0$ 기준 시점 공간에 모았을 때, V-DPM과 4RC는 프레임마다 인물 형상이 조금씩 어긋나 팔다리가 여러 개로 겹친 잔상을 남기지만, Dense4D는 회전하는 무용수의 치마 주름과 팔다리 윤곽을 한 겹의 표면으로 맞춘다.
- 순방향(목표 시점) 전달: $t=0$ 프레임의 픽셀 색상을 대응 관계에 따라 이후 시점 $t$의 표면에 전달해 그렸을 때, 기존 동적 장면 모델들이 복원한 목표 시점의 인물 표면 자체는 그럴듯해 보이지만, $t=0$에서 전달된 점들은 표면 안쪽이나 허공에 흩어지거나 신체 부위가 아닌 곳에 배치된다. 그에 비해 Dense4D는 목표 프레임의 인물 마스크 내부 픽셀에 매칭해 그 깊이로 표면을 그리므로, 전달된 점들과 복원된 표면이 구조상 항상 일치하며 머리부터 발끝까지의 위상 순서가 보존된다.
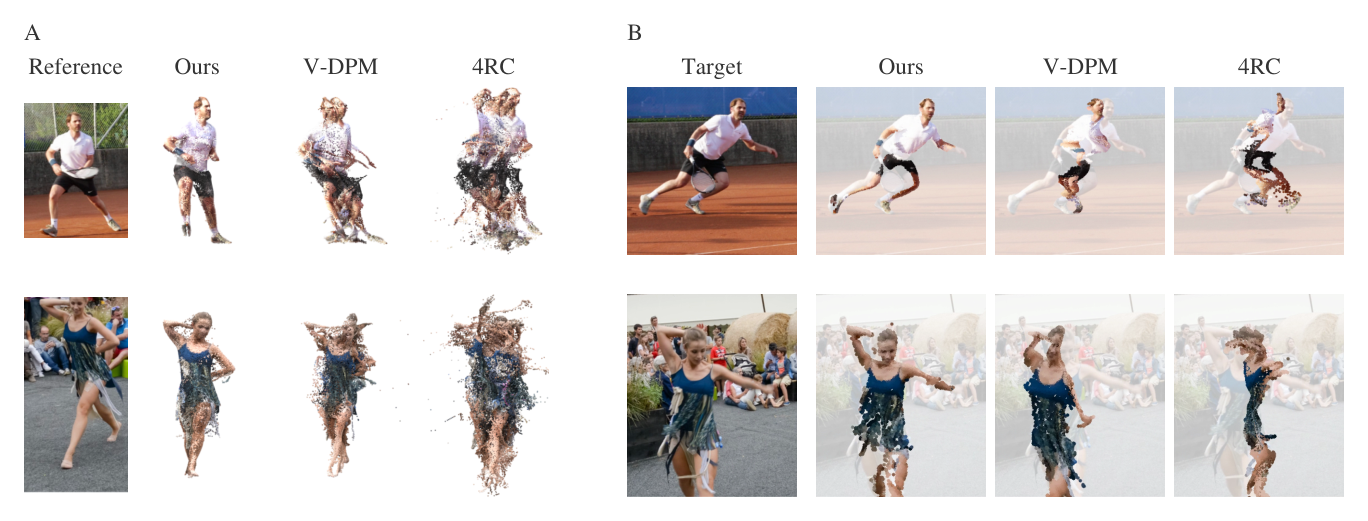 DAVIS 영상에서의 표면 일관성 비교. (A) 여러 프레임의 인물 픽셀을 0번 프레임 기준 자세로 합친 점군. (B) 0번 프레임의 픽셀들을 목표 프레임의 대응 위치로 전달해 원본 색상으로 그린 결과. 출처: arXiv:2610.22325
Dense4D는 인접 프레임 사이의 움직임을 차례로 이어 붙이는(chaining) 방식을 쓰지 않는다. 모든 프레임을 공통 기준 시점의 HPM으로 직접 매칭하므로, 긴 영상도 드리프트(누적 오차) 없이 한 번의 순전파로 추적할 수 있다. 논문에서는 패들보드를 타는 사람의 86초짜리 영상(초당 15프레임 샘플링, 총 1,287프레임) 전체를 네트워크 순전파 한 번으로 처리해 3D 이동 궤적을 복원한 사례를 제시한다.
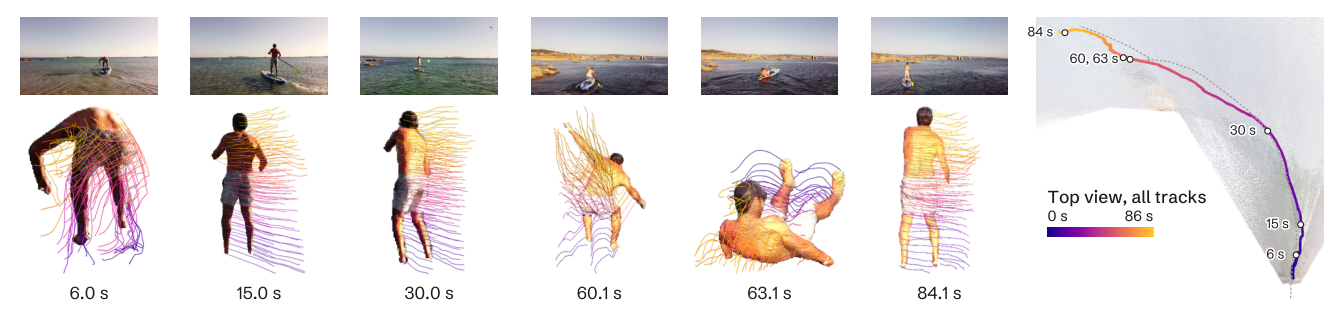 86초(1,287프레임) 영상의 단일 순전파 추적 결과. 왼쪽은 6.0초부터 84.1초까지 주요 시점의 1초 궤적 구간(신체 높이에 따라 색상 부여)이고, 오른쪽은 VGGT-$\Omega$로 복원한 해변 장면 위에 표시한 86초 전체의 인물 이동 경로와 카메라 경로(점선)다. 출처: arXiv:2610.22325
인터넷 비디오($1280 \times 720$)를 처리하는 전체 파이프라인은 세 단계다. SAM 3로 인물 마스크를 추출하고, VGGT-$\Omega$($512 \times 288$)로 배경 장면과 카메라를 복원한 뒤, Dense4D($512 \times 512$ 크롭)로 인물의 4D 대응과 궤적을 복원한다. NVIDIA GH200 GPU 한 대에서 잰 실행 시간과 최대 메모리 사용량은 다음과 같다.
| 입력 프레임 수 | SAM 3 (1280×720) | VGGT-$\Omega$ (512×288) | 크롭 생성 및 출력 (CPU) | Dense4D 순전파 (512×512) | 전체 소요 시간 | 최대 GPU 메모리 |
|---|---|---|---|---|---|---|
| 100프레임 | 10.6초 | 1.8초 | 0.8초 | 4.7초 | 17.9초 | 19.5 GB |
| 150프레임 | 18.2초 | 3.3초 | 1.4초 | 10.0초 | 32.9초 | 21.9 GB |
| 300프레임 | 33.0초 | 11.0초 | 2.6초 | 36.6초 | 83.2초 | 29.1 GB |
VGGT-$\Omega$와 Dense4D는 동일한 백본 구조를 쓰지만, Dense4D가 처리하는 $512 \times 512$ 정사각형 크롭은 $512 \times 288$ 전체 프레임보다 이미지 토큰 수가 1.8배 많아서 순전파 시간이 더 걸린다. 세 모델의 가중치 합계는 11.4GB로 단일 프로세스에 상주하며, 100프레임 분량의 비디오를 처리하는 데 걸리는 전체 시간은 17.9초다.
가장 흥미로운 지점
저자 이름부터 다시 확인했다. 임페리얼 칼리지 런던의 리자 알프 귈러는 2018년 인체 픽셀을 템플릿의 UV 좌표에 매핑하는 DensePose를 컴퓨터 비전의 표준 해법으로 정립한 제1저자다. 그랬던 그가 8년 뒤 단독 저자로 발표한 이번 논문에서는 “사전 정의된 신체 템플릿 없이(without a body template)” 4D 대응 관계를 구하겠다고 선언했다. 자신이 만든 템플릿 방식으로는 실제 옷차림과 머리카락의 움직임을 표현하기 어렵다는 점을 누구보다 잘 알았을 것이다. 인간 포인트 맵(HPM)은 모든 사람을 하나의 고정된 마네킹 템플릿에 맞추지 않는다. 비디오 첫 프레임에 담긴 그 사람 자신의 3차원 표면을 즉석에서 좌표계로 삼는다. 그 고민에 대한 명쾌한 답이다.
문제를 분해하는 엔지니어링 감각도 돋보인다. 최근 4D 비전 연구의 주류는 하나의 거대한 피드포워드 모델이 배경 기하와 카메라 궤적, 동적 객체의 움직임을 한꺼번에 예측하는 종단간(end-to-end) 통합 방식이다. 하지만 카메라가 흔들리고 사람이 화면을 가로질러 뛰어갈 때, 월드 좌표계에서의 수 미터짜리 이동과 옷주름의 1cm짜리 변형을 한 좌표계에서 동시에 회귀해야 한다. 신경망에는 불필요한 부담이다. Dense4D는 회전 호모그래피 가상 카메라로 인물을 화면 중앙에 고정하고 평균 거리로 스케일을 정규화해, 모델이 오직 인물 표면의 상대적인 3D 정합에만 집중하게 만들었다. 인물을 월드 공간에 배치하는 일은 VGGT-$\Omega$ 같은 범용 장면 복원 모델에 맡기고, 두 결과는 공유 픽셀의 깊이 비율 하나로 맞춘다.
논문 말미에는 기준 시점 좌표계가 갖는 구조적 한계도 함께 적혀 있다. HPM은 기준 시점의 3차원 좌표를 대응 관계의 식별자로 쓴다. 따라서 기준 프레임의 인물이 팔짱을 끼거나 손을 몸에 대고 있는 자기 접촉(self-contact) 상태라면, 서로 다른 두 신체 부위가 기준 시점에 거의 같은 3D 좌표를 받아 대응 관계가 모호해진다. 논문은 자기 접촉이 없는 프레임을 기준 시점으로 선택하면 이 문제가 완화된다고 설명한다. 여러 기준 시점을 함께 쓰거나 시간적 연속성을 보조 단서로 삼는다면 이 모호성도 풀 수 있지 않을까 싶다.
출처
- 저자: Rıza Alp Güler (Department of Computing, Imperial College London)
- 발표일: 2026년 10월 15일 (arXiv v1)
- 프로젝트 페이지: https://alpguler.com/dense4d/
- 논문 원문: https://arxiv.org/abs/2610.22325
- 치비 서소영 삽화 1장은 「느낌적인 느낌을 숫자로 옮기는 일」의 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
이 논문의 단독 저자인 리자 알프 귈러(Rıza Alp Güler)는 2018년 CVPR에서 2D RGB 이미지를 3D 인체 표면의 UV 좌표로 매핑하는 고전 연구인 DensePose를 발표한 인물이다. ↩︎
일반적인 직사각형 잘라내기(crop)는 주점(principal point, 광축과 이미지 평면의 교점) 이동만 반영해 이미지 가장자리에서 생기는 원근 왜곡을 그대로 남긴다. 그에 비해 가상 카메라 회전 호모그래피는 카메라 렌즈가 인물을 정면으로 바라보도록 회전시킨 것과 같은 투영 변환이므로 시선 방향에 따른 원근 왜곡이 제거된다. ↩︎
정규화 스케일 $s$가 약 2m인 일반적인 전신 촬영 조건에서 정규화 임계값 $\tau = 0.005$는 실제 물리 거리로 약 1cm의 허용 오차에 해당한다. ↩︎
표에서 † 표시가 붙은 V-DPM, 4RC, Any4D는 원래 카메라 내부 파라미터를 스스로 추정해 쓰는 모델들이다. 공정한 비교를 위해 정답 3D 정보를 쓰지 않고 벤치마크의 카메라 내부 파라미터에 맞추는 보정을 거쳤다. 예를 들어 V-DPM은 보정 전 AJ가 8.9점이었으나 초점 거리와 이미지 평면 오프셋 보정을 거쳐 16.9점으로 올랐고, 4RC도 4.1점에서 14.4점이 됐다. ↩︎