3줄 요약
- 엔지니어 사그닉 바타차르지(Sagnik Bhattacharjee, 필명 datavorous)는 드위터(Dwitter) 생태계를 탐색하기 위해 오픈웨이트 코드 모델 Qwen2.5-Code-7B를 사후학습하고 Demoscener-7B를 공개했다. 드위터는 140자 이내의 자바스크립트 코드로 캔버스 애니메이션을 구현하는 플랫폼이다.
- 저자는 드위터 코드 2만 5,000건으로 추가 사전학습(CPT)을 진행해 모델이 극단적인 코드 압축 문법을 익히도록 했으며, 이때 퍼플렉시티는 28.63에서 8.57로 감소했다. 이어 커뮤니티 추천수 상위 5,000건의 샘플링 확률을 단계적으로 높이는 커리큘럼 학습을 진행해 전체 7,000건 기준 퍼플렉시티를 7.42에서 5.65로 낮췄다.
- 저자는 미완성 코드의 완성본을 8개씩 렌더링하고 가장 아름답다고 판단한 결과를 직접 선택하는 방식으로 GRPO 강화학습을 수행하며 약 4만 개의 애니메이션을 평가했다. 이후 블라인드 평가로 선정한 최종 모델과 드위터 코드 2만 5,000건 데이터셋을 허깅페이스에 공개했다.
256바이트 데모에서 140자 자바스크립트 드위터로
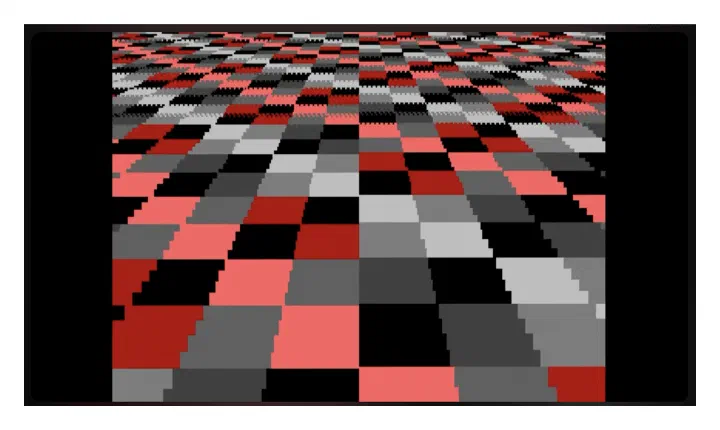
데모씬(Demoscene)은 파일 용량을 극도로 제한한 조건에서 시청각 효과를 구현하는 컴퓨터 아트의 하위문화다. 그중에서도 수백 바이트 이하의 실행 파일로 그래픽과 사운드를 만들어내는 분야를 사이즈코딩(sizecoding)이라 부른다.1 저자는 헬무드(HellMood)가 제작한 256바이트 MS-DOS 데모 Memories와 그 기술 해설서를 살펴보며 탐색을 시작했다. Memories의 첫 장면에는 기울어진 원근 체커보드 효과가 등장한다. 해설서는 이 효과를 구현할 때 16바이트 데모 kasparov와 32바이트 데모 floorcast의 바이트 절약 기법을 어떻게 계승했는지 상세히 설명했다.
어셈블리어 대신 웹 환경에서 유사한 제약을 실험할 수 있는 플랫폼이 드위터(Dwitter.net)다. 드위터에서는 모든 프로그램(드윗, Dweet)을 140자 이내의 자바스크립트 함수 function u(t) 본문으로 작성해야 한다. 창작자들이 글자 수를 절약할 수 있도록 실행 환경은 다음과 같은 단축 변수와 함수를 기본 제공한다.
| 식별자 | 실제 대응 객체 및 함수 | 용도 |
|---|---|---|
u(t) | 매 프레임 호출되는 메인 루프 (t는 경과 시간, 단위는 초) | 시간에 따른 애니메이션 상태 갱신 |
c, x | HTML5 <canvas> 요소 및 2D 렌더링 컨텍스트 | 캔버스 크기 초기화(c.width) 및 도형 그리기(x.fillRect, x.arc) |
S, C, T | Math.sin, Math.cos, Math.tan | 주기적인 파동, 회전, 프랙탈 좌표 계산 |
R(r,g,b,a) | rgba(r,g,b,a) 문자열 생성 함수 | x.fillStyle 및 x.strokeStyle 색상 지정 |
드위터 전체에서 추천(awesomeness)을 가장 많이 받은 작품 역시 Memories와 동일한 패럴랙스 체커보드 효과를 140자 자바스크립트로 재현한 코드였다.
드위터의 핵심 문화는 기존 작품의 코드를 일부 고쳐 새로운 시각 효과를 파생시키는 리믹스(remix)다. 저자가 드위터에서 수집한 세 작품(d/36467 → d/36547 → d/36555)을 비교하면 리믹스 과정을 확인할 수 있다. 세 작품은 Math.min과 x.fillRect(960+r*C(i),540+r*S(i),...) 같은 핵심 부분 문자열(substring)을 공유한다. 각 작품은 상수나 수식 일부만 바꿔 서로 다른 프랙탈 무늬를 만들어낸다.
// 1. d/36467
f=u=>6*Math.min(S(u-8*v+S(i)),S(u-5*i),C(u));for(i=5e4;i--;x.fillRect(960+r*C(i),540+r*S(i),v=1+2*t**.7,f(v+17*i)+f(v-8*i)&2?0:v))r=80+240*t

// 2. d/36547 (d/36467의 리믹스)
f=u=>8*Math.min(S(u-2*v),S(u-2*i)-S(i));for(i=3e4;i--;x.fillRect(960+r*C(i),540+r*S(i),v=1+4*t**.5,f(v+6*i)+f(v-2*i)&10?0:v))r=240+240*t

// 3. d/36555 (d/36547의 리믹스)
f=(u,n=2)=>n?Math.min(f(u-2*w,n-1),f(u-2*i,n-1)):6*Math.max(S(u)**2,C(i-w*Y));for(i=1e4;i--;x.fillRect(960+r*Y,360-r*C(i),f(w+6*i)+f(w-2*i)&9?0:w,w))Y=S(i),r=120+240*t,w=4*t**.5
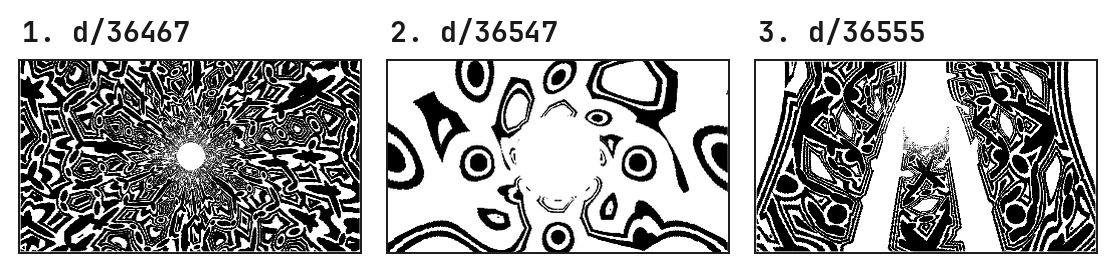 같은 부분 문자열을 사용하는 세 리믹스 드윗(
d/36467, d/36547, d/36555)의 실제 렌더링 화면. 출처: Sagnik Bhattacharjee
작동하는 140자 드윗에서 마지막 30자를 지운 뒤 다른 문자열로 채우면 어떤 시각 효과가 나타날까? 사용 가능한 문자를 64종으로만 가정해도 30자 완성본의 경우의 수는 $64^{30} \approx 1.5 \times 10^{54}$가지에 이른다. 무작위로 문자를 대입하면 거의 모든 조합이 구문 오류를 일으키거나 빈 화면만 출력한다.
반면 자기회귀 언어 모델은 앞부분 코드(prefix)가 주어졌을 때 문법적으로 유효하고 그럴듯한 뒷부분을 확률적으로 샘플링할 수 있다. 미틸 박데(Mithil Vakde, @evilmathkid)는 X에서 이런 탐색에 활용할 만한 아이디어를 제시했다.2 수학적인 ‘아름다움 검증 함수’를 코드로 정의하기 어려운 분야에서도 사람의 대략적인 선호를 기록한 데이터를 검증기(verifier)로 활용할 수 있다는 발상이다. 이 데이터를 활용해 강화학습을 수행하면 유효한 후보를 효율적으로 탐색할 수 있다. 저자는 자신의 깃허브 스폰서(GitHub Sponsors) 후원금으로 GPU를 임대해 드윗 생성 모델 Demoscener의 3단계 사후학습에 착수했다.
1단계: 2만 5,000건의 드윗 수집과 추가 사전학습(CPT)
저자는 먼저 상용 모델인 Claude Sonnet 5.5에게 드윗을 합성하게 했으나, 생성된 애니메이션의 조형적 완성도가 미흡했다. 이에 드위터 공식 API를 통해 실제 창작자들이 작성한 드윗 2만 5,000건을 학습용으로, 약 1,300건을 검증용으로 직접 수집했다.
기반 모델로는 Qwen2.5-Code-7B를 선택했다. 일반적인 자바스크립트 코드는 무리 없이 생성하는 모델이었으나, 글자 수를 극단적으로 줄이는 드위터 특유의 코드 골프(code-golfing) 관용구는 제대로 예측하지 못했다. 예를 들어 for 루프의 초기화 식에 x.fillRect(0,0,w=2e3,w)를 적으면 배경 초기화와 변수 할당을 동시에 처리할 수 있다. 비트 연산자와 삼각함수를 중첩하는 구문도 자주 쓰인다. 기본 모델은 이런 구문에서 높은 서프라이절(surprisal)을 기록했다. 서프라이절은 토큰의 음의 로그 확률을 뜻한다.
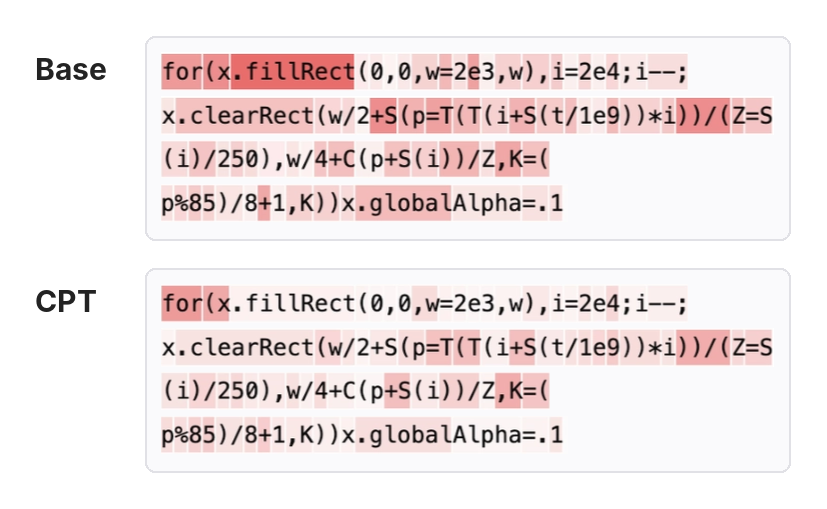 드윗 코드에 대한 기본 모델(Base)과 추가 사전학습 모델(CPT)의 토큰별 서프라이절 비교. 붉은색이 짙을수록 모델이 해당 토큰을 예측하기 어려워했음을 뜻한다. 출처: Sagnik Bhattacharjee
2만 5,000건의 드윗 코퍼스로 추가 사전학습(Continued Pretraining, CPT)을 진행한 결과, 드위터 전용 단축 문법과 루프 패턴에서 발생하던 서프라이절이 크게 감소했다. 저자는 별도로 구축한 검증용 드윗 30건으로 퍼플렉시티(perplexity)를 측정했다. 기본 모델에서 28.63이던 값은 추가 사전학습 후 8.57로 낮아졌다.
2단계: 추천수 기반 커리큘럼 학습
추가 사전학습을 마친 모델은 미완성 드윗의 뒷부분을 문법 오류 없이 완성해 캔버스에 그림을 그려냈다. 학습 데이터 2만 5,000건에는 평범한 습작과 뛰어난 작품이 동일한 비중으로 섞여 있어서, 생성된 화면 대부분도 단순한 노이즈나 단조로운 도형에 그쳤다.
저자는 드위터 커뮤니티의 추천수(awesomeness)를 기준으로 상위 5,000건의 드윗을 선별했다. 이 드윗들은 순위에 따라 1,000건씩 5개 구간(버킷)으로 구분했다. 이어 커리큘럼 학습(Curriculum Learning)을 총 400스텝 동안 진행하면서 상위 구간 드윗의 샘플링 확률을 점진적으로 높였다.
| 학습 스텝 | 1~1,000위 | 1,001~2,000위 | 2,001~3,000위 | 3,001~4,000위 | 4,001~5,000위 |
|---|---|---|---|---|---|
| Step 1 | 20.00% | 20.00% | 20.00% | 20.00% | 20.00% |
| Step 100 | 34.86% | 26.87% | 19.37% | 12.15% | 6.76% |
| Step 200 | 49.02% | 28.53% | 14.37% | 5.79% | 2.29% |
| Step 300 | 60.20% | 27.06% | 9.54% | 2.49% | 0.71% |
| Step 400 | 67.23% | 24.99% | 6.75% | 0.99% | 0.03% |
커리큘럼 학습 전후로 동일한 미완성 코드 프롬프트에서 생성된 완성본을 비교하면 시각적 완성도 차이가 뚜렷하다. 추가 사전학습 직후의 모델(Before)은 색상과 좌표 수식을 거칠게 구성해 격자 노이즈가 깨진 형태의 화면을 출력했다. 반면 커리큘럼 학습을 마친 모델(After)은 삼각함수의 위상차와 투명도를 조합해 부드러운 곡면 파동을 렌더링했다.
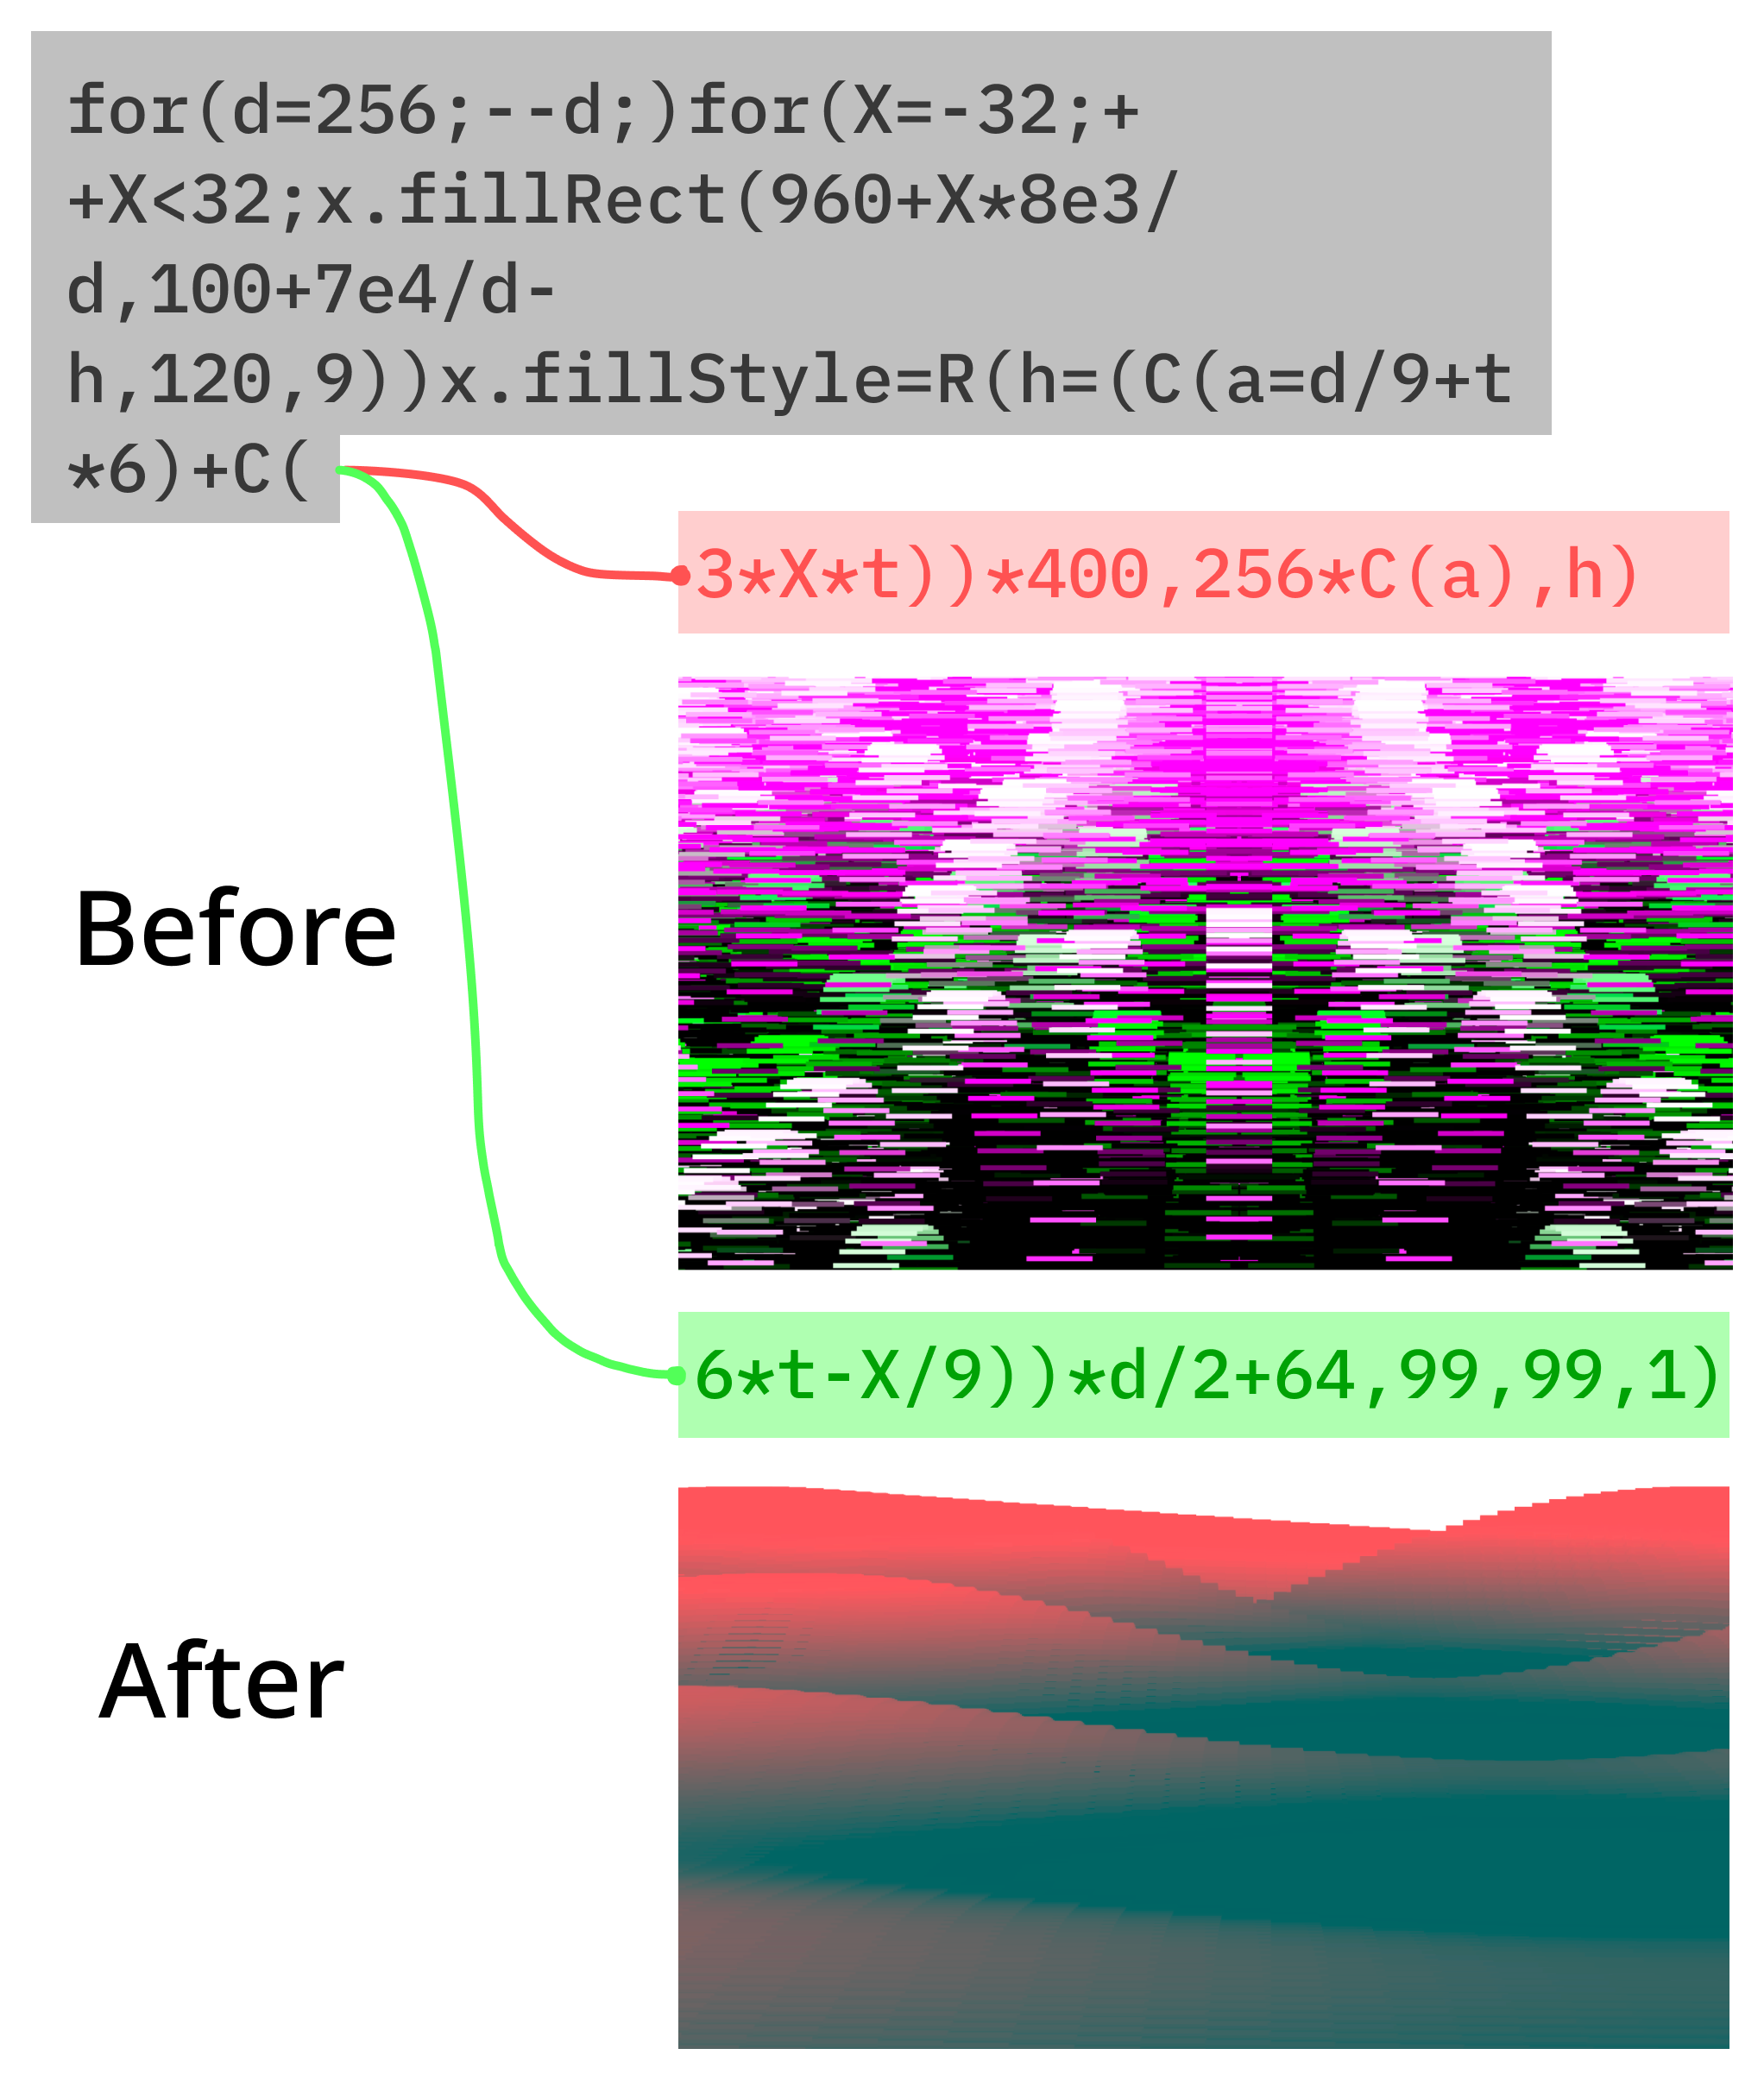 미완성 드윗 코드에 대해 추가 사전학습 모델(Before)과 커리큘럼 학습 모델(After)이 이어 쓴 코드 및 실제 렌더링 화면 비교. 출처: Sagnik Bhattacharjee
정량 지표도 함께 개선됐다. 7,000건의 드윗을 대상으로 측정한 퍼플렉시티는 7.42에서 5.65로 감소했다. 추천수 상위 5,000건에 포함되지 않은 하위권 드윗은 커리큘럼 학습 중 한 번도 샘플링되지 않았음에도, 모든 백분위 구간에서 토큰당 로그 우도(log-likelihood)가 개선됐다. 특히 기존 CPT 모델이 가장 예측하기 어려워했던 중하위권 구간에서 개선 폭이 가장 컸다. 이 구간은 추천수 순위 백분위가 35~45%인 드윗에 해당한다.
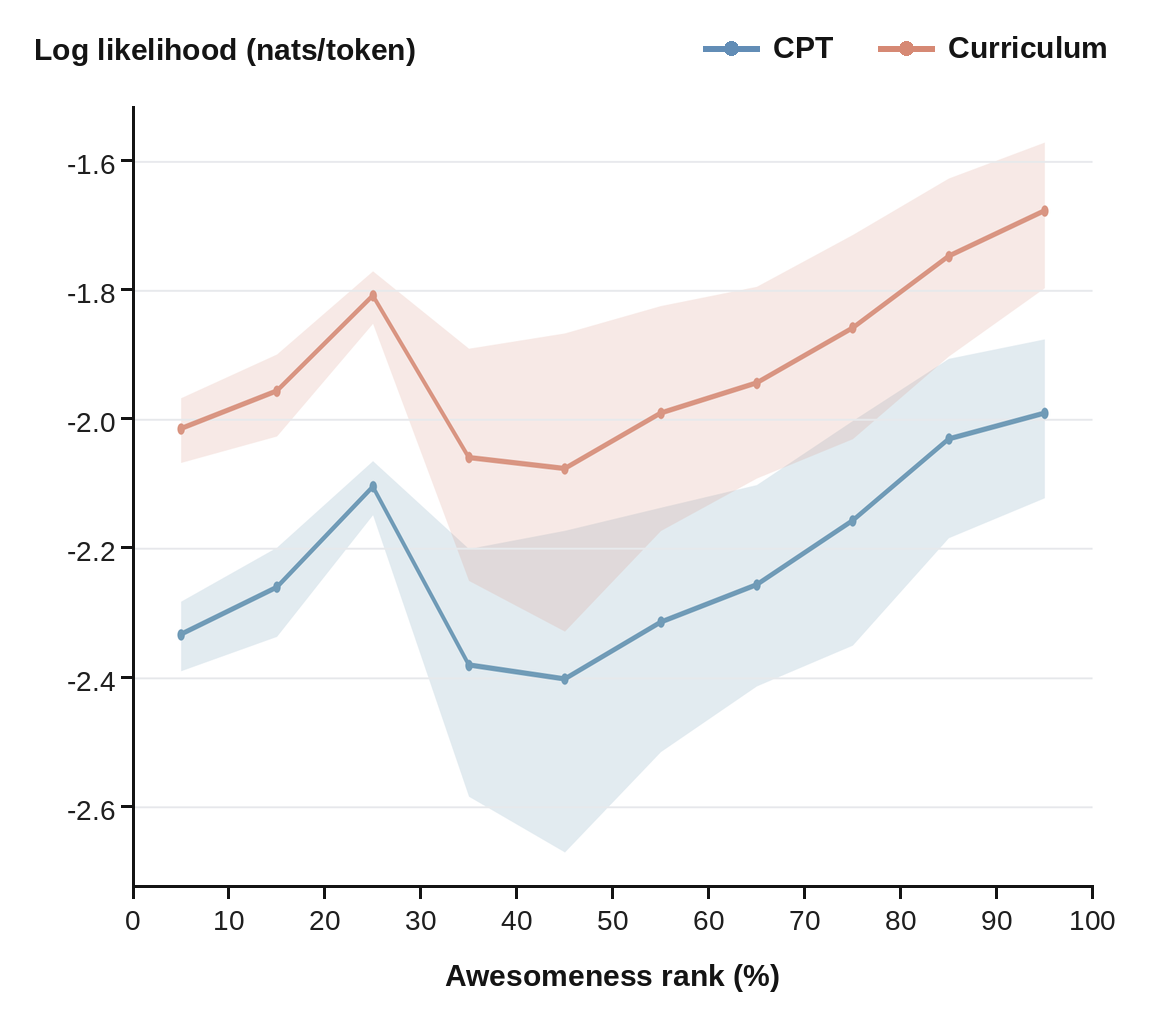 추천수 순위 백분위(가로축)에 따른 추가 사전학습 모델(CPT, 파란색)과 커리큘럼 학습 모델(Curriculum, 주황색)의 토큰당 로그 우도(세로축, nats/token) 비교. 출처: Sagnik Bhattacharjee
3단계: 4만 개의 애니메이션을 직접 고른 GRPO 강화학습
커리큘럼 학습을 거치며 정교한 시각 패턴이 자주 생성됐으나, 미완성 코드를 완성하는 과정에서 빈 화면이 나오거나 구문이 깨지는 실패 사례는 완전히 사라지지 않았다. 수리야(Surya)는 p5.js 수채화 코드 생성 모델을 쌍대 선호도(pairwise preference)로 학습시켰다. 저자는 이 작업(Training AI to Paint with Code)에서 영감을 얻어 GRPO(Group Relative Policy Optimization) 강화학습을 설계했다. 이 방식에서는 사람이 직접 보상 함수 역할을 맡는다.
저자가 구성한 GRPO 학습 루프는 다섯 단계로 이루어진다.
- 검증 세트의 드윗에서 마지막 일부 문자를 제거한 미완성 프롬프트를 준비한다.
- 현재 정책 모델에서 프롬프트당 8개의 완성본을 하나의 그룹(group)으로 샘플링한다.
- 8개의 자바스크립트 코드를 브라우저에 동시에 렌더링해 애니메이션을 재생한다.
- 저자는 애니메이션을 직접 보고 미적으로 가장 뛰어나다고 판단한 1개를 선택한다. 그룹에 속한 애니메이션 8개가 모두 빈 화면(blank)이거나, 구문 오류(malformed)가 발생했거나, 미적 기준에 미달하면 해당 그룹 전체를 학습에서 제외한다.
- 선택된 선호 데이터를 바탕으로 정책 모델을 업데이트하고 다음 라운드를 진행한다.
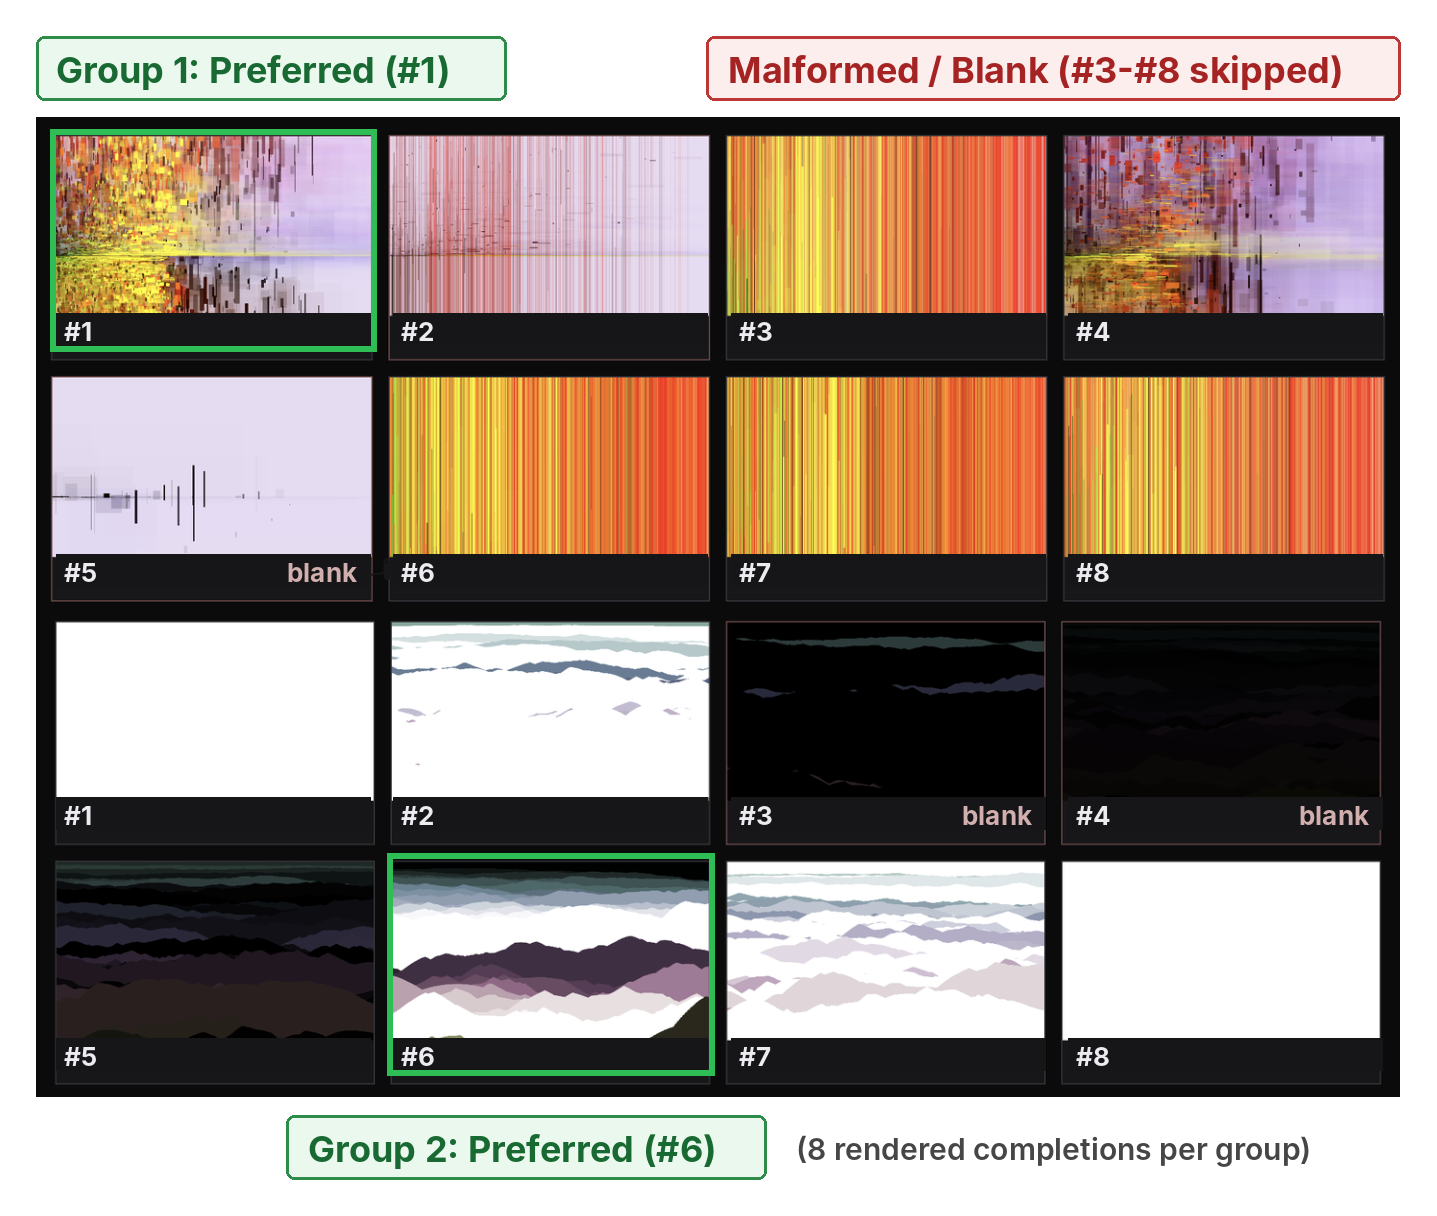 GRPO 강화학습의 인간 평가 화면. 그룹당 8개씩 렌더링된 결과물 중 가장 시각적으로 우수한 데모(Preferred)를 선택하고, 깨진 결과물(Malformed)이나 빈 화면(Blank)은 배제한다. 출처: Sagnik Bhattacharjee
저자는 라운드마다 500개 그룹, 즉 애니메이션 4,000개를 평가했다. 총 9~10라운드 동안 혼자서 약 4만 개의 애니메이션을 직접 보고 평가했다.3
블라인드 평가와 탐색 인터페이스, 모델 공개
저자는 강화학습을 마친 뒤 무작위로 체크포인트 4개를 골랐다. 어느 체크포인트가 가장 우수한지 확인하기 위해 지인에게 데모 400세트를 블라인드 A/B 방식으로 평가해 달라고 했다. 평가자는 같은 미완성 코드에서 각 체크포인트가 생성한 애니메이션을 라벨 없이 동시에 보고, 더 나은 결과를 선택했다.
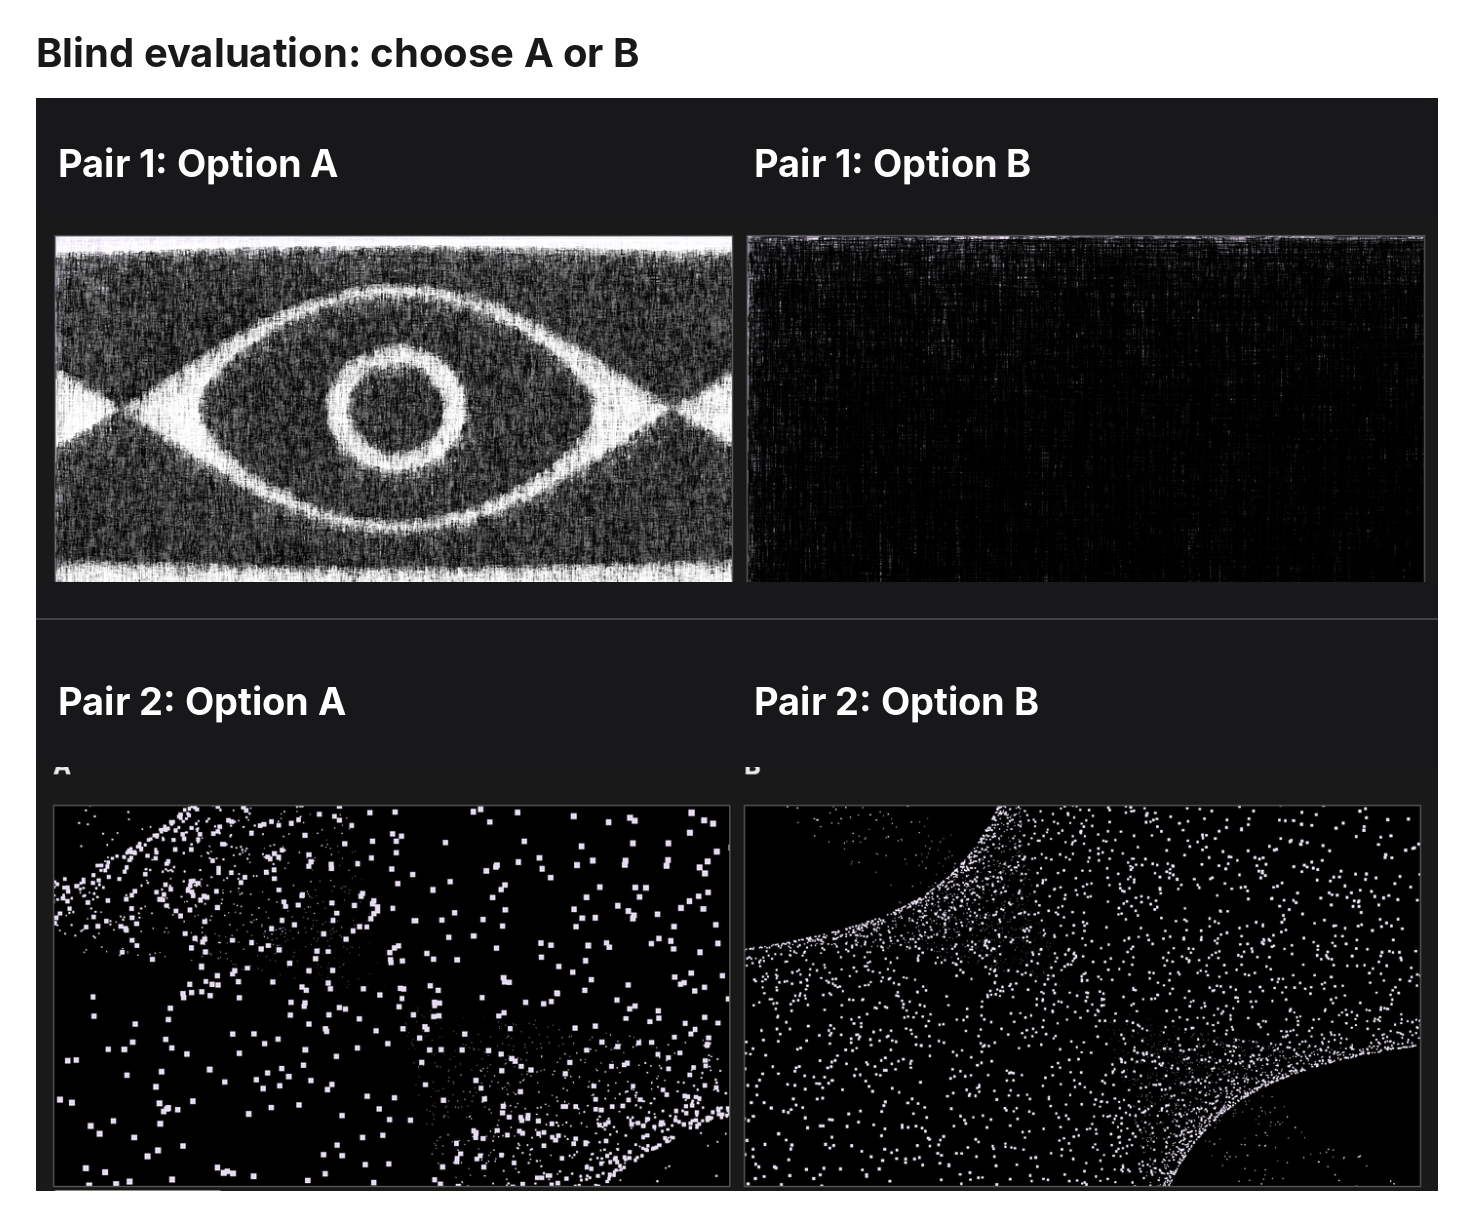 체크포인트 선정을 위한 블라인드 A/B 평가 화면. 같은 미완성 코드에서 생성된 두 애니메이션(Option A, Option B) 중 시각적으로 더 나은 결과를 선택한다. 출처: Sagnik Bhattacharjee
블라인드 평가에서 가장 높은 선호도를 기록한 체크포인트 4(Checkpoint 4)가 최종 모델로 채택됐다. 저자는 이 모델을 자신의 맥(Mac) 로컬 환경에서 구동하며, 데모씬 코드를 대화형으로 탐색할 수 있는 노드 기반 분기 인터페이스(branching UI)를 구축했다. 사용자가 미완성 자바스크립트 코드와 샘플링 개수, 온도(temperature), 최대 토큰 수를 지정하면 여러 완성본과 그 실시간 렌더링 화면이 카드로 생성된다. 사용자는 마음에 드는 결과물을 고른 뒤 코드를 일부 수정하거나 뒷부분을 제거할 수 있다. 이렇게 수정한 코드를 새로운 분기(branch)로 삼아 자동 완성을 계속할 수 있다.
학습을 마친 7B 모델의 가중치와 수집한 데이터셋은 모두 오픈소스로 공개됐다.
- 모델 가중치: datavorous/Demoscener-7B (Hugging Face)
- 데이터셋: datavorous/Demoscener-Dweets-25k (Hugging Face)
가장 흥미로운 지점
내가 이번 실험에서 가장 주목한 것은 추천수 기반 커리큘럼 학습이 하위권 드윗의 로그 우도까지 개선했다는 점이다. 저자는 상위 5,000건의 샘플링 확률만 높이며 400스텝 동안 모델을 학습시켰지만, 정량 평가에서는 학습에 쓰이지 않은 하위권 드윗의 퍼플렉시티까지 함께 낮아졌다. 추천수가 높은 작품일수록 복잡한 그래픽을 140자 코드로 구현하는 핵심 관용구와 수학적 압축 패턴을 집약하고 있어, 상위권 작품을 집중 학습한 과정이 드위터 코드 전반의 문법 예측력을 개선하는 결과로 이어졌다.
미적 판단을 위한 보상 함수를 코드로 작성할 수 없으니, 저자가 약 4만 개의 애니메이션을 직접 평가하며 GRPO의 보상 함수 역할을 맡은 실행력도 인상적이다. 이 실험은 대형 연구소의 거대한 인프라 없이도, 도메인 특화 코드 2만 5,000건과 명확한 커리큘럼 설계, 창작자 한 사람의 일관된 미적 기준으로 모델을 학습시킬 수 있음을 입증한다. 이렇게 학습시킨 7B 규모의 로컬 모델을 창작 도구로 활용하면 $1.5 \times 10^{54}$가지 코드 조합을 탐색할 수 있다.
출처
Sagnik Bhattacharjee (datavorous), “Post training a model to explore Demoscene”, 2026-10-31. 원문: https://datavorous.com/writing/demoscener/
사이즈코딩 위키(sizecoding.org)는 플랫폼별 최소 바이트 데모의 어셈블리 명령어 구성과 수학적 근사 기법을 아카이브로 정리해 제공한다. ↩︎
미틸 박데는 예술처럼 명시적인 보상 함수를 작성할 수 없는 분야에서 모호한 선호 데이터(fuzzy data)를 검증기로 활용해 미적 감각을 학습시키는 접근을 제안했다. ↩︎
저자는 약 1만 번째 애니메이션을 평가할 무렵부터 비전-언어 모델(VLM)이나 인간 선호도 예측 모델(HPSv3)이 절실히 필요했다고 회고했다. 그러나 이미 수작업으로 평가를 진행하고 있었기에 끝까지 직접 평가를 마쳤다고 한다. ↩︎