3줄 요약
- DeepSeek이 2026년 9월 10일 DeepSeek-V4.1-Flash를 MIT 라이선스로 공개했다. 백본 5,520억 파라미터에 Engram 메모리 1,960억 파라미터가 따로 붙은 멀티모달 MoE 모델이며, 컨텍스트는 100만 토큰까지 받는다. 기술 보고서의 제목은 “KV 캐시 압축의 한계를 밀어붙인다"이고, 보고서 전체가 이 한 문장을 향해 쓰였다.
- 설계가 낯설게 보이는 까닭을 찾자면, 층들이 서로 다른 역할을 맡도록 갈라 놓았기 때문이다. 40층 트랜스포머는 인과 인코더 20층과 디코더 20층으로 나뉜다. 디코더의 전역 KV는 인코더 마지막 층의 은닉 상태에 층별 투영 가중치를 적용해 만든다. 그래서 프롬프트를 읽을 때는 활성 파라미터 80억 개를 쓰고, 답을 생성할 때는 160억 개를 쓴다. 전역 KV를 직접 계산하는 층은 40층 가운데 네 층뿐이며, 나머지 30층은 앞 층의 KV를 빌려 쓴다.
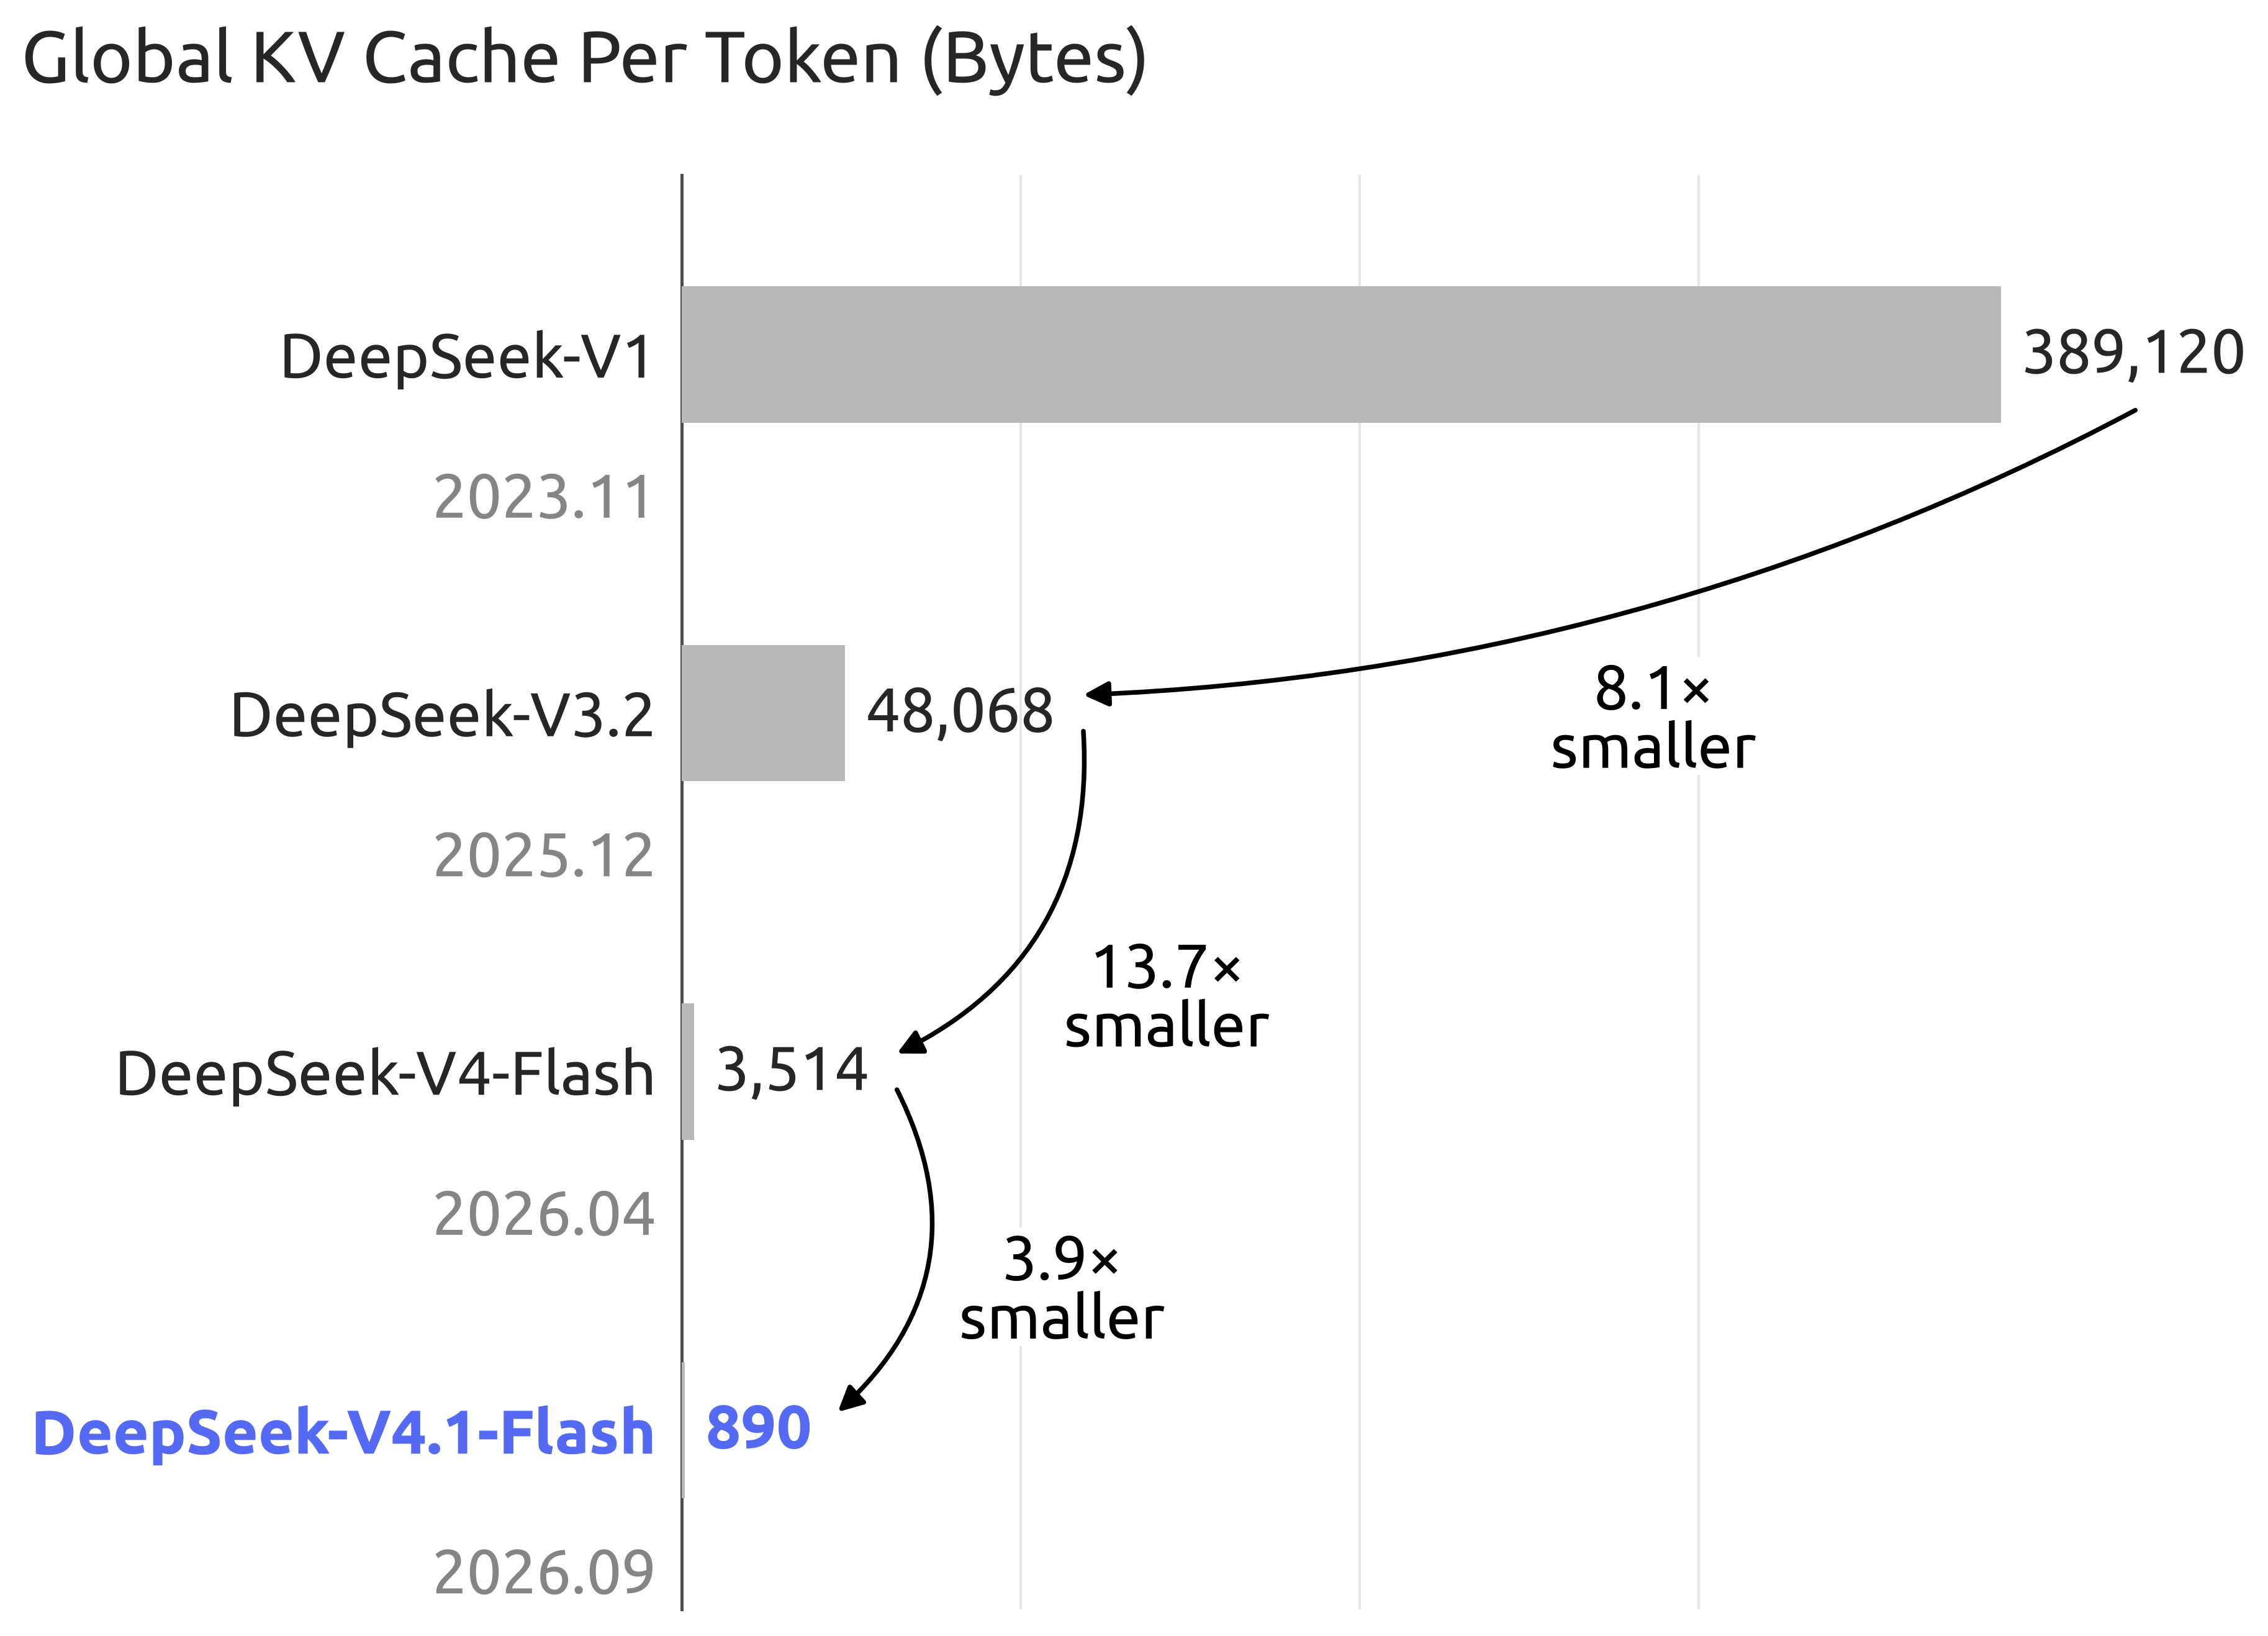
- KV 캐시를 줄이기 위해 연구진은 한 가지 방법에 매달리지 않고 세 방향에서 동시에 손을 댔다. 층 축에서는 위의 교차층 공유로, 정밀도 축에서는 FP4 저장으로, 시퀀스 축에서는 인코더의 2:1 압축으로 줄여 토큰당 전역 KV를 890바이트로 만들었다. 이는 V4-Flash의 4분의 1이다. 여기에 SWA 캐시를 SSD에 남기지 않고 마지막 128토큰만 다시 계산해 복원하는 SWA Bounded Replay를 더해, 영구 캐시는 8분의 1로 줄었다.
어떤 모델인가
DeepSeek은 이 모델을 “새 아키텍처 계열의 가장 작은 모델"이라고 소개했다. 이름은 V4에서 소수점 하나가 올라갔을 뿐이지만, 보고서의 아키텍처 장은 V4와 거의 다른 모델을 설명한다. 핵심 사양을 먼저 정리한다.
| 항목 | DeepSeek-V4.1-Flash |
|---|---|
| 백본 파라미터 | 552B (MoE) |
| Engram 메모리 파라미터 | 196B (백본과 별도, 조회형) |
| 활성 파라미터 | 프리필 8B, 디코드 16B |
| 층 구성 | 40층: 인과 인코더 20층 + 디코더 20층 |
| 은닉 차원 | 5,120 |
| MoE | 공유 전문가 1개 + 라우팅 전문가 384개, 토큰당 6개 활성 |
| 컨텍스트 | 100만 토큰 |
| 사전학습 | 멀티모달 45조 토큰, 희소 어텐션을 6만 4천 토큰 길이에서 처음부터 학습 |
| 토큰당 전역 KV 캐시 | 890바이트 (V4-Flash의 약 4분의 1) |
| 영구 KV 캐시 | V4-Flash의 약 8분의 1 |
| 입력 | 텍스트와 이미지 (DeepSeek-ViT, 처음부터 학습) |
| 라이선스 | MIT |
비교 대상인 V4-Flash는 백본 2,840억에 활성 130억이었고, V4-Pro는 백본 1.6조에 활성 490억이었다. 보고서는 V4.1-Flash-Base가 V4-Pro-Base와 비슷한 지식, 추론, 코딩 능력을 보이면서 전체 파라미터는 3분의 1, 활성 파라미터는 4분의 1만 쓴다고 했다. DeepSeek은 공지에서 V4-Pro를 단계적으로 내리고 그 자리를 이 모델이 맡게 하겠다고 밝혔다.
왜 설계가 낯설게 보이는가
발표 직후 개발자 게시판과 X에서는 이 모델의 구조를 두고 “완전히 다른 짐승"이라거나 “포인트 릴리스인데 파라미터가 두 배에 아키텍처까지 바뀌었다"는 반응이 나왔다.1 DeepSeek을 오래 지켜본 관찰자는 V4.1이 V4와 다른 정도가 LLaMA 3와 LLaMA 1의 차이보다 크다고 적었다.2 낯설게 느껴지는 지점은 크게 세 가지로 나눌 수 있다.
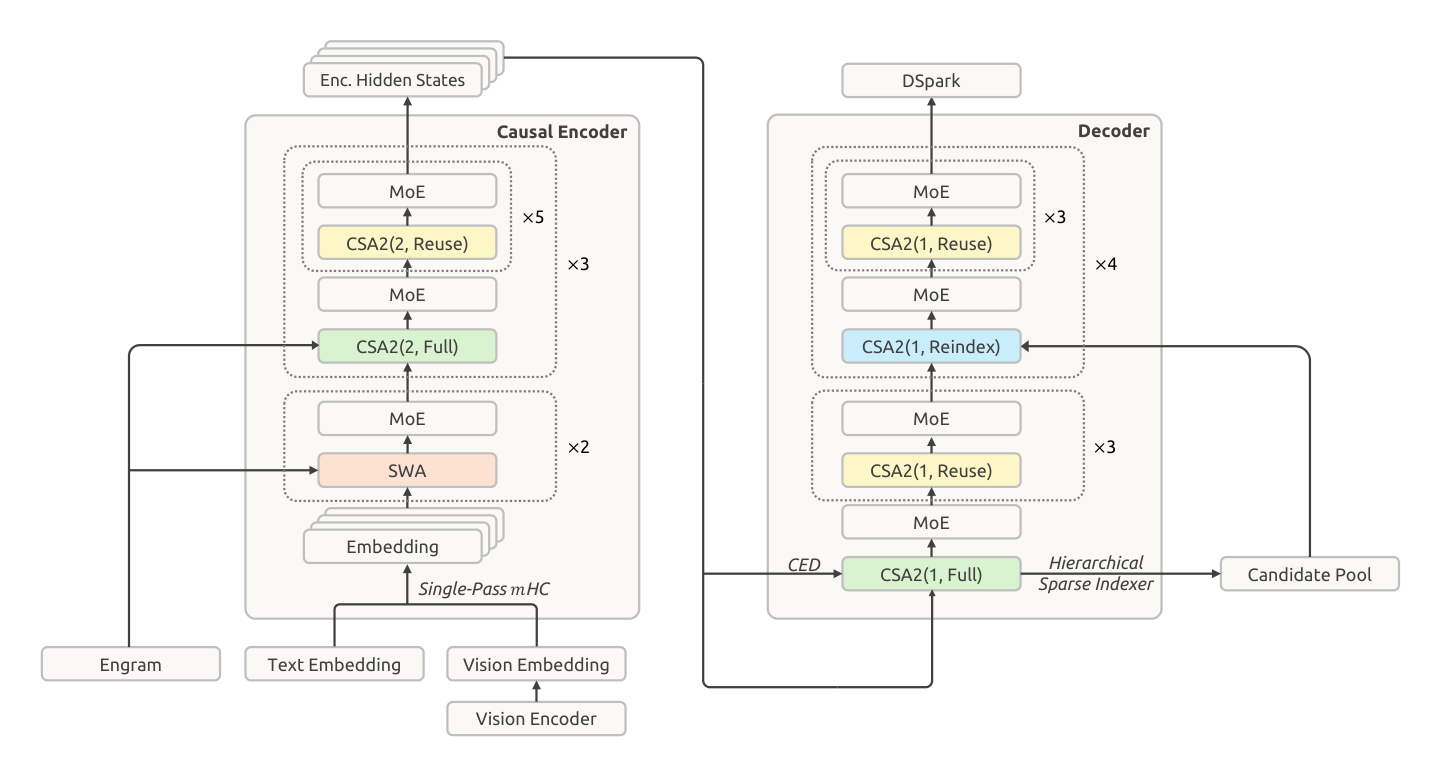 그림 1. DeepSeek-V4.1-Flash의 전체 구조. CSA2(비율, 모드) 표기는 압축 비율과 동작 모드를 뜻한다. 출처: DeepSeek-V4.1-Flash 기술 보고서 Figure 3
인코더와 디코더로 갈라졌다
첫째, 디코더 전용 모델이 지배하는 시대에 인코더와 디코더를 다시 나눴다. 그렇다고 원래 트랜스포머의 인코더처럼 양방향으로 문장을 읽는 인코더가 돌아온 것은 아니다. 보고서는 이 구조를 Causal Encoder-Decoder, 줄여서 CED라고 부른다. 아래쪽 20층이 인과 인코더이고, 위쪽 20층이 디코더다. 두 부분 모두 인과 마스크를 쓴다.
디코더 층이 전역 어텐션에 쓰는 KV를 어디서 가져오는지를 보면, 어디가 낯선지 드러난다. 보통의 트랜스포머에서는 각 층이 자기 층의 은닉 상태에서 K와 V를 계산한다. CED에서 디코더 층은 그렇게 하지 않는다. 디코더 층 l의 전역 KV는 인코더 마지막 층, 곧 20번째 층의 은닉 상태에 층마다 다른 투영 가중치를 곱해 만든다. 디코더 층은 자기가 계산하지 않은 표현에 어텐션을 건다.
이 설계의 출발점은 마이크로소프트 연구진이 2024년에 낸 YOCO다.3 YOCO는 위쪽 절반의 층이 아래쪽 절반이 만든 KV 캐시를 그대로 공유하게 해서 프리필 계산을 줄였다. 보고서는 CED가 그 착상에서 시작해 KV 캐시 용량과 KV 생성의 계산 깊이를 늘리는 구조적 개선을 더한 것이라고 설명했다.
이렇게 하면 프리필 비용이 달라진다. 프롬프트를 읽는 단계에서는 인코더 20층만 계산하면 디코더 전역 KV까지 얻을 수 있으므로, 길이 N인 시퀀스의 프리필 복잡도가 O(NL)에서 대략 O(NL/2)로 내려간다. 보고서가 말하는 프리필 80억, 디코드 160억이라는 활성 파라미터 수는 여기서 나온다. 보고서는 에이전트 작업에서 도구 호출 뒤에 방대한 프리필 요청이 이어지고, 이때 캐시 미스가 나면 계산 부담이 커진다고 적었다. 연구진이 CED를 내놓은 것도 이 병목을 줄이기 위해서였다.
그렇다고 이 구조가 공짜로 얻어지는 것은 아니어서, 한 가지 대가를 치른다. 전역 어텐션의 KV는 인코더 출력에서 투영되지만, 슬라이딩 윈도 어텐션(SWA)의 국소 KV는 디코더에서도 층마다 자기 은닉 상태로 계산한다. 그러면 디코딩을 시작하려면 디코더 20층의 SWA KV가 필요하고, 그것을 정확히 만들려면 프롬프트 마지막 부분을 디코더로 다시 통과시켜야 한다. 이 문제를 어떻게 풀었는지는 아래 SWA Bounded Replay 절에서 다룬다.
40층 가운데 4층만 KV를 만든다
둘째, 층의 대부분이 자기 KV를 갖지 않는다. 보고서는 이 어텐션 구조에 Compressed Sparse Attention 2, 줄여서 CSA2라는 이름을 붙였다. 모든 CSA2 층은 세 가지 모드 가운데 하나를 학습 전에 고정으로 배정받는다.
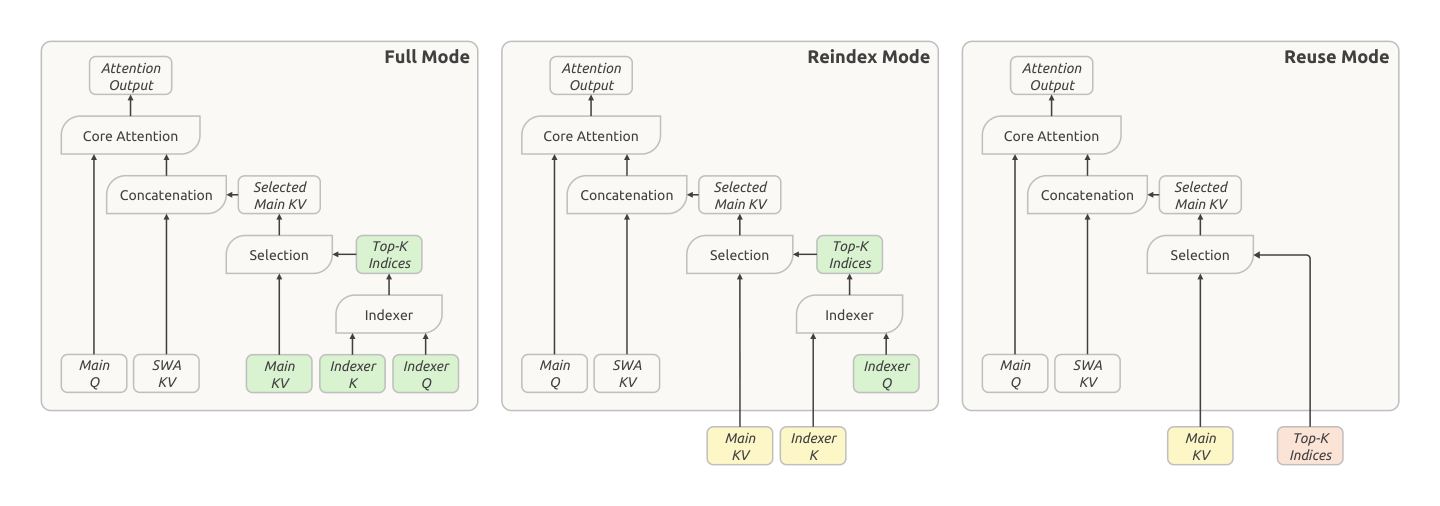 그림 2. CSA2의 세 동작 모드. 녹색은 현재 층에서 계산한 것, 노란색은 가장 가까운 Full 층에서 빌린 Main KV와 Indexer K, 붉은색은 가장 가까운 인덱스 생성 층에서 빌린 Top-K 인덱스다. 출처: DeepSeek-V4.1-Flash 기술 보고서 Figure 4
| 모드 | 전역 KV | 인덱서 K | Top-K 인덱스 | 자기 층에서 계산하는 것 |
|---|---|---|---|---|
| Full | 직접 계산 | 전역 KV에서 투영 | 직접 선택 | 전부 |
| Reindex | 가장 가까운 Full 층에서 빌림 | 빌림 | 자기 인덱서 Q로 다시 채점해 새로 선택 | Q, 인덱서 Q, SWA KV |
| Reuse | 빌림 | 쓰지 않음 | 가장 가까운 Full 또는 Reindex 층의 것을 그대로 사용 | Q, SWA KV |
세 모드 모두 자기 층의 쿼리와 SWA KV는 직접 계산한다. 다른 것은 전역 KV, 인덱서 K, Top-K 인덱스를 어디서 가져오느냐다. Reuse 모드 층은 어느 위치를 볼지도 스스로 정하지 않고, 앞 층이 고른 512개 위치를 그대로 받아 어텐션만 한다.
실제 배치는 이렇다. 인코더의 첫 두 층은 SWA만 쓴다. 나머지 인코더 18층은 2:1로 압축한 CSA2 층인데, 6층씩 세 그룹으로 묶여 각 그룹의 첫 층만 Full 모드이고 나머지 5층은 Reuse 모드다. 디코더 20층은 압축하지 않는 CSA2 층이며 4층씩 다섯 그룹으로 나뉜다. 첫 그룹은 첫 층을 Full 모드로, 그 뒤 3층을 Reuse 모드로 둔다. 나머지 네 그룹은 첫 층이 Reindex 모드이고 뒤 3층이 Reuse 모드다.
세어 보면 40층 가운데 전역 KV를 직접 만드는 Full 층은 인코더에 셋, 디코더에 하나로 모두 넷뿐이다. 나머지는 Reindex 층 4개, Reuse 층 30개, SWA 전용 층 2개로 채워진다. 디코더에서 유일한 Full 층은 CED 규칙에 따라 인코더 마지막 은닉 상태에서 KV를 만들고, 디코더의 나머지 19층은 그 하나의 KV를 나눠 쓴다. 보고서는 이 덕분에 Reuse 모드 층이 프리필에서 15개, 디코드에서 11개의 GPU 커널만으로 실행된다고 했다.
CSA2는 V4의 CSA를 손질한 것이기도 하다. V4는 CSA와 더 세게 압축하는 HCA를 번갈아 배치했는데, V4.1은 CSA2만 쓴다. 압축기에서는 인접한 압축 항목이 원본 항목을 겹쳐 쓰던 방식과 절대 위치 임베딩을 없앴고, 인덱서 K는 은닉 상태에서 따로 만들지 않고 전역 KV에서 투영한다. 보고서는 IndexCache, YOIO, HySparse 같은 선행 연구가 인덱스 재사용이나 KV 재사용 가운데 하나만 다뤘고, 항목 크기, 시퀀스, 층이라는 세 축을 모두 함께 다룬 방법은 없었다고 정리했다.
뒤쪽 인덱서는 앞 인덱서가 고른 후보만 본다
셋째, 디코더 안에 계층형 희소 인덱서가 있다. 희소 어텐션에서는 가벼운 인덱서가 쿼리마다 전역 KV 항목을 채점해 상위 512개를 고른다. 문맥이 100만 토큰이면 이 채점 자체가 문맥 길이에 비례해 커진다.
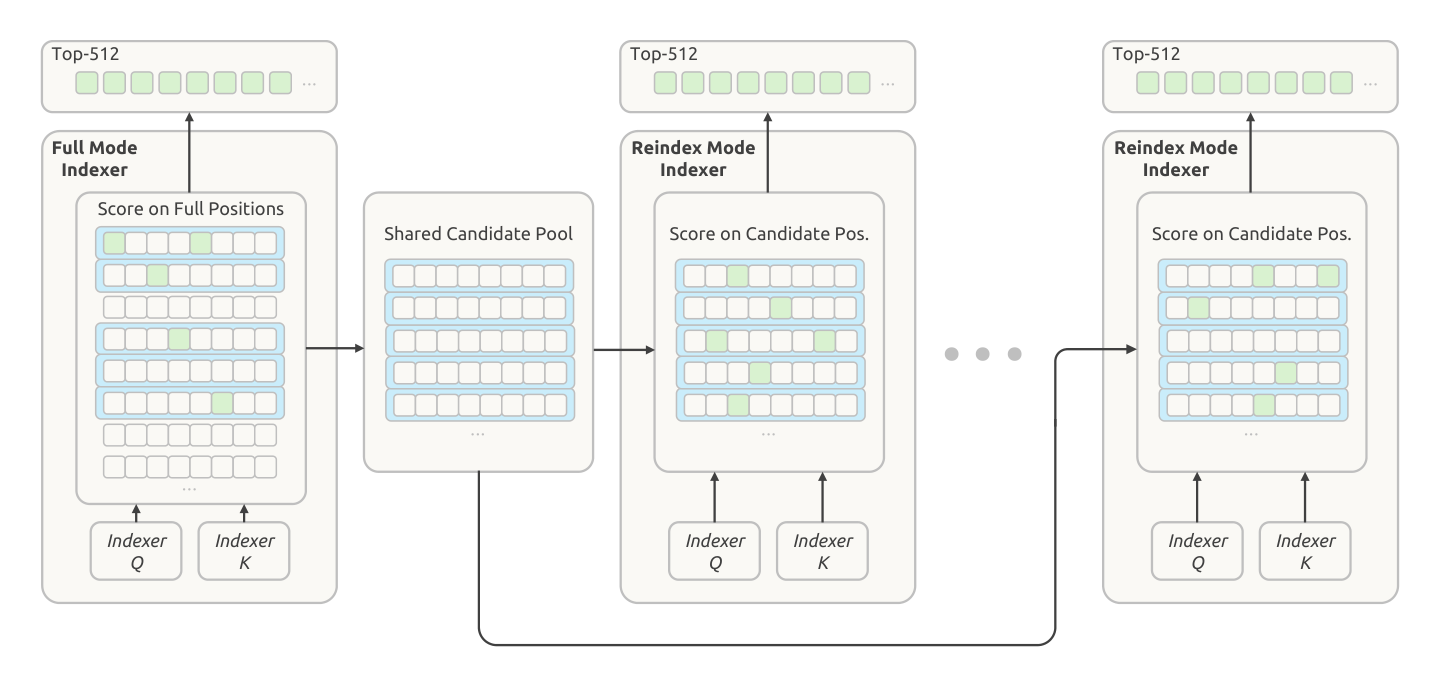 그림 3. 계층형 희소 인덱서. 디코더의 첫 Full 층이 후보 풀을 만들고, 뒤따르는 Reindex 층은 그 풀 안에서만 고른다. 출처: DeepSeek-V4.1-Flash 기술 보고서 Figure 5
V4.1의 디코더에서는 첫 Full 층의 인덱서만 문맥 전체를 채점한다. 이 인덱서는 자기 어텐션에 쓸 Top-512를 고르는 한편, 8개 위치를 한 블록으로 묶어 블록마다 최고 점수를 매긴다. 그런 뒤 점수가 높은 블록 2,048개를 골라 16,384개 위치로 된 후보 풀을 만든다. 뒤따르는 Reindex 층의 인덱서는 이 후보 풀 안에서만 채점해 각자 Top-512를 고른다. 후보 풀의 크기가 고정이므로 뒤쪽 인덱서의 쿼리당 비용은 문맥 길이와 무관하게 일정하다. 이 제한은 사후학습 단계에서 도입되며, 학습과 추론에서 같은 방식으로 적용된다.
보고서는 이 모든 변화를 합쳐 디코드 한 토큰의 연산량이 문맥 길이에 거의 영향을 받지 않게 되었다고 했다. 문맥을 4K에서 1M으로 256배 늘려도 디코드 FLOPs는 4분의 1만 늘어난다.
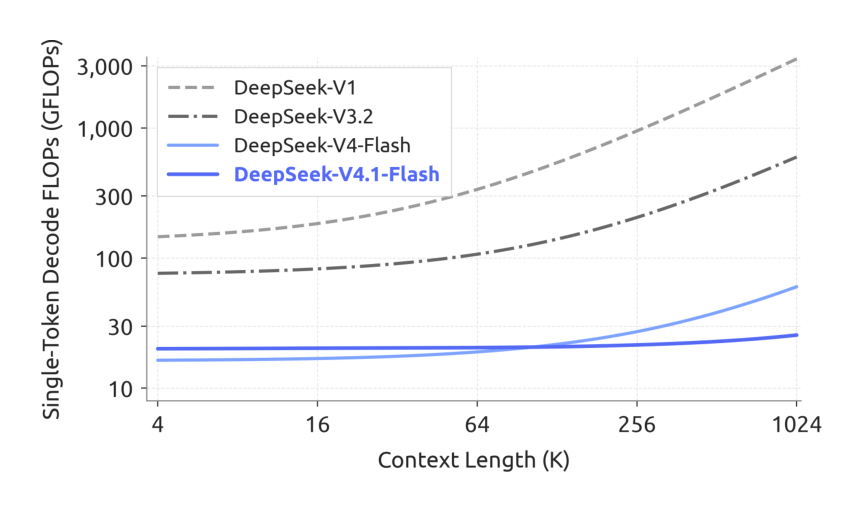 그림 4. 세대별 단일 토큰 디코드 FLOPs. BF16, FP8, FP4 연산을 1, 0.5, 0.25로 가중해 계산했다. 출처: DeepSeek-V4.1-Flash 기술 보고서 Figure 2
KV 캐시는 어떤 축에서 줄었는가
보고서는 KV 캐시를 줄일 수 있는 축을 세 개로 나눈다. 항목 하나의 크기, 시퀀스 방향의 항목 수, 그리고 층 방향의 항목 수다. 세 축에서 얻은 절감 비율은 서로 곱해진다. V4.1-Flash는 여기에 저장 정밀도를 하나 더 얹었다.
| 축 | V4.1-Flash의 처방 | 비고 |
|---|---|---|
| 항목 크기 | MLA 계열 잠재 벡터 512채널 | V2 이후 이어진 설계 |
| 시퀀스 | 인코더 CSA2가 2토큰을 1항목으로 압축 | 디코더는 압축 없음 |
| 층 | 40층 중 Full 층 4개만 전역 KV 보유 | CSA2 교차층 공유 |
| 정밀도 | 전역 KV를 FP4로 저장 | E2M1, 16채널마다 E4M3 스케일 하나 |
이 네 가지가 겹쳐 토큰당 전역 KV 캐시가 890바이트가 되었다. 보고서의 그림 1(b)는 세대별 수치를 나열한다.
| 모델 | 공개 시점 | 토큰당 전역 KV | 직전 세대 대비 |
|---|---|---|---|
| DeepSeek-V1 | 2023.11 | 389,120바이트 | |
| DeepSeek-V3.2 | 2025.12 | 48,068바이트 | 8.1배 감소 |
| DeepSeek-V4-Flash | 2026.04 | 3,514바이트 | 13.7배 감소 |
| DeepSeek-V4.1-Flash | 2026.09 | 890바이트 | 3.9배 감소 |
V1에서 V4.1-Flash까지 누적하면 약 437배다. 890바이트에 100만 토큰을 곱하면 약 0.93GB이니, 100만 토큰 문맥 하나의 전역 KV가 1GB 안에 들어간다.
FP4로 저장하는 이유와 방법
전역 KV를 FP4로 저장하기 위해, 보고서는 4비트 안팎의 여러 포맷을 비교했다. 그 뒤 E2M1 값에 16채널마다 E4M3 스케일 하나를 붙이는 형식을 골랐다. NVFP4를 따르되 그 위에 얹는 전역 스케일은 두지 않았다. 뺄 수 있었던 근거도 적혀 있다. RMS 정규화를 거친 512채널 KV 잠재 벡터의 L2 노름은 √512, 곧 22.6을 넘지 않는다. RoPE가 노름을 보존하므로 회전 뒤 채널별 최대 절대값도 이 범위를 벗어나지 않는다. 학습 중 관측된 최대값은 10 근처였고, 포맷이 표현하는 상한인 2,688에는 여유가 컸다. 그래서 전역 스케일을 빼도 측정 가능한 정확도 손실이 없었다고 한다.
FP4 저장은 사후학습 단계에서 양자화 인지 학습(QAT)으로 도입했다. 사전학습 때부터 FP4로 저장한 것은 아니다. 양자화는 RoPE를 적용한 뒤에 한다. RoPE 전에 양자화하면 정확도가 아주 조금 좋아지지만 디코딩 때 부담이 늘어난다고 했다. 반면 SWA KV는 양자화에 민감해서 FP8을 그대로 유지했다. V4의 FP8 전역 KV와 비교하면 저장 공간이 거의 절반이 된다.
영구 캐시는 SWA를 버려서 줄였다
여기까지가 HBM에 상주하는 런타임 KV 이야기다. 영구 KV 캐시로 넘어가면 사정이 달라진다. 에이전트 세션은 같은 프리픽스를 며칠에 걸쳐 다시 쓰기 때문에 DeepSeek은 전역 KV를 SSD에 72시간 이상 보존한다. V4 배포에서는 이 영구 캐시의 절반 가까이를 SWA KV가 차지했다.
보고서는 이것이 비용이 크면서 효과가 없는 저장이었다고 진단했다. 전역 KV는 오랜 시간에 걸쳐 다시 쓰이지만, SWA KV는 활성 세션 안에서 몇 분 동안만 쓰인다. 다음 턴이 시작되면 SWA KV는 더는 쓸모가 없다. V4 보고서에서도 SWA를 캐시하지 않고 다시 계산하는 Zero SWA Caching을 제안했다. 그런데 정확한 복원에는 L × n_win 토큰을 다시 순방향 계산해야 한다. 여기서 L은 층 수이고 n_win은 윈도 크기다. 두 값을 곱한 길이만큼 다시 계산해야 하므로, 실제 배포에서는 비용을 감당하기 어려웠다고 한다.
V4.1은 이 문제를 두 단계로 풀었다. 첫째, SWA KV를 영구 캐시에서 빼고 각 서버 호스트 DRAM의 10%로 만든 분산 메모리 풀에 둔다. 이 풀의 TTL, 곧 수명은 몇 분이다. 항목이 만료되면 새 세션이 그 공간을 바로 쓸 수 있다. 전역 KV만 72시간 이상 보존되는 영구 캐시에 남는다.
둘째, SWA KV가 없을 때는 SWA Bounded Replay로 복원한다. L × n_win 토큰을 모두 되돌리지 않고 마지막 n_win 토큰, 곧 128토큰만 다시 계산한다. 이때 SWA가 보는 범위를 재생 구간으로 제한해 근사 상태를 쓴다. 보고서는 SWA의 실제 유효 수용 범위가 이론값보다 훨씬 작다는 선행 연구를 근거로 들었다. 복원된 상태는 원래 상태와 수학적으로 같지 않다. 캐시 히트 위치에 따라 그 뒤 계산되는 KV가 조금씩 달라진다. 그런데 실험에서 응답 품질에 미치는 영향이 무시할 수준이었다고 한다. 사후학습에서 같은 재생 과정을 시뮬레이션해 모델이 이 근사에 적응하도록 했다.
이 재생 방식은 인코더와 디코더 두 곳에서 각각 다른 목적으로 쓰인다. 인코더 쪽에서는 프리픽스 캐시 히트를 전역 KV에만 의존하게 만들어 SWA KV를 영구 캐시에서 빼낸다. 디코더 쪽에서는 앞서 말한 CED의 문제를 푼다. 디코더 SWA KV를 만들기 위해 프롬프트 마지막 128토큰의 인코더 출력만 디코더 20층으로 통과시키고, 그 결과를 디코딩에만 쓴다. 이렇게 해서 프리필이 인코더에서 끝날 수 있고, 프리필 계산이 거의 절반으로 줄어든다.
두 요인이 곱해져 영구 KV 캐시는 V4-Flash의 8분의 1이 된다. SWA KV를 빼서 절반, 전역 KV의 압축으로 다시 4분의 1이다.
나머지 부품
전역 어텐션과 캐시 외에도 여러 부품이 바뀌었다.
Single-Pass mHC. V4에서 도입한 mHC는 잔차 흐름을 여러 개의 병렬 가닥, 곧 n개의 가닥으로 유지한다. 블록마다 은닉 상태에서 가닥을 섞는 계수를 예측한다. V4에서는 데이터 의존성 때문에 이 계산이 세 커널로 나뉘어 이상적인 메모리 트래픽의 두 배를 썼다. V4.1은 입력 혼합 계수를 한 블록 뒤로 밀어, 각 블록이 앞 블록이 만든 계수를 쓰게 했다. 그러면 의존성이 사라져 한 커널로 융합할 수 있다. 배포용 Mega-mHC 커널은 잔차를 한 번 읽고 한 번 써서 활성값 메모리 트래픽을 절반으로 줄였다.
Engram. DeepSeek과 베이징대 연구진이 올해 초 발표한 조건부 메모리 모듈이다. 지역 문맥의 N그램을 해시해 거대한 임베딩 표에서 한 줄을 꺼내 오는 구조인데, 이 모델은 1,960억 파라미터 규모의 Engram 모듈 두 개를 0부터 세어 1번 층과 14번 층에 나눠 넣었다. N그램 차수는 2, 3, 4이고 헤드는 8개, 헤드마다 약 1,600만 항목짜리 표를 가진다. 원 논문의 짧은 인과 합성곱은 추론 스택의 복잡도에 비해 이득이 작다며 뺐다. 조회 주소가 입력 토큰만으로 결정되므로 추론 때는 호스트 메모리에서 RDMA로 미리 가져올 수 있다. Engram 논문 자체는 지난 다이제스트에서 정리했다.
DSpark. 추측 디코딩 모듈이다. 128토큰 윈도를 가진 트랜스포머 블록 세 개가 한 번의 순방향 계산으로 초안의 다섯 위치에 해당하는 로짓을 병렬로 낸다. 가벼운 마르코프 헤드는 초안 토큰 사이의 의존성을 맡는다. 신뢰도 헤드가 위치별 수락 확률을 예측하고, 스케줄러가 그 확률과 엔진 처리량 곡선을 합쳐 요청마다 검증 길이를 정한다. V3의 MTP 모듈과 달리 사전학습이 끝난 뒤 백본을 고정한 상태에서 별도로 학습한다.
DeepSeek-ViT. 이미지 인코더는 처음부터 새로 학습했다. 32층 구조에 은닉 차원은 1,024이고 2D-RoPE를 쓴다. 3 × 3 픽셀 언셔플로 시각 토큰 수를 9분의 1로 줄여 약 1,344 × 1,344 해상도까지 받는다. MoE 라우팅에서는 텍스트와 이미지 토큰의 부하 보정 편향을 따로 관리한다.
성능과 한계
보고서는 사후학습에 알고리즘 혁신이 없다고 스스로 밝혔다. SFT, RL, 온폴리시 증류의 표준 순서를 V4 그대로 따랐고, 바뀐 것은 에이전트 과제와 환경을 대규모로 자동 합성하는 데이터 파이프라인이라고 했다. 추론 노력은 1에서 100까지 정수로 조절할 수 있다.
기반 모델 비교표에서 한 줄이 눈에 걸린다. 긴 문맥 벤치마크인 LongBench-V2에서 V4.1-Flash-Base는 45.2점으로 V4-Flash-Base의 44.7점과 거의 같았고, V4-Pro-Base의 51.5점에는 6점 넘게 뒤졌다. 100만 토큰을 가장 싸게 담아 두는 능력과 그 긴 문맥을 정확히 읽어 내는 능력은 이 표에서 따로 움직였다.
사후학습을 거친 모델의 평가에서는 Terminal-Bench 2.1, DeepSWE v1.1, AutomationBench 같은 에이전트 벤치마크에서 폐쇄형 최전선 모델과 비슷한 수준이라고 했다. 전문 지식이 필요한 과학 지향 에이전트 과제인 Terminal-Bench 4.0에서는 거대 모델과 격차가 남는다고 인정했다. 멀티모달에서는 시각 추론과 전문 차트 해석에서 Kimi-K3 같은 오픈소스 상위 모델을 앞서지만, 폐쇄형 거대 시스템과의 전반적 격차는 뚜렷하다고 적었다.
한계 절에는 연구진이 스스로 적어 둔 경고가 있다. 새로 도입한 구조에는 아직 충분히 규명하지 못한 견고성의 경계가 생겼다는 것이다. CSA2의 선택 오류와 SWA Bounded Replay의 근사 상태 복원이 시험하지 않은 경계 조건에서 능력 저하를 일으킬 수 있다고 했다. 연구진은 긴 문맥에서의 희소 검색과 캐시 재개 경계에서의 SWA 상태 복원을 앞으로 스트레스 테스트의 중점으로 삼겠다는 계획도 밝혔다.
공개 첫날 Hugging Face 토론에서는 참고용 추론 코드의 결함이 하나 보고되었다. 2:1 압축에서 그룹의 첫 토큰이 들어오면 압축 항목이 아직 만들어지지 않는데, 이때 인코더의 인덱서가 공유 슬롯에 남아 있던 디코더의 인덱서 K를 읽는다는 것이다. 영향받는 층은 인코더의 Full 층인 2, 8, 14번이었다.4 KV를 층 사이에서 돌려 쓰는 설계가 구현에서 어떤 종류의 함정을 만드는지 보여 주는 사례다.
가장 흥미로운 지점
내가 가장 오래 곱씹은 것은 이 모델이 층을 계산 단위와 기억 단위로 나눴다는 점이다. 트랜스포머에서 층은 표현을 다듬는 단위이면서 동시에 그 층의 기억, 곧 KV를 만드는 단위였다. 이 모델은 그 둘을 떼어 놓았다. 40층이 계산을 하지만 기억은 네 곳에서만 만들어지고, 디코더의 기억은 디코더가 계산하지 않은 인코더 출력에서 나온다. 나는 이 설계가 낯설게 보이는 이유를 여기서 찾는다. 우리가 층에 대해 품고 있던 암묵적 전제가 깨진 것이다.
한 가지 더 눈여겨본 것은 근사를 설계로 받아들인 태도다. SWA Bounded Replay가 복원하는 상태는 원래 상태와 같지 않다고 보고서가 직접 적었다. 캐시 히트 위치에 따라 결과가 달라진다는 뜻이다. 연구진은 그 차이를 고쳐야 할 결함으로 다루지 않았다. 저장과 계산 사이의 새로운 교환 조건으로 놓고, 사후학습에서 그 근사를 미리 겪게 해서 모델이 적응하도록 했다. 정확한 복원을 포기하는 대신, 모델이 부정확한 복원에 익숙해지도록 학습시킨 셈이다. 이 방식이 캐시 재개 경계에서 어떤 실패를 낳을지는 연구진도 아직 모른다고 했고, 나 역시 확인할 길이 없다. 한계 절에 그 불확실성을 그대로 적어 둔 점은 이 보고서에서 내가 가장 믿음이 가는 대목이었다.
출처
DeepSeek-AI, “DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression”, 기술 보고서, 2026년 9월 10일. 원문: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf 모델 카드: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash 공지: https://www.deepseek.com/en/news/deepseek-v4-1-flash/
Hacker News, “DeepSeek v4.1 Flash” 토론, 2026년 9월 10일. https://news.ycombinator.com/item?id=49639090 ↩︎
teortaxesTex의 X 게시물을 인용한 OrcaRouter 블로그, “DeepSeek V4.1 Flash: New Base Model, Not a Point Release”, 2026년 9월 10일. https://www.orcarouter.ai/blog/deepseek-v4-1-new-base-model ↩︎
Yutao Sun 외, “You Only Cache Once: Decoder-Decoder Architectures for Language Models”, NeurIPS 2024. https://arxiv.org/abs/2405.05254 ↩︎
Hugging Face 토론 #12, “Restore each indexer’s K cache on incomplete compression steps”, 2026년 9월 10일. https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/discussions/12 ↩︎