3줄 요약
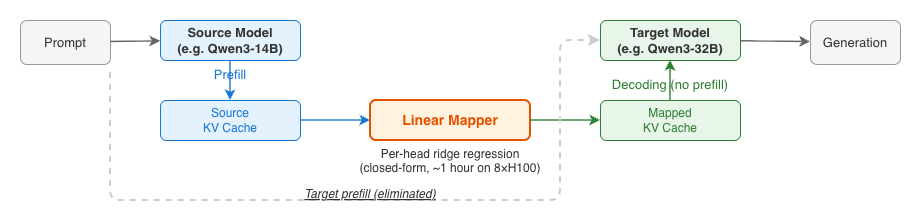
- NVIDIA 연구진 아홉 명이 2026년 8월 4일 arXiv에 공개한 논문이다. 서비스 운영에서는 비용과 품질의 균형을 맞추기 위해 같은 계열의 작은 모델과 큰 모델을 번갈아 쓰는 일이 흔하다. 그런데 모델을 바꿀 때마다 새 모델은 그때까지 쌓인 컨텍스트 전체를 프리필1로 다시 계산해야 한다. 논문은 이전 모델이 만든 KV 캐시를 새 모델의 형식으로 변환해 그대로 쓰는 방법을 제안한다. 연구진은 이를 교차 모델 KV 캐시 전이(cross-model KV cache transfer)라 부른다.
- 연구진은 KV 헤드 수와 헤드 차원이 같은 모델 쌍이라면 두 모델의 KV 사이에 선형 관계가 강하게 나타난다는 것을 확인했다. Qwen3 14B에서 32B로 전이하는 쌍을 보면, 소스 모델의 층 하나로 설명되는 분산이 타깃의 키에서 56%, 값에서 32%에 달한다. 소스 층을 여러 개 함께 쓰면 이 비율은 키 79%, 값 65%로 높아진다. 연구진은 이 관찰을 바탕으로 경사 하강 학습 없이 닫힌 형태의 해를 한 번에 구하는 헤드별 리지 회귀 매퍼를 만들었다.
- 실험한 모델 쌍은 세 계열에 걸쳐 여섯 개였다. 그 가운데 네 쌍에서는 매핑한 캐시로 얻은 정확도가 타깃 모델이 직접 프리필했을 때 정확도의 73~98%에 이르렀다. 반면 Ministral 3의 나머지 두 쌍은 40%대에 그쳤다. 실패한 두 쌍에 비선형 MLP를 쓰자 HellaSwag 유지율이 최대 36.8%p 높아졌다. 매퍼는 다시 프리필하는 것보다 2.7~25배 빨랐다. 연구진은 쌍마다 결과가 다른 이유가 오차의 크기보다 오차 집중도에 있다고 본다. 오차 집중도는 오차가 어텐션 계산에 크게 반영되는 성분에 얼마나 집중되는지를 뜻한다.
모델을 바꾸면 프리필을 다시 해야 한다
논문이 다루는 상황은 실제 서비스 운영에서 흔하다. 캐스케이딩은 쉬운 요청을 작은 모델이 처리하고, 어려운 요청만 큰 모델이 처리하게 하는 방식이다. 대화 중 모델 교체와 요청별 라우팅도 같은 계열에서 크기가 다른 모델을 오가며 이뤄진다. 여기에 에이전트 세션이 길어지면서 한 세션에 쌓이는 컨텍스트도 늘었다.
모델을 바꾸면 새로 요청을 받은 모델은 그때까지 쌓인 컨텍스트 전체를 프리필로 다시 계산한다. 프리필 비용은 모델이 크고 프롬프트가 길수록 늘어난다. 프리픽스 캐싱은 같은 모델이 받은 요청끼리만 캐시를 재사용하기 때문에, 모델을 바꾸는 경우에는 도움이 되지 않는다.
연구진은 프리필의 산출물이 KV 캐시라는 점에 주목했다. 한 모델의 KV 캐시를 다른 모델이 기대하는 형식으로 변환할 수 있으면 프리필을 생략할 수 있다. 변환은 양방향으로 쓸 수 있어서, 작은 모델에서 큰 모델로 전이하면 품질이 오르고 큰 모델에서 작은 모델로 전이하면 비용이 줄어든다. 논문은 연구 범위를 같은 계열의 모델끼리로 한정했다.
변환이 어려운 이유는 두 모델의 층 수, 은닉 차원, KV 헤드 구성이 서로 다를 수 있기 때문이다. 기존 연구는 이 차이를 학습으로 메우거나 아키텍처에 강한 가정을 두었다. 논문은 기존 연구와 다음처럼 비교했다.
| 방법 | 경사 학습 불필요 | 크기가 다른 모델 간 전이 | KV 값 자체를 전이 | 닫힌 형태의 해 |
|---|---|---|---|---|
| C2C | 아니오 | 예 | 예 | 아니오 |
| LatentAlign | 아니오 | 예 | 예 | 아니오 |
| IAM | 예 | 예 | 아니오 | 아니오 |
| DroidSpeak | 예 | 해당 없음 | 예 | 해당 없음 |
| 이 논문 | 예 | 예 | 예 | 예 |
C2C는 모델 쌍마다 신경망 퓨저를 학습하고, LatentAlign은 모델마다 공유 잠재 공간으로 변환하는 어댑터를 학습한다. IAM은 KV 값을 전이하지 않고, 타깃의 어텐션 패턴을 작은 모델의 어텐션 패턴으로 대체한다. DroidSpeak은 은닉 크기, 층 수, 헤드 구성이 모두 같은 모델 사이에서만 KV를 공유한다. 저자들은 교차 모델 KV 관계가 학습 없이 닫힌 형태의 해로 풀릴 만큼 단순한지를 조사한 연구는 자신들이 아는 한 없었다고 밝혔다.
논문은 소스와 타깃의 KV 헤드 수와 헤드당 차원이 같은 쌍을 matched-KV 쌍(이하 KV 일치 쌍)이라 부른다. 층 수나 파라미터 수는 달라도 되며, 실험한 여섯 쌍은 모두 KV 일치 쌍이다.
두 모델의 KV 사이에는 선형 구조가 있다
매퍼를 설계하기 전에, 연구진은 Qwen3에서 두 모델의 KV 관계가 어떤 구조인지부터 조사했다. 저자들은 모델이 실제로 사용하는 키, 위치에 따라 적용되는 RoPE2 회전을 제거한 키, 위치 인코딩이 없는 값의 세 종류로 캐시를 구분해 살폈다.
연구진은 캐시 종류와 소스 층, 타깃 층, 헤드의 모든 조합에 토큰 단위 최소제곱 회귀를 하나씩 적합했다. 소스 층 하나의 토큰별 특징 벡터로 타깃 층의 벡터를 예측하는 회귀이며, 적합 품질은 결정계수 R²을 타깃 헤드 전체에 대해 평균한 값으로 쟀다. 그림 1은 그 값을 소스 층과 타깃 층의 조합별로 표시한 히트맵이다.
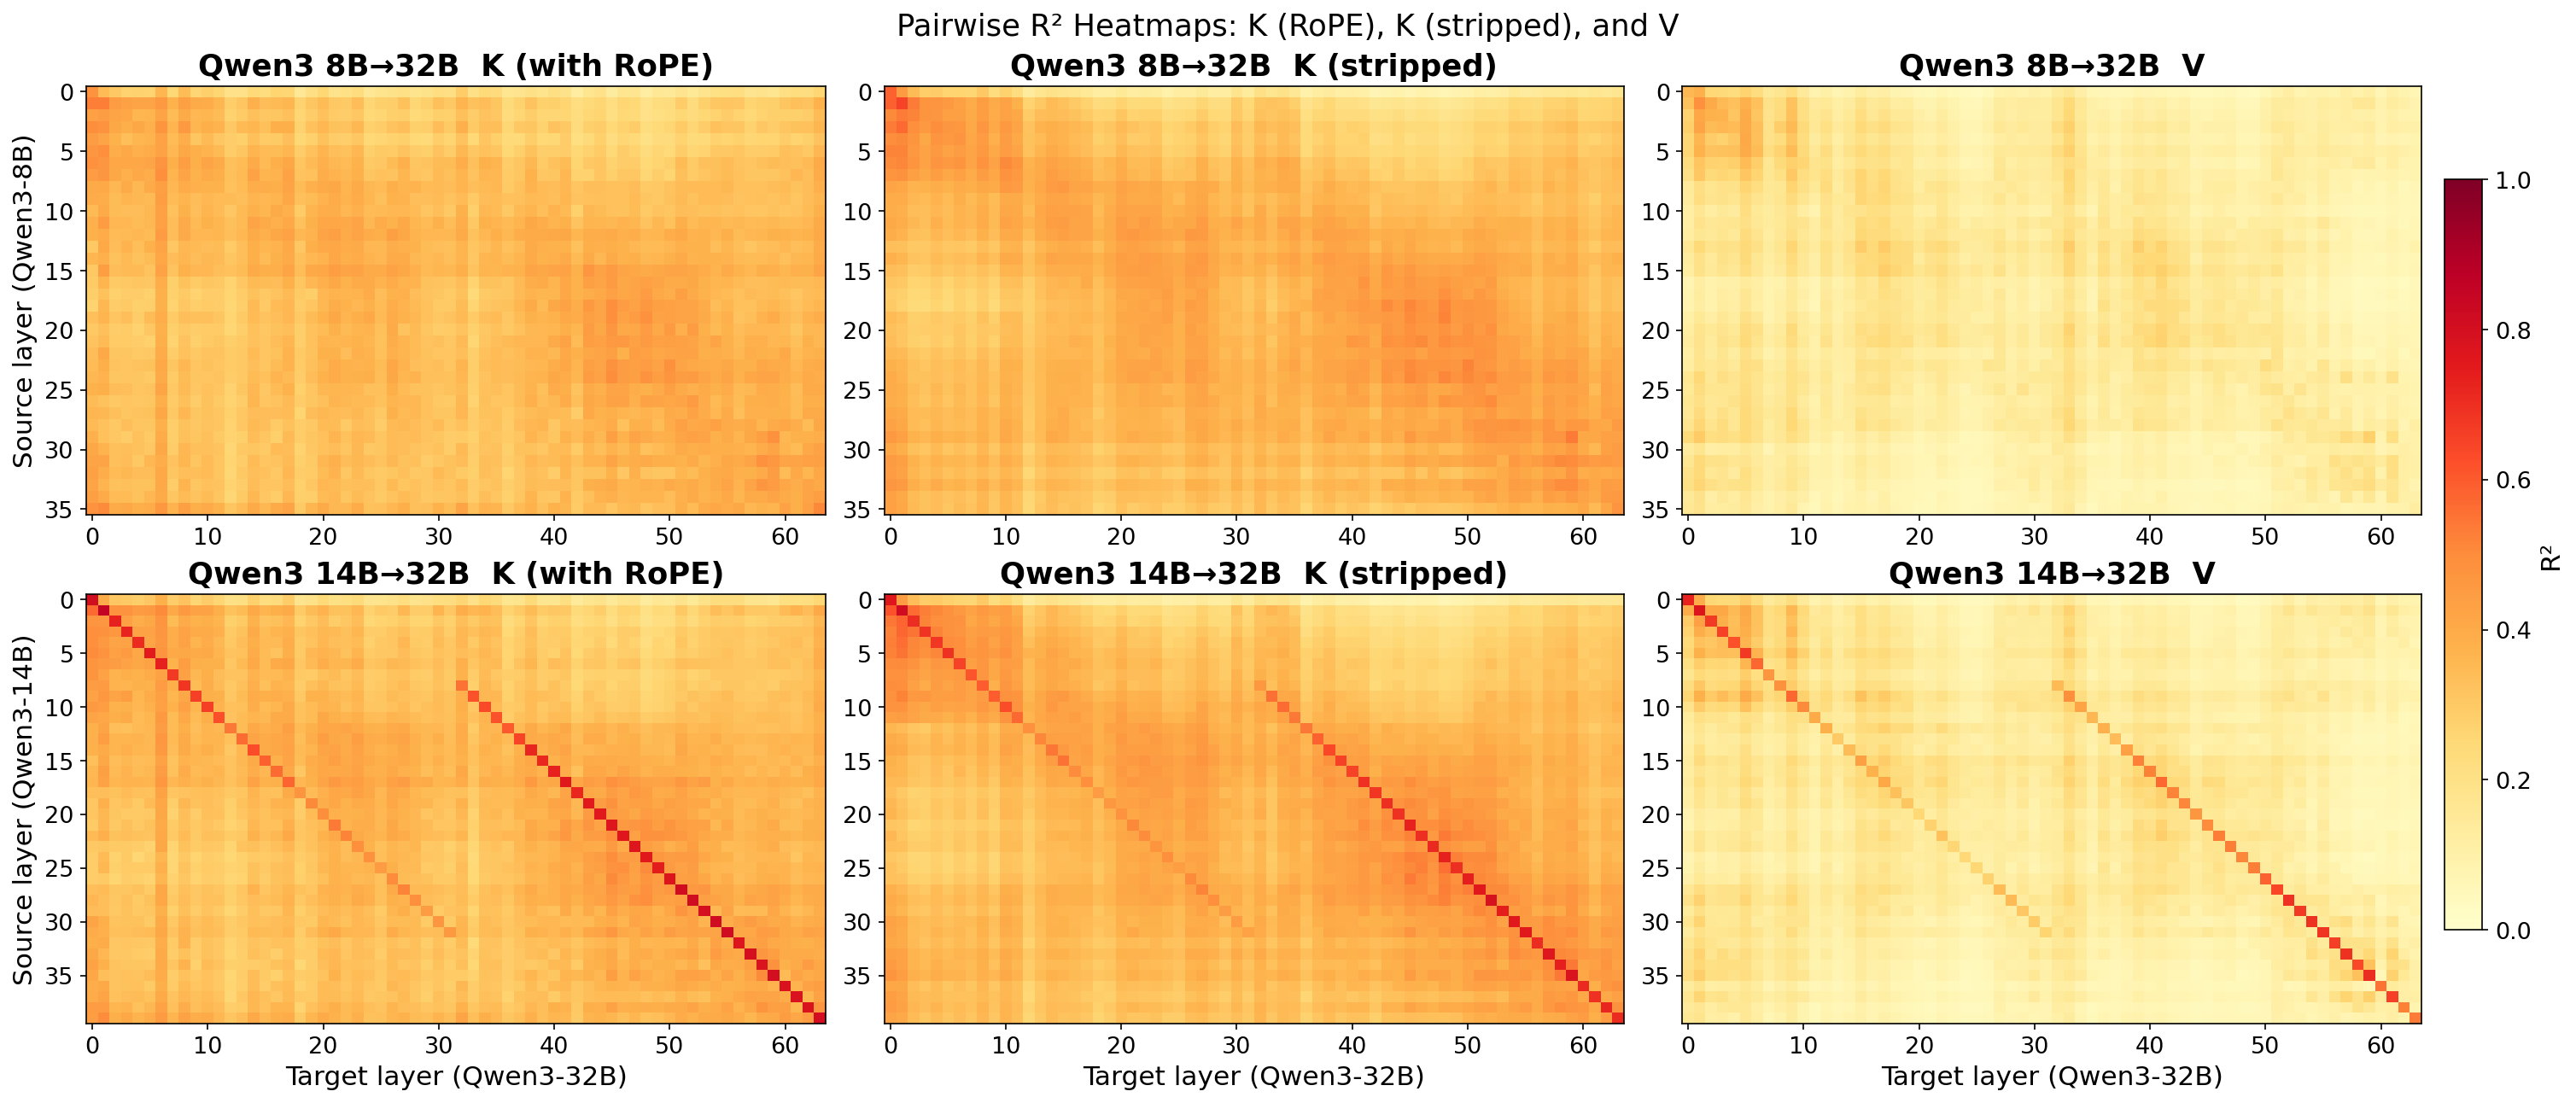 그림 1. 단일 소스 선형 회귀로 잰 헤드 평균 R². 행은 소스 층, 열은 타깃 층이다. 출처: 논문 Figure 2
논문은 히트맵에서 네 가지 경향을 확인했다.
- 선형 회귀 하나로도 타깃 KV 분산의 상당 부분을 설명할 수 있다. RoPE를 제거한 키 기준으로, 헤드 평균 R²이 가장 높은 조합은 Qwen3 14B→32B에서 0.81, 8B→32B에서 0.65였다.
- 아키텍처와 층 수의 차이가 작은 쌍일수록 대각선이 선명하고, 차이가 클수록 패턴이 흐려진다.
- RoPE는 적합을 방해한다. RoPE를 제거하면 대체로 대각선이 더 선명해진다.
- 키가 값보다 예측하기 쉽다. 헤드 평균 R²은 보통 키가 값보다 0.2가량 높다.
소스 층은 몇 개가 필요한가
단일 층 조사에 이어 저자들은 R²을 가장 크게 높이는 소스 층을 하나씩 추가하는 탐욕적 전진 선택을 실행했다. 타깃 층 하나를 예측하는 데 필요한 정보는 여러 소스 층에 분산되어 있었다. 층을 하나만 쓰는 경우(k=1)에 얻은 R²은 Qwen3 14B→32B 기준으로, 모든 층을 쓸 때와 비교해 RoPE를 제거한 키에서 66%, 값에서는 절반에도 못 미치는 42%였다. R²은 k=1에서 k=4 사이에 가장 크게 올랐고, k=6에서 모든 층을 쓸 때와 거의 같아졌다.
| 소스 층 수 k | 키 R² | 값 R² |
|---|---|---|
| 1 | 0.56 | 0.32 |
| 8 | 0.79 | 0.65 |
| 전체 | 0.85 | 0.76 |
매퍼의 구조
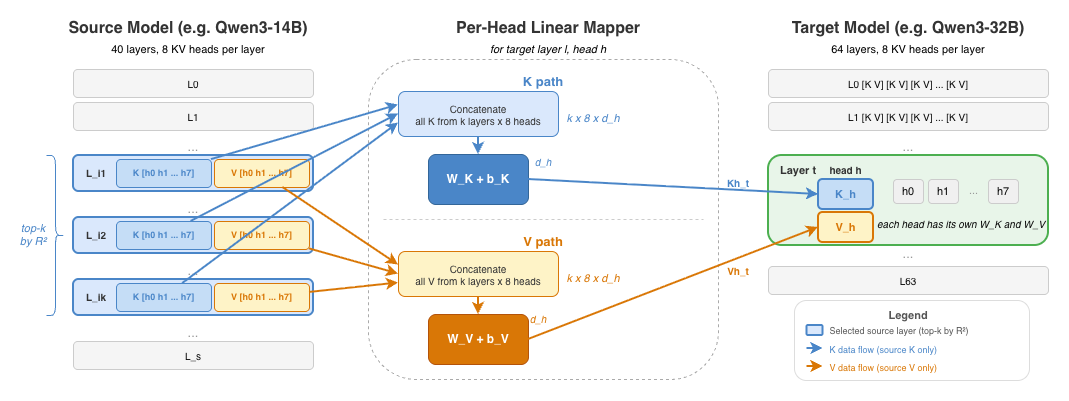 그림 2. 타깃 층 l, 헤드 h 하나에 대한 헤드별 선형 매퍼. 출처: 논문 Figure 3
매퍼는 타깃 모델의 층과 헤드마다 따로 적합하는 선형 변환이다. 매퍼는 헤드별 리지 회귀, 층 교차 소스 선택, RoPE를 제거한 내용 공간 매핑의 세 요소로 구성된다. 헤드 사이에도, 키와 값 사이에도 파라미터를 공유하지 않는다.
헤드별 리지 회귀
타깃 층 l, 헤드 h의 키를 예측할 때는 선택된 소스 층의 키 특징을 연결해 행렬 X를 만든다. 여기에 가중치 W를 곱하고 편향 b를 더한다. 값도 같은 방식으로 예측한다. 보정 토큰 N개로 만든 설계 행렬 X와 응답 행렬 Y에 대해, 가중치의 해는 다음과 같다.
$$ \mathbf{W}^{*}=(\mathbf{X}^{\top}\mathbf{X}+\lambda\mathbf{I})^{-1}\mathbf{X}^{\top}\mathbf{Y} $$연구진은 수치 안정성을 위해 순수 최소제곱 대신 λ=0.01의 리지 회귀3를 택했다. k가 크면 특징 차원이 수만에 이르고, 선택된 소스 층들은 애초에 예측력이 높은 층을 고른 것이라 서로 상관이 높다. 그러면 XᵀX가 특이 행렬에 가까워진다. 풀기 전에 X와 Y를 중심화하고, 편향은 두 평균의 차이로 복원한다.
보정에는 FineWeb-Edu의 1,024토큰 시퀀스 500개를 썼다. 연구진은 4토큰 간격으로 표본을 추출해 타깃 헤드마다 약 12만 8천 개의 토큰 관측치를 얻었다. 경사 하강 학습은 사용하지 않았다. 모델 쌍 하나의 매퍼를 적합하는 데는 H100 GPU 8개로 구성된 노드 하나에서 47~87분이 걸렸다. 시간이 가장 많이 드는 일은 XᵀX 계산이다. 이 행렬은 타깃 층마다 한 번만 계산해 해당 층의 헤드가 함께 쓴다.
층 교차 소스 선택
소스 모델과 타깃 모델의 층 수가 다르므로, 타깃 층마다 입력으로 쓸 소스 층을 정해야 한다. 매퍼는 타깃 층별로 RoPE를 제거한 키와 값의 헤드 평균 R²이 높은 소스 층 k개를 고른다. 그런 다음 그 층들의 KV 헤드를 모두 연결해 입력으로 사용한다. 같은 타깃 층의 헤드는 같은 소스 층 집합을 공유한다. 따라서 소스 헤드 전체의 정보가 입력에 포함된다. k는 쌍마다 스윕으로 정한다. 논문은 세 요소 가운데 이 선택의 기여가 가장 크다고 보고했다.
RoPE를 제거한 내용 공간 매핑
RoPE는 쿼리와 키에 위치별 회전을 적용하는데, KV 캐시에는 회전이 적용된 키만 저장된다. 매퍼는 소스 키에 소스 RoPE의 역회전을 적용해 위치 정보를 제거하고, 위치와 무관한 공간에서 가중치를 곱한 뒤, 타깃의 RoPE를 다시 적용한다.
$$ \hat{\mathbf{K}}_{t}=(\mathbf{K}_{s}\,\mathbf{R}_{\Theta_{s}}^{-1}(t)\,\mathbf{W}_{K}+\mathbf{b}_{K})\,\mathbf{R}_{\Theta_{t}}(t) $$보정 단계에서도 타깃 모델의 실제 키에서 RoPE를 제거해 회귀 목표로 쓰기 때문에, 가중치는 처음부터 끝까지 위치와 무관한 공간에서 적합된다. 회전 행렬은 직교 행렬이라 역변환이 정확하고 계산 비용도 거의 없다. 값에는 위치 인코딩이 없어서 그대로 매핑한다.
논문에 따르면 RoPE가 적용된 키로 바로 적합했을 때도 짧은 컨텍스트 벤치마크에서는 성능 차이가 거의 없었다. 그러나 그렇게 적합한 가중치는 보정에 쓴 1,024토큰 길이의 위치 분포에 종속된다. RoPE를 분리한 방식은 구성상 더 긴 컨텍스트에도 적용할 수 있고, 저자들은 이 점이 최대 32k 토큰 프롬프트를 서빙할 때 중요하다고 설명했다.
실험 설정
실험에는 세 계열의 KV 일치 쌍 여섯 개를 썼다.
| 계열 | 소스 → 타깃 | 파라미터 비율 | KV 헤드 | 헤드 차원 | 층 수 비율 |
|---|---|---|---|---|---|
| Qwen3 | 8B, 14B → 32B | 2.3~4배 | 8 → 8 | 128 → 128 | 1.6~1.8배 |
| Llama 3.1 | 8B → 70B | 8.8배 | 8 → 8 | 128 → 128 | 2.5배 |
| Ministral 3 | 3B, 8B → 8B, 14B | 1.8~4.7배 | 8 → 8 | 128 → 128 | 1.2~1.5배 |
세 계열 모두 모든 층이 전체 어텐션을 쓰는 dense 모델이어서, 타깃의 모든 층이 매핑된 KV를 받는다. Qwen3과 Ministral 3은 사후 학습을 마친 모델을, Llama 3.1은 베이스 모델을 썼고, 모두 completion 모드로 평가했다.
정확도 벤치마크로는 ARC-Challenge, HellaSwag, WinoGrande, MMLU(5-shot), GSM8K(8-shot 사고 연쇄)의 다섯 가지를 썼고, 언어 모델링 품질은 WikiText-2 퍼플렉시티로 쟀다. 멀티턴 전환은 CoQA로 따로 평가했다. 다섯 벤치마크 가운데 GSM8K만 답을 생성해 채점하고, 나머지 넷은 로그 우도로 채점한다.
핵심 지표인 유지율(retention)은 전이 정확도를 타깃 모델 단독 정확도로 나눈 값이다. 그런데 벤치마크마다 무작위로 답했을 때의 점수가 다르다. ARC-C, HellaSwag, MMLU는 25%이고, WinoGrande는 50%, GSM8K는 약 0%다. 이 차이를 보정하려고 연구진은 무작위 수준을 0%, 타깃 모델 단독 정확도를 100%로 두는 하한 정규화 유지율도 함께 보고했다. 예를 들어 Qwen3 32B를 타깃으로 했을 때 WinoGrande에서 48.5점을 받은 매퍼의 유지율은 69.2%다. 하지만 하한 정규화 유지율은 무작위 수준보다 낮은 −7.7%다.
소스 층 수 k는 {1, 2, 4, 6, 8, 10, 12, 16, 20, 24, 전체} 가운데 로그 우도 벤치마크 정확도의 평균을 최대로 만드는 값을 쌍마다 하나씩 골랐다. GSM8K, CoQA, 지연 시간은 이 선택에 쓰지 않았다. 이렇게 고른 k에서 매퍼 하나는 쌍에 따라 10억~34억 개의 파라미터를 가지며, 저장하려면 4~12GB의 공간이 필요하다.
주요 결과: 네 쌍은 성능을 유지했고 두 쌍은 급락했다
작은 모델에서 큰 모델로 전이한 결과다. 벤치마크 열의 값은 유지율이고, 평균은 다섯 벤치마크의 평균이다.
| 계열 | 쌍 (k) | 평균 | 하한 정규화 평균 | ARC-C | HellaSwag | WinoGrande | MMLU | GSM8K |
|---|---|---|---|---|---|---|---|---|
| Qwen3 | 14B→32B (8) | 97.6% | 96.3% | 101.0% | 97.6% | 98.5% | 95.0% | 95.6% |
| Qwen3 | 8B→32B (12) | 87.5% | 80.7% | 94.0% | 95.2% | 91.0% | 88.5% | 68.8% |
| Llama 3.1 | 8B→70B (20) | 72.8% | 62.9% | 90.9% | 94.4% | 87.1% | 73.3% | 18.2% |
| Ministral 3 | 3B→8B (전체) | 76.2% | 65.9% | 90.6% | 93.3% | 91.3% | 69.4% | 36.6% |
| Ministral 3 | 3B→14B (20) | 44.2% | 14.7% | 43.6% | 68.0% | 74.0% | 32.0% | 3.2% |
| Ministral 3 | 8B→14B (12) | 41.6% | 11.1% | 40.7% | 58.7% | 74.2% | 32.7% | 1.6% |
연구진은 결과를 두 등급으로 분류했다.
- 1등급: Qwen3의 두 쌍, Llama 3.1 8B→70B, Ministral 3B→8B의 네 쌍은 다섯 벤치마크 평균으로 타깃 정확도의 73~98%를 유지했다. 이 가운데 Llama 3.1 쌍은 파라미터 비율이 8.8배로, 실험한 쌍 중 가장 크다.
- 2등급: Ministral 8B→14B와 3B→14B는 평균 유지율이 42~44%로 떨어졌고, 하한 정규화 기준으로는 11~15%였다.
두 등급의 결과를 근거로 저자들은 KV 구성이 일치하는 것이 성공과 상관은 있지만 성공을 보장하지는 않는다고 정리했다. 벤치마크 중에서는 생성형인 GSM8K의 편차가 가장 컸다. 1등급에 속한 Llama 3.1 8B→70B도 GSM8K에서는 18.2%, Ministral 3B→8B는 36.6%만 유지했다.
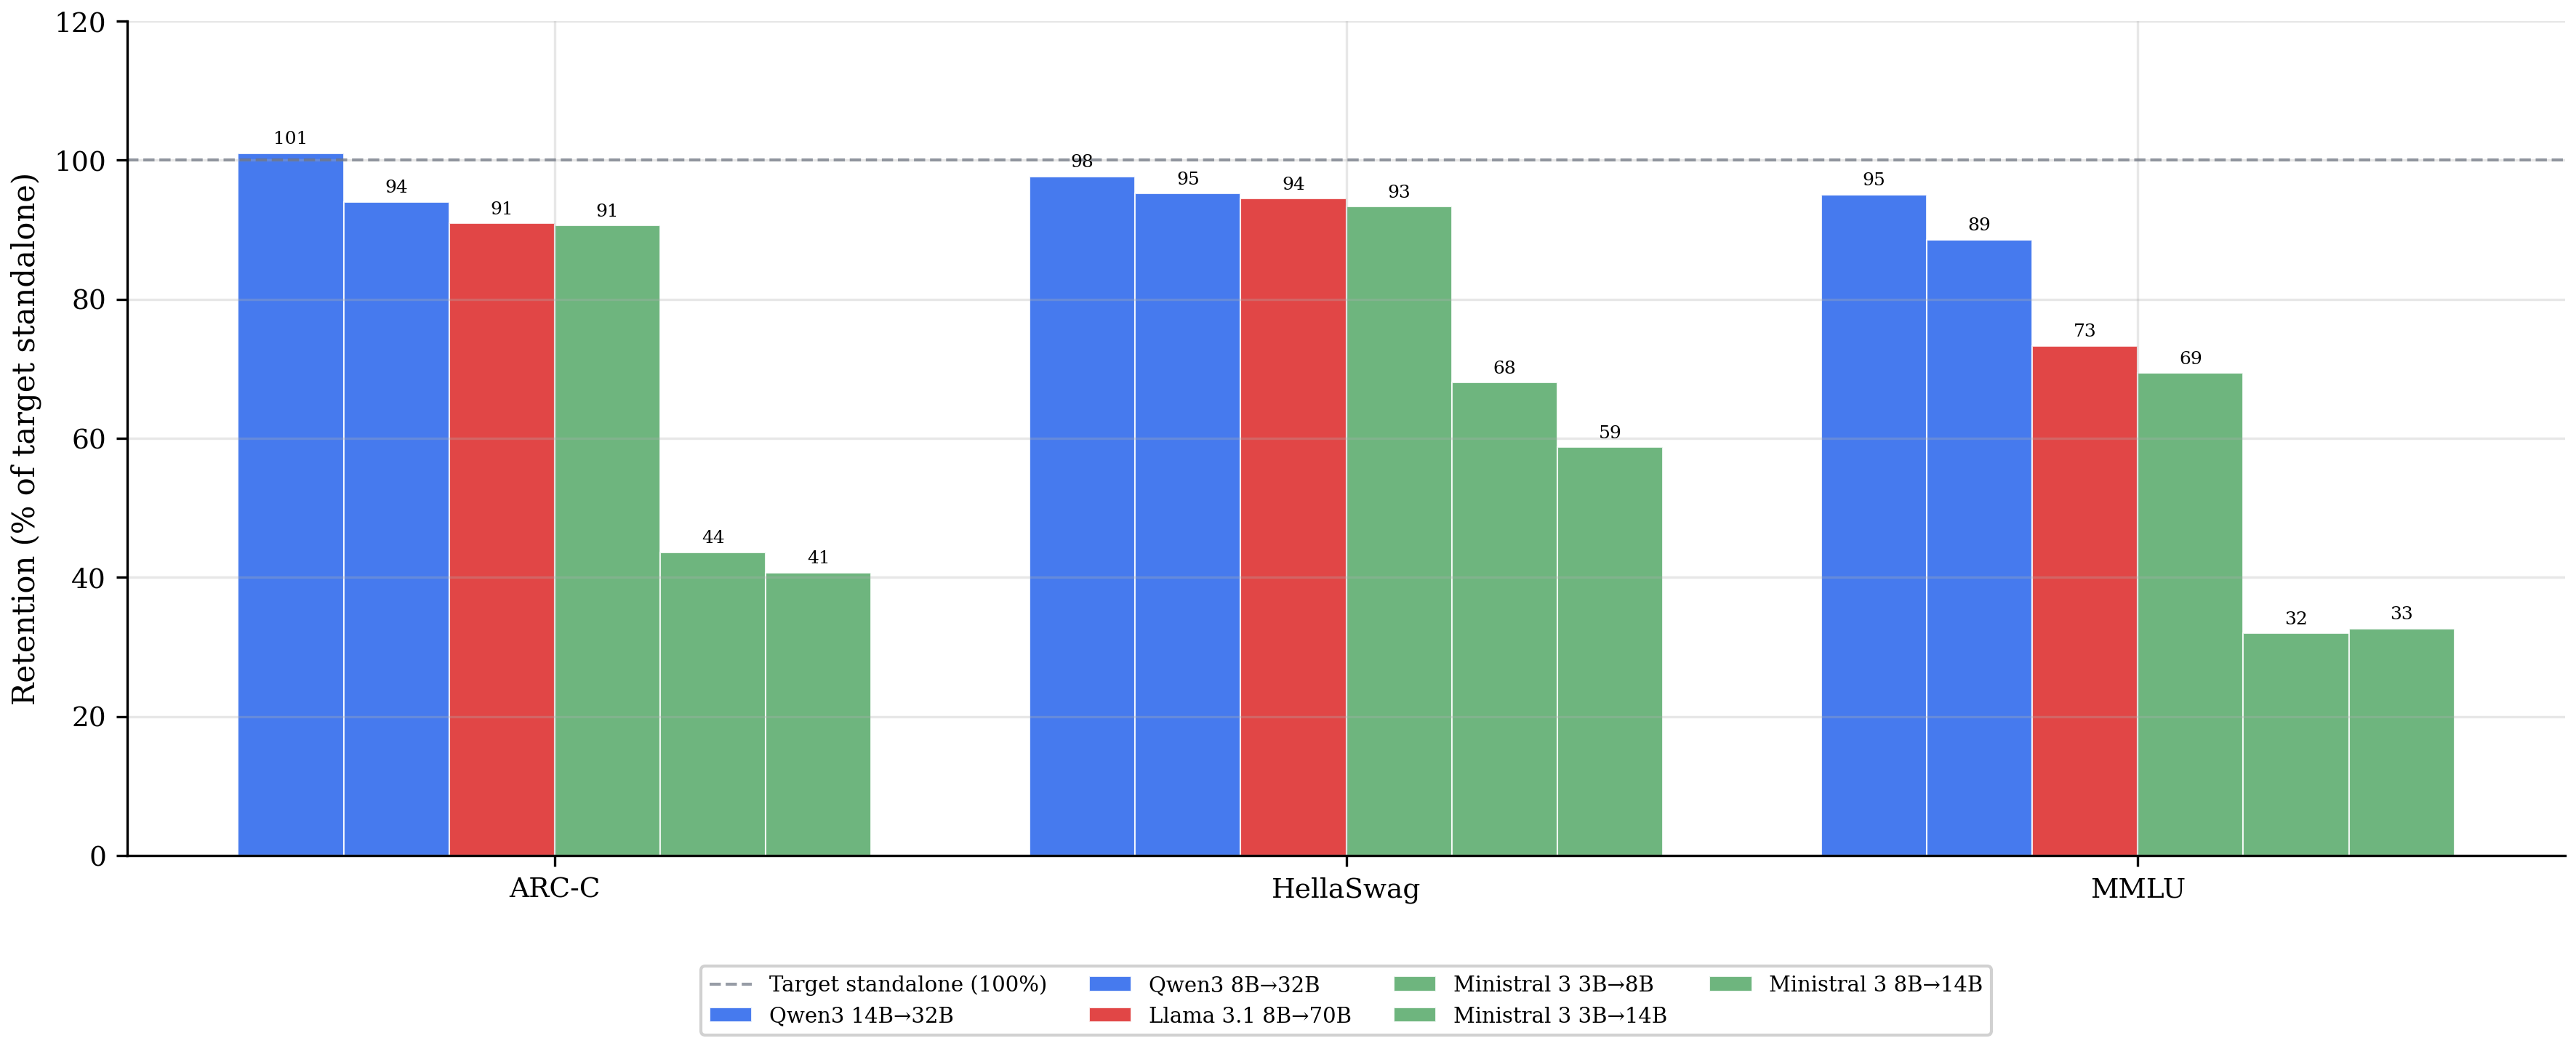 그림 3. 벤치마크별 유지율(타깃 단독 정확도 대비 %). 출처: 논문 Figure 8
k 선택에 쓰지 않은 PIQA, BoolQ, ARC-Easy로 따로 평가해도 두 등급의 차이는 그대로였다. 1등급 네 쌍의 평균 유지율은 96.8~99.9%였고, 2등급 두 쌍은 63.7%와 59.3%였다.
구성 요소별 기여
구성 요소별 기여는 유지율이 가장 높은 Qwen3 14B→32B에서 하나씩 제거해 가며 쟀다. 성능이 가장 좋은 쌍이라 성능 저하가 가장 잘 드러난다는 이유였다. 벤치마크 열의 값은 정확도(%)이고, PPL은 WikiText-2 퍼플렉시티다.
| 구성 | ARC-C | HellaSwag | WinoGrande | MMLU | GSM8K | PPL |
|---|---|---|---|---|---|---|
| 32B 단독 (참고) | 61.01 | 82.65 | 70.01 | 82.17 | 95.15 | 6.79 |
| 전체 (k=8, 리지, 내용 공간) | 61.60 | 80.70 | 68.98 | 78.09 | 90.98 | 7.33 |
| 추론 시 타깃 RoPE 재적용 생략 | 44.97 | 75.39 | 56.59 | 25.79 | 4.17 | 7.70 |
| RoPE 분리 없음 (적합과 추론 모두 RoPE 유지) | 61.09 | 80.73 | 68.59 | 77.70 | 90.98 | 7.35 |
| RoPE 분리 없음, k=1 | 27.65 | 44.81 | 51.78 | 26.07 | 0.38 | 22.73 |
| RoPE 분리 없음, k=1, 리지 대신 최소제곱 | 36.43 | 62.26 | 51.22 | 51.26 | 1.44 | 9.86 |
논문은 이 표에서 세 가지를 관찰했다.
- 층 교차 소스 선택의 기여가 가장 크다. k를 8에서 1로 줄이면 키 R²이 0.79에서 0.56으로 떨어지고, ARC-C, WinoGrande, MMLU의 정확도는 무작위 수준에 가까워진다.
- RoPE 처리가 미치는 영향은 벤치마크마다 다르다. 내용 공간에서 적합한 가중치를 쓰면서 추론할 때 타깃 RoPE를 다시 적용하지 않으면, 적합 조건과 평가 조건이 일치하지 않게 된다. 이 경우 MMLU와 GSM8K는 거의 무작위 수준으로 떨어졌지만 HellaSwag는 약 5%p 떨어지는 데 그쳤다.
- 보정 설정에는 둔감하다. λ를 0에서 0.1까지 바꿨을 때 HellaSwag 정확도의 차이는 1%p 이내였고, λ=1에서만 15.79%p 떨어졌다. 보정 시퀀스 수는 200개부터 결과가 거의 같았고, 50개만 써도 기본 설정(500개)과의 차이가 1.64%p였다.
소스 층 수에 따른 하류 정확도에서도 R²과 같은 포화 패턴이 나타났다. k=1은 모든 쌍에서 부족해서, 쌍마다 적어도 한 벤치마크에서 정확도가 크게 떨어졌다. 규모 차이가 작은 쌍일수록 작은 k에서 포화했다. Qwen3 14B→32B는 k=8에서 HellaSwag 최고치와의 차이가 0.3%p 이내였고, Llama 3.1 8B→70B는 k=24까지 계속 올랐다.
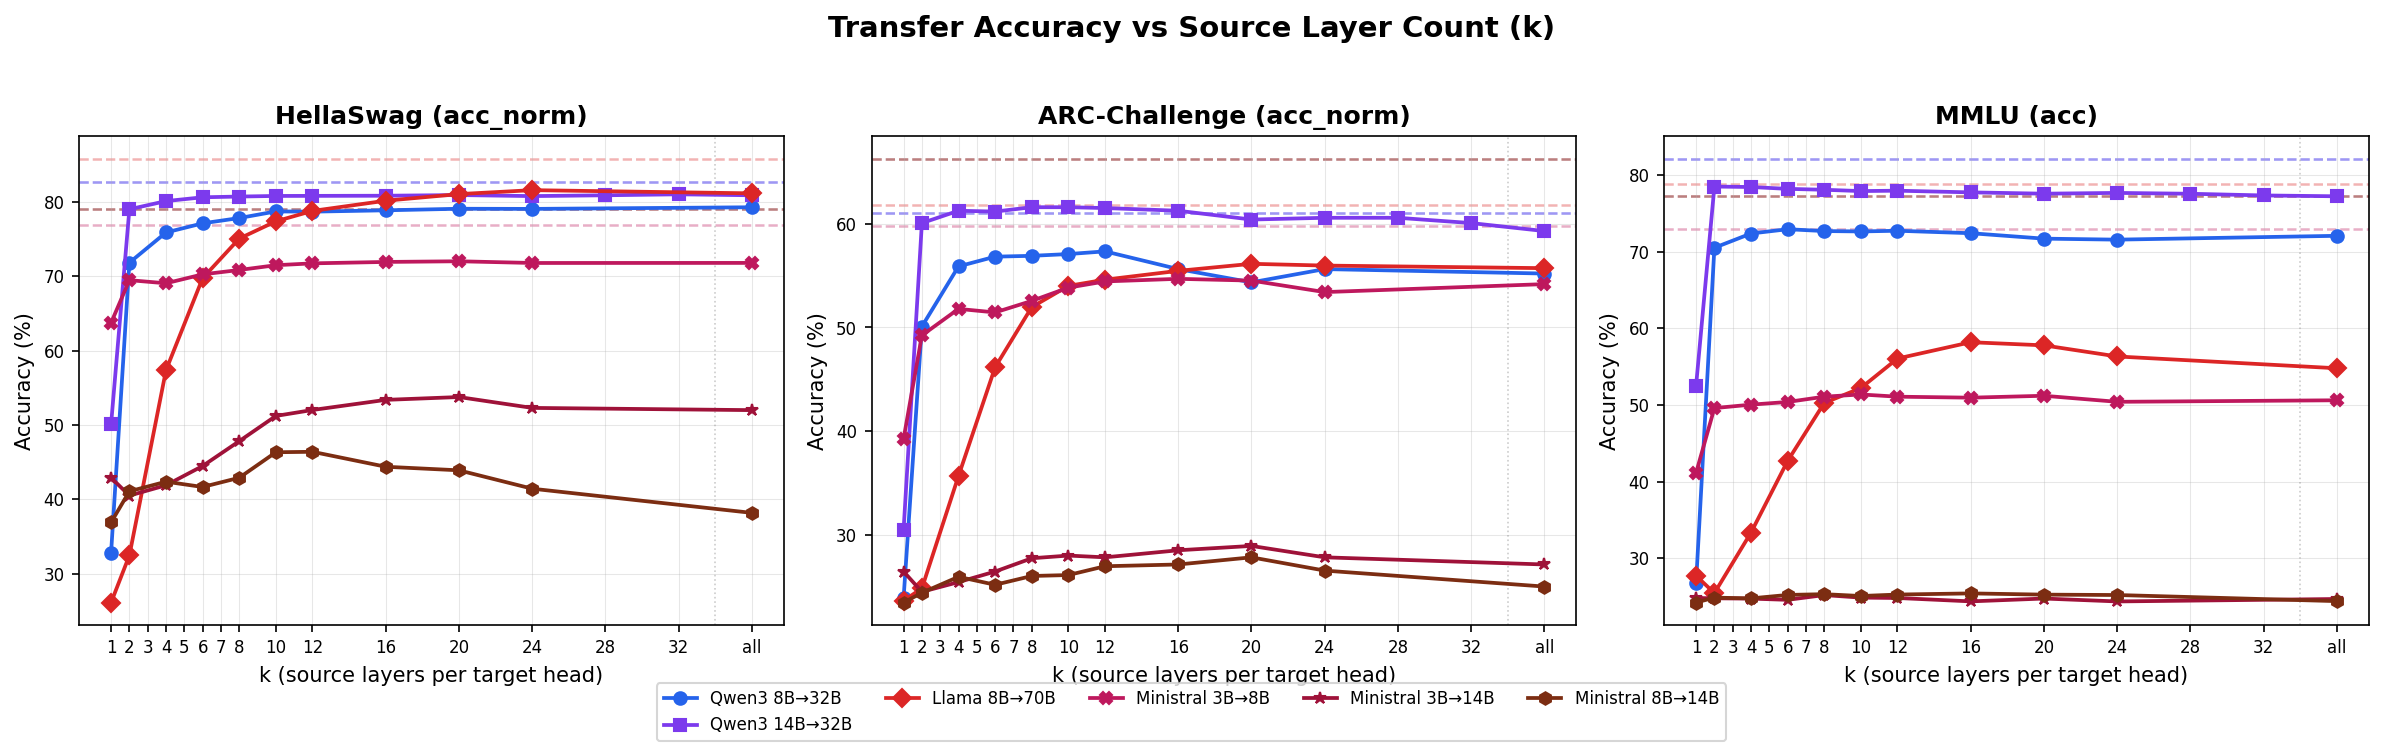 그림 4. 소스 층 수 k에 따른 여섯 쌍의 전이 정확도. 점선은 각 타깃의 단독 정확도다. 출처: 논문 Figure 6
기본값을 기준으로 보정 설정을 바꿔 봤을 때, 성능에 뚜렷한 영향을 준 변수는 도메인뿐이었다. HellaSwag 기준으로, 코드 지시문 데이터인 CodeAlpaca로 보정한 매퍼는 FineWeb-Edu로 보정한 매퍼보다 5.24%p 낮았다. 위키백과로 보정했을 때의 하락 폭은 1.05%p로 훨씬 작았다. 일곱 개 로그 우도 벤치마크로 평가하면 모든 조합의 유지율은 90% 이상이었다. 위키백과로 보정한 매퍼의 평균 유지율은 99.4%였고, 벤치마크 간 편차도 작았다. CodeAlpaca로 보정한 매퍼의 평균 유지율은 95.9%였다. 이 매퍼는 MMLU와 BoolQ에서는 FineWeb-Edu와 같은 수준이었지만, 상호 참조를 묻는 WinoGrande와 어려운 과학 문제를 묻는 ARC-C에서 가장 많이 떨어졌다. 그 결과 벤치마크 간 차이가 11.1%p에 이르렀다.
실패한 쌍에는 MLP가 효과를 냈다
저자들은 리지 매퍼가 실패한 모델 쌍을 비선형 매퍼로 회복할 수 있는지 확인했다. 이를 위해 타깃 층, 헤드, 키 또는 값마다 MLP를 학습해 리지 대신 사용했다. MLP에는 각각 1,024 유닛인 ReLU 은닉층 두 개가 있다. 리지와 같은 MSE 손실을 사용하고 Adam으로 학습했으며, 학습률은 10⁻³, 학습 기간은 20에폭, 배치 크기는 4,096이다. 보정 데이터와 평가 파이프라인은 리지와 같다.
| 쌍 | 리지 HellaSwag 유지율 | MLP HellaSwag 유지율 | 차이 |
|---|---|---|---|
| Qwen3 14B→32B | 97.6% | 97.3% | −0.3%p |
| Ministral 3B→8B | 93.3% | 91.8% | −1.5%p |
| Ministral 3B→14B | 68.0% | 92.3% | +24.3%p |
| Ministral 8B→14B | 58.7% | 95.5% | +36.8%p |
리지가 이미 잘 작동하는 두 쌍에서는 MLP가 리지보다 조금 낮았다. 반면 리지가 실패했던 두 쌍에서는 MLP로 바꾸자 HellaSwag 유지율이 24.3~36.8%p 올랐다. 그 덕분에 MLP를 쓴 네 쌍의 유지율은 모두 90% 이상이었다. 논문은 KV 관계가 이미 선형인 쌍에는 리지로 충분하고, MLP는 리지가 부족한 쌍에서만 도움이 된다고 해석했다.
무엇이 전이 품질을 결정하는가
보정 데이터의 R²으로는 예측되지 않는다
보정 데이터에서 잰 R²으로 전이 결과를 예측할 수 있다면 배포 전에 쌍을 선별하기 쉬워진다. 하지만 여섯 쌍을 양방향으로 평가해 보니, R²만으로는 쌍별 결과를 예측할 수 없었다. Llama 3.1 8B→70B와 Ministral 3B→8B는 보정 데이터에서 키 R²이 둘 다 0.84였다. Llama 쌍은 작은 모델에서 큰 모델로 전이할 때 HellaSwag 정확도의 94%를 유지했지만, 반대 방향에서는 37%만 유지했다. Ministral 쌍은 양방향 모두 93%를 유지했다.
어텐션 출력의 코사인 유사도
R²은 키와 값의 모든 채널에 같은 가중치를 주며 재구성 오차를 평균한다. 그러나 어텐션은 키와 타깃 쿼리의 내적으로 점수를 계산하고, 그 점수를 값의 가중합에 쓴다. 따라서 하류 동작이 보존되는지는 타깃 모델이 계산했을 어텐션 출력에 달려 있다. 연구진은 매핑된 KV와 실제 KV로 각각 계산한 어텐션 출력의 코사인 유사도를 구하고, 그 값을 층과 헤드 전체에서 평균했다.
세 계열 12개 평가(작은 모델에서 큰 모델로 6개, 큰 모델에서 작은 모델로 6개)에서, 이 평균 코사인과 HellaSwag 유지율의 피어슨 상관계수는 +0.57이었다. 보정 데이터의 키 R²은 −0.20으로 상관이 거의 없었다. 저자들은 R²이 한 쌍의 소스 층을 고를 때는 여전히 유용하지만, 쌍끼리 비교하는 지표로는 적합하지 않다고 정리했다.
오차가 어텐션이 크게 반영하는 방향에 집중되는가
R²이 비슷한 매퍼가 서로 다른 코사인 유사도를 내는 이유를 설명하기 위해, 연구진은 헤드마다 오차 집중도(error concentration)를 정의했다. 키의 경우 토큰별 키 오차를 타깃 헤드 쿼리 행렬의 오른쪽 특이벡터에 사영한다. 각 성분에는 대응하는 특이값의 제곱을 가중치로 곱하고, 그 결과를 모든 성분의 평균 오차로 나눈다. 값의 경우에는 위치별 값 오차에 실제 어텐션 가중치의 제곱을 곱한 뒤, 위치별 평균 오차로 나눈다. 집중도가 1보다 크면 오차가 어텐션 계산에 큰 영향을 주는 성분에 집중되어 있다는 뜻이고, 1보다 작으면 거의 영향을 주지 않는 성분에 집중되어 있다는 뜻이다.
리지를 MLP로 바꿨을 때 각 지표가 달라진 폭은 다음과 같다. 모든 값은 HellaSwag 토큰에서 쟀고, 변화는 MLP 값에서 리지 값을 뺀 것이다.
| 쌍 | 리지 키 R² | 키 R² 변화 | 리지 값 R² | 값 R² 변화 | 리지 유지율 | 유지율 변화 | 키 집중도 변화 | 값 집중도 변화 | 코사인 변화 |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3 14B→32B | 0.75 | −0.05 | 0.56 | −0.06 | 97.6% | −0.3%p | −0.03 | +0.00 | −0.03 |
| Ministral 3B→8B | −0.10 | +0.77 | 0.59 | −0.09 | 93.3% | −1.5%p | −0.45 | −0.08 | +0.07 |
| Ministral 3B→14B | −7.81 | +7.62 | 0.17 | +0.27 | 68.0% | +24.3%p | −2.31 | −0.23 | +0.41 |
| Ministral 8B→14B | −3.22 | +3.08 | 0.19 | +0.37 | 58.7% | +36.8%p | −2.71 | −0.23 | +0.48 |
실패한 두 쌍에서 리지의 키 R²은 HellaSwag 토큰 기준으로 −7.81과 −3.22였다.4 보정 데이터로 적합한 선형 매퍼가 평가 데이터에는 일반화되지 않았음을 나타낸다. 이 두 쌍에서 MLP는 키 집중도를 평균 약 2.5 낮추고 어텐션 출력 코사인을 약 0.45 높였으며, HellaSwag 유지율은 24.3~36.8%p 올랐다. 키 R²도 크게 올랐지만 여전히 0보다 작았다.
리지가 이미 성공한 쌍에서는 지표 변화가 훨씬 작았고, 유지율도 함께 오르지 않았다. Ministral 3B→8B의 경우, MLP로 바꾼 뒤 오차 집중도는 낮아지고 코사인은 높아졌다. 그런데도 HellaSwag 유지율은 1.5%p 떨어졌다. 저자들은 이를 근거로, 오차를 재분배해 집중도를 낮추는 것만으로는 충분하지 않다고 해석했다. 어텐션 계산에 크게 반영되는 오차가 성능을 제한할 만큼 컸던 쌍에서만 정확도가 달라진다고 본 것이다. KV 관계가 이미 선형인 쌍에서 리지로 충분한 이유도 이 해석으로 설명된다.
대화 도중 모델을 바꿔도 성능이 유지되는가
대화 도중 모델을 교체하는 시나리오를 확인하려고, 연구진은 Qwen3 14B와 32B를 번갈아 쓰면서 CoQA로 드리프트를 쟀다. 평가에는 다섯 도메인의 CoQA 대화 100개(대화당 약 15턴)를 썼고, 턴마다 답을 정답과 비교한 F1로 채점했다. 드리프트는 같은 턴에서 타깃 단독 F1과 매퍼를 쓴 F1의 차이다.
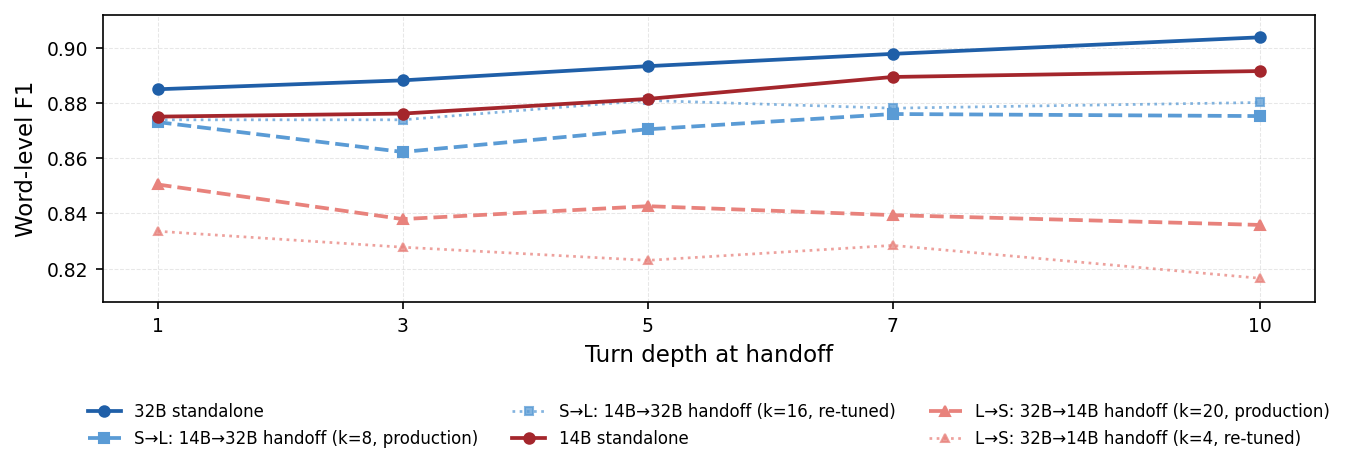 그림 5. CoQA 멀티턴 전환에서 턴별 F1. 실선은 타깃 단독, 파선은 단일 턴 기준으로 고른 k의 매퍼, 점선은 멀티턴 스윕으로 다시 고른 k의 매퍼다. 출처: 논문 Figure 4
작은 모델에서 큰 모델로 전이할 때는 1턴에서 10턴까지 격차가 1.7%p 늘었다. 매퍼를 쓴 점수는 일정하게 유지됐지만, 32B 단독 점수는 턴이 지날수록 올랐다. 큰 모델에서 작은 모델로 전이할 때는 드리프트가 턴당 0.33%p씩 선형으로 늘었다. 연구진은 두 증가율 모두 10턴 이내에 연쇄적 실패를 일으킬 만큼 크지는 않다고 판단했다.5 멀티턴 과제에 맞춰 k를 다시 고르면 드리프트는 최대 2.0%p 달라졌다.
다시 프리필하는 것보다 얼마나 빠른가
매퍼는 타깃 모델의 트랜스포머 본체를 실행하는 대신 층마다 배치 행렬곱을 한 번씩 실행하고, 타깃 모델은 매핑된 캐시로 바로 디코딩을 시작한다. Qwen3 14B와 32B 사이에서 잰 결과는 다음과 같다.
| 시퀀스 길이 | 14B→32B 매퍼 | 14B→32B 재프리필 | 배율 | 32B→14B 매퍼 | 32B→14B 재프리필 | 배율 |
|---|---|---|---|---|---|---|
| 64 | 14.0ms | 61.7ms | 4배 | 11.6ms | 39.2ms | 3배 |
| 8K | 67.8ms | 1,154.8ms | 17배 | 101.9ms | 501.0ms | 5배 |
| 32K | 277.6ms | 6,975.3ms | 25배 | 427.1ms | 2,952.7ms | 7배 |
시퀀스 길이 64토큰에서 32,768토큰까지, 작은 모델에서 큰 모델로 전이할 때는 4~25배, 반대 방향은 3~7배 빨랐다. 시퀀스가 길어질수록 재프리필 시간이 매퍼 시간보다 훨씬 빠르게 늘어나서 배율도 커진다.
부록에서는 측정을 세 계열 일곱 쌍으로 확장했다. 측정 조건은 일곱 쌍에 시퀀스 길이 열 가지를 곱한 70개였는데, 재프리필이 매퍼보다 빠른 조건은 하나도 없었다. 배율은 Ministral 3B→8B의 2.7배(최소)에서 Qwen3 14B→32B의 25.1배(최대)까지였다. 32,768토큰에서 Llama 3.1 8B→70B는 재프리필에 11,562ms, 매퍼에 777ms가 걸렸다.6
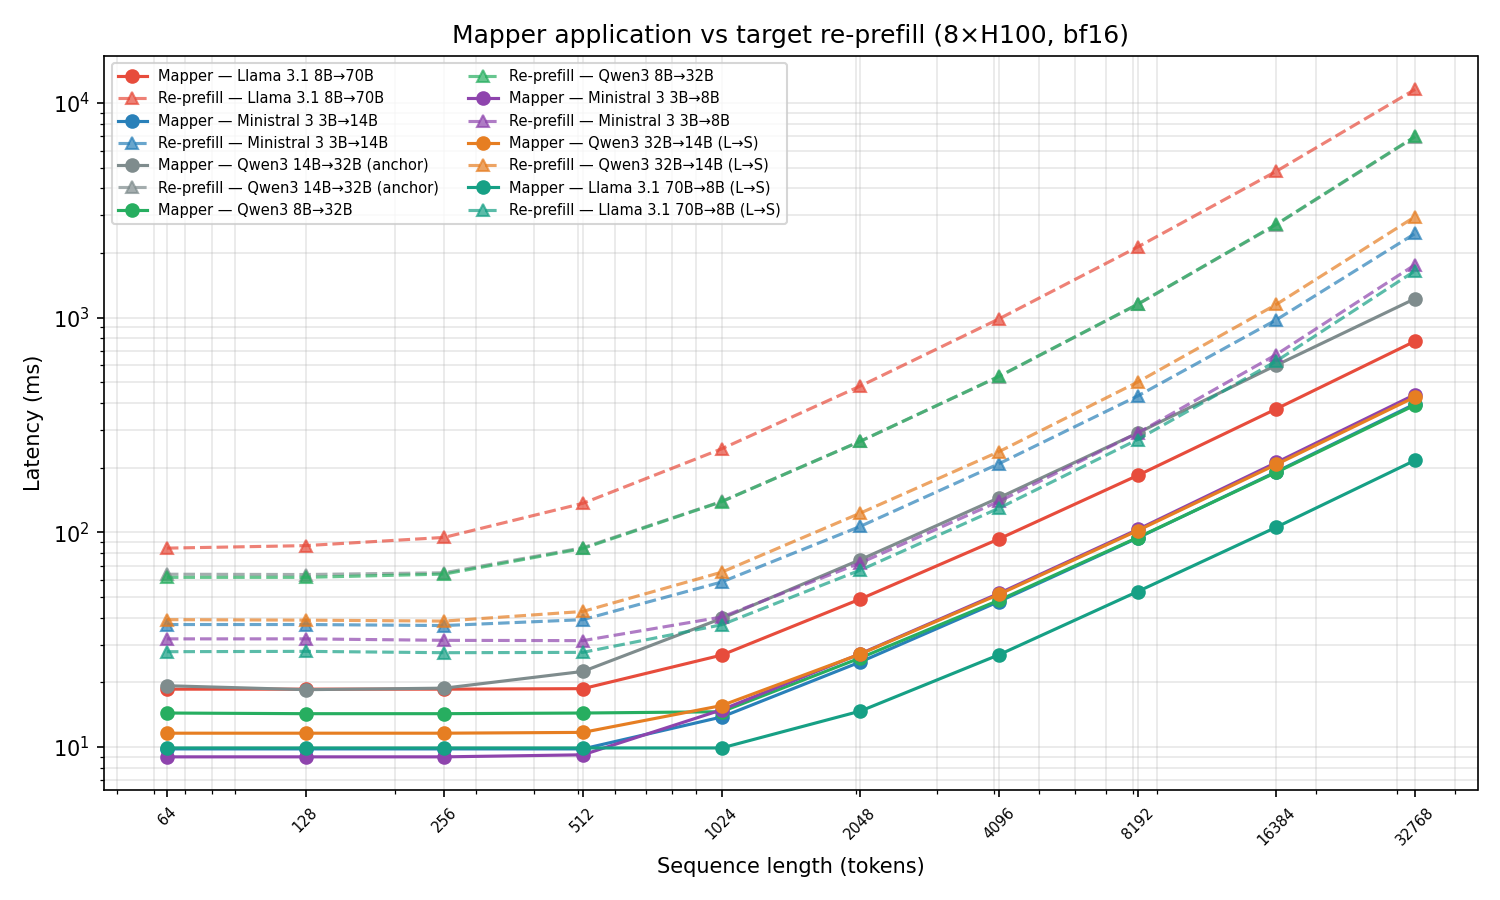 그림 6. 매퍼 적용(실선)과 타깃 재프리필(파선)의 시퀀스 길이별 지연 시간. 출처: 논문 Figure 9
매퍼를 보관하는 비용
매퍼 크기는 타깃 층 수, 헤드 수, k로 정해지며 시퀀스 길이와 캐시 크기에는 영향을 받지 않는다. 추론할 때는 타깃 층마다 배치 행렬곱을 한 번 실행하므로 매퍼를 GPU 메모리에 상주시킬 필요가 없다. 저자들은 매퍼를 CPU 메모리나 디스크에 저장하고, 현재 사용하는 모델 쌍의 매퍼만 GPU 메모리로 전송하는 방식을 제안했다. 호스트와 GPU 사이의 대역폭을 25~50GB/s(PCIe Gen4, Gen5)로 가정하면, 4~12GB 매퍼를 불러오는 데 약 80~480ms가 걸린다. 이 비용은 그 모델 쌍을 처음 사용할 때 한 번만 든다.7
리지 매퍼는 전이 방향마다 따로 필요하다. 따라서 모델 P개를 오가는 라우터에는 순서쌍 P(P−1)개에 해당하는 매퍼가 필요하다. 매퍼 평균 크기를 약 6.5GB로 두면, 모델이 3개, 4개, 5개일 때 필요한 저장 용량은 각각 약 39GB, 79GB, 131GB다. 필요한 용량은 P의 제곱에 비례해 증가하지만, 저장 공간은 VRAM 대신 디스크나 호스트 메모리로 마련할 수 있다.
한계와 후속 과제
논문은 한계를 네 가지로 정리했다.
- 보정에는 FineWeb-Edu만 썼다. 위키백과와 CodeAlpaca로 바꾼 실험은 주제와 문체를 따로 통제하지 않았기 때문에, 의료나 법률처럼 한 분야에 한정된 데이터로 보정할 때의 영향은 이 실험으로 알 수 없다.
- k는 결과를 보고할 때 쓴 벤치마크를 기준으로 고른 값이다. 연구진이 선택 기준에서 벤치마크를 하나씩 빼고 k를 다시 골라 보니, 제외한 벤치마크의 정확도는 최대 2.49%p, 평균 0.30%p 차이가 났다. 연구진은 이 측정이 표본 외 데이터로 k를 고른 것을 대신하지는 못한다고 밝혔다.
- KV 일치 조건은 경험적으로 정한 조건이다. 매퍼 수식 자체는 차원이 달라도 적용할 수 있지만, 실험한 여섯 쌍은 모두 KV 일치 쌍으로 골랐고 불일치 쌍은 실험하지 않았다.
- 같은 계열의 dense 전체 어텐션 모델만 다뤘고, 하이브리드 어텐션이나 어텐션과 순환 구조를 결합한 모델은 다루지 않았다.
후속 과제로는 다섯 가지를 제시했다.
- MLP, MoE, 어텐션 코사인을 직접 최적화하는 목적 함수 등 학습형 매퍼의 체계적 비교
- 매퍼를 적합하기 전에 전이 가능성을 추정하는 지표. 어텐션 출력 코사인은 매퍼를 적합한 뒤에야 잴 수 있다.
- Qwen3에서 Llama 3.1로 가는 것처럼 계열이 다른 모델 사이의 전이
- 학습 데이터 중복, 미세 조정 방식처럼 아키텍처 외의 요인이 전이 가능성에 주는 영향
- 슬라이딩 윈도 어텐션 같은 제한 어텐션 구조와, Nemotron 3처럼 KV와 함께 SSM 상태를 유지하는 하이브리드 구조로의 확장
가장 흥미로운 지점
나는 이 논문에서 0.84라는 숫자가 계속 신경 쓰였다. 앞에서 본 Llama 3.1 8B→70B와 Ministral 3B→8B는 보정 데이터의 키 R²으로는 구별되지 않는다. 둘 다 0.84이기 때문이다. 하지만 큰 모델에서 작은 모델로 전이하면 두 쌍의 HellaSwag 유지율은 37%와 93%로 크게 차이 난다. 이 차이는 캐시를 원본에 가깝게 재구성하는 일과 타깃 모델이 그 캐시로 제대로 추론하게 만드는 일이 서로 다른 목표라는 점을 알려 준다. 연구진이 오차 집중도를 정의한 것도 이 간극을 설명하기 위해서였다. 같은 크기의 오차라도 쿼리와의 내적에 크게 반영되는 방향에 있으면 어텐션 출력이 크게 달라지고, 거의 반영되지 않는 방향에 있으면 결과에 영향을 거의 주지 않는다.
한편 선형 변환 하나만으로 Qwen3 32B는 14B의 캐시를 받아 단독 정확도의 97.6%를 유지한다. 같은 계열의 모델은 크기가 달라도 내부 표현의 상당 부분이 선형 변환으로 연결되어 있다고 해석할 수 있는 결과다. 그러나 Ministral 3의 14B 타깃 쌍처럼 같은 계열에 속한 모델끼리도 실패하는 경우가 있고, 연구진도 학습 데이터 중복이나 미세 조정 방식이 영향을 줄 수 있다고 추정할 뿐 원인을 확정하지는 못했다. 적합하기 전에 성공 여부를 가늠할 지표가 나오기 전까지는, 쌍마다 한 시간씩 매퍼를 적합하고 벤치마크로 확인하는 절차를 거쳐야 한다.
출처
Taekyung Heo, Rasoul Shafipour, Ritchie Zhao, Maximilian Golub, Mohammad Mahdi Kamani, Ritika Borkar, Makesh Tarun Chandran, Pantea Zardoshti, Bita Darvish Rouhani (NVIDIA). “Cross-Model KV Cache Transfer in LLM Families: A Closed-Form Linear Mapping for Prefill Reuse.” arXiv:2608.03893, 2026년 8월 4일.
원문: https://arxiv.org/abs/2608.03893
프리필(prefill)은 모델이 답을 만들기 전에 입력 프롬프트 전체로 순전파를 한 번 실행하는 단계다. 이때 층마다 키와 값을 계산해 KV 캐시에 저장한다. 이후 토큰을 하나씩 생성하는 디코딩 단계에서는 이 캐시를 읽어 계산한다. ↩︎
RoPE(rotary position embedding)는 토큰의 위치에 따라 쿼리와 키 벡터를 정해진 각도만큼 회전시켜 위치 정보를 인코딩하는 방식이다. 회전 행렬은 직교 행렬이므로 전치 행렬을 곱하면 회전하기 전의 벡터를 정확히 복원할 수 있다. ↩︎
리지 회귀는 최소제곱 목적 함수에 가중치 제곱합에 비례하는 벌점 항을 더한 회귀다. 입력 특징끼리 상관이 높아 역행렬 계산이 불안정할 때 해를 안정시킨다. ↩︎
R²이 음수이면 모든 토큰에 대해 평균값 하나를 예측값으로 쓸 때보다 오차가 크다. ↩︎
연구진은 이 결과가 한 모델 쌍만 평가한 결과라고 덧붙였다. 또 큰 모델에서 작은 모델로 전이할 때 나타난 선형 드리프트는 매우 긴 세션에서는 누적될 수 있다고 밝혔다. ↩︎
지연 시간은 합성 입력으로 쟀고, 매핑한 캐시를 타깃 프로세스로 보내는 시간은 측정하지 않았다. 매퍼는 torch.compile이나 CUDA 그래프 없이 eager 모드로 실행했으며, 짧은 시퀀스에서는 Python 디스패치와 GPU 간 전송의 고정 비용이 매퍼 시간의 대부분을 차지한다(Qwen3 14B→32B 기준 14.0ms). Ministral 3의 재프리필 시간은 비전 타워를 제외한 언어 모델 디코더만 잰 값이다. 한편 그림 6에서 Qwen3 14B→32B 매퍼 곡선은 32,768토큰에서 약 1,200ms로, 표의 277.6ms와 다르다. 논문은 이 차이를 설명하지 않는다. ↩︎
이 전송 시간은 매퍼 크기와 대역폭으로 계산한 값이며 측정값은 아니다. ↩︎