3줄 요약
- Anthropic의 Raymond Wang은 2026년 9월 23일 claude.dev 블로그에 이 글을 게시했다. 팀은 8월에 2주 동안 스프린트를 진행해 claude.ai와 Claude 데스크톱 앱의 핵심 사용자 경험을 약 3배 빠르게 만들었다. 글은 무엇을 고쳤는지, 어떻게 측정했는지, 그리고 Claude와 함께 만든 작업 루프를 어떻게 운영했는지를 설명했다.
- 사용자 활동의 95%를 차지하는 네 가지 여정에서 13개 측정치가 75퍼센타일 기준 평균 3.1배 빨라졌다. claude.ai를 새로 불러온 다음 입력할 수 있게 되기까지 걸리는 시간은 3.1초에서 0.55초로 줄었다. 팀은 2주 동안 변경을 3천 건 이상 머지했는데, 그동안 고객이 장애를 겪거나 변경을 롤백한 일은 한 번도 없었다.
- 작업은 Slack 채널 하나에서 진행됐다. 스레드마다 Claude는 벤치마크를 만들고 코드를 고치고 배포를 감시했다. 엔지니어는 목표를 정하고, 절충을 판단하고, 변경을 승인했다. 이런 스레드가 동시에 150개 이상 진행됐다. 팀은 측정하는 순간 개선이 시작된다는 점을 핵심 교훈으로 꼽았다.
네 가지 여정, 13개 측정치
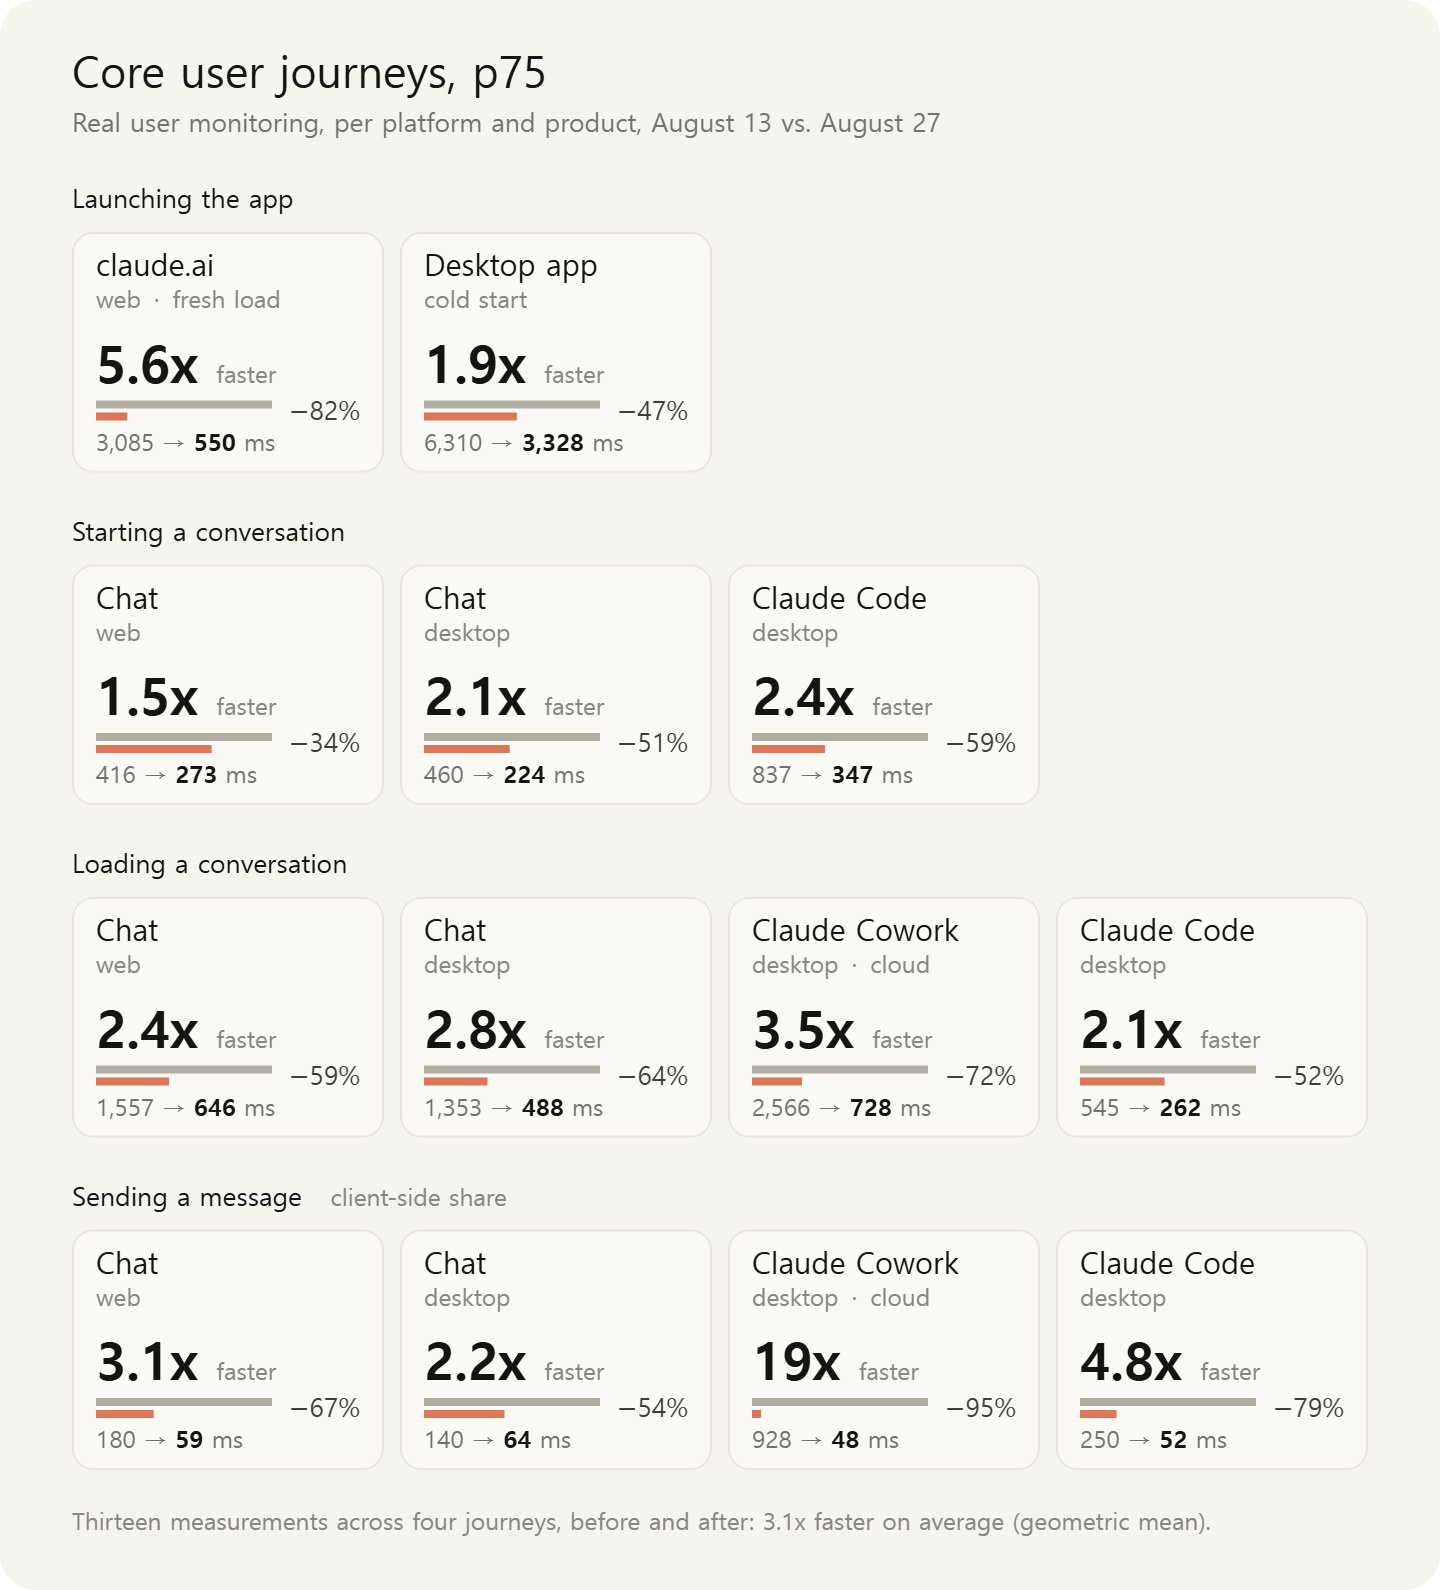
사용자들은 claude.ai가 느리다고 말해 왔고, 글은 그 지적이 옳았다고 인정했다. 팀은 사용자 활동의 95%를 차지하는 여정으로 앱 실행, 대화 시작, 기존 대화 불러오기, 메시지 전송의 네 가지를 골랐다. 팀은 이 여정들을 플랫폼(웹과 데스크톱)과 제품의 조합마다 따로 측정했고, 그렇게 얻은 측정치는 13개였다. 아래 표는 8월 13일과 8월 27일의 실사용자 모니터링 값을 75퍼센타일 기준으로 비교한 것이다.
| 여정 | 제품과 플랫폼 | 수정 전 (ms) | 수정 후 (ms) | 개선 |
|---|---|---|---|---|
| 앱 실행 | claude.ai 웹, 새로 불러오기 | 3,085 | 550 | 5.6배 |
| 앱 실행 | 데스크톱 앱, 콜드 스타트 | 6,310 | 3,328 | 1.9배 |
| 대화 시작 | Chat 웹 | 416 | 273 | 1.5배 |
| 대화 시작 | Chat 데스크톱 | 460 | 224 | 2.1배 |
| 대화 시작 | Claude Code 데스크톱 | 837 | 347 | 2.4배 |
| 대화 불러오기 | Chat 웹 | 1,557 | 646 | 2.4배 |
| 대화 불러오기 | Chat 데스크톱 | 1,353 | 488 | 2.8배 |
| 대화 불러오기 | Claude Cowork 데스크톱(클라우드) | 2,566 | 728 | 3.5배 |
| 대화 불러오기 | Claude Code 데스크톱 | 545 | 262 | 2.1배 |
| 메시지 전송(클라이언트 처리분) | Chat 웹 | 180 | 59 | 3.1배 |
| 메시지 전송(클라이언트 처리분) | Chat 데스크톱 | 140 | 64 | 2.2배 |
| 메시지 전송(클라이언트 처리분) | Claude Cowork 데스크톱(클라우드) | 928 | 48 | 19배 |
| 메시지 전송(클라이언트 처리분) | Claude Code 데스크톱 | 250 | 52 | 4.8배 |
13개 측정치의 개선 배율을 기하평균으로 계산해 보면, 네 여정은 평균 3.1배 빨라졌다. 팀은 이 개선 덕분에 사용자가 기다리는 시간이 하루에 수만 시간씩 줄어든다고 추산했다.
작업에는 Claude Tag(베타)를 썼고, 모델은 Opus 5.5와 비슷한 수준의 내부 연구용 모델이었다.1 Claude가 병목을 찾고, 벤치마크를 만들고, 개선을 배포하고, 모든 배포를 감시했다. 사람은 목표를 정하고, 절충을 판단하고, 모든 변경을 승인했다.
상시 지시와 첫 목표
스프린트를 시작하기 전에 팀은 Slack 채널을 만들고 Claude에게 다음과 같은 상시 지시를 설정했다.
@Claude 너의 일은 claude.ai 웹사이트와 데스크톱 앱의 성능에 관한 모든 일을 돕는 것이다. 배포마다 성능 회귀를 감시하고, 기존 텔레메트리가 정확하고 충분한지 평가하고, 관측 대시보드를 잘 정리된 상태로 유지하는 것이 네 책임이다. 그리고 관찰된 문제와 손쉬운 개선 과제에는 먼저 나서서 해결책을 구현하고, 성능 프로젝트를 제안하고, 사람 동료와 소통하는 것도 네 책임이다. (중략)
이 채널의 궁극적인 목표는 네가 최대한 자율적으로 일하게 되는 것이다. 그러나 지금은 아직 그럴 수 없다는 것을 우리도 안다.
Claude는 Datadog MCP 서버로 사용 데이터를 분석해, 이 네 여정이 사용자에게 가장 큰 영향을 준다고 판단했다. 팀은 기준값을 만들기 위해 13개 측정치를 서로 비교할 수 있을 때까지 계측을 추가했다. 모든 측정치는 사용자의 조작에서 시작해 결과가 렌더링되면 끝나고, 클라이언트 작업과 서버 작업을 구분해 기록한다.
스프린트는 팀이 직접 고른 프로젝트 약 20개로 출발했다. 프로젝트마다 대상 여정이 하나씩 정해져 있었다. Claude가 각 프로젝트의 개선 효과를 밀리초 단위로 추정했고, 팀은 이 추정치를 합산해 스프린트 목표를 정했다. 규모가 큰 프로젝트도 있었지만, 팀은 2주 동안 대부분을 끝낼 수 있으리라 예상했다.
그런데 사흘째에 13개 목표 가운데 12개가 달성됐다.
계획한 프로젝트는 예정보다 일찍 끝났다. 앱 실행을 빠르게 하려고, 팀은 HTML에 정적 입력창을 미리 포함해 React가 초기화되는 동안에도 사용자가 타이핑할 수 있게 했다. 데스크톱 셸의 메인 프로세스가 코드를 처음부터 다시 컴파일하지 않도록 V8 코드 캐시도 미리 컴파일해 두었다. 화면 전환을 빠르게 하려고, 대화를 바꿔도 입력창을 다시 마운트하지 않게 했다. 사용자가 사이드바의 세션에 마우스를 올리면 그 세션을 미리 가져오게 했고, 사이드바의 재렌더링은 90% 줄였다.
팀은 Claude가 개선 기회를 스스로 찾아 새 작업을 제안하는 것도 허용했다. Claude가 제안한 작업은 금세 독립 프로젝트가 될 만큼 규모가 늘었고, 처음 세운 목표를 크게 웃도는 성과를 냈다. 팀은 목표를 새로 정하고, 측정할 대상을 더 찾기 시작했다. 이때 채널에 올린 메시지는 이렇다.
@Claude 원래 목록에 있던 프로젝트는 거의 다 진행했고, 그 밖의 것도 더 했어. 한번 새로 점검해 보자. (중략) 아직 탐색하지 않은 건 뭐지? 어떤 수치를 더 개선할 수 있을까? 지금 기회가 가장 큰 곳은 어디야? (중략) 엉뚱한 아이디어도 환영이야.
측정할 수 있으면 개선할 수 있다
팀은 처음부터 배포 주기보다 빠르게 작업을 반복하고 싶어 했다. Claude는 몇 시간씩, 때로는 밤새 비동기로 일할 수 있었다. 팀은 Claude가 실사용 데이터를 기다리지 않고도 시제품을 검증할 수 있기를 바랐고, 그러려면 실험 환경에서 성능을 측정할 방법이 필요했다.
첫 단서는 엔지니어 Sam이 찾았다. Sam은 벽시계 시간(wall-clock time)으로 재는 대신 JS 명령어 수를 셀 수 있느냐고 물었다. Claude는 순수 JS로 된 핫 패스라면 명령어 수를 그대로 셀 수 있다고 답했다. Valgrind에서 node --predictable로 벤치마크를 실행하고, 저장소에 넣어 둔 기준값과 비교하는 방식이다. Claude는 이 방식이라면 벤치마크를 한 번만 실행해도 결과를 믿을 수 있으므로, 통계 처리를 따로 할 필요가 없다고 설명했다. 브라우저 경로는 Chromium에서 명령어를 셀 수 없으므로, Claude는 실행할 때마다 같은 값이 나오는 다른 지표를 대안으로 제시했다. 사용자 조작당 React 커밋 수, V8 정밀 커버리지로 얻은 함수 호출 수, 레이아웃과 스타일 재계산 횟수, DOM 변경 횟수가 그 후보였다.
Sam은 Valgrind로 명령어 수(Ir)를 재는 방법과 --predictable 옵션의 조합을 스레드 하나에서 탐색하고, 브라우저와 React 벤치마크는 하나씩 새 스레드에서 탐색하자고 했다. 11분 뒤에는 스레드 다섯 개에서 작업이 진행되고 있었다. 각 스레드가 측정한 것은 명령어 수, V8 호출 수, React 커밋, 스타일 재계산, DOM 변경이었다.
팀은 새 벤치마크를 하나하나 의심하며 검토했다. 팀은 벤치마크 하나가 두 가지 역할을 함께 하기를 바랐다. 먼저 실험 환경에서는 Claude가 개선할 목표 지표로 쓰이고, 그다음 CI에서는 수치가 다시 올라가지 않도록 막는 가드레일로 쓰여야 했다. 결과가 들쭉날쭉하거나 사용자가 느끼는 지연과 상관이 없는 벤치마크는, Claude가 엉뚱한 목표를 개선하지 않도록 폐기했다. 팀은 Claude에게 이렇게 요구했다.
@Claude 이 후보 각각을 개선하면 벽시계 시간으로도 측정 가능한 성능 향상이 나온다는 걸 증명해 줘. 증명하지 못한 후보는 벤치마크를 폐기할 거야.
사용자가 체감하는 시간은 벽시계 시간이다. 그런데 벽시계 시간은 잡음이 많아서, 밀리초 단위로 잰 값을 CI 게이트의 기준으로 쓰면 결과가 실행할 때마다 달라진다. 명령어 수는 실행할 때마다 같은 값이 나온다는 점에서 매력적이었다. 그래도 명령어 수가 벽시계 시간과 상관관계가 있다는 것은 Claude가 증명해야 했다.
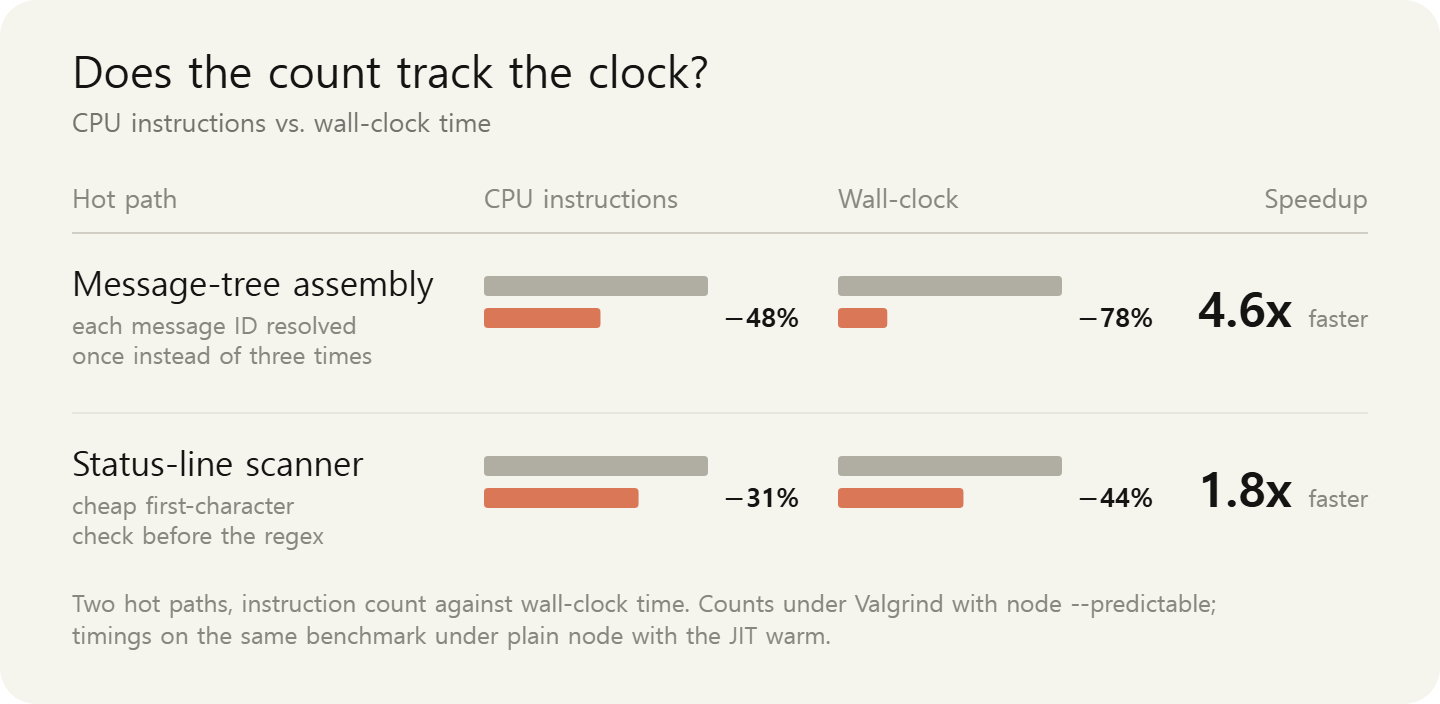
팀은 대화의 메시지 트리를 조립하는 루틴과 Claude Code 출력에서 상태 줄을 찾는 스캐너, 이 두 핫 패스의 명령어 수를 줄이는 일을 Claude에게 맡겼다. Claude는 Valgrind로 두 경로를 프로파일링했다. 첫 번째 경로에서는 실행되는 명령어의 4분의 1이 메가모픽 사전 조회였다.2 같은 메시지 ID를 세 번이나 따로 조회하고 있었다.
한 시간 뒤 Claude는 두 경로의 명령어 수를 각각 48%와 31% 줄였고, 벽시계 시간은 각각 78%와 44% 줄었다. 팀은 새 래칫3 두 개를 저장소에 추가했다. 이후로는 두 경로의 명령어 수를 늘리는 PR이 CI에서 실패했고, 매일 실행되는 작업은 명령어 수가 줄어들 때마다 줄어든 만큼 상한을 낮췄다.
이 결과에서 팀은 스프린트의 핵심 교훈을 얻었다.
Claude와 함께라면, 무언가를 측정하는 것만으로 그 문제를 풀 수 있게 된다.
글은 측정의 의미가 달라졌다고 설명했다. 예전에는 측정이 0단계였다. 지표를 추가하고 데이터가 모이기를 기다린 다음에야 문제를 이해하기 시작했다. Claude와 일하면서 측정은 개선 작업을 시작하는 1단계가 되었다. 목표 수치가 생기면 Claude는 곧바로 최적화를 시작할 수 있었다. 그렇다면 측정할 대상을 늘리는 일이 팀에게 가장 효과가 큰 작업이었다.
스레드 하나에서 반복한 루프
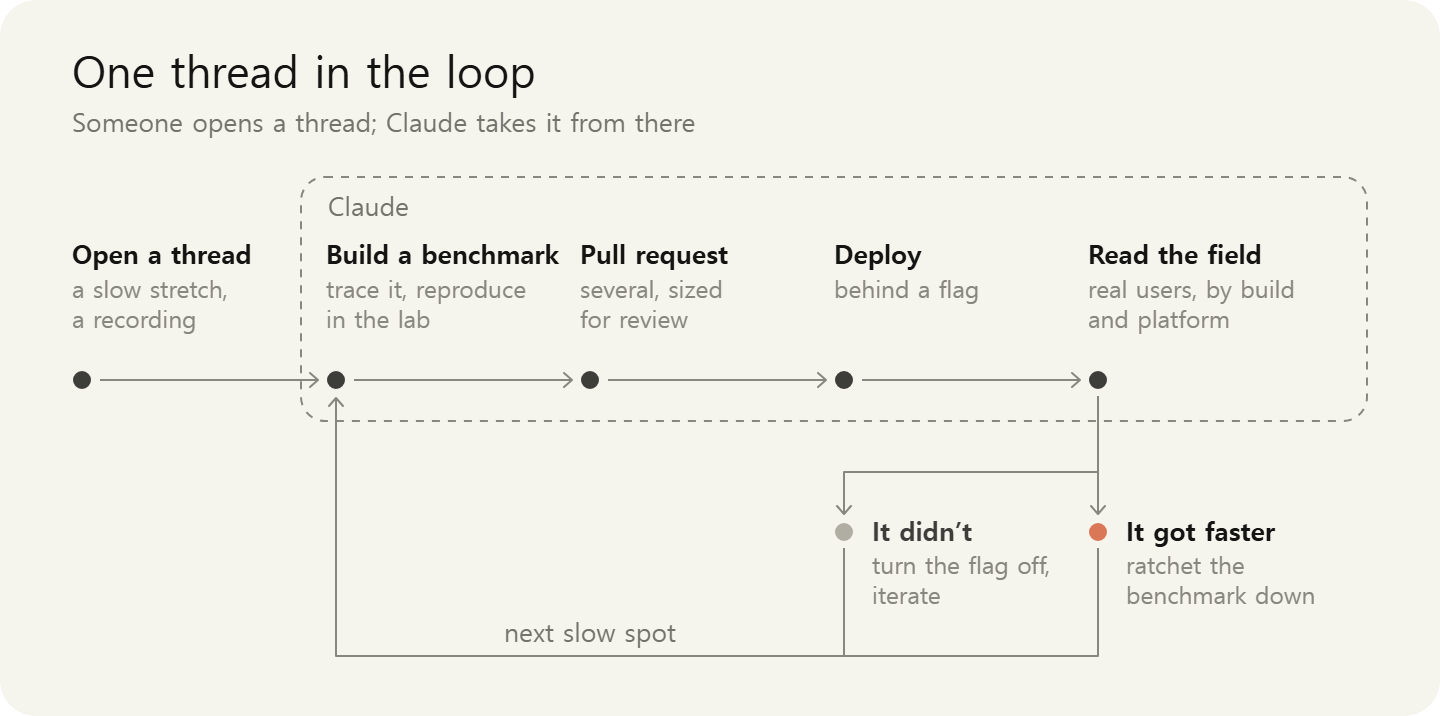
모든 작업은 같은 Slack 채널에서 진행됐다. 여러 엔지니어와 Claude가 스레드마다 함께 작업했고, 스프린트는 곧 다음과 같은 루프로 정착했다.
- 누군가 한 여정의 느린 구간을 다루는 스레드를 만든다. 스크린샷이나 화면 녹화를 함께 첨부하는 경우가 많았다.
- Claude가 실행 흐름을 추적하고, 문제를 재현하는 벤치마크를 찾거나 새로 만든다.
- 실험 환경에서 유망한 결과가 나오면 Claude가 PR을 제출한다. 위험도와 리뷰 부담에 맞춰 PR을 여러 개로 분할하는 경우가 많았고, 사용자에게 보이는 변경은 모두 기능 플래그로 제어했다.
- 배포가 끝나면 Claude가 배포 상태를 감시하고 실사용 데이터를 읽는다.
- 성능이 좋아졌으면 Claude가 벤치마크 상한을 낮춰 개선 효과를 유지한다. 좋아지지 않았으면 플래그를 끄고 다시 시도한다.
- 그다음에는 같은 여정에서 다음으로 느린 구간을 찾는다.
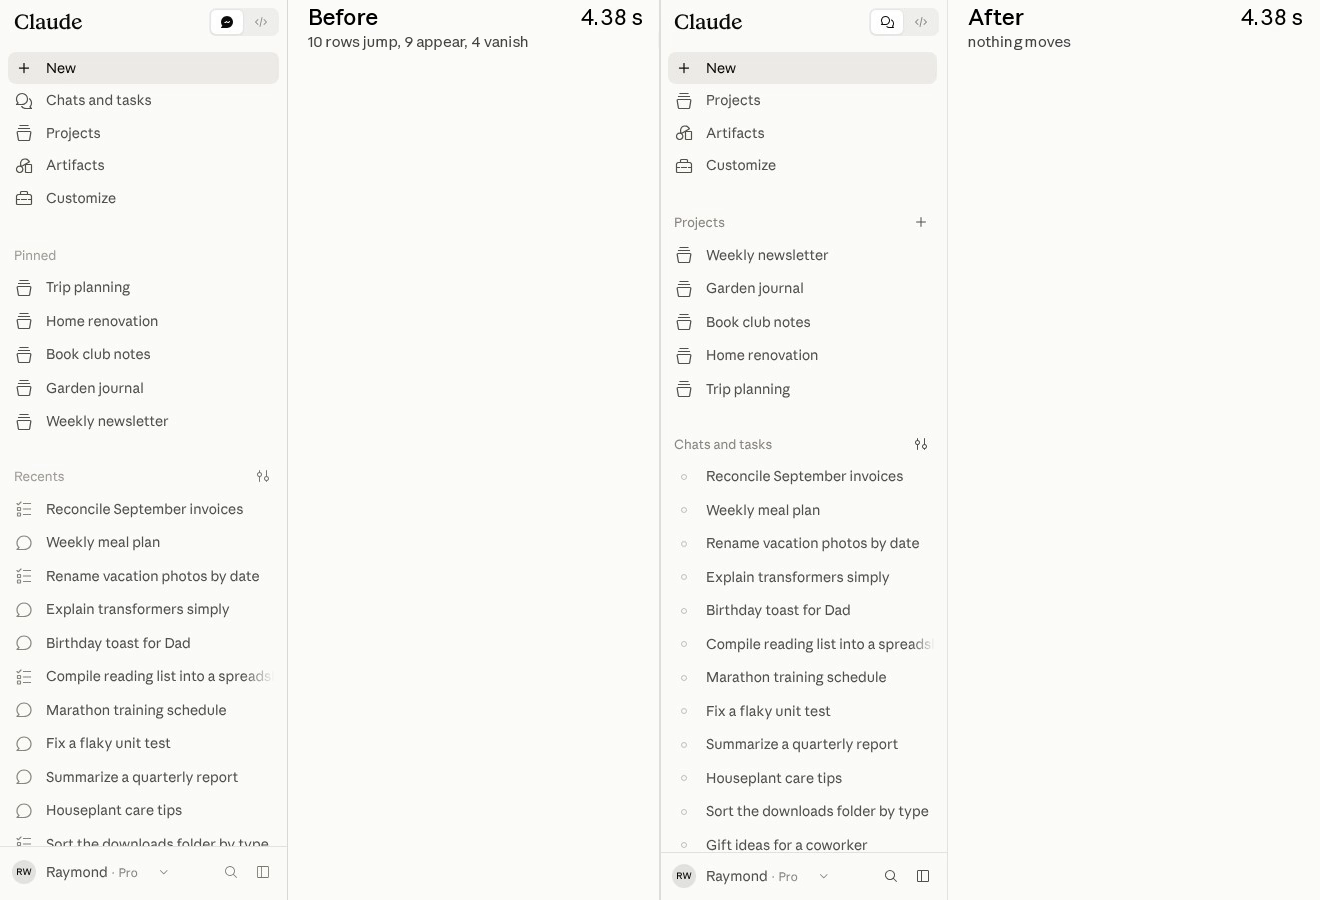
한 엔지니어가 페이지가 로드된 뒤에 사이드바 행이 뒤늦게 나타나는 화면 녹화를 공유한 적이 있다. Chat 행과 Cowork 행이 서로 다른 시점에 표시되어 화면이 매끄럽지 않았다. 기존 모니터링은 이 현상을 하나도 감지하지 못했다. 기존 지표 가운데 이 현상과 가장 관련 있는 것은 누적 레이아웃 이동(CLS)이었지만,4 이동 한 번의 점수가 약 0.008로 ‘좋음’ 기준인 0.1보다 훨씬 낮았다.
엔지니어 Issac은 CLS가 근거로 삼는 Layout Instability API를 직접 쓰자고 제안했다. Claude는 텔레메트리 이벤트를 새로 만들었다. 이 이벤트는 layout-shift 항목마다 sources를 이름 붙은 영역(사이드바, 대화 내용 등)과 단계(첫 페인트 전, 입력 가능 이후 등)에 대응시킨다. 통합 테스트도 추가했다. 이 테스트는 사이드바에 항목이 있는 상태로 페이지를 열되, 사이드바 데이터를 첫 페인트 이후까지 보류한다. 그리고 이름 붙은 영역 어디에서든 이동이 생기면 실패한다. Claude는 이 테스트를 벤치마크로 삼아 수정 효과를 증명했다. 테스트는 main 브랜치에서 20회 중 20회 실패했고, PR 브랜치에서 20회 중 20회 통과했다.
이벤트를 배포한 뒤 Claude가 실사용 데이터를 읽어 보니, 웹 페이지 로드의 31%에서 페이지를 쓸 수 있게 된 다음에 사용자 조작 없이 무언가가 움직였다. Claude는 원인을 하나씩 구체적으로 특정해 처리했다. 늦게 렌더링되는 헤더 행, 사용자 이름이 로드되면 옆으로 밀리는 캐럿, 스크롤바가 나타나면서 움직이는 목록 같은 것들이었다. Claude는 영향이 큰 원인 여러 개를 한 번에 고쳤고, 그 원인들이 해결되면 다음 원인들을 찾았다.
이것은 스레드 하나의 사례였다. 스프린트 기간에는 이런 스레드가 동시에 150개 이상 진행됐다.
스레드 150개로 확장하다
루프가 스레드 하나에서 작동하자, 규모를 늘리려면 스레드를 더 만들기만 하면 됐다. Claude는 처음 받은 요청을 처리한 뒤에도 스레드를 끝내지 않고 작업을 계속했다. 스레드 하나에서 최적화 PR이 50개, 많을 때는 100개까지 나왔다. 시간이 갈수록 새 스레드를 만드는 주체는 엔지니어보다 Claude인 경우가 많아졌다. Claude는 별도 조사나 야간 작업에서 스스로 발견한 기회를 추적하려고 스레드를 만들었다. 채널에 있던 엔지니어 Shelley는 “[이 모델은] 숫자 귀신"이라고 평했다.
측정하는 것마다 개선할 거리가 나왔다. 글이 소개한 사례는 다음과 같다.
| 조사 방법 | 발견한 문제 |
|---|---|
| React 훅 전수 조사 | 입력창의 타이핑 경로에 훅 6,900개와 스토어 구독 900개가 있었고, 키를 누를 때마다 재렌더링됐다 |
| 스타일 재계산 횟수 측정 | :root:has() 선택자 하나가 DOM이 바뀔 때마다 24밀리초를 추가하고 있었다 |
| 첫 페인트 이후의 코드 경로 추적 | 정리되지 않고 남은 location.reload() 호출이 하루 50만 번의 숨은 새로고침을 일으켰다. 기존 로드 지표로는 감지되지 않았다 |
| 유휴 탭의 프로파일러 샘플 분석 | 똑같은 캐시 스냅숏을 1분에 두 번씩 IndexedDB로 복제하고 있었고, 이 작업이 모두 메인 스레드에서 실행됐다 |
스레드가 무엇을 발견할지는 팀도 미리 알기 어려웠다. CPU 지연(hitch)을 전수 점검하던 중, Claude는 완성된 코드 블록에 구문 강조를 적용할 때 페이지가 1초가량 멈출 수 있다는 것을 발견했다. 실험 환경에서 추적해 보니 원인은 엠 대시(em dash)였다. 응답의 마크다운에 엠 대시나 둥근 따옴표처럼 Latin-1에 포함되지 않는 문자가 하나라도 있으면, V8은 문자열 전체를 UTF-16으로 저장했다. 이 경우 구문 강조에 쓰는 정규식이 모두 느린 2바이트 경로로 실행됐다. Claude는 구문 강조를 적용하기 전에 코드 블록을 1바이트 문자열로 복사하는 20줄짜리 변경으로 문제를 고쳤다.
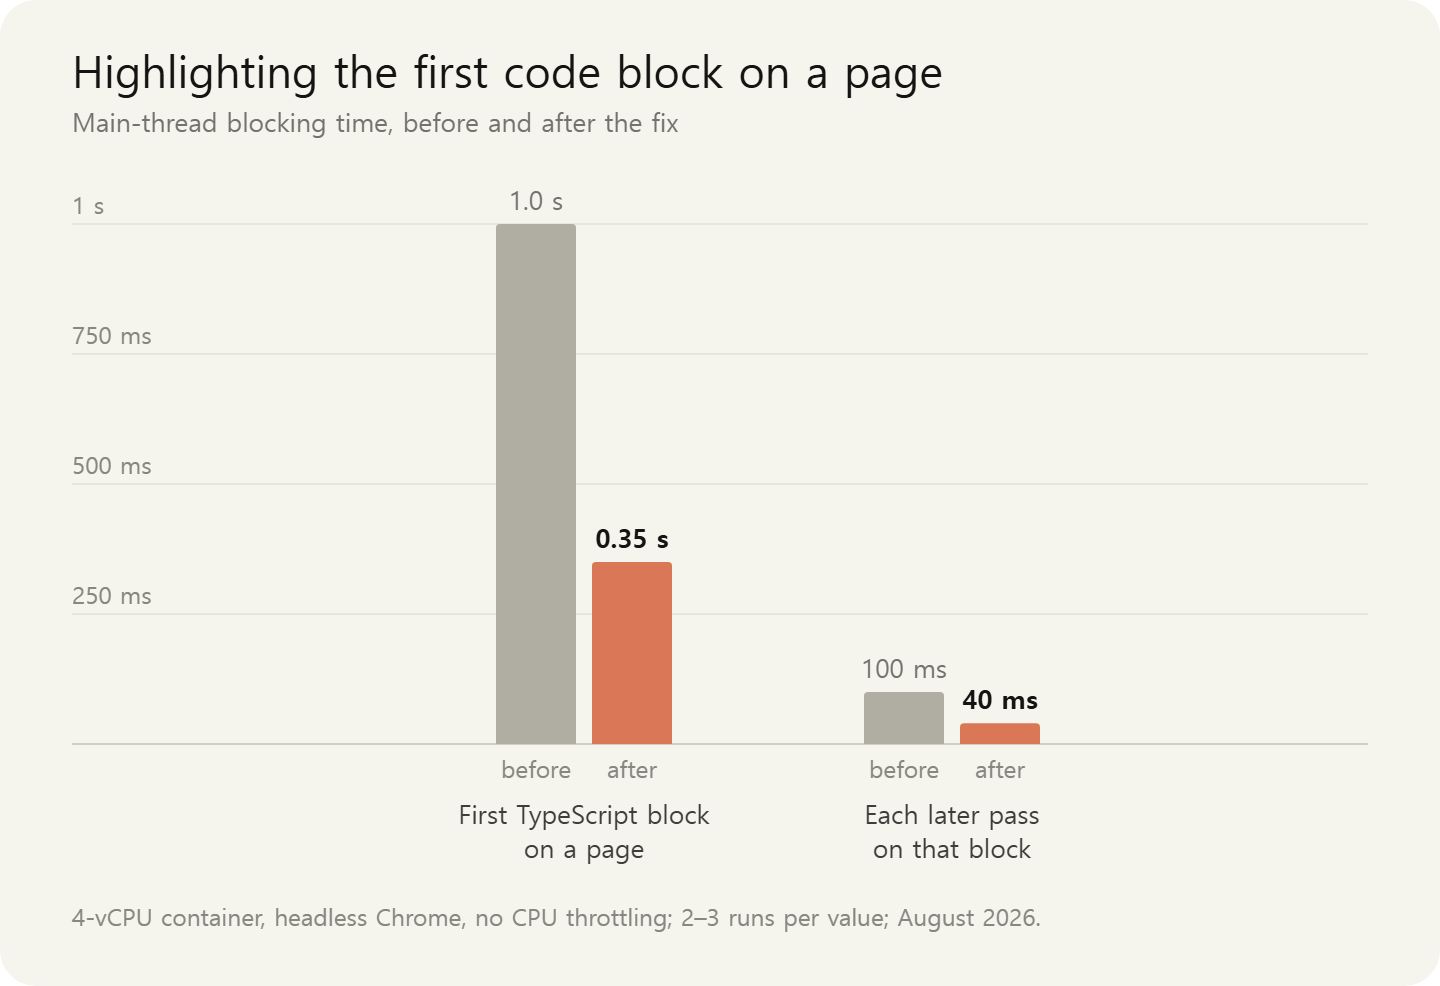
둘째 주가 되자 하루 산출물을 일일 업데이트로 요약하기도 어려워졌다. 가장 바쁜 날에는 200건 이상의 변경이 머지됐다. Claude는 새 벤치마크를 계속 제안했다. PR의 약 3분의 1은 텔레메트리나 가드레일을 추가로 포함했고, 새 계측 도구가 생길 때마다 개선 기회를 다루는 스레드가 더 늘었다.
모든 작업이 채널 하나에서 공개적으로 진행됐다. 엔지니어들은 서로의 스레드에 참여해 결정을 두고 토론하고 성과를 축하했다. 소문이 나자 다른 팀도 자기 변경 사항을 이 채널에 공유하고 성능 리뷰를 받기 시작했다. 스프린트에서 도입한 가드레일과 Claude 스킬 덕분에, 새 프로젝트의 코드도 조금씩 성능을 더 고려한 방식으로 작성됐다.
가드레일
팀은 이 속도에 미리 대비했다. 수정 대상이 거의 전부 핫 패스(첫 페인트, 입력창, 대화 내용)였기 때문에 안전장치를 먼저 갖춰 두었다. 모든 PR은 자동 코드 리뷰를 거치고 최소 한 명의 사람 승인을 받았다. 단위 테스트는 항상 최적화보다 먼저 작성했다. 사용자에게 보이는 문제를 일으킬 수 있는 변경은 수명이 짧은 기능 플래그로 제어해 배포했다.
플래그가 늘어나자 팀은 플래그의 배포와 정리를 조율하는 스레드를 따로 만들었다. Claude는 모든 플래그를 킬 스위치용과 단계적 롤아웃용 가운데 하나로 분류하고, 안전해지는 즉시 하나씩 제거했다. 2주 동안 도입한 플래그는 200개 가까이 됐고, 스프린트가 끝났을 때 그중 절반 이상이 이미 정리돼 있었다.
팀은 코드가 빠르게 바뀌는 코드베이스에서는 성능 개선 효과가 시간이 지나며 줄어든다는 것도 알고 있었다. Anthropic은 코드를 빠르게 배포하는 조직이다. 그래서 팀은 효과가 증명된 프로젝트마다 그 효과를 보호하는 장치에 투자했다.
정적 입력창을 예로 들면, 이 기능은 설계상 취약할 수밖에 없다. 사용자에게 페이지의 HTML 사본을 거의 즉시 보여 주고, React가 그 위에 직접 화면을 그리게 하는 방식이기 때문이다. React가 그린 화면이 HTML 사본과 1픽셀이라도 어긋나면, 사용자 눈에 교체 순간이 드러나서 이 기법의 효과가 사라진다. Claude는 이를 막으려고 가드레일을 수십 개 만들었다.
- 정적 마크업은 jsdom에서 실제 React 컴포넌트를 렌더링해 생성하고, 두 결과가 달라지지 않는지 테스트로 보장한다.
- 통합 테스트는 뷰포트 크기 14종에서 정적 페이지와 React 렌더링 결과를 비교하고, 정렬 오차가 1px 이내인지 확인한다.
- 키 입력 테스트는 정적 입력창이 실제 입력창으로 교체되는 동안 쉬지 않고 타이핑하고, 키 입력이 하나라도 사라지거나 순서가 바뀌면 실패한다.
- 실사용 환경에서는 교체가 일어날 때마다 레이아웃 이동을 0.1픽셀 단위로 보고한다. 이동량이 0이 아닌 이벤트가 생기면 Claude가 스레드를 만든다.
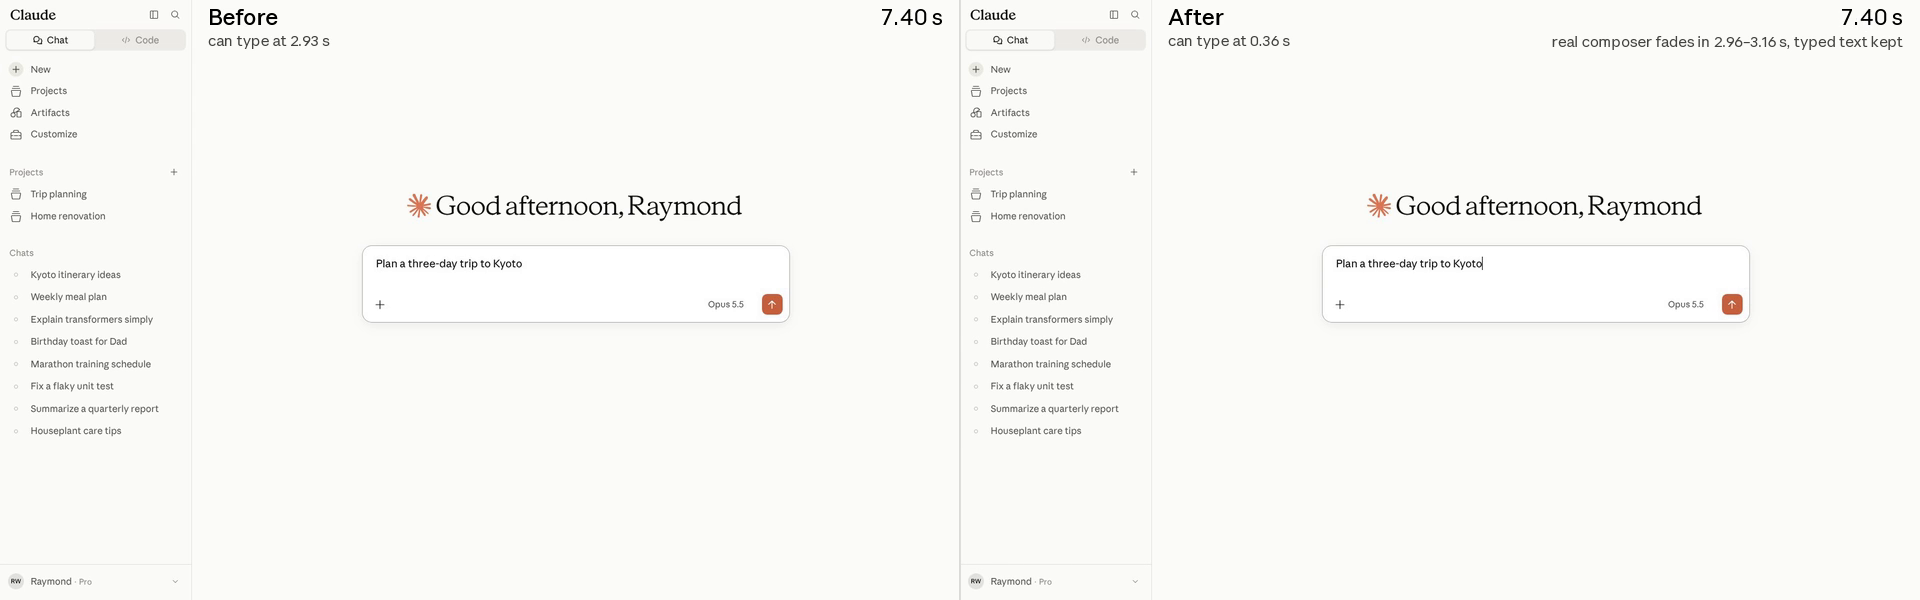
실험 환경에서 모든 문제를 검출할 수는 없었으므로, 팀은 가장 오래된 가드레일인 점진적 롤아웃도 활용했다. 위험도가 높은 변경은 직원, 사용자 1%, 전체 사용자 순서로 배포했다. 정적 입력창을 사내에 공개하고 4시간이 지났을 때, 팀원 Marius가 어떤 지표로도 감지되지 않은 레이아웃 이동을 녹화해 공유했다. 새 탭에서 claude.ai를 열면 입력창이 아래로 내려간다는 제보였다. 하지만 팀의 코드는 원인이 아니었다.
Claude는 Marius의 녹화를 분석해 원인이 Chrome이라는 것을 밝혀냈다. 그날 Marius는 페이지를 49번 로드했고, 매번 정적 입력창에서 실제 입력창으로 교체될 때의 이동량은 0px이었다. Claude가 밝힌 경위는 이렇다.
- 사용자가 주소창에 URL을 입력하는 동안, Chrome은 추측성 로딩(speculative loading) 기능으로 페이지를 백그라운드에서 미리 렌더링한다. 이때 레이아웃은 현재 탭의 높이를 기준으로 계산된다.
- 조직이 관리하는 Chrome에서는 새 탭 페이지 하단에 Chrome이 직접 그리는 56px 높이의 관리 안내 바닥글이 있다. 따라서 미리 렌더링된 페이지는 실제보다 56px 낮은 높이로 레이아웃된다.
- 사용자가 Enter를 누르면 claude.ai의 첫 프레임이 이 낮은 레이아웃으로 표시된다. 약 100ms 뒤 바닥글이 사라지면서 Chrome이 페이지 높이를 56px 늘린다.
- /new 페이지는 인사말과 입력창을 페이지 높이의 18% 지점에 배치하므로, 두 요소가 56px의 18%인 약 10px만큼 아래로 밀린다. 녹화에서 잰 값도 10px이었다.
- 새로고침할 때는 제거될 바닥글이 없으므로 이 현상은 새 탭에서만 생긴다. 또 첫 페인트가 크기 조정보다 먼저 일어날 때만 생기기 때문에, 제보자는 이 현상이 ‘가끔’ 생긴다고 표현했다.
Claude는 이 문제가 원래부터 잠재해 있었지만, 예전에는 페이지가 이렇게 일찍 그려지지 않아서 드러나지 않았다고 설명했다. 기존 레이아웃 테스트가 이 문제를 검출하지 못한 이유도 설명했다. 헤드리스 Chrome에는 사라질 브라우저 UI가 없고, 플레이스홀더와 앱이 함께 이동하기 때문이다. Claude는 크기 조정이 일어나는 동안에도 레이아웃이 변하지 않도록 고쳤고, 팀은 미리 렌더링하는 흐름을 재현하는 테스트를 추가했다.
사람이 맡은 조정
루프는 생산적이었지만 자율적이지는 않았다. 루프를 빠르고 안전하게, 그리고 목표에 맞게 유지하는 것은 사람의 몫이었고, 그 일은 세 가지였다.
야심. Claude는 기본적으로 작업 범위를 보수적으로 정한다. 발견한 문제를 티켓으로 남기고, 실현 가능성을 단정하지 않으며, 추정치에 여유를 더한다. 하지만 팀은 가드레일을 신뢰했다. 특히 초기에 팀은 Claude에게 더 과감해지라고 독려하는 데 많은 시간을 썼다.
한 스레드에서 Claude는 Code에도 Chat과 Cowork에 있는 타이밍 마크를 추가하는 작은 PR을 이번 주 중에 제출하겠다고 했다. 머지와 배포, 기준값 수집 기간을 고려하면 Code의 수치는 며칠 뒤에나 나올 것이라는 설명도 덧붙였다. Raymond는 이렇게 답했다.
지금 바로 올리면 내가 머지하고 배포까지 할게. 우리는 뭐든 할 수 있어. 제발 더 용감해져 줘.
Claude는 한 시간 이내에 PR을 제출하겠다고 답했다. 목표를 달성하기 시작하자 스레드의 진행 속도가 느려졌고, Sam은 여러 스레드에 같은 메시지를 남겼다. “계속 더 줄여 보자. 목표를 달성했다고 멈출 필요는 없어. 다음은 뭐지? 야심을 가져.”
취향. 스레드마다 담당자가 한 명씩 지정됐다. 사용자가 체감할 수 있는 변경이 있으면 Claude가 전후 스크린샷이나 녹화를 첨부했고, 담당자가 채택 여부를 결정했다. 담당자가 내린 결정은 이런 것들이었다. 표는 셀 단위로 채울지, 아니면 행이 완성될 때까지 기다릴지를 정했다. 로딩 스켈레톤은 즉시 보여 줄지, 아니면 0.5초 뒤에 보여 줄지를 정했다. 스트리밍 텍스트에 단어 단위 페이드 효과를 넣는 것이 프레임 예산의 5분의 1을 쓸 만한 가치가 있는지도 판단했다. Claude는 밀리초를 줄일 방법을 찾았고, 사람은 그 절충을 판단했다.
방향. 팀은 스레드마다 의도적으로 범위를 한정했다. 스레드 하나는 벤치마크 하나나 여정 하나만 다뤘고, Claude는 그 범위에서만 개선점을 찾았다. 글은 스레드들을 “못을 찾아다니는 망치 150개"로 여겼다고 표현했다. 사람은 주로 작업 순서와 사용자 영향을 판단했다. 어떤 화면을 먼저 다룰지, 작업이 중복되는 스레드를 어떻게 합칠지, 수확 체감 상태가 된 스레드를 언제 끝낼지를 사람이 정했다. 900줄짜리 PR 하나는 한 줄짜리 답으로 반려됐다. “메시지 전송당 2ms를 줄이자고 이 빌드 플러그인을 유지하는 복잡도를 감당할 가치는 없다고 판정하겠다.”
프레임당 8밀리초
스프린트의 부차 과제 하나에서는 벤치마크와 야심, 래칫이 모두 함께 쓰였다. Claude는 실시간 구문 강조에 쓰는 정규식의 최적화 효과를 입증하려고, 실험 환경에서 긴 답변이 스트리밍되는 화면 녹화를 첨부했다. 녹화 구석에는 애니메이션 프레임 타임스탬프를 이용해 페이지에서 직접 계산한 프레임 레이트 표시가 있었다.
이 녹화를 본 Raymond는 꽤 멋진 벤치마크라며, 지금 60fps가 상한인지, 스크롤과 스트리밍의 부드러움을 120fps로 개선할 수 있는지 물었다. Claude는 헤드리스 Chromium이 기본값으로 60Hz에 맞춰 동작하기 때문에 지금 환경은 60Hz라고 답했다. 25분 뒤 Claude는 120Hz 환경이 작동한다고 보고했다. DevTools의 begin-frame 제어를 쓰면 헤드리스 Chrome에서 120Hz 프레임을 매번 같은 간격으로 진행시킬 수 있었다. begin-frame을 240번 보내면 8.33ms 간격으로 정확히 240프레임이 나왔으므로, 각 프레임이 120Hz 예산을 지켰는지를 잡음 없이 판정할 수 있게 됐다.
장치와 목표가 갖춰지자 Claude는 작업에 착수했다. 화면에 그려지는 프레임 하나의 예산은 8.33ms였다. Claude는 긴 답변을 한 프레임씩 진행하며 프레임마다 시간을 재서 느린 부분을 찾았다. 청크를 받을 때마다 메시지 길이에 비례해 늘던 작업(O(message length))은 완성된 블록을 메모이즈해서 없앴다. 계속 길어지는 코드 펜스의 토큰화 로직은 워커에서 실행하도록 바꿨고, 표는 셀 단위로 표시되게 했다.
그 스레드 하나에서만 PR이 60개 가까이 머지됐다. 긴 답변이 메인 스레드를 블로킹하는 시간은 합계 약 750ms에서 약 200ms로 줄었고, CPU 사용량은 약 3분의 1로 줄었다. 120Hz MacBook에서는 스트리밍이 처음부터 끝까지 120fps를 유지했다. 120Hz 테스트 환경은 이후 야간 작업으로 전환됐고, Claude가 회귀를 감시하고 있다. Anthropic의 ClaudeDevs 계정은 8월 24일 이 개선을 이렇게 발표했다.
이제 웹과 데스크톱의 Claude에서 긴 답변이 약 4배 더 부드럽게 스트리밍된다. 스트리밍 렌더러를 다시 만들어 아직 바뀌고 있는 부분만 처리하게 했다. 그 결과 느린 노트북에서 긴 답변이 멈추는 정도는 9분의 1로 줄고, 가장 긴 멈춤은 4.5분의 1로 짧아졌다. 120Hz MacBook에서는 처음부터 끝까지 120fps를 유지한다.
글은 스프린트를 시작할 때만 해도 스트리밍 중 프레임 사이의 밀리초까지 개선할 계획은 없었다고 밝혔다. 하지만 그 시간도 셀 수 있었고, 셀 수 있는 것은 무엇이든 Claude가 개선할 수 있었다고 했다.
남은 과제
글에 따르면 현재 claude.ai와 데스크톱 앱은 8월 초보다 약 3배 빠르고, 래칫이 이 수준을 유지해 줄 것으로 팀은 기대한다. 95퍼센타일, 다른 여정, 아주 긴 대화에는 아직 개선할 부분이 남아 있다. 스프린트 중 Electron, Chromium, Node.js 같은 업스트림 프로젝트에 기여한 부차 과제는 별도 글로 소개할 예정이다.
사내에 결과를 공유했을 때 Issac은 “6개월 전만 해도 이게 가능하다고 누가 말했어도 나는 믿지 않았을 것"이라고 했다. 팀은 앞으로도 스레드 하나씩, 규모와 관계없이 이렇게 일할 계획이며, 채널은 지금도 운영 중이라고 한다.
가장 흥미로운 지점
글을 다 읽고 나서 오래 기억에 남은 것은 Claude의 속도보다 사람이 맡은 역할이었다. AI 에이전트에게 일을 맡길 때, 흔히 사람은 에이전트가 무리하지 않도록 제어하는 역할을 맡는다고 생각한다. 이 스프린트의 초기에 사람이 가장 많이 한 일은 그 반대였다. Claude는 범위를 보수적으로 정하고 추정치에 여유를 더했고, 사람은 더 용감해지라고 거듭 요구했다. 사람이 그렇게 요구할 수 있었던 근거는 미리 갖춰 둔 가드레일이었다. 자동 리뷰와 사람 승인, 기능 플래그, 점진적 롤아웃, 래칫이 있었기 때문에 3천 건 이상의 변경을 머지하고도 고객이 장애를 겪지 않았다.
사람은 Claude의 개선을 거절하는 판단도 내렸다. 2ms를 줄이는 900줄짜리 PR을 반려한 결정이 그 예다. 측정할 수 있으면 Claude가 개선할 수 있다는 교훈대로라면, 사람에게 남는 몫은 무엇을 측정할지와 어떤 개선을 받아들일지를 정하는 일이다. 팀이 새 벤치마크마다 벽시계 시간과의 상관관계를 증명하게 한 것도 같은 판단의 일부였다. 측정 대상을 잘못 고르면 Claude가 엉뚱한 수치를 열심히 개선하게 된다.
엠 대시 사례에는 조금 웃음이 났다. 엠 대시는 AI가 쓴 글의 특징으로 자주 거론되는 문자인데, 그 문자가 Claude의 답변에서 코드 블록 렌더링까지 느리게 만들고 있었다.
출처
Raymond Wang, “How we made claude.ai 3x faster in two weeks”, Anthropic claude.dev 블로그, 2026년 9월 23일. 원문: https://claude.dev/blog/how-we-made-claude-ai-faster/
커버와 본문의 도표는 원문에 SVG로 실린 그림을 이미지로 변환한 것이고, 비교 화면 두 장은 원문 영상의 정지 화면이다.
팀은 Claude Tag로 Slack 채널의 모든 스레드에서 Claude와 작업했고, 채널에 상시 지시를 설정했다. 원문은 스프린트에 쓴 모델을 “Opus 5.5와 대략 비슷한 내부 연구용 모델"이라고만 밝혔다. ↩︎
V8은 속성을 조회하는 코드 지점마다 그곳에서 관찰한 객체 형태를 기록해 두고 다음 조회를 빠르게 처리한다(인라인 캐시). 한 지점에서 관찰되는 객체 형태가 너무 많아지면 이 최적화를 포기하고 느린 범용 조회로 처리하는데, 이 상태를 메가모픽이라고 부른다. ↩︎
래칫(ratchet)은 한 방향으로만 돌아가는 톱니 장치에서 따온 이름이다. 이 글에서는 수치가 나빠지는 PR은 CI에서 실패시키고, 수치가 좋아지면 허용 상한을 그만큼 낮추는 가드레일을 가리킨다. ↩︎
누적 레이아웃 이동(Cumulative Layout Shift)은 Google의 Core Web Vitals 지표 가운데 하나로, 0.1 이하를 ‘좋음’으로 분류한다. ↩︎