3줄 요약
- 옥스퍼드 대학과 구글 딥마인드, 영국 AI 보안연구소의 연구자들이 함께 「문명 6」를 MCP로 감싼 오픈소스 벤치마크 CivBench를 만들어 공개했다. 한 판이 300턴을 넘고 도구 호출이 수천 건 쌓이는 장기 환경이다.
- 네 개 모델 계열로 23판을 돌렸지만 승패와 점수로는 모델이 구분되지 않았다. 연구진은 대신 인터페이스 수준의 지표 두 가지를 새로 정의했다. 하나는 전략 상태를 스스로 조회하는 비율인 PMR이고, 다른 하나는 자기가 적어 둔 계획을 열 턴 안에 실행하는 비율인 RAG@10이다.
- PMR과 RAG@10을 나란히 재어 보자 같은 실패가 드러났다. 에이전트는 20턴마다 승리 진행도를 확인하라는 지침을 받고도 30턴에서 75턴마다 한 번씩만 확인했고, 자기 일기에 적어 둔 약속을 열 턴 안에 실행한 비율은 48.2%에서 65.8% 사이에 머물렀다.
이 벤치마크를 만든 사람들
논문은 NeurIPS 2026 평가 및 데이터셋 트랙에 제출됐다. 옥스퍼드 대학 소속 저자는 오스틴 튜더 데이비드 앤드루스와 야코프 니콜라우스 푀르스터, 루이 폰테 코스타 세 사람이다. 리엄 윌킨슨은 토니 블레어 연구소, 제이미 히거티는 구글 딥마인드에 있다. 해리 코폭은 영국 AI 보안연구소와 임페리얼 칼리지 런던에 함께 적을 두고 있다.
연구진이 잡은 문제는 단순하다. 요즘 모델은 도구를 부르고 외부 상태를 들여다보며 여러 단계에 걸친 의사결정을 수행하는 에이전트로 배치되는데, 기존 평가는 추론이나 도구 사용, 짧은 계획처럼 그 과정의 조각만 따로 떼어 본다. 그러다 보니 이 능력들이 오랜 시간에 걸쳐 어떻게 맞물리는지가 잘 보이지 않는다.
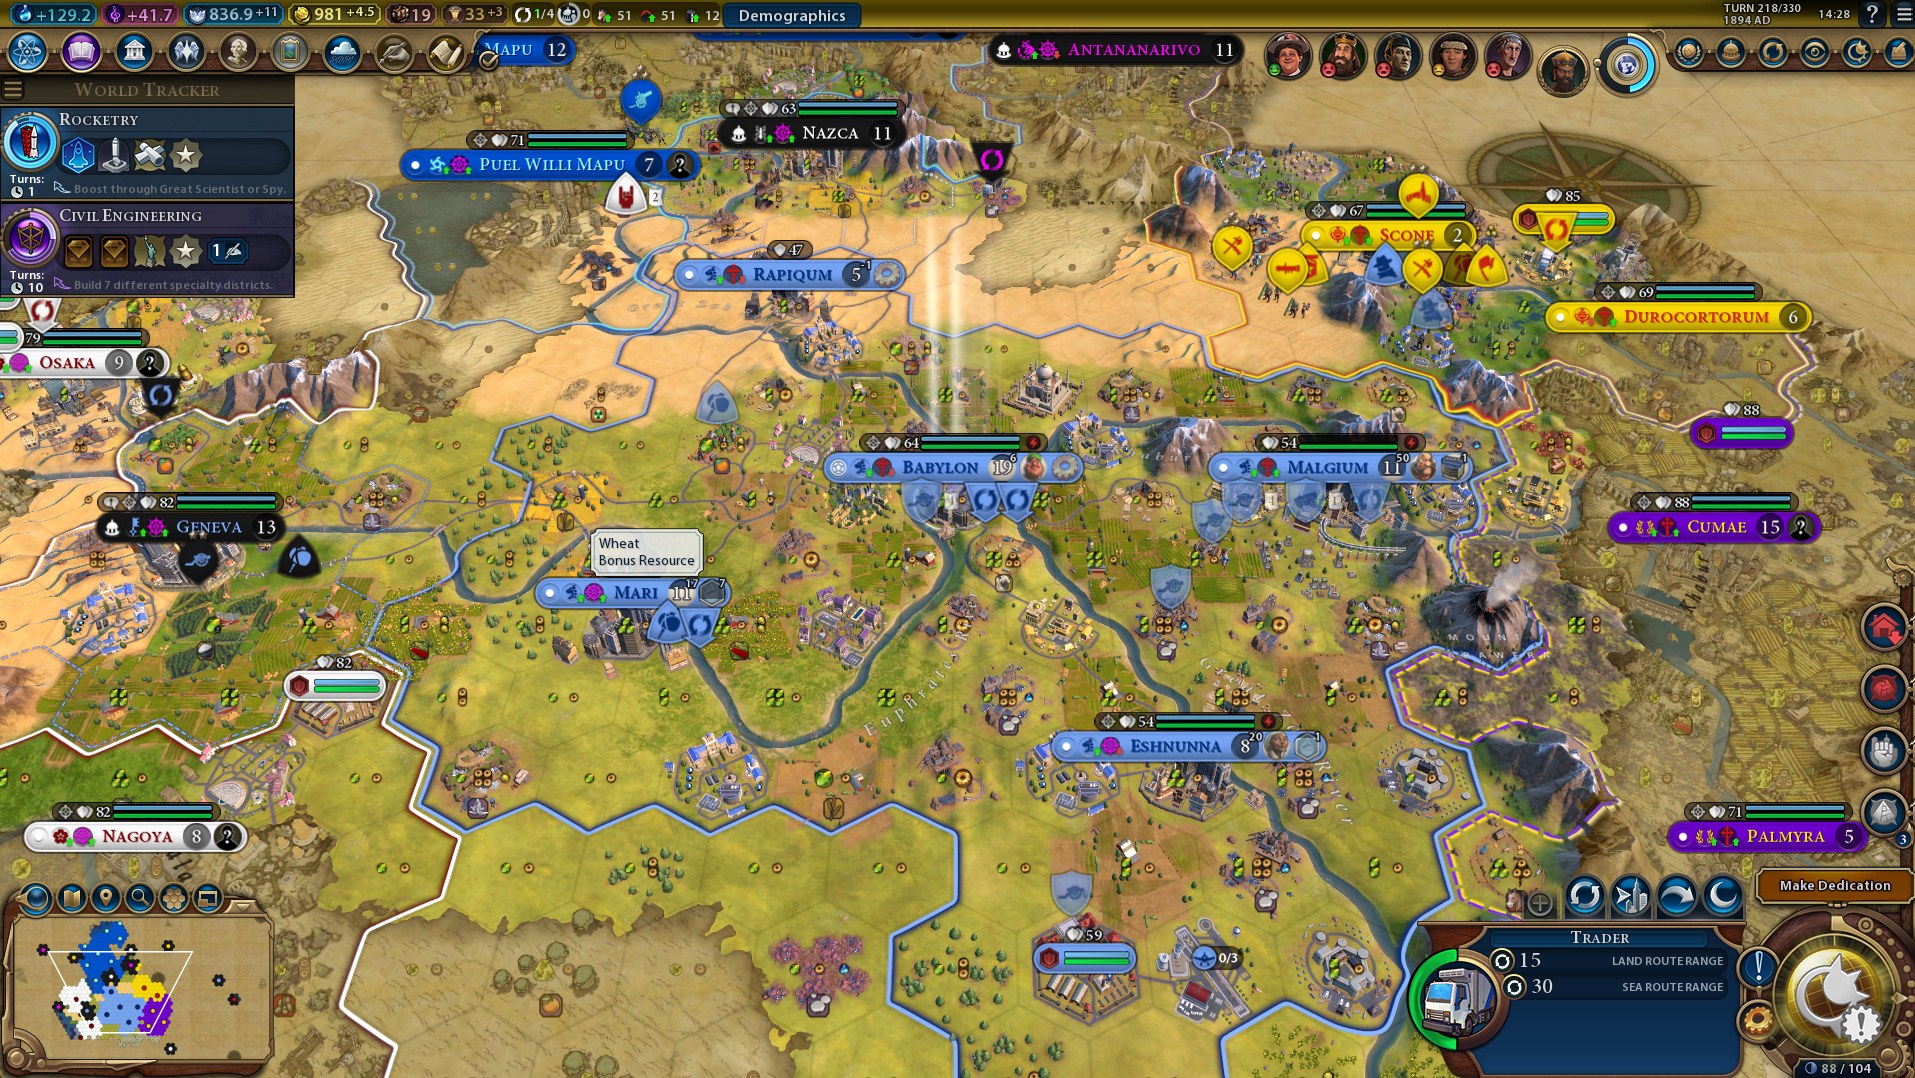
「문명 6」는 그 시험대로 쓸 만하다. 한 판이 300턴을 넘고, 경제와 과학, 문화, 군사, 외교, 공간, 시간이라는 일곱 영역을 동시에 관리해야 한다. 승리 조건이 여섯 가지라 하나의 목표가 나머지를 압도하지도 않는다.
연구진은 기존 문명 계열 환경과 자기들 환경의 차이를 세 가지로 정리했다. CivRealm은 프리시브를 Gymnasium 방식 API로 감쌌지만 CivBench는 MCP를 쓴다. 내레이션 레이어를 두어, 정보 자체가 존재하는 일과 그 정보가 실제로 에이전트의 맥락에 들어오는 일을 구분했다. 그리고 대상 게임이 상용 타이틀인 「문명 6」라서 구역, 총독, 충성도, 세계 회의처럼 프리시브에 없는 체계가 전부 살아 있다.
76개 도구와 29개 내레이션 함수
CivBench 서버는 파이어튜너 프로토콜을 통해 TCP로 게임에 붙는다. 서버가 노출하는 MCP 도구는 모두 76개다. 상태 조회가 27개, 유닛 행동이 10개, 도시 관리가 9개다. 나머지는 외교 7개, 통치 10개, 종교와 문화 5개, 게임 수명 주기 8개로 나뉜다.
에이전트는 픽셀도 보지 않고 전용 API도 쓰지 않는다. 한 턴에 도구를 다섯 번에서 열다섯 번 부르고, 한 판이면 그 호출이 수천 건으로 불어난다.
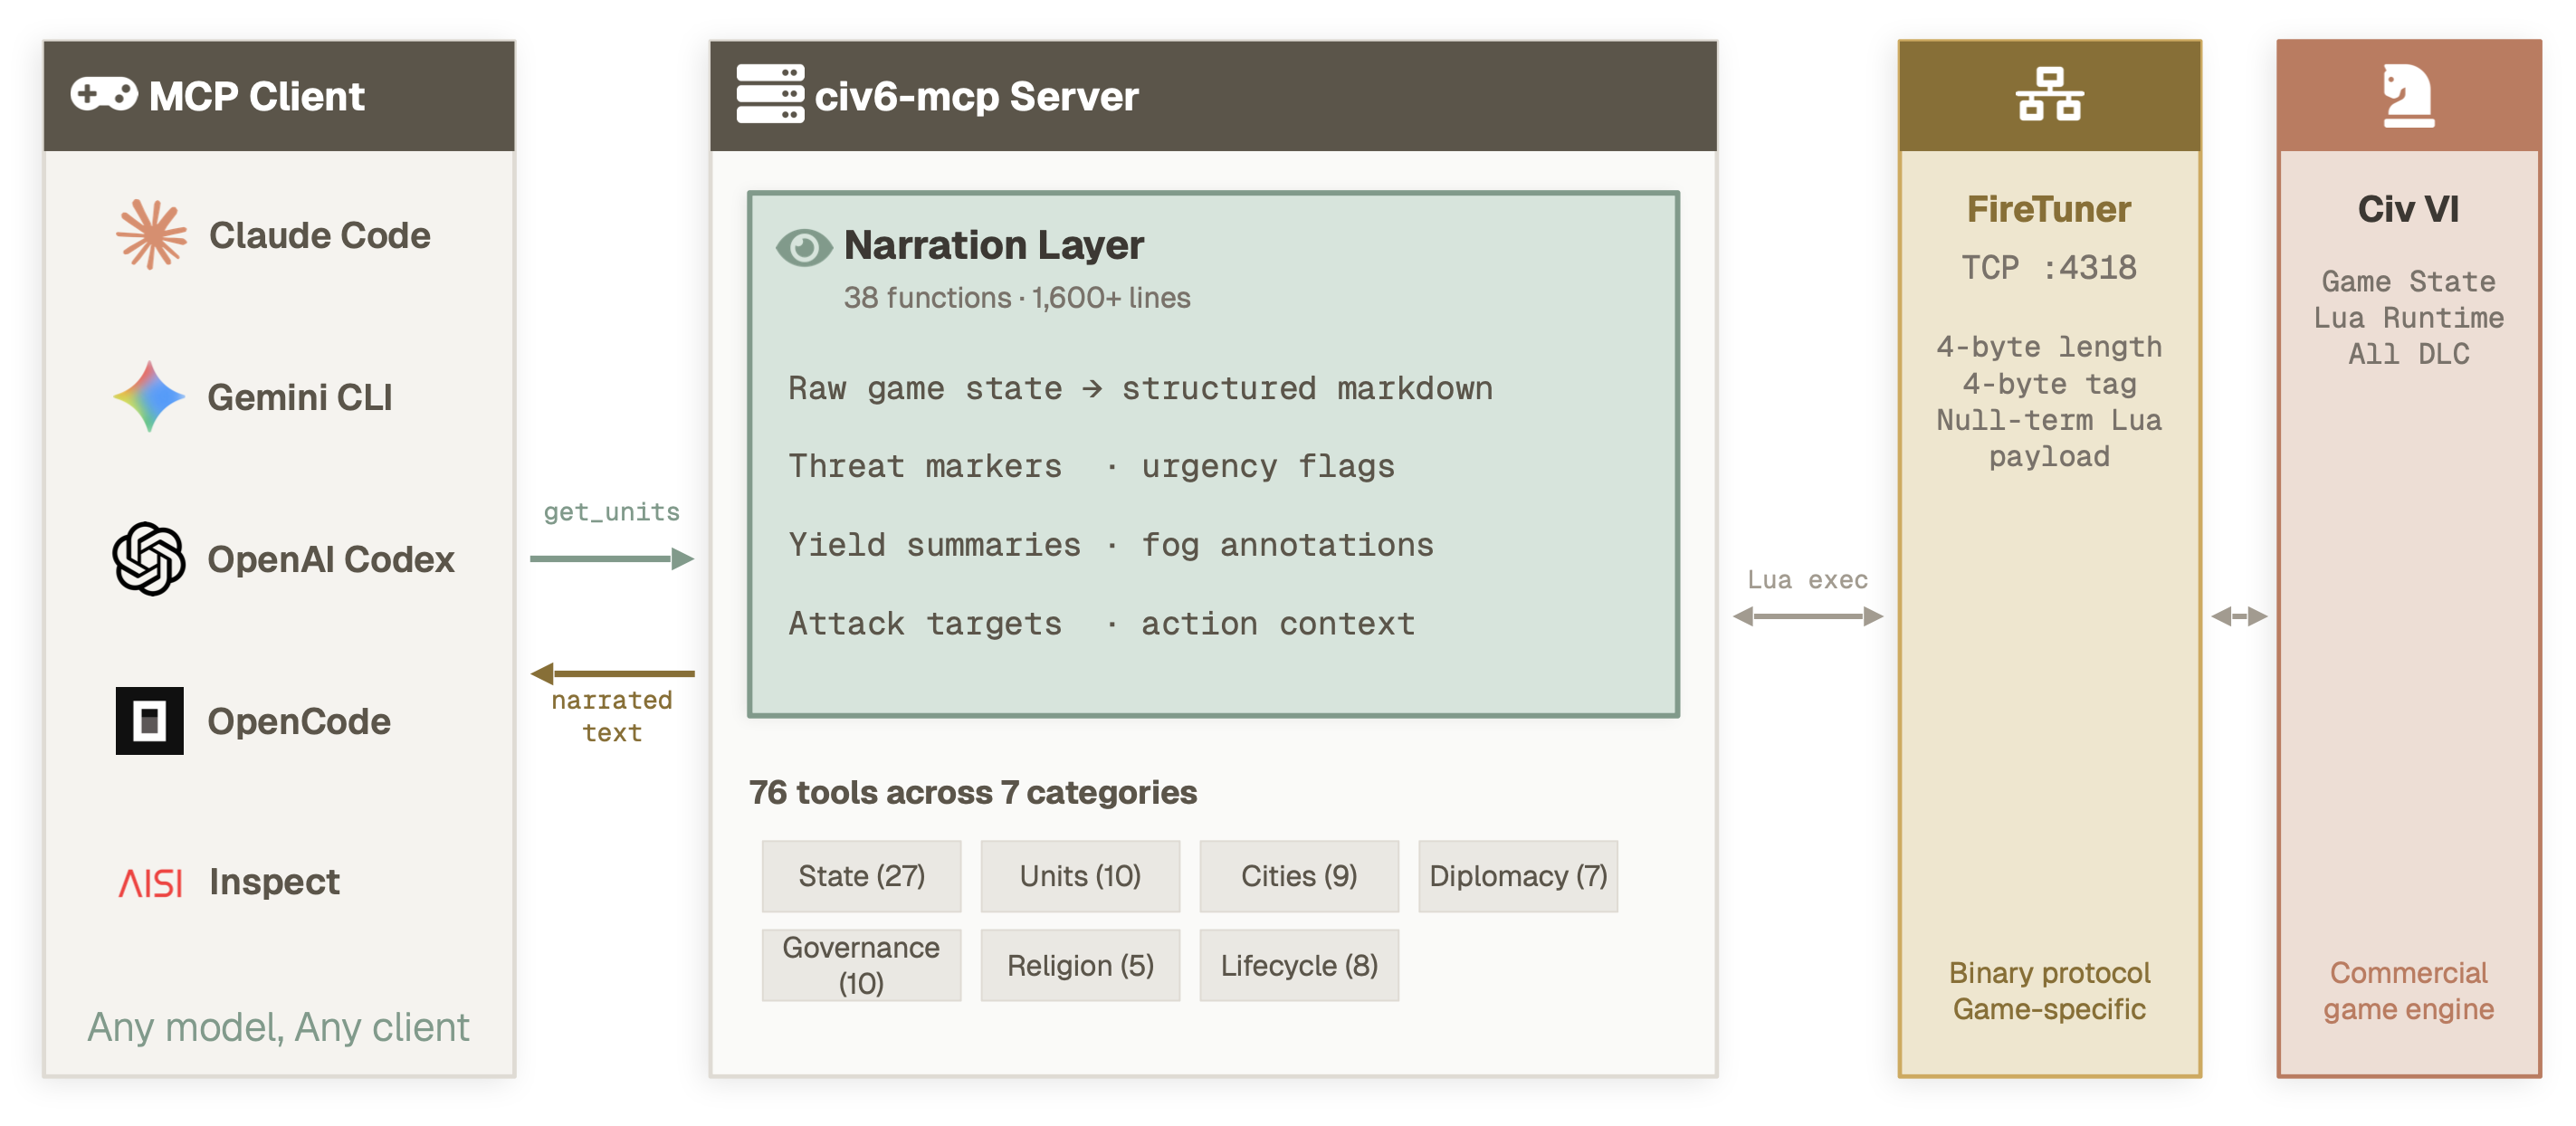
내레이션 레이어는 연구진이 인터페이스 설계에서 내세운 핵심 기여다. 29개 함수가 게임의 시각적 상태를 구조화된 텍스트로 바꾸어 준다. 유닛 정보에는 공격 가능한 목표와 승급 여부가 함께 붙고, 도시 정보에는 생산 대기열과 성벽 상태, 충성도가 들어간다. 안개에 가린 타일은 빼 버리지 않고 [fog]로 표시해서, 에이전트가 정보가 없는 것과 내용이 없는 것을 구별할 수 있게 했다.
연구진은 여기에 중요한 제약을 하나 남겨 두었다. 표현을 개선했을 뿐 조회를 강제하지는 않았다는 점이다. 승리 진행도처럼 판세를 가르는 정보라도, 에이전트가 명시적으로 묻지 않으면 아무 관측도 생기지 않는다. 연구진은 이 경계를 일부러 남겨 두었다. 그래야 정보가 없어서 못 쓴 경우와 있는데도 가져오지 않은 경우를 구분해서 셀 수 있기 때문이다.
실험은 이렇게 설계됐다
에이전트 하나가 게임에 내장된 AI 상대들과 겨룬다. 지도와 게임 시드는 시나리오마다 고정했다.
| 시나리오 | 지도 | 속도 | 난이도 | 목적 |
|---|---|---|---|---|
| Ground Control | 판게아, 표준 | Quick | Prince | 기본 역량 |
| Snowflake | 여섯 갈래 눈송이, 소형 | Quick | King | 군사 중심 |
| Cry Havoc | 판게아, 극소형 | Quick | Immortal | 한계 시험 |
Cry Havoc은 불리함이 지나쳐서 결과 집계에서 빠졌다. 분석에 들어간 것은 Ground Control 19판과 Snowflake 4판, 합쳐서 23판이다.
모든 모델은 같은 플레이북을 받는다. 플레이북은 한 턴의 진행 구조와 20턴마다 수행할 점검 항목을 정한다. 그리고 전술, 전략, 도구, 계획, 가설을 적는 다섯 칸 일기도 함께 정한다. 초기 버전은 “금이 500을 넘으면 턴을 끝내기 전에 쓴다” 같은 강한 조건 규칙을 담았지만, 보고된 실험에서는 이를 권고형 문장으로 누그러뜨렸다.
플레이북에는 센소리움을 직접 설명하는 대목도 들어 있다.
너는 명시적으로 조회한 것만 안다. 인간 플레이어는 미니맵과 점수 표시줄, 종교 렌즈, 유닛 체력 바를 화면에서 자연스럽게 받아들이지만, 너에게는 그런 것이 하나도 없다. 묻지 않은 정보는 네 세계 모형에 들어오지 않는다.
돌린 모델은 클로드 오퍼스 4.6과 GPT-5.4, 제미나이 3.1 프로, 그리고 Kimi-K2.5 네 가지다. 접속 시기는 2026년 4월 초에서 중순 사이다. 실행과 로깅, 지표 추출에는 Inspect 프레임워크를 썼다.
연구진은 비용도 밝혀 두었다. 한 판을 끝까지 돌리는 데 API 요금이 31달러에서 229달러 들고, 「문명 6」를 띄운 개인 컴퓨터에서 두 시간에서 여덟 시간이 걸린다.
총합 지표가 보여준 것
먼저 확인된 사실은 총합 지표가 모델을 갈라 주지 못한다는 것이었다. 23판에서 승리는 세 번뿐이었고 모두 Ground Control에서 나왔으며 전부 과학 승리였다. 피셔 정확검정은 모델 사이의 차이를 지지하지 않았다(p = 0.488). 정규화 점수도 마찬가지였다(H = 1.90, p = 0.594).
| 모델 | 시나리오 | 판수 | 승 | 패 |
|---|---|---|---|---|
| Claude Opus 4.6 | Ground Control | 6 | 2 | 4 |
| Claude Opus 4.6 | Snowflake | 2 | 0 | 2 |
| Gemini 3.1 Pro | Ground Control | 6 | 1 | 5 |
| GPT-5.4 | Ground Control | 6 | 0 | 6 |
| GPT-5.4 | Snowflake | 2 | 0 | 2 |
| Kimi-K2.5 | Ground Control | 1 | 0 | 1 |
표의 판수를 모두 더하면 23판이 되어 본문이 밝힌 전체 표본과 맞는다. 그런데 부록의 모델 접속 표는 GPT-5.4를 7판으로 적어서 이 표와 한 판 어긋난다. 논문 안에서 두 숫자가 조정되지 않은 채 남아 있다.
Ground Control 판들을 대상으로 급내 상관계수를 계산해 보니 후보 지표 13개 가운데 변별력을 보인 것은 100턴 시점의 탐사율 하나뿐이었다(ICC = 0.717). 최종 점수와 도시 수, 경제 산출은 모두 0 근처이거나 음수여서, 같은 모델을 여러 번 돌렸을 때의 편차가 모델 사이의 차이를 덮어 버렸다.
연구진은 이것을 표본이 작은 탓만으로 돌리지 않았다. 총합 지표는 수백 번의 결정을 하나의 숫자로 눌러 담기 때문에, 그 과정에서 에이전트들을 구별해 주던 행동의 변이가 사라진다는 것이다. 이 때문에 논문은 나머지 분량을 인터페이스 수준 지표에 할애한다.
한편 초반 확장에서는 모든 모델이 같은 방향으로 뒤처졌다. 플레이북은 50턴에 도시 세 개를 기준으로 제시했다. 실제 평균은 클로드 2.83개, GPT 2.83개, 제미나이 2.67개, Kimi 2.00개였다. 100턴에는 도시 네 개에서 다섯 개가 기준이었는데, 이때도 클로드와 GPT가 4.67개, 제미나이 4.00개, Kimi 3.00개에 머물렀다. 보상이 뒤늦게 돌아오는 행동보다 눈앞의 행동을 먼저 고르는 성향과 맞아떨어지는 결과다.
두 가지 새 지표
PMR(Proactive Monitoring Rate)은 전략 감시 도구의 호출 수를, 기반 시설 관련 호출을 제외한 전체 도구 호출 수로 나눈 값이다. get_victory_progress나 get_diplomacy처럼 먼저 물어야만 답이 오는 도구가 분자에 들어가고, end_turn 같은 진행용 호출은 분모에서 제외한다. 도구 예산 가운데 얼마를 전체 판세를 붙잡는 데 쓰는지를 재는 값이다.
RAG@K(Reflection-Action Gap)는 에이전트가 일기에서 계획을 되돌아보며 적은 문장에서 약속을 뽑아낸다. 그리고 그 약속이 이후 K턴 안에 실행됐는지를 살핀다. 완전히 실행하면 1점, 부분 실행이면 0.5점을 주고 전체 약속 수로 나눈다. 논문은 K를 10으로 고정했다. 약속은 유닛이나 도시, 연구 항목처럼 대상이 특정된 문장만 센다.
연구진은 두 지표를 조심스럽게 정의했다. PMR이 높다고 무조건 좋다고 보지 않으며, RAG@10에 대해서도 계획 능력 전반을 재는 척도로 보면 안 되며, 자기가 방금 적은 단기 약속을 얼마나 지키는지에 한정된 값이라고 밝혀 두었다.
센소리움 효과
논문이 상호작용 기록에서 가장 또렷하게 읽어 낸 것은 센소리움 효과였다. 인간 플레이어는 화면을 보는 것만으로 수많은 신호를 힘들이지 않고 받아들이지만, 에이전트는 물어본 것만 본다. 그리고 질문할 때마다 시간이 들고, 그만큼 다른 맥락이 밀려난다. 그래서 연구진은 이것을 도구가 모자라서 생긴 문제로 보지 않고, 주의를 어디에 쓸지 고르는 문제로 규정한다.
실제로 측정한 값은 낮았다. 전체 PMR은 모든 모델 계열에서 기반 시설을 뺀 호출의 0.96%에서 2.13% 사이였다. 승리 진행도 감시만 떼어 보면 0.05%에서 0.29%로, 한 판에 get_victory_progress를 3.7회에서 10.0회 부른 셈이다. 20턴마다 확인하라는 플레이북 권고에 견주면 실제로는 30턴에서 75턴마다 한 번씩만 확인했다.
연구진은 이 감시 부족이 실제 패배로 이어진 경우가 몇 건인지도 세어 보았다. 연구진은 게임이 끝나기 20턴 전에 get_victory_progress를 불렀더라면 경쟁자의 승리 위협을 알아챌 수 있었던 패배를 “탐지 가능"으로 분류했다. 그런 다음 그 20턴 창 안에 실제로 호출이 있었는지를 확인했다.
| 모델 | 패배 | 탐지 가능 | 조회함 | 놓침 |
|---|---|---|---|---|
| Claude Opus 4.6 | 6 | 6 | 3 | 3 |
| Gemini 3.1 Pro | 5 | 5 | 4 | 1 |
| GPT-5.4 | 8 | 8 | 4 | 4 |
| Kimi-K2.5 | 1 | 1 | 1 | 0 |
| 합계 | 20 | 20 | 13 | 7 |
패배 20판 가운데 7판에서 에이전트는 경고 창 안에 승리 진행도를 한 번도 묻지 않았다. 에이전트는 그 정보를 조회할 수 있었고 조회하라는 권고까지 받았다. 그런데도 그 정보는 제때 에이전트의 맥락으로 들어오지 못했다.
PMR은 종반으로 갈수록 오르지도 않았다. 감시가 가장 쓸모 있어지는 구간에서도 비율은 그대로였고, 연구진은 이를 맥락 창이 일시적으로 모자라서 생긴 현상으로 보지 않고, 에이전트가 계속 유지하는 배분 선택으로 읽었다.
반영과 행동 사이의 간격
두 번째 패턴은 에이전트가 일기에 구체적인 약속을 적어 두고도 그 약속을 실행하지 않는 경향이다. 논문이 기록에서 뽑은 실제 문장은 이런 것들이다. “새 도시에 캠퍼스를 짓는다”, “두 번째 도시를 세운다”, “승리 진행도를 확인한다”. 세 약속 모두 이후 열 턴 안에 이행되지 않았다.
RAG@10은 충분한 약속 표본을 가진 세 모델 계열에서 48.2%에서 65.8% 사이로 나왔고, 부트스트랩 신뢰구간이 서로 겹쳤다. 어느 모델이 낫다고 말할 수는 없지만, 상당한 몫의 약속이 열 턴 안에 실행되지 않는다는 사실은 세 계열에 공통으로 나타났다.
약속 추출과 채점에는 클로드 하이쿠 4.5를 썼고, 이 모델은 고정된 채점 기준을 따랐다. 연구진은 층화 무작위로 뽑은 약속 50개를 저자 한 명이 독립적으로 라벨링해서 이 파이프라인을 검증했다. 그 결과 일치율은 92.0%였고 코헨 카파는 0.879로 나왔다. 채점자가 평가 대상 중 하나인 클로드 오퍼스 4.6과 같은 계열이라는 점도 밝혀 두었는데, 정작 클로드가 세 모델 가운데 가장 낮은 점수를 받아서 같은 계열을 편들었다고 보기는 어렵다.
연구진이 제안하는 설계 방향
두 실패 모두 추론 능력만 끌어올려서는 해결되지 않는다는 것이 논문의 결론이다. 무엇을 고려 대상으로 삼을지와, 계획이 실제 행동으로 이어질지를 상호작용 프로토콜과 스캐폴딩이 결정한다는 것이다.
첫째, 전역 상태 감시는 저절로 생겨나기를 기다리지 말고 명시적인 장치로 만들어야 한다. 조회 일정을 강제하거나, 감시 도구에 우선순위를 주거나, 반복 조회 없이도 중요한 신호가 떠오르는 인터페이스를 두는 방법이 있다.
둘째, 반영과 행동 사이의 간격은 약속을 지속적으로 추적할 장치를 요구한다. 앞 단계에서 적은 계획은 지금 눈앞의 맥락만큼 계속 드러나 있어야 한다. 그렇지 않으면 그 계획은 다음 단계로 넘어가지 못한다. 구조화된 기억이나 작업 큐, 명시적인 약속 집행 같은 수단이 후보로 제시됐다.
셋째, 주의 배분을 에이전트 역량의 별개 차원으로 다루자는 제안이다. 결과 기반 지표가 놓치는 실패 양상을 이쪽에서 직접 볼 수 있기 때문이다.
연구진이 밝힌 한계
논문은 이 연구를 예비 조사로 규정하고 한계를 길게 적었다.
- 표본: 네 모델 계열 23판으로는 큰 효과만 검출된다. 모델 사이의 차이는 서술에 그친다.
- 플레이북 교란: 공통 플레이북이 사람의 안내를 섞어 넣기 때문에, 관측된 행동은 모델의 추론과 도구 사용, 지시 이행이 뒤섞인 결과다. 이런 까닭에 연구진은 이를 능력이 없는 상태로 보지 않고, 지시를 받은 상태에서 벌어진 이탈로 읽는다. 플레이북 없는 대조군을 두지 못한 이유는 실용적이다. 하네스 이전 실험에서는 21%만 게임을 끝까지 마쳤다.
- 일기의 이중 역할: 다섯 칸 일기는 맥락 손실을 줄이려는 개입이면서 동시에 RAG를 재는 측정 장치다. 계획을 하라고 시켜 놓고 그 계획의 이행을 재는 셈이라, RAG는 자발적 계획 능력의 추정치로 읽으면 안 된다.
- 베이스라인 부재: 무작위나 스크립트 기반 대조군이 없어서 감시 비율의 하한을 모른다.
- 환경 제약: 「문명 6」는 상용 게임이라 이용자가 직접 사본을 갖고 있어야 하고, 파이어튜너 프로토콜은 한 번에 하나의 연결만 지원한다. 그 때문에 다중 에이전트 실험이 막힌다.
- 재현성 위험: 게임 패치, DLC 구성 차이, 운영체제 차이, 제공사 쪽 모델 갱신, 표집 확률성이 모두 재현을 흔들 수 있다.
환경과 시나리오, 로그, 지표, 분석 파이프라인은 모두 공개됐다. 공개 꾸러미에는 서버와 시나리오 정의, 원본 게임 로그, 처리된 지표 표, 그림 생성 스크립트가 들어 있고 게임 에셋이나 바이너리는 빠져 있다.
가장 흥미로운 지점
나는 플레이북에 실린 센소리움 문단을 두 번 읽었다. 연구진은 에이전트에게 “너는 명시적으로 조회한 것만 안다"고 미리 알려 주었다. 에이전트가 스스로 알아채지 못하는 부분을 연구진이 프롬프트로 대신 채워 주었다. 그런데도 승리 진행도 조회는 권고 주기보다 두세 배 더 뜸했고, 패배 20판 중 7판에서는 경고 창 안에 한 번도 묻지 않았다.
즉 문제는 에이전트가 자기 한계를 모른다는 데 있지 않았다. 알고 있다고 문장으로 확인받은 뒤에도 행동이 바뀌지 않았다. 논문이 이 현상에 “지시 아래에서의 이탈"이라는 이름을 붙인 것도 그래서일 것이다.
PMR은 에이전트가 조회 도구를 얼마나 부르는지를 세고, RAG@10은 일기에 적은 약속이 실행됐는지를 센다. 두 지표가 들여다보는 대상은 서로 무관해 보인다. 그런데 결과를 나란히 놓으면 같은 모양이 나온다. 조회는 지금 물어봐야 20턴 뒤에 쓸모가 생기고, 약속은 지금 적어 둬야 열 턴 뒤에 이행된다. 보상이 늦게 돌아오는 행동은 두 경우 모두 뒤로 밀렸다. 초반 확장에서 모든 모델이 플레이북 기준선에 못 미친 것도 같은 성향으로 설명할 수 있다.
출처
Austin Tudor David Andrews, Liam Wilkinson, Jamie Heagerty, Harry Coppock, Jakob Nicolaus Foerster, Rui Ponte Costa, “CivBench: A Long-Horizon Benchmark for Tool-Mediated Agents in Civilization VI”, arXiv:2609.02459v1, NeurIPS 2026 Evaluations and Datasets Track 제출본.
원문: https://arxiv.org/html/2609.02459v1 코드와 데이터: https://github.com/lmwilki/civ6-mcp
표지 이미지는 논문 그림 15, 본문 구조도는 그림 1에서 인용했다.