3줄 요약
- React 코어 팀 출신 엔지니어 Cheng Lou가 오픈소스로 공개한 Handwired는 일반 자바스크립트와 타입스크립트로 작성한 빌더 코드를 32비트 부동소수점 연산 네 가지(
affine,reglu,boolean,index)만으로 이루어진 신경망 회로(Circuit)로 컴파일한다. - 입력값의 범위와 격자 단위를 미리 선언하면(
assumeRange,assumeGrid,assumeOneHot) 조건문, 비교, 배열 조회, 물리 시뮬레이션 루프가 분기 없이 층이 적은 산술 회로로 바뀐다. 화면 주사율이 10fps에서 120fps까지 달라져도 같은 시점의 출력은 비트 단위로 일치한다. - 함께 공개된 데모는 세 가지다. HandwiredOS는 학습 없이 연산 4,646개만으로 창 세 개짜리 데스크톱 UI를 구동하고, Learned Gallery는 일부 가중치만 학습 대상으로 삼아 초당 600스텝의 역전파로 사진 정렬을 실시간 학습한다. JSON Search는 불리언 상태 전이를 32비트 정수로 묶어, WebGPU에서 JSON 문서 10만 개의 정규식 검색을 5.2ms 만에 처리한다.
일반 코드를 학습 없는 신경망 회로로 바꾸는 방식
통상적인 딥러닝에서는 대량의 데이터를 주입해 경사하강법으로 가중치를 찾고, 학습이 끝난 뒤에도 각 가중치의 역할을 역추적하기 어렵다. 이와 달리 Handwired에서는 개발자가 작성한 코드가 곧바로 신경망의 가중치와 연결 구조를 결정한다. 개발자가 의도한 로직을 일반 타입스크립트나 자바스크립트로 작성하면, 라이브러리가 그 로직을 가중치 합과 활성화 함수로 이루어진 고정된 신경망 회로(Circuit)로 조립한다. 이렇게 조립한 회로는 학습 과정을 전혀 거치지 않아도 첫 실행부터 원래 코드와 비트 단위로 똑같은 결과를 내놓는다. 또 모든 연산이 미분 가능하므로, 필요한 부분의 가중치만 골라 학습시킬 수도 있다.1
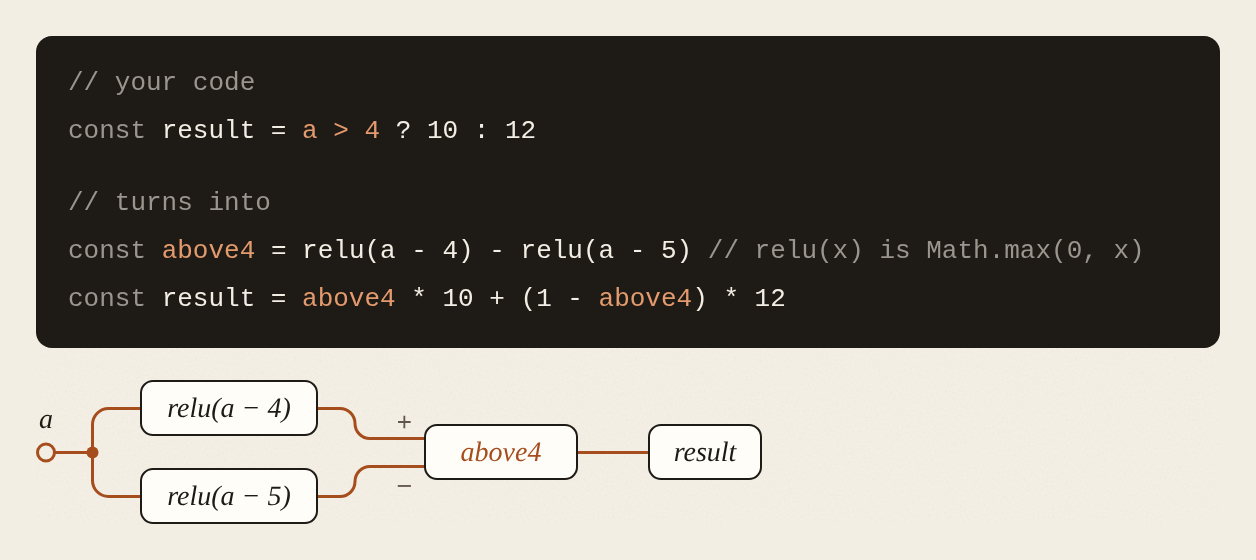
단순한 예로 삼항 연산자 const result = a > 4 ? 10 : 12를 보자. 정수 입력 a에 ReLU 함수(relu(x) = Math.max(0, x)) 두 개를 조합하면, 비교와 분기가 산술식 두 줄로 바뀐다.
 출처: Handwired 데모 사이트
첫째 식 above4 = relu(a - 4) - relu(a - 5)는 비교 조건을 0 또는 1로 바꾼다. 정수 a가 4 이하일 때는 relu(a - 4)와 relu(a - 5)가 모두 0이므로 above4는 0이 된다. a가 5 이상일 때는 두 값의 차이가 항상 1이므로 above4는 1이 된다. 둘째 식 above4 * 10 + (1 - above4) * 12는 두 분기의 값(10과 12)을 모두 계산한 뒤 above4를 가중치로 삼아 곱해 하나만 선택한다.
Handwired가 생성하는 모든 회로는 1차원 32비트 부동소수점 배열(Float32Array) 하나를 메모리로 사용한다. 배열 앞쪽 인덱스에는 입력값, 상수, 영속 상태(SourceTable)를 배정하고, 이어지는 인덱스에는 회로가 순서대로 계산하는 연산 노드(wire)를 배치한다. 회로를 이루는 기본 명령(instruction)은 아래 네 가지로 고정되어 있다.
| 명령 | 수식 (f는 Math.fround) | 주된 용도 |
|---|---|---|
affine | $f(b + \sum_i f(c_i \times w_i))$ | 가중치 합, 덧셈과 뺄셈, 불리언 부정(1 - x) |
reglu | $f(\text{left} \times \max(0, \text{gate}))$ | 비선형 활성화(left = 1이면 ReLU), 조건 곱셈 |
boolean | $f(f(f(s) + 8388609) - 8388609)$ | 0~1 사이 값을 FP32 가수부 반올림으로 0과 1로 확정 |
index | $\text{values}[\text{cand}[\lfloor\text{form}\rfloor]]$ | 후보 테이블에서 정수 인덱스로 값 1개 즉시 조회 |
네 명령 중 부동소수점 규격을 직접 이용한 명령이 boolean이다. 이 명령은 IEEE 754 단정밀도 부동소수점(FP32)의 가수부(mantissa)가 정확히 23비트라는 성질을 이용하며, 수식의 상수 8,388,609도 $2^{23} + 1$에서 나왔다. 0과 1 사이의 값에 $2^{23} + 1$을 더하면 마지막 유효 비트에서 짝수 반올림(round-to-nearest-even)이 일어나, 0.5 미만은 0으로, 0.5 이상은 1로 확정된다. 여기서 다시 $2^{23} + 1$을 빼면 정확히 0 또는 1만 남는다.2
값의 성질을 선언해 회로를 줄이는 원리
일반 프로그램은 if 문을 만나면 선택되지 않은 분기를 건너뛰지만, 산술 회로는 매 프레임 모든 연산 노드를 처음부터 끝까지 실행한다. 이 때문에 조건 비교나 배열 조회를 그대로 부동소수점 연산으로 풀면 연산 수와 회로 깊이(layer)가 크게 늘어난다. Handwired는 입력 셀이나 중간 노드에 값의 성질을 약속하는 선언을 추가해 회로 크기를 줄인다. 선언은 assumeRange, assumeGrid, assumeOneHot, assumeBit 네 가지다.3
선언이 있을 때와 없을 때의 격차는 대소 비교 함수 emitCompare(circuit, a, b)에서 뚜렷하게 확인된다. 임의의 32비트 부동소수점 수 두 개를 비교하려면 두 수의 차이가 $2^{-149}$(FP32 최소 양수 서브노멀)만큼 작을 때도 부호를 판별해야 한다. 격자 선언이 없으면 Handwired는 부호 증폭 연쇄 회로(sign cascade)를 조립한다. 차이에 2의 거듭제곱 배율을 거듭 곱한 뒤 [-1, 1] 구간으로 잘라 내는 회로다. 0에서 16,384 사이의 두 수를 이 방식으로 비교하면 연산 15개와 층 14개를 거쳐야 한다.
반면 마우스 포인터 좌표처럼 두 입력이 모두 2의 거듭제곱 간격의 격자를 따르는 경우가 있다(assumeGrid, 예를 들어 1/64픽셀 간격). 이때 두 값의 차이가 격자 $2^{24}$칸 이내라면, 차이 $D = (a - b) / \text{grid}$는 항상 정수가 된다. $D$가 정수이므로 $a \ge b$이면 $D \ge 0$이고, $a < b$이면 $D \le -1$이다. 따라서 다음 식 하나로 비교가 끝난다.
이 정수 비트 경로는 연산 2개와 층 2개로 완성된다. 변수 두 개에 assumeGrid를 선언하면 부호 증폭 연쇄 회로(연산 15개, 층 14개)를 생략할 수 있다.
원핫(one-hot) 그룹 선언(assumeOneHot)도 같은 원리로 회로를 압축한다. 여러 후보 값 가운데 현재 선택된 탭이나 창 하나의 값을 고를 때, 기본 산술식은 각 후보에 선택 비트를 곱해 더하는 마스크 합산이다($\sum_j \text{selected}_j \times \text{candidate}_j$). 후보가 $N$개라면 곱셈(reglu) $N$개와 덧셈(affine) 1개를 실행해야 한다. 그러나 선택 비트가 oneHot 그룹으로 선언되어 있고 후보 값이 모두 유한한 부동소수점 수이면, 컴파일러(compile.ts)가 이 합산 패턴을 인식해 index 조회 명령 하나로 치환한다. 후보가 10개든 1,000개든 연산은 하나다.
반복문과 스프링 물리를 고정 깊이로 바꾸는 다섯 가지 패턴
산술 회로는 실행 도중에 조건을 확인해 루프를 일찍 끝낼 수도(break), 런타임에 정해지는 횟수만큼 반복할 수도 없다. 저장소의 docs/patterns.md 문서에는 일반 자바스크립트의 다섯 가지 반복문 패턴을 고정된 층 수의 산술 회로로 바꾸는 해법이 정리되어 있다.
| 원래 JS 반복문 패턴 | Handwired 회로 변환 방식 | 회로 깊이 |
|---|---|---|
단조 조건 findIndex (1, ..., 1, 0, 0) | 참인 비트들의 총합이 첫 거짓 원소의 인덱스(affine 1개) | 3개 층 |
비단조 조건 findIndex / argmax | 이진 균형 트리로 토너먼트 비교(emitFirstActive, emitArgmax) | $O(\log n)$ 층 |
| 누적 합계와 1패스 상태 기계 | Sklansky 또는 Brent-Kung 병렬 접두사 네트워크 | $O(\log n)$ 층 |
| 최장 일치 정규식 매칭 | 역방향 패스(끝점) + 정방향 패스(시작점 확정) 2패스 오토마타 | 입력 길이에 비례 |
| 가변 횟수 선형 루프 (4ms 스프링 물리) | 호스트가 $2 \times 2$ 전이 행렬 거듭제곱 $M^{\text{steps}}$ 계산 후 행렬 곱 1회 | 3개 층 (연산 14개) |
다섯 패턴 가운데 특히 정교한 것은 스프링 애니메이션 처리(emitApplySpringMatrix)다. 스프링은 프레임 사이에 경과한 시간에 따라 4ms짜리 물리 스텝을 반복하는 횟수가 달라진다. 스프링의 변위와 속도 $(x, v)$를 한 스텝 전진시키는 식은 선형 변환이므로 $2 \times 2$ 행렬 $M$ 하나로 표현된다. 호스트 타이밍 모듈(host-timing.ts)은 매 프레임 회로를 실행하기 전에 행렬 거듭제곱 $M^{\text{steps}}$의 네 성분(m00, m01, m10, m11)을 미리 계산해 입력 셀에 기록한다. 그러면 프레임 사이에 5스텝이 지났든 200스텝이 지났든, 회로는 reglu 4개와 affine으로 이루어진 행렬-벡터 곱셈 한 번(연산 14개, 층 3개)으로 물리 계산을 마친다.
아울러 docs/behavior-choices.md는 주사율이 서로 다른 모니터(10fps, 30fps, 60fps, 120fps)에서도 시뮬레이션 결과가 비트 단위로 일치하도록 세 가지 규칙을 둔다.
- 이벤트 시각까지 먼저 전진: 포인터 클릭이나 이동 이벤트가 들어오면, 현재 프레임 시각으로 바로 건너뛰지 않고 그 이벤트가 발생한 타임스탬프까지 먼저 스프링을 전진시킨 뒤 이벤트를 적용한다.
- 64ms 고정 간격 정착 검사: 정착(settle) 검사는 스프링이 목표치에 충분히 가까워지면 목표 좌표로 고정하는 검사다. 이 검사를 매 프레임 실행하면 주사율마다 정착 시점이 달라진다. Handwired는 정착 검사를 시뮬레이션 시간으로 64ms(16스텝)의 배수가 되는 시각에만 수행한다.
- 목표 사각형 기준 클릭 판정과 변위 저장: 스프링이 이동하는 도중에 사용자가 창이나 버튼을 클릭하면, 화면에 그려진 순간 위치가 아닌 스프링이 향하는 목표 사각형(destination rectangle)을 기준으로 클릭 여부를 판정한다. 덕분에 움직이는 토스트 알림이나 창을 잘못 누르는 문제가 사라진다. 또 클릭 판정 회로가 스프링 출력에 의존하지 않으므로, HandwiredOS에서는 연산 170개와 층 29개를 절약한다. 스프링의 상태 셀에는 절대 좌표를 기록하지 않고 목표 지점과의 차이(변위)만 저장한다. 이렇게 하면 원점에서 131,072px 떨어진 좌표에서도, 64비트 부동소수점으로 계산한 값과의 오차가 0.00014px 이내로 유지된다.
세 가지 실행 환경을 검증하는 데모
저장소의 src/ 디렉터리에는 데모 세 개가 있다. 같은 회로 표현(Circuit)을 서로 다른 세 실행 환경에서 검증한 결과물이다.
1. HandwiredOS
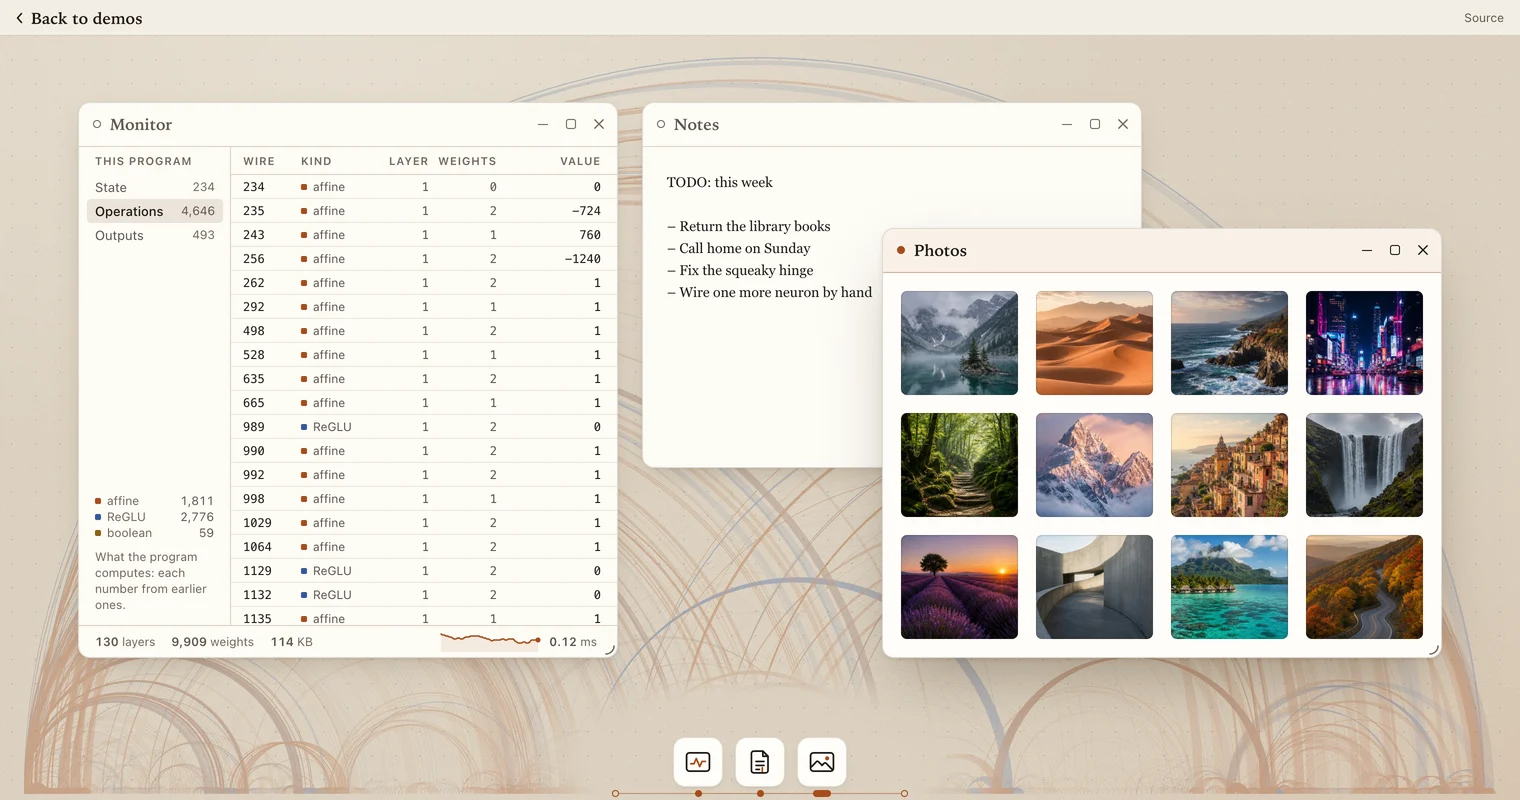
표지 그림의 HandwiredOS(src/handwiredos/)는 Monitor, Notes, Photos 창 세 개와 화면 아래쪽 아이콘 독(dock)으로 이루어진 데스크톱 환경이다. 창 드래그, 크기 조절과 조절 테두리 감지, 창 순서(z-order) 변경, 최소화와 최대화 스프링 애니메이션, 사진 그리드 배치와 라이트박스 줌까지 모두 학습 없이 컴파일한 단일 수치 회로가 계산한다.
| 항목 | 수치와 구성 | 비고 |
|---|---|---|
| 회로 규모 | 소스 셀 234개, 활성 연산 4,646개(130층), 가중치 9,909개(114KB) | affine 1,811개, reglu 2,776개, boolean 59개 |
| 1회 평가 시간 | Bun(CPU) 25~36µs, Chrome 120~140µs | 60fps 프레임 예산(16.6ms)의 1% 미만 |
Monitor와 Notes | Monitor는 64개 가상 DOM 슬롯, Notes는 <textarea> 위임 | 텍스트 줄바꿈을 회로에 넣으면 연산 15,600개 추가 |
10월 13일 실험에서는 Notes 창의 텍스트 줄바꿈과 커서 이동까지 회로로 구현해 보았다. 그러자 연산 15,600개와 가중치 34,221개가 추가되었는데, 데스크톱의 나머지 전체를 합친 것의 세 배가 넘는 규모였다. 이에 따라 텍스트 편집은 브라우저에 맡기고, 회로는 창의 위치와 크기만 계산하도록 역할을 분리했다.
2. Learned Gallery
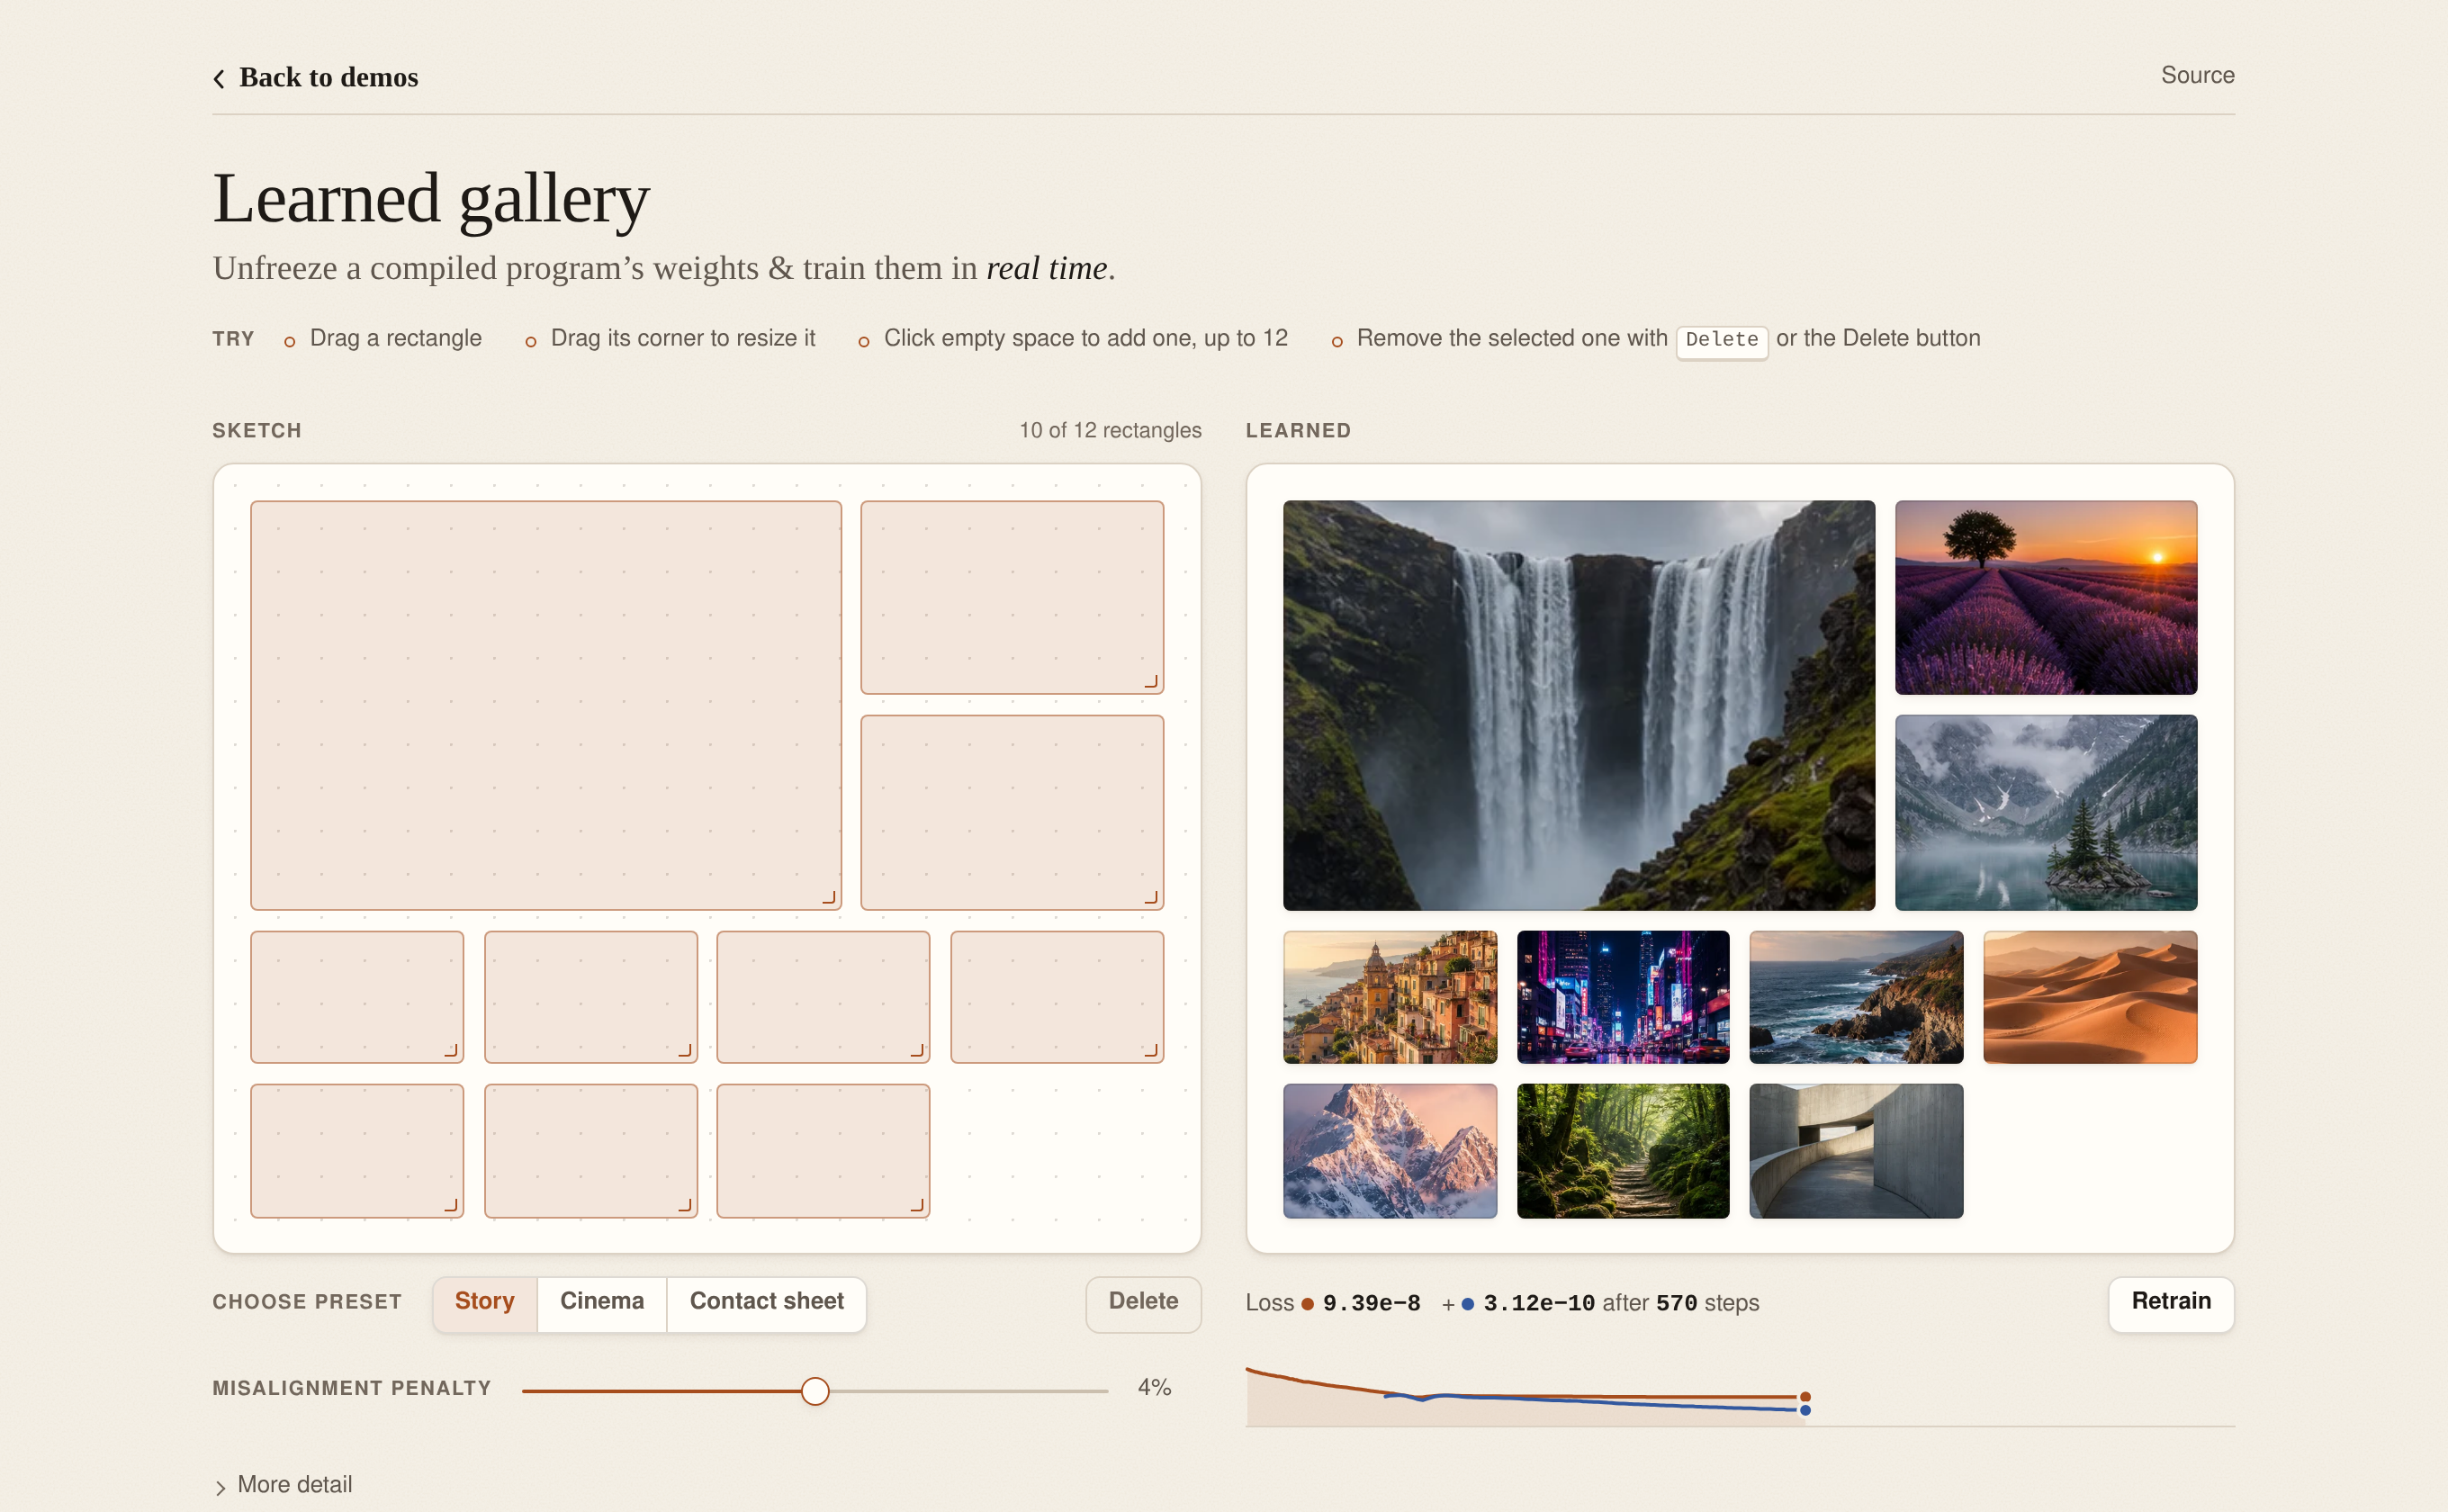
두 번째 데모인 Learned Gallery(src/learned-gallery/)는 코드를 산술 회로로 바꿨을 때 얻는 이점, 곧 미분 가능성을 활용한다. 화면 구성과 조작 로직은 일반 코드처럼 작성한다. 사진 최대 12장의 목표 위치와 크기를 결정하는 부분만 2층 ReGLU 신경망에 맡기고, 이 신경망을 브라우저에서 실시간으로 학습시킨다. 신경망의 규모는 학습 가능한 소스 셀 244개, 전체 연산 6,320개, 층 8개다.
 출처: Handwired 데모 사이트
사용자가 왼쪽 SKETCH 캔버스에서 상자들을 마우스로 끌어다 놓으면, 학습 루프가 애니메이션 프레임마다 10스텝씩(초당 600스텝) circuit.backpropagateReference와 Adam 옵티마이저를 실행해 가중치 244개를 갱신한다. 1스텝 역전파와 가중치 갱신에 걸리는 시간은 Bun에서 약 0.2ms, Chrome에서 0.34~0.41ms다.
정렬 품질을 좌우하는 요소는 손실 함수(loss function)의 두 항이다. 사용자 스케치 좌표와의 오차(Huber 손실)만 줄이면 신경망은 사용자가 비뚤게 놓은 상자 배치를 그대로 복제한다. Handwired는 여기에 정렬 불일치 벌점(misalignment penalty)을 추가했다. 이 벌점은 사진들의 가로와 세로 가장자리 좌표 쌍을 비교해 값이 비슷한 가장자리끼리 일치하도록 유도한다. 또 라그랑주 승수법(method of multipliers)으로 학습 후반으로 갈수록 정렬 벌점의 비중을 높인다.4 덕분에 사용자가 상자를 대략적인 위치에 놓기만 해도 이웃한 사진 가장자리들이 0.01~0.16px 오차 이내로 정렬된다.
3. JSON Search
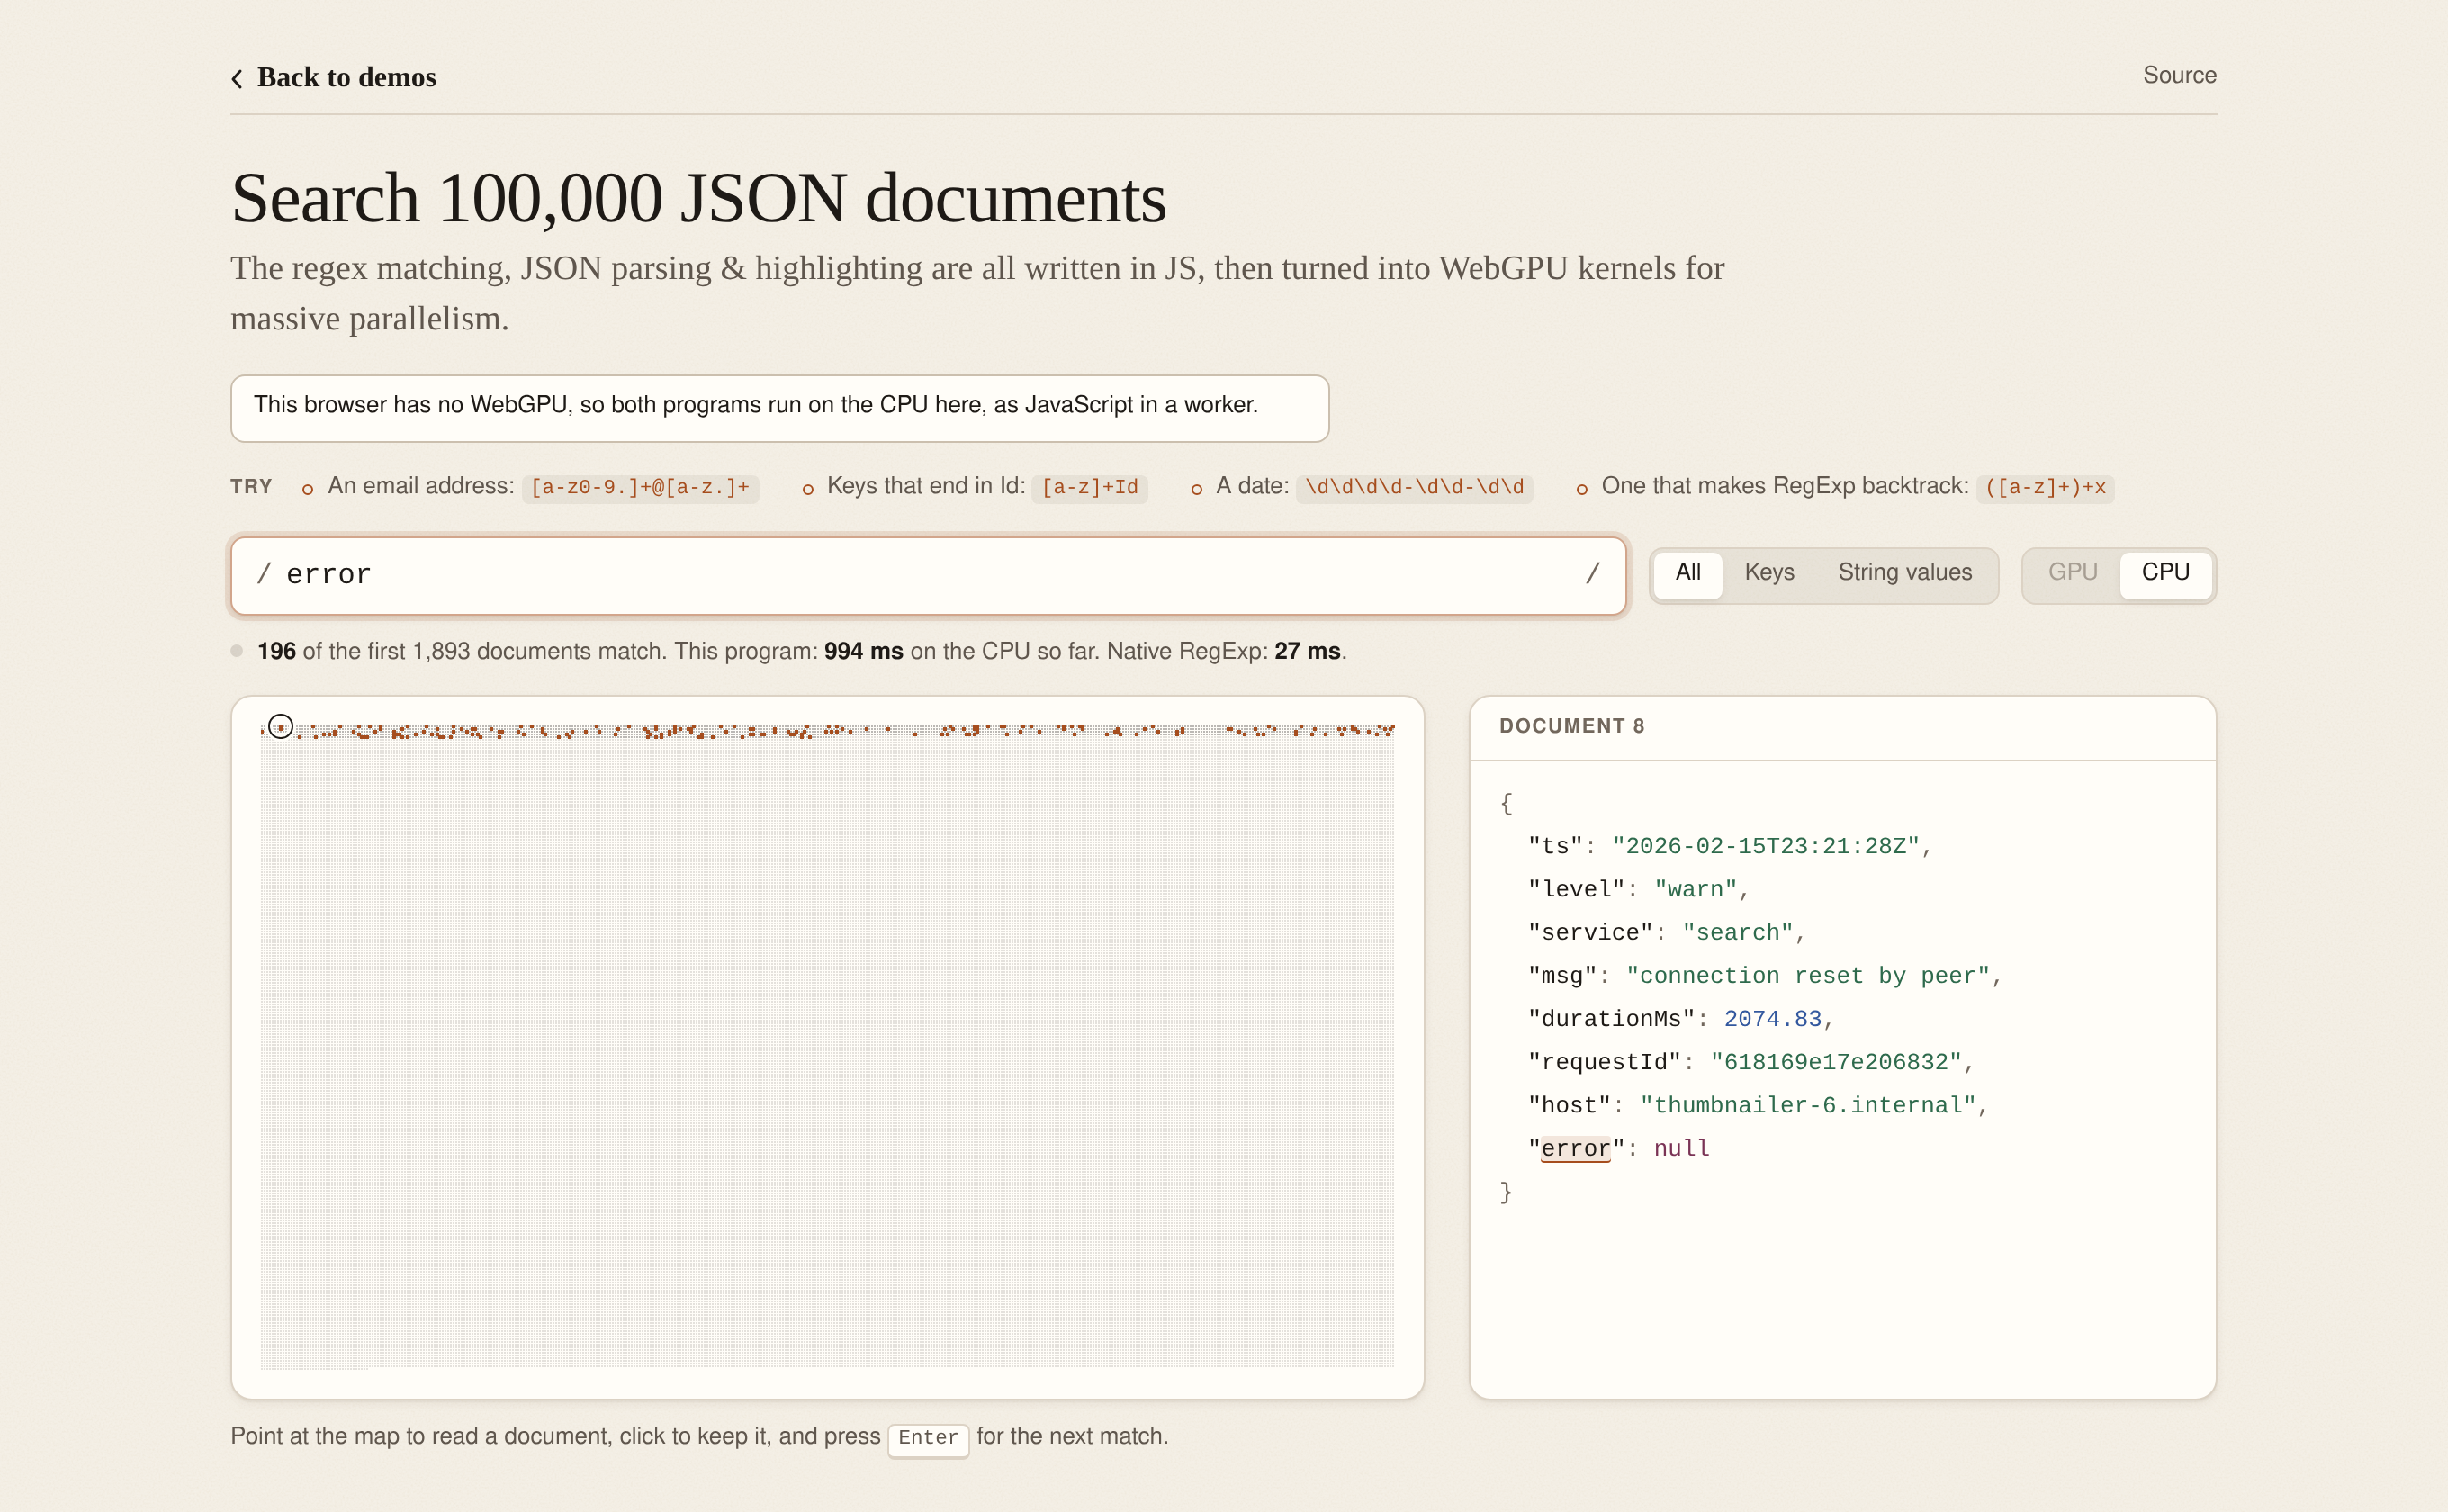
세 번째 데모인 JSON Search(src/json-search/)는 Handwired 회로를 WebGPU 컴퓨트 셰이더(WGSL)로 컴파일한다. 512자 이하의 JSON 문서 10만 개(GPU 메모리 205.2MB)를 키를 누를 때마다 실시간으로 구문 강조하고 정규식으로 검색한다.
 출처: Handwired 데모 사이트
정규식 검색기는 톰슨(Thompson)과 글루시코프(Glushkov) 방식의 비결정적 유한 오토마타(NFA)를 역방향으로 한 번, 정방향으로 한 번 실행해 최장 일치 구간을 찾는다. 이 오토마타 회로를 단순한 부동소수점 셰이더(loop-emit.ts)로 그대로 옮기면, 상태가 32개일 때 문자 하나를 처리할 때마다 WGSL 문장 4,655개를 실행해야 한다. 문서 10만 개를 검색하는 데는 945ms가 걸린다.
반면 bit-emit.ts 컴파일러는 회로의 선언을 분석해 0과 1만 가지는 불리언 연산을 찾아낸다. 그리고 상태 32개의 전이를 부호 없는 32비트 정수(u32) 하나를 다루는 비트 AND 연산과 바이트 룩업 테이블 조회로 묶는다. 이 방식을 비트 패킹(bit-packing)이라 한다.
| 실행 경로 | 32상태 루프 크기 | 10만 문서 검색 (연속 / 대기 후) | 역추적 패턴 |
|---|---|---|---|
| 기본 WGSL | 문장 4,655개 | 945ms | 역추적 없음 |
| 비트 패킹 WGSL | 문장 219개 | 5.2ms / 13.2ms | 5~12ms (선형 시간) |
단일 스레드 JS RegExp | 해당 없음 | 복합 패턴 9~56ms | 2.1초 멈춤 |
CPU 워커 8개 JS RegExp | 해당 없음 | 2~7ms | 워커 스레드 멈춤 |
bit-emit.ts로 컴파일한 32상태 셰이더는 루프 본문이 문장 4,655개에서 219개로 축소된다. 문서 10만 개 전체를 검색하는 시간은 연속 실행할 때 945ms에서 5.2ms로, 약 180배 단축된다. 키 입력 사이에 쉬었다가 처음 실행할 때도 13.2ms다. 오토마타 회로는 입력 문자 하나당 항상 같은 횟수의 연산만 실행하므로, 일반 정규식 엔진(RegExp)이 2.1초 동안 멈추는 재앙적 역추적(catastrophic backtracking) 패턴 ([a-z]+)+x도 5~12ms 만에 끝낸다. 저장소의 벤치마크 문서(src/json-search/README.md)는 CPU 워커 8개로 병렬화한 네이티브 RegExp도 함께 측정했는데, 역추적이 없는 일반 패턴에서는 2~7ms로 동작해 WebGPU와 대등한 성능을 낸다.
가장 흥미로운 지점
이번 코드베이스에서 유독 새로웠던 발상은 값의 범위와 격자 선언을 신경망과 GPU 셰이더의 컴파일러 최적화 힌트로 삼는 방식이다. 기존 딥러닝 프레임워크는 텐서의 모양(shape)과 자료형(dtype)으로 메모리 배치만 정하며, 원소 값이 1/64 격자 단위를 따르는지나 후보 여럿 중 하나만 1인 원핫 조건을 만족하는지는 컴파일 단계에서 알지 못한다. Handwired는 빌더 코드에 assumeGrid, assumeOneHot, assumeBit를 명시하게 한다. 그리고 이 선언을 근거로 같은 산술 그래프를 2층짜리 정수 비트 비교로 줄이거나, 후보 합산을 단일 index 조회로 바꾸거나, 32개 불리언 상태 전이를 32비트 정수 비트마스크 연산 하나로 묶는다.
무엇을 회로로 구현하고 무엇을 브라우저에 맡길지, 연산 수와 가중치 수를 일일이 계측해 정한 기록도 인상적이다. 기능마다 추가되는 연산 수와 얻는 정확도를 먼저 비교한 뒤, 산술 회로로 얻을 이점이 적은 기능은 과감히 브라우저 기본 요소에 위임했다. 어떤 계산을 산술 회로로 처리해야 실익이 있는지, 채택하지 않은 실험까지 포함한 실측 수치가 구체적인 판단 기준이 된다.
출처
- 저자: Cheng Lou (
@chenglou) - 공개 시점: 2026년 10월 (MIT 라이선스)
- 원문 저장소: https://github.com/chenglou/handwired
- 라이브 데모: https://chenglou.me/handwired/
- 치비 삽화 두 장은 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
Handwired는 임의의 기존 자바스크립트 소스 파일을 자동으로 구문 분석해 신경망으로 바꿔 주는 범용 파서를 제공하지 않는다. 개발자는
Circuit과SourceTable이 제공하는 헬퍼 함수를 호출하는 빌더 코드를 작성한다. 이 빌더 함수가 한 번 실행되면서 회로에 연산 노드를 차례대로 추가한다. ↩︎CPU와 GPU, WebAssembly가 모두 IEEE 754 단정밀도 반올림 규칙을 따르므로
Math.fround를 매 단계에 적용하면 실행 환경이 달라져도 연산 결과가 비트 단위로 일치한다. ↩︎이 선언들은 런타임과 테스트에서 실제로 검증하는 계약이다. 약속한 범위나 격자 단위에 맞지 않는 입력이 주어지면 검증기가 즉시 예외를 발생시킨다. ↩︎
학습 도중 손실이 발산하는 현상을 막으려고
trainOrUndo라는 역추적(backtracking) 기법도 함께 적용한다. 매 스텝 가중치를 갱신한 뒤 손실이 이전 스텝보다 커지면 가중치와 Adam 모멘트를 직전 상태로 되돌리고 학습률을 절반으로 줄여 다시 시도한다. ↩︎