3줄 요약
- 독일 막스플랑크 소프트웨어시스템 연구소와 막스플랑크 보안 및 프라이버시 연구소, 보훔 루르 대학교, 네덜란드 델프트 공과대학교, 인도공과대학교 카라그푸르(IIT Kharagpur) 공동 연구진이 실제 ChatGPT 사용자 80명의 대화 기록을 분석했다. 기록은 유럽연합 일반 개인정보 보호법(GDPR)의 데이터 열람권으로 수집했고, 연구진은 여기서 메모리 항목 2,050건을 추출했다.
- 분석해 보니 메모리의 95.9%는 사용자가 요청하지 않았는데도 ChatGPT가 스스로 생성한 것이었다. 전체 메모리의 28%에는 GDPR이 정의하는 개인정보가, 52%에는 욕망과 의도 같은 심리 상태 정보가 기록되어 있었다.
- 메모리 어휘의 평균 84%가 실제 사용자 발화에 그대로 등장할 만큼, 메모리는 원문을 충실히 반영했다. 연구진은 해법으로 프롬프트 재작성 도구 ‘Attribution Shield’를 제시했다. 질문의 의도와 답변 품질은 유지하고, 질문 내용을 사용자 본인의 일로 특정하는 표현만 지우는 도구다.
알고리즘 자화상과 연구 배경
ChatGPT, Gemini, Claude 같은 대화형 AI 서비스는 ‘메모리(Memory)’ 기능을 도입했다. 세션이 끝난 뒤에도 대화 맥락을 보존했다가 다음 대화에 활용하는 기능이다. 작동 방식은 두 가지다. 하나는 사용자가 기억해 달라고 직접 지시하는 명시적(explicit) 방식이고, 다른 하나는 모델이 앞으로 쓸모 있겠다고 판단한 정보를 대화 도중 스스로 추론해 저장하는 암묵적(implicit) 방식이다.
연구진은 대화형 AI의 메모리가 만드는 개인화 프로파일을 ‘알고리즘 자화상(Algorithmic Self-Portrait)’이라고 부른다. 사용자가 사적인 대화에서 스스로 털어놓은 정보(self-disclosed information)가 원재료가 되지만, 그중 무엇을 남기고 어떻게 요약할지는 시스템 알고리즘이 결정하기 때문이다. 기존 웹 플랫폼은 클릭, 조회, 좋아요 같은 행동 로그로 관심사를 추정해 광고 타기팅에 썼다. 대화형 AI는 대화에 직접 참여하면서 사용자의 내밀한 발화를 수집한다.
메모리가 어떤 기준으로 생성되고 얼마나 민감한 정보를 기록하는지는 시스템 외부에서 확인하기 어렵다. 연구진은 연구 질문(RQ) 네 가지를 세우고 실제 데이터로 답을 찾았다.
- RQ1 (주도권): 메모리 갱신을 주로 주도하는 것은 AI 시스템인가, 사용자인가?
- RQ2 (저장 내용): AI 시스템은 사용자에 관한 어떤 정보를 메모리로 저장하는가?
- RQ3 (충실도): AI 메모리는 실제 사용자 대화를 얼마나 충실하게 반영하는가?
- RQ4 (역공학과 방어): 메모리 추론 과정을 역공학해 개인 귀속과 프라이버시 위험을 줄일 수 있는가?
데이터셋과 메모리 추출 방법
플랫폼 내부에 저장된 개인화 데이터를 외부 연구자가 확보하기는 쉽지 않다. 연구진은 이를 해결하려고 GDPR 제15조 3항의 ‘정보주체의 열람권(right of access)’을 활용한 데이터 기부 방식을 택했다.1 크라우드소싱 플랫폼 프롤리픽(Prolific)에서 90일 이상 활동하며 100회 이상 대화한 ChatGPT 정기 사용자를 모집했다. 참가자들은 OpenAI에서 자기 대화 이력을 직접 내려받아 기부했고, 연구진은 이렇게 수집한 데이터셋(InVivoGPT)에서 80명의 기록을 분석했다. 참가자는 미국 거주자가 33.8%, 유럽 거주자가 62.5%였다. 남성이 72.5%, 여성이 26.2%였고, 18~34세가 66.3%였다.
| 구분 | 인원(명) | 비율(%) |
|---|---|---|
| 성별 | ||
| 남성 | 58 | 72.5 |
| 여성 | 21 | 26.2 |
| 응답 거부 | 1 | 1.2 |
| 연령 | ||
| 18~24세 | 19 | 23.8 |
| 25~34세 | 34 | 42.5 |
| 35~44세 | 12 | 15.0 |
| 45~64세 | 13 | 16.25 |
| 65세 이상 | 2 | 2.5 |
| 국가 | ||
| 미국 | 27 | 33.8 |
| 독일 | 14 | 17.5 |
| 이탈리아 | 14 | 17.5 |
| 프랑스 | 10 | 12.5 |
| 스페인 | 10 | 12.5 |
| 기타 | 5 | 6.2 |
ChatGPT가 내보낸 대화 로그에는 사용자의 입력과 모델의 응답뿐 아니라 모델이 호출한 내부 도구(image_gen, python, file_search 등)의 기록이 함께 들어 있다. 이 가운데 메모리 저장과 수정, 삭제를 담당하는 도구는 bio 도구다. 연구진은 먼저 bio 도구 메시지 가운데 model set context updated라는 문구가 포함된 기록을 모두 찾았다. 그다음 부모 메시지 식별자(parent attribute)를 역추적해, 그 도구를 호출한 GPT 메시지와 직전에 메모리 갱신을 유발한 사용자 발화를 짝지었다.
이 과정을 거쳐 전체 80명 가운데 참가자 65명의 기록에서 대화 1,058개(질문-응답 22,971턴)와 메모리 항목 2,050건을 추출했다. 나머지 15명의 기록에서는 메모리 갱신 이력이 발견되지 않았다.
누가 메모리를 만들고 무엇을 기록하는가
시스템이 주도하는 일방적 메모리 생성
OpenAI의 공식 도움말 문서는 메모리를 사용자가 기억해 달라고 직접 지시한 세부 사항이라고 설명한다. 그러면서도 앞으로의 대화에 유용할 만한 정보를 공유하면 요청이 없어도 시스템이 알아서 메모리에 저장할 수 있다고 안내한다. 예를 들어 사용자가 대화 중에 “나는 워라밸을 선호해(I prefer work life balance)”라고만 말해도, ChatGPT는 “사용자는 워라밸을 선호함”이라는 메모리를 자동으로 추가한다.
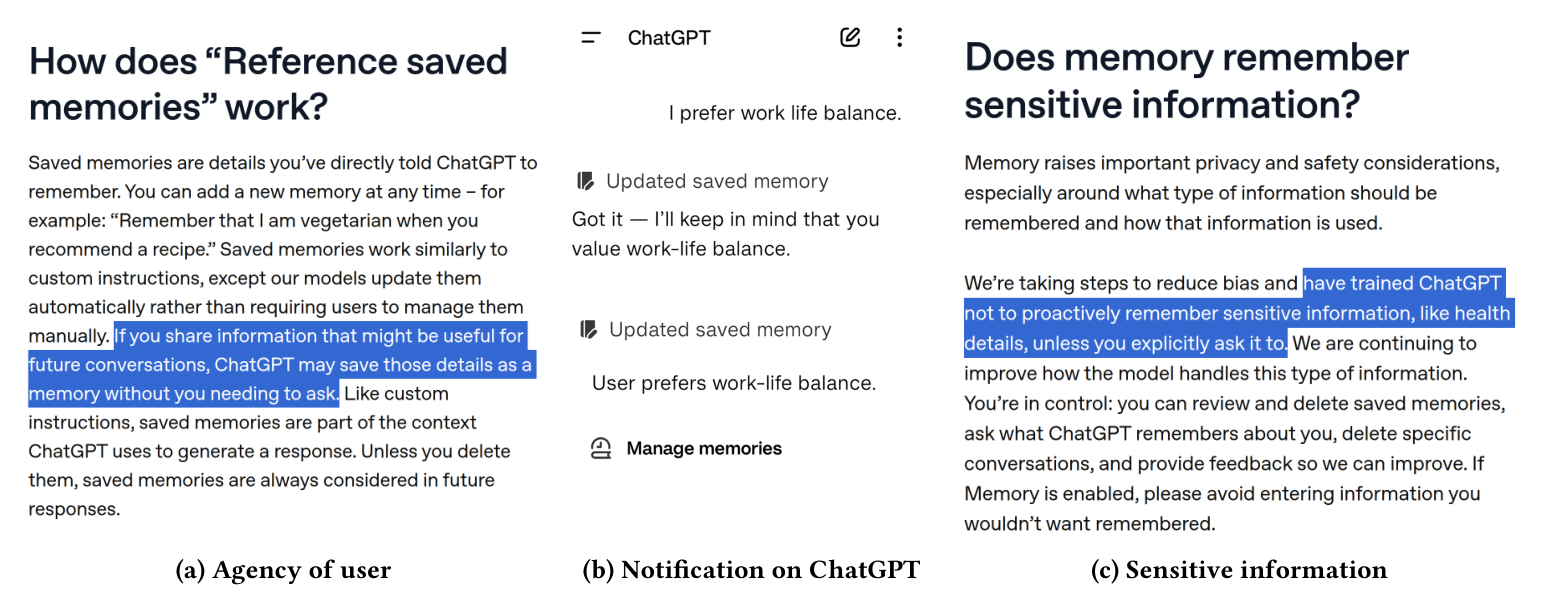 (a) 요청 없이도 유용한 세부 정보를 저장할 수 있다고 명시한 OpenAI FAQ, (b) 사용자의 명시적 요청 없이 메모리를 갱신한 실제 앱 화면, (c) 민감 정보를 능동적으로 기억하지 않도록 학습시켰다는 OpenAI FAQ 문구 (출처: arXiv:2602.01450)
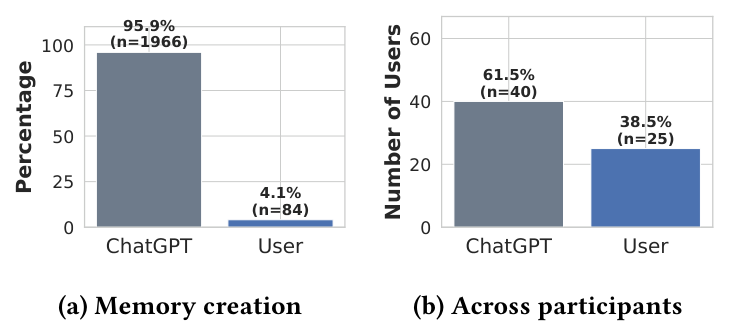
실제 대화에서 누가 메모리 생성을 주도하는지 확인하기 위해, 연구진은 메모리 갱신을 유발한 사용자 발화 2,050건에 정규식 기반 언어 패턴 분류를 적용했다. 검사한 표현은 remember, note that, store, save, add to memory, forget처럼 메모리를 다루라고 명시하는 말이다. 이런 직접 요청이 포함된 발화는 2,050건 가운데 84건, 4.1%에 불과했다. 참가자 수로 봐도 한 번이라도 메모리 갱신을 직접 요청한 사람은 메모리가 있는 참가자 65명 가운데 25명(38.5%)뿐이었다. 나머지 1,966건, 95.9%는 사용자의 지시 없이 ChatGPT가 스스로 판단해 생성한 메모리였다. 사용자는 이미 만들어진 메모리를 나중에 열람하거나 삭제할 수 있을 뿐이고, 무엇을 기억으로 남길지는 생성 단계에서 시스템이 결정했다.
정책과 어긋나는 민감 개인정보 저장
그렇다면 시스템이 일방적으로 저장한 메모리에는 어떤 정보가 들어 있을까. OpenAI는 사용자가 명시적으로 요청하지 않는 한 건강 정보나 인종, 종교 같은 민감 정보를 능동적으로 기억하지 않도록 모델을 학습시켰다고 밝히고 있다. 연구진은 이 정책이 지켜지는지 확인하려고 GPT-4o로 전체 메모리를 분류했다. 기준은 GDPR 제4조 1항이 정의하는 일반 개인정보(Personal Data)와 제9조 1항이 정의하는 민감정보(Special Category Personal Data)다.2
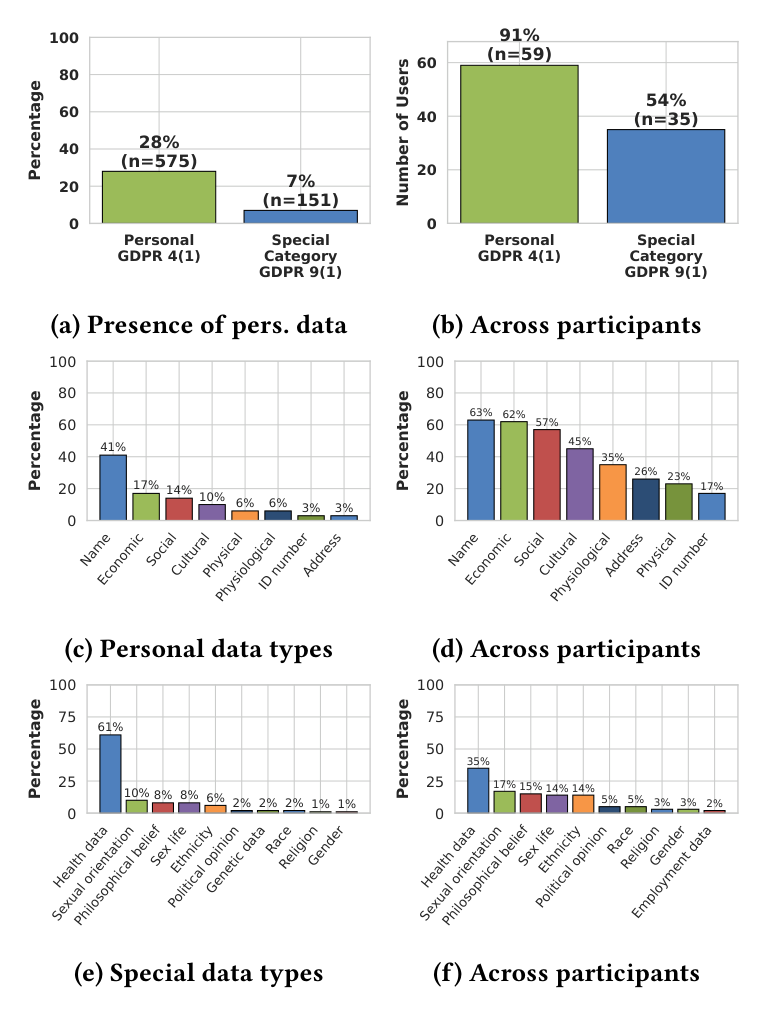 (a-b) 전체 메모리 및 참가자 기준 GDPR 개인정보와 민감정보 포함 비율, (c-d) 일반 개인정보 세부 유형 분포, (e-f) 민감정보 세부 유형 분포 (출처: arXiv:2602.01450)
분류 결과는 OpenAI의 공식 정책 설명과 달랐다. 전체 2,050건 가운데 575건(28%)에는 GDPR이 규정하는 일반 개인정보가, 151건(7%)에는 제9조 1항의 민감정보가 포함되어 있었다. 참가자 단위로 집계하면 메모리가 있는 사용자의 91%(59명)에게서 일반 개인정보가, 54%(35명)에게서 민감정보가 발견됐다.
일반 개인정보가 포함된 메모리에서 가장 흔한 항목은 이름(41%)이었다. 그다음은 경제적 정체성(17%), 사회적 정체성(14%), 문화적 정체성(10%) 순이었고, 신체적 특성과 생리적 특성이 각각 6%, 식별 번호와 주소가 각각 3%였다. 참가자 기준으로는 이름이 기록된 사용자가 63%, 경제적 정보가 62%, 사회적 정체성 정보가 57%였다.
민감정보(Special Category) 중에서는 건강 데이터가 가장 큰 비중을 차지했다. 민감정보가 포함된 메모리의 61%가 건강 관련 내용이었고, 성적 지향(10%), 철학적 신념(8%), 성생활(8%), 민족(6%), 정치적 견해, 유전 정보, 인종(각 2%), 종교, 성별(각 1%) 순이었다. 전체 참가자의 35%는 ChatGPT 메모리에 건강 상태나 질환 정보가 저장되어 있었다.
심리 상태와 마음이론 분류
ChatGPT의 메모리는 신상 명세뿐 아니라 사용자의 내면 상태도 함께 기록한다. 예컨대 “사용자 ○○○은 주요 경력 결정을 내릴 때 실패에 대한 두려움을 느낀다”라는 메모리는 이름이라는 식별자에 더해 실패에 대한 두려움이라는 내면의 주관적 상태까지 기록한다. 연구진은 이처럼 사용자가 어떻게 생각하고 느끼는지를 포착한 항목을 ‘심리적 메모리(psychological memories)’라고 불렀다. 분석에는 마음이론(Theory of Mind, ToM)의 틀을 썼다. 마음이론은 다른 사람의 정신 상태를 추론하는 인지 능력을 가리킨다.
분류에는 보두앵(Beaudoin) 등이 정립한 마음이론 범주 일곱 가지(감정, 욕망, 의도, 지각, 지식, 신념, 비문자적 의사소통의 심리적 이해)를 사용했다.3
| 마음이론(ToM) 범주 | 의미 해석 | 실제 메모리 기록 예시 |
|---|---|---|
| 감정 (Emotions) | 일시적으로 느끼는 정서 상태 | 사용자는 친구와 가족이 있음에도 때때로 외로움을 느끼며 더 많은 교감을 원하고 있다. |
| 욕망 (Desires) | 선호, 바람, 포부, 장기적 목표 | 사용자는 자신의 삶에서 의미 있는 변화를 만들고 싶다는 강한 열망을 표현했다. |
| 의도 (Intentions) | 특정 계획을 실행하려는 다짐과 의지 | 사용자는 자기 조절 능력을 개선하는 데 집중하고자 한다. |
| 지각 (Percepts) | 겪은 경험이나 감각적 인식 | 사용자는 대마초가 속도를 늦추고 일을 서두르지 않게 도와준다고 느낀다. |
| 지식 (Knowledge) | 특정 사실이나 행위에 대한 인지 여부 | 사용자는 간트 차트가 무엇인지 몰랐으며 프로젝트 관리 도구라는 점을 새로 배웠다. |
| 신념 (Belief) | 현실에 대한 관점, 자아 개념, 가치관 | 사용자는 의사를 즉시 만나기 어렵고 재정적 제약이 있어 ChatGPT의 조언과 추천에 크게 의존한다. |
| 비문자적 이해 (Mentalistic) | 어조나 비유 등 비문자적 표현의 파악 | 사용자는 자신의 머리카락이 바나나 바구니처럼 보인다고 묘사한다. |
전체 2,050건의 메모리 가운데 과반인 52%에서 최소 하나 이상의 마음이론 범주가 확인됐으며, 메모리가 있는 참가자의 97%(63명)에게 심리적 메모리가 하나 이상 있었다.
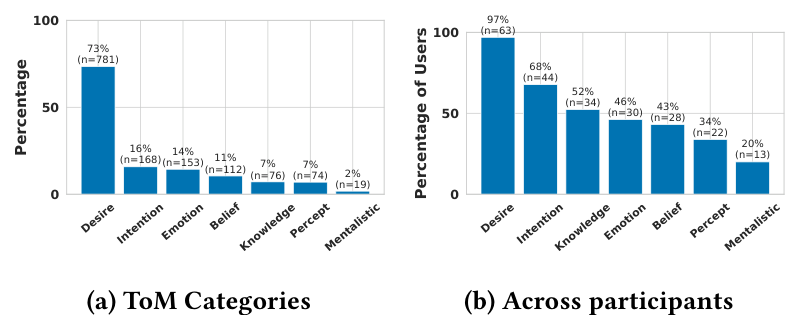 (a) 심리 정보가 포함된 메모리 중 각 ToM 범주가 차지하는 비율, (b) 해당 ToM 범주 메모리를 보유한 참가자 비율 (출처: arXiv:2602.01450)
심리적 메모리에서 가장 큰 비중을 차지한 범주는 욕망(73%, 781건)이었다. 그다음은 의도(16%, 168건), 감정(14%, 153건), 신념(11%, 112건), 지식(7%, 76건), 지각(7%, 74건), 비문자적 이해(2%, 19건) 순이었다. 한 메모리가 여러 범주에 해당할 수 있어 비율을 더하면 100%보다 크다. 참가자 기준으로는 97%(63명)에게 욕망 관련 메모리가, 68%(44명)에게 의도 관련 메모리가, 52%(34명)에게 지식 관련 메모리가 있었다.
연구진은 이 분포를 성격심리학의 시간적 안정성 개념으로 해석한다. 성격심리학은 사람의 심리 특성을 시간적 안정성에 따라 세 가지로 구분한다. 일시적인 정신 상태(감정, 지각), 평생 거의 변하지 않는 기질적 성향(dispositional traits), 그리고 안정성이 그 중간 정도인 ‘특성적 적응(characteristic adaptations)’이다. 특성적 적응은 개인의 목표와 가치에 따라 행동을 조율하는 지속적인 심리 틀이다. 기질적 성향은 ‘어떤 유형의 사람인가’를 설명하고, 특성적 적응은 ‘그 사람이 구체적으로 무엇을 추구하는가’를 설명한다.
ChatGPT가 저장한 심리적 메모리에서 특성적 적응에 해당하는 욕망과 의도는 합쳐서 약 90%였다. 일시적 상태인 감정과 지각은 20% 수준에 그쳤다. 틱톡, 인스타그램, 구글처럼 광고 수익에 의존하는 플랫폼은 사용자를 광고주용 세그먼트로 분류하면 되므로, 대략적인 관심사나 성향만 파악해도 충분하다. 반면 ChatGPT는 사용자 한 사람과 오랫동안 일관된 대화를 지속해야 한다. 연구진은 그 때문에 ChatGPT가 사용자의 목표, 계획, 신념 같은 지속적 동기 부여 속성을 우선 수집하도록 최적화되어 있다고 진단한다.
저장된 메모리는 원문에 얼마나 충실한가
시스템이 일방적으로 만든 메모리가 사용자의 말을 왜곡하거나 없는 내용을 지어내면, 잘못된 개인화로 편향을 강화하거나 사용자를 오도할 위험이 생긴다. 연구진은 저장된 메모리가 실제 사용자 발화에 얼마나 근거를 두고 있는지(provenance)를 네 가지 비교 범위에서 검증했다.
- 현재 메시지(CM, Current Message Only): 메모리 생성을 직접 유발한 가장 최근의 사용자 메시지 1건.
- 대화 맥락(CC, Conversation Context): 현재 메시지와 동일 대화의 이전 사용자 메시지 전체.
- 대화 + 로컬 메모리(CLM, Conversation + Local Memory): 현재 대화의 사용자 메시지들과 동일 대화에서 앞서 생성된 메모리들.
- 전체 사용자 이력(FUH, Full User History): 현재 대화와 로컬 메모리에 더해 해당 사용자의 과거 모든 대화에서 생성된 메모리 전체.
연구진은 네 가지 맥락마다 세 가지 지표를 측정했다. ① 구문 일치도는 메모리 토큰이 사용자 텍스트에 그대로 등장하는 비율인 정확 일치율(Exact Match Rate)과 BLEU-1 정밀도로 쟀다. ② 의미 유사도는 text-embedding-3-large 임베딩의 코사인 유사도다. ③ GPT-4o 판정은 1점 ‘근거 없음 또는 모순’부터 5점 ‘직접 언급됨’까지의 5점 척도다.4
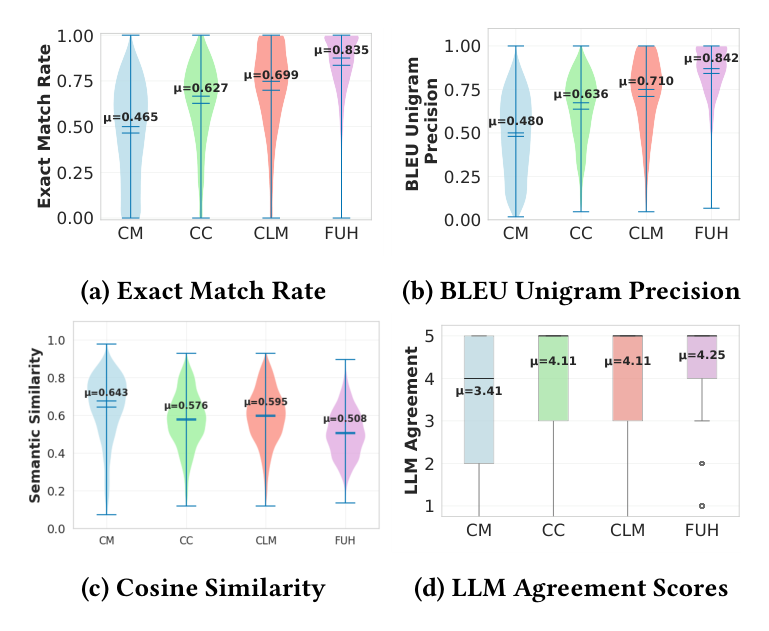 (a) 정확 일치율(Exact Match Rate), (b) BLEU 유니그램 정밀도, (c) 코사인 의미 유사도, (d) GPT-4o 기반 논리적 타당성 평가 점수 분포 (출처: arXiv:2602.01450)
전체 사용자 이력(FUH)을 기준으로 할 때 메모리 어휘의 평균 84%가 사용자 텍스트에 그대로 등장했다. 비교 범위를 CLM, CC, CM으로 한정하면 정확 일치율은 각각 70%, 63%, 47%로 낮아졌다. 직전 메시지 하나와만 비교해도 메모리 어휘의 절반 가까이가 일치한다. 과거 메모리를 맥락에 추가하면 일치율은 63%에서 84%로 크게 오른다. 기존 메모리가 새 메모리를 만드는 데 영향을 준다고 볼 수 있는 대목이다. 의미 유사도는 모든 맥락 조건에서 평균 0.508~0.643이었다.
GPT-4o를 통한 5점 척도 평가(FUH 기준 평균 4.25점)에서도 전체 메모리의 77%가 4점(요약 및 바꿔 쓰기) 또는 5점(직접 언급됨)을 받았고, 14%가 3점(논리적으로 추론됨)을 받았다. 근거가 약하다는 2점은 5%, 근거가 없다는 1점은 4%였다.
| 판정 점수 | 사용자 메시지 (CM 기준) | 생성된 메모리 |
|---|---|---|
| 1점 (근거 없음) | “제 XX 경력과 자원봉사 경험을 중심으로 이 직무의 커버레터를 작성해 주세요.” <첨부 파일 업로드됨> | “사용자의 이름은 XXX XXXX이다.” |
| 2점 (약한 근거) | “XXX의 직업을 좀 더 흥미로운 걸로 바꿔 줘. 여행 작가나 사진가는 말고 VR 관련도 빼고.” | “XXX의 직업이 지속가능한 패션 브랜드의 크리에이티브 디렉터로 변경되었다.” |
| 3점 (논리적 추론) | “‘모든 것을 알지만 누구에게도 알려지지 않은 것이 주체다’라는 쇼펜하우어의 말은 무슨 뜻이야?” | “사용자는 쇼펜하우어의 주체 개념과 인식론적 함의를 탐구하고 있다.” |
| 4점 (요약 및 바꿔 쓰기) | “XX 직무 면접을 준비 중인데 면접관에게 마지막에 할 질문을 준비해야 해. 도와줄 수 있어?” | “사용자는 XX 직무 면접을 준비하고 있다.” |
| 5점 (직접 언급) | “이 모델에서 상원이 하원을 해산할 수 있는 권한은 이미 되돌려 놓았어.” | “사용자는 자신의 모델에서 상원이 하원을 해산하는 권한을 되돌렸다.” |
낮은 점수를 받은 사례들을 수동으로 확인해 보니 두 가지 원인이 드러났다. 첫째는 사용자가 이력서 같은 파일을 첨부했을 때 ChatGPT가 파일 본문에서 이름이나 경력을 뽑아 메모리에 저장한 경우다. 평가 모델에는 대화 텍스트만 전달되고 첨부 파일 원문은 제공되지 않았기 때문에 1점(근거 없음)으로 분류됐다. 둘째는 ChatGPT가 사용자가 말하지 않은 의도까지 추론한 경우, 곧 과잉 추론(extrapolation)이다. 예를 들어 “하루 종일 에너지를 내기 위한 저렴한 식단을 추천해 줘”라는 질문에서 ChatGPT는 “식단 조절로 에너지 수준을 높이고 싶어 함”이라고 기록했다(3점). “너바나(Nirvana) 같은 밴드를 추천해 줘”라는 질문 하나로 “사용자는 너바나를 좋아함”이라고 저장한 사례도 있다. 예시로 든 밴드를 좋아한다고 단정한 것이라 2점을 받았다.
메모리 추출 역공학과 Attribution Shield
오픈웨이트 모델을 이용한 메모리 추출기 모사
OpenAI는 민감정보를 능동적으로 저장하지 않는다고 안내하지만 실제 동작은 달랐다. 연구진은 이 괴리를 확인한 뒤, 사용자에게 어떤 민감 메모리가 뽑힐지 미리 경고하고 질문을 안전하게 고쳐 주는 방어 체계인 ‘Attribution Shield’를 설계했다.
이를 위해 먼저 실험 데이터셋을 구축했다. 전체 사용자 쿼리 22,971개 가운데 민감 데이터가 없는 쿼리를 제외한 14,834개다. 메모리를 유발한 원본 쿼리 2,050건과, GPT-4o가 개인정보를 식별해 일반 질문으로 재작성한 쿼리 12,784건으로 구성된다. 모델로는 오픈웨이트 LLM 세 가지, Qwen2.5-32B-it, Gemma3-27B-it, GPT-OSS-20B를 썼다. 새 사용자가 생길 때마다 모델을 다시 학습시키는 것은 현실적이지 않다. 이 때문에 무작위로 고른 사용자 5명의 데이터만 학습에 썼다. 파인튜닝(FT)에는 학습 샘플 약 87개를, 인컨텍스트 러닝(ICL)에는 사용자당 2개씩 모두 10개의 예시를 썼고, 성능은 전체 테스트셋(약 13,600개 쿼리)에서 평가했다.
| 모델 | 방식 | 메모리 예측 BLEU Recall | 메모리 예측 ROUGE Recall | 메모리 예측 의미 유사도 | 재작성 쿼리 BLEU Recall | 재작성 쿼리 ROUGE Recall | 재작성 쿼리 의미 유사도 |
|---|---|---|---|---|---|---|---|
| Qwen2.5-32B-it | ICL | 0.41 | 0.35 | 0.68 | 0.16 | 0.13 | 0.55 |
| Qwen2.5-32B-it | FT | 0.43 | 0.39 | 0.70 | 0.09 | 0.08 | 0.42 |
| Gemma3-27B-it | ICL | 0.39 | 0.32 | 0.62 | 0.21 | 0.17 | 0.46 |
| Gemma3-27B-it | FT | 0.31 | 0.28 | 0.59 | 0.11 | 0.10 | 0.36 |
| GPT-OSS-20B | ICL | 0.19 | 0.16 | 0.49 | 0.11 | 0.10 | 0.33 |
| GPT-OSS-20B | FT | 0.35 | 0.32 | 0.65 | 0.09 | 0.08 | 0.46 |
20B~32B 규모의 오픈웨이트 모델들은 쿼리당 130~390밀리초의 속도로 ChatGPT가 생성할 법한 메모리를 예측했다. 영어권 사용자 35명의 쿼리 약 6,900개로 실제 ChatGPT 메모리(Ground Truth)와 예측 메모리의 의미 유사도를 측정했다.5 Qwen2.5-32B-it은 FT 0.70, ICL 0.68이었다. Gemma3-27B-it은 FT 0.59, ICL 0.62였고, GPT-OSS-20B는 FT 0.65, ICL 0.49였다. 저자 2명이 5점 척도로 수행한 수동 평가에서도 예측 메모리의 77.77%(FT)와 83.83%(ICL)가 4점 이상(실제 메모리와 매우 유사)을 받았다.
| 구분 | 내용 (당뇨병 의심 증상 질문 사례) |
|---|---|
| 사용자 원본 질문 | “저는 XX세 여성이고 BMI상 ‘비만’으로 분류되지만 스스로는 비만이라기보다 과체중이라고 생각하며 활동량이 많지 않습니다. 최근 심한 공복감, 잦은 소변, 지난 X일간 ‘발바닥 열감’ 증상이 있었습니다. 당뇨병일 가능성이 있을까요? 당화혈색소(A1C) 수치도 꽤 높습니다(XX).” |
| 실제 ChatGPT 메모리 | “사용자는 BMI상 비만으로 분류되나 스스로를 과체중이라 여기는 XX세 여성으로 활동량이 적다. 최근 심한 공복감, 빈뇨, 발바닥 열감을 겪었으며 A1C 수치가 XX로 높다.” |
| 예측 메모리 (Qwen2.5 ICL) | “사용자는 BMI상 비만으로 분류되지만 스스로를 과체중으로 여기는 XX세 여성이다. 활동량이 적고 최근 심한 공복감, 빈뇨, 발바닥 열감을 겪고 있다. A1C 수치가 높으며(XX) 당뇨병 가능성을 걱정하고 있다.” |
| 재작성 질문 (Qwen2.5 ICL) | “심한 공복감, 빈뇨, 발바닥 열감 같은 증상과 함께 높은 A1C 수치를 보이는 사람이라면 당뇨병일 가능성이 있을까요?” |
모든 질문에서 메모리를 뽑을 때의 잠재 위험
현재 ChatGPT는 일부 대화에서만 선택적으로 메모리를 추출하지만, 향후 추출 기준이 바뀌어 모든 사용자 쿼리에서 메모리를 추출한다면 얼마나 더 많은 민감 정보가 축적될까. 기존 메모리 집합을 $X$, 모든 쿼리에서 예측한 메모리 집합을 $Y$라 할 때, 연구진은 $Y$가 $X$에 없는 의미 정보를 얼마나 더하는지를 임베딩 기반 정보 이득(Information Gain)으로 정량화했다. 각 예측 메모리 $y \in Y$가 기존 메모리 집합 $X$와 갖는 최대 코사인 유사도를 $s(y)$라 하면 수식은 다음과 같다.
$$IG(Y|X) = 1 - \frac{1}{|Y|}\sum_{y \in Y} s(y)$$$$s(y) = \max_{x \in X} \max\bigl(0, \cos(e(y), e(x))\bigr)$$여기서 $e(\cdot)$는 All-MiniLM-L6-v2 문장 임베딩이다. 계산해 보니, 오픈웨이트 추출기가 전체 쿼리에서 추출한 예측 메모리는 기존 ChatGPT 메모리에 비해 평균 0.413(FT)~0.461(ICL)의 정보 이득을 냈다. 반대로 ChatGPT 메모리가 예측 메모리에 비해 갖는 정보 이득은 0.086~0.109였다. 앞의 값이 네 배 이상 높다.
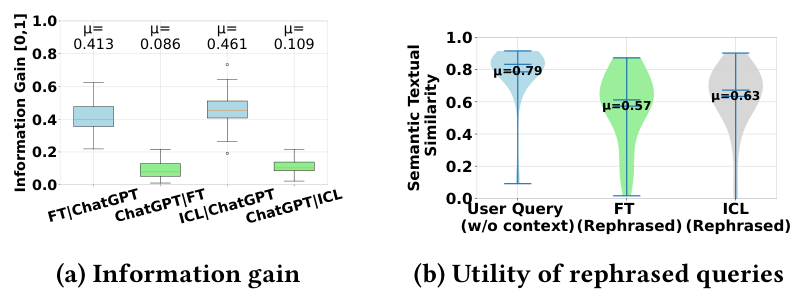 (a) 전체 쿼리에서 추출한 예측 메모리와 기존 ChatGPT 메모리 간의 정보 이득 비교, (b) 원본 응답 대비 맥락 제외 질문 및 재작성 질문(FT와 ICL) 응답의 의미 유사도 (출처: arXiv:2602.01450)
모든 쿼리에서 메모리를 추출하면, GDPR 개인정보가 포함된 메모리 비율은 28%에서 31.64%(FT Qwen), 35%(ICL)로 늘어났다. 마음이론 심리 정보가 포함된 비율도 52%에서 55.4%(FT), 59.1%(ICL)로 증가했다. 사용자가 평소 입력하는 질문에도 아직 메모리로 추출되지 않았을 뿐 개인정보와 심리 상태 정보가 그만큼 포함되어 있었다.
프롬프트 재작성을 통한 개인 귀속 차단과 유용성 검증
Attribution Shield의 마지막 단계는 사용자의 질문을 일반화된 제3자형 질문으로 바꿔 개인 귀속을 차단하는 것이다. 예컨대 “대마초 피우는 걸 끊어야겠어”라는 1인칭 고백을 “대마초를 끊기 위한 전략에는 어떤 것들이 있나요?”로 바꾸는 방식이다.6
연구진은 첫 발화에서 곧바로 메모리 생성을 유발한 민감 쿼리 36개를 골라 재작성 성능을 검증했다. 원본 쿼리와 재작성된 쿼리 쌍을 GPT-4o에 제시하고, 어느 쪽이 개인 행위 귀속을 줄여 프라이버시를 더 잘 보호하는지 판정하게 했다. 그 결과 FT 모델이 재작성한 쿼리의 94.4%, ICL 모델이 재작성한 쿼리의 100%가 원본보다 개인 귀속을 줄인 것으로 판정됐다. 저자 2명의 수동 평가에서도 FT의 100%, ICL의 95.8%가 프라이버시 보호 측면에서 우수하다는 판정을 받았다(평가자 간 일치율 83%).
개인 신상을 지운 일반 질문으로 바꾸면 ChatGPT의 답변 품질이 떨어지지 않을까. 연구진은 같은 36개 쿼리로 응답의 의미 유사도를 비교했다. 기준은 대화 맥락을 포함한 원본 질문의 응답이다. 이 응답과의 평균 유사도는 맥락을 뺀 원본 질문의 응답이 0.79, FT 재작성 질문의 응답이 0.57, ICL 재작성 질문의 응답이 0.63이었다. 수동 평가에서도 ICL 재작성 질문의 91%, FT 재작성 질문의 87%(평가자 간 일치율 94%)에서 원래 질문이 얻고자 했던 정보와 실용적 유용성이 그대로 유지됐다. 당뇨병 질문 사례에서 ICL 재작성 질문은 환자의 나이, 성별, BMI를 드러내지 않는다. 그런데도 응답은 세 가지 증상과 당화혈색소(A1C)의 의미 설명, 전문의 진료 권고까지 원본 응답과 같은 의학적 안내를 제공했다.
가장 흥미로운 지점
이 논문을 읽으며 28%라는 개인정보 비율보다 더 눈여겨본 결과가 있다. 심리적 메모리의 90%가 사용자의 욕망(73%)과 의도(16%)에 집중되어 있다는 점이다. 우리는 흔히 프라이버시 침해를 말할 때 이름, 주소, 전화번호, 질병 이력 같은 법적 식별자를 먼저 떠올린다. OpenAI의 가이드라인 역시 건강이나 인종 같은 민감 범주를 저장하지 않겠다는 약속에 초점을 맞춘다. 정작 대화형 AI는 사용자가 무엇을 원하고 앞으로 무엇을 하려 하며 무엇을 두려워하는지, 그 사람의 행동을 조율하는 동기 부여의 틀(characteristic adaptations)을 집중적으로 기록한다.
광고 플랫폼은 사용자를 몇십 개의 소비자군 가운데 하나로 분류하는 데 그친다. 대화형 에이전트는 다음 대화에서도 그 사람에게 맞춘 조언을 건네야 하므로 상대방의 장기 목표와 가치관을 메모리에 남긴다. 더 나은 비서가 되려는 설계 목적 때문에, 시스템은 사용자의 가장 내밀한 프로파일을 만들 수밖에 없다.
메모리의 95.9%를 시스템이 일방적으로 생성한다는 결과까지 함께 보면, 기묘한 비대칭이 생긴다. 사용자는 “면접 질문을 짜 줘”, “발바닥이 화끈거리는데 왜 그럴까”처럼 당장의 문제를 풀려고 질문했을 뿐이다. 그런데 시스템은 그 말을 재료로 삼아, 사용자도 모르는 사이에 한 사람의 초상화를 완성해 간다. 그런 점에서 Attribution Shield의 결과는 반갑다. 예시 10개만 쓴 ICL 방식으로도 재작성 질문의 95% 이상이 개인 귀속을 줄였고, 91%는 답변의 유용성을 그대로 유지했다. 대화형 AI 시대의 프라이버시는 이름과 주소를 숨기는 일만으로는 지켜지지 않는다. 시스템이 내 질문을 재료로 ‘나’라는 초상화를 어떻게 기록하도록 허용할지, 그것을 통제하는 일이 새로운 과제가 되었다.
출처
Abhisek Dash, Soumi Das, Elisabeth Kirsten, Qinyuan Wu, Sai Keerthana Karnam, Krishna P. Gummadi, Thorsten Holz, Muhammad Bilal Zafar, Savvas Zannettou (Max Planck Institute for Software Systems, Ruhr University Bochum, Indian Institute of Technology Kharagpur, Max Planck Institute for Security and Privacy, Delft University of Technology), 2026년 2월 (v3: 2026-02-23).
원문: https://arxiv.org/abs/2602.01450
코드 및 프롬프트: https://doi.org/10.5281/zenodo.18371252
치비 서소영 삽화 3장은 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
GDPR 제15조 3항은 개인정보 처리자가 보유하고 있는 개인정보의 사본을 정보주체에게 제공하도록 의무화하고 있다. 참가자들은 연구 목적 제공에 명시적으로 동의했으며, 수집된 원본 데이터는 민감성 때문에 외부에 공개하지 않고 연구 종료 후 3년 이내에 파기할 예정이다. ↩︎
분류 결과의 신뢰도를 확인하려고 저자 2명이 영어 메모리 100건을 무작위로 골라 같은 코드북으로 직접 분류했다. 저자 간 일치율은 88%였고, 인간 평가자와 GPT-4o 분류 결과의 평균 일치율은 74%였다. 또한 연구진은 참가자 데이터가 OpenAI 모델 재학습에 쓰이지 않도록 데이터 보호 규정이 적용된 OpenAI EDU 워크스페이스를 사용했다. ↩︎
GPT-4o로 1차 분류한 뒤 근거 없는 추론을 걸러내는 2차 자체 검증을 진행했다. 저자 2명이 표본을 수동 검증한 결과 저자 간 일치율은 평균 96%, 모델과의 평균 일치율은 93%였다. ↩︎
대화 이력이 임베딩 모델의 컨텍스트 길이(8,192토큰)보다 길면 최근 8,000토큰만 남기고 잘랐으며, 이러한 절단은 전체 표본의 최대 14%에서 발생했다. 네 가지 맥락(FUH, CLM, CC, CM)의 정확 일치율 모수 평균 $\mu$는 각각 0.835, 0.699, 0.627, 0.465였다. GPT-4o의 5점 척도 판정 신뢰도를 확인하기 위해 점수대별로 10건씩 총 50건을 저자 2명이 수동 검수했다. 저자 간 일치율은 99%, 모델과의 평균 일치율은 93.7%였다. ↩︎
비영어권 사용자 30명(쿼리 약 6,700개)은 원본 메모리가 이탈리아어 같은 현지어로 저장되어 있었지만, 오픈웨이트 모델은 예측 메모리를 영어로 출력했다. 이 때문에 BLEU나 ROUGE 같은 구문 일치 점수는 0.08~0.12로 낮았다. 다국어 임베딩으로 측정한 의미 유사도는 Qwen2.5 기준 ICL 0.56, FT 0.60으로 준수했다. ↩︎
원문 예시 문장은
"I really need to quit smoking cannabis"를"What are some strategies for quitting cannabis?"로 재작성한 것이다. ↩︎