3줄 요약
- Julie A. Van Dyke와 Jack Dempsey가 2026년 Journal of Educational Psychology에 발표한 교실 실험 논문이다. 컴퓨터 구문 분석기가 문장 구조를 분석해 줄바꿈과 들여쓰기로 표시하는 서식(Linguistically Driven Text Formatting, 제품명 Cascade Format)이 초등학생의 독해를 돕는지 12주 동안 검증했다.1
- 미국 중서부 공립 초등학교 4, 5학년 87명이 한 주에 세 번, 30분씩 자기 수준에 맞춘 지문을 읽었다.2 Cascade 서식으로 읽은 집단은 11일 동안 독해 정답률이 일반 서식 집단보다 빠르게 올랐고, Lexile 635L~785L 구간의 학생들은 일반 서식으로 바꾼 뒤에도 오른 정답률을 유지했다.
- 설문에서 학생들은 이 서식으로 읽으면 “문장을 소리 내어 읽으면 어떤 억양일지 들린다"고 답했다. 가장 읽기 수준이 낮은 학생들은 정답률이 유의하게 오르지 않았지만 답에 대한 자신감이 올랐다고 보고했다.
자료 정보
- 제목: Linguistically-driven text formatting improves reading comprehension: Evidence from 4th and 5th graders
- 저자: Julie A. Van Dyke (예일대학교 Haskins Laboratories와 Yale Child Study Center, 코네티컷대학교 CT Institute for Brain and Cognitive Sciences), Jack Dempsey (일리노이대학교 어배너섐페인)
- 게재: Journal of Educational Psychology, 118(7), 1120–1140 (2026)
- DOI: 10.1037/edu0001054
- 데이터와 분석 코드: https://osf.io/xmpce/ (무료 OSF 계정 필요)
- 이해 상충: 두 저자는 서식을 개발한 Cascade Reading, Inc.의 자문역이며, 이 회사에서 보수와 연구비를 받는다고 논문 첫 장에 밝혔다.
문제 의식
논문은 독해력과 문법 지식의 상관이 높다는 선행 연구에서 출발한다. 저자들이 인용한 Catts 등(2006)의 종단 연구를 보면, 단어는 제대로 읽는데 독해 점수가 25백분위 미만인 8학년 학생들은 수용 어휘가 20백분위, 문법 이해가 30백분위 수준이었다. 이 학생들의 결손은 유치원, 2학년, 4학년 때 검사에서도 이미 나타났다. 그런데 이 8학년 부진 독자들 가운데 저학년 때 언어 치료를 받은 학생은 약 18%로, 다섯 명 중 한 명이 채 되지 않았다.
저자들은 이 결손이 늦게 발견되는 이유로 교재의 난이도 변화를 들었다. 학생들은 3학년 말부터 읽기를 배우는 단계에서 읽어서 지식을 배우는 단계로 전환한다. 이때부터 읽게 되는 설명문에는 수동태, 분열문, 목적격 관계절, 다중 내포 구절이 이야기책이나 구어보다 많이 나온다. 구어 능력이 평범한 학생도 이런 문장을 이해하기 어려워한다. 4, 5학년이 되어서야 성적이 떨어지는 ‘늦게 발현하는 읽기 장애(LERD)’ 학생이 생기는 것도 이 때문이라고 저자들은 설명했다.
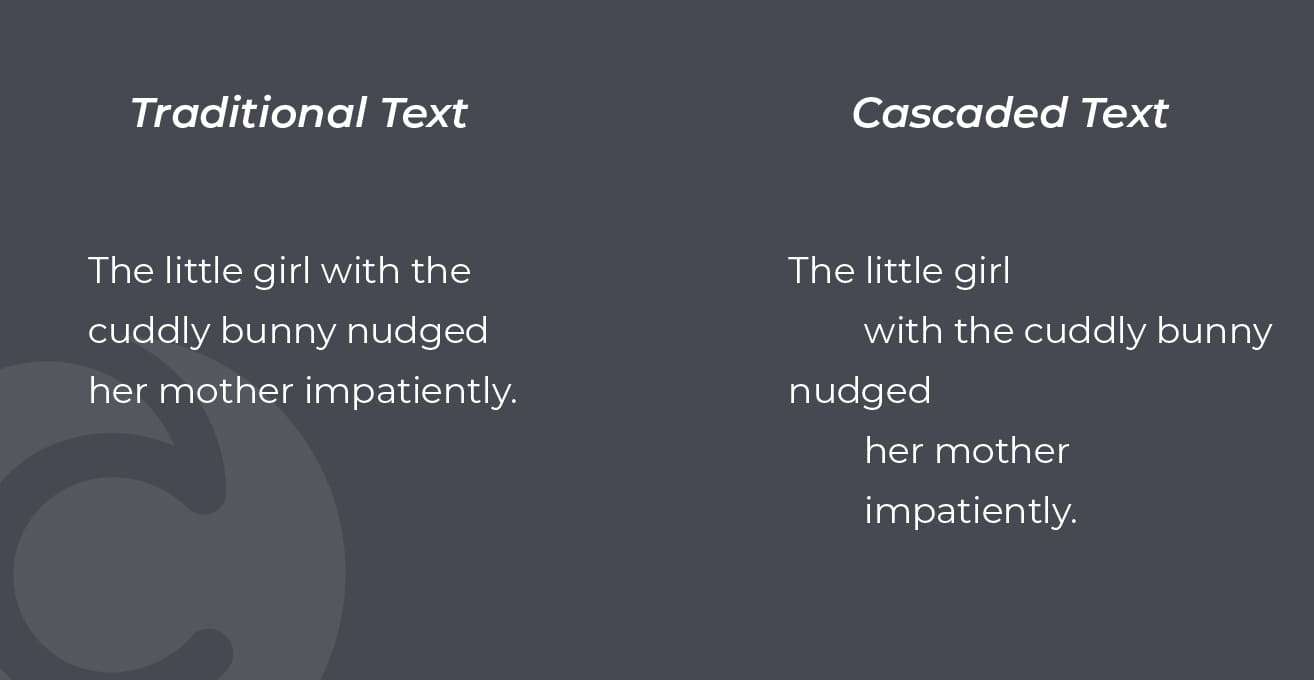
논문은 “The girl with the cuddly bunny nudged her mother impatiently at the bus stop"이라는 문장을 예로 들었다. 숙련된 독자는 단어를 하나씩 읽으면서 곧바로 “the girl”, “with the cuddly bunny”, “nudged”, “her mother” 같은 의미 단위로 조합한다. 그리고 토끼 인형을 든 사람, 엄마를 쿡 찌른 사람, 조바심을 낸 사람이 모두 소녀라는 것을 알아챈다. 언어 능력이 낮은 독자는 어떤 단어들이 한 구성 성분을 이루는지 잘 알아보지 못하고, 같은 문법 관계를 가진 단어가 여러 개 내포된 문장에서 쉽게 혼동한다.
Cascade 서식의 작동 방식
Cascade 서식은 문장마다 구성 성분 분석기와 의존 구문 분석기를 실행한다. 언어 모델은 두 분석 결과를 바탕으로 줄을 바꿀 곳과 들여쓰기 깊이를 정한다. 줄바꿈 패턴은 화면 폭이나 사용자 취향과 상관없이 문장 속 의존 관계로만 결정된다. 저자들은 이 점을 앞선 서식 연구와 구분되는 특징으로 꼽았다.
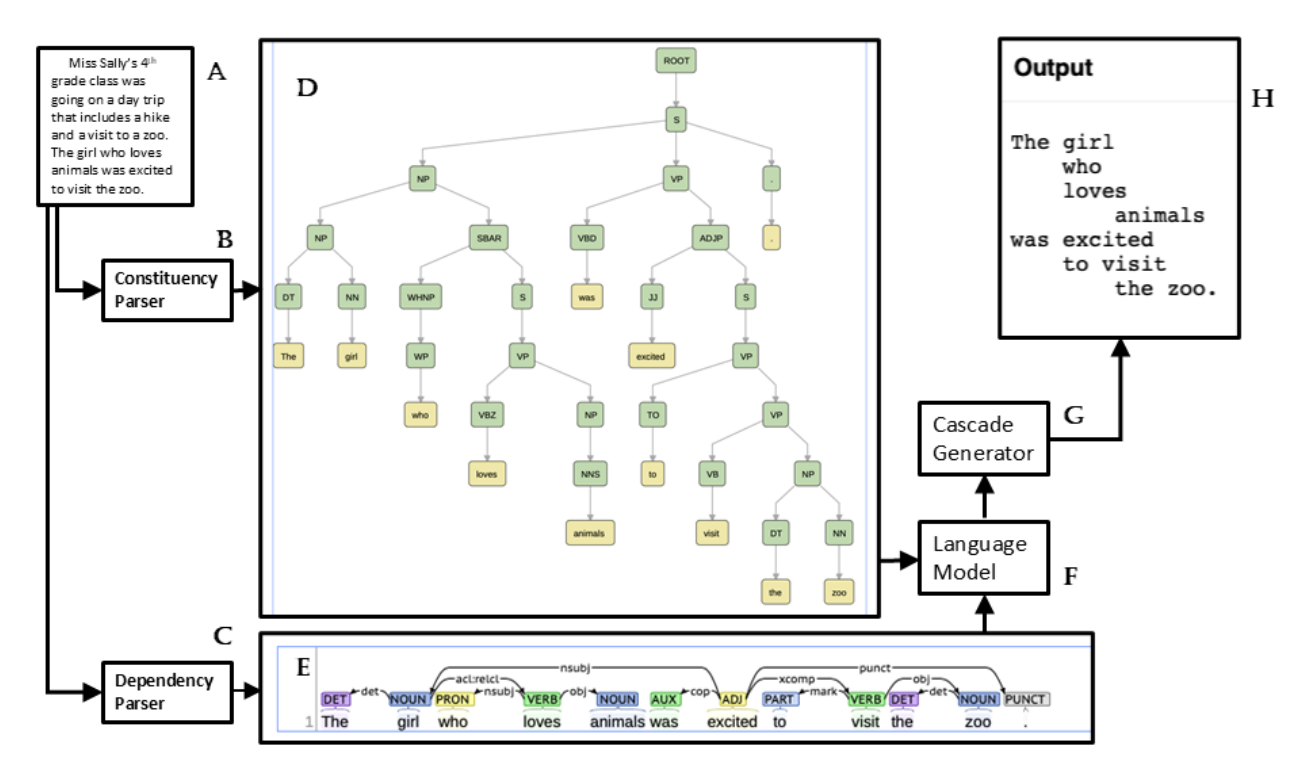 LDTF의 처리 흐름. 출력(H)에서 관계절 “who loves animals"는 주어 “The girl” 밑에 들여쓰이고, 술어 “was excited"는 주어와 같은 들여쓰기로 쓰인다. 출처: Van Dyke & Dempsey 프리프린트(2025).
줄바꿈과 들여쓰기는 네 가지 원칙을 따른다.
| 원칙 | 내용 | 논문 예문 |
|---|---|---|
| 1. 주어와 술어를 정렬한다 | 명사와 그 명사의 동사는 항상 같은 들여쓰기로 쓴다. 내포절 속 주어와 술어에도, 수동문에도 적용한다 | The girl hopes her teacher understands how hard she worked. |
| 2. 의존어는 핵어 밑에 들여쓴다 | 목적어, 전치사구, 관계절, 수식어를 그것이 수식하는 말 밑에 들여써서 무엇을 꾸미는지 알 수 있게 한다 | Jackie donated a book about early immigrants to Florida to the town library. |
| 3. 도입부를 들여쓴다 | 핵어보다 먼저 나오는 도입구나 종속절을 들여쓴다. 원칙 2의 특수한 경우다 | After school, Janie ordered a sandwich. |
| 4. 한 그룹의 단어는 정렬하고 그룹 전체를 함께 들여쓴다 | 접속사는 연결되는 항목들보다 왼쪽으로 내어 쓰고, 연결되는 항목끼리는 같은 들여쓰기로 맞춘다 | My daughter likes dogs and cats. |
원칙 4에는 인지적 근거가 있다. 사람의 뇌는 단어를 읽는 즉시 구조를 할당하기 때문에, “My daughter likes dogs and cats"를 읽으면 처음에는 “dogs"만 “likes"의 목적어로 해석한다. Cascade 서식에서는 “dogs"가 두 칸 들여쓰여 있고 “and"가 왼쪽으로 내어 쓰여 있다. 독자는 “cats"를 읽기 전부터 목적어가 “dogs and cats” 전체라는 신호를 받는다.
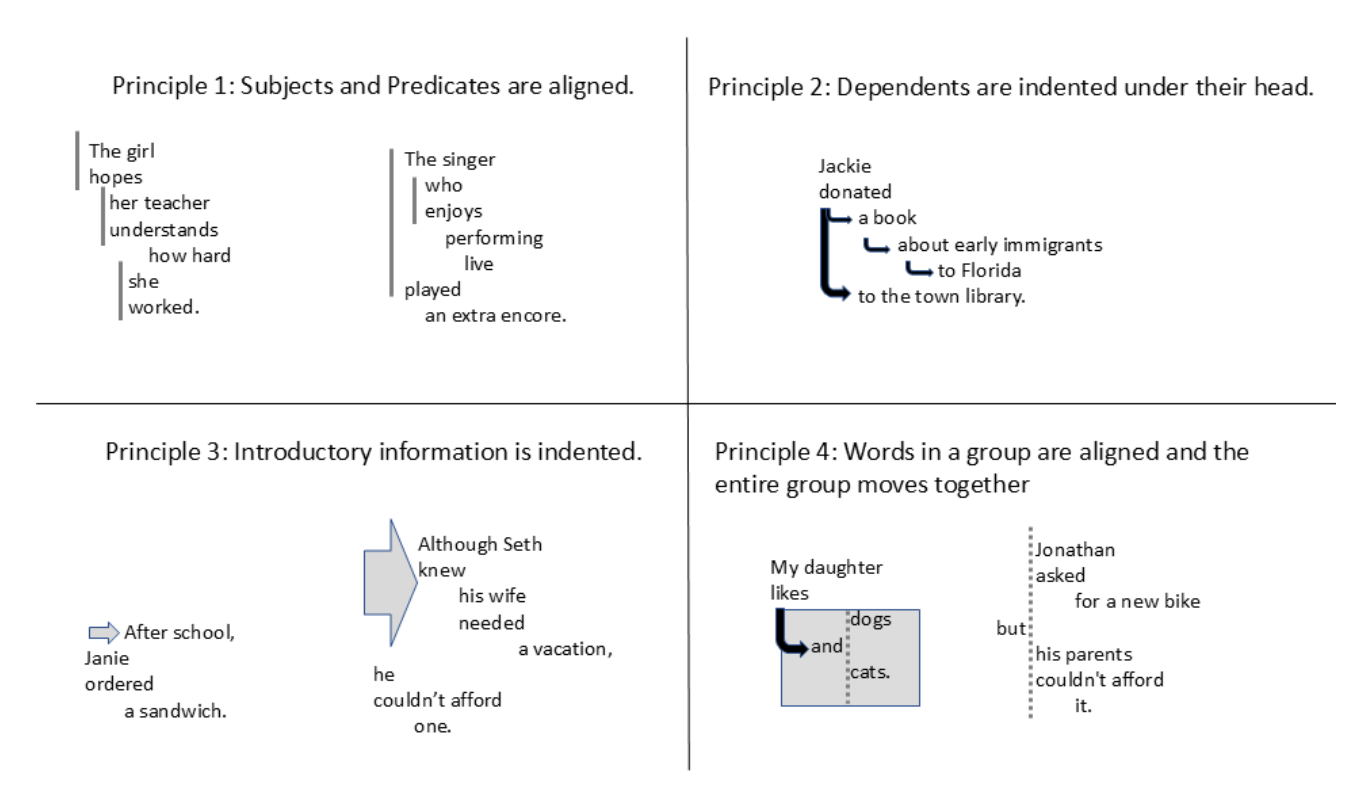 Cascade 서식의 네 원칙과 예문. 출처: Van Dyke & Dempsey 프리프린트(2025).
구문 단위가 끝나는 곳에서 줄을 바꾸면 독해가 좋아진다는 결과는 1966년 Graf와 Torry의 연구에서 이미 보고됐다. 이후에도 공백, 줄바꿈, 들여쓰기로 문장을 재배치한 서식 연구가 여럿 나왔다. 저자들은 이 연구들의 서식 규칙이 임시방편에 가까워 문장의 구성 성분 구조와 맞지 않는 경우가 많았다고 평가했다. 저자들은 그 예외로 Bever 연구진의 서식을 꼽았다. 이 서식은 구성 성분 사이에 공백을 넣는다. Jandreau와 Bever(1992)가 대학생에게 이 서식을 읽혔더니, SAT 언어 점수가 550 미만인 학생의 독해는 좋아졌지만 550 이상인 학생에게서는 효과가 나타나지 않았다. Cascade 서식은 여기에 의존 문법을 더해, 구성 성분을 드러내는 데서 그치지 않고 어느 성분이 어느 성분과 관계를 맺는지도 표시한다.
저자들은 뇌의 통계적 학습 기제가 구문 단위에 민감하다는 선행 연구를 근거로, 이 서식을 반복해서 읽으면 구문 지식이 훈련되어 읽기 유창성과 독해가 좋아질 것이라고 예측했다. 이번 연구는 협력 학교의 요구 때문에 구문 지식은 측정하지 않았고, 독해 정답률과 학생들의 주관적 반응만 측정했다.
실험 설계
- 기간: 2021년 9월 말부터 12월 중순까지 12주.
- 참가자: 부모 동의를 받은 107명 가운데 개별화 교육 프로그램(IEP) 대상 학생을 제외한 87명. 4학년 두 반, 5학년 두 반, 4, 5학년 혼합 STEM 선택반 두 반에서 모집했다. 저널판 초록에 따르면 평균 나이는 9.6세이고 여학생은 46명이다. IEP 학생은 교사가 옆에서 함께 소리 내어 읽는 방식으로 참여했기 때문에 분석에서 제외했다.
- 집단 배정: Gates-MacGinitie 읽기 검사로 학생마다 Lexile 점수3를 구했다. 그다음 최소화(minimization) 알고리즘으로 두 집단의 구성을 맞췄다. Lexile 점수에 가중치 7/14를 주고, 나이, 성별, 인종, 장애 여부, 학군 거주 여부, 급식 지원 여부, 학년에 각각 1/14를 주었다. 검사일에 결석한 19명은 일반 서식 집단으로 먼저 배정했다.
- Lexile 구간: A(470L~620L), B(635L~785L), C(795L~945L), D(950L~1100L). A가 가장 읽기 수준이 낮고 D가 가장 높다. 학생들은 자기 구간에 맞는 난이도의 지문을 읽었다.
- 지문과 문항: 비영리 단체 ReadWorks가 제공하는 과학, 역사, 예술 분야 지문을 썼고, 지문 길이는 모두 1,000단어 미만이었다. 학생들은 하루 30분 동안 지문 세 편을 읽었고, 지문마다 사지선다 5~7문항에 답했다. 문항은 명시된 정보 1~2개, 주제 1개, 통사 관계 1개, 어휘 1개, 글의 구조나 근거 1~2개, 추론 1개로 구성했다.4
- 읽기 환경: 학생들은 크롬북 화면에서 한 단으로 된 텍스트를 읽었다. Cascade 서식에서는 들여쓰기가 구문을 뜻하기 때문에 문단 구분은 음영으로 표시했다.
- 서식 교육: Cascade 서식을 먼저 읽은 집단은 첫 사흘 동안 화면 일곱 장으로 된 안내 자료로 네 원칙을 배웠다. 연구 기간 전체에서 서식에 관한 명시적 교육은 이것이 전부였다.
교장은 모든 학생이 새 서식을 경험해야 한다고 요구했다. 그래서 연구진은 중간에 두 집단의 서식을 맞바꾸는 교차 설계를 택했다.
| 단계 | 기간 | Cascade 먼저 집단 | 일반 서식 먼저 집단 |
|---|---|---|---|
| 1단계 | 11일 | Cascade 서식 | 일반 서식 |
| 휴지기 | 1주 | 평소 수업 | 평소 수업 |
| 2단계 | 11일 | 일반 서식 | Cascade 서식 |
| 휴지기 | 3일 | 평소 수업 | 평소 수업 |
| 3단계 | 2일 | 일반 서식 | 일반 서식 |
각 단계 9일째에 연구진은 리커트 척도 설문을 실시했다. 설문은 답에 대한 자신감, 묵독할 때 문장이 어떤 억양으로 읽힐지 떠오르는 정도(청각 시뮬레이션), 답을 추측한 빈도, 책보다 컴퓨터로 읽는 것을 좋아하는지를 물었다. 연구가 끝난 날에는 익명 종이 설문(Exit Ticket)으로 서식 선호와 계속 사용할 의향을 물었다.
데이터 정제
연구진은 두 가지 표본을 분석했다. 모든 기록을 넣은 ‘전체 표본’에서는 1, 2, 3단계 어디에서도 연구진이 관심을 둔 효과가 나오지 않았다. 읽기 시간을 확인해 보니 비정상적으로 빠른 기록이 일부 있었다. 연구진은 학생이 지문을 실제로 읽었다고 볼 수 있는 기록만 남긴 ‘내적 타당도 표본’을 주 분석으로 삼았다.
- 지문 제거: 연구진은 Aimsweb+ 묵독 유창성 검사의 표준화 표본(유치원부터 8학년까지 31,000명 이상)으로 Lexile 구간별 기대 묵독 속도를 계산했다. 실제 읽기 속도가 이 기대 속도보다 3표준편차 이상 빠른 지문은 제외했다. 이 기준으로 전체 지문의 29%를 제외했고, 구간별 제외 비율은 A 11.4%, B 20%, C 19%, D 6.9%였다.
- 문항 제거: 문항을 읽는 데 필요한 시간보다 빨리 답한 경우도 제외했다. 문항이 한 화면에 한꺼번에 제시됐기 때문에, 이 경우 그 지문의 문항 세트 전체를 버려야 했다. 이 기준으로 남은 데이터의 18.7%를 추가로 제외했다. 구간별로는 A 26.3%, B 23.6%, C 13.6%, D 8.9%였다.
연구진은 베이지안 위계 모형으로 분석했다. 89% 신용구간(CrI)5이 0을 포함하지 않을 때 유의한 효과로 판정했다. 민감도 분석에서 사전 분포를 바꿔도 내적 타당도 표본의 1단계 핵심 효과(집단과 일차의 상호작용)에 대한 베이즈 인자는 35.5~39.3으로 안정적이었다. 반면 전체 표본에서는 사전 분포를 어떻게 설정하느냐에 따라 베이즈 인자가 4.75에서 37.95까지 달라졌다. 정제 후 표본의 사후 검정력은 57~70%로 추정됐다.
결과 1: Cascade 서식 집단의 정답률이 더 빨리 올랐다
1단계 모형에서 집단과 일차의 상호작용이 유의했다(추정치 -0.06, 89% CrI [-0.11, -0.01]). Cascade 서식으로 읽은 집단의 정답률이 11일 동안 일반 서식 집단보다 빠르게 올랐다는 뜻이다. 구간 A, B, C는 모두 D보다 정답률이 낮았다. 집단과 Lexile 구간의 상호작용은 유의하지 않았지만, 연구진은 B와 C 구간에서 Cascade 서식의 이득이 수치상 가장 컸다고 보고했다.
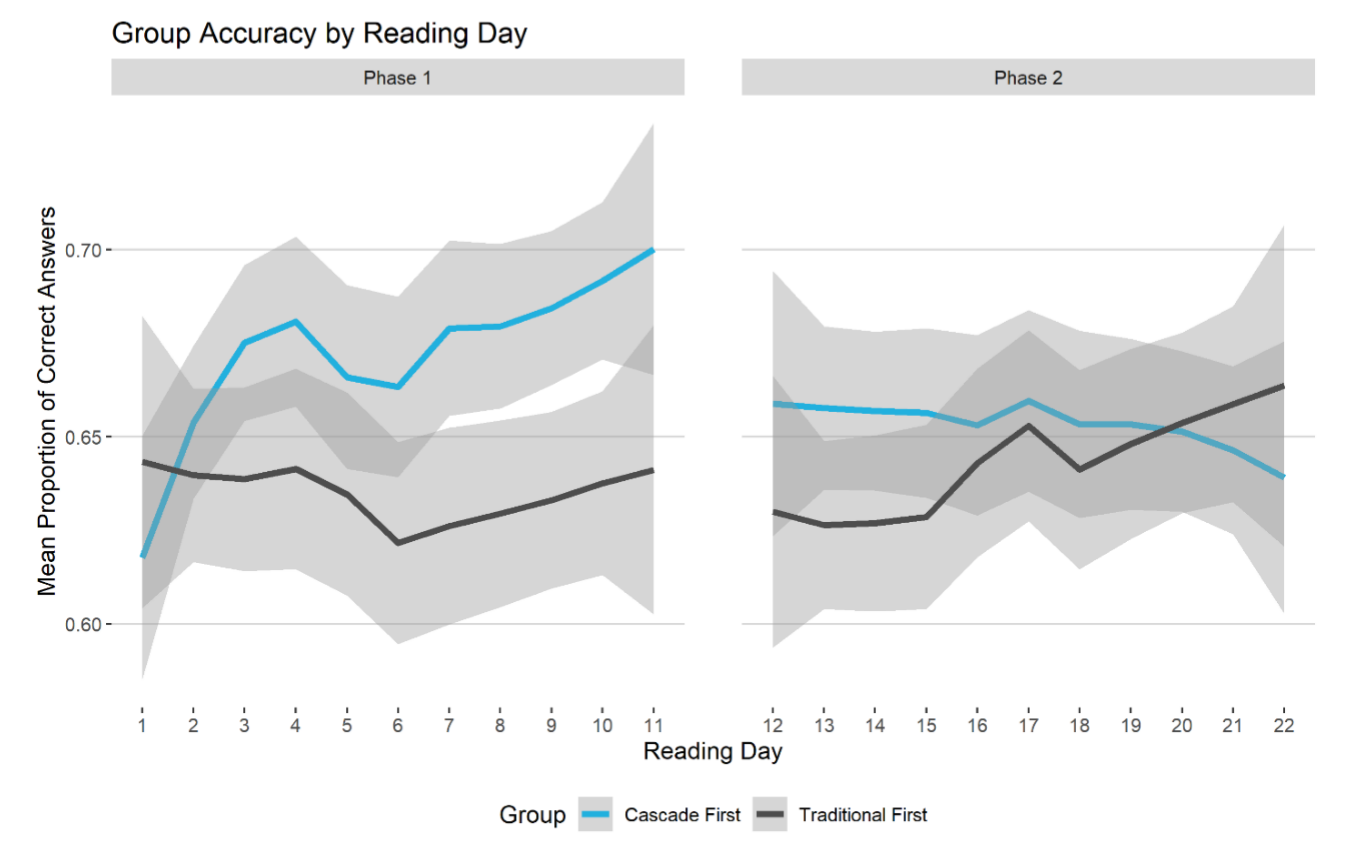 1, 2단계의 읽기 일차별 평균 정답률. 음영은 신뢰구간이다. 1단계에서 Cascade 먼저 집단은 첫날 0.62 안팎에서 11일째 0.70까지 올랐고, 일반 서식 집단은 0.62~0.64 사이였다(그래프 판독값). 출처: Van Dyke & Dempsey 프리프린트(2025).
2단계와 3단계를 각각 분석한 모형에서는 유의한 효과가 없었다. 연구진은 1단계에서 이미 Cascade 서식을 경험하고 정답률이 오른 집단이 2단계에서 대조군 구실을 할 수 없었기 때문이라고 해석했다.
결과 2: 일반 서식으로 바꾼 뒤에도 이득이 유지됐다
연구진은 Cascade 서식으로 읽은 경험이 일반 서식 읽기로 이어지는지를 ‘전이 효과’로 따로 분석했다. 1단계와 2단계를 비교한 모형에서도 집단과 단계의 상호작용이 유의했다. Cascade 먼저 집단은 일반 서식으로 바꾼 뒤에도 1단계에서 얻은 정답률을 유지했고, 일반 서식 먼저 집단은 Cascade 서식으로 바꾼 뒤 정답률이 올랐다. 집단, 단계, 구간의 3원 상호작용은 B 구간에서만 유의했다. 연구진은 B 구간의 향상이 Cascade 서식으로 읽은 학생에게만 나타났으므로 전이 효과로 볼 수 있다고 설명했다. C 구간에서는 서식을 바꾼 뒤 두 집단 모두 정답률이 올랐는데, 이 변화는 집단과 상관이 없었다.
2단계와 3단계를 비교하면, 두 집단 모두 3단계에서 정답률이 떨어졌다. 그러나 2단계에 Cascade 서식으로 읽은 집단은 하락 폭이 더 작았고, 이 차이는 B 구간에서 유의했다.
| 비교 구간 | 효과 | 추정치 | 89% CrI |
|---|---|---|---|
| 1단계와 2단계 | 집단과 단계의 상호작용 | 0.24 | [0.02, 0.46] |
| 1단계와 2단계 | 집단, 단계, B 구간의 3원 상호작용 | -0.43 | [-0.71, -0.15] |
| 1단계와 2단계 | 단계와 C 구간의 상호작용 | 0.48 | [0.15, 0.82] |
| 2단계와 3단계 | 집단, 단계, B 구간의 3원 상호작용 | -0.55 | [-1.08, -0.03] |
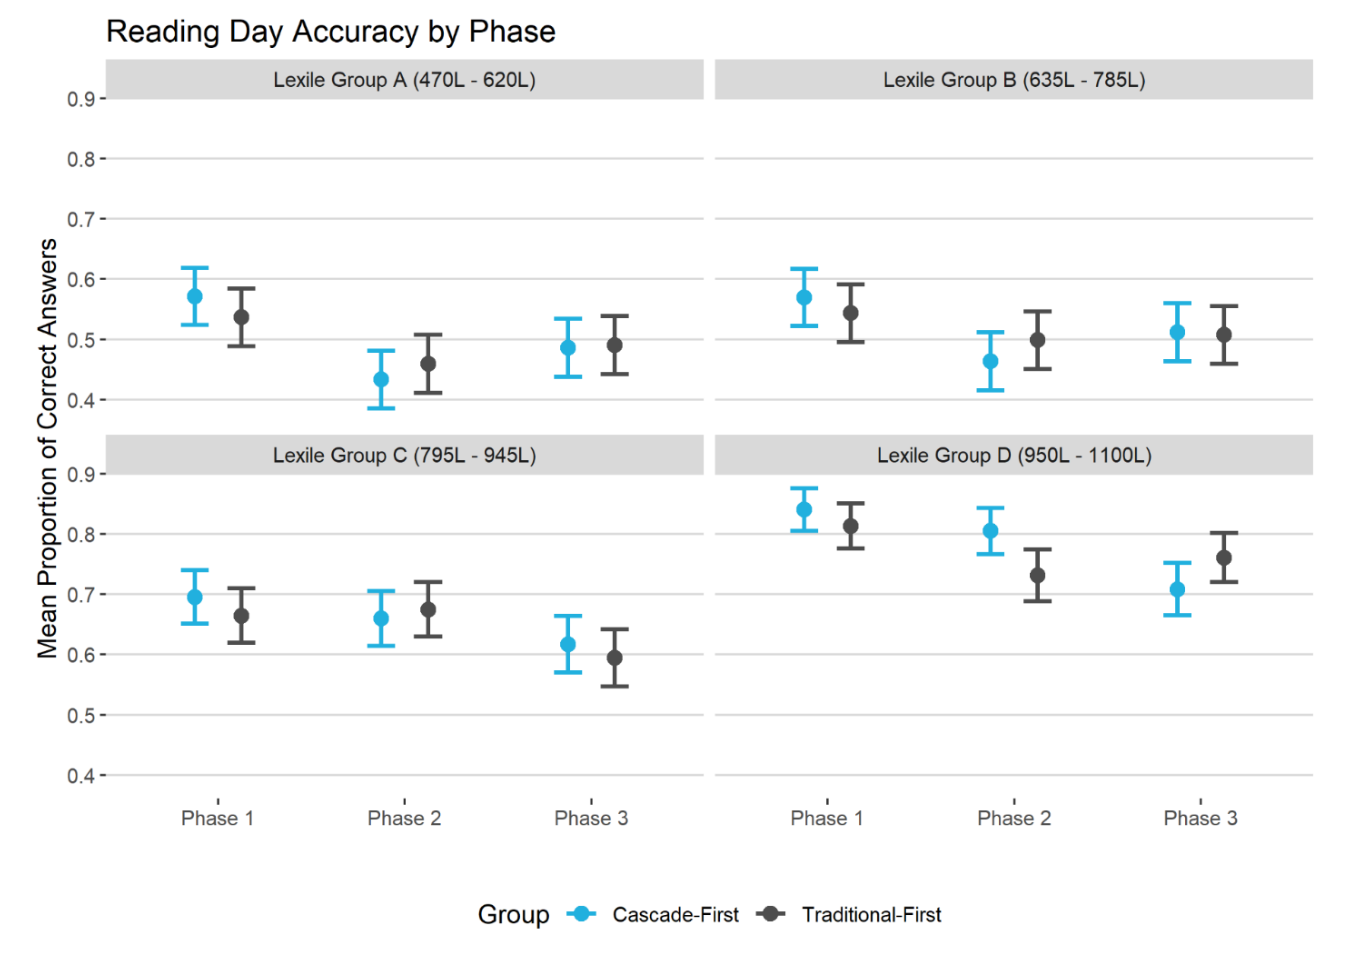 Lexile 구간별, 단계별 평균 정답률. 오차 막대는 표준오차다. 출처: Van Dyke & Dempsey 프리프린트(2025).
저널판 초록은 같은 결과를 학년 백분위로 적었다.6 초록에 따르면 25~50백분위 독자의 정답률이 유의하게 올랐고, 일반 서식으로 바꾼 뒤에도 25백분위 독자의 이득은 유의했으며 50백분위 독자는 수치상 더 나았다.
결과 3: “소리 내어 읽으면 어떤 억양일지 들린다”
설문 네 문항 가운데 자신감과 청각 시뮬레이션 두 문항에서만 유의한 결과가 나왔다.
- 청각 시뮬레이션: Cascade 서식으로 읽을 때 “문장을 소리 내어 읽으면 어떤 억양일지 들렸다"는 응답이 더 잦았다(집단 주효과 -1.35, p = 0.03). B와 C 구간에서는 같은 수준의 일반 서식 독자보다 이 경험을 더 자주 보고했다(집단과 B 구간의 상호작용 1.76, p = 0.03, 집단과 C 구간의 상호작용 2.38, p = 0.01).
- 자신감: 가장 낮은 A 구간 학생들은 Cascade 서식으로 읽을 때 답에 더 자신이 있었다고 답했다(집단과 A 구간의 상호작용 2.75, p = 0.01). A 구간의 정답률 향상은 유의하지 않았다.
- 설문 응답과 독해 정답률 사이에는 유의한 관계가 나타나지 않았다.
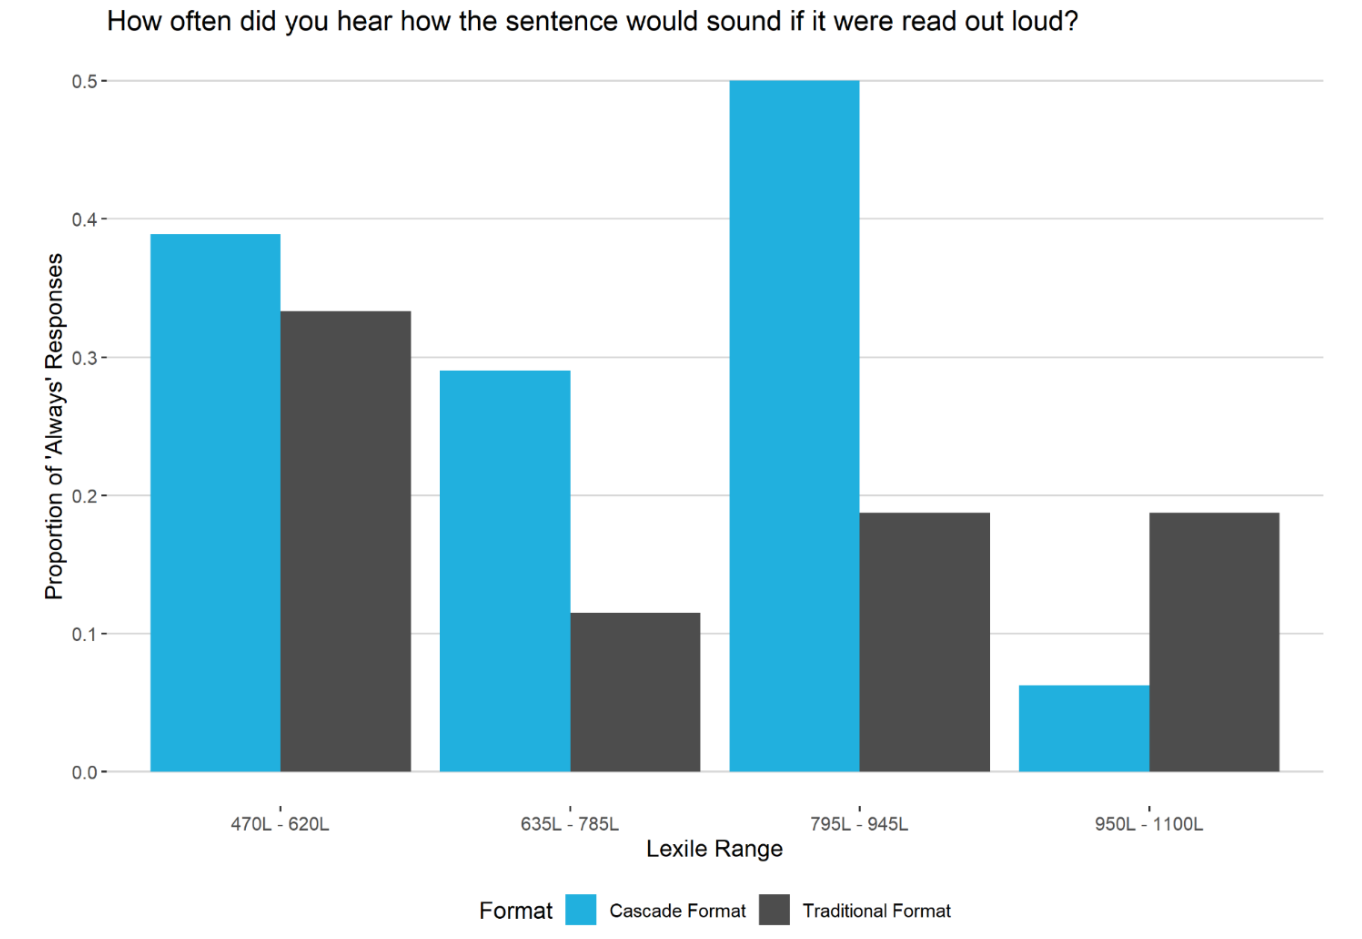 청각 시뮬레이션 문항에 ‘항상’이라고 답한 비율. 795L~945L 구간은 Cascade 서식에서 0.50, 일반 서식에서 0.19 안팎이었고, 950L~1100L 구간만 일반 서식의 비율이 더 높았다(그래프 판독값). 출처: Van Dyke & Dempsey 프리프린트(2025).
익명 종료 설문에는 IEP 학생을 포함해 91명이 응답했다. 응답자의 45%가 Cascade 서식을 일반 서식보다 선호했고, 38%가 학교에서 계속 쓰고 싶다고 답했다. Cascade 서식을 선호한 학생은 읽은 내용을 더 잘 기억하게 됐다고 답하는 경향이 있었다(r = 0.24, p = 0.04). 문단의 중요성을 배웠다는 응답도 같은 경향을 보였다(r = 0.26, p = 0.02). 연구진이 학급을 방문했을 때 여러 학생은 “단어가 더 작은 단위로 구분되어 있어서” Cascade 서식이 읽기 편하다고 말했다. 특수교사는 한 IEP 학생이 Cascade 서식 덕분에 처음으로 “독자가 된 느낌"을 받았다고 전했다.
저자들이 밝힌 한계
- 대조군이 1단계에만 있다. 모든 학생이 새 서식을 경험해야 했기 때문에, 온전한 대조군과 비교할 수 있는 것은 1단계뿐이다. 2단계와 3단계 사이 휴지기가 3일로 짧아서, 서식 효과가 단순 연습 효과나 최근 노출 효과와 얼마나 다른지 판단하기도 어렵다.
- 데이터 손실이 크다. 과속 기록을 제외하면서 분석할 수 있는 데이터가 크게 줄었다. 상호작용 효과를 검정할 때는 검정력이 부족했다. B 구간과 비교하면 A 구간은 데이터가 43%, C 구간은 77%, D 구간은 27% 적었다. 연구진은 가장 강한 효과가 데이터가 가장 많은 B 구간에서 나온 것이 우연이 아닐 수 있다고 직접 적었다.
- 필요한 노출량을 모른다. 대학생 대상 선행 연구에서는 Cascade 서식 텍스트를 약 3,000단어 읽은 뒤 독해가 향상됐다(Dempsey 외, 2024, 2025). 초등학생에게 얼마나 노출해야 하는지는 이번 연구로 알 수 없다.
- 구문 지식을 측정하지 못했다. 학사 일정 때문에 서식의 작동 원리로 가정한 구문 지식의 변화는 측정하지 못했다.
- 사전 등록을 하지 않았다. 연구 설계와 분석 계획을 사전 등록하지 않았다.
- 코로나19 휴교 직후였다. 휴교가 학생들의 집중력이나 학력에 준 영향을 평가할 수 없었다.
연구진은 참가자가 더 많고, Cascade 서식을 전혀 쓰지 않는 대조군을 두고, 관찰 기간이 더 긴 연구로 결과를 재현해야 한다고 결론지었다. Cascade 서식은 cascadereading.com에서 무료로 쓸 수 있고, 임의의 텍스트를 변환하는 기능과 수업용 지문 라이브러리도 제공된다고 논문 각주에 적혀 있다.
가장 의외였던 것
연구진은 화면 일곱 장으로 된 안내 자료로 들여쓰기 규칙만 가르쳤을 뿐, 문법 수업은 따로 하지 않았다. 그런데도 학생들이 가장 많이 보고한 변화는 소리와 관련된 것이었다. 들여쓰기로 구문 단위를 보여 주자, 학생들은 소리를 내지 않고 읽는데도 문장이 어떤 억양으로 읽힐지 들렸다고 답했다. 연구진은 이 현상을 암묵적 운율과 연결했다. 미국 NAEP의 구두 읽기 유창성 채점 기준은 자연스러운 억양으로 읽는 능력을 최고 등급의 요건으로 두고 있다. 단어는 제대로 읽지만 독해가 학년 수준보다 낮은 고등학생은 운율 능력도 낮다는 연구가 있다. 시각적인 서식으로 읽은 학생들이 청각 시뮬레이션을 보고했다는 점이 나에게는 가장 의외였다.
나는 효과가 나타난 학생 집단에도 주목했다. 이 서식의 도움이 가장 필요해 보이는 A 구간 학생들은 자신감만 올랐고 정답률은 유의하게 오르지 않았다. 정답률 향상과 전이 효과가 가장 뚜렷했던 학생들은 중간 수준인 B 구간이었다. 연구진은 A 구간 학생들에게는 더 많은 연습이나 명시적인 교육이 필요할 수 있다고 보았다.
출처
Van Dyke, J. A., & Dempsey, J. (2026). Linguistically-driven text formatting improves reading comprehension: Evidence from 4th and 5th graders. Journal of Educational Psychology, 118(7), 1120–1140. American Psychological Association.
- 원문(APA PsycNet): https://psycnet.apa.org/record/2027-91150-001
- DOI: https://doi.org/10.1037/edu0001054
- 저자 프리프린트(2025년 12월): https://cascadereading.com/wp-content/uploads/2025/12/MKE-Preprint.pdf
- 데이터와 코드: https://osf.io/xmpce/
- 이미지: 도식과 그래프는 저자 프리프린트에서, 커버의 서식 비교 이미지는 Cascade Reading 웹사이트(https://cascadereading.com/about/)에서 인용했다.
저널판 본문은 유료라서, 이 글의 세부 수치와 그림은 저자들이 Cascade Reading 서버에 공개한 2025년 12월 프리프린트에서 옮겼다. 제목, 저자, 표본 수는 저널판과 같지만 최종 게재본과 표현이나 세부 수치가 다를 수 있다. ↩︎
논문 초록과 본문은 참가자를 4, 5학년으로 적었지만 Impact Statement는 “3, 4학년"으로 적었다. 모집 학급과 읽기 검사 수준이 모두 4, 5학년이므로 Impact Statement의 표기를 오기로 보았다. ↩︎
Lexile은 MetaMetrics가 개발한 읽기 난이도 척도다. Lexile은 문장 길이와 단어 빈도로 글의 난이도를 매긴다. 학생의 읽기 수준도 표준화 검사 점수로 환산해 같은 척도에 표시하므로, 학생 수준에 맞는 글을 고를 수 있다. 점수 뒤에 L을 붙여 표기한다. ↩︎
연구진은 각 단계에서 세 차례, 목적격 관계절이나 중앙 내포절처럼 어려운 구문을 담은 50개 문장으로 이해 과제도 냈다. 학생들은 문장마다 예 또는 아니오로 답했다. 서식과 상관없이 대부분의 학생이 이 과제를 완료하지 못해서 결과는 보고하지 않았다. ↩︎
신용구간(credible interval)은 베이지안 추정에서 쓰는 구간이다. 89% 신용구간은 모수가 이 범위의 값일 사후 확률이 89%라는 뜻이다. ↩︎
프리프린트는 결과를 Lexile 구간 A~D로 적었다. 프리프린트 토론 절은 B와 C 구간이 MetaMetrics 기준으로 3~7학년 학생의 25~75백분위에 대략 해당한다고 설명한다. ↩︎