3줄 요약
- Cartesia는 고정 토크나이저 대신 바이트를 묶는 방법까지 학습하는 H-Net의 스케일링 실험을 공개했다.
- 토큰화만 바꾼 통제 실험에서는 같은 예측 손실에 필요한 연산량이 줄었다. 2단계 H-Net은 SmolLM3가 학습을 마치고 얻은 평균 평가 점수를 그 학습 데이터와 연산의 약 10분의 1로 얻었다.
- H-Net은 추론 중에도 반복되는 새 단어와 형식에 따라 청크를 바꿨다. 연구진은 DNA와 이미지에서도 모델이 데이터에 맞는 처리 단위를 학습하는 현상을 관찰했다.
바이트를 어떻게 묶을지도 학습한다
언어 모델은 보통 문장을 토큰이라는 단위로 변환한 뒤 읽는다. 널리 쓰이는 BPE는 학습 자료에서 자주 등장하는 바이트 조합을 합쳐 고정된 어휘 목록을 만든다. 바이트를 하나씩 처리할 때보다 입력의 길이가 짧아져 계산량을 줄일 수 있다. 이번 실험의 BPE 토큰 하나는 평균 4.57바이트에 해당했다.
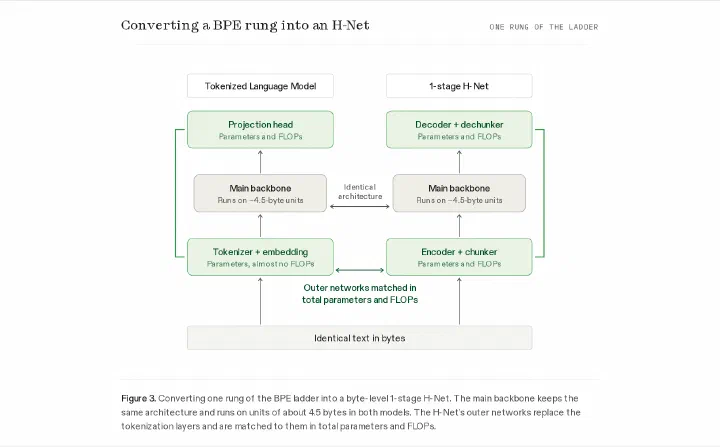
그러나 미리 만든 어휘 목록은 문맥에 따라 달라지지 않는다. 처음 보는 변수명이나 여러 단어로 된 표현을 처리할 때도 같은 규칙을 적용한다. H-Net에서는 바이트의 묶음인 청크를 결정하는 모듈도 다음 바이트를 예측하는 훈련에 참여한다.
인코더가 바이트를 읽으면 학습된 청크 모듈이 입력을 압축한다. 주 네트워크는 압축된 청크를 처리한다. 이후 청크를 원래 입력 길이로 복원하면 디코더가 다음 바이트를 예측한다. 주 네트워크를 다시 H-Net으로 구성하면 여러 단계의 압축도 가능하다. 원문은 이를 2025년에 발표한 H-Net의 개선판으로 소개한다.
| 구분 | BPE를 쓰는 언어 모델 | H-Net |
|---|---|---|
| 처리 단위 결정 | 전처리에서 정한 고정 어휘로 결정 | 모델이 입력 문맥에 따라 결정 |
| 학습 방식 | 토크나이저와 언어 모델을 별도로 학습 | 청크 생성과 예측을 함께 학습 |
| 여러 단계의 압축 | 일반적으로 한 번 토큰화 | H-Net을 재귀적으로 구성 가능 |
토큰화만 교체했을 때의 학습 효율
첫 실험은 H-Net 전체를 최적으로 설계하기보다 토큰화 방식의 효과를 확인하는 데 집중했다. 연구진은 BPE를 쓰는 Transformer를 여러 크기로 학습하고, 크기마다 같은 조건의 1단계 H-Net을 하나씩 만들었다. H-Net의 주 네트워크는 비교 모델과 같은 구조를 사용했다. 인코더와 디코더의 파라미터 수와 연산량은 BPE 모델의 임베딩 및 출력 계층에 맞췄다. 평균 압축률도 4.57로 제한했다.
학습 자료는 바이트 수 기준 영어 70%, 코드 20%, 수학 5%, 다국어 5%다. 두 모델이 읽는 텍스트와 문서를 구분하는 지점을 일치시켰다. BPE에도 학습 자료에 적응할 기회를 주기 위해, 기존 토크나이저를 가져오는 대신 같은 자료로 토크나이저를 새로 학습했다. 평가에는 바이트당 비트 수인 BPB를 사용했다. 토큰화 방식이 달라도 다음 데이터를 얼마나 잘 예측하는지 비교할 수 있는 손실 지표다. 값이 낮을수록 좋다.
표의 배수는 같은 예측 손실을 얻는 데 드는 학습 연산량을 비교한 값이다. H-Net의 연산량을 1로 둘 때 BPE 모델에 드는 연산량이다.
| 평가 대상 | 연산 효율 배수 |
|---|---|
| 학습 분포의 검증 자료 | 1.28배 |
| Paloma 평가 모음 | 1.83배 |
| OLMES 평가 모음 | 2.06배 |
| 학습에 포함된 프로그래밍 언어 15종 | 중앙값 2.04배 |
| 학습에 포함되지 않은 프로그래밍 언어 10종 | 중앙값 3.10배 |
| 미학습 언어 중 Prolog | 5.37배 |
검증 자료의 1.28배는 H-Net이 약 22% 적은 연산으로 같은 손실을 얻었다는 뜻이다. Paloma와 OLMES에서는 정답에 부여하는 확률을 BPB로 환산해 스케일링 관계를 비교했다.1 코드에서는 H-Net이 더 많은 바이트를 한 청크로 묶어 계산을 덜 쓰면서도 예측 손실이 낮았다.

동일 손실에 필요한 학습 연산량을 비교한 원문 Figure 4. 출처: Cartesia.
2단계 H-Net과 SmolLM3의 비교
두 번째 실험에서는 압축률과 구조의 제약을 완화했다. 비교 대상은 학습 자료 구성과 중간 체크포인트를 공개한 Hugging Face의 SmolLM3-3B다. H-Net은 바이트를 처리하는 단계에 Mamba-2 인코더와 디코더를 썼다. 다음 단계에는 슬라이딩 윈도 어텐션과 Mamba-2를 썼고, 주 네트워크는 40개 계층의 Transformer로 구성했다.
압축 목표는 첫 단계 4배, 다음 단계 2배로 설정했고, 학습 후 전체 압축률은 약 7.6배였다. 주 네트워크가 같은 텍스트에서 처리하는 청크 수는 SmolLM3의 토큰 수보다 약 40% 적었다. 대신 인코더와 디코더를 포함한 외부 네트워크에 전체 연산의 약 43%를 사용했다.
| 비교 항목 | 2단계 H-Net | SmolLM3 |
|---|---|---|
| 전체 파라미터 수 | 36.7억 | 30.8억 |
| 바이트당 학습 연산량 | 4.44 GFLOPs | 4.36 GFLOPs |
| SmolLM3 최종 평균 점수까지의 학습량 | 약 1조 토큰 분량 | 약 11조 토큰 |
바이트당 연산량 차이는 2% 이내다. 연구진은 같은 텍스트를 학습할 때 연산 비용이 비슷하도록 맞췄다. 추론과 상식, 지식과 이해를 평가하는 여섯 과제의 평균 점수를 비교했다. H-Net은 약 1조 토큰 분량의 데이터를 학습했을 때 SmolLM3가 학습을 마치고 얻은 평균 점수와 같아졌다. 바이트당 연산 비용이 비슷하므로 필요한 총 학습 연산도 그에 비례해 줄었다.2
추론 중에도 새 단어를 묶는 방법이 달라진다
학습을 마친 H-Net도 입력을 읽는 동안 청크를 바꾼다. 같은 입력 문맥에서 낯선 단어를 여러 번 만나면, 처음에는 여러 청크로 처리하던 단어를 이후에는 더 적은 청크로 처리하는 사례가 있었다. Cartesia는 이를 문맥 내 토큰화, 즉 in-context tokenization이라고 부른다.
코드의 새 변수명과 함수명, 반복되는 문자나 숫자 조합에서도 이런 변화가 나타났다. 영어와 이탈리아어에 똑같이 쓰이는 글자도 뜻과 용법에 따라 서로 다른 단어와 묶였다. 청크를 정할 때 문자열의 등장 빈도와 함께 문맥도 영향을 준다는 뜻이다.
| 원문에서 관찰한 입력 | 청크의 변화 |
|---|---|
| 반복되는 낯선 단어 | 등장 횟수가 늘면서 더 적은 청크로 처리 |
| 반복되는 문장 형식 | 예측하기 쉬운 긴 구간을 더 크게 압축 |
| 코드의 공백과 줄바꿈 | 줄바꿈을 포함하는 청크도 생성 |
| 여러 바이트로 표현되는 문자 | 개선판에서 문자 및 언어적 단위에 더 적합하게 구분 |
DNA와 이미지에서도 처리 단위를 학습한다
DNA 실험은 A, C, G, T라는 염기 단위로 입력을 읽는 Transformer와 H-Net을 비교했다. H-Net의 목표 압축률은 6배였다. 세 평가 자료에서 같은 예측 손실을 얻는 데 Transformer는 H-Net보다 약 5.8배에서 7.1배의 연산량이 필요했다.3

DNA 다음 염기 예측의 스케일링 비교인 원문 Figure 13. 출처: Cartesia.
사람이 주석을 달아 가르치지 않았는데도 청크는 생물학적 단위를 반영했다. 원핵생물의 다음 염기 예측만 학습한 모델에 사람의 유전체를 제시하자, 단백질을 암호화하는 구간에서는 세 염기로 된 코돈에 맞는 청크가 나타났다. 인트론이나 반복 구간, tRNA 유전자에서는 서로 다른 처리 단위를 사용했다.
이미지 연구는 아직 진행 중이다. 연구진은 픽셀에서 직접 이미지를 생성하는 JiT 기반 모델의 주 네트워크를 다차원 H-Net으로 교체했다. 모델은 세부 묘사가 많은 영역, 노이즈 제거 단계, 이미지의 복잡도에 따라 계산을 다르게 배분했다. 전경의 물체 때문에 서로 떨어져 있는 배경 영역을 같은 청크로 처리하는 사례도 제시했다.
새 변수명에 적응하는 토큰화
나는 코드에서 반복되는 새 이름을 더 적은 청크로 처리한다는 사례를 특히 흥미롭게 읽었다. 고정 어휘 목록에 없는 이름도 지금 읽는 문맥을 통해 효율적으로 표현할 수 있기 때문이다. 학습에 없던 프로그래밍 언어에서 연산 효율 차이가 더 컸던 것도 이 적응력과 관련이 있을지 궁금하다. Cartesia는 후속 글에서 이런 분포 변화와 학습 효율의 관계를 더 자세히 분석하겠다고 예고했다.
출처
Cartesia Research, 2026년 10월. From Tokens to Bytes I: Scaling Hierarchical Networks.
평가 모음의 배수는 정답률이 그 배수로 증가했다는 뜻이 아니다. 정답에 대한 BPB 손실과 학습 연산량의 관계를 추정해 얻은 결과다. ↩︎
학습 데이터와 연산이 약 10분의 1로 줄었다는 결과는 2단계 H-Net과 SmolLM3를 특정 사전학습 조건에서 비교해 얻었다. H-Net의 학습 자료는 공개된 정보를 바탕으로 SmolLM3 첫 단계의 구성을 최대한 재현했다. SmolLM3의 전체 학습에는 세 단계의 자료 구성과 스케줄을 사용했다. 파라미터 수도 다르므로 이 글의 1단계 통제 실험과 구분해서 읽어야 한다. 실제 추론 속도를 10배 개선했다는 측정도 아니다. ↩︎
원문 본문은 6배에서 7배로 요약한다. 차트에서 곡선을 맞춰 추정한 값은 각각 5.95배, 5.83배, 7.06배다. 평가 자료에는 학습에 사용한 유전체의 다른 구간이 포함되므로, 새로운 유전체 전체에 대한 일반화와는 구분된다. ↩︎