3줄 요약
- 독일 율리히 연구소(Forschungszentrum Jülich)와 아헨 공대(RWTH Aachen) 연구진이 2025년 9월 Nature Computational Science에 발표한 논문이다. 생성형 트랜스포머가 토큰을 하나 만들 때마다 GPU는 KV 캐시 전체를 메모리에서 다시 읽어 온다. 논문에 따르면 지연과 에너지 소모는 계산보다 이렇게 반복되는 데이터 이동 때문에 더 크게 늘어난다. 연구진은 커패시터에 전하를 저장하는 게인 셀 배열이 KV 캐시를 저장하는 동시에 어텐션의 두 내적을 아날로그로 직접 계산하도록 설계했다.
- 아날로그 회로에는 비선형 곱셈, 커패시터 누설, 저정밀 양자화, 소프트맥스 대신 쓰는 HardSigmoid 같은 제약이 있다. 공개된 사전학습 모델은 이런 제약을 전제로 학습되지 않았다. 층마다 스케일 계수를 맞추는 적응 알고리즘 덕분에, 하드웨어 모델은 GPT-2를 처음부터 다시 학습시키지 않고도 공개 GPT-2와 비슷한 벤치마크 성적을 냈다. 정확도를 재는 6개 과제의 평균은 하드웨어 모델이 41.80%, 공개 GPT-2가 43.02%였다.
- 28nm 공정 회로 시뮬레이션으로 추산한 결과, 어텐션 헤드 하나가 토큰 하나를 처리하는 데 드는 에너지는 6.1nJ이고 지연은 65ns다. 비교 대상을 어텐션 연산으로 한정하면, 이 설계는 H100보다 100배 빠르고 에너지는 7만분의 1만 쓴다. 연구진이 칩을 실제로 제작한 것은 아니며, 이 수치는 모두 회로 시뮬레이션에서 나왔다.
토큰마다 KV 캐시를 다시 읽어 오는 비용
자기회귀 디코더는 토큰을 하나 생성할 때마다 그 토큰을 입력 시퀀스 끝에 붙여 다음 단계의 입력으로 삼는다. 이전 토큰들의 키(K)와 값(V) 투영을 매번 다시 계산하지 않으려고, 계산해 둔 투영을 메모리에 저장하고 새 토큰의 투영만 추가하는 방식이 KV 캐싱이다.
그런데 GPU에서 KV 캐싱을 쓰면 캐시를 읽어 오는 비용이 병목이 된다. GPU는 토큰마다 KV 캐시 전체를 고대역폭 메모리(HBM)에서 캐시 메모리인 SRAM으로 전송해야 한다. 게다가 KV 캐시는 대개 SRAM 용량보다 크다. 논문이 든 예로, Mistral 7B는 배치 크기가 1일 때도 KV 캐시 전체에 8Gb가 필요하다. 최근 반도체 공정에서는 데이터에 접근할 때 드는 에너지가 연산에 드는 에너지를 웃돈다. 그러다 보니 대형 언어 모델에서는 KV 캐시를 불러오기만 해도 지연이 길어지고 에너지 소모가 커진다.
알고리즘 차원의 대응은 이미 많이 나와 있다. 토큰 가지치기, 잠재 공간 KV 캐시 압축, 저랭크 근사, 여러 헤드가 같은 KV 쌍을 공유하는 그룹 쿼리 어텐션(GQA)이 메모리 요구량을 줄인다. Mamba처럼 계산량이 시퀀스 길이에 선형으로 비례하는 대안 아키텍처도 있지만, 논문은 대규모 학습에서는 트랜스포머가 여전히 더 안정적이라고 평가했다.
연구진은 하드웨어 설계로 이 병목을 해결하려 했다. 메모리 소자에서 직접 계산하는 인메모리 컴퓨팅(IMC)은 주로 선형층의 고정된 가중치를 비휘발성 메모리에 저장하는 용도로 연구되어 왔다. 하지만 KV 캐시는 입력에 따라 매 단계 새로 써야 하므로 요구 조건이 훨씬 까다롭다. 논문은 네 가지 요건을 꼽았다.
| 요건 | 필요한 이유 |
|---|---|
| 빠르고 에너지 효율적인 쓰기 | 생성 단계마다 KV 캐시를 갱신한다 |
| 높은 병렬성 | 추론 지연을 낮춘다 |
| 높은 메모리 밀도 | 큰 모델로 확장한다 |
| 긴 보존 시간 | 잦은 리프레시를 피한다 |
기존 구현은 이 조건을 모두 충족하지 못했다. DRAM은 병렬성이 제한되어 디지털 순차 가산기가 많이 필요하고, SRAM은 휘발성이며 밀도가 낮다. 비휘발성 메모리는 쓰기가 느리고 에너지가 많이 들며, 매 단계 새로 쓰는 데 필요한 내구성도 부족하다.
저장과 곱셈을 함께 처리하는 게인 셀
연구진이 고른 소자는 게인 셀(gain cell)이다. 게인 셀은 커패시터에 정보를 전하로 저장하고, 전용 읽기 트랜지스터가 커패시터 전압에 따라 전류를 만든다. DRAM과 달리 읽어도 저장값이 지워지지 않기 때문에 여러 셀을 동시에 읽는 병렬 연산이 가능하다. 게인 셀은 내구성이 높고, 쓰기가 빠르고, 쓰기 에너지가 낮으며, 여러 단계의 값을 저장할 수 있다.
IGZO나 ITO 같은 산화물 반도체 트랜지스터(OSFET)로 만든 게인 셀은 전원 없이도 몇 초 동안 상태를 유지한다. 작은 크기로 제작할 수 있어 SRAM보다 밀도가 높고, 3차원 적층도 가능하다.
이 설계에서 게인 셀 크로스바 배열은 KV 캐시를 저장하는 메모리이면서 어텐션을 계산하는 연산기다. 셀 하나는 커패시터를 충전하는 쓰기 단과, 입력과 저장 전압의 곱을 근사하는 곱셈 단으로 이뤄진다. 곱셈 단의 푸시풀 트랜지스터 쌍은 저장 전압에 따라 크기가 정해지는 아날로그 전류를 만든다. 이 전류는 입력 펄스가 들어오는 동안에만 공유 비트라인으로 흐른다. 여러 셀에서 나온 전류는 비트라인에서 키르히호프 법칙에 따라 합쳐진다. 따라서 비트라인에 흐르는 전류의 합이 내적 값이 된다.
연구진이 시뮬레이션한 실리콘 CMOS 게인 셀은 저장 전압이 지수적으로 감쇠하며, 그 시간 상수(보존 시간)는 5ms다.1
ADC 없이 아날로그로 계산하는 어텐션
어텐션은 쿼리 Q와 키 K의 내적으로 점수 S를 만들고, 활성화 함수 φ를 적용한 뒤 값 V와 다시 내적해 출력 A를 얻는다. 일반 트랜스포머에서 φ는 소프트맥스다.
$$S_i = Q_i \cdot K^{T}, \qquad A_i = \phi\left(\frac{S_i}{\sqrt{d}}\right) \cdot V$$아날로그 인메모리 연산에서 아날로그 디지털 변환기(ADC)는 전력을 많이 소비하고 면적도 크다. 그 때문에 아날로그로 계산해 얻은 이점이 상당 부분 줄어드는 경우가 많다. 연구진은 ADC를 쓰지 않고, 두 번의 내적과 스케일링과 활성화 함수까지 어텐션의 핵심 연산을 모두 아날로그 영역에서 처리했다. 과정은 네 단계다.
- 쿼리 Q를 펄스 폭 변조(PWM) 펄스로 인코딩해 첫 번째 배열에 입력한다. 이 배열에는 K가 저장되어 있으므로 Q와 K의 내적이 계산된다.
- 전하 펄스 변환 회로(charge-to-pulse circuit)는 첫 번째 배열에서 나온 전류를 적분한다. 이어서 이 회로는 누적된 전하에 비례하는 폭의 PWM 전압 펄스를 생성한다. 펄스 폭은 포화 임계값에 도달할 때까지 선형으로 늘어난다. 전하가 양수일 때만 펄스가 나오므로, 이 회로가 HardSigmoid 활성화 함수 역할도 한다.
- 이 펄스가 V를 저장한 두 번째 배열의 입력이 되어 φ(S)와 V의 내적이 계산된다.
- 부호를 처리하는 두 번째 전하 펄스 변환 회로가 두 번째 배열의 전류를 적분해, 양수와 음수 모두에 대해 펄스를 만든다. D 플립플롭이 결과의 부호를 저장하고, 16단계 디지털 카운터가 펄스 폭을 잰 뒤 부호 비트를 곱한다. 최종 정밀도는 32단계다.
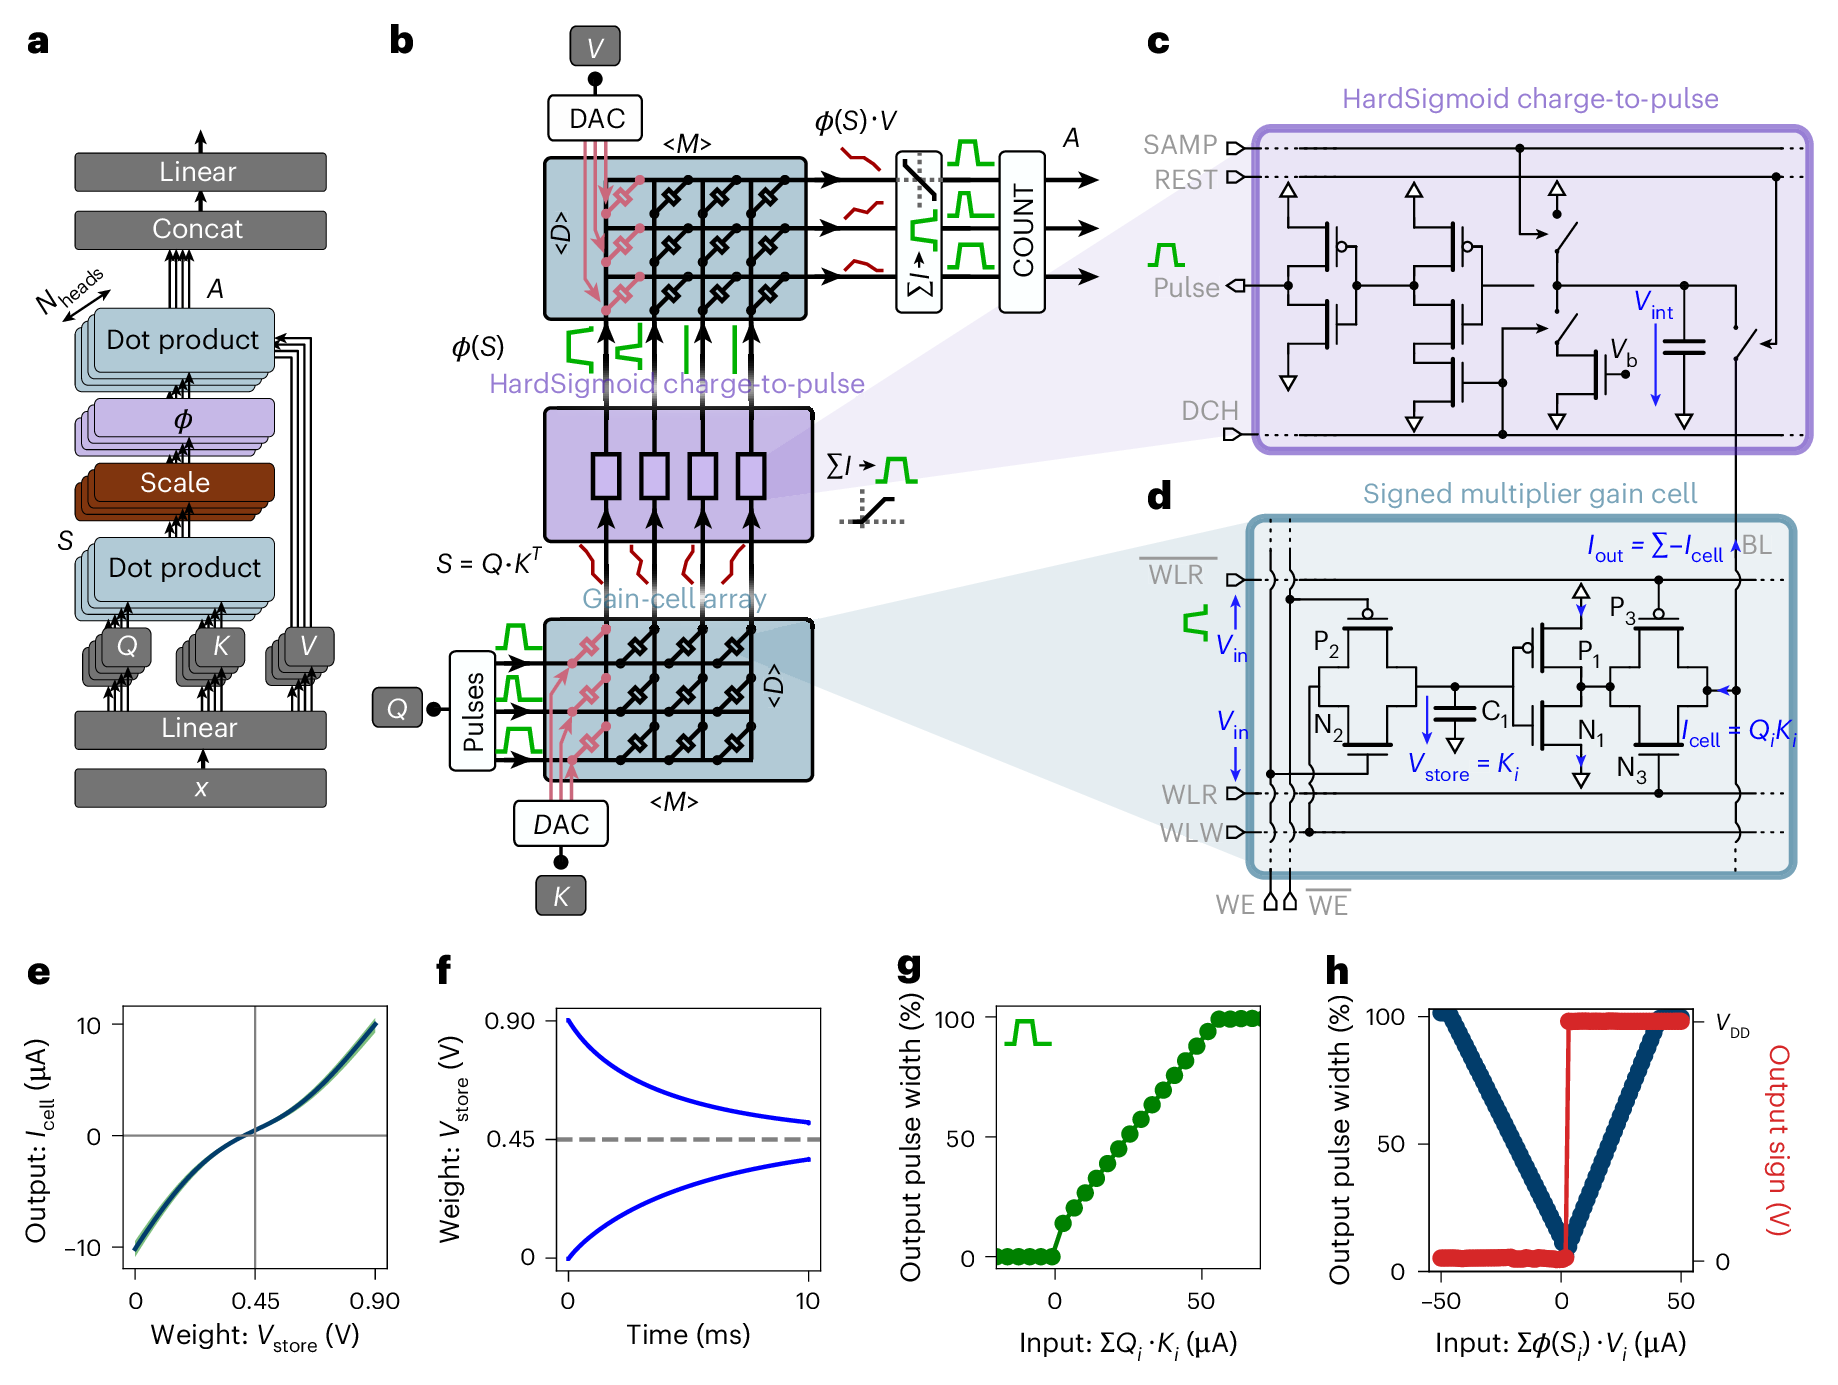 Fig. 1. 아날로그 하드웨어 어텐션의 구성 요소. 출처: Leroux et al., Nature Computational Science (2025), CC BY 4.0
소프트맥스 대신 HardSigmoid를 쓴 이유도 하드웨어 제약에 있다. 소프트맥스는 정규화를 위해 모든 입력 원소를 더해야 하므로 전역 연결이 필요하고, 그 하드웨어 복잡도는 시퀀스 길이에 비례해 증가한다. HardSigmoid는 원소별로 계산되므로 이런 연결이 필요 없다.2
슬라이딩 윈도와 쓰기 읽기 파이프라인
시퀀스가 아무리 길어져도 메모리 배열의 크기는 일정하게 유지해야 한다. 그래서 이 설계는 인과적이면서 국소적인 슬라이딩 윈도 어텐션을 쓴다. 메모리에는 가장 최근 토큰 M개의 키와 값만 유지하고, 그보다 오래된 토큰의 점수는 마스킹한다. 층 하나하나의 어텐션 범위는 국소적이어도 수용 영역(receptive field)은 층 수에 비례해 증가하므로, 층이 많은 신경망이라면 전역 정보도 포착할 수 있다고 한다.
추론 단계마다 두 배열에는 K와 V 행렬의 열이 하나씩 새로 기록된다. 배열의 열 M개는 이전 M개 토큰의 K와 V를 나타내고, 행은 임베딩 원소 d개를 나타낸다. M단계가 지나 모든 열이 채워지면 가장 오래된 첫 열부터 덮어쓴다.
한 추론 단계는 아래 순서로 진행된다.
- 5ns 동안 초기화 단계를 거친다.
- 3비트 DAC가 만든 10ns짜리 다단계 전압 펄스로 새 K와 V 벡터를 각 배열의 한 열에 기록한다.
- 이와 병렬로, 1GHz로 동작하는 4비트(16단계) 펄스 발생기가 쿼리 Q를 길이가 0ns에서 15ns 사이인 PWM 펄스로 인코딩한다.
- Q와 K의 내적을 계산하는 동안에는 V 배열이 쓰이지 않으므로, 그 시간에 V 배열에 새 값을 기록한다.
- V 쓰기가 끝나면 V 배열의 판독 회로를 초기화하고, 첫 번째 배열에서 나온 φ(S) 펄스를 V 배열에 입력한다.
- 카운터가 펄스 폭과 부호를 디지털 값으로 바꾸고, 디지털 가산기가 하위 타일들의 결과를 합산한다.
이렇게 쓰기와 읽기를 겹쳐 실행하면 어텐션 전체의 지연은 65ns로 추산된다.
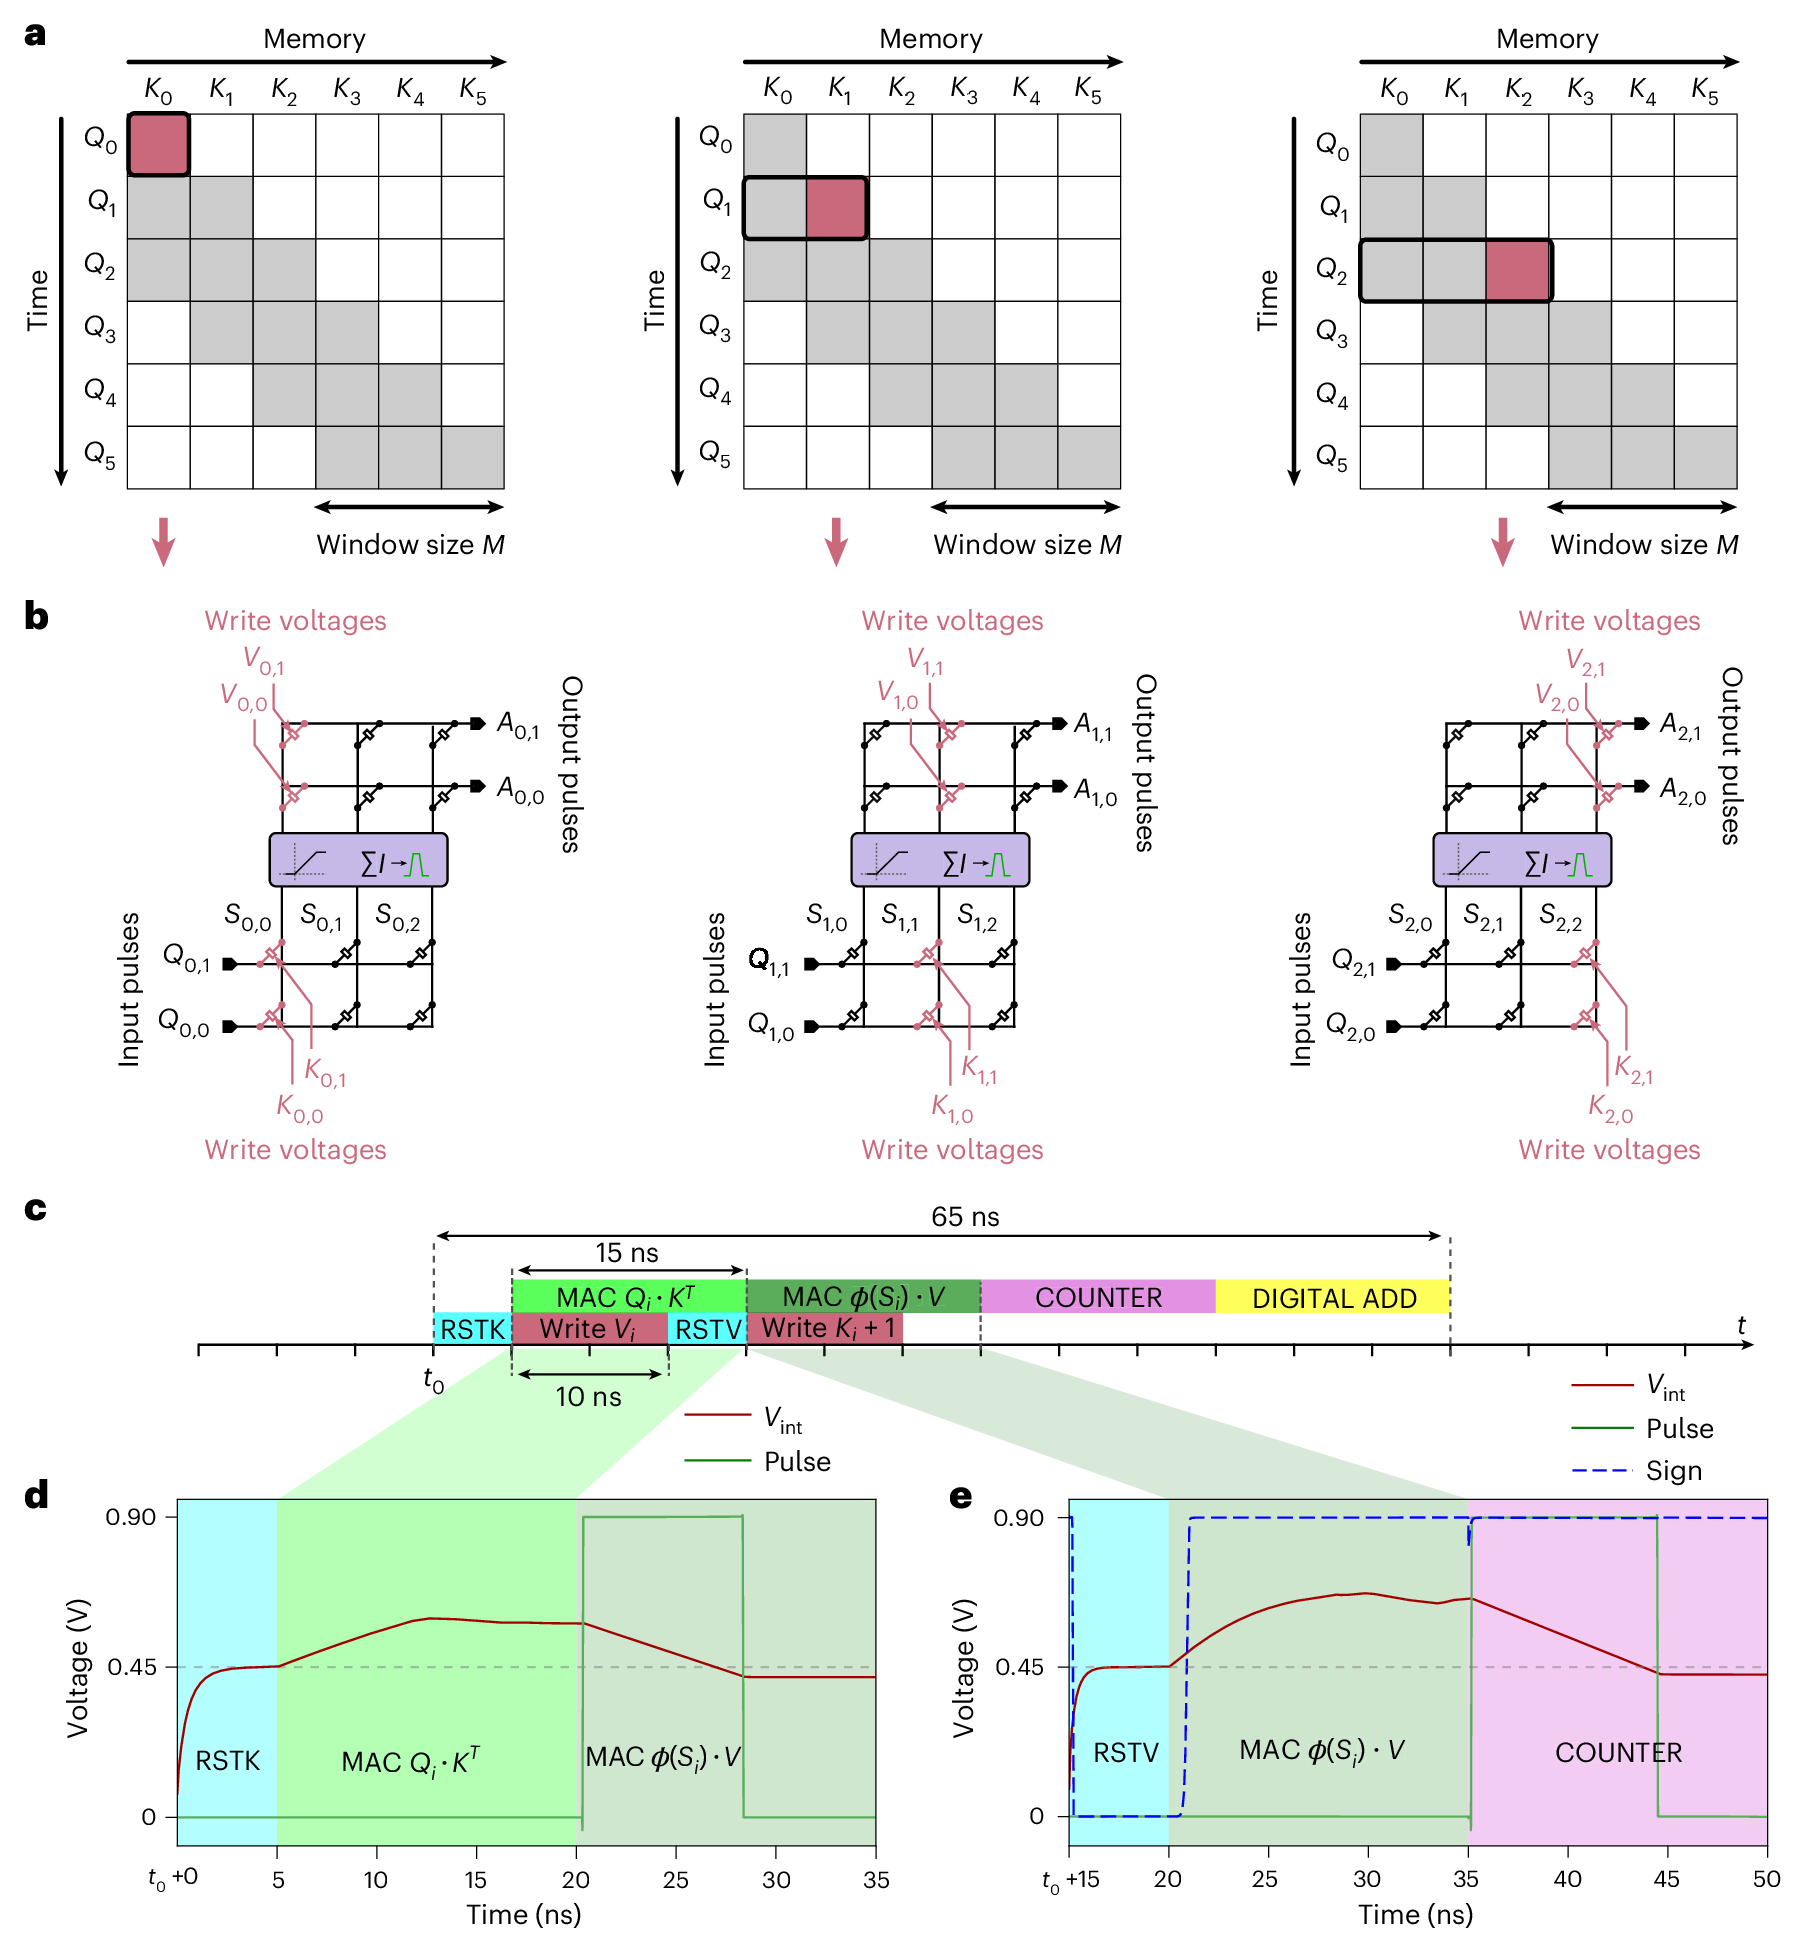 Fig. 2. 아날로그 하드웨어 어텐션 파이프라인. 출처: Leroux et al., Nature Computational Science (2025), CC BY 4.0
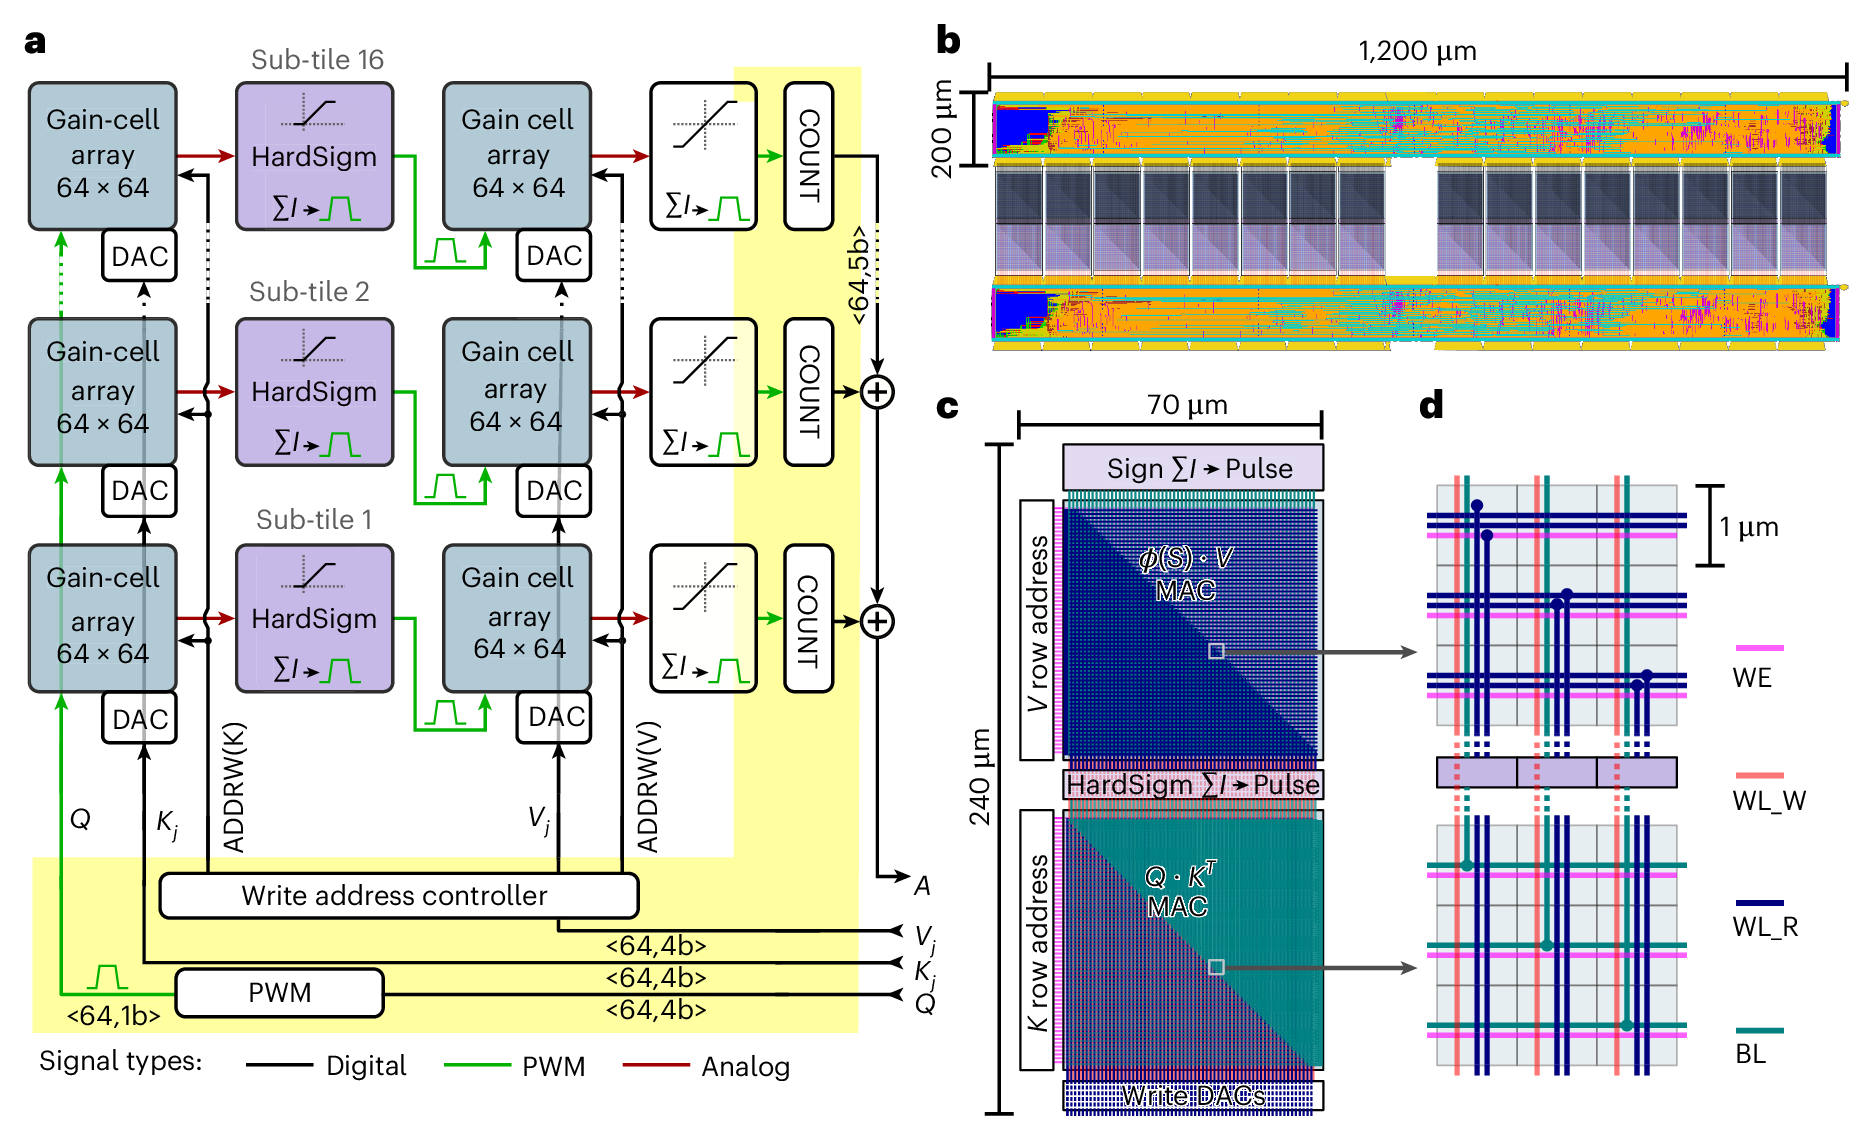
연구진은 배열 크기를 64×64로 제한했다. 큰 아날로그 크로스바에서는 배선 저항 손실로 생기는 IR 강하가 정확도를 떨어뜨리기 때문이다. 연구진이 구현한 GPT-2의 헤드 차원 d는 64이고 윈도 크기 M은 1,024다. 따라서 연구진은 헤드 하나의 KV 캐시를 16개 하위 타일로 분할했다. 각 하위 타일은 K와 V를 저장하는 64×64 배열 두 개와 전용 전하 펄스 변환 회로를 갖는다. 16개 타일은 모두 같은 Q를 병렬로 입력받고, 입력 16개짜리 디지털 가산기 64개가 타일별 결과를 합산한다. 이 글의 커버 이미지(논문 Fig. 3)가 이 구조의 블록도와 레이아웃이다.
하위 타일 수를 늘리면 최대 어텐션 범위도 늘어난다.3 대신 면적이 윈도 크기에 비례해 증가하고, 디지털 가산기마다 클록 한 사이클씩 지연이 추가된다.
사전학습 모델을 하드웨어에 맞추는 세 단계
이 하드웨어의 어텐션은 일반 트랜스포머와 여섯 가지가 다르다.
- 소프트맥스 대신 HardSigmoid를 쓴다.
- 인과적 어텐션 대신 슬라이딩 윈도 어텐션을 쓴다.
- 입력은 4비트, 저장된 투영은 3비트, 출력은 5비트로 양자화된다.
- 최종 합산 전에 게인 셀 배열을 하위 타일로 분할한다.
- 게인 셀의 입력과 저장 전압의 관계가 비선형이다.
- 커패시터 누설로 저장값이 시간에 따라 감쇠한다.
이 여섯 가지 차이를 그대로 둔 채로는 공개된 사전학습 가중치를 하드웨어 모델에 쓸 수 없다. 게다가 게인 셀의 비선형성은 3차 다항식으로 기술되므로, 비선형 모델을 직접 학습시키면 계산량과 메모리 요구량이 크게 늘어난다. 연구진은 적응 절차를 세 단계로 구성했다.
1단계는 선형 중간 모델의 미세조정이다. 내적은 이상적인 선형 연산으로 두고 나머지 하드웨어 제약은 모두 포함한 중간 모델을 만든다. 공개 GPT-2 가중치에서 출발해 OpenWebText로 다음 단어 예측을 학습시키자, 이 중간 모델은 3,000회 미만의 반복으로 공개 GPT-2와 대등한 퍼플렉시티에 도달했다. 처음부터 학습시킨 모델은 같은 수준에 도달하는 데 13,000회 이상 걸렸다. 연구진은 HardSigmoid를 쓰는 등 구조가 다른 모델이어도 가중치 전이가 효율적이라는 근거로 이 결과를 제시했다.
2단계는 비선형 모델로의 적응이다. 선형 중간 모델의 가중치를 게인 셀 비선형성까지 포함한 최종 하드웨어 모델로 전이한다. 층마다 통계가 달라 한 번의 피팅으로 비선형성을 보정하기 어렵기 때문에, 연구진은 선형 변환 y = ax + b를 도입했다. 연구진은 Q, K, V 투영과 어텐션 출력에 각각 스케일 계수 a와 b를 두고, 헤드와 층별로도 별도의 계수를 적용한다. 적응 알고리즘은 먼저 선형 모델에서 각 스케일링 단 출력의 평균과 표준편차를 대량의 표본으로 측정한다. 그다음 비선형 모델의 같은 단에서 평균과 표준편차를 측정해, 두 모델의 통계가 같아지도록 a와 b를 반복해서 갱신한다.
$$a \leftarrow a\,\frac{\sigma_{L}}{\sigma_{NL}}, \qquad b \leftarrow b + \left(\mu_{L} - \mu_{NL}\right)$$반복은 두 모델의 표준편차 차이와 평균 차이가 모두 0.0001 미만이 될 때까지 계속된다. 이 단계에서 비선형 게인 셀 모델의 퍼플렉시티는 1,757에서 21로 떨어졌다. 보충 자료에는 같은 알고리즘이 다른 종류의 곱셈 비선형성에도 일반화된다는 결과가 수록되어 있다.
3단계는 비선형 모델의 미세조정이다. 적응을 마친 비선형 모델을 역전파로 다시 미세조정해 성능을 추가로 개선한다.
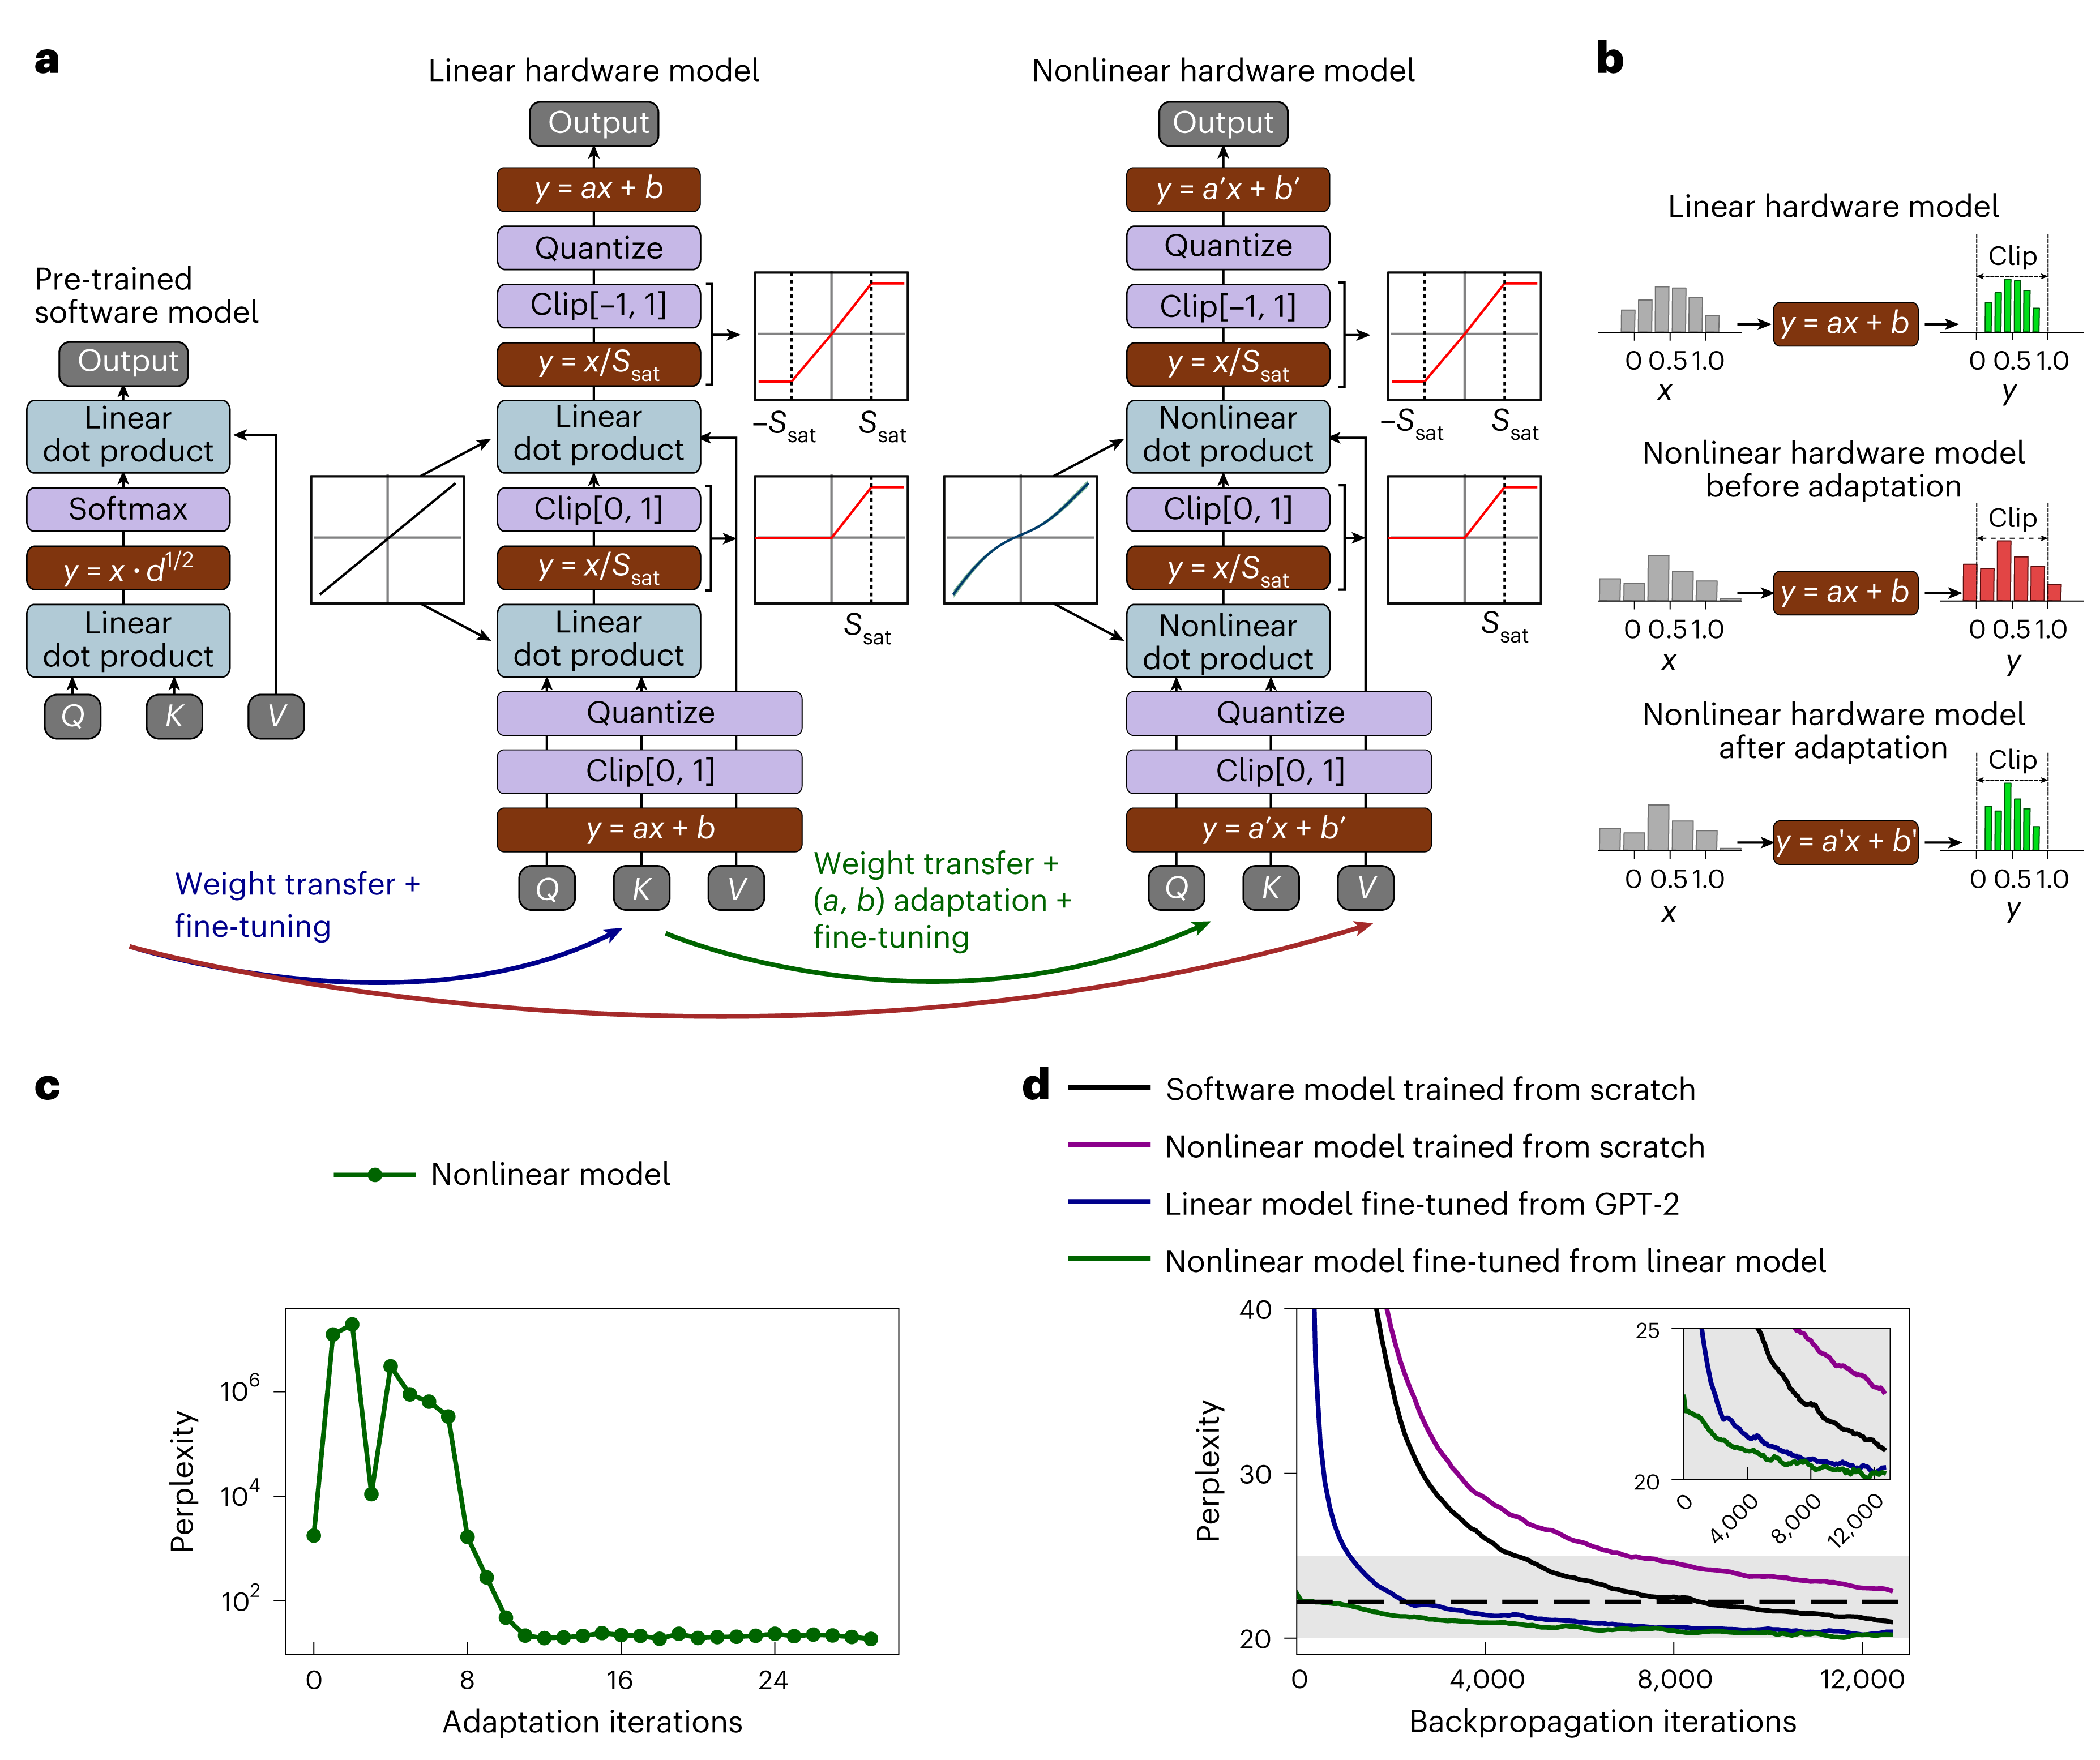 Fig. 4. 하드웨어 모델 적응과 학습. 출처: Leroux et al., Nature Computational Science (2025), CC BY 4.0
학습 시뮬레이션은 커패시터 누설도 모델링한다. 저장값은 지수적으로 감쇠한다. 연구진은 시간 상수 5ms, 어텐션 지연 65ns, 층 수 12를 넣어 단계당 감쇠 계수를 약 1.6×10⁻⁴(0.00016)로 정했다. 실제 트랜스포머에서는 피드포워드 층 같은 다른 모듈의 지연이 더해져 층당 지연이 65ns보다 길어진다. 그래도 OSFET 게인 셀에서 보고된 시간 상수는 이보다 1,000배 길기 때문에, 이 감쇠 계수는 매우 보수적으로 정한 값이라고 한다. 학습 속도를 높이기 위해 연구진은 하드웨어 시뮬레이션을 Triton으로 FlashAttention 알고리즘의 변형에 통합했고, 그 결과 학습 지연이 5분의 1로 줄었다.
GPT-2와 GPT-2-XL 벤치마크
연구진은 소프트웨어 기준 모델 두 개와 하드웨어 모델 세 개를 7개 언어 과제로 평가했다.4 아래 표는 논문 Table 1에서 LAMBADA, WikiText-2와 전체 평균을 발췌했다. 정확도는 높을수록, 퍼플렉시티는 낮을수록 좋다.
| GPT-2 (1억 2,400만 파라미터) | LAMBADA 퍼플렉시티 | LAMBADA 정확도(%) | WikiText-2 퍼플렉시티 | 평균 정확도(%) | 평균 퍼플렉시티 |
|---|---|---|---|---|---|
| 공개 GPT-2 | 35.15 | 45.96 | 37.37 | 43.02 | 36.26 |
| 처음부터 학습한 소프트웨어 모델 | 46.39 | 41.56 | 41.25 | 41.46 | 43.82 |
| 선형 하드웨어 모델 | 51.69 | 38.10 | 39.79 | 41.38 | 45.74 |
| 비선형 하드웨어 모델 (적응만) | 76.59 | 31.61 | 42.34 | 39.79 | 59.47 |
| 비선형 하드웨어 모델 (적응과 미세조정) | 43.08 | 40.16 | 39.97 | 41.80 | 41.52 |
적응과 미세조정을 모두 거친 비선형 하드웨어 모델은 평균 정확도 41.80%로 공개 GPT-2의 43.02%에 근접했고, 같은 조건으로 처음부터 학습시킨 소프트웨어 모델의 41.46%와 같거나 높은 성적을 냈다.5 미세조정을 생략해도 대부분의 과제에서 결과가 거의 같았다. 미세조정의 효과가 뚜렷하게 드러난 과제는 LAMBADA와 WikiText-2뿐이었고, LAMBADA 퍼플렉시티는 미세조정 전 76.59에서 미세조정 후 43.08로 개선됐다.
| GPT-2-XL (15억 파라미터) | LAMBADA 퍼플렉시티 | LAMBADA 정확도(%) | WikiText-2 퍼플렉시티 | 평균 정확도(%) | 평균 퍼플렉시티 |
|---|---|---|---|---|---|
| 공개 GPT-2-XL | 9.68 | 63.87 | 20.38 | 55.12 | 15.03 |
| 처음부터 학습한 소프트웨어 모델 | 14.82 | 56.33 | 24.98 | 50.15 | 19.90 |
| 선형 하드웨어 모델 | 12.32 | 58.54 | 23.26 | 51.92 | 17.79 |
| 비선형 하드웨어 모델 | 12.17 | 59.48 | 22.29 | 51.69 | 17.23 |
모델 규모를 늘려도 같은 결과가 나오는지 확인하려고, 연구진은 GPT-2-XL에도 GPT-2와 같은 학습 설정을 적용했다. 비선형 하드웨어 모델의 평균 정확도 51.69%는 공개 체크포인트의 55.12%에 조금 못 미쳤다. 하지만 작은 GPT-2 기준선보다는 확실히 높았고, 처음부터 학습한 소프트웨어 GPT-2-XL의 50.15%와는 대등했다. 남은 격차에 대해 연구진은 하드웨어의 한계라기보다 학습 반복 횟수가 달라서 생긴 차이로 본다. 공개 모델이 몇 번의 반복으로 학습되었는지는 공개되지 않았다.
회로 정확도와 에너지, 지연
연구진은 두 내적을 각각 64×64 배열 하나와 전하 펄스 변환 회로 64개로 SPICE 시뮬레이션했다. 이어서 이 결과를 신경망 시뮬레이션에 사용한 모델의 예측과 비교했다.6 아래 Fig. 5의 a와 b가 그 비교다. 첫 번째 내적의 SPICE 결과는 모델 예측보다 전반적으로 조금 높고, 두 번째 내적의 결과는 대각선에 가깝게 분포한다.
어텐션 헤드 하나가 토큰 하나를 처리하는 데 드는 에너지를 구성 요소별로 집계하면 아래 표와 같다.
| 구성 요소 | 토큰당 에너지 |
|---|---|
| 첫 번째 내적 (게인 셀 배열과 전하 펄스 변환 회로) | 1,120pJ |
| 두 번째 내적 | 700pJ |
| 디지털 제어와 라우팅 (전력 113.7mW) | 4nJ |
| DAC | 330pJ |
| 합계 | 6.1nJ |
두 번째 게인 셀 배열은 입력인 φ(S)가 더 희소해서 흐르는 전류가 적고, 그만큼 에너지도 덜 든다. 전체 에너지의 절반 이상은 아날로그 연산이 아닌 디지털 제어와 라우팅에서 소비된다.
GPU 세 종과의 비교도 어텐션 연산에 한정했다.7
| 비교 대상 | 속도 향상 | 에너지 절감 |
|---|---|---|
| Nvidia Jetson Nano (임베디드용) | 7,000배 | 40,000배 |
| Nvidia RTX 4090 (소비자용) | 300배 | 90,000배 |
| Nvidia H100 (데이터센터용) | 100배 | 70,000배 |
논문의 초록과 서론은 이 결과를 서로 다른 배수로 요약했다.8
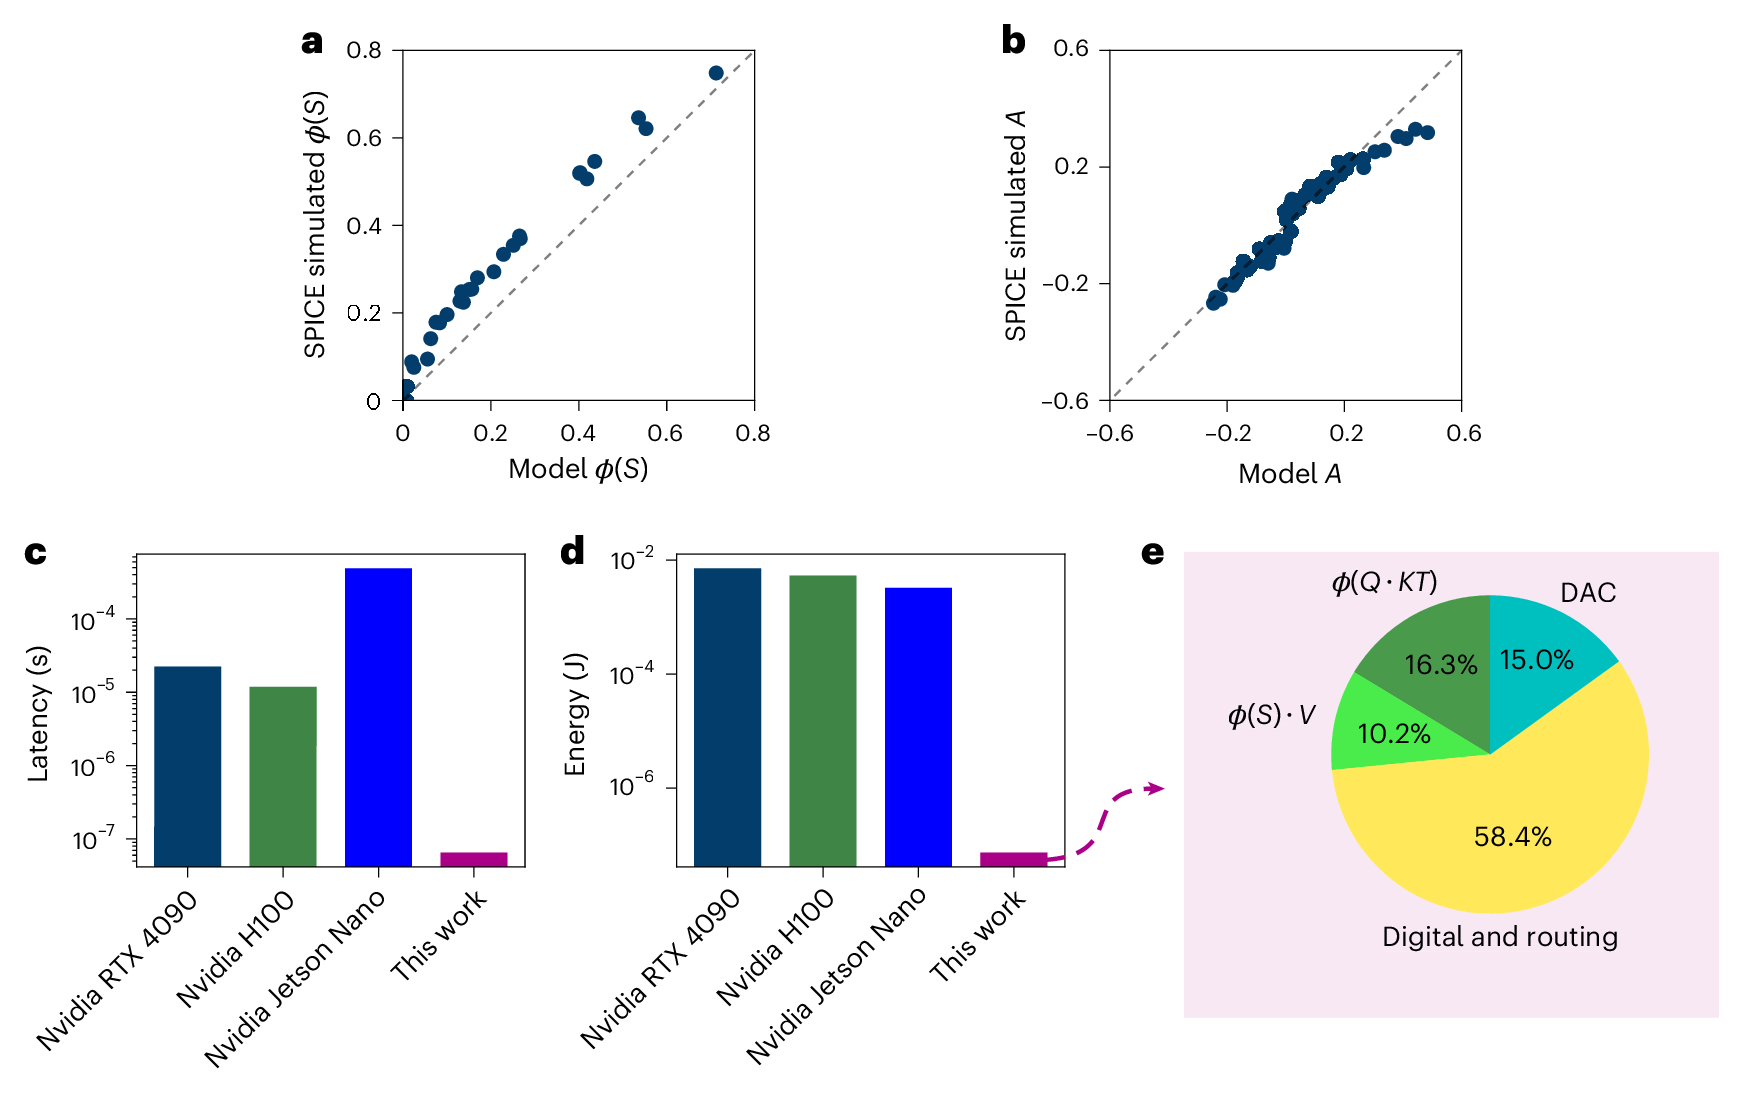 Fig. 5. 아날로그 하드웨어 어텐션의 정확도와 성능. 출처: Leroux et al., Nature Computational Science (2025), CC BY 4.0
면적
면적 추정은 ITO 게인 셀을 전제로 한다. ITO는 게인 셀 면적을 크게 줄인 새로운 OSFET 기술로, 트랜지스터 두 개짜리 ITO 게인 셀은 약 370nm×370nm, 즉 0.14μm²를 차지한다. 연구진은 이 연구들을 근거로 자신들이 설계한 트랜지스터 6개짜리 셀의 면적을 최악의 경우 1μm²로 추정했다. CMOS 쓰기 트랜지스터를 쓴 게인 셀과 비교하면 면적이 19분의 1로 줄어든다.
- 디지털 제어 회로를 포함한 어텐션 헤드 하나의 면적은 0.5mm²(500×10⁻³mm²)다.
- 다른 연구에서 보고된 더 작은 게인 셀을 기준으로 하면, 디지털 제어를 제외하고 GPT-2 어텐션 헤드 하나의 KV 캐시에 필요한 게인 셀 크로스바 면적은 약 0.0157mm²(15.7×10⁻³mm²)다.
- 게인 셀을 N층으로 3차원 적층하면 디지털 제어를 제외한 면적은 (36.7/N)×10⁻³mm²가 된다. N이 1이면 36.7×10⁻³mm², 4면 9.2×10⁻³mm², 8이면 4.6×10⁻³mm², 12면 3.1×10⁻³mm²다.9
여러 어텐션 헤드는 칩 위에 병렬 타일로 배치하거나 여러 층으로 쌓아, 주변 회로와 디지털 로직을 공유할 수 있다고 연구진은 덧붙였다.
논문이 밝힌 한계
- GPT-2-XL 규모의 하드웨어 모델은 기준 모델보다 성능이 조금 낮다. 연구진은 값을 일정 범위로 제한하는 클램핑 때문에 생기는 기울기 소실 문제를 완화할 방법이 있어야 더 깊은 신경망을 학습시킬 수 있다고 보았다.
- 실제 칩으로 검증하는 단계가 남아 있다. 적응 알고리즘을 쓰면 학습 대부분을 소자별 비선형 모델 없이 진행할 수 있으므로, 실제로 측정한 소자에도 이 방법을 적용할 수 있다고 연구진은 주장했다.
- 이 연구는 어텐션만 다룬다. 전체 에너지를 크게 줄이려면 모든 구성 요소를 최적화해야 하고, 연구진은 앞으로 선형층을 저전력으로 구현하는 다른 IMC 기술과 결합하겠다고 밝혔다.
- 모델이 커져도 KV 캐시는 전체 파라미터 수만큼 빠르게 늘지 않는다. OSFET 3차원 적층까지 활용하면 더 큰 신경망에도 과하지 않은 면적으로 이 설계를 적용할 수 있을 것으로 연구진은 기대했다.
누설을 결함으로만 다루지 않는 설계
커패시터 누설은 아날로그 메모리의 약점이다. 저장값이 시간에 따라 감쇠하므로 보통은 리프레시로 막아야 하는 결함으로 취급된다. 그런데 이 논문은 감쇠를 감쇠 마스크 형태로 학습 시뮬레이션에 포함했고, 저장된 키와 값이 약해지는 현상이 신경망 성능을 반드시 해치지는 않는다고 적었다. 딥러닝에는 지수 감쇠 마스크로 메모리 구조를 개선하는 기법이 이미 여럿 있다. 연구진은 보충 자료에서 KV 쌍의 감쇠와, 토큰 사이 거리에 비례하는 음의 편향을 어텐션 점수에 더하는 ALiBi의 관계를 따로 분석했다.
나는 이 대목이 가장 의외였다. 알고리즘 연구에서는 오래된 토큰의 영향을 줄이는 편향을 일부러 설계해 넣는데, 이 하드웨어에서는 소자의 물리 현상인 전하 누설이 비슷한 효과를 낼 수도 있다는 뜻이기 때문이다.
소프트맥스를 HardSigmoid로 바꾼 선택도 비슷한 경우다. 시그모이드 어텐션이 소프트맥스와 대등하다는 선행 연구가 있었기 때문에, 연구진은 전역 합산 회로 없이 전하 펄스 변환 회로 하나로 활성화 함수를 구현할 수 있었다. 이 논문은 하드웨어를 모델에 맞추는 동시에 모델도 하드웨어에 맞게 바꾸고, 적응 알고리즘은 그렇게 바뀐 모델을 처음부터 다시 학습시키지 않고 쓸 수 있게 해 준다.
출처
Nathan Leroux, Paul-Philipp Manea, Chirag Sudarshan, Jan Finkbeiner, Sebastian Siegel, John Paul Strachan, Emre Neftci. “Analog in-memory computing attention mechanism for fast and energy-efficient large language models.” Nature Computational Science 5권 9호, 813-824쪽 (2025). 2025년 9월 8일 온라인 게재. 저자 소속은 Forschungszentrum Jülich(PGI-14, PGI-15)와 RWTH Aachen 전기공학부다.
오픈 액세스 논문이며 CC BY 4.0 라이선스로 공개되었다. 이 글의 그림은 원문에서 가져와 가장자리에 흰 여백만 추가했다.
원문: https://www.nature.com/articles/s43588-025-00854-1
논문은 OSFET 기반 게인 셀이 이보다 몇 자릿수 긴 보존 시간을 낼 수 있다고 덧붙였다. ↩︎
논문이 인용한 선행 연구에 따르면 시그모이드 기반 어텐션은 70억 파라미터 규모 모델까지 소프트맥스 어텐션과 대등한 성능을 냈다. 슬라이딩 윈도 어텐션에서는 소프트맥스의 정규화가 기억 소실을 일으키고, 시그모이드 기반 어텐션이 정보를 더 잘 보존한다는 연구도 함께 인용했다. ↩︎
슬라이딩 윈도 어텐션의 최대 어텐션 범위는 L(M − 1) + 1이다. L은 층 수, M은 윈도 크기다. ↩︎
평가 과제는 ARC-Easy, ARC-Challenge, WinoGrande, HellaSwag, LAMBADA, PIQA, WikiText-2다. 각 평가 결과는 표본 4,000개의 평균이다. 표의 평균 정확도는 정확도를 보고하는 6개 과제의 평균이고, 평균 퍼플렉시티는 LAMBADA와 WikiText-2의 평균이다. WikiText-2 퍼플렉시티는 원문 텍스트의 단어 수로 정규화한 값이다. ↩︎
공개 GPT-2를 제외한 모든 모델은 같은 반복 횟수로 학습한 뒤 평가했다. 선형 하드웨어 모델은 13,000회 학습했고, 적응만 거친 비선형 모델은 이 13,000회 선형 모델을 미세조정 없이 적응 알고리즘으로 변환했다. 적응과 미세조정을 모두 거친 모델은 3,000회 학습한 선형 모델을 적응시킨 뒤 10,000회 미세조정했다. ↩︎
SPICE 시뮬레이션은 Cadence Virtuoso 환경에서 TSMC 28nm 공정 설계 키트(PDK)로 수행했다. 배열 원소마다 기생 배선 커패시턴스 0.8fF와 직렬 저항 2Ω을 포함했다. 윈도 크기 1,024인 헤드 전체의 에너지와 지연은 하위 타일 하나의 측정값에 16을 곱해 외삽했다. ↩︎
GPU 측정에는 FlashAttention-2를 썼고, 연구진은 12개 어텐션 헤드로 토큰 1,024개를 자기회귀 방식으로 생성하는 실험을 10회 실행해 평균했다. 지연과 전력은 Nvidia-SMI 파이썬 API로 측정했고, 추론 전에 측정한 정적 전력을 뺐다. 이 하드웨어가 선형 투영을 구현하지 않으므로 GPU 측정에서도 선형 투영은 제외했다. ↩︎
초록은 GPU 대비 지연을 최대 10²배(100배), 에너지를 최대 10⁴배(1만 배) 줄인다고 요약했고, 서론의 기여 목록은 에너지 10⁵배(10만 배), 지연 10²배(100배)라고 적었다. 본문이 보고한 에너지 절감은 4만에서 9만 배이고, Jetson Nano 대비 속도 향상은 7,000배다. ↩︎
3차원 적층 식에서 N이 1일 때의 값 36.7×10⁻³mm²는 앞 항목의 15.7×10⁻³mm²보다 크다. 논문은 두 값의 관계를 따로 설명하지 않는다. Methods에 따르면 3차원 적층 계산은 양수용과 음수용 셀 두 개로 이뤄진 부호 있는 게인 셀(0.28/N μm²)을 기준으로 한다. ↩︎