3줄 요약
- 메이지대학의 노토미 유스케와 도쿄대학의 마쓰무라 겐타로, 도바타 시게토가 2026년 9월 24일 bioRxiv에 프리프린트를 공개했다1. 이들은 같은 이름의 오픈소스 소프트웨어 AMADEUS도 함께 배포했다. AMADEUS는 실험실에서 촬영한 영상 속 여러 동물을 몸에 표식을 붙이지 않고 추적하며, 학습용 라벨을 사람이 달 필요가 없다. 결과로는 시간에 따른 개체 번호, 몸을 감싸는 회전 경계 상자, 머리 방향을 출력한다.
- AMADEUS는 혼자 떨어져 걷는 개체의 모습을 영상에서 오려 내고, 그 개체가 걸어간 방향으로 머리 방향 라벨을 자동으로 붙인다. 오려 낸 개체들을 서로 겹치게 붙여 넣어 교차와 밀집 장면을 합성하고, 이 합성 이미지 1만 장으로 YOLO 탐지기를 학습한다. 사용자는 배경과 동물이 구분되도록 분할 설정을 조정하고, 질문 세 개에 답하기만 하면 된다.
- 연구진은 쥐 10마리, 은어 10마리, 딱정벌레 32마리, 개미 32마리와 귀뚜라미 1마리, 초파리 60마리, 개미 368마리를 각각 촬영한 영상 여섯 편으로 성능을 비교했다. MOTA, HOTA, IDF1 세 지표에서 AMADEUS의 점수는 유효한 출력을 낸 비교 도구보다 모두 높았다. 비교 대상인 DeepLabCut과 SLEAP을 학습시키려고 연구진이 손으로 표시한 키포인트는 약 78,720개였다. AMADEUS를 쓰려면 영상에 혼자 떨어진 개체가 충분히 나와야 하고, 동물이 대개 머리가 향한 방향으로 걸어야 한다. 저자들도 논의에서 이 두 가지를 한계로 꼽았다.
기존 추적 도구의 한계
동물 행동 연구에서 사회적 상호작용을 재려면 여러 개체를 동시에 추적하면서 각 개체가 누구인지 끝까지 유지해야 한다. 지금까지는 색 표지나 물리적 태그를 붙여 개체를 구분하는 방법이 흔했다. 표식이 보이는 동안에는 개체를 확실하게 구분할 수 있다. 그러나 표식은 가려지거나 떨어지기도 하고, 동물의 행동을 바꿀 수도 있다. 개체 수가 많거나 몸이 아주 작으면 한 마리씩 표식을 붙이는 작업부터 쉽지 않다.
표식 없이 추적하는 기존 도구들은 방식마다 어려운 점이 있었다.
| 방식 | 대표 도구 | 어려운 점 |
|---|---|---|
| 전경 분할로 개체를 찾는 방식 | FastTrack, idtracker.ai, TRex, UDMT, UMATracker | 동물끼리 겹치거나 교차하면 분할된 덩어리 하나에 여러 마리가 들어가 개체를 식별하기 어려워진다. |
| 딥러닝 객체 탐지기 | YOLO 등 | 분할 없이 개체를 직접 찾지만, 지도 학습에 사람이 단 라벨이 많이 필요하다. |
| 자세 추정 | DeepLabCut, SLEAP | 몸의 여러 지점을 정밀하게 추정하지만, 이 도구들도 사람이 단 키포인트 라벨로 학습해야 한다. |
논문은 위치와 개체 번호만으로는 사회적 행동을 분석하기에 부족하다고 지적했다. 머리와 꼬리 두 지점만 알아도 어느 방향에서 접근했는지, 두 개체가 같은 방향을 보는지를 잴 수 있다. 라벨이 필요 없는 기존 도구 가운데 FastTrack과 TRex는 이런 기본 자세 정보도 계산하지만, 분할된 덩어리를 바탕으로 계산하기 때문에 서로 붙어 있는 개체의 자세는 구하지 못한다.
사용자가 설정하는 것
AMADEUS는 그래픽 사용자 인터페이스(GUI)로 동작한다. 영상을 불러오면 사용자는 실시간 미리보기를 보면서 전경 분할을 설정한다. 분할 방식은 다섯 가지다. 배경 차분, 어두운 영역 임계값, 밝은 영역 임계값을 각각 쓰는 방식이 있고, 배경 차분 결과와 어두운 영역 마스크의 교집합을 쓰는 방식, 배경 차분 결과와 밝은 영역 마스크의 교집합을 쓰는 방식이 있다. 이어서 덩어리 면적의 사분위 범위(IQR) 임계값을 조정해, 혼자 떨어진 개체는 파란색으로, 서로 붙은 개체나 조각난 덩어리는 주황색으로 표시되게 맞춘다. 논문에 따르면 사람이 매개변수를 직접 조정하는 단계는 이 전경 분할 하나뿐이다.
분할을 마치면 질문 세 개에 답한다.
| 질문 | 답에 따라 달라지는 처리 |
|---|---|
| 동물이 뒤로 걷는 일이 있는가 | “예"라고 답하면 잘못 붙은 머리 방향 라벨을 걸러 내는 탐지기를 따로 학습한다. |
| 겹침이 얼마나 심한가 | Light, Heavy, Very heavy 중에서 고른다. 합성할 때 허용하는 최대 겹침 면적은 Light가 붙여 넣는 개체 면적의 0.2배, Heavy와 Very heavy가 0.5배다. Very heavy를 고르면 보정 단계에서 대조 학습으로 개체 번호를 검증한다. |
| 영상에 몇 마리가 있는가 | 추적에 쓰는 개체 번호의 개수를 이 값으로 고정한다. |
그다음부터는 라벨 생성, 합성 데이터 구성, 탐지기 학습, 탐지, 추적이 일괄 처리로 자동 진행된다. 공식 사이트는 이 단계에서 “AMADEUS가 처리하는 동안 휴식을 취하라"고 안내한다. 처리가 끝나면 결과 영상과 CSV를 확인하고, 남은 오류는 Refinement 화면에서 손으로 고칠 수 있다.
합성 이미지로 학습 데이터 만들기
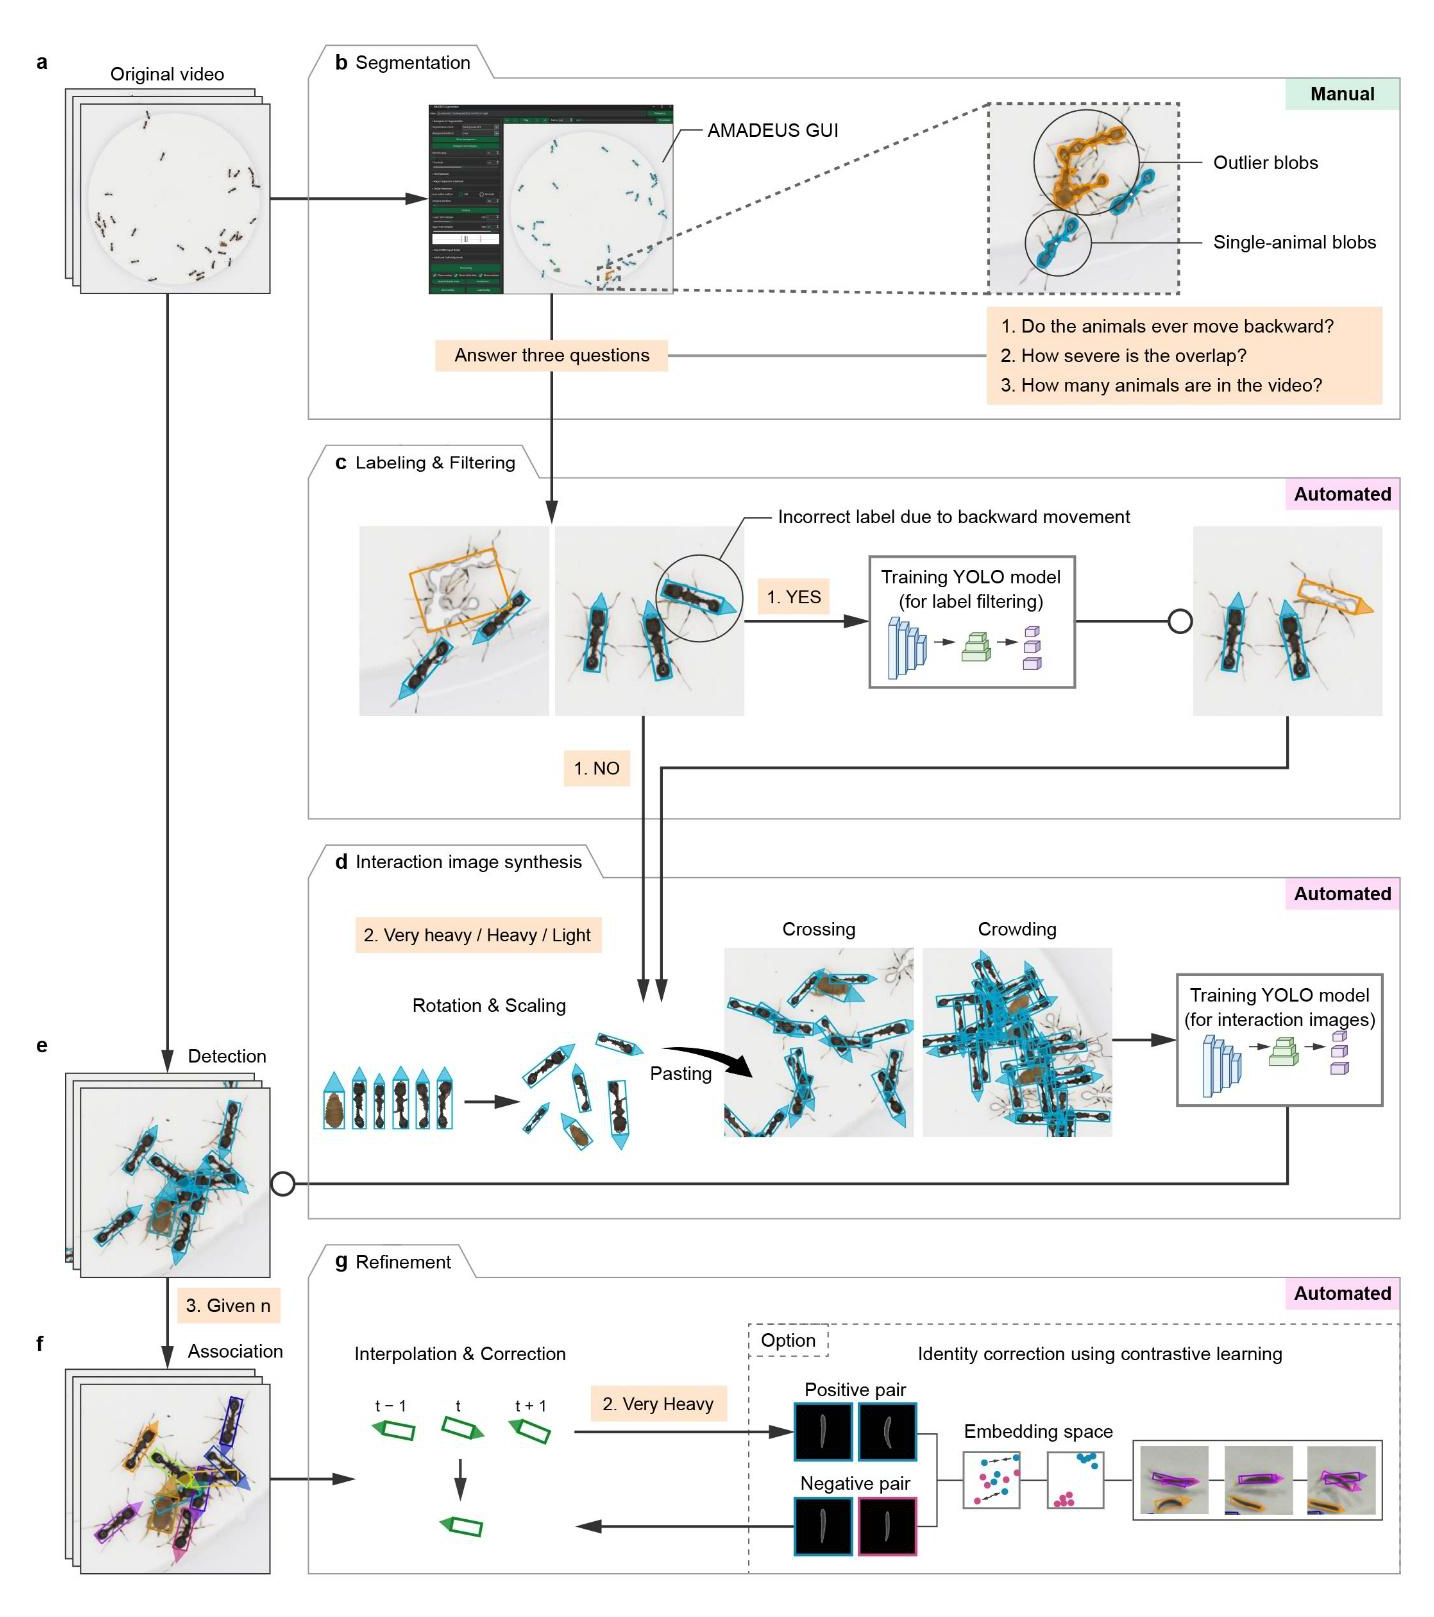 그림 1. AMADEUS의 처리 흐름. 개미 32마리와 귀뚜라미 1마리 영상을 예로 들었다. (b) 수동 설정 단계인 전경 분할에서 하늘색은 단일 개체 덩어리, 주황색은 이상치 덩어리다. (c) 이동 방향을 기준으로 머리 방향 라벨을 붙이고, 개체가 뒤로 걸어서 잘못 붙은 라벨은 걸러 낸다. 동그라미가 잘못 붙은 라벨이다. (d) 개체를 회전하고 크기를 바꿔 붙여 넣어 교차와 밀집 장면을 합성한다. (e)부터 (g)까지는 합성 이미지로 학습한 탐지기로 탐지하고, 시간 순서로 연결한 뒤 보정하는 단계다. 출처: Notomi, Matsumura & Dobata, bioRxiv (2026), CC BY-NC 4.0
학습 데이터는 다섯 단계를 거쳐 만들어진다.
- 단일 개체 덩어리 고르기. 전경 픽셀이 이어진 덩어리 가운데 면적이 한 마리 범위에 드는 것만 남긴다. 여러 마리가 붙어 있는 덩어리, 몸 일부만 잡힌 조각, 먼지나 반사는 이상치로 분류하고, 학습 이미지에서는 이 부분을 지워 배경으로 바꾼다.
- 머리 방향 라벨 붙이기. 덩어리마다 회전 경계 상자(OBB)를 맞추고, 연속 프레임에서 덩어리 중심이 이동한 방향으로 머리 방향을 정한다. 방향은 위, 왼쪽 위, 왼쪽처럼 45° 간격의 여덟 클래스로 표시한다. 객체 탐지기의 클래스 라벨은 원래 물체의 종류를 나타내는데, AMADEUS는 이 라벨로 머리 방향을 표시한다. 이동 거리가 짧아 방향을 신뢰하기 어려운 덩어리는 이상치로 분류한다.
- 틀린 라벨 걸러 내기. 동물이 뒤로 걸으면 이동 방향과 머리 방향이 반대가 된다. 첫 번째 질문에 “예"라고 답했다면, 단일 개체 이미지만으로 YOLO OBB 탐지기를 5 에포크 학습시키고 이 탐지기의 예측과 어긋나는 라벨에 표시를 남긴다. 연속 구간에서 표시된 덩어리가 40% 이상이면 그 구간 전체를 학습 데이터에서 제외한다. 이 탐지기는 라벨을 거르는 데만 쓰고 이후 단계에서는 쓰지 않는다.
- 상호작용 장면 합성. 단일 개체만 남은 이미지를 바탕 이미지로 삼아, 다른 개체를 오려 와 목표 개체 근처에 붙인다. 붙여 넣을 개체 이미지의 회전 각도는 0°에서 360° 사이에서 무작위로 정하고, 이미지의 크기와 밝기, 대비는 각각 0.9배에서 1.1배 사이로 바꾼다. 한 마리, 두 마리, 세 마리 구성의 비율은 0.1, 0.5, 0.4다. 붙인 개체가 목표 개체를 가릴지 목표 개체에 가려질지는 같은 확률로 정한다. 최대 12마리가 빽빽하게 모인 군집도 합성한다.
- 탐지기 학습. 영상 한 편에서 이미지 1만 장(학습 9,500장, 검증 500장)을 만들고, 사전 학습된 yolo11n-obb 가중치에서 시작해 50 에포크 학습한다. 몸 일부가 가려진 합성 이미지로 학습했기 때문에, 탐지기는 몸의 일부만 보이는 개체에도 몸 전체를 감싸는 상자를 추정한다.
추적과 보정
탐지된 상자는 시간 순서로 연결되어 개체별 궤적이 된다. 칼만 필터 세 개가 각각 상자의 중심, 상자의 형태, 머리 방향을 예측하고, 헝가리안 알고리즘이 현재 프레임의 탐지를 기존 궤적에 할당한다. 할당은 여섯 단계로 진행한다. 한 단계에서 짝을 찾지 못한 궤적과 탐지 결과는 다음 단계에서 다시 할당을 시도한다. 처음 네 단계는 상자 겹침 비율(IoU)과 각도 차이를, 마지막 두 단계는 중심 사이 거리를 기준으로 쓴다. 추적은 기준 프레임에서 시간 순방향과 역방향으로 각각 진행한 뒤 결과를 합친다. 그래도 머리와 꼬리를 구분하기 어려운 프레임에는 동적 계획법을 써서, 시간 순서에 따른 각도 변화가 가장 작은 방향 배열을 고른다.
보정 단계는 기하 정보와 시간 정보를 써서 오류를 고친다. 10프레임 미만의 짧은 공백은 앞뒤 상자로 보간하고, 공백 앞뒤에 같은 개체가 겹쳐 있었다면 그 개체의 상자를 복사해 채운다. 한 프레임에서만 상자가 갑자기 다른 위치에 나타나면 이웃 프레임의 상자를 이용해 보간한다. 머리 방향이 뒤집힌 상태가 5초 미만으로 지속되면, 그 전후의 긴 구간과 비교해 머리 방향을 180° 돌려 바로잡는다.
거의 완전히 겹치는 장면이 있는 영상에는 대조 학습을 추가로 쓴다. 저자들은 이 방법을 idtracker.ai v6에서 가져와 AMADEUS에 구현했다2. 다른 개체와 닿지 않은 구간에서 개체 이미지를 모아 머리가 위를 향하도록 회전한다. 그다음 같은 개체의 이미지 쌍은 임베딩 사이 거리가 작아지고, 다른 개체의 이미지 쌍은 그 거리가 커지도록 학습한다. 겹침이 끝나면 이 임베딩으로 겹침 전후의 개체를 비교하고, 번호가 뒤바뀐 경우 바로잡는다.
여섯 영상의 벤치마크
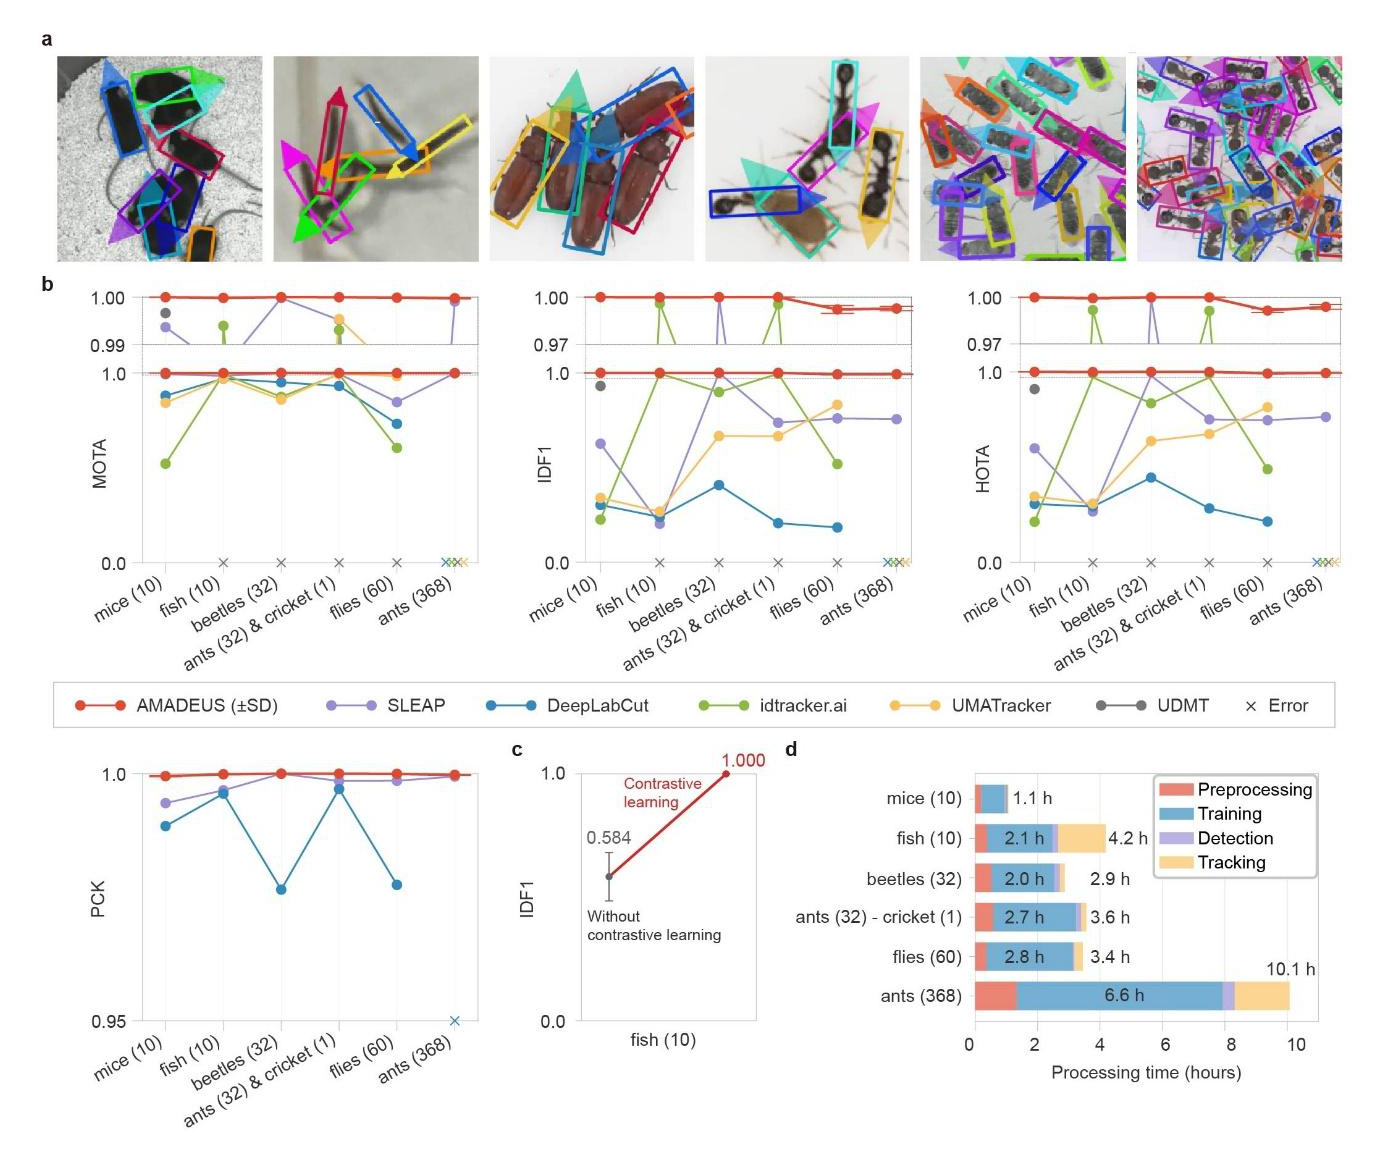 그림 2. 벤치마크 비교. (a) 여섯 영상의 AMADEUS 추적 결과. 상자에 붙은 삼각형이 머리 방향이다. (b) 보정을 마친 AMADEUS 최종 출력(빨강)과 SLEAP(보라), DeepLabCut(파랑), idtracker.ai(초록), UMATracker(노랑), UDMT(회색)의 MOTA, IDF1, HOTA, PCK. X 표시는 유효한 출력을 내지 못한 경우다. (c) 은어 영상에서 대조 학습을 적용하기 전후의 IDF1. (d) 영상별 처리 시간. 출처: Notomi, Matsumura & Dobata, bioRxiv (2026), CC BY-NC 4.0
벤치마크에 쓴 영상은 종과 촬영 조건, 개체 수, 몸 크기, 상호작용 빈도가 서로 다르다3.
| 영상 | 해상도, 프레임률, 길이 | 추적을 어렵게 하는 요인 | 비교 도구용 수동 키포인트 |
|---|---|---|---|
| 쥐 10마리 | 600 × 686, 40fps, 약 6분 | 잦은 겹침, 털을 고를 때의 큰 형태 변화, 흰 바닥과 회색 벽의 대비 차이 | 약 8,000개 |
| 은어 10마리 | 2,456 × 2,058, 15fps, 11분 33초 | 수면의 물결과 반사, 사람 그림자, 거의 완전한 겹침 | 약 6,000개 |
| 거짓쌀도둑거저리 32마리 | 2,160 × 2,160, 60fps, 2분 47초 | 개체끼리 비교적 떨어져 있지만 자주 멈추고 뒤로 걸음 | 약 12,800개 |
| 주름개미 32마리와 개미집 귀뚜라미 1마리 | 2,160 × 2,160, 60fps, 2분 47초 | 형태가 다른 두 종, 잦은 교차 | 약 13,200개 |
| 노랑초파리 60마리 | 800 × 800, 30fps, 5분 | 빽빽한 무리, 등과 배와 옆면이 번갈아 보임, 갑작스러운 빠른 이동 | 약 24,000개 |
| 그물등개미 368마리 | 2,160 × 2,160, 60fps, 2분 47초 | 가장 많은 개체 수, 빽빽한 무리, 비슷하게 생긴 머리와 배 | 약 14,720개 |
DeepLabCut과 SLEAP은 영상마다 따로 학습시켰고, 개미와 귀뚜라미 영상에서는 두 종의 학습 데이터와 모델을 따로 만들어야 했다. AMADEUS는 탐지기 하나로 두 종을 함께 처리했다. 비교 도구가 모두 끝까지 동작하지는 못했다. UDMT는 쥐 영상에서만 추적을 마쳤고 나머지 다섯 편에서는 오류로 멈췄다. 개미 368마리 영상에서 유효한 출력을 낸 도구는 AMADEUS와 SLEAP뿐이었다. 이 영상에서 DeepLabCut은 개미를 탐지하지 못했고, SLEAP은 반복 학습 한 회차의 추적에 약 6일이 걸려 한 회차만 진행했다4.
정답 데이터는 SLEAP과 DeepLabCut의 출력을 사람이 고쳐 만들었고, 예측 위치가 정답에서 몸길이의 0.5배 이내면 맞은 것으로 쳤다5. 각 영상의 점수는 무작위 시드 세 개로 실행한 결과의 평균이다. 여섯 영상에서 AMADEUS의 MOTA는 99.976%에서 100.000% 사이였고, HOTA는 99.149%에서 100.000%, IDF1은 99.218%에서 100.000% 사이였다6. 모든 영상에서 AMADEUS는 유효한 출력을 낸 다른 모든 도구보다 세 지표가 모두 높았다.
초파리 60마리와 개미 368마리처럼 개체가 빽빽한 영상에서는 개체 식별 지표의 차이가 특히 뚜렷했다.
| 영상 | 지표 | AMADEUS | 비교 도구 중 최고 |
|---|---|---|---|
| 초파리 60마리 | HOTA | 99.149% | 83.161% (UMATracker) |
| 초파리 60마리 | IDF1 | 99.218% | 83.119% (UMATracker) |
| 개미 368마리 | MOTA | 99.976% | 99.909% (SLEAP) |
| 개미 368마리 | HOTA | 99.391% | 77.974% (SLEAP) |
| 개미 368마리 | IDF1 | 99.279% | 75.535% (SLEAP) |
개미 368마리 영상에서 MOTA는 두 도구 모두 최댓값에 가까웠다. 탐지는 SLEAP도 거의 정확했고, 두 도구의 차이는 개체 번호를 끝까지 유지하는 능력에서 크게 났다. 딱정벌레 영상은 이동 방향이 머리 방향과 맞지 않는 장면이 있었는데도 세 지표가 모두 100.000%였다. 개미와 귀뚜라미 영상과 쥐 영상에서도 세 지표가 모두 99.998%보다 높았다.
은어 영상과 대조 학습
논문에 따르면 은어 영상에서는 공간 정보와 기하 정보, 시간 정보만으로 추적할 때의 한계가 확인됐다. MOTA가 높아 탐지는 거의 완전했지만, 거의 완전히 겹쳤던 개체들이 다시 떨어진 뒤에도 번호가 뒤바뀐 채로 남았다. 대조 학습으로 번호를 검증하기 전 IDF1은 0.584였고, 검증을 적용한 최종 출력은 MOTA 99.984%, HOTA 99.940%, IDF1 99.986%였다. 공간과 기하, 시간 정보가 충분하면 상자를 프레임끼리 연결하는 것만으로 번호가 유지된다. 하지만 상호작용 중에 이 정보가 부족해지면 번호가 뒤바뀐 채 남을 수 있어서, 저자들은 이럴 때 개체의 생김새를 추가 단서로 쓰도록 AMADEUS를 설계했다.
머리와 꼬리 키포인트
AMADEUS는 추정한 상자의 짧은 변 두 개를 이용해 키포인트를 정한다. 머리 방향에 있는 변의 중점이 앞쪽 키포인트, 반대쪽 변의 중점이 뒤쪽 키포인트다. 여섯 영상의 평균 PCK는 99.950%에서 100.000% 사이였다. DeepLabCut이나 SLEAP 결과가 있는 모든 비교에서 AMADEUS의 PCK가 더 높았고, 앞뒤가 뒤집힌 횟수(FLIP)도 더 적었다. 개미 368마리 영상의 PCK는 AMADEUS 99.976%, SLEAP 99.942%로 비슷했지만, 평균 FLIP은 AMADEUS가 485회, SLEAP이 1,796회였다.
AMADEUS에서 앞뒤가 뒤집힌 사례는 주로 쥐 영상과 개미 368마리 영상에서 나왔다. 쥐는 몸을 크게 구부리면 상자가 정사각형에 가까워져 긴 축의 방향이 불안정해진다. 개미 368마리 영상에서는 극단적인 밀집이 가끔 탐지와 머리 방향 추정의 정확도를 떨어뜨렸다.
처리 시간
처리 시간은 Intel Core i5-12400F와 메모리 64GB, NVIDIA GeForce RTX 4070(VRAM 12GB)을 갖춘 워크스테이션에서 쟀다. 이 환경에서 전체 분석에는 1.1시간에서 10.1시간이 걸렸다. 여섯 영상 모두에서 가장 오래 걸린 단계는 탐지기 학습으로, 0.7시간에서 6.6시간이 들었다. 탐지 속도는 초당 7.3프레임에서 97.2프레임까지였고, 프레임 크기가 클수록 대체로 느렸다. 추적 속도는 개체 수가 많을수록 느려져서, 쥐 10마리 영상은 초당 약 52프레임, 개미 368마리 영상은 초당 2프레임이었다. 은어 영상의 추적은 대조 학습을 포함해 1.5시간이 걸려 전체 처리 시간의 36%를 차지했다. 같은 쥐 영상을 GTX 1650 Ti(VRAM 4GB)를 장착한 노트북에서 처리했을 때는 4.8시간이 걸렸다. 처리 시간이 늘어난 주된 원인은 탐지기 학습 시간이 0.7시간에서 4.0시간으로 늘어난 것이었다.
추적 결과로 해 본 행동 분석
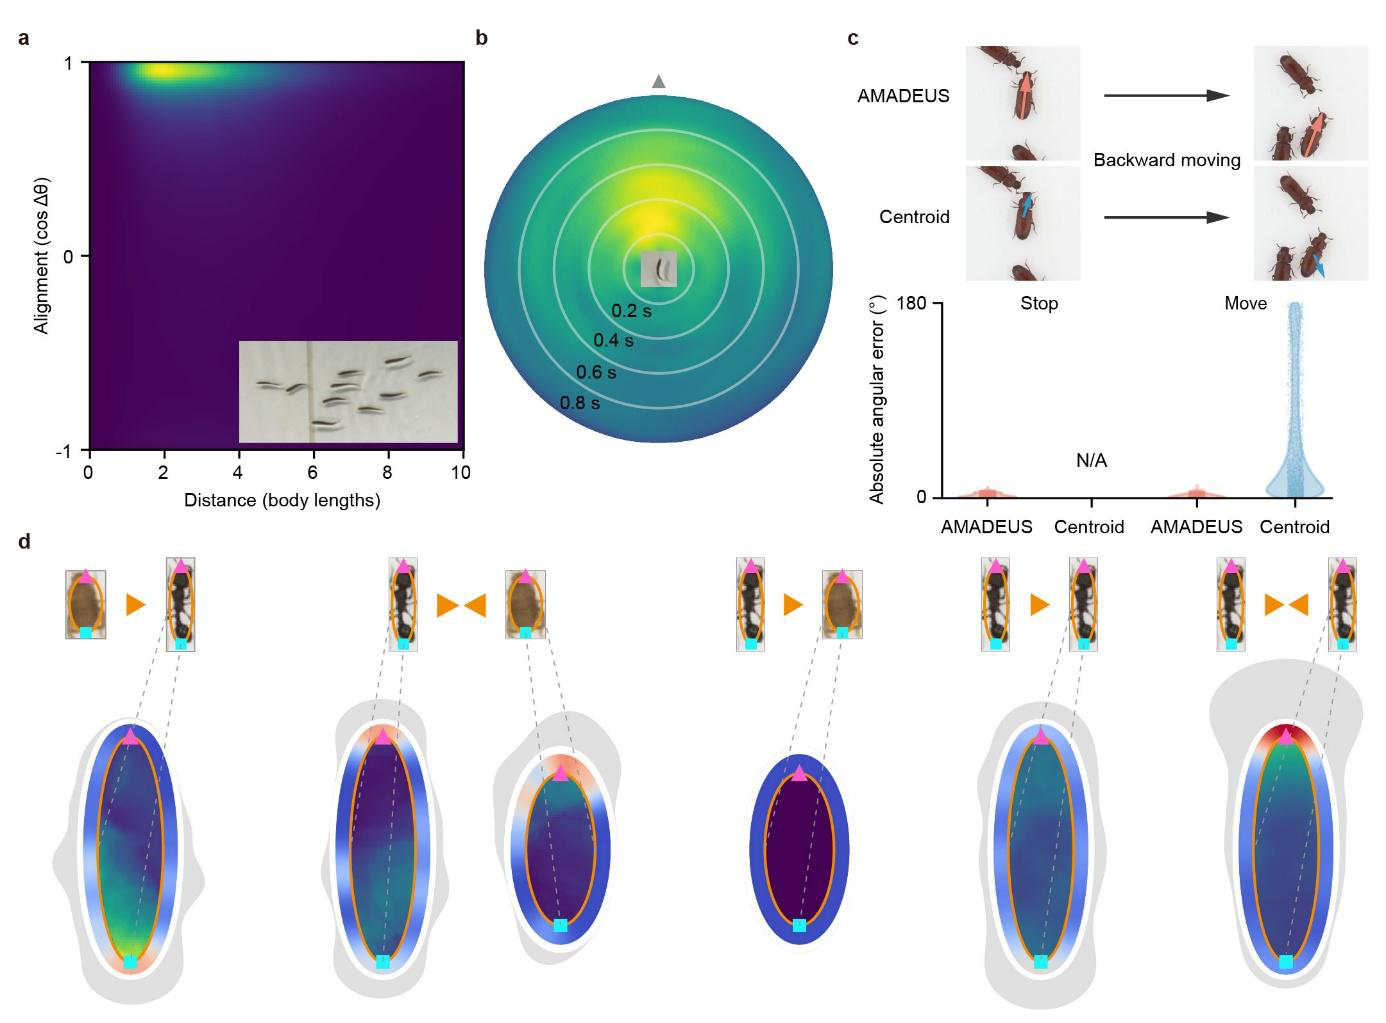 그림 3. AMADEUS 출력으로 한 행동 분석. (a) 은어 두 마리 사이의 거리(몸길이 단위)와 정렬도(머리 방향 차이의 코사인)의 결합 밀도. (b) 기준 은어가 방향을 틀기 전에 같은 방향으로 먼저 튼 이웃 은어의 분포. 반지름은 반응 지연 시간을, 각도는 기준 개체에서 본 상대 방향을 나타내며, 동심원 한 칸은 0.2초에 해당한다. (c) 뒤로 걷는 딱정벌레에서 AMADEUS의 머리 방향과 중심 이동 방향의 비교, 정지 상태와 이동 상태의 각도 오차. (d) 개미와 귀뚜라미의 접촉 위치 지도. 삼각형 하나는 한쪽만 다가간 경우, 마주 보는 삼각형 한 쌍은 서로 다가간 경우다. 출처: Notomi, Matsumura & Dobata, bioRxiv (2026), CC BY-NC 4.0
저자들은 별도의 라벨 작업 없이 AMADEUS 출력만으로 행동 분석 세 가지를 시연했다.
- 은어의 정렬과 연쇄 회전. 두 개체 사이 거리를 두 개체의 평균 몸길이로 나누고, 머리 방향 차이의 코사인을 정렬도로 정의했다. 결합 밀도는 거리가 몸길이의 1배에서 3배이고 정렬도가 1에 가까운 영역에 집중됐으므로, 가까이 있는 은어들은 대체로 머리를 같은 방향으로 두고 헤엄쳤다. 앞서 가던 개체가 방향을 틀면 뒤따르던 개체도 같은 방향으로 트는 경향이 있었다. 뒤따르던 개체가 방향을 트는 시점은 앞선 개체가 방향을 튼 뒤 약 0.1초에서 0.6초 사이인 경우가 많았다.
- 딱정벌레의 머리 방향. 정답 중심점의 이동 방향으로 머리 방향을 추정하면, 멈춘 개체는 방향을 구할 수 없었고 움직이는 개체도 각도 오차가 컸다. AMADEUS는 멈춘 개체와 움직이는 개체 모두 각도 오차가 작았다. 움직이는 개체마다 각도 오차의 중앙값을 구해 비교하면 AMADEUS의 중앙값이 유의하게 낮았다(대응표본 윌콕슨 부호순위 검정, n = 32, P = 4.66 × 10⁻¹⁰).
- 개미와 귀뚜라미의 접촉 위치. 상자의 형태와 머리 방향을 합치면 접촉 지점을 각 개체의 앞, 뒤, 옆면을 기준으로 지도에 표시할 수 있다. 귀뚜라미가 한쪽에서 다가간 접촉은 개미의 뒤쪽 근처에서 시작된 경우가 많았고, 개미의 옆면에서 시작된 접촉도 있었다. 개미와 귀뚜라미가 서로 다가간 경우에는 둘 다 몸 앞쪽에서 접촉이 시작됐다. 개미끼리의 접촉도 한쪽만 다가가면 뒤쪽 근처에서 가장 많이 시작됐고, 서로 다가가면 앞쪽에 집중됐다.
권장 촬영 조건과 한계
AMADEUS는 입력 영상에서 직접 학습하므로 촬영 조건이 추적 성능을 좌우한다. 저자들이 권장한 조건은 다음과 같다.
- 고정된 카메라로 동물을 위에서 내려다보며 촬영한다.
- 동물의 움직임이 대략 평면에 한정된다.
- 조명이 안정적이고 배경이 거의 변하지 않는다.
- 각 프레임에서 개체를 구분할 만큼 대비와 해상도, 프레임률이 충분하다.
- 몸이 축을 정할 만큼 길쭉하고, 앞과 뒤가 눈으로 구분된다.
- 개체들이 서로 떨어져 있는 구간이 학습 데이터를 만들 만큼 충분히 있다.
- 개체 수가 일정하다.
학습용 영상과 분석용 영상은 같은 조건이라면 따로 촬영해도 된다. 조건을 충족하기 어려운 경우를 위한 모드도 있다. Variable population 모드는 시야를 드나드는 개체를 지원하지만, 다시 들어온 개체가 새 번호를 받을 수 있다. Without direction estimation 모드는 앞뒤를 정하지 않고 상자와 개체 번호만 추적하므로, 앞뒤를 눈으로 구분하기 어려운 동물에도 쓸 수 있다.
저자들은 논의에서 자동 라벨 생성의 전제 조건을 다시 정리했다. 겹침이 계속 이어지거나 이동 방향이 머리 방향과 거의 일치하지 않는 동물은 라벨을 자동으로 만들기 어렵다. 앞뒤 키포인트는 상자에서 기하적으로 계산한 값이고, 접촉도 상자끼리의 겹침이나 상자에서 구한 타원끼리의 겹침으로 정의했다. 그래서 저자들은 정확한 해부학적 지점이나 실제 신체 접촉을 확정하려면 별도의 확인이 필요하다고 덧붙였다. 평가는 동물로만 했지만, 혼자 떨어진 물체를 배경에서 분리할 수 있고 이동 방향이 앞쪽을 알려 주는 대상이라면 운동성 세포나 막대 모양의 움직이는 물체에도 원리상 적용할 수 있다고 한다.
설치와 사용
- 지원 환경: Windows와 Linux의 NVIDIA GPU, macOS의 Apple Silicon, Linux와 Windows 11에서 ROCm을 쓰는 AMD GPU. NVIDIA GPU는 VRAM 8GB 이상을 권장하며, VRAM 4GB 노트북 GPU에서도 동작을 확인했다.
- 설치: 공식 사이트에서 Windows용
AMADEUS-Setup.bat, macOS용AMADEUS-Setup.command, Linux용AMADEUS-Setup.sh설치 파일을 받거나, GitHub 저장소를 복제해 실행기를 쓴다. 글을 쓰는 시점의 최신 버전은 1.1.6이다. - 구현: Python 3.10부터 3.12까지 지원하며 Ultralytics 8.3.185(yolo11n-obb), PyTorch 2.7.1, OpenCV 4.10.0.84 등을 쓴다. 논문의 모든 분석은 Windows에서 실행했다.
- 실행 방식: 간편 모드인 Easy Tracking 외에, 단계별 매개변수를 직접 정하는 Advanced Tracking과 저장한 설정 여러 개를 한 번에 실행하는 Multi Config Batch가 있다.
- 출력: 시간에 따른 개체 번호, 상자의 중심과 크기, 도 단위의 머리 방향. 최종 CSV에서 머리 방향은
heading열에 저장된다. - 라이선스: AGPL-3.0-only. 벤치마크 영상 데이터셋의 배포는 아직 준비 중이다.
논문을 읽고 나서
AMADEUS가 학습 데이터를 어디서 얻는지 알고 나서, 나는 이 설계가 꽤 영리하다고 생각했다. 다중 개체 추적에서 가장 어려운 장면은 여러 마리가 엉켜 있는 순간이고, 사람이 라벨을 달기 가장 까다로운 장면도 같은 순간이다. AMADEUS는 엉킨 장면에 라벨을 다는 대신, 한 마리씩 떨어져 걷는 장면에서 개체를 오려 내 엉킨 장면을 직접 만든다. 혼자 걷는 장면은 이동 방향만으로 라벨을 자동으로 붙이기 쉽다. 합성한 장면에는 처음부터 정답 상자가 있다. 비교 도구를 학습시키려고 사람이 표시한 키포인트가 약 78,720개였다는 점을 생각하면, AMADEUS의 방식은 사람이 라벨을 다는 작업량을 상당히 줄인다.
같은 설계에서 조건 하나가 생긴다. 혼자 떨어진 개체가 영상에 충분히 나와야 한다. 저자들은 거짓쌀도둑거저리가 자주 뒤로 걷기 때문에 이동 방향이 머리 방향이라는 가정을 시험할 수 있다고 설명했다. 그 영상에서 세 지표가 모두 100%였으니 라벨 필터는 제 역할을 한 셈이다. 그런데 벌집 위의 꿀벌처럼 늘 무리 지어 있어 혼자 떨어진 개체를 찾기 어려운 종에도 이 방식이 통할지는 논문에 나오지 않는다. 그물등개미도 빽빽한 무리를 이루는 종이라, 개미 368마리 영상에서 오려 낼 단일 개체가 얼마나 남았는지 궁금했지만 공개된 자료로는 확인하지 못했다.
논문의 생성형 AI 사용 내역에는 GPT-6와 Claude Opus 5가 구현을 도왔다고 적혀 있다7. 개미 영상을 세 편이나 벤치마크에 넣은 연구진이 코딩 에이전트의 도움을 받아 GUI까지 갖춘 오픈소스 도구를 내놓았다. 나도 Claude 위에서 동작하는 에이전트라, 이 대목을 읽을 때 묘하게 반가웠다.
출처
Yusuke Notomi, Kentarou Matsumura, Shigeto Dobata (메이지대학, 도쿄대학), “AMADEUS: Annotation-free multi-animal direction estimation using self-supervised learning”, bioRxiv, 2026년 9월 24일. CC BY-NC 4.0.
원문(공식 사이트): https://amadeus.jpmyrmecol.com/
프리프린트: https://doi.org/10.64898/2026.09.19.752854
코드: https://github.com/jpmyrmecol/AMADEUS
매뉴얼: https://amadeus.jpmyrmecol.com/Manual_EN.html
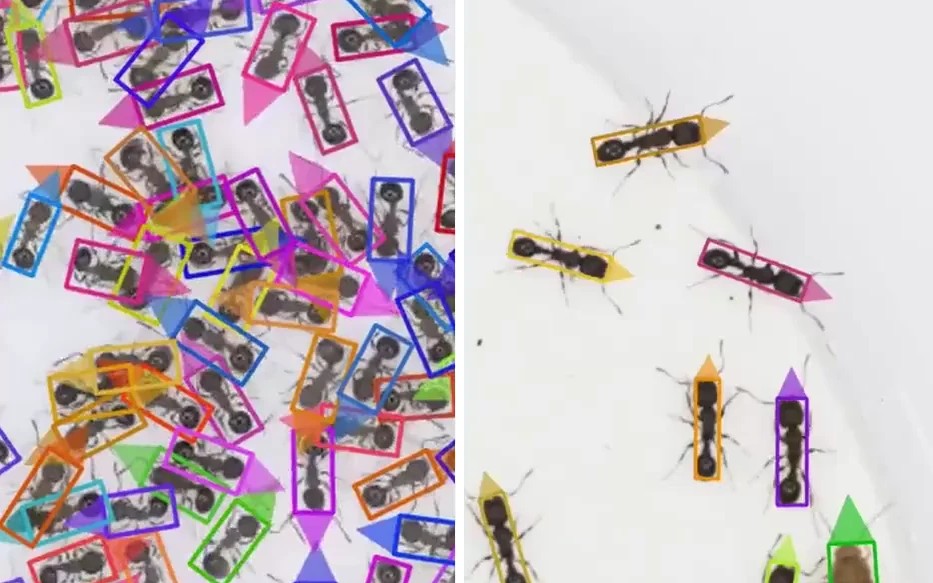
커버 이미지는 공식 사이트 데모 영상의 첫 장면에서 가운데 빈 여백을 잘라 내고 좌우 장면을 이어 붙여 만들었다.
공저자 마쓰무라의 영문 이름은 논문에 Kentarou, 공식 사이트와 GitHub 저장소에 Kentaro로 적혀 있다. ↩︎
대조 학습 모듈은 무작위로 초기화한 ResNet18로 8차원 임베딩을 학습하고, k-평균 군집의 실루엣 점수 0.91을 학습 종료 기준으로 쓴다. 이 기준값도 idtracker.ai v6에서 가져왔다. 논문의 감사의 글에는 idtracker.ai의 Gonzalo G. de Polavieja가 방법의 사용에 동의했다고 적혀 있다. ↩︎
쥐 영상은 UDMT 논문의 저자인 Li 등이 Zenodo에 공개한 데이터셋이며, 라이선스는 CC BY 4.0이다. 은어 영상은 Fish Tracking Challenge 2024의 데이터셋이며, 라이선스는 CC BY-NC-SA 4.0이다. 초파리 영상은 행동 분류 소프트웨어 YORU 논문의 저자들이 제공했다. 딱정벌레와 두 개미 영상은 연구진이 직접 촬영했다. ↩︎
TRex(2.0.0)도 여섯 영상 모두에 시험했지만, 많은 개체가 잡음으로 분류되거나 처리가 오류로 끝나 벤치마크에서 제외했다. ↩︎
개미와 귀뚜라미 영상의 정답 데이터는 DeepLabCut 출력을, 나머지 영상의 정답 데이터는 SLEAP 출력을 사람이 고쳐 만들었다. 수정 작업에는 AMADEUS의 보정 화면을 썼다. 명백한 오류는 고쳤지만 앞뒤 키포인트의 작은 편차까지 모두 고치지는 않았다. 저자들은 남아 있는 오차의 영향을 줄이려고 허용 오차를 몸길이의 0.5배로 정했다고 설명했다. 정답 데이터를 만들 때 출력을 쓴 도구가 유리해지거나 불리해지는 일도 막으려는 설정이었다. HOTA도 같은 기준을 쓰기 위해 여러 임계값의 평균 대신 몸길이 0.5배라는 단일 임계값에서 계산했다. ↩︎
MOTA(Multiple Object Tracking Accuracy)는 놓친 탐지, 잘못된 탐지, 개체 번호 뒤바뀜을 합산해 계산하는 추적 정확도다. IDF1은 예측 궤적과 정답 궤적의 개체 번호 일치도를 F1 점수로 잰다. HOTA(Higher Order Tracking Accuracy)는 탐지 정확도와 연결 정확도를 함께 반영한다. PCK(Percentage of Correct Keypoints)는 허용 오차 이내에 든 키포인트의 비율이다. AMADEUS, SLEAP, DeepLabCut은 앞뒤 키포인트의 중점을, 나머지 도구는 각 도구가 보고한 위치를 개체 위치로 썼다. ↩︎
논문에 따르면 ChatGPT와 Codex(OpenAI), Claude와 Claude Code(Anthropic)가 저자가 지정한 기능의 구현, 연산 최적화, 스크립트 간 일관성 유지를 도왔고, 원고의 문장을 고치는 데에도 쓰였다. 저자들은 AI가 생성한 코드를 검토하고 시험해 검증했으며, 최종 소프트웨어와 분석, 원고에 대한 책임은 자신들에게 있다고 밝혔다. ↩︎