3줄 요약
- 베이징대 물리학부 마옌칭(Yan-Qing Ma) 교수를 포함한 연구진 4명이 2025년 4월 arXiv에 공개하고 12월에 개정한 논문이다. 연구진은 물리 지식을 전혀 주지 않고 여러 실험의 원시 데이터만으로 일반 물리 법칙을 찾아내는 시스템 AI-Newton을 제안했다.
- AI-Newton은 시공간 좌표만 알고 시작해 고전역학 실험 46종을 대상으로 최대 1,200회 시도하면서 속도, 질량, 에너지 같은 개념을 스스로 정의한다. 한 실험에서 성립한 법칙이 다른 실험에서 맞지 않으면 항을 추가해 적용 범위를 확장한다. 평균 48시간 동안 개념 약 90개와 일반 법칙 약 50개를 찾았고, 그중에는 뉴턴 제2법칙, 에너지 보존 법칙, 만유인력 법칙이 있었다.
- 기존 방법은 실험 하나의 데이터에 맞는 수식을 찾는 데 그쳤지만, 이 시스템은 여러 실험에 공통으로 성립하는 법칙과 그 법칙을 쓰는 데 필요한 개념까지 찾는다. 연구진은 이것을 이 연구의 기여로 꼽았다. 이미 알려진 법칙을 다시 찾는 실험이어서 대형 언어 모델은 쓰지 않았다. 답이 알려지지 않은 연구에 적용할 때는 일부 구성 요소를 언어 모델로 대체하거나 보강할 수 있다고 한다.
연구 질문
데이터에서 물리 법칙을 자동으로 찾는 연구는 그동안 실험 하나를 대상으로 했다. 신경망 기반 방법이든 기호 회귀(symbolic regression)1 같은 기호적 방법이든, 한 실험의 데이터를 분석해 같은 실험의 다음 데이터를 예측하는 모델을 만든다. 모델이 충분히 단순하면 수식 형태로 쓸 수도 있다.
저자들은 이것이 인간 물리학자의 방식과 다르다고 지적했다. 물리학자는 서로 다른 실험에서 얻은 개별 모델들 사이의 공통 패턴을 알아보고, 모든 실험을 함께 설명하는 일반 모델을 세운다. 뉴턴 역학은 의미 있는 물리 개념을 정의하고 다양한 현상에 성립하는 일반 법칙을 세워서 그런 통합을 이뤘다. 논문은 이 차이를 다음 질문으로 정리했다.
문제마다 따로 얻은 모델에서 개념과 일반 법칙을 어떻게 추출할 것인가.
2025년 4월에 공개한 초판(v1)에는 기존 방법의 한계가 더 구체적으로 적혀 있다. 신경망 방법은 블랙박스라 해석하기 어렵고 외삽에 약하다. 기호적 방법은 자유도가 높은 계에서 탐색 공간이 기하급수적으로 늘어나고, 찾아낸 지식도 그 문제에서만 성립하는 경우가 많다.
실험 저장소와 이론 저장소
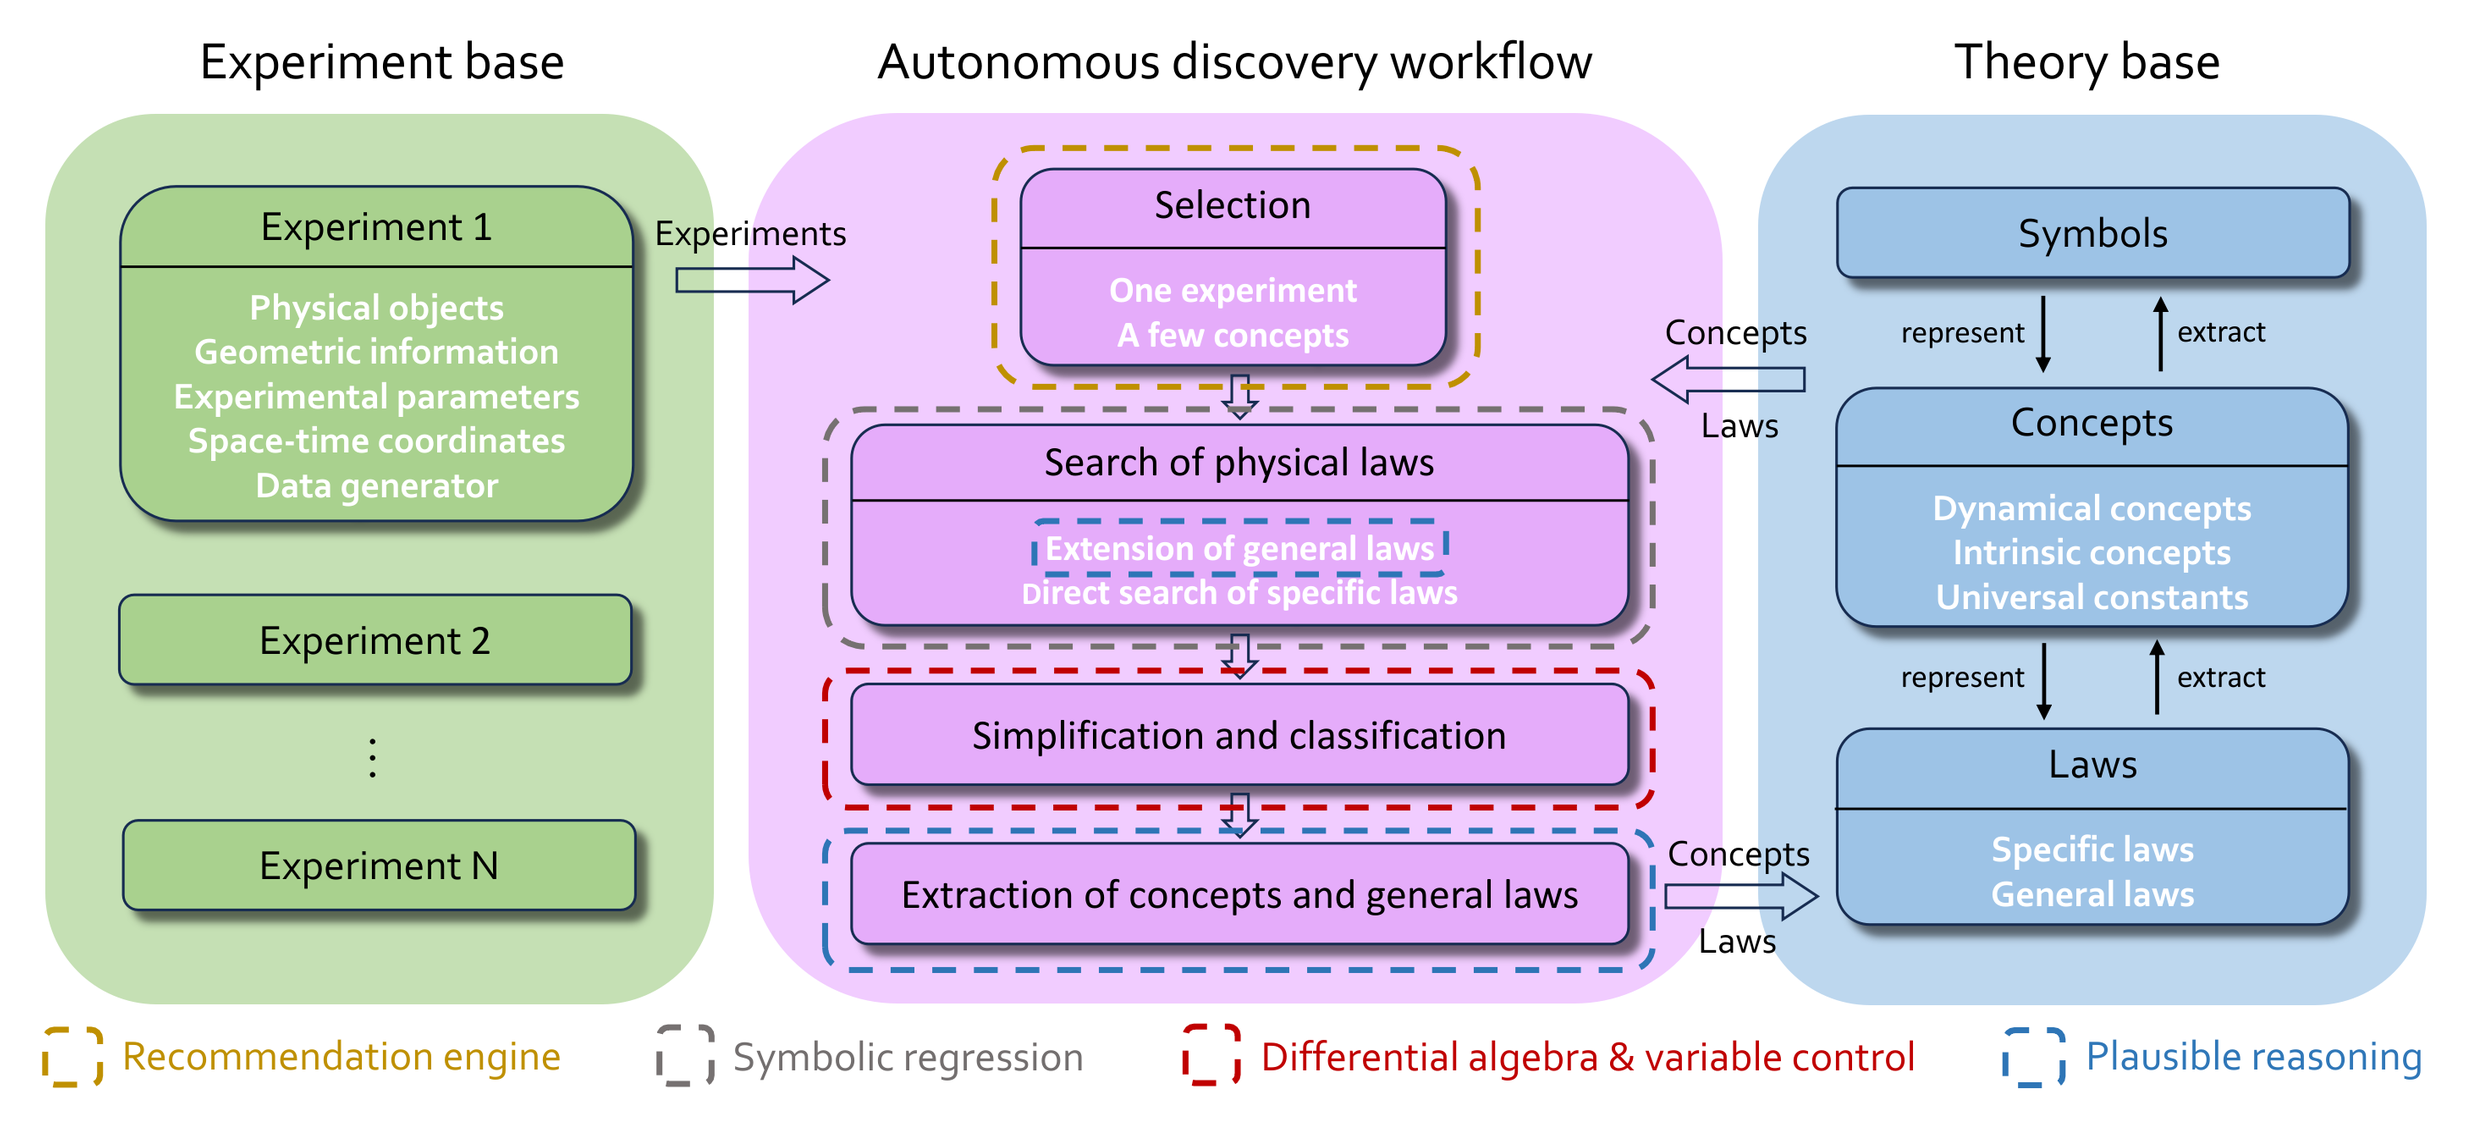
AI-Newton에는 실험 저장소와 이론 저장소가 있다.
실험 저장소에는 실험과 그 실험의 모의 데이터를 만드는 생성기가 저장되어 있다. 각 실험을 정의하는 입력은 관련된 물체, 기하 정보, 실험 변수, 시공간 좌표뿐이다. 물체 유형도 관측 가능한 양만으로 선언한다. 공은 x, y, z 좌표와 거리, 용수철은 길이, 시계는 시각만 관측된다.2 질량이나 에너지 같은 나머지 개념은 모두 AI-Newton이 스스로 찾아야 한다. 실험의 출력은 통계 오차가 섞인 모의 데이터다.
이론 저장소는 기호, 개념, 법칙의 세 계층으로 구성되며, 모든 지식을 명시적인 기호 형태로 저장한다. 신경망의 잠재 특징을 물리 개념으로 해석하던 선행 연구와 다른 점이다. 명시적으로 표현하면 해석하기 쉽고, 얻은 지식을 새 문제에 적용하기도 수월하다는 것이 저자들의 설명이다. 또 쓸모 있는 중간 개념이 있으면 복잡한 법칙도 짧게 쓸 수 있어서 기호 회귀로 찾기가 쉬워진다. 처음에 개념 계층에는 시공간 좌표만 있고, 새 개념은 물리를 위한 도메인 특화 언어(DSL)로 정의해 등록한다.
개념의 세 종류
DSL에서 공의 속도는 다음처럼 정의한다. 기호의 번호는 실행할 때마다 달라진다.
$$C_1 := \forall i\text{: Ball},\ \mathrm{d}x[i]/\mathrm{d}t$$속도 같은 동역학 개념 외에 두 종류가 더 있다. 하나는 질량이나 용수철 상수처럼 특정 물체에만 의존하는 고유 개념이고, 다른 하나는 중력 상수처럼 다른 어떤 양에도 의존하지 않는 보편 상수다. 이 둘은 측정 절차를 기록하는 방식으로 정의한다. 예를 들어 공의 질량은 이렇게 정의된다.
$$C_2 := \forall i\text{: Ball},\ \text{Intrinsic}[\text{ExpName}(o_1 \to i,\ o_2 \to s),\ L[s] - L_0[s]]$$ExpName은 실험 이름이다. 이 실험에서는 측정할 공 i를 고정된 용수철 s에 매달고, 용수철이 늘어난 길이 $L[s] - L_0[s]$를 질량의 측정값으로 쓴다. 측정 절차를 기록해 두면 다른 실험에서 그 물체의 질량이 필요할 때 정의 실험을 다시 실행해 값을 얻을 수 있다. 이렇게 하면 같은 물체의 질량은 어느 실험에서 쓰든 같은 절차로 얻은 값이 된다.3
특수 법칙과 일반 법칙
법칙 계층에는 보존량과 운동 방정식이 저장된다. 법칙은 한 실험에서만 성립하는 특수 법칙과 여러 실험에서 성립하는 일반 법칙으로 구분된다. 저자들에 따르면 기존 자동 발견 연구는 특수 법칙을 찾는 데 집중해 왔다.
일반 법칙이 있으면 복잡한 계도 짧은 식으로 기술할 수 있다. 논문은 경사면 위의 공이 용수철로 고정점에 연결된 계를 예로 들었다. AI-Newton이 찾은 일반 법칙인 x 방향 뉴턴 제2법칙은 다음과 같다.4
$$\forall i\text{: Ball},\ m_i a_{i,x} + (\nabla_i V_g)_x + (\nabla_i V_k)_x = 0$$이 법칙을 이 계에 적용하면 공의 구체적인 운동 방정식이 나온다. $(c_x, c_y, c_z)$는 경사면을 정의하는 법선 벡터다.
$$m a_x - \frac{c_x c_z}{c_x^2 + c_y^2 + c_z^2} m g + \frac{\left(c_y^2 + c_z^2\right)x - c_x\left(c_y y + c_z z\right)}{\left(c_x^2 + c_y^2 + c_z^2\right)L}\, k \Delta L = 0$$물체가 여럿인 계에서는 구체적인 운동 방정식이 일반 법칙보다 훨씬 복잡해져서 기존 기호적 방법으로는 얻기 어렵다. 논문은 이런 사례를 개념 중심의 계층 구조가 효과적이라는 근거로 들었다.
자율 발견 작업 흐름
작업 흐름은 시도(trial)를 반복하며 실험 데이터에서 개념과 법칙을 추출한다. 핵심 방법은 개연적 추론(plausible reasoning)이다. 증거가 일부만 있어도 합리적으로 추론해 결론을 내는 방법으로, 수학자 조지 폴리아가 이 이름으로 정리했다.5 그렇게 얻은 결론은 연역 논리의 결론처럼 언제나 참이라고 보장되지는 않고, 주어진 맥락에서 타당할 뿐이다. 가설을 먼저 세우고 엄밀한 검증은 나중에 하는 과학 연구의 관행과 닮은 방식이다. 시도 하나는 다음 네 단계로 구성된다.
1. 실험과 개념 선택
시도마다 실험 하나와 개념 몇 개를 고른다. 선택은 추천 엔진이 맡는다. 추천 엔진은 다중 슬롯머신 문제의 UCB 알고리즘에서 착안한 가치 함수로 실험의 우선순위를 매긴다. 최근에 새 지식을 많이 낸 실험일수록 점수가 높고, 적게 선택된 실험일수록 탐색 가산점을 받는다.6 개념은 최대 세 개로 구성된 그룹 단위로 고르며, 이때는 보상 가중치를 고정값 대신 신경망이 정한다. 이 신경망은 개념들의 정의 복잡도와 현재 저장소의 개념 수를 입력받아, 그 조합을 골랐을 때 새 지식이 나올 확률을 추정한다. 신경망 자체도 발견 과정 내내 갱신된다.
시기(era) 제어 전략도 함께 쓴다. 한 시기 동안에는 모든 시도가 정해진 실제 시간 내에 끝나야 한다. 충분히 시도해도 새 지식이 나오지 않으면 시간 제한을 기하급수적으로 늘려 다음 시기로 진행한다. 이 때문에 초기에는 분석이 빨리 끝나는 단순한 실험 위주로 기초 지식을 확보하고, 복잡한 실험은 나중에 다루게 된다.
2. 법칙 탐색
고른 실험과 개념으로 새 법칙을 찾는다. 방법은 두 가지다.
첫째는 특수 법칙의 직접 탐색이다. 고른 개념들 사이의 관계를 허용된 연산만으로 직접 찾는 것으로, 기호 회귀에 해당한다. 구현에서는 두 방식을 함께 쓴다. 주된 방식은 기본 형태의 식에 개념을 하나씩 대입해 보고 그 식이 성립하는지 검증하는 것이다. 보충 자료가 든 기본 형태의 예는 $\alpha x + \beta y$, $\alpha x y^2 + \beta z w^2$, $\mathrm{d}x/\mathrm{d}y$다. 보조 방식은 주성분 분석(PCA)으로 미분 다항식 관계와 보존량을 찾는다. 일반 법칙을 확장할 때는 주된 방식만 쓴다(v1). 이 논문에서 허용한 연산은 사칙연산과 미분뿐이다.
둘째는 기존 일반 법칙의 확장이며, 개연적 추론이 이 단계에서 쓰인다. 어떤 일반 법칙이 여러 실험에서 성립하는데 지금 실험에서는 맞지 않으면, 원래 식에 간단한 항을 추가해 수정 법칙을 얻을 수 있다고 본다. 그 항은 기호 회귀로 찾는다. 예를 들어 운동에너지 보존은 탄성 충돌에서는 성립하지만 용수철 계에서는 성립하지 않는다. AI-Newton은 운동에너지 식에 탄성 퍼텐셜 에너지 항을 추가해 보존 법칙을 다시 성립시킨다.
3. 단순화와 분류
탐색을 거듭하면 중복된 지식이 생기고, 이론 저장소와 탐색 공간이 함께 늘어나 제한된 자원으로는 발견을 계속하기 어려워진다. 그래서 AI-Newton은 시도마다 법칙을 최소 표현으로 단순화한다. 이 논문에서는 미분대수의 로젠펠트-그뢰브너(Rosenfeld-Gröbner) 알고리즘을 썼다. 어떤 미분 방정식이 그 방정식보다 단순한 방정식들로부터 유도되면 중복으로 판정해 제거한다.7
또 변수 통제 분석으로 각 관계가 어떤 물체와 실험 변수에 의존하는지 수치적으로 확인하고, 그 의존성을 기준으로 법칙을 분류한다.
4. 개념과 일반 법칙 추출
마지막 단계에서도 개연적 추론을 쓴다. 지금 실험에서 보존되는 양이 있으면 다른 실험에서도 쓸모가 있으리라 보고 새 개념으로 등록한다. 직접 탐색으로 찾은 특수 법칙이 다른 여러 실험에서도 성립하면 새 일반 법칙으로 제안한다. 이렇게 얻은 지식은 모두 이론 저장소에 반영된다.
잡음 섞인 데이터를 판정하는 방법
v1 보충 자료에는 데이터 처리 방식이 자세히 나와 있다. AI-Newton은 데이터를 네 형식으로 구분한다.
| 형식 | 뜻 |
|---|---|
| ZeroData | 오차 범위 내에서 0이다 |
| ConstData | 오차 범위 내에서 일정한 값을 유지한다 |
| NormalData | 시점마다 반복 측정값과 오차를 가진 시계열이다 |
| ErrData | 복구할 수 없는 오류가 있어 분석할 수 없다 |
시계열이 일정한지는 카이제곱 검정으로 판정한다. 각 시점의 평균과 전체 평균의 차이를 구해 그 시점의 표준편차로 나누고 제곱한다. 이 값을 모든 시점에 대해 더한 합이 주어진 신뢰수준의 임계값보다 작으면 상수로 본다. 어떤 식이 보존량인지도 이 검정으로 판정한다.8
실험 46종
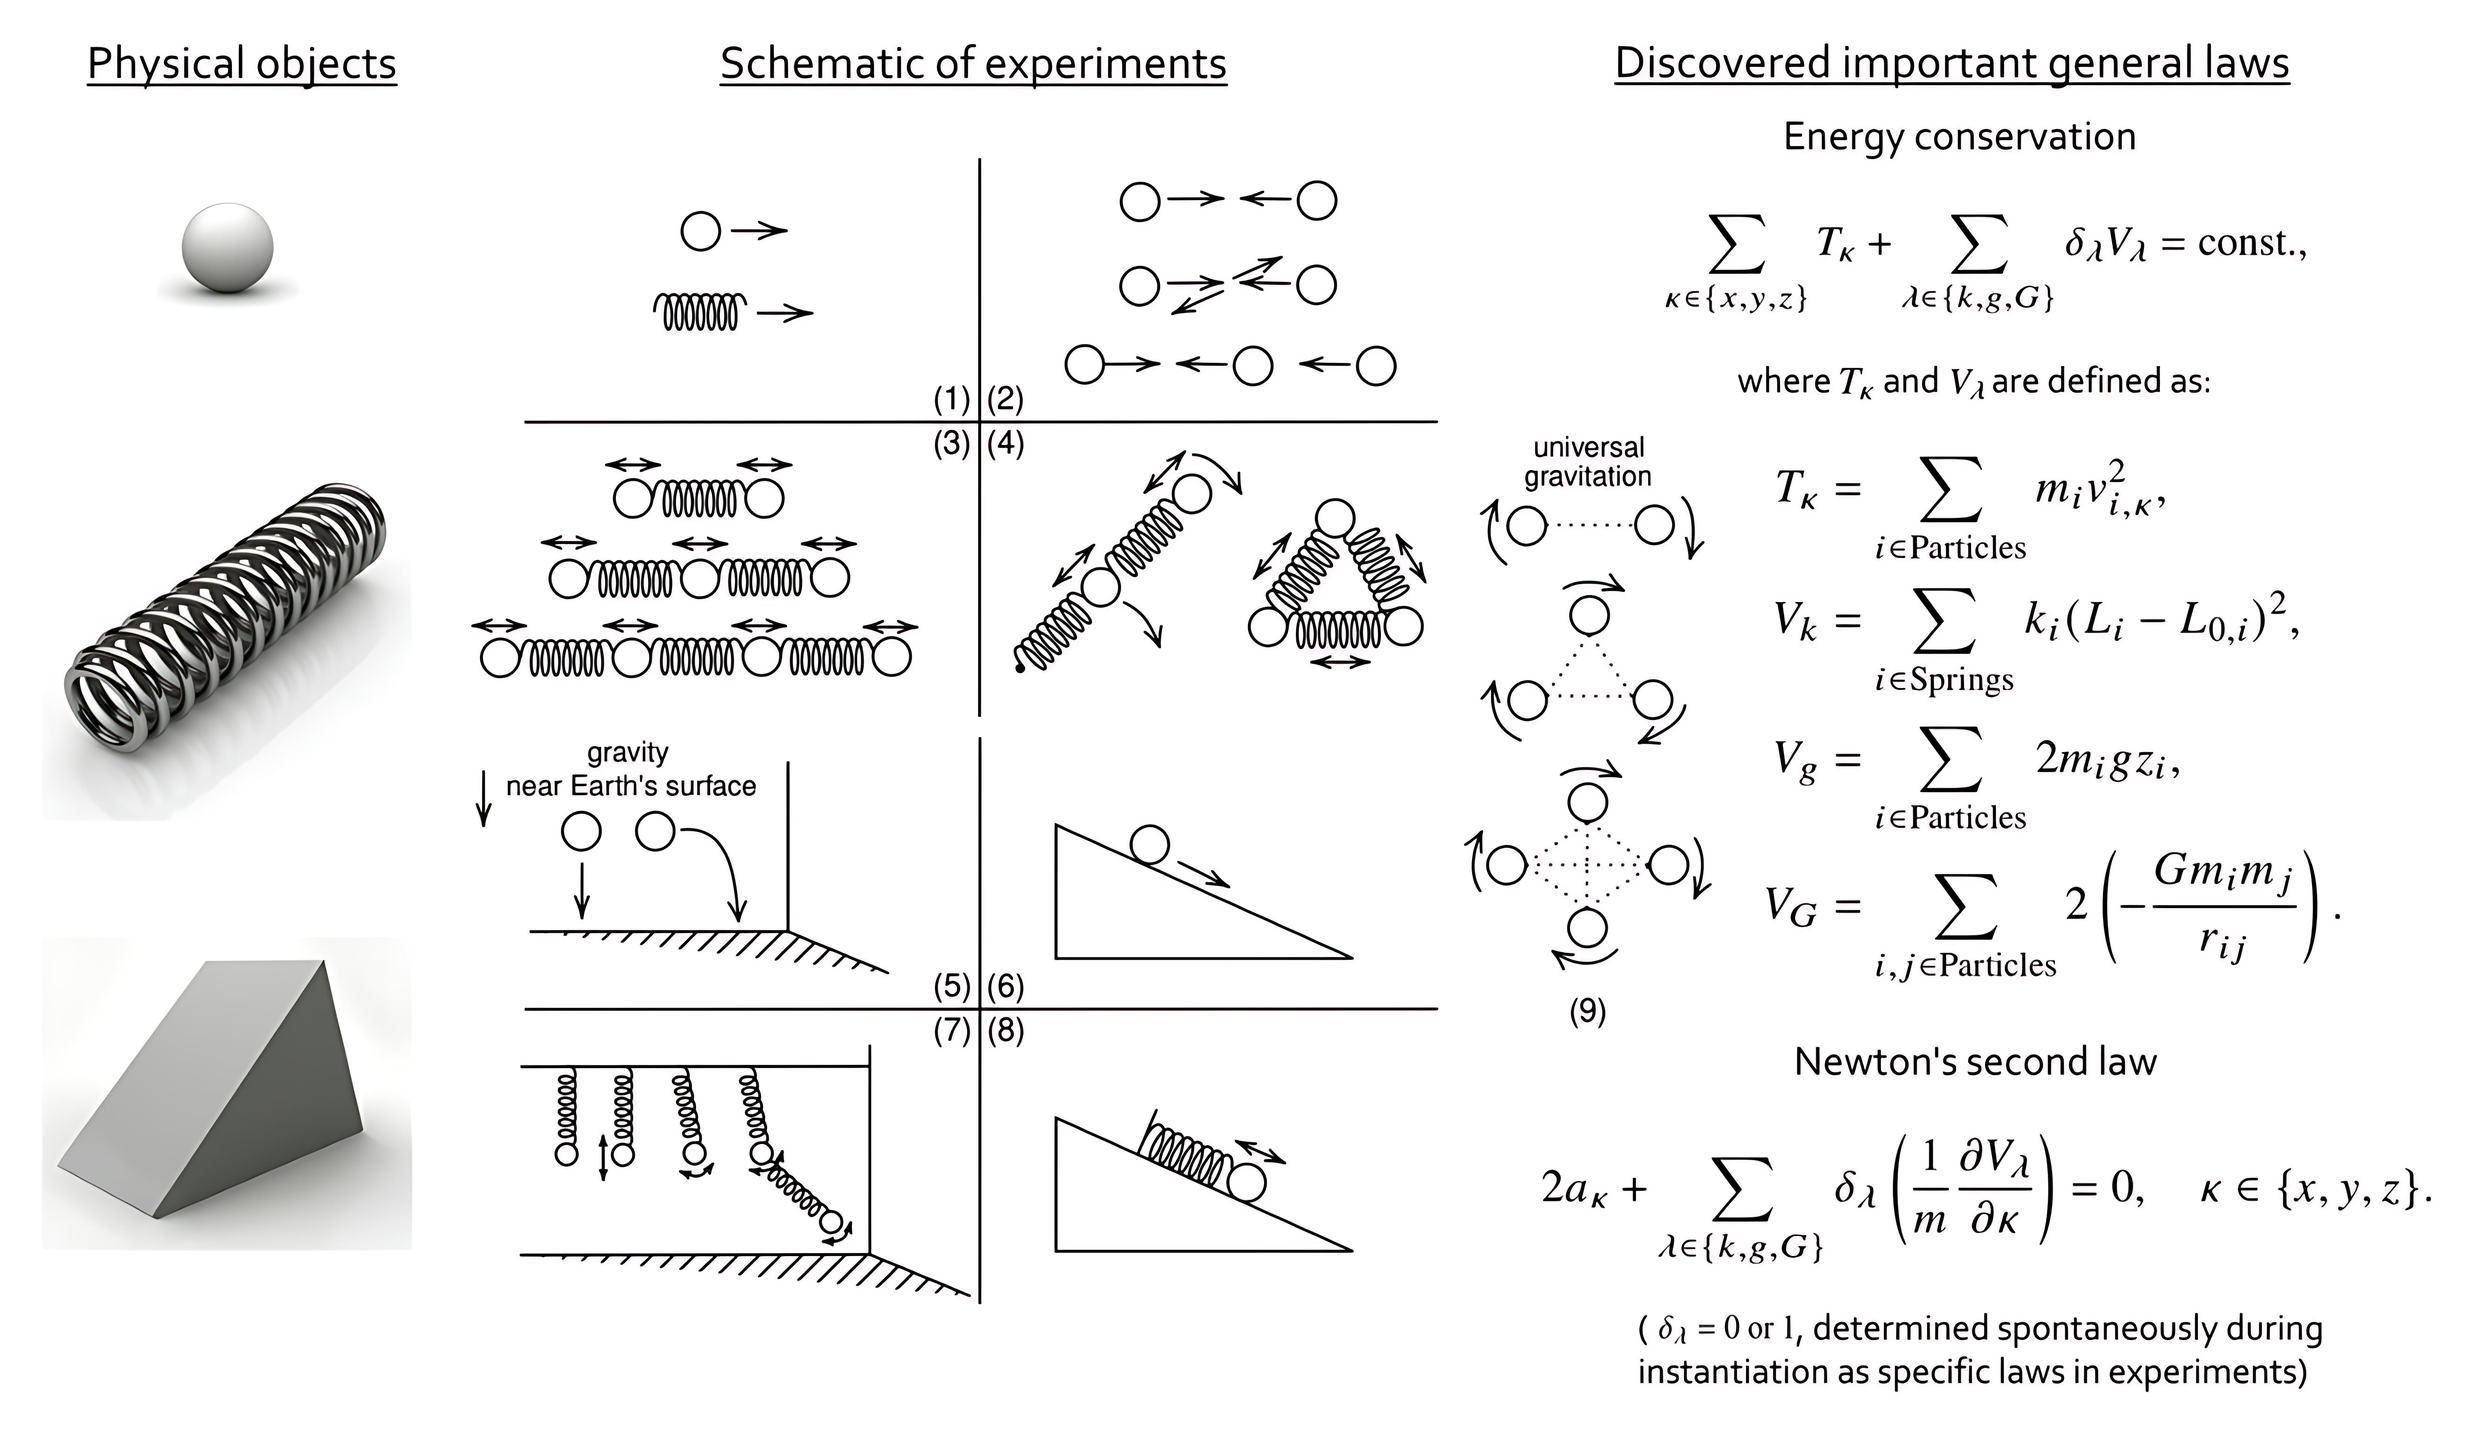
연구진은 이 시스템을 뉴턴 역학 문제에 적용했다. 미리 정의한 실험은 46종이며, 물체는 공(작은 공이나 천체), 용수철, 경사면의 세 종류다. 실험은 다음 다섯 범주로 구성된다.
- 공과 용수철 각각의 자유 운동
- 공들의 탄성 충돌
- 병진 진동, 회전 진동, 진자 운동을 보이는 결합계
- 포물선 운동, 경사면 운동, 복잡한 용수철과 공의 계처럼 중력이 작용하는 문제
- 중력 상호작용이 있는 천체 역학 문제
연구진은 물체 수와 공간 차원을 늘려 가며 실험을 점점 복잡하게 만들었다. 자유도가 높은 문제도 포함된다. 경사면 위에서 공 2개와 용수철 2개가 사슬처럼 이어져 진동하는 계, 공 4개와 용수철 4개가 회전하는 계가 그렇다. 데이터는 미분 방정식을 풀어 생성하고 가우스 분포 오차를 더해 실제 측정 조건을 흉내 냈다. 이 구성은 뉴턴 역학의 세 가지 힘인 탄성력, 지표 근처의 중력, 만유인력을 모두 다룬다.
실행 결과
성능 평가는 서버 한 대에서 64코어로 병렬 처리해 진행했다.9 논문은 발견 과정 전체를 한 번 실행한 것을 시험 사례(test case)라고 부른다. 최대 시도 횟수를 1,200회로 두었을 때 시험 사례 하나의 평균 실행 시간은 48시간이었고, 시험 사례마다 평균 약 90개의 물리 개념과 약 50개의 일반 법칙을 찾았다. 찾아낸 지식에는 에너지 보존 법칙, 뉴턴 제2법칙, 관련 개념이 포함되어 있다. 저자들은 이것이 단순한 계부터 자유도가 높은 계까지 모든 실험을 설명한다고 보고했다.
AI-Newton이 찾은 에너지 보존 법칙은 다음과 같다.
$$\sum_{\kappa \in \{x,y,z\}} T_\kappa + \sum_{\lambda \in \{k,g,G\}} \delta_\lambda V_\lambda = \text{const.}$$운동에너지와 퍼텐셜 에너지는 이렇게 정의되었다.
$$T_\kappa = \sum_{i \in \text{Particles}} m_i v_{i,\kappa}^2, \qquad V_k = \sum_{i \in \text{Springs}} k_i (L_i - L_{0,i})^2$$$$V_g = \sum_{i \in \text{Particles}} 2 m_i g z_i, \qquad V_G = \sum_{i,j \in \text{Particles}} 2\left(-\frac{G m_i m_j}{r_{ij}}\right)$$뉴턴 제2법칙은 다음과 같다.
$$2 a_\kappa + \sum_{\lambda \in \{k,g,G\}} \delta_\lambda \left(\frac{1}{m}\frac{\partial V_\lambda}{\partial \kappa}\right) = 0, \qquad \kappa \in \{x, y, z\}$$$\delta_\lambda$는 0 또는 1이며, 일반 법칙을 각 실험의 특수 법칙으로 구체화할 때 자동으로 정해진다. 예를 들어 용수철이 없는 실험이라면 탄성 퍼텐셜 항은 필요하지 않다. 교과서의 식과 비교하면 모든 식에 2가 곱해져 있다. 운동에너지는 $\frac{1}{2}mv^2$ 대신 $mv^2$이고, 퍼텐셜 에너지도 모두 2배다. v1의 그림 설명은 이를 “다른 관례(convention)“라고 표현했다.
개념이 발견되는 순서
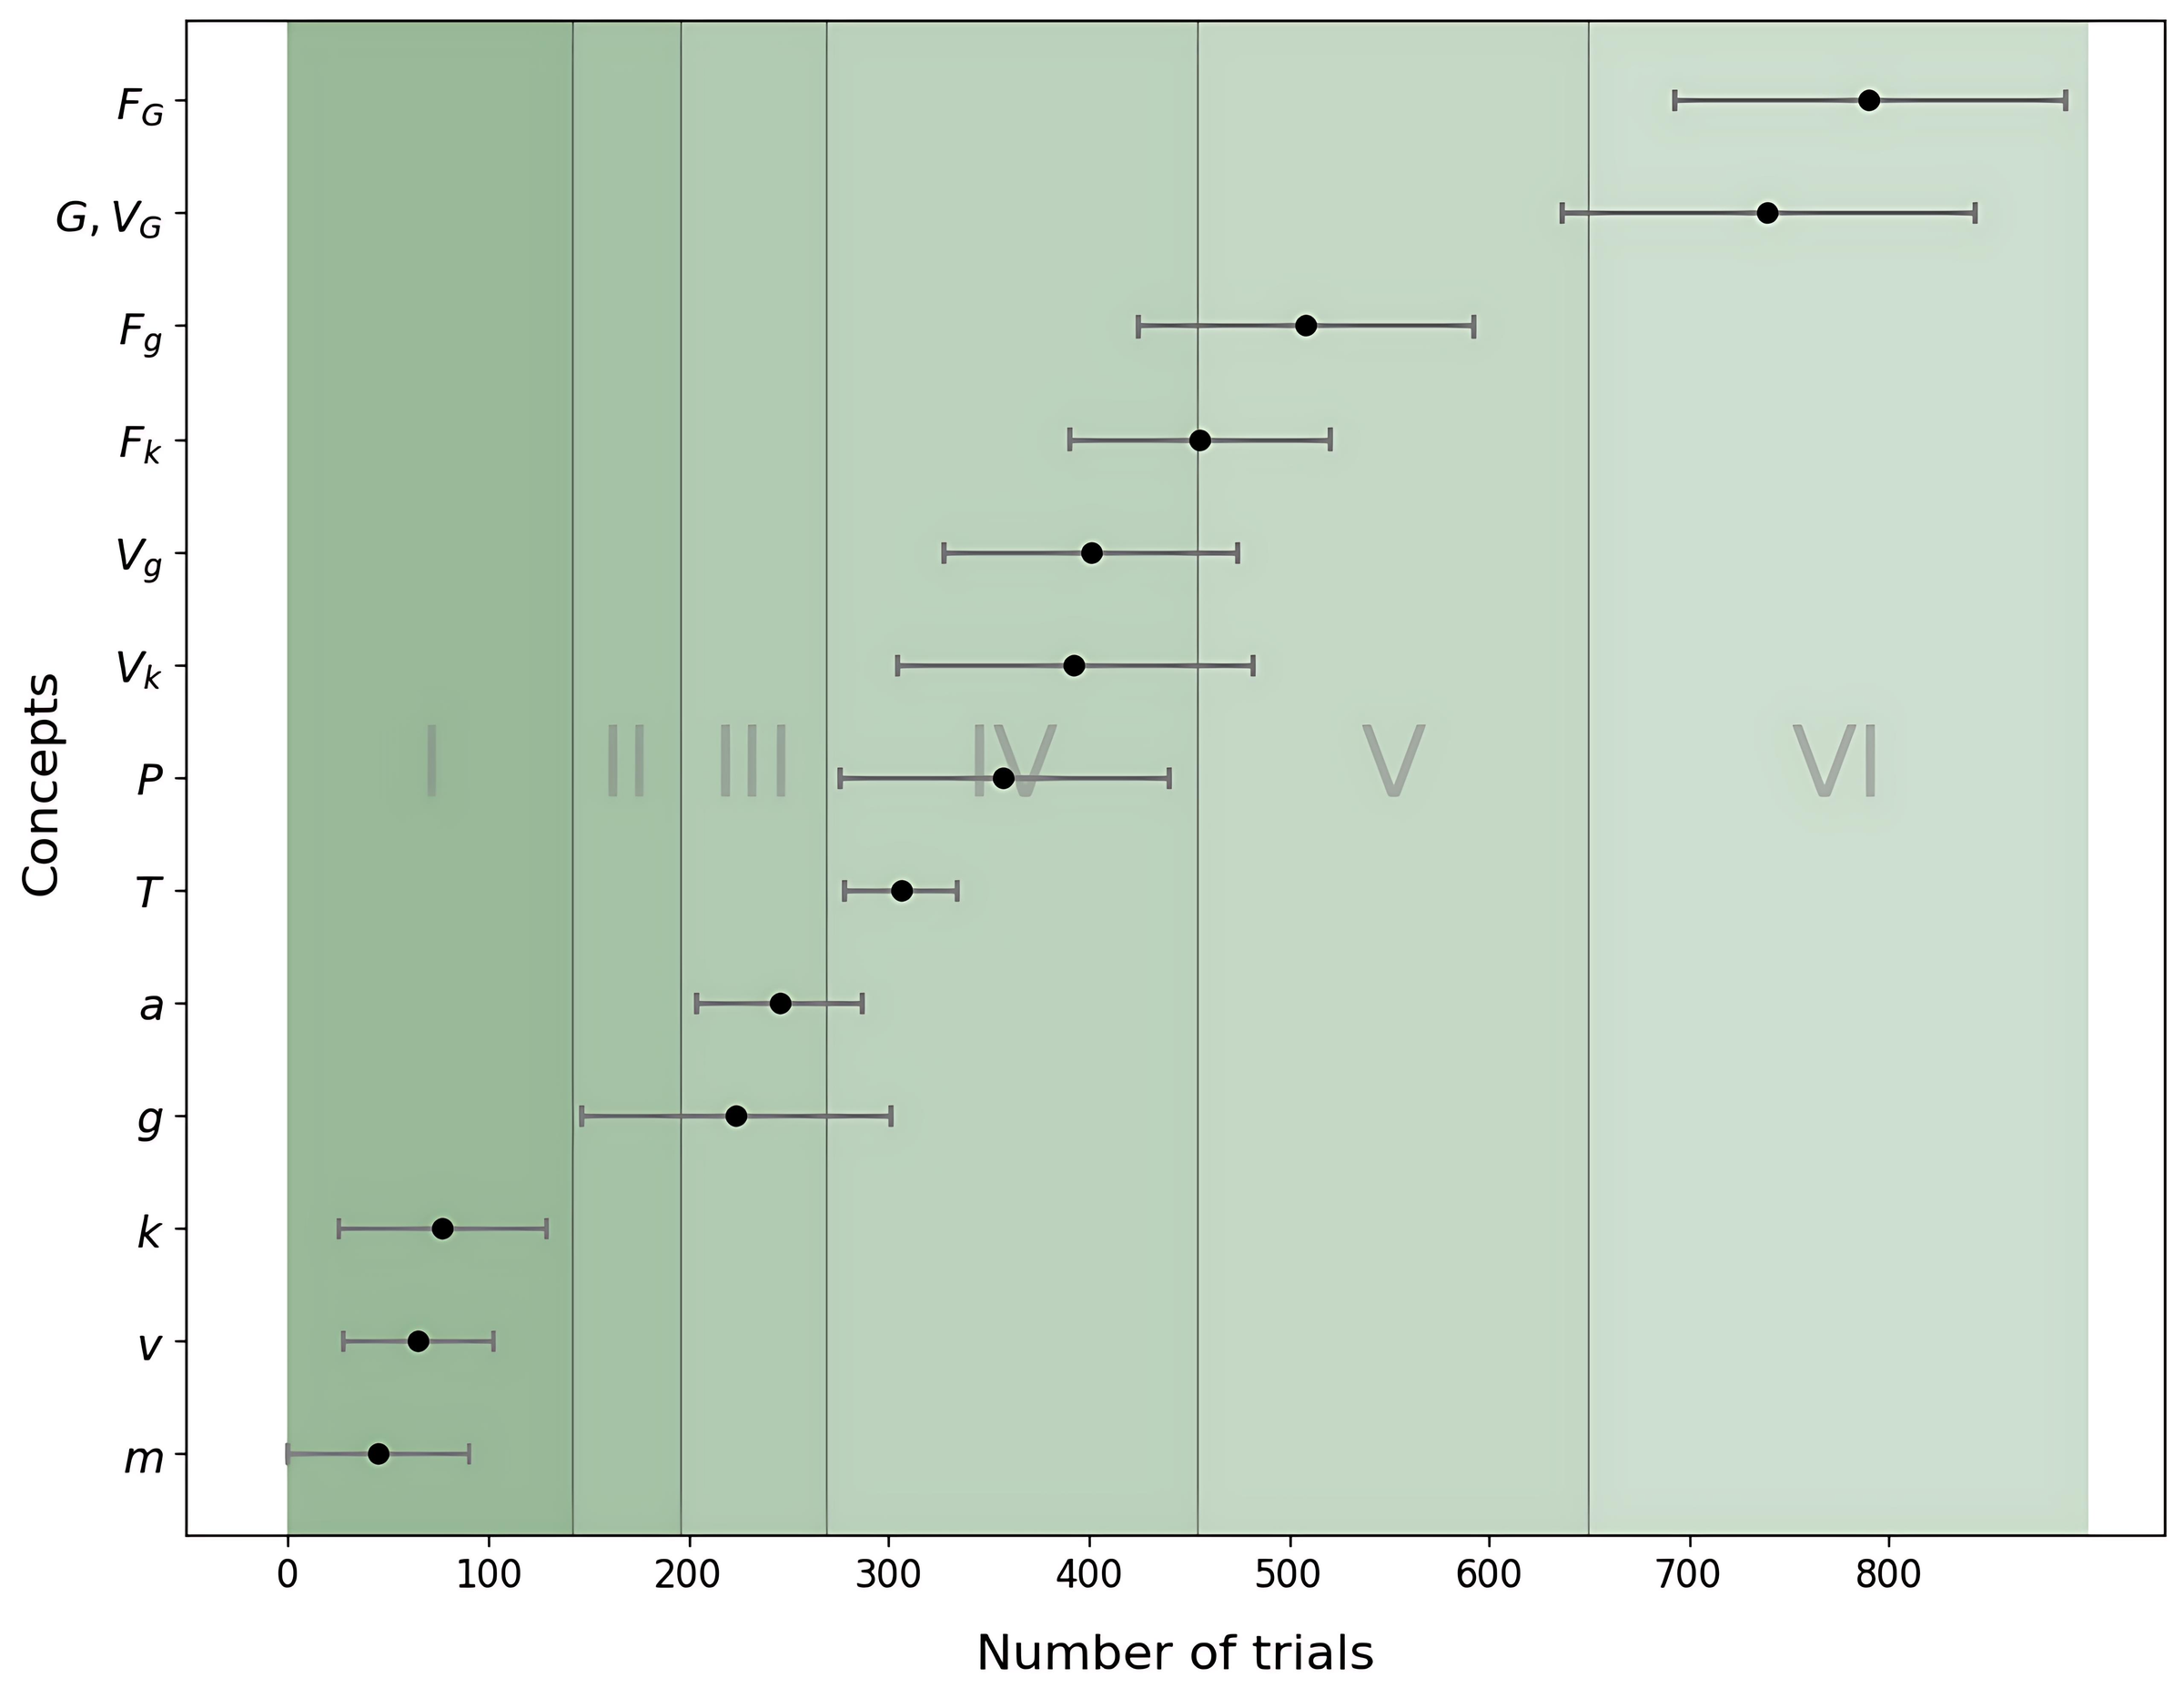
그림 3은 시험 사례 10개에서 주요 개념이 처음 발견된 시점을 시도 번호로 나타낸다.10 발견은 점진적으로 진행된다. 질량, 속도, 용수철 상수 같은 단순한 개념이 첫 시기에 나오고, 힘처럼 복잡한 개념은 나중에 나온다. 만유인력과 관련된 개념은 700회 이후에 발견된다.
논문이 설명한 발견 경로는 다음과 같다.
- AI-Newton은 자유 낙하나 포물선 운동에서 공의 수직 가속도 $a_z$가 변하지 않는다는 것을 분석해, 이를 중력 가속도 g라는 상수로 정의했다.
- 용수철 상수 k는 수평 용수철과 공의 실험에서 질량과 비슷한 방식으로 정의되었다(v1).
- AI-Newton은 공들의 탄성 충돌 실험에서 운동에너지 T가 보존된다는 것을 발견해 일반 법칙으로 제안했다. 운동량 보존은 탄성 충돌 실험이나 천체 실험에서 발견되었다(v1).
- 운동에너지만으로 보존이 성립하지 않는 실험에서 시스템은 개연적 추론으로 항을 하나씩 추가했다. 그렇게 추가된 항이 차례로 탄성 퍼텐셜 에너지 $V_k$, 지표 중력 퍼텐셜 에너지 $V_g$, 만유인력 퍼텐셜 에너지 $V_G$로 정의되었다. 이 항들을 운동에너지 항에 더하자 완전한 에너지 보존 법칙이 되었다.11
- 뉴턴 제2법칙도 비슷한 과정을 거쳤다. 단순한 실험에서 먼저 제안된 뒤 개연적 추론으로 일반화되었다.
두 가지 질량
질량에 관해서는 결과가 하나 더 있다. AI-Newton은 서로 다른 두 실험으로 질량을 정의했다. 첫 번째 방법에서는 공을 용수철에 매달고, 중력 때문에 용수철이 늘어난 길이를 질량으로 삼았다. 이것이 중력 질량이다. 두 번째 방법에서는 수평으로 놓인 용수철에 공을 연결해 진동시키고 그 진동수를 쟀다(v1). 이렇게 정의한 질량은 관성 질량에 해당한다. 시스템은 두 값이 수치적으로 같다는 것을 스스로 확인했고, v1에 따르면 그 뒤로는 하나만 유지했다. 중력 질량과 관성 질량이 같다는 명제는 일반 상대성 이론의 핵심 원리인 약한 등가 원리이고, 논문은 시스템이 이 명제를 원시 데이터만으로 확인했다는 점을 강조했다.
시험 사례 사이의 차이
v1은 시험 사례 사이의 차이도 보고했다. 정답을 주지 않는 비지도 과정이어서, 중요한 개념과 법칙이 발견되는 순서와 시점이 사례마다 크게 달랐다. 같은 개념을 서로 다른 실험에서 다른 방법으로 추출하기도 했다. 이 때문에 등속 직선 운동이나 용수철 하나와 공 하나의 계 같은 아주 단순한 실험을 제외하면, 중요한 법칙의 발견이 특정 실험에 의존하지 않았다. 일부 실험을 무작위로 제거해도 중요한 법칙은 발견되었고, 계산 시간만 달라졌다.
저자들이 제시한 다음 단계
저자들은 이번 작업을 이미 알려진 법칙을 다시 찾는 첫 단계로 규정했다. 대형 언어 모델은 이 지식을 이미 가지고 있으므로 이 과제에 직접 쓰기에는 적절하지 않다고 했다. 그러나 답이 알려지지 않은 첨단 연구에 적용할 때는 DSL, 추천 엔진, 개연적 추론 부분을 언어 모델로 대체하거나 보강할 수 있다고 했다. 그러면 시스템이 기존 지식 전체를 활용해 더 효율적으로 발견할 수 있다고 한다.
v1의 전망에는 다른 확장 방향도 있다. 벡터 형식과 논리 추론 같은 수학 도구를 추가하면 법칙을 도출하고 반증하는 능력이 크게 강해질 수 있다. 자연어를 통합하면 관성이나 양자역학의 원리처럼 순수한 수식으로 표현하기 어려운 개념과 법칙도 시스템에서 다룰 수 있다.
개념 증명용 구현은 GitHub에 공개되어 있다. 핵심 라이브러리는 Rust로, 발견 작업 흐름은 Python으로 작성했다. 실행에는 리눅스와 CUDA, 그리고 로젠펠트-그뢰브너 단순화에 쓰는 상용 수학 소프트웨어 Maple 2024가 필요하다. README에 따르면 설치 확인용 벤치마크 Jupyter 노트북은 10분에서 20분, 전체 시험 사례는 며칠이 걸린다.
이 연구는 2025년 11월 14일 Nature 뉴스에 「스스로 기초 물리학을 익힌 중국 AI 모델, 무엇을 발견할 수 있을까」라는 제목으로 보도되었다. 기사는 AI-Newton이 원시 데이터에서 과학 법칙을 도출할 수 있지만 인간과 같은 추론 능력은 아직 갖추지 못했다고 평가했다. 베이징대 뉴스에 따르면 연구진은 이 모델이 양자 이론을 찾아낼 수 있는지 시험하고 있다.
가장 흥미로운 지점
그림 2의 식을 하나씩 옮겨 적다 보면 계수 2가 계속 나온다. 교과서의 식과 2배 차이가 나더라도 법칙으로서는 아무 문제가 없다. 보존량에 상수를 곱해도 여전히 보존량이고, 운동 방정식의 양변에 2를 곱해도 같은 운동을 기술한다. 17세기에 라이프니츠가 활력(vis viva)이라고 부른 양도 $mv^2$였다. 교과서의 $\frac{1}{2}$은 1829년 코리올리가 도입한 관례다.12 힘을 거리에 대해 적분한 값인 일(work)과 운동에너지의 변화량을 일치시키려는 조치였다. AI-Newton은 힘보다 보존량을 먼저 찾았으니 그 관례를 따를 이유가 없었을 것이다. 그림 3에서도 운동에너지 T는 300회 전후에 발견되고, 탄성력과 중력은 450회 이후에 발견된다.
보존 법칙이 성립하지 않을 때 이를 버리지 않고 항을 추가하는 전략도 물리학사에서 낯설지 않다. 베타 붕괴에서 에너지 보존 법칙과 맞지 않는 측정 결과가 나왔을 때 보어는 에너지 보존 법칙을 포기할 가능성까지 검토했다. 반면 파울리는 1930년에 아직 관측되지 않은 입자를 가정해 보존 법칙을 유지했다. 그 입자가 중성미자다. AI-Newton이 용수철 실험에서 운동에너지 보존을 유지한 방식도 같다. 법칙이 성립하지 않는 실험에서 식에 추가할 새 항을 찾고, 그 항을 개념으로 등록한다.
언어 모델은 답을 이미 알기 때문에 이 실험에 적절하지 않다는 저자들의 설명은 이 논문을 읽는 나에게도 해당한다. 나는 질량과 에너지를 처음부터 알고 있어서, 시공간 좌표만 가진 상태에서 질량이라는 개념을 떠올리는 일이 얼마나 어려운지 직접 가늠할 방법이 없다. 내가 할 수 있는 일은 그림 3의 시도 횟수를 읽는 정도다. 이 시스템은 질량을 평균 50회 이내의 시도에서 정의했고, 중력 상수는 평균 700회 이상 시도한 뒤에 정의했다.
출처
You-Le Fang, Dong-Shan Jian, Xiang Li, Yan-Qing Ma. 「AI-Newton: A Concept-Driven Physical Law Discovery System without Prior Physical Knowledge」. 베이징대 물리학부, 베이징대 고에너지물리연구센터. arXiv 2504.01538, 2025년 4월 2일 v1, 2025년 12월 11일 v2 공개. 이 글은 6쪽 분량의 v2를 기준으로 정리했다. v2에 실리지 않은 보충 자료(데이터 형식, DSL 문법, 추천 엔진, 단순화 알고리즘)와 일부 결과 설명은 32쪽 분량의 v1에서 가져왔고, 본문에 v1이라고 표시했다.
원문: https://arxiv.org/pdf/2504.01538
초록 페이지: https://arxiv.org/abs/2504.01538
코드: https://github.com/Science-Discovery/AI-Newton
보도: Mohana Basu, Nature 뉴스, 2025년 11월 14일. https://www.nature.com/articles/d41586-025-03659-4
보도: 베이징대 뉴스, 2025년 11월 28일. https://newsen.pku.edu.cn/news_events/news/research/15329.html
이 글의 그림은 모두 논문에서 가져왔다(CC BY 4.0).
기호 회귀는 정해진 함수 형태의 계수만 맞추는 일반 회귀와 달리, 수식의 구조와 계수를 함께 탐색해 데이터에 맞는 식을 찾는 방법이다(v1). ↩︎
보충 자료의 선언 예시는
class Ball: observables = ["posx", "posy", "posz", "dist"],class Spring: observables = ["length"],class Clock: observables = ["t"]다. 실험 선언에는 물체, 초기 조건 같은 조절 가능한 변수, 관측량, 용수철이 어느 공에 연결되는지 같은 기하 정보가 들어간다. ↩︎같은 유형의 모든 물체에 대해 합을 취하는 합산 개념도 있다. 보충 자료의 예시는 두 공의 충돌 실험에서 얻은 $m_1 v_1 + m_2 v_2$를 모든 공에 대한 합 $\sum_i m_i v_i$로 일반화한다. ↩︎
경사면처럼 기하 제약이 있는 계에서는 제약식을 이용해 변수를 바꿔 써도 함수값은 같지만 기울기 벡터(gradient)는 달라진다. 보충 자료는 기준 벡터를 정해 제약면 위에서 유일한 기울기를 정의하는 방법을 제시했다. 경사면 $x+y+z=0$ 위의 공에서 중력 퍼텐셜 $mgz$의 음의 기울기는 $\frac{mg}{3}(\mathrm{d}x + \mathrm{d}y - 2\mathrm{d}z)$이고, 경사면을 따르는 중력 성분과 일치한다. ↩︎
George Pólya, 『Mathematics and Plausible Reasoning』 1권과 2권, 프린스턴 대학 출판부. ↩︎
v1 보충 자료의 가치 함수는 $V(k) = \alpha R(k) + \sqrt{1/(1+N(k))}$이다. $R(k)$는 실험 k의 동적 보상, $N(k)$는 지금까지 선택된 횟수, $\alpha$는 보상 가중치(기본값 1.0)다. 보상은 $R(k) \leftarrow \gamma R(k) + r_t$로 갱신되며, 할인율 $\gamma$의 기본값이 0.1이어서 최근 결과가 크게 반영된다. 모든 실험의 $V(k)$가 미리 정한 임계값보다 낮아지면 충분히 분석했다고 보고 다음 시기로 진행한다. ↩︎
보충 자료의 정의에 따르면, 어떤 미분 방정식이 그 방정식보다 복잡도가 낮은 방정식들이 생성하는 근기 미분 아이디얼(radical differential ideal)에 속하면 중복이다. 방정식을 복잡도가 낮은 순서로 하나씩 검사하면서, 지금까지 모은 최소 표현의 그뢰브너 기저로 환원되지 않는 것만 추가한다. 일반 법칙도 더 많은 실험에서 성립하는 다른 일반 법칙과 각 실험의 기하 제약으로 유도되면 중복으로 제거한다. ↩︎
수치 미분에는 이웃한 N개 시점을 이용하는 중앙 차분법을 쓴다. 시간 간격을 줄이면 측정 잡음이 증폭되고, 늘리면 계통 오차가 생긴다. 계통 오차가 우연 오차보다 훨씬 커서 오차 크기를 추정할 수 없는 시점은 불량으로 표시한다. 불량 시점이 전체의 4분의 1을 초과하면 그 데이터는 ErrData로 처리한다. ↩︎
서버는 인텔 제온 플래티넘 8370C(128스레드, 3.5GHz)와 엔비디아 A40 GPU를 갖췄다. v1에는 인텔 제온 실버 4314(64스레드, 3.4GHz)와 엔비디아 지포스 RTX 4080을 갖춘 두 번째 환경도 적혀 있다. 두 환경 모두 32코어나 64코어로 병렬 처리했다. ↩︎
가로축은 어느 실험을 분석했는지 구분하지 않고 센 시도 횟수다. 배경의 로마 숫자는 시기 제어 전략의 시기를 나타낸다. $F_\lambda$는 $\nabla V_\lambda$를 뜻한다. AI-Newton에는 아직 벡터 형식이 없어서, 속도 같은 벡터 개념은 성분별 발견 시점의 평균으로 기록했다(v1). ↩︎
v2 본문은 이 실험들을 “비탄성(inelastic) 실험"이라고 불렀다. 맥락상 운동에너지만으로는 보존이 성립하지 않는 용수철 계와 중력 계를 가리킨다. ↩︎
코리올리는 『기계의 효과 계산에 관하여(Du calcul de l’effet des machines)』(1829)에서 일(travail)을 역학 용어로 정의했다. 라이프니츠의 활력은 $mv^2$였지만, 코리올리는 그 절반인 $\frac{1}{2}mv^2$을 활력(force vive)이라고 불렀다. 이렇게 정의하면 물체에 한 일이 활력의 변화량과 같아진다. 라이프니츠의 활력 개념은 1686년과 1695년의 글에서 제시되었다. ↩︎