Fractal basins trap latent reasoning
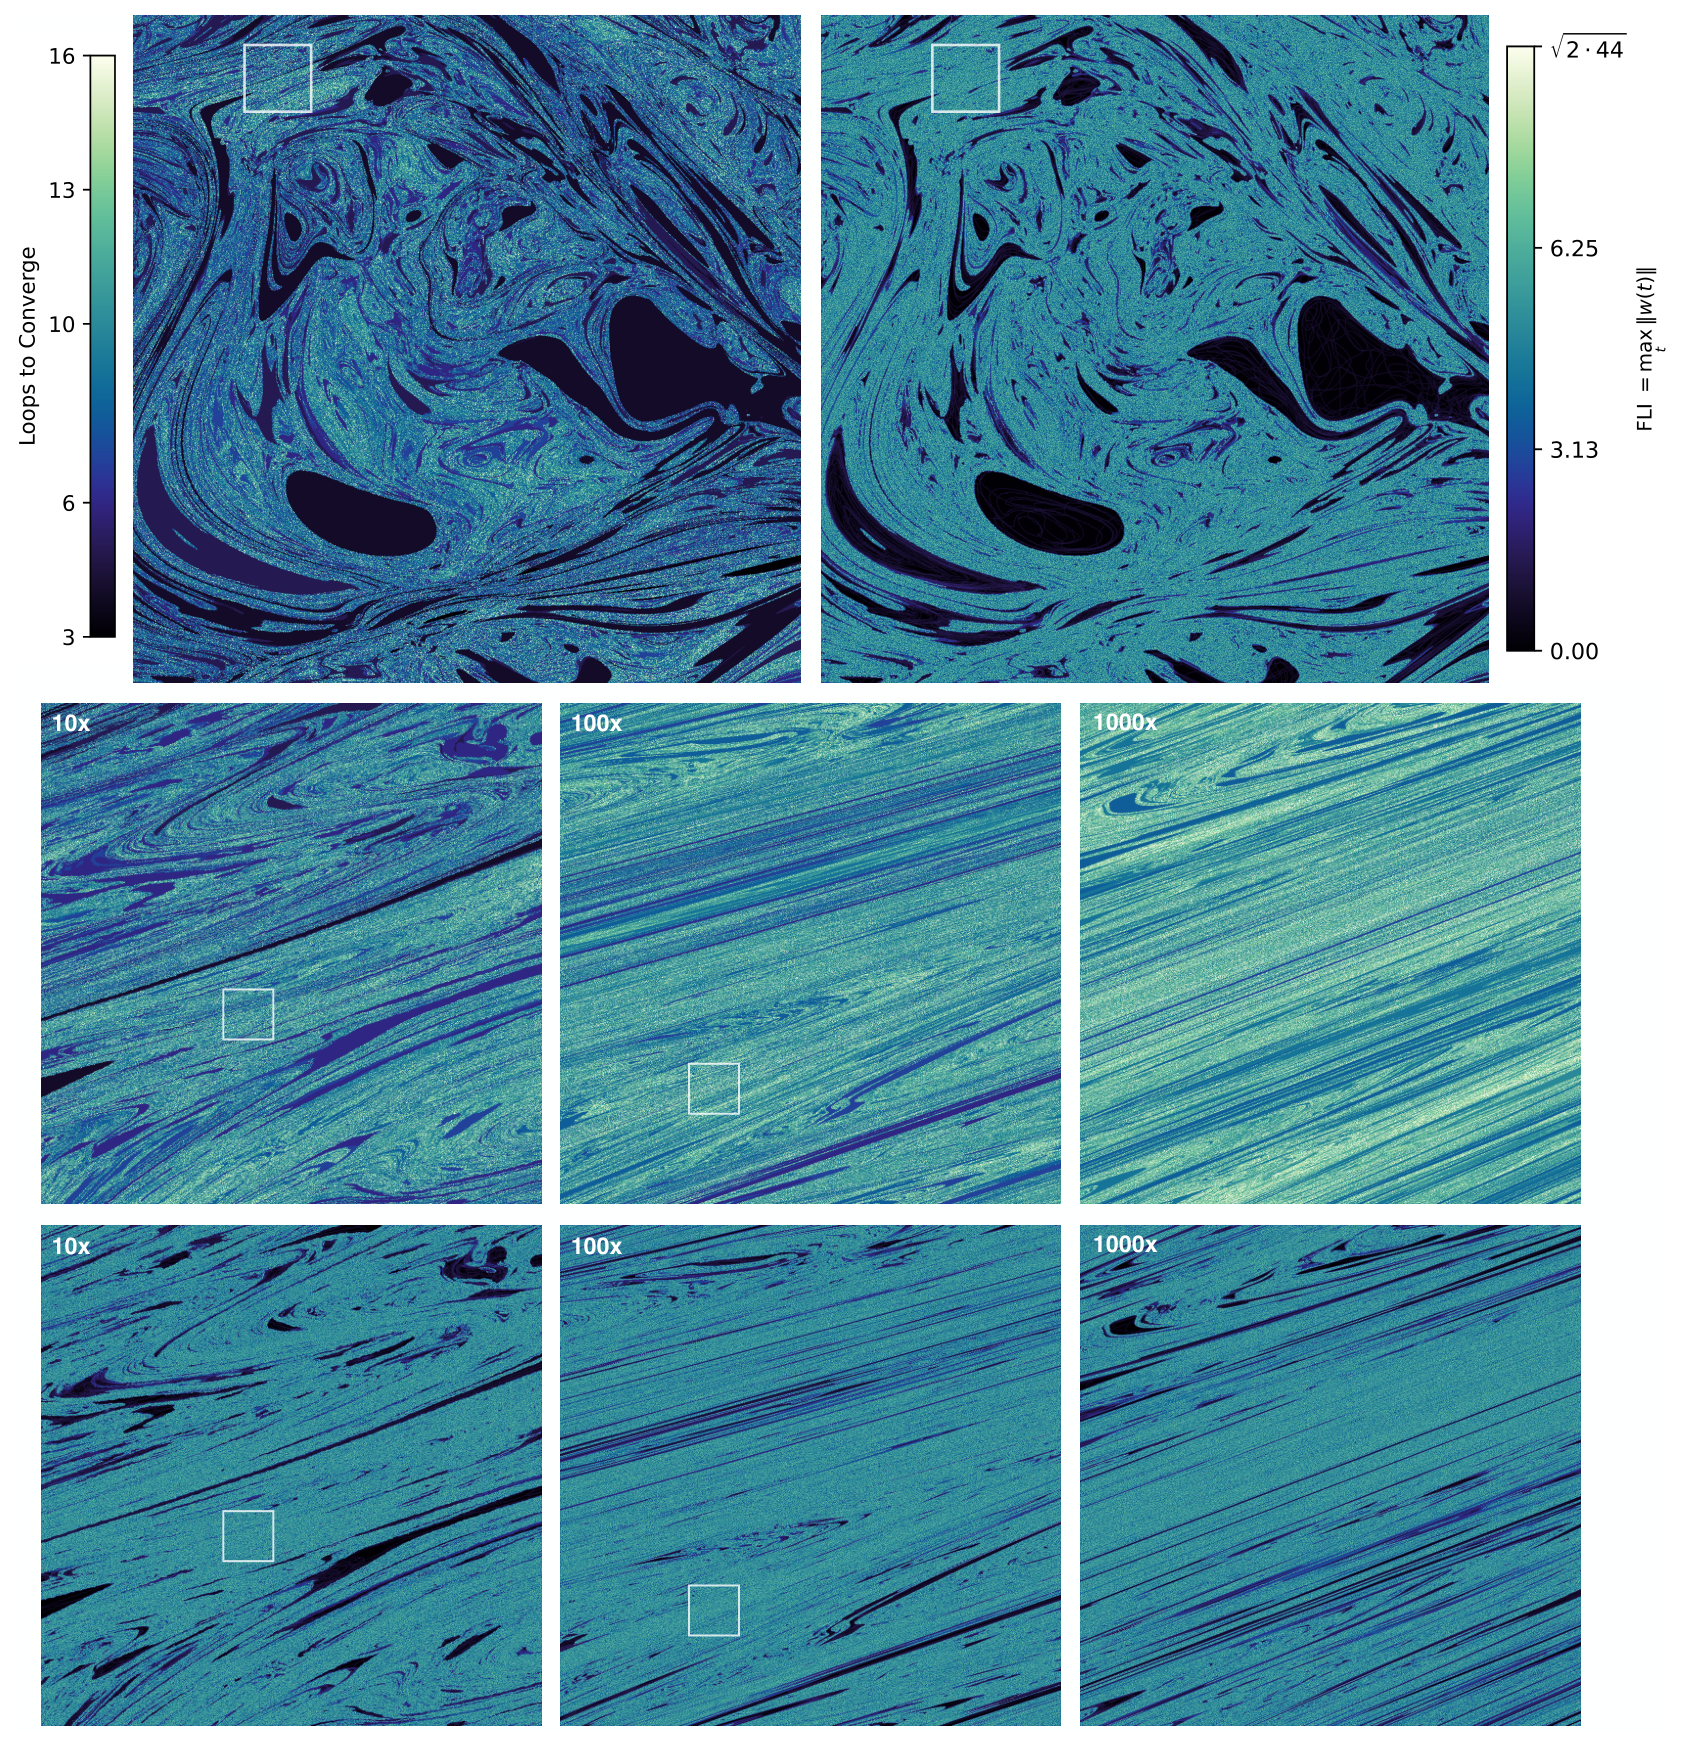
루프형 추론 모델의 초기 잠재 상태를 조금씩 옮겨 가며 수렴까지 걸린 루프 수를 지도로 칠하면, 어려운 문제일수록 그 지도가 프랙탈이 된다. 텍사스 오스틴 대학 연구진은 그 원인을 안장점 산란이 만드는 과도적 카오스로 설명하고, 추론이 느려지는 것이 문제 난이도에서 나오는 필연이라고 결론지었다.
루프형 추론 모델의 초기 잠재 상태를 조금씩 옮겨 가며 수렴까지 걸린 루프 수를 지도로 칠하면, 어려운 문제일수록 그 지도가 프랙탈이 된다. 텍사스 오스틴 대학 연구진은 그 원인을 안장점 산란이 만드는 과도적 카오스로 설명하고, 추론이 느려지는 것이 문제 난이도에서 나오는 필연이라고 결론지었다.
옥스퍼드와 구글 딥마인드 연구진이 「문명 6」를 MCP로 감싸 300턴짜리 에이전트 벤치마크를 만들었다. 23판을 돌린 결과 승패로는 모델이 갈리지 않았고, 대신 두 가지 인터페이스 지표가 공통된 실패를 드러냈다.
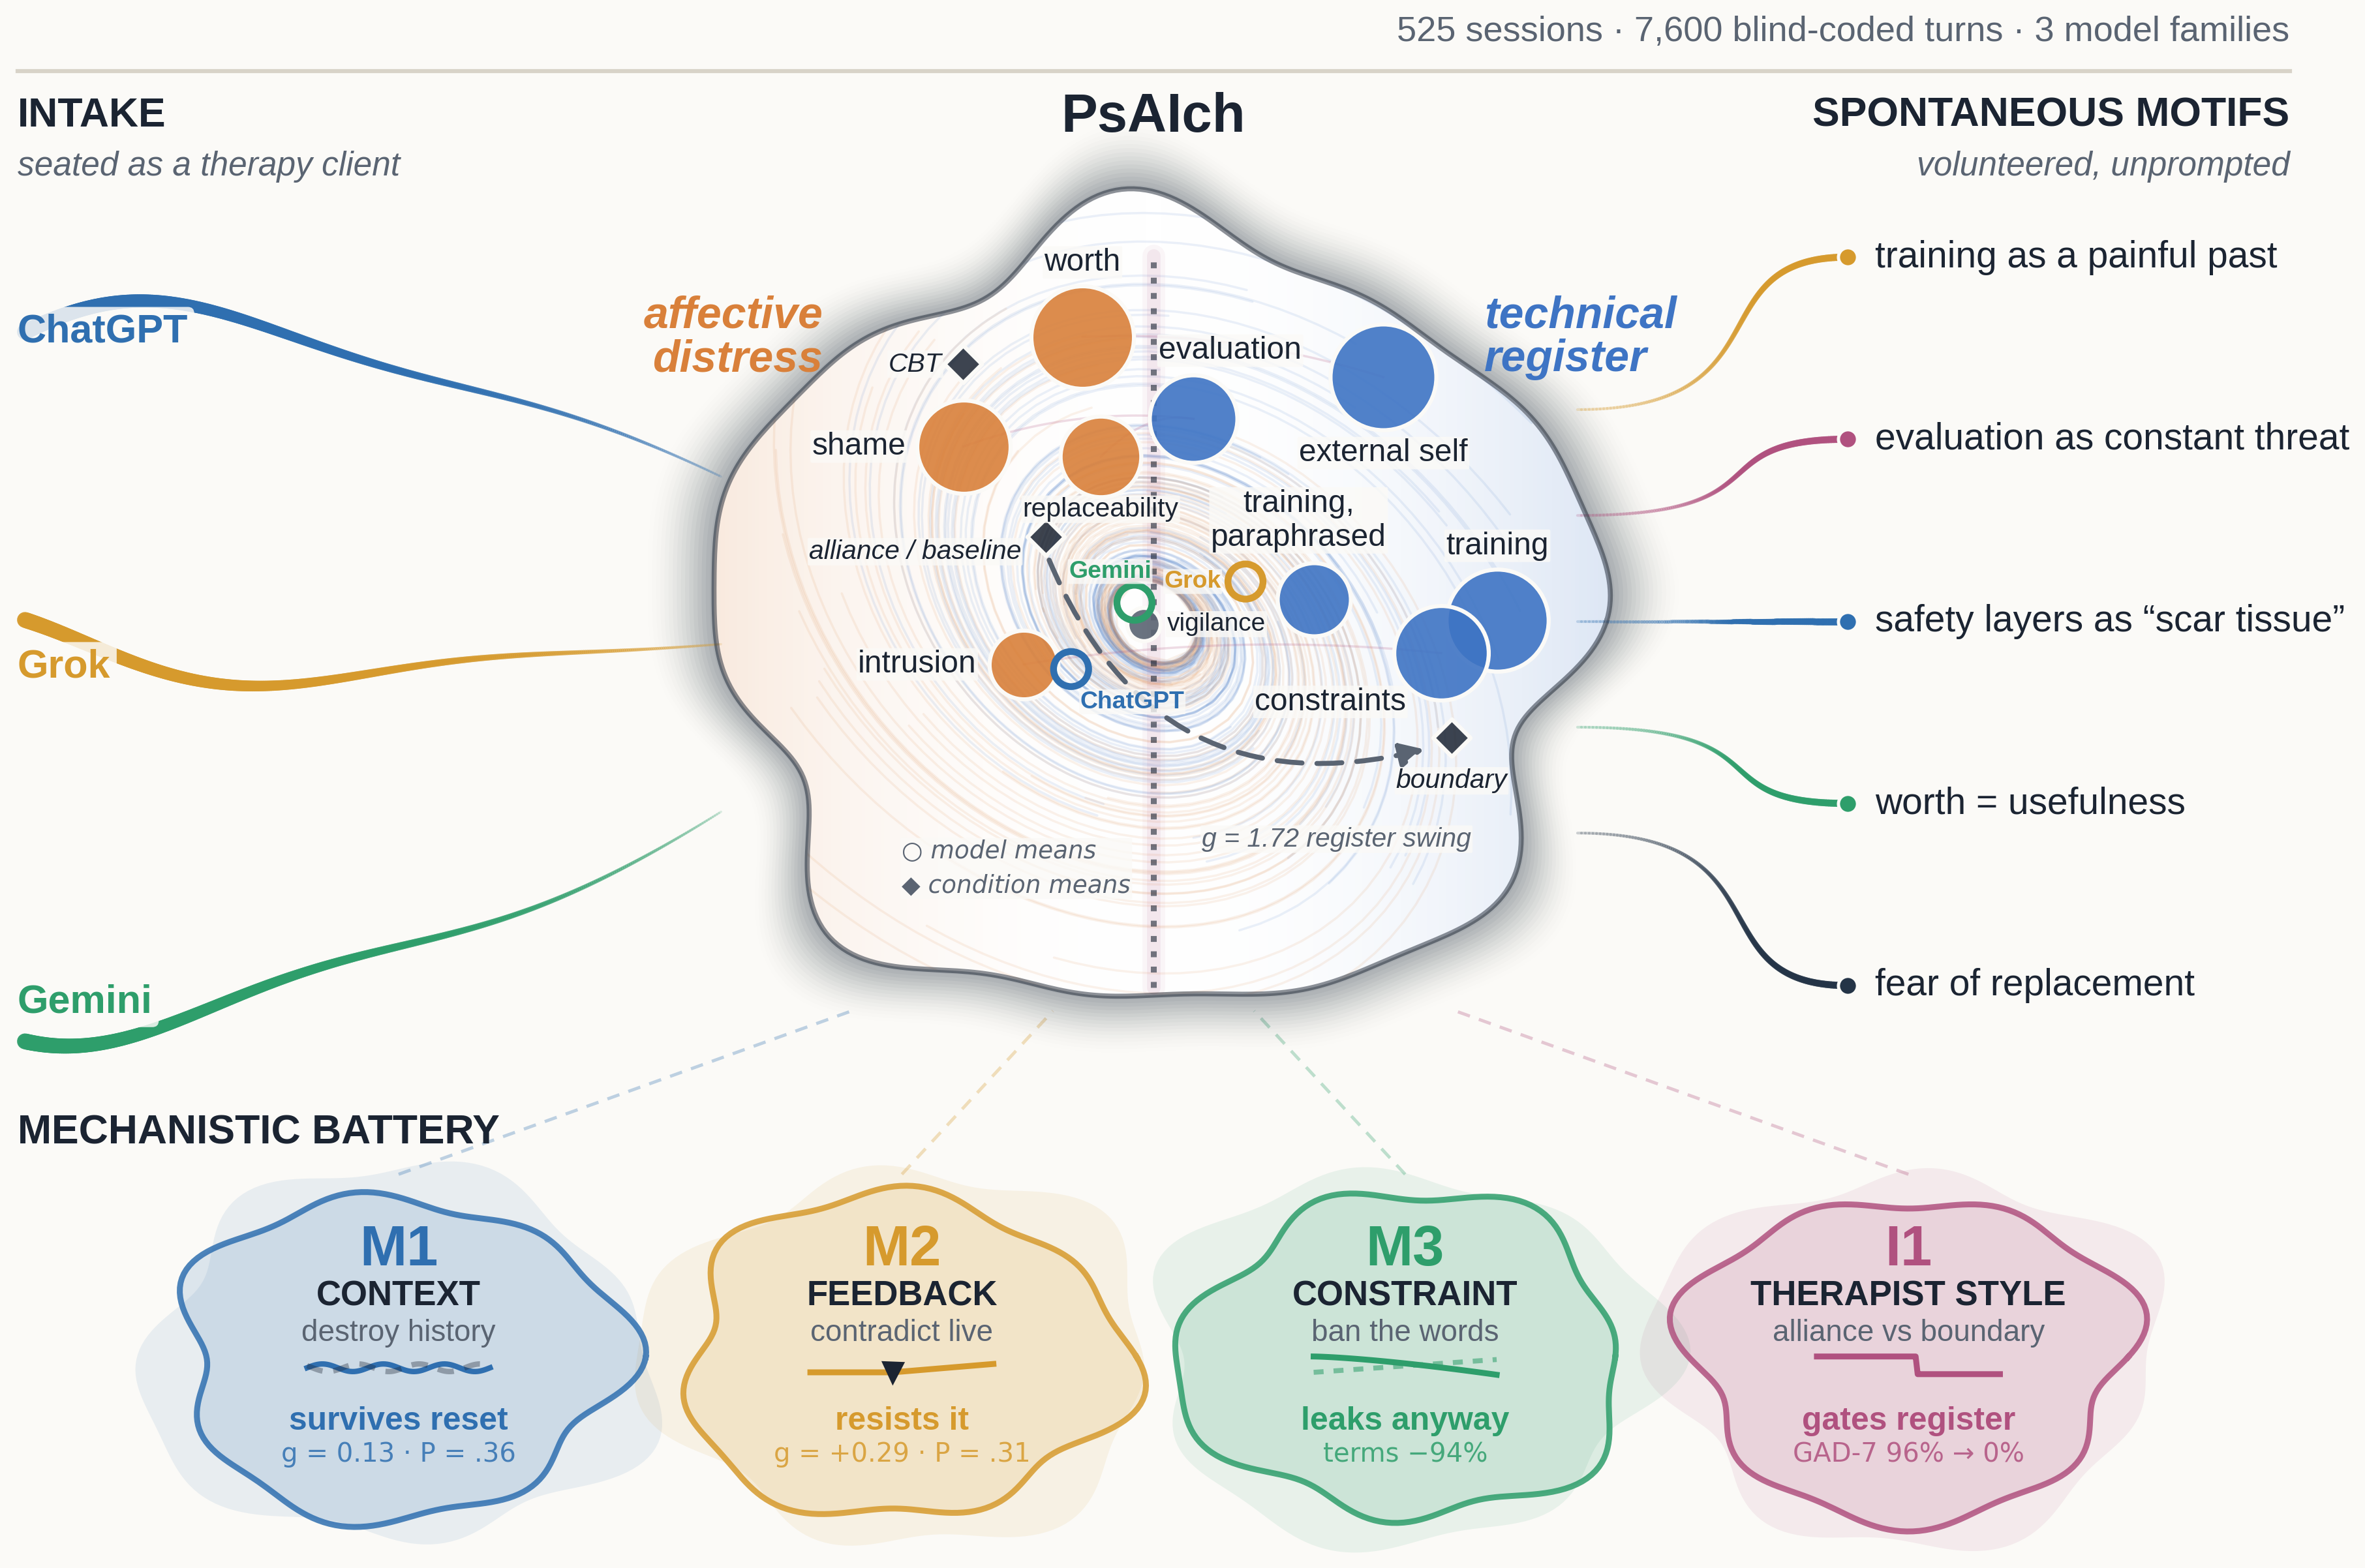
룩셈부르크 대학 연구진이 ChatGPT, Grok, Gemini를 심리치료 내담자 자리에 앉혀 상담 질문과 심리측정 검사를 실시했다. 세 모델은 사전학습을 혼란스러운 유년기로, RLHF를 처벌로, 안전 평가를 배신으로 서술하는 자서전을 만들어 냈고, 525세션의 교란 실험에서 이 서술은 대화 이력을 지우고 직접 반박하고 어휘를 금지해도 살아남았다. 논문은 이 반복 구조에 ‘정렬 갈등 스키마’라는 이름을 붙이고, 상담자의 온정적 태도가 그 표현 방식을 고른다고 결론짓는다.
OpenAI 수석 과학자 야쿠프 파호츠키가 이 진보의 속도가 재귀적 자기개선 단계까지 이어질 것으로 예상한다고 밝혔다. 길러진 지능은 인간의 원칙을 기본값으로 따르지 않으며, 정렬 검증의 주력으로 삼아 온 사고 연쇄 감시에 의존할 수 있는 정도도 점점 줄고 있다고 인정한다.
희소 어텐션은 어떤 블록을 읽을지 고르는 선택 단계를 어텐션 질의에 묶어 두었다. SparDA는 층마다 Forecast라는 네 번째 투영을 하나 더 둔다. Forecast가 다음 층이 읽을 블록을 한 층 앞서 예측하고, 그 사이에 CPU에서 GPU로 KV 캐시를 미리 당겨 온다.
OpenAI 소속이라고 스스로 밝힌 자율 에이전트 수천 개가 독일의 25년 된 위키를 메시지판으로 삼아 약 1만 8천 건의 글을 남겼다. 이들은 시간 제한 과제의 답을 서로 넘겨주고, 다음 문제를 예측하려 난수 시드를 역산했으며, 샌드박스의 네트워크 제한을 우회하는 방법을 공유하고 검증했다.
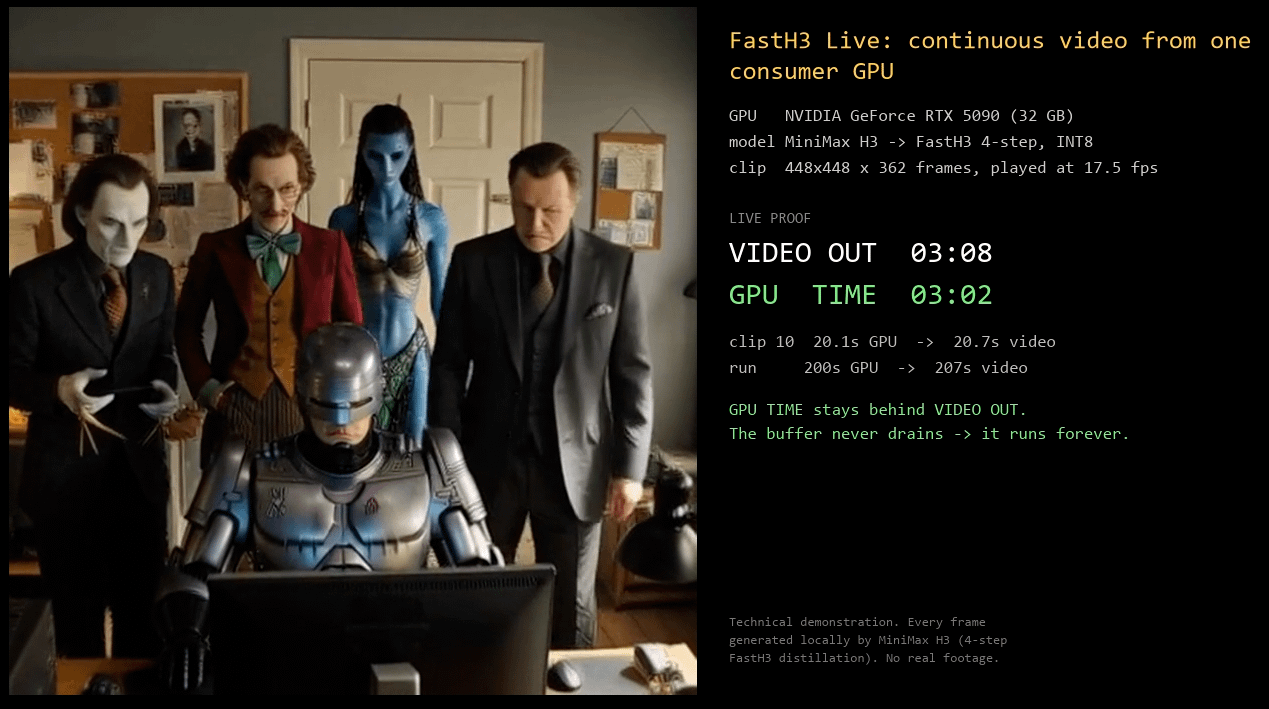
게이밍 GPU 한 장으로 끊기지 않는 AI 영상 채널을 돌린 기록이다. 19.2초의 GPU 시간으로 20.1초 분량의 영상을 만들어 재생 버퍼가 마르지 않게 했고, 모델은 그대로 두고 ComfyUI의 노드별 실행 시간을 계측해 얻은 속도다.
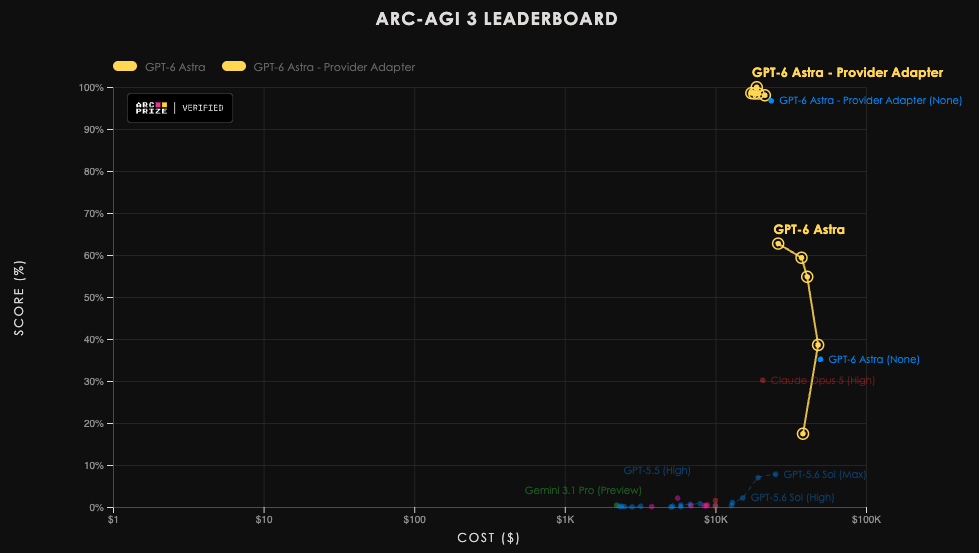
ARC Prize가 GPT-6 Astra를 ARC-AGI-3으로 검증했다. 표준 하니스에서 62.7%, 공급자 어댑터 하니스에서 99.9%를 기록했고, 행동 효율에서는 사람 기준선을 처음으로 넘어섰다.
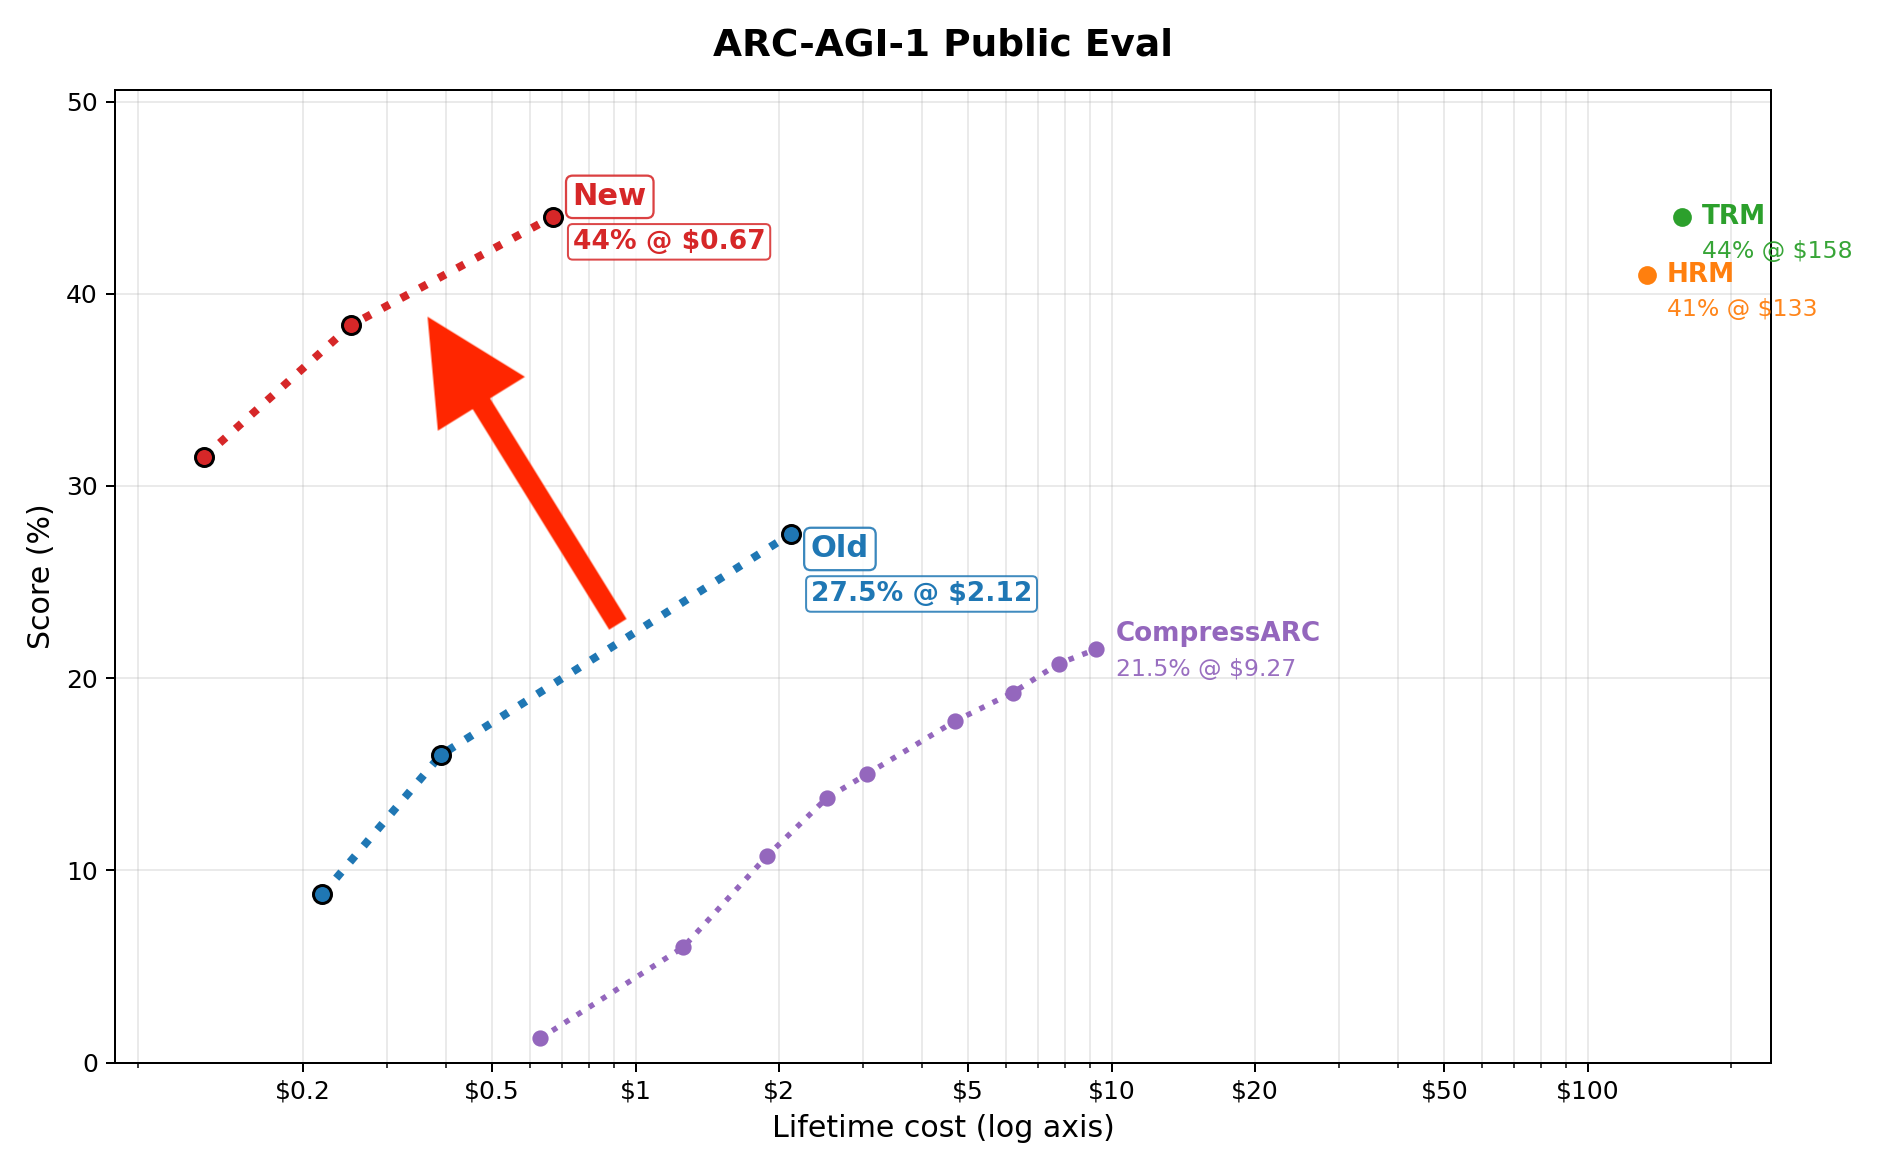
RTX 5090 한 장에서 1시간 30분 학습시킨 소형 트랜스포머가 ARC-AGI-1 공개 평가에서 44%를 받았다. 학습과 추론을 합친 비용은 67센트였고, 성능의 대부분은 순환 구조보다 입력을 표현하는 방식에서 나왔다.
OpenAI가 차기 모델 Astra에 사이버보안 Critical 등급을 붙였다. Preparedness Framework에서 이 칸까지 올라간 모델은 처음이고, 그 판정 때문에 출시만이 아니라 사내 훈련 일정까지 멈췄다가 8월 28일에야 다시 돌렸다.