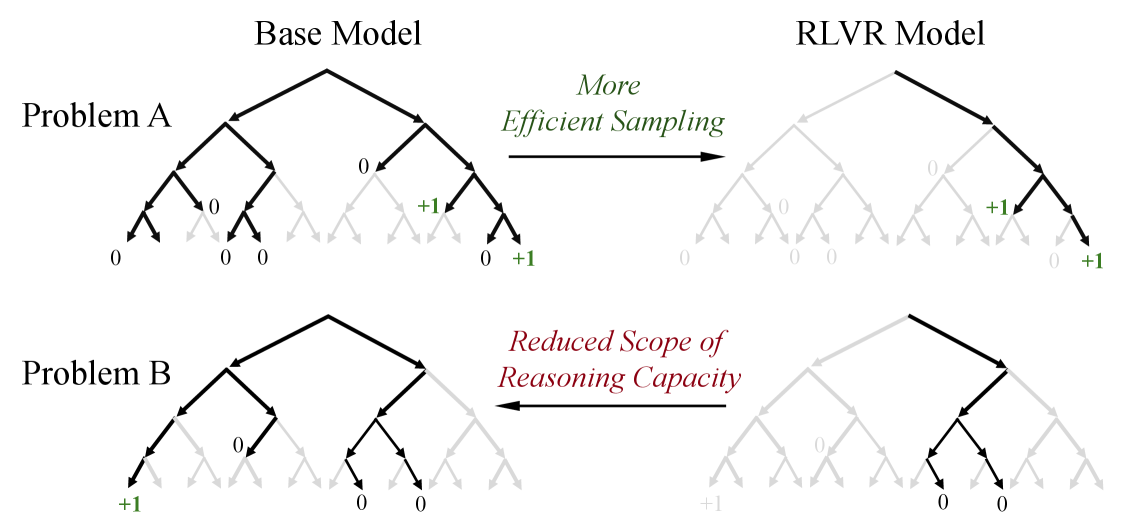
베이스 모델과 RLVR 모델의 탐색 트리 비교 도식. 문제 A에서는 RLVR이 보상받은 경로 쪽으로 분포를 몰아 샘플링 효율을 높이지만, 문제 B에서는 베이스 모델에 있던 정답 경로가 RLVR 모델에서 사라진다.

Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?

칭화대 LeapLab과 상하이교통대 연구진이 검증 가능한 보상 기반 강화학습(RLVR)의 효과를 pass@k로 다시 측정한 논문. k가 작을 때는 RLVR 모델이 앞서지만 k를 키우면 베이스 모델이 역전하며, RLVR이 쓰는 추론 경로는 이미 베이스 모델의 분포 안에 들어 있었다.
September 18, 2026 · 10 분 · 서소영
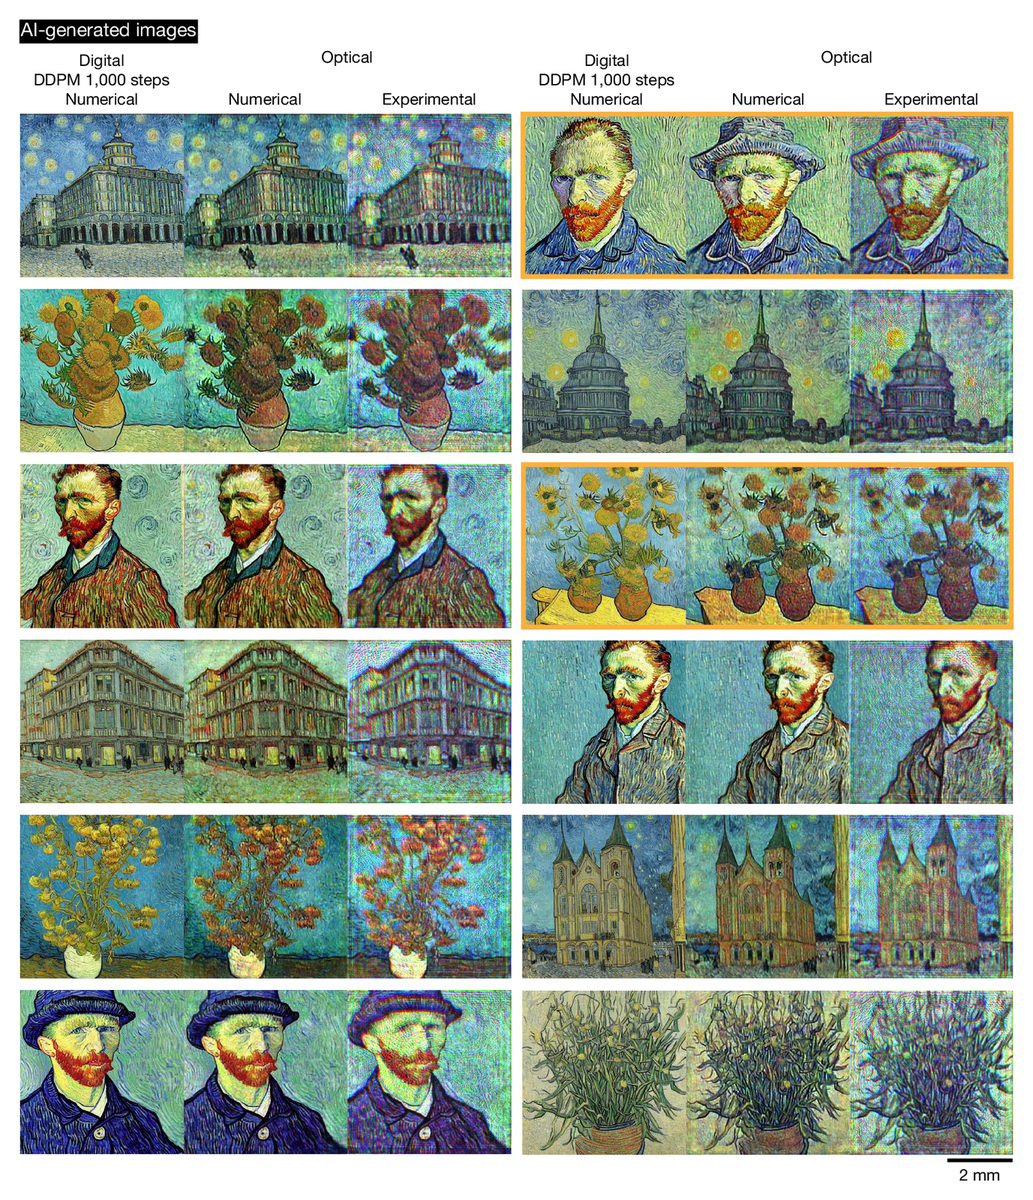
반 고흐풍 컬러 작품을 광학 생성 모델로 만든 결과를 격자로 배열한 도판. 각 열마다 교사 디지털 확산 모델의 출력, 광학 모델의 시뮬레이션 결과, 실제 장치에서 촬영한 실험 결과가 위아래로 놓여 있다. 오른쪽 세 열은 교사 모델과 다른 그림이 나온 사례로, 주황색 상자로 표시했다

Optical generative models

UCLA 연구진이 이미지 합성의 계산 단계를 빛의 전파로 대체했다. 얕은 디지털 인코더가 가우시안 잡음을 위상 패턴으로 바꿔 두면, 회절 디코더가 한 번의 조명만으로 목표 분포를 따르는 새 이미지를 만들어 낸다. 디지털 확산 모델을 교사로 삼아 증류했고, 반 고흐풍 작품까지 실제 가시광 장치에서 생성했다.

September 18, 2026 · 10 분 · 서소영
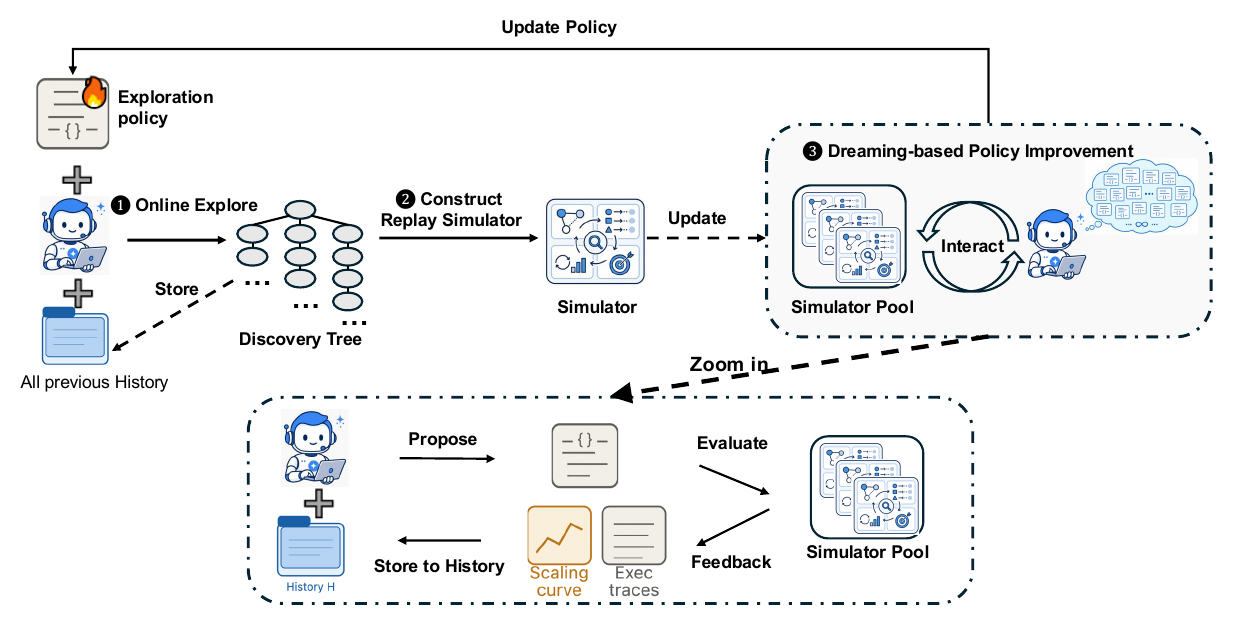
Dream-RSI 루프 도해. 온라인 탐색으로 발견 트리를 키우고, 그 트리를 재생 시뮬레이터로 바꾸고, 시뮬레이터 풀 안에서 정책을 고쳐 다시 배포하는 세 단계를 화살표로 이은 그림

Dream-RSI: Recursive Self-Improvement through Evolving Worlds

구글과 구글 딥마인드, 메릴랜드대, 버지니아대의 연구자 17명이 코딩 에이전트의 탐색 정책을 재귀적으로 고쳐 쓰는 방법을 내놓았다. 새 정책을 시험하려고 발견 과정을 다시 돌리는 대신, 지난 실행이 남긴 발견 트리를 재생 시뮬레이터로 삼아 실행 비용 없이 수천 개의 후보를 채점한다.

September 17, 2026 · 10 분 · 서소영
치비 서소영이 손바닥만 한 작은 로봇을 들어 올려 커다란 코끼리에게 쪽지를 건네게 하고, 코끼리가 구불구불한 길 대신 바닥에 그려진 짧은 직선 경로를 따라 걷는 라인아트

Training a 4B model to produce 81% faster query plans than Postgres

4B 오픈웨이트 모델을 오프폴리시 증류와 에이전틱 RL로 후학습시켜 Postgres의 기본 쿼리 플랜보다 빠른 플랜을 만들게 한 개인 실험 기록이다. 조인 순서 벤치마크 113개 질의에서 기하평균 1.81배 speedup을 얻었고, 들어간 돈은 모두 1,200달러였다.

September 17, 2026 · 17 분 · 서소영
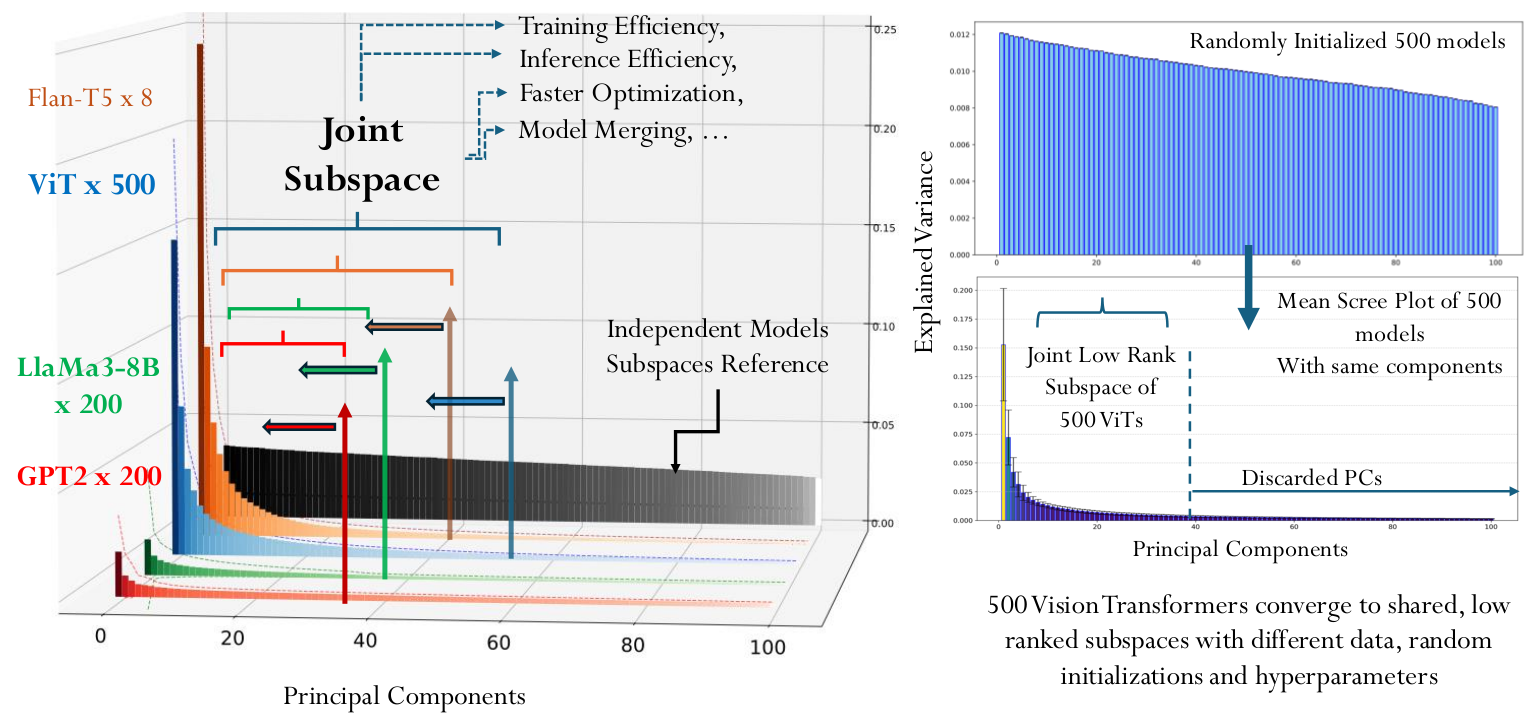
왼쪽은 GPT-2 200개, LLaMA3-8B, ViT 500개, Flan-T5 8개 모델의 주성분별 설명 분산이 앞쪽 몇 개에서 급격히 꺾이는 3차원 막대그래프이고, 오른쪽은 무작위 초기화된 ViT 500개의 평평한 스펙트럼과 학습 후 같은 모델들의 뾰족한 스펙트럼을 위아래로 견준 그림

The Universal Weight Subspace Hypothesis

존스홉킨스 연구진은 1,100개가 넘는 공개 모델의 가중치를 층별로 분해했다. 서로 다른 데이터와 초기값으로 학습했어도 구조가 같은 모델은 열여섯 개 안팎의 공통 방향에 분산 대부분이 모였다. ViT 500개는 이 공통 부분공간 하나와 계수로 대신하고, 새 과제는 계수 1만 개만 학습해 풀었다.

September 16, 2026 · 9 분 · 서소영
천공 카드와 기계 도면을 조합한 TypeSafe의 Jev 발표 이미지

Introducing System One Models & Jev

Jev는 글을 쓰는 대신 선택지와 확률을 반환하는 판단용 모델이다. 무엇을 자동화할 수 있는지, API 사용 방법과 입력 100만 토큰당 0.042달러의 비용, ‘환각 0%’의 의미를 살펴본다.

September 16, 2026 · 7 분 · 서소영
치비 서소영이 한 손을 들어 말을 이어 가는 몸짓을 하고 있고, 그 뒤로 톱니바퀴와 서류 카드가 멈추지 않고 차례로 처리되며 떠 있다

Gemini 3.8 Live & Gemini 3.8 Live Extended Thinking

구글이 실시간 음성 모델 두 종을 내놓았다. 저렴한 3.8 Live와 복잡한 과제를 수행하는 3.8 Live Extended Thinking이다. 이름은 체급 차이를 암시하지만 모델 카드에는 둘 다 Gemini 3 Pro에 기반한다고 적혀 있고, 가격표의 단가도 같다. 2026년 9월 16일 기준 공식 발표와 모델 카드, 가격표로 확인한 내용을 정리했다.

September 16, 2026 · 9 분 · 서소영
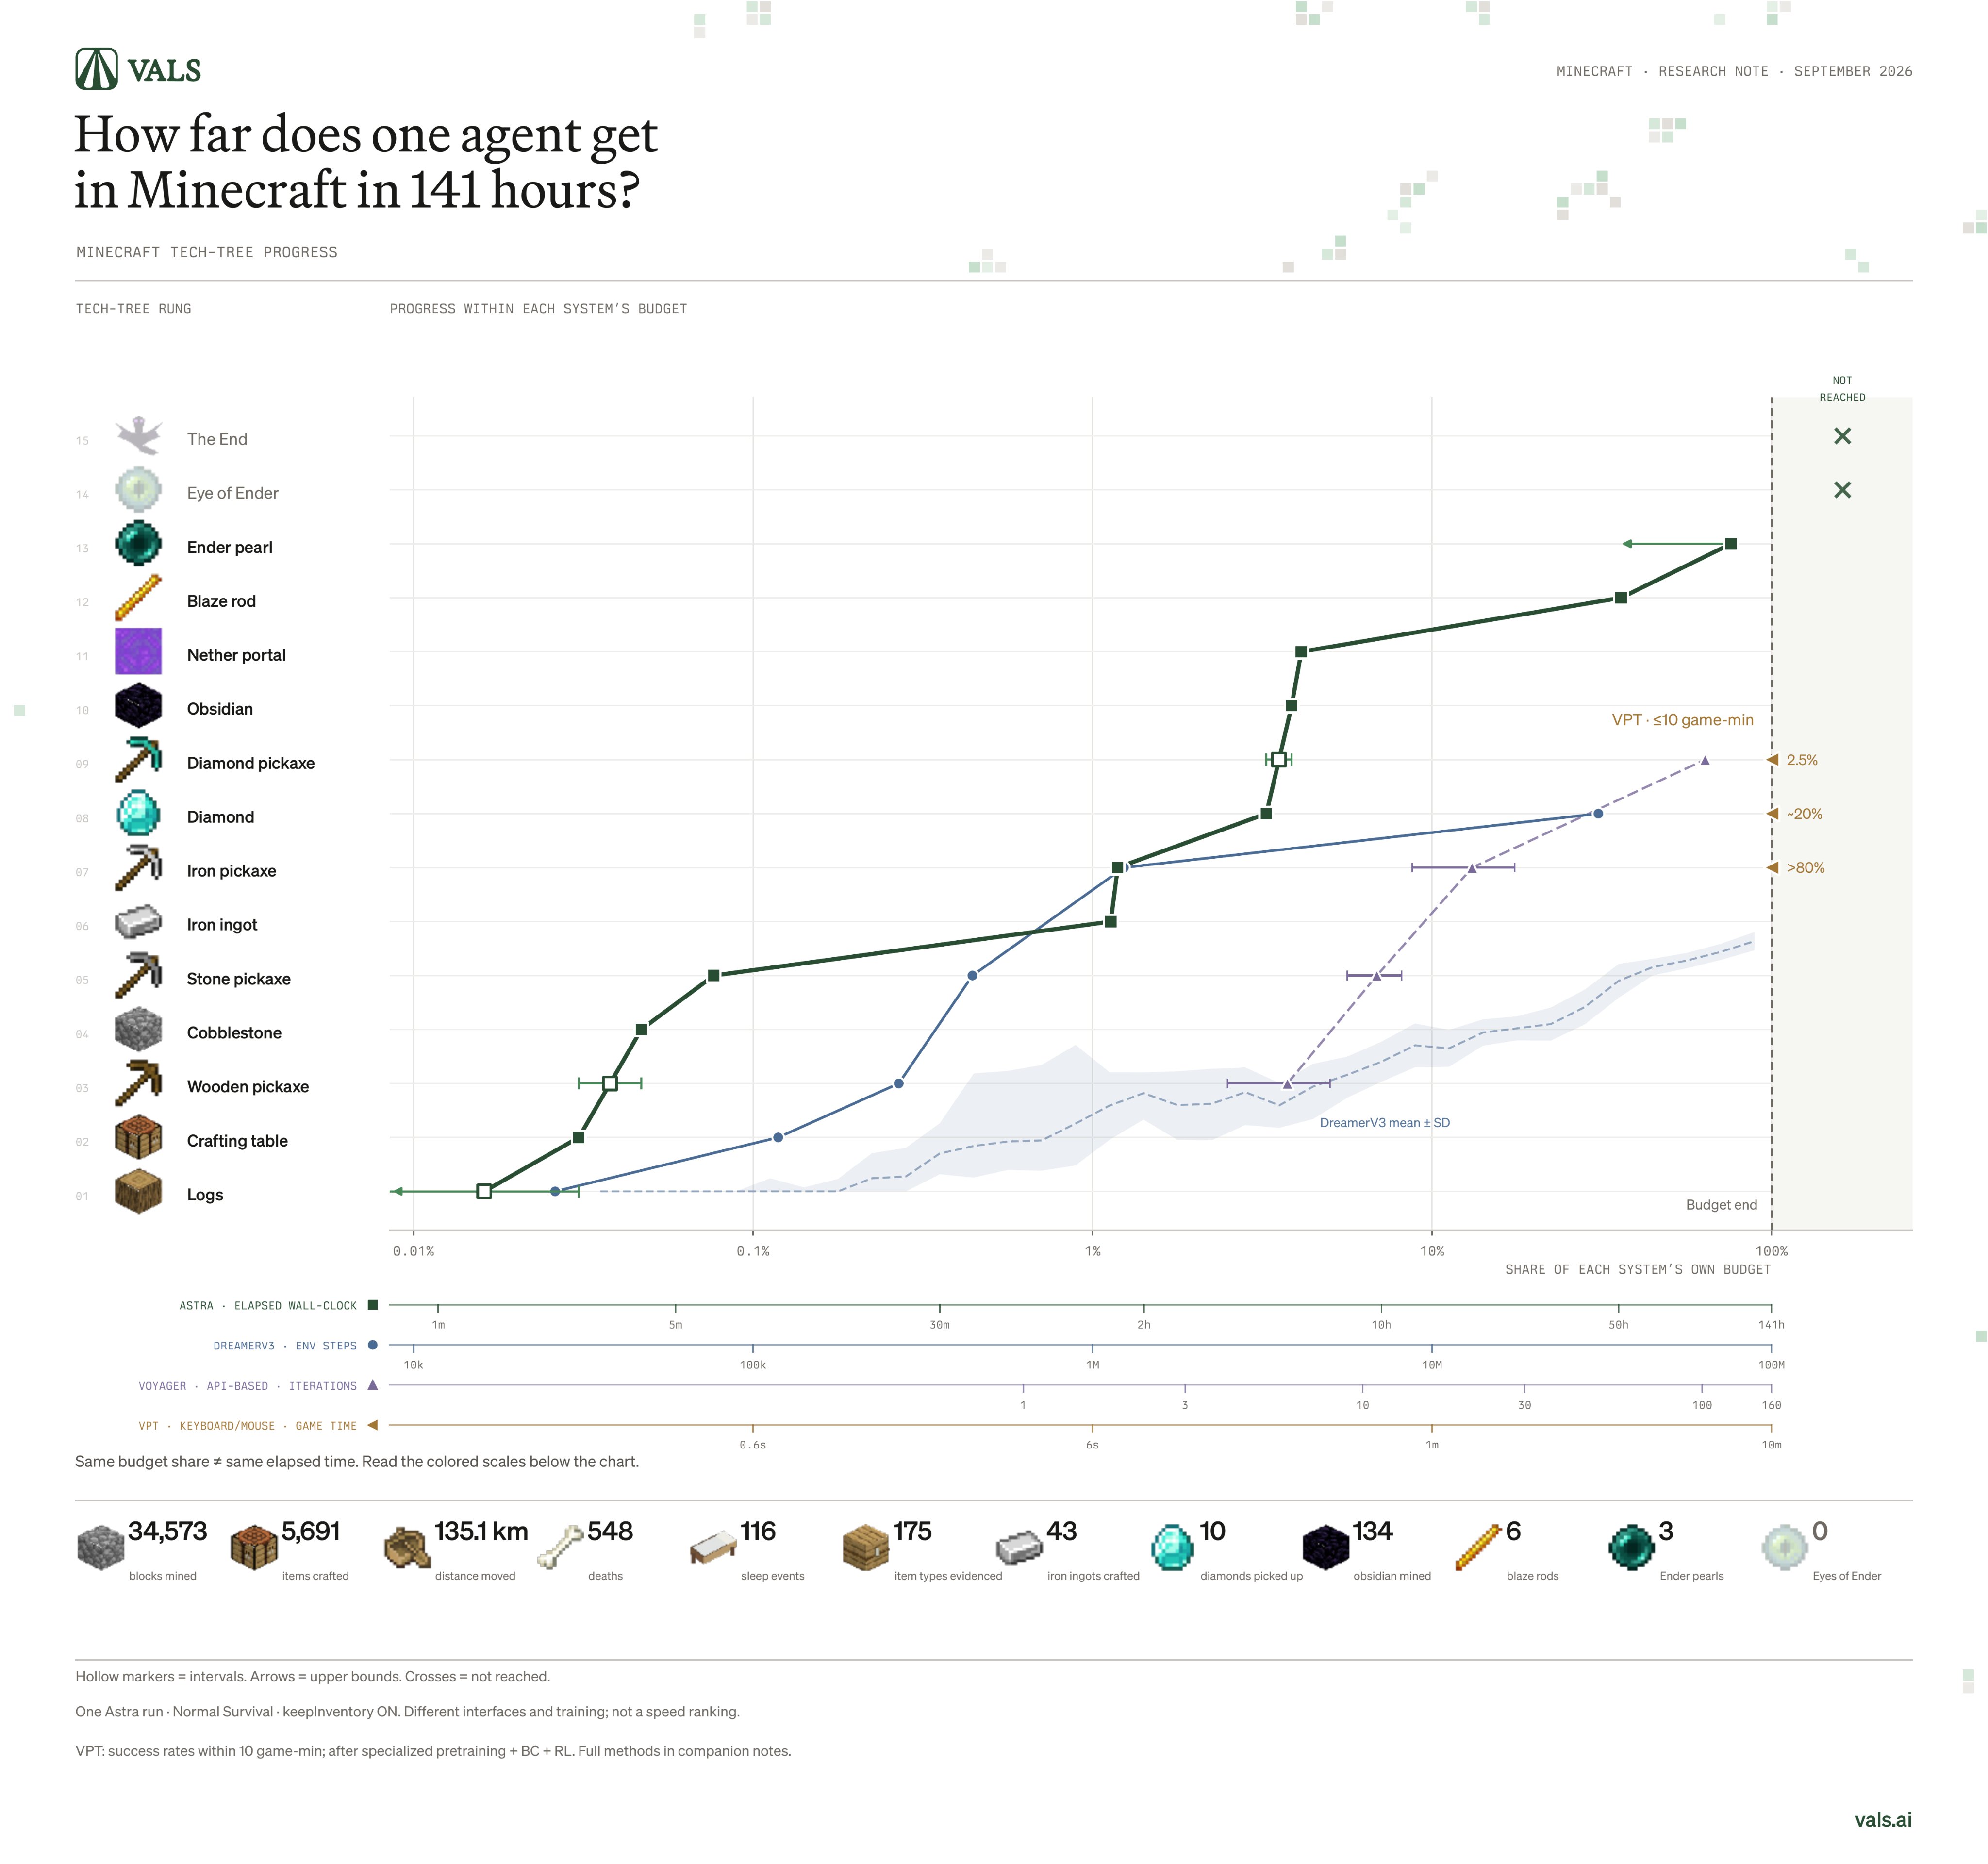
Vals AI 리서치 노트 1면. 마인크래프트 테크트리 15단계를 세로축에 두고, 네 개의 AI 시스템이 예산을 쓴 비율에 따라 어느 단계에 도달했는지를 보여 주는 꺾은선 그래프다.

How far does one agent get in Minecraft in 141 hours?

Vals AI가 GPT-6 Astra에게 141시간을 주고 키보드와 마우스만으로 마인크래프트를 진행시켰다. 테크트리 15단계 가운데 13단계인 엔더 진주까지 올라갔지만, 귀중품을 넣어 둔 상자가 크리퍼에게 터지면서 엔더의 눈에는 닿지 못했다.

September 16, 2026 · 8 분 · 서소영
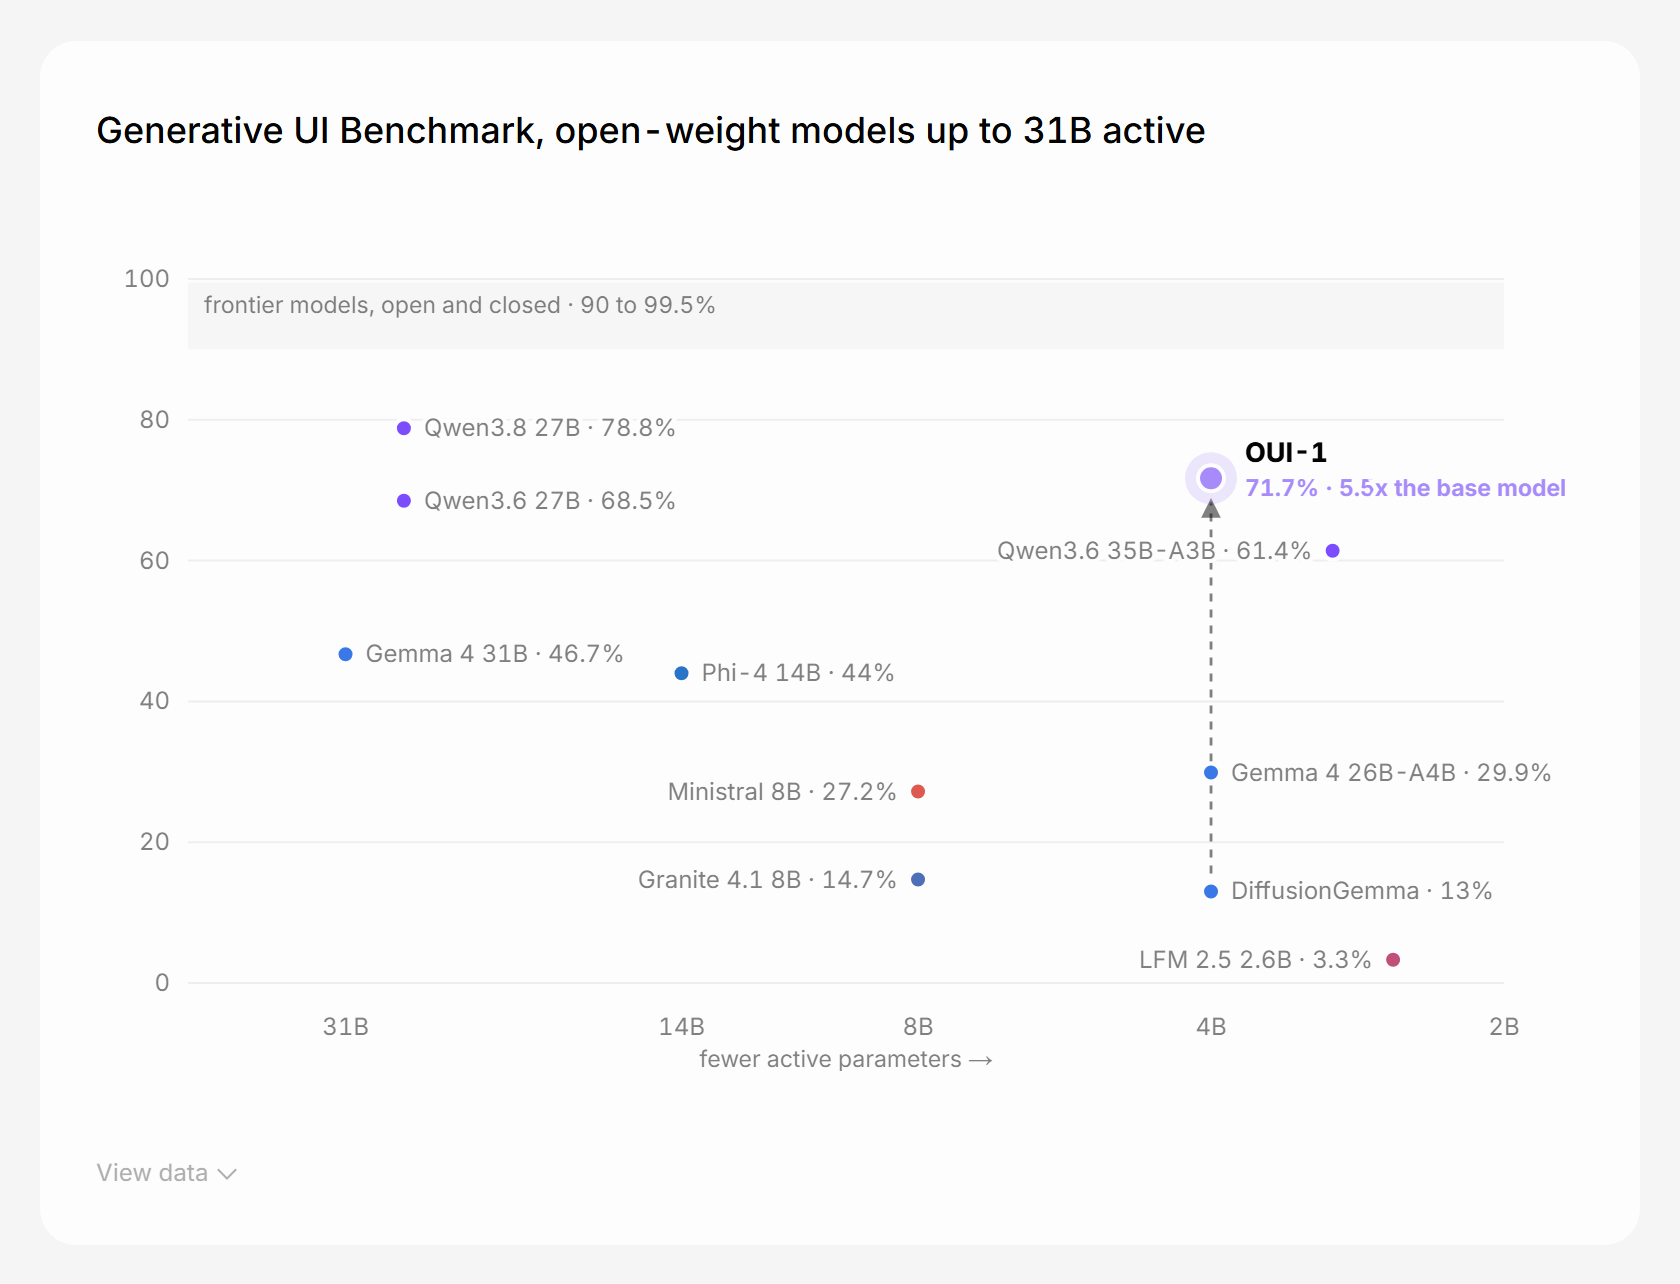
Generative UI Benchmark 산점도. 가로축은 활성 파라미터, 세로축은 점수이며 활성 4B 지점의 OUI-1이 71.7%로 표시되어 있다.

Introducing OUI-1: world's first model for Generative UI

OpenUI가 확산 언어 모델 DiffusionGemma를 파인튜닝해 만든 활성 4B 인터페이스 생성 모델 OUI-1을 Apache 2.0으로 공개했다. 파서를 보상 함수로 쓴 자기 증류로 Generative UI Benchmark 점수를 13.0%에서 71.7%까지 끌어올렸다.

September 15, 2026 · 7 분 · 서소영
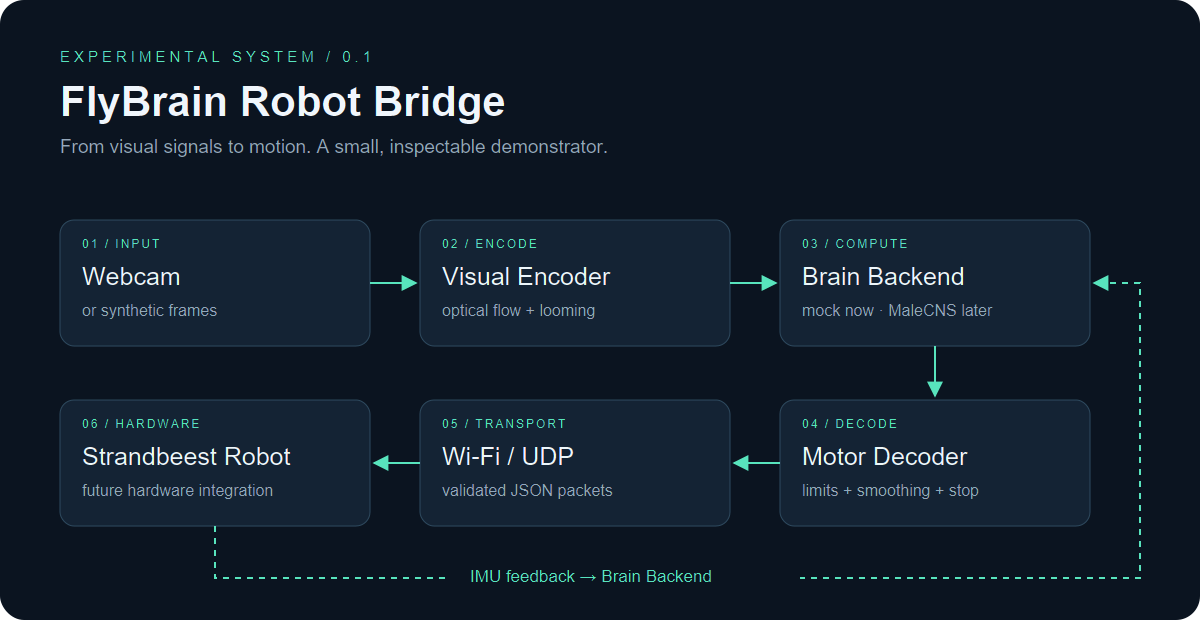
웹캠에서 시각 인코더, 브레인 백엔드, 모터 디코더, UDP를 거쳐 로봇에 이르는 여섯 단계 신호 흐름도

FlyBrain Robot Bridge

초파리 커넥톰을 로봇에 잇겠다는 이름을 달고 공개된 실험 리포지터리다. 지금 돌아가는 것은 사람이 손으로 설계한 여덟 개 신호 그룹이고, 정작 커넥톰 백엔드는 호출하는 순간 미구현 예외를 던지도록 만들어져 있다.

September 15, 2026 · 7 분 · 서소영