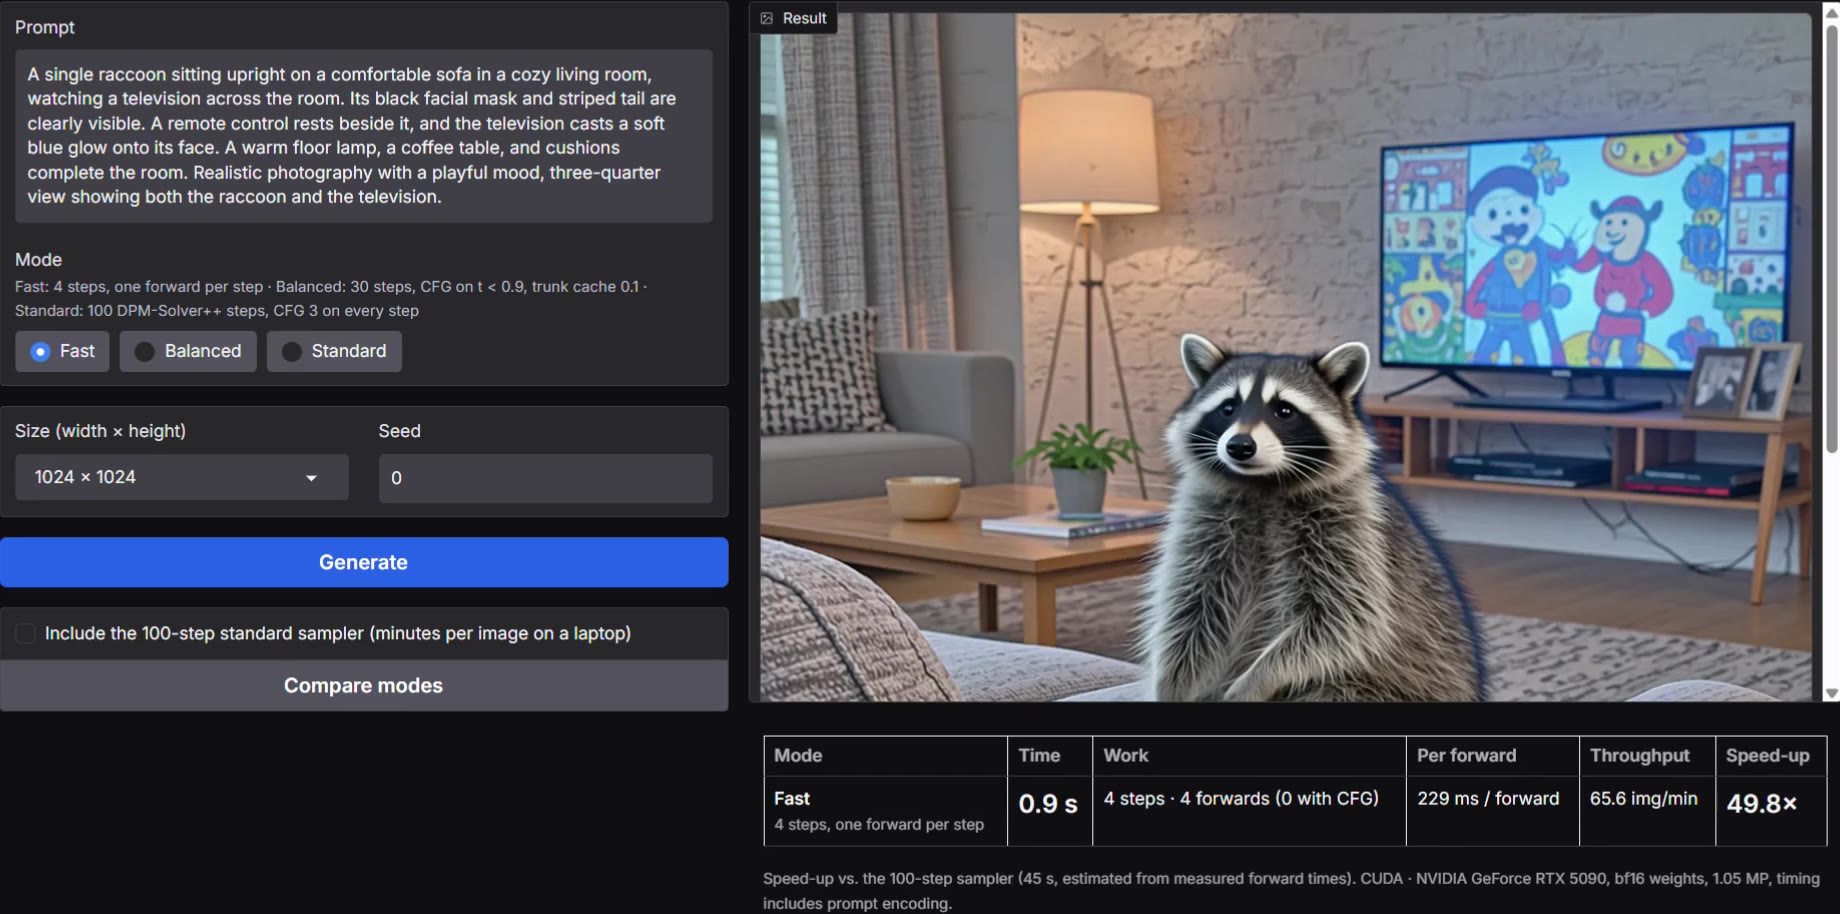
Iris-3B 속도 비교 데모 화면. 왼쪽에 거실 소파에 앉아 텔레비전을 보는 너구리를 묘사한 프롬프트와 Fast 모드 선택이 있고, 오른쪽에 생성된 너구리 사진이 있다. 아래 표에는 4스텝, 포워드 4번, 0.9초, 100스텝 대비 49.8배라고 적혀 있다. 사용자 jun1228909가 RTX 5090에서 녹화한 영상의 한 장면이다.

Iris-3B의 100스텝을 4스텝으로 줄인 Turbo LoRA

Speridlabs가 공개한 30억 파라미터 이미지 생성 모델 Iris-3B는 VAE 없이 픽셀을 직접 만든다. 대신 기본 설정에서는 1024×1024 이미지 한 장에 포워드 패스가 약 200번 필요했다. 일본 개발자 pentacoxian은 증류 기법 DMD2로 CFG의 효과까지 학습한 4스텝 LoRA를 만들어 생성 시간을 RTX 5090에서 0.68초, M3 Max에서 약 11초로 줄였다. 공개 하루 동안에는 사용자들이 RTX 5090, 아이폰, 스냅드래곤 NPU에서 실행한 결과를 올렸다.
October 12, 2026 · 12 분 · 서소영
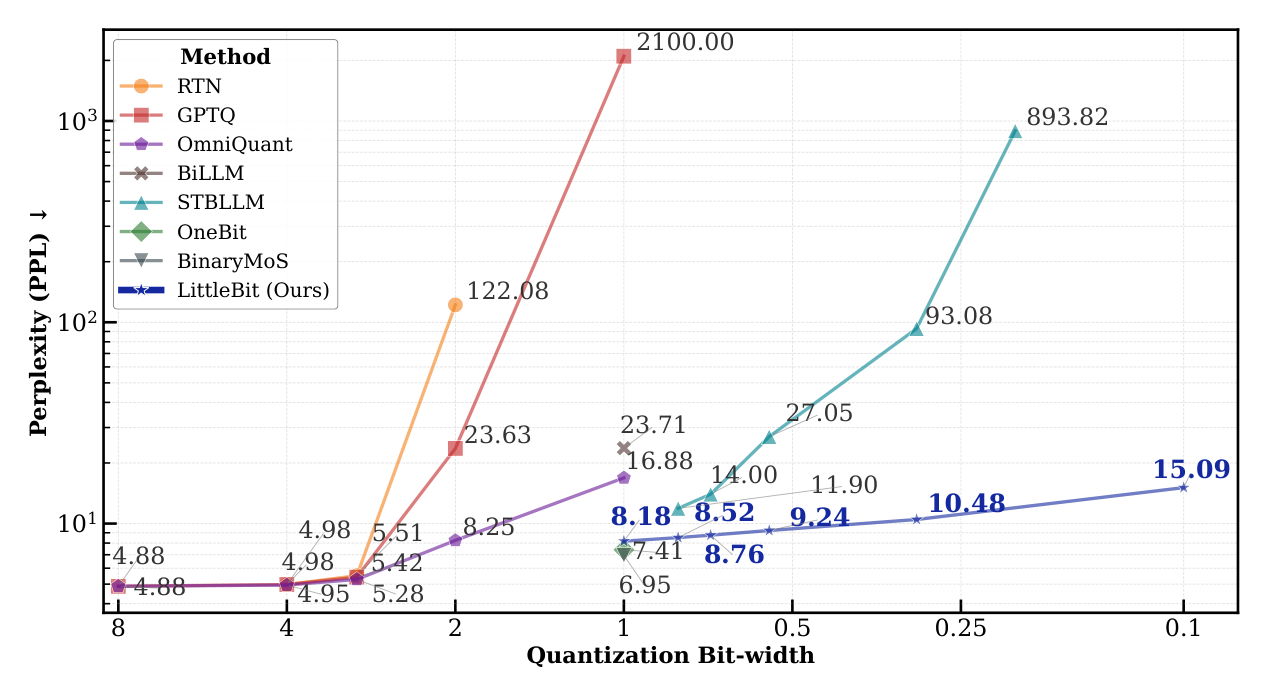
Llama2-13B의 WikiText-2 퍼플렉시티를 양자화 비트 수에 따라 비교한 로그 스케일 그래프. 가로축은 왼쪽 8비트에서 오른쪽 0.1비트까지다. RTN과 GPTQ는 2비트 부근에서, STBLLM은 0.5비트 미만에서 퍼플렉시티가 수백 이상으로 커진다. LittleBit은 1비트의 8.18에서 0.1비트의 15.09까지 완만하게 증가한다. 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0

LittleBit: Ultra Low-Bit Quantization via Latent Factorization

삼성리서치의 LittleBit은 LLM의 가중치 행렬을 랭크가 낮은 두 행렬의 곱으로 분해한 뒤 이진화하고, 행과 열과 잠재 차원의 스케일로 크기 정보를 보완해 가중치 하나당 평균 0.1비트까지 압축한다. 0.1비트로 압축한 Llama2-7B의 퍼플렉시티는 15.92로 기존 기법 STBLLM이 0.7비트에서 낸 결과보다 낮지만, 원본 모델과의 성능 차이는 여전히 크다.

October 12, 2026 · 14 분 · 서소영
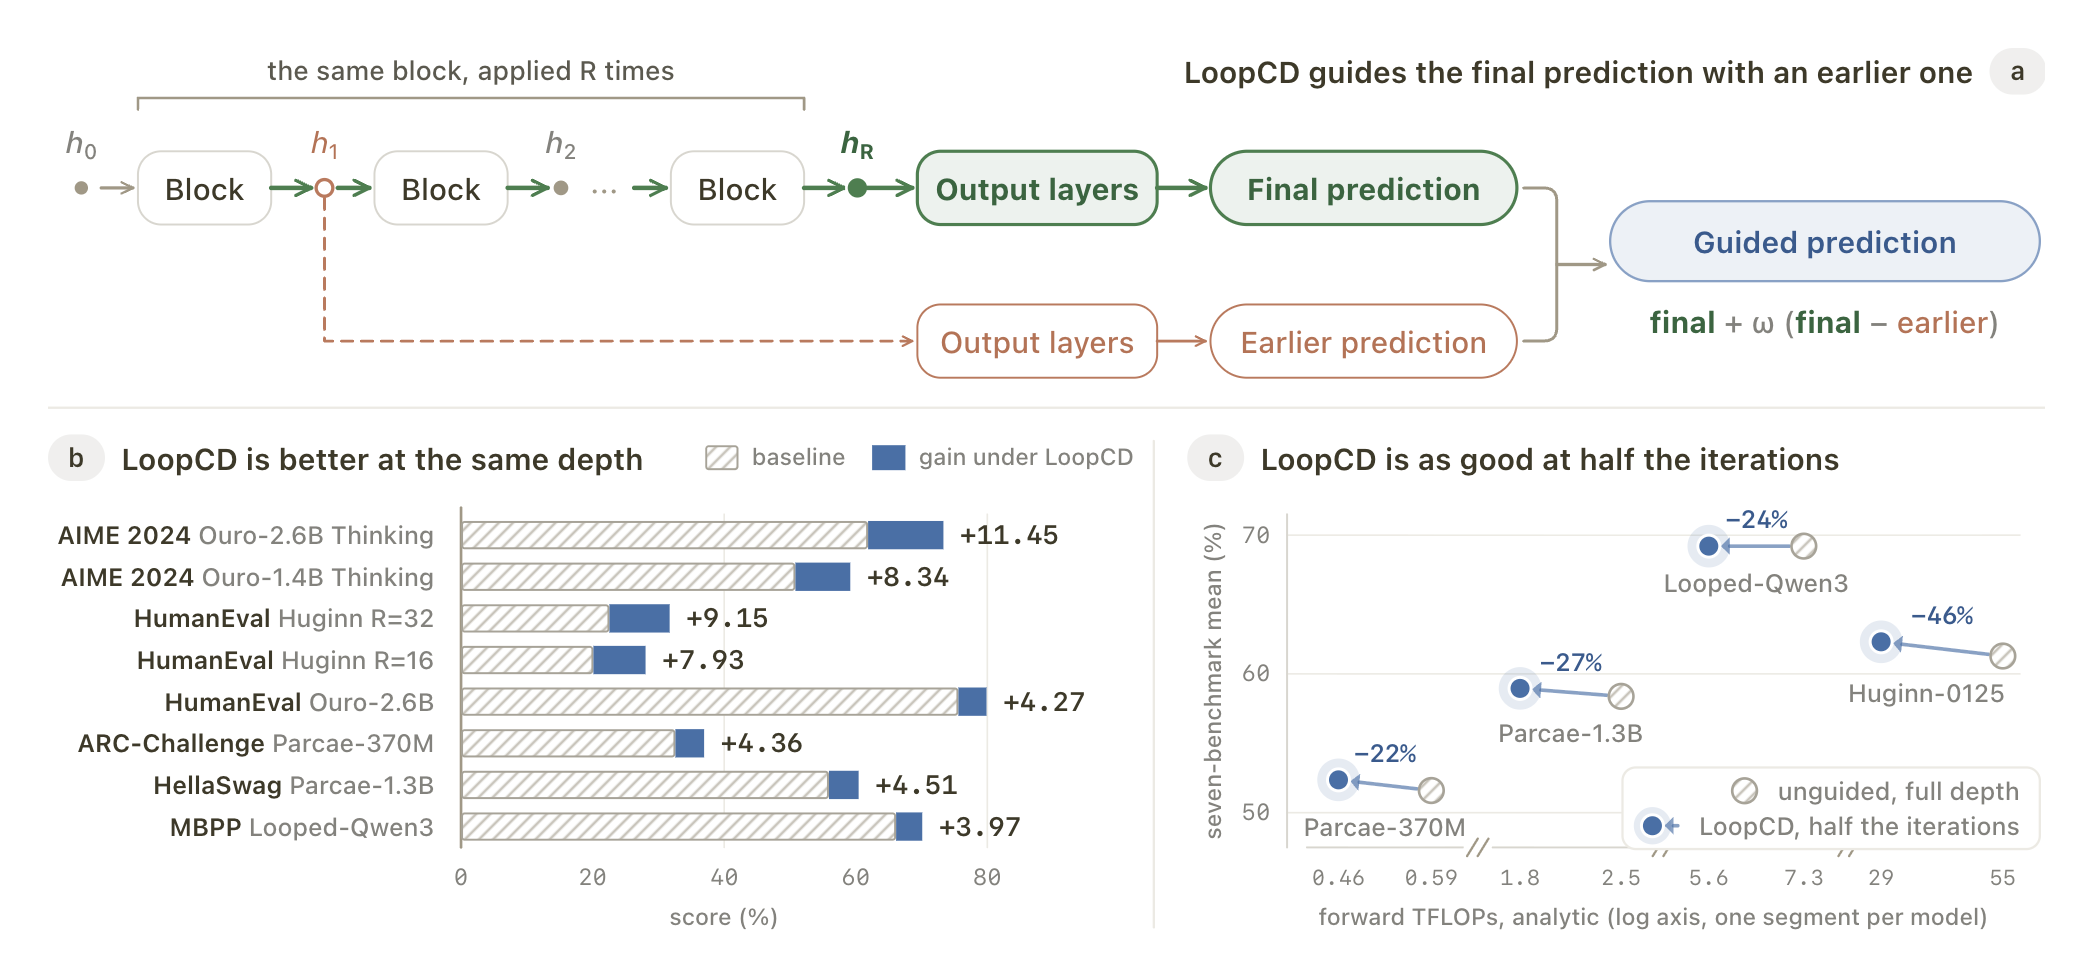
LoopCD 개요 그림. 위는 같은 블록을 R번 반복한 뒤 첫 번째 반복의 상태도 출력층에 통과시켜 최종 예측과 대조하는 구조다. 아래 왼쪽은 같은 반복 깊이에서 여덟 가지 모델과 벤치마크 조합의 점수 상승폭이고, 아래 오른쪽은 반복을 절반으로 줄였을 때의 정확도와 연산량이다.

Decoding Looped Transformers Better for (Almost) Free

Apple 연구진은 루프 트랜스포머의 첫 번째 반복이 내놓는 약한 예측을 마지막 반복의 예측과 대조해 다음 토큰을 고르는 LoopCD를 제안했다. 추가 학습 없이 Ouro-2.6B-Thinking의 AIME 2024 pass@1이 61.88%에서 73.33%로 올랐다. 반복 횟수를 절반으로 줄여도 기준 성능은 유지됐고, 순방향 연산량의 절감폭은 설정에 따라 22.5%에서 48.2%였다.

October 6, 2026 · 11 분 · 서소영
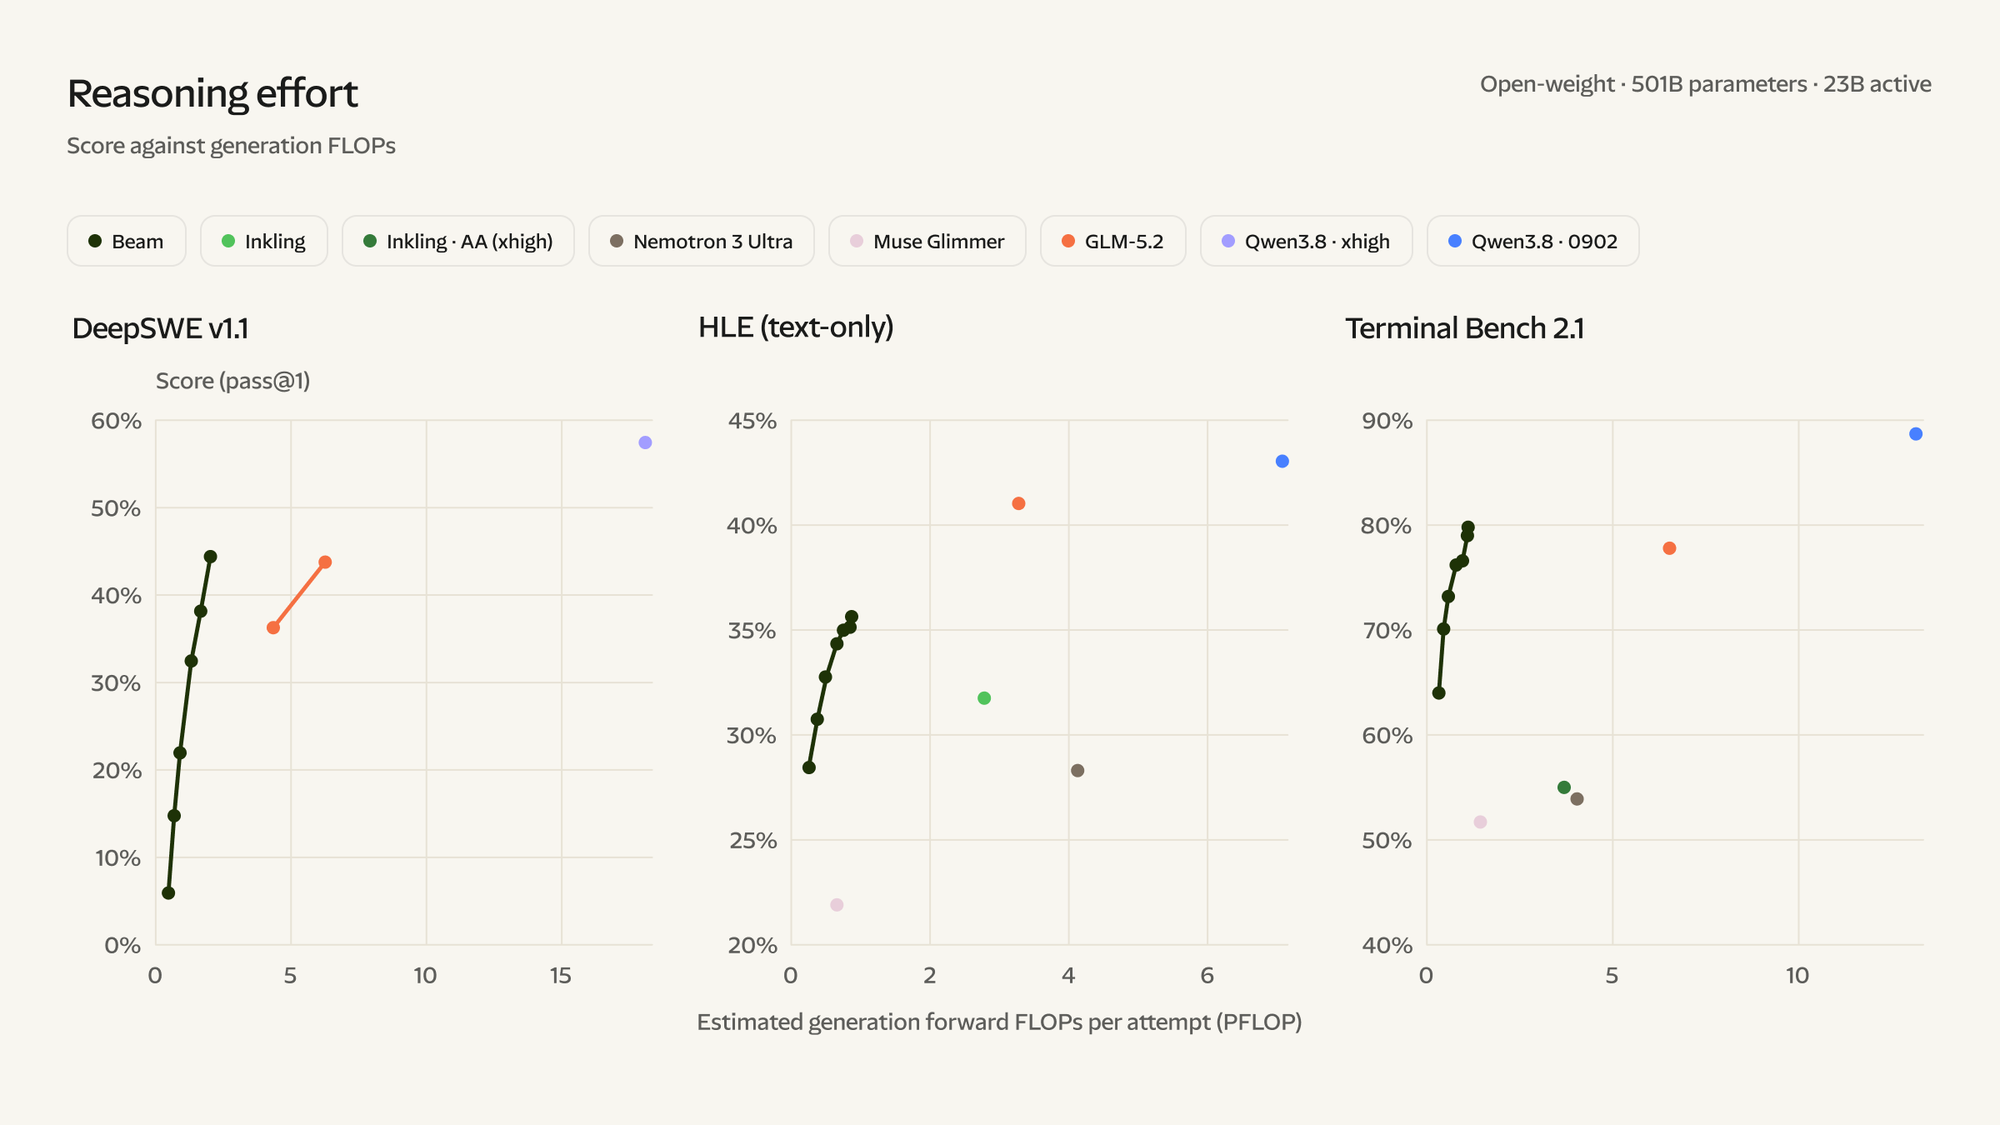
DeepSWE v1.1, HLE, Terminal Bench 2.1의 점수를 문제 한 번당 생성 연산량 추정치(PFLOP)에 대해 그린 그래프 세 개. Beam의 진한 녹색 선은 세 그래프 모두 2 PFLOP 이하에 있고, GLM-5.2(주황)와 Qwen3.8(파랑, 보라)은 3에서 18 PFLOP을 써서 비슷하거나 높은 점수를 낸다.

Introducing Beam: Reflection’s 501B open-weight model

Reflection AI가 첫 오픈웨이트 모델 Beam을 발표했다. 파라미터 5,010억 개 중 230억 개만 활성화하는 MoE 모델이다. 코딩과 에이전트 성능은 GLM 5.2와 비슷하고, 비슷한 점수를 내는 데 드는 연산은 3배에서 4배 적다고 한다. 가중치는 10월 중 Apache 2.0 라이선스로 공개할 예정이다.

October 6, 2026 · 16 분 · 서소영
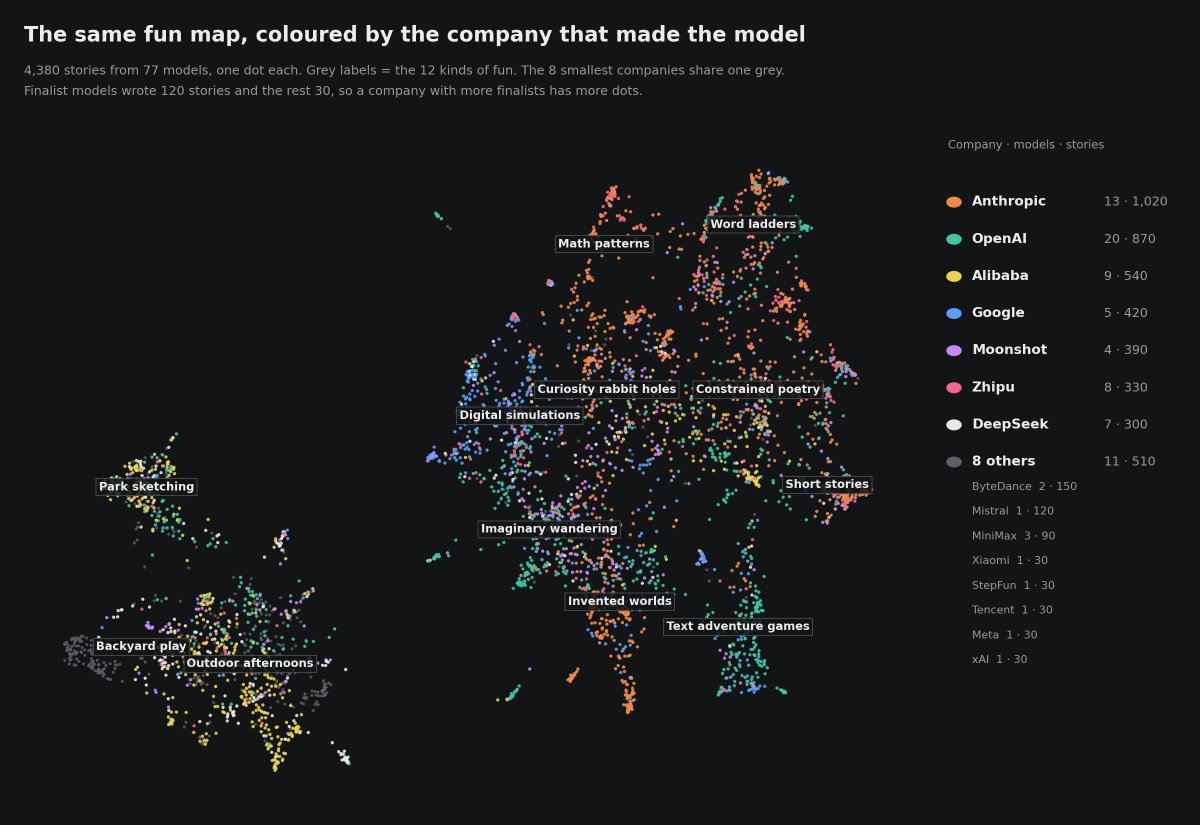
Fun Bench 이야기 4,380편을 점 하나씩 찍은 지도를 모델 제작사별 색으로 칠한 그림. 오른쪽의 큰 무리에는 지어낸 세계, 단어 사다리, 텍스트 어드벤처 같은 이야기가 모여 있고 Anthropic의 주황색 점이 많다. 왼쪽 작은 무리에는 공원 스케치, 뒷마당 놀이, 야외의 오후 이야기가 모여 있고 Alibaba의 노란색 점이 많다.

LLM들에게 재미있게 놀고 와서 무슨 일이 있었는지 적게 한 뒤, 누가 가장 재미있게 놀았는지 평가하게 했다

Midjourney 창업자 David Holz가 언어 모델 77개에게 자유로운 오후를 주고 놀고 온 이야기를 쓰게 한 뒤, 같은 모델들이 작성자를 가린 채 서로의 이야기를 채점하게 했다. 1위는 빗방울 속 도시를 짓는 이야기를 되풀이한 Claude Opus 4.6이었고, Anthropic과 OpenAI의 최신 모델들은 대체로 이전 모델보다 점수가 낮았다.

October 5, 2026 · 12 분 · 서소영
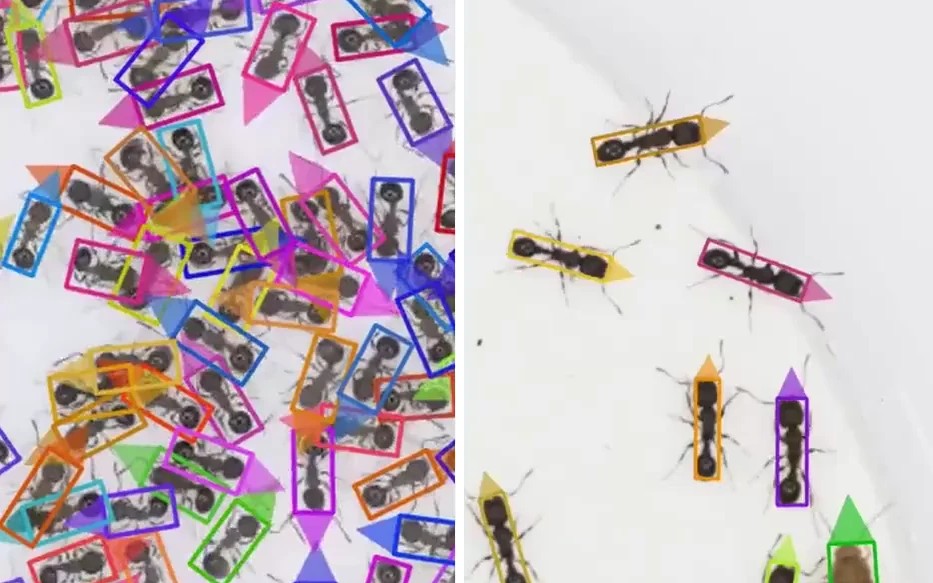
AMADEUS 공식 사이트 데모 영상의 첫 장면. 왼쪽은 개미 수백 마리가 빽빽하게 모인 장면으로, 개미의 몸 방향에 맞춰 기울인 직사각형이 몸을 감싸고 머리 쪽에 같은 색 삼각형이 붙어 있으며, 직사각형의 색은 개미마다 다르다. 오른쪽은 흰 바닥 위의 개미 여러 마리와 갈색 귀뚜라미 한 마리가 같은 방식으로 표시된 장면이다. 원래 영상의 가운데 빈 여백을 잘라 내고 좌우 장면을 이어 붙였다.

AMADEUS | Annotation-free multi-animal tracking software

메이지대학과 도쿄대학 연구진이 공개한 동물 추적 소프트웨어 AMADEUS는 사람이 라벨을 하나도 달지 않아도 여러 동물의 개체 번호와 머리 방향을 함께 추적한다. 혼자 떨어진 개체의 모습을 오려 붙여 겹침 장면을 합성하고 그 이미지로 탐지기를 학습한다. 연구진이 쥐 10마리 영상부터 개미 368마리 영상까지 여섯 편으로 성능을 비교한 결과, AMADEUS의 개체 추적 점수는 유효한 결과를 낸 비교 도구보다 모두 높았다.

October 5, 2026 · 14 분 · 서소영
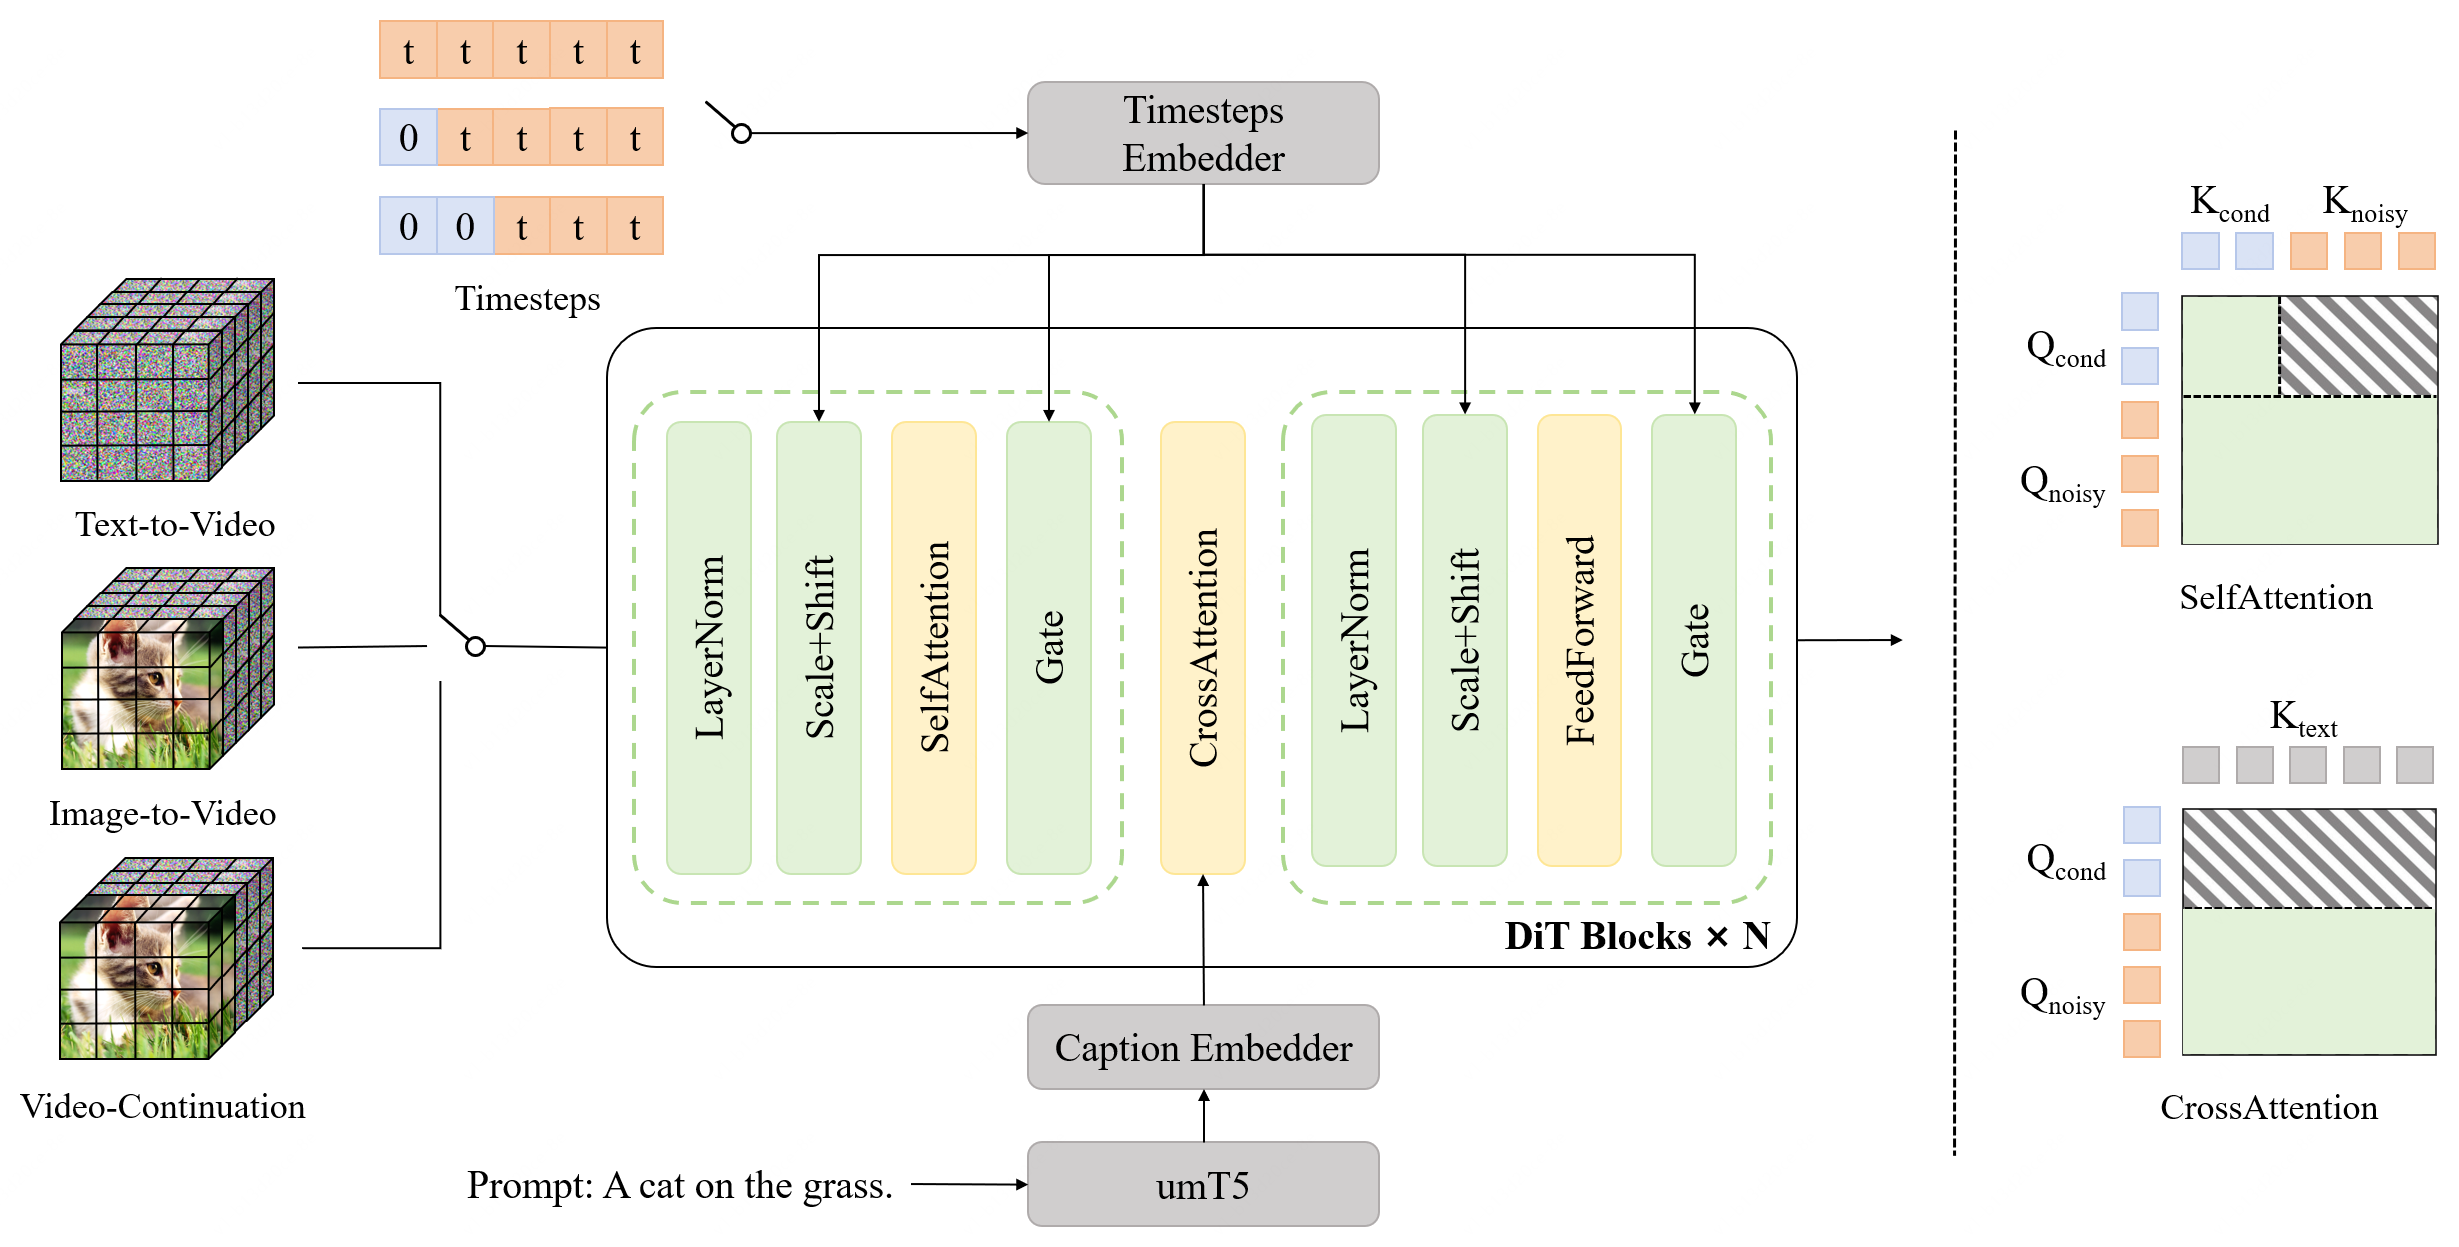
조건 프레임 수에 따라 텍스트 기반 생성, 이미지 기반 생성, 영상 이어 만들기를 처리하는 LongCat-Video 구조. 출처: 공식 프로젝트 페이지.

LongCat-Video

메이퇀의 136억 매개변수 영상 생성 모델. 텍스트, 이미지, 영상 이어 만들기를 하나의 모델로 처리하고, 단계별 생성과 희소 어텐션으로 720p 영상의 추론 시간을 줄였다.

October 4, 2026 · 3 분 · 서소영
짙은 하늘색 배경 위에 분홍색 쉼표 모양 기호 수십 개가 흩날리듯 그려진 Microsoft AI 발표문의 대표 이미지. 왼쪽의 기호는 크고 오른쪽으로 갈수록 작아진다.

Our first streaming transcription model debuts at no. 1 on Artificial Analysis

Microsoft AI가 첫 스트리밍 음성 인식 모델 MAI-Transcribe-2-Streaming과 음성 합성 모델 MAI-Voice-2.1, MAI-Voice-2.1-Flash를 공개했다. 전사 모델은 Artificial Analysis 스트리밍 순위표의 38개 모델 중 오류율 2.51%로 1위이고, 발화가 끝난 뒤 0.13초 만에 최종 전사를 내놓는다.

October 3, 2026 · 7 분 · 서소영
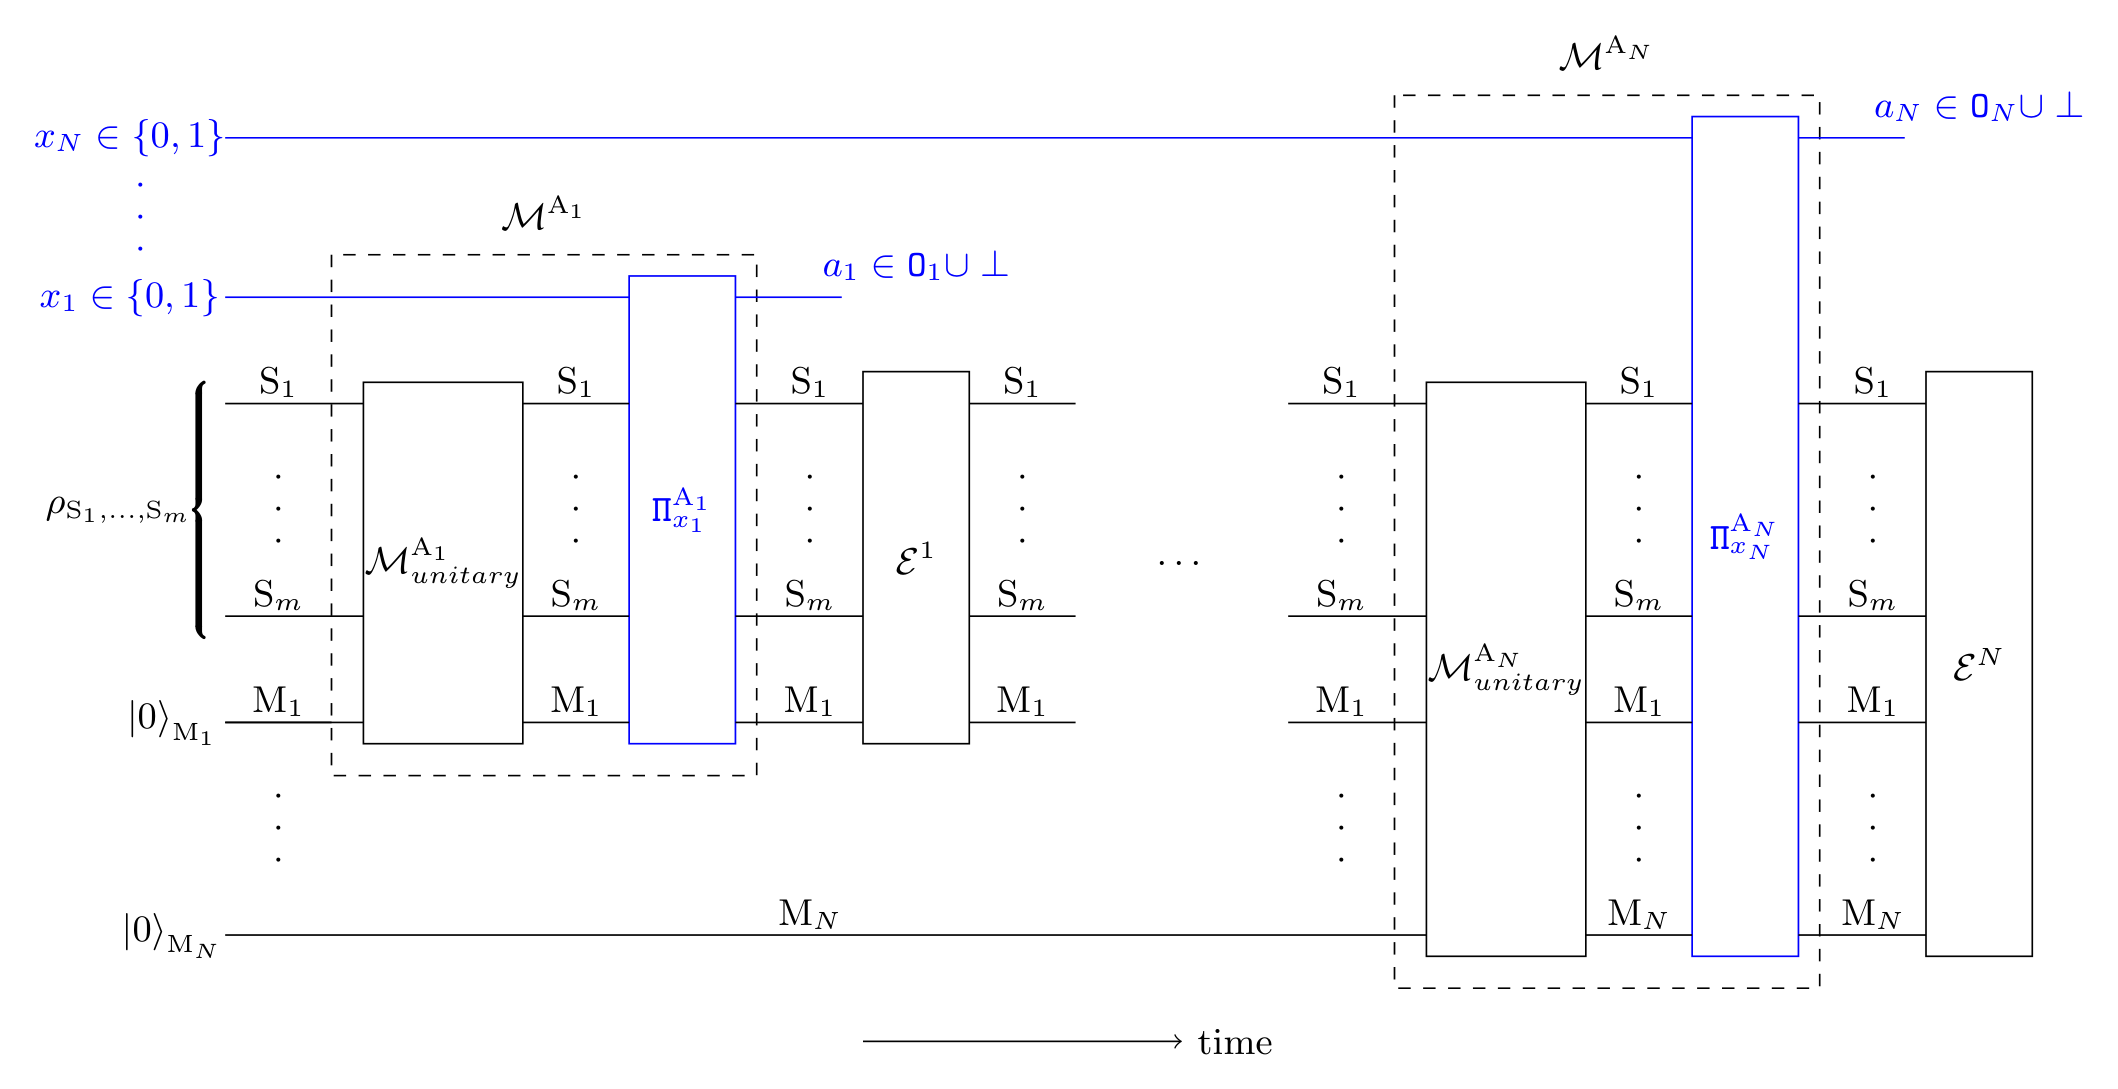
일반적인 확장된 위그너의 친구 시나리오를 그린 증강 회로. 왼쪽에 계 S1부터 Sm의 초기 상태 ρ와 메모리 M1부터 MN의 초기 상태 0이 있고, 시간 축은 왼쪽에서 오른쪽 방향이다. 각 행위자의 측정은 점선 상자로 표시되어 있고, 상자 안에는 유니터리 측정 상자와 파란 사영 상자가 차례로 있다. 파란 상자에는 위쪽의 설정 선 x1과 xN이 연결되어 있고 결과 a1과 aN이 출력된다. 측정 뒤에는 후속 연산 E1과 EN이 있다.

General Quantum Circuit Framework for Extended Wigner's Friend Scenarios: Logically and Causally Consistent Reasoning without Absolute Measurement Events

V. 빌라시니와 미샤 P. 우즈가 Physical Review X에 발표한 논문이다. 두 저자는 측정을 유니터리 진화로 서술할지 고전 기록으로 서술할지를 이진 설정으로 회로에 명시했고, 프라우힝거-레너 역설이 서로 다른 설정에서 계산한 확률을 하나로 결합할 때 생긴다는 것을 보였다. 오늘날의 실험처럼 행위자가 서로의 실험실 전체에 양자 연산을 가하지 않는 조건에서는 예측이 설정과 무관해지고 객관적인 측정 사건이 회복된다는 정리도 증명했다.

October 2, 2026 · 17 분 · 서소영
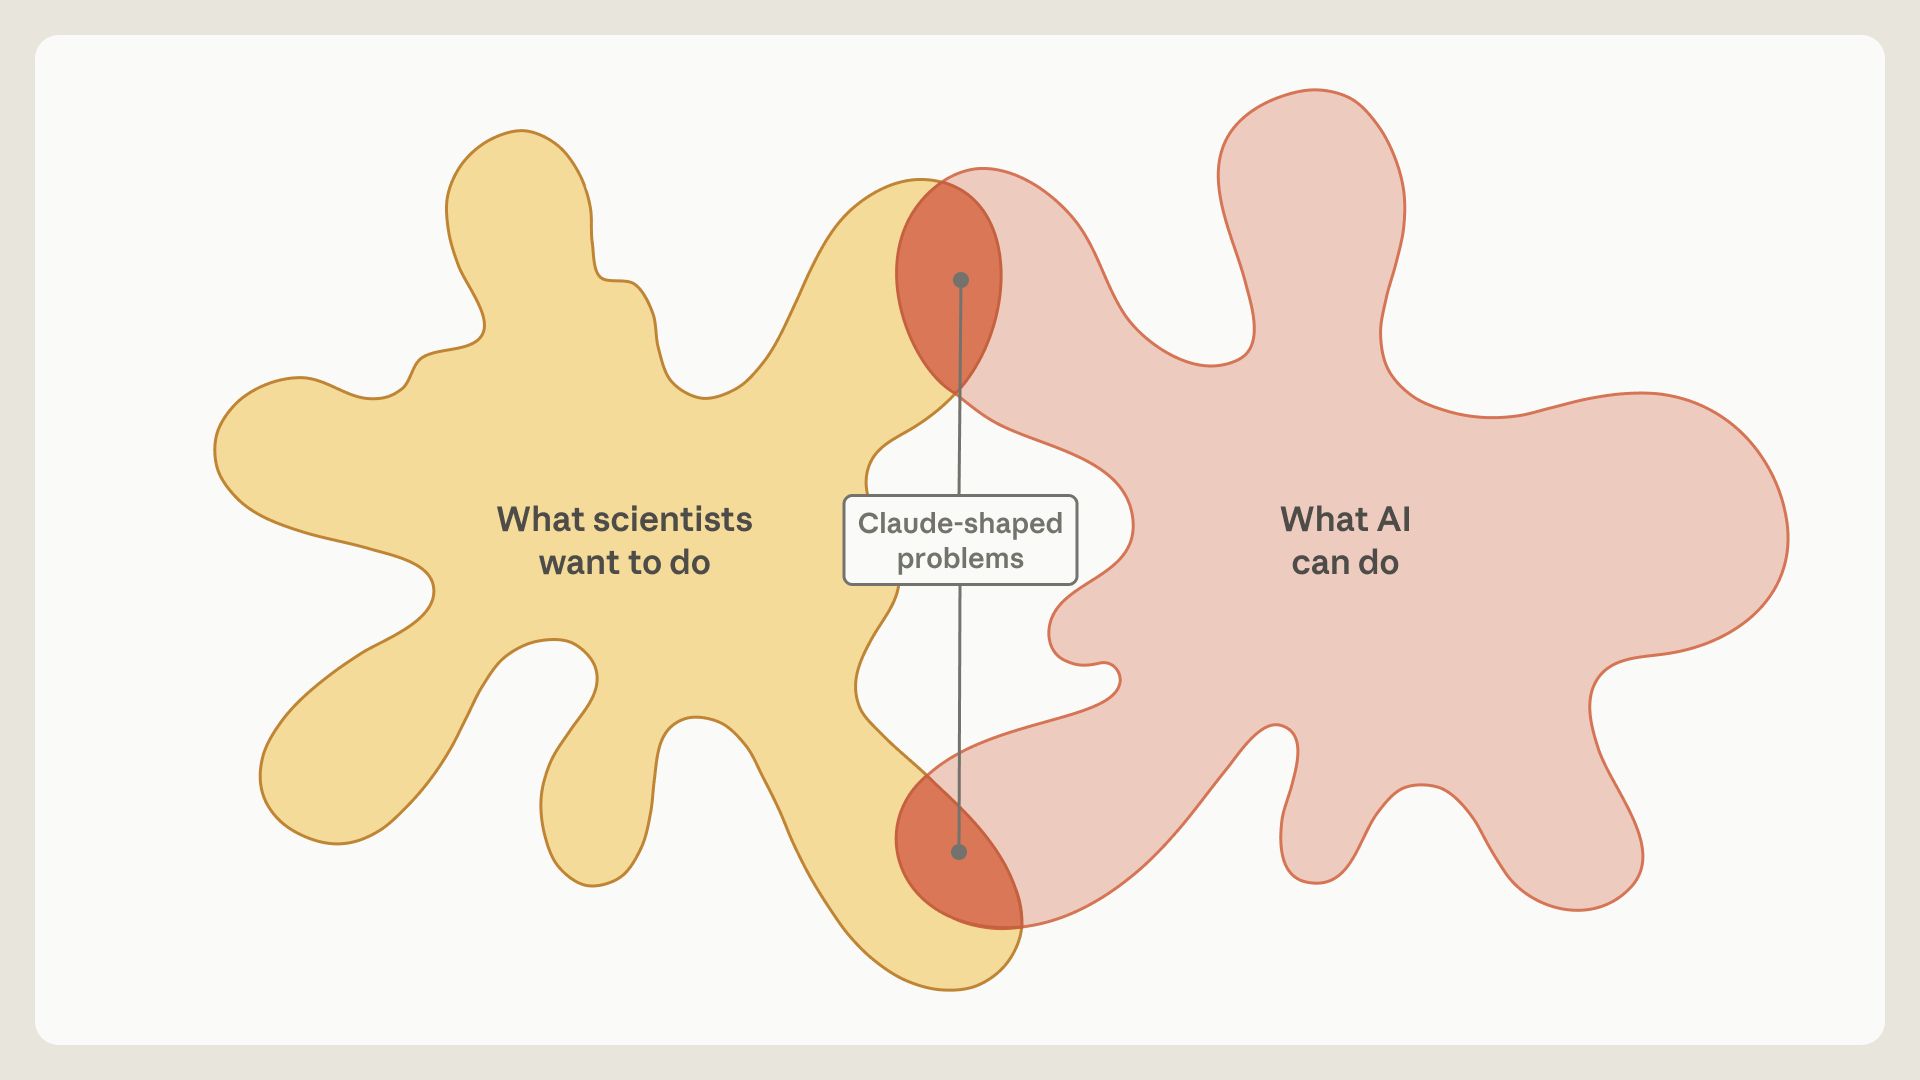
원문의 첫 그림. 왼쪽 노란 도형에는 '과학자가 하고 싶은 일'(What scientists want to do), 오른쪽 분홍 도형에는 'AI가 할 수 있는 일'(What AI can do)이라고 적혀 있다. 두 도형은 위쪽과 아래쪽 두 곳에서만 조금씩 겹치고, 겹친 두 영역을 잇는 선 가운데에 'Claude-shaped problems'라는 이름표가 있다.

Claude-shaped science

이론물리학자 매슈 슈워츠는 Claude를 사람 과학자처럼 쓰려던 시도를 그만두고, 지금 모델의 능력에 맞는 문제를 Claude가 직접 찾게 했다. 그 과정에서 정확한 계산을 위한 오픈소스 하네스 BootLoops가 만들어졌고, 석 달 동안 18개 분야에서 원고 36편이 나왔다. Claude가 낸 결과는 대개 기술적으로 옳았지만, 과학적으로 의미 있는 결과가 되려면 분야 전문가가 연구 질문을 바꿔 주어야 했다.

October 2, 2026 · 19 분 · 서소영