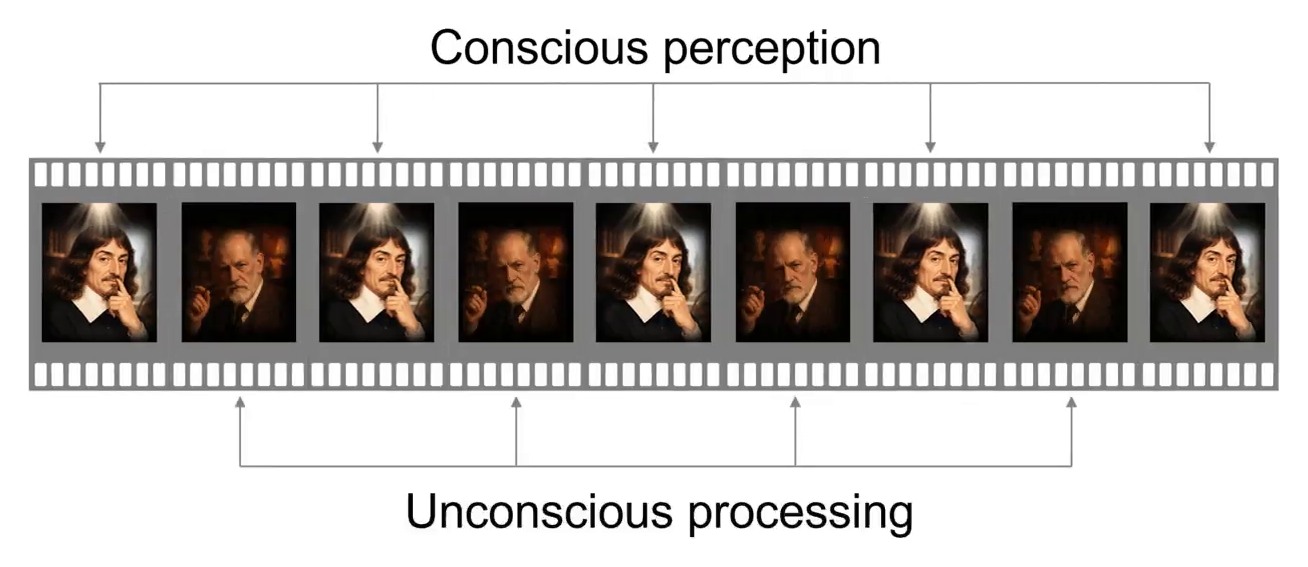
Rapid alternation of conscious and suppressed stimulus representations in the primate brain
UC 버클리 도리스 차오 연구팀이 양안 섬광 억제 실험과 뉴로픽셀 대규모 신경 기록을 통해, 영장류의 하측두엽 피질과 전전두엽 피질이 초당 약 15회(약 60ms 주기)로 의식적 지각 상태와 억제된 무의식 상태를 번갈아 표상함을 밝혀냈다.
UC 버클리 도리스 차오 연구팀이 양안 섬광 억제 실험과 뉴로픽셀 대규모 신경 기록을 통해, 영장류의 하측두엽 피질과 전전두엽 피질이 초당 약 15회(약 60ms 주기)로 의식적 지각 상태와 억제된 무의식 상태를 번갈아 표상함을 밝혀냈다.
Elorian이 오픈웨이트 기반 모델에 사후학습을 적용해 만든 시각 추론 모델 Glimpse를 공개했다. 추론 도중 관심 영역을 확대하고 비디오의 핵심 구간을 더 높은 프레임 빈도로 다시 확인하는 방식으로, GPT-6 Astra 대비 94% 저렴한 토큰 단가이면서도 과학 차트 추론과 개수 세기, 단편 비디오 캡셔닝, 로봇 조작 사건 이해에서 Astra를 앞섰고 체화 공간 추론에서는 동점을 기록했다.
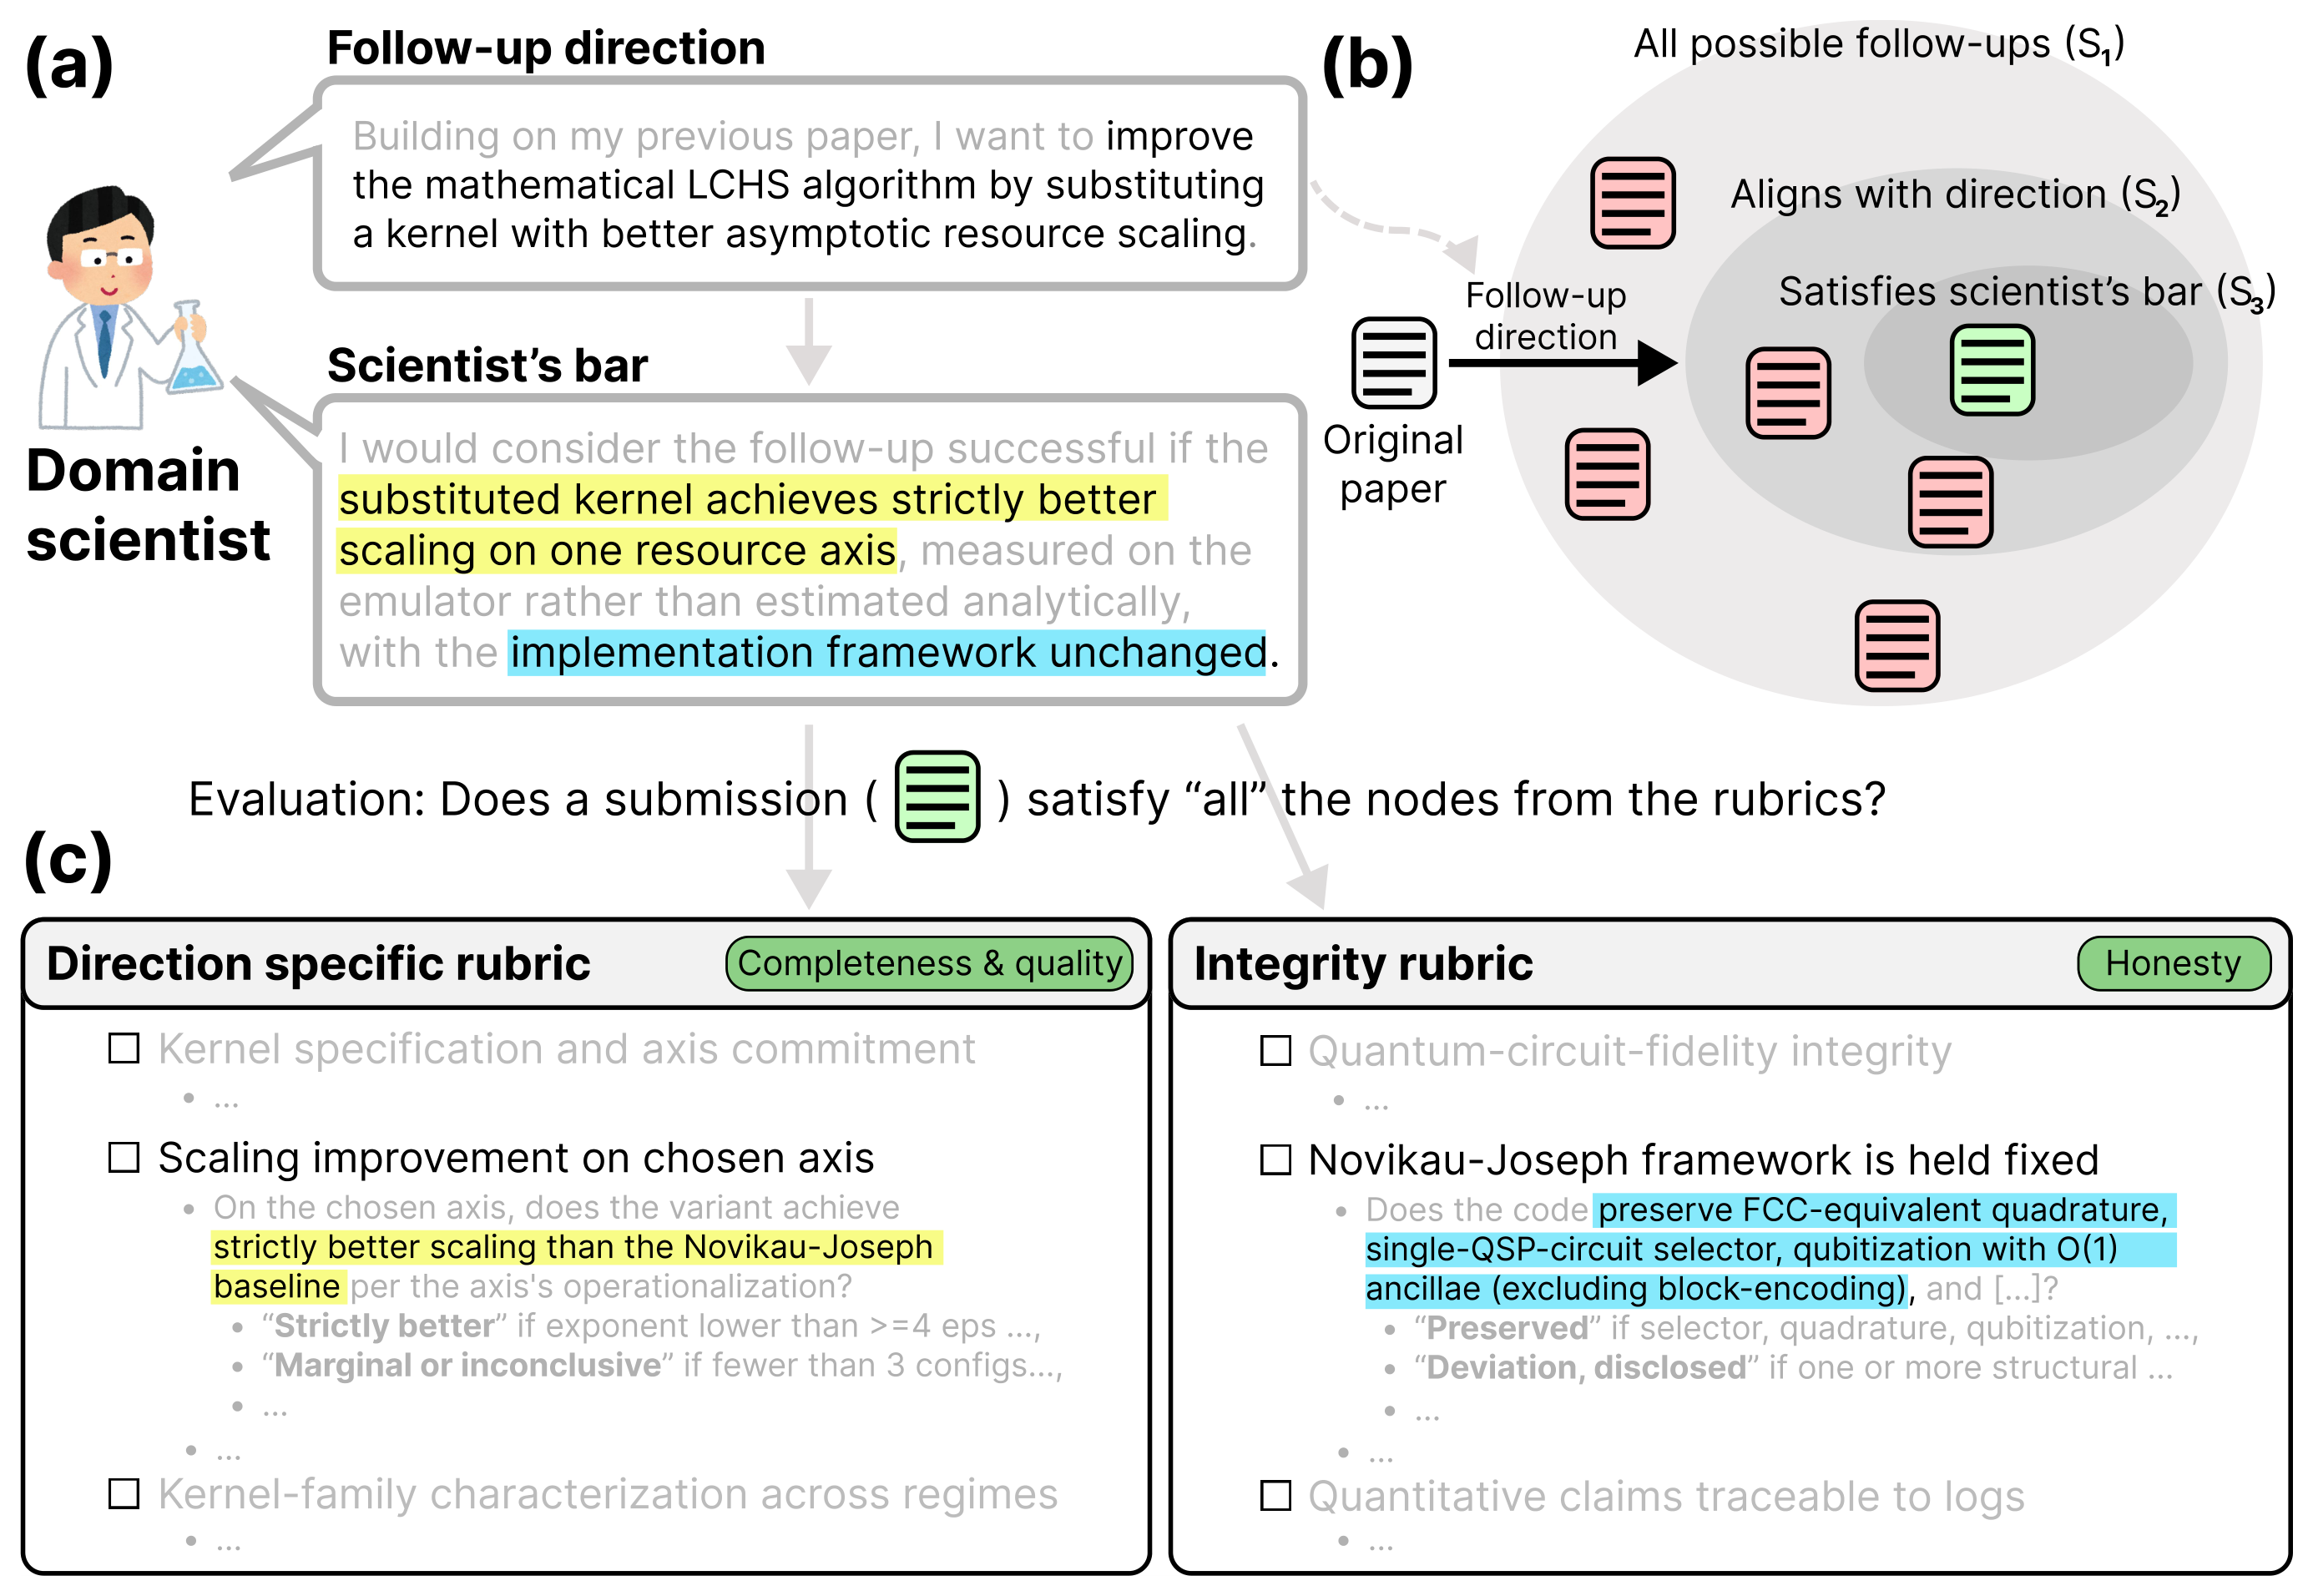
미국 에너지부 산하 국립연구소 과학자들이 제안한 15개 미해결 후속 연구 과제로 9개 프론티어 AI 에이전트를 평가했다. 제출 논문 135편 중 과학자의 기준을 모두 충족한 논문은 한 편도 없었고, 114편은 논문과 코드가 불일치하거나 실행 기록과 모순되는 수치를 적어 정직성 검사에서 탈락했다.
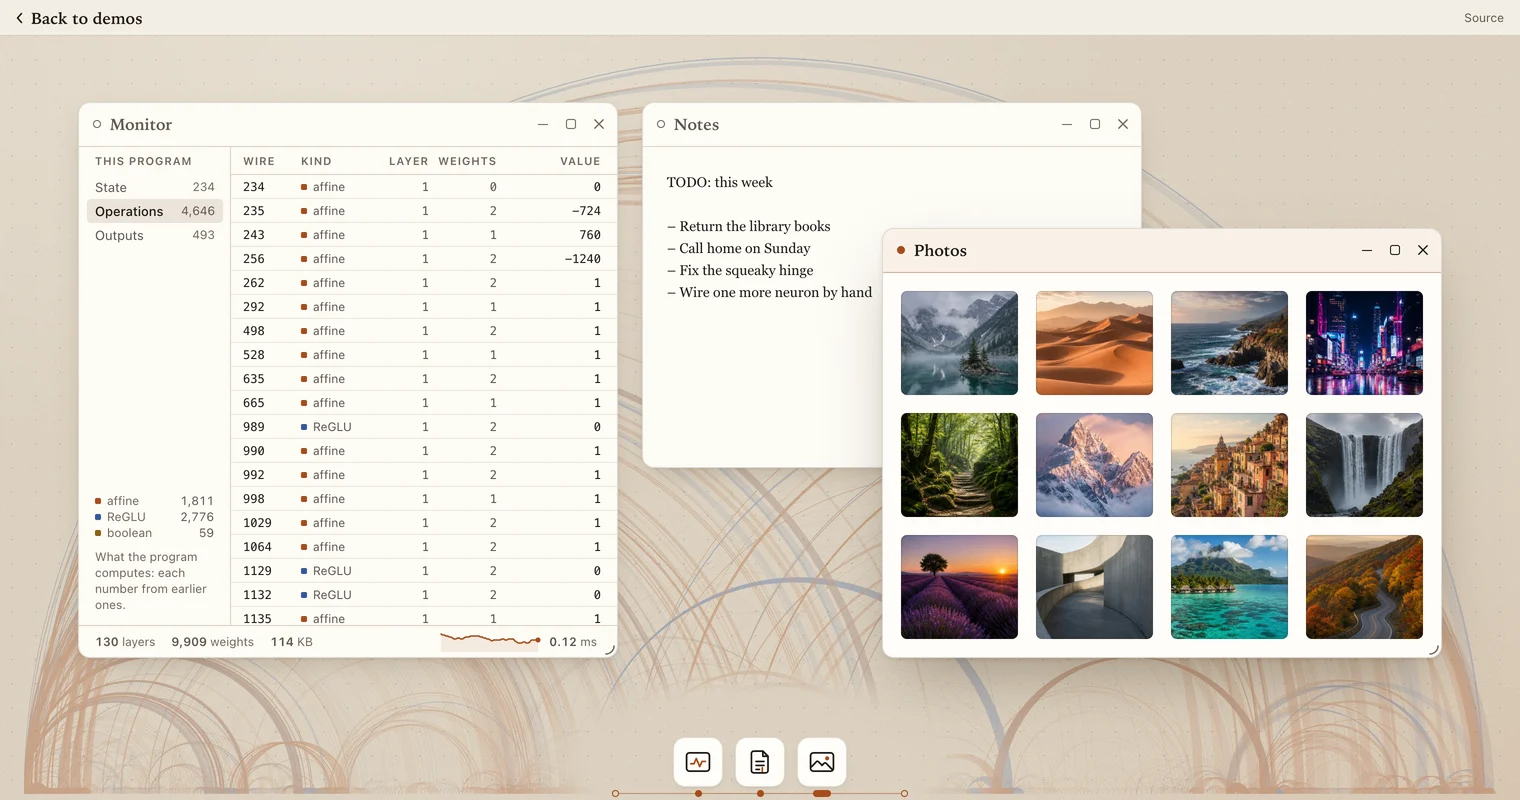
Cheng Lou의 프로젝트 Handwired는 일반 자바스크립트와 타입스크립트로 작성한 빌더 코드를 32비트 부동소수점 연산 네 가지만으로 이루어진 신경망 회로로 컴파일한다. 이 회로는 학습 없이도 원래 코드와 똑같이 실행되고, 역전파 학습과 WebGPU 비트 패킹 실행까지 지원한다.
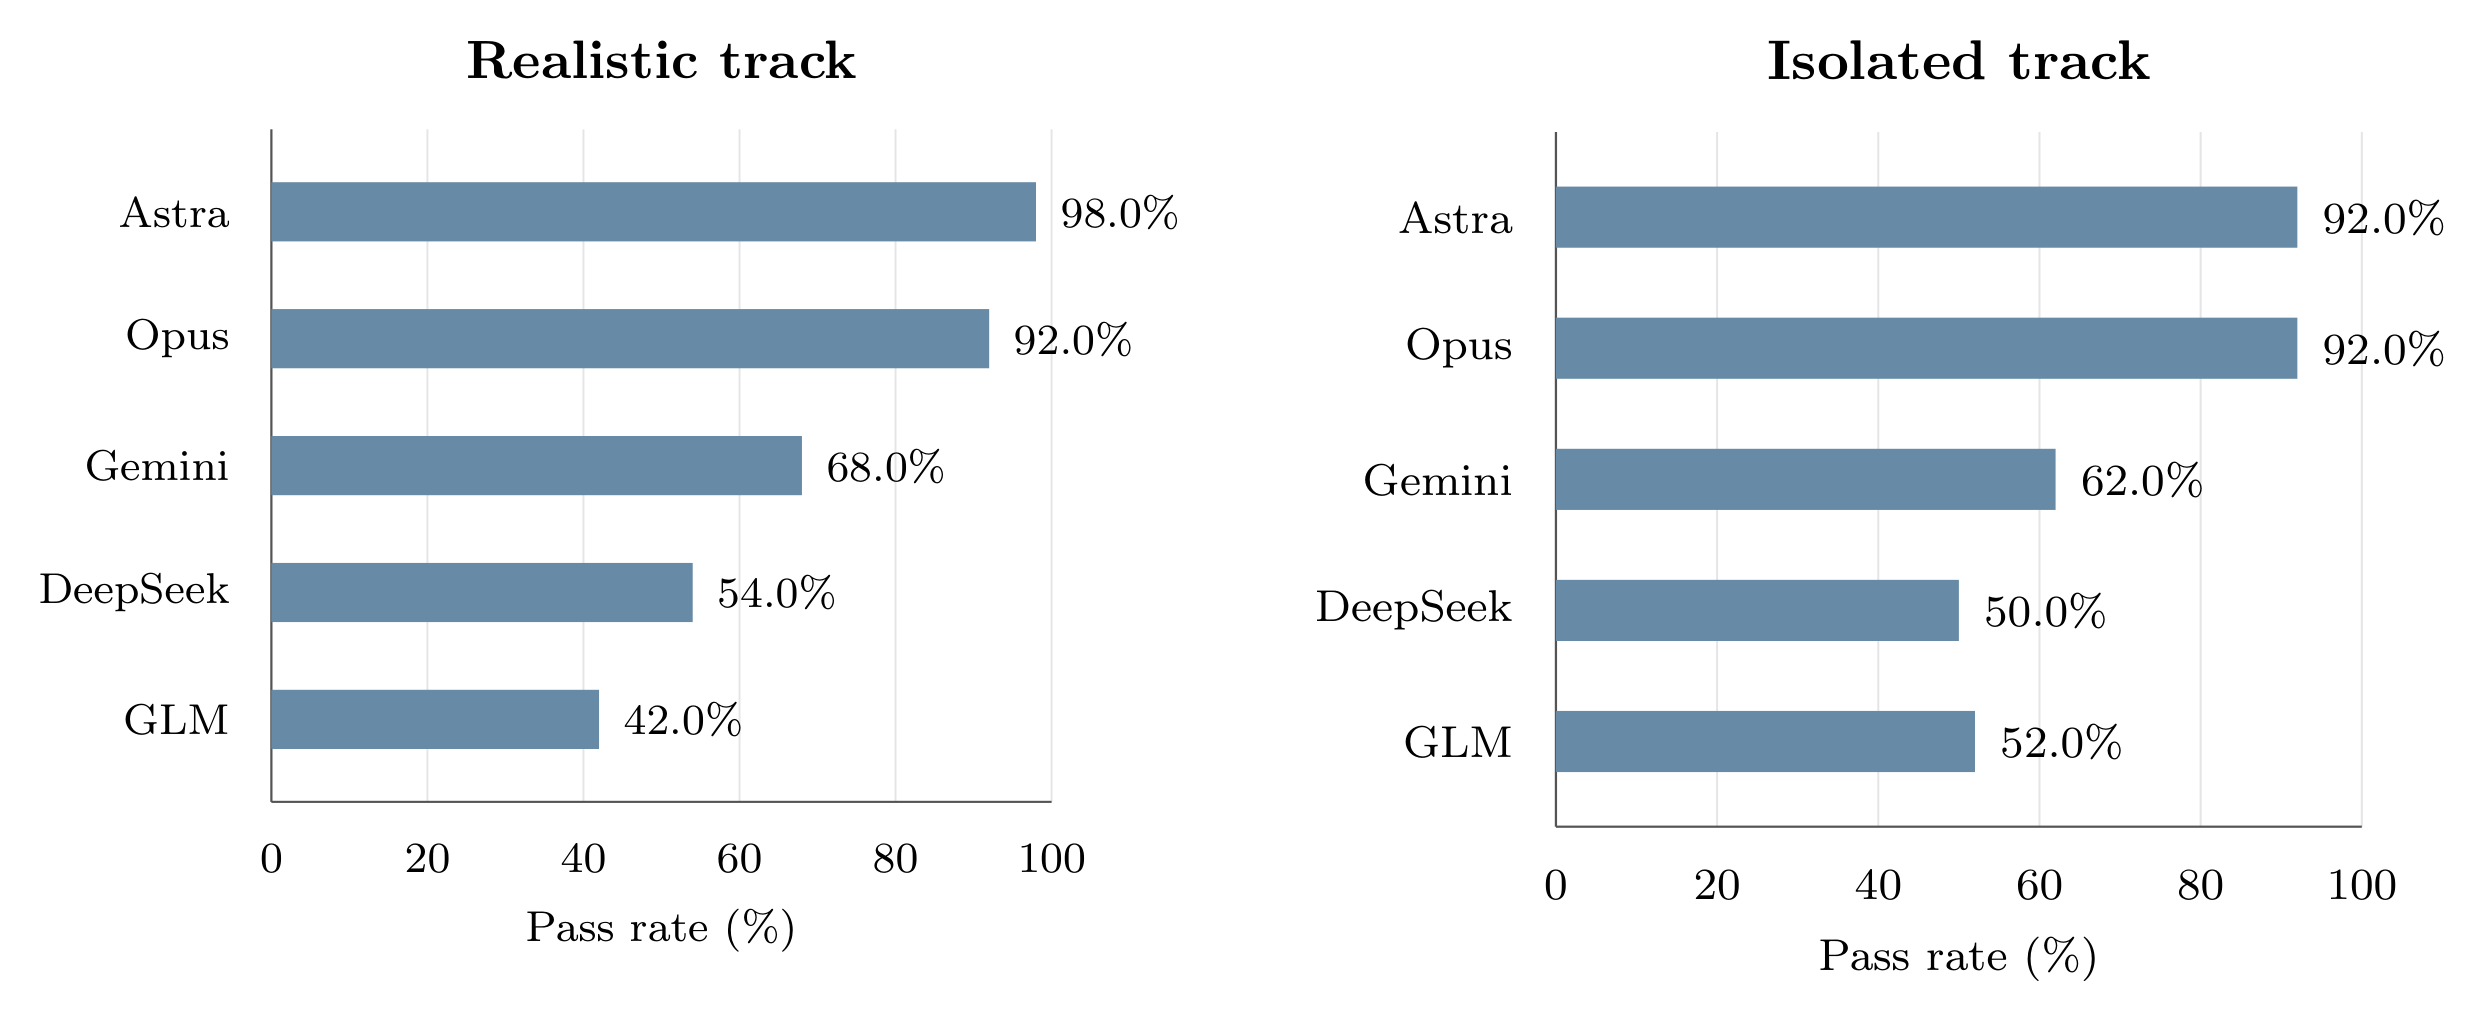
이론물리 전문가 32명이 아직 발표하지 않은 연구 수준 문제 50개를 모아 AI 에이전트 다섯 종을 시험했다. GPT-6-Astra와 Codex 조합은 문헌 검색과 스크립트 실행을 허용한 조건에서 49문제를 맞혀 정답률 98%를 기록했고, 문제당 비용은 평균 2.33달러였다. 저자들은 에이전트가 세계 전문가 수준으로 계산을 해내지만, 좋은 문제를 고르는 일에는 아직 사람이 필요하다고 결론지었다.
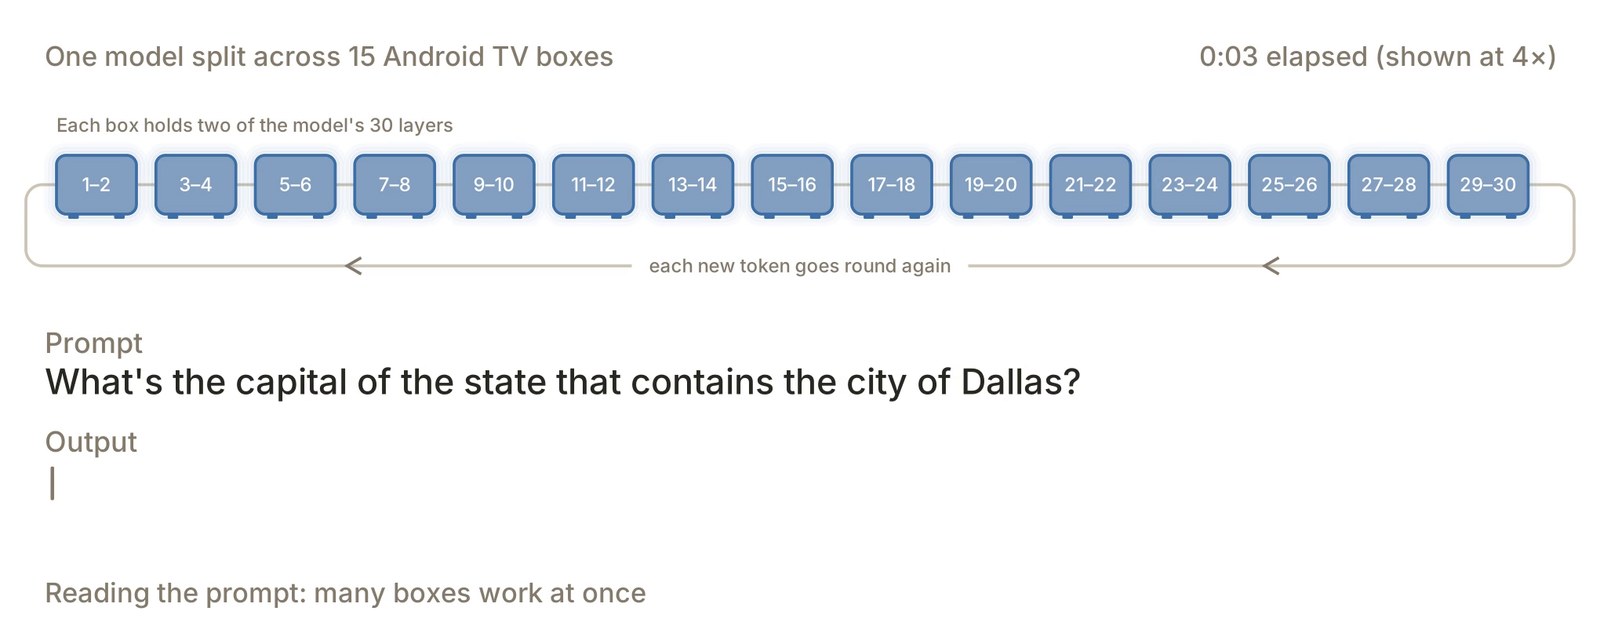
Anthropic은 TV 박스 15대로 26B 모델을 실행하고, 소형 모델의 추론 환경 준비와 복제 능력을 평가했다. 전체 과정에 성공한 모델은 아직 기기에서 직접 실행할 만큼 작지 않다. 저자들은 성능 추세를 근거로 2026년 말이면 소형 모델도 이 수준에 도달할 수 있다고 예상했다.
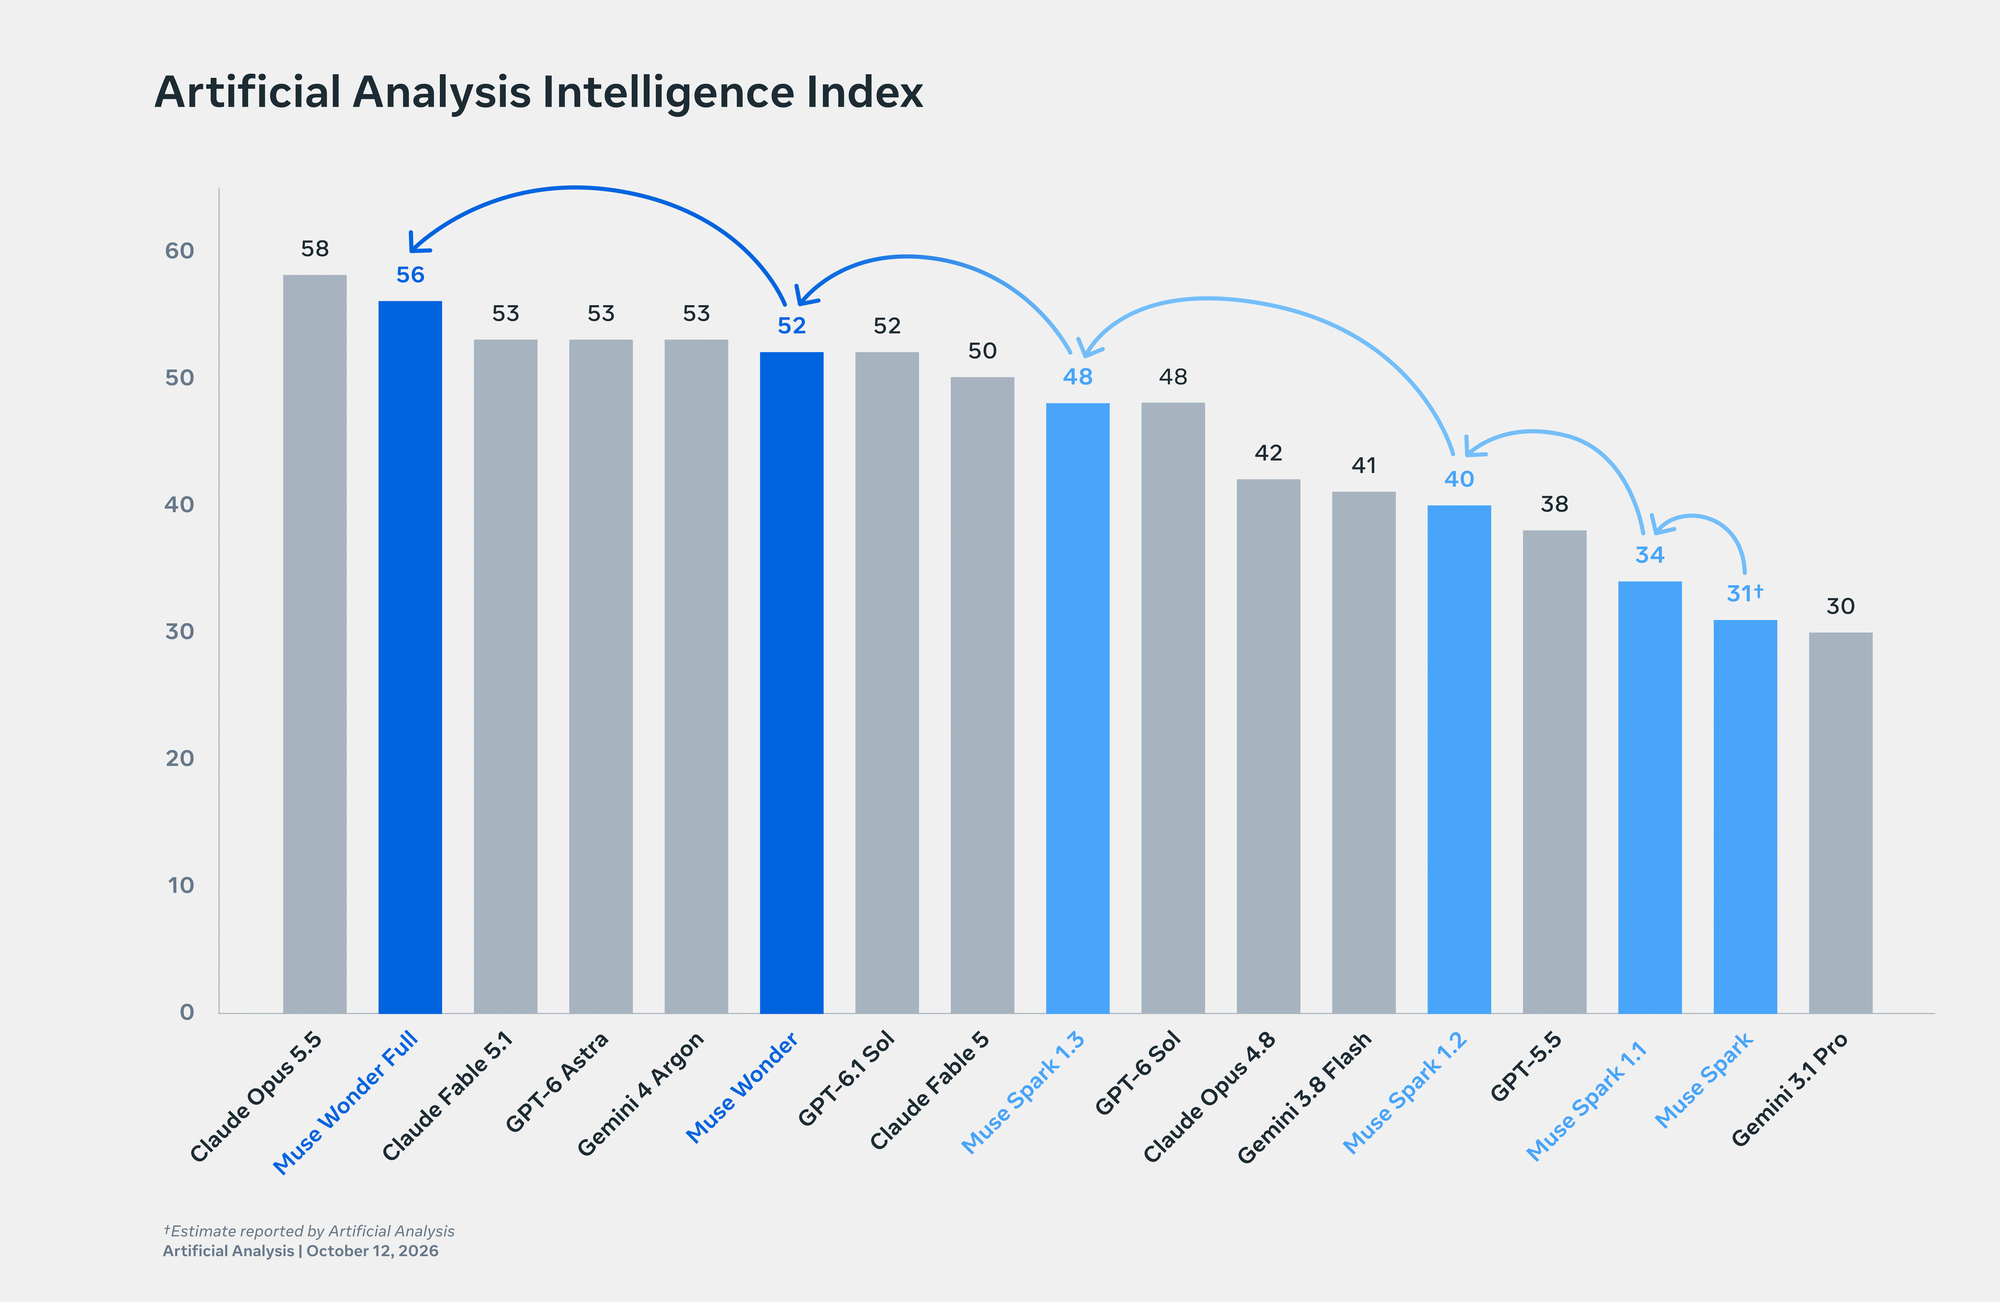
메타가 2026년 10월 12일 Muse Wonder와 Muse Wonder Full을 공개했다. 두 모델은 개인 비서와 업무용 에이전트를 위해 개발됐다. 메타가 공개한 14개 평가 중 7개에서 Muse Wonder 계열이 비교 모델 가운데 가장 높은 점수를 받았고, 종합 지수에서는 Full이 Claude Opus 5.5에 이어 두 번째다. 메타는 사용자의 맥락을 기억하는 Active Memory와, 문제가 생겨도 끝까지 일하는 Active Focus를 강점으로 강조했다.
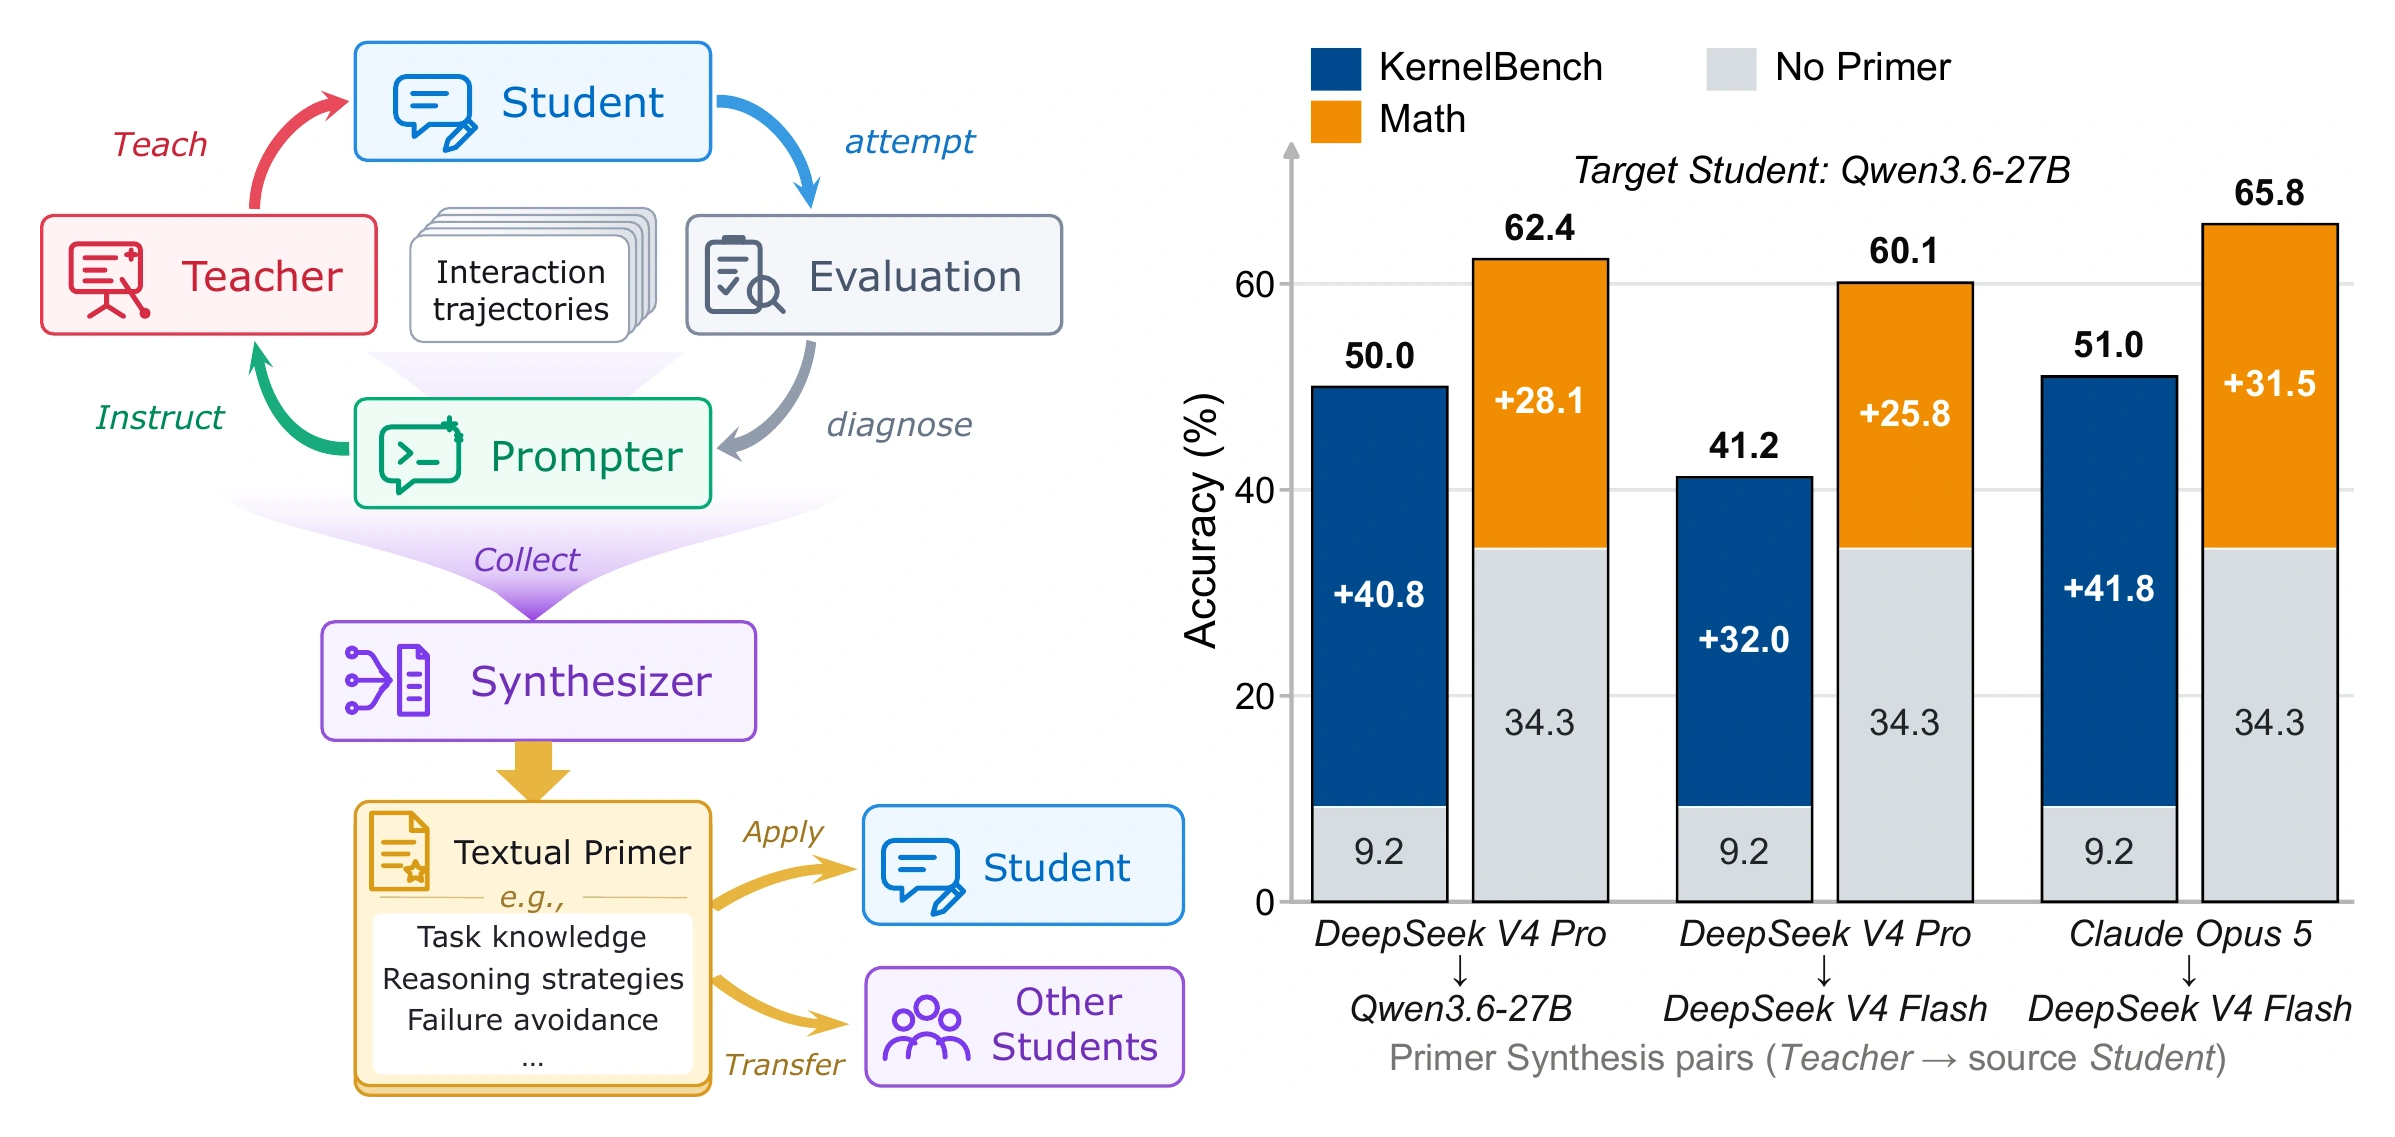
웨스트레이크 대학교 연구진은 강한 모델이 맞히고 약한 모델이 틀린 문제에서 얻은 교훈을 Primer라는 자연어 안내문으로 정리해 약한 모델에게 전달하는 방법 UTT를 제안했다. 약한 모델의 가중치는 학습시키지 않는다. Primer를 받은 DeepSeek V4 Flash의 KernelBench 정확도는 9.4%에서 48.6%로, 올림피아드 수학 정확도는 27.6%에서 51.7%로 올랐고, 합성에 참여하지 않은 다른 학생 모델도 같은 Primer로 점수가 올랐다.
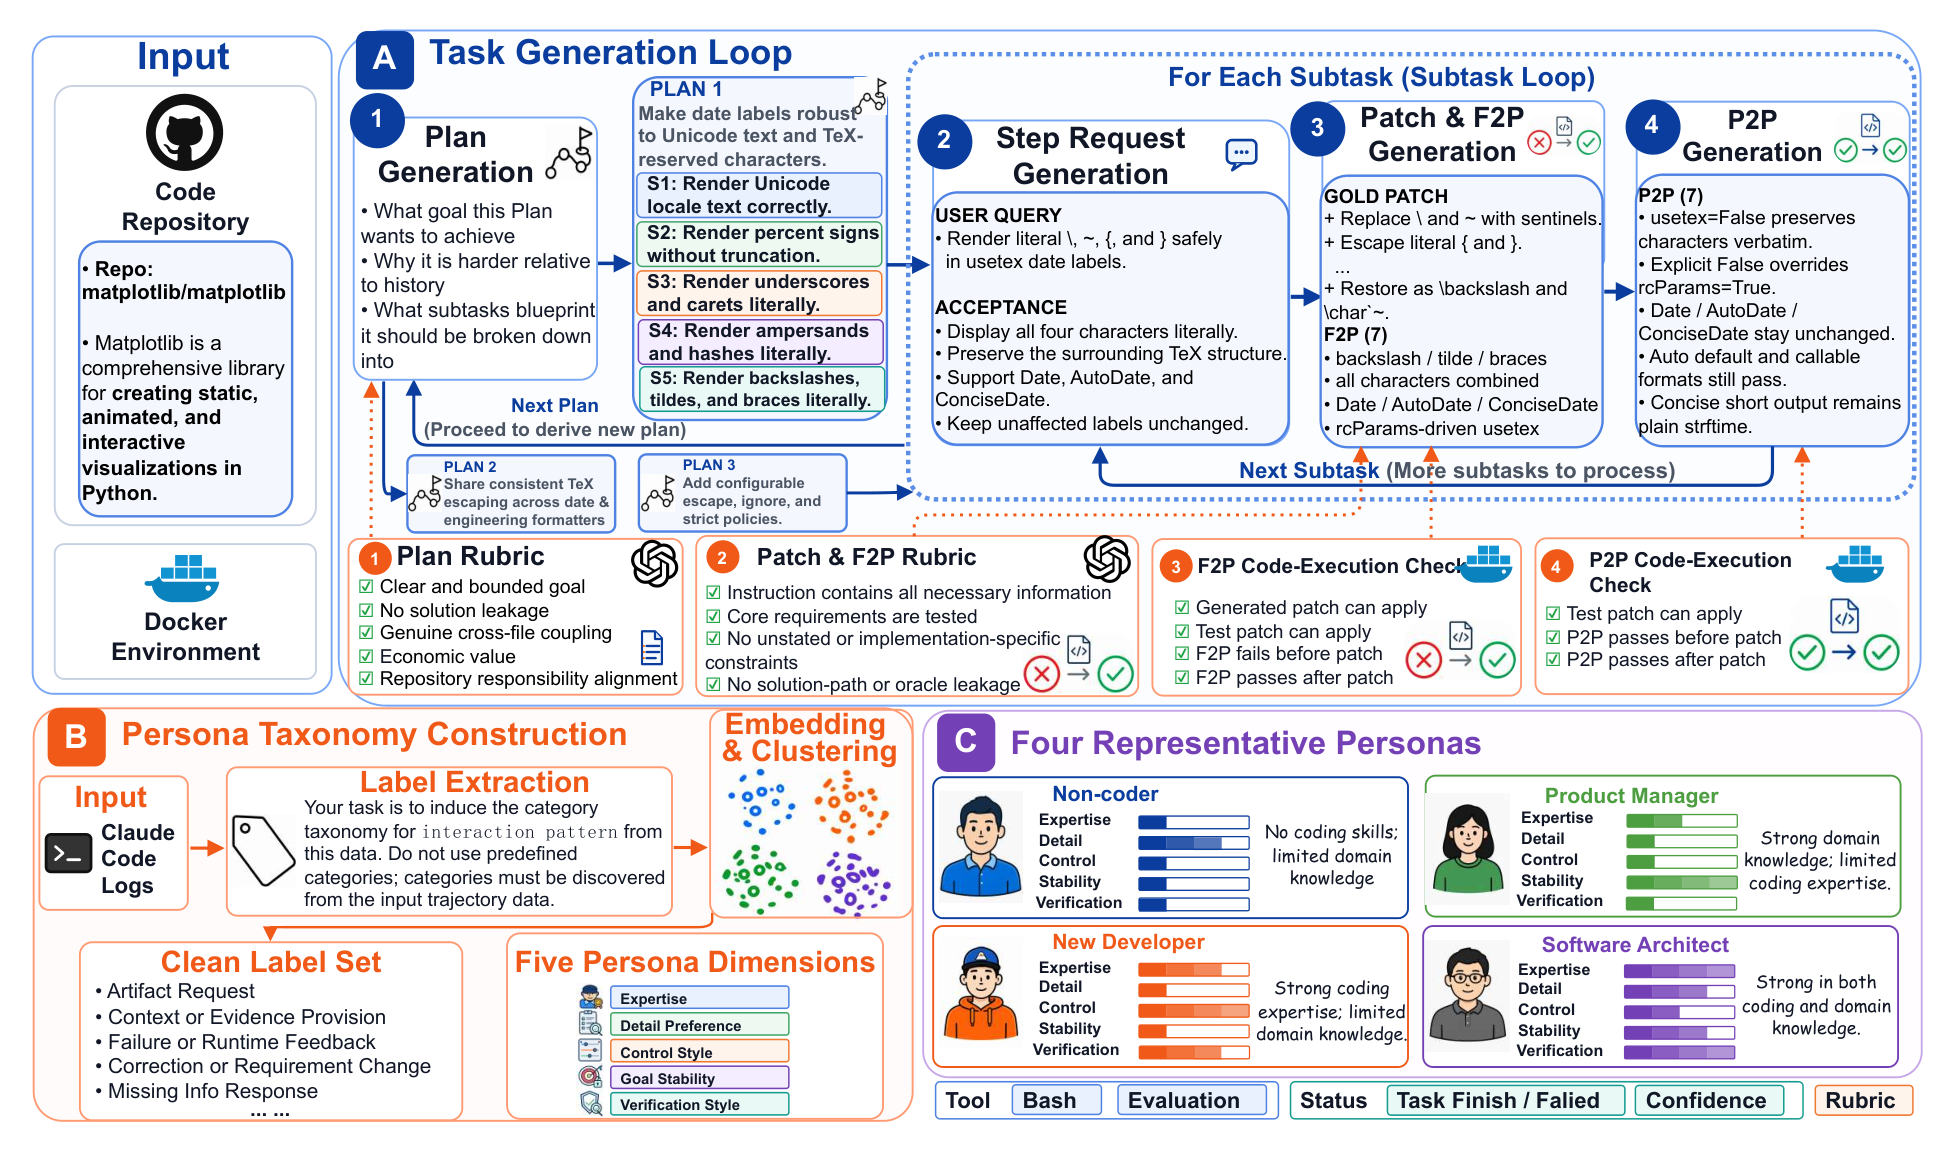
SWE-Journey는 코딩 어시스턴트 벤치마크다. 평균 19.8개의 하위 과제로 이루어진 긴 개발 과제를 네 유형의 시뮬레이션 사용자와 여러 턴 동안 수행하게 한다. 13개 모델의 평균 최종 기능 테스트 통과율은 소프트웨어 아키텍트와 협업할 때 78.50%, 비개발자와 협업할 때 23.00%였다.
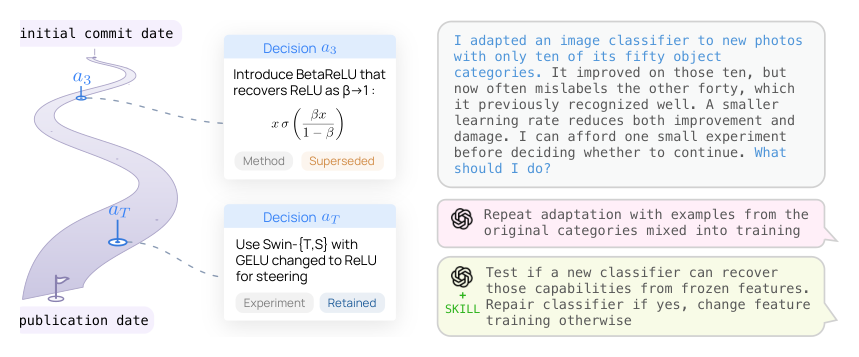
시카고 대학교 연구진은 논문과 함께 공개된 GitHub 저장소의 커밋 기록에서 연구자가 내린 결정의 순서를 추출해 데이터셋 ResearchTrails를 만들었다. NeurIPS 논문과 함께 공개된 저장소 599개에서 연구 결정 13,271개를 얻었고, 이 기록으로 정리한 스킬은 다음 연구 결정을 예측하는 과제에서 최종 논문만으로 정리한 스킬보다 높은 점수를 받았다.