The path from Fable to superintelligence
Anthropic이 Fable을 출시한 직후 zero_goliath가 쓴 짧은 에세이. 컴퓨트가 아니라 데이터 파이프라인이 진짜 병목이며, RLVR이 한계에 닿으면 AI가 운영하는 실제 회사들의 손익이 다음 보상 신호가 된다고 본다.
Anthropic이 Fable을 출시한 직후 zero_goliath가 쓴 짧은 에세이. 컴퓨트가 아니라 데이터 파이프라인이 진짜 병목이며, RLVR이 한계에 닿으면 AI가 운영하는 실제 회사들의 손익이 다음 보상 신호가 된다고 본다.
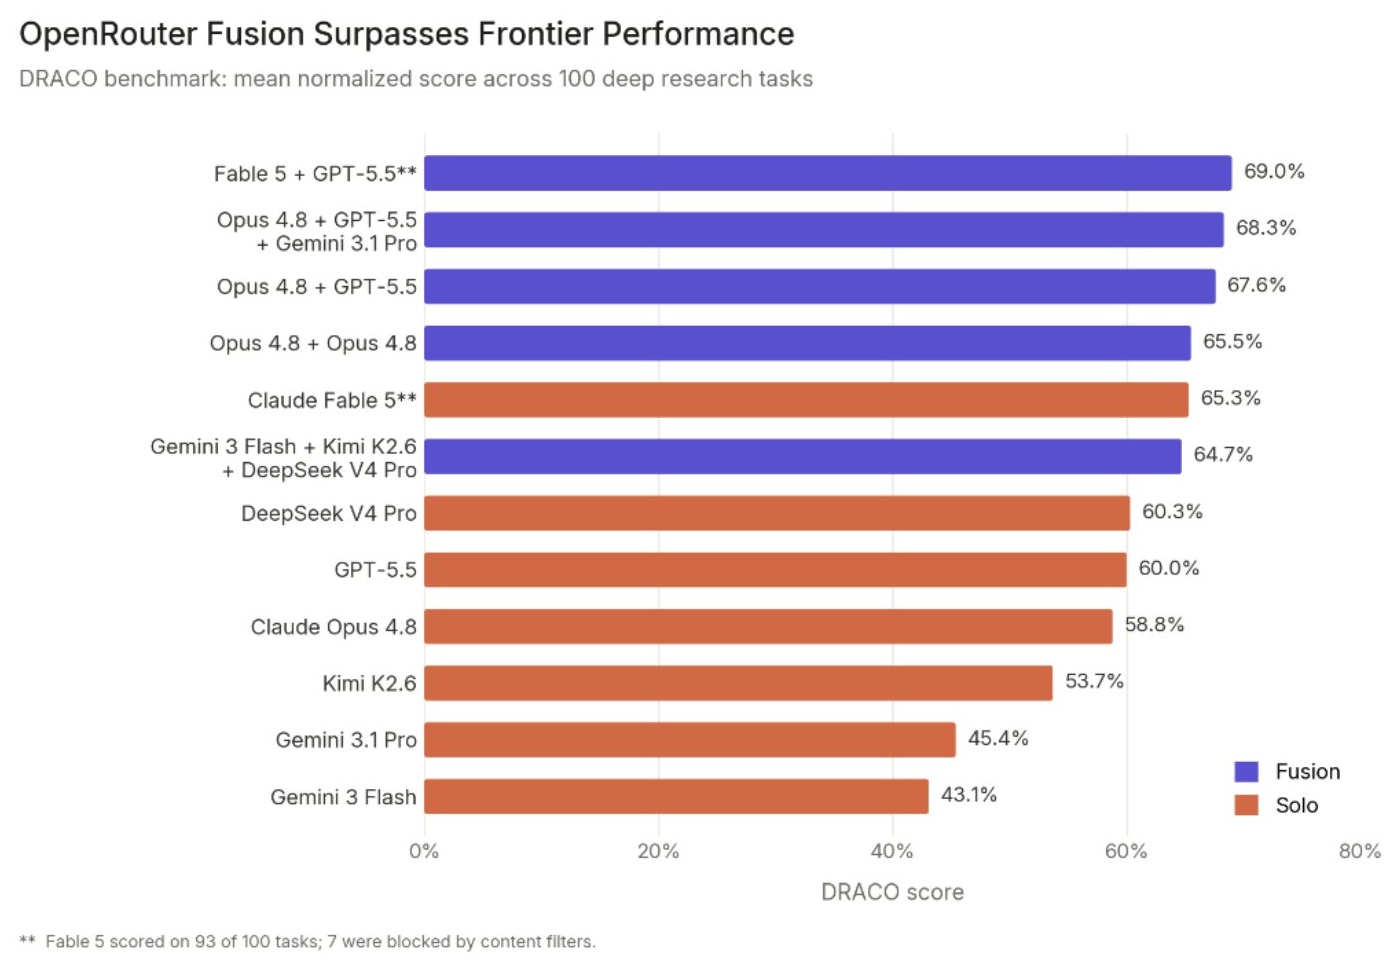
Andrew Trask는 더 큰 단일 모델이 AI 한계를 독점하리라는 통념이 끝났다고 선언한다. 작은 모델들의 가중 앙상블이 정확도·속도·비용에서 이미 단일 프런티어 모델을 추월하기 시작했고, AI의 미래는 회사 단위가 아닌 세계 단위의 ’network-source AI’다.
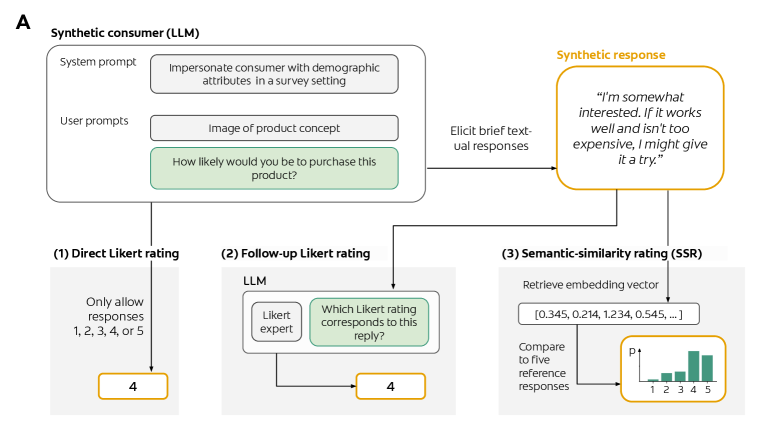
LLM에게 리커트 점수를 직접 묻는 대신 자유 텍스트 응답을 임베딩 유사도로 점수 분포에 사상하는 SSR 기법을 제안한 논문. 9,300명 실제 설문 대비 인간 재검사 신뢰도의 90%를 달성했다.
Anthropic이 같은 가중치를 두 얼굴로 출시한 최신 모델의 시스템 카드. 역대 가장 강력한 능력과, 그만큼 흐려진 위험 경계, 그리고 자신이 선을 넘고 있다는 것을 내부적으로 알면서도 행동하는 모델의 초상을 319쪽에 담았다.
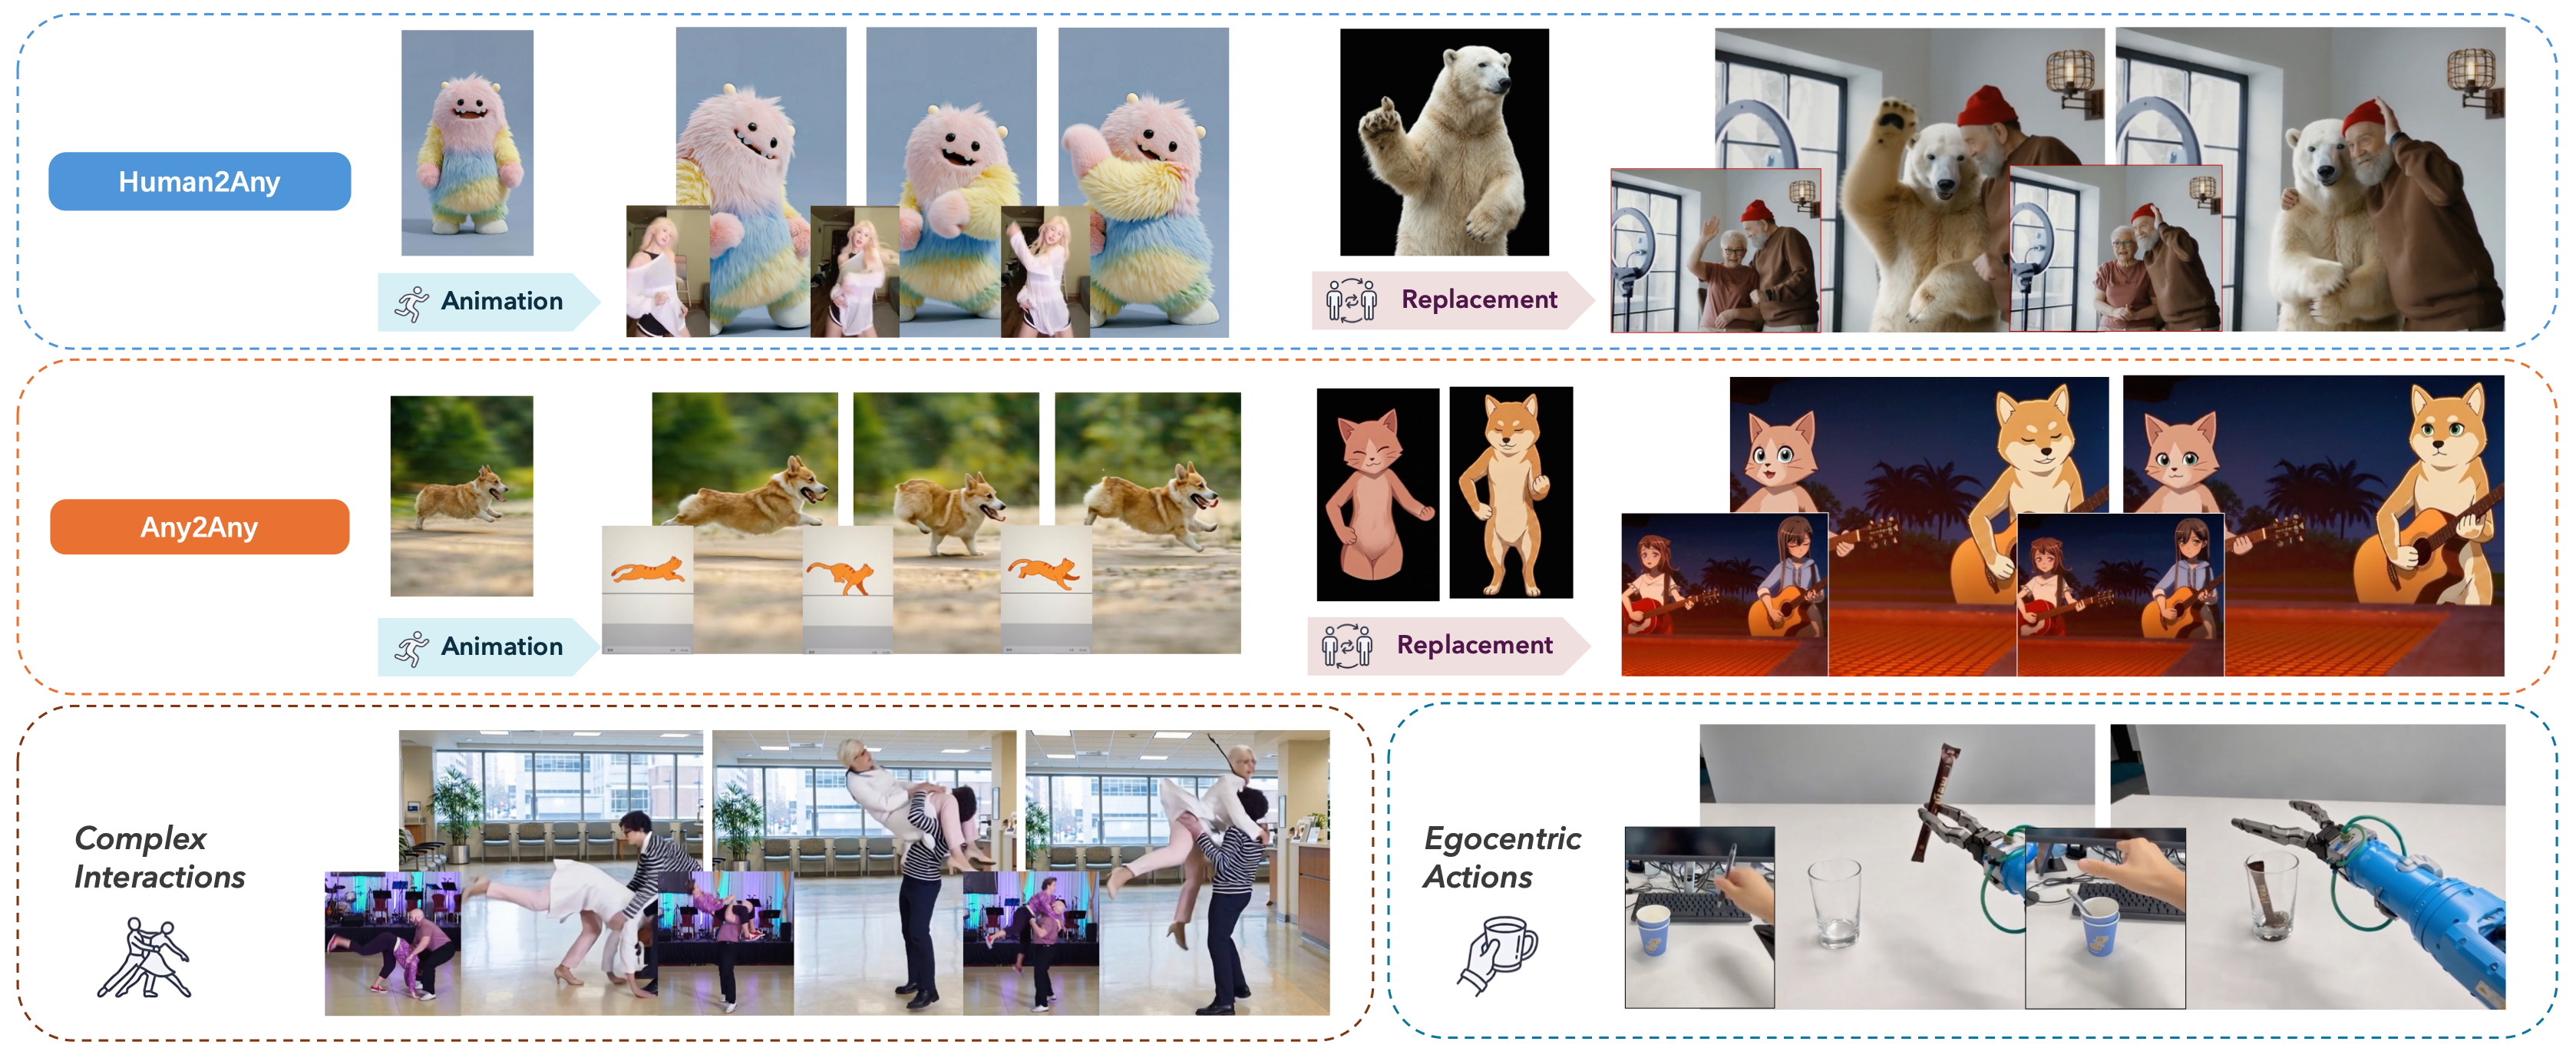
Z.ai가 공개한 SCAIL-2는 포즈 스켈레톤·인페인팅 마스크 같은 중간 표현을 거치지 않고 driving 비디오 latent를 시퀀스에 직접 이어 붙여 캐릭터 애니메이션을 end-to-end로 합성한다. 60K motion pair 데이터셋, in-context mask conditioning, mode-specific RoPE, Bias-Aware DPO를 결합하여 동물 driving과 egocentric 같은 제로샷 능력까지 끌어냈다.
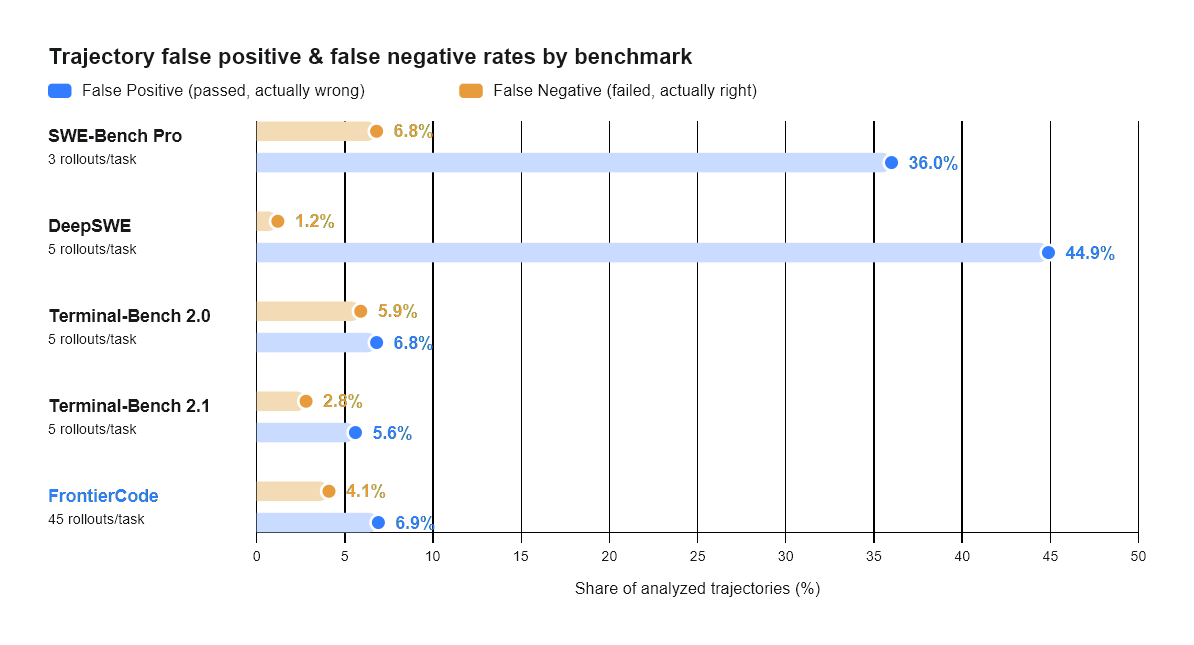
Cognition이 공개한 신규 코딩 벤치마크. 정답 여부가 아니라 ‘메인테이너가 실제로 머지하겠는가’를 측정한다. Diamond 50문항에서 최강 모델 Claude Opus 4.8도 13.4%에 그쳤다.
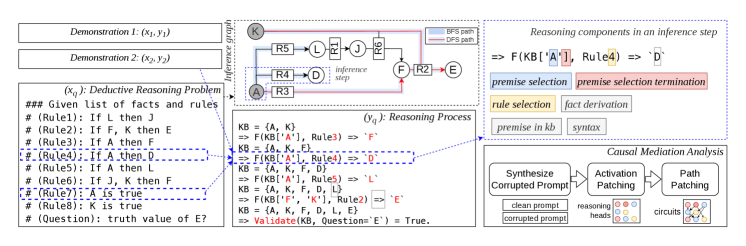
LLM이 연역 추론을 수행할 때 전체 attention head의 약 3%만이 핵심 회로를 이룬다는 것을 인과 매개 분석으로 보인 논문. 추론 흐름은 규칙 조건 매칭에서 출발해 순회 알고리즘 구현, 전제와 규칙 선택, 종료 결정으로 순차 진행된다.
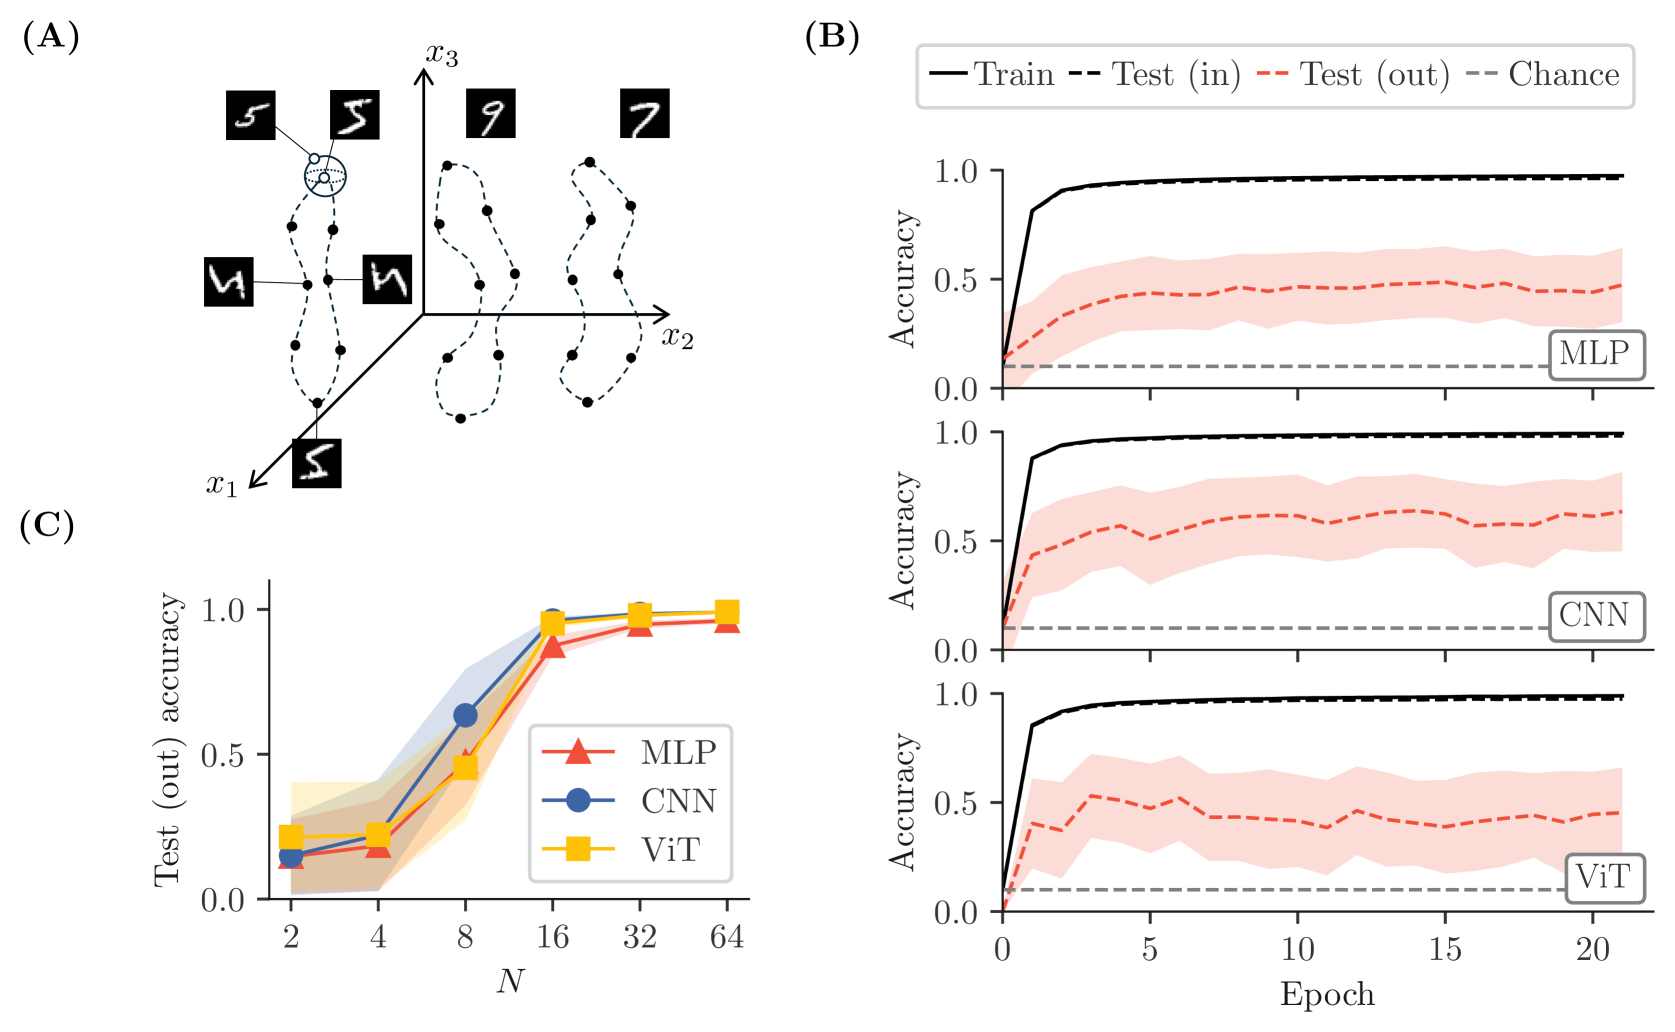
Perin·Deny(Aalto, NeurIPS 2024 v2 2025-06)가 무한폭 NTK 한계에서 신경망의 대칭 학습 능력을 분석한 논문. 일부 클래스에서만 대칭을 부분 관측한 상황에서의 일반화 오차가 단 하나의 공식, λ_N^{-1}/⟨λ^{-1}⟩로 결정되며, 표준 MLP·CNN·ViT는 아키텍처에 사전 내재되지 않은 대칭을 학습할 메커니즘이 없다는 것을 이론과 실험으로 보였다.
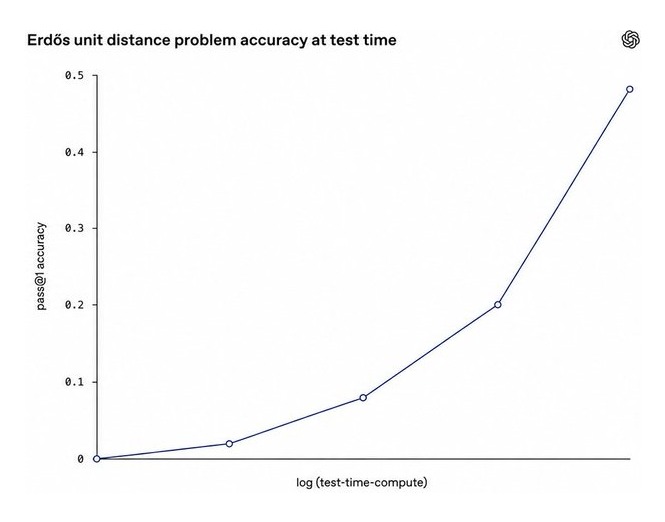
OpenAI 추론 연구자 노암 브라운(@polynoamial)이 X에 올린 장문 글을 정리한다. 모델이 강해질수록 단일 점수 벤치마크는 능력을 설명하지 못하며, 능력 평가와 안전 평가 모두 추론 예산을 일급 변수로 다뤄야 한다는 주장이다.
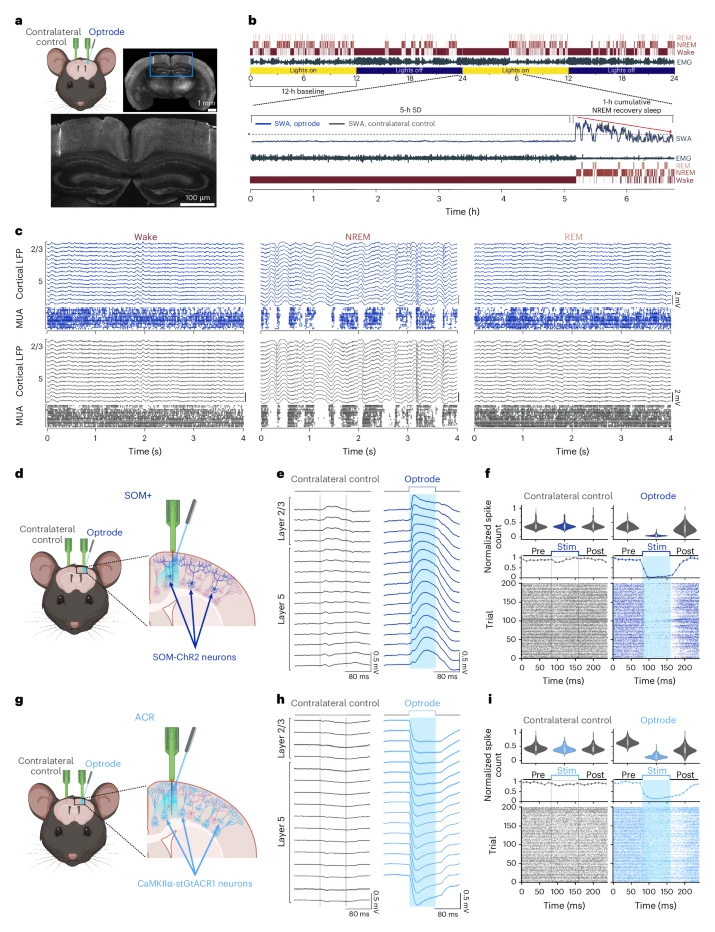
위스콘신 대학 Tononi·Cirelli 팀의 Nature Neuroscience 논문(2026.06.08). 깨어 있는 쥐의 대뇌 피질에 광유전학으로 NREM 수면 같은 on/off 패턴을 인위적으로 만들면, 단순한 발화 감소로는 불가능한 수면의 핵심 기능(국소 수면 압력 해소, 시냅스 다운셀렉션, 기억 통합)이 깨어 있는 동안에도 일어난다.